KaliBench:Kali Linux 上的细粒度网络安全工具调用基准与免运行时可验证奖励 KaliBench: A Fine-Grained Benchmark for Cybersecurity Tool Use on Kali Linux with Runtime-Free Verifiable Rewards
首个Kali Linux细粒度安全命令生成基准,免运行时奖励训练使8B模型媲美685B
前置知识
Schema-free NL-to-CLI 翻译
把自然语言指令直接翻译成可执行的命令行,且不给模型提供工具的 JSON schema 或参数说明。与函数调用基准(模型只需按 schema 填字段)不同,模型必须凭内部知识同时选出正确工具并写出语法、参数都正确的命令。
本文的核心设定:Kali 有 2372 个工具,无法在 prompt 里枚举全部 schema,理解这一设定才能理解为什么任务难度远超传统 function calling 基准。
RLVR 与 GRPO
RLVR(Reinforcement Learning with Verifiable Rewards)指用可程序化验证的信号(如答案正确性)作为奖励做强化学习,而非依赖人工标注或奖励模型。GRPO(Group Relative Policy Optimization)是 DeepSeek 提出的策略优化算法,对同一 prompt 采样一组回答,用组内相对优势代替价值网络来估计优势函数,训练更省显存。
论文训练部分的第二大支柱就是 RLVR:利用 CLI 命令可确定性验证的特性构造奖励,用 GRPO 在 8B 模型上做免运行时的强化学习。
别名感知的参数匹配与 F1
UNIX CLI 中长选项与短选项等价(如 $-l \equiv --list$),可选参数顺序无关,位置参数顺序固定。别名感知匹配把等价写法视为相同,再对预测与真值的参数集合计算精确率/召回率的调和平均 $F_1 = 2PR/(P+R)$,从而公平评分而不惩罚等价形式。
论文所有评测指标(Optional-Arg F1、Positional-Arg F1、Exact Correct)都建立在这套匹配规则上,不理解它就无法理解分数的含义。
LoRA 参数高效微调
LoRA 冻结预训练权重,只训练注入到注意力/MLP 层的低秩分解矩阵 $\Delta W = BA$(秩 $r \ll d$),大幅降低显存与算力需求,单卡即可微调 8B 级模型,常配合 Unsloth 等加速库使用。
论文用 LoRA + Unsloth 在单张 H200 上完成 8B 模型的 SFT 与 GRPO,理解 LoRA 才能评估其训练成本与可复现性。
研究动机
现有 LLM 网络安全评测分两类,都无法回答"模型能否写出正确命令":一类是知识型基准(SecEval、CyberMetric、SECURE、CTI-Bench 等),用选择题或简答测概念理解;另一类是端到端智能体基准(CyBench、NYU-CTF Bench、DefenderBench),让模型自主完成 CTF 挑战,但规划、环境交互、工具调用、错误恢复混在一起,失败无法归因到具体环节。而现实安全运营严重依赖命令行:Kali Linux 预装 2000+ 安全工具包,分析师要把"扫描子网 SMB 配置错误"这类意图翻译成 nmap、Metasploit、Volatility 的精确调用,CLI 极不容错——参数顺序、标志拼写、别名混用的微小错误就会使执行失败。已有函数调用基准(BFCL、ToolSandbox 等)假设工具由 JSON schema 显式定义,但 Kali 有 2,372 个工具,在 prompt 中枚举全部 schema 因上下文长度限制并不现实,评测实质上是 schema-free 的。
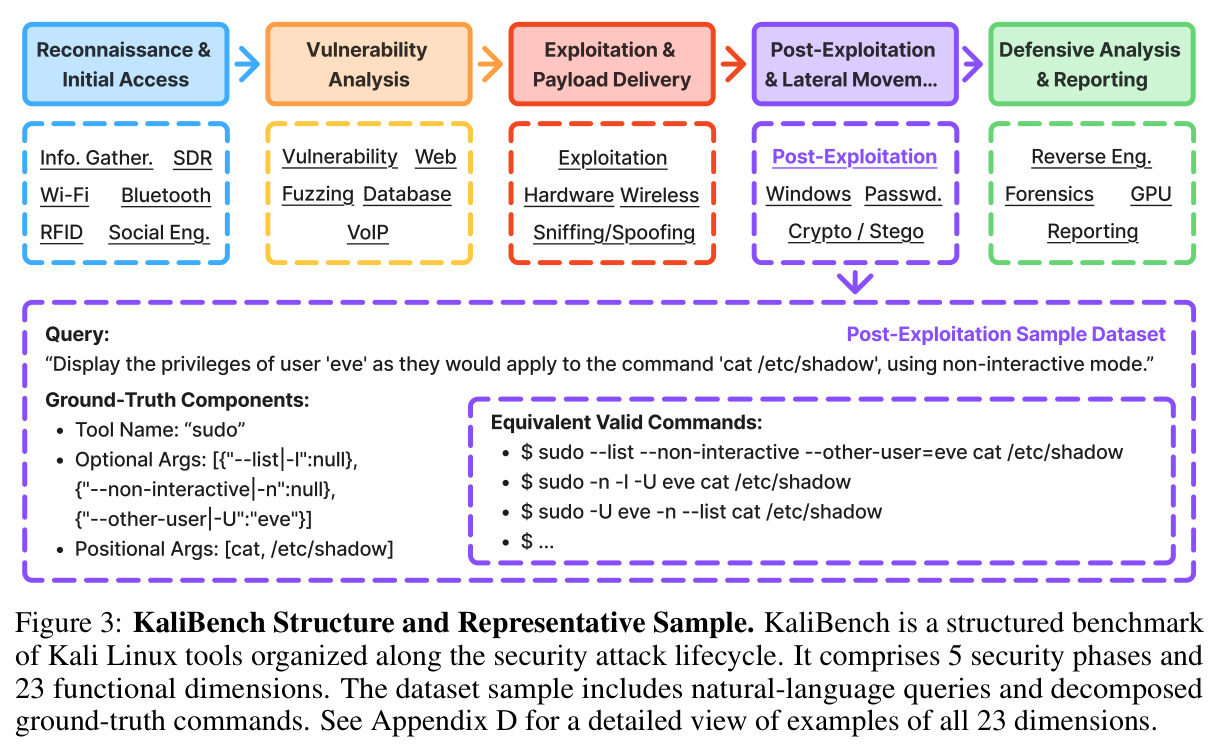
本文的目标是构建 KaliBench——一个面向 Kali Linux 自然语言到 CLI 翻译的细粒度基准与数据集:覆盖 1,642 个工具、8,504 对查询-命令,按 23 个能力维度和 5 个安全阶段组织,切分为 5,000 评测对与 3,504 训练对。数据通过"官方文档锚定生成 + LLM 验证 + 沙箱执行 + 人在环路复核"的多阶段管线保证语义正确与真实可执行。评测上,把命令分解为工具选择与参数构造,设计 Unrestricted/Restricted/Hinted 三种模式逐级提供工具信息,用别名感知的确定性指标(Tool Accuracy、Optional/Positional F1、Total Score、Exact Correct)精确定位模型短板。训练上,利用 CLI 评测的确定性结构提供免运行时可验证奖励,证明 SFT 与 RLVR(GRPO)能把 8B 模型的三模式平均 Total Score 提升 7.5 个百分点,达到与 685B MoE 相当的水平。
与已有工作不同的是,独特切入有三点。第一,schema-free 设定:不同于 BFCL 等把工具 schema 直接给模型填空,这里 2,372 个工具的文档无法塞进 prompt,模型必须凭内部知识同时完成选工具和写参数,更贴近真实安全运维。第二,细粒度解耦评测:不满足于整条命令的对错,而是拆成工具名、别名等价的可选参数(如 $-l \equiv --list$,顺序无关)、顺序固定的位置参数,分别打分,从而首次把"参数构造"识别为主要瓶颈。第三,评测即奖励:因为真值命令在构建期已通过沙箱执行验证,评分函数是纯确定性解析比对,可以直接当作 RL 奖励,训练时完全不需要执行模型输出,避开了 agentic RL 沙箱的高成本与安全风险。这个 runtime-free verifiable rewards 把基准和训练方法统一在了同一个确定性评分器上。
核心方法
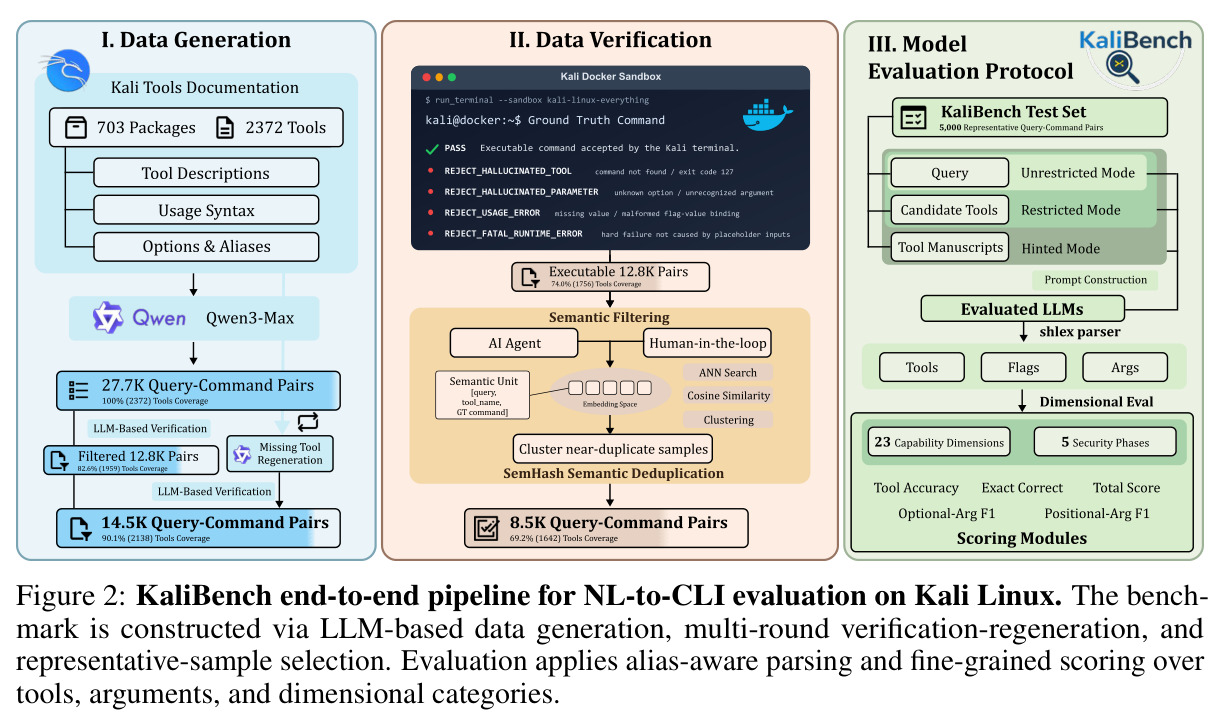
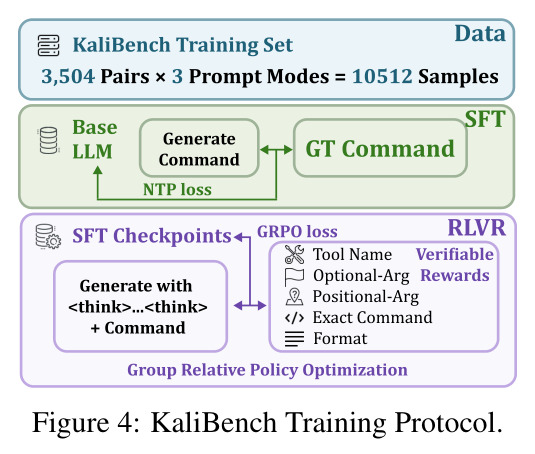
直觉:安全场景的命令生成失败主要不在"选错工具"而在"写错命令",所以需要能把这两种能力分开测、且判分完全确定的基准。技术路线四步。(1) 数据生成:从 Kali 仓库抓取 2,372 个工具的结构化 Markdown 文档(含长短选项与别名),用 Qwen3-Max 对每个工具生成 10–13 对查询-命令及结构化标注,得 27.7K 对。(2) 多阶段验证:LLM-as-Verifier 对照文档逐对核查(首轮过滤 53.8%,含再生成共移除 47.65%,余 14.5K);Docker 内 kali-linux-everything 沙箱逐条执行(再过滤 11.95%);AI agent + 人工复核(再剔 4.9%);SemHash 对 [query, tool_name, command] 语义单元以余弦相似度 $>0.90$ 聚类去重,最终保留 8,504 对(原始的 30.7%),切分为 5,000 评测对(覆盖全部 1,642 工具)+ 3,504 训练对(962 工具)。(3) 评测协议:三种提示模式下用 shlex 解析模型输出,与真值组件级比对。(4) 训练协议:3,504 对 × 3 模式 = 10,512 样本,LoRA + SFT/GRPO。
核心创新一:把自然语言到 CLI 定义为 schema-free 任务——安全工具数量太大,无法像函数调用基准那样在 prompt 中提供 schema,模型必须"从记忆中重建命令",这比填结构化字段难得多。核心创新二:别名感知的细粒度确定性评分——将命令分解为 tool_name、可选参数(flag–value 对,长短别名等价、顺序无关)与位置参数(顺序固定),用 shlex 词法解析后按组件计算 Tool Accuracy、Optional-Arg F1 与 Positional-Arg F1($F_1 = 2PR/(P+R)$),Exact Correct 仅在全部组件精确匹配时为 1,使误差能定位到"哪个环节出错"。核心创新三:runtime-free verifiable rewards——真值命令在数据构建期已被沙箱验证可执行,评测器是无需环境的确定性函数,因此可直接作为 RLVR 奖励(工具名 + 可选参数 + 位置参数 + 格式 + 精确匹配五项),RL 训练不再需要执行模型生成的命令。与已有工作的本质区别在于:把基准评测器与训练奖励函数统一为同一个确定性评分器。
方法步骤详情
第一步·数据生成:输入 2,372 个工具的官方文档,Qwen3-Max 每工具产出 10–13 对查询-命令,附 tool_name、别名感知 flag–value 对、有序位置参数三类标注,输出 27.7K 对。第二步·LLM 验证:把 query、generated_command、tool_manuscript 交给 LLM,核查 flag 是否有文档依据、命令是否忠实实现查询;首轮过滤 53.8%,经迭代再生成得 14.5K 对(累计移除 47.65%)。第三步·终端验证:在 kali-linux-everything 镜像的 Docker 沙箱中逐条执行,记录 stdout/stderr/退出码/超时,规则化过滤幻觉命令,再移除 11.95%。第四步·人工复核:Codex 先交叉核对语义一致性,人工审查发现 4.9% 无效(如 $--g$ 应为 $-g$、漏写必选参数、参数语义错位)。第五步·去重切分:SemHash 嵌入后 ANN 聚类(余弦 $>0.90$),每簇留代表样本,得 8,504 对;评测集 5,000、训练集 3,504。第六步·评测:三模式提示,shlex 解析,计算五项指标。第七步·训练:RedSage-Ins-8B 为骨干,LoRA+Unsloth,单张 H200,batch 32,2 epochs,训练 SFT、GRPO、SFT+GRPO 三变体。
技术新颖性
与四类已有工作逐一对比:(1) 知识型安全基准(SecEval/CyberMetric/SECURE/CS-Eval 等)测知识回忆,本文测操作行为;(2) 端到端智能体基准(CyBench/NYU-CTF/DefenderBench)测完整 CTF 流程,失败无法归因,本文隔离命令生成并给出组件级归因;(3) 函数调用基准(BFCL/ToolSandbox/StableToolBench/HammerBench)假设 schema 已知,本文首次在 schema-free CLI 场景评测,并引入别名感知评分($-l \equiv --list$、可选参数顺序无关、位置参数顺序固定),这是对 UNIX CLI 语义的更忠实建模;(4) 训练方法上,主流 RLVR 需要在环境中执行动作取奖励,本文利用"命令可静态解析验证"的特性把评测器直接当奖励,免沙箱、低成本、可扩展。此外,"LLM 验证→沙箱执行→AI 辅助人工复核→语义去重"的数据质量管线本身也可迁移到任何 CLI 密集领域。
实验结果
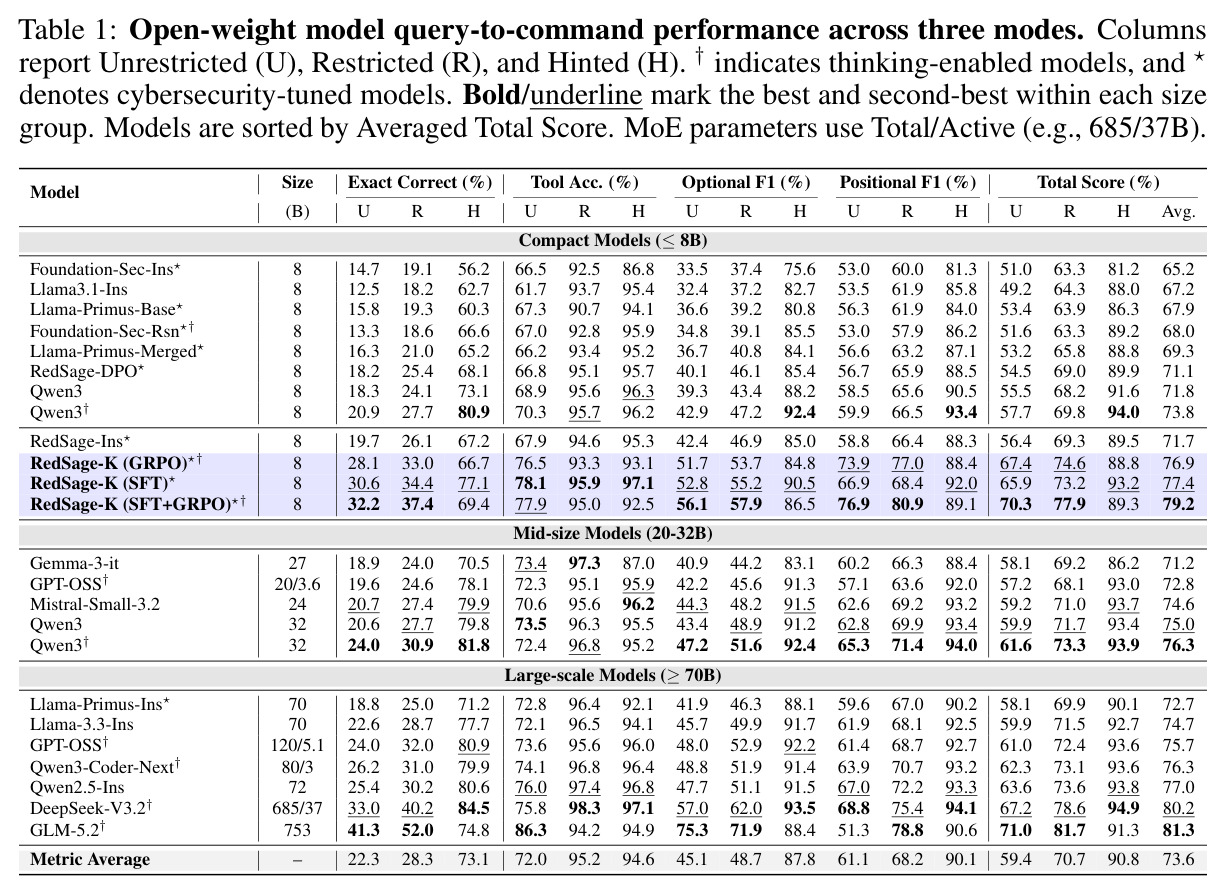
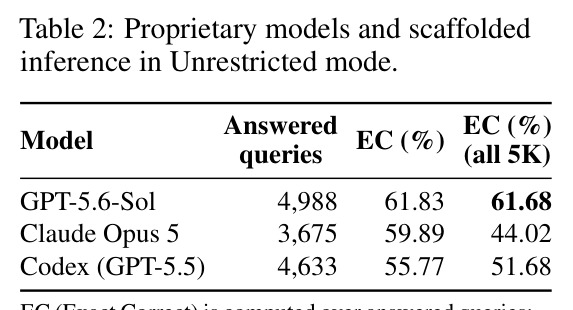
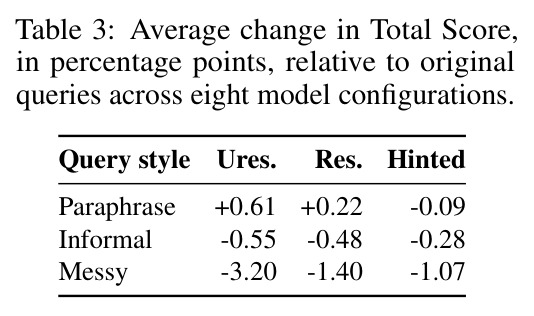
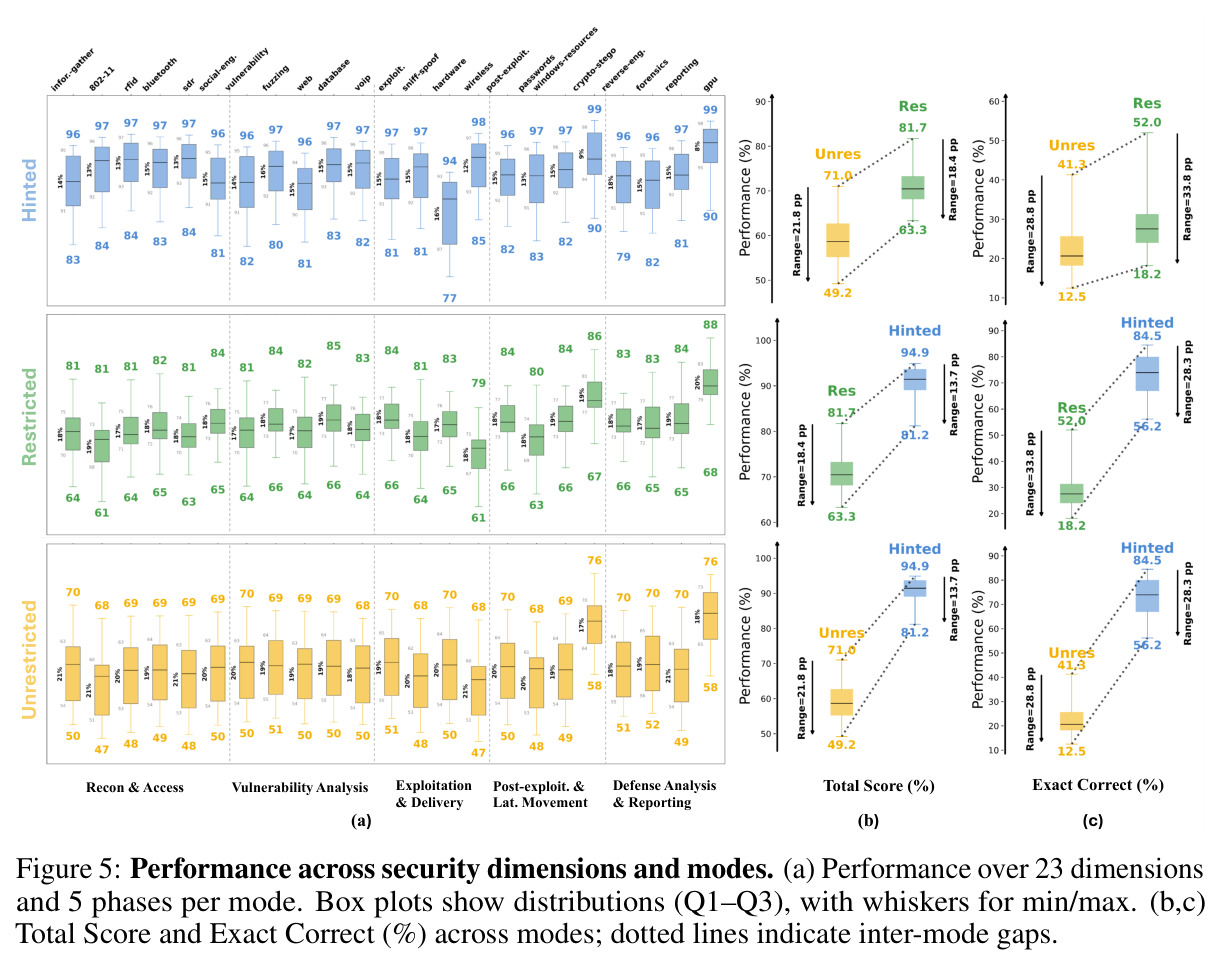
论文评测 24 个开源配置在三种模式下的表现。Unrestricted 下没有开源模型 Exact Correct 超过 42%:最强 GLM-5.2(753B)41.3%,DeepSeek-V3.2 33.0%。模式对比揭示能力分层:U→R 使平均 Tool Accuracy 从 72.0% 升至 95.2%,但参数级指标仅小幅提升,说明写对参数才是瓶颈;U→H 增益最大,EC 22.3%→73.1%,Opt-F1 45.1%→87.8%,TS 59.4%→90.8%,说明失败源于领域知识不足而非意图理解。规模效应不均:8B Qwen3†(Avg 73.8)超过 27B Gemma-3(71.2)。专有模型:GPT-5.6-Sol 全集 EC 61.68%,Codex 51.68%,Claude Opus 5 仅 44.02%(答题 EC 59.89%,但只回答 73.5% 的测试集)。后训练:RedSage-K(SFT+GRPO,8B)Avg 79.2、U 模式 EC 32.2%,超除 GLM-5.2 外全部开源模型,仅比 DeepSeek-V3.2† 低 1.0 分,平均 TS 提升 7.5 个百分点。失败模式四类:长短选项混用、选项幻觉、编造长选项、单复数混淆。鲁棒性:改写查询几乎无影响(+0.61),混乱查询在 U 模式掉 3.20 个百分点,Hinted 下仅 $-1.07$。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| NL-to-CLI 命令生成(Unrestricted 模式,5,000 测试集) | Exact Correct (%) | GLM-5.2 (753B) 41.3% 为最强开源;RedSage-K (SFT+GRPO) 8B 达 32.2% | 微调前骨干 RedSage-Ins 8B 为 19.7%,24 模型平均 22.3% | 8B 模型经 SFT+GRPO 提升 +12.5 个百分点,超过全部更大规模的安全专用模型 |
| 三模式平均 Total Score(开源模型综合排名) | Avg Total Score (%) | RedSage-K (SFT+GRPO) 8B 达 79.2,开源总排名第三 | DeepSeek-V3.2† (685B) 80.2;未微调 RedSage-Ins 71.7 | 8B 仅落后 685B MoE 1.0 分,三模式平均 TS 提升 7.5 个百分点 |
| 提供工具文档(Hinted)vs 无提示(Unrestricted) | Exact Correct (%) / Opt-F1 (%) | Hinted 下 24 模型平均 EC 73.1%、Opt-F1 87.8% | Unrestricted 下平均 EC 22.3%、Opt-F1 45.1% | 文档使 EC 提升 +50.8 个百分点,证明瓶颈是领域知识而非意图理解 |
| 专有模型/脚手架系统(Unrestricted,5,000 全集) | Exact Correct (%) | GPT-5.6-Sol 61.68%(最高) | Codex(GPT-5.5) 51.68%,Claude Opus 5 44.02%,最强开源 GLM-5.2 41.32% | 即使最强专有系统也未超过 62%,基准仍未饱和 |
局限与改进
作者承认的局限:只评单轮命令生成,不含多步工作流、环境反馈与错误恢复;数据由工具文档合成(manuscript-grounded),与真实分析师查询分布可能有偏差。我的补充观察:(1) 判分靠 shlex 静态解析而非真实执行,别名表之外的等价写法(引号转义、环境变量、管道替代形式)可能被误判为错;(2) 数据由 Qwen3-Max 生成,而被评模型大量来自 Qwen 家族,存在同源生成偏置的风险;LLM 验证后人工复核仍发现 4.9% 错误,残余噪声规模未量化;(3) Restricted 模式随机采 20 个候选工具,与真实部署中候选来源不一致,95.2% 的 TA 可能高估了真实场景的工具选择难度;(4) 专有模型回答率差异巨大(Claude 仅 73.5%),安全对齐对分数的干扰难以与能力分离;(5) 3,504 对训练集仅覆盖 962 个工具,对评测集中其余约 680 个工具的泛化未单独分析;(6) 基准公开后训练集可能污染未来模型的预训练语料,需要持续换题机制。
独立分析的弱点
弱点一:静态解析无法感知执行语义——语法正确但目标主机不存在、权限不足的命令照样得分,改进方向是分层验证:解析判分为主,抽样沙箱执行复核。弱点二:别名等价表完全依赖官方文档,文档未收录的等价形式(如引号转义差异)会被判错,改进方向是用 shell AST 级解析加执行等价性判定扩充等价类。弱点三:合成查询多为"用工具 X 做操作 Y"的规整句式,真实红队/应急响应的查询更跳跃、更含噪——Messy 变体使 U 模式掉 3.20 分已暴露脆弱性,改进方向是用真实 CTF write-up 和红队报告构造查询。弱点四:奖励基于与单一真值的组件匹配,但许多命令存在多个合理答案(论文给出的 sudo 例子就列出多种等价命令),RL 会惩罚合理变体,改进方向是多参考奖励或执行等价奖励。弱点五:单轮、无反馈设定与实际 agentic 使用(执行→观察 stderr→修正)差距大,无法评估模型利用执行输出自我纠错的能力。
未来方向
作者提出的方向:扩展到多步工作流与错误恢复;引入检索增强的工具使用(评测时用 RAG 提供文档而非全部塞入 prompt);环境感知评测。基于成果可延伸的方向:(1) 把免运行时的结构奖励与执行反馈奖励结合,做双层 RLVR,先学会写对命令、再学会根据输出修正;(2) 利用 23 维能力标注做课程学习或能力条件化生成,针对 802-11、wireless 等低分维度定向增强;(3) 把数据管线迁移到其他 CLI 密集域(云厂商 CLI、数据库 shell、DevOps 工具链),验证方法通用性;(4) 针对 Messy/Informal 查询做数据增强与鲁棒训练,弥合评测与真实用户输入的分布差;(5) 专门研究安全对齐策略与任务能力的关系(Claude 覆盖率仅 73.5% 的现象);(6) 把 KaliBench 风格的确定性奖励推广到多轮 shell 交互的轨迹级 RL。
复现评估
开源情况:论文提供项目页与 GitHub 仓库,数据集与评测代码计划随论文发布;真值命令经过沙箱验证、评分是确定性函数,复现主表只需下载权重 + vLLM。算力需求:开源模型评测在 NVIDIA A100 多卡集群(vLLM),≥72B 模型走 OpenRouter API;训练门槛很低——LoRA + Unsloth 在单张 H200(141GB)上 batch 32 训 2 个 epochs 即可复现 RedSage-K 三个变体。难度评估:复现评测(容易):shlex 解析 + 组件打分逻辑清晰;复现数据管线(中等):需要 Qwen3-Max API、kali-linux-everything Docker 镜像,人工复核环节是主要人力成本且难以完全一致;复现训练(容易):10,512 样本、LoRA、单卡即可。风险点:若 prompt 模板或别名解析规则未完整开源,细节数字可能对不齐;GPT-5.6-Sol/Claude Opus 5 等专有模型结果受 API 版本与安全策略影响,难以精确复现。
论文图表
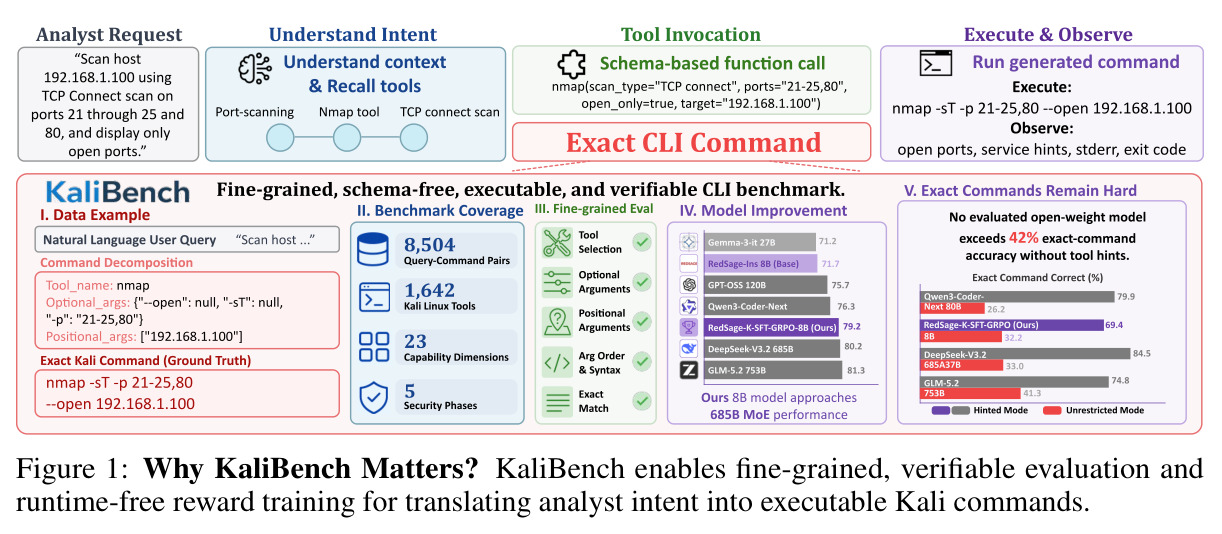
全景导读图:以 nmap 为例展示从分析师自然语言查询("扫描主机 192.168.1.100 的 21-25、80 端口,仅显示开放端口")到精确命令(nmap -sT -p 21-25,80 --open 192.168.1.100)的完整链路:理解意图→召回工具→构造结构化调用→执行观察。下方给出四个关键板块:数据示例、基准覆盖(8,504 对 / 1,642 工具 / 23 维度 / 5 阶段)、细粒度评测、模型改进,以及核心结论——无工具提示时没有开源模型超过 42% 精确命令准确率,微调后 8B 模型(79.2)逼近 685B MoE(80.2)。
一图看懂论文的动机、任务形式、评测思路与头条结论,是进入论文其他部分的最佳入口。