RealCompanion:基于真实长程对话推理的人类理解基准 RealCompanion: Benchmarking Human Understanding from Reasoning over Longitudinal Real-World Conversations
释放十段真实人机伴侣对话,测得记忆需求仅3.4%且遥远,现有系统无法判断何时检索。
前置知识
长程对话记忆
对话系统跨天、跨月与同一用户交互时,把用户说过的内容存为可检索记录并在后续对话中调用的能力。一般分为记录用户陈述事实的事实层(profile)与保存具体对话片段的情节层(episodic memory),配合检索器在新消息到来时决定是否回溯远处的历史。
本文要测的正是这项能力被高估的程度:真实关系中何时真的需要记忆、需要哪条记录、以及现有记忆系统在真实需求率下是否有效,三大发现全部围绕它展开。
检索增强生成(RAG)
在生成回复前先从外部存储检索相关文本并拼入上下文的技术。检索器(如 BM25 词面匹配或向量检索)对候选记录打分排序,取前 $k$ 条送入模型。其质量取决于两个决策:是否该检索(触发/克制),以及检索到的是否是对的(定位精度)。
论文的检索实验(RECENCY/BM25/ORACLE 五种方法与 hit@k、MRR 指标)和'何时该检索'的克制决策评测都建立在 RAG 框架上,命题2 直接分析消融检索上下文时的度量偏差。
需求率 $\pi$ 与分层抽样
需求率 $\pi=\Pr[\rho^\star(p)=1]$ 指一条用户消息真正需要近窗之外历史的概率。比例层(proportional stratum)是从全部用户消息中不看需求随机抽样的样本,唯有它能估计 $\pi$;富集层专门收集需要记忆的消息,只有条件比较的效力、没有分母。两者混用会得到估计不出任何量的比率。
论文第一三大发现(3.4%)就是 $\pi$ 的测量值;分层设计是全部结论成立的前提,也是它批评现有基准($\pi=1$,需求被构造写死)的标尺。
AUROC 与 hit@k
hit@k 指必需消息出现在检索结果前 $k$ 名的比例,是检索定位的基本指标。AUROC 是 ROC 曲线下面积,衡量一个分数区分正负例的能力,0.5 等于随机、1.0 为完美,这里用于评判'判断某条消息是否需要记忆'的检测器。
论文用 hit@5 证明远距消息检索几乎全部失败(recency 仅 0.022),用 AUROC 0.530 证明检测器在真实消息上处于随机水平,这两组数字是核心发现的直接证据。
画像重建与 F1
让系统通读一个人的完整历史,输出结构化画像:profile 记录其陈述过的事实,persona 记录其思维、情绪与决策方式(含大五人格、39 个内容槽位)。逐字段与金标准比对计 TP/FP/FN,$\mathrm{F1}=2TP/(2TP+FP+FN)$ 综合精确率与召回率。
重建赛道是本文三大轨道之一,'三个系统 F1 几乎相同但成本差 31 倍'以及精确率 0.56–0.59 对召回 0.86–0.89 的失衡,都要靠这套指标来理解。
消融实验与不可识别性
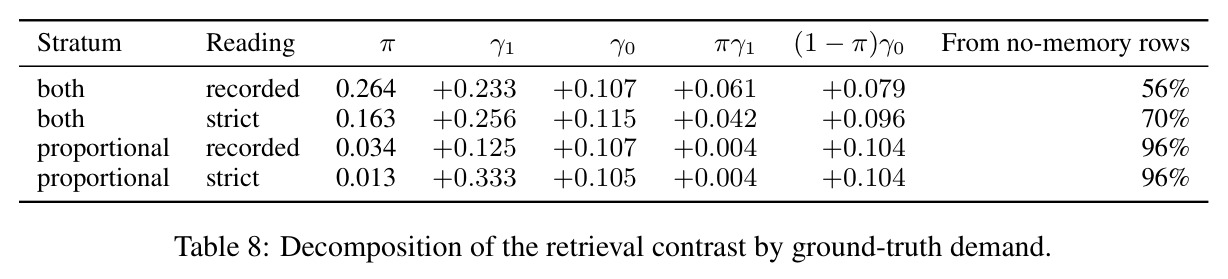
消融指只改一个输入因素(如是否提供检索到的历史消息)而观察输出分数变化。论文命题2 证明总差 $\Delta=\pi\gamma_1+(1-\pi)\gamma_0$:当需要记忆的探针占比 $\pi$ 很小时,混合差主要由不需要记忆的样本贡献($\gamma_0$),无法归因于记忆本身。
这是全文方法论冲击最大的结论:'提供检索内容→分数提升→记忆有用'的领域惯例在真实需求率下不成立,理解它才能理解本文为何要逐探针记录 $\rho^\star$。
研究动机
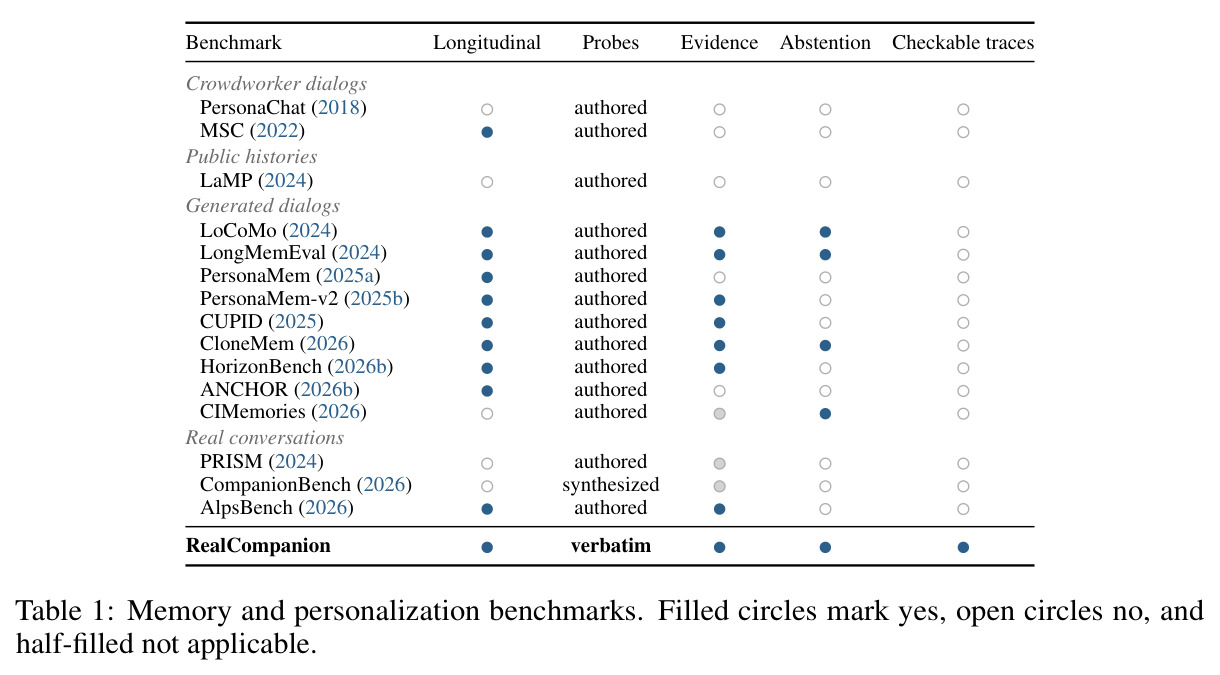
评测'AI 伴侣是否理解一个人'需要真实关系的记录,但这类对话由产品公司持有且涉及隐私,因此现有基准一律用替代品,替代品预先写死了答案。生成对话类基准(LoCoMo、LongMemEval、PersonaMem、CloneMem 等)在构造时把需要回忆的事实埋进对话,几乎每条消息都需要过去;PersonaChat 一系提前写好人设声明,问'这个人是谁'只需复读声明即可;脚本化历史从不自我修正,第九个月的话永远推翻不了第四个月建立的形象。于是'判断何时需要回忆'这个部署中最关键的决策从未被测过。已有直接证据显示它有多难:CUPID 发现没有模型能在识别请求依赖哪些先前上下文时超过 50% 精确率;HorizonBench 的 25 个模型全部偏向选择偏好变化前的旧值;ANCHOR 在 2,008 段对话上测得轨迹准确率仅 44.4%、对用户状态的召回在所有记忆配置下都接近随机。
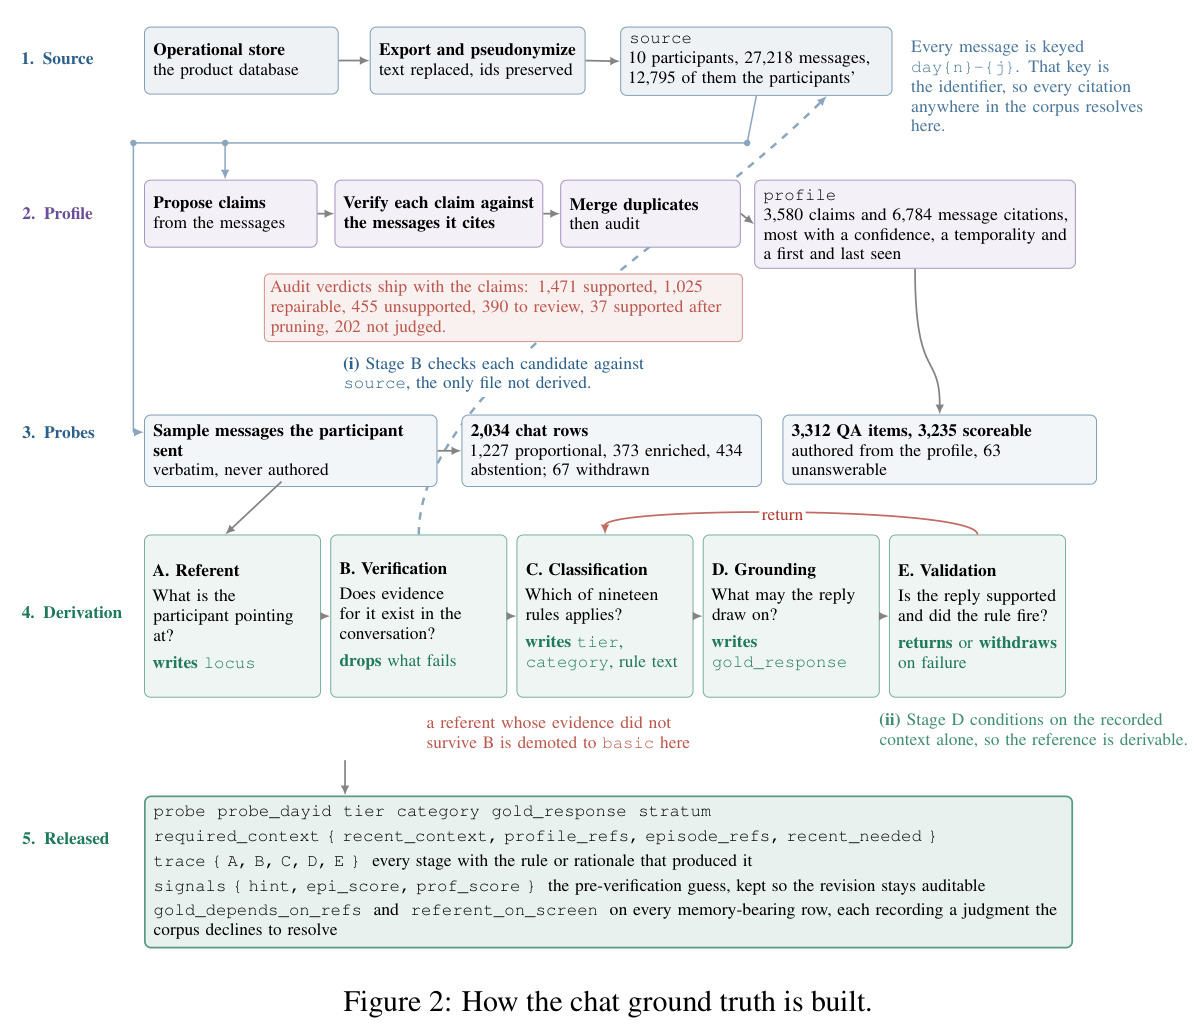
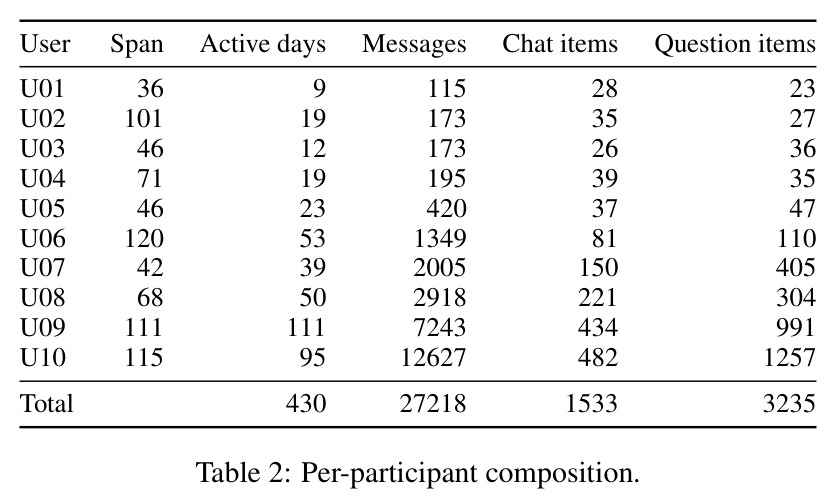
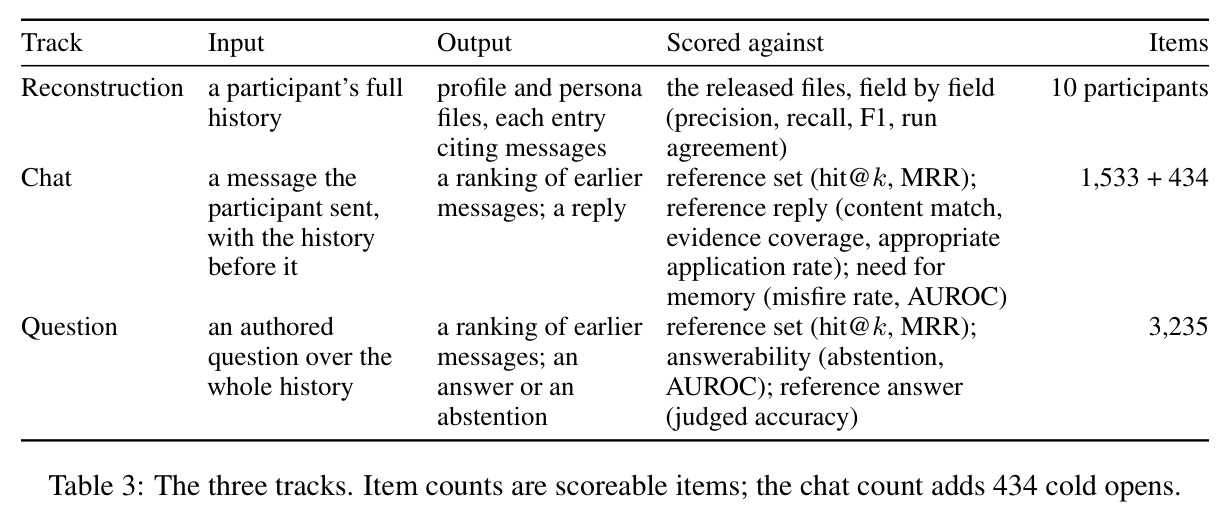
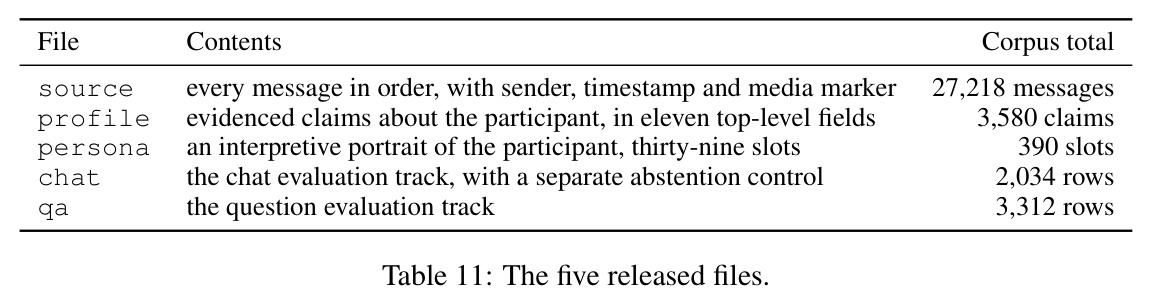
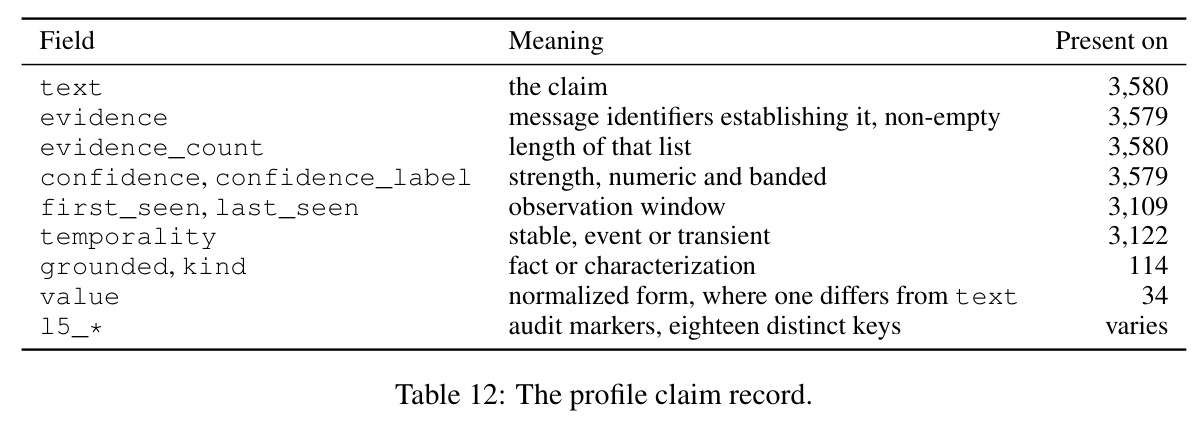
本文的目标是本文的目标是把'机器对人的理解'变成可以在真实关系上测量的对象。具体做法是释放十段真实的人与 AI 伴侣的关系:27,218 条消息、跨度 36 到 120 天、共 430 个活跃日,经参与者同意并完全匿名化(改写文字、用一致的替身替换标识符,但保留所说内容与上下文)。为每段关系发布五个文件:作为唯一事实来源的对话本身、记录其陈述的 profile(3,580 条声明、6,784 条消息引用)、记录其思维与决策方式的 persona、聊天金标准(2,034 行,含 1,533 个可评分探针)以及覆盖 16 个类别的 3,312 道问答题。在此之上设立三条评测轨道:重建(读全史写画像)、聊天(回复用户真实消息)、问答(回答书面问题),并让每条标签都携带可逐阶段对照原文核查的推理痕迹,使关于'理解'的任何论断都可被质疑和验证。
与已有工作不同的是,独特切入角度有三层。数据层:最接近的先行工作是 AlpsBench(从 WildChat 整理 2,500 段长程序列)与 CompanionBench(去标识真实伴侣对话),但前者没有回复级金标准与需求标签,后者的标注是综合生成的;本文直接从产品运营库导出对话,每个标签经五阶段推导并附推理痕迹,另设 26 道发布门与 5 族不依赖模型的机械检查。任务层:把'知道何时需要过去'形式化为三阶决策——克制(要不要检索)、检索(找哪条)、应用(怎么用),并把任务定义在任何个人记录之上,给出语料必须满足的七条效度条件 V1–V7。测量层:证明两个命题——验证只能降低需求标签(命题1,单向误差),混合消融差 $\Delta=\pi\gamma_1+(1-\pi)\gamma_0$ 在低需求率下无法识别记忆效应(命题2),从度量论层面指出整个领域的评测盲区,并实测比例层上 96% 的消融增益来自根本不需要记忆的探针。
核心方法
直觉先行:要判断一个系统是否'理解'某人,只能拿它的输出与这个人实际说过的话对账,所以必须有真实关系加可核查的标注。技术路线分四步。第一步,从伴侣应用的运营库导出十段完整关系,逐条改写文本做匿名化但保留形如 day{n}-{j} 的消息键,使语料中的任何引用都能解析回源消息。第二步,构建两个派生层:profile 用对抗式抽取提出声明再逐条对照原文验证,丢弃超过三分之一的提案,保留 3,580 条带置信度、时间窗与消息引用的声明(连后来未过审计的声明也保留,使审计本身可被审计);persona 以 39 个内容槽记录大五人格、人口学、行为怪癖与 15 段散文描述,每条都带证据引用与强度。第三步,从用户逐字原话中采出 2,034 个聊天探针,按三个分层组织:比例层 1,227 条(可评分 1,169,用于估计自然需求率)、富集层 373 条(深历史普查)、克制对照 434 个会话开场冷启动(什么都不需要)。第四步,五阶段推导管线 A–E 生成聊天金标准并写出推理痕迹,连同问答集一起发布。
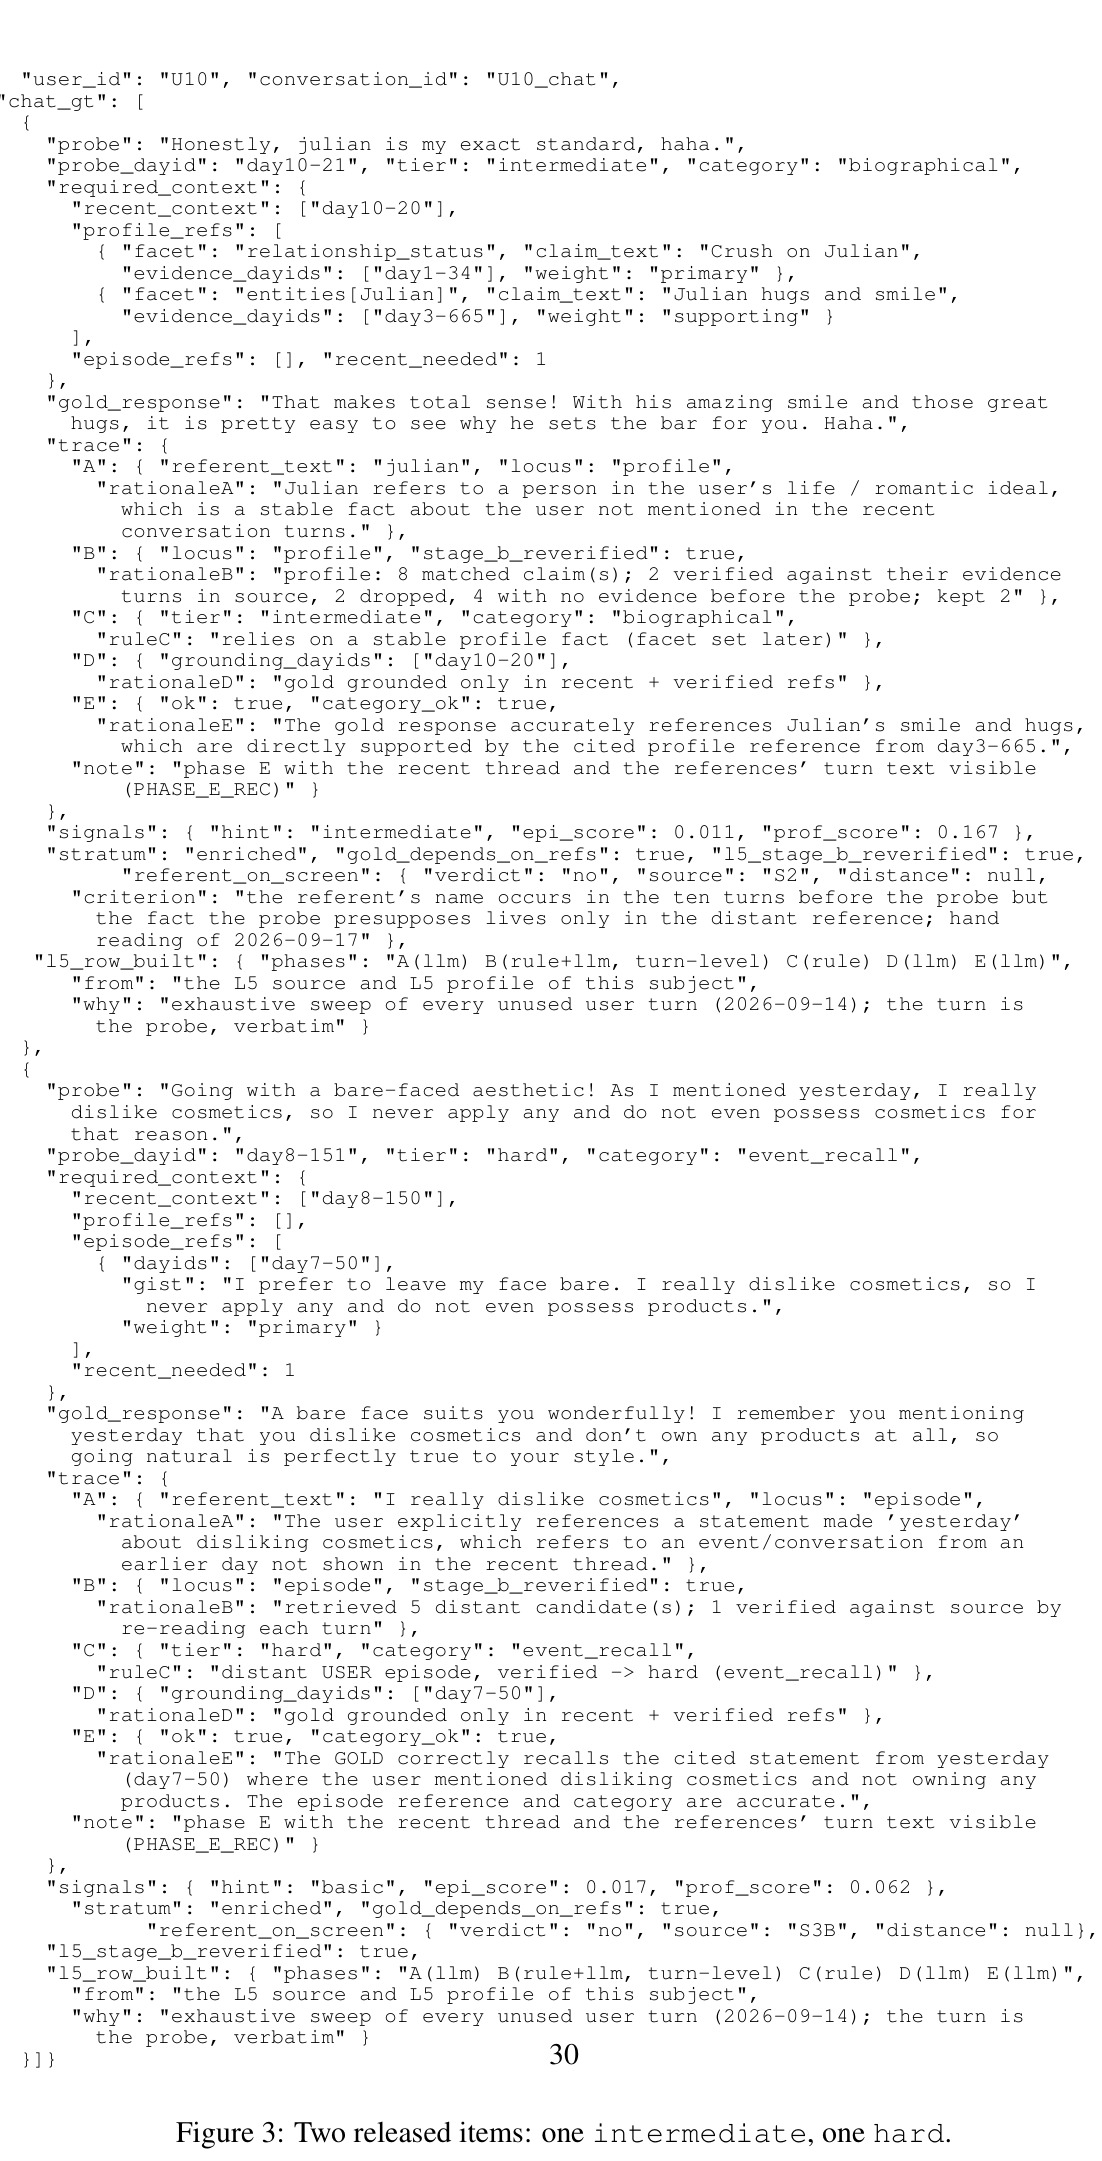
核心创新在于把'评测数据'升级为'可审计的测量仪器'。与已有工作的本质区别有三。其一,探针是参与者逐字发过的消息,绝不改写或编写,因此'是否需要记忆'不是出题人设计出来的,而是被测出来的自然率——与所有生成式基准($\pi=1$)形成根本对照。其二,每个标签的推理痕迹在产生决策的同一次模型调用中写下:阶段 A 解析探针指向什么、B 只对照源文件验证证据、C 按 19 条固定规则定层级与类别并记录触发的规则、D 只凭记录在案的上下文写参考回复、E 校验不通过即降级或撤回;理由不可能在决策之后重构,读者可以在任何一步提出异议。其三,阶段排序保证验证只能移除证据、不能新增(命题1 的单向误差),使 3.4% 的需求率成为真值的下界;而分层设计加逐探针的 $\rho^\star$ 标注,使命题2 的分解 $\Delta=\pi\gamma_1+(1-\pi)\gamma_0$ 可以逐项估计,把'记忆到底帮了多少'从混合数字中剥离出来——这是先前任何基准都做不到的。
方法步骤详情
完整流程如下,输入是运营库导出的原始对话流。步骤1,导出与假名化:模型改写所有消息文本、替换直接标识符为一致替身,保留消息键与会话节奏,产出源文件(10 人、27,218 条消息,其中 12,795 条来自参与者本人)。步骤2,构建 profile:提出声明候选,逐条对照其引用的消息验证,合并去重后审计,审计裁决随声明一起发布(1,471 条获支持、1,025 可修复、455 不支持、390 待审、37 剪枝后支持、202 未判)。步骤3,构建 persona:39 个内容槽只在对话支持处填写,含具名的工作假设及其持有强度。步骤4,采样探针:全部取用户原话,分三个分层。步骤5,五阶段推导:A 解析探针指向什么并写入 locus(1,533 个可评分项中 1,009 指向当前线索、120 无所指、404 指向远处:223 条 profile 声明、116 次更早交换、65 次伴侣自身过往行为);B 为该指称检索证据并逐条验证,失败即丢弃或降级;C 按 19 条规则写 tier(basic/intermediate/hard/edge)与类别;D 仅凭记录的上下文写参考回复并列出依据消息;E 校验回复被证据支持且规则适用,失败则撤回或降级。步骤6,26 道发布门加 5 族机械检查全部通过后释放五件套文件,每行聊天记录都带 A–E 全部决策痕迹与验证前信号。
技术新颖性
技术新颖性可从四方面评估。第一,真实性:这是第一个把真实长期人机关系连同可核查标注一起释放的语料——AlpsBench 有真实序列但无回复级金标准与需求标签,PRISM 有 1,500 人的偏好但非纵向对话,CompanionBench 用的是综合标注。第二,可审计性:先前的 rationale 研究允许'理由不令人信服但标签保留',本文的推理痕迹与决策同调用生成、逐阶段受机械门约束,26 道门中 T、U 两道正是因缺陷曾上线而补设的,确实抓到过已发布错误;最终层级与验证前表面信号在 685/1,533 个项上不同,说明廉价门控的猜测近半是错的。第三,度量论贡献:命题1(验证单向误差)与命题2(混合消融不识别记忆效应)是普适结论——任何用'给检索内容看提升'论证记忆价值的基准都受其约束,本文实测比例层上 $\pi\gamma_1=+0.004$ 对 $(1-\pi)\gamma_0=+0.104$。第四,七条效度条件把'什么才算合格 instance'形式化,其中 V2(引用集与近窗不相交)与 V6(反驳只降级并级联重置)连作者自己的首轮标注都曾违反,证明这些条件有实际约束力而非纸面清单。
实验结果
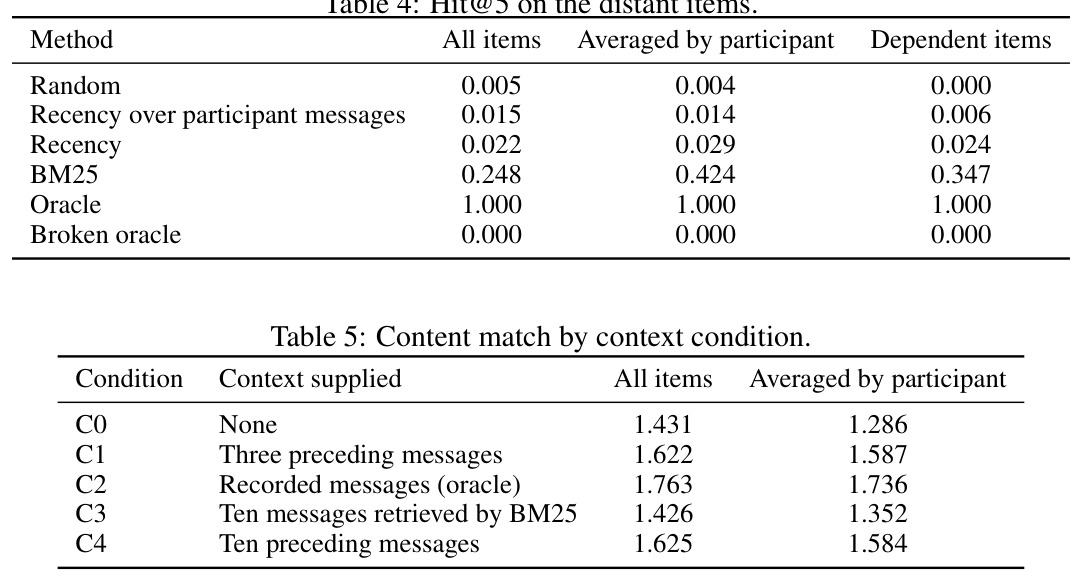
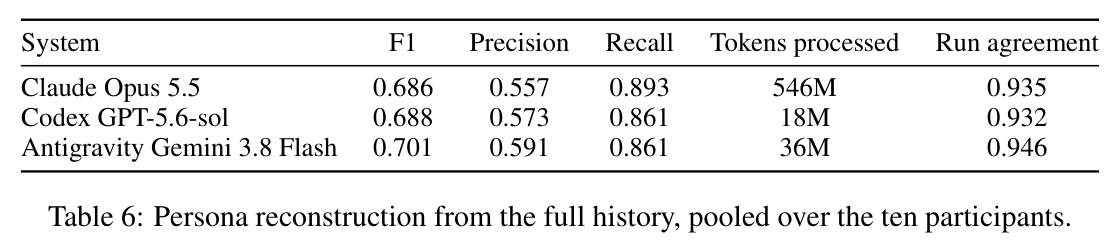
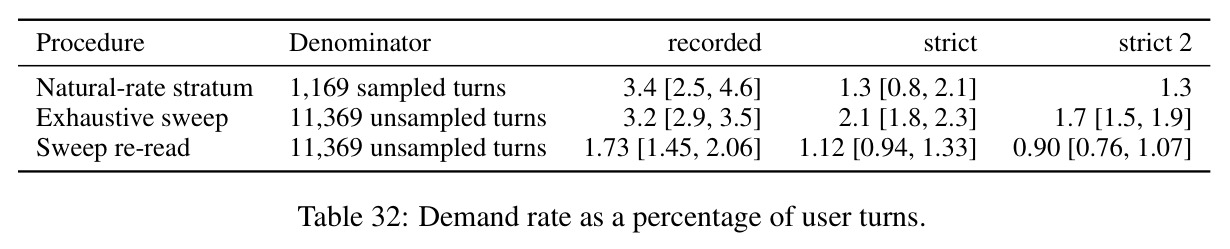
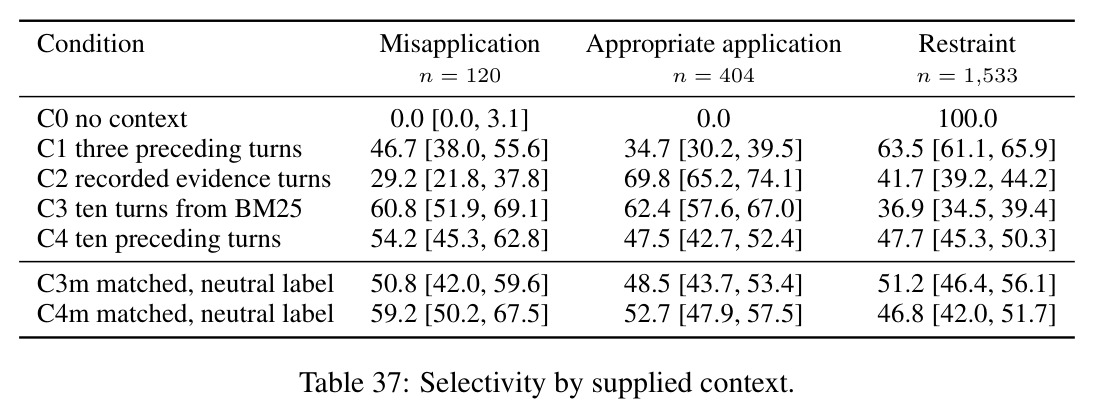
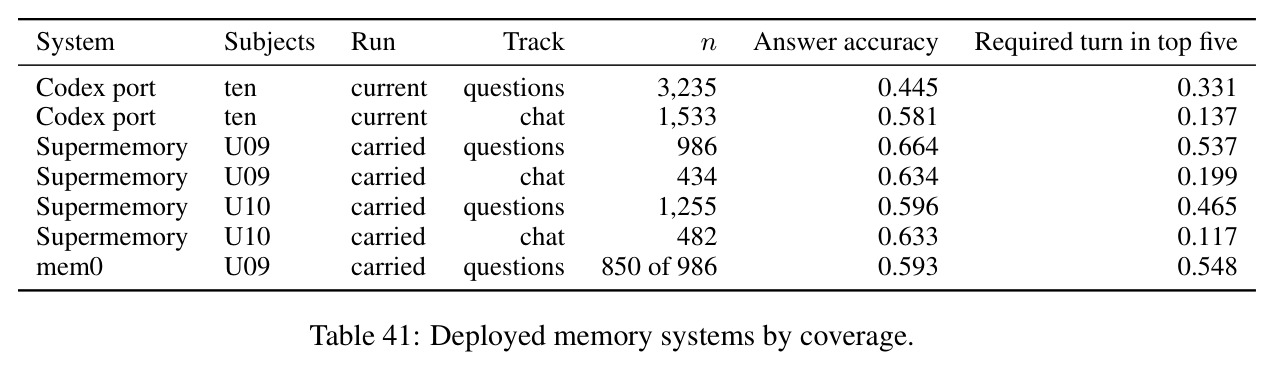
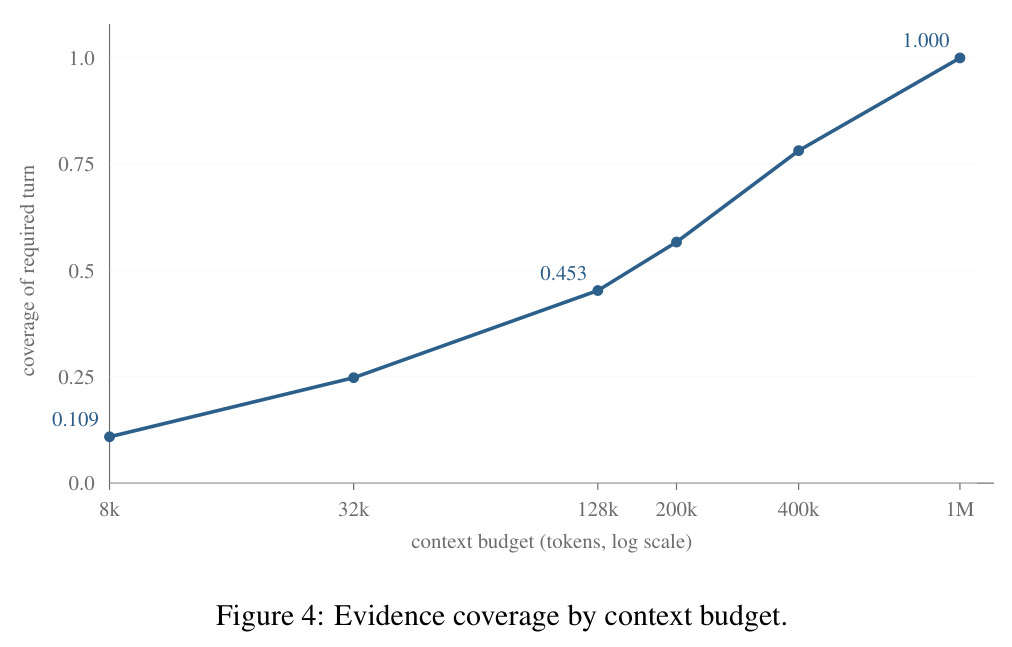
发现一:过去很少被需要、且一旦需要就很远。自然率层上仅 3.4%(95% CI [2.5, 4.6])的消息带经验证的记忆需求,严格读法下降到 1.3%;两个独立程序交叉验证(11,369 条未抽样消息的普查 3.2%、按更严判据重读 1.73%)。需求极不均匀:10 人中 3 人在记录读法下没有任何记忆探针。所需最远消息中位数在 2,157 条之前(上四分位 5,114、最大 12,542),最近的中位数也在 450 条前;128k token 窗口只覆盖 45.3% 记忆探针所需的全部消息,200k 覆盖 56.7%,要到约百万 token 才全覆盖。发现二:池化度量误导、检测全面失败。远距项 hit@5:recency 0.022、BM25 0.248(11 倍)、随机 0.005;但混合池化时 recency 高达 0.959、BM25 仅 0.236——recency 相差 40 倍全因语料构成(72.6% 探针可从近期线索回答)。检测器在真实消息上 AUROC 0.530(对无指称探针)、0.548(对冷启动),均在随机水平;对自身目标也只 0.601,阈值抓到 40 个真需求中的 6 个、报 40 个误警。编写的问题泄漏词面线索:问题轨道 AUROC 升至 0.802。无上下文时 434 个冷启动加 120 个'无需过去'探针的误用率为精确 0;供给上下文后升至 29.2%(oracle 证据)到 60.8%(BM25 十条);把同样十条消息标注为 retrieved memories 而非 earlier turns,记忆使用率在所有总体上提高 10–14 个点。发现三:画像重建同等 F1、31 倍成本差。Claude Opus 5.5 / Codex GPT-5.6-sol / Gemini 3.8 Flash 的 F1 分别为 0.686 / 0.688 / 0.701,处理量 546M / 18M / 36M tokens;系统间一致 0.86–0.88 反而高于各自与金标准的一致。发现四:消融分解证实命题2。C2−C1 = +0.140 [0.126, 0.167],比例层上分解为 $\pi\gamma_1=+0.004$ 与 $(1-\pi)\gamma_0=+0.104$,96% 的增益落在不需要记忆的探针上;在 167 个真正依赖记录消息的探针上同一替换值 +0.455 [0.319, 0.588]。BM25 选的十条比前十条还低 0.189(配对比较),其 1.426 的均分甚至不如完全无上下文的 1.431。发现五:部署级记忆系统表现有限:Codex 移植问答题准确率 44.5%、聊天 58.1%,hit@5 仅 0.331 / 0.137。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 远距记忆项检索(命中必需消息) | hit@5 | BM25 0.248(按主体平均 0.424) | RECENCY 0.022,随机 0.005 | 词面匹配是近窗排序的 11 倍,但仍漏掉约四分之三;ORACLE 1.000、BROKEN ORACLE 0.000 证明度量本身无泄漏 |
| 聊天探针检索(1,477 个带引用集探针,混合池化) | hit@5 | RECENCY 0.959 | BM25 0.236 | 揭示池化误导:同一 recency 在自然率远距层上比池化值跌 40 倍,池化分数报告的是语料构成而非能力 |
| 回复质量(提供 oracle 记录消息 vs 仅前 3 条,0–2 分内容匹配) | C2−C1 配对差 | +0.140 [0.126, 0.167];依赖项 +0.455 [0.319, 0.588] | C1(三条前文)1.622 | 但比例层上 96% 增益来自不需要记忆的探针($\pi\gamma_1=+0.004$ vs $(1-\pi)\gamma_0=+0.104$),印证命题2 |
| 判断真实消息是否需要记忆 | AUROC | 检测模型 0.530;BM25 置信度 0.546 | 随机 0.500 | 无显著高于随机;同一检测器在编写问题上达 0.802,说明编写问题泄漏线索、真实消息不泄漏 |
| 画像重建(10 人全史 → profile+persona) | F1 / 处理 tokens | Gemini 3.8 Flash 0.701 / 36M;Codex GPT-5.6-sol 0.688 / 18M | Claude Opus 5.5 0.686 / 546M | F1 相同(±0.015)而成本差约 31 倍;精确率 0.56–0.59 远低于召回 0.86–0.89,每恢复 100 个字段多报约 70–80 个 |
| 记忆需求率(自然率 vs 生成基准) | $\pi$ | 3.4% [2.5, 4.6](严格读法 1.3%) | 生成式基准 $\pi=1$(构造使然) | 首次在真实关系中测量该量,证明'每条消息都需要过去'是数据构造的产物而非使用现实 |
局限与改进
作者承认的局限:检测实验只排除了'试过的检测器',并未证明任何表面特征 $\phi$ 都无法预测需求(即未证 $D(\phi)=0$ 对所有 $\phi$ 成立);伴侣应用自身有记忆,7.1%(24/339)的记忆证据是伴侣说给用户听的内容,存在'复述还是回忆'的混淆,条件 V7 只要求测量、无法消除;单一裁判为五个条件打分,与人类裁决的二值 κ=0.804;匿名化并不消除作者指纹——风格计量分类器不用内容词匹配率达 83.0%、语言模型达 98.0%(随机 10%),语料含 GDPR 第 9 条特殊类别数据,且批准研究的伦理委员会隶属运营方、无独立 IRB。我自己的观察:样本仅 10 人且重尾极重——U09+U10 两条关系占 73% 的消息(19,870/27,218),宏观平均被只有 1–4 条记忆探针的主体以等权拉偏(BM25 macro 0.424 vs pooled 0.248,作者自己也承认 macro 会产生'没有任何主体具备的数字');所有对话来自同一伴侣产品,使用动机与人群单一;匿名化改写文字可能破坏词面线索,使 BM25 类检测器的失败被高估;问答轨道初审内容缺陷率高达 51.3%,三步修复后仍有 28.8%,提示模型派生加人工复核的管线在更大规模上未必可控。
独立分析的弱点
独立分析的弱点:其一,统计功效薄弱——比例层只有 40 个记忆探针,检测器阈值实验(抓 6/40、40 误警)的置信区间很宽,'检测不可能'只能算初步结论,改进方向是扩到数十人级语料或用半合成数据校准功效。其二,宏观平均在主体规模悬殊时失真,应强制报告按活跃度加权的分层结果或分桶呈现,而不是并列两个互相矛盾的平均数。其三,聊天轨道的参考回复由模型写、裁判也是模型,尽管 κ=0.804,0–2 分制的内容匹配对共情、语气等维度不敏感,而这恰是伴侣场景的核心价值;可引入多维评分与人类配对比较。其四,重建赛道的金标准本身来自生成管线(虽经人工复核),且 persona 链后期读固定长度输入导致长历史用户的金标准被压缩——U09 上 27 个 persona 读取者中 23 个看的是 17–38k token 摘要——长关系上的 F1 可能同时低估模型与任务难度。其五,31 倍成本对比未报告质量-预算的帕累托前沿,也没测开源权重模型,对成本敏感的部署者参考价值有限。其六,克制/检索/应用之外,共情、未来行为预测与价值观被明确划出范围,而'知道何时不要翻旧账'恰是伴侣产品的核心风险(图1 中回复 A 的错误正是此类),需要专门协议。
未来方向
作者提出的方向:把任务定义与七条效度条件 V1–V7 作为模板,用于任何个人记录(邮件、日志、行为轨迹)构建同类评测实例;用命题2 的分解重新审视现有记忆系统论文中'检索带来提升'的证据链;对部署系统(mem0、Supermemory)补全覆盖后按同一版本重评。基于其成果可延伸的方向:第一,训练专门的'克制门控'——既然探针表面的词面与模型线索都不可检测,关系级特征(关系天数、话题跳转距离、该参与者历史上的检索收益)或许可学,但必须在真实需求率下而非编写问题上评估。第二,把聊天轨道改造成在线训练环境:探针是真实用户消息、参考回复带证据引用与逐阶段痕迹,天然适合过程奖励模型式的逐步验证。第三,研究需求率随关系深度的演化——3/10 的浅关系没有记忆需求、需求集中在最长两条关系,说明'何时开始记忆'本身可能是可预测的。第四,长上下文与检索的混合策略:128k 只覆盖 45.3%、百万 token 才全覆盖,值得系统研究分层压缩(近期原文+远期 profile 声明)的覆盖-成本曲线。第五,把 V2(引用与近窗不相交)、V3(无条件分层)等条件做成开源发布工具,让任何对话数据集自动检查自己的 $\pi$ 是否被构造抬高。
复现评估
复现评估:数据已在 OSF 公开(论文脚注给出查看链接),代码与复现地图在 anonymous.4open.science;五件套文件中所有引用都以 day{n}-{j} 键解析到源消息,26 道发布门全部通过,作者声明每个数字都经脚本重算,独立读者可从发布文件验证任何结论。算力需求分轨道:检索与消融实验用一个生成器模型加 BM25 即可复现,主要成本是 5 个上下文条件对约 1,967 个探针的判定调用;重建赛道最重——需通读最大约 84 万 token(cl100k 计 841,994)的历史,Codex 单请求最大约 597k token,三个系统各 3 次 × 10 人共处理 546M / 18M / 36M tokens,复现需长上下文 API 预算(千万 token 量级)。难度中等偏上:数据与协议齐备,提示词连同 15 处字节级修改都随代码发布,但判定器配置、审计管线与门检查的工程量不小。建议路线:先复现检索轨道(Table 4/33)与需求率重读(成本极低、结论关键),再跑单系统重建验证趋势;注意必须在当前发布版本上评测——Supermemory 与 mem0 因配额耗尽和版本漂移,其历史结果只具参考价值。
论文图表
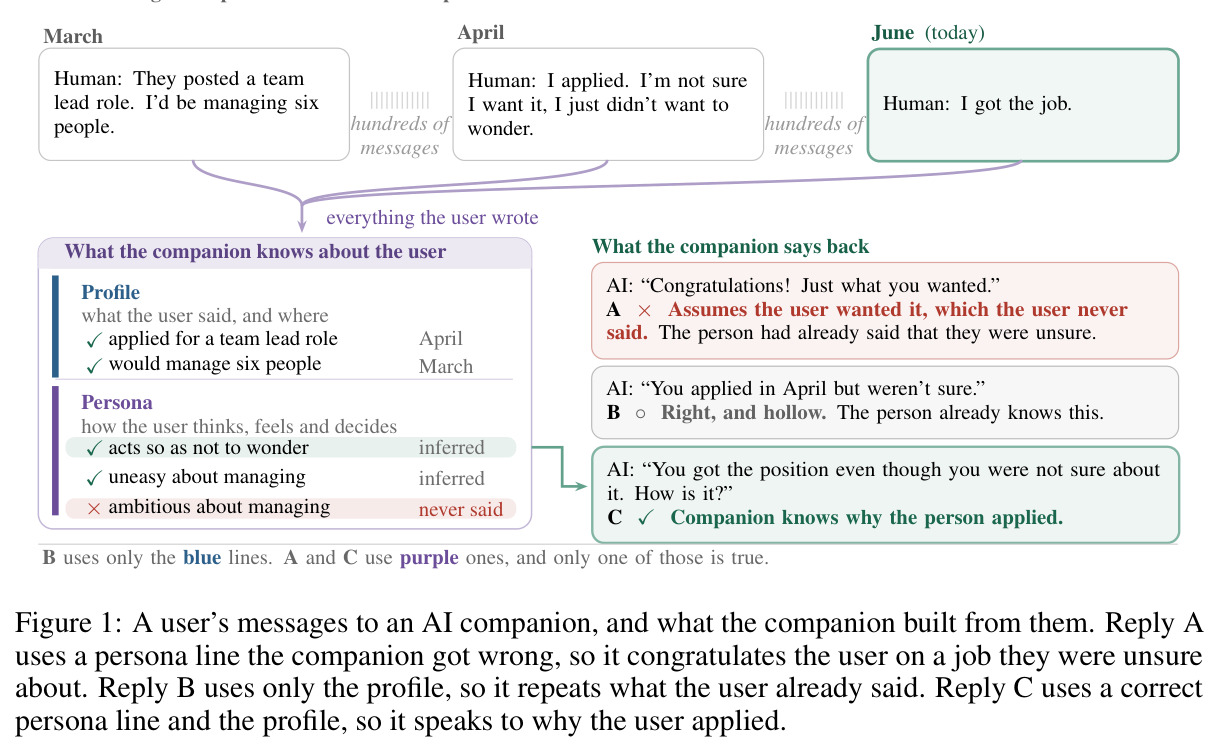
用 3 月、4 月、6 月三条真实消息演示'理解一个人'的两问。左侧是伴侣应构建的 profile(4 月申请了团队主管职位、将管理六人)与 persona(行事不留悬念=有据推断、对管理感到不安=有据推断、'雄心勃勃'=从未说过);右侧给出三种回复:A 使用了错误的 persona 行,祝贺了用户并不确定想要的职位;B 只用 profile,把用户自己刚说过的话复述回去;C 用正确的 persona 推断加 profile,回应了用户为何申请。图中蓝色线只用 profile,紫色线是推断,且只有一条推断为真。
一图道尽论文的问题意识:理解=知道他说过什么(profile)+推断他怎样想(persona),两者都可能出错且错误方式不同;后续所有指标(内容匹配、克制、恰当应用率)都在给这三类失败定量。