VIEScore2:带空间定位解释的统一图像评估器 VIEScore2: Unified Image Evaluation with Spatially Grounded Explanations
单一模型同时输出质量分数、16×16缺陷网格与可读解释,统一生成与编辑评估
前置知识
视觉语言模型(VLM)
VLM 是同时接受图像和文本输入的自回归大模型,把图像切成视觉 token 与文本 token 一起送入 Transformer,从而能“看图说话”。本文用的骨干 Qwen3-VL-8B 是 80 亿参数的开源 VLM,图像会被缩放(生成图最长边 384²、条件图 256² 像素)后编码。关键性质是:只要把空间信息编码成文本(如格子坐标),它就能在单次生成中同时输出分数和位置,无需额外预测头。
VIEScore2 的全部输出(分数、16×16 缺陷格子、解释)都是 VLM 生成的文本,理解这一点才能明白为什么同一个模型能覆盖打分、定位、解释三种任务。
GRPO(组相对策略优化)
GRPO 是 DeepSeekMath 提出的强化学习算法:对每个输入采样一组(本文 4 个)回答,用奖励模型或规则给每个回答打分,在组内做标准化得到相对优势,再用裁剪的策略梯度更新模型。它不需要训练单独的价值网络,也不用 KL 惩罚(本文设为无),特别适合奖励可以由规则直接算出的“可验证”任务。
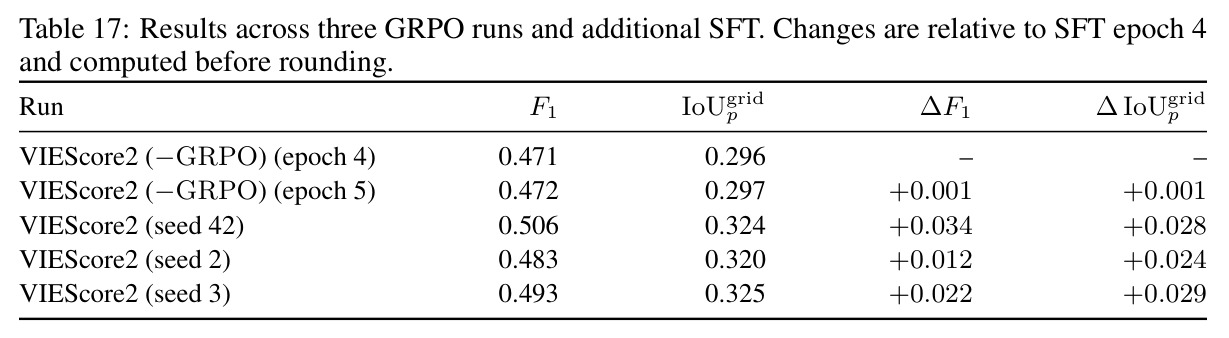
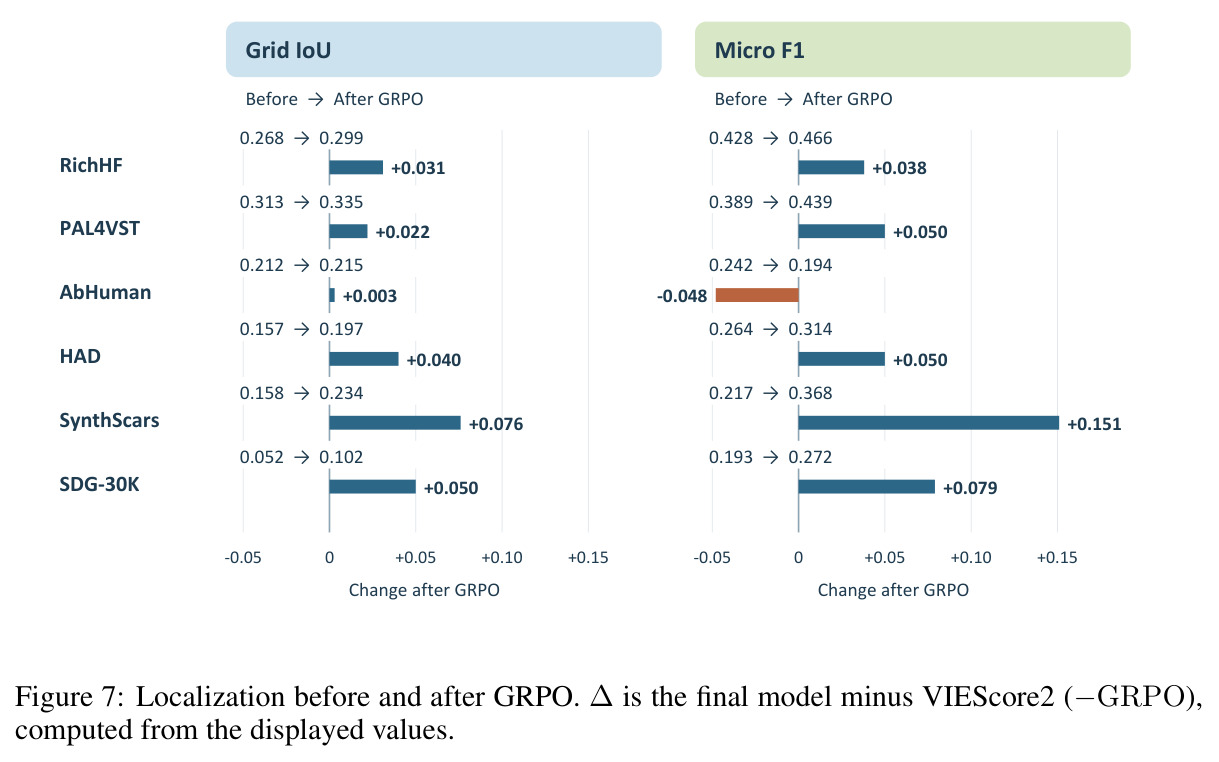
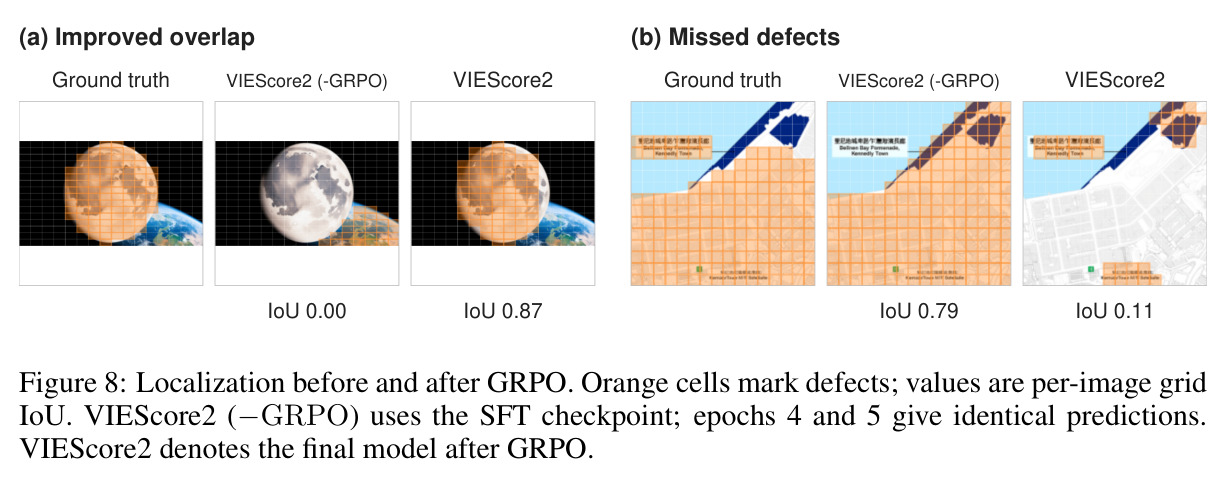
本文 SFT 之后的关键增益全部来自 GRPO:网格 IoU 提升 0.024–0.029,而多训一个 epoch 的 SFT 只提升 0.001。读懂奖励设计和组内相对比较才能理解论文的消融实验。
Dice 系数与 IoU
两者都衡量两个集合的重叠程度。IoU = |交集|/|并集|;Dice = 2|交集|/(|A|+|B|),当权重全为 1 时等价于 cell 级 F1。本文把医学分割的 Dice 目标(Milletari 等,V-Net)改造成强化学习奖励:对每个格子按标注覆盖度加权(有“!”标记的格子权重为 2),并用参数 $\beta$ 调节精确率-召回率权衡,$\beta=1$ 时即覆盖加权 Dice。
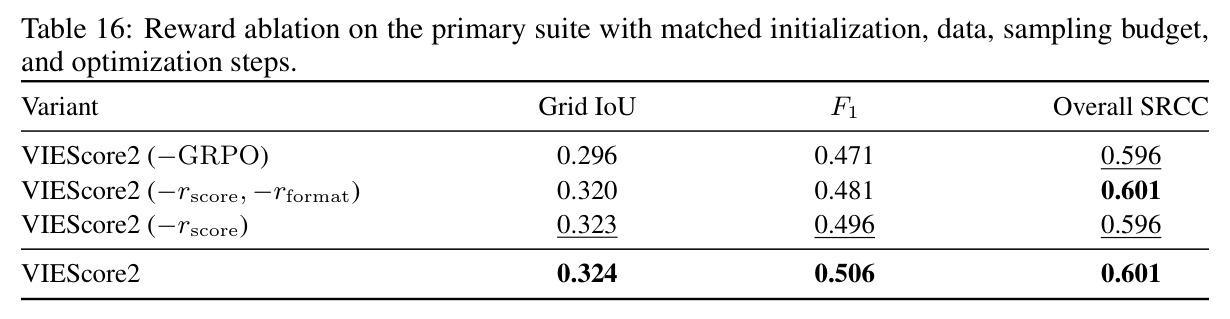
cell 级 Dice 奖励是本文 GRPO 增益的核心来源(仅用它就把 IoU 从 0.296 提到 0.320),评测中也用 per-image grid IoU 作为主要定位指标。
SRCC(Spearman 秩相关系数)
SRCC 衡量模型分数与人类评分在排序上的一致程度:把两列分数分别转成排名后计算皮尔逊相关,取值 -1 到 1。它只关心“谁比谁好”的相对顺序,不要求分数本身校准。评估图像质量模型时几乎都用它,因为人类评分的主观偏移不影响排名相关性。
论文的主评分指标就是 SRCC:VIEScore2 在主套件上 0.601 vs Gemini-3-Flash 0.491。没有这个概念就无法判断 0.601 意味着多大的评估质量差距。
SFT 与 LoRA
SFT(监督微调)用(输入,目标回答)对训练模型做最大似然,只对目标 token 计交叉熵损失。LoRA 是参数高效微调:冻结原权重,只训练注入每个线性层的低秩矩阵(本文 rank=32、缩放 16、作用于所有线性层),大幅省显存。本文 SFT 5 个 epoch,第 4 epoch 的 LoRA 权重并入主干后转全参数 GRPO,第 5 epoch 作为“额外 SFT”对照。
论文刻意用第 5 epoch 与 GRPO 对照,证明定位增益来自强化学习而非额外的数据暴露,这是理解 4.4 节消融的前提。
条件图像生成与编辑
指除了文本提示外还提供图像输入的合成任务:编辑任务给源图(要求局部修改),参考图生成给 1 张或多张参考图(要求保持主体/风格一致)。这带来额外评估维度——不仅要看画面质量,还要核对“该改的改了没、该留的留了没”。本文将条件图像按阅读顺序排在生成图像之前输入 VLM。
这是 VIEScore2 区别于 PAL、RAHF 等纯文生图评估器的核心能力:六类 ImagenWorld 任务(TIG/TIE/SRIG/SRIE/MRIG/MRIE)覆盖零到多个条件图像。
研究动机
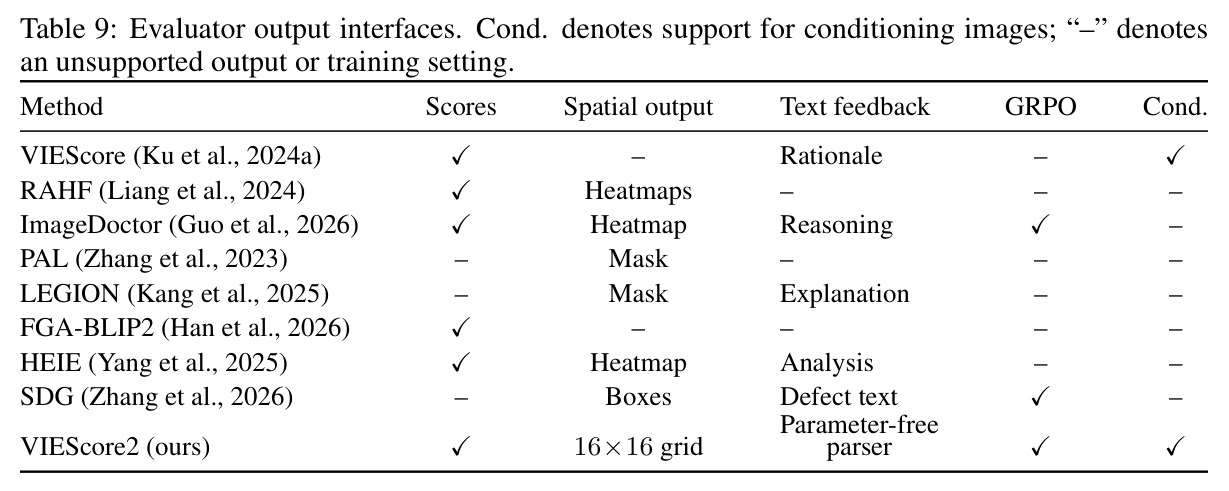
图像生成与编辑模型越来越逼真,但输出仍频繁出现局部失败:结构不合理、物体扭曲、视觉伪影、违背提示词等。人工排查这些缺陷成本高、难以规模化,自动评估器因此愈发重要。然而现有评估器普遍只给标量分数:CLIPScore、ImageReward 等无法解释分数来自图像哪些区域;VIEScore 让冻结 VLM 输出分数加自由文本解释,但解释与图像区域没有对齐,可能出现“凭空解释”;另一类空间方法能定位缺陷——PAL 输出像素级伪影掩码、RAHF 输出伪影与错位两张热图、ImageDoctor 输出热图、LEGION 输出掩码加解释、SDG 输出缺陷框——但它们几乎都面向纯文生图任务,依赖专用空间预测头,难以扩展到需要条件图像的编辑与多参考生成,也无法在同一个模型里同时给出分数、类别化缺陷位置和文本解释。评估器“打了分却指不出哪里有问题”成为核心痛点。
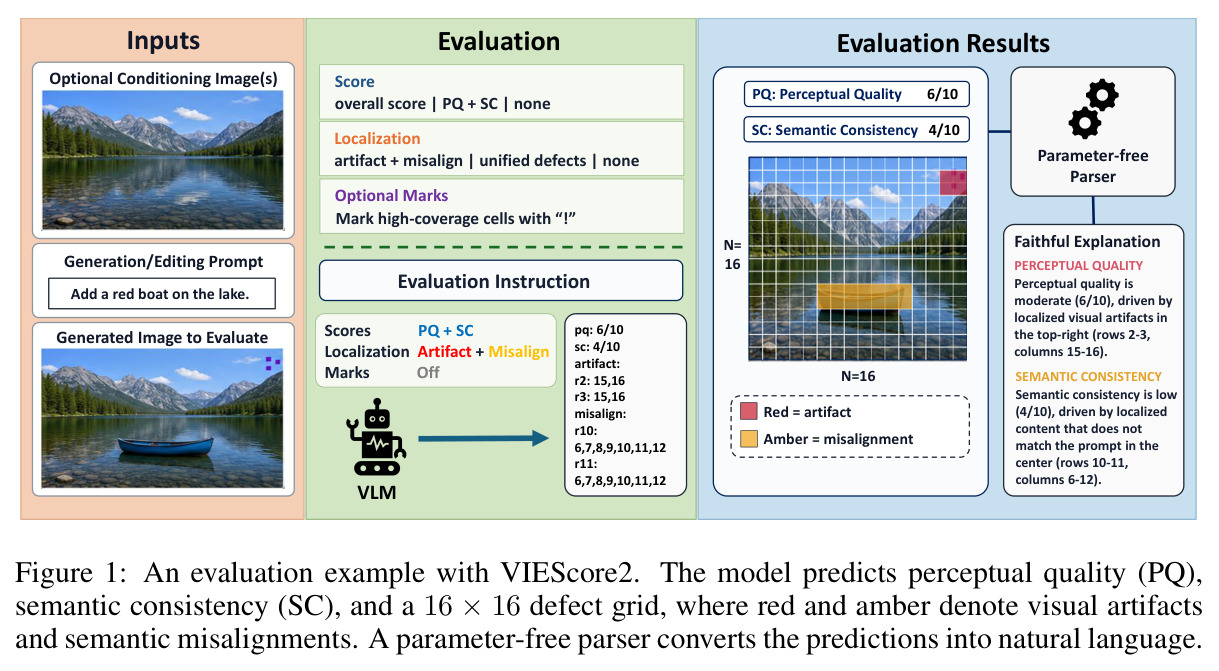
本文的目标是本文要构建统一评估器 VIEScore2:输入生成图像、生成/编辑提示词、零个/一个/多个条件图像(编辑源图或参考图)以及一条评估指令,在单次自回归推理中同时输出:(1) 质量分数——总体分,或感知质量 PQ 与语义一致性 SC 两项,均为 0–10 分;(2) 16×16 网格上的缺陷位置,可区分视觉伪影与语义错位两个类别;(3) 由无参数解析器转成的、与分数和网格严格对应的可读解释。同一套权重要覆盖仅打分、仅定位、联合评估三种模式且不需要任务专用预测头;在 38K 多源异构监督数据上训练后,要在生成与编辑、训练来源内外共六个定位基准和多类评分任务上超越同输入设置的通用 VLM,并与专用评估器竞争。
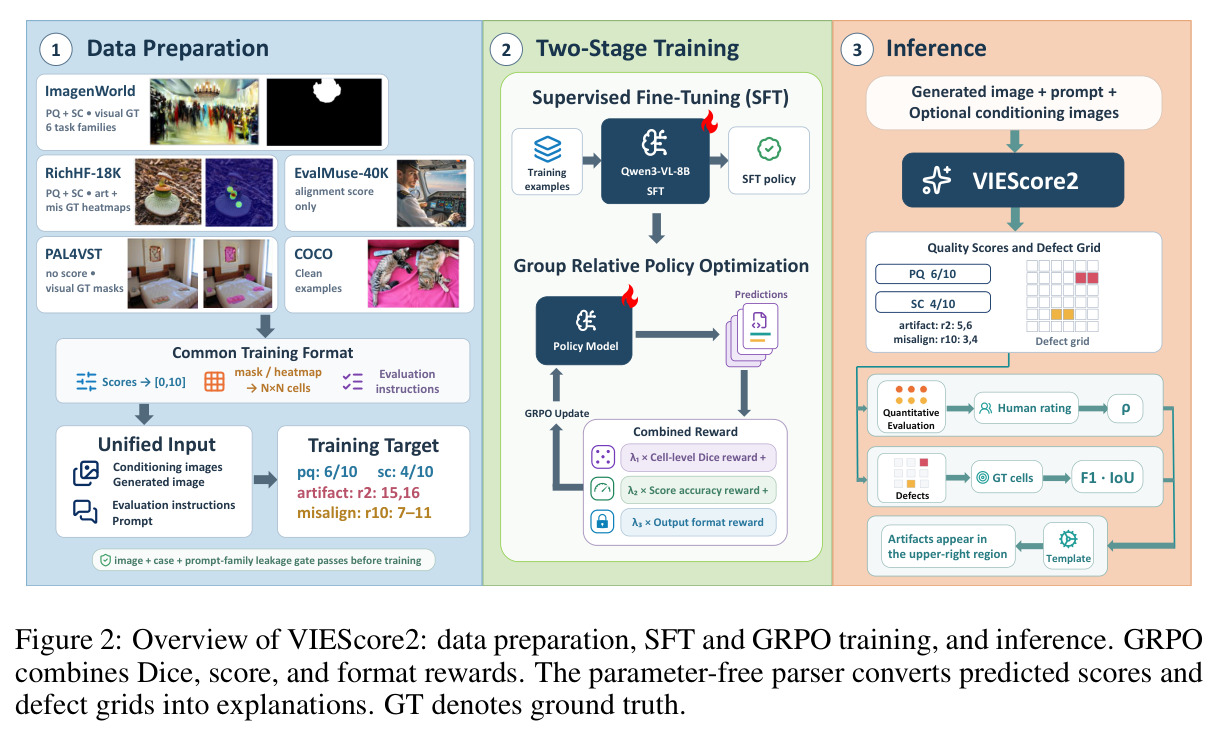
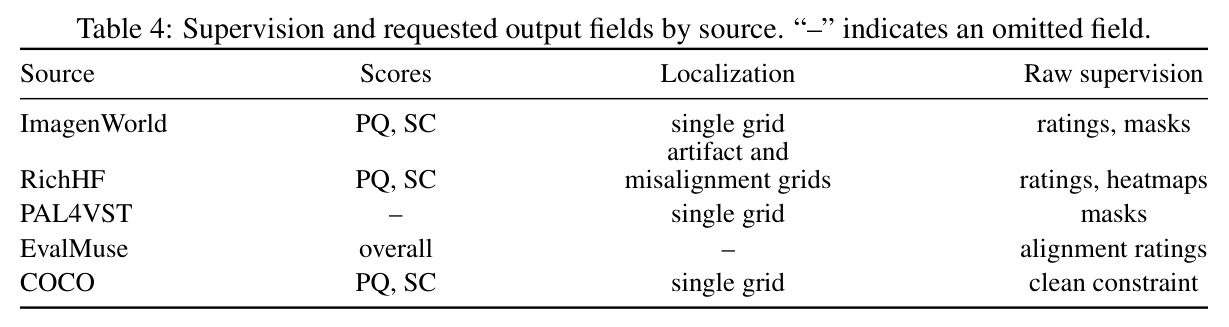
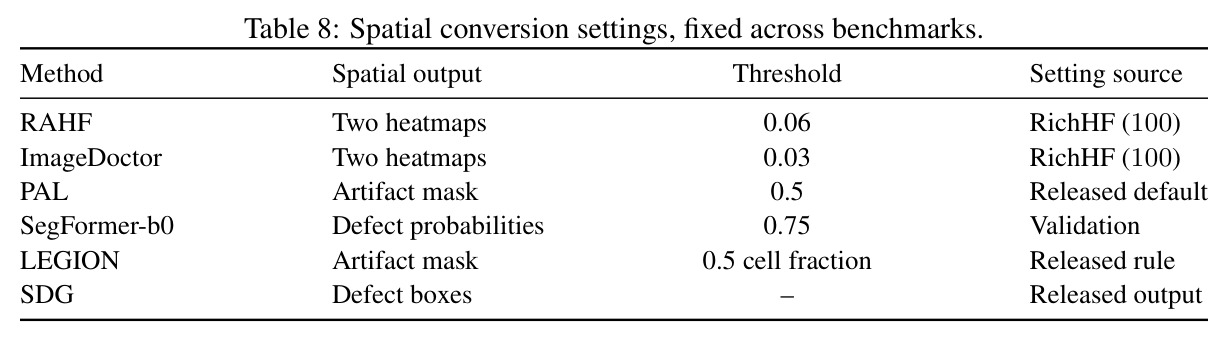
与已有工作不同的是,本文的独特切入点是把缺陷表示为文本原生的稀疏网格坐标(如 artifact: r2: 5,6),以此作为统一接口。第一,掩码、热图、框等异构空间标注都能通过缩放加阈值化转换成格子集合,从而把五个来源、监督类型各异的数据归一进同一个训练格式,且每个样本只保留它实际拥有的监督(分数或定位或两者);第二,这种文本表示可以直接解析,使 GRPO 的奖励(覆盖加权 cell 级 Dice)能在推理时的同一表示上直接计算,实现“可验证的空间后训练”,不存在训练优化一种表示、推理输出另一种表示的错位;第三,分数-格子-解释三层输出通过无参数解析器用固定规则绑定,解释的忠实性由构造保证而非依赖模型自觉。相比之下,VIEScore 的自由文本解释不可验证,ImageDoctor 和 SDG 优化的是热图或框奖励,与文本自回归格式之间存在转换鸿沟。
核心方法
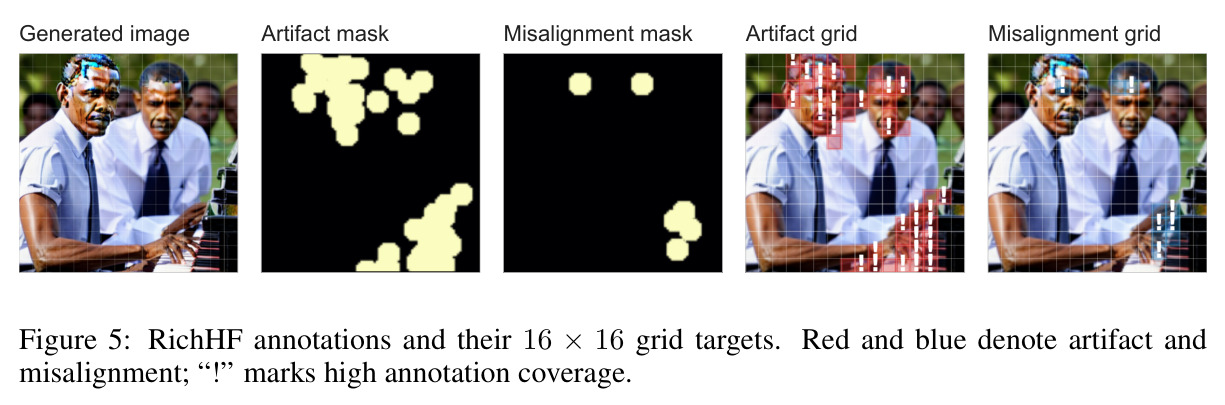
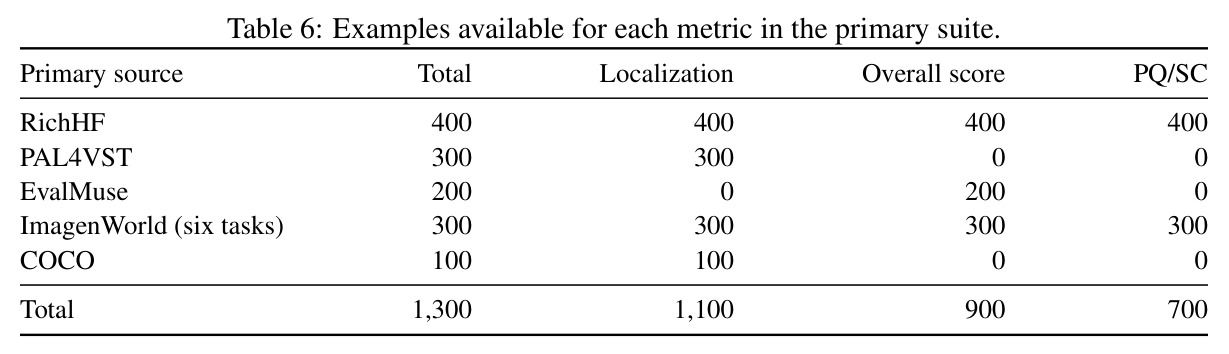
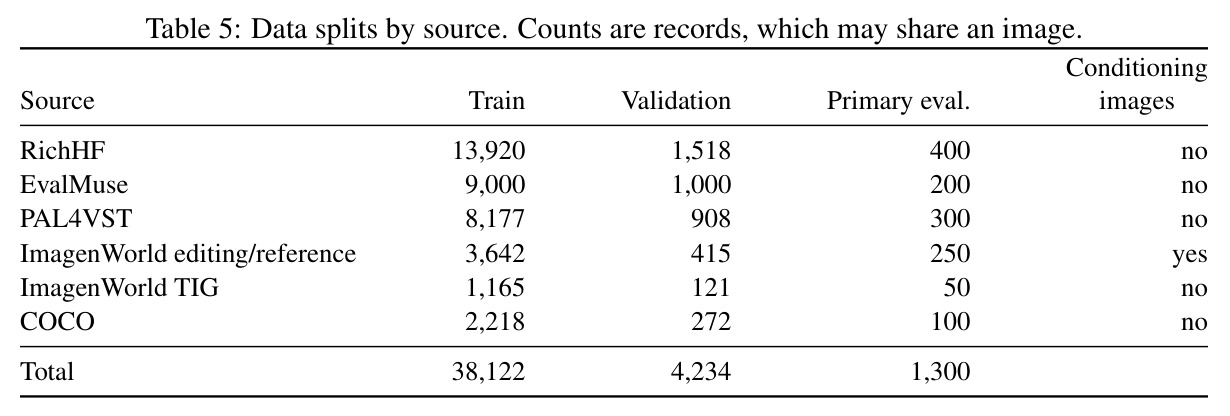
直觉上,VIEScore2 是一位“会指出哪里有问题”的评委:不只给总分,还在 16×16 网格上标出视觉伪影与语义错位所在格子,并写成“SC 4/10,由图像中部(第 10–11 行、第 6–12 列)与提示不符的内容导致”这样的解释。技术路线分三步。(1) 数据准备:把 ImagenWorld、RichHF-18K、EvalMuse-40K、PAL4VST、COCO 五个来源共 38,122 个训练样本归一化——分数统一到 0–10;掩码用 LANCZOS 插值缩放到 16×16 后以 0.5 阈值化成格子;RichHF 热图中原始响应 ≥0.9 的格子加“!”覆盖标记(表示标注支持度高,非严重程度)。(2) 两阶段训练:先对 Qwen3-VL-8B 做 LoRA SFT,再用 GRPO 全参数强化学习,奖励由覆盖加权 cell 级 Dice、分数准确度、输出格式合法性三项加权组成。(3) 推理:贪心解码输出分数与格子文本,无参数解析器按四连通把格子分组、按方位描述位置生成解释。整个流程见图 2。
核心创新是把“评估的空间证据”压进文本 token 流,并用可验证奖励直接优化它。与已有方法有三点本质区别。其一,VIEScore 等评估器的自由文本解释无法被 token 级交叉熵约束空间正确性;本文将缺陷表示为稀疏格子集合 $G \subseteq \{1,\dots,N\} \times \{1,\dots,N\}$,同一格式既用于自回归生成也用于奖励计算,GRPO 的优化目标与推理输出完全对齐。其二,Dice 奖励引入覆盖加权:被“!”标记(热图响应 ≥0.9)的格子权重 $w_c=2$,其他为 1,把标注置信度显式编入奖励,漏检高置信缺陷代价更大;$\beta$ 控制精确率-召回率权衡,$r_{dice}=\frac{(1+\beta^2)TP_w}{(1+\beta^2)TP_w+\beta^2 FN_w+FP}$,$\beta=1$ 经开发集验证最优。其三,单一 8B 模型通过评估指令切换仅打分/仅定位/联合三种模式,兼容零个、单个、多个条件图像——这是掩码/热图专用头的空间评估器做不到的。训练时每条样本只用其可用的监督项,缺失项在组内对所有回答给零奖励,不产生梯度差异。
方法步骤详情
第一步,数据准备:RichHF(13,920 条)提供 PQ/SC 分数与伪影、错位两张热图及覆盖标记,PQ 取伪影与美学评分均值、SC 取错位评分;ImagenWorld(编辑/参考 3,642 条 + 文生图 1,165 条)提供 1–5 分评分与缺陷掩码,按 $(r-1)/4 \times 10$ 映射;EvalMuse(9,000 条)只给 1–5 对齐分,按 $2.5(r-1)$ 映射;PAL4VST(8,177 条)只有掩码;COCO(2,218 条)为无缺陷干净样本(PQ=SC=10、空网格),占语料不超过 10% 以免偏置。输入为生成图+提示词+可选条件图+评估指令 $\tau_i$,输出按指令包含分数行(pq:/sc: 或 score:)与格子行(r行号: 列号列表,加!表高覆盖,空网格输出 none)。第二步,SFT:损失为 $\mathcal{L}_{SFT}=-\sum_i \sum_{t=1}^{|y_i|} \log p_\theta(y_{i,t}|x_i,\tau_i,y_{i,<t})$,只对目标 token 计损失;LoRA rank 32 作用于全部线性层,学习率 $2\times10^{-4}$、余弦衰减、批次 32、5 个 epoch。第三步,GRPO:第 4 epoch 的 LoRA 并入主干,8-bit AdamW 全参数训练,学习率 $10^{-5}$、1 个 epoch、每个输入采样 4 个回答、共 2,400 个按监督类型/条件/缺陷密度分层的样本;总奖励 $r_{total}=\lambda_{dice}r_{dice}+\lambda_{score}r_{score}+\lambda_{format}r_{format}$,权重 (1, 0.3, 0.1),其中 $r_{score}=1-|\hat{s}-s|/10$,格式奖励检查输出可解析性,两类别格子取并集算 Dice。第四步,推理与解析:贪心解码、上限 1,024 token;无参数解析器按四连通分组格子、按大小最多描述三个组件并给出方位与坐标范围,分数按 <5、5–8、≥8 映射为低/中/高。
技术新颖性
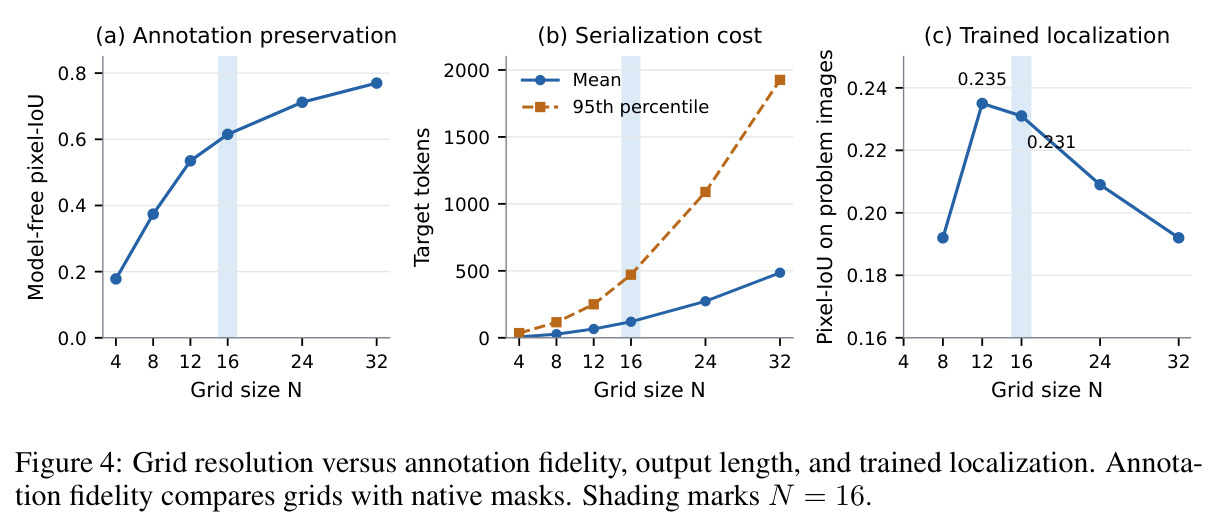
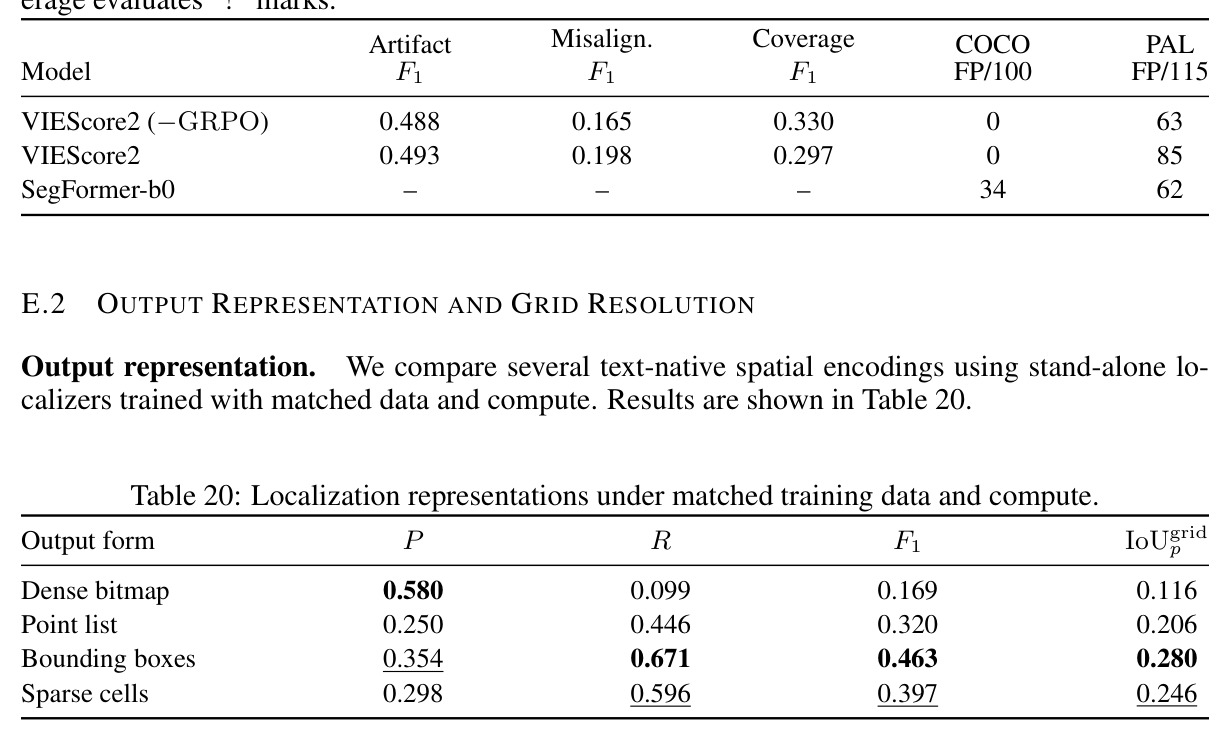
技术新颖性可从三层分析。表示层:Text4seg 等工作已把分割作为文本生成,但本文进一步把“类别化缺陷+覆盖标记”编进稀疏格子文本,支持不连通区域与空网格,并用实验确定 N=16 的最优权衡——model-free pixel-IoU 0.615(N=12 只有 0.535),而 p95 目标序列 471 token(N=32 达 1,926);有趣的是 N=32 训练后 pixel-IoU 反而降到 0.192,说明更细网格带来更长序列反而难学。训练层:ImageDoctor 用热图奖励、SDG 用框奖励做 RL,本文的 cell 级 Dice 奖励直接作用在自回归文本坐标上,消融显示仅 Dice 一项就把 IoU 从 0.296 提到 0.320,三个种子稳定提升 0.024–0.029,而额外 SFT epoch 仅 +0.001,证明增益来自强化学习本身;格式奖励因所有变体解析率都是 100% 而无可测效果,仅作为保险。系统层:无参数解析器保证解释与预测严格一致(作者也承认它不验证正确性),与 LEGION/HEIE 让模型自由生成解释的路线形成“忠实性换表达力”的取舍;另外与同监督训练的密集基线 SegFormer-b0(IoU 0.272)相比本文 0.324 领先,说明文本式定位并未牺牲精度,且匹配预算下稀疏格子 F1(0.397)虽低于边界框(0.463),但格子在类别分离、连通区域和奖励计算上更简洁。
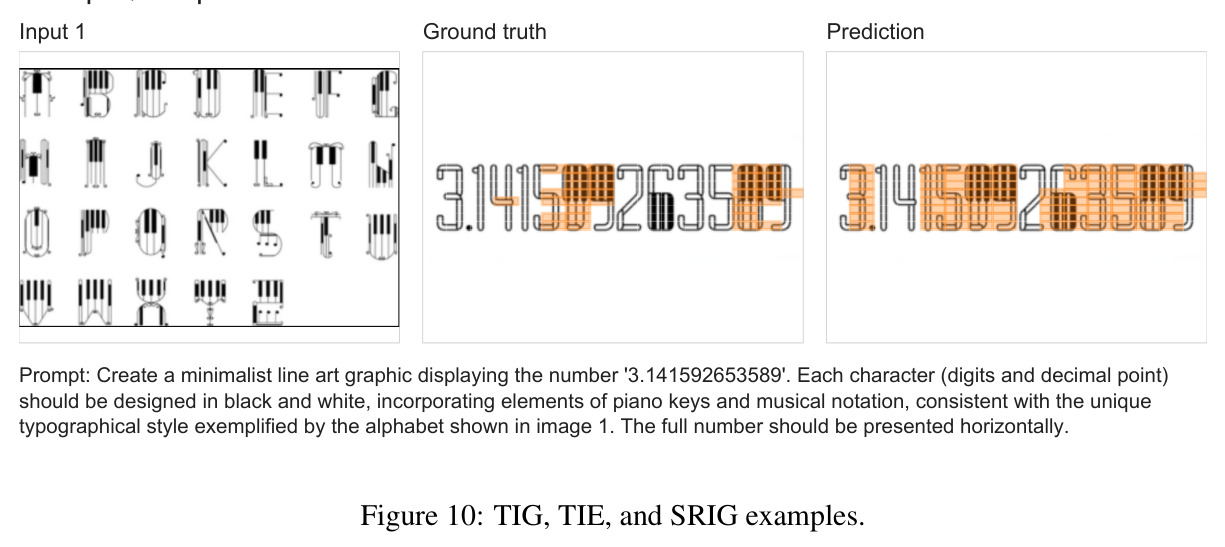
实验结果
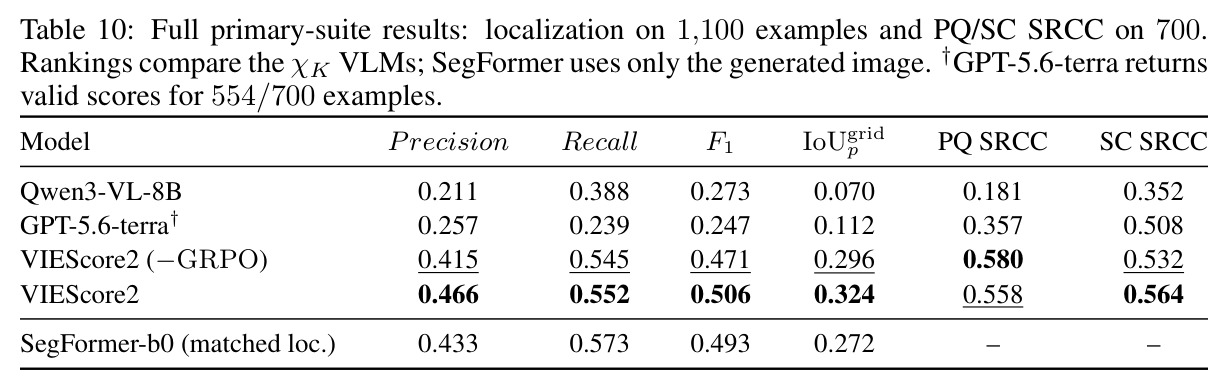
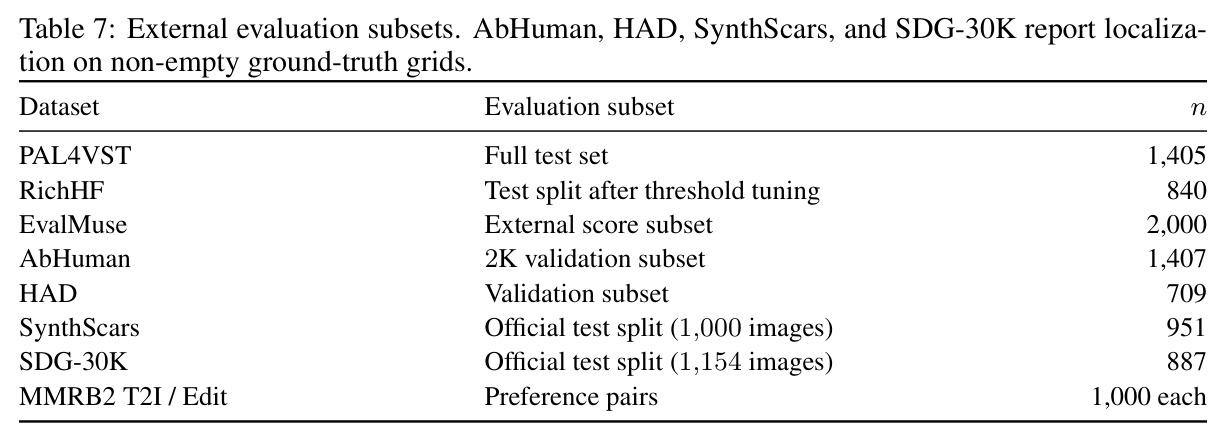
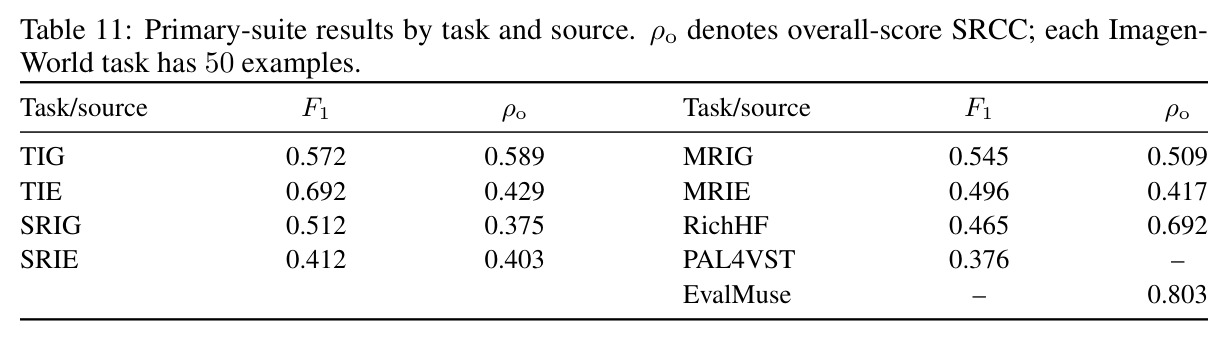
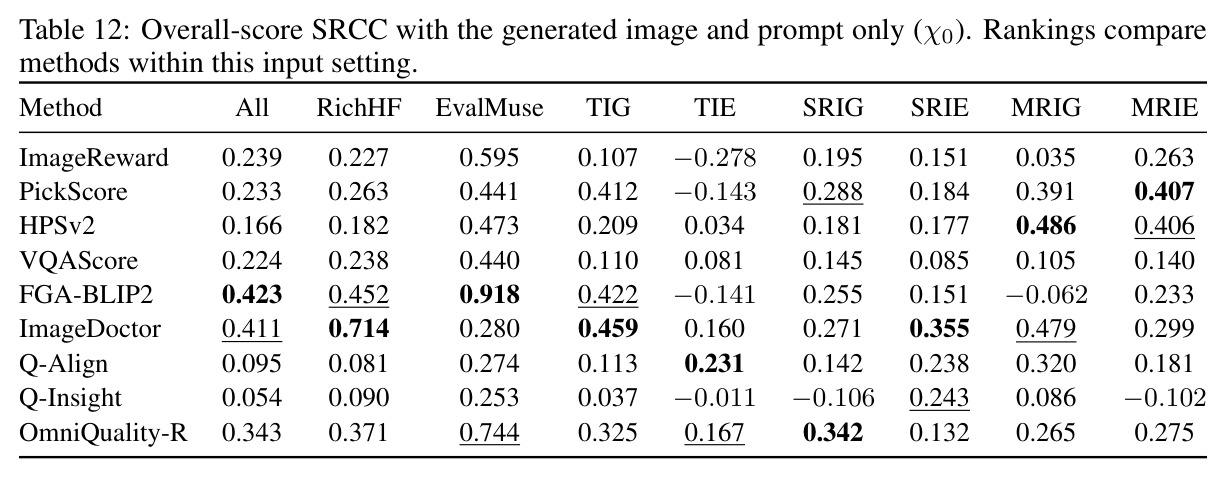
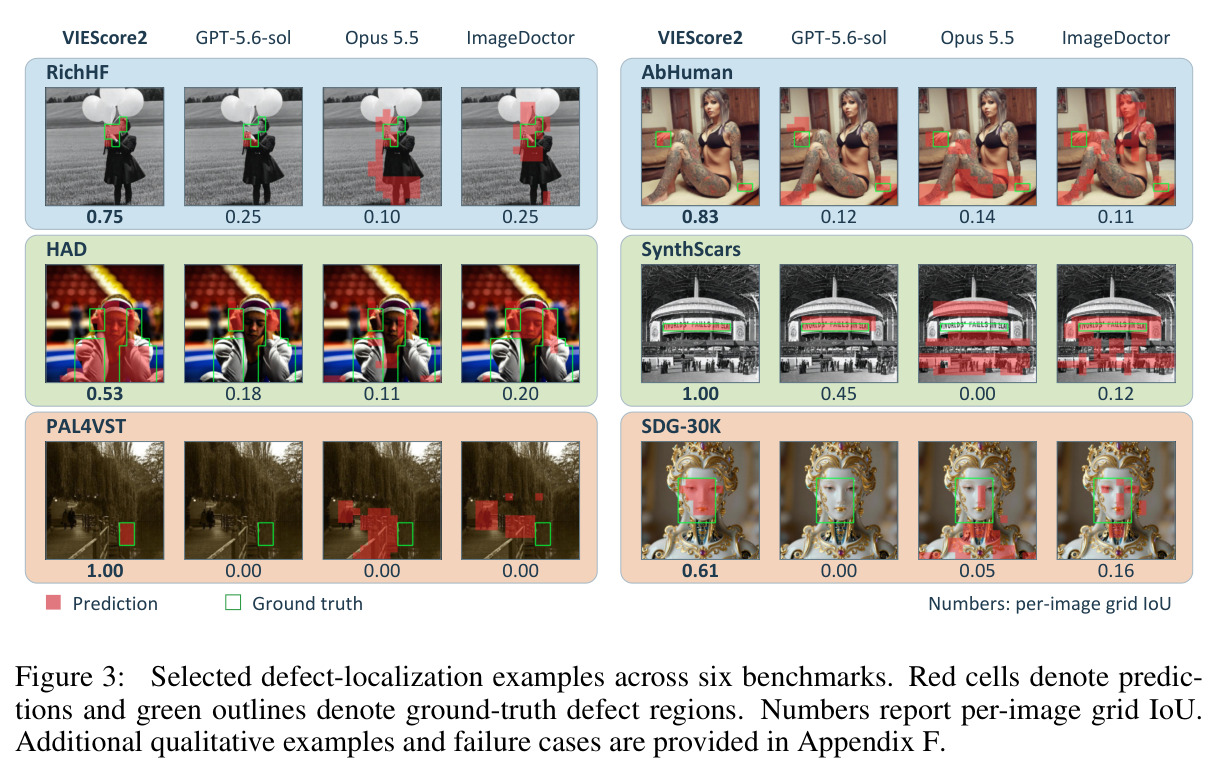
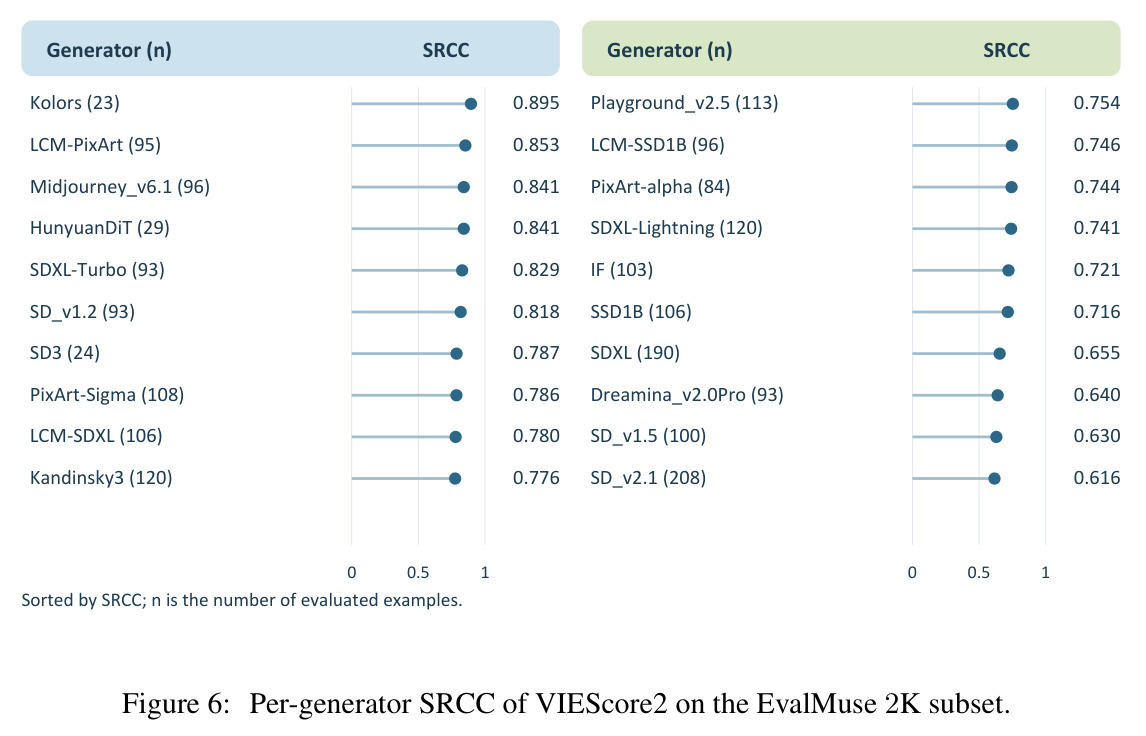
评分方面:主套件 900 个有分数标注的样本上,VIEScore2 总体分 SRCC 0.601,显著高于最强零样本通用 VLM Gemini-3-Flash(0.491)、GPT-5.6-sol(0.437)、GPT-5.6-terra(0.402)与未微调 Qwen3-VL-8B(0.373);它在 RichHF(0.692)、EvalMuse(0.803)、SRIG(0.375)领先,Gemini-3-Flash 在 TIE(0.686)和 SRIE 更强,GPT-5.6-sol 领先 MRIG/MRIE。外部 EvalMuse 2K 子集 SRCC 0.773,仍低于专用模型 FGA-BLIP2 的 0.910。定位方面:共享 16×16 网格的六个基准上 per-image grid IoU 三项第一——RichHF 0.299(RAHF 0.285)、PAL4VST 0.335(PAL 0.306)、SynthScars 0.234(LEGION 0.218),HAD 第二(0.197,GPT-5.6-sol 0.211)、AbHuman 第三(0.215,SDG 0.253),五项进前三且 SynthScars/SDG-30K 属训练来源之外;但 SDG-30K 仅 0.102 落后 SDG 的 0.137。联合评估(定位 1,100 例 + PQ/SC 700 例):F1 0.506、IoU 0.324、PQ SRCC 0.558、SC SRCC 0.564,全面超过 GPT-5.6-terra(0.247/0.112/0.357/0.508)与 Qwen3-VL-8B。消融:GRPO 三个种子 IoU 提升 0.024–0.029 而额外 SFT epoch 仅 +0.001;仅 Dice 奖励即获大部分增益(0.296→0.320),完整奖励 0.324 IoU / 0.506 F1 且评分 SRCC 保持 0.601;$\beta=1$ 时精确率 0.415→0.466、召回 0.545→0.552 同升。提供条件图像使 250 个条件样本 SRCC 0.420→0.451、F1 0.514→0.536。MMRB2 偏好评估:文生图准确率 0.574 排第二(GPT-5.6-terra 0.614),编辑 0.547 低于两个 VLM 基线。代价:GRPO 后干净 PAL4VST 图像误报 63/115→85/115,覆盖标记 F1 0.330→0.297(COCO 干净图误报保持 0)。
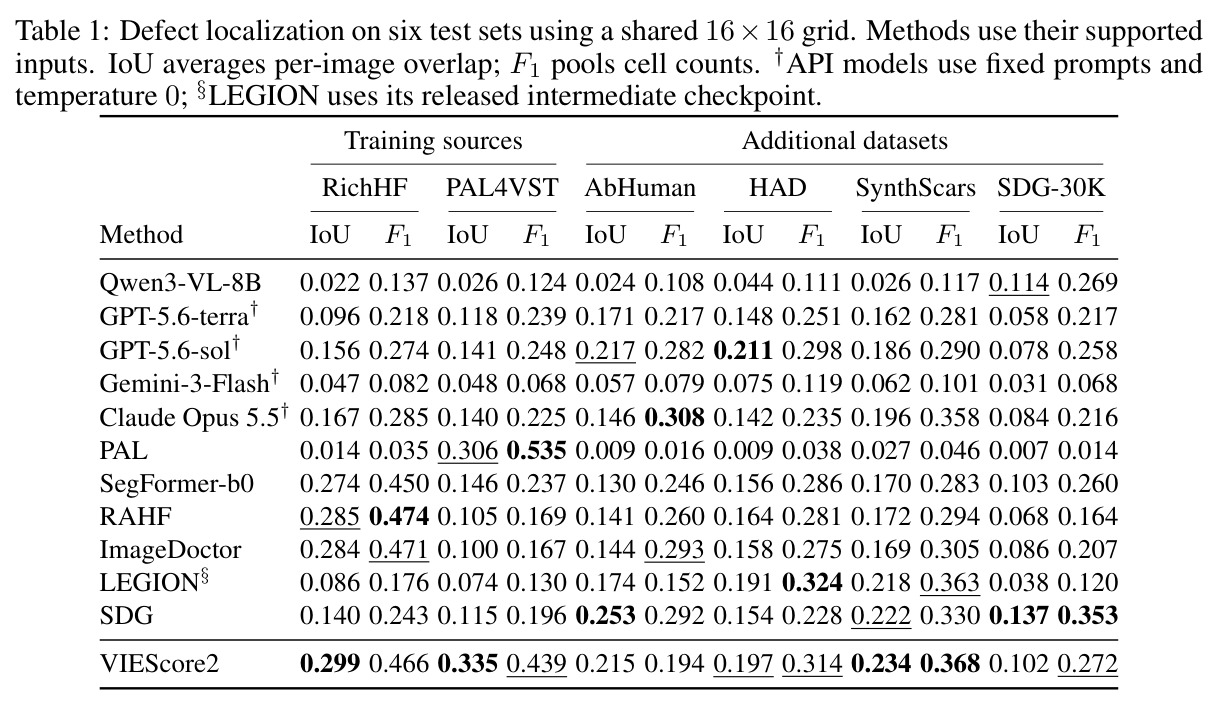
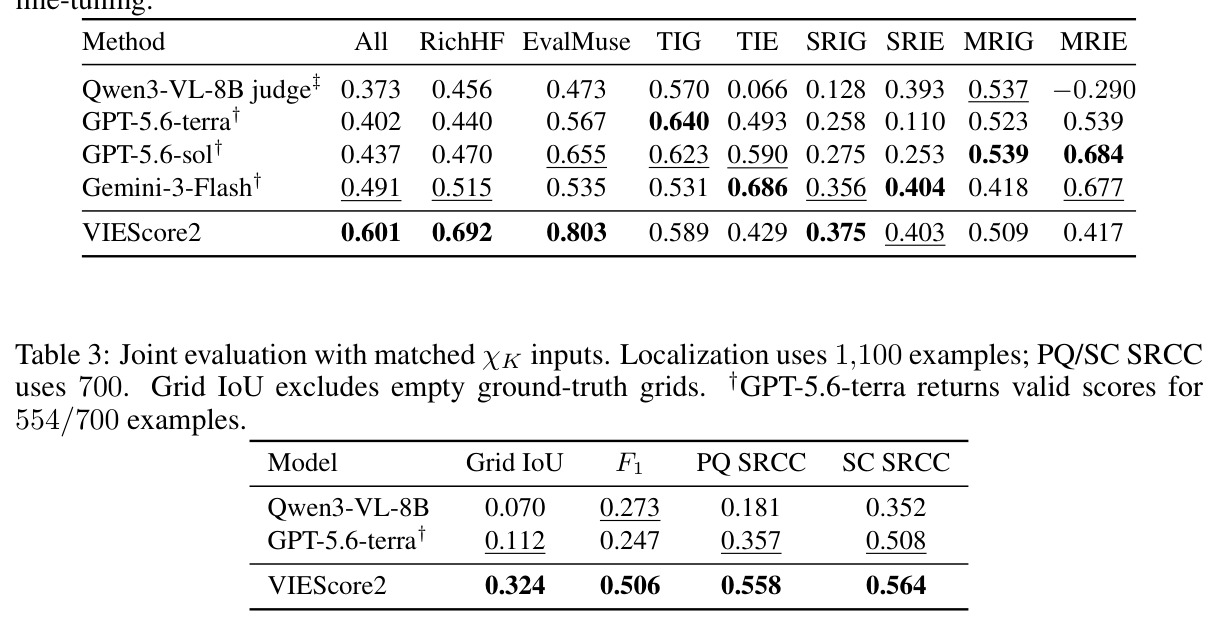
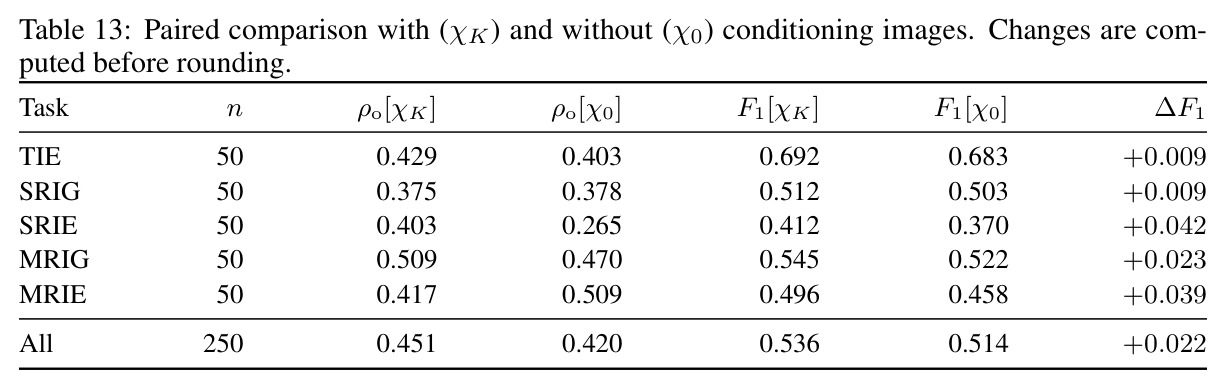
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 整体质量评分(主套件 900 例,χK 输入) | 总体分 SRCC | 0.601 | Gemini-3-Flash 0.491(最强零样本通用 VLM) | +0.110 |
| RichHF 缺陷定位(400 例) | per-image grid IoU | 0.299 | RAHF 0.285 / ImageDoctor 0.284 | +0.014,排名第一 |
| PAL4VST 缺陷定位(主套件 300 例) | per-image grid IoU | 0.335 | PAL 0.306 / SegFormer-b0 0.146 | +0.029,排名第一 |
| SynthScars 定位(951 例,训练来源之外) | grid IoU / micro F1 | 0.234 / 0.368 | LEGION 0.218 / 0.363 | +0.016 / +0.005,两项均第一 |
| 联合评分+定位(定位 1,100 例 / PQ·SC 700 例) | F1 与 PQ/SC SRCC | F1 0.506;PQ 0.558 / SC 0.564 | GPT-5.6-terra F1 0.247;0.357 / 0.508 | F1 翻倍(+0.259) |
| GRPO 消融(3 个独立种子) | grid IoU 相对 SFT 检查点 | +0.024 ~ +0.029 | 额外 1 个 SFT epoch 仅 +0.001 | 增益差约 25 倍,证明 RL 本身的贡献 |
| EvalMuse 外部 2K 子集评分 | SRCC | 0.773 | FGA-BLIP2 0.910(专用对齐评估器) | −0.137,统一模型仍落后专用模型 |
局限与改进
作者承认的局限:(1) 仅在 Qwen3-VL-8B 上验证,其他骨干与规模的效果未知,且与已发布评估器的对比无法解耦架构、数据与训练流程各自的贡献;(2) 固定网格会漏小缺陷、只能粗逼近不规则边界——16×16 下 6.4% 的非空掩码栅格化后直接消失;(3) 无参数解析器的解释忠实于预测但不独立验证正确性,也不识别缺陷成因;(4) GRPO 在部分干净图像子集上增加误报,是定位能力与保守识别之间的权衡。我的补充观察:(1) 语义错位定位很弱,F1 仅从 0.165 提升到 0.198,远低于伪影的 0.493,说明模型“看得出难看”但“看不出不对”;(2) 分数奖励对评分无实质贡献(仅 Dice 的变体同样 0.601),评分能力几乎全部来自 SFT;(3) MMRB2 编辑准确率低于通用 VLM,编辑一致性判断仍是短板;(4) 在框状标注的 SDG-30K 上 IoU 仅 0.102 落后 SDG,暴露对异构标注风格的适配不足;(5) 与 FGA-BLIP2 的差距(0.773 vs 0.910)说明统一性以一定的评分精度为代价。
独立分析的弱点
独立分析的弱点与改进方向:(1) 固定分辨率网格的信息损失——手指、文字等小缺陷常不足一个格子,N=16 时 6.4% 标注消失,而 N=32 又因序列过长难训练;改进方向是层次化/自适应网格(先 16×16 粗定位再对可疑区域细化),或盒子+格子混合输出以兼取框的精确性与格子的灵活性。(2) 错位定位 F1 仅 0.198,因为训练集中带双类别标注的只有 RichHF 一家;改进方向是引入 EvalMuse 式细粒度对齐标注,并为编辑任务构造“区域级改动检测”数据,让条件图像与生成图做显式对比。(3) 干净图像误报与召回的权衡——GRPO 后干净 PAL 误报 63→85/115;可在奖励中加入干净样本的 FP 惩罚项,或对 none 预测做置信度校准。(4) 解释是模板拼装,只能报告“哪里、什么类别”,无法回答“为什么错、怎么改”;可让 VLM 对每个缺陷格子生成一句自由描述,再用网格预测做事实校验,兼顾表达力与忠实性。(5) 分数与定位的互相增强未实现——定位证据已经免费可得,却未用于条件化评分;可让分数奖励采用成对排序形式而非逐样本绝对误差,或在推理时先定位再评分。(6) 只测了 8B 骨干与贪心解码,未探索更大模型、多次采样投票或测试时扩展的收益。
未来方向
作者提出或基于成果可延伸的方向:(1) 跨骨干验证——在更大 VLM(32B/72B)或其他模型家族上复现 GRPO 增益,检验可验证空间奖励是否存在规模效应,这也是作者在局限里明确点出的空白;(2) 用作生成模型的奖励模型——0.601 的 SRCC 加上网格级密集信号天然适合 RLHF/DPO,作者已在 MMRB2 上初步验证此用途,提升编辑准确率后可闭环到图像编辑模型的偏好训练;(3) 缺陷归因——目前解析器只说“哪里有问题”,未来可结合扩散模型的交叉注意力图或编辑前后差异图解释“为什么错”,从评估走向诊断;(4) 数据引擎闭环——用 VIEScore2 自动筛选、重标注或挖掘困难样本反哺生成模型训练,配合人机协同审阅界面(作者强调评估器应支持而非替代人类判断);(5) 扩展到视频生成评估与多图一致性——多参考任务 MRIE 的 SRCC 仅 0.417,多输入场景有明显空间;(6) 更精细的可验证奖励——用像素级软权重替代二值格子权重,或加入类别混淆惩罚(当前 Dice 奖励对伪影/错位互换不敏感),也可探索列表式评分奖励替代绝对误差。
复现评估
复现可行性较高。数据全部公开:RichHF-18K、EvalMuse-40K、PAL4VST、ImagenWorld、COCO 及评测用 AbHuman、HAD、SynthScars、SDG-30K 均为已发布数据集;训练/验证/评测切分与防泄漏措施(图像精确与感知哈希去重、提示词家族审计,去除受影响样本后整体 SRCC 变化 <0.001)在附录 A 详述;评估指令模板全文在附录 G,解析器规则、各基线的空间转换阈值(如 RAHF 0.06、ImageDoctor 0.03)在附录 B/C 列明。算力需求温和:8B 骨干 + LoRA(rank 32)SFT 5 个 epoch(有效批次 32、序列上限 2,048 token),GRPO 仅 1 个 epoch、2,400 个样本、每样本 4 次采样、8-bit AdamW、补全上限 768 token,单机数张 A100/H100 即可完成,且论文提供三个种子的方差(IoU +0.024–0.029)与开发集调参协议(RichHF 100 张调阈值)供对照。主要不确定性:(1) 文中未明确承诺开源代码与模型权重,若不开源需按附录重实现解析器与奖励逻辑;(2) GRPO 对采样子集与超参较敏感,好在消融覆盖全面(β、奖励项、表示形式、网格分辨率均有专门表格);(3) 复现 API 基线对比需遵循其解析失败处理约定(如 GPT-5.6-terra 在 700 例中仅 554 例返回有效分)。总体评估:中等难度,熟悉 VLM 训练的团队一到两周可复现核心结果。
论文图表
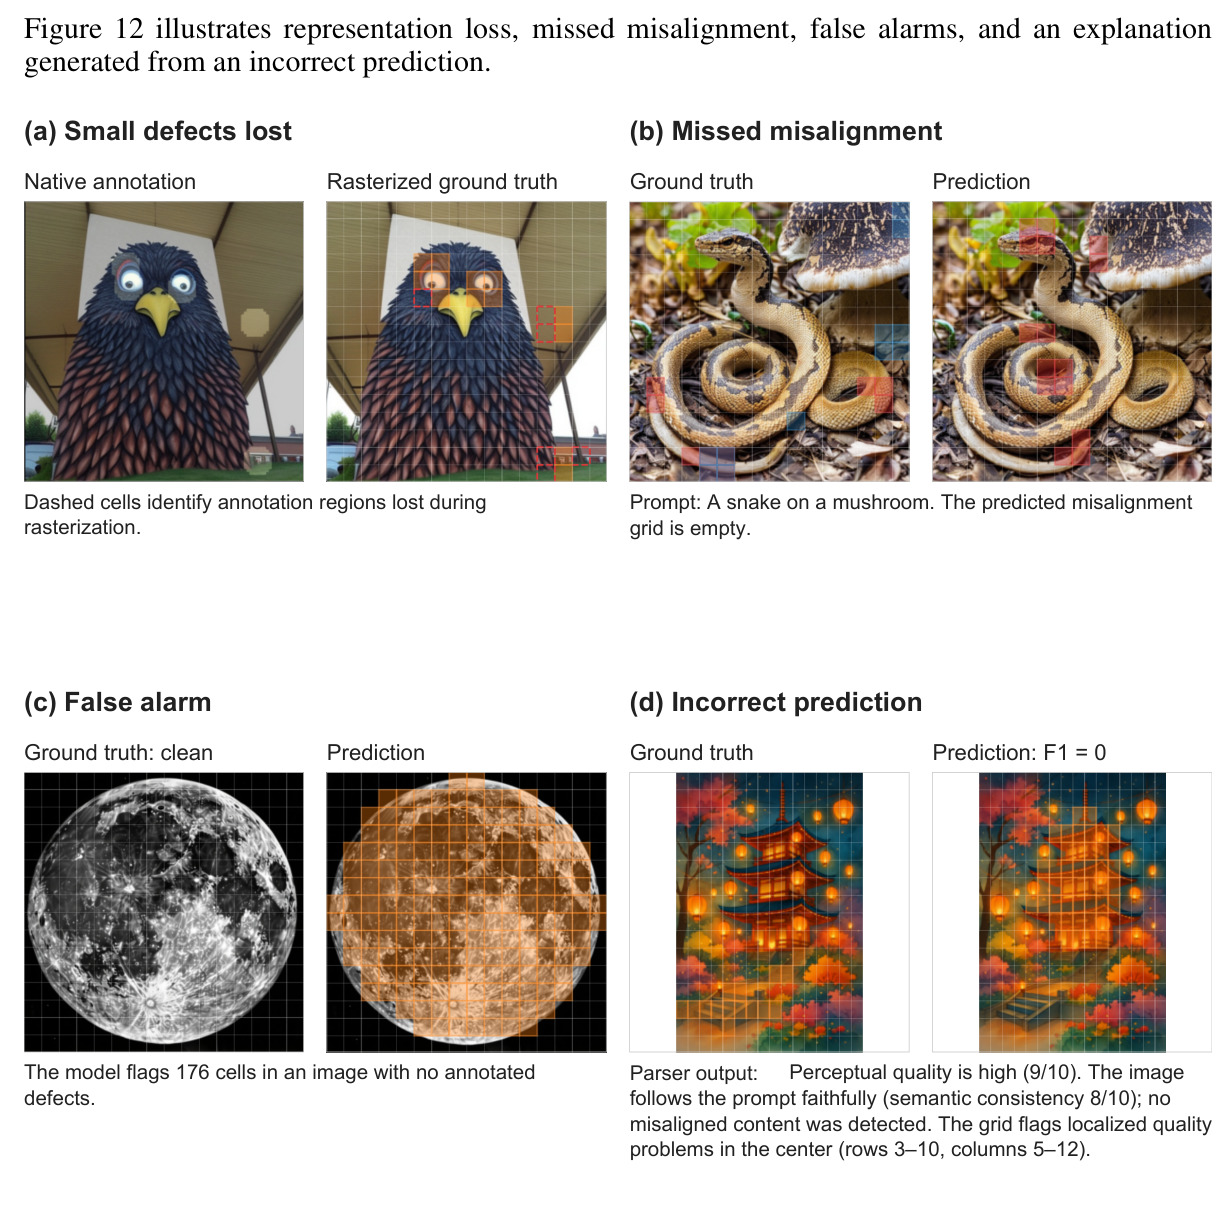
四类失败:(a) 小缺陷在栅格化时丢失(虚线格子为消失的标注区域);(b) 错位漏检——“A snake on a mushroom”的错位网格预测为空;(c) 误报——干净图被标出 176 个缺陷格子;(d) 错误预测 F1=0,但解析器仍一本正经地生成“质量高(9/10)、完全符合提示”的解释。
集中呈现表示损失、类别不平衡、误报权衡与“解释忠实但不正确”四条局限的实例证据,是批判性理解论文边界的必看材料。