CANOPY:面向多模态RAG的自适应粒度证据压缩 CANOPY: Adaptive-Granularity Evidence Compression for Multimodal RAG
微调节点编码器驱动层次化父子剪枝,跨模态自适应压缩检索证据并按需补检索
前置知识
RAG(检索增强生成)
先从外部语料检索与问题相关的条目(段落、表格、图片、视频切片等),再把它们拼进大模型上下文让模型“有据可答”,缓解大模型对训练数据中罕见、过时或缺失知识的幻觉。核心组件是检索器(通常为双塔向量检索,如 DPR/FAISS 索引)和阅读器(根据证据生成答案的 LLM)。
本文的全部工作发生在 RAG 流水线内部,研究的是“检索返回之后、送入阅读器之前”这一段证据该如何裁剪,先理解 RAG 才能定位本文的位置。
多模态异构语料检索
语料同时包含文本段落、表格、图片和视频段,每个条目用统一的多模态嵌入模型(本文用 Qwen3-VL-Embedding-2B)编码进一个向量索引;查询是纯文本,检索时全库最近邻搜索,或先经路由器分到模态子库(modality routing)再检索。
CANOPY 的卖点是同一套压缩流程能同时处理四种模态的检索结果,理解异构性才能理解“共享程序”的含义以及实验语料的构成。
检索后证据压缩(post-retrieval compression)
在检索返回 top-k 条目后、送入阅读器前,把每条条目压缩成更小的证据(抽取句子/行/片段,或生成摘要),以减少阅读器输入 token、去除干扰内容。已有方法按模态各用一套机制:RECOMP 抽句或摘要、LongLLMLingua 按 token 概率剪、TableRAG 取相关单元格、VideoRAG 选关键帧。
这是本文定义并研究的问题本身;作者的核心主张是“选定检索粒度并不等于确定了条目内该保留多少”,压缩要在条目内部逐区域自适应决定。
双塔编码器与余弦相似度打分
查询和候选分别经编码器映射为向量,用余弦相似度 $\cos(u,v)=u^\top v/(\|u\|\,\|v\|)$ 度量相关性。本文冻结查询编码器 $f_0$,用 LoRA 微调节点编码器 $f_\theta$;节点嵌入与查询无关,可离线计算并缓存,打分只用 $s_\theta(q,v)=\cos(f_0(q),f_\theta(v))$。
CANOPY 的全部节点级剪枝只依赖这一个打分函数的相对大小比较,编码器分数在“父区域与子区域之间”是否可比,直接决定剪枝质量,也是微调动机所在。
成对排序损失与 LoRA 微调
成对排序损失要求“更相关者得分更高”,本文形式为 $\ell(q,v)=\log\big(1+\sum_{(a,b)\in\mathcal{P}(v)}\exp\,\lambda[s_\theta(q,b)-s_\theta(q,a)]\big)$,$\lambda=20$。LoRA 冻结原模型权重、只训练注入的低秩矩阵(本文 rank 8、$\alpha$=16),少量数据即可微调 2B 模型。
节点编码器的训练全靠从金证据位置机械导出的偏好对加这个损失实现,是理解方法创新点和复现训练的必要知识。
多跳问答(multi-hop QA)
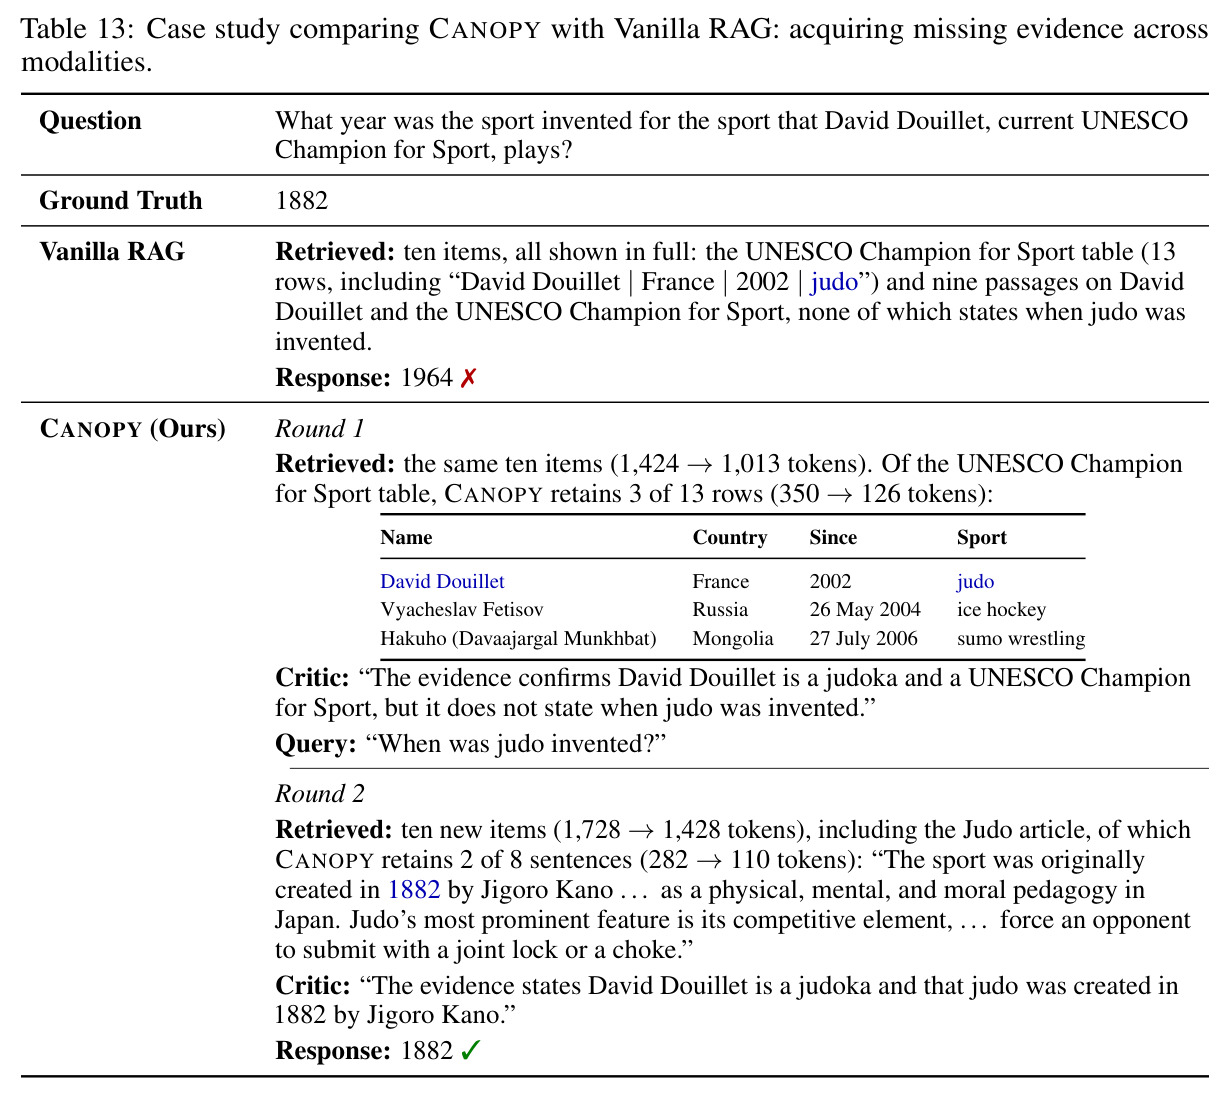
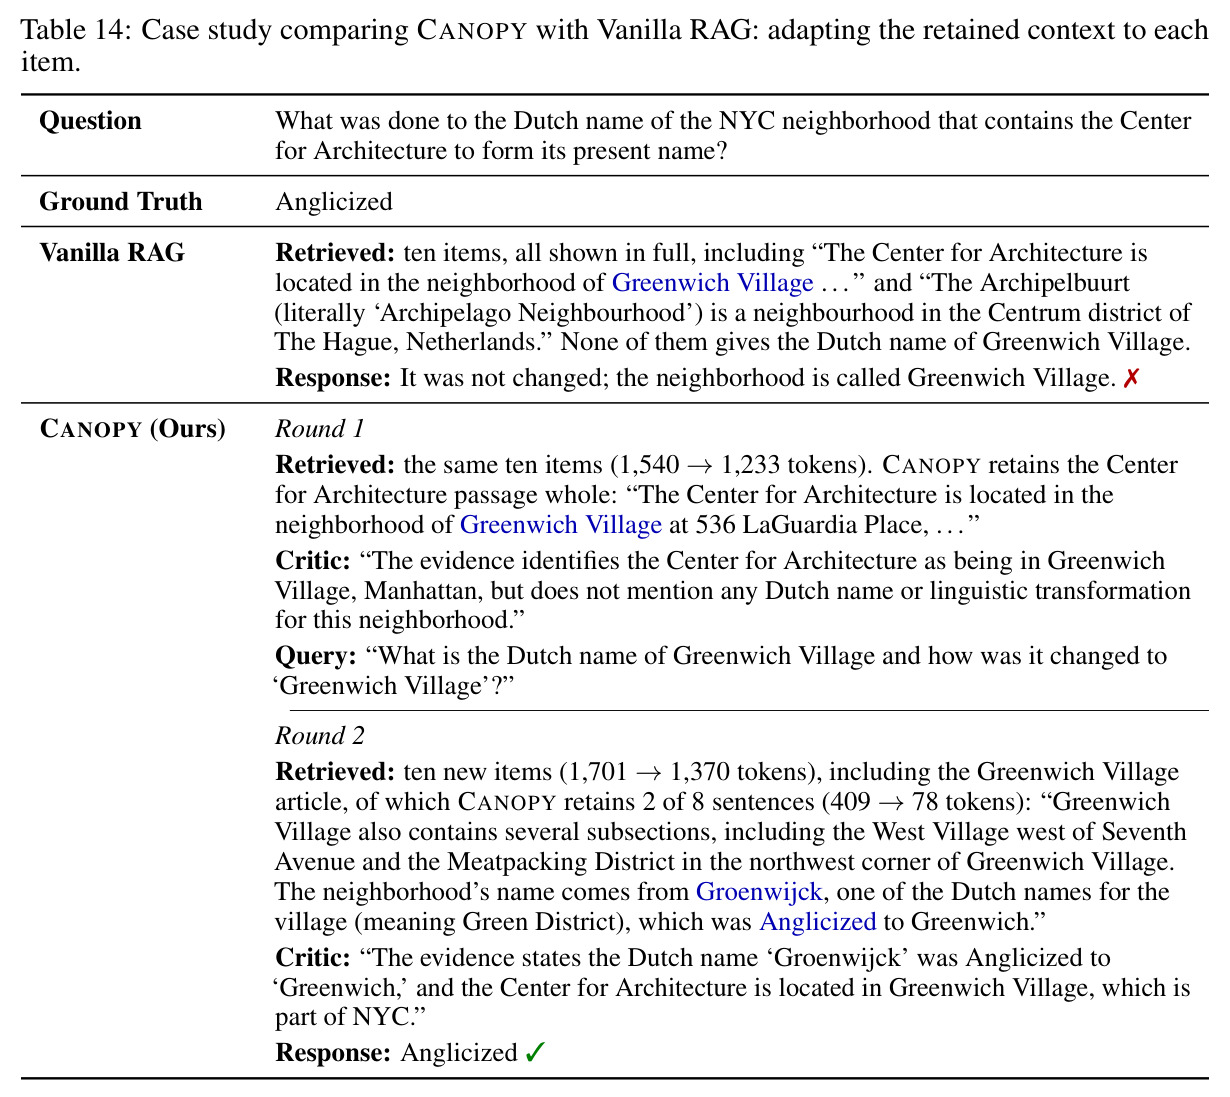
答案需要串联多条证据才能得出的问题,例如“David Douillet 所从事的运动是哪年发明的”——先要查到他练柔道,再查柔道 1882 年发明。第一轮检索往往只含其中一跳,中间结果会揭示下一步要检索什么,因此需要迭代式检索。
实验反复显示 CANOPY 的准确率增益主要来自多跳基准上的批评家补检索而非压缩本身,理解多跳才能正确解读其消融结论。
研究动机
多模态 RAG 检索回来的是“整条”条目:整段文字、整张表、整段视频,但回答一个问题往往只需要其中一小块。论文 Figure 1 给了三个例子:问“哪个州的熊最多”,整段灰熊介绍里只需要第一句(阿拉斯加灰熊约 5.5 万只);问“RoboWarrior 主机何时发布”,需要表格中的一行加上链接段落里解释 FC/NES 关系的一句话;问“2012 年万米赛谁掉了鞋”,一小时的视频只需要 0:30–1:00 的片段。整条传入有两个代价:一是上下文有限、token 昂贵,二是无关内容会分散模型注意力、损害答案质量(Liu et al. 2024 的 lost in the middle、Shi et al. 2023 的干扰实验)。反过来,若对每条条目统一用细粒度选择,又会把证据从解释它所需的上下文中剥离——表格行离开列头就不可读。更麻烦的是同一条目内不同区域需要的上下文量不同,给整条条目定一个统一粒度无法解决这个权衡。
本文的目标是本文要为“检索后证据压缩”建立一个跨模态共享的程序:对异构检索结果中的每一条——文本、表格、视频(图片保持单节点)——逐区域自适应决定“保留到什么粒度、保留哪些区域”,且节点级剪枝不调用 LLM(只用嵌入相似度比较)以控制推理成本。同时,由于压缩无法找回从未被检索到的证据,框架还与“证据充分性批评家”耦合:当累积证据不足以回答时,定位缺失事实、生成定向后续查询并补检索,同时用压缩控制多轮累积的证据量。最终在约 3,290 万条统一异构语料上,覆盖 NQ、HotpotQA、OTT-QA、MMQA、LVBench 五个基准做端到端评估,同时报告答案质量(EM/F1/准确率)与阅读器输入 token 数、LLM 调用次数和时延。
与已有工作不同的是,本文的独特切入是把“检索粒度”与“条目内保留范围”解耦:检索阶段决定取哪些条目,CANOPY 在其后对每个条目内部逐区域决定保留多少。技术差异化有三点:其一,条目被表示为“原始区域”的层级,而非 RAPTOR 那样的递归生成式摘要,也不是 Mix-of-Granularity 那种按查询挑选预定义检索粒度;其二,训练信号不是普通相关性标签,而是从金证据在层级中的位置导出的“父子偏好”——让编码器学会在同一个条目内比较“父区域与其子区域谁更该被展开”,这与推理时固定的父子相对剪枝规则一一对应;其三,各分支可独立停止,于是一条条目内可同时保留多个不同粒度的区域,既不需要绝对相似度阈值(免去按模态调阈值的麻烦),也不需要 token 预算或保留数量上限。这种“训练目标与剪枝规则严格对齐”的设计是已有工作所没有的。
核心方法
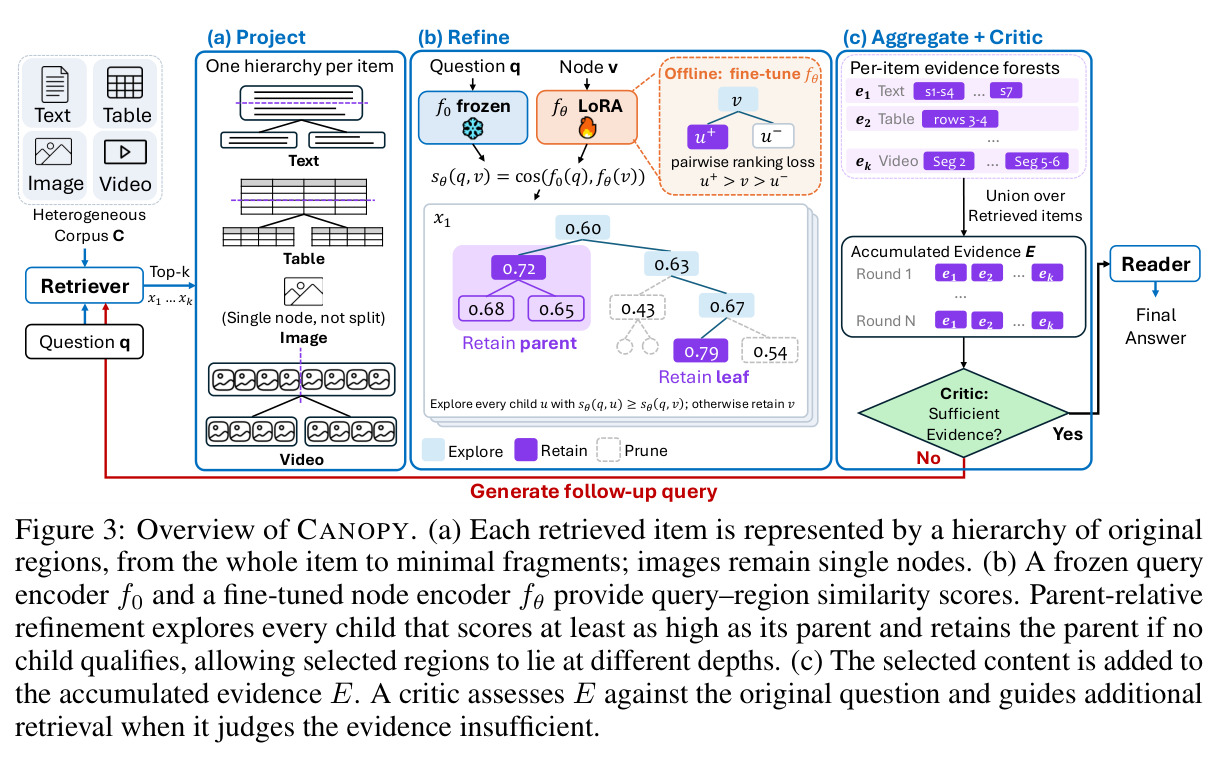
直觉上,“该留多少”不该由人拍板,而应由问题与区域的相关性结构决定:如果某个子区域比它的父区域更贴问题,就往下钻;如果孩子们都不比父亲强,说明细分会丢上下文,就整块保留。技术路线分四步。第一步检索:用 Qwen3-VL-Embedding-2B 在 32.9M 条统一 FAISS 索引(fp16 标量量化、精确内积)上取 top-$k$=10 条。第二步建层级:每条条目构造成分支因子 $B=2$ 的树,根是整条条目,叶子是最小片段——文本为句子、表格为行(各级保留列头)、视频为 30 秒片段(每 10 秒采 1 帧、至多 32 帧),图片是单节点;表格首次出现时 LLM 只依据问题判一次“聚合题还是查值题”,聚合题整表保留。第三步打分与细化:冻结查询编码器 $f_0$ 加 LoRA 微调的节点编码器 $f_\theta$ 计算节点分 $s_\theta(q_t,v)=\cos(f_0(q_t),f_\theta(v))$,从根开始父子相对细化:得分不低于父节点的孩子全部保留并继续细化,其余子树丢弃;无孩子达标则保留父节点,选出的节点互不为祖先,构成证据森林。第四步批评家循环:LLM 批评家对照原问题检查累积证据 $E_t$ 是否充分,充分则阅读器作答,否则指出缺失事实并生成下一轮查询 $q_{t+1}$,新条目用 $q_t$ 打分压缩后入库,至多 $R=3$ 轮。
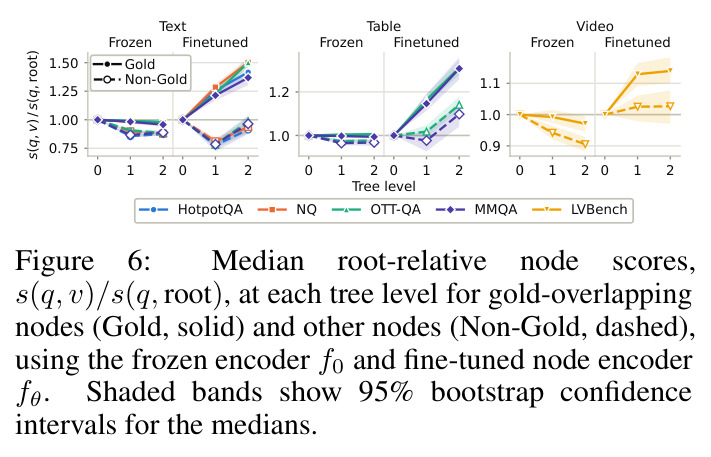
核心创新是把“剪枝规则”与“编码器训练”设计成一体。现成编码器的相似度在不同大小的区域之间不可比:覆盖三句话的父段落与查询的相似度未必高于其中最相关的那一句,直接比大小会乱剪。CANOPY 用金证据标注构造偏好对微调 $f_\theta$:若节点 $v$ 完全被金覆盖($F(v)\subseteq G_i$),让它压过自己的每个孩子,教会“到此为止、保留上下文”;若 $v$ 只部分覆盖金证据,则让含金孩子压过 $v$、$v$ 压过不含金孩子、含金孩子再压过不含金孩子,教会“沿含金方向下钻”。这样训练出的分数天然支持固定规则“孩子得分 $\ge$ 父亲则下钻,否则停”,每个父节点都是探索与停止的局部参照。与已有方法的本质区别:RECOMP/LongLLMLingua 只服务文本,TableRAG/VideoRAG 各管一摊且常需 LLM;RAPTOR 检索的是生成摘要;S2G-RAG 用 LLM 判充分性还要逐句抽取。CANOPY 节点级剪枝零 LLM 调用、无绝对阈值、无保留数量预算,节点嵌入可缓存复用。
方法步骤详情
离线训练:把各基准的金证据位置映射为最小片段集合 $G_i$;对每个训练问题找出“金覆盖且没有完全金的真祖先”的内部节点集合 $V_i$(即理想细化会访问的节点);对每个 $v\in V_i$ 生成偏好对 $\mathcal{P}(v)$(完全金:$v$ 胜所有孩子;部分金:含金孩子胜 $v$、$v$ 胜不含金孩子、含金孩子胜不含金孩子),用成对排序损失 $\ell(q,v)=\log\big(1+\sum_{(a,b)\in\mathcal{P}(v)}\exp\lambda[s_\theta(q,b)-s_\theta(q,a)]\big)$、$\lambda=20$ 训练。五个基准共 4,162 个训练问题、18,575 个实例 $(q,v)$,共享一个 LoRA(rank 8、$\alpha$=16、dropout 0.05),AdamW 学习率 $5\times10^{-5}$、批 16、2 个 epoch(2,322 步),视觉塔冻结,$f_0$ 恒冻结。在线推理:第 $t$ 轮用 $q_t$($q_1$ 为原问题)检索 $k=10$ 条;为每条构造层级(表格先做一次性聚合/查值分类);计算节点分并执行 Algorithm 1 的父子细化得证据森林;新条目压缩后并入累积证据 $E_t$(重复条目跳过);批评家读原问题与 $E_t$,输出“充分与否+缺失事实+后续查询”;充分则阅读器作答,否则以 $q_{t+1}$ 进入下一轮,至多 3 轮,第 3 轮后直接作答。阅读器输入设上限(四个文本基准 16k token,LVBench 64k/40k),超限按最新优先截断。
技术新颖性
新颖性有四点。第一,问题形式化新:把“条目内自适应保留范围”从“检索粒度选择”中剥离出来单独研究,并论证二者互不替代——条目相关不代表知道其中哪些区域有用、各需多少上下文。第二,监督信号新:偏好对由金证据在层级中的位置机械导出,无需人工标注“该留哪个粒度”,且训练目标与推理时固定遍历规则一一对应,编码器学到的正是规则要用的比较;推理时不需要为每个模态单独调绝对阈值。第三,跨模态共享:文本/表格/视频只在“怎么切叶子”上模态特定(句子/行/30 秒片段),细化规则、打分、训练完全同一套;实验证明从 Wikipedia 表格学来的行级投影可零改动迁移到金融报表(TAT-QA 上与整页输入仅差 0.3 F1)。第四,成本结构新:节点级剪枝纯靠嵌入余弦比较(无 LLM),LLM 调用只留给批评家、聚合分类与路由——每题平均 2.8 次调用,对比 S2G-RAG 的 5.6 次;代价是证据 token 略多。这与“用 LLM 挑证据”或“生成式摘要”的压缩路线有本质差异。
实验结果
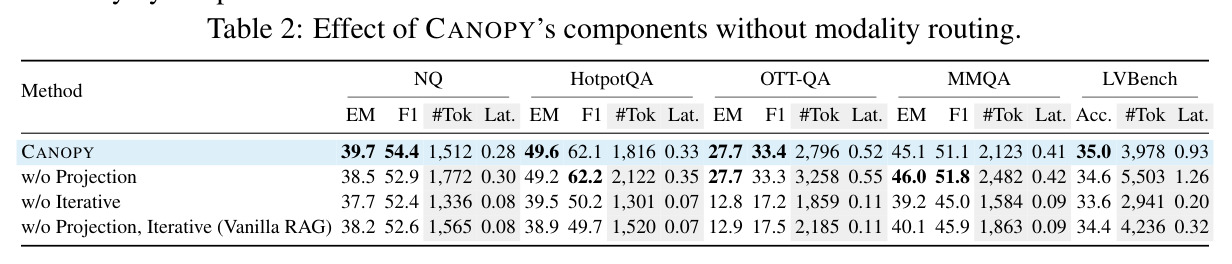
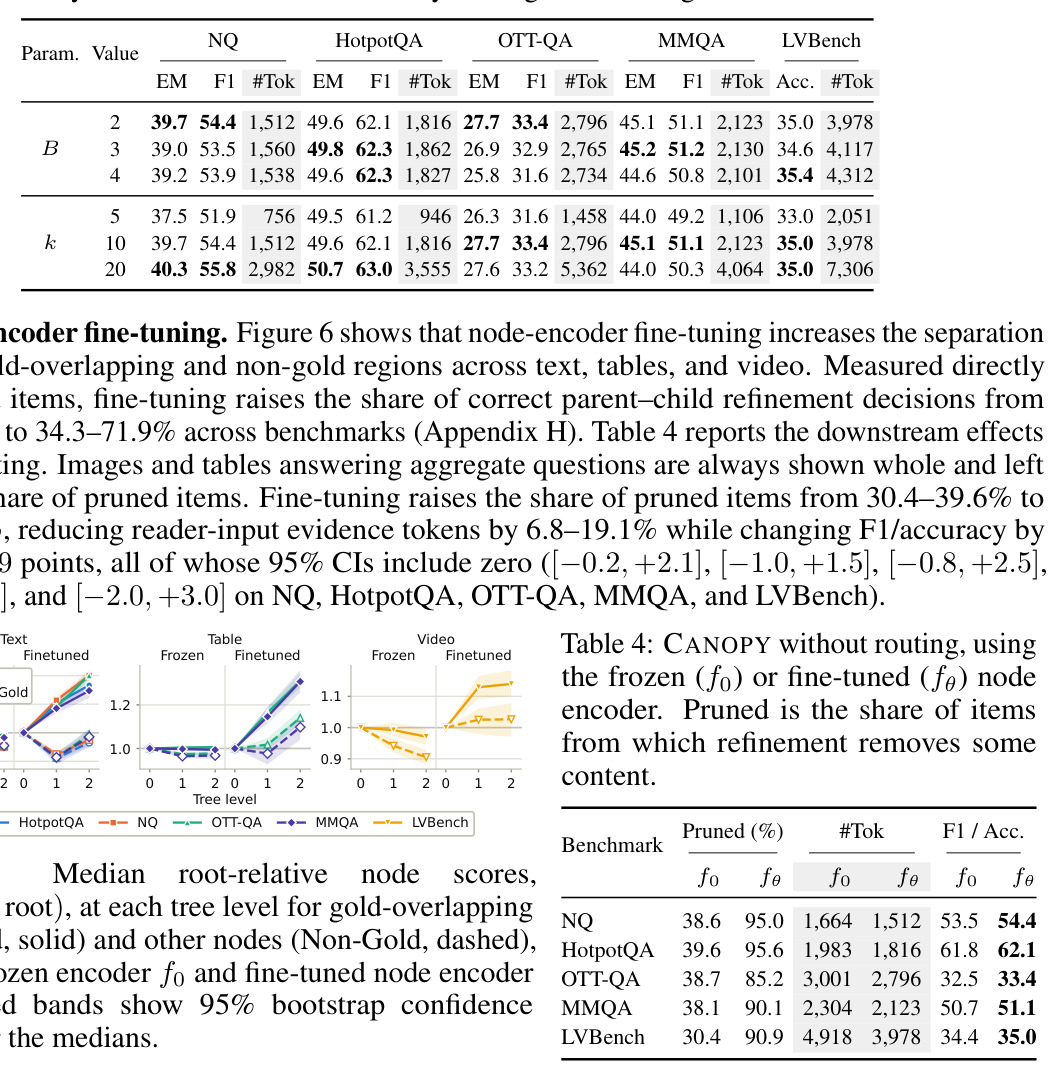
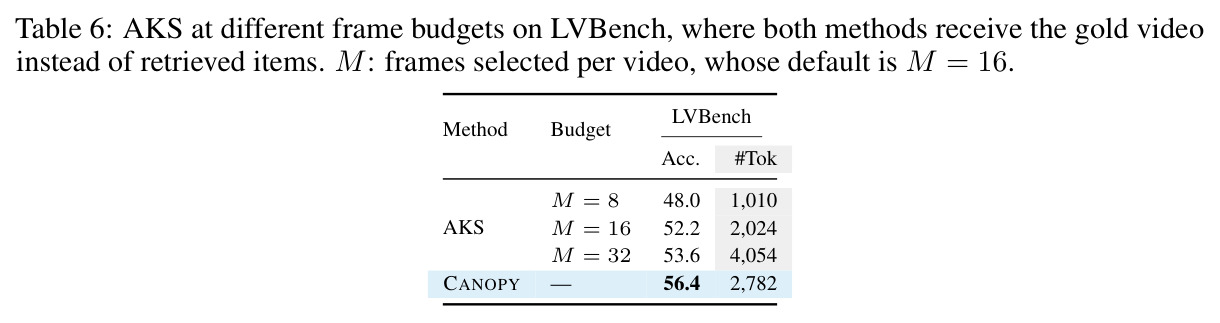
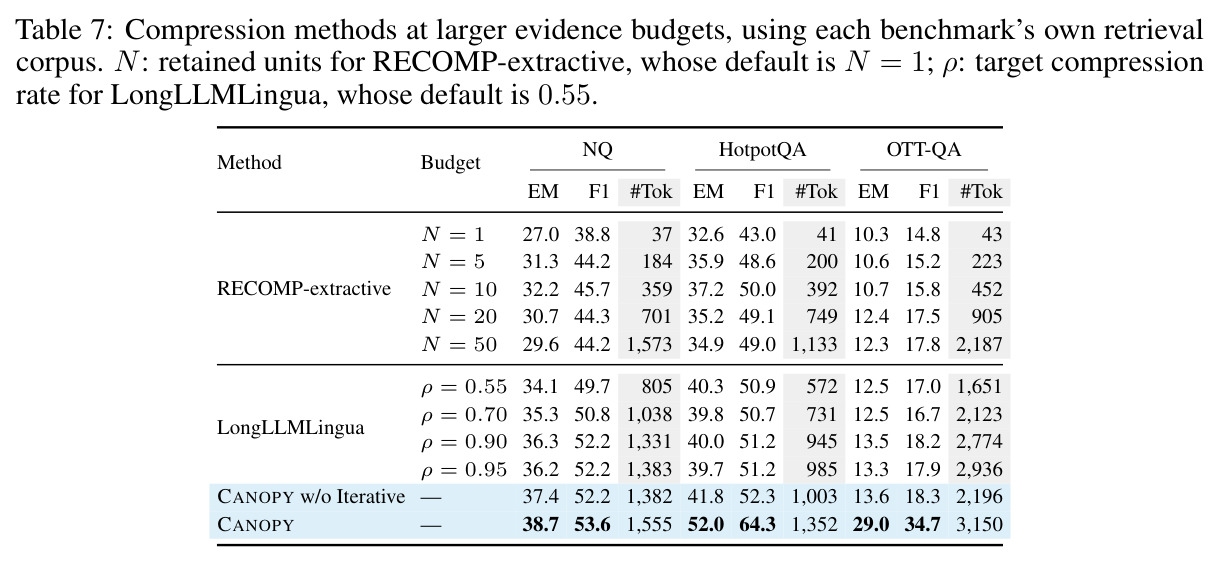
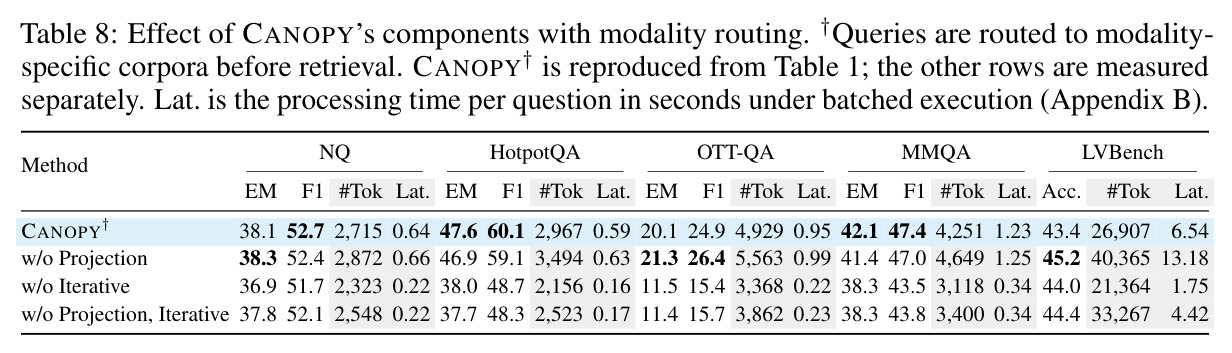
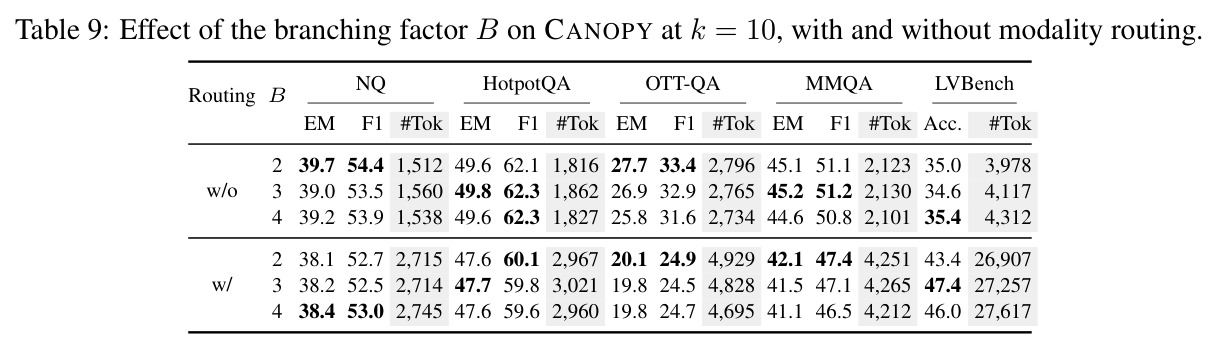
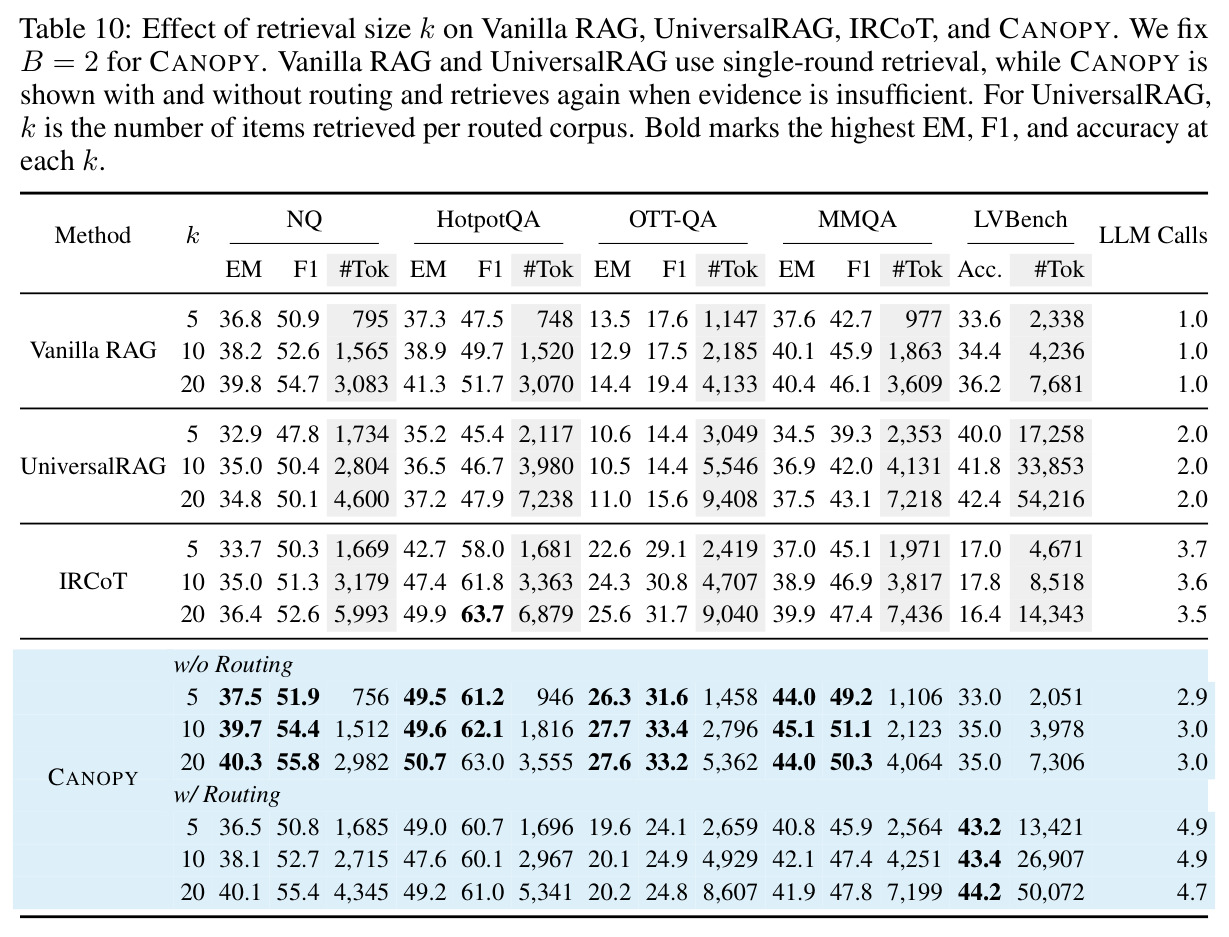
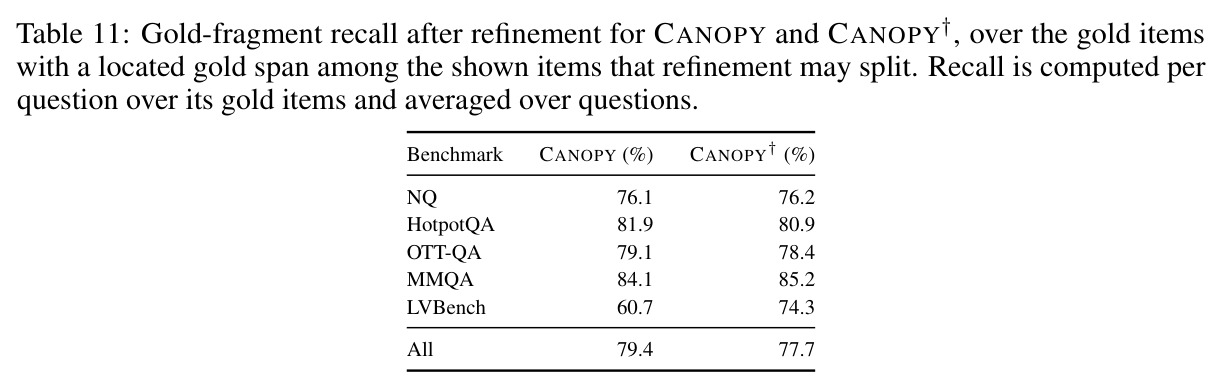
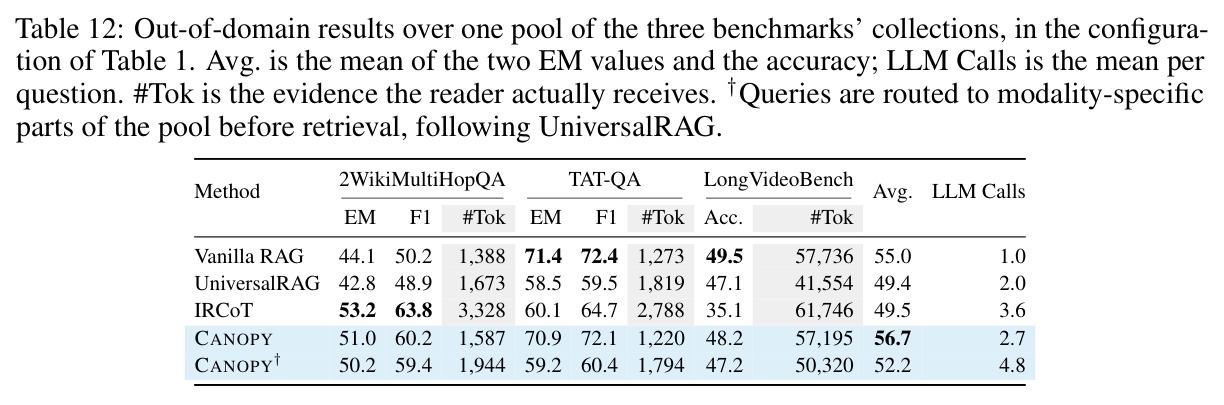
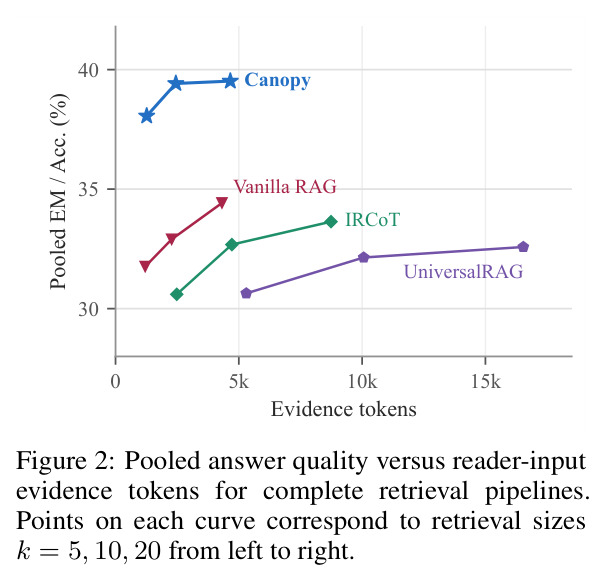
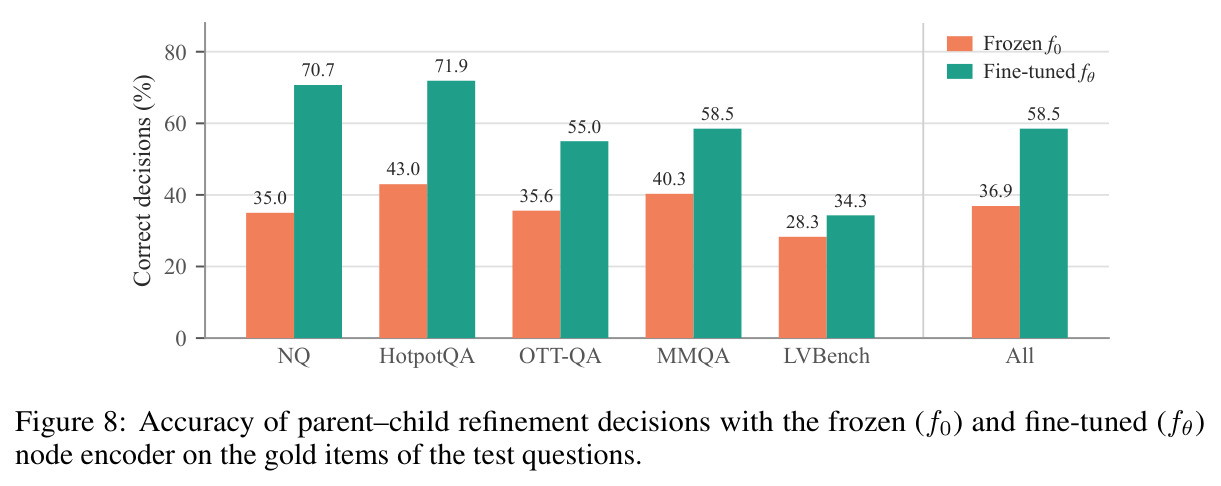
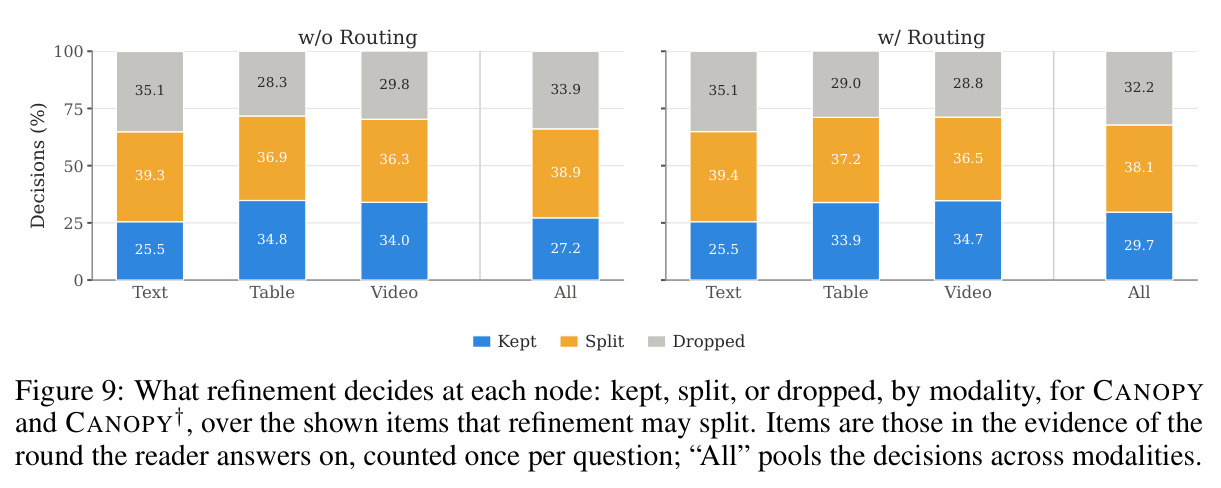
主实验(Table 1,Qwen3-VL-8B-Instruct,32.9M 统一语料,$k$=10、$B$=2、$R$=3):CANOPY 五基准平均 EM/准确率 39.4,高于 Vanilla RAG 32.9、IRCoT 32.7、UniversalRAG 32.1;分基准为 NQ EM 39.7/F1 54.4(1,512 token)、HotpotQA 49.6/62.1(1,816)、OTT-QA 27.7/33.4(2,796)、MMQA 45.1/51.1(2,123)、LVBench 35.0(3,978)。增益集中在多跳:HotpotQA 比 IRCoT +2.2 EM(+0.3 F1 不显著)、OTT-QA +3.4 EM;平均 2.1 轮检索下 token 至多比 Vanilla RAG 多 28%、比 UniversalRAG 少 46–88%。路由只在 LVBench 有用(CANOPY$^\dagger$ 43.4 对不路由 35.0),且换 InternVL3.5-8B 后路由版 LVBench 34.0 反低于 UniversalRAG 37.2 而 token 更多(31,218 对 27,290)。与模态专属压缩器比(Figure 4,各基准自有语料):LongLLMLingua 加大预算也饱和在低 1.4–16.5 F1 处;LVBench 上 AKS 花 1.5 倍 token 仍低 2.8 点;S2G-RAG token 更少但每题 5.6 次 LLM 调用对 CANOPY 2.8 次。消融(Table 2)给出关键因果:去压缩 token 降 14.2–27.7% 而 EM 变化 −0.9~+1.2(置信区间全含 0);去迭代检索 HotpotQA EM 掉 10.1(49.6→39.5)、OTT-QA 掉 14.9(27.7→12.8)——准确率主要来自补检索,压缩负责省 token。编码器微调(Table 4、Figure 6/8):细化决策正确率 36.9%→58.5%(NQ 35.0→70.7、HotpotQA 43.0→71.9、LVBench 仅 28.3→34.3);被剪条目占比 30.4–39.6%→85.2–95.6%,token 再降 6.8–19.1%;金片段召回 79.4%,LVBench 仅 60.7%。选择策略(Figure 5,直接给金条目):CANOPY 五基准全超平坦选择;相对整条保留,LVBench 省 40% token 准确率持平(56.4 vs 56.2),OTT-QA 省 27.5% token 但 F1 70.5→67.8;金片段本身非上界(LVBench 53.0)。敏感性(Table 3/10):$B$ 2→4 变化很小;$k$ 5→20 token 涨 3.6–3.9 倍而 EM 变化 ≤2.8;CANOPY $k$=5 在 HotpotQA/OTT-QA/MMQA 超 Vanilla RAG $k$=20,仅用 31–35% token。域外(Table 12):零改动迁移,三基准平均 56.7 最佳,2WikiMultiHopQA F1 60.2 比 Vanilla RAG 高 10.0(几乎全在组合题 47.0 vs 25.7),TAT-QA 72.1 vs 72.4、LongVideoBench 48.2 vs 49.5 且 token 略少。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| NQ 单跳文本问答(32.9M 统一语料) | EM | 39.7(F1 54.4,1,512 tok) | Vanilla RAG 38.2 | +1.5 EM |
| HotpotQA 多跳文本问答 | EM | 49.6(F1 62.1) | IRCoT 47.4 | +2.2 EM |
| OTT-QA 表格+文本开放域问答 | EM | 27.7(F1 33.4) | IRCoT 24.3 | +3.4 EM |
| MMQA 文本+表格+图片问答 | EM | 45.1(F1 51.1) | Vanilla RAG 40.1 | +5.0 EM |
| LVBench 长视频问答 | Acc. | 35.0(不路由)/ 43.4(CANOPY†) | Vanilla RAG 34.4 / UniversalRAG 41.8 | 路由版 +1.6 |
| 同一迭代流水线去/留压缩(无路由) | 阅读器输入证据 token | 降低 14.2–27.7% | w/o Projection(同流水线整条传入) | EM 变化 −0.9~+1.2,均不显著 |
| 父子细化决策正确率(测试金条目) | 全偏好成立比例 | 58.5%(微调 $f_\theta$) | 36.9%(冻结 $f_0$) | +21.6 个百分点 |
| 2WikiMultiHopQA(域外,零改动迁移) | F1 | 60.2(EM 51.0) | Vanilla RAG 50.2 | +10.0 F1 |
局限与改进
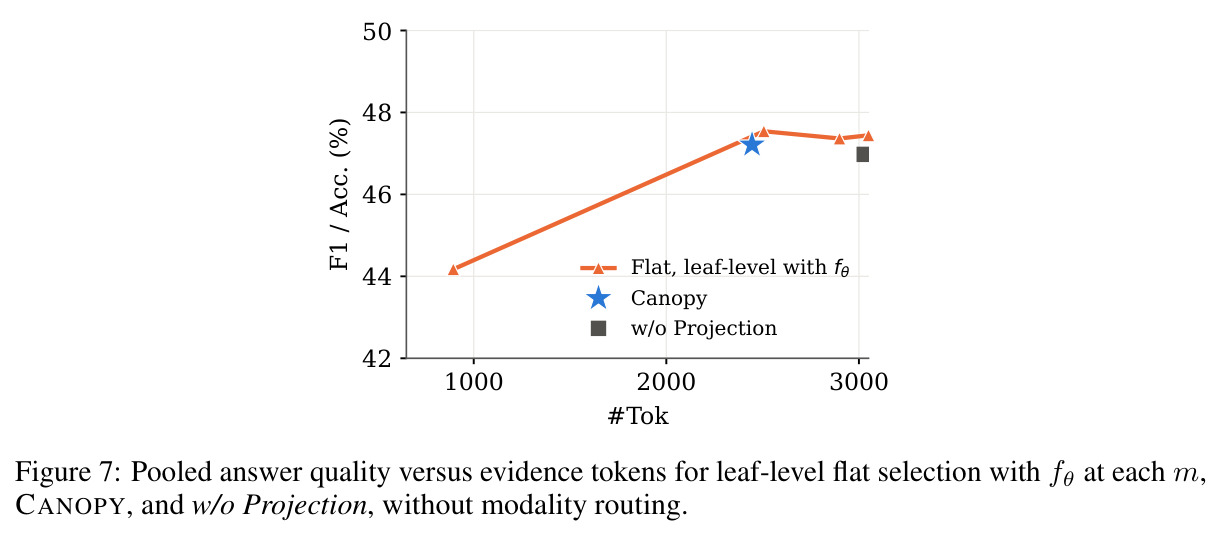
作者承认的局限:与 IRCoT 在 HotpotQA 上 +0.3 F1 不显著(95% CI [−1.7, +2.2]);路由在 InternVL3.5-8B 的 LVBench 上失效(34.0 对 UniversalRAG 37.2,token 反而 31,218>27,290);路由 LVBench 上压缩省 33.3% token 但准确率降 1.8(45.2→43.4);批评家的“充分”判断只是操作性停止准则而非完备性保证,达到轮数上限也不代表证据齐全。我的补充观察:其一,视频模态明显薄弱——微调后细化决策正确率仅 34.3%、金片段召回 60.7%,固定 30 秒切片加每 10 秒一帧的采样太粗,可能漏掉关键瞬间;其二,63.3% 的后续检索条目是证据中已有的重复项(51.2–76.6% 区间),说明批评家生成查询的多样性不足,浪费轮次与计算;其三,Appendix G 显示给平坦选择同样的 $f_\theta$ 后其质量-token 曲线与 CANOPY 相当,层次化规则的优势是操作性(免扫保留数 $m$)而非精度性;其四,聚合题处理只覆盖表格,文本/视频上的聚合型问题(列举、最值)未处理;其五,训练依赖各基准的金 span,无 span 的条目被当整条金处理、不产生训练实例,冷启动模态难以获益;其六,#Tok 统计不含节点编码与向量检索开销,对所有取回条目全部节点做嵌入的隐性成本未计入。
独立分析的弱点
弱点一:视频压缩质量差(决策正确率 34.3%、召回 60.7%)。固定 30 秒切片可能把动作切成两半,改进方向是用镜头边界检测或字幕对齐做自适应切分,或为片段生成文本字幕后走文本式细化,并把帧采样密度做成分数引导。弱点二:批评家重复检索严重(63.3% 重复条目)。可在批评家提示中显式维护“已检索事实/已查缺口”清单(其 prompt 已有雏形但显然不够),或对后续查询做去重与新增信息增益估计,收益低的轮次提前终止。弱点三:层次化选择相对平坦选择的精度增益不明确(Appendix G)。可把两者结合:用 $f_\theta$ 对叶子全局排序作候选,再用父子规则决定停止深度,兼得排序效率与上下文保留。弱点四:LVBench 路由+压缩组合掉点(45.2→43.4),说明激进剪枝在长视频上有风险,可引入不确定性回退——剪枝前后分数差小或批评家置信度低时保留整条。弱点五:聚合题只对表格做 LLM 分类,文本列举/最值题同样可能被剪掉分散在多处的句子,可扩展分类器覆盖文本与视频。弱点六:单一共享 LoRA 对模态差异容量有限,LVBench 学得最差,可为视频单设适配器或加大秩。弱点七:训练需要金 span,可用阅读器答案反推伪 span 或用 LLM 自动标注来弱化监督,从而扩展到无标注语料。
未来方向
作者指向的方向:把共享压缩程序推广到更多模态与任务(目前限短答案 QA)、改进批评家充分性判断以获得更可靠的停止准则、进一步降低重复检索。基于本文成果可自然延伸:其一,把建树与节点编码前移到索引期,为全库条目离线缓存层级与嵌入(论文只对检索到的条目在线建树),把在线压缩变成查表加比较;其二,把父子相对规则从 B 叉树推广到图——段落间引用、表格与文本的超链接本身构成自然层级,可处理 OTT-QA 式跨条目证据链;其三,成本感知的轮次控制:用批评家 rationale 估计“再检索一轮的期望收益/token 比”动态决定是否继续,替代固定 $R$=3;其四,把批评家蒸馏为小模型或用偏好优化训练充分性判断,降低每题约 3 次 LLM 调用的开销;其五,在小时级连续视频、流式与对话式 RAG 中检验 30 秒叶子假设;其六,把评估从 EM/F1 扩展到忠实度与幻觉率,验证“保留原始区域而非生成摘要”是否真的降低幻觉;其七,研究压缩与阅读器位置偏差(lost in the middle)、上下文缓存的交互,探明保留区域的排序策略。
复现评估
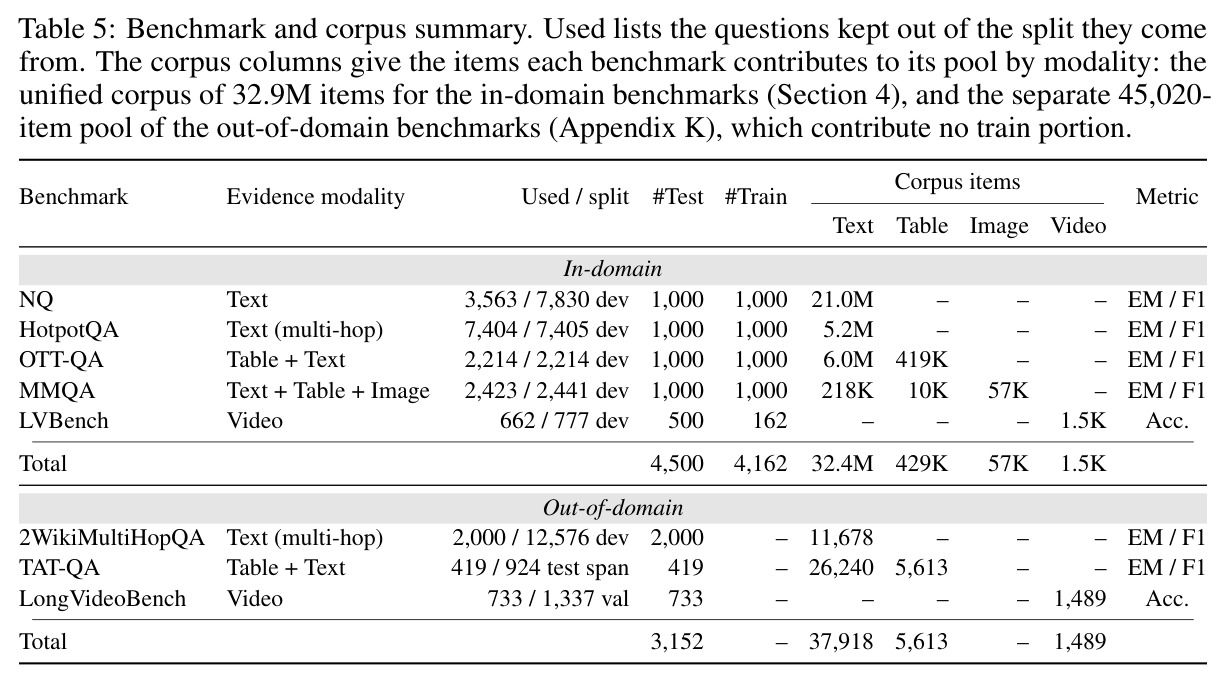
复现条件总体透明。数据全部公开:NQ/HotpotQA/OTT-QA/MMQA 用官方 dev 划分(保留金证据可定位的题目,如 NQ 3,563/7,830),LVBench 用 UniversalRAG 发布的改写版(77 个可用视频、1,529 个预切片,662 题中 500 测试/162 训练),域外 2WikiMultiHopQA、TAT-QA(经 T2-RAGBench 做语境无关改写)、LongVideoBench 构建方式也写明;语料构成与金 span 映射规则逐基准给出(Appendix A)。训练超参完整:18,575 实例、LoRA rank 8/$\alpha$=16/dropout 0.05、$\lambda$=20、AdamW lr $5\times10^{-5}$、批 16、2 epoch,基础模型 Qwen3-VL-Embedding-2B、Qwen3-VL-8B-Instruct、InternVL3.5-8B 均开源;批评家/聚合分类/路由三个 prompt 全文在 Appendix M。算力:推理用 4 张 RTX A6000 48GB 起 vLLM(批 200、32 并发),LoRA 微调 2B 骨干单卡可行。难点在工程量:构建 32.9M 条目的 FAISS 平坦索引需要可观的嵌入计算与存储,基线复现要跑 UniversalRAG、IRCoT、RECOMP、LongLLMLingua、S2G-RAG、AKS 六套系统。论文未明确放出官方代码,仅给项目主页(canopy-project-page.github.io);复现核心方法(单基准+单流水线)难度中等,完整复刻全部实验属中高难度。
论文图表
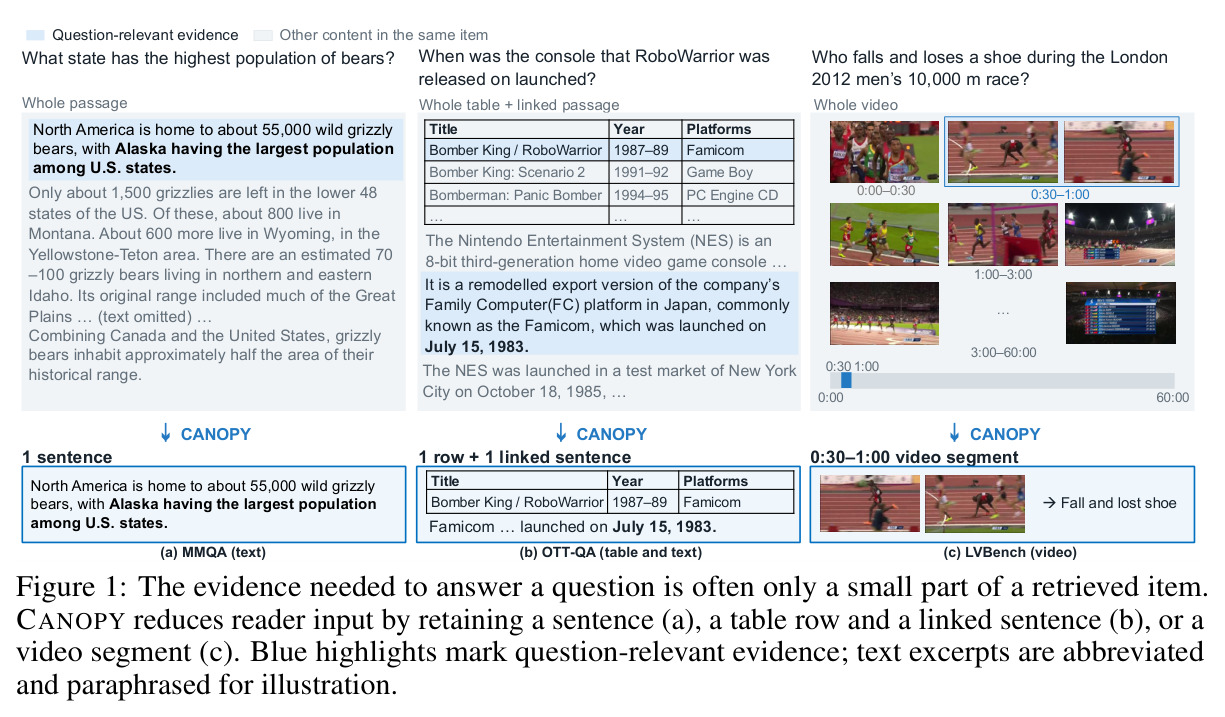
三列对比整条检索结果与 CANOPY 保留的部分:MMQA 文本问题(哪种州灰熊最多)整段只留 1 句;OTT-QA 问题(RoboWarrior 主机何时发布)整表加链接段落只留 1 行加 1 句;LVBench 问题(2012 万米赛谁掉鞋)整段视频只留 0:30–1:00 片段。蓝色标出与问题相关的证据。
全文动机的直观呈现:证明条目内有用的证据只占一小部分,且不同模态所需的粒度不同,是一切设计的出发点。
在各基准自有语料上,CANOPY 与 RECOMP(抽取/摘要两版)、LongLLMLingua、S2G-RAG、AKS 在不同预算下的质量-token 曲线。LongLLMLingua 加大预算饱和后仍低 1.4–16.5 F1;AKS 花 1.5 倍 token 低 2.8 个点;S2G-RAG token 更少但每题 5.6 次 LLM 调用,CANOPY 仅 2.8 次。
展示与模态专属压缩方法的正面对比,凸显 CANOPY“无 LLM 剪枝+迭代检索”独特的成本结构。
直接给定金条目时比较五种策略:整条保留(Gold Item)、只留金片段(Gold Span)、叶级平坦、任意级平坦、CANOPY。CANOPY 在五个基准全部超过两个平坦选择;相对整条保留,LVBench 省 40% token 且准确率持平(56.4 vs 56.2),OTT-QA 省 27.5% token 但 F1 从 70.5 降至 67.8;金片段准确率仅 53.0,说明注释之外的上下文有用。
直接检验“自适应粒度”的价值:既显示剪枝收益的边界,也证明保留上下文比只取金片段更好。
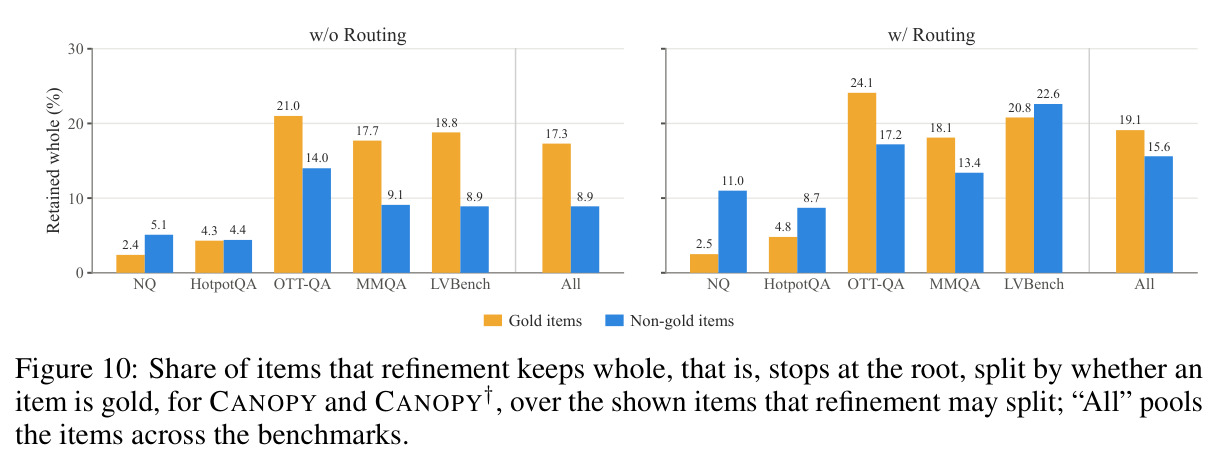
分金/非金条目统计“整条保留(根处即停)”比例:CANOPY 对非金条目 8.9%、金条目 17.3% 整条保留(CANOPY† 为 15.6%/19.1%),说明细化并非只对支持答案的条目手下留情,非金条目同样被大幅剪枝,但金条目也更常被整体保留。
支撑“压缩省 token 主要靠剪非金条目”的机制理解,同时展示细化的判别力边界。
主结果表:两个阅读器(Qwen3-VL-8B-Instruct / InternVL3.5-8B)× 六种方法 × 五基准,报告 EM/F1、#Tok、时延与 LLM 调用次数。CANOPY(Qwen3-VL)平均 39.4 最佳:NQ 39.7/54.4、HotpotQA 49.6/62.1、OTT-QA 27.7/33.4、MMQA 45.1/51.1、LVBench 35.0;每题 3.0 次 LLM 调用、0.28–0.93 秒,token 与 Vanilla RAG 相当而远低于 UniversalRAG/IRCoT。
论文最核心的证据:质量、token、时延、调用次数四维全景对比,一切结论的数字来源。
$B\in\{2,3,4\}$ 与 $k\in\{5,10,20\}$ 的敏感性:$B$ 增大质量变化很小(最大为 OTT-QA EM 27.7→25.8),token 略变;$k$ 从 5 到 20 token 涨 2–4 倍而 EM 变化 ≤2.8,LVBench 在 $k$=10 后不再提升。支撑 $B$=2、$k$=10 的默认选择。
展示方法对超参的稳健性,说明默认配置并非精调出来的脆弱点。