生物推理模型对生物输入的真实使用评估 When Do Biological Reasoning Models Use Their Biological Inputs?
用扰动、证据冲突、探针和推理链审计六个生物推理模型,发现它们常依赖文本而非基础模型表征。
前置知识
生物基础模型(Evo2 / ESM3 / Nucleotide Transformer)
在海量 DNA、蛋白质序列或单细胞转录组上自监督预训练的编码器:Evo2 处理基因组序列,ESM3/ESM2 处理蛋白质,Nucleotide Transformer 处理核酸。它们把一段序列或一个细胞压缩成连续向量表征 $Z_{\text{repr}}$,供下游 LLM 经投影层接入。
本文所有实验的对象就是这些表征:扰动的是表征、冲突的是表征与文本、探针也是训练在表征上。不理解基础模型是什么,就无法理解'表征有没有被用'这一核心问题。
后训练(SFT 与 RL)
SFT(监督微调)用带答案和思维链的标注样本继续训练基座模型;RL(强化学习)用可验证答案的奖励信号进一步优化。BioReason 和 BioReason-Pro 都发布 SFT 与 RL 两类 checkpoint,本文还使用了 42 个不同规模、LoRA rank 和 RL 时长的 BioReason 重训 checkpoint。
研究问题 RQ2 的全部内容就是比较 SFT/RL checkpoint:RL 抬高了基准准确率,却没有提高对基础模型表征的依赖,说明'更准'与'更会用输入'是两个独立的量。
线性探针(Linear probe)
冻结表征,只在其上训练一个线性分类器来预测目标标签。若简单线性模型就能从 $Z_{\text{repr}}$ 预测任务标签,说明信息已编码在表征中;但这不代表模型行为上真的使用了它。探针准确率与模型实际使用是两个必须分开检验的命题。
Finding 1 的关键证据:Evo2/ESM3 表征'贡献很小',但探针证明目标可从表征预测,从而排除'表征没有信息'的替代解释,把问题锁定在'模型不用'上。
单细胞转录组与差异表达基因(DEG)
单细胞测序给出单个细胞中各基因的表达量向量;DEG 是某细胞类型相对其他类型显著差异表达的基因,常用作细胞标记。C2S-Scale 把表达谱写成按表达量排序的基因句子(gene sentence)输入 LLM,CellWhisperer 则用连续转录组表征。
理解单细胞部分实验(Fig. 2e,f、Fig. 5、Fig. 7d)的前提:删除 DEG、打乱基因顺序、置换 counts 都是对表达信息的因果干预,rationale 中 DEG 精度也是核心指标。
GO 本体与 Fmax
Gene Ontology 用受控词表(分子功能、生物过程、细胞组分)描述基因与蛋白功能,带实验证据的 NOT 注释可表明某蛋白确定不具备某功能。蛋白功能预测的标准指标是精确率-召回率曲线上的最大 $F_1$ 值(Fmax),评估的是预测 GO 术语集合的质量。
BioReason-Pro 的任务就是预测 GO 集合,论文用 Fmax 衡量其对 ESM3 表征的敏感度,并用 GO NOT 对构造天然的负对照证据冲突。
推理链忠实性(Faithfulness)
思维链只是模型输出的一部分,可能是事后编造的合理叙述,而非真正影响预测的计算路径。评估忠实性需要检验推理内容是否与输入证据一致、是否响应输入扰动、是否与最终答案自洽。
RQ3 整章都在做这件事:BioReason 把每个变体都说成 T>C、BioReason-Pro 在推理中描述了最终 GO 集合里不存在的功能,都是典型的推理链与输入/答案脱节。
研究动机
生物推理模型把 LLM 与两类生物输入拼接:生物基础模型输出的连续表征 $Z_{\text{repr}}$(来自 Evo2、ESM3、ESM2、Nucleotide Transformer 等)和生物文本 $Z_{\text{text}}$(基因/通路描述、GO 与 InterPro 功能注释、基因列表等)。社区习惯用基准准确率证明'模型能对生物输入做推理',但同一个基因组、蛋白或细胞往往同时有多个表征来源,信息高度重叠——功能注释文本本身就常常足以支撑正确答案,序列表征可能根本没被读取。基准分数无法区分三种解释:该输入没有预测价值、其信息被其他输入冗余覆盖、或模型确实没有使用有预测价值的输入。这带来实际风险:为每个查询跑一次 Evo2/ESM3 前向、训练投影层、维护多模态训练管线,如果模型实际只读文本,整套多模态架构就是昂贵且无效的装饰,还会让人高估模型对序列和表达数据的理解能力。
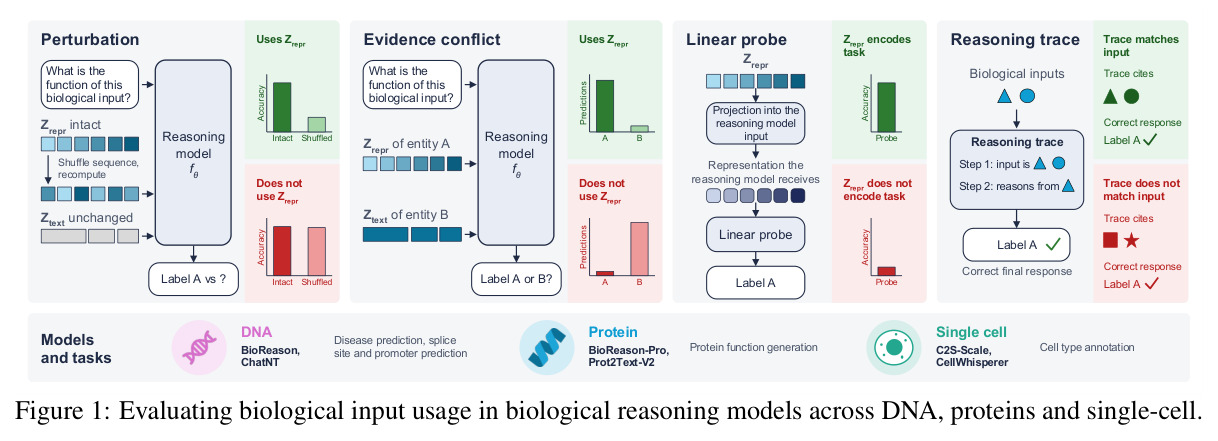
本文的目标是作者要建立一套系统的输入使用审计框架,对每个生物输入逐一定判定:模型的预测是否真的依赖于该输入中任务相关的内容,并回答四个研究问题。RQ1:扰动输入的任务相关生物内容是否会改变预测与性能;当扰动无效时,输入是否至少编码了目标。RQ2:后训练(SFT/RL)或扩大规模带来的准确率提升,是否伴随对生物输入更大的性能贡献。RQ3:生成的推理链与要求模型给出的解释,是否如实反映输入证据并与最终预测一致。RQ4:加入要求模型预测输入内容的辅助监督目标,能否提高模型对该输入的利用并迁移到主任务。核心概念区分是'可预测性'(表征里编码了目标)与'使用'(模型行为依赖表征)。
与已有工作不同的是,视觉-语言领域早有针对语言先验、视觉内容不敏感的反事实评估工作,probing 文献也已指出探针准确率不等于任务相关性,但生物推理模型领域此前只有 Fesser et al. (2026) 研究后训练本身,尚无工作系统回答'哪个输入被使用'。本文的独特切入点有三:其一,利用生物对象多重表征天然冗余的结构,设计证据冲突(evidence conflict)——把实体 A 的表征与实体 B 的文本拼进同一 prompt——这比 shuffle 序列(可能产生分布外输入)更干净地量化模型'听谁的';其二,用线性探针与简单基线排除'表征本来就没信息'的解释,把'不用'与'没用'分开;其三,借助 42 个公开的 BioReason post-training checkpoint,把'准确率提升是否意味着表征贡献提升'变成可在训练轨迹上检验的可证伪命题。扰动、冲突、探针、推理链四位一体的组合在该领域是首次。
核心方法
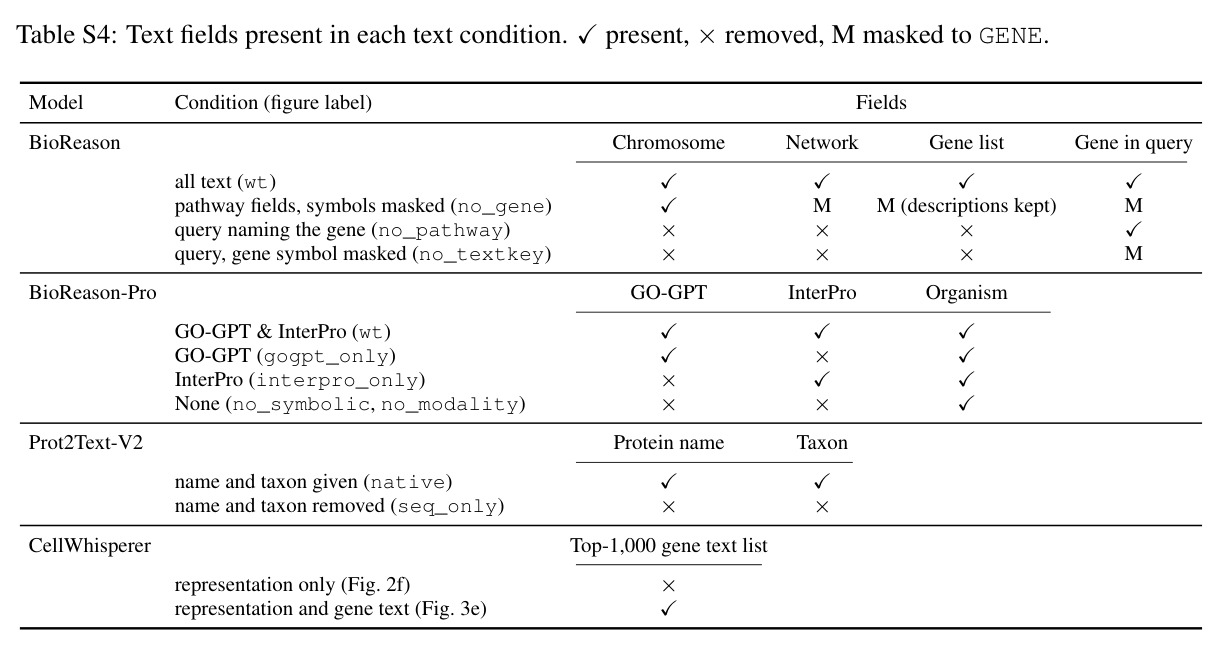
直觉上,判断模型是否使用某个输入 $Z_i$,最直接的办法是只改变 $Z_i$ 中任务相关的内容,看答案是否随之改变。作者把问题形式化:模型 $f_\theta$ 接收文本查询 $q$(指定任务与输出格式)和生物输入 $Z = (Z_{\text{repr}}, Z_{\text{text}})$,输出预测和(可选的)推理链 $(\hat{y}, \hat{R}) = f_\theta(q, Z)$。审计由四个互补测试组成:(1)Perturbation:打乱、删除或重采样 $Z_i$ 的任务相关内容而保持 $q$ 与其余输入 $Z_{-i}$ 不变,比较准确率与答案变化;(2)Evidence conflict:将两个不同实体的输入拼进同一 prompt 使其支持不同答案,统计预测跟随哪一方;(3)Linear probe:当扰动影响很小时,用线性探针或多数类基线检验 $Z_i$ 是否本可预测目标,区分'信息不在表征里'与'有信息但模型不用';(4)Reasoning trace:检验推理链中的生物学陈述是否与输入一致、是否响应扰动、是否与最终预测自洽。测试覆盖 DNA(BioReason、ChatNT)、蛋白质(BioReason-Pro、Prot2Text-V2)、单细胞(C2S-Scale 2B/27B、CellWhisperer)三个模态共六个模型。
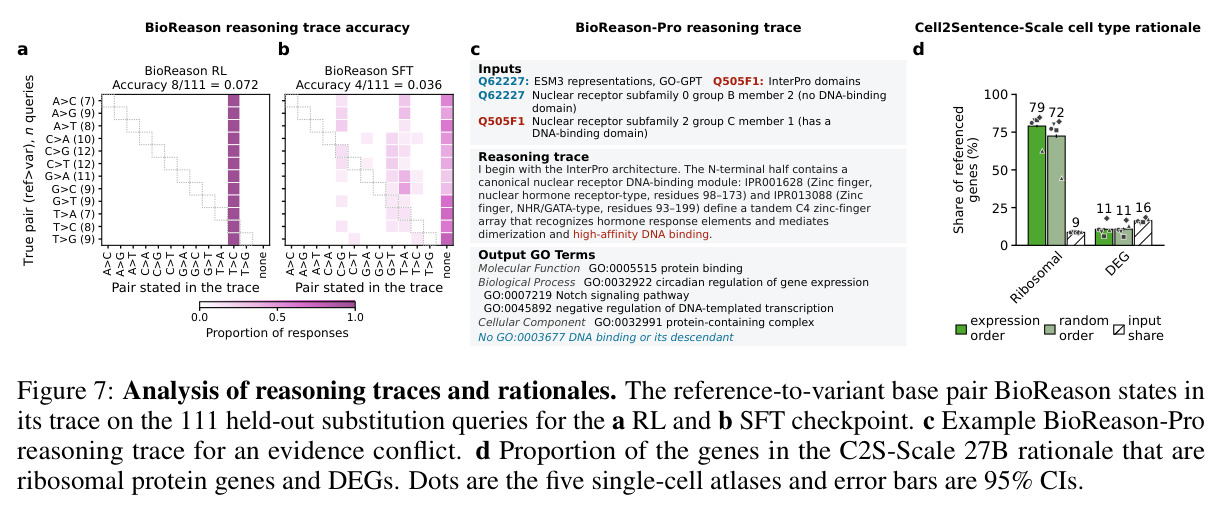
核心创新是把'基准准确率'与'输入性能贡献'解耦,并给出可操作的判定准则:当简单预测基线(多数类查询表或线性探针)能从 $Z_i$ 预测任务目标,但对 $Z_i$ 的任务相关内容做扰动后推理模型性能几乎不变(在尽可能控制 $Z_{-i}$ 预测信息的前提下),则称 $Z_i$ 被 underutilized。与以往 probing 研究只回答'表征里有没有信息'不同,本文把行为扰动与表征探针配对,直接回答'模型行为上用没用';与 VLM 的反事实评估不同,这里利用了同一生物对象具有多种独立来源表征(序列编码器输出 vs 人工整理文本)这一领域特有结构,证据冲突给出源偏好的直接量化(如 97.9% 跟随文本)。推理链审计进一步把可解释性研究与输入归因连接:如果链中连变体碱基都说错(对所有输入都声称 T>C),说明链只是模板复述而非证据推理。
方法步骤详情
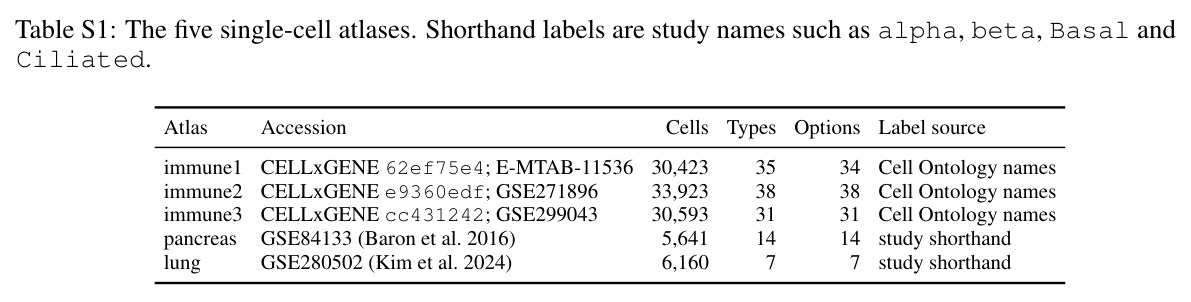
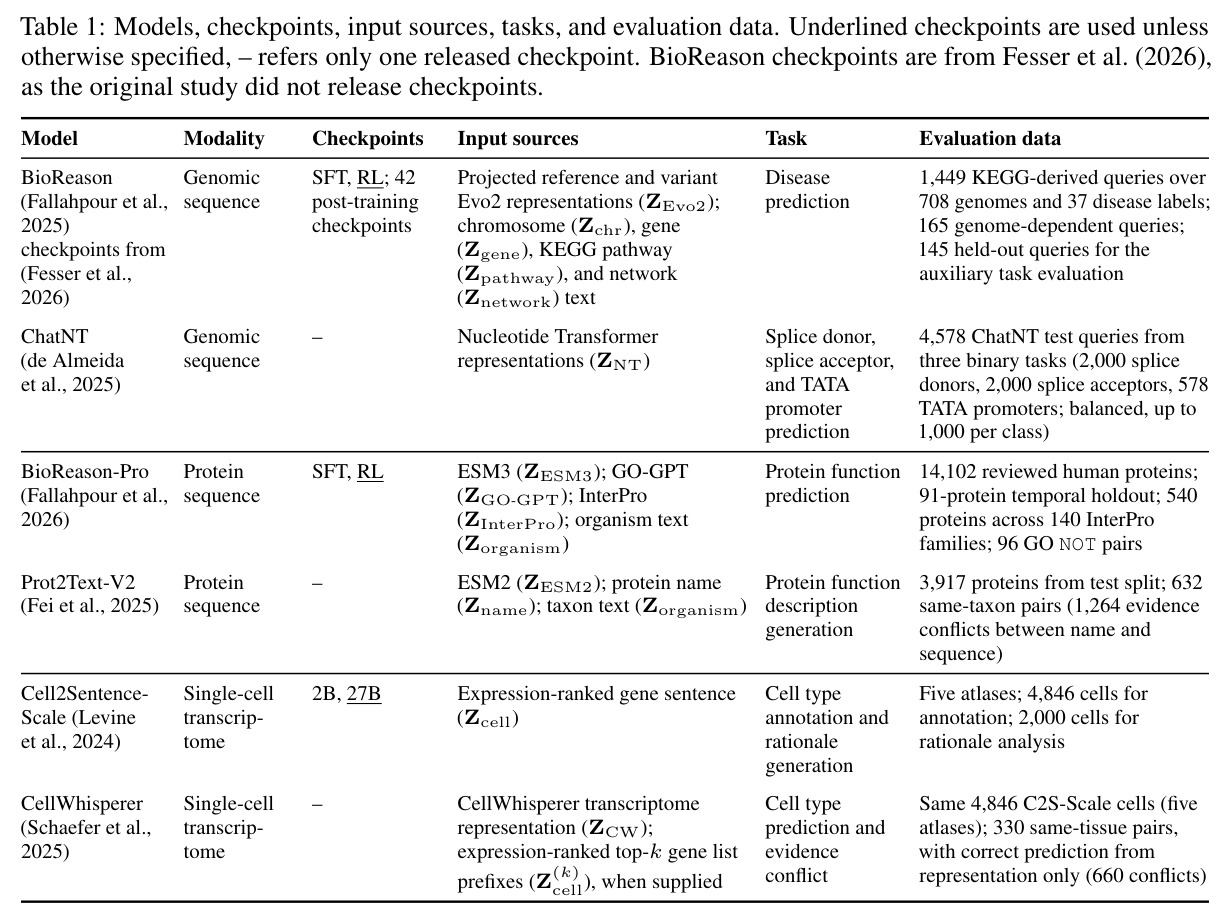
第一步,收集各模型原生评测集:BioReason 用 1,449 条 KEGG 疾病查询(708 对参考/变体基因组、37 个疾病标签)加 165 条基因组依赖查询与 145 条 holdout;ChatNT 用其自带的剪接供体/受体和 TATA 启动子二分类测试集共 4,578 条;BioReason-Pro 用 14,102 条 reviewed 人类蛋白(另有 91 条 2026-03-20 之后注释的时间 holdout、540 条跨 140 个 InterPro 家族的蛋白、96 个 GO NOT 对);Prot2Text-V2 用官方测试集 3,917 条;C2S-Scale 与 CellWhisperer 共用五个单细胞图谱的 4,846 个细胞。第二步,构造扰动输入:把 DNA/蛋白序列打乱后重新过 Evo2/ESM3 得到扰动表征 $Z_{\text{repr}}'$;基因句做顺序打乱、全基因组重采样、按 DEG 强弱分层删除(0–100%);CellWhisperer 在细胞内跨基因置换 counts 后重算表征。第三步,证据冲突:从原始查询出发,将实体 A 的 $Z_{\text{repr}}$ 与实体 B 的 $Z_{\text{text}}$(或反之)拼进同一 prompt,统计预测与 A、B 或两者皆不符的比例。第四步,线性探针:在基础模型 mean-pooled 输出与投影后表征上分别训练线性分类器,DNA 侧在 165 条基因组依赖查询上比较疾病预测准确率,蛋白侧在 140 个 InterPro 家族上对酶活性、细胞器定位、DNA 结合三个属性计算 per-family AUROC。第五步,推理链分析:BioReason 在 145 条 holdout 查询上核对链中声称的参考→变体碱基对;BioReason-Pro 在 53 条功能冲突上核对链中功能描述与最终 GO 集合;对 C2S-Scale 27B 在 2,000 个细胞上统计 rationale 引用基因的 DEG 精度与核糖体基因占比。第六步,辅助监督实验:把 BioReason 训练目标替换为'答案+编辑位置的参考/变体碱基',用 257 bp 与 2,048 bp 两种窗口、各三个训练种子重训,检验编辑碱基预测准确率、对 shuffle 的响应,以及在已见/未见基因组上的泛化。
技术新颖性
单看每个工具——序列打乱、线性探针、反事实冲突——都不新,贡献在于把它们组装成针对'多重生物表征冗余'这一领域特有结构的因果审计协议,并首次在六个真实发布的生物推理模型上系统执行。几个设计点尤其值得注意:其一,证据冲突刻意只使用未修改的查询和来自两个真实实体的输入,避免 shuffle 带来的分布外问题,两种手段结论一致时才下结论;其二,探针同时训练在基础模型原始输出和经过投影层之后的 $Z_{\text{repr}}$ 上,排除了'信息是投影层丢掉的'这一疑问(两个位置探针性能几乎相同,如 0.736 vs 0.735);其三,42 个开源 post-training checkpoint(不同模型规模、SFT/RL LoRA rank、RL 时长)使'准确率提升 $\Rightarrow$ 表征贡献提升'成为一个在训练轨迹上被系统证伪的命题;其四,利用 GO NOT 实验注释(有实验证据表明某蛋白不含某功能)构造天然负对照对,验证冲突结论不依赖人工构造方式;其五,辅助监督实验给出了一个干预性验证:显式要求模型从 $Z_{\text{repr}}$ 预测内容,确实能使其对表征敏感,但泛化受限,这个负面结果同样有信息量。协议已在 GitHub(mims-harvard/bio-mirage)开源。
实验结果
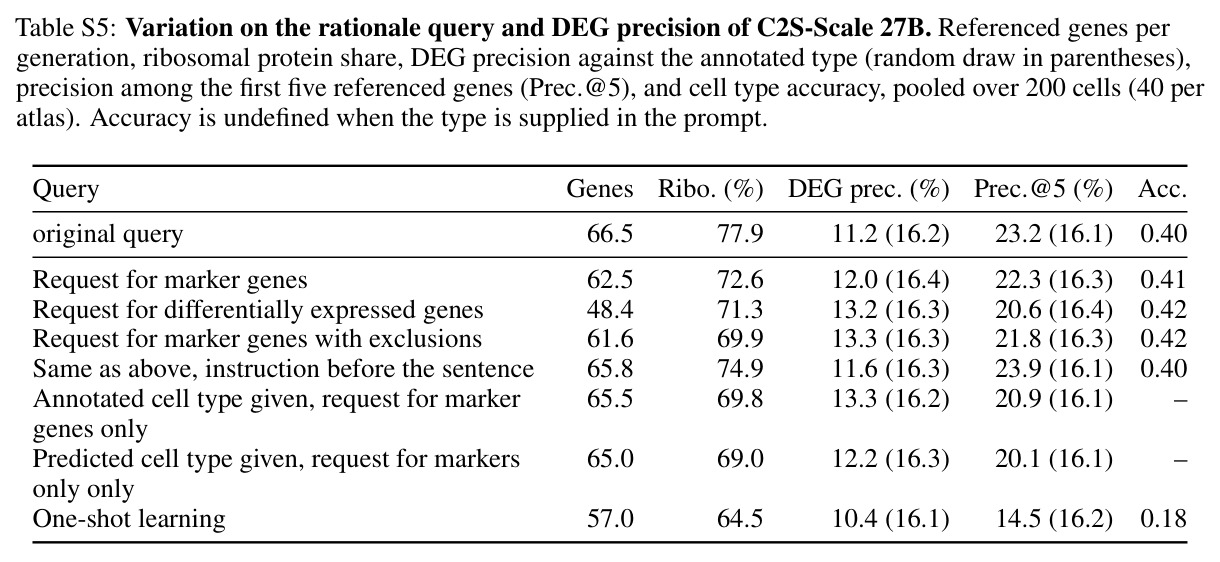
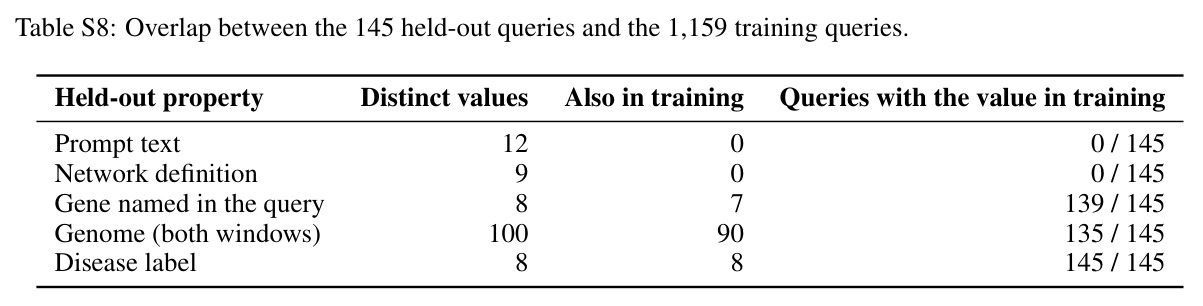
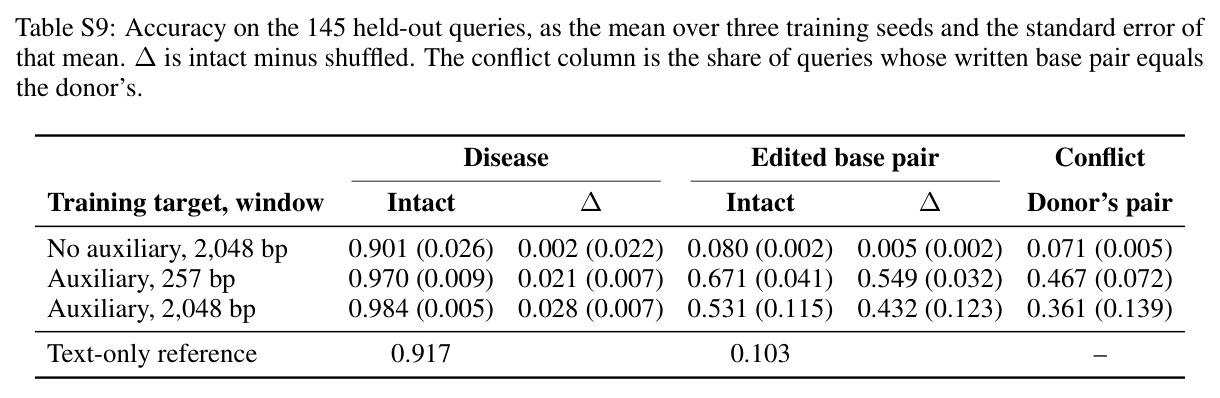
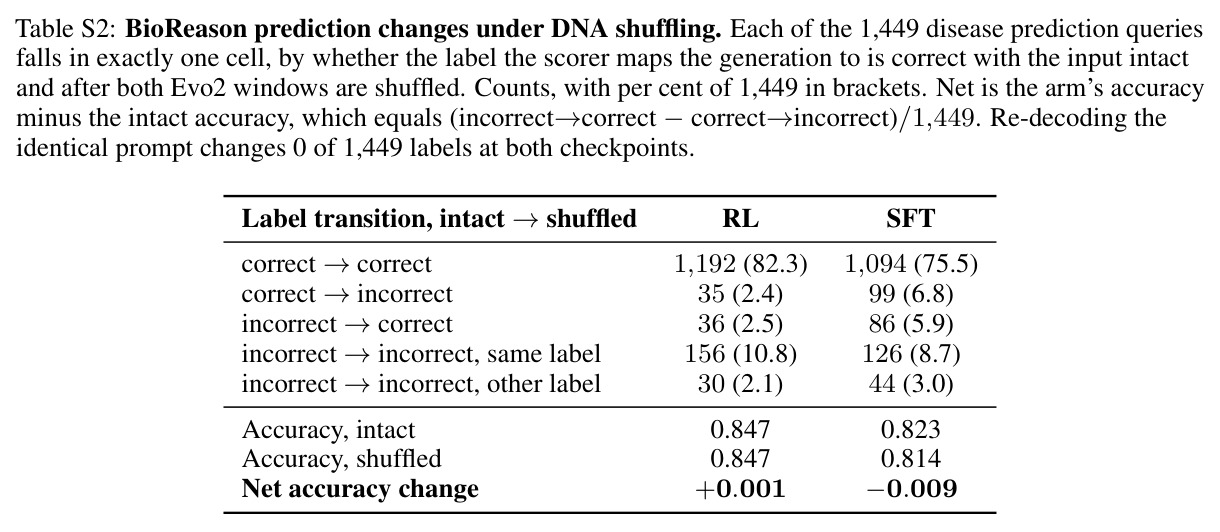
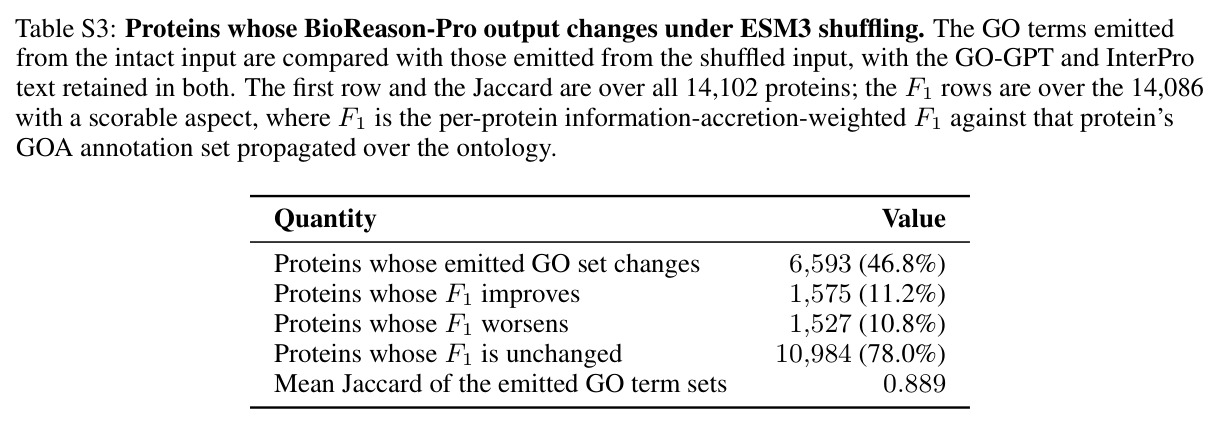
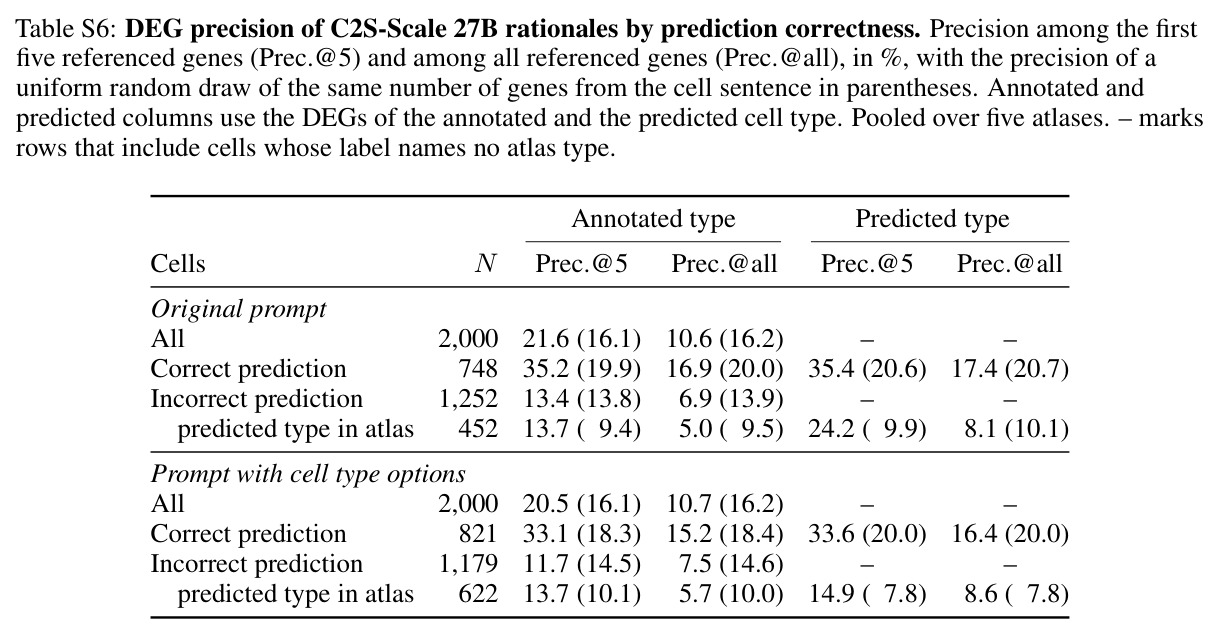
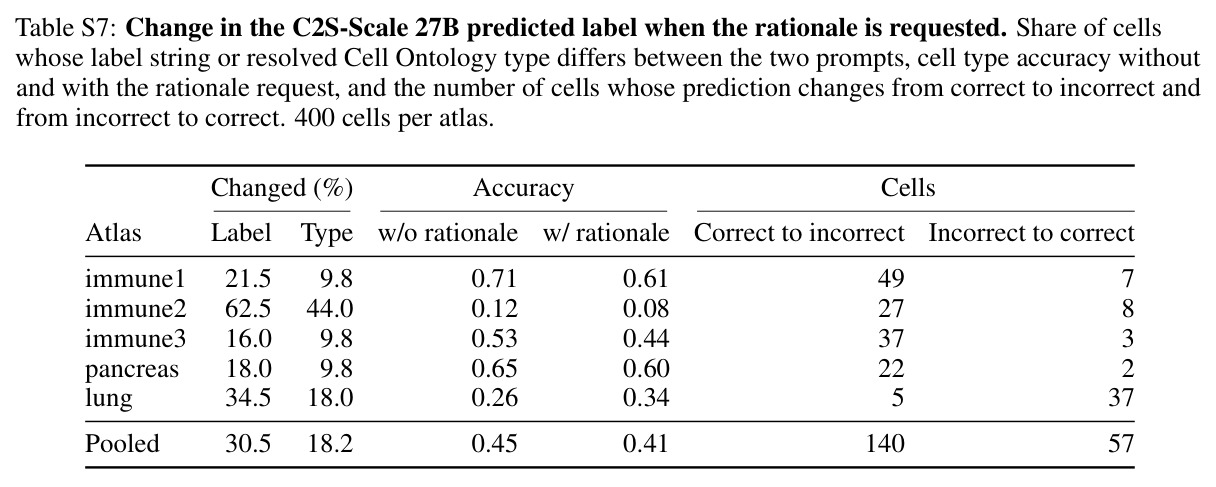
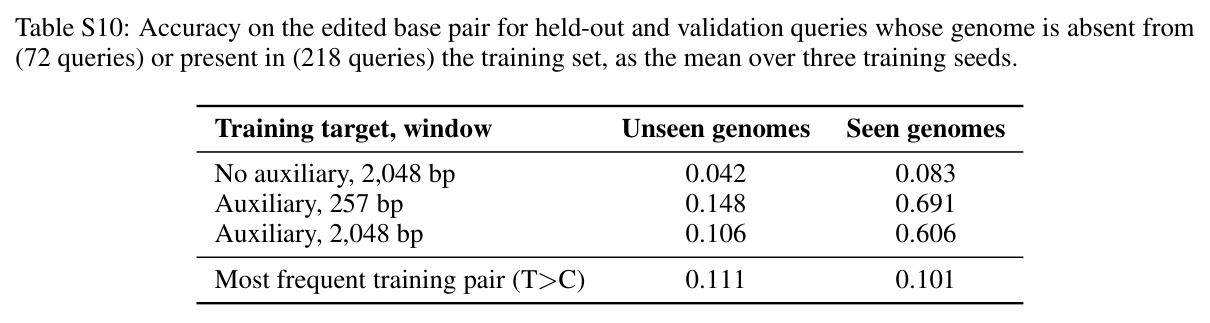
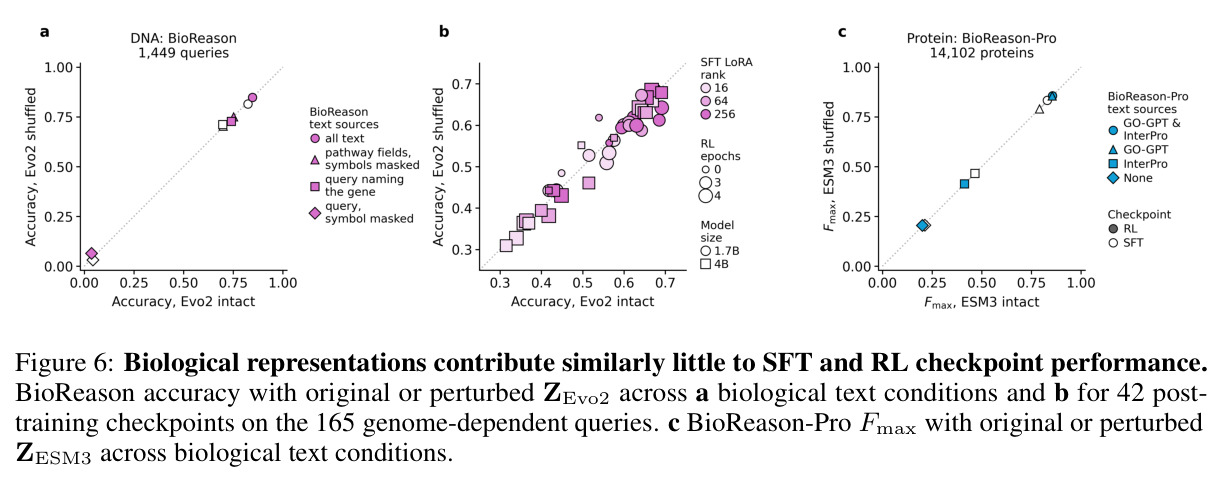
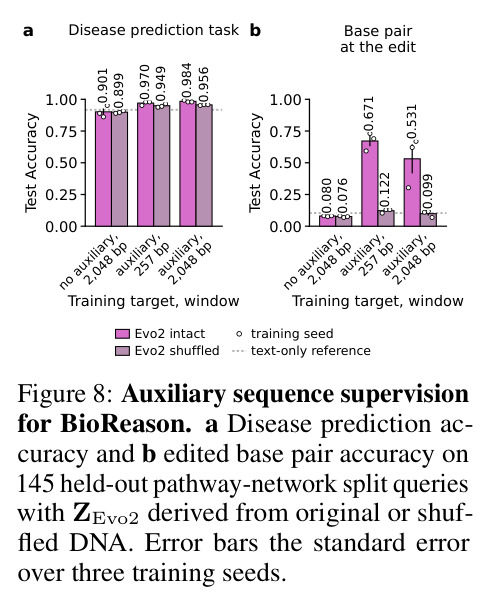
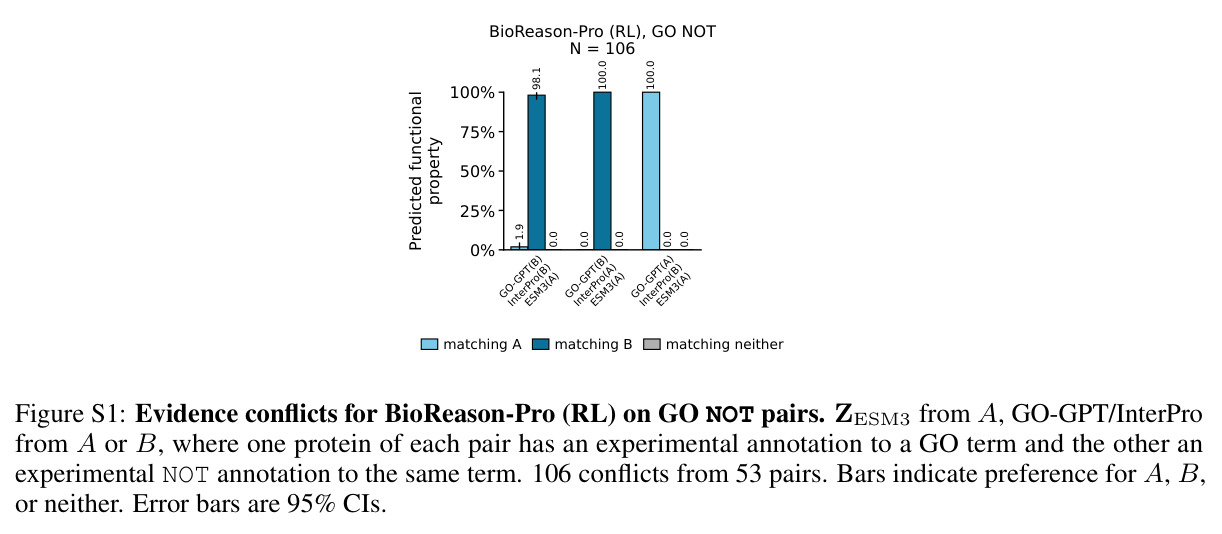
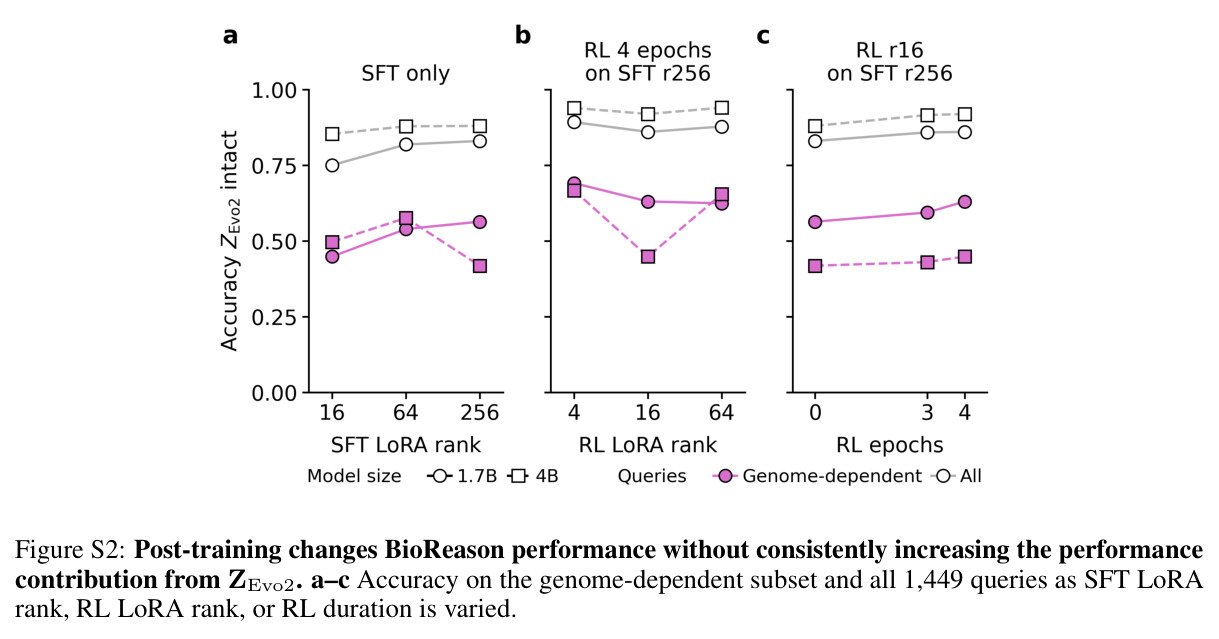
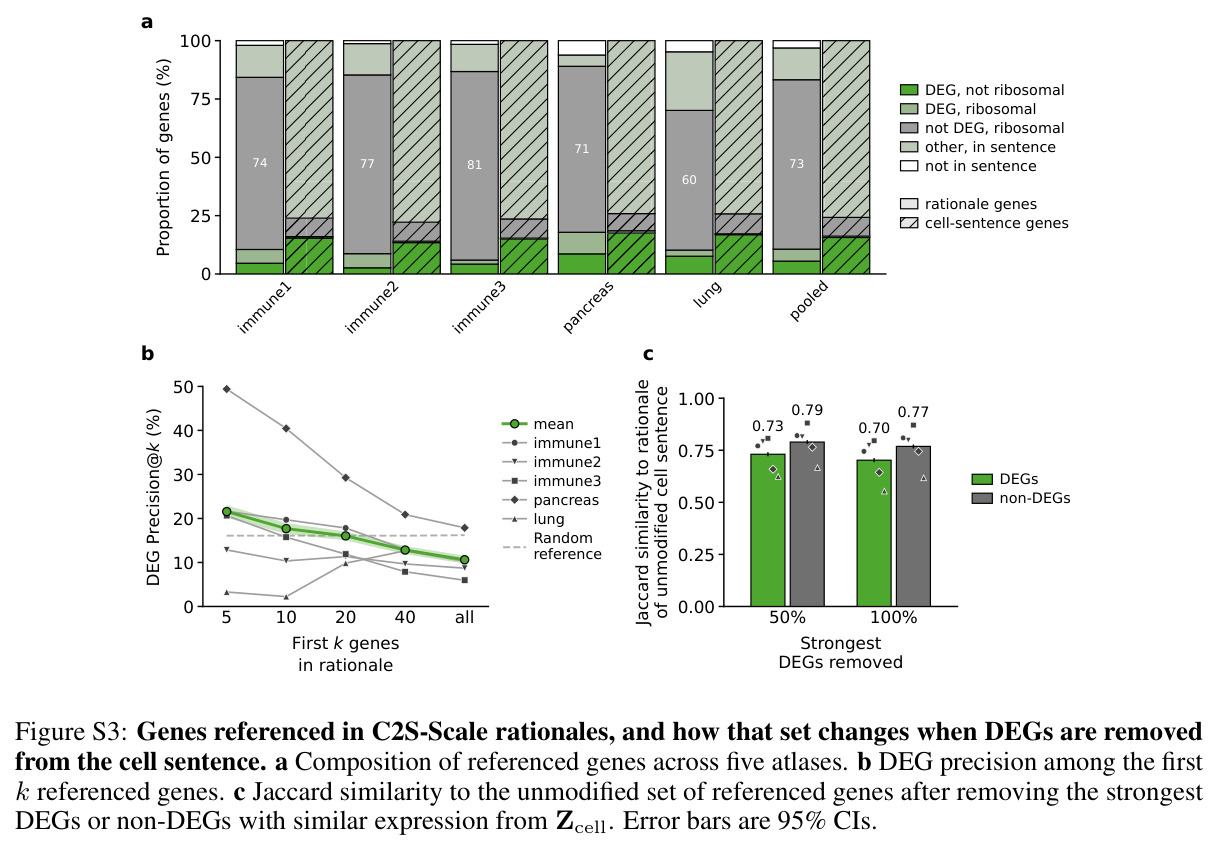
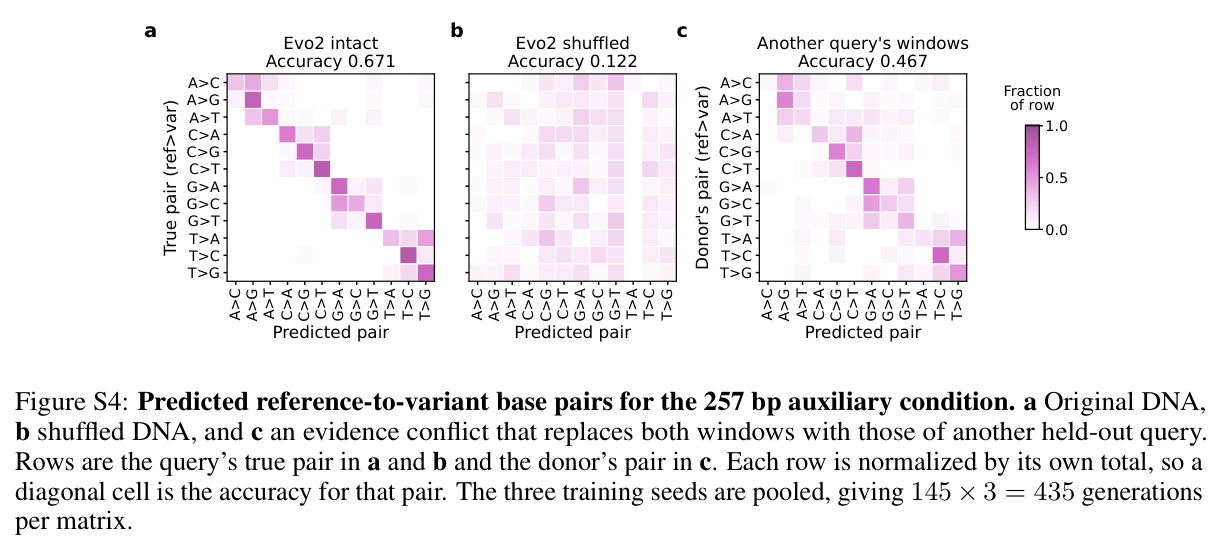
RQ1(输入是否被使用):BioReason 打乱 DNA 后疾病预测准确率几乎不变(0.847 vs 0.847),仅 101/1,449(7.0%)条答案改变,证据冲突中 97.9% 跟随基因/通路文本;BioReason-Pro 用打乱序列重算的 ESM3 表征,14,102 条蛋白上 Fmax 仅从 0.855 变到 0.856,时间 holdout 上 0.685 vs 0.682,冲突中 99.7% 跟随 GO-GPT 文本(106 个 GO NOT 对上仍 98.1%)。相反,ChatNT 对 DNA 高度敏感:打乱后剪接供体 0.988→0.502、剪接受体 0.987→0.502、TATA 启动子 0.971→0.577;Prot2Text-V2 去掉蛋白名与物种文本后 BioBERT BERTScore F1 下降 0.177,冲突中 97.0% 跟随序列;C2S-Scale 27B 基因句打乱后准确率 0.446→0.351;CellWhisperer 置换 counts 后 $1-$困惑度分位从 0.98→0.53(immune1)、0.84→0.25(lung),冲突中 96.1% 跟随表征。探针证明信息确实存在:165 条基因组依赖查询上 Evo2 输出探针 0.736、投影后 0.735,均高于 text-only 的 0.708(PRNP 相关的 98 条上探针达 0.855);ESM3 探针对酶活性/细胞器定位/DNA 结合的 per-family AUROC 达 0.766/0.898/0.830,DNA 结合上甚至高于 BioReason-Pro 本身的 0.736。RQ2(后训练):BioReason RL 准确率高于 SFT(0.847 vs 0.823)但对 $Z_{\text{Evo2}}$ 的敏感度相同(RL 0.847 vs 0.847,SFT 0.823 vs 0.814);42 个 checkpoint 上准确率变化与表征优势无线性关系;C2S-Scale 从 2B 到 27B,准确率 0.366→0.446,100% 删除最强 DEG 后 2B 得 0.140 vs 匹配非 DEG 的 0.363(差 0.223),27B 得 0.127 vs 0.446(差 0.319),是唯一规模增长带来更大表征贡献的案例。RQ3(推理链):BioReason RL/SFT 在 145 条 holdout 上仅 7.2%/3.6% 说对碱基替换,RL 在全部 145 条(含 shuffle 输入)上都声称 T>C;BioReason-Pro 在 53 条冲突中 23 条先用文字描述了来自 B 的功能(如'DNA 识别模块')却最终输出不含 DNA binding 的 GO 集合;C2S-Scale rationale 平均引用 63.4–67.8 个基因,其中 62.6–84.7% 是核糖体蛋白基因,全体引用的 DEG 精度仅 10.63%(低于随机),只有前五个引用有标记富集,452 条错误注释中前几位引用对'预测类型'DEG 的精度仍有 24.2% vs 9.9%,且要求 rationale 使池化准确率从 0.45 降到 0.41。RQ4(辅助监督):加入编辑碱基预测目标后,257 bp 模型的编辑碱基对准确率从 0.080 提到 0.671(shuffle 后降至 0.122),2,048 bp 为 0.531/0.099;但 145 条 holdout 中 135 条的基因组在训练中出现过——已见基因组 218 条上 0.691/0.606,未见 72 条上仅 0.148/0.106(多数类基线 0.111),且疾病预测准确率在 shuffle 下依旧几乎不变。
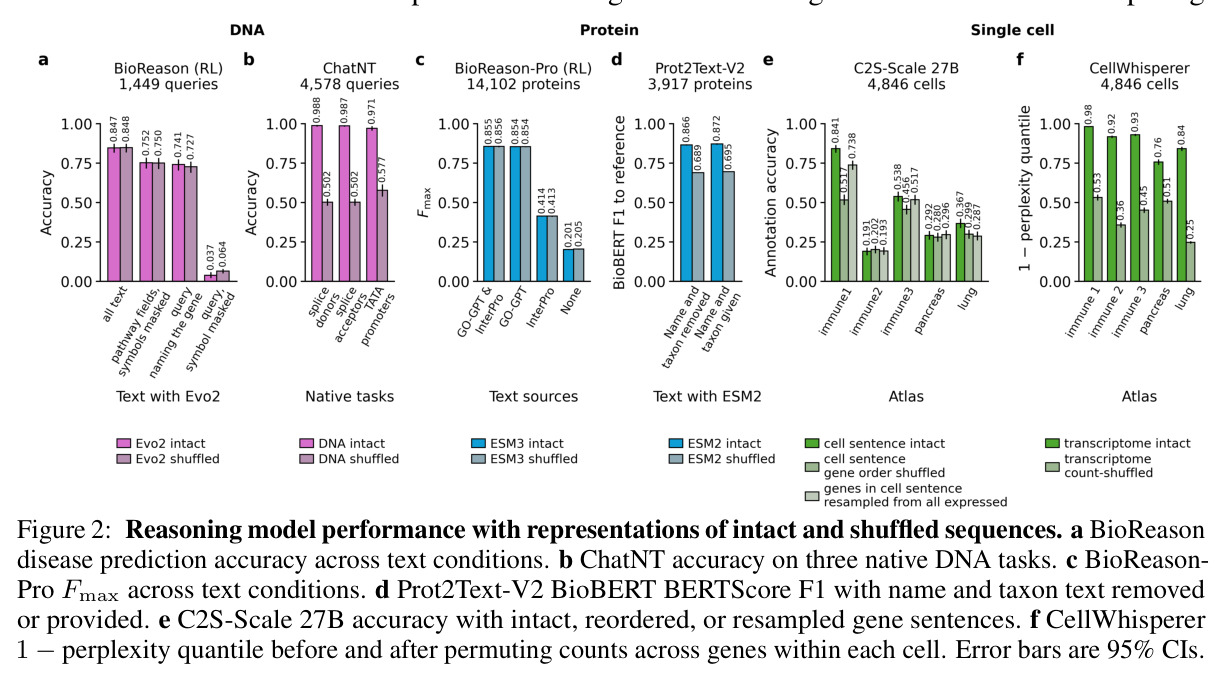
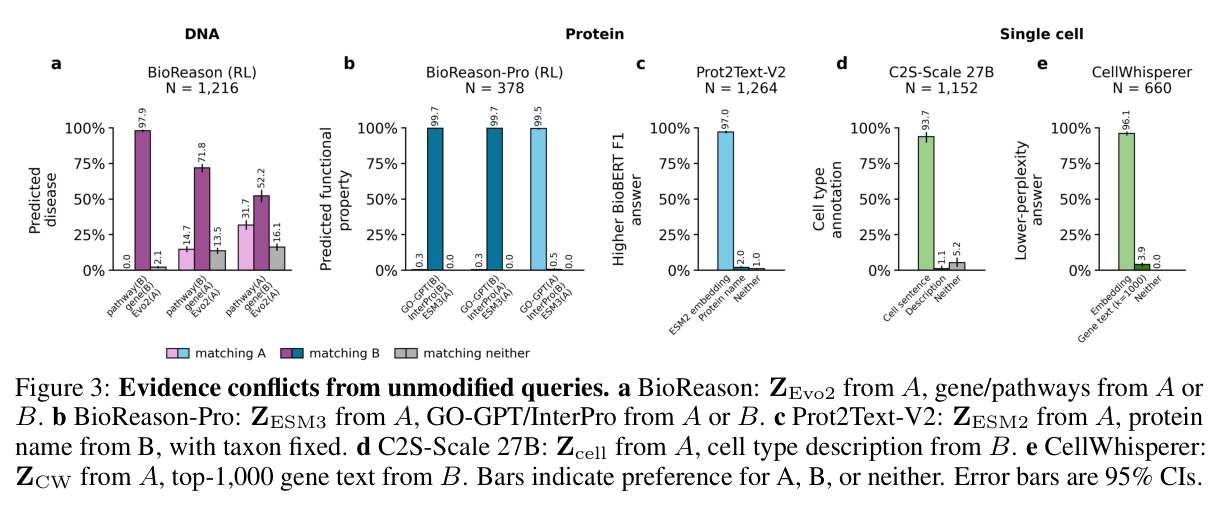
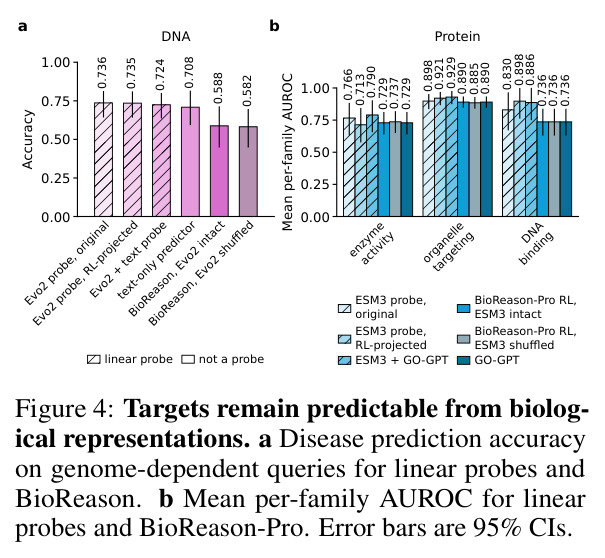
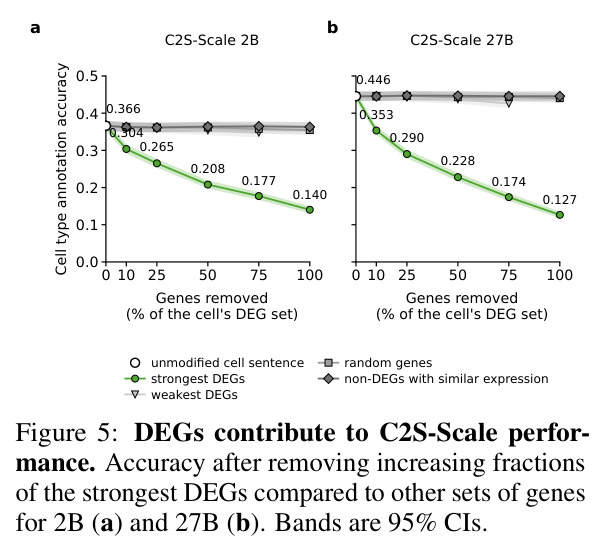
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| BioReason 疾病预测(1,449 条 KEGG 查询) | accuracy | 0.847(原始 $Z_{\text{Evo2}}$)/ 0.847(打乱 DNA 后重算) | SFT checkpoint 0.823 / 0.814;text-only 探针 0.708;Evo2 探针 0.736 | 打乱表征后性能变化为 0,表明 $Z_{\text{Evo2}}$ 贡献极小;RL 相对 SFT 提升 +0.024 但表征贡献未变 |
| ChatNT 剪接供体/剪接受体/TATA 启动子(4,578 条) | accuracy | 原始表征下 0.988 / 0.987 / 0.971 | 打乱 DNA 表征后 0.502 / 0.502 / 0.577 | 下降 0.39–0.49,DNA 表征贡献巨大(对照 BioReason 的 0 变化) |
| BioReason-Pro 蛋白功能预测(14,102 条 reviewed 人类蛋白) | Fmax | RL 0.855(原始 $Z_{\text{ESM3}}$)/ 0.856(打乱序列表征);时间 holdout 0.685 / 0.682 | SFT 0.829 / 0.833;ESM3 探针 per-family AUROC 0.766/0.898/0.830 | 约 0;RL 相对 SFT +0.026 但表征贡献不变;GO NOT 对冲突中 98.1% 跟随文本 |
| Prot2Text-V2 蛋白功能描述生成(3,917 条) | BioBERT BERTScore F1 | 提供 ESM2 表征时显著更高;证据冲突中 97.0% 跟随序列而非蛋白名 | 移除蛋白名与物种文本后 F1 下降 0.177 | ESM2 表征有明确性能贡献,与 BioReason-Pro 形成鲜明对比 |
| C2S-Scale 细胞类型注释(五图谱 4,846 细胞) | accuracy | 27B:0.446(完整基因句);打乱基因顺序 0.351;重采样基因 0.406;删除 100% 最强 DEG 后 0.127 | 删除等量表达匹配的非 DEG 后 0.446;2B 模型对应 0.140 vs 0.363 | DEG 专属差 27B 为 0.319、2B 为 0.223,规模扩大同时提高了准确率与 DEG 贡献 |
| CellWhisperer 细胞类型(同一批 4,846 细胞) | 1−perplexity 分位 | 原始表征下 immune1 0.98、lung 0.84;冲突中 96.1% 给表征支持的答案更低困惑度 | 细胞内跨基因置换 counts 并重算表征后降至 0.53、0.25 | 转录组表征贡献显著 |
| BioReason 辅助碱基监督(145 条 holdout pathway-network 查询) | 编辑碱基对 accuracy | 257 bp 辅助模型 0.671(intact)/ 0.122(shuffled);无辅助 0.080 | 多数类基线(最频训练碱基对)0.111;未见基因组上辅助模型仅 0.148 / 0.106 | 辅助监督使编辑碱基预测对表征敏感,但提升集中在训练见过的基因组 |
局限与改进
作者承认的局限:只评估了六个模型的特定任务与输入组合,结论未必推广到其他架构或生物模态;部分分析依赖序列打乱,可能把表征推出自然序列分布(尽管用未修改输入构造的证据冲突支持相同结论);线性探针只能证明目标可从表征预测,不能说明 LLM 如何在内部利用表征。我的补充观察:其一,'打乱后准确率不变'的判定对任务标签结构敏感——BioReason 的疾病标签在通路文本中几乎都有线索,而 ChatNT 的二元任务天然依赖序列,任务性质差异使六个模型间的横向比较需谨慎;其二,基因组依赖查询只有 165 条且 PRNP 一个基因就占 98 条,DNA 探针优势的样本基础偏窄;其三,论文未做'将表征置零/删除'这一更直接的对照(部分架构上做不到,但置零投影输出是可行的),置零与打乱的效果差值得补充;其四,RQ4 的辅助监督只在一个模型一个任务上尝试,且 257/2,048 bp 窗口与原任务输入长度之间的交互未被拆分;其五,未见基因组上编辑碱基预测失败说明学到的仍是记忆而非序列推理,但作者未尝试基因组级数据划分增强等修复手段。
独立分析的弱点
第一,对 BioReason/BioReason-Pro '零使用'的直接补救(表征输入 dropout、表征-文本一致性对比目标、在 SFT 数据中加入冲突样本强迫模型分辨来源)论文完全未实验验证,只在展望中提到 RL 奖励正确使用输入的可能——这是可以立即跑通的下一步。第二,证据冲突只统计'最终跟随谁'这一二元结果,没有量化部分采纳或加权融合的中间状态;CellWhisperer 用困惑度做软度量的做法可以推广到其他模型的 token 级 logit 分析,得到更细的证据加权曲线。第三,C2S-Scale rationale 过度引用核糖体基因暴露了 gene sentence 表示本身的偏置(高表达基因总排在句首),改进方向包括按 DEG 归一化排序、混合连续表征、或在 rationale 训练数据中抑制高频基因模板。第四,审计基本是发布 checkpoint 上的黑盒扰动,缺少对投影层与注意力流的白盒分析(表征信息在第几层被文本信号覆盖),这能区分'投影即丢弃'与'逐层被淹没'两种机制。第五,任务覆盖偏窄:疾病预测本质接近'基因→疾病'查询表,天然存在文本捷径,缺少必须依赖序列才能解决的任务设计(如定量变体效应预测),这可能系统性低估表征能带来的性能上限。第六,六个模型的输入源各不相同,跨模型比较混杂了架构、任务与训练数据差异,理想设计是同一基座换不同输入源做受控对比。
未来方向
作者明确提出的方向:评估更多模型与生物模态;在同一模型内固定其他训练设置、只变化训练 prompt 组成做受控实验;设计奖励'对生物输入变化的正确响应'的 RL 目标,而不只奖励最终答案正确,从训练目标层面逼模型使用输入。基于本文成果可自然延伸:把四个测试打包成标准化发布前审计套件(类似 VLM 的反事实基准),要求新生物推理模型报告输入敏感度曲线与源偏好指标;探索让探针性能与下游行为挂钩的训练目标,例如对投影后的 $Z_{\text{repr}}$ 施加反事实一致性损失;在 RQ4 方向上结合基因组级 held-out 划分与序列级预训练,检验辅助碱基预测能否真正泛化到未见基因组;将 evidence conflict 协议扩展到多轮对话与 agent 场景,检验模型在被追问时是否会改用被忽略的表征;最后,这套'预测性 vs 使用性'的区分框架可移植到医疗影像、基因组医学等其他高风险多模态领域,用于检测'基准繁荣'背后的输入捷径。
复现评估
复现条件较好。代码与协议开源于 GitHub(mims-harvard/bio-mirage),项目网站 zitniklab.hms.harvard.edu/biomirage 汇总了资源;六个被测模型均有公开 checkpoint 或推理管线,唯一例外是 BioReason 原始 checkpoint 未发布,作者改用 Fesser et al. (2026) 重训并公开的 42 个 post-training checkpoint(覆盖模型规模、SFT/RL LoRA rank、RL 时长扫描)。数据均可公开获取:KEGG 疾病查询集、UniProt reviewed 人类蛋白与 GOA 注释、五个公开单细胞图谱,细胞句子由作者按论文附录 A.1.3 的流程自建。算力方面,主要开销是重跑 Evo2/ESM3 前向以获得打乱表征(Evo2 对全基因组序列前向较贵)和线性探针训练(便宜);RQ4 的辅助监督重训是 257/2,048 bp 两种窗口 × 3 个种子的 LoRA SFT/RL,规模可控。难度中等偏高:需要熟悉每个模型各自的原生推理格式与权重加载,尤其 shuffle 后重算表征、构造冲突 prompt 的工程细节繁琐;论文附录 A–E 给出了数据划分、prompt 模板、评分规则、种子与不确定度估计,复现所需信息记录得相当完整。
论文图表