初始化提升大模型驱动的自动发现 Initialization Improves LLM-Driven Discovery
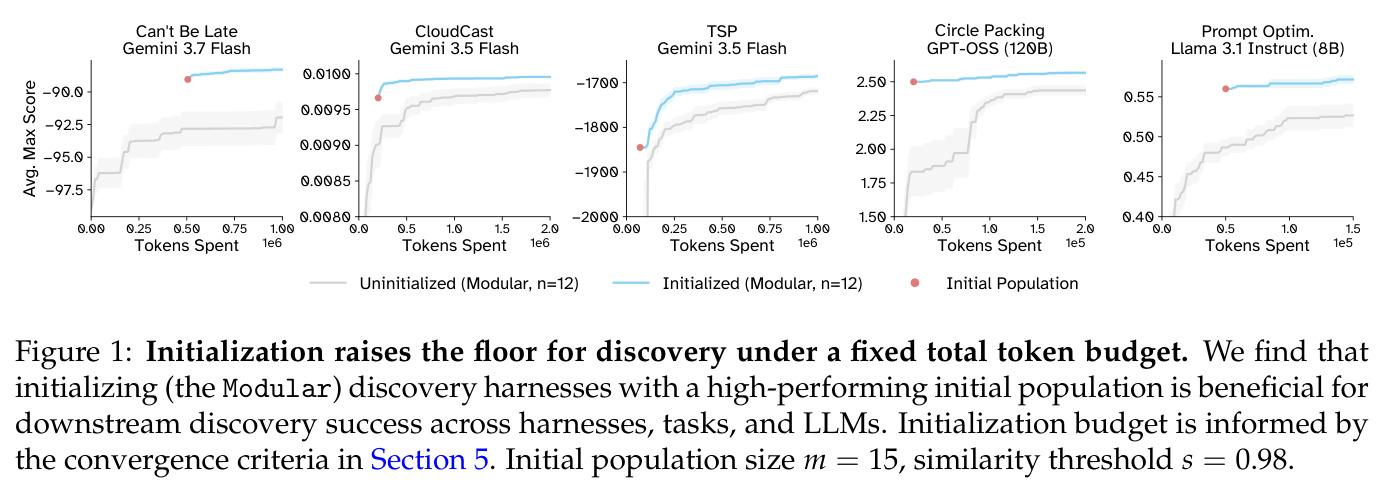
先并行探索再串行精修的初始化策略,让 LLM 发现框架稳定提升 2%-21%
前置知识
发现 harness 与 OPRO
harness 指管理 LLM 上下文的迭代优化框架:维护一个由历史解组成的种群,采样父代让 LLM 变异生成新解,按任务评分函数筛选后加入种群,种群超容则周期性剪枝。OPRO(Yang et al., 2024)是该范式的代表,用自然语言表达优化目标,把目标与历史解示例一起喂给 LLM 让其逐步改进。
本文的 Modular 套件就是在 OPRO 上扩展变异策略与父代采样两个自由维度得到的 12 个 harness,理解 harness 的种群机制是读懂全文实验设计的前提。
串行 vs 并行发现
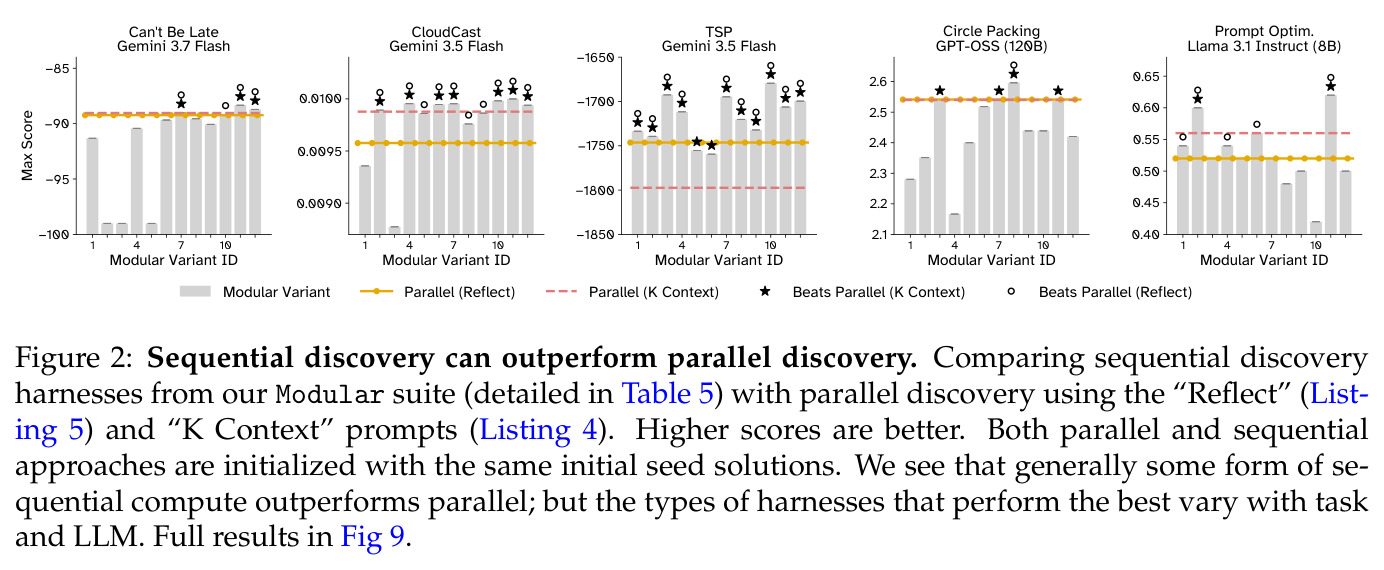
串行发现让 LLM 的提示随历史解不断更新,逐条精修;并行发现则对同一个种子解独立重复查询 LLM,上下文从不变动,性能完全依赖模型的参数化知识。论文要求两者消耗相同的 token 预算后再比较。
本文的核心问题之一就是这两种计算分配方式的优劣,并提出把并行计算从'搜索手段'重新定位为'初始化手段',不理解两者的区别就无法理解这一主张。
模式坍缩(mode collapse)
指发现轨迹中生成解的语义多样性随迭代急剧下降的现象:新解越来越相似,种群收敛到某个局部模式。本文用滑动窗口内的平均两两余弦相似度来量化(窗口 15,Circle Packing 为 6),发现串行 harness 普遍坍缩而并行方案多样性维持高位。
模式坍缩是论文诊断出的核心失败模式,也是'更多探索能否挽救糟糕起点'这一问题的出发点。
种群多样性度量
用句嵌入模型把每个解映射为向量 $e_i$(自然语言任务用 all-MiniLM-L6-v2,代码任务用 nomic-ai/CodeRankEmbed),集合多样性定义为 $\mathrm{Diversity}(D) = 1 - \mathrm{sim}(E)$,其中 $\mathrm{sim}(E)$ 是所有向量对的平均余弦相似度 $\cos(e_i,e_j)$。
论文中相似度阈值 $s$ 的拒绝采样、初始种群贪心筛选、模式坍缩检测全部建立在这个度量上,是贯穿全文的技术工具。
推理时计算(inference-time compute)
不改变模型权重、通过生成更多 token 换取更好结果的做法,如 best-of-n、自一致性、迭代精修等。本文强调应以 token 而非评估次数来计量成本,因为不同 harness 生成并评估单个解所耗费的 token 差异巨大,按次数比较不公平。
论文所有对比都在控制 token 预算的前提下进行,而初始化方法的本质,就是对一笔固定 token 预算在并行与串行之间的重新分配。
研究动机
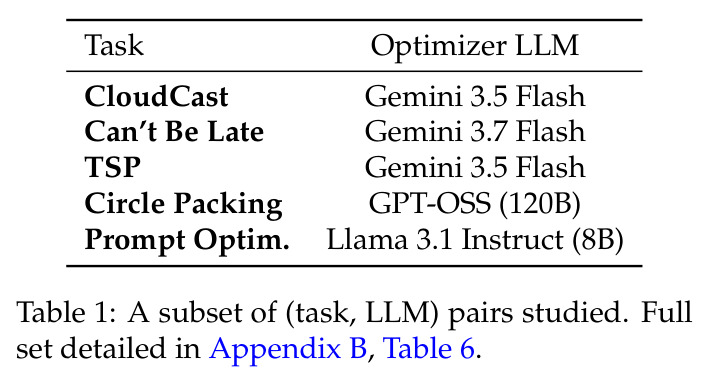
把 LLM 接入迭代优化 harness 已催生算法设计、药物重定位、定理证明、智能体系统设计等真实发现,但这类系统普遍脆弱:同一任务换一个 harness 或换一个 LLM,成绩就大幅波动。本文在 5 个任务(CloudCast 多云传输成本优化、Can't Be Late 抢占式实例调度、n=26 圆填充、n=100 旅行商 TSP、GSM8K 提示词优化)上构建了 12 个 Modular harness,并与 ShinkaEvolve、OpenEvolve、optimize anything 三个被广泛采用的 SOTA 系统对比,发现没有任何 harness 能在所有 (任务, LLM) 设置下占优。更麻烦的是,串行精修普遍伴随模式坍缩:候选解的语义多样性随 token 消耗持续下降。社区流行的对策是增强探索——要么用更复杂的多样性感知 harness,要么加相似度拒绝等在线干预——但这些手段此前从未被控制变量地系统验证过;而且过去工作以"评估次数"计成本,掩盖了不同方案生成单个解的真实 token 开销。
本文的目标是本文的目标分三层。第一,厘清推理时计算应如何在种群中分配与管理:串行精修是否真的优于最朴素的并行重试?作者把 OPRO 泛化为 Modular 套件——4 种变异策略 × 3 种父代采样策略共 12 个 harness,在与并行方案相同的种子解与 token 预算下严格对比。第二,检验"更多探索能否把低质量的初始解救回来":对比多样性导向的 SOTA harness,以及在 Modular 上施加余弦相似度阈值($s\in\{0.95,0.8\}$)、LLM-Judge、去重三类在线干预后的表现。第三,若上述手段都不可靠,就寻找一个跨任务、跨 LLM、跨 harness 都成立的杠杆:用总预算的 $r$ 比例做并行探索来构造高性能初始种群,再热启动串行优化,并给出自动确定 $r$ 的收敛判据,最后在 SOTA harness 上验证其普适增益(最终为 2%-21%)。
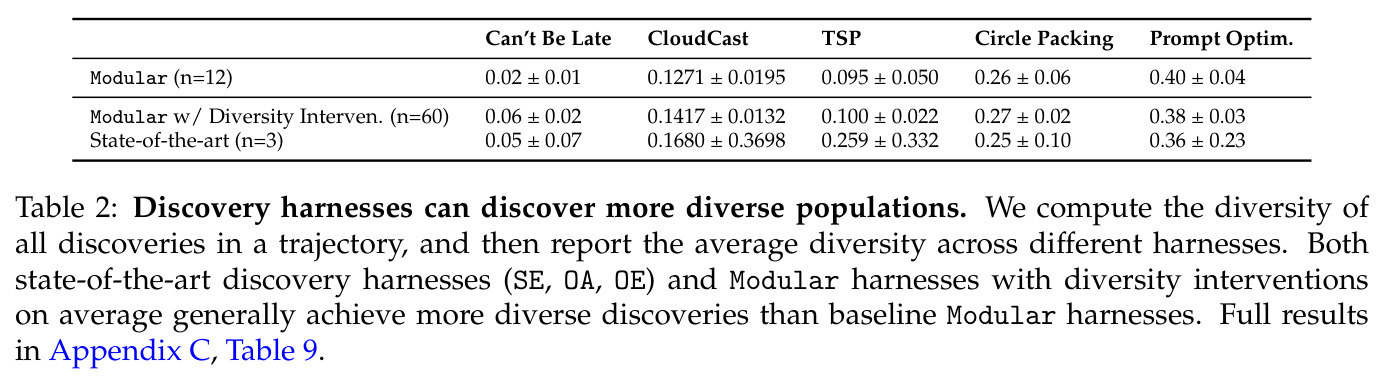
与已有工作不同的是,已有工作的惯常思路是把 harness 设计得越来越精巧——岛模型、多样性档案、语言算子等——默认更强的搜索机制自然带来更好的发现。本文反向切入,把"harness 内种群的演化动态"本身当作研究对象:不问哪个 harness 更强,而问什么样的中间状态(种群的规模、得分、多样性)在预测最终成功。由此得到两个被此前工作忽视的事实:其一,探索与成绩并不同向,SOTA harness 平均多样性更高(CloudCast 上 0.168 vs Modular 的 0.127)却常常更差;其二,前 15 个解的中位得分与轨迹最大得分强相关,多数设置 $R^2$ 在 0.5 以上、最高约 0.82,即"起跑线"几乎决定"终点"。这把并行计算的角色从"冲高上限的搜索"($r=1$)重构为"抬高下限的初始化"($0<r<1$),是概念层面的贡献,而非又提出一个新 harness。
核心方法
方法分诊断与干预两步。诊断阶段:固定"评分→采样父代→LLM 变异→按标准入群→超容剪枝"的 OPRO 式循环,只暴露两个自由度——4 种变异提示(Listing 4-7,含 Reflect、K Context 等)× 3 种父代采样算法(Alg 2-4)——构成 12 个 Modular harness;在 5 个任务上以相同种子解和固定 token 预算(每任务约 $10^5$ 到 $2\times10^6$ token)对比 Modular、两种并行提示与三个 SOTA harness,用最大得分、token 支出、嵌入多样性 $\mathrm{Diversity}(D)=1-\mathrm{sim}(E)$ 三个指标刻画轨迹。干预阶段即初始化方法:把总预算按比例 $r$ 划分,前 $r$ 用于批量并行采样;检测到并行解质量收敛后,从并行池中贪心筛选 $m=15$ 个高分、且与已选解余弦相似度低于 $s=0.98$ 的解构成初始种群 $p_{\mathrm{init}}$(唯一样本不足则用去重后的次优补齐),再用它热启动任意串行 harness 消耗剩余预算。
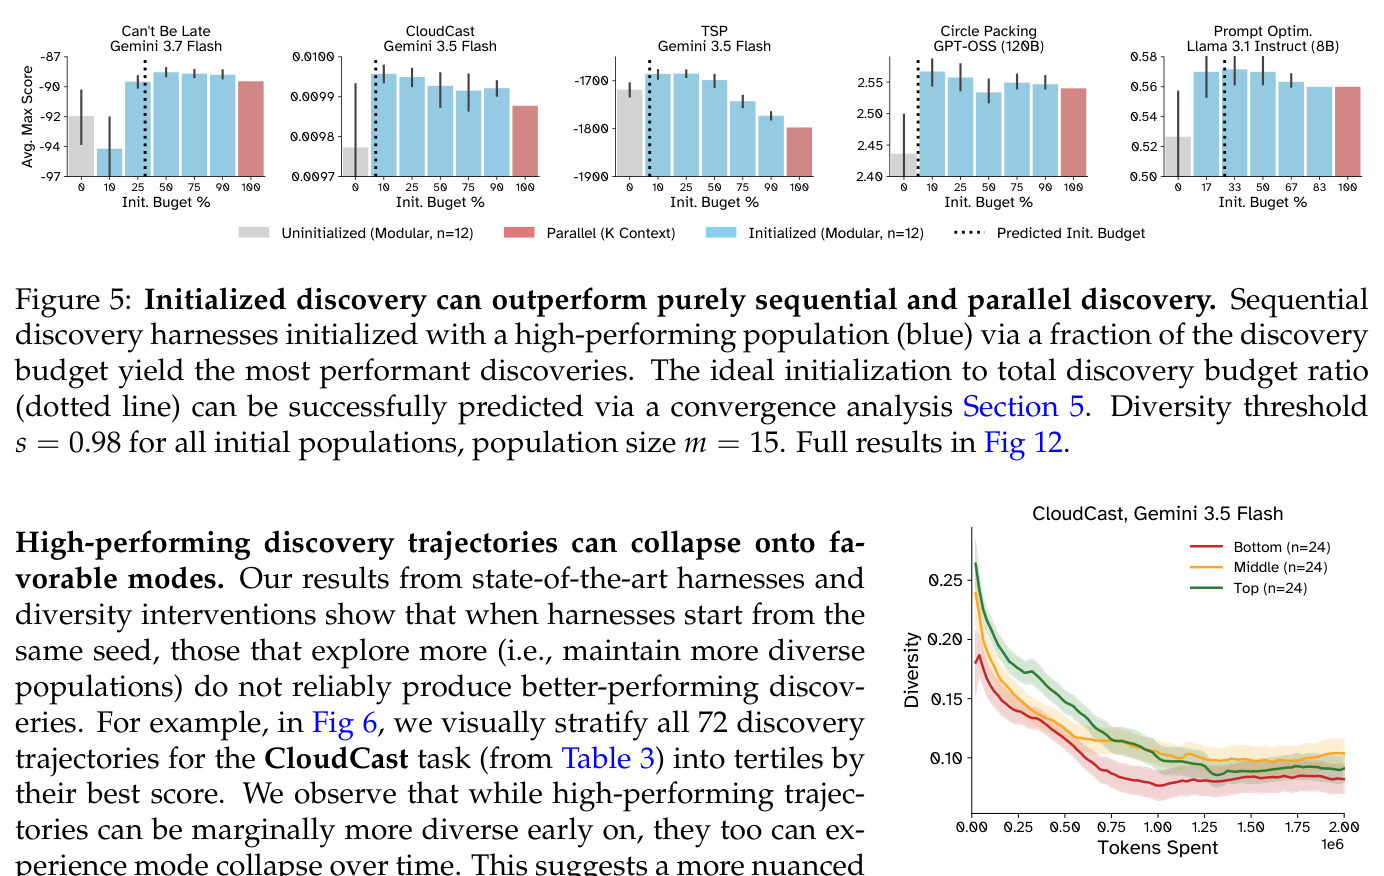
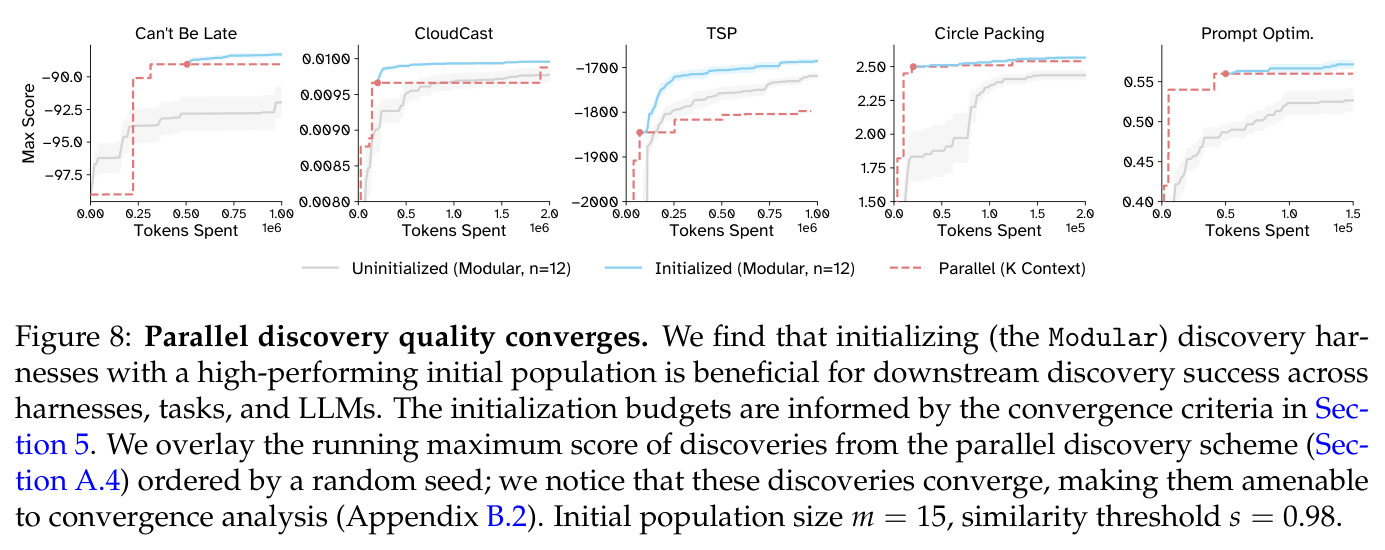
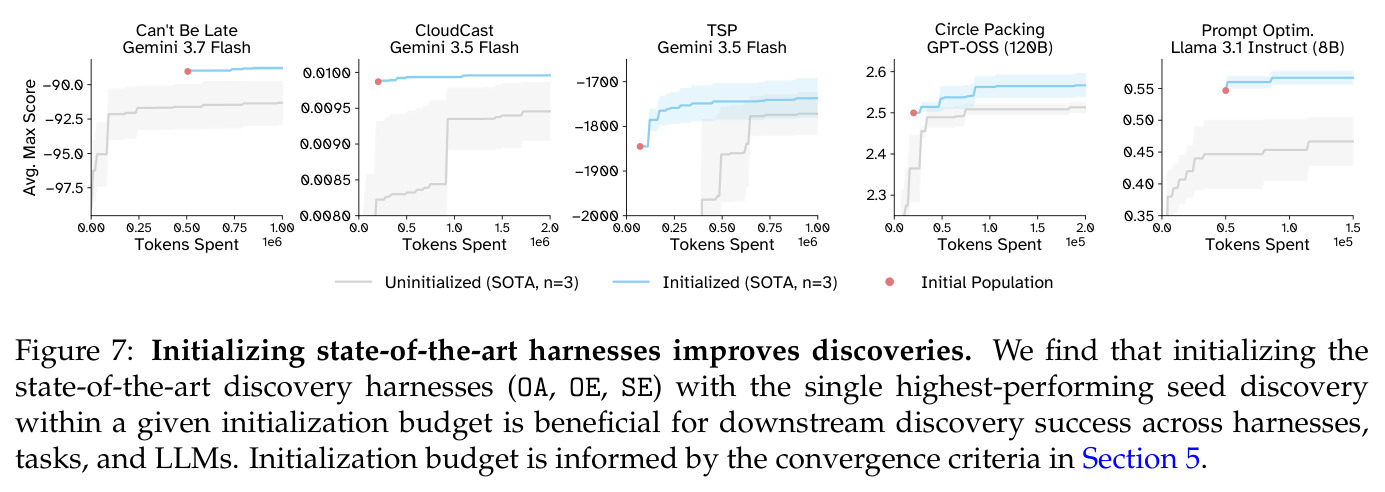
核心思想是把"初始化质量"确认为 LLM 发现的第一性变量,并给出一个任务、LLM、harness 三无关的注入手段。与已有工作的本质区别有三。第一,SOTA harness 依赖隐式初始化——靠自身搜索机制慢慢爬出坏种子,而实验证明这不可靠:给 ShinkaEvolve/OpenEvolve/optimize anything 显式喂入高性能初始解后成绩提升 2%-21%,说明它们自身并不能稳定构造好起点。第二,多样性干预是"在线"的(拒绝与现有种群过相似的新解),本文的初始筛选是"离线"的贪心构建,且刻意只做最轻量的过滤($s=0.98$,仅剔除近乎重复解):实验显示 $s=0.95/0.8$ 等更强约束会拉低初始种群平均分进而拖累终值,而完全贪心 $s=1$ 又可能被重复解占据,$s=0.98$ 恰好平衡。第三,预算 $r$ 不是拍脑袋定的:利用并行发现质量会收敛的观察,将并行解按随机顺序排列并检测收敛点,该判据在所有任务上都命中接近最优的初始化预算(图 5 虚线),且同一任务的判据可跨 LLM 复用。
方法步骤详情
完整流程五步。步骤一(并行探索):以种子解为起点,用 Reflect 或 K Context 提示让 LLM 独立变异,上下文永不变动;采用批量式而非一次性打满预算,便于中途检测收敛。步骤二(收敛检测):将并行解按随机种子排序,滑动考察累积最优得分,满足附录 B.2 的收敛判据(连续若干批无显著改进)即停止并行阶段(图 8 显示并行质量通常很快趋平)。步骤三(种群筛选):对并行池按得分降序贪心选解,若候选与已选解的嵌入余弦相似度$\cos(e_{\mathrm{new}},e_i)\ge s$ 则跳过($s=0.98$ 最佳),直至集满 $m=15$ 个;不足时用去重后的高分解补位。步骤四(热启动):将 $p_{\mathrm{init}}$ 作为 active population 注入任意 Modular harness(对 SOTA 则取池中最高分单解作种子),用剩余 $1-r$ 预算继续迭代。步骤五(鲁棒性检验):在 $r$ 取 5 档、$s\in\{1,0.98,0.95,0.8\}$ 网格上验证,确认结论对表 1 各任务-LLM 组合均成立。
技术新颖性
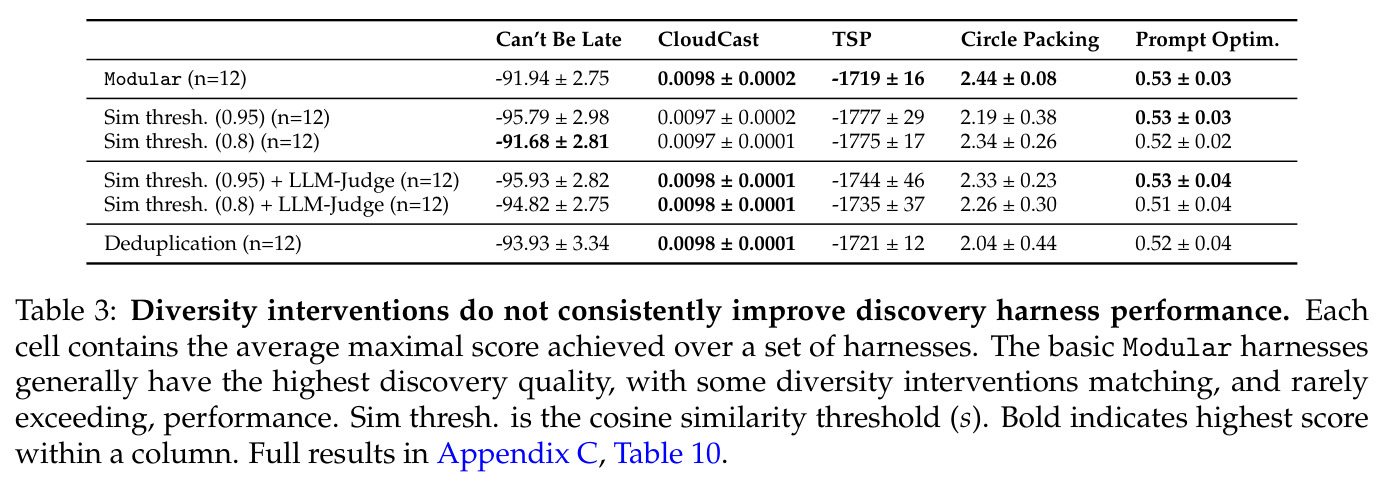
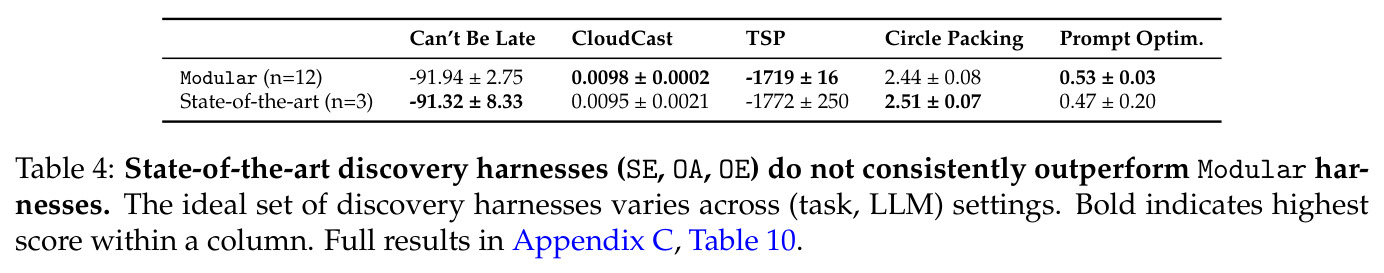
新颖性体现在四方面。其一,评测方法学:以 token 而非评估次数计成本,避免"harness 每步消耗不同 token"造成的不公平比较,这在进化式 LLM 搜索文献中很少被严格控制。其二,Modular 套件本身:以最小改动把 OPRO 泛化为 12 个 harness 的受控实验平台,使"harness 设计差异"成为可扫描的自变量,而非把各家系统数十个工程细节混在一起无法归因。其三,实证否定了两个流行直觉:"更高级的 harness 更好"(表 4:SOTA 在 CloudCast 得 0.0095±0.0021 输给 Modular 的 0.0098±0.0002,TSP 上 -1772±250 输给 -1719±16 且方差大一个数量级)与"更多多样性更好"(表 3:相似度阈值 0.95 使 Can't Be Late 从 -91.94 跌到 -95.79)。其四,把"起点很重要"的民间智慧变成可操作技术:初始化是唯一在全部 12 个 Modular × 5 任务设置中一致为正的干预,且无需改动任何 harness 内部机制,即插即用,这是与设计新搜索算子路线的根本不同。
实验结果
五个核心发现。①串行 vs 并行(图 2):控制 token 预算后,每任务都有多个 Modular 变体击败并行重试,但胜出变体各异(TSP 串行占优、Circle Packing 并行反超),最优 harness 随 (任务, LLM) 漂移。②模式坍缩(图 3):12 个 Modular 变体的窗口化多样性随 token 持续下滑,并行方案维持高多样性。③探索不等于高分(表 2/3/4):SOTA 与干预虽提升多样性却不兑换成绩,有的反而有害(阈值 0.95 令 Can't Be Late 从 -91.94 跌至 -95.79,去重令 Circle Packing 从 2.44 跌至 2.04),SOTA 亦未稳定超过 Modular。④早期预测晚期(图 4/6):前 15 解中位分与轨迹最大分强相关,多数 $R^2$ 达 0.5-0.82,高分轨迹照样坍缩。⑤初始化有效(图 5/7):$0<r<1$ 时初始化后的 Modular 于全部 5 任务一致优于纯串行与纯并行,收敛判据命中近优预算,$s=0.98$ 最稳;对 SE/OE/OA 显式初始化提升 2%-21%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| TSP n=100(Gemini 3.5 Flash) | 路径长度得分(负值计分,越大越好) | Modular 12 变体平均最大分 -1719±16 | SOTA(SE/OE/OA)-1772±250;纯并行更低 | 均值好 53,方差缩小约 15 倍 |
| CloudCast(Gemini 3.5 Flash) | 传输成本代理得分(越大越好) | Modular 0.0098±0.0002 | SOTA 0.0095±0.0021 | 均值高 0.0003 且方差缩小约 10 倍 |
| Can't Be Late(Gemini 3.7 Flash) | 调度得分(越大越好) | Modular 基线 -91.94±2.75 | 相似度阈值 0.95 干预后 -95.79±2.98 | 强多样性干预反而劣化 3.85,证明探索非万能 |
| Circle Packing n=26(GPT-OSS 120B) | 累积直径(越大越好) | SOTA 2.51±0.07;初始化后进一步抬升 | Modular 2.44±0.08;去重干预仅 2.04±0.44 | SOTA 略优 0.07,但去重干预劣化 0.40 |
| Prompt Optimization GSM8K(Llama 3.1 8B) | GSM8K 准确率 | Modular 0.53±0.03 | SOTA 0.47±0.20 | +0.06,且 SOTA 方差大 6 倍以上 |
| 全部 5 任务(SOTA harness 显式初始化) | 最大得分相对增益 | 初始化后一致提升 2%-21% | 未初始化的 SE/OE/OA(相同 token 预算) | 所有 (任务, LLM) 组合均为正增益 |
局限与改进
作者承认与本文可观察到的局限。首先,收敛判据虽在实验任务上表现好,但本质是启发式(连续批次无改进即停),阈值需要按任务调;作者只验证了它跨 LLM 复用,未验证跨任务族迁移。其次,实验覆盖 5 个任务、主表只报告 5 对 (任务, LLM) 组合,且全是评测器便宜、可大量调用的算法/提示优化类任务;评测昂贵的真实科学发现场景(湿实验、仿真)是否同样"早期即定局"存疑。第三,用轨迹最大得分定义成功天然奖励幸运采样,多轨迹取平均可缓解但不能消除偶然性。第四,模式坍缩只被诊断、未被治愈——初始化只是让轨迹更容易落进"好模式",一旦起点平庸仍无可靠的在线逃逸机制(图 6 显示高分轨迹最终也会坍缩)。第五,多样性度量依赖单一嵌入模型(all-MiniLM-L6-v2 / CodeRankEmbed),嵌入空间的"相似"未必对应功能相似。第六,窗口 15(Circle Packing 为 6)、种群 $m=15$ 等超参的敏感性主要放在附录,正文未展开。
独立分析的弱点
独立分析出以下弱点。①收敛即停可能过早:并行发现的"质量收敛"不等于"多样性收敛",早停会让初始种群困在参数化知识容易达到的浅层模式,对长尾目标(论文自己提到的知识长尾问题)可能系统性偏乐观,改进方向是在判据中加入多样性或"新且优"解比例指标。②贪心筛选以得分为唯一排序键,$s=0.98$ 只剔除近乎重复解,初始种群仍可能聚集在同一高分模式周围,降低后续串行阶段可用的搜索方向多样性;可对初始种群做轻量聚类、每簇保最高分。③预算分配是静态一次性决策,串行阶段若持续无改进没有回流机制;更优设计是监控串行进展,停滞时追加一轮小规模并行并重新初始化(类重启策略)。④对 SOTA harness 只喂单个最高分种子,未测试喂入完整 $p_{\mathrm{init}}$ 种群的效果,后者可能与 ShinkaEvolve 的岛模型天然契合。⑤"前期决定后期"的因果机制未验证——是上下文自强化(好解吸引后续变异趋同)还是任务实例难度异质性造成的统计假象?可做交换初始种群的干预实验来区分。
未来方向
作者明确提出的方向:更好地量化 LLM 参数化知识与发现任务的关系——并行发现不更新上下文、完全依赖参数化知识,可当作探测模型"固有能力"的探针,进而研究参数化先验与上下文先验如何交互;以及把冷门领域的问题改写成模型熟悉的领域(例如用流行编程语言而非生僻语言表达算法设计题)来降低发现难度。基于本文成果还可延伸:把收敛判据推广为在线的计算实时调度器,在串行/并行之间动态切换甚至多轮交替;把初始化与多样性干预结合成两阶段策略(先提分后探索);研究模式坍缩的机理(上下文自强化)并设计上下文编辑、遗忘机制来在线打断坍缩;把方法搬到评测昂贵的科学场景,用代理模型替代精确评分;以及检验"早期质量预测后期"这一相关关系在分子设计、电路综合、定理证明等其他模态上的普适性。
复现评估
复现评估:中等偏易。附录信息充分——A.1 给出 12 个 Modular harness 的配置与算法(Alg 2-4),A.2 给出 LLM-Judge 提示,A.3 给出 SE/OE/OA 的超参,A.4 给出并行变异提示(Listing 4-7),B 节给出 5 个任务的评分器、token 预算(约 $10^5$–$2\times10^6$)与收敛判据。多样性度量用的 all-MiniLM-L6-v2 与 CodeRankEmbed 均开源;三个 SOTA harness 本身是开源项目。主要成本与风险在 LLM API:主实验依赖 Gemini 3.5/3.7 Flash、GPT-OSS 120B 与 Llama 3.1 8B,闭源模型存在版本漂移风险;按每任务 $10^5$–$2\times10^6$ token 估算,跑完 12 harness × 5 预算档 × 多 LLM 网格约需数十到上百美元级 API 费用。正文未附代码链接,Modular 循环需自行实现(逻辑简单,数百行)。总体:有工程经验者数天内可复现单任务结论,全量网格需更多预算。
论文图表
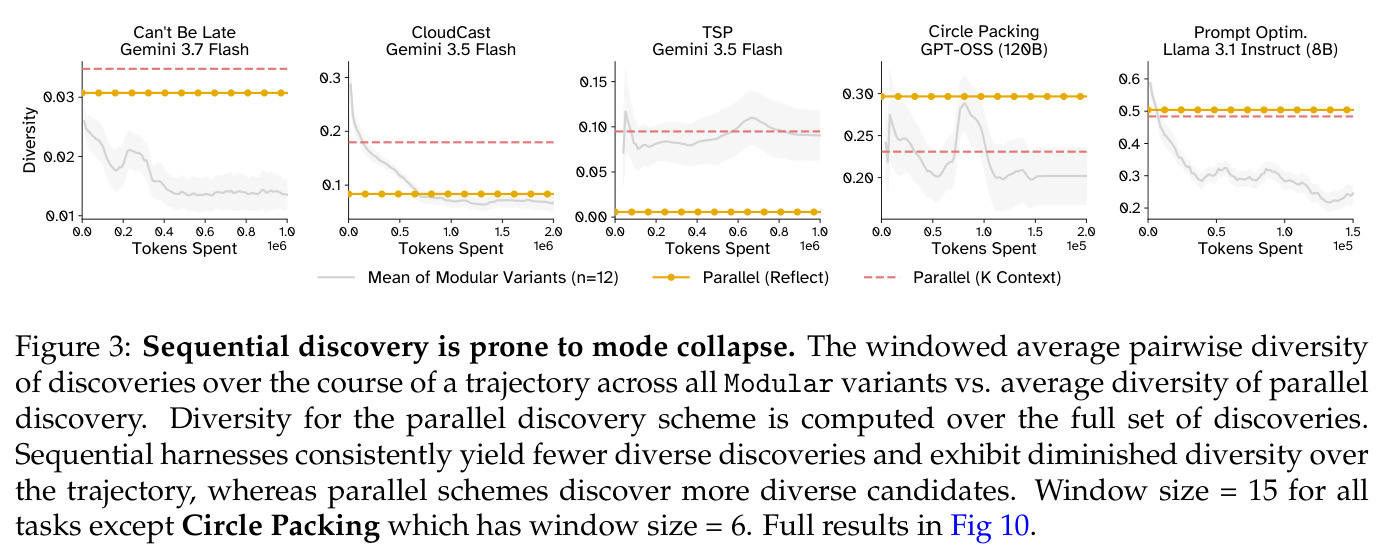
绘制串行轨迹的窗口化平均两两多样性(窗口 15,Circle Packing 为 6)与并行方案的总体多样性随 token 消耗的变化。12 个 Modular 变体的多样性持续下降,而两种并行方案维持高多样性。
正式定义并展示"模式坍缩"这一核心失败模式,是第 4 节"探索是否有用"问题的直接证据来源。
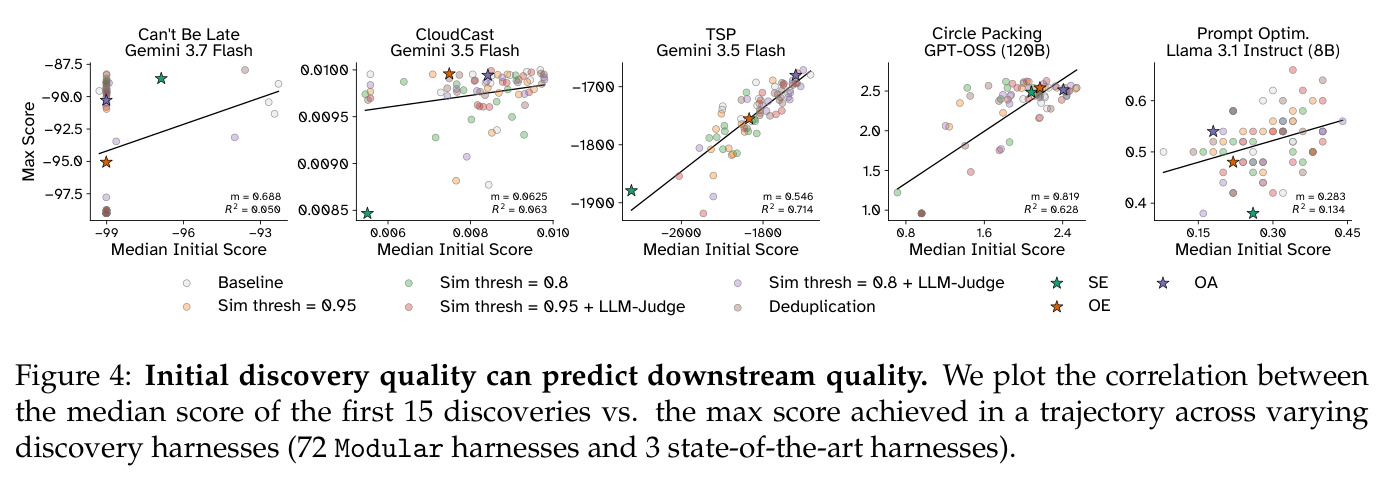
散点图:横轴为轨迹前 15 个解的中位得分,纵轴为该轨迹的最大得分,覆盖 72 条 Modular 轨迹(12 harness × 6 种设置)与 3 条 SOTA 轨迹,各面板标注 $R^2$。多数任务设置中初始质量与最终成绩显著正相关,个别任务(如 Prompt Optim)相关性较弱。
这是初始化方法最直接的实证动机:如果起跑线决定终点,那么花预算优化起点就是理性的,整篇论文的逻辑链条从此图建立。