PixelDense:将密集预测作为像素扩散的表征对齐 PixelDense: Dense Prediction as Representation Alignment for Pixel Diffusion
用语义与几何双流正交表征对齐四个密集预测教师,加速并增强像素扩散训练
前置知识
REPA(表征对齐)
REPA 在扩散 Transformer 训练时,把中间层 denoiser 的 token 特征经一个小投影头,用余弦损失 $\ell_{\cos}(a,b)=1-\langle a,b\rangle/(\|a\|\,\|b\|)$ 对齐到冻结编码器(如 DINOv2)同位置的特征。教师不接收梯度,训练结束后整个对齐分支被丢弃,因此只加速训练(论文称可达一个数量级)而不增加任何推理成本。
PixelDense 本质上是把 REPA 的单一语义教师扩展为四个密集预测教师的语义/几何双流版本,所有损失设计都建立在对 REPA 余弦对齐机制的理解之上。
像素空间扩散
与先经 VAE 压缩的潜空间扩散不同,像素空间扩散(如 PixelGen、DeCo、PixelFlow)直接在 RGB 像素上去噪。其 denoiser 的视觉 token 就落在 RGB patch 网格上,与密集预测模型所消费的图像网格一一对应。
正是这种 token 与像素网格的一一对应,使 denoiser 中间特征能逐 token 直接对齐密集教师特征,是本文方法成立的结构前提。
密集预测基础模型
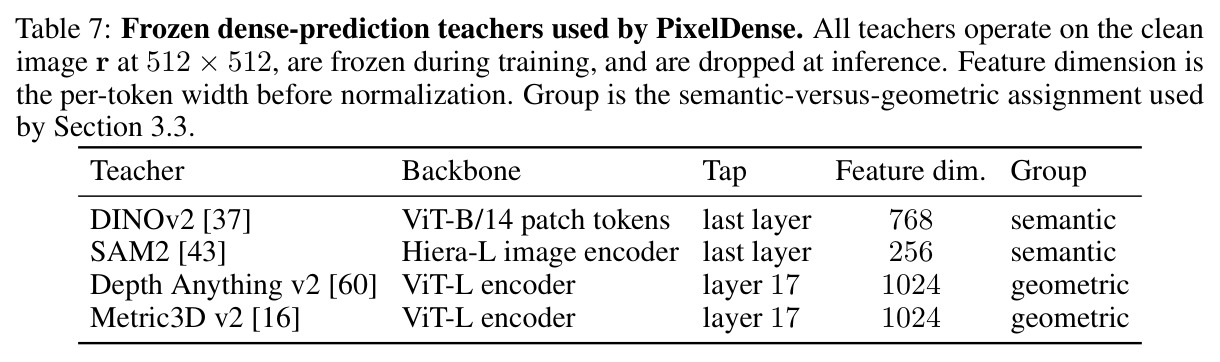
指在单张 RGB 图上输出逐 patch/逐像素空间结构的预训练模型:DINOv2 提供物体级语义特征,SAM2 提供实例与区域边界特征,Depth Anything v2 提供单目深度特征,Metric3D v2 提供深度与表面法向特征。它们被显式训练来暴露空间结构。
本文的核心贡献就是首次把这类模型整体作为 REPA 对齐教师,并按语义/几何两组进行路由,因此必须理解各自捕获什么结构。
流匹配(Flow Matching)
一种生成模型训练目标:学习从噪声分布到数据分布的速度场,损失 $\mathcal{L}_{\mathrm{FM}}$ 让网络在加噪样本上预测速度或干净样本 $\hat{x}_0=f_\theta(x_t,t,y)$,采样时沿概率流积分。PixelGen 等像素扩散即采用此目标。
PixelDense 的总损失为 $\mathcal{L}=\mathcal{L}_{\mathrm{FM}}+\mathcal{L}_{\mathrm{align}}+\lambda_{\mathrm{orth}}\mathcal{L}_{\mathrm{orth}}+\mathcal{L}_{\mathrm{aux}}$,理解主干损失才能分清各组件的作用。
权重空间正交正则
对两条投影流的输入投影矩阵按行归一化后,惩罚行间平均绝对余弦:$\mathcal{L}_{\mathrm{orth}}=\frac{1}{D_sD_g}\|\bar{W}_{\mathrm{sem}}\bar{W}_{\mathrm{geo}}^{\top}\|_1$。其为 0 时语义与几何梯度从互不重叠的输入子空间进入 denoiser 特征,且只依赖投影权重、与数据无关。
这是防止语义/几何梯度互相干扰、实现子空间路由的关键机制,本文取权重 $\lambda_{\mathrm{orth}}=0.01$,消融显示去掉它 GenEval 从 0.8093 降至 0.8053。
SDEdit 与 GenEval
SDEdit 把源图加噪到强度 $\tau$ 再以目标提示词去噪完成编辑,编辑强度越大保留越少;GenEval 是 553 条提示、覆盖单物体/双物体/计数/颜色/属性绑定/位置六类的自动文生图评测,报告 Overall 与分类别得分。
SDEdit 用于检验模型保留源图几何结构的能力(PIE-Bench 实验),GenEval 是本文主表的核心指标(0.7927→0.8093)。
研究动机
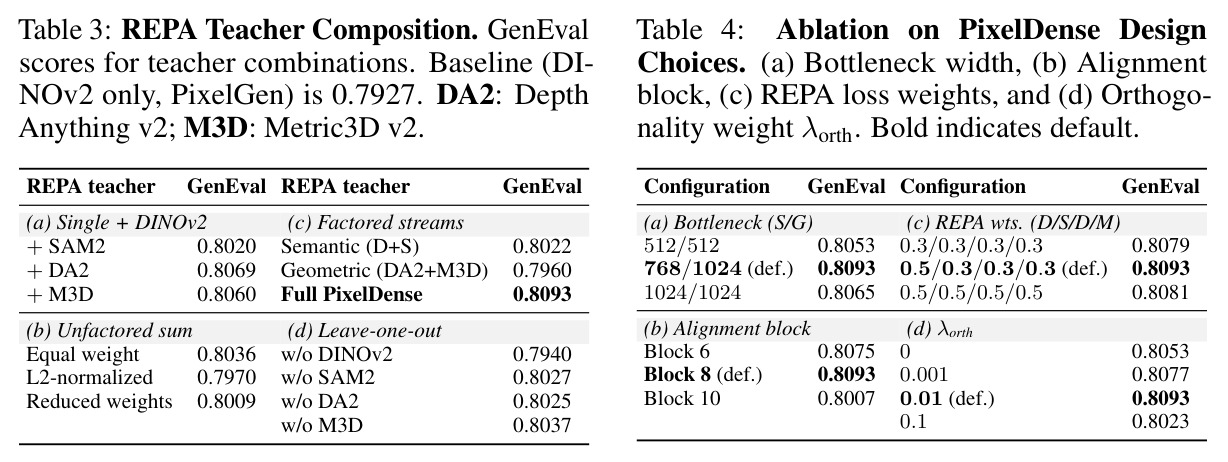
REPA 类方法通过对齐冻结编码器特征能把 DiT 训练加速约一个数量级,但对齐目标几乎清一色是 DINOv2、CLIP 这类语义编码器。iREPA 指出对齐收益的真正载体是空间结构而非全局语义,而专门被训练来预测空间结构的密集预测基础模型(SAM2、Depth Anything v2、Metric3D v2 等)却一直被忽视。作者在 PixelGen 512×512 上的实验确认:任一密集教师作为附加对齐目标都能超过 DINOv2-only 基线 0.7927——SAM2 达 0.8020、Depth Anything v2 达 0.8069、Metric3D v2 达 0.8060,几何教师还强于分割教师。然而反直觉的是,把四个教师的 REPA 损失简单求和后 GenEval 只有 0.8036,反而低于最好的单个几何教师:语义与几何梯度竞争同一个 denoiser 投影,产生负迁移。根源在于语义编码器奖励视角不变性与实例同一性,几何编码器奖励度量布局与表面朝向,两组梯度挤在同一个特征基里无法各自专业化。
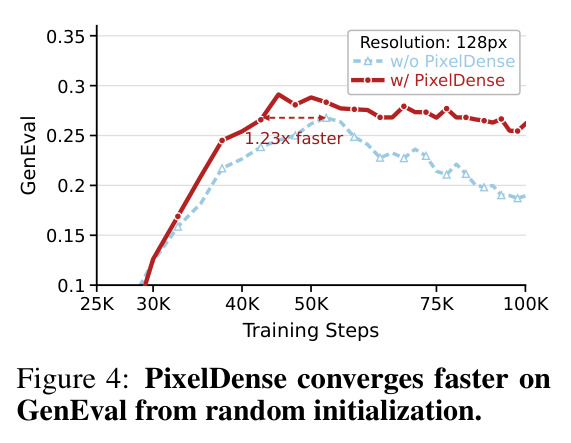
本文的目标是本文的目标是:在不改变推理侧任何结构和成本的前提下,把语义、分割、深度、法向四类密集感知知识同时注入像素扩散 Transformer 的训练,并让它们互不抵消。具体要回答三个问题:密集预测教师是否比纯语义教师更强;多个密集教师如何组合才不产生负迁移;这样的配方能否跨骨干(PixelGen、DeCo)、跨场景(文生图、部分噪声重建、从零训练、SDEdit 编辑)稳定迁移。量化目标包括提升 GenEval、DPG-Bench 与 HPS v2.1(最终 GenEval Overall 从 0.7927 提至 0.8093),把从零训练到基线峰值的时间缩短约 1.23 倍,并系统性改善重建与编辑中的分割、深度、法向几何保真。
与已有工作不同的是,作者的独特切入是把多教师对齐重新表述为表征路由(representation routing)问题:关键不是选哪个教师,而是让不同性质的教师通过不同子空间监督同一个 denoiser。具体体现在三点:其一,利用像素扩散中 denoiser token 与图像网格的一一对应,使中间特征可以逐 token 对齐密集教师特征,这是潜空间方法做不到的;其二,不做加法融合,而是按语义(DINOv2+SAM2)与几何(Depth Anything v2+Metric3D v2)把教师分成两股独立投影流,并用一个仅在投影权重上计算、完全无数据依赖的正交惩罚保持两流输入子空间不相交;其三,所有教师训练期冻结、推理期整体丢弃,部署模型就是原封不动的三通道 RGB 生成器加原采样器。与此最近的相关工作 Align4Gen 与 Geometry Forcing 面向视频时序一致性且只做求和,图像方向此前默认单一语义教师。
核心方法
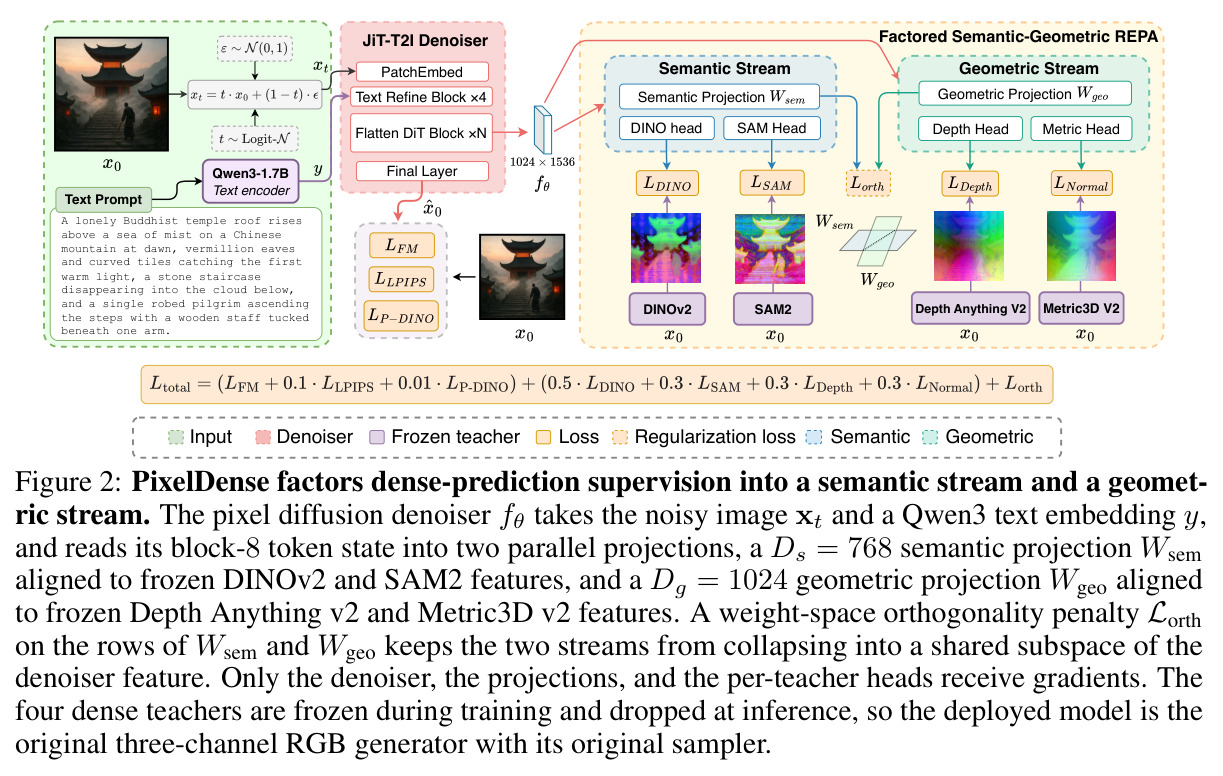
直觉上,语义与几何编码器奖励互不相同的不变性,两组梯度挤进同一个特征基就会互相拉扯,解法是给每组各开一条专线。PixelDense 在 16 块像素扩散 Transformer 的第 8 块读取视觉 token 状态 $h^{\ell}$,送入两条两层 MLP 投影流:语义流 $\pi_s$(输入投影宽 768)对齐 DINOv2 与 SAM2,几何流 $\pi_g$(宽 1024)对齐 Depth Anything v2 与 Metric3D v2,经四个线性教师头映射后逐 token 计算余弦对齐损失,按 0.5/0.3/0.3/0.3 加权;同时以 $\lambda_{\mathrm{orth}}=0.01$ 的权重空间正交惩罚防止两流塌缩到同一子空间。总损失由流匹配项 $\mathcal{L}_{\mathrm{FM}}$、对齐项 $\mathcal{L}_{\mathrm{align}}$、正交项与辅助感知损失构成,后者为继承自 PixelGen 的 LPIPS 与 Perceptual-DINO 损失。训练结束后教师与全部对齐参数被丢弃,部署模型的采样成本与原版完全一致。
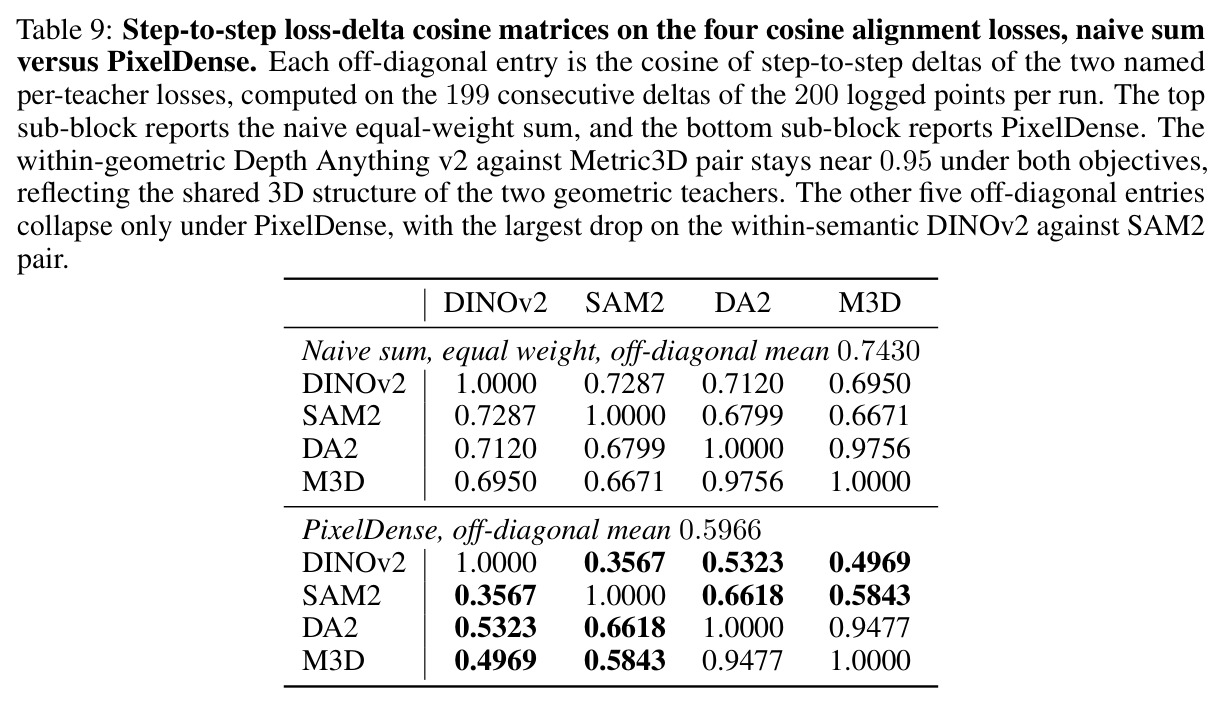
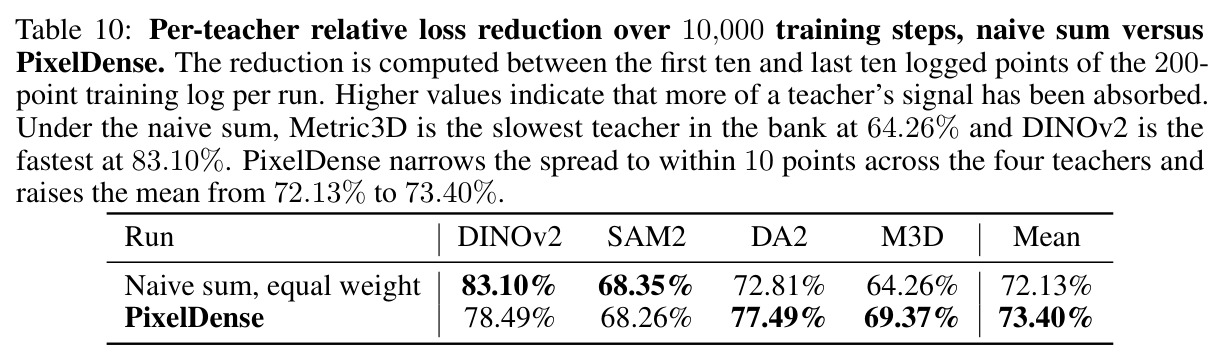
核心创新是把教师组合从加权求和升级为带结构约束的表征路由。与 REPA/iREPA 的单语义教师不同,PixelDense 首次把密集预测模型群作为教师;与朴素的四教师求和(虽各有独立投影头,但所有损失仍更新同一个 denoiser 特征 $h^{\ell}$)不同,它通过两股瓶颈投影流加行归一化正交惩罚 $\mathcal{L}_{\mathrm{orth}}=\frac{1}{D_sD_g}\|\bar{W}_{\mathrm{sem}}\bar{W}_{\mathrm{geo}}^{\top}\|_1$,在第一层投影就为语义与几何梯度保留互不相交的输入子空间,使两股监督各自专业化而非平均化。附录的训练动力学诊断给出机制证据:分解后四条教师损失的逐步增量余弦相似度从 0.7430 降到 0.5966(跨流与 DINOv2-SAM2 对解耦最明显),而长期共改进的 Pearson 相关保持在 0.9083;各教师相对损失降幅的语义/几何差距从 0.0719 缩到 0.0006,平均降幅从 72.13% 升至 73.40%,说明没有教师被梯度竞争挤到次要地位。
方法步骤详情
流程共六步。第一步,冻结四教师并抽取特征:DINOv2 ViT-B/14 末层 768 维、SAM2 Hiera-L 末层 256 维、Depth Anything v2 与 Metric3D v2 均 ViT-L 第 17 层 1024 维,对 512×512 干净图输出特征网格,双线性重采样到 denoiser patch 格并做通道级 L2 归一化。第二步,在第 8 块读取视觉 token 状态 $h^{\ell}$。第三步,经两层 MLP(SiLU 加通道 LayerNorm)得到语义流 $\pi_s$ 与几何流 $\pi_g$ 的输出。第四步,四个单线性头把流输出映射到教师特征宽度。第五步,逐 token 余弦损失按 0.5/0.3/0.3/0.3 加权,加 $\lambda_{\mathrm{orth}}=0.01$ 正交惩罚,与流匹配损失及 LPIPS/Perceptual-DINO 辅助损失共同优化 denoiser 与对齐参数 $\Phi$。第六步,2×H200、有效批 256、AdamW(lr 1e-5,200 步预热后恒定)、EMA 0.9999,在 BLIP3-o-60K 上微调 10000 步;推理时删除教师与 $\Phi$,用 25 步 Adam LM 求解器、CFG 4.0 采样。
技术新颖性
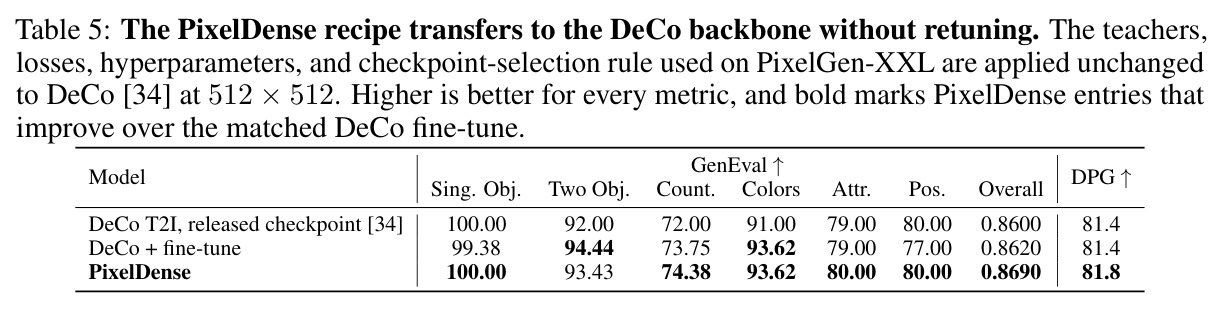
技术新颖性体现在四个层面。第一,教师选择:首次系统地把 SAM2、Depth Anything v2、Metric3D v2 等密集预测基础模型作为图像扩散的 REPA 对齐目标;此前最接近的多编码器对齐(视频方向的 Align4Gen、Geometry Forcing)只做简单求和且面向时序一致性。第二,问题识别:明确指出并量化了密集多教师对齐中的负迁移——四教师等权求和仅 0.8036,低于最佳单几何教师的 0.8069,并把组合问题重构为子空间路由。第三,机制设计:正交惩罚只作用于两条流输入投影的行空间、完全无数据依赖,因此零推理开销即可让语义与几何梯度从正交子空间进入网络;消融显示去掉它 GenEval 从 0.8093 掉到 0.8053,加大 10 倍到 0.1 则过约束掉到 0.8023。第四,通用性:同一配方不做任何重调即迁移到 DeCo 骨干(GenEval 0.8620→0.8690、DPG 81.4→81.8),在从零训练中带来约 1.23 倍收敛加速,并在重建与编辑任务上全面提升几何保真。
实验结果
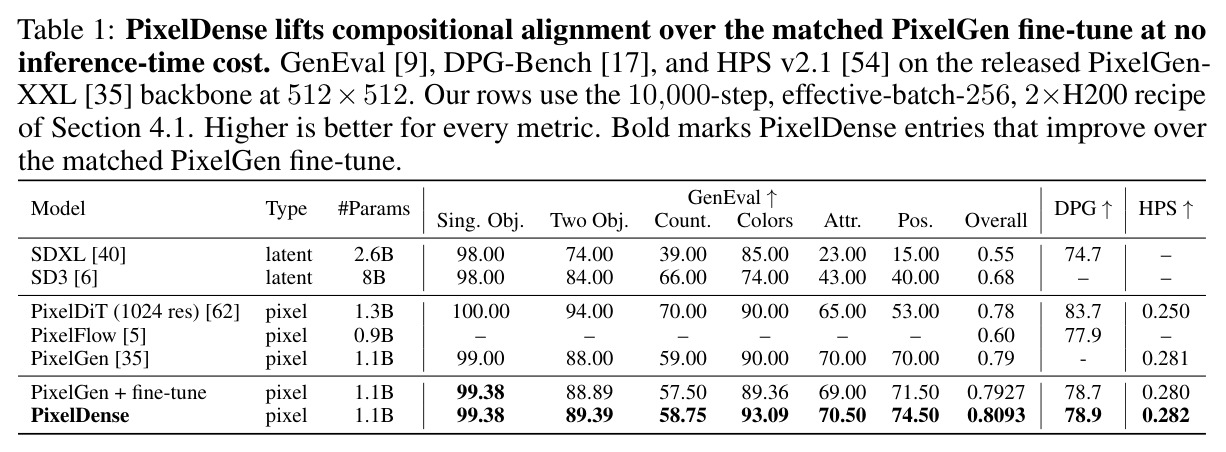
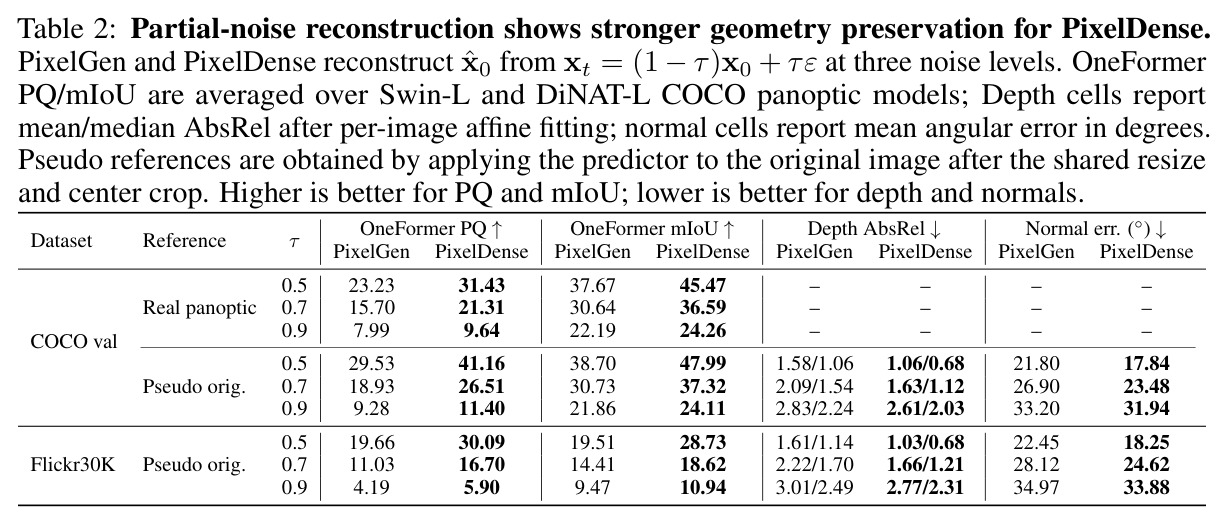
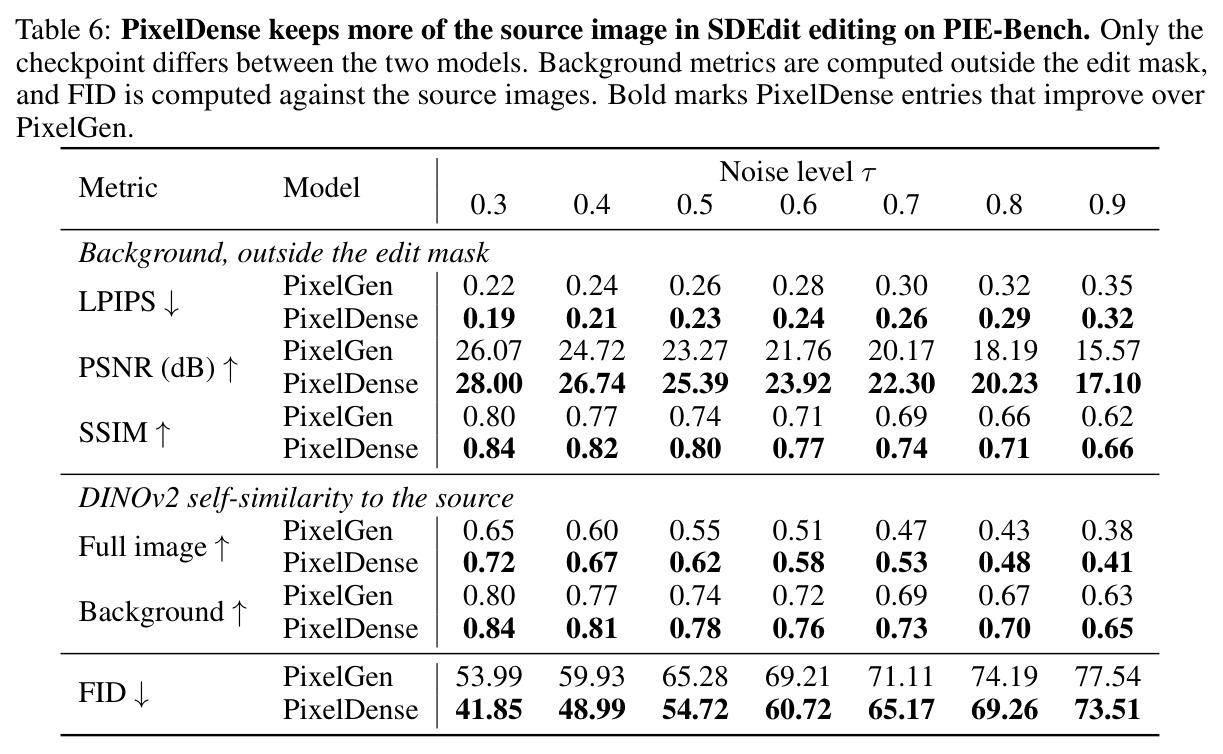
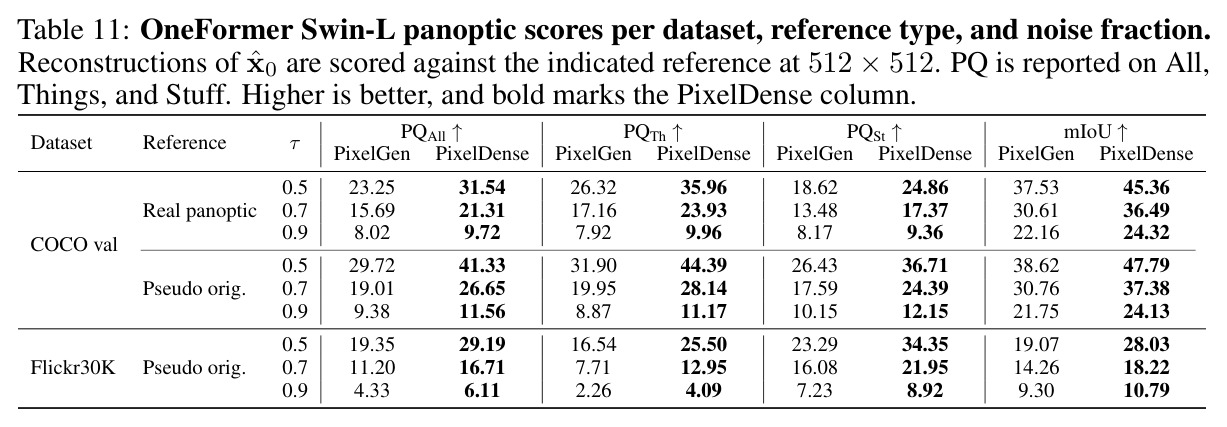
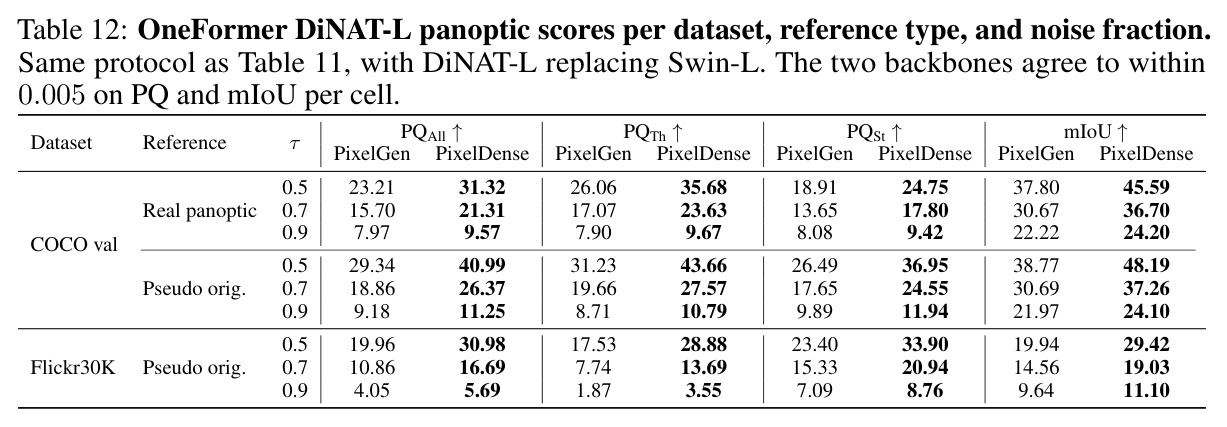
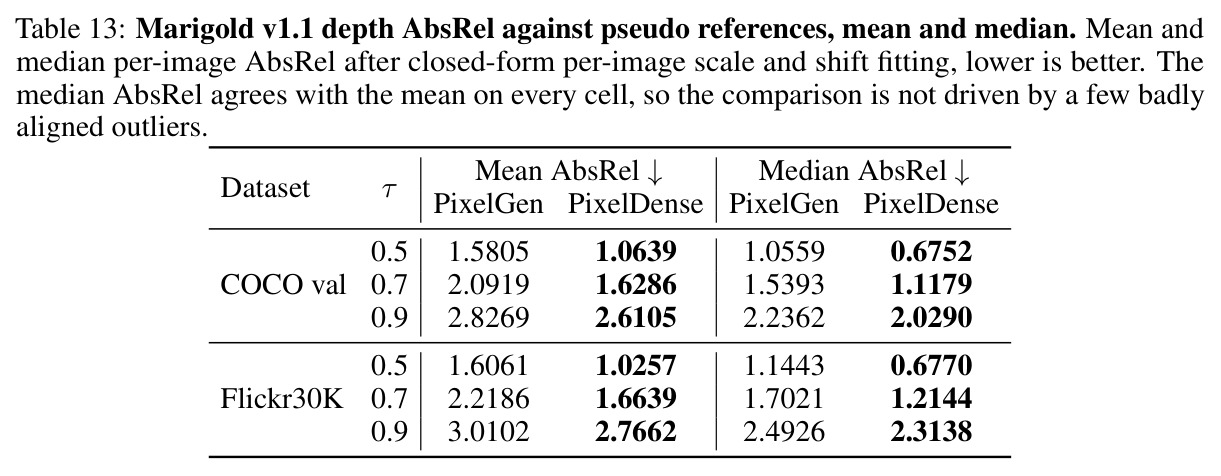
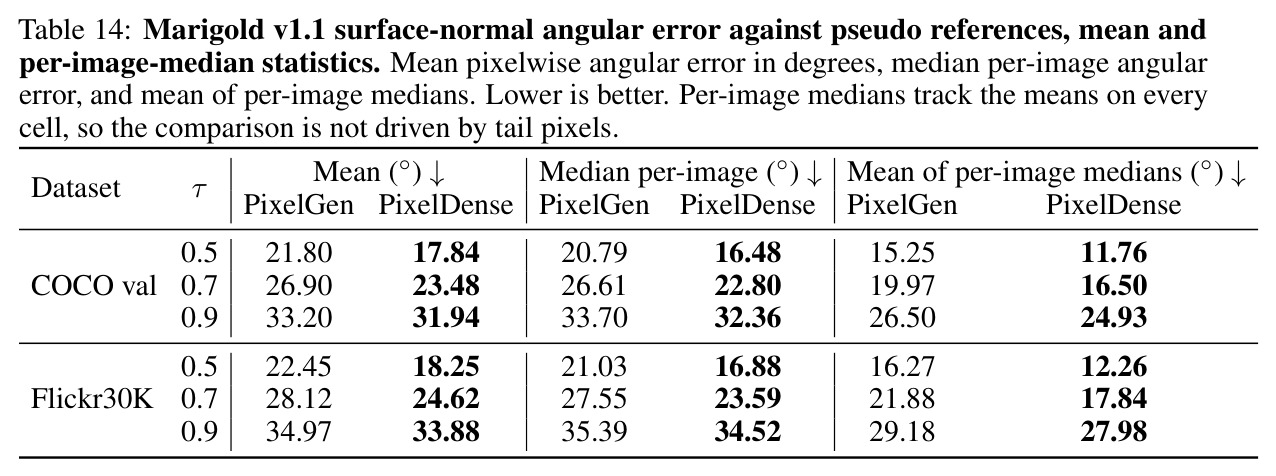
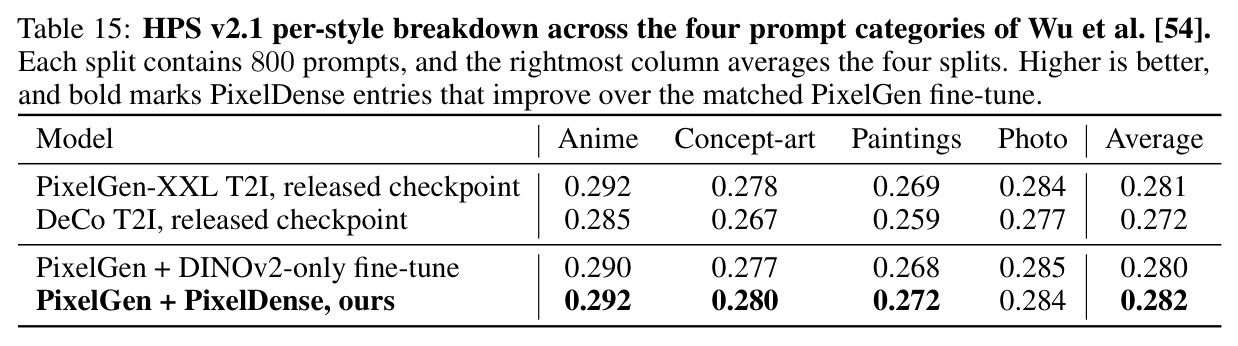
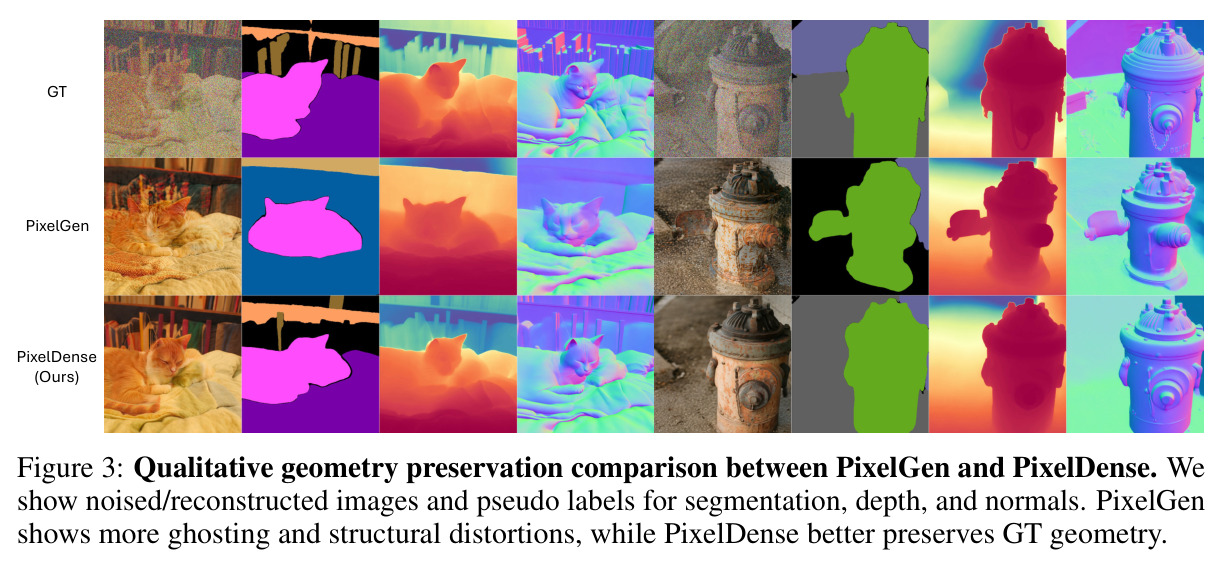
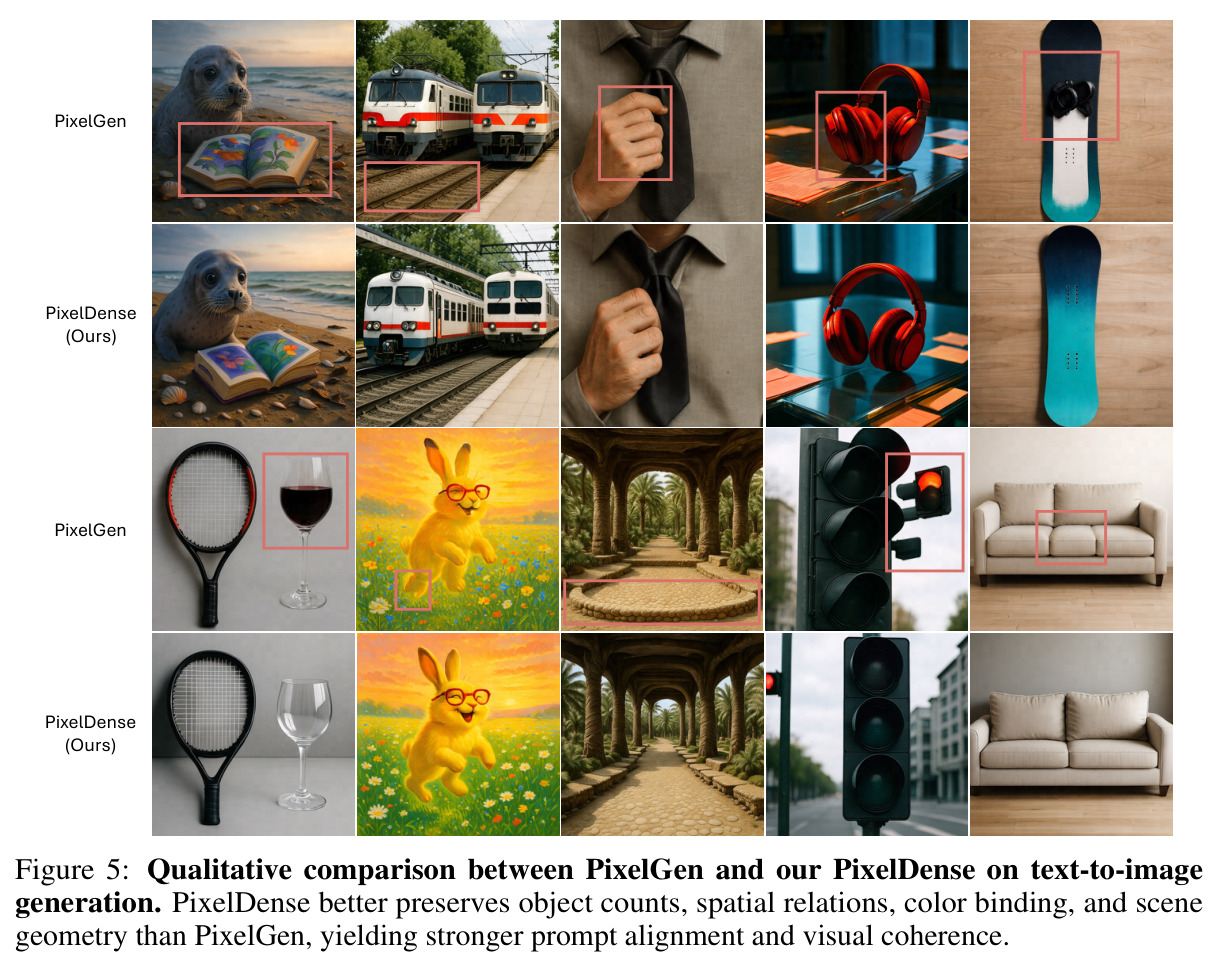
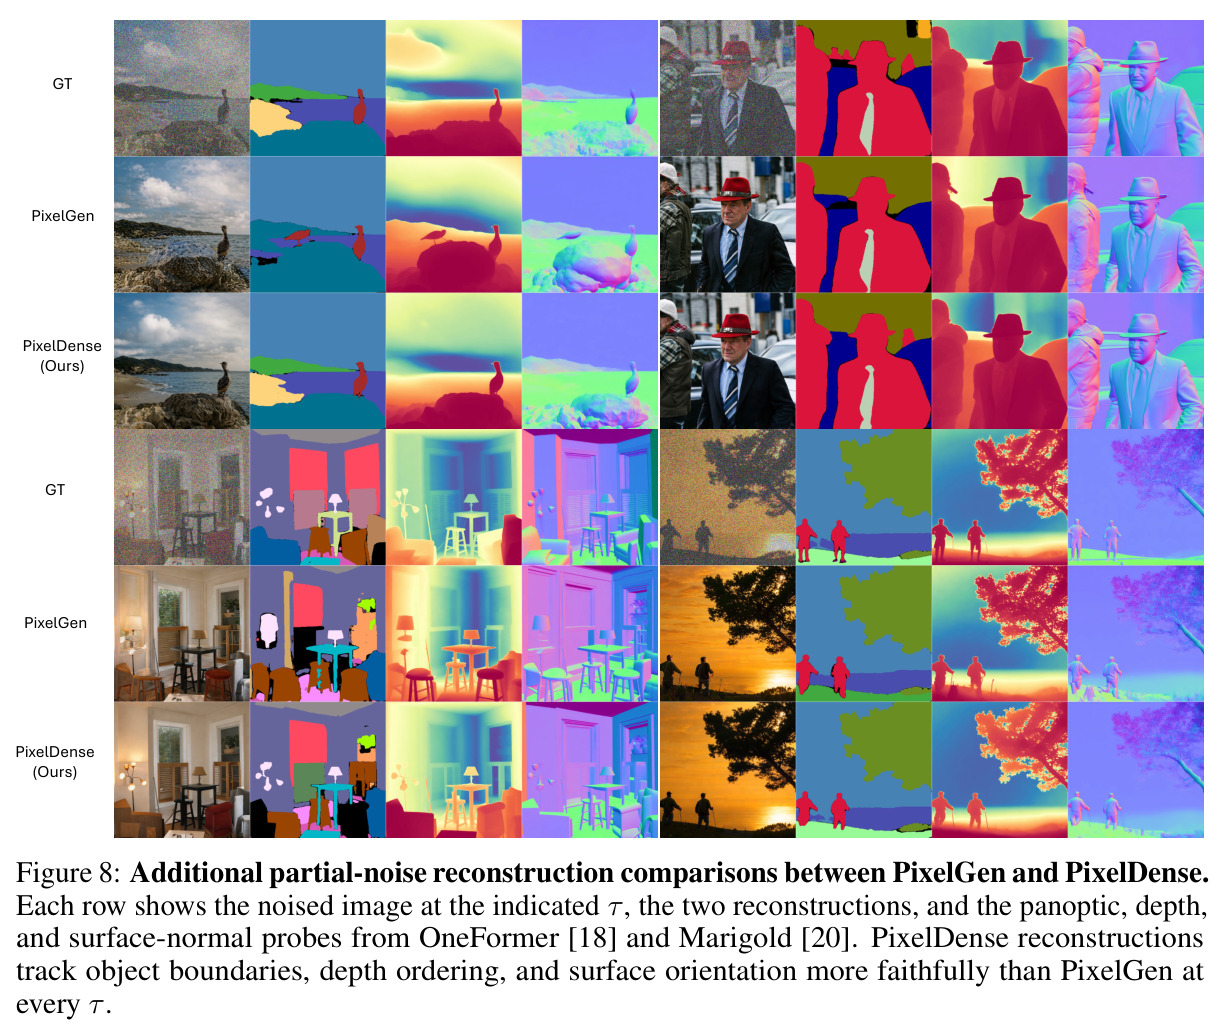
主实验(表1):PixelGen-XXL 512×512 上 GenEval Overall 从匹配微调基线 0.7927 提至 0.8093(相对 +2.09%),DPG 78.7→78.9,HPS v2.1 0.280→0.282,为该规模像素方法最佳,且推理零开销。教师组合(表3):单个密集教师均超 DINOv2 基线(SAM2 0.8020、DA2 0.8069、M3D 0.8060),但四教师等权和仅 0.8036、L2 归一化 0.7970,低于最佳单教师;仅语义流 0.8022、仅几何流 0.7960,完整 PixelDense 0.8093 最优;留一消融缺一不可(去 DINOv2 掉至 0.7940)。几何保真(表2):部分噪声重建中 COCO 真值 PQ 在 τ=0.5 从 23.23 升至 31.43(+35.3%),Flickr30K 伪标签 PQ 19.66→30.09(+53.1%),深度 AbsRel 1.61→1.03(−36.0%),法向角误差 21.80°→17.84°,全部单元格占优。消融(表4)确认瓶颈 768/1024、对齐块 8、λ_orth=0.01 为最优配置(块 10 掉至 0.8007)。从零训练(图4):128×128 下 1.23× 速度达到基线峰值并全程领先。跨骨干(表5):DeCo 上 GenEval 0.8620→0.8690、DPG 81.4→81.8。编辑(表6):PIE-Bench 七档噪声六项指标全优,背景 PSNR 最高约 +2.2 dB(τ=0.6:21.76→23.92),τ=0.3 时 FID 53.99→41.85。
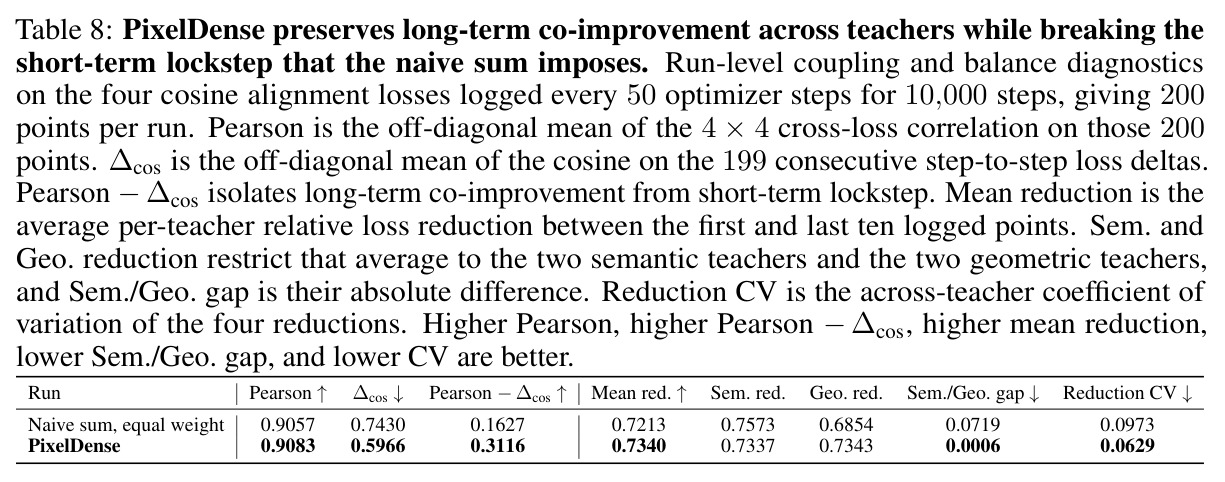
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 文生图组合能力(PixelGen-XXL 512×512) | GenEval Overall | 0.8093 | PixelGen 匹配微调 0.7927 | +0.0166(相对提升 2.09%) |
| 文生图细粒度提示跟随 | DPG-Bench | 78.9 | 匹配微调 78.7 | +0.2 |
| 人类偏好对齐 | HPS v2.1(四风格平均) | 0.282 | 匹配微调 0.280 | +0.002 |
| 部分噪声重建·全景分割(COCO 真值,τ=0.5) | OneFormer PQ | 31.43 | PixelGen 23.23 | +35.3% |
| 部分噪声重建·全景分割(Flickr30K 伪标签,τ=0.5) | OneFormer PQ | 30.09 | PixelGen 19.66 | +53.1% |
| 部分噪声重建·单目深度(Flickr30K,τ=0.5) | AbsRel 均值(Marigold,仿射拟合后) | 1.03 | PixelGen 1.61 | −36.0% |
| 部分噪声重建·表面法向(COCO,τ=0.5) | 平均角误差(°) | 17.84 | PixelGen 21.80 | −3.96° |
| 跨骨干迁移(DeCo-T2I 512×512) | GenEval Overall | 0.8690 | DeCo 匹配微调 0.8620 | +0.0070(DPG 另 +0.4) |
| SDEdit 编辑背景保持(PIE-Bench,τ=0.6) | 背景 PSNR (dB) | 23.92 | PixelGen 21.76 | +2.16 dB(全噪声水平均优,FID τ=0.3 时 41.85 vs 53.99) |
| 从零训练收敛(128×128,BLIP3-o-60K) | 达到基线峰值 GenEval 所需步数 | 约 1.23× 提前,且后续 100K 步内持续高于基线 | 无 PixelDense 的从零训练 | 1.23× 收敛加速 |
局限与改进
作者承认的局限:编辑实验只覆盖 SDEdit,未测试反演式或指令式编辑;对齐只作用于单个中间块(第 8 块),多尺度、多块对齐未探索;未做骨干与语料规模扩展;教师库限于所研究的四个感知模型;编辑后的身份与 3D 几何度量留待未来。我的补充观察:其一,绝对增益不大——DPG 仅 +0.2、HPS 仅 +0.002,GenEval +0.0166 说服力有限,且主对比对象是作者自己微调的模型而非社区公开检查点;其二,训练成本显著增加,每步需前向 DINOv2 加三个大型骨干(SAM2-Hiera-L 与两个 ViT-L),本质是把成本从推理转移到训练;其三,正交约束只施加在第一层输入投影的行空间,完整非线性双流并不保证正交,机制解释与实际约束有缺口;其四,Flickr30K 全景评估依赖 COCO 词表的 OneFormer 伪标签参考,深度与法向也用 Marigold 自举伪参考;其五,密集教师训练分布的偏差会被继承;其六,主实验仅在 512×512、约 6 万张 BLIP3-o-60K 小语料上微调 1 万步,可扩展性未知。
独立分析的弱点
第一,主基准增益偏小:DPG 仅 +0.2、HPS 仅 +0.002,说明密集对齐对全局美学与细粒度语义帮助有限,改进方向是与文本对齐类后训练(RLHF/DPO)联合,或在语义流加入 SigLIP 等更强语义教师并保持分流路由。第二,训练开销大:四个冻结教师中三个是大型骨干,每步前向显著增加 FLOPs 与显存,可探索教师特征离线缓存或低秩教师蒸馏。第三,超参手工化:权重 0.5/0.3/0.3/0.3、λ_orth=0.01、块 8 均来自网格搜索,且对齐块从 8 移到 10 掉分明显(0.8007),稳健性存疑,可引入不确定性加权或课程式调度(借鉴 HASTE、ERW)自动决定注入时机与强度。第四,方法绑定像素空间:潜空间扩散缺少 RGB patch 网格,可尝试在 VAE 解码特征或潜变量对应网格上建立逐 token 对齐。第五,语义/几何二分是人类先验而非学到的结构,表 9 显示分解后 DINOv2-SAM2 步增量余弦仍有 0.3567、DA2-M3D 高达 0.9477,组内未完全解耦,可按教师特征谱聚类自动分组并扩展到多于两股流,并对整条非线性流施加表征级去相关。
未来方向
作者提出的方向:多尺度与多块对齐;扩大骨干与训练语料规模;探索四个感知模型之外更丰富的教师库;把编辑实验扩展到反演式与指令式方法,并配套身份保持与 3D 几何度量。基于本文成果可自然延伸:其一,把语义/几何分流路由推广到视频扩散,同时服务时序一致性与 3D 一致性,直接升级 Align4Gen 与 Geometry Forcing;其二,按深度/法向/边界进一步细分教师组,自动学习分组与权重,形成可扩展的教师路由框架;其三,结合课程式对齐调度研究对齐信号在不同训练阶段的最优注入时机,可能进一步压缩从零训练成本;其四,把密集教师知识蒸馏进生成器本身,让小模型也获得几何先验;其五,利用训练好的语义/几何流中间特征作为结构控制信号,用于可控布局生成、SAM2 mask 条件生成与几何感知编辑;其六,在潜空间扩散中复现该配方以检验其普适边界。
复现评估
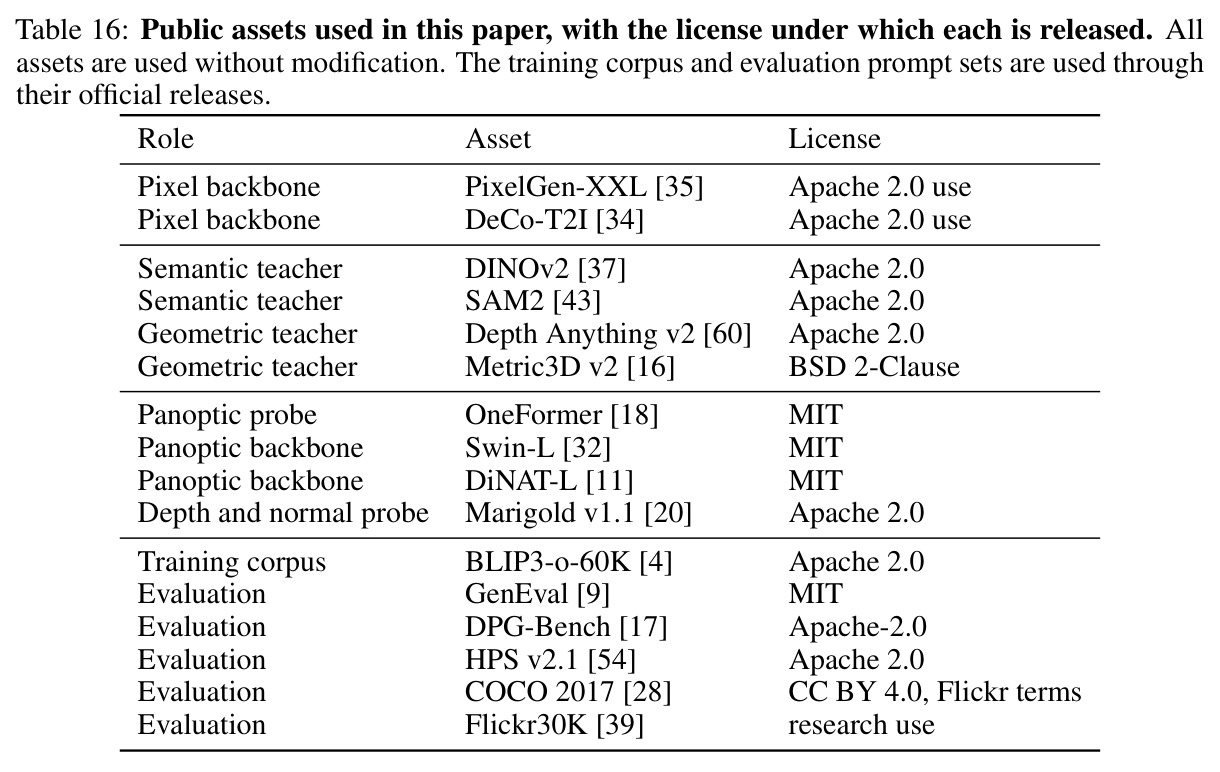
可复现性总体较好但门槛不低。资产方面:论文表 16 逐一列出全部公共资产与许可证——PixelGen-XXL 与 DeCo、DINOv2/SAM2/Depth Anything v2(均 Apache 2.0)、Metric3D v2(BSD 2-Clause)、OneFormer/Swin-L/DiNAT-L(MIT)、Marigold(Apache 2.0)、BLIP3-o-60K 语料及 GenEval/DPG-Bench/HPS v2.1 评测集均为官方发布;评测协议完全标准化(GenEval 553 提示官方打分器、DPG 官方 grader、HPS 四个 800 提示风格集),且未重训任何教师或探测器。算力方面:微调需 2×H200、有效批 256、10000 步,加每步四个教师前向,属中高门槛;从零训练需 128×128 下 10 万步。正文未明确承诺开源训练代码,若不开源,复现双流投影、教师特征重采样对齐与评估管线仍有可观工程量。总体而言数据与协议描述极为详尽、指标可第三方验证,主要风险在像素扩散训练框架与教师特征抽取的工程细节。
论文图表
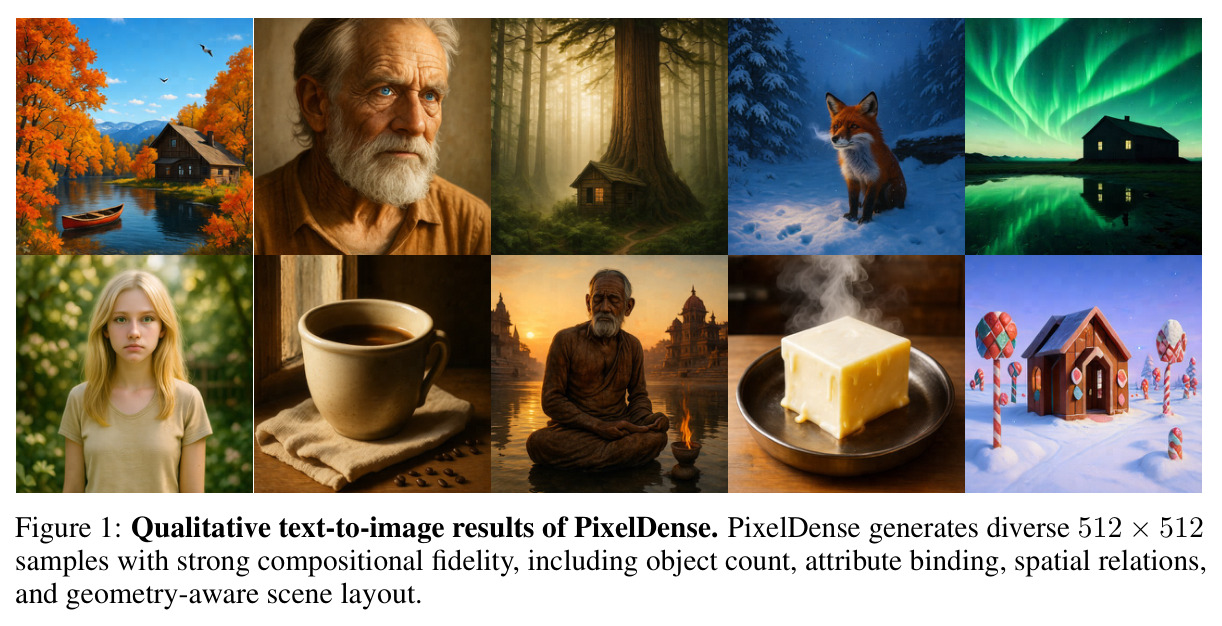
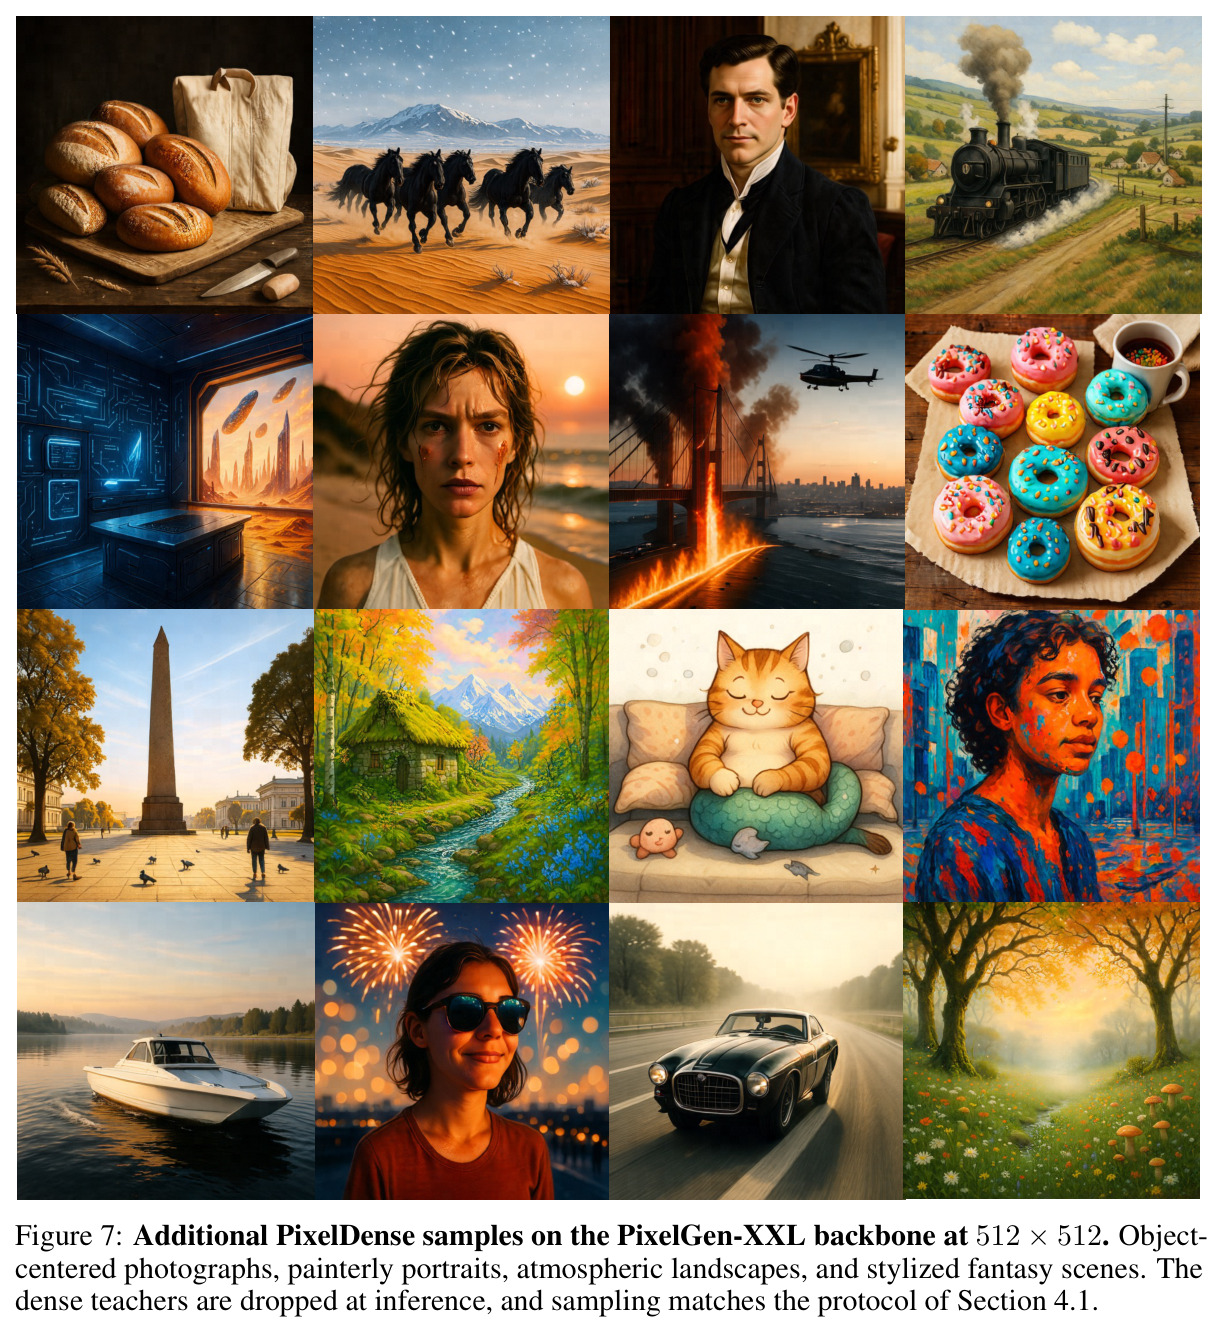
PixelDense 在 512×512 上的多样化文生图样本,展示物体数量、属性绑定、空间关系与几何感知场景布局方面的强组合保真度。
作为开篇 teaser,直观呈现方法的最终生成能力,是理解论文卖点(组合保真与几何感知)的第一入口。
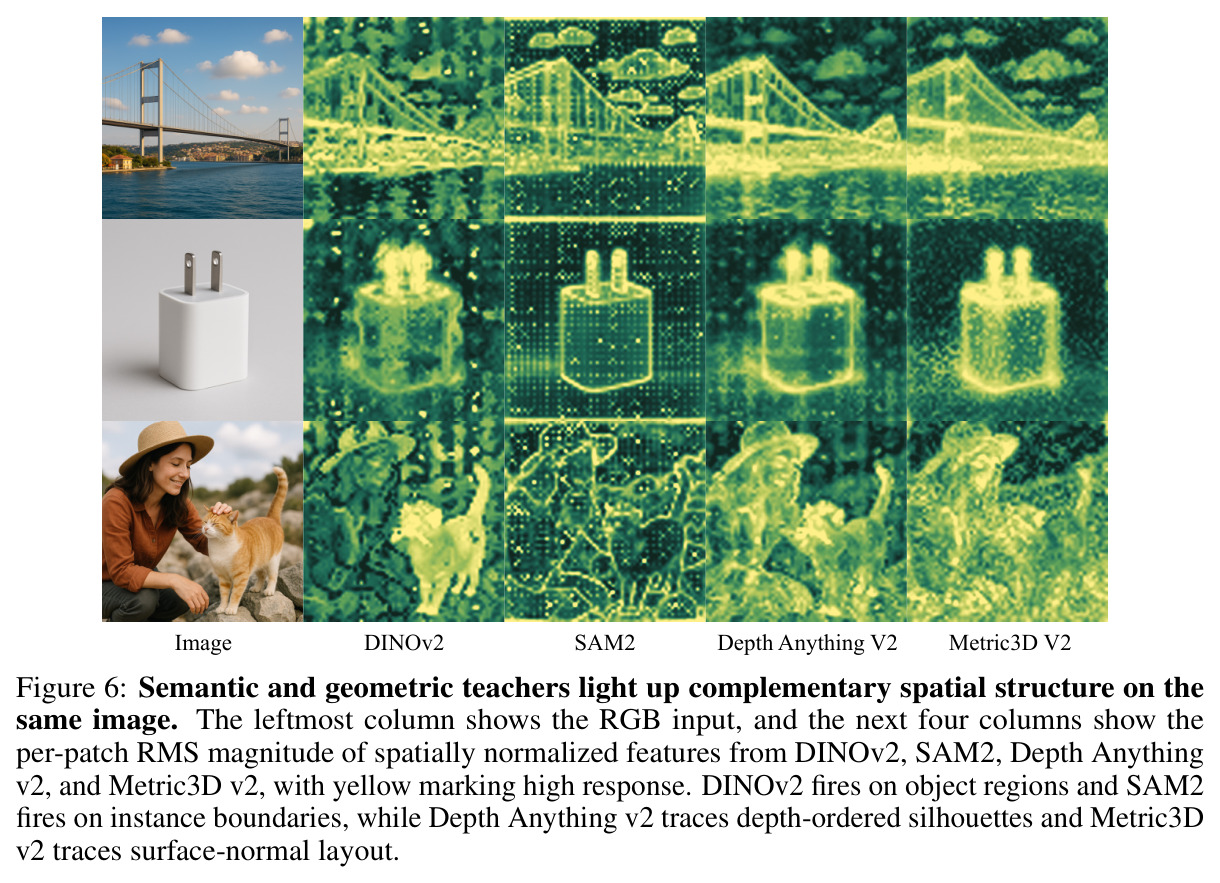
同一 RGB 输入上四个教师的逐 patch 特征 RMS 响应热图:DINOv2 在物体区域激发,SAM2 沿实例边界激发,Depth Anything v2 勾勒深度排序轮廓,Metric3D v2 呈现表面法向布局。
直观论证语义教师与几何教师捕获互补结构,是语义/几何分组与双流 factorization 的动机证据(附录 C.1)。