引导像素扩散Transformer的表征学习 Learning Representations to Guide Pixel Diffusion Transformers
用低维瓶颈与表征引导目标,让普通Transformer学会真正服务于像素生成的内部表征。
前置知识
流匹配(Flow Matching)
一种连续时间生成范式:在噪声分布与数据分布之间定义直线路径 $z_t = t x + (1-t)\epsilon$,训练网络预测速度场 $v = x - \epsilon$,推理时沿该常微分方程积分即可生成样本。相比 DDPM 训练目标更简单、采样路径更直。本文遵循 JiT 的做法让网络直接预测干净图像 $x_\theta$,再换算成速度 $v_\theta = (x_\theta - z_t)/(1-t)$,等效于按 $1/(1-t)^2$ 重加权的 x 空间损失。
RG 的核心操作就是把流匹配的训练目标 $v = x - \epsilon$ 沿表征诱导的速度偏移 $\Delta v^{rep}$ 进行外推修改,不理解流匹配的目标形式就无法理解 RG 在改什么。
像素空间扩散 vs 潜空间扩散
主流扩散模型(DiT、SiT 等)先经 SD-VAE 把图像压到低维潜空间再生成,训练快但受重建瓶颈限制;像素空间扩散直接对 RGB 像素建模,避免 VAE 重建损失、保留细粒度细节,但高频细节使收敛更慢、更难学到高层语义。像素扩散 Transformer(pDiT)指直接在像素上工作的 DiT 类架构,JiT 证明普通 Transformer 就能做出有竞争力的像素生成。
本文的研究对象就是 pDiT,核心主张是不需要越来越复杂的像素专用解码器,普通 Transformer 加上正确的表征处理即可逼近潜空间模型的质量。
REPA(表征对齐)
一种加速扩散训练的方法:在网络的某个中间层挂一个投影头,用余弦相似度损失把该层特征对齐到冻结的 DINOv2 特征,让中间表征提前获得语义与空间结构,从而加快早期收敛。本文沿用 REPA 作为"语义脚手架"(λ=0.5,对齐 encoder 第 3/5/7 层),但实验证明对齐层的增益在后续层会迅速消失。
本文第一节的关键实验就是把 REPA 加在 JiT 不同层上,发现"表征质量提升 ≠ 生成效用提升",这个反直觉发现直接引出了 RG 的设计动机。
CFG(无分类器引导)
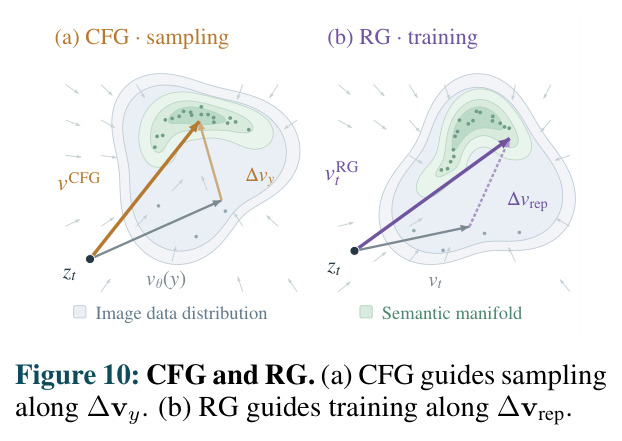
采样期的引导技术:训练时以 0.1 概率把条件 c 置为空 token,使单一网络同时建模条件与无条件速度;采样时按 $v_w = v_\emptyset + w(v_c - v_\emptyset)$ 外推,等效于从锐化分布 $p(z_t)p(c|z_t)^w$ 采样。代价是推理需要两次前向。RG 与其数学形式同构,但把引导从采样期搬进了训练目标。
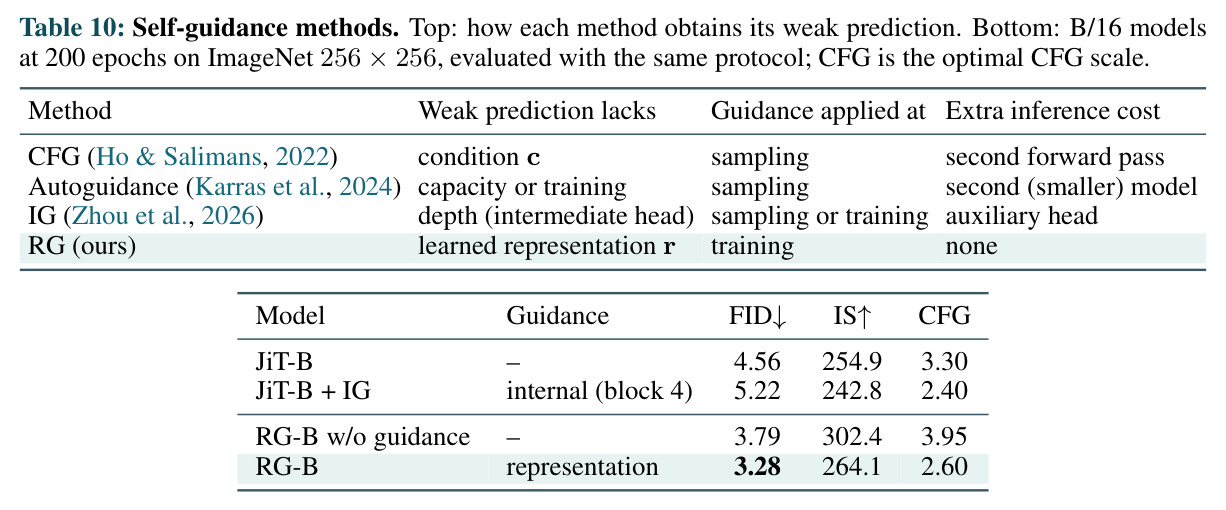
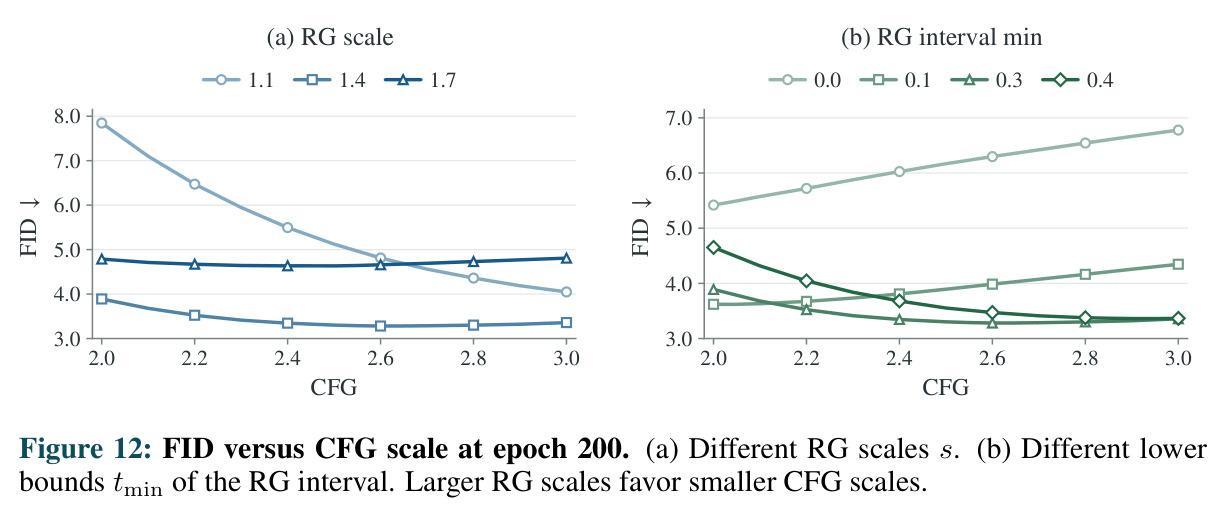
RG 收敛时等效于以表征 r 为条件的 CFG,有效引导尺度 $w_{rep} = 1/(2-s)$;理解 CFG 才能理解为什么 RG 会"锐化"分布、为什么启用 RG 后最优 CFG 尺度从 3.95 降到 2.60。
FID(Fréchet Inception Distance)
图像生成质量的标准指标:把真实图像与生成图像分别通过 Inception 网络提取特征,各自拟合多元高斯分布,再计算两个高斯之间的 Fréchet 距离。FID 越低表示生成分布越接近真实分布。类条件 ImageNet 生成通常报告 50K 样本的 FID-50K,并配合 IS(越高越好)、Precision/ Recall 使用。
论文的主要量化结论都围绕 FID 展开(如 RG-XL/16 在 ImageNet 256×256 达 1.55),所有对比与消融都以此为核心指标。
DINOv2 与自监督视觉表征
Meta 提出的自监督预训练视觉编码器(ViT 架构,学生-教师自蒸馏训练),其特征同时具有强全局语义(线性探测分类精度高)和清晰的空间结构(patch 特征能勾出物体分割边界),广泛用作下游任务的教师。本文用 DINOv2-B/14(带 registers)作为 REPA 对齐目标,并消融比较了 DINOv3。
论文反复用线性探测精度、RMSC、LDS 衡量内部表征的语义与空间质量,这些度量的参照系正是 DINOv2 这类"理解型"好表征,也用于暴露它们对生成未必有用。
研究动机
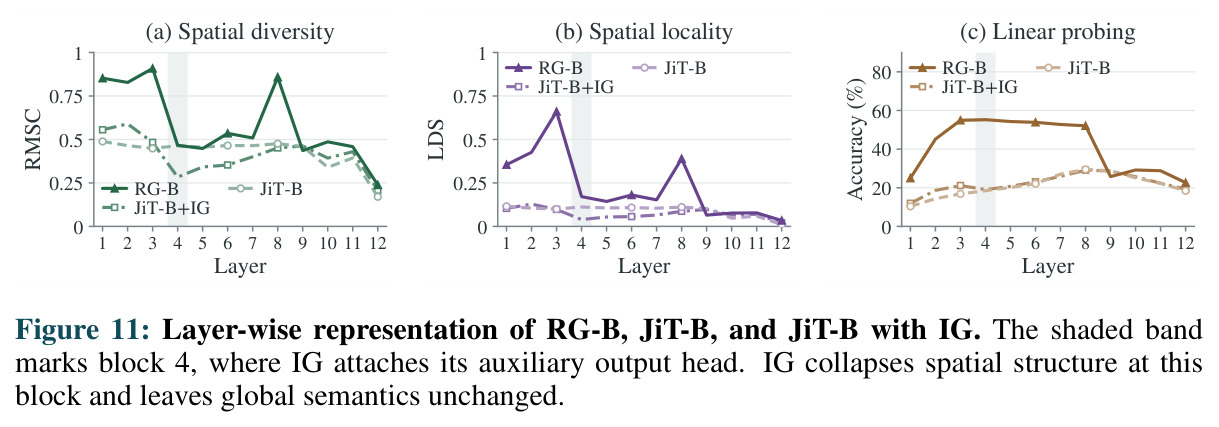
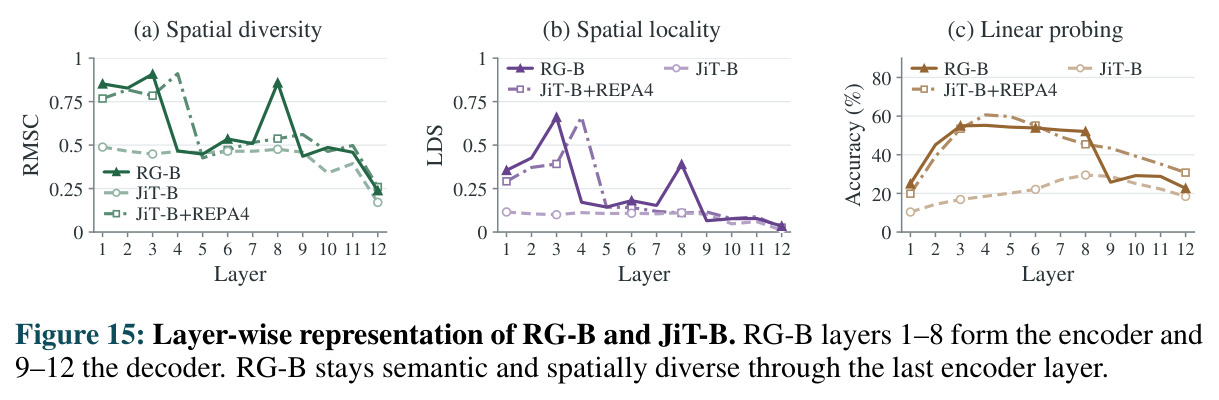
视觉表征学习十年来的成果几乎全部服务于"理解"(分类、检测、分割),理解任务可以丢弃大量低层像素内容,而生成必须组织全局语义与空间结构、最终还要恢复每一个像素,"好表征"的定义在两个场景下并不相同。近期生成模型大量借用预训练编码器:或把 VAE 潜空间对齐到 DINOv2 特征(VA-VAE、RAE),或直接以预训练特征为生成潜变量,或用 REPA 把扩散中间特征对齐到 DINOv2。但这些工作只关注"表征里有什么信息",忽略了另一半问题。论文用实验揭示了具体裂缝:在 JiT-B/16 上把第 4 层对齐 DINOv2(REPA-4),对齐层的线性探测精度冲到 60.7%、LDS 达 0.662,但这些增益向输出方向逐层衰减,到第 12 层精度跌至 30.8%、LDS 跌至 0.025;生成侧 REPA-4 只在早期加速训练,约 160 epoch 后被基线反超,最终 FID 4.80 反而差于基线的 4.56,把对齐挪到更深层(REPA-6/REPA-8)更是恶化到 5.38 和 8.33。
本文的目标是论文要回答"什么使表征对视觉生成有用"这一根本问题,并据此给出可操作的方法:在保持 JiT 式普通 Transformer 架构(不引入任何像素专用解码器)的前提下,让内部表征既被正确地形成——紧凑、面向生成、语义与空间结构清晰——又被生成过程主动地利用——梯度真正流经它、解码器真正依赖它。两者缺一不可:强行让生成器依赖形成不良的表征会放大无益的低层信息,而结构良好的表征若可被绕开则毫无收益。最终目标是以此缩小像素空间扩散与潜空间扩散的性能差距,并在类条件 ImageNet 256/512 与文本到图像生成上验证其可扩展性与通用性。
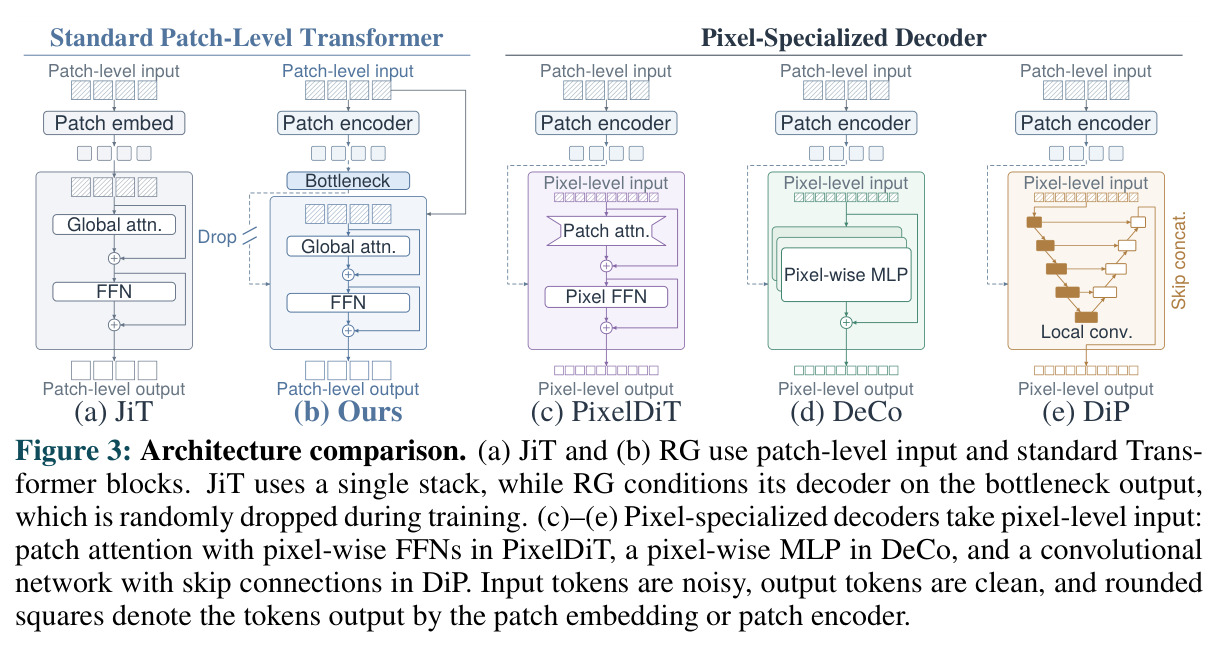
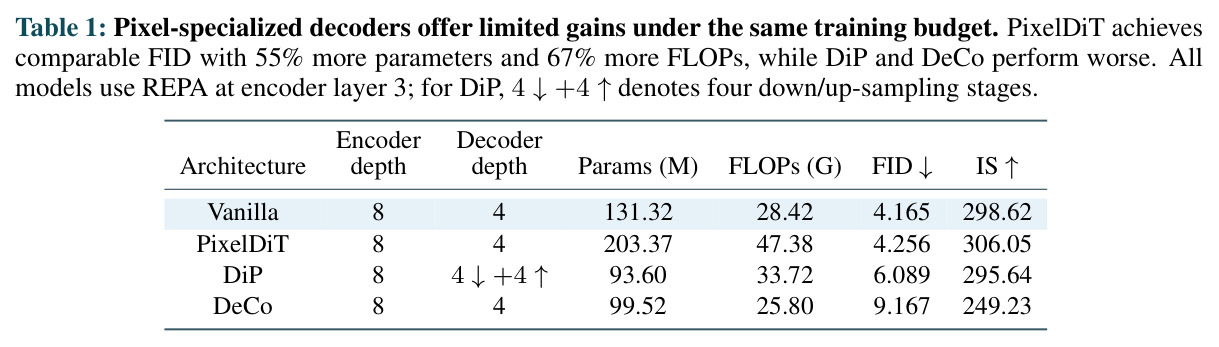
与已有工作不同的是,已有的两条改进路线都被论文用实验质疑:其一,注入更强外部语义(REPA 及其变体)只在被对齐的层有效,语义在通往像素预测的路上被逐步覆写;其二,用专用像素解码器把表征学习与像素合成分离(PixelDiT 用像素级注意力、DeCo 用逐像素 MLP、DiP 用卷积加跳连)看似合理,但论文发现解码器的设计反过来决定编码器必须保留什么——DeCo/DiP 保留更多空间结构却丢失语义,vanilla/PixelDiT 保留语义却没有空间结构,是"重新分配"而非"改进":PixelDiT 与 vanilla 的 FID 相当(4.256 vs 4.165)却多 55% 参数、67% FLOPs,DiP 和 DeCo 反而更差(6.09、9.17)。论文的独特切入点是在"表征接口"上做文章:用低维瓶颈控制表征如何形成,用模型自身表征诱导的速度偏移修改训练目标确保表征被使用,两者都不改变普通 Transformer 的架构。
核心方法
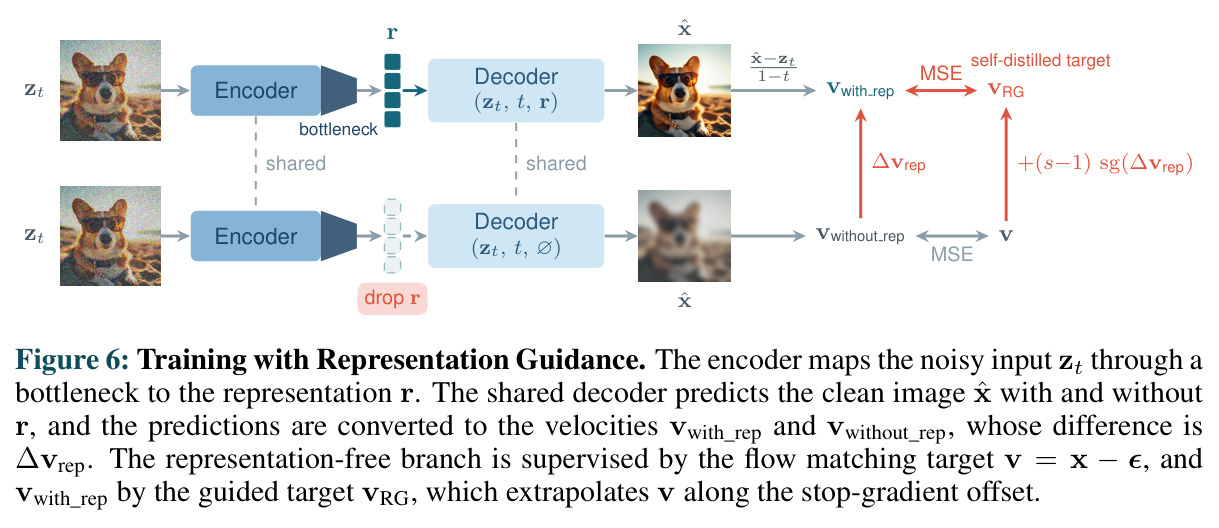
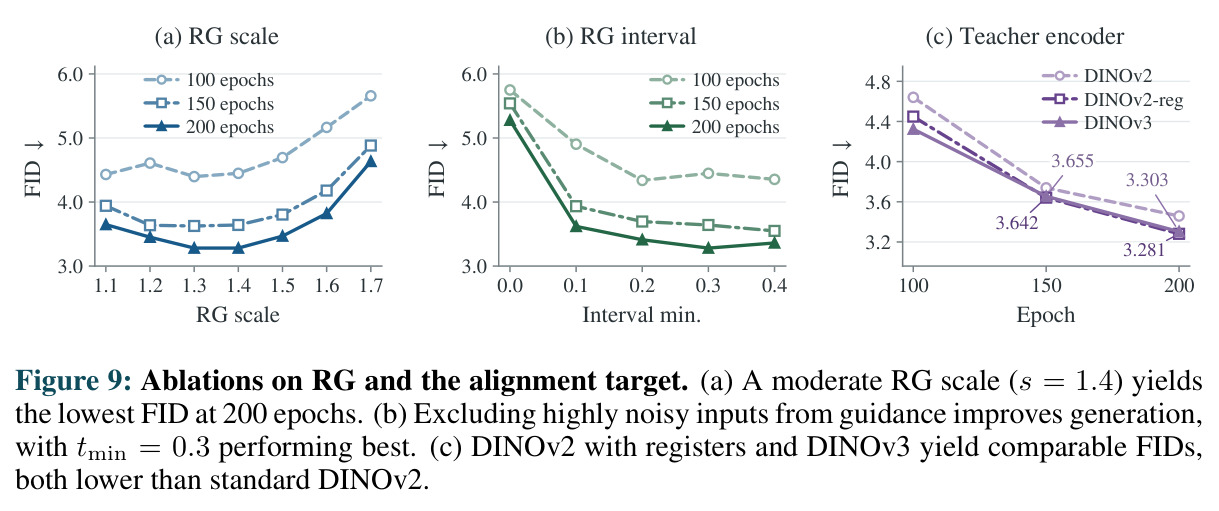
直觉上,对生成有用的表征必须"形成得好"且"被用得上"。技术路线:采用 DDT 式解耦编码器-解码器(均为 JiT 标准块,B/16 为 8+4 块),编码器输出 $h \in \mathbb{R}^{N \times D}$ 经线性瓶颈 $u = h W_{down} \in \mathbb{R}^{N \times d}$、$r = u W_{up}$($d \ll D$,默认 128)形成隐式潜空间,r 作为逐 token 的 adaLN 条件输入解码器预测干净图像。训练时以 0.1 概率把 r 置零,使同一网络可预测无条件速度;RG 把两者之差加入流匹配目标:$v^{RG} = v + (s-1)\,\mathrm{sg}(\Delta v^{rep})$,其中 $\Delta v^{rep} = v_\theta(z_t, t, r) - v_\theta(z_t, t, \emptyset)$ 由 EMA 教师计算,s=1.4,仅在 $t \in (0.3, 1]$ 启用。
核心创新是把"引导"从采样期搬进训练期,且让弱预测与强预测只差一个表征。与 CFG(推理期外推、需两次前向)、autoguidance(需额外小模型)、Internal Guidance(中间块挂辅助头)不同:RG 两分支共享解码器、输入 $z_t$、时间 t 与类条件 c,唯一区别是 r 是否置零,故 $\Delta v^{rep}$ 精确隔离出紧凑学习表征的贡献。论文证明收敛解为 $v_\theta = \bar{v}_\emptyset + \frac{1}{2-s}(\bar{v}_r - \bar{v}_\emptyset)$($1 \le s < 2$),即以表征为条件的 CFG,有效尺度 $w_{rep} = 1/(2-s)$(s=1.4 时约 1.67),对应锐化分布 $p(z_t)p(r|z_t)^{w_{rep}}$。更关键的是 $\mathcal{L}_{RG}$ 的梯度流经 r 回传到瓶颈和编码器——引导条件本身是被学习的,训练直接塑造表征。这与自蒸馏同源:自蒸馏锐化教师分布产生判别特征,RG 沿表征偏移锐化速度目标,逼迫表征编码生成所需的语义与空间结构。
方法步骤详情
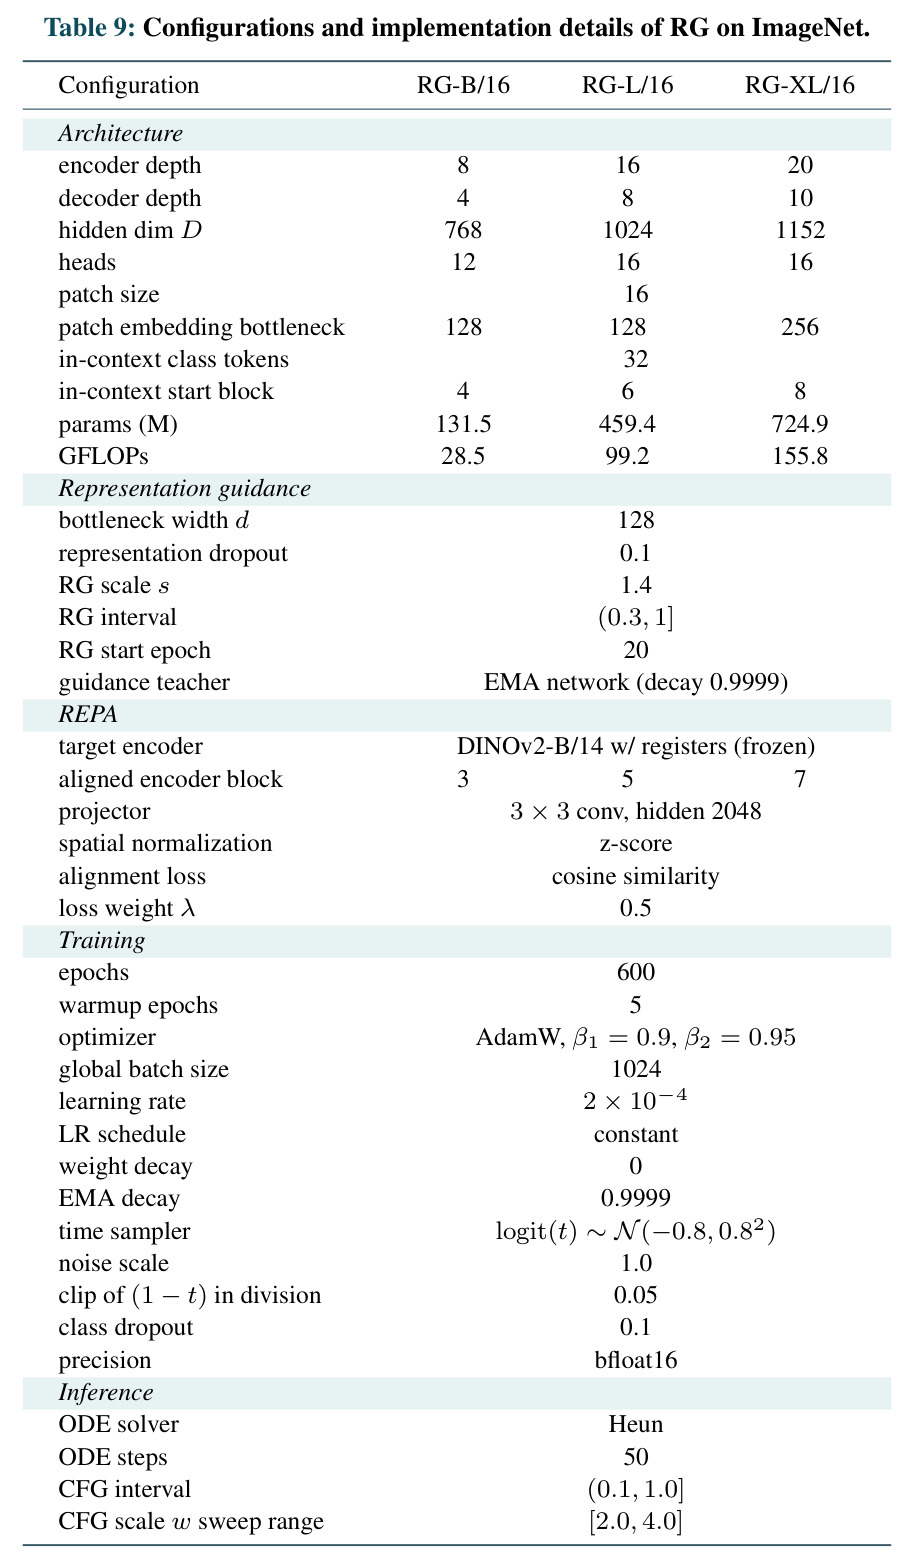
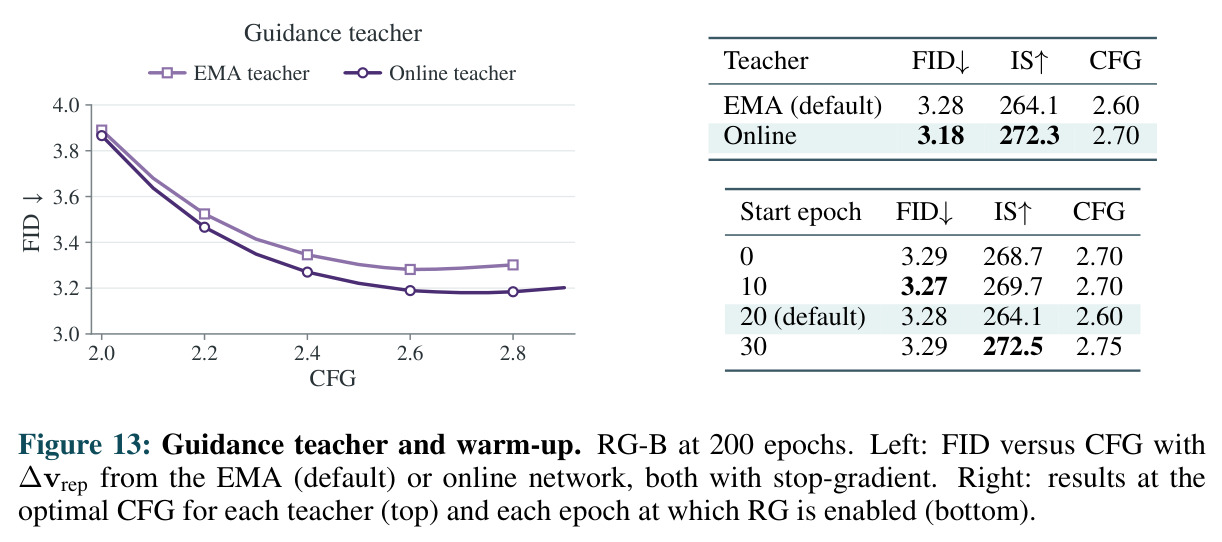
一个训练步:(1) 采样 $(x,c)$、$\epsilon \sim \mathcal{N}(0,I)$、$t$(logit-normal),构造 $z_t = tx + (1-t)\epsilon$。(2) 编码器 $E_\theta$(B/L/XL 为 8/16/20 块)处理 $z_t$,经瓶颈(d=128)得表征 r。(3) 用 EMA 网络(decay 0.9999)做两次无梯度前向:含 r 得 $v^{with\_rep}$,r 置零得 $v^{without\_rep}$,差为 $\Delta v^{rep}$;RG 仅在 $t \in (0.3, 1]$ 启用,20 epoch 热身后开启。(4) 计算引导目标 $v^{RG} = v + (s-1)\,\mathrm{sg}(\Delta v^{rep})$。(5) 在线解码器(B/L/XL 为 4/8/10 块)以 r 为 adaLN 条件预测 $\hat{x}$ 并换算速度,用 $\|v^{with\_rep} - v^{RG}\|^2$ 更新。(6) 总损失 $\mathcal{L} = \mathcal{L}_{RG} + \lambda \mathcal{L}_{REPA}$(λ=0.5,余弦对齐编码器第 3/5/7 层到冻结 DINOv2-B/14-reg)。配置:AdamW、恒定 lr 2e-4、batch 1024、bfloat16、8×A100、600 epoch;推理 50 步 Heun + 区间 CFG,RG 零推理开销,训练仅多两次 EMA 前向(+0.4M 参数、13% FLOPs)。
技术新颖性
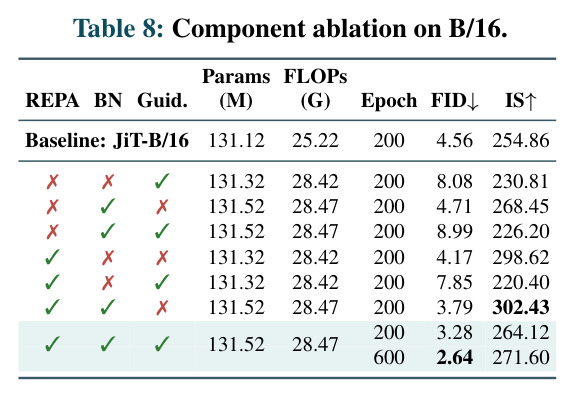
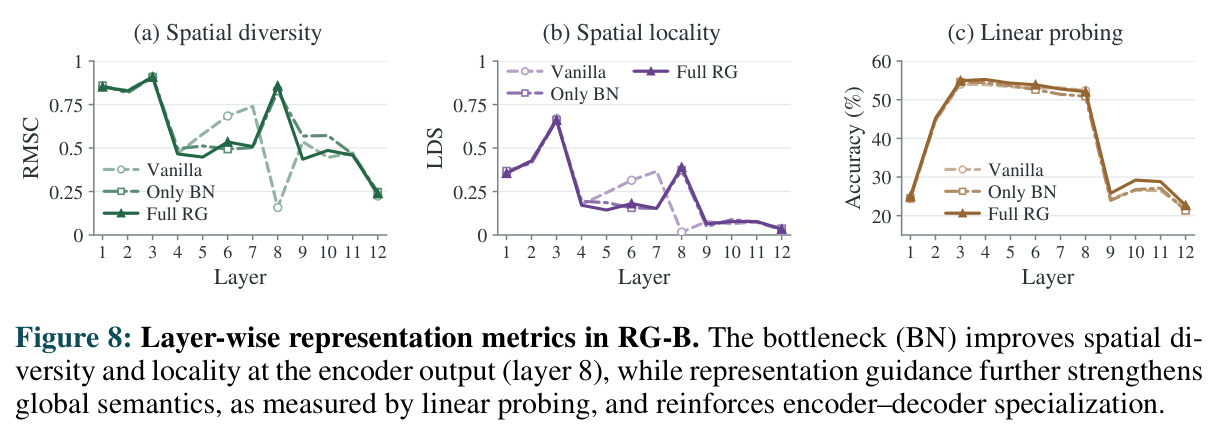
新颖性体现在三个层面。诊断层面:论文首次系统性地用表征度量(RMSC、LDS、线性探测)沿层追踪并证明两个反直觉结论——外部对齐的语义会随像素合成的深入被逐步覆写(REPA-4 的探测精度从 60.7% 跌到 30.8%),专用像素解码器只是在编码器与解码器之间重新分配语义/空间建模负担而非改进表征(四种架构 FID 为 4.165~9.167,无一稳定占优)。目标层面:RG 是首个用"模型自身学习表征"在训练期修改流匹配目标的引导方法,与 autoguidance(弱预测缺容量、需第二个模型)、IG(弱预测缺深度、需辅助头)形成清晰对照(Table 10),RG 不需要第二个模型、不需要辅助头、无推理开销,且引导方向由被优化的对象本身定义。表征层面:瓶颈形成的"隐式潜空间"是个精巧设计——它像 VAE 潜空间一样紧凑且有空间组织,但每个时间步都从 $z_t$ 现场计算、为生成目标端到端优化,而扩散过程仍留在像素空间,兼得两者之长。组件消融(Table 8)也证明三件套缺一不可:单独加 RG 反而把 FID 从 4.56 推高到 7.85~8.99,只有"REPA 脚手架 + 瓶颈 + 引导"组合才把 FID 降到 3.28。
实验结果
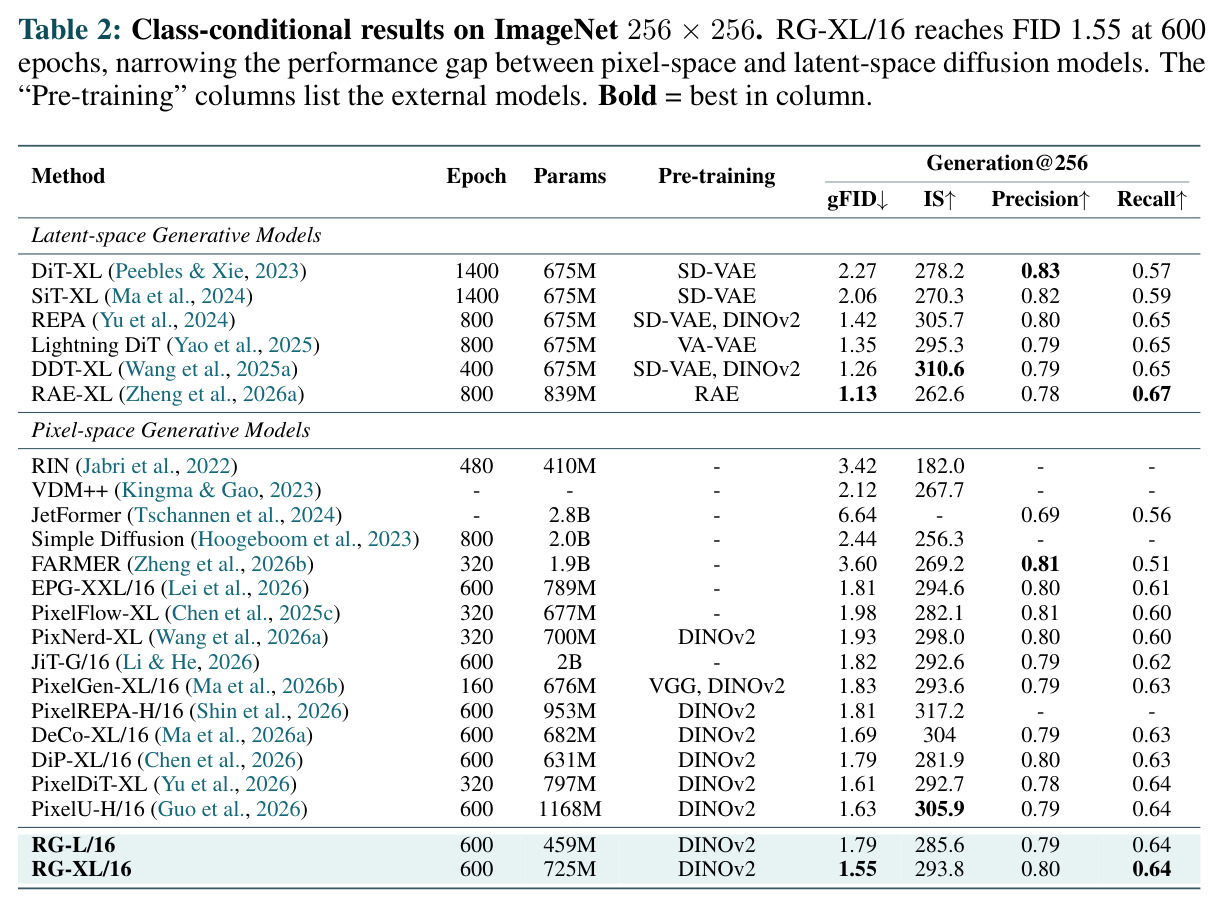
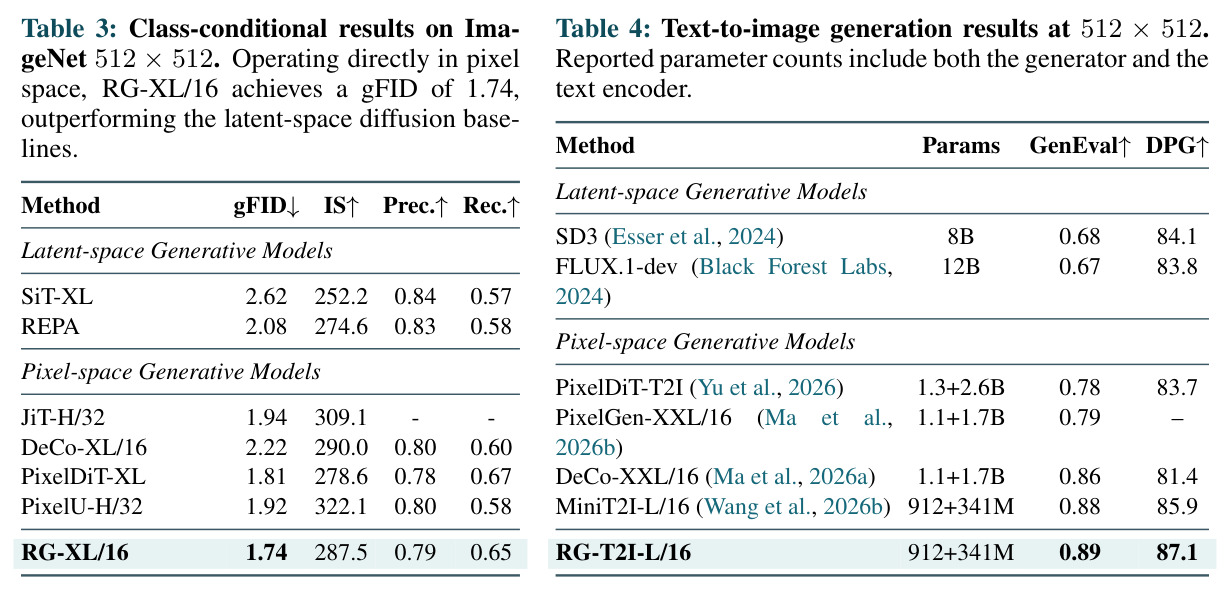
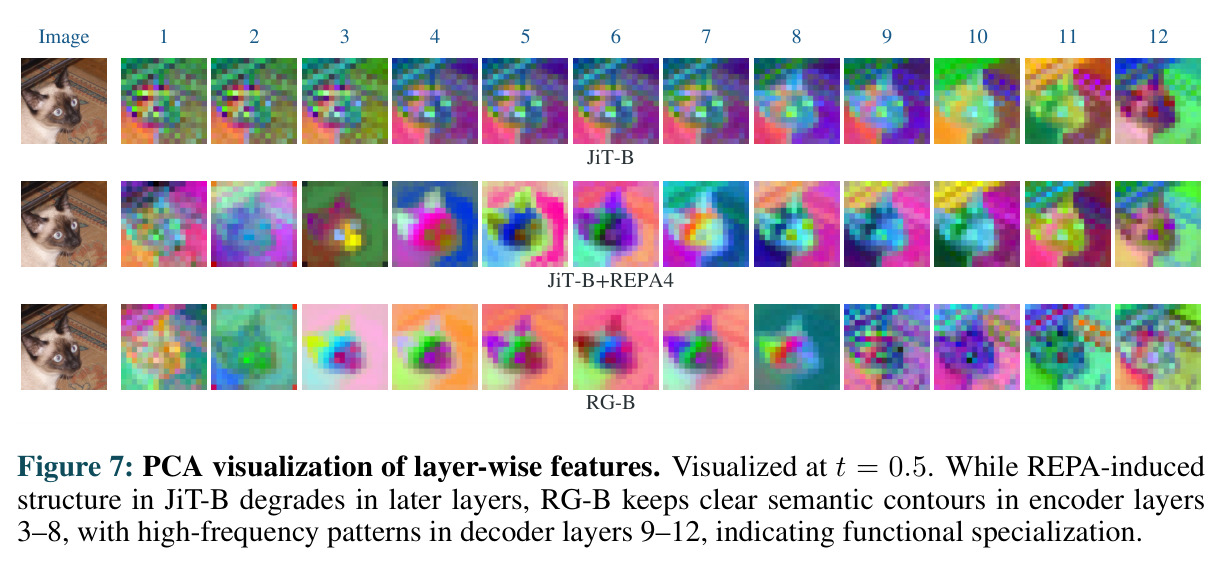
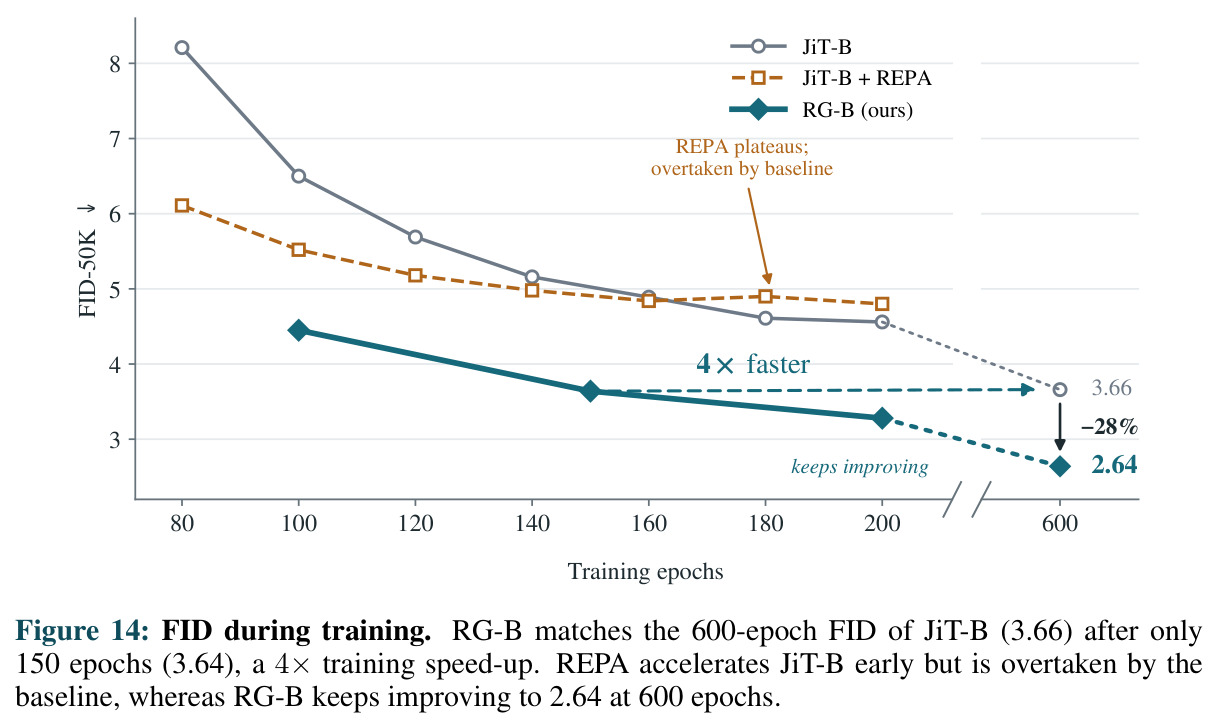
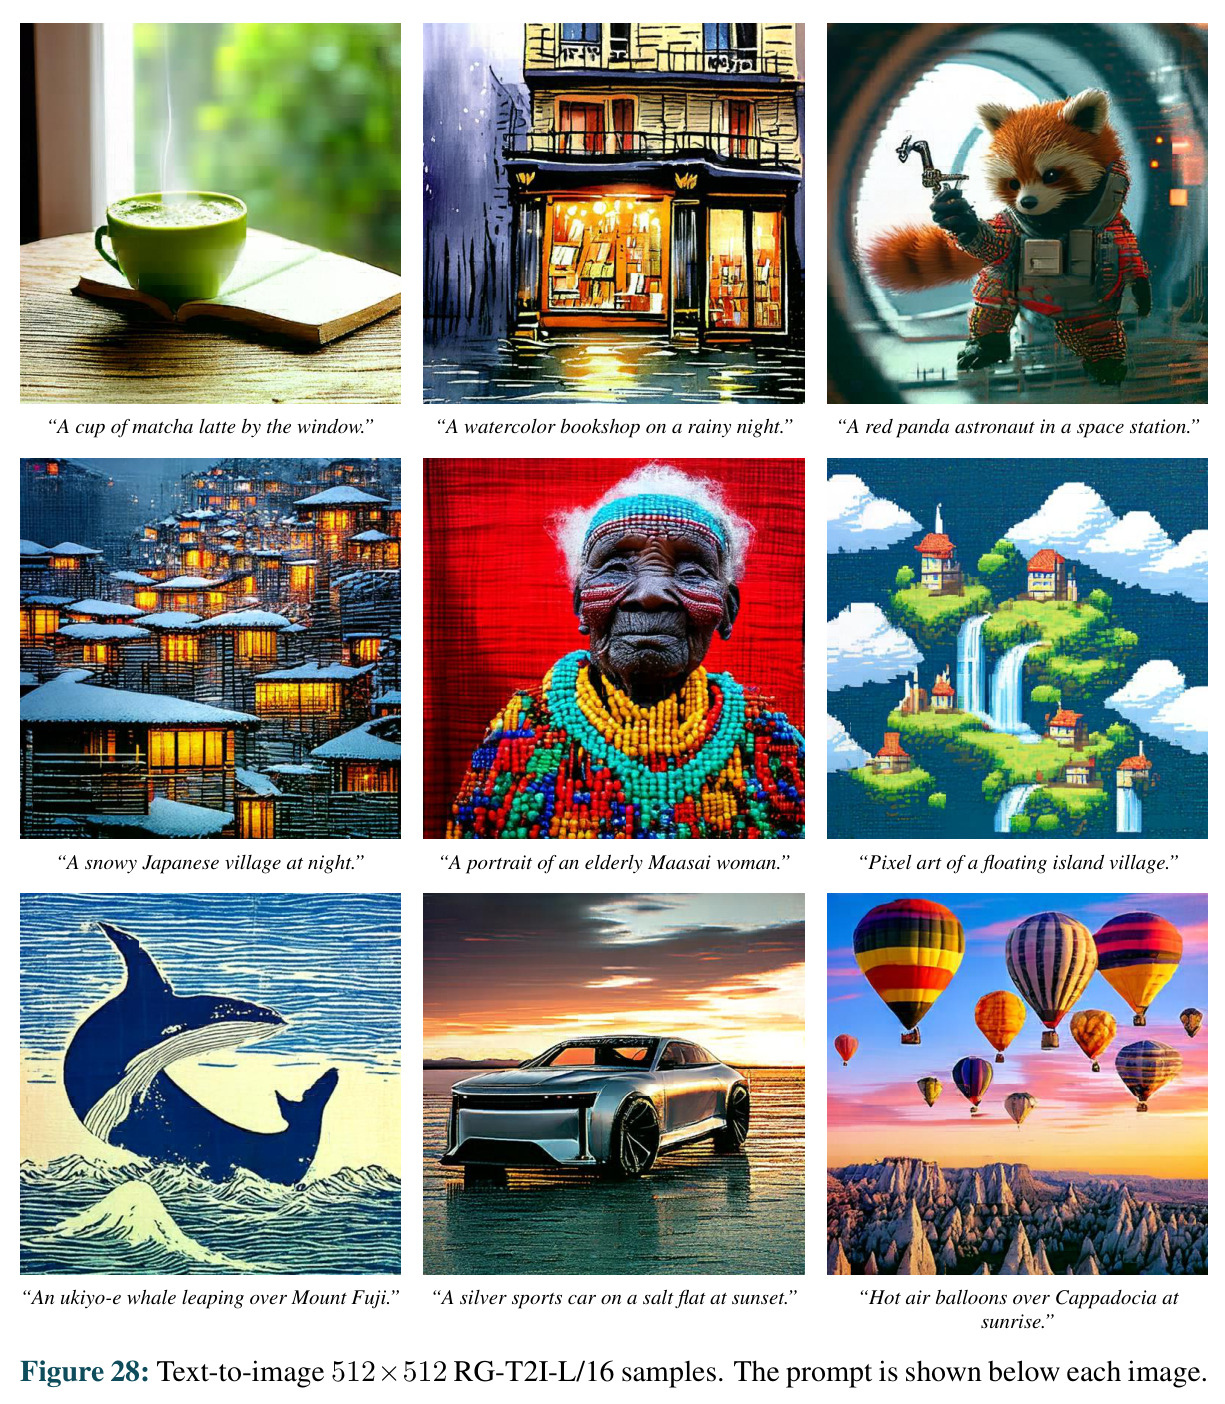
逐实验分析:(1) ImageNet 256×256(Table 2):RG-XL/16(725M,600ep)gFID 1.55、IS 293.8,为像素空间最低,超过 PixelDiT-XL(1.61)、DeCo-XL(1.69)、DiP-XL/16(1.79);RG-L/16 仅 459M 达 1.79,超过 2B 的 JiT-G/16(1.82)与 953M 的 PixelREPA-H(1.81),参数效率约 4 倍。(2) 512×512(Table 3):RG-XL/16 gFID 1.74,超过 PixelDiT-XL(1.81)、REPA(2.08)、SiT-XL(2.62)。(3) 文生图(Table 4):RG-T2I-L/16(912M+341M 文本编码器)GenEval 0.89、DPG 87.1,超过 SD3(8B,0.68/84.1)、FLUX.1-dev(12B,0.67/83.8),较同配方 MiniT2I-L/16(0.88/85.9)+0.01/+1.2。(4) 组件消融(Table 8):4.56 → +REPA 4.17 → +瓶颈 3.79 → +引导 3.28(600ep 2.64);缺 REPA 或瓶颈时引导使 FID 升至 7.85~8.99;RG 仅 +0.4M 参数、13% FLOPs。(5) 收敛(Figure 14):RG-B 150ep 达 JiT-B 600ep 水平(3.64 vs 3.66),4 倍加速且持续改进,而 REPA 版约 160ep 后被基线反超。(6) 表征(Figure 15):RG-B 编码器 3–8 层线性探测稳定在 52.1%–55.2%,末层 RMSC 0.858 / LDS 0.390(JiT-B 为 0.476/0.111);REPA 峰值精度 60.7% 更高但 FID 4.80 远差于 RG-B 的 3.28,印证"表征能否维持到被解码器使用"才关键。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ImageNet 256×256 类条件生成(600 epoch) | gFID ↓ | 1.55(RG-XL/16,725M) | PixelDiT-XL 1.61;DiT-XL 2.27;SiT-XL 2.06 | 较最强像素空间基线降低 0.06,较 DiT-XL 降低约 32% |
| ImageNet 256×256 类条件生成(参数效率) | gFID ↓ / 参数量 | 1.79 / 459M(RG-L/16) | JiT-G/16:1.82 / 2B;PixelREPA-H/16:1.81 / 953M | 参数少约 4.4 倍,FID 反而更低 |
| ImageNet 512×512 类条件生成 | gFID ↓ | 1.74(RG-XL/16) | PixelDiT-XL 1.81;SiT-XL(潜空间)2.62 | 较最强像素基线降低 0.07,并反超潜空间基线 |
| 文本到图像生成 512×512 | GenEval ↑ | 0.89(RG-T2I-L/16,912M+341M) | MiniT2I-L/16 0.88;SD3(8B)0.68;FLUX.1-dev(12B)0.67 | 较同规模 MiniT2I +0.01,较 SD3 +0.21 |
| 文本到图像生成 512×512 | DPG-Bench ↑ | 87.1 | MiniT2I-L/16 85.9;DeCo-XXL/16 81.4;SD3 84.1 | 较同规模基线 +1.2 |
| B/16 组件消融(200 epoch) | gFID ↓ | 3.28(REPA+瓶颈+引导,131.5M) | JiT-B 4.56(131.1M) | 降低约 28%,额外成本仅 0.4M 参数、13% FLOPs |
| 训练收敛速度 | 达到 JiT-B@600ep FID 3.66 所需 epoch | 150 epoch(FID 3.64) | JiT-B 需 600 epoch | 约 4 倍训练加速 |
局限与改进
作者承认:实验限于图像生成,更大规模、视频、3D/音频留待未来。我的观察:(1) RG 与 REPA 深度耦合——无 REPA 时引导使 FID 恶化到 7.85~8.99,"不依赖外部强特征"的主张并不彻底,且把编码器输出直接对齐 DINOv2 会灾难退化(8.97),侧面承认预训练表征本身不适合像素生成;(2) 超参敏感:s=1.4、$t_{min}=0.3$ 均为扫出,$t_{min}=0$ 时 FID 飙到 5.28,高噪声端表征不可靠只是被绕开而非解决;(3) 表征分析主要在 B/16、200ep 规模,XL 规模是否保持同样功能分化未验证;(4) 默认 EMA 教师(3.28)劣于在线教师(3.18),作者解释是推测性的且基于单次运行;(5) 全部结果无方差报告,0.06 量级的 FID 差距稳健性存疑;(6) 文生图对比中竞品用 1.7B~2.6B 文本编码器,341M 的 FLAN-T5-Large 语义上限存疑,DPG 领先幅度(+1.2)较小。
独立分析的弱点
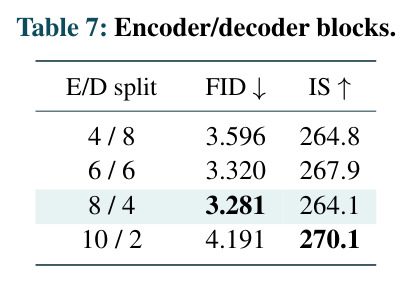
独立分析的弱点与改进方向:(1) 对预训练教师的依赖是最大软肋——REPA 是方法成立的必要条件,难以迁移到缺乏强预训练编码器的领域(医学、遥感、3D),可探索用模型自身 EMA 表征做对齐目标或用多尺度重构约束替代;(2) 高噪声区间失效($t \le 0.3$ 表征不可靠)暴露固定宽度瓶颈的局限——极端腐蚀输入被强压到 d=128 必丢信息,可设计噪声条件化瓶颈宽度;(3) 编解码 8/4 分割是手工网格搜索结果(10/2 恶化到 4.19),不同规模/分辨率未必最优,可探索可学习 token 路由让"表征何时交给像素合成"自适应;(4) EMA 教师(decay 0.9999,平均约 8 个 epoch)导致偏移滞后于当前表征,与在线教师有 0.1 FID 差距,可用更小 decay 或时间差分修正;(5) 像素空间 512×512 时 32×32 token 注意力开销仍远高于潜空间方法,可结合线性/窗口注意力;(6) RG 锐化效应($w_{rep} \approx 1.67$)与采样期 CFG 叠加的相互作用只有经验证据,s 趋近 2 的发散行为缺乏理论刻画。
未来方向
作者明确提出的方向:把 RG 扩展到更大模型规模、视频生成、3D 与音频等其他模态。基于论文成果可自然延伸的方向:(1) 视频——时间维是天然的"语义 vs 细节"分解轴,可在时间维上设瓶颈、让表征承载跨帧一致性而解码器负责逐帧高频细节;(2) 表征的下游利用——隐式潜空间 u 紧凑且空间有序,可直接在其上做语义编辑、插值、组合或作为理解任务的输入,打通"生成学表征、表征反哺理解"的闭环;(3) 与蒸馏结合——RG 已把部分引导内化进模型(最优 CFG 从 3.95 降到 2.60),或可降低蒸馏时的分布锐化误差,做更高效的学生压缩;(4) 把"训练期自引导"范式推广到自回归、掩码生成等非扩散范式,检验"表征必须被主动利用"这一结论的普适性;(5) 理论工作——严格刻画 RG 目标收敛解 $w_{rep} = 1/(2-s)$ 对应的分布锐化、以及其对样本多样性的影响(目前 precision/recall 中 recall 未受损但机理不明);(6) 用 DINOv3 或生成模型自身的教师探索"自举表征",摆脱对外部编码器的最后依赖。
复现评估
复现条件较好:代码开源(GitHub: Pan-Zihao/Representation-Guidance),有项目主页与样本;数据全部公开(ImageNet-1K、CC12M+LLaVA-NeXT 字幕、BLIP3o-60K/DALL-E 3/ShareGPT4o-Image 微调集);Table 9 给出 B/L/XL 全部架构与超参,评估协议明确(FID-50K、50 步 Heun、CFG 区间扫描)。算力门槛:8×A100 + bfloat16,XL/16 训 600ep 估计需数周;B/16 消融(200ep)单机 8 卡可复现,是最实际的起点。难度中等:超参多且耦合(s、t_min、热身、REPA 层、d=128、8/4 分割)须整体照搬;结果为单次运行无方差,0.06 级差距复现可能落入噪声;1024×1024 文生图依赖"精选内部数据"微调无法完全复现;EMA 与在线教师的差异提示实现细节可能影响 0.1 量级结果。
论文图表
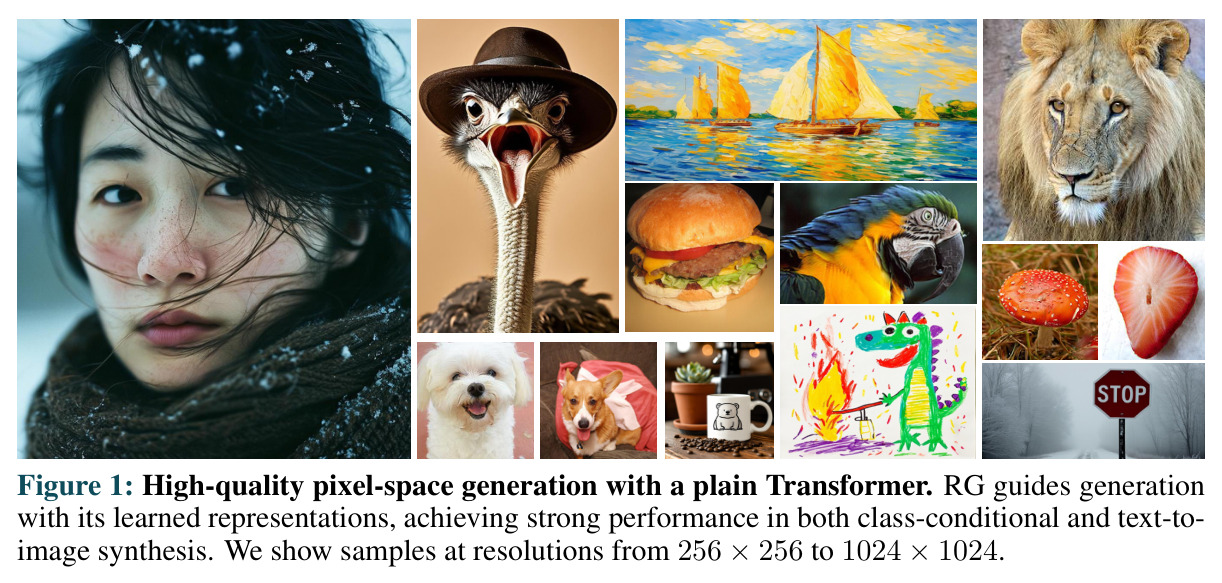
论文开篇展示图:普通 Transformer 架构(无像素专用解码器)在 RG 引导下生成的样本集,覆盖类条件生成与文生图,分辨率从 256×256 到 1024×1024,图像质量精细、语义准确。
一眼建立核心卖点:不引入任何复杂像素模块,仅靠表征层面的设计就能达到高质量像素生成,是全文主张的视觉证据。
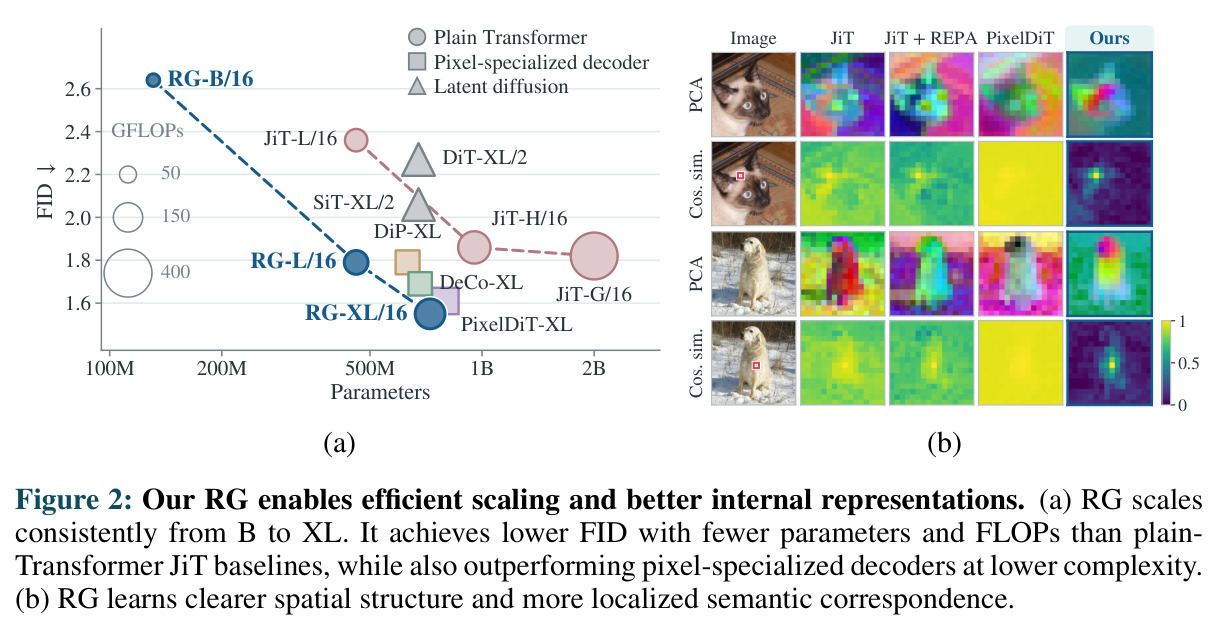
(a) 以参数量/计算量(GFLOPs)为横轴、FID 为纵轴的散点对比,RG 从 B 到 XL 稳定位于 JiT 基线与 PixelDiT/DeCo/DiP 等专用解码器方法的左下方(更少算力更低 FID),例如 RG-L/16 (459M) 优于 JiT-G/16 (2B);(b) 各方法内部特征的 PCA 与相似度对比,RG 的空间结构更清晰、语义对应更局部。
一图概括方法的两大收益——计算-质量权衡和内部表征质量,是引言部分对"表征中心设计"有效性的总览证据。
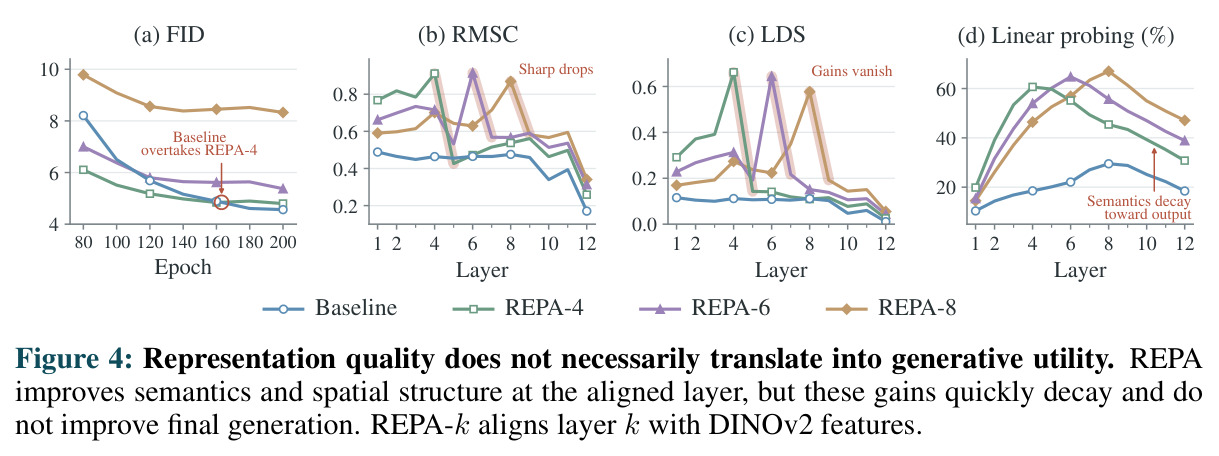
四联图:(a) FID 随训练 epoch 变化,REPA-4 早期加速但约 160 epoch 后被基线反超,200 epoch 最终 FID 4.80 vs 基线 4.56;(b)(c) 沿层追踪 RMSC 与 LDS,对齐层 4 处急剧提升随后迅速衰减;(d) 线性探测精度同样在层 4 后逐层下降。REPA-6/REPA-8 的最终 FID 分别为 5.38 和 8.33。
这是论文第一个核心洞察的证据图:外部对齐带来的表征质量增益无法穿越后续像素合成层存活,直接否定了"注入更强语义就够"的路线。
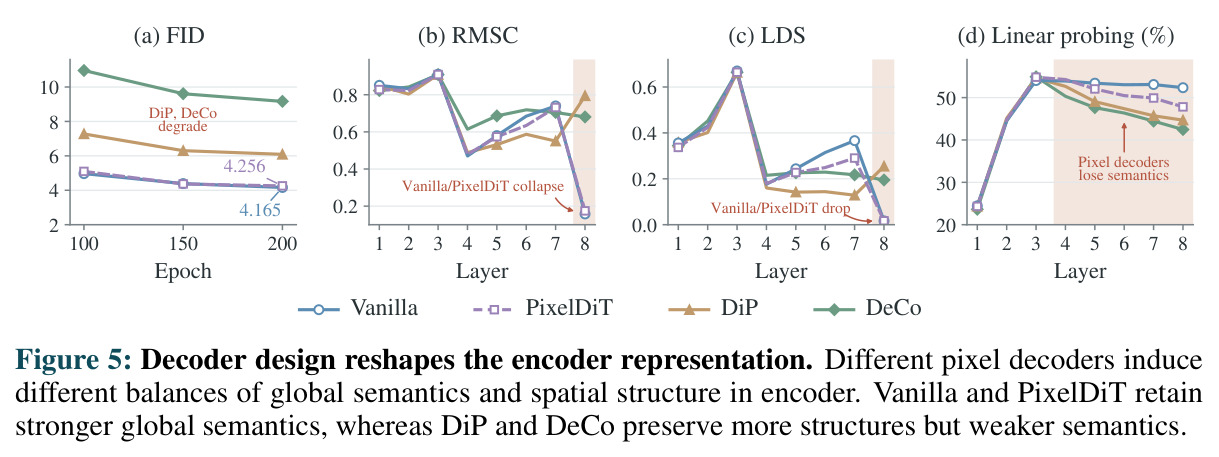
与 Figure 4 同结构的四联图,比较 vanilla、PixelDiT、DiP、DeCo 四种解码器:FID 曲线显示 DiP/DeCo 在 100-200 epoch 持续退化(最终 6.09/9.17);逐层指标显示 PixelDiT/DiP/DeCo 的编码器线性探测精度在中间层骤降,DeCo/DiP 保留更多空间结构(RMSC/LDS 更高)但语义更弱,vanilla/PixelDiT 反之。
支撑论文第二个核心洞察:解码器设计反向决定编码器必须保留什么信息,专用像素解码器只是重新分配语义与空间建模而非改进表征。
ImageNet 512×512 结果:RG-XL/16(patch 16,32×32 token 网格)达 gFID 1.74、IS 287.5,超过潜空间 SiT-XL(2.62)、REPA(2.08)和像素空间 PixelDiT-XL(1.81)、JiT-H/32(1.94)、DeCo-XL/16(2.22)等。
验证方法在高分辨率下的有效性——像素空间生成的高频负担随分辨率加重,RG 仍能领先,说明结论不限于 256×256。
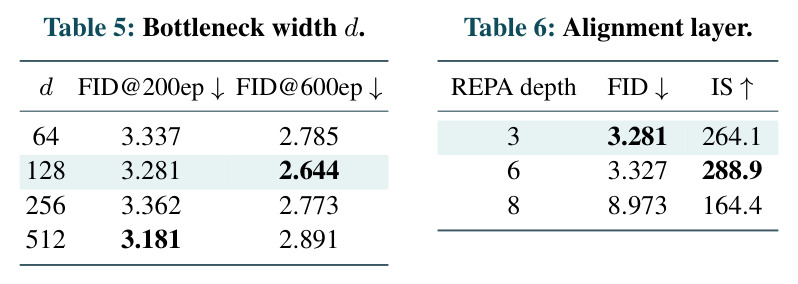
REPA 对齐层消融:对齐层 3 得 FID 3.281,层 6 得 3.327,对齐最后编码层(层 8,即编码器输出 h 被直接对齐 DINOv2)FID 飙升至 8.973。
一个精妙的反向证据:把编码器输出强行变成 DINOv2 会灾难性退化,说明预训练"理解型"表征本身不适合像素生成,必须端到端为生成优化。