我有数据流:让自监督学习在连续视频上奏效 I Have a Stream: Making Self-Supervised Learning Work on Continuous Video
揭示批内高相似性是流式自监督学习瓶颈,StreamMAE以运动感知管线解决
前置知识
自监督学习(SSL)
不依赖人工标注、直接从数据自身结构中学习表征的范式。典型做法包括对比学习(拉近同图不同增广的表征、推远不同图像)、自蒸馏(学生网络模仿教师网络的输出分布)和掩码重建(遮住图像一部分让模型恢复),预训练得到的编码器再迁移到分类、分割、深度等下游任务。
本文研究的正是 SSL 方法在流式视频这一非 i.i.d. 数据分布下是否还成立,三种 SSL 目标函数的优劣对比是全文实验主线。
MAE(掩码自编码器)
He 等提出的掩码图像建模方法:随机遮住 75% 的图像 patch,ViT 编码器只处理可见 patch,轻量解码器根据隐表征重建被遮像素,以重建损失训练。由于每个样本独立计算损失,不依赖 batch 内样本间关系,对数据分布的相关性天然较鲁棒。
StreamMAE 完全保留 MAE 的重建目标,所有创新都在输入数据管线上,理解 MAE 是理解本文方法的前提。
i.i.d. 训练假设
独立同分布假设:每个训练样本独立抽取自同一数据分布,实践中通过全局打乱数据集、随机组 batch、多轮 epoch 重放来近似。它保证每个 batch 都是数据分布的代表性缩影,是几乎所有深度学习优化理论的隐含前提。
流式视频恰好打破这一假设:帧按时间顺序到达、batch 内高度冗余、数据不可重访。本文的全部问题定义都建立在打破 i.i.d. 之上。
ViT(Vision Transformer)
将图像切成固定大小的 patch(如 16×16 像素),每个 patch 线性投影为 token 后送入标准 Transformer 编码器处理。本文用 ViT-S/16 和 ViT-B/16 两种规格,patch 粒度也被复用来聚合帧间差异图。
运动偏置裁剪的运动分数 $m_t(p)$ 正是按 ViT patch 粒度计算的,且扩展实验围绕 ViT-S 与 ViT-B 的容量差异展开。
批间/批内相似性
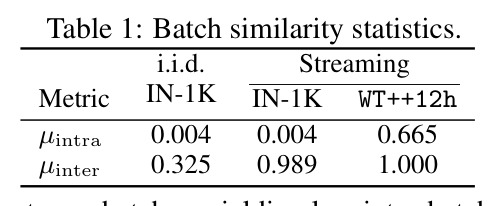
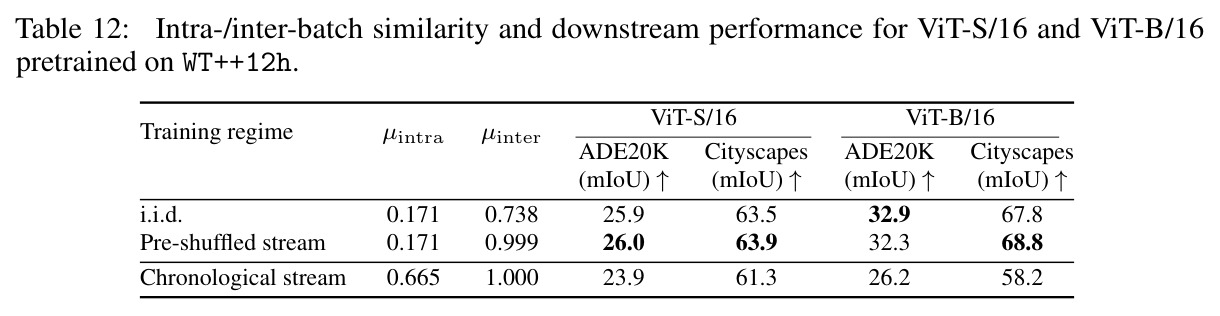
用预训练模型(本文用 DINOv2-L)提取特征后计算余弦相似度:批内相似性 $\mu_{intra}$ 衡量同一 batch 内样本两两相似程度,批间相似性 $\mu_{inter}$ 衡量相邻两个 batch 之间的重叠程度。流式滑窗使两者都趋近 1,而 i.i.d. 训练两者都很低。
这两个指标是全文诊断的核心工具:作者通过解耦实验证明 $\mu_{inter}$ 高无害、$\mu_{intra}$ 高才是流式训练退化的元凶。
mIoU 与微调评估协议
mIoU(平均交并比)是语义分割的标准指标,衡量预测掩码与真值掩码的重叠程度。本文遵循 MAE 的评估惯例,以端到端全量微调为主要协议:把预训练编码器接到任务头(分割用线性头、深度用 DPT)上一起微调后报告指标。
论文的几乎所有结论(如 63.8 vs 61.3 mIoU)都以微调后的 mIoU/RMSE 表达,需要理解该协议才能正确解读表格。
研究动机
现有自监督学习方法(MAE、DINO 等)的预训练流程默认 i.i.d. 假设:图像被全局打乱、多轮重复采样、每个 batch 由互不相关的样本构成。这与 SSL 常引用的灵感来源——婴儿视觉发育——相去甚远:真实视觉经验以时间顺序到达,相邻帧高度相似、内容缓慢演化。机器人与边缘设备上的相机正是以流式方式观察世界,数据无需落盘为固定数据集。然而在该设定下,batch 由短时段的连续帧构成,冗余度极高:WT++ London 视频中连续 512 帧的 DINOv2 特征平均相似度高达 0.95,而随机采样仅 0.18。已有流式/在线学习工作大多放宽条件:Carreira 等的单一连续流学习依赖 ImageNet 预训练初始化,Han 等的 Orthogonal-AdamW 未完全弥合从零训练的退化,MemoryStoryboard 等依赖回放缓冲区恢复样本多样性。「从随机初始化开始、严格流式、无重放」的设定此前缺乏系统研究。
本文的目标是本文要回答一个明确问题:自监督学习能否在连续视频流上良好工作,并随视频数据增多而正向扩展——模型从随机初始化训练,帧按时间顺序消费,batch 由滑动窗口构成,不允许全局打乱、多轮重放或长期回放缓冲。为此作者做了三件事:其一,将公开的 WalkingTours(13 小时)扩展为 WT++,一个 95 小时、58 条城市步行游览视频的流式预训练语料,默认用其中 12 小时伦敦视频(WT++12h)训练;其二,在该协议下系统评测 MoCo v3、DINO、MAE 等代表性方法及流式定制基线(Orthogonal-MAE、MemoryStoryboard);其三,诊断流式与 i.i.d. 预训练性能差距的根源,并据此提出 StreamMAE,目标是让流式 MAE 追平同数据 i.i.d. 版本,并在 12h→25h→50h→95h 的流长扩展中持续受益。
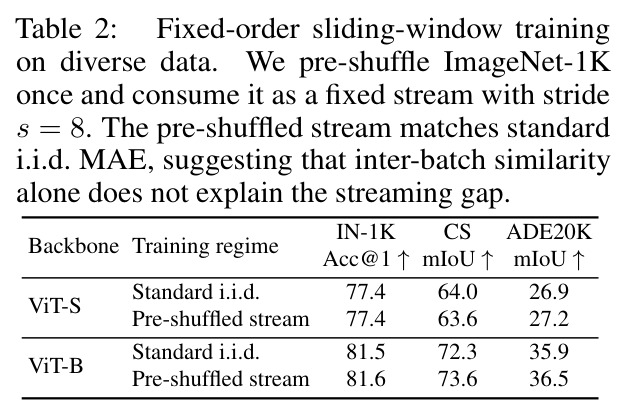
与已有工作不同的是,本文最独特的切入是把「流式 vs i.i.d.」的差距分解为两个正交因素:批间相似性(滑窗导致相邻 batch 大量重叠,流式下 $\mu_{inter}=1.000$)与批内相似性(batch 内帧互为近似重复,$\mu_{intra}=0.665$)。作者设计了一个巧妙的解耦实验:把 ImageNet-1K 预先打乱一次后当作固定流、以步幅 8 滑窗消费——它保留了流式的高批间相似性($\mu_{inter}=0.989$),却保有 i.i.d. 的低批内相似性($\mu_{intra}=0.004$)。结果显示这种「伪流式」MAE 完全追平标准 i.i.d.(IN-1K 77.4 vs 77.4 Acc@1),证明批间相似性无害,真正的瓶颈是批内近似重复帧。这一诊断与此前工作(如 Han 等把问题归因于梯度相关)形成对照,并直接决定方法形态:既然问题在输入分布而非目标函数,就应该改数据管线而不是改损失。
核心方法
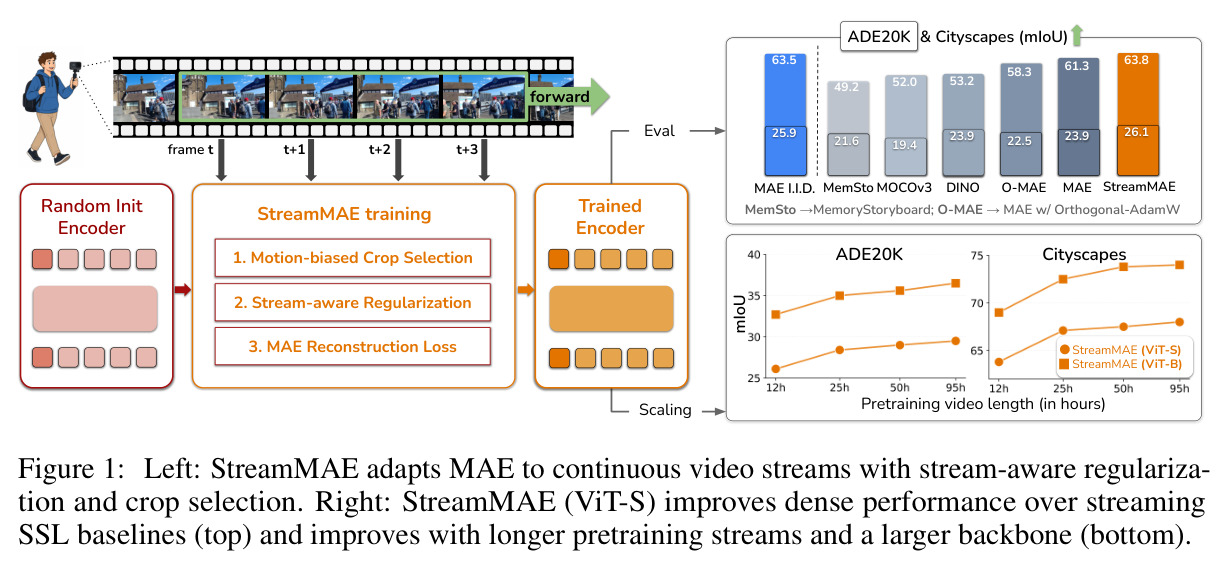
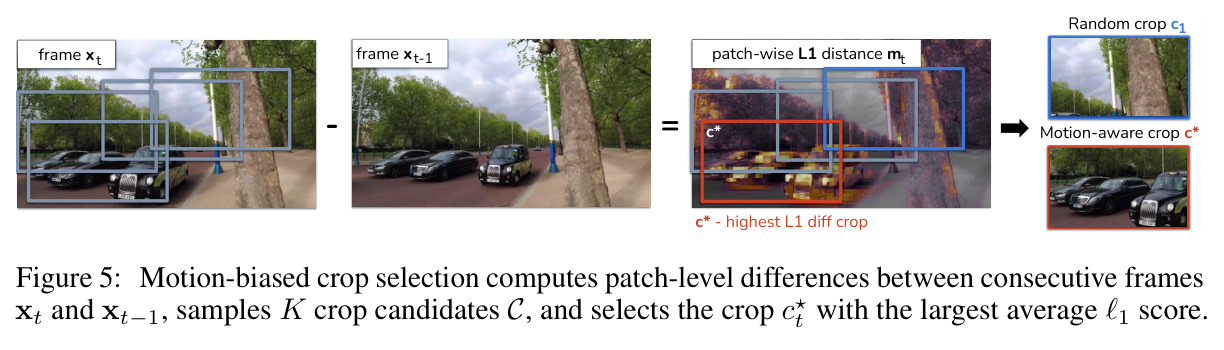
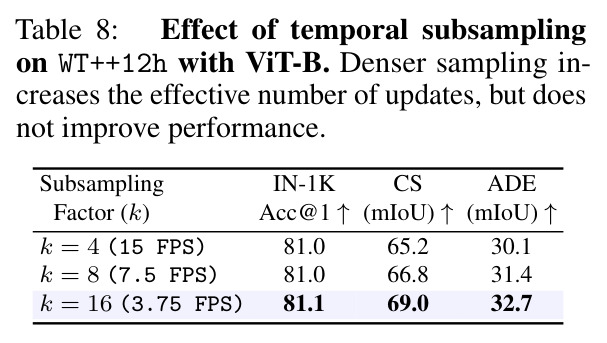
StreamMAE 的直觉很朴素:MAE 的掩码重建目标对批内冗余最不敏感——每个样本独立重建,不需要在 batch 内对比(对比学习会因近似重复帧产生假负样本)也不需要跨批聚类(自蒸馏依赖多样数据),所以目标函数原封不动,全部改造放在输入管线上。技术路线分两组。一是流感知正则化:颜色抖动(p=0.5)扰动低层外观统计,drop path 线性增至 0.25 防止过拟合重复局部模式,DataDrop 在每个大小 B=2048 的滑窗内随机丢弃 75% 样本、只对剩余样本反传,避免近似重复帧主导梯度更新。二是流感知裁剪:把 MAE 的随机缩放裁剪拆成两阶段,先在 patch 级帧差图上从 K=4 个候选中选出平均运动最大的第一级区域 $c^\star_t$,再在其内部执行标准 MAE 裁剪,且以 0.5 概率应用以避免过度聚焦同一区域。预训练在 WT++12h(60FPS 720p 降采样 16 倍至 3.75FPS)上进行,可平滑扩展到 95 小时。
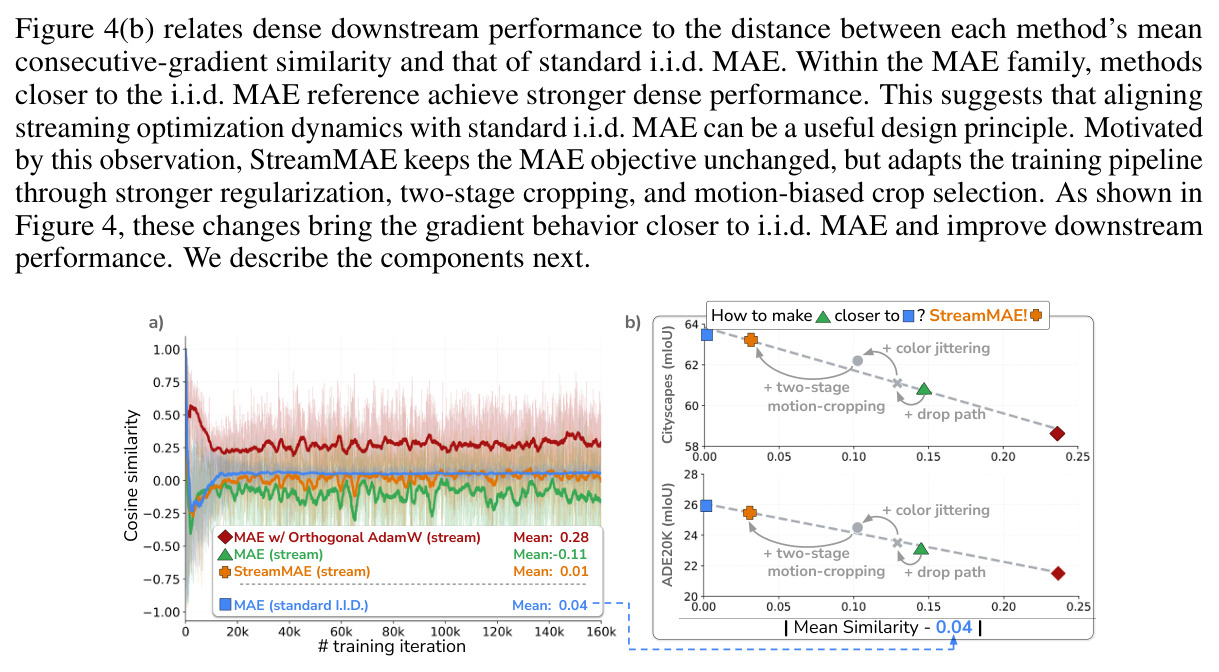
核心创新是「先诊断、后设计」的方法论及其两个结论。第一,通过预打乱 ImageNet-1K 的解耦实验证明批间相似性对 MAE 无害(77.4 vs 77.4 Acc@1),把此前「梯度相关是元凶」的解释修正为「批内近似重复帧才是瓶颈」;进一步用连续 batch 梯度余弦相似度作为诊断指标(在最后一个 Transformer 块的 MLP 参数上测量):流式 MAE 的运行均值低至 -0.11,i.i.d. MAE 为 0.04,且两者距离与下游稠密任务性能强相关——越接近 i.i.d. 参照的变体性能越好。第二,StreamMAE 不引入新损失、新架构或回放缓冲,仅靠 DataDrop、更强正则与运动偏置裁剪就把梯度相似度拉回 0.01,几乎对齐 i.i.d. 参照。运动偏置裁剪用 patch 级 L1 帧差 $D_t$ 近似运动强度,避免光流的计算开销,把学习焦点从静止背景转向变化区域——这是对「信息在哪里」这一流式先验的显式建模,区别于一切在损失端做文章的流式方法。
方法步骤详情
完整流程如下。输入侧:60FPS、1280×720 的步行视频按 k=16 降采样至 3.75FPS,得到帧序列 $V=(x_1,\dots,x_N)$;训练时以 B=2048、步幅 s=1 的滑动窗口按时间顺序取帧。第一步,DataDrop 在窗口内采样二值掩码随机丢弃 75% 样本(不前向、不计损失),有效批量降为 $B_{eff}=512$,窗口照常按步幅推进、不重复消费。第二步,计算当前帧与前一帧的逐像素 L1 差异图 $D_t(h,w)=\|x_t(h,w,:)-x_{t-1}(h,w,:)\|_1$,按 ViT patch 粒度聚合为运动分数 $m_t(p)=\frac{1}{|\Omega_p|}\sum_{(h,w)\in\Omega_p}D_t(h,w)$。第三步,两阶段裁剪:以 0.5 概率从 K=4 个候选中选平均运动最大者 $c^\star_t=\arg\max_c \frac{1}{|P(c)|}\sum_{p\in P(c)}m_t(p)$,否则随机选;再在 $c^\star_t$ 内做标准 MAE 随机缩放裁剪。第四步,施加颜色抖动(p=0.5)后做 75% 随机掩码,编码器只编码可见 patch,解码器重建被掩像素,损失与原版 MAE 完全一致。训练用 AdamW($\beta_1=0.9$,$\beta_2=0.95$),ViT-S/ViT-B 学习率分别为 $8\times10^{-5}$/$4\times10^{-5}$,按 $B_{eff}/256$ 线性缩放,流式用线性预热加常数学习率。
技术新颖性
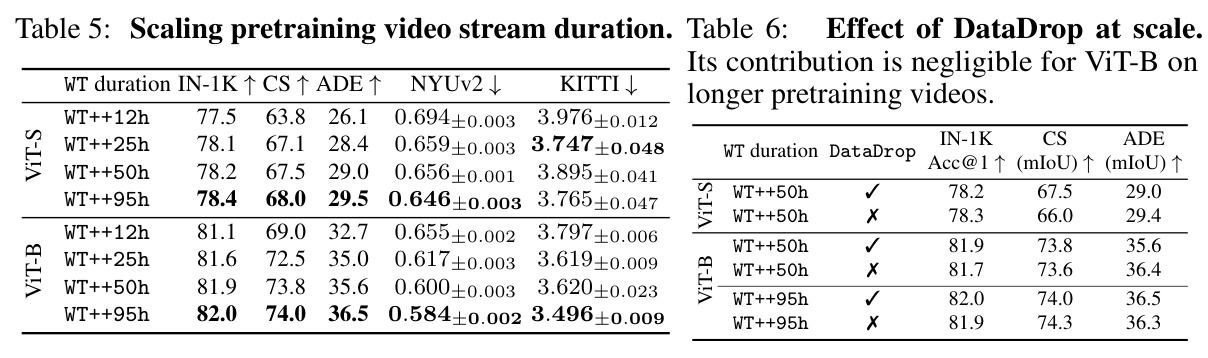
技术新颖性体现在三个层面。问题定义上,作者坚持最严格的流式设定——从零训练、无全局打乱、无多轮重放、无长期回放缓冲——而此前工作要么依赖预训练初始化,要么靠回放/记忆机制(MemoryStoryboard、reservoir 缓冲)恢复多样性,本文是首批在该设定下给出系统性基准与可行方案的。分析方法上,预打乱流的解耦实验和「梯度相似度距离—下游性能」相关图(Figure 4b)提供了可复用的诊断工具。方法设计上,所有改动都在数据管线层:运动偏置裁剪把时序信息仅用于选择视野而不进入网络,编码器保持纯图像 ViT;两阶段裁剪把「在哪里裁」与「怎么增广」解耦,K=1 时退化为随机两阶段裁剪,运动偏置是其自然扩展。消融显示正则与裁剪贡献了大部分增益(Cityscapes 60.8→63.8 mIoU 中 DataDrop 仅贡献 0.5),且 DataDrop 在 ViT-B 大规模下可忽略,说明核心贡献是运动感知采样而非简单丢弃。
实验结果
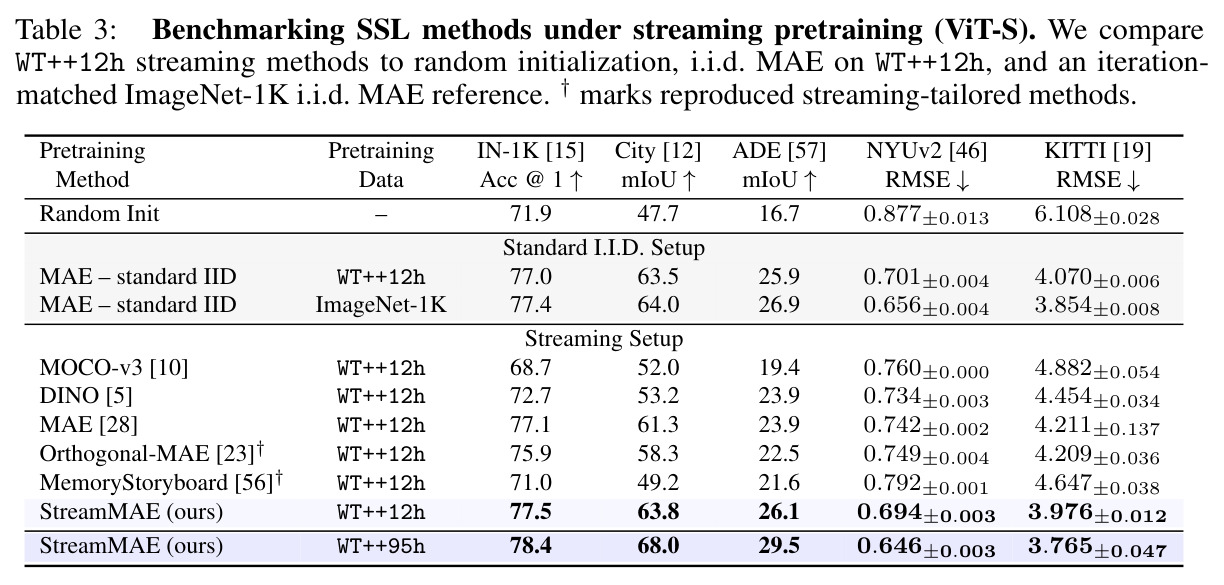
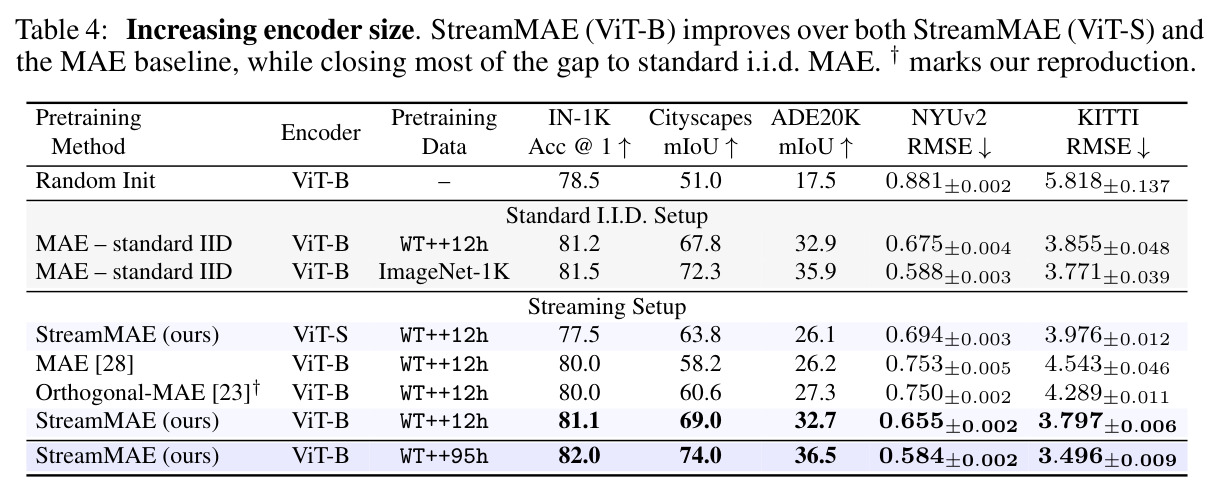
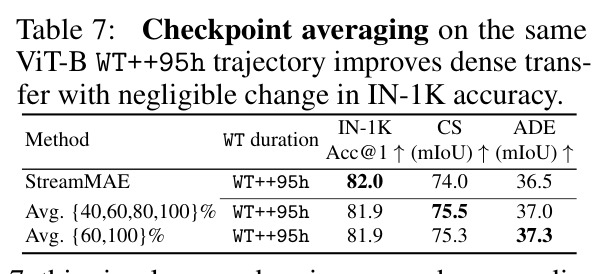
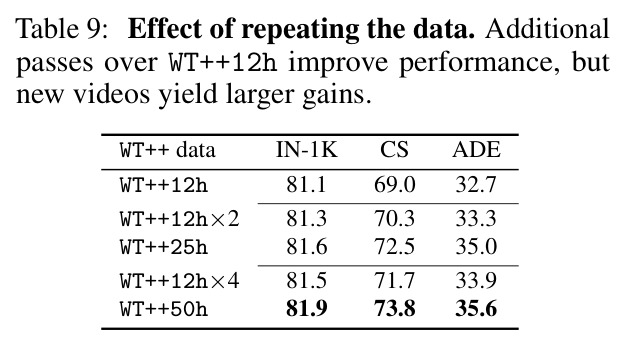
流式基准(ViT-S,WT++12h):MoCo v3 仅 68.7% IN-1K,低于随机初始化的 71.9%,印证近似重复帧作假负样本时对比学习崩溃;DINO 72.7%;MAE 最稳(77.1%);Orthogonal-MAE 75.9%、复现的 MemoryStoryboard 71.0%。StreamMAE 达 77.5% IN-1K、63.8 CS mIoU、26.1 ADE mIoU、0.694 NYUv2 RMSE、3.976 KITTI RMSE,全面领先并追平同数据 i.i.d. MAE(77.0/63.5/25.9/0.701/4.070)。解耦实验:预打乱 IN-1K 流 77.4% 与 i.i.d. 77.4% 持平(ADE 27.2 vs 26.9),证明批间相似性无害。累积消融:CS 从 60.8 经 DataDrop(61.3)、正则(62.6)、两阶段裁剪(62.8)到运动偏置裁剪(63.8)。扩展性:ViT-B 上流式 MAE 与 i.i.d. 差距拉大(CS 58.2 vs 67.8),StreamMAE 达 69.0;ViT-B + WT++95h 达 82.0 IN-1K、74.0 CS、36.5 ADE,CS 反超 ImageNet i.i.d. MAE(72.3)。新视频(WT++25h:72.5 CS)优于重复 epoch(WT++12h×2:70.3);提高帧率只增更新不涨点(15FPS 65.2 vs 3.75FPS 69.0 CS)。Attentive probing 比流式 MAE 高 6.8/9.8 个点(ViT-S 40.2 vs 33.4;ViT-B 47.1 vs 37.3),追平 i.i.d.。跨域:HD-EPIC、CROWD、KrishnaCAM 上分割提升 1.6–5.8 mIoU、深度 RMSE 降 0.042–0.531,CROWD 的 CS 71.5 反超 i.i.d. 的 68.1。检查点平均再涨 CS 74.0→75.5。
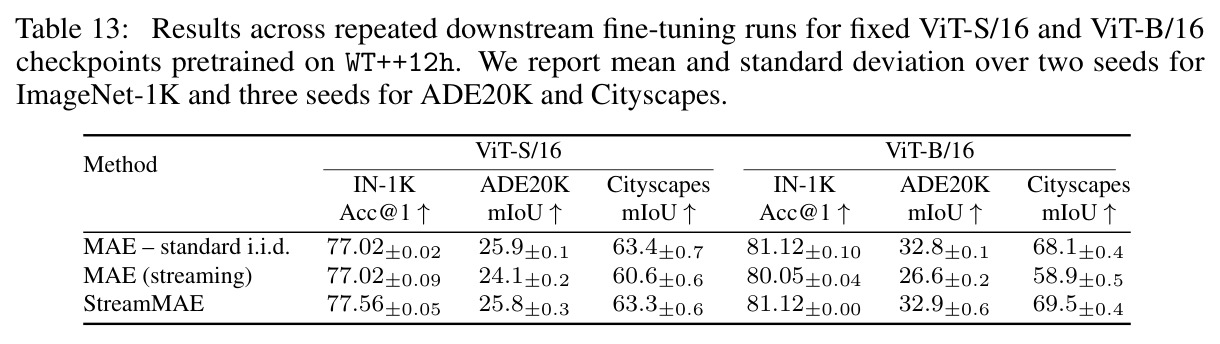
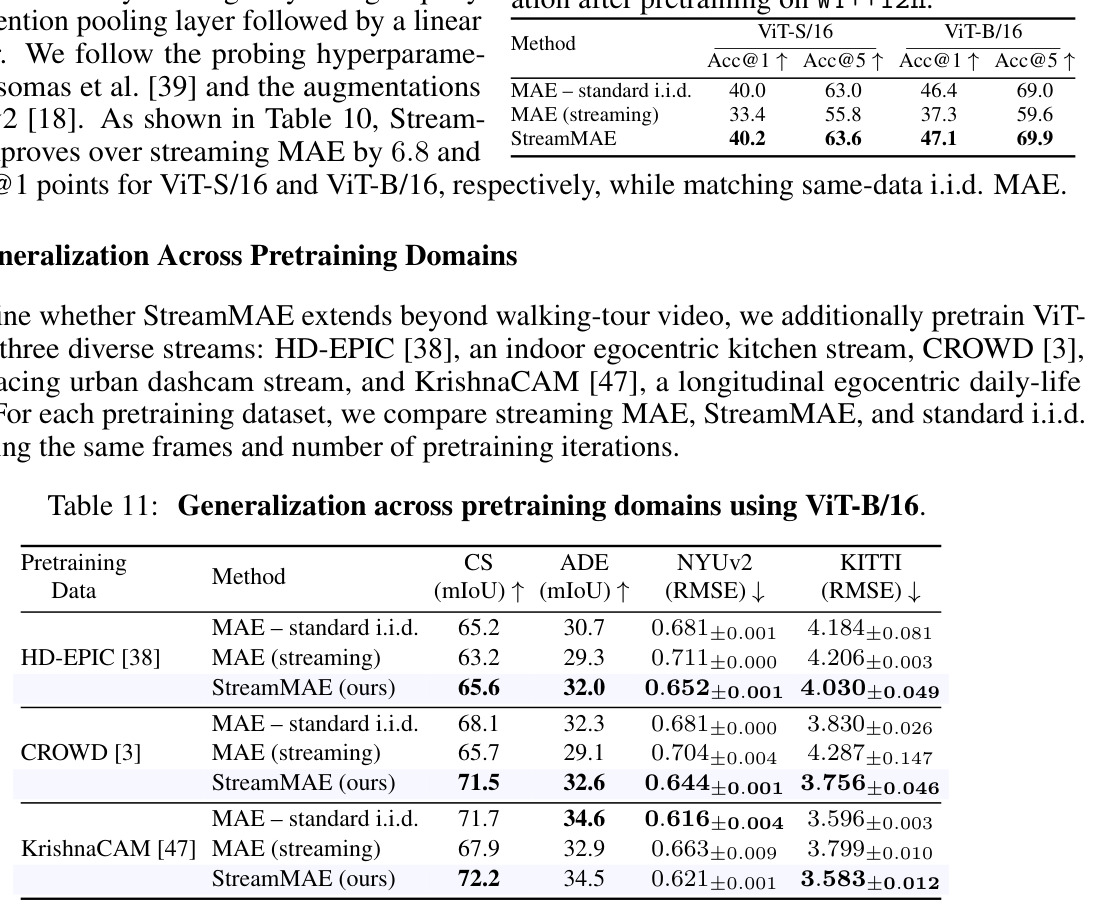
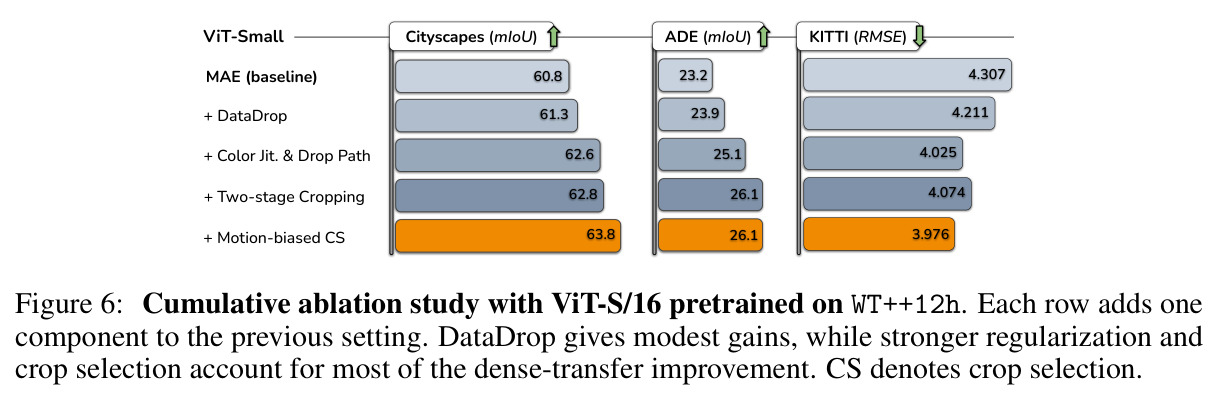
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ImageNet-1K 分类(ViT-S,WT++12h 流式预训练) | Top-1 Acc@1(全量微调) | 77.5% | 流式 MAE 77.1%;MoCo v3 68.7%;DINO 72.7%;同数据 i.i.d. MAE 77.0% | +0.4 个点 vs 流式 MAE,追平同数据 i.i.d.;比 MoCo v3 高 8.8 个点 |
| Cityscapes 语义分割(ViT-S,WT++12h) | mIoU | 63.8 | 流式 MAE 61.3;Orthogonal-MAE 58.3;DINO 53.2;MoCo v3 52.0 | +2.5 vs 流式 MAE,+11.8 vs MoCo v3 |
| ADE20K 语义分割(ViT-S,WT++12h) | mIoU | 26.1 | 流式 MAE 23.9;同数据 i.i.d. MAE 25.9 | +2.2 vs 流式 MAE,追平 i.i.d. |
| KITTI 深度估计(ViT-S,WT++12h) | RMSE(越低越好) | 3.976 | 流式 MAE 4.211;MemoryStoryboard 4.647 | 降低 0.235 vs 流式 MAE |
| Cityscapes 语义分割(ViT-B,WT++95h) | mIoU | 74.0 | ImageNet-1K i.i.d. MAE 72.3;同数据 i.i.d. MAE(ViT-B,12h)67.8 | 反超图像 i.i.d. 预训练 +1.7,超同数据 i.i.d. +6.2 |
| KITTI 深度估计(ViT-B,WT++95h) | RMSE(越低越好) | 3.496 | 流式 MAE(ViT-B,12h)4.543 | 降低 1.047 |
| ImageNet-1K Attentive Probing(冻结表征,ViT-B,WT++12h) | Top-1 Acc@1 | 47.1% | 流式 MAE 37.3%;同数据 i.i.d. MAE 46.4% | +9.8 个点 vs 流式 MAE,追平 i.i.d. |
局限与改进
作者承认与可观察到的局限。其一,数据域集中于城市步行视角,虽补充了 HD-EPIC(室内厨房)、CROWD(行车记录仪)、KrishnaCAM(头戴日常)三个流并验证有效,但仍以第一人称/前向视角为主,缺乏航拍、监控等更异质的视角。其二,分类任务收益有限:迭代数匹配的 ImageNet i.i.d. MAE 参考在多数基准上仍更强,ViT-B + WT++95h 在 ADE20K 上也落后长预算 i.i.d. 参考,说明强域外语义任务上大规模图像预训练仍占优。其三,DataDrop 在 ViT-B 大规模下收益消失(Table 6),其作用机制未被完全解释。其四,跨视频拼接流在边界存在人为断点,与真正单镜头连续流不同;帧率(3.75FPS)、DataDrop 率(75%)、运动偏置应用概率(0.5)等关键超参依赖经验调参。其五,编码器仍是逐帧图像模型,时序信息只用于裁剪选择,未建模帧间聚合,视频原生架构的潜在收益未被探索。
独立分析的弱点
独立分析几点弱点。第一,运动偏置裁剪依赖相邻帧的 L1 差异,对相机抖动、曝光突变、镜头切换敏感——虽然 KrishnaCAM 消融显示不规则运动下仍有 +0.6/+0.7 mIoU 和 -0.063 KITTI RMSE 的收益,但快速转向、夜间灯光等极端场景可能误导裁剪选择;改进方向是引入鲁棒的运动估计(轻量光流或特征空间差异)并结合置信度门控。第二,固定 75% 的 DataDrop 率是静态超参,理想策略应感知当前窗口冗余度(例如用在线估计的 $\mu_{intra}$ 门控丢弃率),在信息密集段少丢、冗余段多丢。第三,常数学习率+线性预热虽契合「数据持续到达」的部署设定,但放弃了 lr 衰减的收敛增益;可探索流式友好的自适应调度或周期性重启。第四,冻结表征质量有天花板:attentive probing 仅 40.2%(ViT-S),远低于 DINOv2 等大规模 i.i.d. 模型,说明逐帧流式训练的表征通用性仍受限,可考虑在流式框架内引入全局原型或跨流记忆蒸馏。
未来方向
作者方向之外可延伸的空间很大。直接延伸:把流式协议推向真正无限流(在线学习、数据长度未知),研究灾难性遗忘与知识巩固的平衡;将运动偏置思想推广到多模态流(音频-视频、触觉);结合检查点平均与流式 EMA,为「时间集成」给出理论解释。架构层面:把逐帧编码器换成带时序建模的结构,或引入 token 合并、帧间注意力,主动利用而非丢弃相邻帧冗余。系统层面:DataDrop 式采样天然适合边缘设备的低内存在线适配,可落地到机器人导航与具身智能的流式预训练。理论层面:为「批内相似性→优化退化」建立形式化分析(梯度方差、有效样本量的视角),解释为何重建目标对冗余鲁棒而对比/蒸馏目标崩溃。数据层面:构建数百小时、跨季节跨城市的流,检验 12h→95h 的扩展律是否持续成立,并研究收益趋缓点(50h→95h 增益已明显小于 12h→50h)。
复现评估
复现条件较好。代码基于 solo-learn 框架实现,项目页(martinovicivan.github.io/StreamMAE)为开源入口;WT++ 由 58 条公开步行游览视频构成,数据获取门槛低,但需自行下载并做版权核查,这一点是最大的非算力障碍。主要算力开销:默认设置 B=2048 滑窗、有效批量 $B_{eff}=512$、ViT-S/16、学习率 $8\times10^{-5}$、常数学习率训练;ViT-B 与 WT++95h 实验(迭代匹配参考为 650k 迭代)需要多卡训练数天,作者使用埃尔朗根 NHR@FAU 的 HPC(BayernKI 项目)。复现难点:视频降采样、帧差图缓存与滑窗数据管线需自己搭建;MemoryStoryboard 与 Orthogonal-MAE 基线为作者复现(表中 † 标注),数字可能存在偏差;深度估计指标为两个种子的均值±标准差,需留意随机性。总体评估:单卡可复现 ViT-S/WT++12h 主结果(约数天),完整复现全表需要可观的多卡算力,难度中等偏高。
论文图表
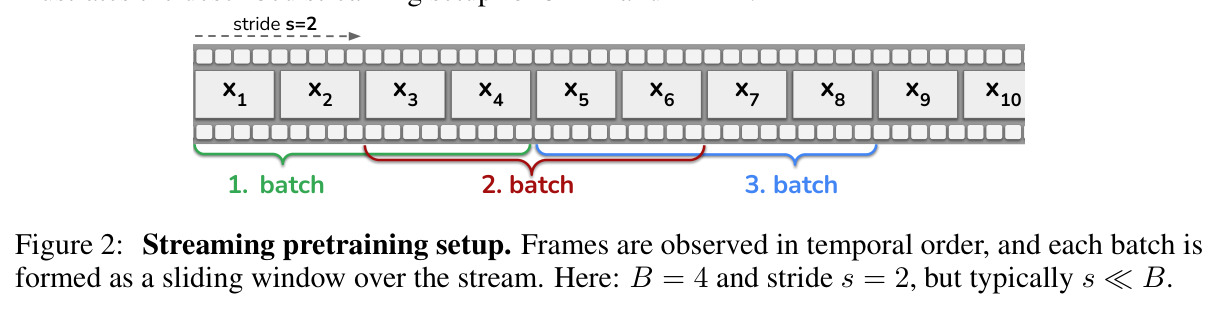
以 10 帧、batch 大小 B=4、步幅 s=2 为例,图示滑动窗口如何按时间顺序切出第 1、2、3 个 batch:相邻窗口重叠 B−s 帧(此处 2 帧),帧不能打乱、不能回看。
它一图定义了「严格流式」协议的全部约束(时间有序、滑窗组批、无全局打乱),是理解所有实验设定和「批间相似性从何而来」的基础。
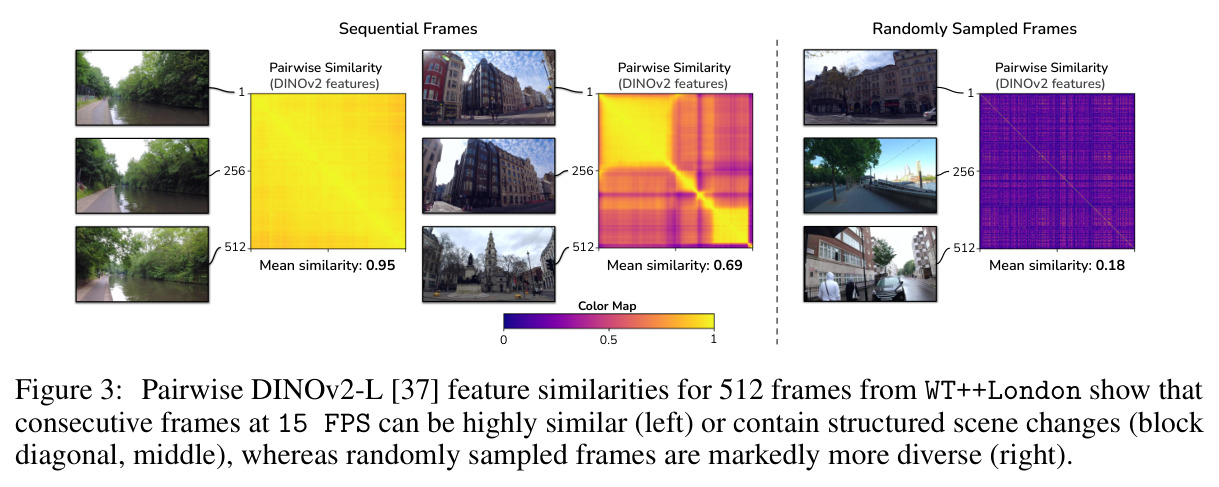
三张相似度矩阵热图对比:连续帧的平均相似度 0.95(近乎全红,近似重复)、含场景切换的连续段 0.69(块对角结构)、随机采样帧仅 0.18(整体低相似),直观呈现流式 batch 与 i.i.d. batch 的分布鸿沟。
它用数据可视化了流式训练的根本困难——batch 内近似重复——是后文「批内相似性才是瓶颈」这一诊断的直觉证据。