大语言模型注意力机制的演进:机制、权衡与新兴趋势 The Evolution of Attention in Large Language Models: Mechanisms, Trade-offs, and Emerging Trends
以五维记忆框架统一解析注意力演进,发现混合架构与跨层复用正成为主流
前置知识
自注意力与KV缓存
Transformer 的核心算子:查询 $q_t$ 与历史位置的键 $k_i$ 做缩放点积,经 $\mathrm{softmax}$ 归一化后加权求和值向量。自回归解码时每个 token 的 K/V 必须缓存,缓存随上下文长度线性增长;预填充阶段的比较次数则为 $O(L^2)$。
论文讨论的一切效率问题(二次预填充、缓存线性膨胀)都源于该机制,五维分析框架的 Memory Representation/Update/Access 等维度就是围绕它定义的。
GQA / MQA / MLA
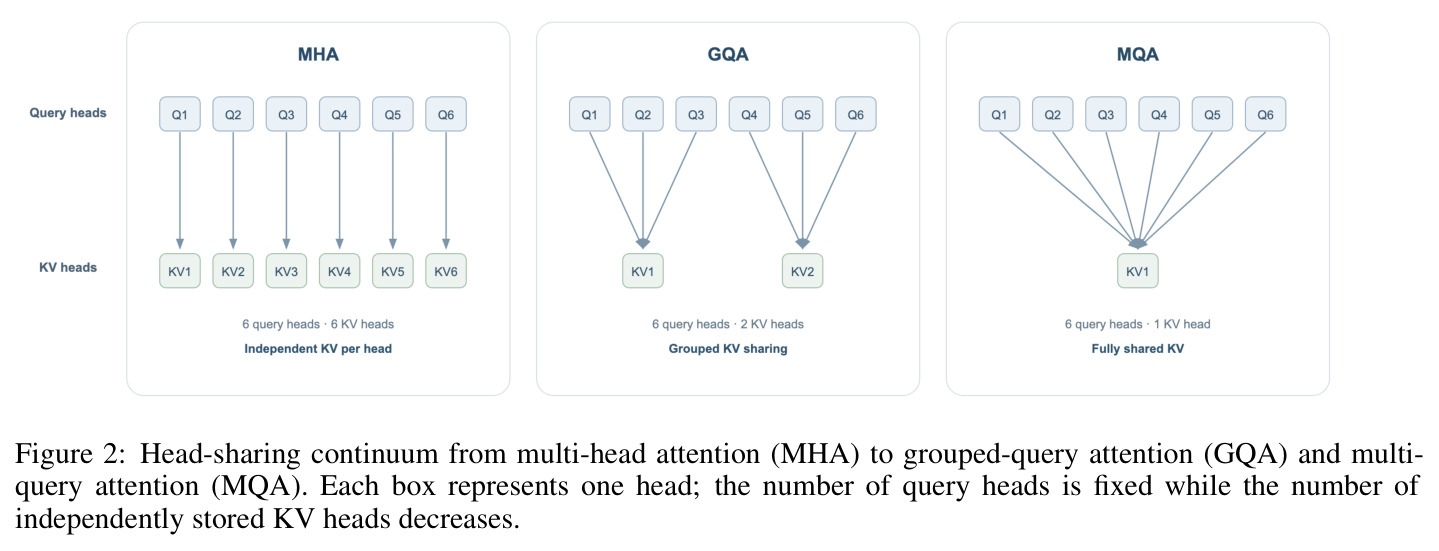
三种降低 KV 冗余的表示优化:MQA 让所有查询头共享 1 组 KV;GQA 分组共享,是 MHA 与 MQA 之间的连续折中;MLA(DeepSeek-V2 提出)把每个 token 的 KV 压缩为低秩潜向量并只缓存潜向量,RoPE 部分单独处理。三者都保留 token 级可寻址性。
它们是 Softmax 注意力章节的主线,也是产业盘点中 GQA 与 MLA 两大主流路线,前沿模型表里反复出现。
线性注意力与循环关联状态
利用核可分解性 $K(q,k)=\phi(q)^\top\phi(k)$,把历史累进矩阵状态 $S_t=S_{t-1}+\phi(k_t)v_t^\top$,读取时做状态收缩;状态大小与上下文无关,但单个 token 不再可独立寻址。DeltaNet/GDN 等用 delta 规则修正旧关联。
这是四个机制家族之一,综述对 Retain/Erase/Write 的三轴分解和等价目标函数推导都建立在该递推形式上。
状态空间模型(SSM/Mamba)
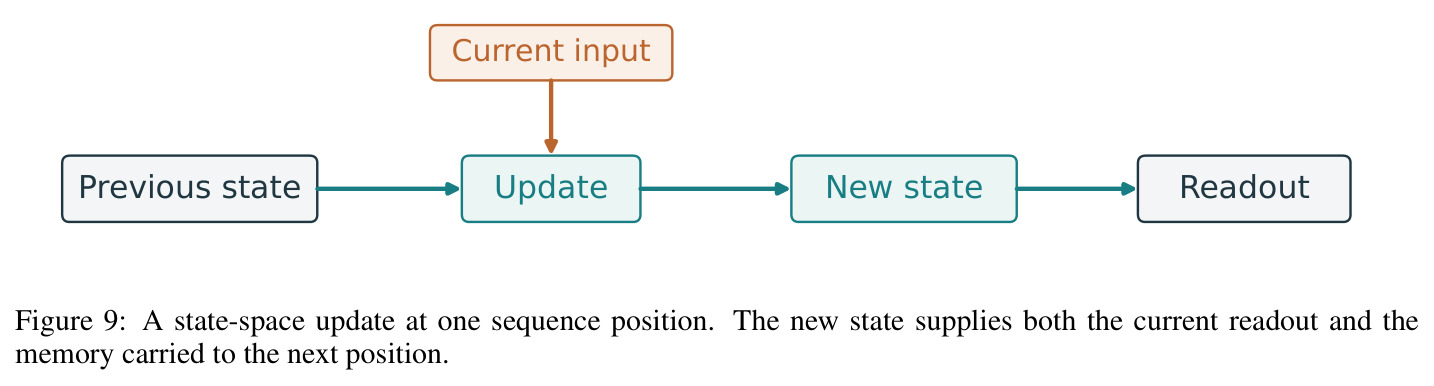
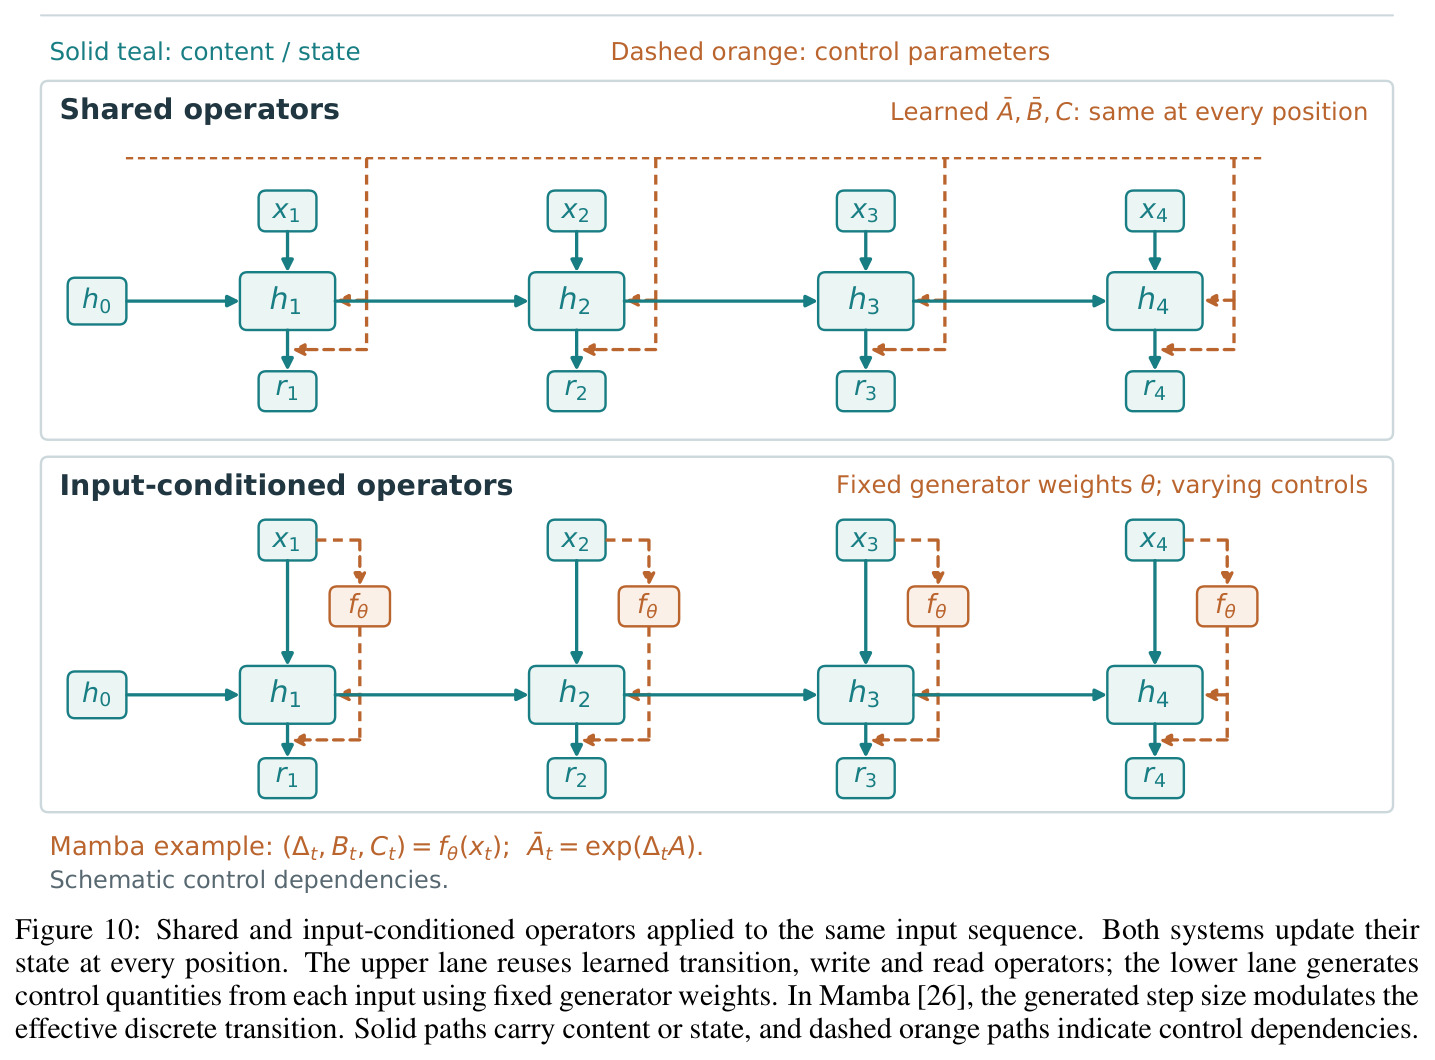
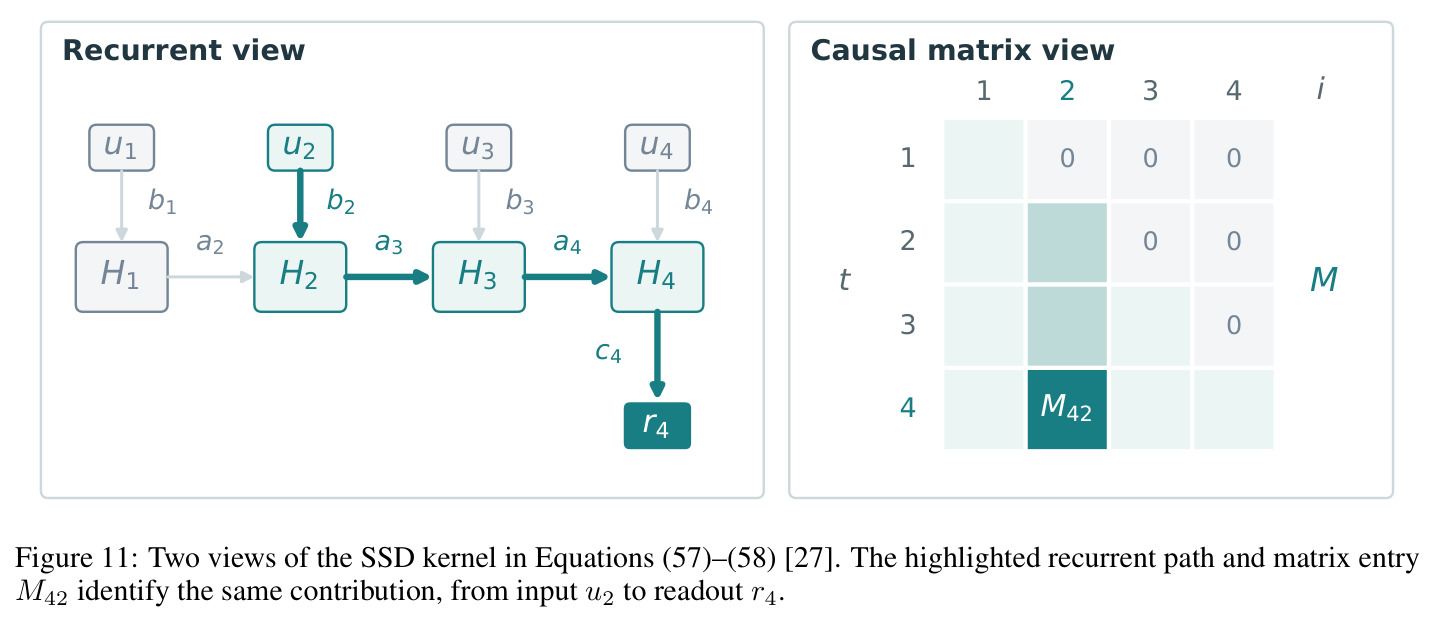
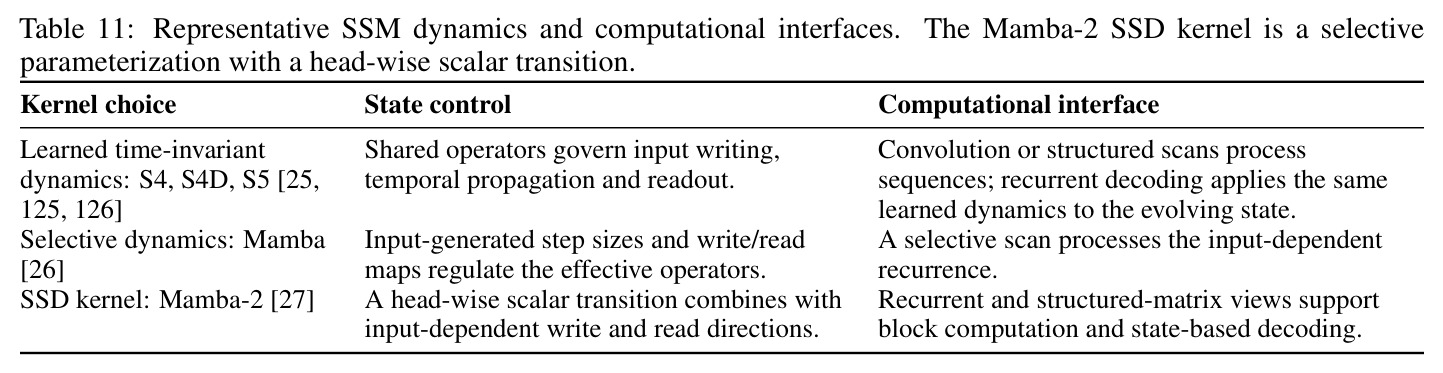
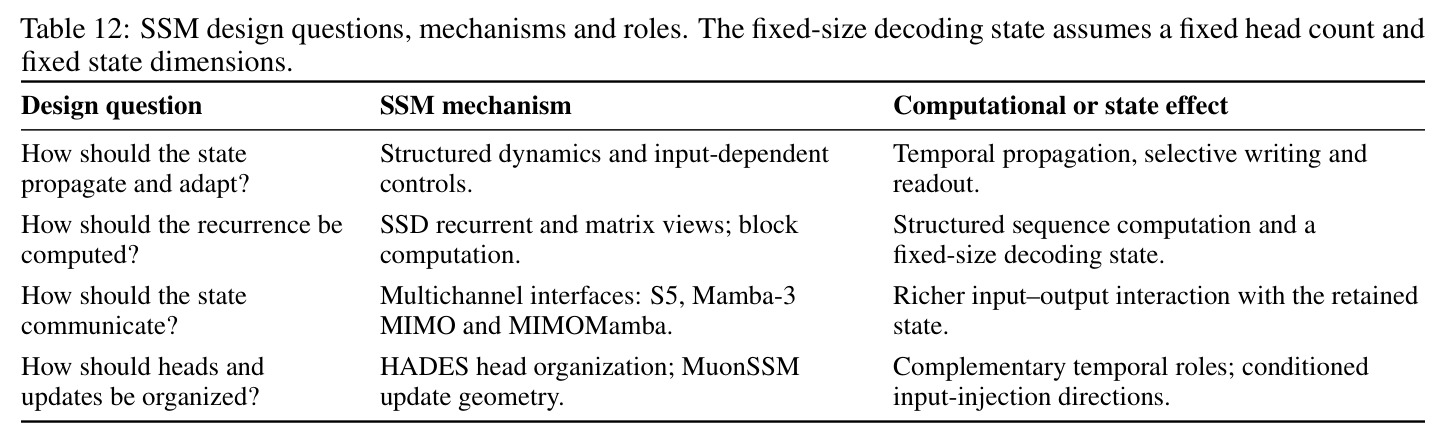
用结构化动力学 $h_t=\bar A h_{t-1}+\bar B x_t,\ r_t=Ch_t$ 传播历史;Mamba 让步长与读写参数随输入生成(选择性),Mamba-2 的 SSD 把受限选择性核与注意力式下三角矩阵对偶,训练可并行扫描、解码状态有界。
SSM 是四大机制家族之一,也是混合架构中 GDN/KDA/Mamba 层的理论来源,理解状态动力学才能读懂混合层配比的动机。
稀疏注意力与Top-k路由
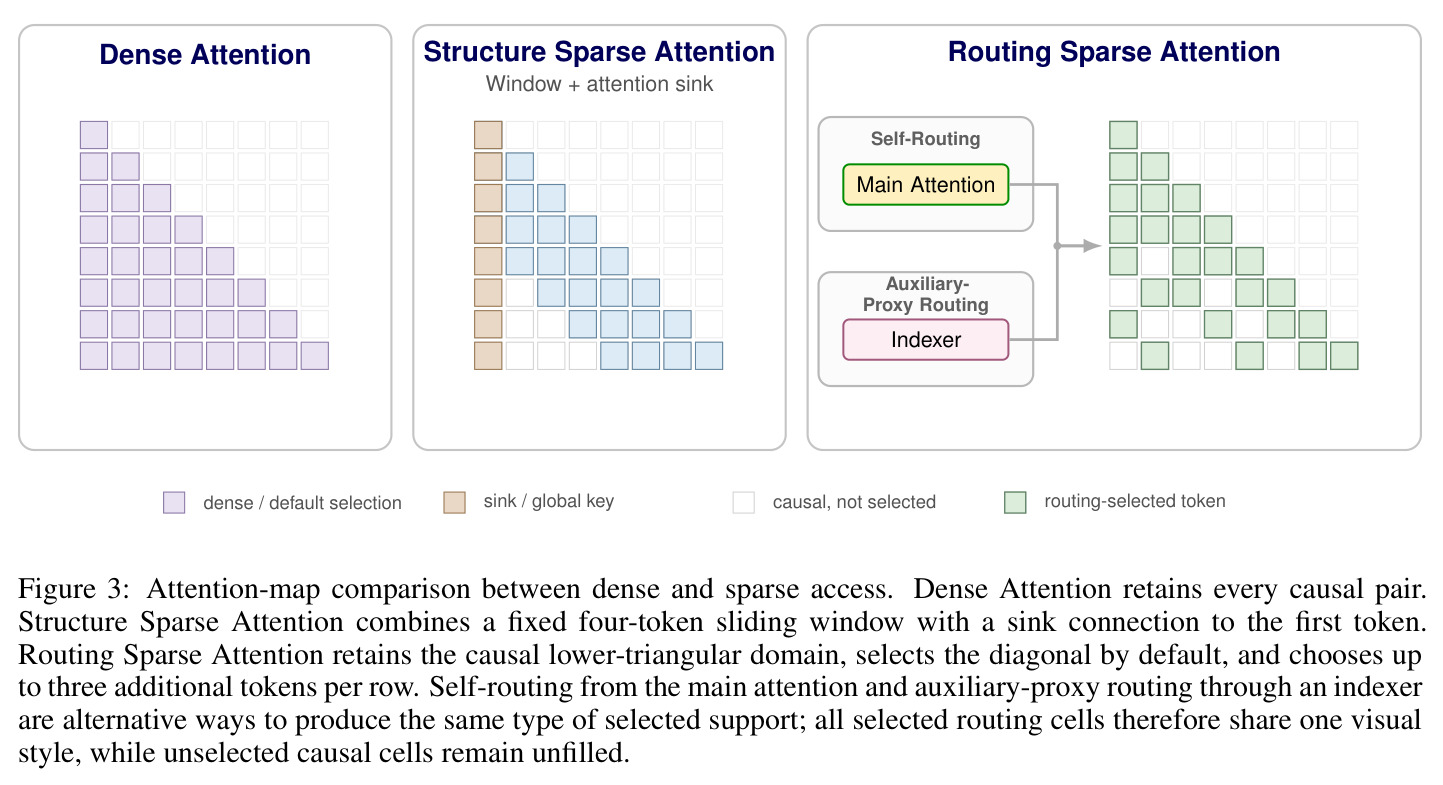
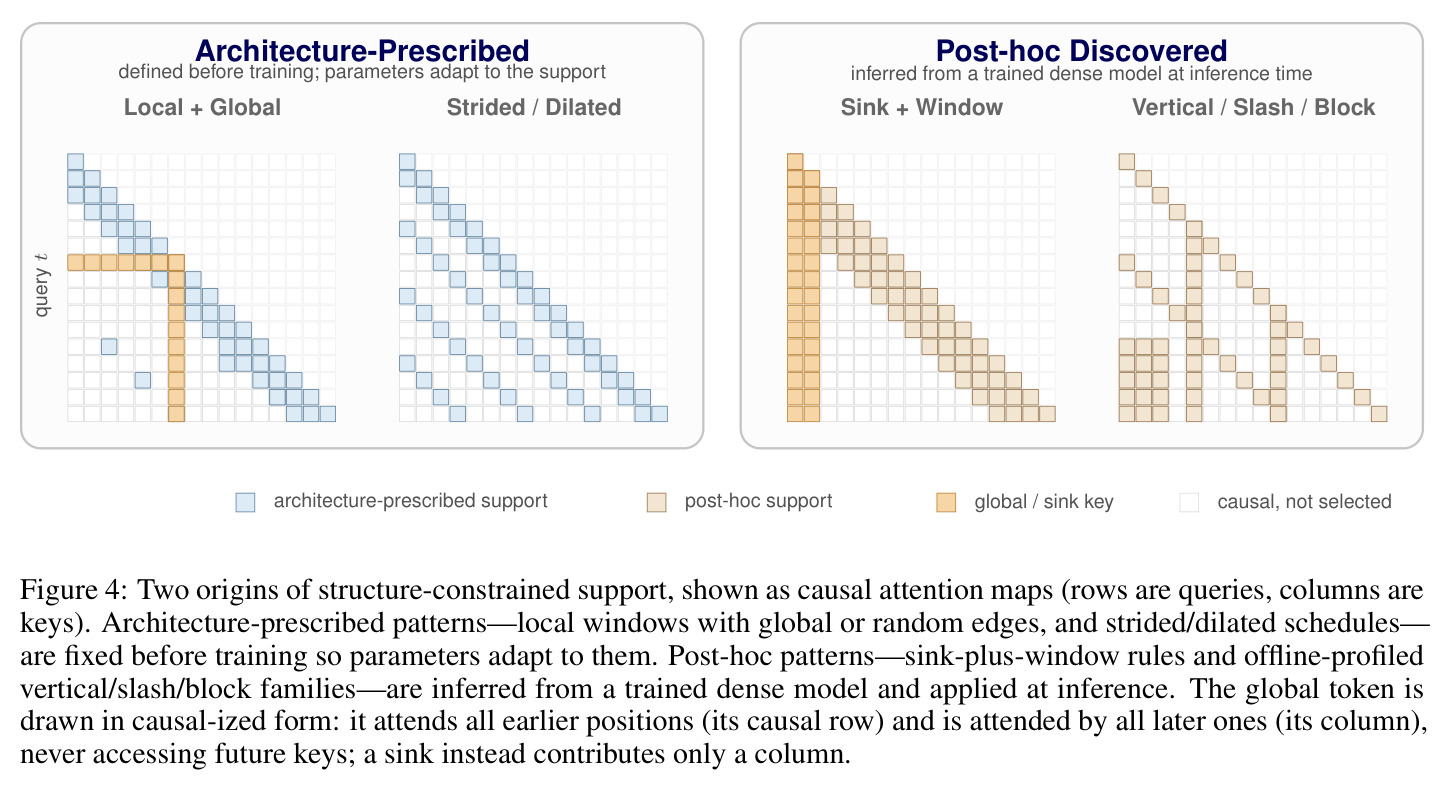
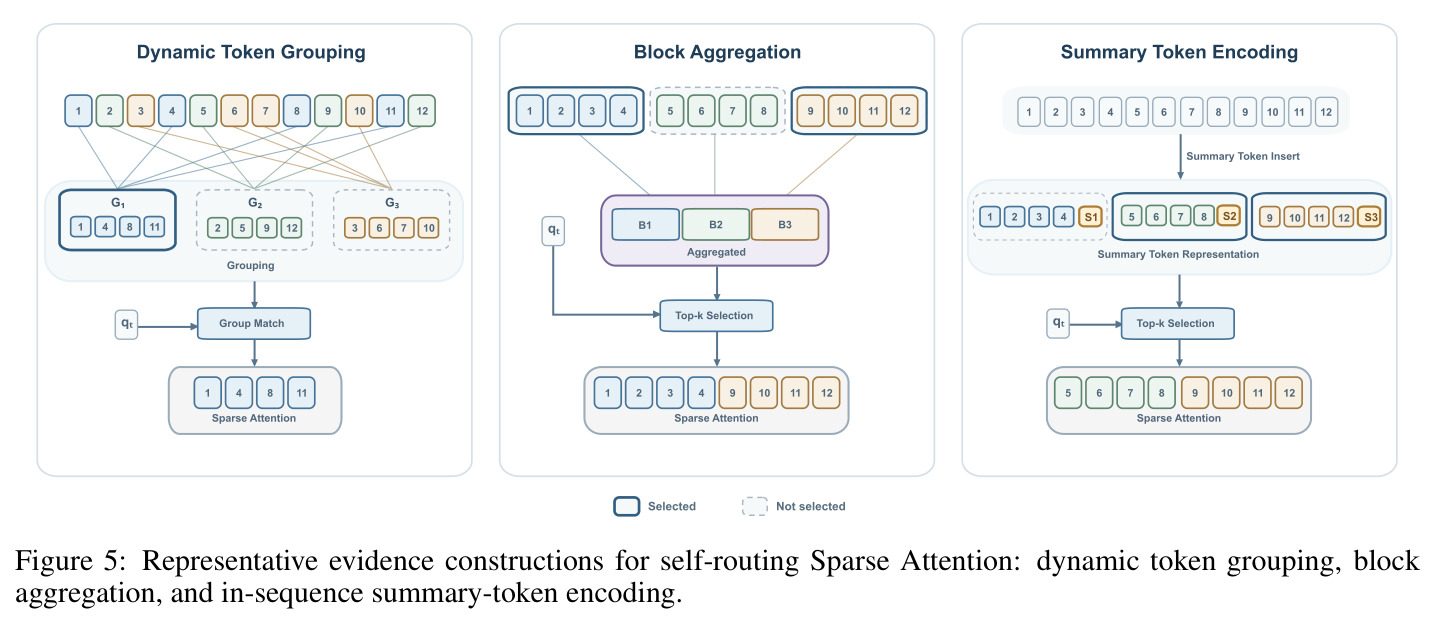
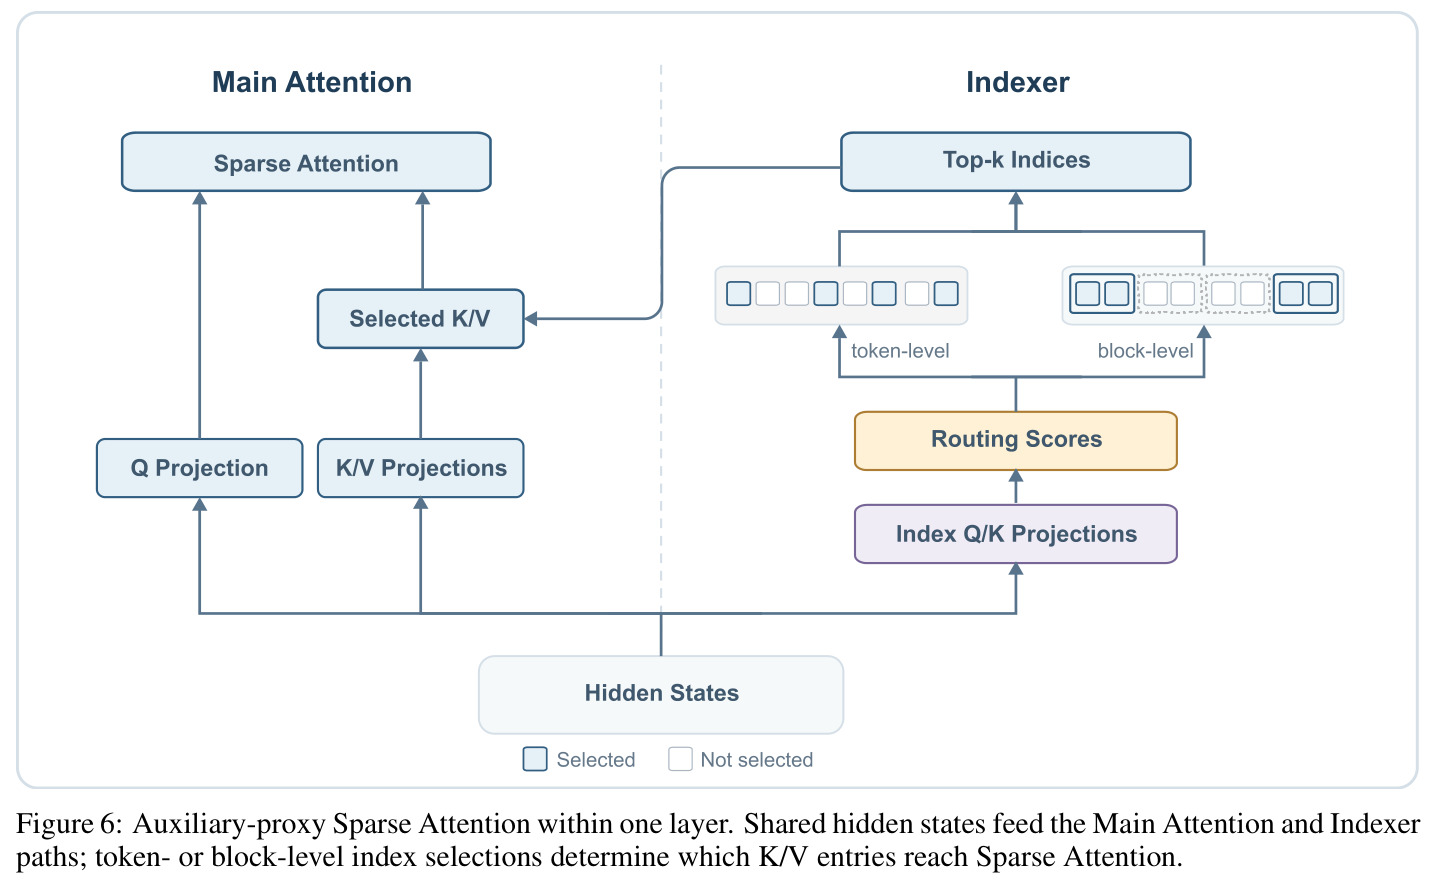
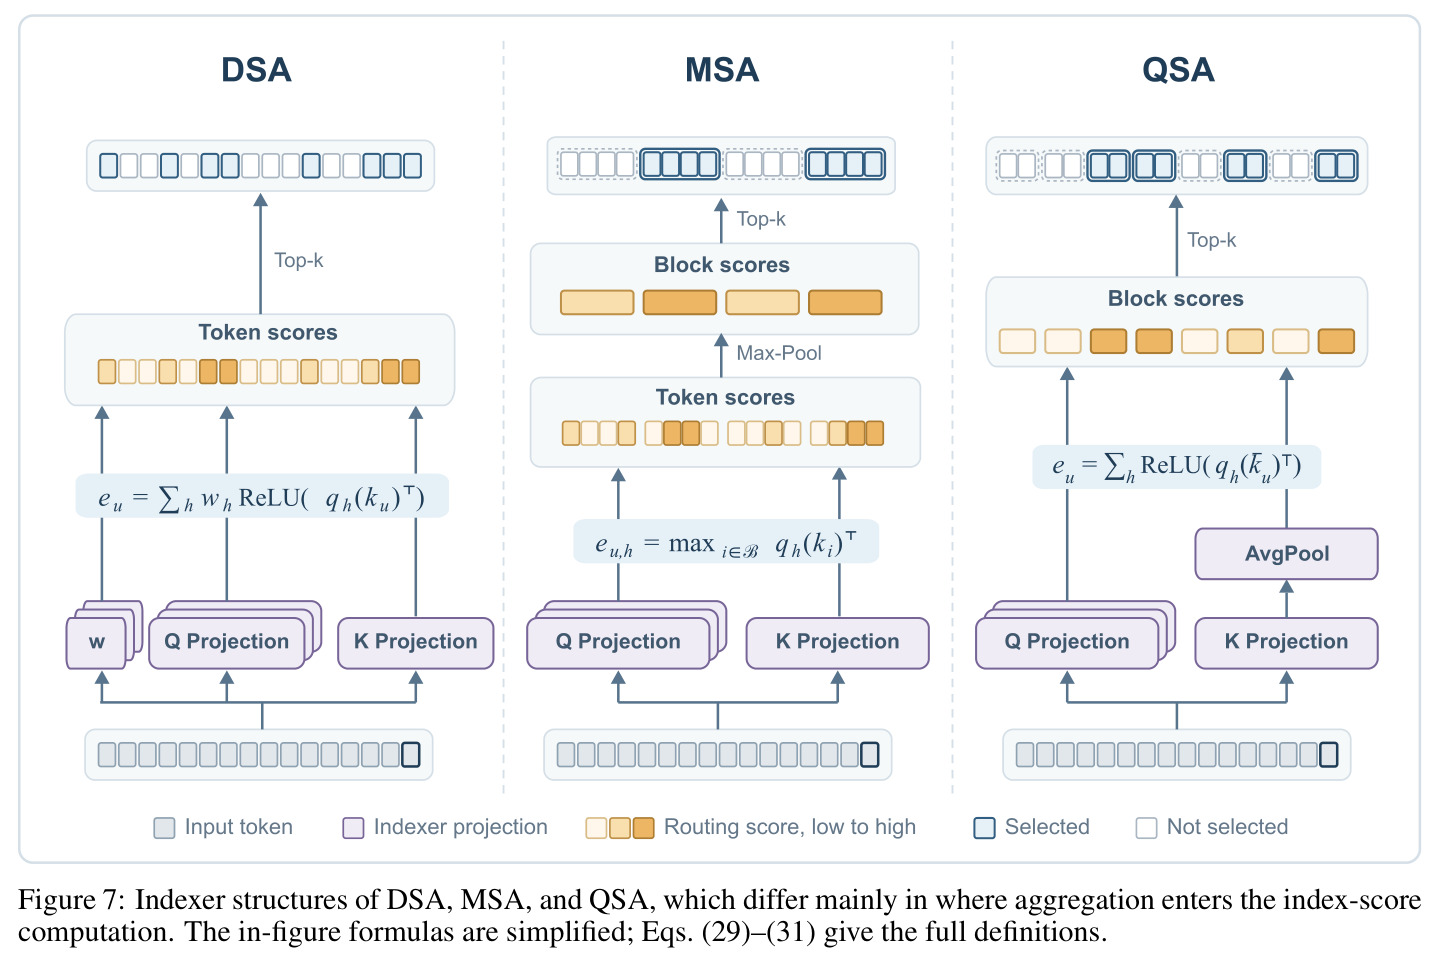
不改变 KV 表示,只让每个查询访问预算内的候选集 $|I_t|=b_t\ll t$,选中后仍做候选局部 softmax。候选可来自固定模式(滑窗+sink)、自路由(Quest/MoBA/NSA)或独立索引器(DeepSeek 的 Lightning Indexer),分属不同证据来源。
这是当前产业界最活跃的方向,论文识别的最新趋势(跨层索引复用、CSA2 的 Full/Reindex/Reuse 模式)都建立在稀疏路由之上。
研究动机
自注意力赋予大语言模型细粒度、查询依赖的上下文访问能力,是现代 LLM 的计算基座,但代价明确:预填充阶段 query-key 比较次数随序列长度二次增长,自回归解码时 KV 缓存按 $\Theta(Ld_{KV})$ 每层线性增长;而且标称更长的上下文窗口并不能保证可靠利用远处证据——候选集扩大会加剧检索干扰、削弱远程召回。为缓解这些限制,研究已沿多条方向演化:KV 头共享(MQA/GQA)、潜空间压缩(MLA)、跨层 KV 共享(CLA)、稀疏访问、循环状态(线性注意力/SSM)、以及异构机制混合。然而现有综述要么按架构族与计算复杂度组织,要么聚焦长上下文技术或 KV 缓存管理,各机制家族被孤立叙述;「某个方法到底改了记忆系统的哪个功能」缺乏统一的比较语言,读者难以判断不同路线的真实异同,也难以理解它们为何能在同一模型中组合。
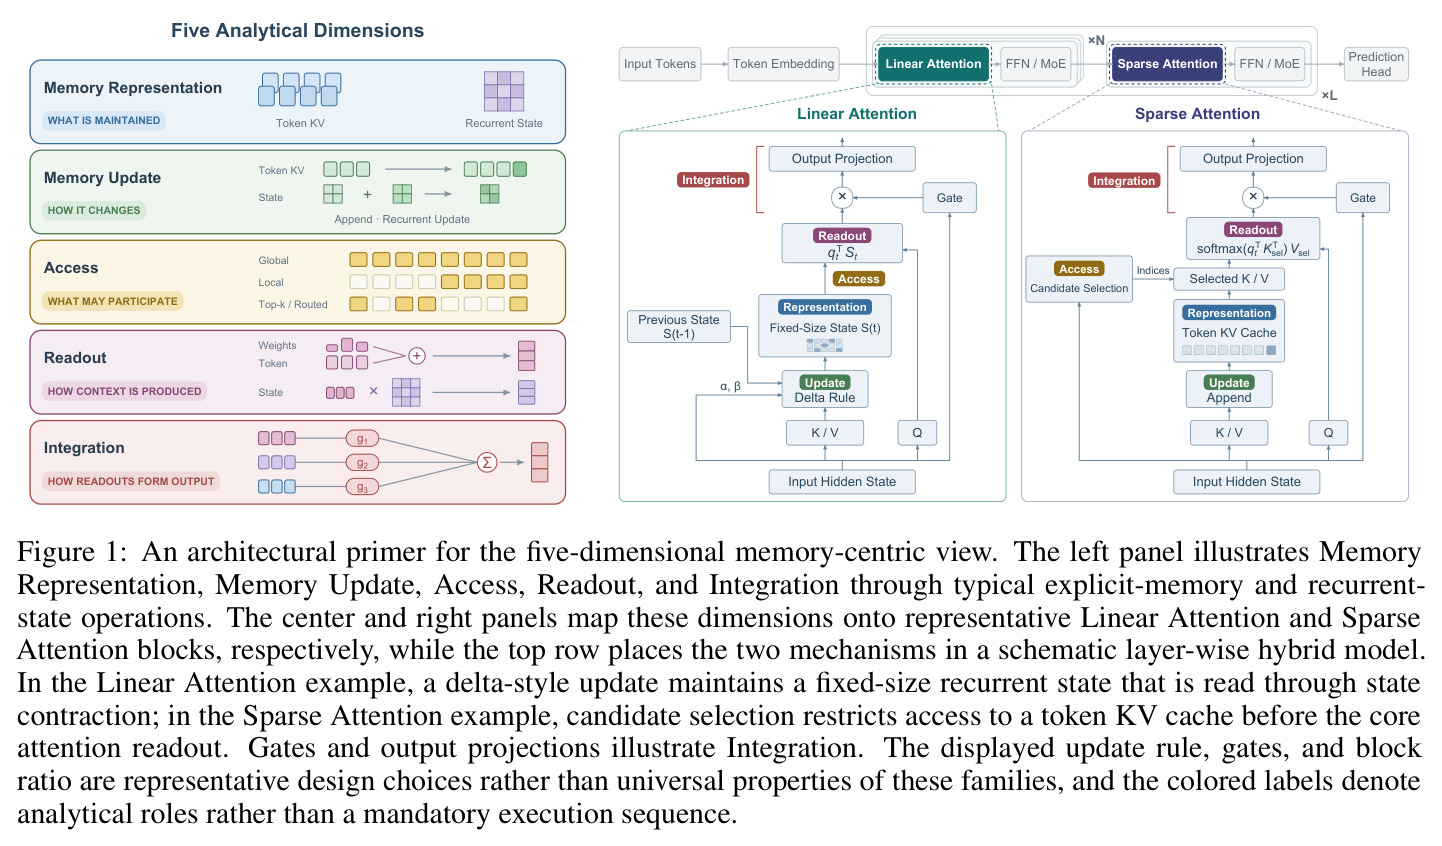
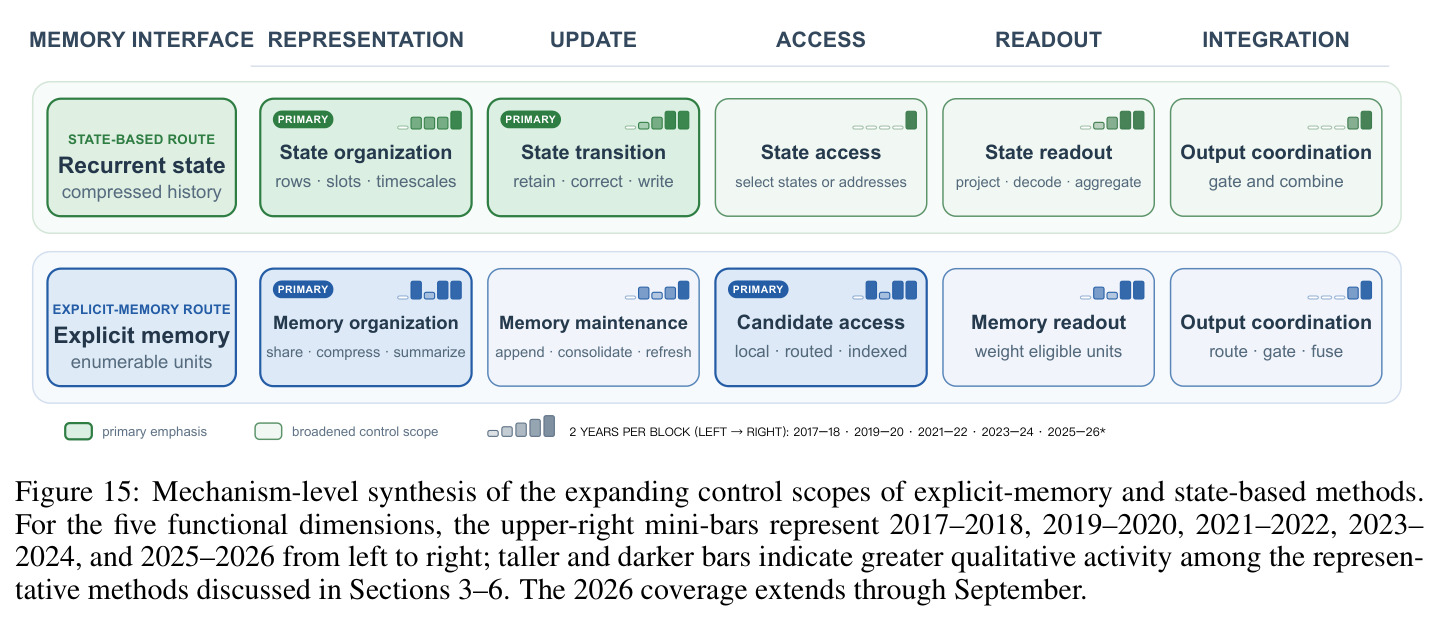
本文的目标是本文的目标是建立以「模型内部上下文记忆」为共同分析单元的统一视角。具体包括:提出五维分析透镜(Memory Representation、Memory Update、Access、Readout、Integration),在统一框架下重构 Softmax 注意力、稀疏注意力、线性注意力、SSM 四条机制线与混合架构这条组合线的发展;再把机制层分析与两组实证证据连接——覆盖 14 个主要模型世系、59 条发布级架构记录的纵向盘点(截至 2026-09-22),以及 11 个高性能开源权重模型端点的冻结对比;最终给出机制层、架构层、前瞻层三级综合,并提出有状态多维记忆路由这一可检验的假说,把高效序列架构设计从「优化孤立算子」转向「组织记忆的表示、生命周期与选择性使用」。
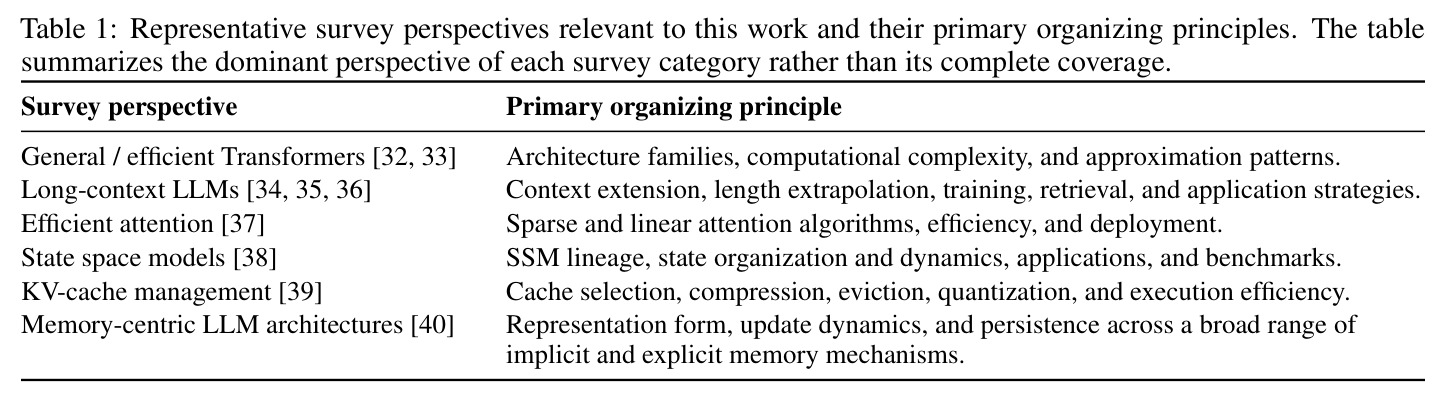
与已有工作不同的是,本文的独特切入在于以「记忆功能」而非「算子或复杂度」组织文献。以往综述分别按架构家族与近似策略、上下文扩展与长度外推、稀疏/线性算法、SSM 谱系或 KV 缓存管理来分类,而本文问五个功能问题:过去的信息以什么形式保留、如何被更新、哪些对当前查询可见、可见信息如何读取、多个读取结果如何整合。这使历史上有重叠的家族(例如多数稀疏方法在选定候选后仍用 softmax 读出)可以在同一坐标系下做多标签描述,而不被强行归一为单一计算模型。此外,它把机制综述与公开发布架构的纵向盘点和冻结前沿对比结合,提供了从论文方法到产业落地的实证桥梁:既有 59 条记录的时间演化,又有前沿性能面上注意力结构的横截面,这是以往注意力/记忆综述普遍缺少的组合。
核心方法
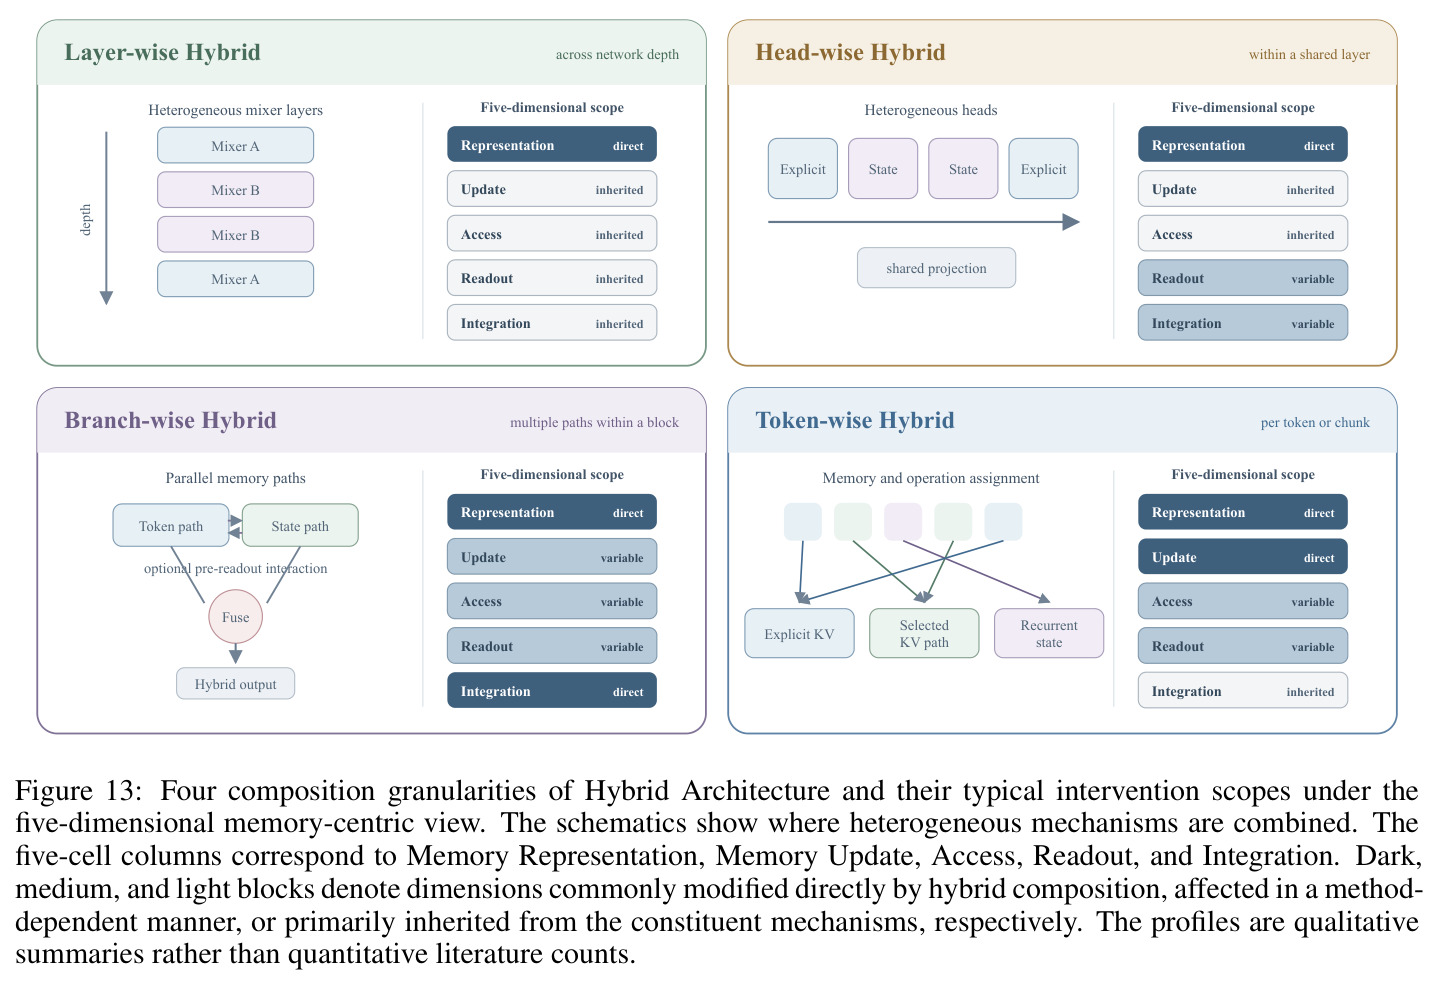
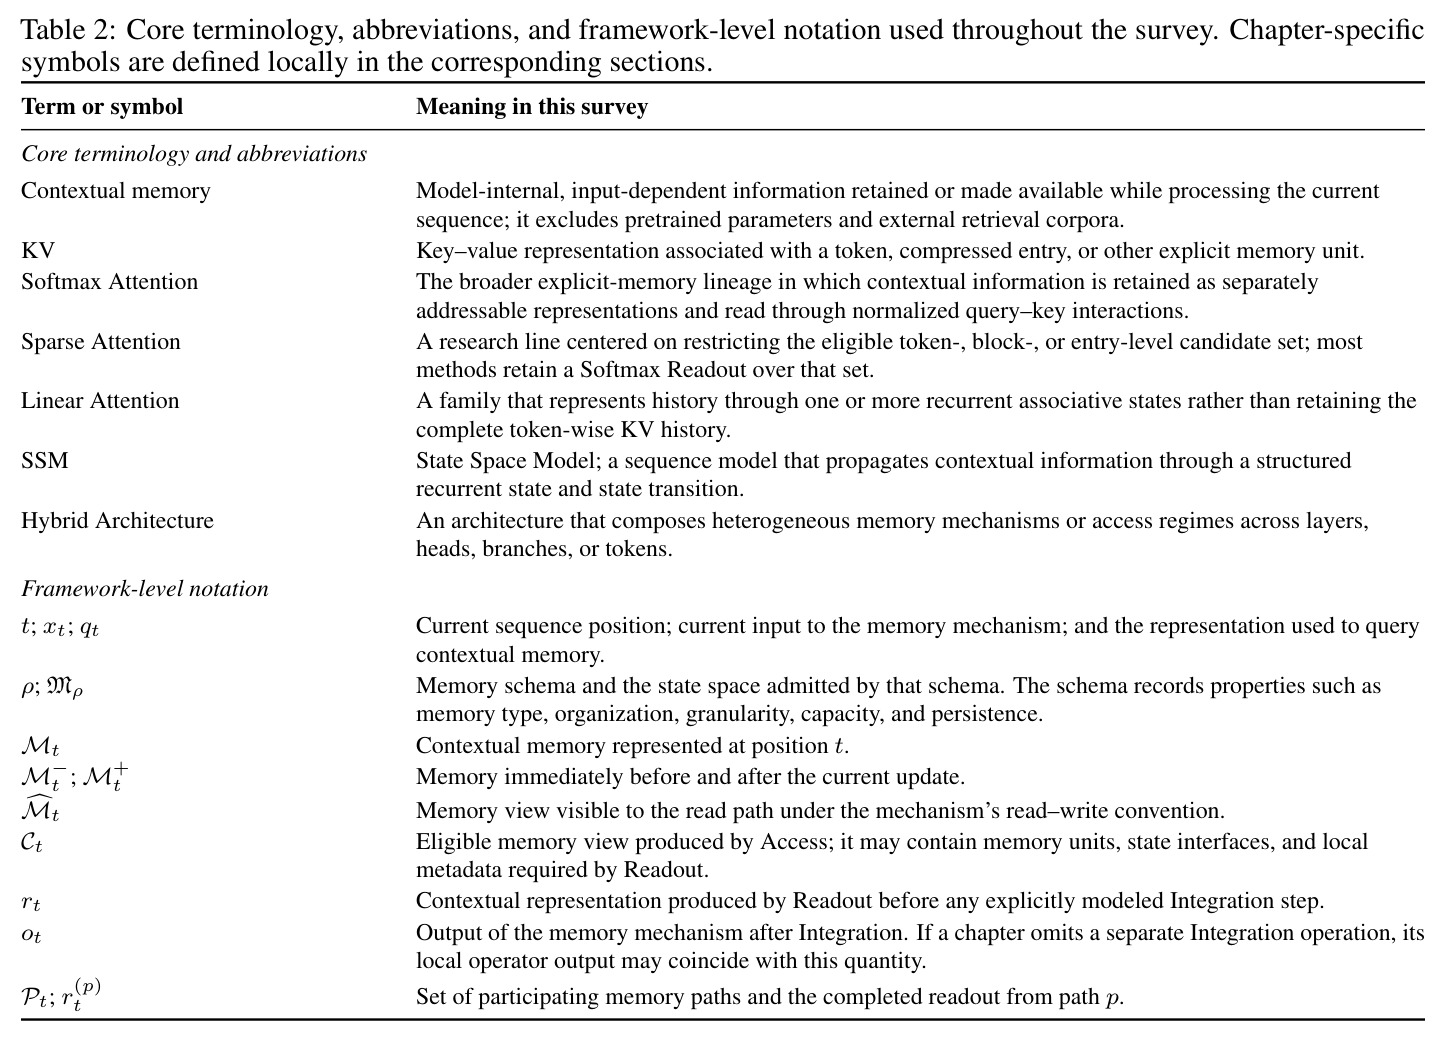
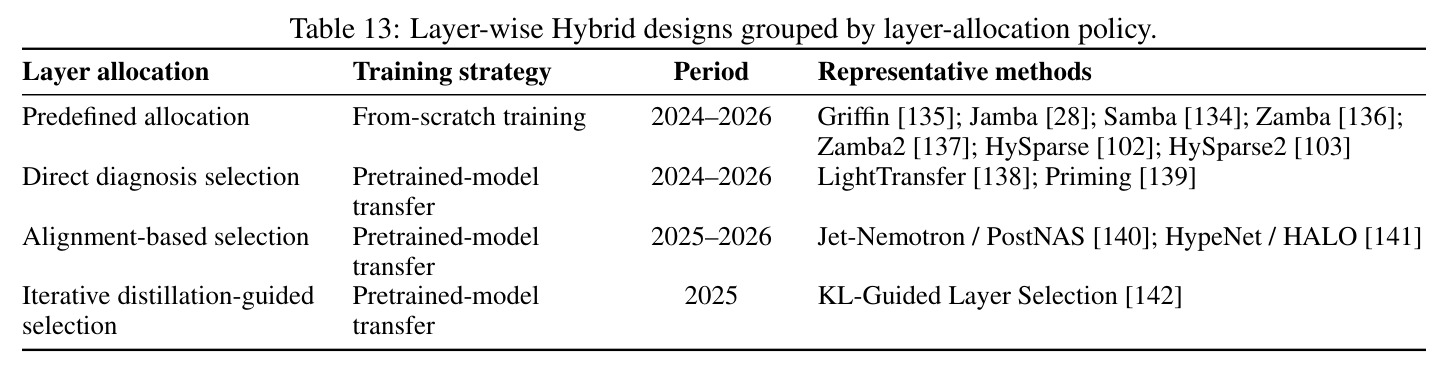
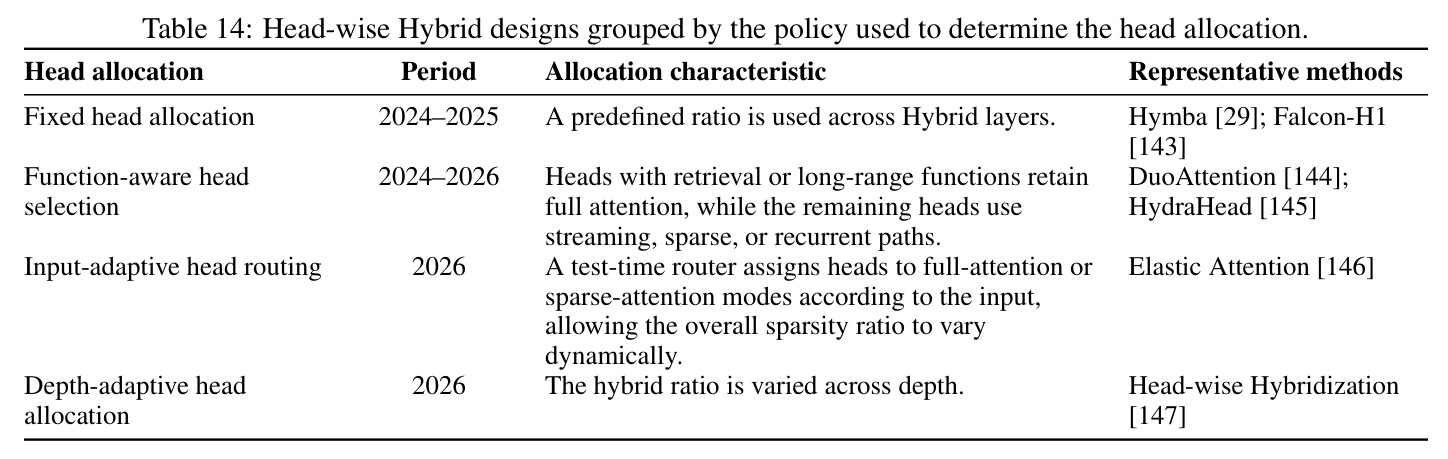
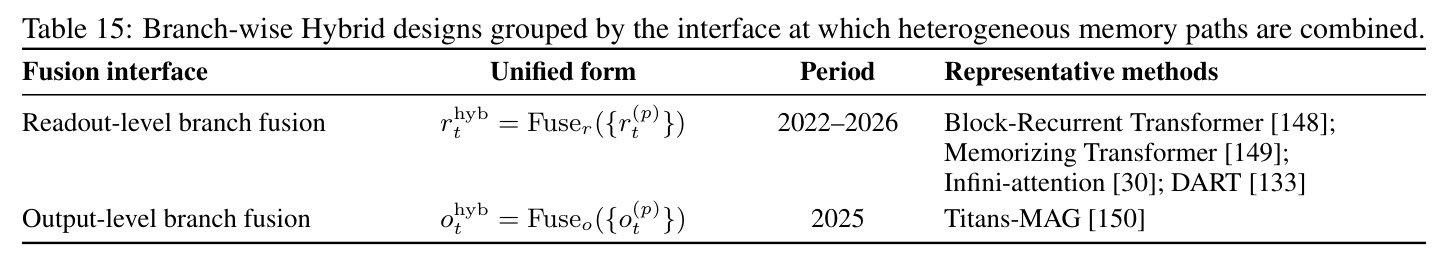
直觉上,无论保留全部 KV 的稠密注意力、限制候选集的稀疏注意力,还是把历史压进循环状态的线性注意力与 SSM,本质都是同一类系统:在处理序列的过程中维护并使用一份模型内部的上下文记忆。技术路线分四步。第一步形式化透镜:设记忆模式 $\rho$ 刻画记忆的类型、组织、粒度、容量与持久性,维护的记忆 $M_t\in\mathcal{M}_\rho$,随后四个抽象算子依次为更新 $M_t^+=\mathrm{Update}_\rho(M_t^-,x_t)$、访问 $C_t=\mathrm{Access}_\rho(q_t,M_t^c)$、读出 $r_t=\mathrm{Readout}_\rho(q_t,C_t)$、整合 $o_t=\mathrm{Integration}_\rho(r_t;x_t)$。第二步按主要干预维度重构四个机制家族(第3-6章)。第三步按组合粒度——层、头、分支、token——分析混合架构(第7章)。第四步用 59 条发布记录的纵向盘点与 11 个前沿端点的冻结对比做架构层实证(第8章),最后在第9章给出三级综合与多维记忆路由假说。
核心创新是用「按功能干预分类」替代「按算子家族分类」。两个方法可以用完全相同的 softmax 读出,却改动截然不同的记忆功能:MQA/GQA/MLA 改 Representation(降低每 token 冗余),Quest/MoBA/DSA 改 Access(限制候选集),DeltaNet/GDN/KDA 改 Representation+Update(循环状态),Talking-Heads/Gated Attention/MoH 改 Readout 或 Integration(读出调制与门控)。透镜还引入两组关键区分:其一,历史覆盖(多少历史能影响记忆)与可寻址性(单个历史单元是否仍可被单独选中)——固定大小状态覆盖全程但不可寻址,KV 缓存可寻址但线性增长;其二,地址压缩与内容压缩——QSA 只压缩索引键、内容仍是原始 token KV,CSA 则连 KV 本体一起压缩。这些区分让「一个效率方法到底改了哪一段」第一次有了精确表述,也解释了为何跨层 KV 共享(共享内容)与跨层索引复用(共享访问决策)是两种不同机制。
方法步骤详情
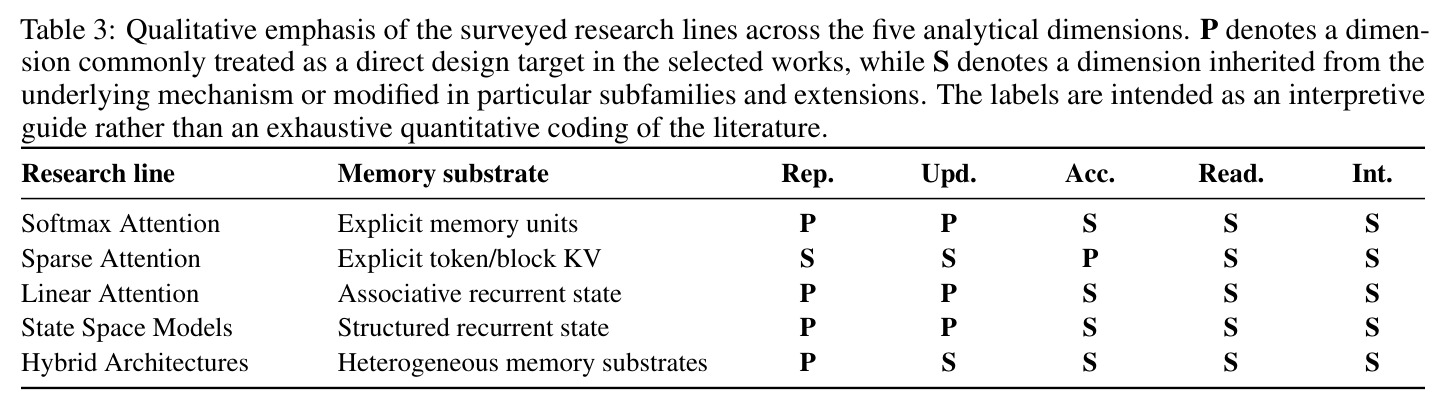
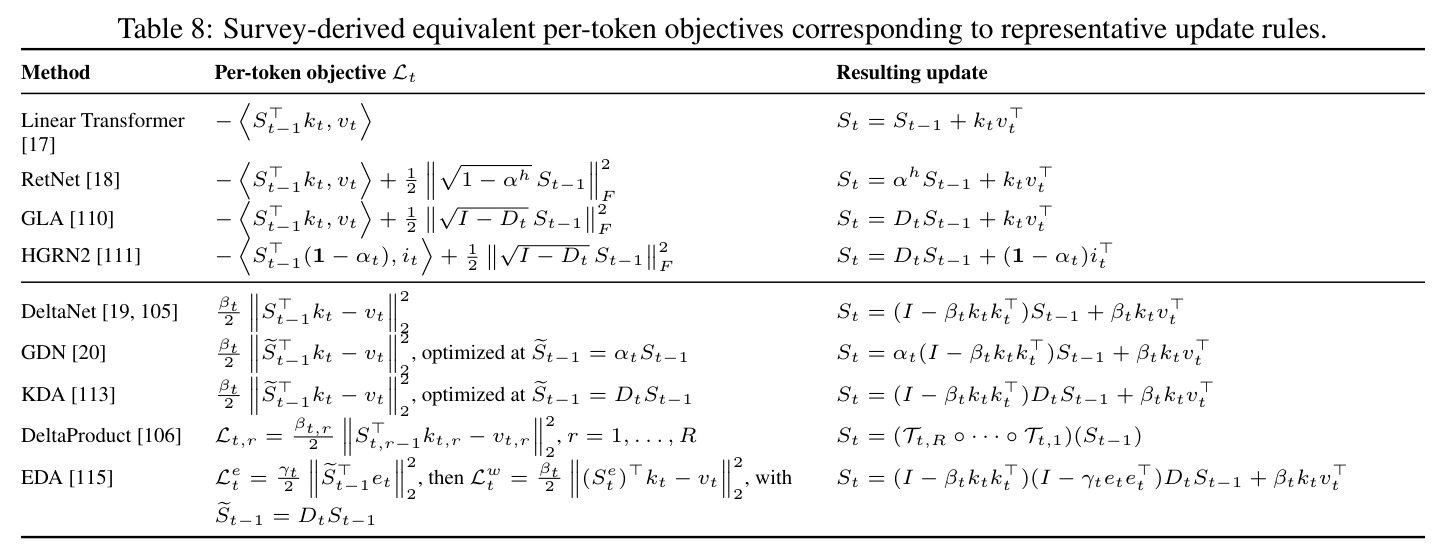
第1步定义框架:给定位置 $t$ 的输入 $x_t$ 与查询 $q_t$,用记忆模式 $\rho$ 与式 (1)-(5) 形式化更新、访问、读出、整合四个算子。第2步家族映射:表3用 P/S 标注各线侧重——Softmax/Linear/SSM 主攻 Representation+Update,Sparse 主攻 Access,Hybrid 主攻 Representation。第3步机制重构:线性注意力更新分解为 Retain/Decay、Erase/Correct、Write/Commit 三轴,逐方法给出统一规则与等价目标(表7、表8),如 DeltaNet 对应 $\frac{\beta_t}{2}\|\bar S_{t-1}^\top k_t-v_t\|^2$ 的单步梯度;SSM 从时不变动力学讲到选择性控制与 SSD 对偶。第4步盘点构建:共享注意力骨干的同批发布并为一条记录,披露不足标 undisclosed;冻结对比取 2026-09-22 的 Artificial Analysis v4.3.2 快照 11 个开源端点。第5步综合:机制层、架构层结论递进到前瞻假说。
技术新颖性
新颖性有四点。其一,分析工具:五维透镜与记忆模式 $\rho$ 记法是新的公共词汇,可对任意方法做多标签定位,避免家族划分的互斥性(如稀疏方法仍含 softmax、混合方法横跨所有家族)。其二,综合方法:综述自行把数十种线性注意力更新规则统一为 Retain/Erase/Write 分解并推导等价优化目标(表8),揭示「加性方法最大化相关性→delta 类方法最小化重构误差」的两阶段演化,是本文自己的智力贡献。其三,实证:首次系统整理 59 条发布级记录(14 世系),量化混合占比从 2022-23 的 0% 升至 2026 的 63%,并把「跨层复用」识别为与「混合放置」正交的新协调轴(仅 GLM、DeepSeek、LongCat 三个模式的 5 条记录具备)。其四,前瞻:提出四维地址空间 $\mathcal{A}_t=\mathcal{T}_t\times\mathcal{L}\times\mathcal{S}\times\mathcal{G}$ 与 Sparse Write/Sparse Read 耦合的有状态记忆路由假说,把网络深度变成记忆组织的新坐标。
实验结果
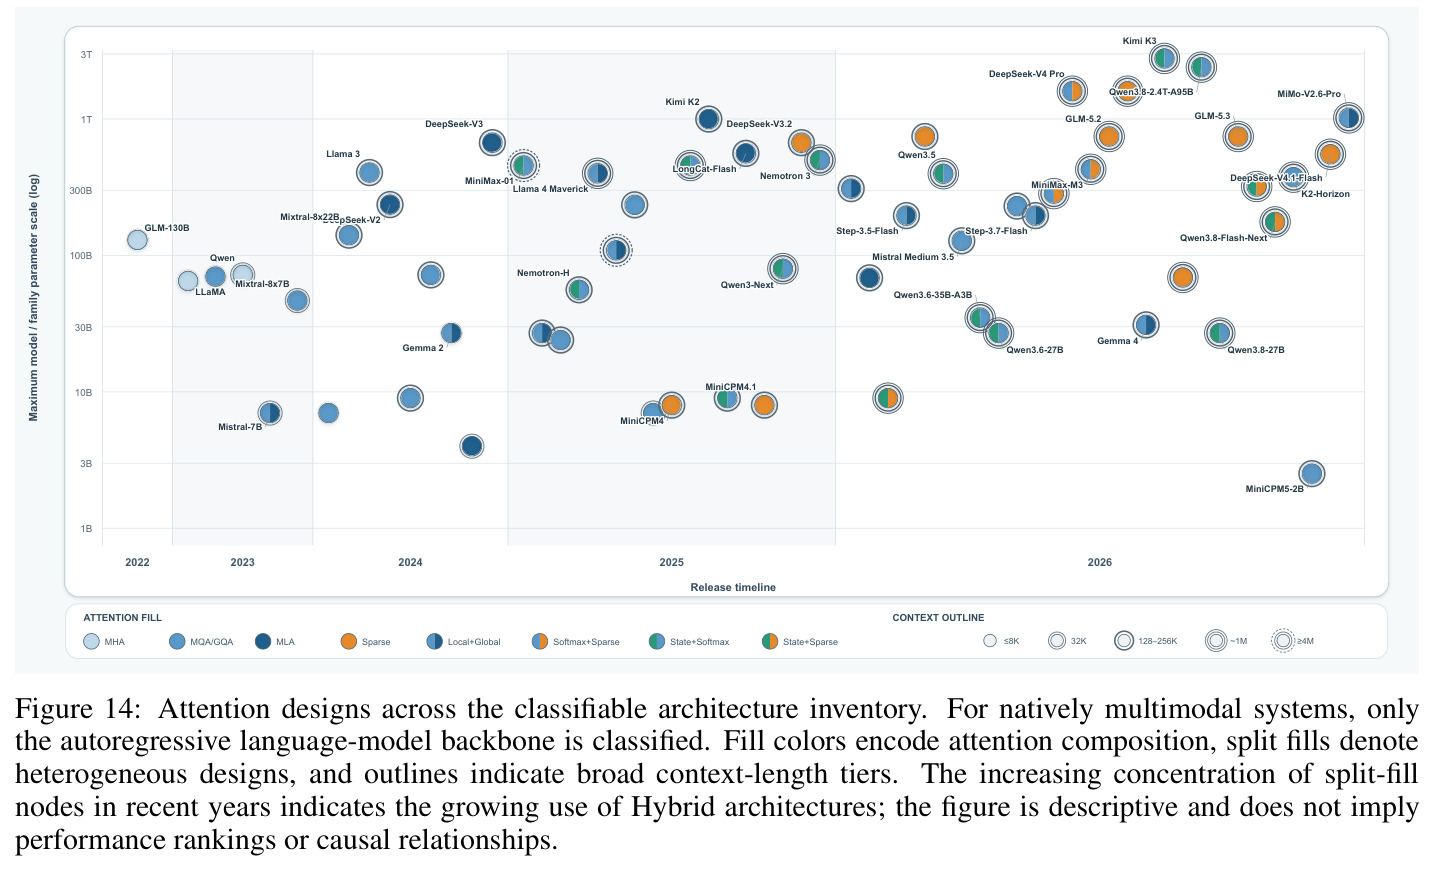
核心发现分三层。机制层:显式记忆路线(Softmax/Sparse)与状态路线(Linear/SSM)起点不同但显式控制范围不断扩张、交集增大——前者延伸到有界更新与读出门控,后者延伸到选择性访问与门控整合;收敛在控制范围而非记忆基底。架构层:58 条可分类记录中 32 条单一、26 条混合;混合占比从 2022-23 的 0/6 升至 2024-25 的 9/25(36%),再到 2026 的 17/27(63%);跨层复用 2026 年首现于 5 条记录(19%)——GLM-5.2/5.3 的 IndexShare、DeepSeek-V4.1-Flash CSA2、LongCat 的 Cross-Layer Indexing。前沿层:11 个端点高度异构——Kimi K3(2.8T/104B,3 KDA:1 门控 MLA)、Qwen3.8-2.4T(3 DeltaNet:1 全 GQA)、DeepSeek-V4 Pro(CSA/HCA)、K2-Horizon 纯 GQA——但 11/11 保留显式 token 检索路径,循环与稀疏是补充而非替代。
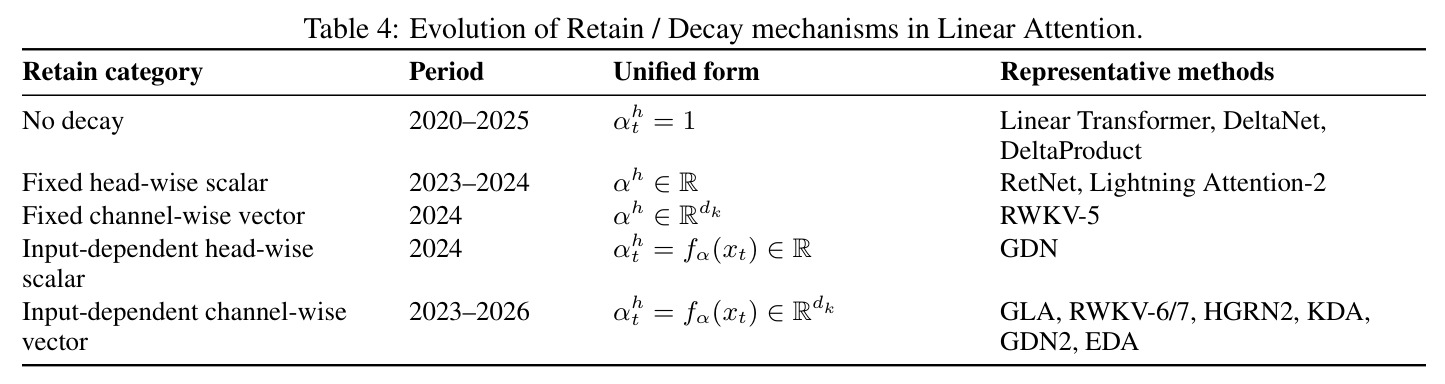
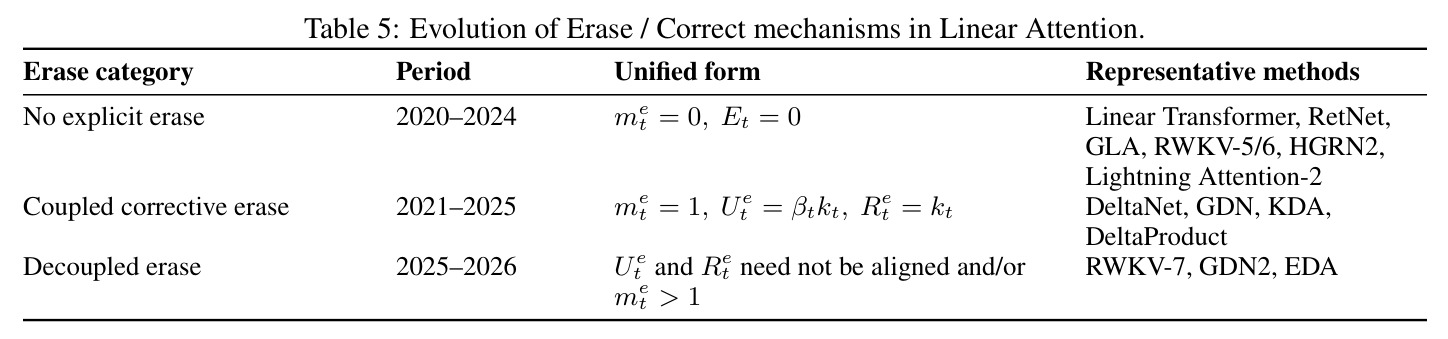
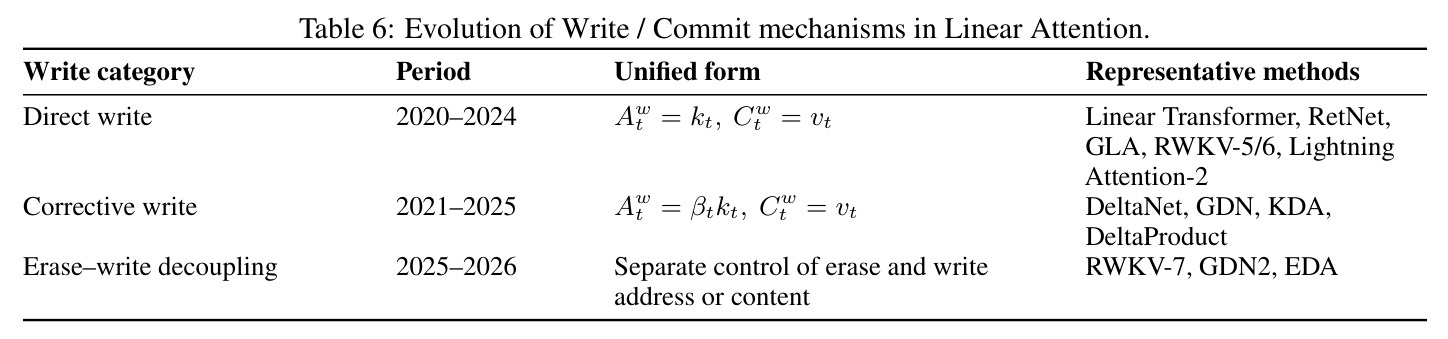
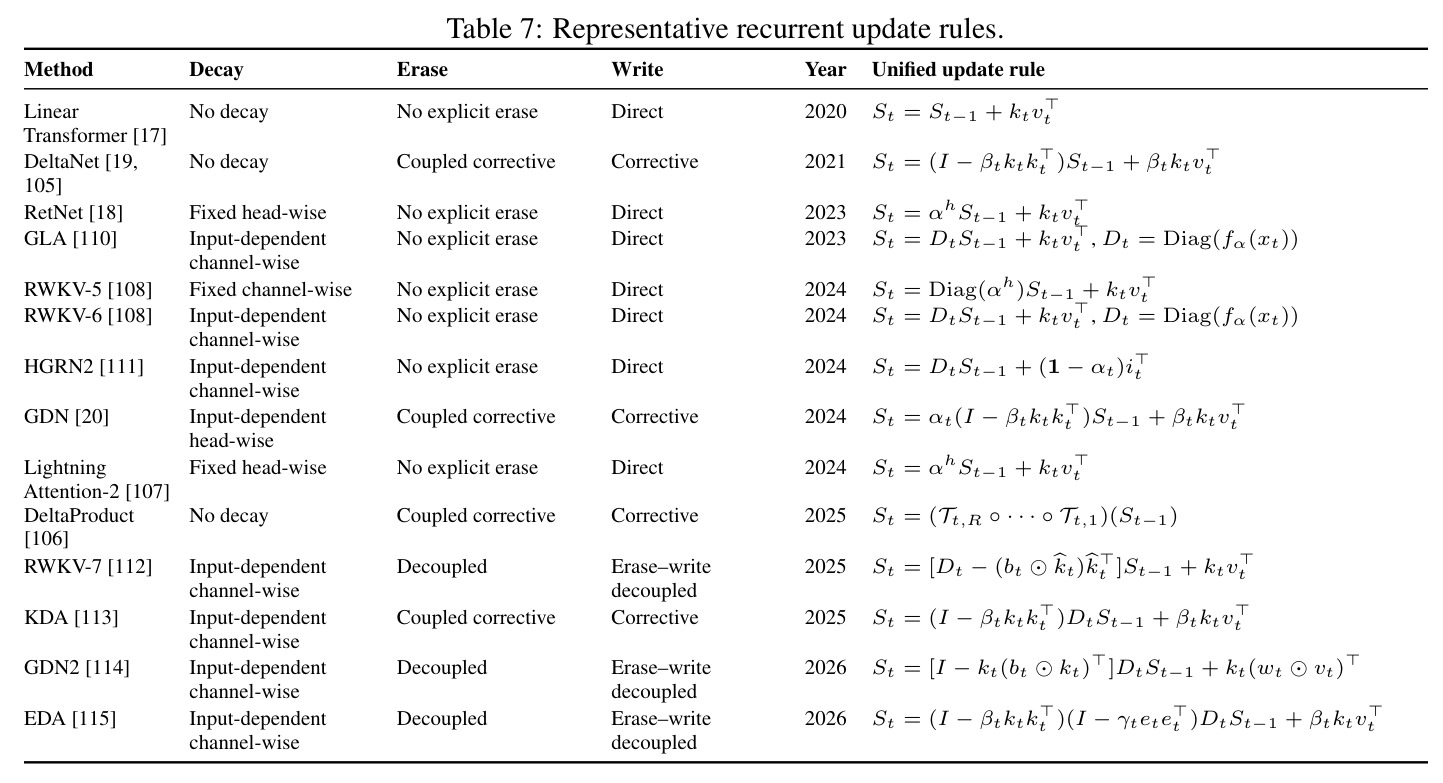
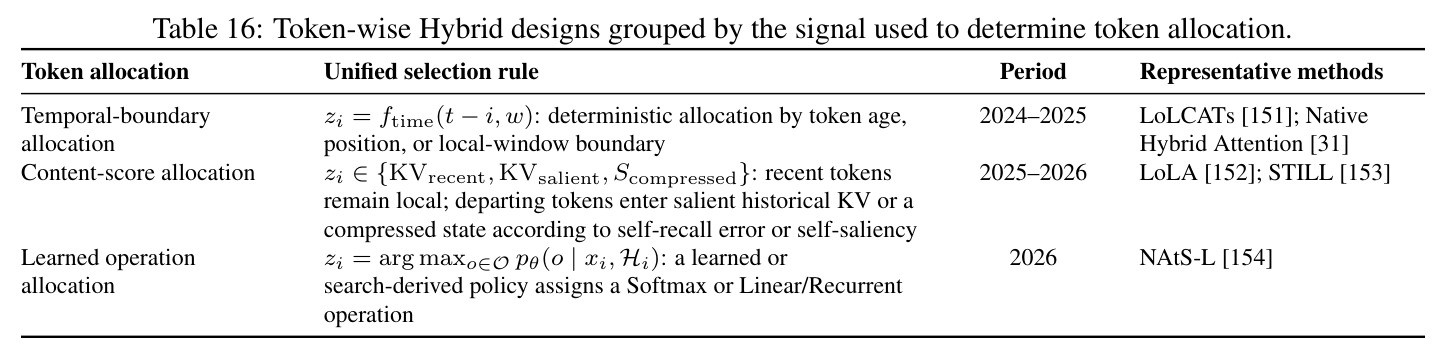
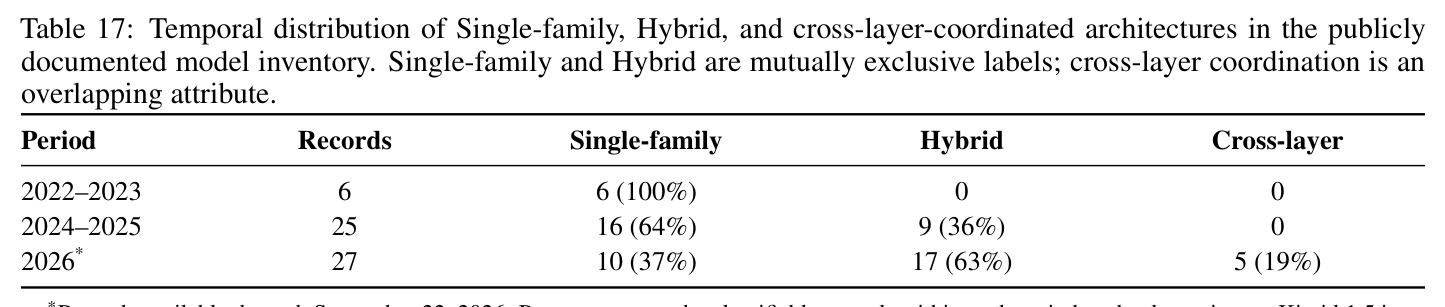
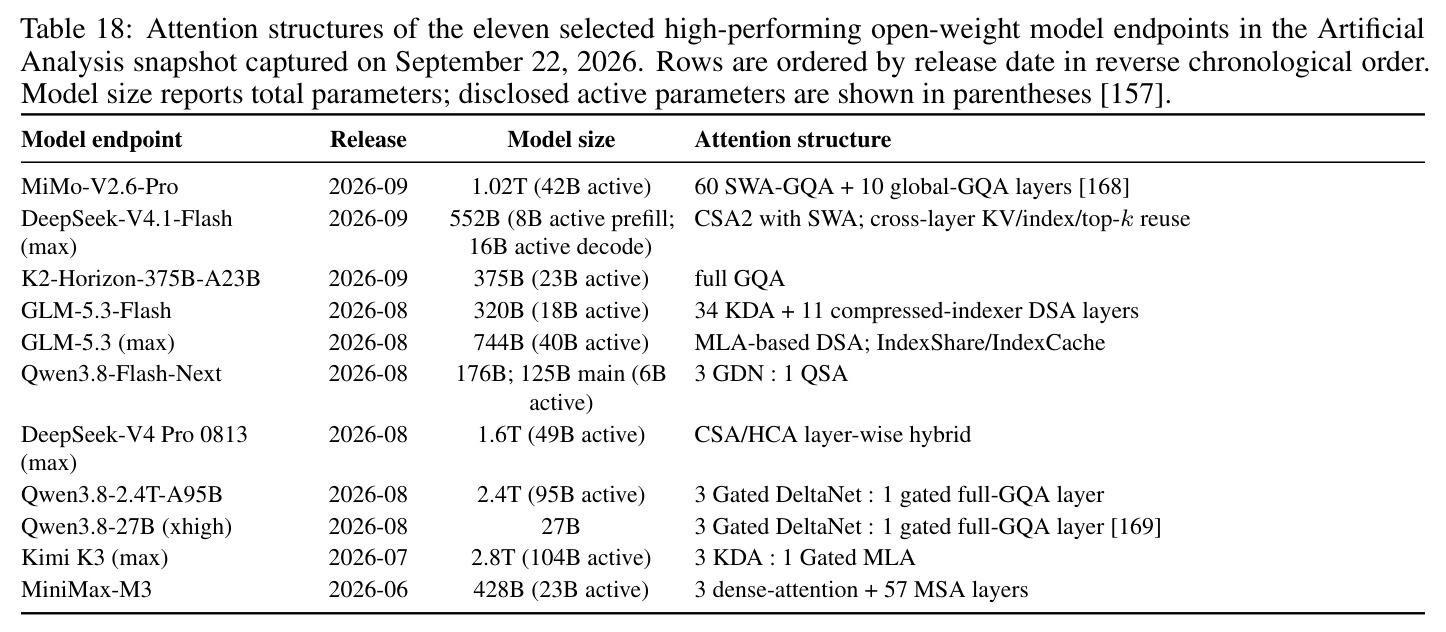
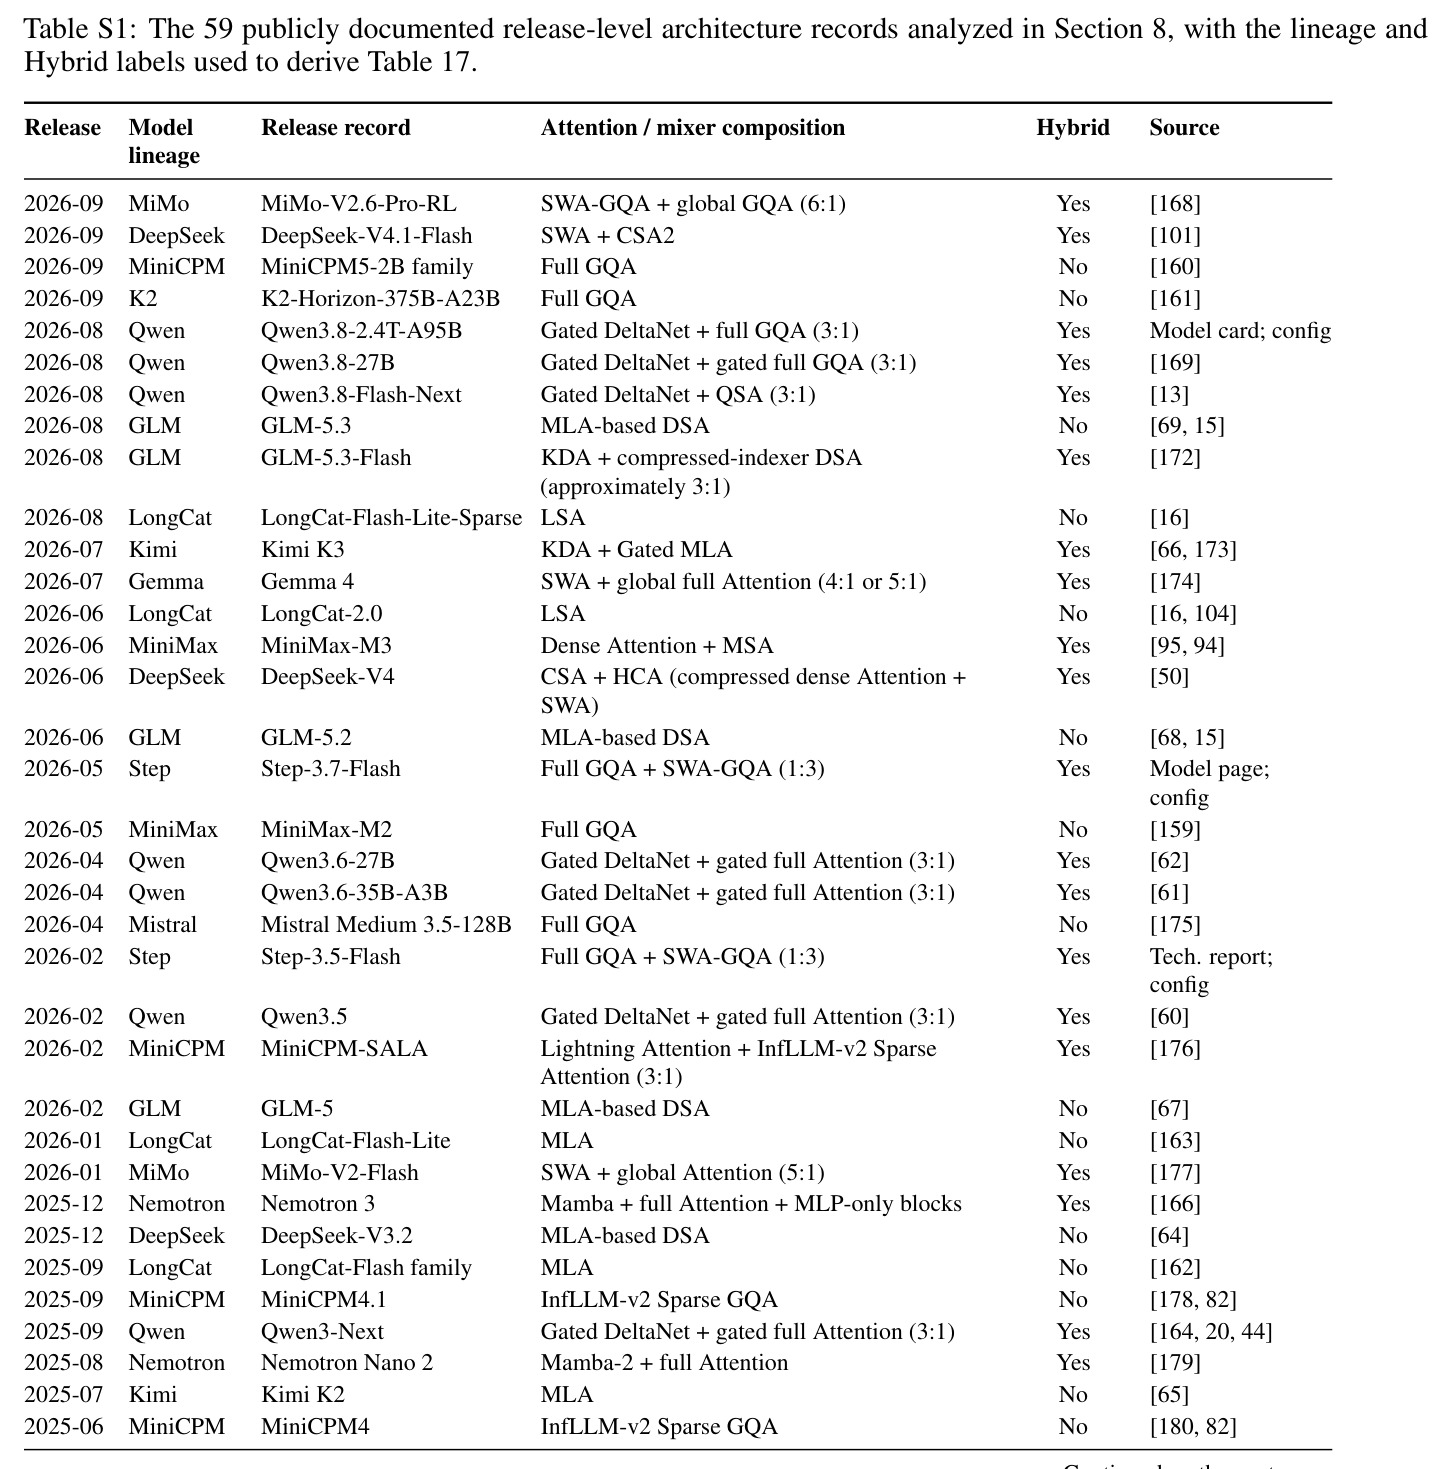
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 发布级架构纵向盘点(2022–2026.9,58条可分类记录) | 混合架构记录占比 | 2026年:17/27(63%) | 2022–2023年:0/6(0%);2024–2025年:9/25(36%) | 混合设计从无到主流,占比三年内升至63% |
| 跨层记忆/路由工件复用的采用 | 具备跨层复用属性的记录占比 | 2026年:5/27(19%),为GLM-5.2/5.3、DeepSeek-V4.1-Flash、LongCat-2.0、LongCat-Flash-Lite-Sparse | 2022–2025年:0条 | 2026年首次出现该协调方式,扩展了记忆工件在深度上的生命周期 |
| 开源性能前沿的注意力构成(Artificial Analysis v4.3.2 冻结快照) | 保留显式 token 检索路径的端点比例 | 11/11(100%) | 不适用(描述性统计,无因果推断) | 表明循环状态与稀疏访问在前沿是补充而非替代 token 级寻址 |
局限与改进
作者明确承认的限制:盘点是有目的的精选而非穷尽,也未按市场份额加权,因此只能刻画「文档化采用与共存」,不能把模型质量归因于注意力机制——排行榜分数还受模型规模、训练、后训练、推理预算与系统实现影响;Kimi k1.5 因架构未披露被排除在分类之外;冻结快照截止 2026-09-22,而领域演化极快,结论容易过时;多模态模型只分类语言骨干,可能遗漏模态接口对注意力设计的影响。我自己的观察:表3的 P/S 标签是解释性定性标注而非定量编码,边界方法的归类存在主观空间;混合/单一家族是发布级二分标签,把同日多尺寸发布合并,掩盖了层配比、头预算等关键差异;综述未在任何受控预算下对机制做定量性能对比或元分析,「哪个机制在什么场景更优」依然无解;CSA/HCA/QSA 等新名词高度依赖厂商技术报告,第三方难以独立验证;跨层复用仅 5 条记录,据此推断趋势样本明显偏小。
独立分析的弱点
弱点一:纯描述性、缺乏预测力——框架能事后解释任何方法改了哪个维度,却无法在设计新方法前告诉你哪个维度的干预收益最大。改进方向:为五维建立可量化的设计空间覆盖图谱,结合现有消融文献估计每个维度的边际质量-效率收益。弱点二:记录粒度太粗——发布级记录合并多尺寸模型,Hybrid 二分标签掩盖层配比(如 3:1 与 1:7 的巨大差异)、头预算与融合接口;改进方向:按「层配比+访问机制+状态机制+融合接口」四元组编码记录,支持聚类与共现分析。弱点三:效率讨论停留在公式与渐近复杂度层面,没有统一的端到端吞吐、显存流量、内核实测对比,而真实差距常取决于 kernel 与硬件支持(如 MoH 的头稀疏只有运行时支持才省算力);改进方向:补充标准化的延迟/带宽/显存占用对照表并区分 FLOPs 节省与真实加速。弱点四:前瞻假说虽然给出了「匹配记忆、计算与路由预算下的质量-效率前沿」这一判据,却没有配套具体基准、数据集与报告规范,短期难以证伪;改进方向:定义公共长上下文检索+智能体任务套件以及记忆预算报告标准。
未来方向
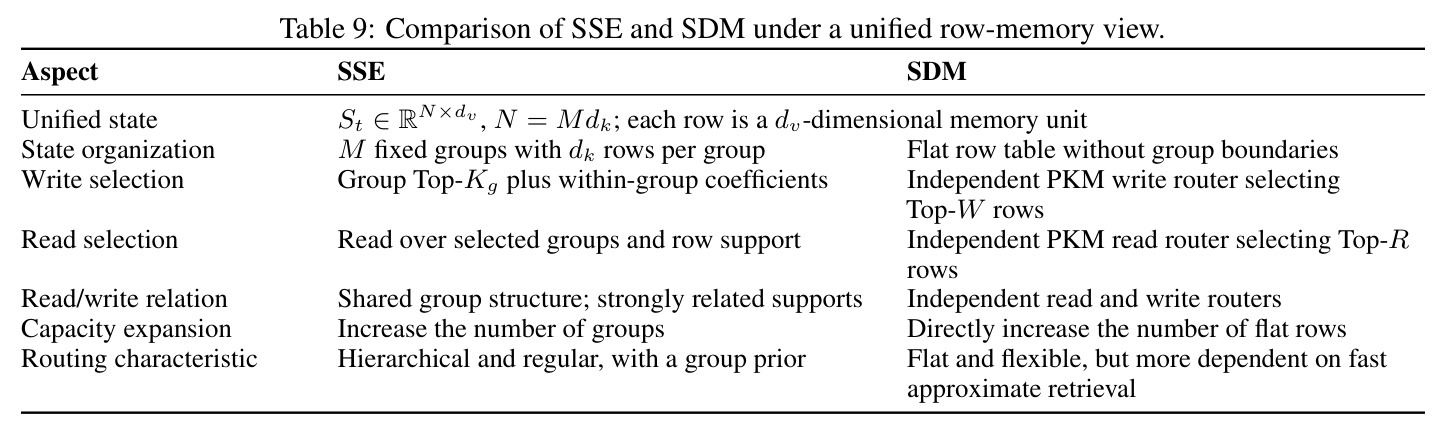
作者提出有状态多维记忆路由假说:持久记忆按 $\mathcal{A}_t=\mathcal{T}_t\times\mathcal{L}\times\mathcal{S}\times\mathcal{G}$(时间×深度×基底×粒度)组织,写路由 $W_t\subseteq\mathcal{A}_t$ 与读路由分离且联合协调;写决策改变未来可用信息,路由因此主导记忆生命周期——类似记忆版 MoE,区别在持久性。落到四个可检验方向:(1) 工作负载感知的差异化表示——类型化构造器按来源、稳定性、层级、精度把输入区域映射到精确/压缩/索引/循环四类记忆;(2) 非对称构建与检索——轻量预填充路径产出摘要与路由地址,解码先查粗记忆、不足再细化到原始 token;(3) 增量生命周期与可复用工件——轻量控制器按隐藏态漂移与候选集变化在 reuse/refresh/transform/invalidate 间选择;(4) 任务条件联合路由——有限配置菜单+任务状态选择记忆基底、检索粒度、注意力模式与计算预算。还可延伸:跨层复用的理论边界、记忆写入的长期信用分配、多维路由的硬件感知内核设计。
复现评估
作为综述无需复现训练实验,其可复现资产分三部分。其一,附录表 S1 完整给出 59 条记录的发布时间、模型世系、注意力/混合器构成、Hybrid 标签与来源映射(从 GLM-130B 2022-10 的全 MHA 到 MiMo-V2.6-Pro-RL 2026-09 的 6:1 SWA-GQA+全局 GQA),任何人可据此核对、更新或扩展盘点;构建规则(合并标准、undisclosed 处理、多模态只看语言骨干)写得足够明确。其二,冻结对比基于公开的 Artificial Analysis Intelligence Index v4.3.2(2026-09-22 快照)加各模型官方技术报告与配置文件,理论上可重建,但排行榜历史快照难以回溯,复现需自行存档。其三,分析框架门槛低:五维标注只需阅读方法论文即可完成,可直接套用于新论文。论文为 arXiv 预印本(阿里 Token Hub 团队),未附带代码库。总体难度:盘点数据部分中等(依赖官方披露完整性与持续追踪约 200 篇文献),框架应用部分容易,验证前瞻假说部分困难(需自行训练多套架构做受控对比)。
论文图表