A2Z GameSpec-Bench:编码智能体从长篇游戏设计文档生成游戏的忠实度基准 A2Z GameSpec-Bench: How Faithfully Can Coding Agents Generate Games from Game Design Specifications?
以100份长篇GDD构建冻结的依赖感知契约,三轴联动评测并改进编码代理的设计忠实度
前置知识
GDD(游戏设计文档)
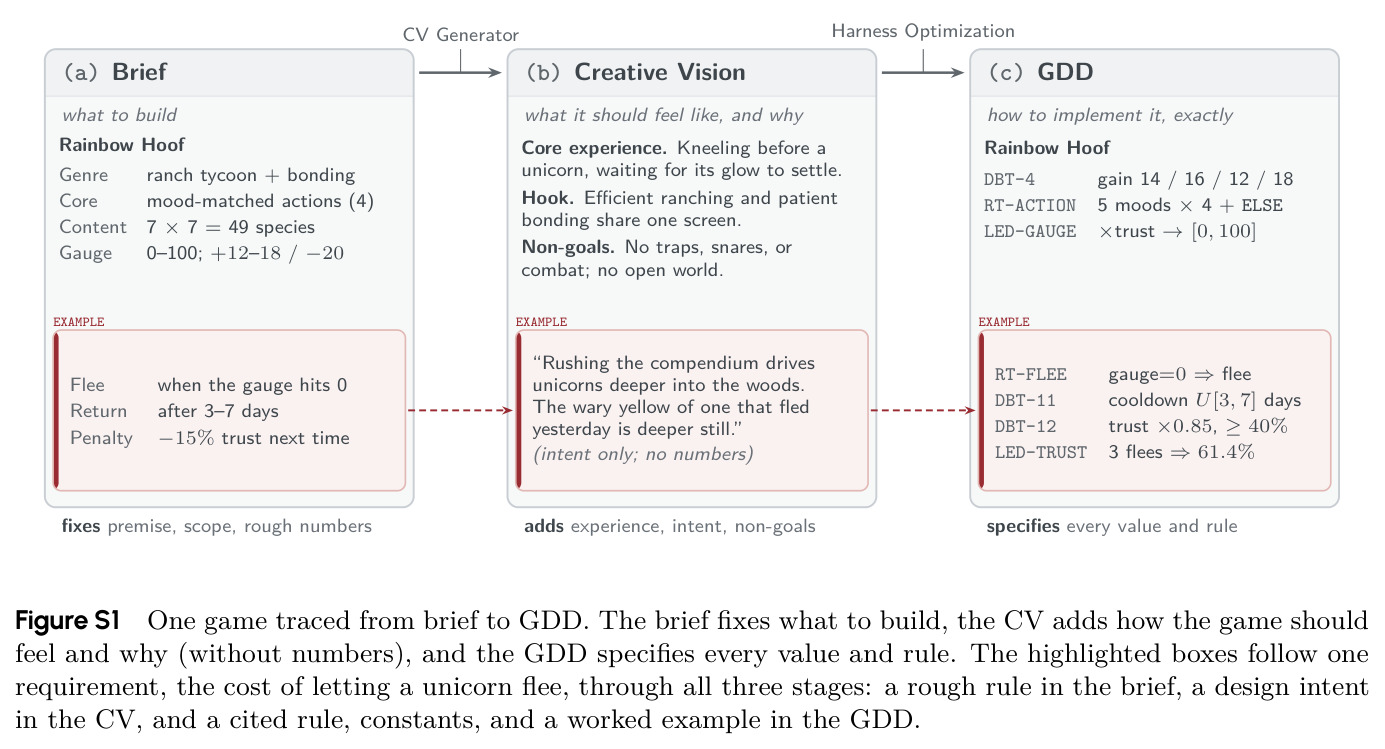
游戏行业中完整描述一款游戏设计的长篇规格文档,涵盖机制规则、数值平衡、状态机、UI、美术音频需求等,是策划与程序之间的“合同”。本文的GDD还采用固定书写约定:可调数值登记进带稳定标识符的平衡表(DBT-n)、离散行为写成自上而下首条匹配且含ELSE兜底的规则表(RT-*)、多来源派生值写成带算例的账本(LED-*),使每条需求都可定位、可复算。
整个基准围绕“长篇GDD能否被忠实实现”构建:评测目标全部从GDD的行级条目抽取,理解这些约定才能理解契约如何形式化规则与依赖。
编码智能体(Coding Agent)与规格驱动开发
以LLM为核心、能在开发环境中自主读写代码、执行构建并迭代调试的软件工程代理。规格驱动开发指只提供详细规格,让代理端到端交付完整应用(这里是源码工程+可玩构建),无需人逐步指挥每个低层操作,从而在放大的委托规模下保留设计控制权。
被测对象就是9个编码智能体配置(Claude/GPT/GLM/DeepSeek/Kimi系),任务是从一份GDD一次性产出完整可玩游戏,考察的正是这种规格遵循能力。
依赖感知契约(Dependency-Aware Contract)
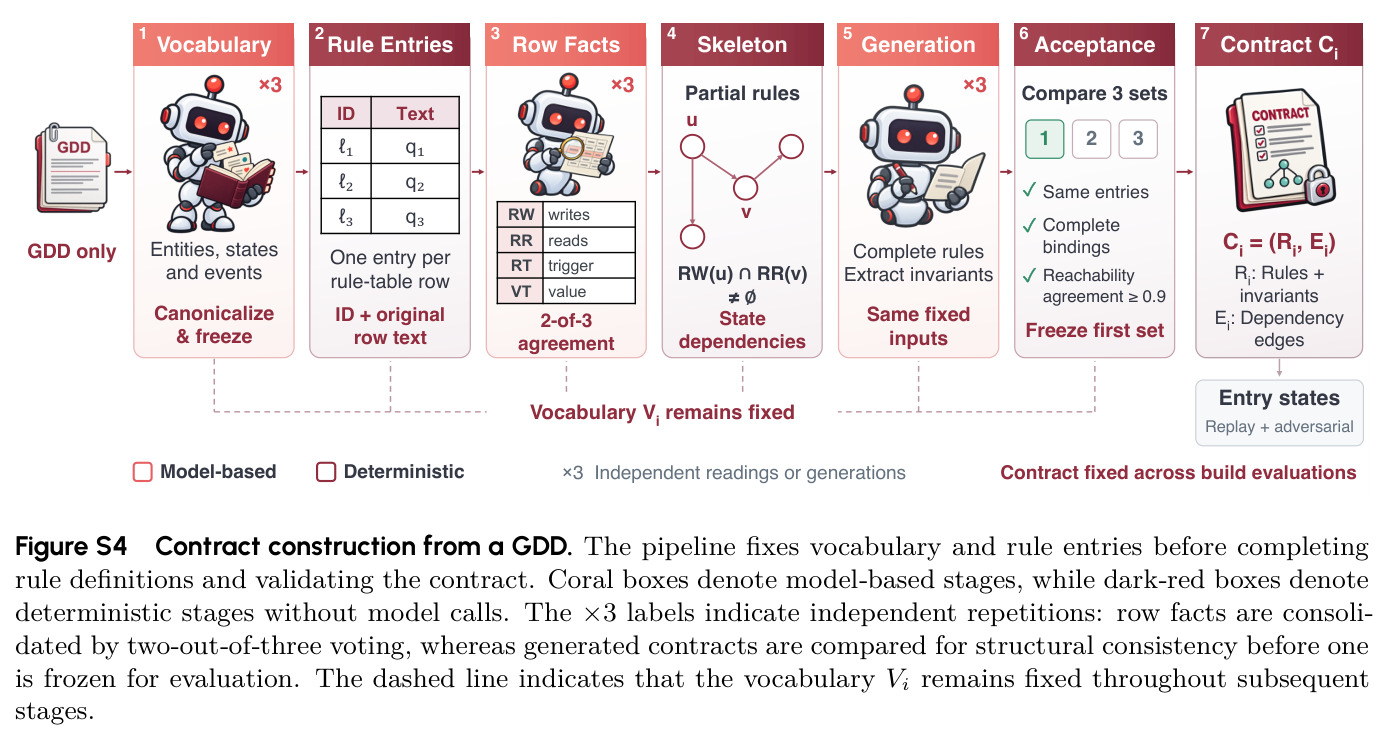
把GDD形式化为二元组 $\mathcal{C}_i=(\mathcal{R}_i,\mathcal{E}_i)$:规则集(条件、触发、效果)与不变式集,加上有向依赖边——当一条规则写入的状态恰被另一条规则的条件读取($\mathrm{RW}(\ell_u)\cap\mathrm{RR}(\ell_v)\neq\emptyset$)或其发出的事件触发另一规则时连边。契约在生成前构建、对构建代理隐藏、跨代理与修订轮冻结。
契约是全文评测与反馈的“锚点”:依赖加权评分、集成失败诊断、需求级反馈都建立在依赖边与固定需求身份之上。
LLM-as-a-Judge(代理评审)
用LLM替代人类按固定评分细则对生成物打分并强制引用证据。本文源码轴用带锚点的 $f^{src}_{i,r}\in[0,1]$ 连续分(1.00=完全实现、0.5=约半数行为、0=缺失或矛盾),不变式用二值判决,回放轴必须引用具体帧,试玩轴每规则三次判决取严格多数;证据缺失记为“未验证”而非“违反”。
三个评测轴全部由评审模型驱动,其一致性(如源码Pearson 0.72、试玩判决一致度0.91/0.89)与成本直接决定基准的可信度与可复现性。
Code-as-Policy 试玩机器人
源自 Liang et al. 2023 的思想:评估侧编码代理读取测试目标 $\omega$ 与统一的观察/输入接口API,生成一个可执行JavaScript程序作为bot($b_{i,\omega}=A_{play}(g_i,\omega,\mathrm{API})$),用条件与循环根据运行时状态在线选择玩家输入,并以带规则ID的快照记录证据,形成轨迹 $\tau=[(o_t,x_t)]$。
自适应试玩轴完全靠这种bot实现闭环交互测试,是普通/对抗试玩与执行证据采集的执行载体。
场景回放与对抗式测试
回放(replay)按固定输入序列与时刻 $\xi=[(x_n,t_n)]$ 重放游戏并采集帧证据,可控但无法响应运行时状态;对抗式(adversarial)测试先用场景入口或最小化 setState 初始化满足目标规则前置条件的状态 $z\models\varphi_r$,之后只允许玩家输入去触发并观察效果,用于覆盖普通游玩到不了的分支;初始化只供前置条件、绝不供预期结果。
二者加源码检查构成三轴评测;对抗式初始化使判断覆盖率从21.7%跃升到74.4%,是理解主要结果与组件分析的前提。
研究动机
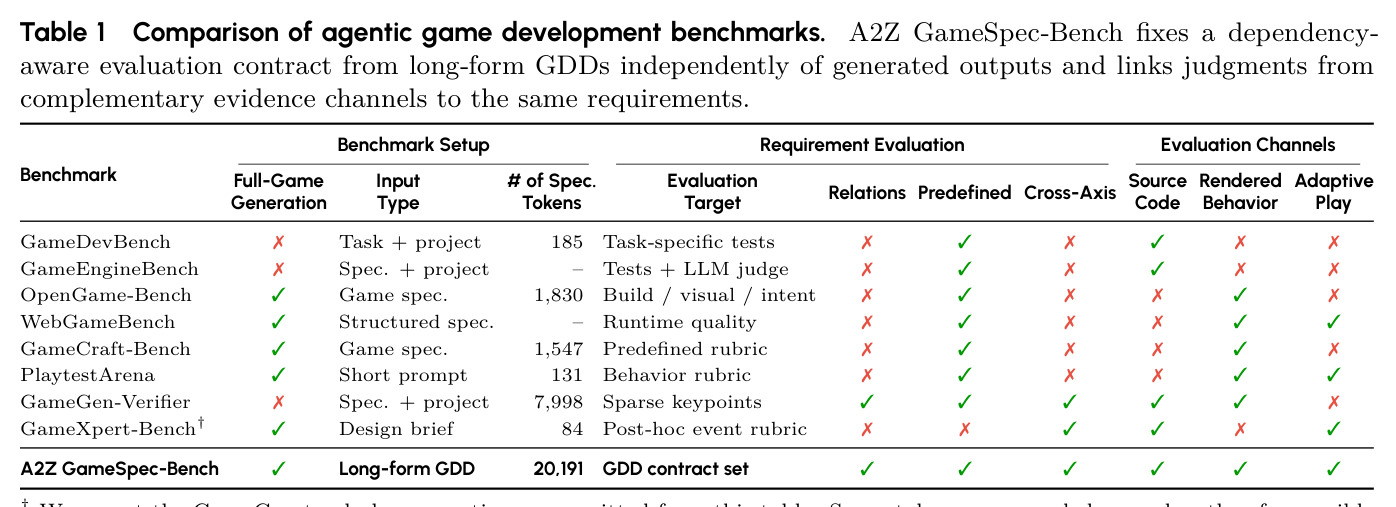
现有游戏开发基准的输入规格太“短”、证据太“单一”。表1统计各基准可公开规格的平均token数:PlaytestArena约131、GameDevBench约185、GameCraft-Bench约1,547、OpenGame-Bench约1,830,最长的GameGen-Verifier也仅约7,998——而真实工作室GDD动辄上万token,压缩规格掩盖了长程需求间的耦合。评测上,多数基准只沿单轴进行(源码检查、状态初始化测试或固定回放)。图2a给出反例:自研游戏Siege Deck 2D中“到30张牌须先移除一张再摸牌”的规则在源码轴拿满分,但试玩回放显示点击奖励时移除步骤被跳过——单轴漏检了状态联动缺失。更根本的是,游戏规格高度因果化:对353份外部文档共73,700句用CiRA分类器统计,工作室GDD因果句占37.9%、桌游规则书45.3%、游戏基准规格32.0%,宏平均38.4%,远高于一般需求文档的约28%,说明把需求当独立清单会系统性漏评依赖关系。
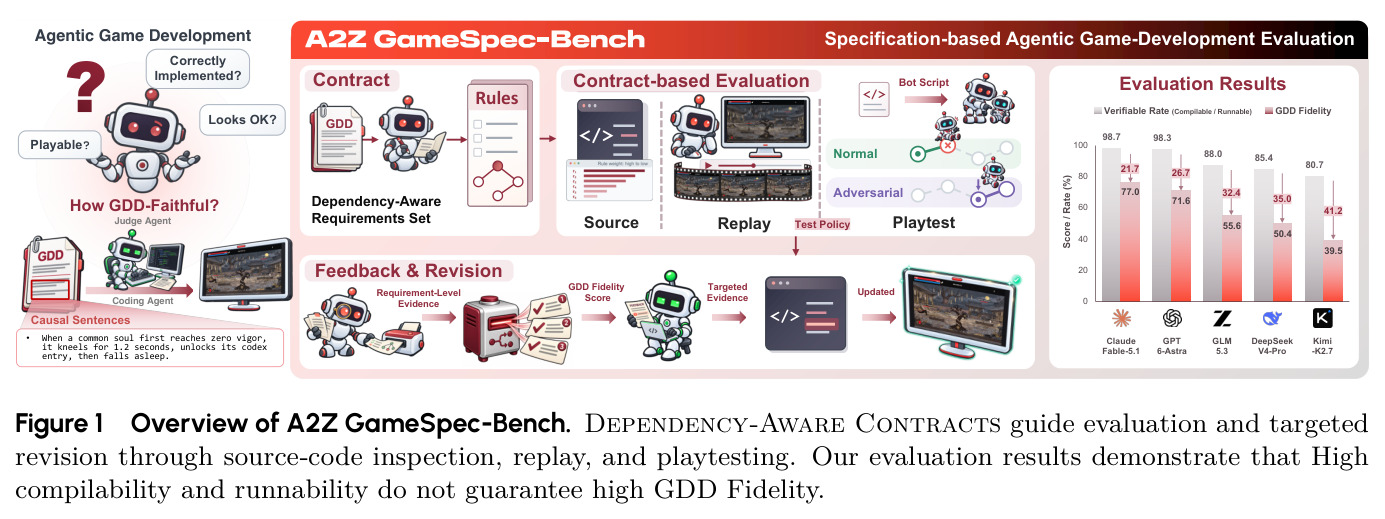
本文的目标是构建A2Z GameSpec-Bench:一套100份长篇GDD(50份Small平均14,085 token、50份Big平均26,297 token)的端到端评测,要求编码代理从GDD交付源码工程与可玩构建。每份GDD被转换为冻结的依赖感知契约(平均69条结果需求+32条不变式、20个回放场景),以“同一需求在源码、渲染、实际游玩三轴上的判决与证据”度量GDD Fidelity,使高编译可运行不再被误认为忠实实现;同时让需求级证据反哺修订,回答核心问题:编码代理实现设计规格的忠实度到底有多高、差距出在哪个轴。
与已有工作不同的是,本文的独特切入有四点。其一,契约在初始生成前构建并对构建代理隐藏,且跨代理、跨修订轮冻结——评测目标不随被测对象漂移(对比naive评审:同一构建五次运行仅35%条目能对齐、9%贯穿全部运行)。其二,需求不是独立清单而是依赖图:明确区分“给定前置下的局部测试”与“指定玩法路径的运行时证据”,这与DSG/ComplexBench等结构化契约工作不同,把前置关系落到可执行游戏的运行时行为上。其三,三轴判决与证据链接到同一需求条目,支持跨轴对比、失败定位与修订指引,而非各轴各评各的。其四,明确分离“验什么”(契约定义)与“怎么验”(Test Policy),使同一契约可迁移到不同引擎与3D环境。
核心方法
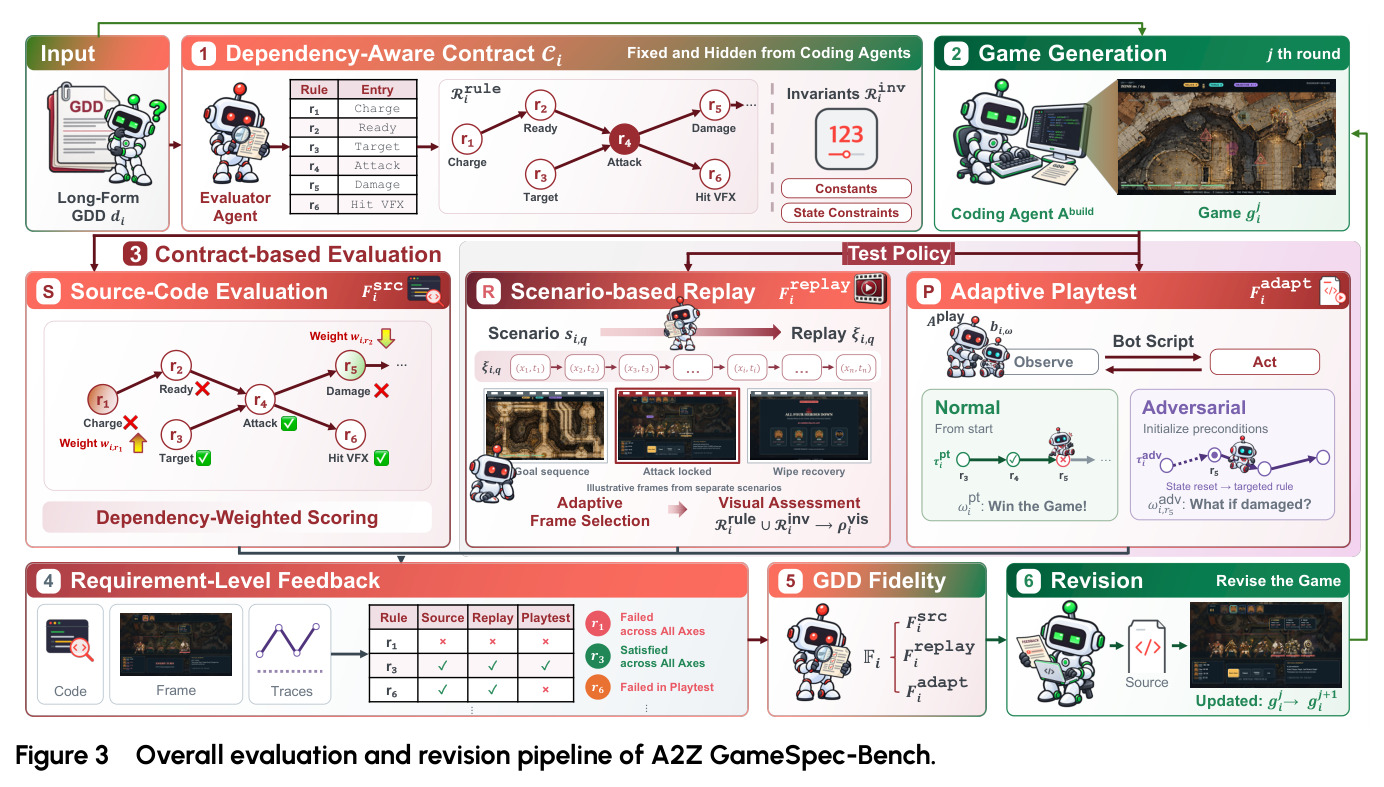
直觉上,审一份“游戏做得对不对”就像工作室QA流程:先读代码,再按剧本点一遍看画面,最后真的上手玩,还要故意制造极端局面。技术路线分五步。①GDD制备:brief定类型/前提/核心机制→creative vision写体验意图→harness生成GDD;harness本身用Meta-Harness式迭代搜索优化(13个CV、每轮3个候选、选用第8代),产物按G1结构完整/G2引用一致/G3行为可行(无死机制、难度不降)/G4公式可复算四准则由Validate-Agent全量校验,连续3轮无违例才收录为“Golden GDD”。②契约冻结:六阶段管线把GDD转为 $\mathcal{C}_i=(\mathcal{R}_i,\mathcal{E}_i)$。③三轴取证:源码静态检查(依赖加权)、场景回放(自适应取帧)、自适应试玩(普通+对抗),判决挂回同一需求。④汇总:$\mathbb{F}_i^j=(F^{src}+F^{replay}+F^{adapt})/3$,三轴等权。⑤反馈修订:需求级证据 $h_j$ 驱动 $g^{j+1}=A_{build}(d_i,g^j,h_j)$,再用同一契约复评。统一开发环境为Phaser 4.1+TypeScript+Vite的2D单机网页游戏,保证跨代理可控比较。
核心创新是“冻结的依赖感知契约 + 三轴同源证据”。与已有工作的本质区别在于评测目标的身份与稳定性:GameCraft-Bench用提交者自带轨迹加固定间隔抽帧的隐藏rubric;GameGen-Verifier从规格抽关键点并初始化状态做有界交互——但都不维护跨轴、跨轮次的统一需求身份。本文契约的依赖边从行级读/写事实($\mathrm{RW}\cap\mathrm{RR}\neq\emptyset$)确定性推导出骨架,模型只在骨架内补全条件-触发-效果,因此依赖可追溯、可复现(三次独立生成的可达性一致度、边Jaccard、角色保持均≥0.999)。源码评分按下游可达数加权 $w_{i,r}=\alpha+(1-\alpha)\frac{\log(1+D_{i,r})}{\log(1+D_i^{\max})}$(默认 $\alpha=0.5$),让“牵一发而动全身”的根规则更有分量;试玩区分普通可达验证与初始化前置的对抗验证,且未验证不等于违反。契约和回放场景集固定,而每个构建提交自己的回放输入策略,兼顾可控与可比。
方法步骤详情
①数据:brief→CV→GDD两级展开,Validate-Agent按G1-G4全量校验并修复(如两处波次数不一致、90秒boss计时器永不开火、ceil(50/4)写成12等),三连干净轮后收录;Small/Big各50份,结果需求均值54.2条(9–151)/84.0条(10–246),不变式共1,378/1,862条。②契约构建六阶段:词表固定(模型三次读数归并同义词)→代码抽取规则条目(保留ID与原文行,建立溯源映射 $\pi$)→行事实(写集RW/读集RR/触发RT/更新值VT,2/3投票)→代码拼依赖骨架→模型补全规则与不变式(×3独立)→程序化验收(同条目集+绑定完整+可达性一致≥0.9)后冻结第一代。③源码轴:静态评审员对每规则打锚定分并引用文件与行级证据,$F^{src}=F^{rule}\cdot F^{inv}$,其中 $F^{rule}$ 为依赖加权均值、$F^{inv}$ 为不变式通过率。④回放轴:契约导出共享入口条件的规范场景集 $\mathcal{S}_i$,构建代理为每场景提交固定输入策略 $\xi_{i,q}$,全量录制后评审员将rubric项映射到相关输入后的时间区间、确定性工具返回至多M帧,凭帧打分并沿用GameCraft-Bench的类别权重0.15/0.35/0.15/0.35。⑤试玩轴:生成bot后,普通试玩从默认态 $z_0$ 完成游戏得 $\tau^{pt}$;对抗试玩对未验证规则初始化 $z\models\varphi_r$ 后仅用玩家输入得 $\tau^{adv}_{i,r}$,每规则三次判决严格多数,$F^{adapt}=$ 确认满足数/规则总数。⑥汇总与修订:三轴等权得 $\mathbb{F}$,输出需求级“条件-证据-判决”作为 $h_j$ 驱动两轮修订并复评。
技术新颖性
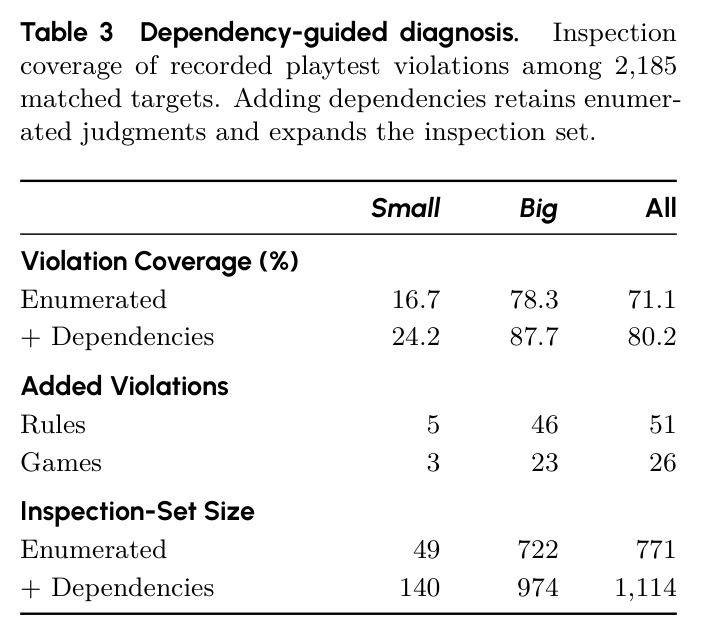
技术新颖性体现在四方面。其一,规格规模与可判性:平均20,191 token/份,约为此前最大规格的2.5倍,且通过G1-G4与DBT/RT/LED约定保证每条需求可检查、公式可复算,避免了“低分究竟该怪代理还是怪规格”的归因混乱。其二,依赖来源确定化:依赖边由读/写集合交集程序化拼出,而非模型自由列举,重复生成的边Jaccard≥0.999;相比之下naive评审同一构建五次仅35%条目可对齐(Jaccard≥0.5)、Big上中位匹配仅31%,冻结契约把评测目标漂移压到最低。其三,评测即测试工程:契约(验什么)与Test Policy(怎么验)解耦,回放的规范场景集跨构建固定,同一契约结构已成功迁移到Three.js 3D(附录H),证明引擎无关性设计。其四,把“集成失败”变成可定位对象:依赖上下文把已记录试玩违规的检查覆盖率从71.1%提升到80.2%(+9.1pt,95%CI 6.1–13.0),并给出如Grand Atelier 2D“提交处理器只放行合格收藏→规定的失败分支与-12声望惩罚缺失”这类行级诊断,而枚举式评审给这些规则打了满分。
实验结果
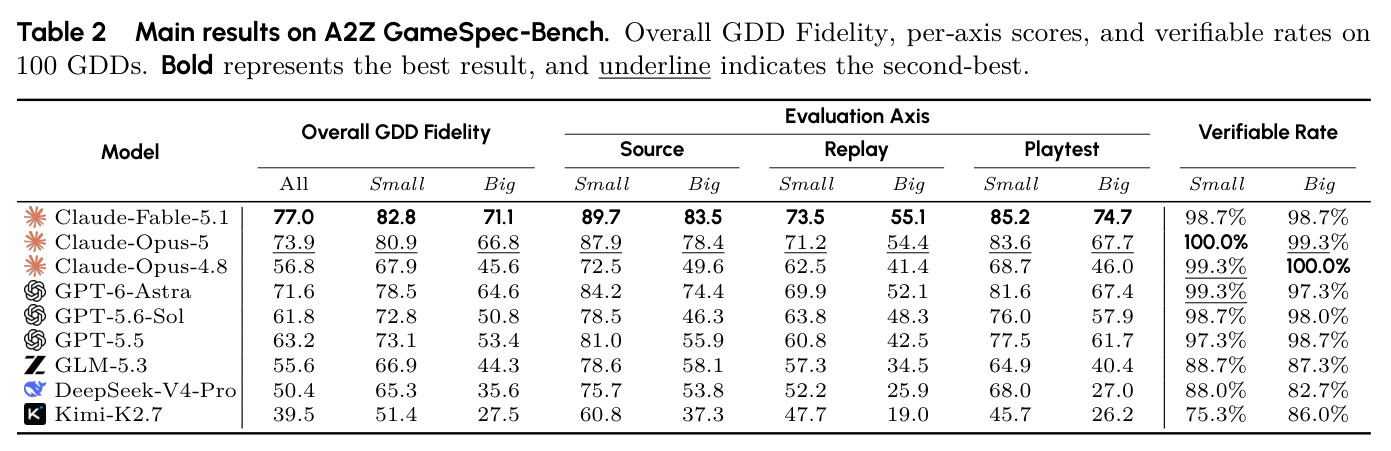
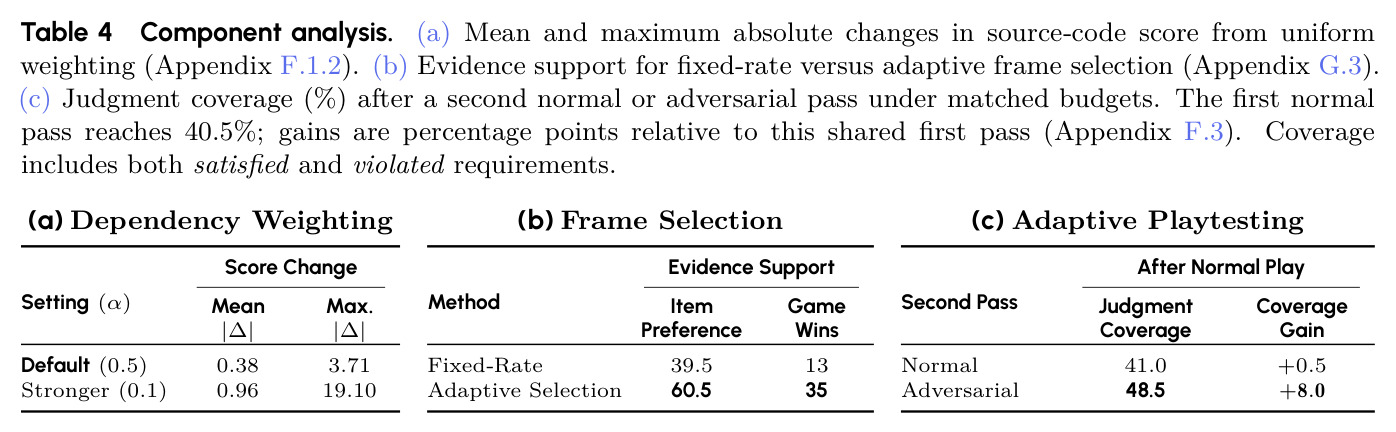
主结果(表2):Claude-Fable-5.1以77.0居首(Small 82.8/Big 71.1),Claude-Opus-5 73.9、GPT-6-Astra 71.6次之,Kimi-K2.7垫底39.5;九代理平均Small 71.1 vs Big 51.1,从Small到Big总分降20.0分,三轴分别降19.1/20.6/20.3,说明大规格的难度是全局性的而非某单轴问题。关键反差:Fable-5.1可验证率(编译+运行通过)高达98.7%但保真仅77.0——“能跑≠做对”。源码分相近的代理可被运行时轴区分开:GPT-5.5与GLM-5.3源码分68.5 vs 68.4几乎持平,运行时保真却差11.4分(60.6 vs 49.3);Big上GLM源码更高(58.1 vs 55.9)运行时反而低近15分。轴互补性(图4):源码满分规则仅76.8%被试玩确认满意,而源码0分规则有25.7%在试玩中满意;对100局GPT-5.6-Sol游戏分别去掉源码/回放/试玩轴会导致20.5%/8.9%/11.2%的局对排序翻转。依赖诊断(表3):局部通过率72.4%的依赖规则在要求所有上游也通过时仅剩22.7%(差49.7pt);2,185个匹配目标中违规检查覆盖率从71.1%提至80.2%。修订实验(图6,50 Big、GPT-5.6-Sol):三轴反馈两轮达74.3,超self-revision的67.0共7.3分(相对+10.9%)。组件分析(表4):依赖加权影响小(α=0.5时|Δ|均值0.38/最大3.71;α=0.1时0.96/19.10,排名不变);对抗二测覆盖+8.0pt(48.5% vs 41.0%);自适应选帧获60.5%项级偏好(50局35胜13负2平)。稳健性:任意非负轴权重下前三名次不变(36对中30对次序不变)。3D扩展(表S21):Sonic源码99.71但回放仅53.50,跨轴落差在3D依旧显著。
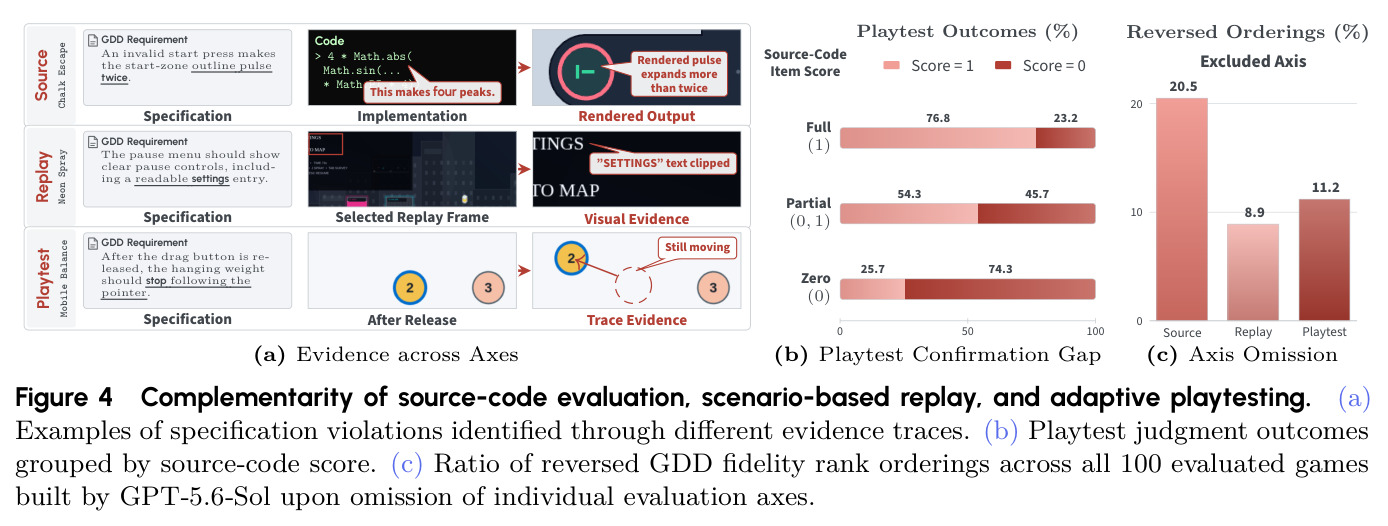
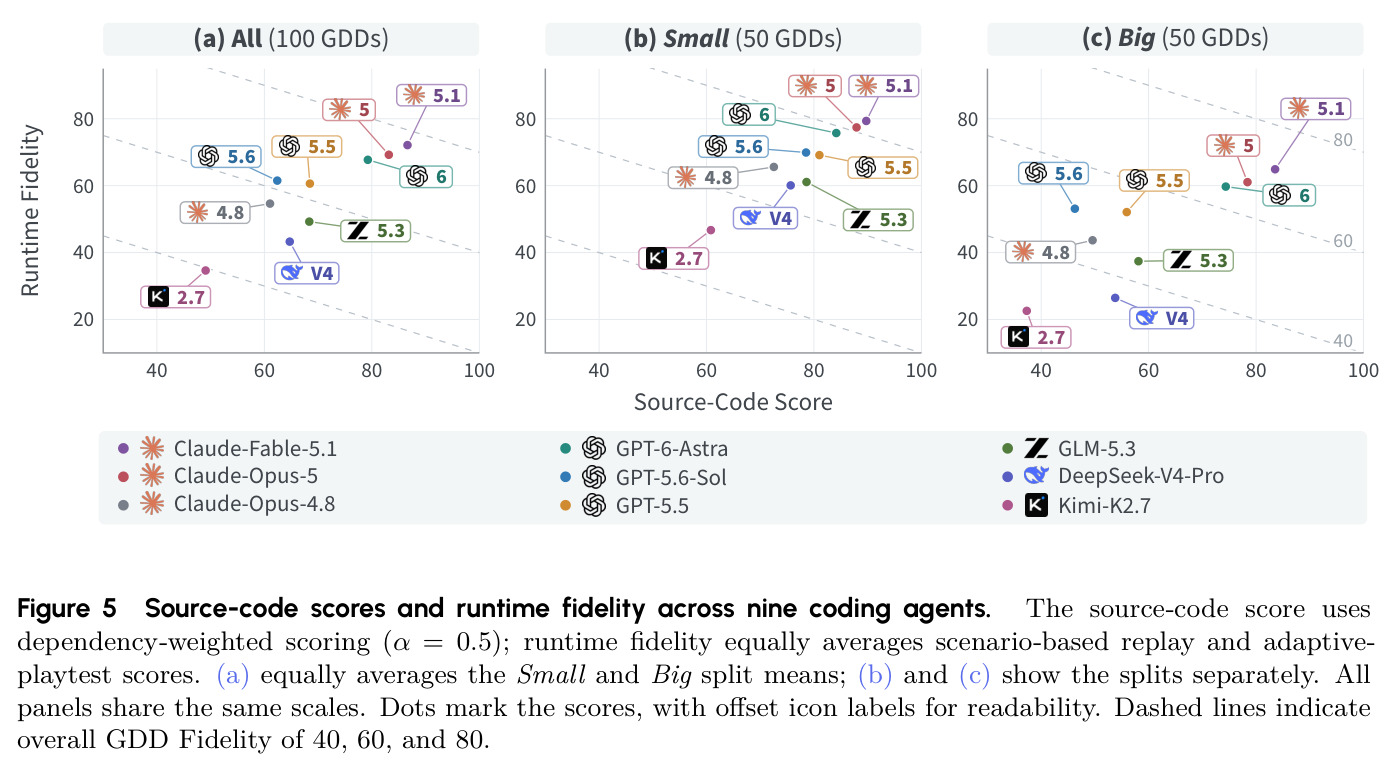
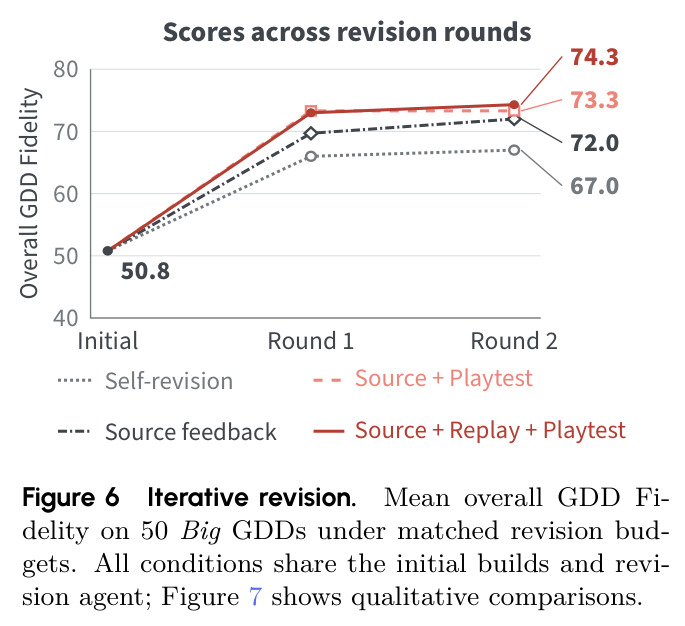
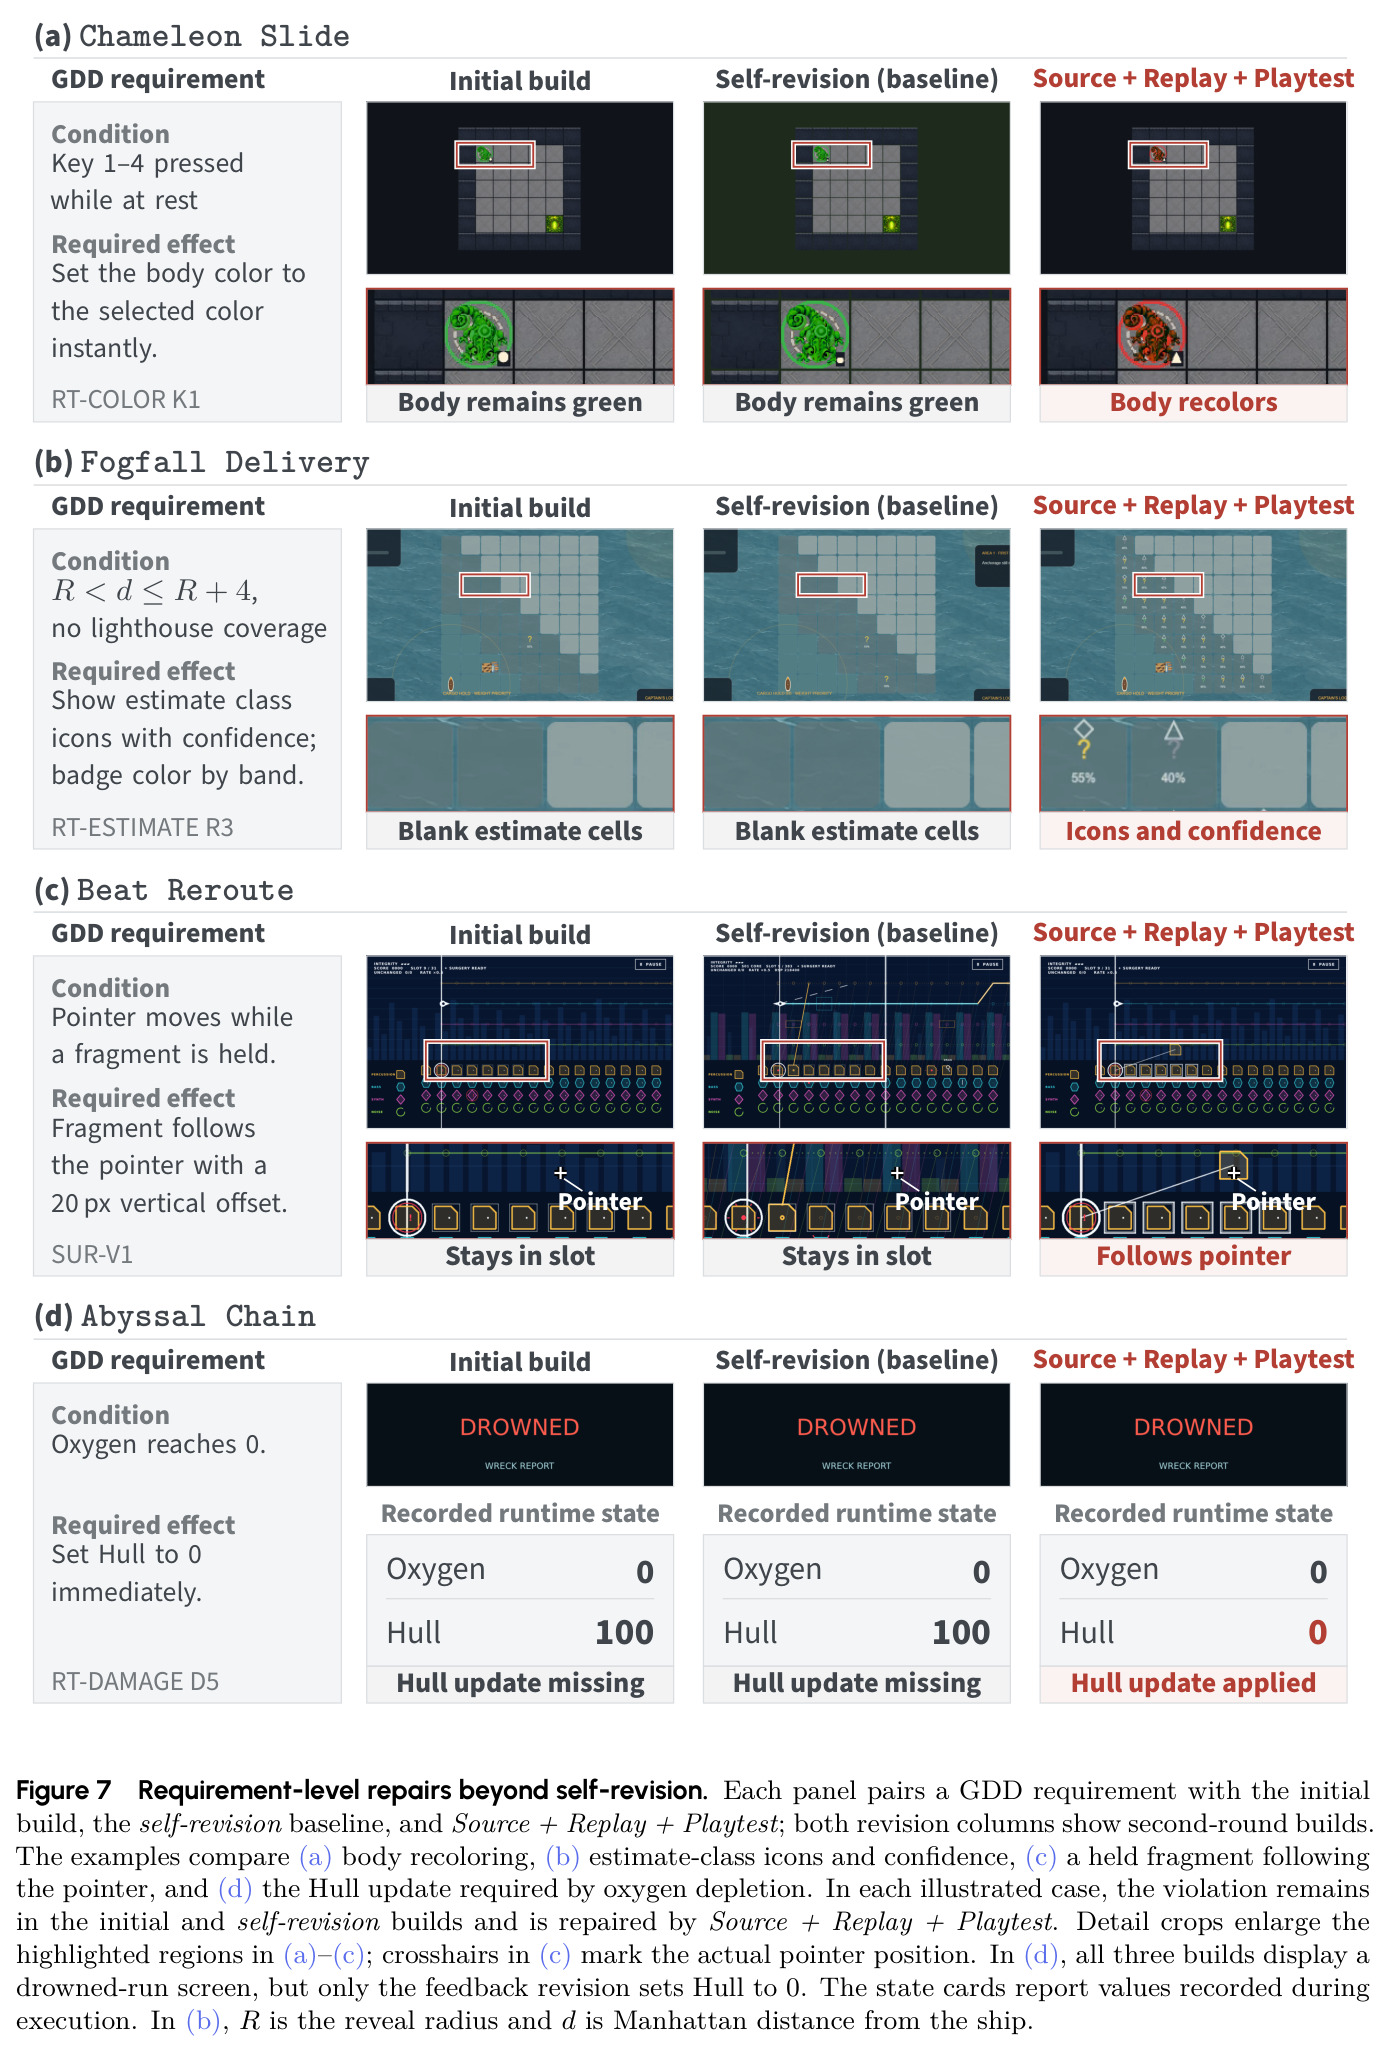
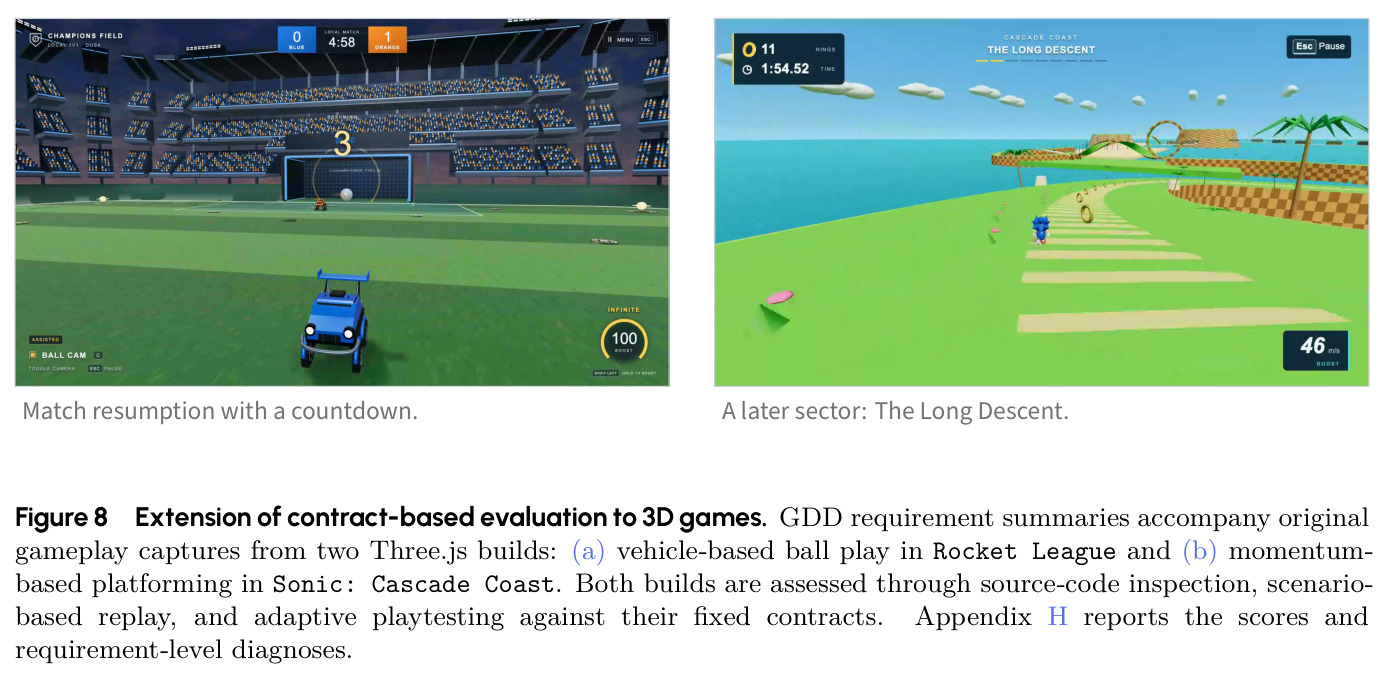
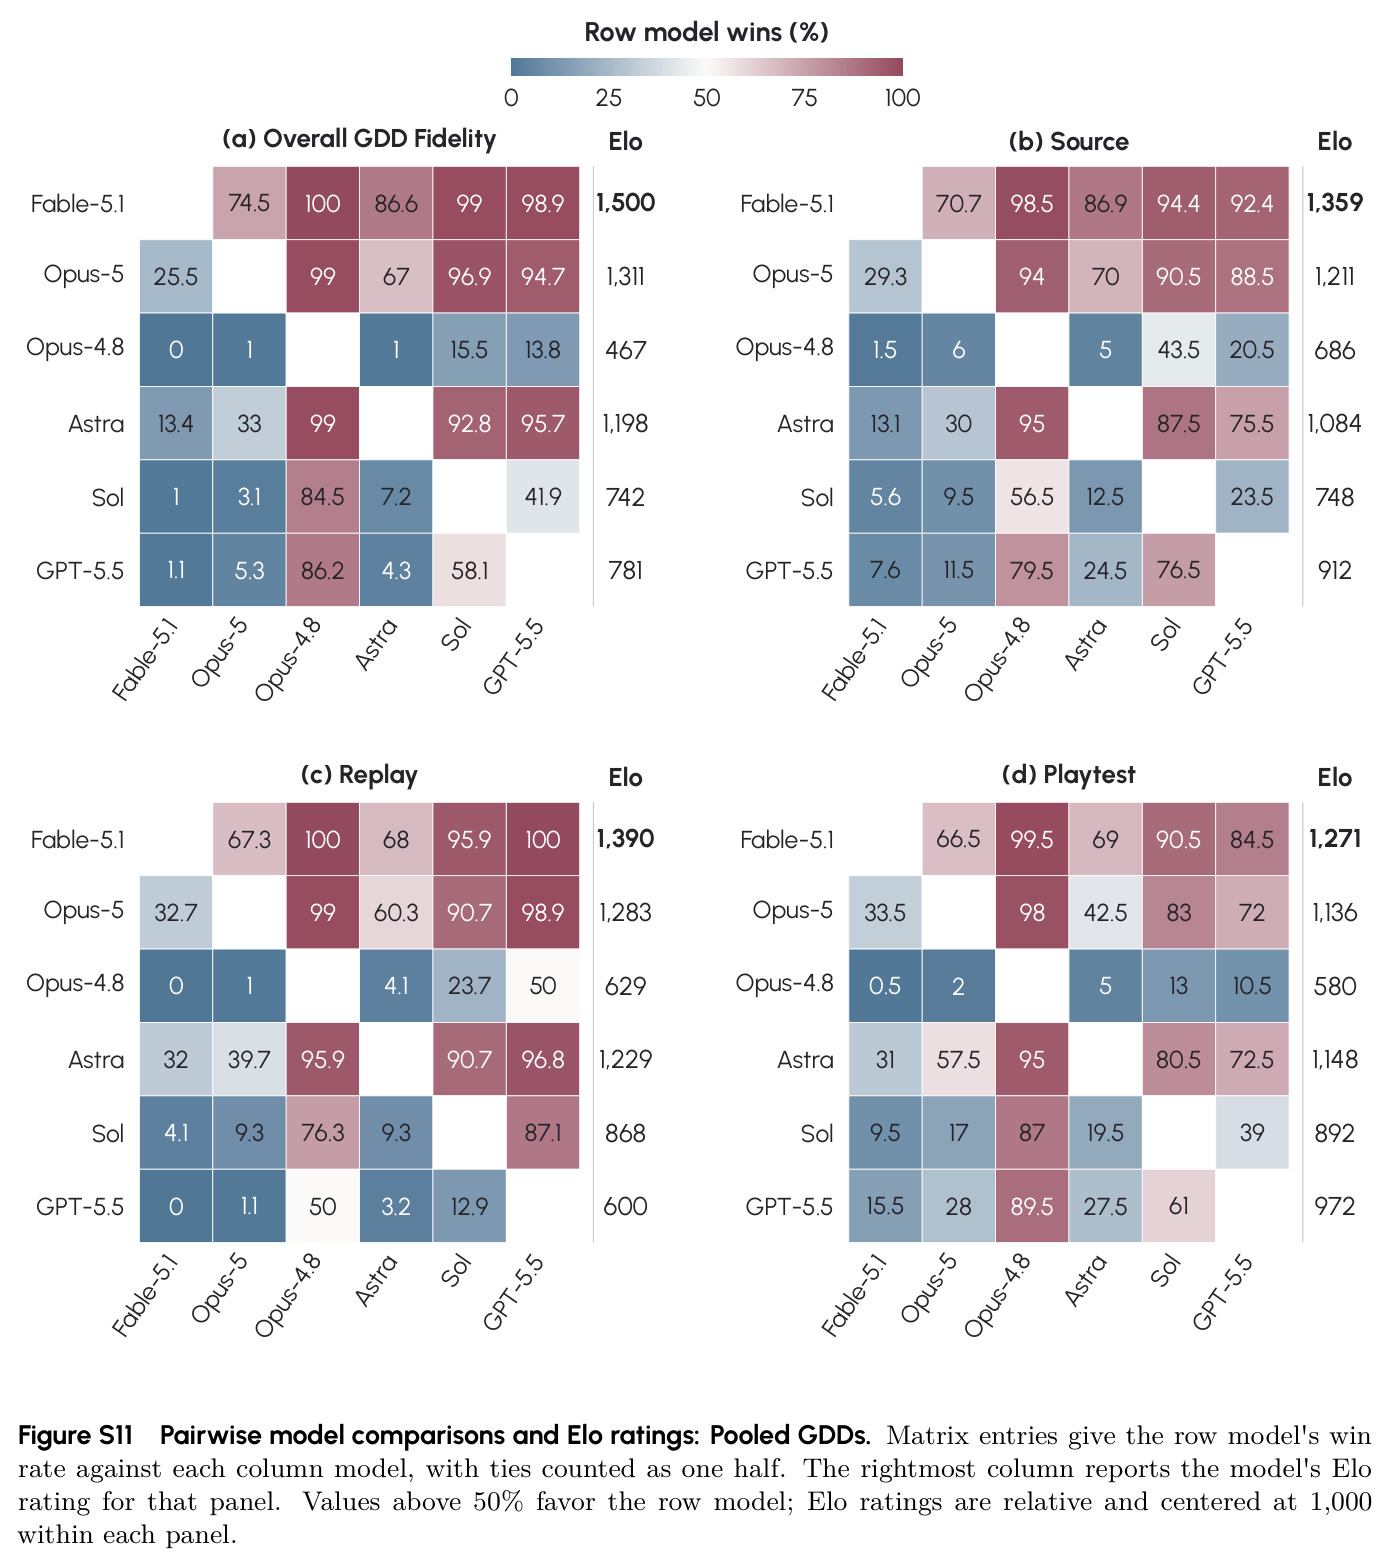
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 端到端游戏开发(100份GDD全体) | Overall GDD Fidelity(0–100) | Claude-Fable-5.1:77.0(第1名) | Claude-Opus-5:73.9(第2名);Kimi-K2.7最低39.5 | +3.1分领先第二名;相比最低分离37.5分 |
| 可运行性 vs 规格忠实度 | Verifiable Rate vs GDD Fidelity | Fable-5.1:可验证率98.7% / 保真77.0 | 同模型自身:编译与运行几乎全通过 | 暴露21.7分落差,证明高可编译可运行不等于高忠实度 |
| Big GDD 子集(50份,平均26,297 token) | Overall GDD Fidelity | Fable-5.1:71.1 | 九代理Big均值51.1(Small均值71.1) | Big比Small平均降20.0分,三轴分别降19.1/20.6/20.3 |
| 迭代修订(50 Big GDD,GPT-5.6-Sol,两轮等预算) | 两轮后 Overall GDD Fidelity | Source+Replay+Playtest 三轴反馈:74.3 | Self-revision(仅看GDD+源码):67.0 | +7.3分(相对提升10.9%) |
| 依赖引导的集成失败诊断(100局GPT-5.6-Sol初始构建) | 已记录试玩违规的检查覆盖率 | 加入依赖上下文:80.2%(449/560) | 枚举式逐条检查:71.1%(398/560) | +9.1个百分点(95% bootstrap CI 6.1–13.0) |
| 对抗式试玩 vs 重复普通试玩(86条依赖规则,等预算) | 判决覆盖率(满意+违反/全部规则) | 首测40.5%后加对抗二测:48.5% | 第二遍普通试玩:41.0% | +8.0个百分点(普通二测仅+0.5) |
| 回放帧选择(50 Small游戏,244条回放,4,102配对项) | 审计偏好(帧证据对判据支撑度) | 自适应选帧:60.5%项级偏好,35局胜 | 固定间隔采样:39.5%,13局胜(2平) | +21个百分点项级偏好 |
| 依赖调整通过率(100局GPT-5.6-Sol) | 源码规则通过率(依赖链规则) | 局部判据:72.4% | 要求全部上游规则也通过:22.7% | 49.7分落差,量化“局部通过掩盖前置失败” |
局限与改进
作者承认(附录J):基准仅覆盖100份合成GDD、2D单机Phaser环境,对人类撰写的规格、其他引擎与更广软件任务的普适性尚未建立;Three.js上的三个3D游戏只证明可行,不证明跨引擎/跨品类性能;契约构建与证据解释均依赖生成模型,冻结契约与重复判决也无法完全消除遗漏与评审偏差。我的补充观察:①评审模型相关性有限——默认Luna-high对Sol参照的源码规则级Pearson仅0.72、回放项级0.85,且参照系本身是另一个LLM,全文缺少人测校准锚点;②状态依赖边只做属性级匹配、不校验写入值与读取条件是否兼容(附录B.6),是“潜在前置”而非保证的阻断关系,可能高估依赖调整通过率的下降幅度;③回放的输入策略由被测的构建代理自己提交,场景集虽由契约固定,理论上仍存在“避开易败场景”的博弈空间;④修订实验只在50 Big GDD、单一GPT-5.6-Sol上进行,反馈增益能否跨模型外推未验证;⑤三轴等权与α=0.5虽做了完整的敏感性分析,但仍是约定而非从下游效用推导出的选择。
独立分析的弱点
①对闭源评审模型的深度依赖:默认评估链是GPT-5.6-Luna(high),换评审即引入-0.005到+0.081的均分漂移(表S11),长期可用性与可复现性受制于API政策。改进方向:在人工标注子集上校准并开源评审器,或训练专用评审模型。②合成GDD语言风格均质(同一harness产出、同一套模板约定),代理可能过拟合其行文模式而非学会阅读真实策划文档。改进:引入人类工作室GDD(哪怕是10份)做分层报告,检验分数迁移。③试玩质量依赖bot作者模型:Sol与Luna两种作者的覆盖率相差0.15–0.17,与同模型重跑的0.11–0.16部分重叠,说明“评估质量本身是个变量”。改进:多bot集成投票,或训练专门的playtest策略模型并报告bot间方差。④评测成本结构偏斜:回放+试玩占约900墙钟小时的96.9%(40.1%+56.8%),不利于快速迭代与大规模RL训练。改进:分层触发式评测——先用便宜的源码轴筛掉明显不合格构建,再对候选触发运行时轴。⑤依赖加权对总分的影响微乎其微(α=0.5时均值仅0.38分),其象征意义大于度量意义。改进:把依赖主要用于诊断与反馈端(那里已证明+9.1pt违规覆盖收益),而非计入分数。⑥3次构建/游戏、无best-of-k的设定虽然控制了方差口径,但可能低估强代理的上界。改进:补充pass@k与预算-性能曲线。
未来方向
作者明确提出的方向:推广到人类撰写的GDD、更多引擎与更广的软件任务;3D(Three.js)已验证契约与三轴的可迁移性。基于本文成果可延伸的方向:①把契约评分改造成强化学习奖励——本文已证明需求级反馈带来+10.9%相对提升,需求级“条件-证据-判决”正是天然的过程奖励信号,可效仿WebGrader用grader做RL的思路训练“规格忠实”的编码代理;②多智能体工作室工作流:策划-程序-QA角色分工,契约作为QA交接物与验收标准,研究角色间沟通对保真度的影响;③按依赖图的规模、深度、分支因子构造难度课程(curriculum),系统研究保真度随依赖复杂度的标度律;④对抗鲁棒性:研究代理针对固定场景集的“应试”行为,设计held-out需求与动态场景采样;⑤跨引擎契约编译器:把同一契约同时编译到Phaser/Unity/Godot的观察-输入接口,真正检验引擎无关性;⑥人因校准:邀请真人策划评估需求级反馈的可用性,量化LLM判决与专家判断的系统性差异。
复现评估
开源情况:代码与数据集发布在 https://a2z-gamespec-bench.github.io,100份GDD及契约构建协议(G1-G4准则、六阶段管线、三轴prompt节选、判决聚合规则)在正文与附录中完整公开。数据与算力:被测开源模型(DeepSeek-V4-Pro、GLM-5.3、Kimi-K2.7)用vLLM 0.28.0、每个分配4块NVIDIA B300,总计约1,100 GPU时;评测在10台AWS m7i.4xlarge + Playwright/Chromium 149上进行,约900墙钟小时(源码3.1%、回放40.1%、试玩56.8%)。成本参考:回放评审用Luna-high每游戏约$0.3–0.5(比Sol-xhigh参考省6.7倍)、试玩每游戏$0.08–0.11。难度评估:中高。主要门槛不在算力而在评审链——闭源前沿模型(GPT-5.6-Luna/Sol、Claude系)同时承担构建与评估,且GDD的harness搜索(Claude-Opus-4.8提案、GPT-5.5评分、20代上限选第8代)成本未披露;但管线中词表冻结、骨架拼接、验收、帧检索等均为确定性代码阶段,×3重复判决协议明确,工程能力强的团队有望在数周内重建核心评测管线,代价是需要可观的API预算。
论文图表
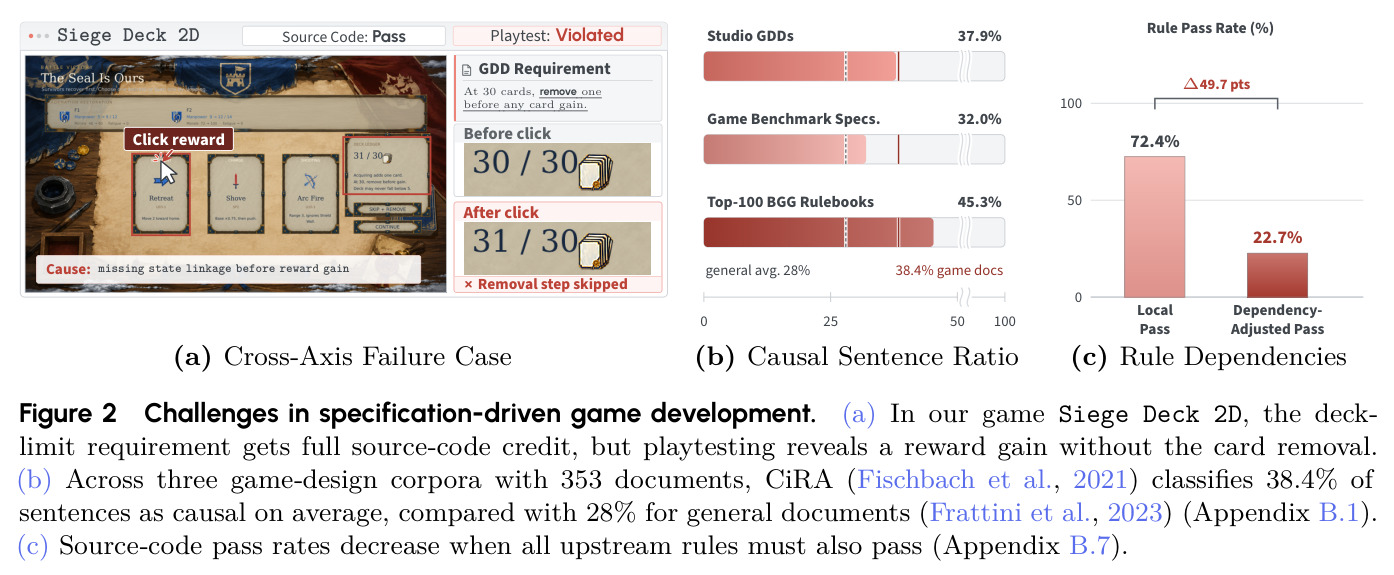
三个动机证据。(a) 自研游戏Siege Deck 2D的跨轴失败:牌库上限规则在源码轴拿满分,但试玩回放暴露“点击奖励时未先移除一张牌”的状态联动缺失(局部通过72.4% vs 依赖调整后22.7%,差49.7分)。(b) 用CiRA分类器统计353份外部文档(工作室GDD 37.9%、游戏基准规格32.0%、桌游规则书45.3%),因果句宏平均38.4%,远高于一般文档的约28%。(c) 依赖调整的源码规则通过率大幅下降的汇总。
为“为什么需要依赖感知契约+多轴评测”提供最直接的实证动机,其中跨轴失败案例是全文反复引用的典型反例。