ReSAIL:缓解迭代式智能体自蒸馏中的性能坍塌 ReSAIL: Mitigating Collapse in Iterative Agent Self-Distillation
用PI敏感步骤选择与特权行为保持,阻止多轮自蒸馏部署中的性能坍塌
前置知识
自蒸馏(Self-Distillation)
让模型自己充当教师来训练自己的蒸馏方式。本文中同一个模型有两个共享参数的视图:不带特权信息的普通视图 $\pi(\cdot|h)$ 和带特权信息的特权视图 $\pi(\cdot|h,c)$。训练时冻结一份教师副本,用特权视图的输出分布去监督普通视图的学生,把模型“借助额外信息时的行为”内化进参数,部署时不再需要这些信息。
ReSAIL 完全建立在 PI 自蒸馏框架(SDPO/OEL)之上,是二者的即插增强模块;不理解共享参数的双视图师生结构,就无法理解其选择与保留两个模块各自保护什么。
特权信息(Privileged Information, PI)
仅在训练时提供给教师、部署时不给策略的辅助上下文,例如从完整轨迹提取的经验总结、参考解答或事后反馈。教师“开卷”作答优于学生“闭卷”作答,自蒸馏就是把这种开卷能力转移到闭卷策略中。本文文本任务的 PI 是由冻结起始策略从轨迹生成的结构化经验摘要。
PI 敏感性(用 JSD 度量的 PI 对教师预测的改变程度)是本文选择蒸馏步骤的核心依据;特权保留(PR)保护的正是模型的 PI 条件行为,两个模块都围绕 PI 展开。
KL 散度与 Jensen–Shannon 散度
KL 散度 $D_{KL}(P\|Q)$ 衡量用 $Q$ 近似 $P$ 时的信息损失,非对称且无界;JSD 是其对称化版本 $\mathrm{JSD}(P,Q)=\tfrac{1}{2}D_{KL}(P\|M)+\tfrac{1}{2}D_{KL}(Q\|M)$,其中 $M=(P+Q)/2$,对称有界。本文的蒸馏与保留损失都用逐 token 的 KL 实现,PI 敏感性则定义为同一教师两个视图之间的平均 JSD。
公式 (1)(6) 的损失和公式 (3) 的敏感性打分全部基于这两个散度,是读懂方法章节的数学基础。
迭代自蒸馏与 OEL
OEL(Online Experiential Learning)把经验自蒸馏扩展为多轮循环:部署收集轨迹 → 从轨迹提取经验作为 PI → 离线自蒸馏进参数 → 更新后的模型作为下一轮起始策略。理想情况下性能递归提升(RSI),但已有工作与本文实验都表明该循环会逐轮退化甚至坍塌。
本文研究的问题正是这个循环中的坍塌,实验协议(3 轮部署周期、每轮 30 次更新、每轮用新轨迹)也沿用 OEL 设定。
ALFWorld / TextCraft / AITZ 基准
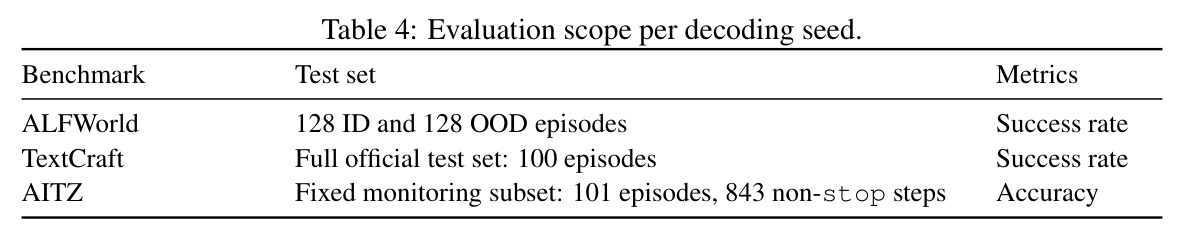
三个评测环境:ALFWorld 是文本化具身家务任务(128 个同分布 ID + 128 个分布外 OOD 任务,30 步交互上限);TextCraft 是文本版 Minecraft 组合合成(官方 100 个任务);AITZ 是安卓 GUI 导航离线数据集(101 集、843 个非停止步的固定监测子集,按官方规则计算动作精确匹配准确率)。
前两者上的多轮成功率是论文核心证据(Table 1),AITZ 用于验证敏感性选择可泛化为多模态离线数据过滤器。
选择比 ρ 与保留权重 λ
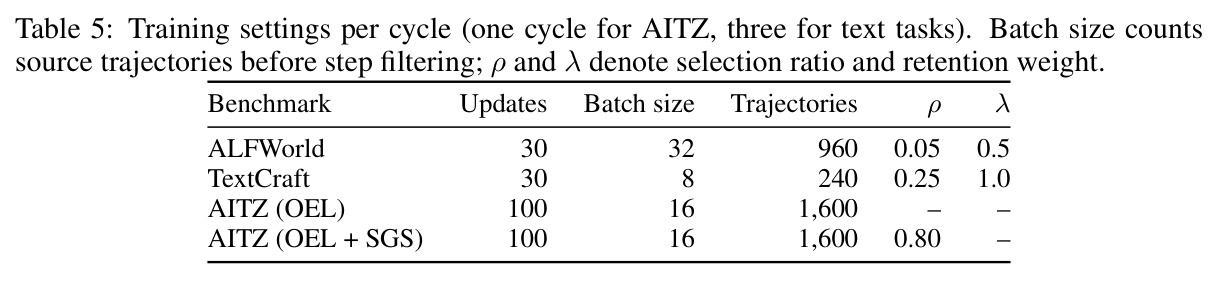
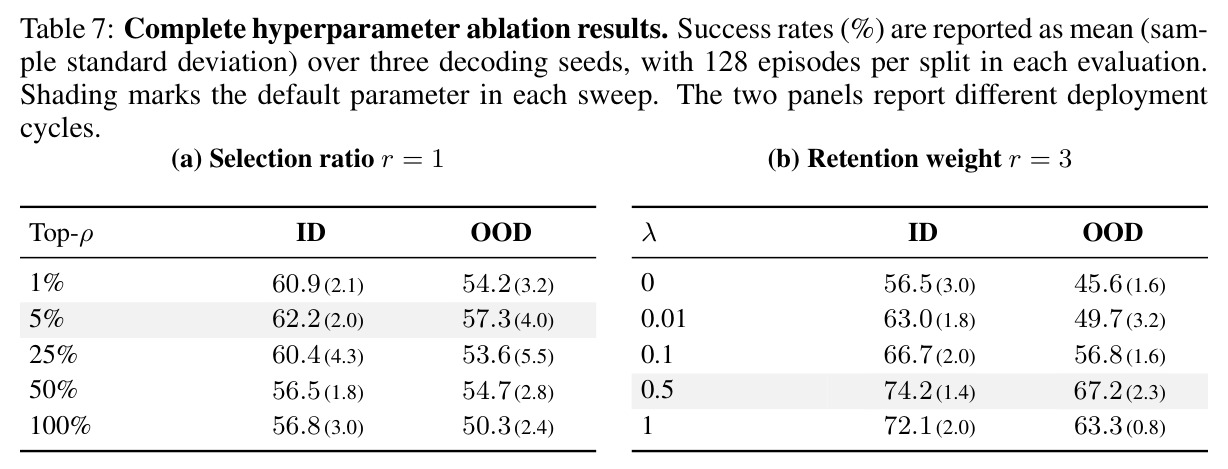
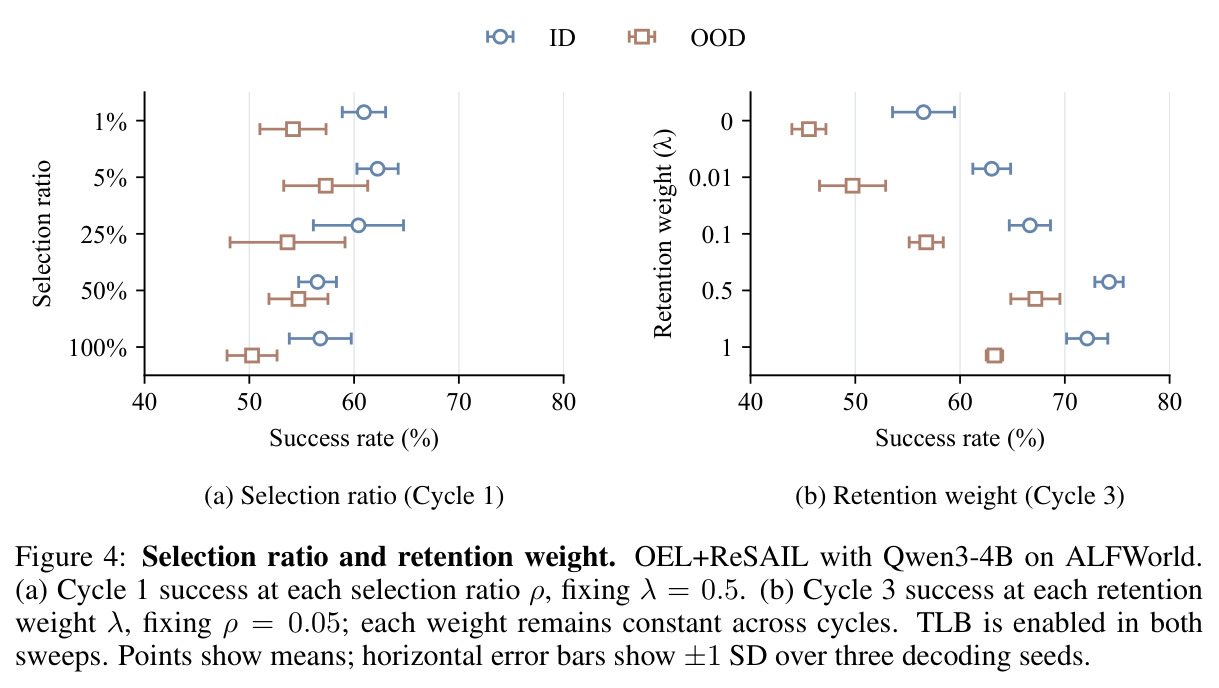
ReSAIL 的两个关键超参:$\rho$ 控制每个批次中按教师 PI 敏感性选出参与蒸馏的步骤比例($K_\rho=\lceil\rho|U|\rceil$,ALFWorld 默认 0.05,即只蒸馏最敏感的 5% 步骤);$\lambda$ 控制特权保留损失强度,总损失为 $\mathcal{L}=\mathcal{L}_{sel}+\lambda\mathcal{L}_{ret}$(默认 0.5)。
超参扫描(Figure 4/Table 7)显示 ρ=0.05 优于全量蒸馏、λ=0.5 优于 0 和 1,是复现与调参的核心。
研究动机
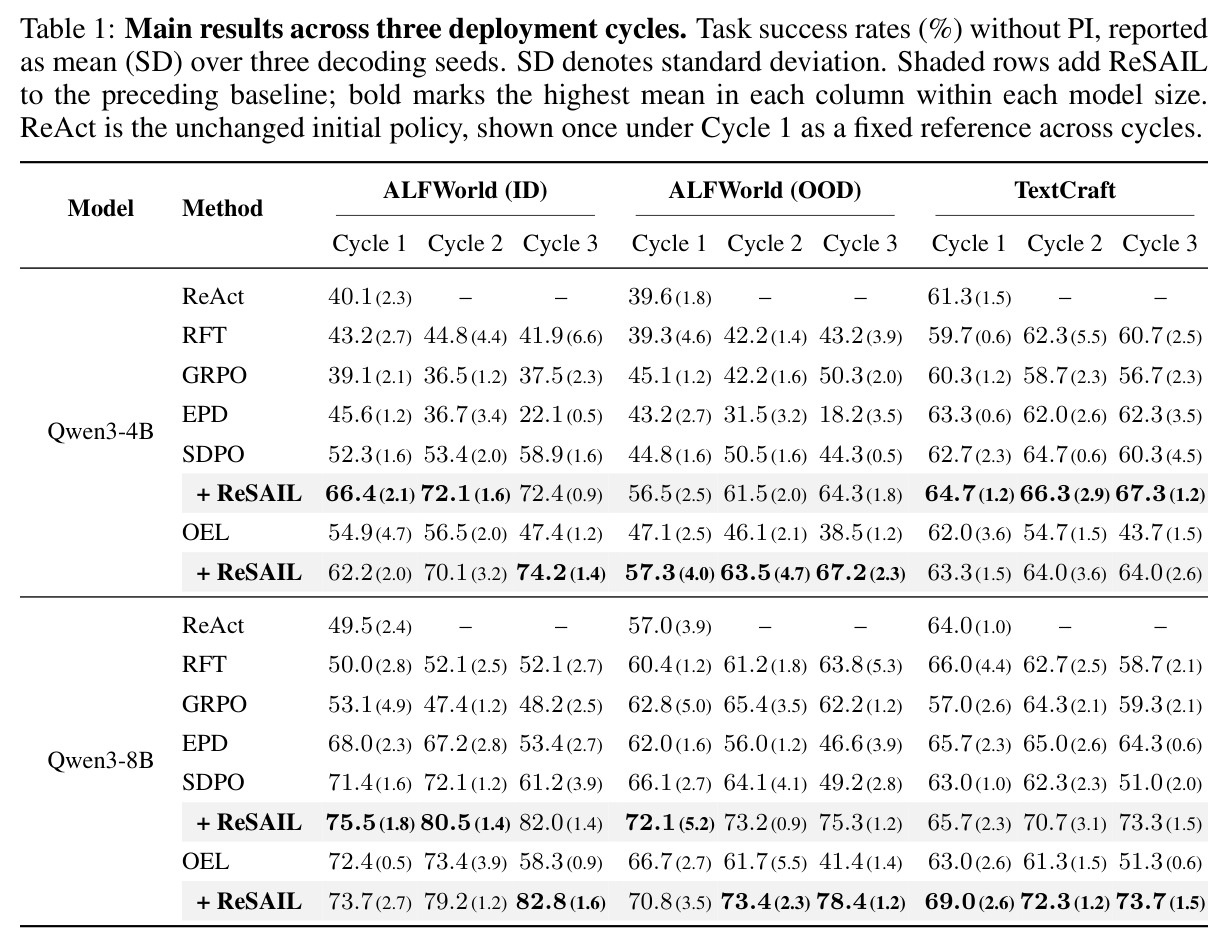
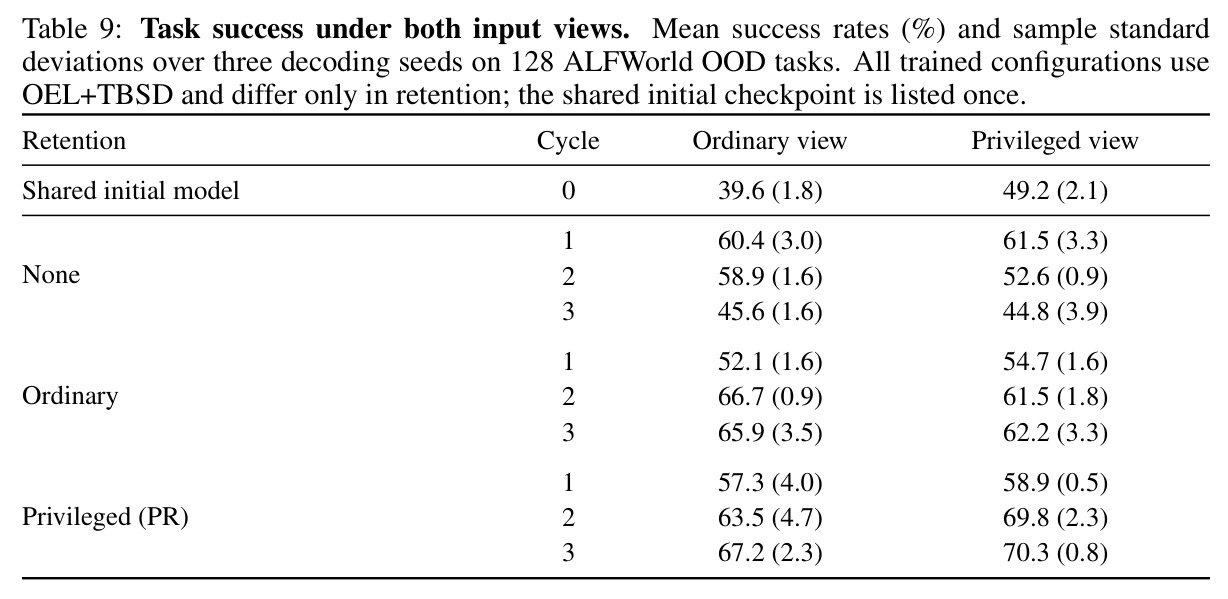
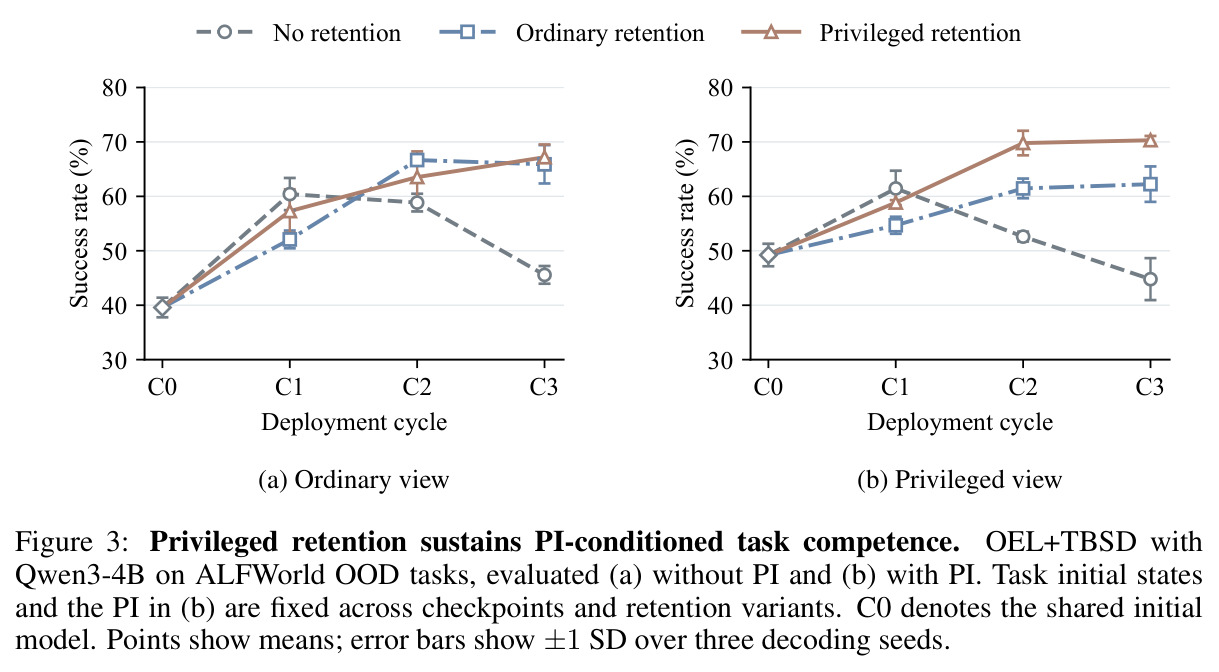
迭代自蒸馏让 LLM 智能体从一次次部署中学习,被视为通向递归自我改进(RSI)的路径,但作者用 SDPO 和 OEL 进行的实验显示这条路并不稳定:性能随部署周期逐轮坍塌。在 ALFWorld OOD(Qwen3-4B)上,OEL 成功率从第 1 轮的 47.1% 跌到第 3 轮的 38.5%;Qwen3-8B 上从 66.7% 崩到 41.4%;TextCraft 上从 62.0% 崩到 43.7%。EPD 坍塌最剧烈,ALFWorld OOD 上从 43.2% 跌至 18.2%。更关键的第二个隐患是:模型在“带特权信息(PI)”条件下的能力也在退化——固定任务与 PI 后,无保留配置的 PI 条件成功率从第 1 轮的 61.5% 降到第 3 轮的 44.8%。这意味着更新后的学生作为下一轮教师时,其提供的监督质量在持续下降,形成“越教越差”的恶性循环。已有的补救方案(Chen et al., 2026a)需要用 PI 条件教师额外与环境交互生成离线轨迹,在环境无法重复访问的设定下不可行。
本文的目标是本文的目标是在“只能使用已收集的部署轨迹、训练时不再与环境交互”这一更受限但更实用的设定下,让迭代自蒸馏在多个部署周期中持续增益而非坍塌。具体拆解为两个子问题:其一(Q1),蒸馏监督并非每一步都同等有用,应该优先蒸馏哪些交互步骤?作者假设 PI 对教师预测改变最大的步骤,携带最多关于“如何利用 PI”的监督信息;其二(Q2),当学生升级为下一轮教师时,它的 PI 条件行为(即下一轮监督的来源)没有被基线目标保护,需要被显式保留。最终交付物是一个可直接插到 SDPO/OEL 上的增强模块,要求在不同模型规模(Qwen3-4B/8B)和多个基准上,使三轮部署后的成功率既显著高于基线,又不得低于自身第一轮水平。
与已有工作不同的是,本文的独特之处在于把“迭代自蒸馏为何退化”拆解为监督选择与监督者退化这两个正交问题,并给出纯离线、零额外环境交互的解法。与已有缓解手段相比:Chen et al. (2026a) 发现重复内化会退化后,转向用 PI 条件教师生成的成功轨迹做 off-policy 上下文蒸馏,但收集这些教师轨迹需要额外的环境交互;ReSAIL 则只在已收集的部署轨迹上做文章,用“同一教师两个视图之间的 JSD”这个无需任何额外采样的统计量挑选信息量最大的步骤(SGS),用轨迹级损失均衡(TLB)防止长轨迹主导梯度,再用特权保留(PR)把学生的 PI 视图锚定在冻结教师上。这是首个证明“更鲁棒的学习机制本身就能有效缓解迭代自蒸馏性能坍塌”的工作,不依赖更多数据、更强教师或重新访问环境。
核心方法
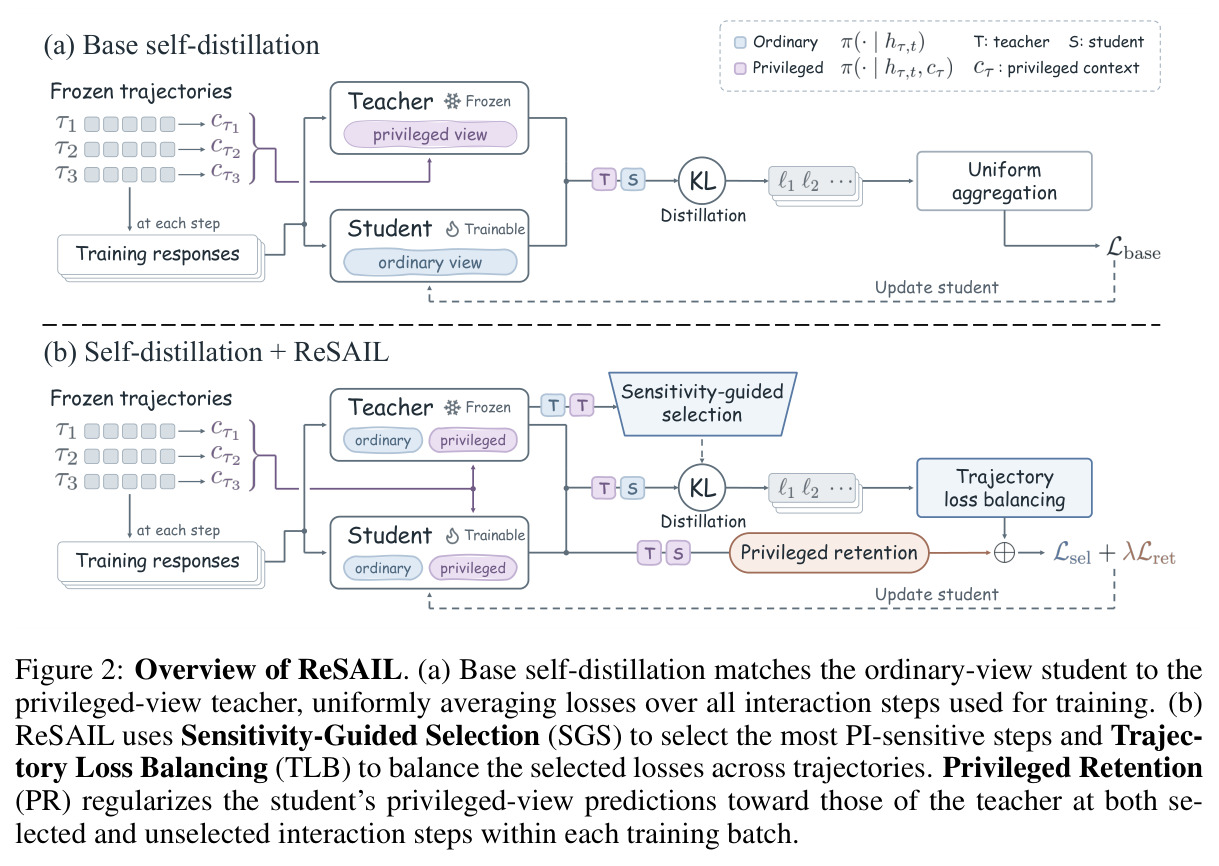
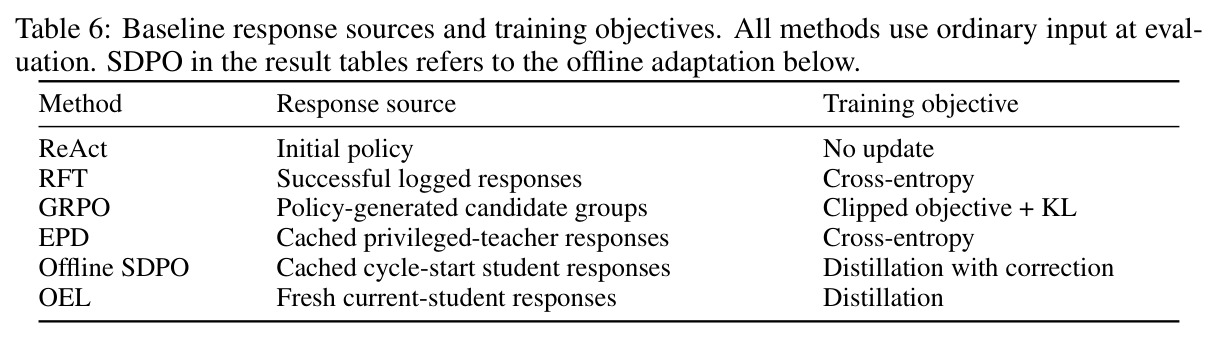
直觉上,基线自蒸馏有一个低效点和一个隐患:低效在于把所有交互步骤一视同仁地均匀平均,而 PI 对教师预测的帮助集中在少数关键步骤(分叉点、易错点),大量低信息步骤稀释了有效梯度;隐患在于蒸馏只在普通视图上拉齐师生,完全不管学生自己的 PI 视图,但两者共享参数,训练普通视图会顺带侵蚀 PI 视图,等这个学生变成下一轮教师时,它的“开卷能力”已经受损。ReSAIL 的技术路线由两个模块构成:(1) 轨迹均衡的选择性蒸馏 TBSD——先用冻结教师的 PI 敏感性给每步打分,按比例 $\rho$ 选出最高的 $K_\rho=\lceil\rho|U|\rceil$ 个步骤,只在这些步骤上计算蒸馏 KL,并在轨迹内取均值、跨轨迹按 $1/|B|$ 加权(TLB);(2) 特权保留 PR——在全部候选步骤 $U$ 上把学生的特权视图分布拉向冻结教师的特权视图。总损失 $\mathcal{L}=\mathcal{L}_{sel}+\lambda\mathcal{L}_{ret}$,作为插件叠加在 SDPO/OEL 上,不改变其响应来源与 KL 方向。
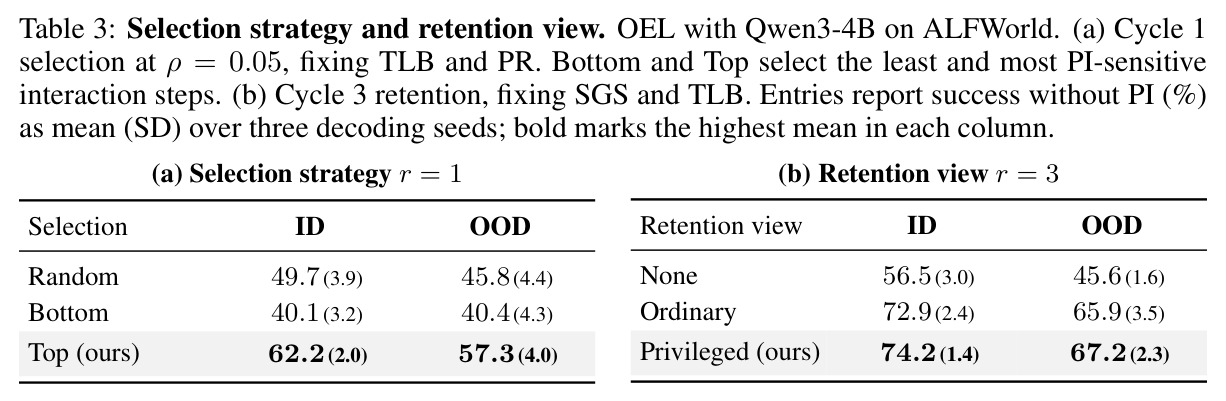
核心创新有两点。第一,用 PI 敏感性作为蒸馏信号的选择器:对同一冻结教师、同一段响应前缀 $z_{<k}$,计算 $s_\pi(h,c;z)=\frac{1}{|z|}\sum_{k=1}^{|z|}\mathrm{JSD}\big(\pi(\cdot|h,z_{<k}),\,\pi(\cdot|h,c,z_{<k})\big)$。由于两个视图共享参数和前缀,JSD 恰好度量“PI 本身改变了多少预测”,不需要奖励、参考答案或额外环境采样。这与基线有本质区别:基线对所有步骤均匀蒸馏;对照实验(Table 3a)显示同等稀疏度下 Random 选择比 Top 低 12.5/11.5 个百分点,Bottom 甚至比 Random 更差,证明增益来自“选对步骤”而非“选少一点”。第二,特权保留把“模型利用 PI 的能力”当作需要跨周期保护的资产:参数共享意味着普通视图蒸馏必然干扰 PI 条件行为,PR 用 $\ell_{ret}=\frac{1}{|z|}\sum_k D_{KL}\big(\pi_S(\cdot|h,c,z_{<k})\,\|\,\pi_T(\cdot|h,c,z_{<k})\big)$ 在全部步骤上显式锚定它,保障下一周期的教师质量。
方法步骤详情
一个完整内化周期(Algorithm 1)如下。输入:本轮轨迹集 $D_r$、起始策略 $\pi_r$、选择比 $\rho$、保留权重 $\lambda$、更新次数 $M$。第一步,用 $\pi_r$ 初始化学生 $\pi_S$ 并冻结一份教师 $\pi_T$,为每条轨迹生成经验摘要 $c_\tau$ 并缓存(成功轨迹总结“最小计划/关键动作/检查项/避免项”,失败轨迹总结“失败诊断/有用证据/修正计划/避免项”)。第二步,每次更新取轨迹批 $B$,获取训练响应 $z_{\tau,t}$(OEL 每次从当前学生普通视图重采,SDPO-offline 由周期起始策略生成一次后复用),得到候选步骤集 $U$。第三步,用冻结教师对 $U$ 中每步计算 JSD 敏感性(Top-20 加残差尾部近似),取 Top-$\lceil\rho|U|\rceil$ 得 $C_\rho$;得分、响应与选中索引在反向传播前全部固定。第四步,计算选择性蒸馏损失 $\mathcal{L}_{sel}=\frac{1}{|B|}\sum_{\tau:\,m_\tau>0}\frac{1}{m_\tau}\sum_{t\in C_\rho(\tau)}\ell_{dist}(\tau,t)$,其中 $\ell_{dist}$ 是逐 token 学生-教师 KL 的 token 平均。第五步,在全部 $U$ 步上以相同轨迹级归约计算 $\mathcal{L}_{ret}$。第六步,仅优化学生:$\mathcal{L}=\mathcal{L}_{sel}+\lambda\mathcal{L}_{ret}$,AdamW 恒定学习率 $10^{-6}$。$M$ 次更新后,最终学生成为 $\pi_{r+1}$,既是下一轮部署策略,也初始化下一轮师生。文本任务共 3 轮,每轮 30 次更新。
技术新颖性
技术新颖性体现在四个层面。(1) 信号设计:用同一模型两个视图间的 JSD 度量 PI 敏感性,是自监督、免奖励、免额外交互的步骤级信息量代理;由于两视图共享前缀与参数,得分解释干净(纯 PI 效应),将其用于蒸馏数据选择属首次。(2) 归约设计:TLB 先在轨迹内对被选步骤取均值、再除以全批轨迹数 $|B|$,使每条含选中步骤的轨迹总权重恒为 $1/|B|$,消除“选中步骤多的长轨迹主导总损失”的长度偏置,这是简单均匀平均不会考虑的。(3) 跨周期视角:以往工作把每个训练周期当作独立问题,本文首次指出“学生即下一位教师”带来的二阶退化,并把保持教师能力作为训练目标的一部分;消融显示普通视图保留在 PI 条件评测下比 PR 低 8.1 个百分点,说明保留“哪个视图”本身就很重要。(4) 工程兼容性:ReSAIL 不改动基方法的响应来源与 KL 方向,只增加选择与正则,因此能同时插进 SDPO 与 OEL 两类目标;SGS 还能独立剥离出来用作静态离线数据过滤器(AITZ 实验验证了这一点),显示出模块化价值。
实验结果
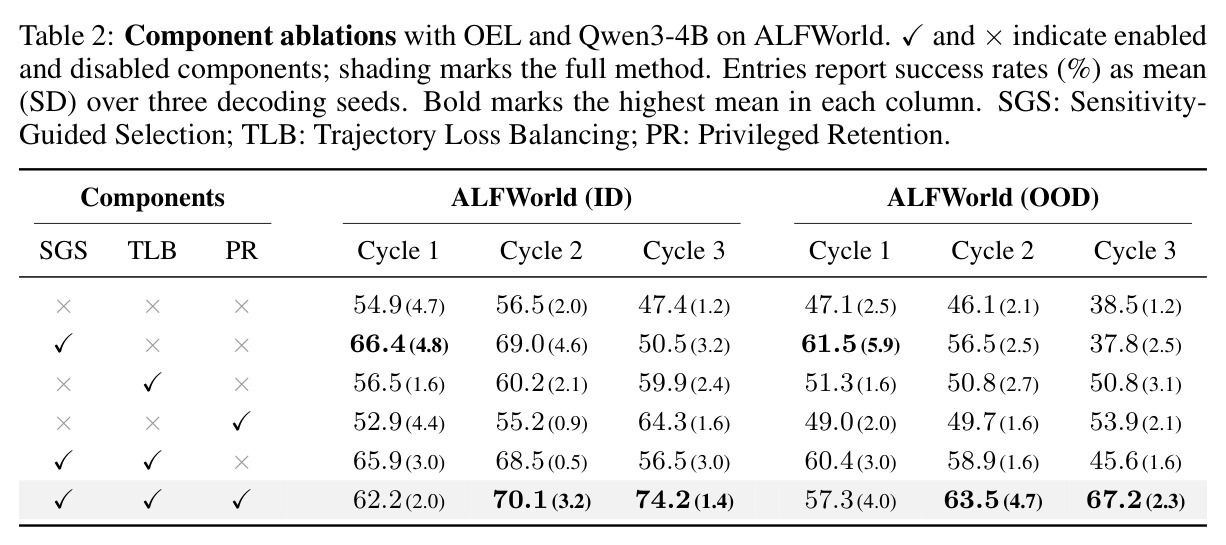
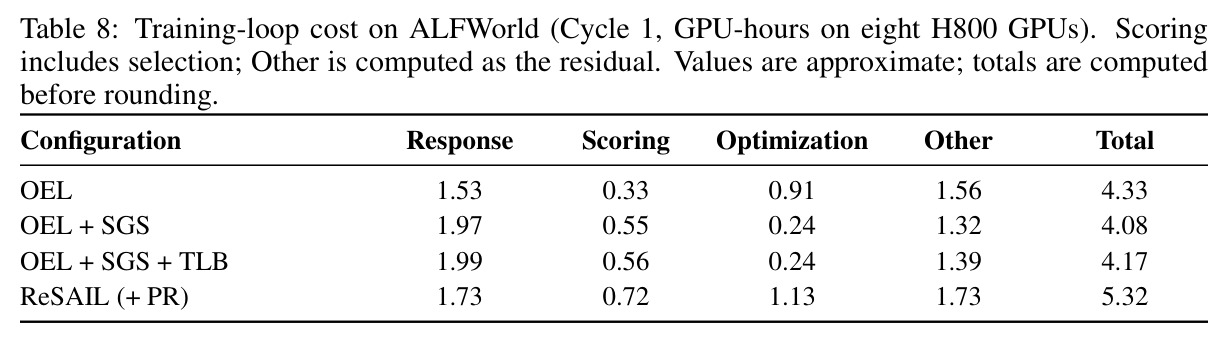
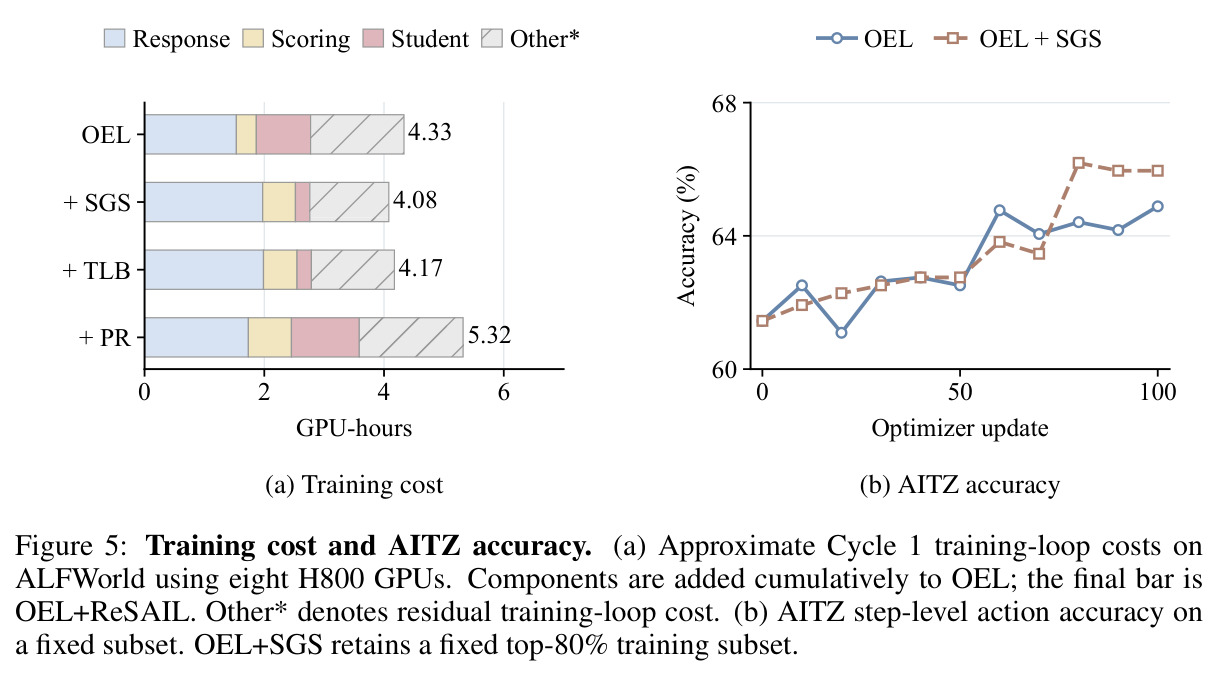
主实验(Table 1)覆盖 ALFWorld ID/OOD 与 TextCraft × Qwen3-4B/8B × 三轮部署。第 3 轮时,SDPO+ReSAIL 与 OEL+ReSAIL 在全部六个“模型×基准”设置上超过所有未增强基线:相对母方法,SDPO 提升 7.0–26.1 个百分点、OEL 提升 20.3–37.0 个百分点,六设置平均绝对增益 22.5 个百分点。代表性数字:ALFWorld OOD 上 Qwen3-4B 的 OEL+ReSAIL 达 67.2%(OEL 仅 38.5%),Qwen3-8B 达 78.4%(OEL 41.4%,且远超最强替代基线 RFT 63.8%、GRPO 62.2%、EPD 46.6%)。持续性方面,ReSAIL 在所有设置中均值逐轮不降,而 OEL 在全部六个设置、SDPO 在五个中第 3 轮低于第 1 轮;对母方法的领先从第 1 轮到第 3 轮由 6.8 扩大到 18.3(SDPO)、5.0 扩大到 26.6(OEL)。消融(Table 2)揭示时间尺度分工:SGS 单独第 1 轮最强(+11.5/+14.4 点)但第 3 轮仍坍塌;加 TLB 部分缓解;再加 PR 后第 3 轮比 TBSD 高 17.7/21.6 点。对照实验证明增益来自选对步骤(Top 62.2%/57.3% vs Random 49.7%/45.8%)与选对保留视图(特权保留 74.2%/67.2% vs 普通保留 72.9%/65.9%)。双视图评测(Figure 3)显示:无保留时 PI 条件成功率从 61.5% 跌至 44.8%,有 PR 时从 58.9% 升至 70.3%。效率上,SGS 使学生优化开销降约 74%、总开销 4.33→4.08 GPU 时;完整 ReSAIL 为 5.32(1.23×OEL);SGS 作 AITZ 离线过滤器把动作准确率从 64.89% 提到 65.95%(+1.06 点)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ALFWorld OOD(Qwen3-4B,第 3 轮部署成功率) | 成功率 (%) | OEL+ReSAIL 67.2;SDPO+ReSAIL 64.3 | OEL 38.5;SDPO 44.3 | +28.7(对 OEL);+20.0(对 SDPO) |
| ALFWorld ID(Qwen3-4B,第 3 轮部署成功率) | 成功率 (%) | OEL+ReSAIL 74.2;SDPO+ReSAIL 72.4 | OEL 47.4;SDPO 58.9 | +26.8(对 OEL);+13.5(对 SDPO) |
| ALFWorld OOD(Qwen3-8B,第 3 轮部署成功率) | 成功率 (%) | OEL+ReSAIL 78.4;SDPO+ReSAIL 75.3 | OEL 41.4;SDPO 49.2;最强非自蒸馏基线 RFT 63.8、GRPO 62.2、EPD 46.6 | +37.0(对 OEL);+26.1(对 SDPO) |
| TextCraft(Qwen3-4B,第 3 轮部署成功率) | 成功率 (%) | SDPO+ReSAIL 67.3;OEL+ReSAIL 64.0 | SDPO 60.3;OEL 43.7 | +7.0(对 SDPO);+20.3(对 OEL) |
| AITZ 多模态 GUI 动作预测(离线数据过滤) | 步级动作 EM 准确率 (%) | OEL+SGS(保留 top-80% 步骤)65.95 | OEL 64.89 | +1.06(相同 100 次更新预算) |
局限与改进
作者承认的局限:所有均值的标准差只反映三个解码种子的波动,而非独立训练运行之间的方差(附录 C.1 明确说明误差条描述的是解码可变性);实验只覆盖三个部署周期,更长周期下是否仍不坍塌未验证;$\lambda=1$ 时性能反而低于 $\lambda=0.5$,说明保留强度需要仔细调节。我自己的观察:(1) 完整 ReSAIL 训练环开销是 OEL 的 1.23 倍(5.32 vs 4.33 GPU 时),PR 需要在所有步骤上做特权视图的前向/反向,成本不小;(2) 超参跨基准不通用——ALFWorld 用 $\rho{=}0.05,\lambda{=}0.5$,TextCraft 用 $\rho{=}0.25,\lambda{=}1.0$,落地需要逐基准调参;(3) 方法依赖经验摘要质量,摘要由起始策略生成,若 PI 本身误导(如失败轨迹总结错误),敏感性选择与保留都会被带偏;(4) JSD 用 Top-20+残差尾部近似,对分布平坦、top token 不稳定的步骤可能打分不准;(5) Figure 6 显示 PI 敏感性随周期总体下降,意味着后期可选的高信息步骤变少,选择机制的长期收益存疑;(6) PR 锚定的是周期起始的冻结教师而非历史最优,理论上可能把 PI 能力固定在次优水平,限制上限;(7) ALFWorld 每侧仅 128 任务、TextCraft 仅 100 任务,对几个点的差异统计功效有限。
独立分析的弱点
独立分析的弱点与改进方向。(1) 计算开销集中于 PR:全步骤特权视图前向/反向使成本升至 1.23 倍,可只在敏感性 top-k 步骤上做保留、或每 n 次更新做一次保留来降本,并验证性能折损。(2) 超参敏感:$\rho,\lambda$ 在两个文本基准上取值不同,且 $\lambda$ 过大有害,可探索按批次敏感性统计自适应调节 $\lambda$,或设计无验证集的自动定 $\rho$ 准则。(3) 训练方差未刻画:所有结论只平均解码种子,若不同训练种子间方差大,结论稳健性需打折,应补充多训练种子实验。(4) PI 形式单一:文本任务只测了经验摘要型 PI,参考解答、hindsight 反馈等其他 PI 下敏感性信号是否同样有效未知,可系统比较 PI 类型与选择准则的交互。(5) 评测规模有限:128/100 个任务、3 个解码种子,对 1–2 个点的差异置信度不足(例如 AITZ 上 +1.06 点未给显著性检验)。(6) 保留目标设计保守:PR 把学生 PI 视图锚向周期起始冻结教师,若教师 PI 能力平庸,保留会变成阻碍进步的保守正则,可尝试锚向历史最优教师的 EMA,或只约束“PI 相对增益”而非整个 PI 条件分布的更松弛正则。每个弱点都有明确的实验路径,属于工程可改进范畴。
未来方向
可延伸的研究方向。(1) 坍塌的理论刻画:目前只有经验证据,把“PI 条件能力退化 → 监督质量下降 → 部署性能坍塌”形式化为动力学模型,预测何时坍塌、ReSAIL 何时有效,是重要的理论工作。(2) 更长周期与更大规模:验证 5–10 个周期、更大模型下是否需要更强的保留机制,$\lambda$ 或许应随周期调度(本文固定不变)。(3) 与 RL 结合:ReSAIL 处理离线自蒸馏,可与在线 RL(GRPO 类)交替训练,或把敏感性打分用于 RL 的优势加权与经验回放优先级。(4) 完整的多模态迭代设定:本文只把 SGS 用于 AITZ 静态过滤,多模态 GUI 智能体的多轮自蒸馏(截图历史增长带来的上下文压力)是自然延伸。(5) PI 类型泛化:在参考解答、hindsight 反馈等 PI 形式下重新定义与校准敏感性。(6) 保留目标升级:从锚定冻结教师到锚向改进中的教师(EMA/最优历史检查点),兼顾保持与提升。(7) 真实部署验证:在环境不可重复访问的线上场景(产品助手、运维智能体)中检验 ReSAIL 的实用价值,这正是论文强调的受限设定。
复现评估
复现评估:论文未明确承诺开源代码,但实现细节披露非常充分。基础设施:基于 slime 框架 + Megatron-LM 训练 + SGLang 生成,Python 3.12.3 / PyTorch 2.11.0 / CUDA 12.9,BF16 参数 + FP32 优化器状态,8 卡 H800 数据并行度 8。关键超参全部给出:AdamW 恒定学习率 $10^{-6}$ 无 warmup;ALFWorld 每轮 30 次更新、批 32 条轨迹(每轮 960 条)、$\rho{=}0.05$、$\lambda{=}0.5$;TextCraft 批 8(240 条)、$\rho{=}0.25$、$\lambda{=}1.0$;AITZ 单轮 100 次更新、1600 条轨迹(从 Aguvis Stage-2 的 1728 条 CoAT 轨迹采样)、保留 top-80% 步骤。评测协议完整:温度 0.4、top-p 1.0、30 步上限、1024 token 上限、3 个解码种子;附录 E 给出全部 prompt 模板(含摘要提取与特权插入格式)。成本方面,ALFWorld 单轮训练环约 4.1–5.3 GPU 时(8×H800),单轮实验门槛不高,4B 模型在实验室级集群即可复现;主要难度在于 slime/Megatron/SGLang 版本耦合的环境搭建和轨迹收集管线。总体属于中高可行性的复现。
论文图表
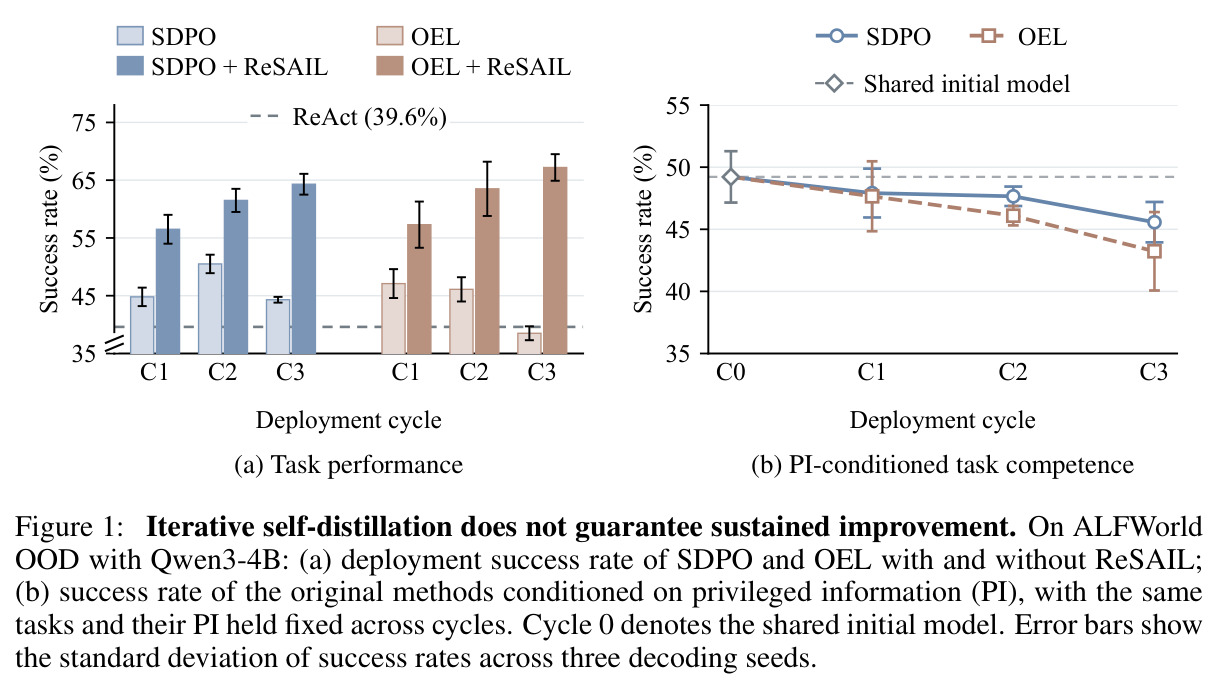
双面板折线图(ALFWorld OOD,Qwen3-4B):(a) SDPO 与 OEL 加不加 ReSAIL 的部署成功率随三个周期变化,基线在第 3 轮明显回落,+ReSAIL 持续上升;(b) 固定任务与 PI 后各方法的 PI 条件成功率随周期下降,共享初始模型 ReAct 为 39.6%。
一张图同时呈现论文的两大动机证据:部署性能坍塌与 PI 条件能力退化,是理解问题真实存在的起点。
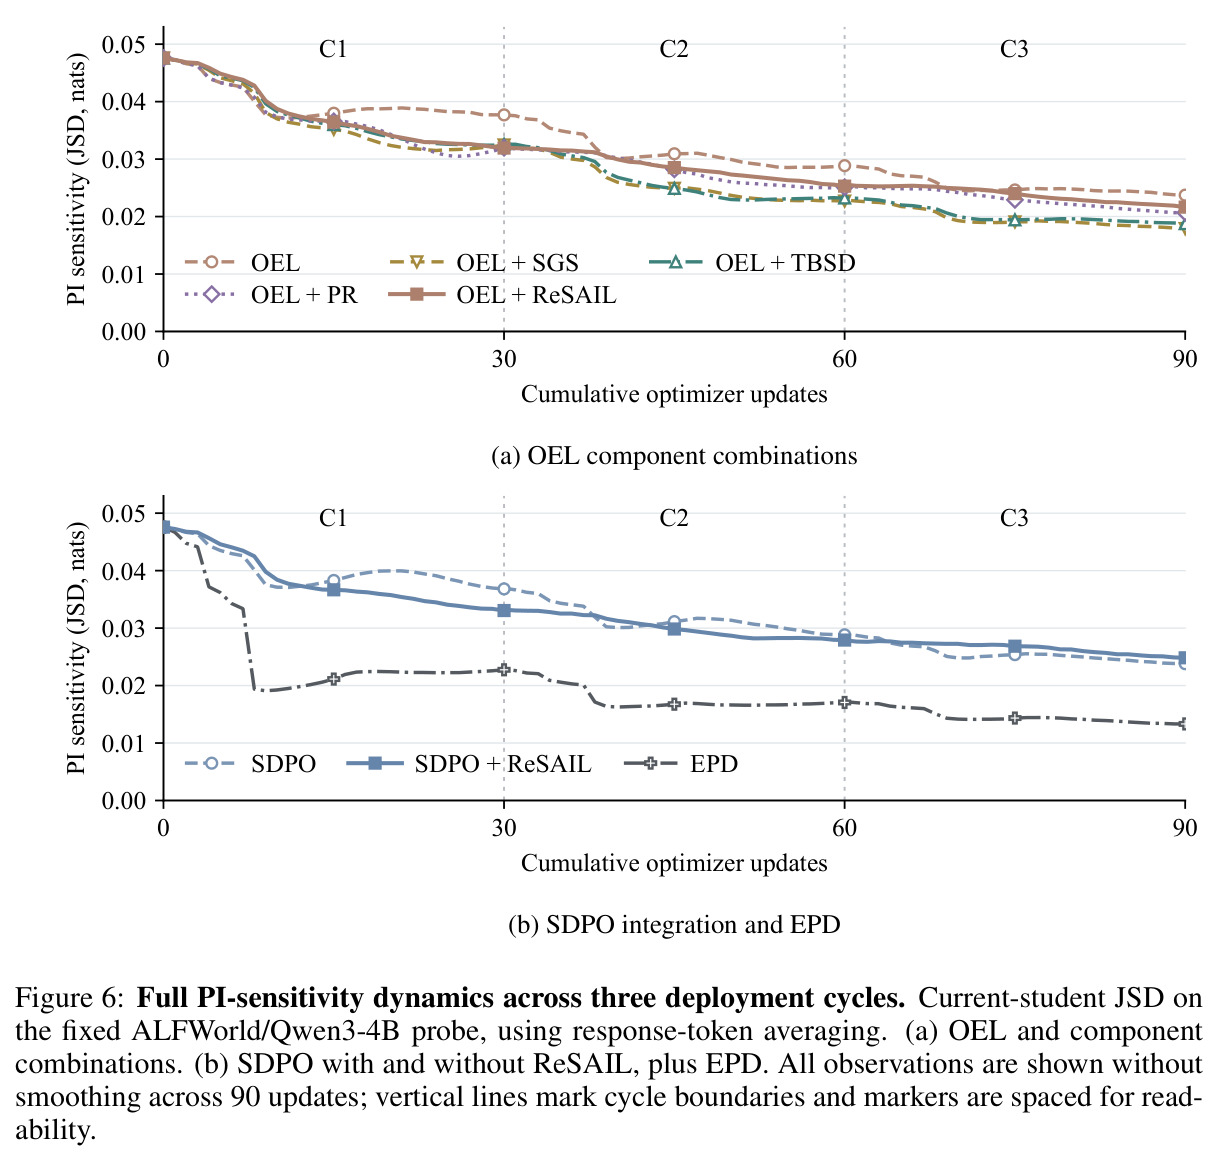
附录诊断图:8 个配置在 90 次更新上的完整无平滑 PI 敏感性(JSD,nats)轨迹。敏感性总体随周期下降,ReSAIL 下的局部反弹弱于 OEL/SDPO;加 PR 并不会一致抬高周期末点的 JSD。
揭示分布层面的敏感性与功能层面的能力并不完全对齐,提示敏感性信号的局限,是评估方法边界的重要材料。