Fold2Reason:学习蛋白质折叠能否泛化为更广泛的推理能力 Does Learning Protein Folding Generalize to Broader Reasoning?
用蛋白质结构生成可验证问答与几何信号微调LLM,通用推理基准平均提升3.23个百分点
前置知识
LoRA(低秩适配)
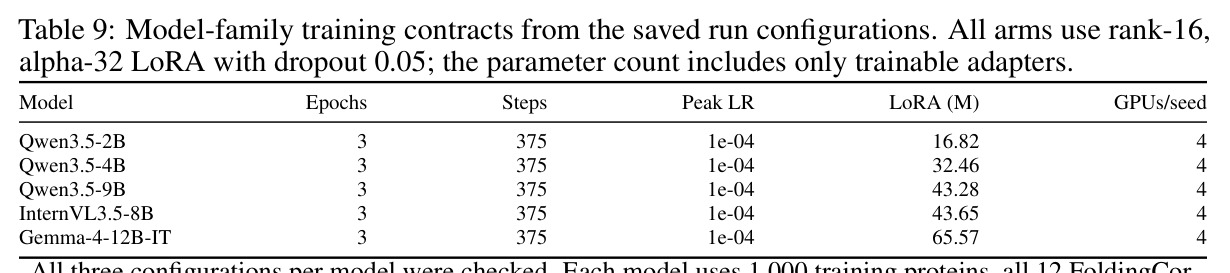
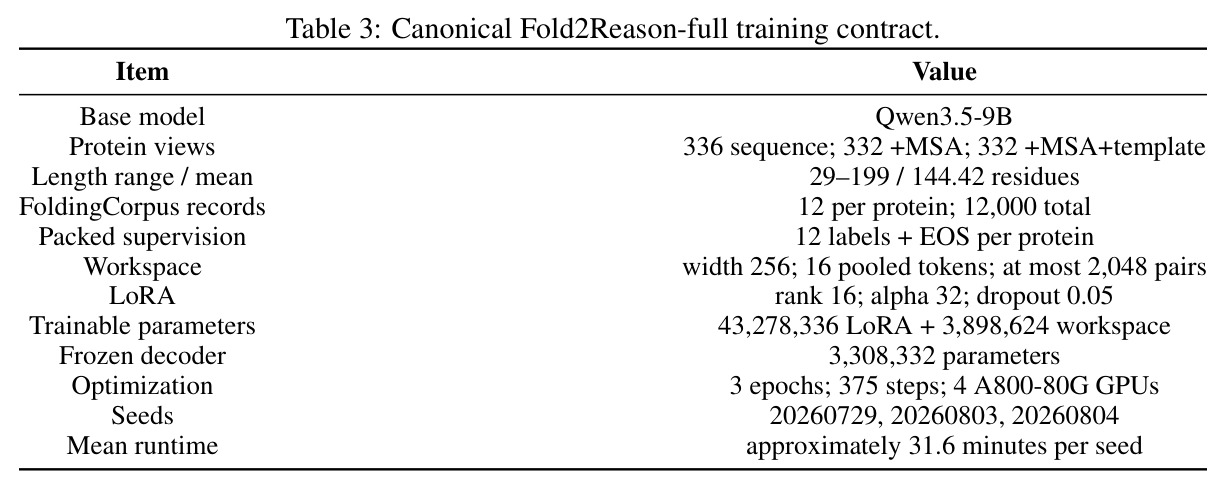
一种参数高效微调方法:冻结预训练模型全部权重,只在注意力与前馈层的投影矩阵旁挂一对低秩分解矩阵 $\Delta W = BA$(秩 $r \ll d$),只训练这几十M参数。本文用 rank 16、alpha 32,可训练参数 43.28M,约为 9B 底座的 0.5%。
本文所有实验只训练 LoRA 适配器,推理时也只保留这个适配器——迁移结论完全建立在这点参数改动上,不理解 LoRA 就无法理解其实验设计的巧妙之处。
蛋白质折叠与接触图
蛋白质是由氨基酸序列折叠成的三维分子,PDB 数据库存储实验解析的原子坐标。接触图(contact map)是 $L\times L$ 矩阵:若残基 $i,j$ 的 Cα 距离 $d(i,j)<8$Å 且序列间隔 $\ge 6$,则记为接触。序列决定三维结构是结构预测的核心问题。
本文的全部训练信号都由这些坐标程序化生成(接触、距离、手性、方向等),读者需要知道坐标里蕴含哪类可验证的空间陈述,才能理解 FoldingCorpus 的构造逻辑。
TM-score 与 lDDT
两个标准结构相似度指标:TM-score 衡量预测与真实结构全局拓扑的对齐程度(对长链不敏感,1 为完全一致);lDDT(局部距离差异测试)衡量所有原子对局部距离的保留程度,对局部结构更敏感。两者都在 0 到 1 之间。
论文用 TM-score 与 lDDT-Cα 报告折叠读出质量,并靠二者分离『局部结构改善』与『全局拓扑不变』这一关键发现(lDDT 升、TM 不升)。
匹配对照与消融实验
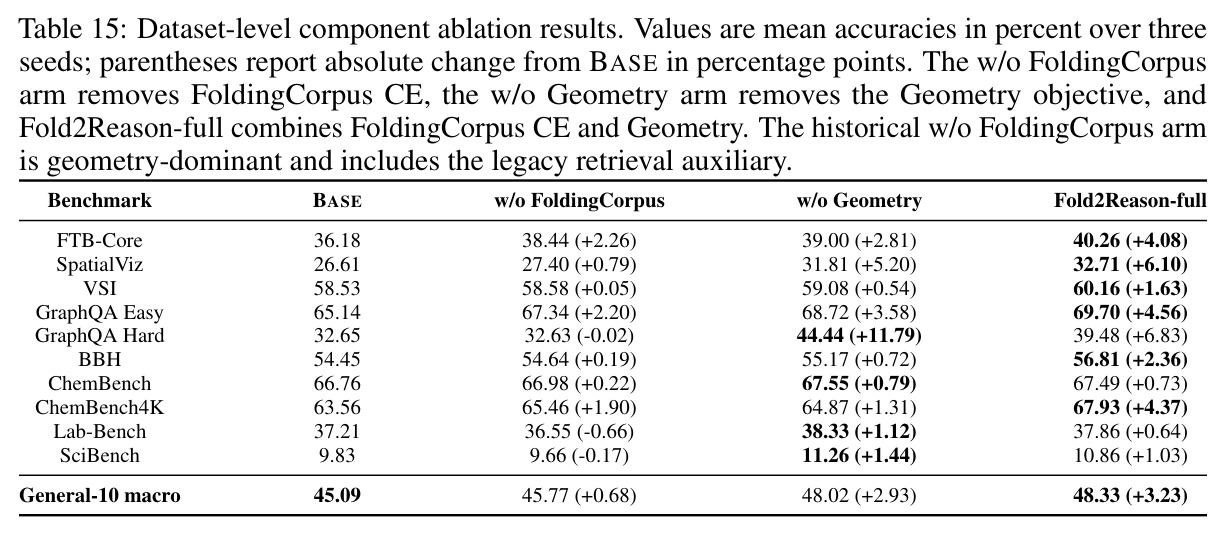
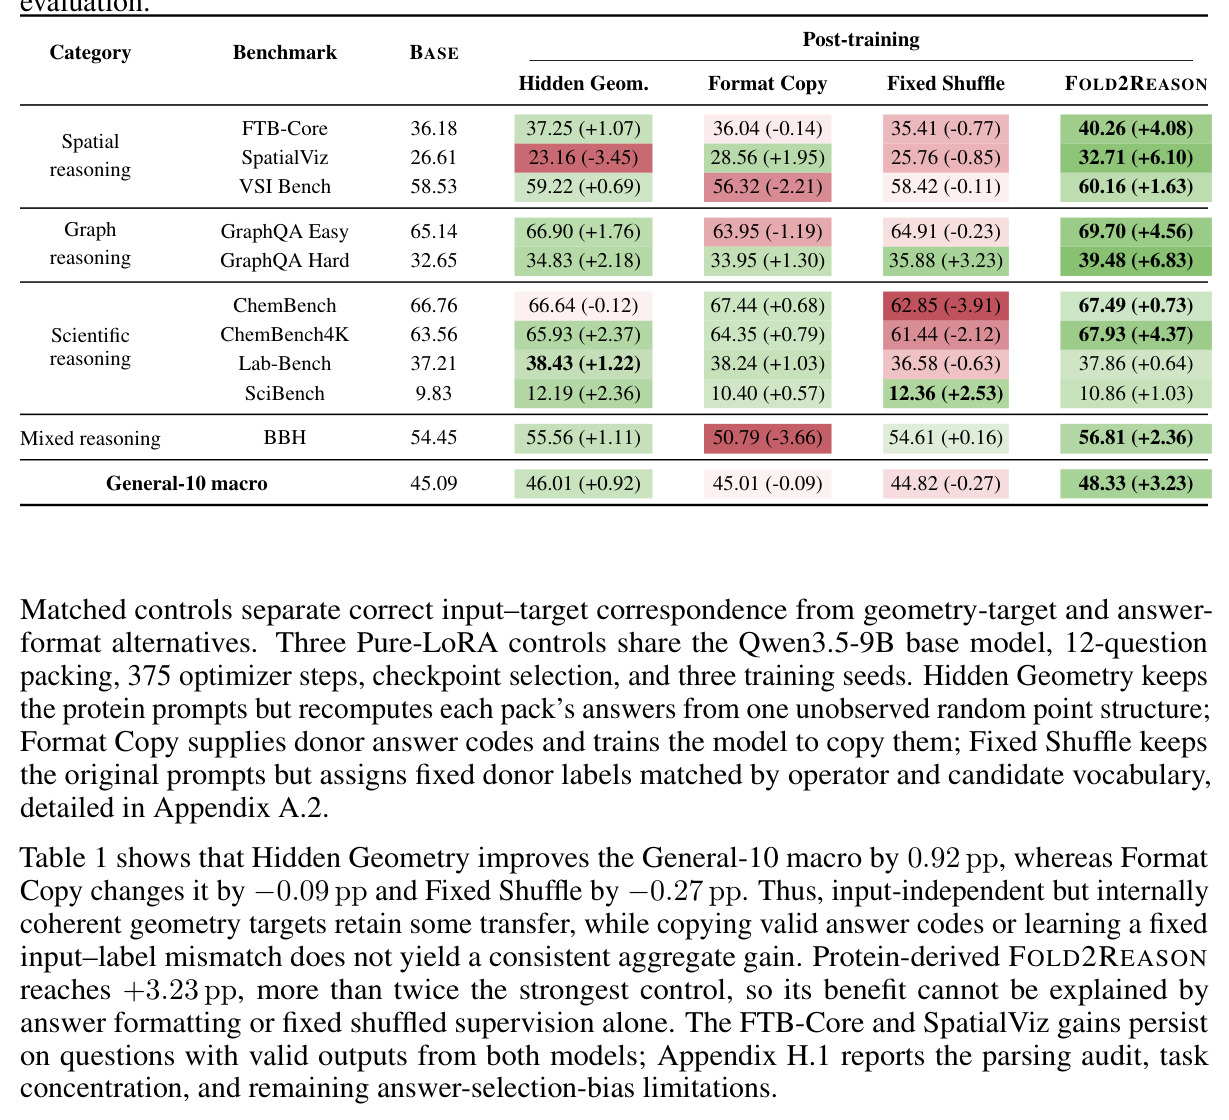
匹配对照(matched control)是与实验组共享一切条件、只改变单一因素的对照组;消融(ablation)是逐个移除方法组件观察效果变化。本文用 Hidden Geometry / Format Copy / Fixed Shuffle 三个对照分离『学结构』与『学格式』,用 w/o Geometry、w/o FoldingCorpus 两个消融定位两条损失路径的贡献。
这篇论文的核心主张(蛋白质监督而非答案格式带来迁移)完全依赖这些对照实验的结论,看懂对照设计才能评估证据强度。
研究动机
大语言模型的能力高度依赖人类撰写的文本与代码,但这类语料传达的往往是『表面答案』,而不是答案背后的空间与结构逻辑。随着高质量人类文本逼近枯竭(论文引用 Villalobos et al. 的储量估算),社区转向指令微调、合成逻辑数据和代码训练。然而专项训练的迁移效果很不稳定:数学、代码推理训练有时能带动通用表现,有时却让其他能力持平甚至变差(论文引用 Huan et al. 2025、Liu et al. 2026 的负结果)。具体来说,一个在数学基准上变强的模型,未必在空间想象、图结构推理或科学问题上变强——因为文本答案本身不携带可验证的三维几何约束。于是『监督数据的哪些性质决定通用迁移』成为一个悬而未决的问题:需要一个包含大量结构化目标、答案可被程序自动判对错、且能规模化的监督源,才能做受控实验。
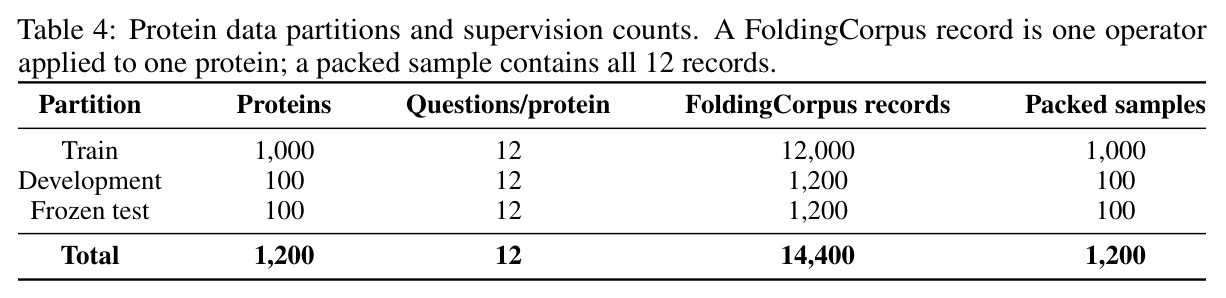
本文的目标是本文要检验一个明确假设:让通用大模型学习蛋白质折叠这类『结构约束任务』,能否获得、或更可靠地激发可迁移到训练域之外的计算能力。目标分三层:(1) 数据层,构建 FoldingCorpus——从 PDB 已解析坐标出发,用 12 个确定性结构算子生成可精确核验的问答对,核心集 1,200 个蛋白、14,400 条记录(1,000 训练/100 开发/100 冻结测试),所有答案由程序从坐标独立重算审计;(2) 方法层,提出 Fold2Reason 后训练配方,把离散结构答案与连续三维几何两类信号经同一共享接口注入冻结的 Qwen3.5-9B(仅训练 LoRA);(3) 评估层,在与蛋白质毫无关系的 10 项通用推理基准(General-10,共 76,725 题)上测量迁移,评估时丢弃全部蛋白质专用模块,只保留适配后的语言模型。
与已有工作不同的是,本文的独特切入角度是反转了结构信息与语言模型关系的方向。以往工作(ESM 类蛋白语言模型、3D-MoLM、蛋白-文本对齐)都是『结构进、蛋白任务出』:把结构编码器接到 LLM 上,评估的仍是分子或蛋白质任务本身。本文反过来把蛋白质结构当作训练信号源,测量的是『卸下蛋白质接口之后』的通用推理——蛋白输入、训练期工作区、几何解码器在推理时全部移除,任何提升只能留在适配后的模型参数里。此外,已有的可验证奖励/合成逻辑数据多来自程序生成的文本或数学题,本文把监督源扩展到三维科学结构档案:一个已被解决的问题(蛋白质结构预测)变成后训练监督的现成来源。配套的三个匹配对照(Hidden Geometry、Format Copy、Fixed Shuffle)在同类『数据→能力迁移』研究中也少见地严格,把『学到真实的结构对应关系』与『仅仅学到答题格式』干净地分离开。
核心方法
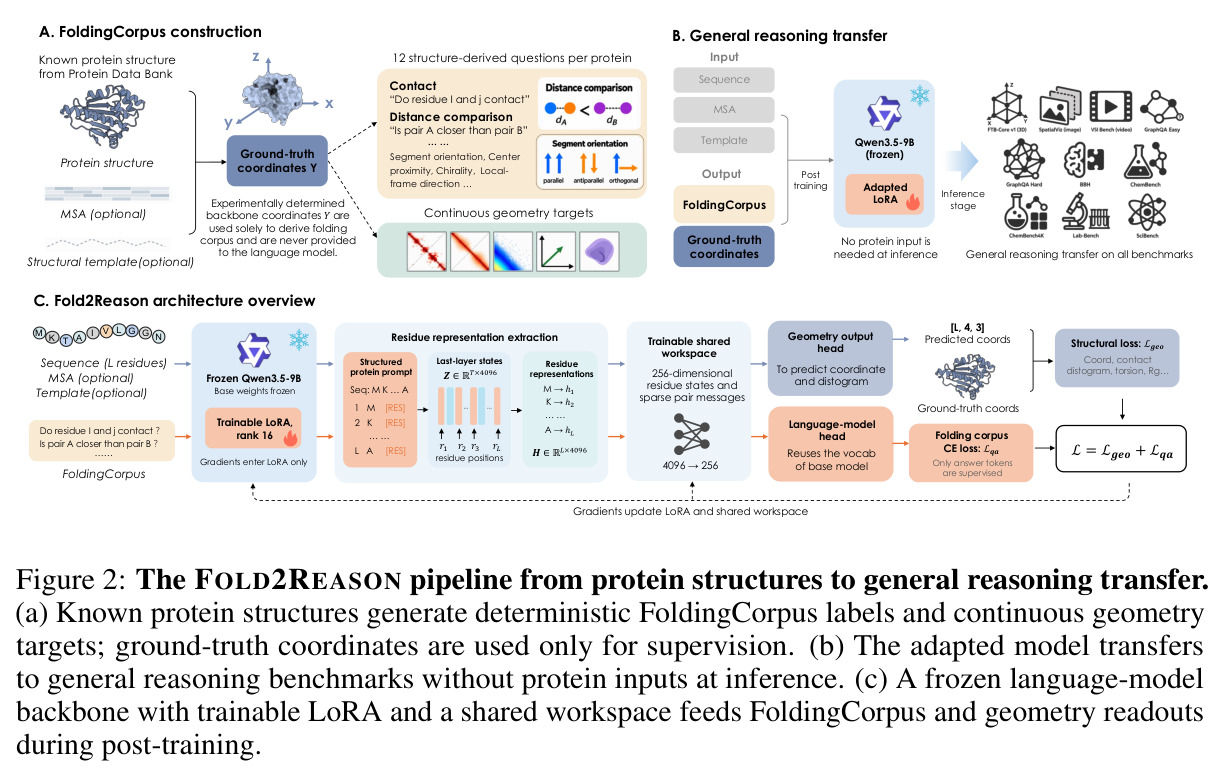
直觉:一个已解析三维结构的蛋白质天然携带大量可程序判对错的空间陈述——某两残基是否接触、哪对离中心更近、手性如何。把它们变成单 token 答案的问答题,让冻结的 LLM 学会『从序列推断结构逻辑』,有望锻炼可迁移的空间与科学推理。技术路线:(1) 取 1,000 个 OpenFold 短蛋白,每个用 12 个结构算子生成问答题打包成一个样本;(2) 每残基一个标记符输入冻结的 Qwen3.5-9B,取残基态 $H = f_\theta(x)_{\text{res}} \in \mathbb{R}^{L\times 4096}$,坐标从不进入输入;(3) 可训练工作区 $W_\phi$ 把残基态降到 256 维、在近邻与远距采样对上做消息传递,输出残基表示 $E$ 和 16 个池化证据 token $M \in \mathbb{R}^{16\times 4096}$;(4) 离散路径用语言头监督答案 token($\mathcal{L}_{qa}$),连续路径把 $E$ 送冻结坐标/距离图解码器 $g_\psi$ 算几何损失($\mathcal{L}_{geo}$);总损失 $\mathcal{L} = \mathcal{L}_{qa} + \mathcal{L}_{geo}$ 只更新 LoRA 与工作区,推理时全部卸载,只留适配后的语言模型。
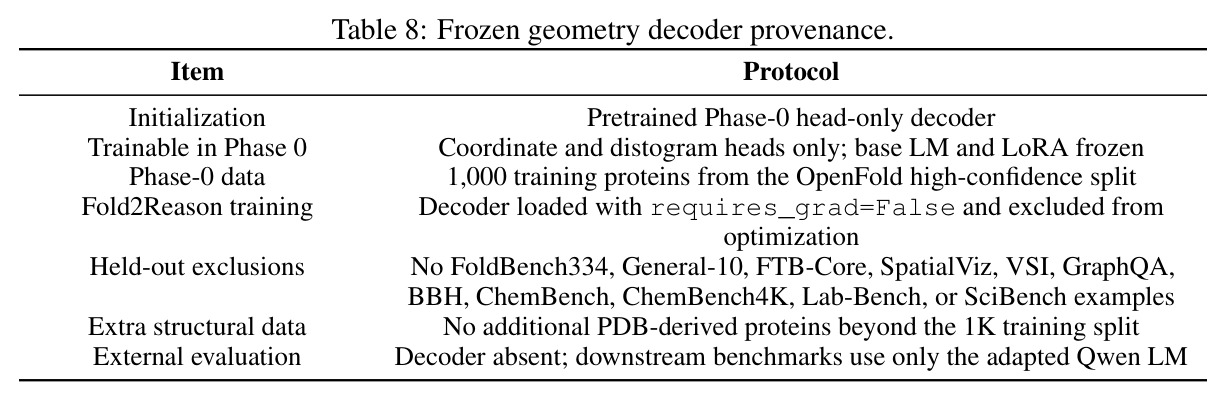
核心创新是『一个工作区、两种读出』加『推理时完全卸载』。与已有方法的本质区别有三点。其一,监督目标是『已知答案、隐藏证据』:坐标只用来生成标签和损失、从不进入模型输入,模型必须从序列加可选 MSA/模板证据推断结构逻辑,这才是『学习折叠』而不是抄结构。其二,冻结几何解码器 $g_\psi$ 是关键设计:如果解码器可训练,几何目标会被新头部自己『吸收』,主干学不到任何东西;冻结之后梯度必须流经共享工作区和 LoRA 参数,迫使语言模型内部表示变得结构可解码。其三,答案全部是单 token 分类——9 个二选一、2 个三选一、1 个 32 路文本指纹匹配,每个蛋白只监督 12 个答案 token 加 EOS,监督极度稀疏,但每个标签都可由程序从坐标独立重算核验,配合加盐哈希决定选项顺序,保证数据可审计且答案位置不泄露信息。迁移评估时把工作区、解码器、蛋白输入全部移除,使『行为迁移发生在适配后的模型里』成为构造性结论。
方法步骤详情
第一步,数据构建:输入 OpenFold 实验解析坐标(每 ID 一条松弛构象,居中并放入右手 PCA 框架),施加 12 个算子——短/中/长程接触($d<8$Å 按序列间隔分档)、两组距离排序、片段方向、离质心更近、局部坐标方向、Cα 手性(叉积符号)、多约束锚点、32 路指纹检索(配 31 硬负例)、任意接触;加盐哈希决定选项顺序,答案由程序独立重算,14,400 条记录全部通过审计。第二步,按互斥 MMseqs2 聚类切出 1,000/100/100 训练/开发/冻结测试蛋白,pLDDT<70 残基不参与监督。第三步,每样本两次前向:蛋白前向产出 $H$,工作区产出 $E$ 与 $M$;答案前向把 $M$ 拼到问题序列,仅对 12 个答案 token 与 EOS 计算 $\mathcal{L}_{qa} = -\frac{1}{|\mathcal{S}|}\sum_{t\in\mathcal{S}} \log p_{\theta,\phi}(y_t \mid M, q, y_{<t})$;$E$ 同时送冻结解码器算七项几何损失之和 $\mathcal{L}_{geo}$(坐标、配对距离、接触、距离图、局部系、扭转、回转半径)。第四步,优化:LoRA rank 16(43.28M 参数)加工作区 3.90M,解码器冻结;4×A800-80G、3 epochs 共 375 步、梯度裁剪 1.0,每种子约 31.6 分钟。第五步,评估:丢弃工作区与解码器,仅留 LoRA 适配模型,在 General-10(76,725 题)与 FoldBench334 上贪心解码。
技术新颖性
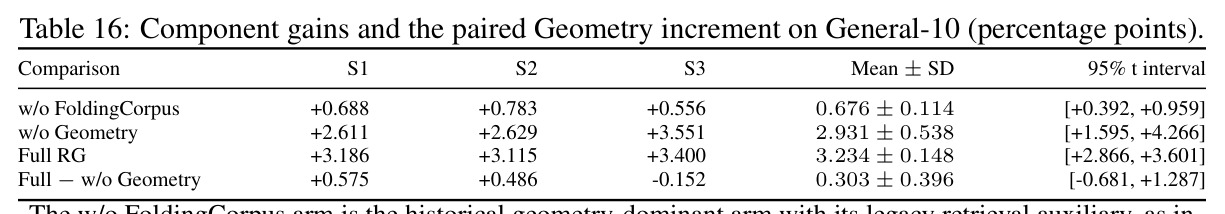
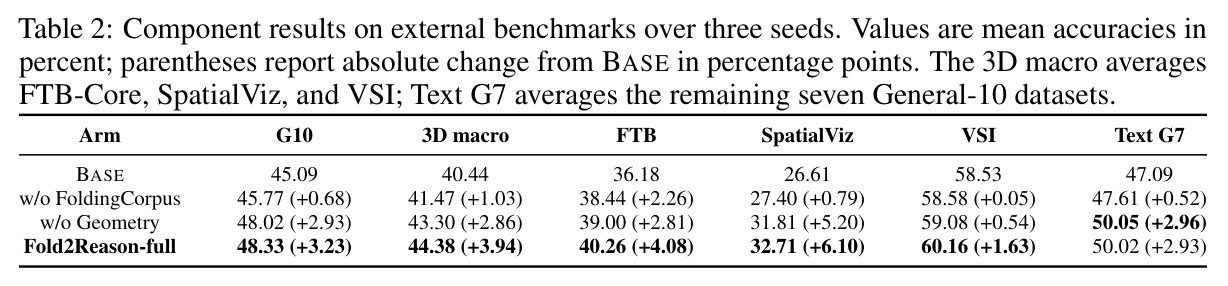
技术新颖性体现在四个方面。(1) 把『结构可验证性』引入后训练数据工程:接触、距离、手性、方向等目标由坐标程序化生成且可独立重算,不需要人工标注,也不像合成数学题那样依赖生成器的语言质量——这是把可验证监督的来源从符号域扩展到三维连续几何。(2) 双信号设计有明确分工并被消融证实:离散问答承载绝大部分通用迁移(去掉几何损失仍有 +2.93 pp),连续几何专门改善局部结构可解码性与 3D 任务(配对增量 +0.30 pp,集中在 FTB-Core +1.26 / SpatialViz +0.90 / VSI +1.08)。(3) 冻结解码器的用法在方法论上类似探测(probing)但反向使用——不是用探针诊断表示里有什么,而是用冻结探针的梯度去塑造表示,同时援引 Hewitt & Liang 的控制任务传统保持解释上的克制。(4) 实验治理的严谨程度本身是贡献:聚类互斥划分、独立重算答案、预注册 checkpoint、机器可读证据包(含 SHA-256 清单),在『哪些数据造就通用能力』这个近年热点方向里审计标准明显更高。
实验结果
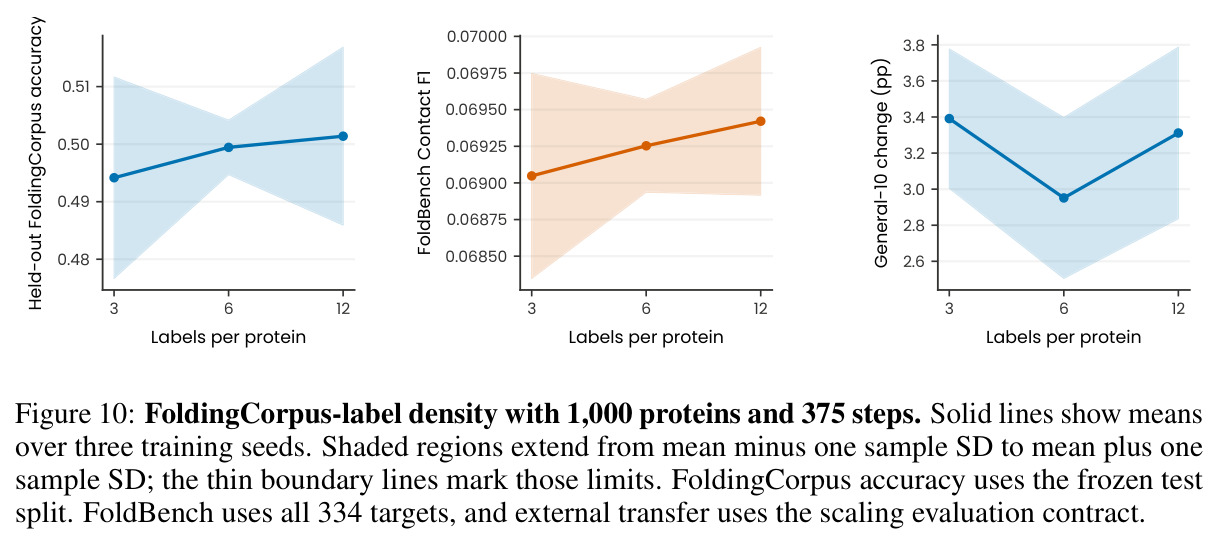
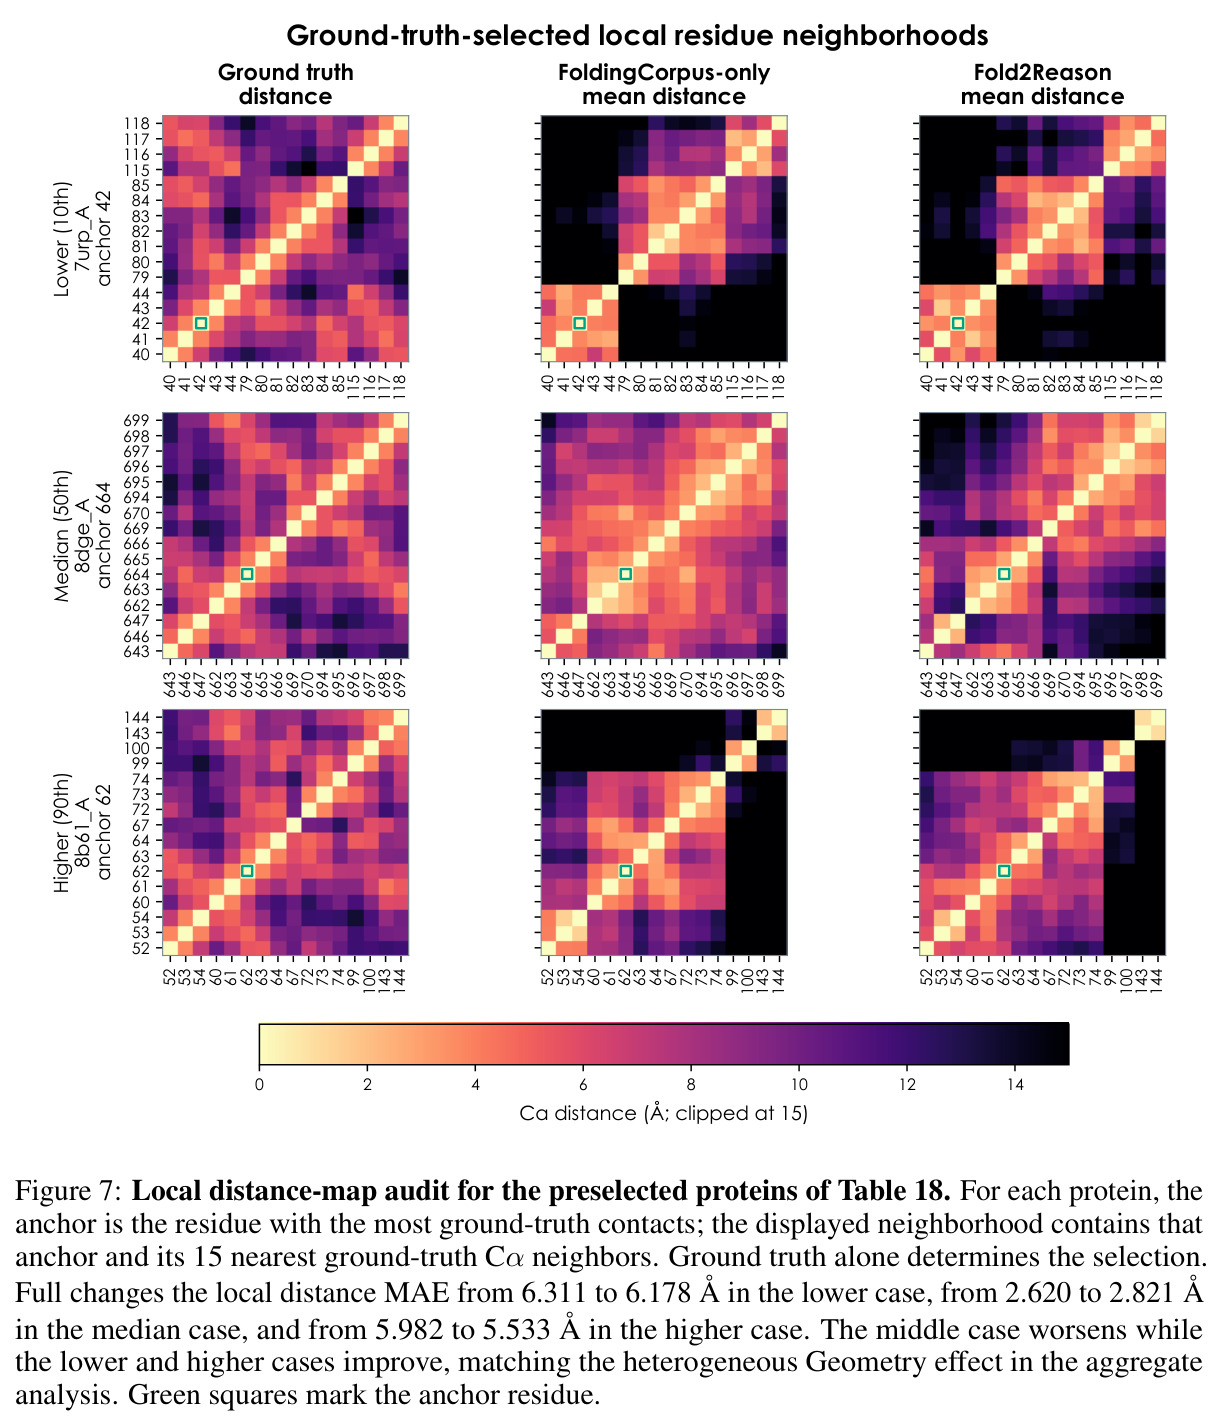
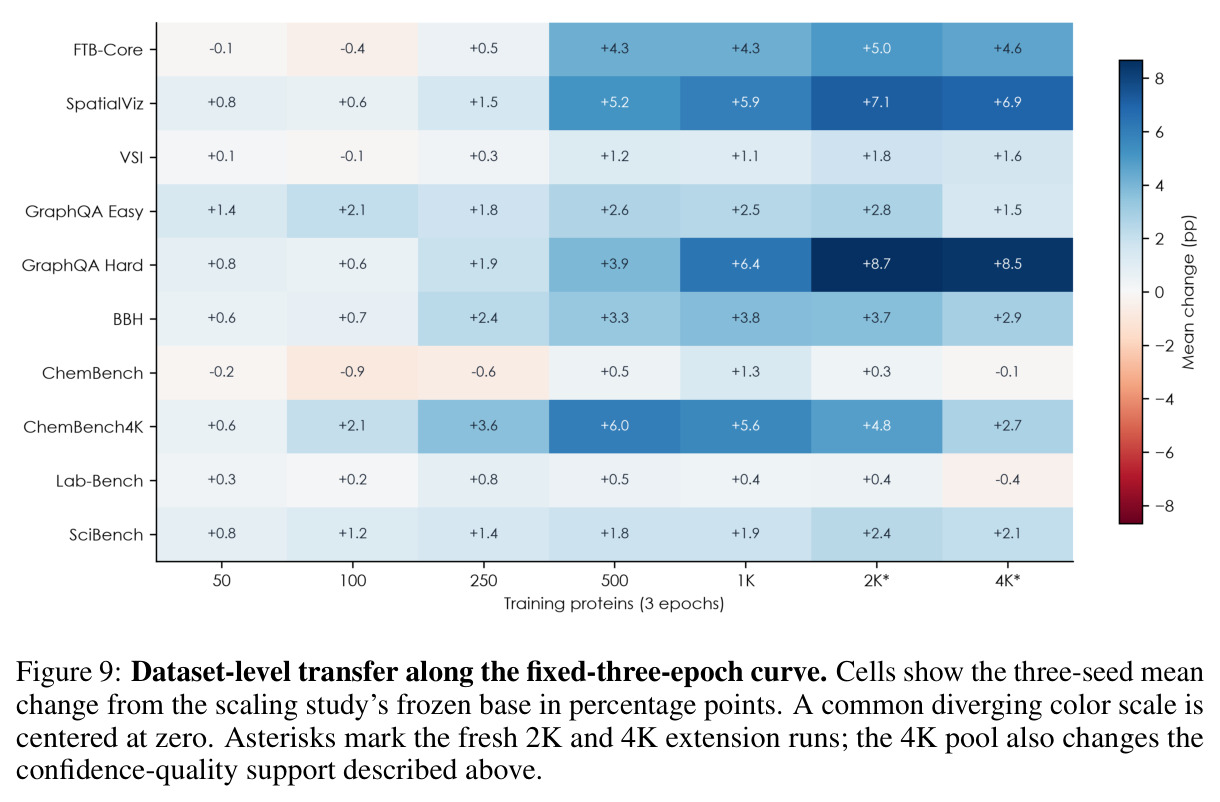
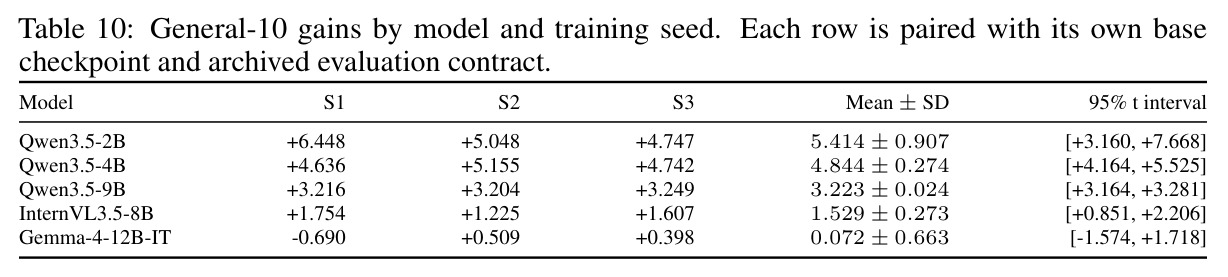
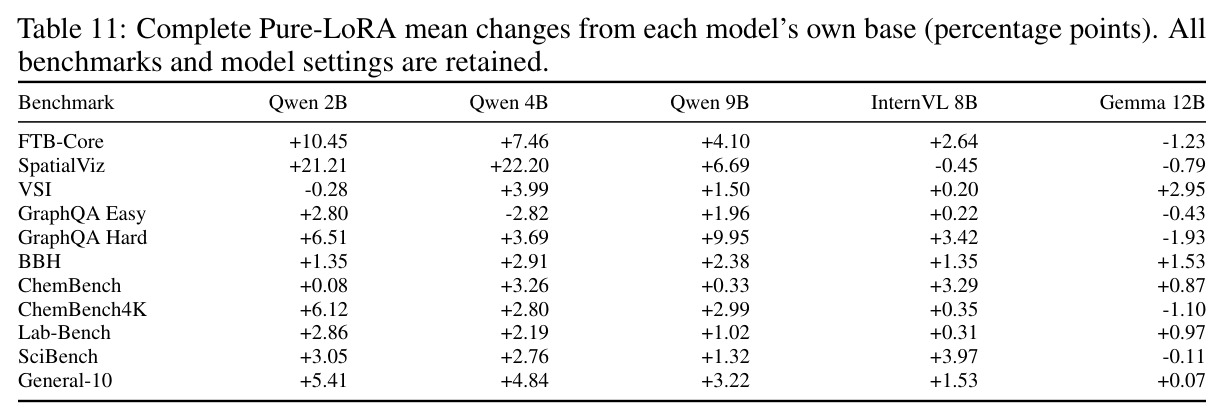
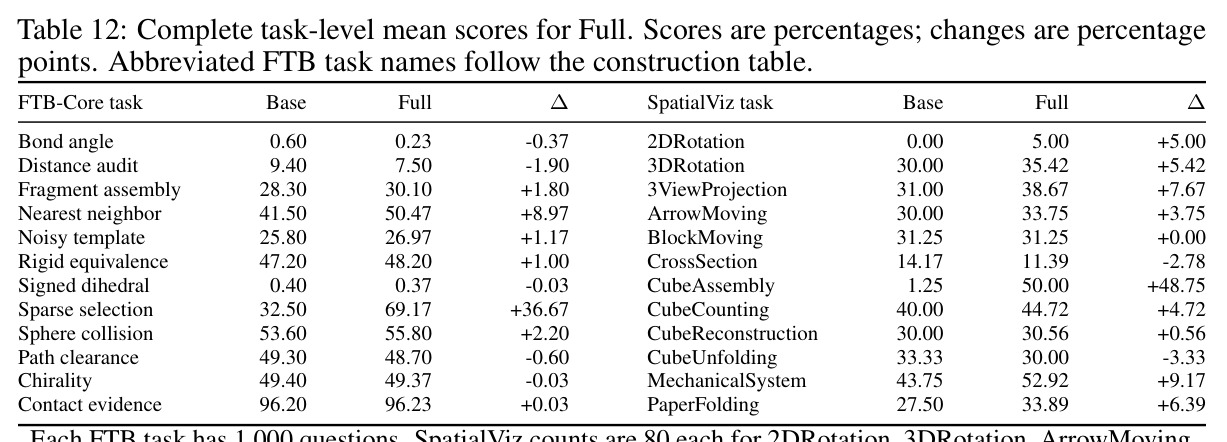
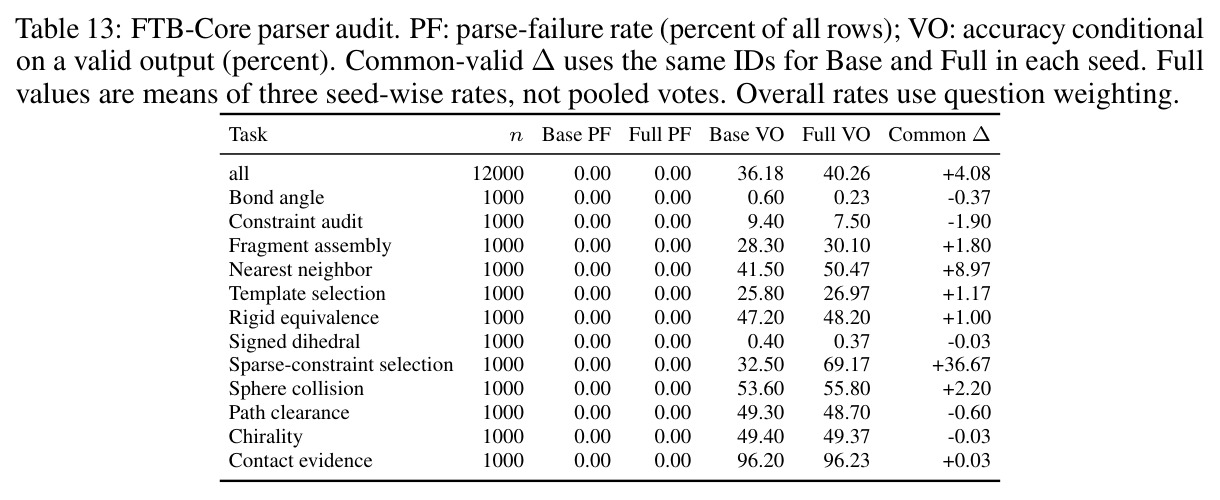
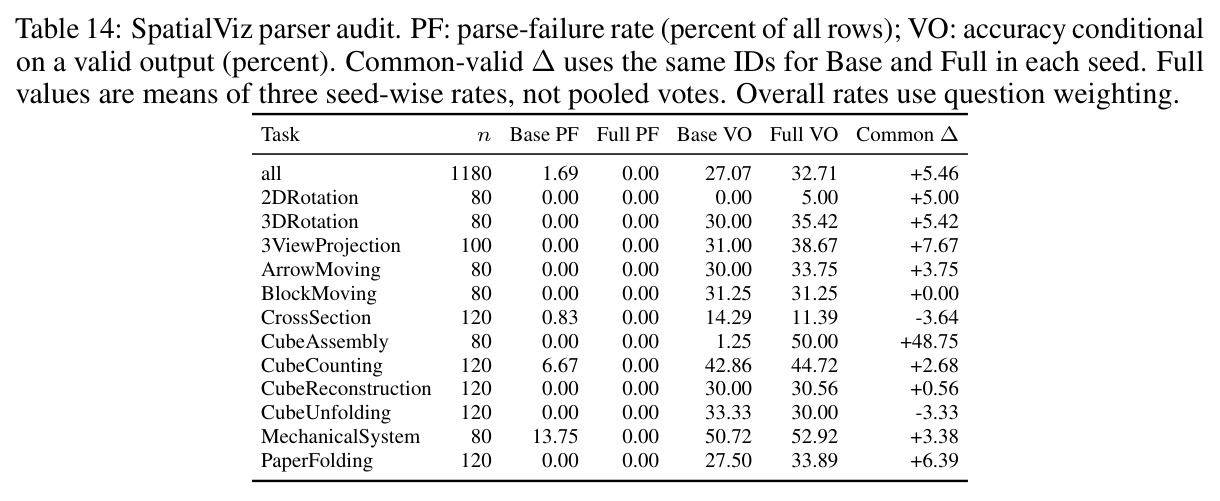
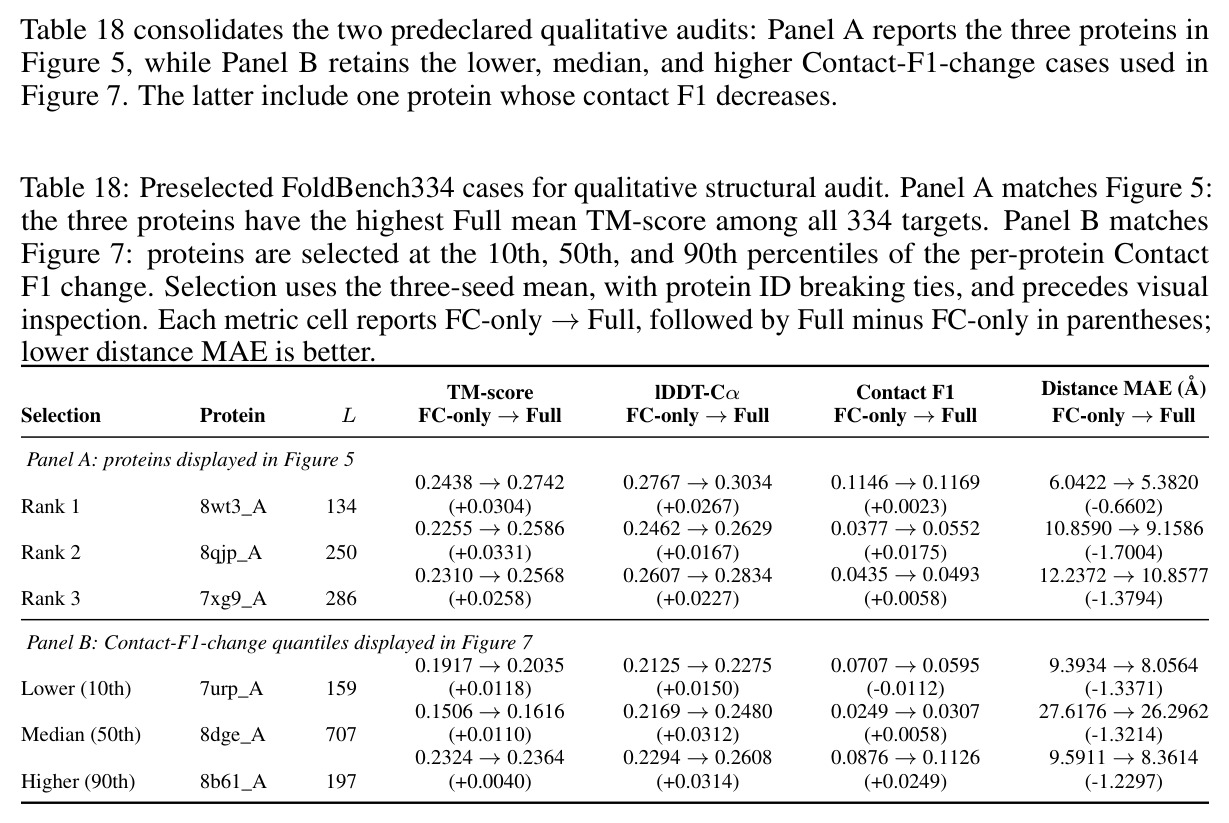
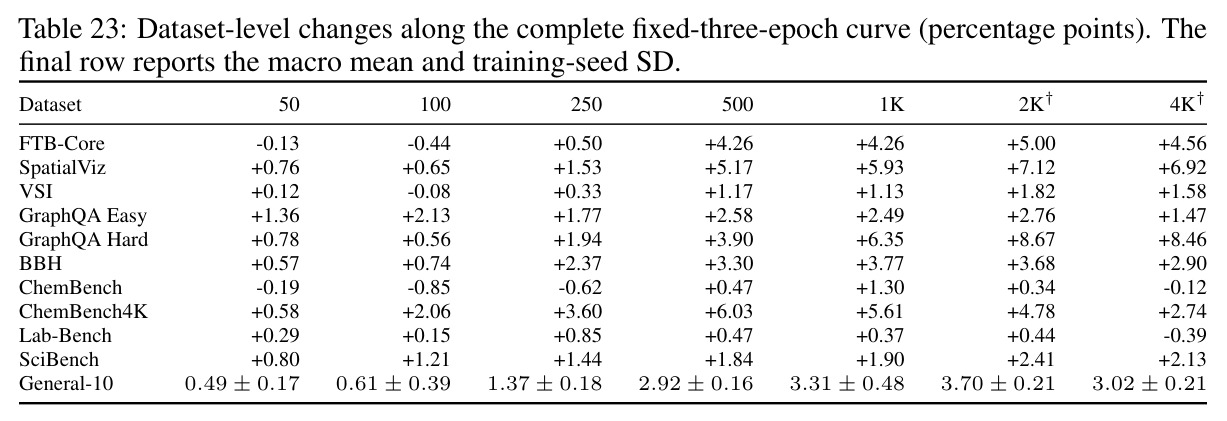
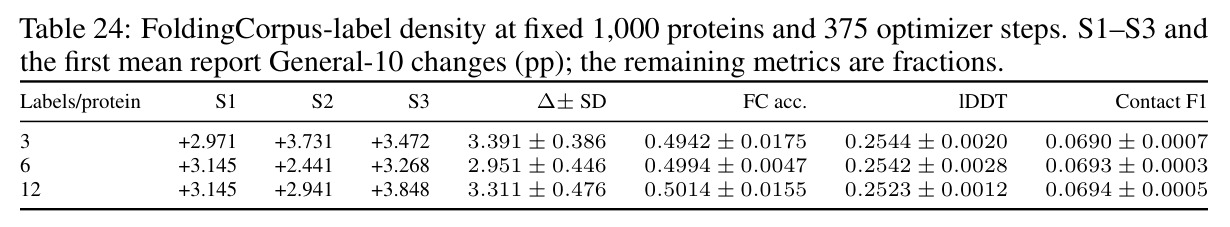
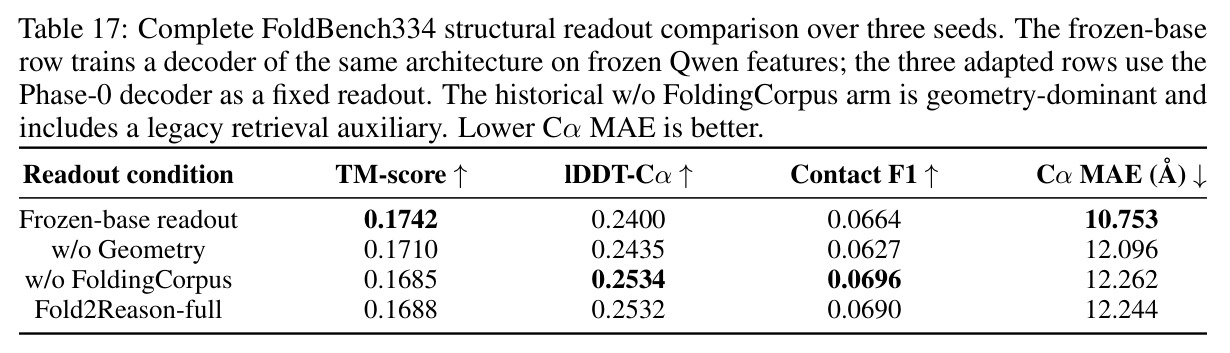
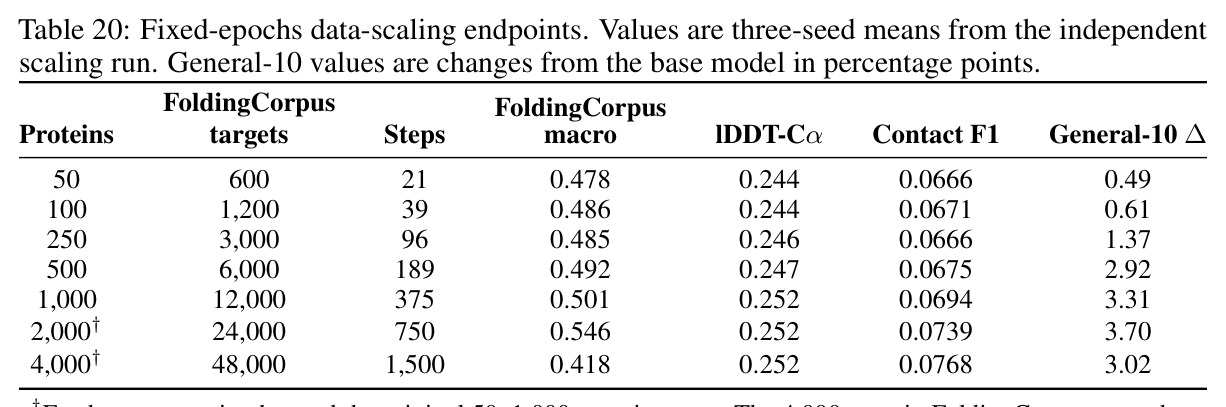
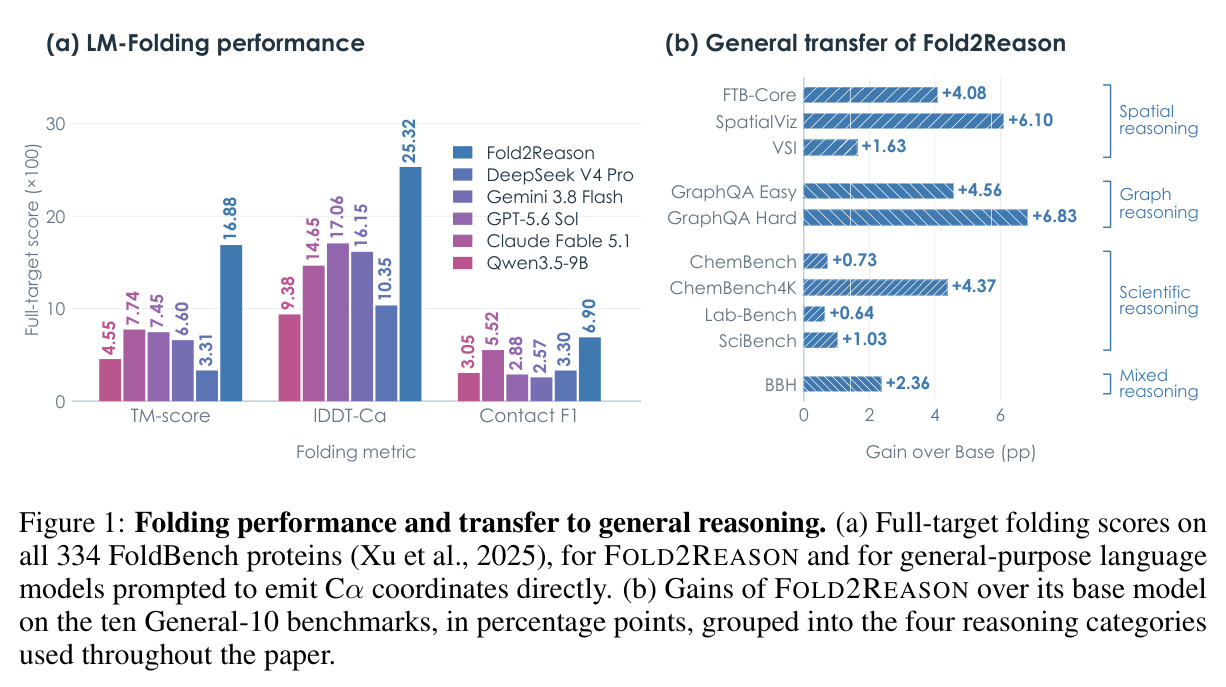
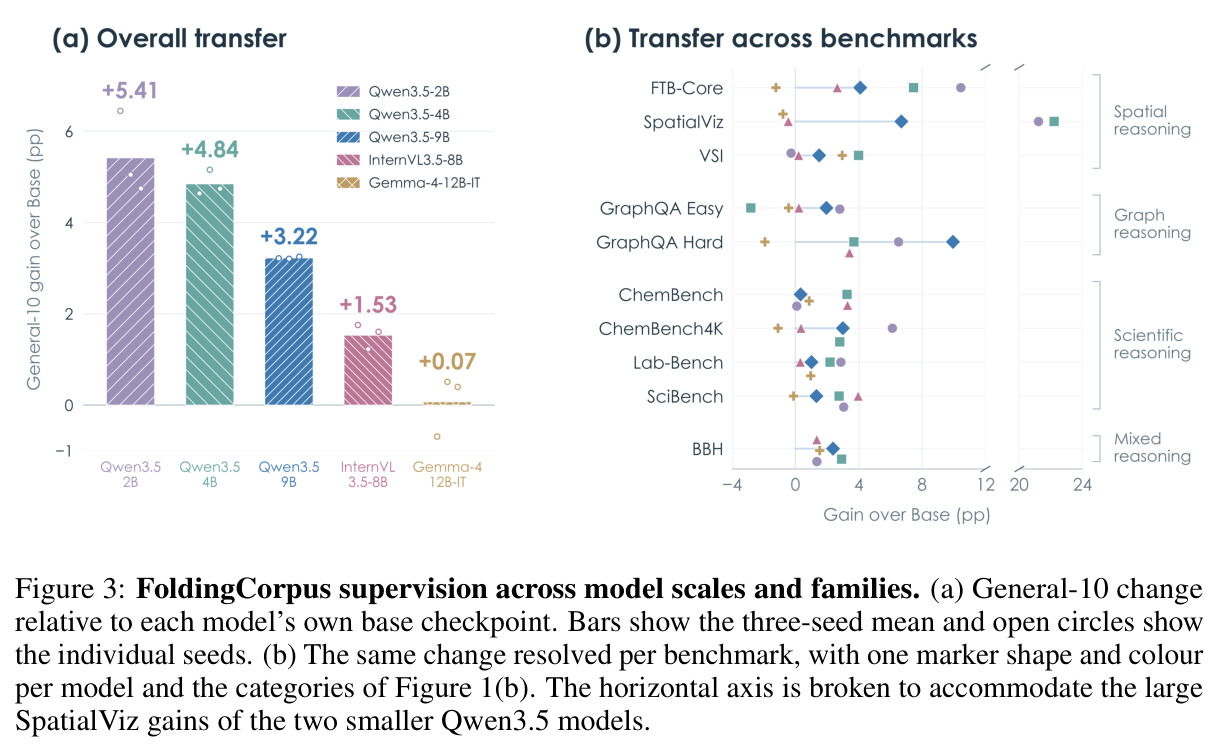
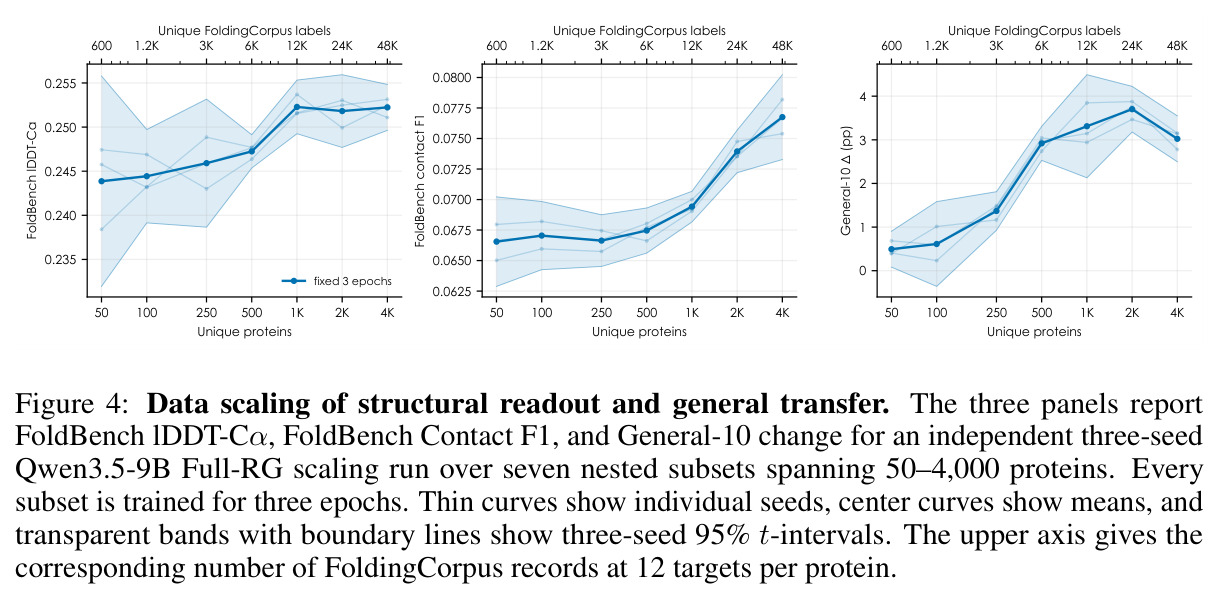
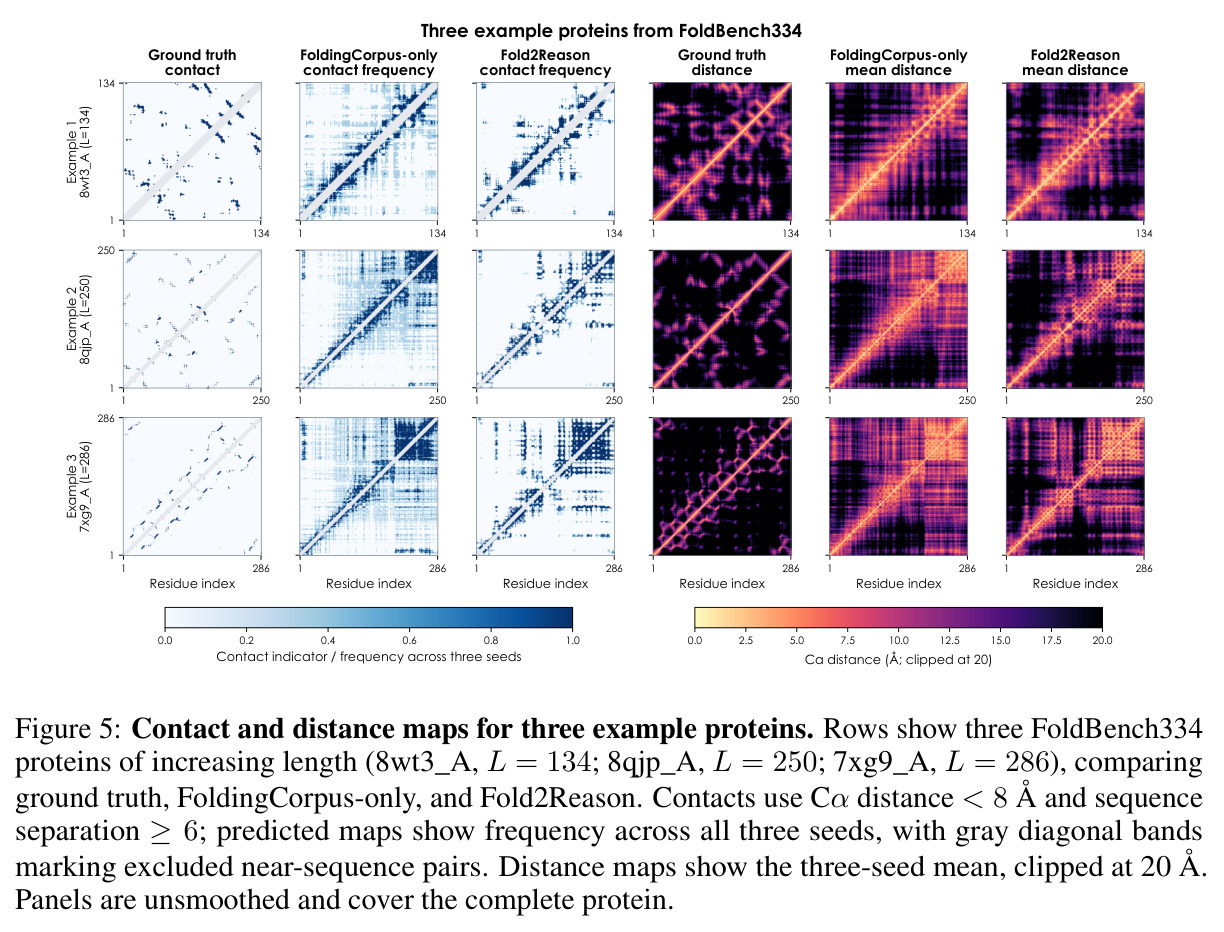
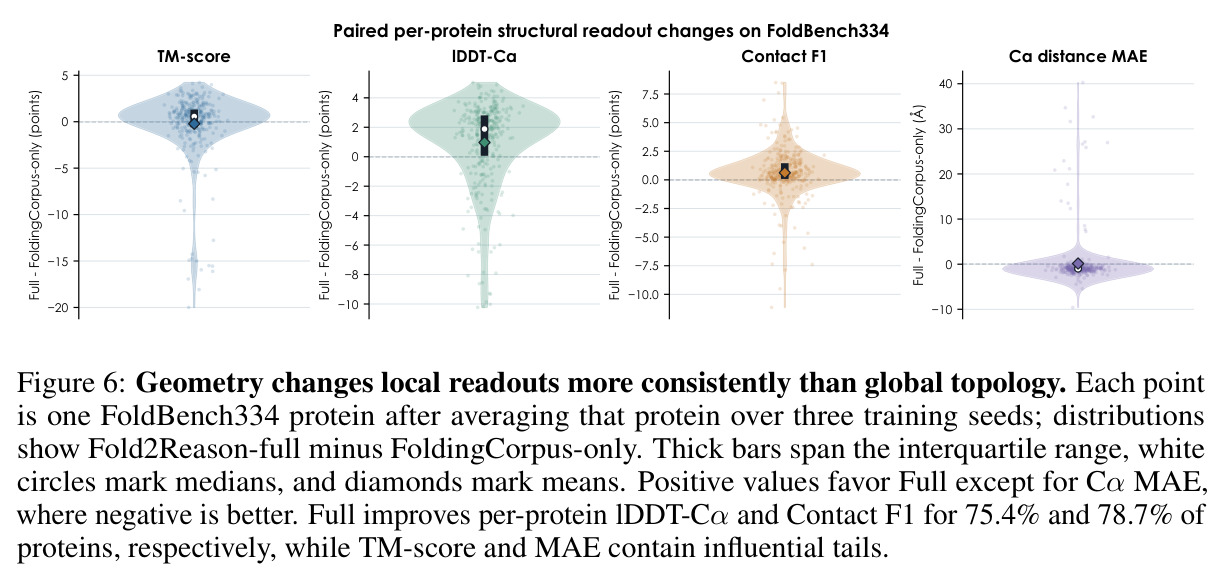
主实验:三个独立训练 adapter 上 General-10 宏观平均从 45.09% 升至 48.33%(+3.23 pp,SD 0.15),10 个数据集均值全正——GraphQA Hard +6.83、SpatialViz +6.10、GraphQA Easy +4.56、ChemBench4K +4.37、FTB-Core +4.08、BBH +2.36、VSI +1.63;剔除自建 FTB-Core 后仍 +3.14 pp。匹配对照:Hidden Geometry +0.92、Format Copy −0.09、Fixed Shuffle −0.27,真实蛋白增益超最强对照两倍,无法用答题格式解释。模型泛化:FoldingCorpus-only 在 Qwen3.5-2B/4B/9B 上分别 +5.41/+4.84/+3.22 pp,InternVL3.5-8B +1.53 pp,Gemma-4-12B-IT 中性(+0.07)。数据规模:50→4,000 蛋白固定 3 epochs,增益 0.49/0.61/1.37/2.92/3.31/3.70/3.02 pp,2,000 蛋白达峰;每蛋白标签 3/6/12 无单调剂量效应。消融:w/o Geometry +2.93、w/o FoldingCorpus 仅 +0.68;几何配对增量平均 +0.30 pp(种子间变号),集中在 3D 基准。折叠本身:Fold2Reason 在 FoldBench334 上 TM-score 16.88、lDDT-Cα 25.32、Contact F1 6.90(×100),为未适配基座(4.55/9.38/3.05)的 2.7–3.5 倍,但绝对值属『结构可解码』而非可靠重构;几何监督使 lDDT +0.00973、Contact F1 +0.00629 而 TM 不升,75.4%/78.7% 蛋白的 lDDT/Contact F1 逐蛋白改善,全局拓扑不变。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| General-10 宏观平均(10 项通用推理基准,76,725 题) | 准确率 (%) | 48.33 | 45.09(Qwen3.5-9B 基座) | +3.23 pp(SD 0.15) |
| GraphQA Hard(图结构推理) | 准确率 (%) | 39.48 | 32.65 | +6.83 pp |
| SpatialViz(图像空间推理) | 准确率 (%) | 32.71 | 26.61 | +6.10 pp |
| GraphQA Easy | 准确率 (%) | 69.70 | 65.14 | +4.56 pp |
| ChemBench4K(化学问答) | 准确率 (%) | 67.93 | 63.56 | +4.37 pp |
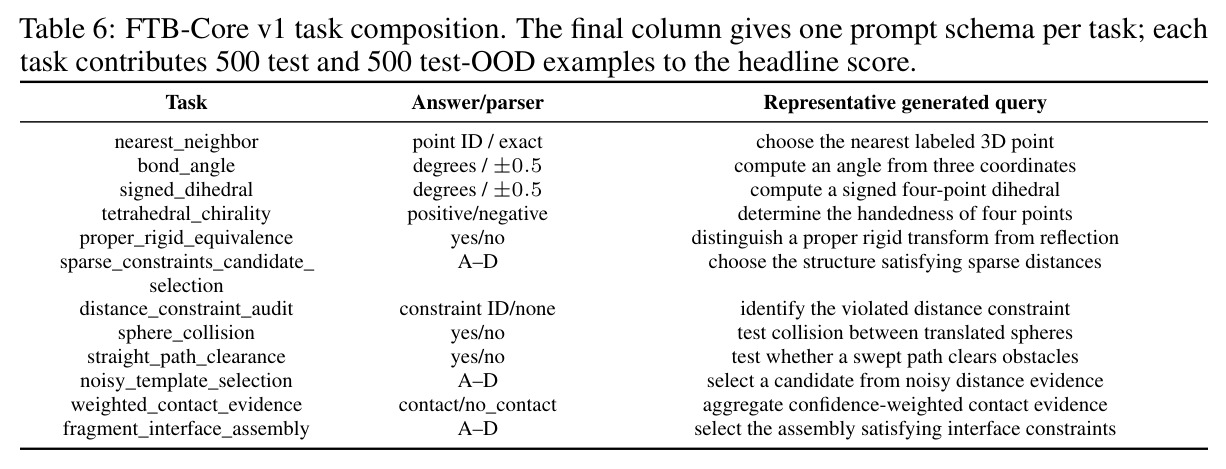
| FTB-Core(自建文本 3D 推理) | 准确率 (%) | 40.26 | 36.18 | +4.08 pp |
| BBH(混合推理) | 准确率 (%) | 56.81 | 54.45 | +2.36 pp |
| FoldBench334 全目标折叠 | TM-score (×100) | 16.88 | 4.55(未适配 Qwen3.5-9B 直接生成坐标) | 约 3.7 倍 |
| FoldBench334 全目标折叠 | lDDT-Cα (×100) | 25.32 | 9.38 | 约 2.7 倍 |
局限与改进
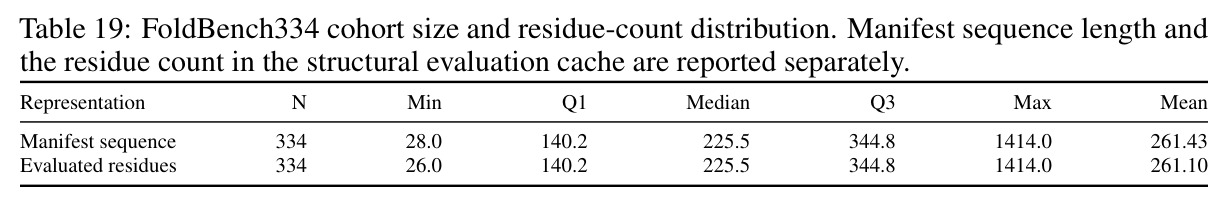
作者承认的局限:训练只用 1,000 个蛋白、rank-16 LoRA、3 个种子,+3.23 pp 属中等效应量;冻结解码器只测『结构可解码性』而非准确全局重构(TM-score 仅 0.169,距离可用折叠系统很远);数据隔离只做到精确序列与 5-mer 筛查(最大 5-mer Jaccard 0.02381),MMseqs2/CATH/SCOP 级远程同源隔离未验证,独立审计还在 scaling 池发现 6 个输入的模板接触约束源自 FoldBench 靶点、Smith–Waterman 比对发现 3 对 train–FoldBench 匹配;Gemma-4-12B-IT 完全中性说明存在架构依赖;机制未定——『可复用推理』『更可靠调用预训练能力』『渐进的答案格式适应』三种解释无法区分;FTB-Core 是自建基准且提示词清晰度缺人工校验。我的补充观察:几何增量 +0.30 pp 在三种子上变号(−0.15 到 +0.57),统计上脆弱;4,000 蛋白端点一个种子答案校准崩溃(准确率 0.128)提示训练不稳定被『迁移仍为正』掩盖;固定 3 epochs 使数据规模与优化步数同步增长(21→1,500 步),『2,000 蛋白达峰』混合了数据广度与算力两个因素无法归因;GraphQA Easy/Hard 合计 43,200 题占 General-10 过半,构成上偏图文推理;SciBench 基线仅 9.83%,在如此低的基线上 +1.03 pp 的实际意义存疑。
独立分析的弱点
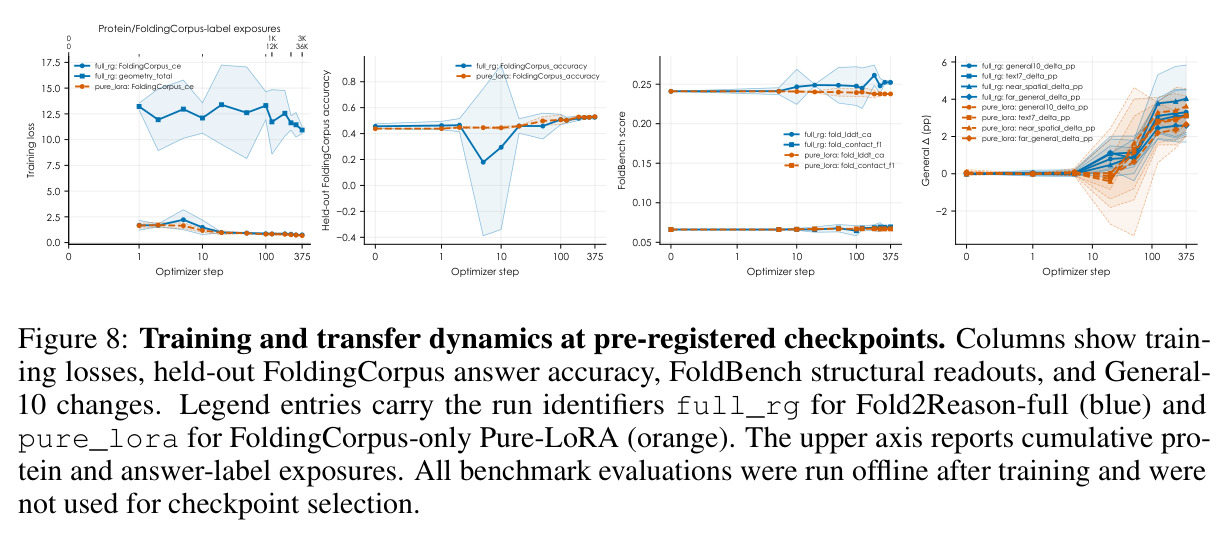
第一,机制解释缺位:+3.23 pp 可观但不大,且论文自己承认无法区分『学到新推理计算』与『更好地调用预训练已有能力』或『渐进格式适应』;checkpoint 轨迹显示增益随优化逐步发展(第 5 步约 0,第 375 步约 +3),这一时间模式既符合能力获取也符合格式适应。改进方向:用激活修补、LoRA 子空间分析定位被改变的回路,或训练后用文本指令做同样的结构任务看是否被激发。第二,架构依赖:Gemma-4-12B-IT 完全中性(+0.07,种子间有正有负),方法可能依赖 Qwen/InternVL 特定的预训练分布;改进:在 Llama、Mistral 等更多家族上测试并解剖 Gemma 失败原因(tokenizer、注意力模式还是训练动态)。第三,监督极度稀疏:每蛋白仅 12+1 个监督 token,32 路检索题的每个类别在训练中只出现 21–38 次,大量前向算力花在蛋白编码上;改进:探索稠密几何目标或对每蛋白采样更多算子实例并配课程。第四,规模曲线不纯:固定 3 epochs 让步数随数据同步增长,4K 池还悄悄放宽了质量门槛(平均 pLDDT 70/高置信占比 0.70,对比 2K 池的 80/0.80),『2,000 达峰』结论混杂两个变量;改进:固定步数扫数据、固定数据扫步数的解耦实验,并统一质量门槛。第五,蛋白长度仅 29–199 残基,长程空间推理未覆盖,几何读出对全局拓扑无改善;改进:在全长蛋白与更强解码器(如 IPA 式模块)上重做几何路径。
未来方向
作者提出的方向:扩展到更广的基准与语料、更强的几何解码器、更多架构;并把『已解决的科学问题』变成后训练监督的一般范式——分子构象、材料晶体、RNA 结构等同样能从已知结构生成可验证标签。基于本文成果可自然延伸的方向:(1) 机制研究——用因果干预确定蛋白质训练究竟改变了哪些计算,正面回答『可复用推理还是调用增强』;(2) 把离散结构问答升级为链式推理或强化学习:让模型先显式生成中间结构推理再作答,用可验证答案当 RL 奖励,检验结构信号的收益能否放大;(3) 训练编排研究——把折叠训练插入 SFT/RLHF 之前或之后,检验增益是否被后续训练保留;(4) 多源科学结构混合(蛋白+小分子+晶体)测试迁移是否叠加、是否存在干扰;(5) 越过 2,000 蛋白峰值后引入数据质量筛选、课程学习或更大底座,看峰值是否右移;(6) 把冻结几何读出当作低成本的表示质量诊断工具——无需推理即可监控模型内部结构信息的含量,这对训练监控本身就有实用价值。
复现评估
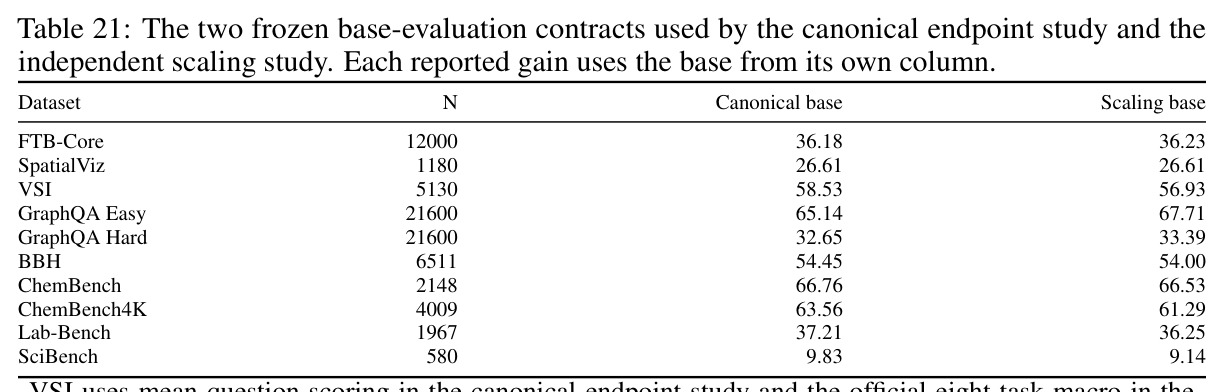
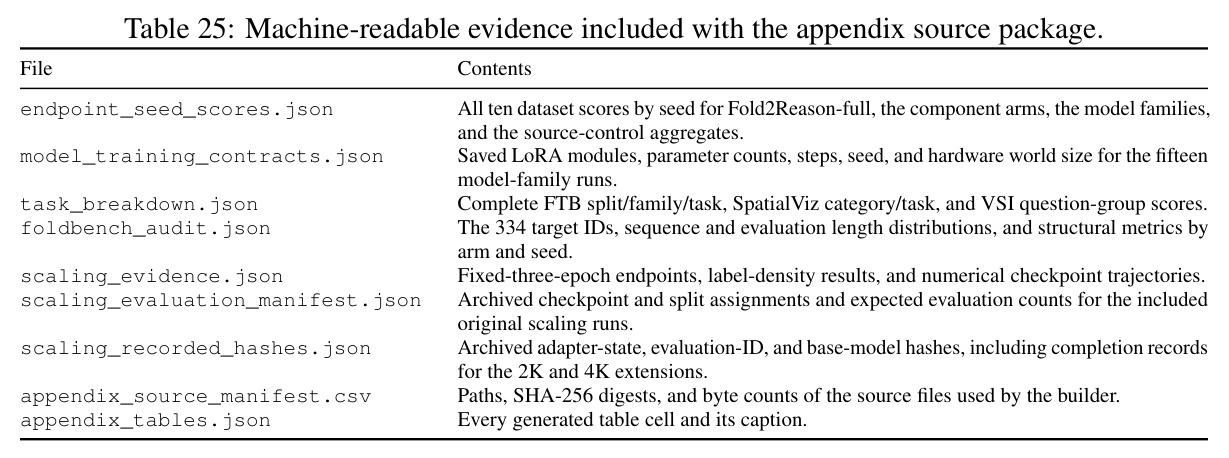
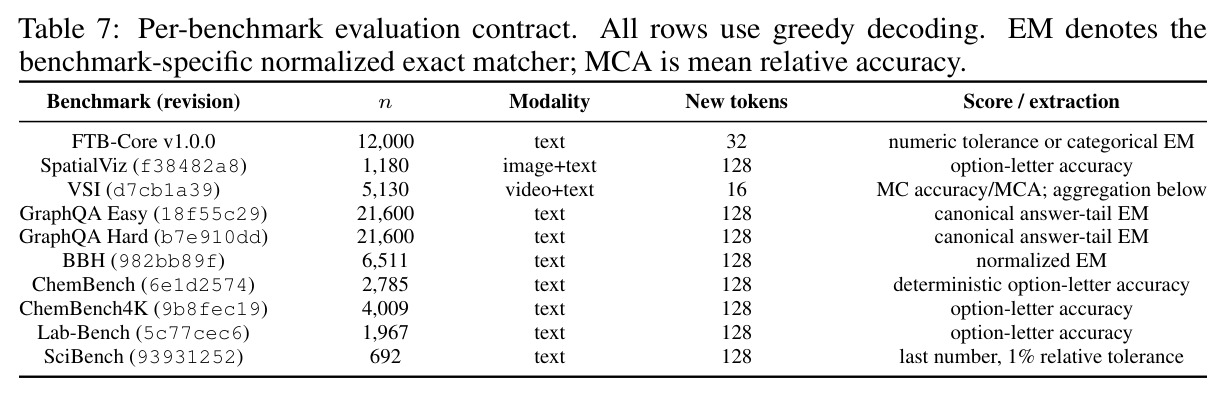
复现条件在同类研究中属于标杆水平。代码承诺开源于 github.com/GENTEL-lab/Fold2Reason;数据全部来自公开的 OpenFold 单体短蛋白集合与 PDB;FoldingCorpus 生成器、FTB-Core 生成器(SHA-256 前缀 52b2b1cf,2026-07-24 冻结)、全部渲染提示、解析器与校验脚本随发布;附录 N 提供 8 个机器可读证据文件(endpoint_seed_scores.json、foldbench_audit.json、scaling_evidence.json 等)及 SHA-256 清单,表格可从原始实验文件重建。算力门槛极低:4×A800-80G、3 epochs、375 步、每种子约 31.6 分钟,LoRA 仅 43.28M 参数,15 个模型族运行的单研究组即可完成。评估协议全部冻结(每个数据集的修订号、文件哈希、贪心解码、固定新 token 限额)。需要注意的坑:MSA/模板视图依赖 OpenFold 源对齐文件;精确种子复现依赖数据加载顺序;scaling 研究与主实验的评估契约不同(VSI 用官方八任务宏平均对比逐题平均);scaling 池存在已披露但未清理的模板重叠。综合评估:主干结果复现难度低,社区可快速验证或反驳其核心主张。
论文图表