PixelUMM:无编码器的图像与视频统一理解与生成模型 PixelUMM: Encoder-Free Unified Image and Video Understanding and Generation
以单层线性投影直连像素与共享骨干,无编码器统一图像与视频的理解和生成
前置知识
统一多模态模型(UMM)
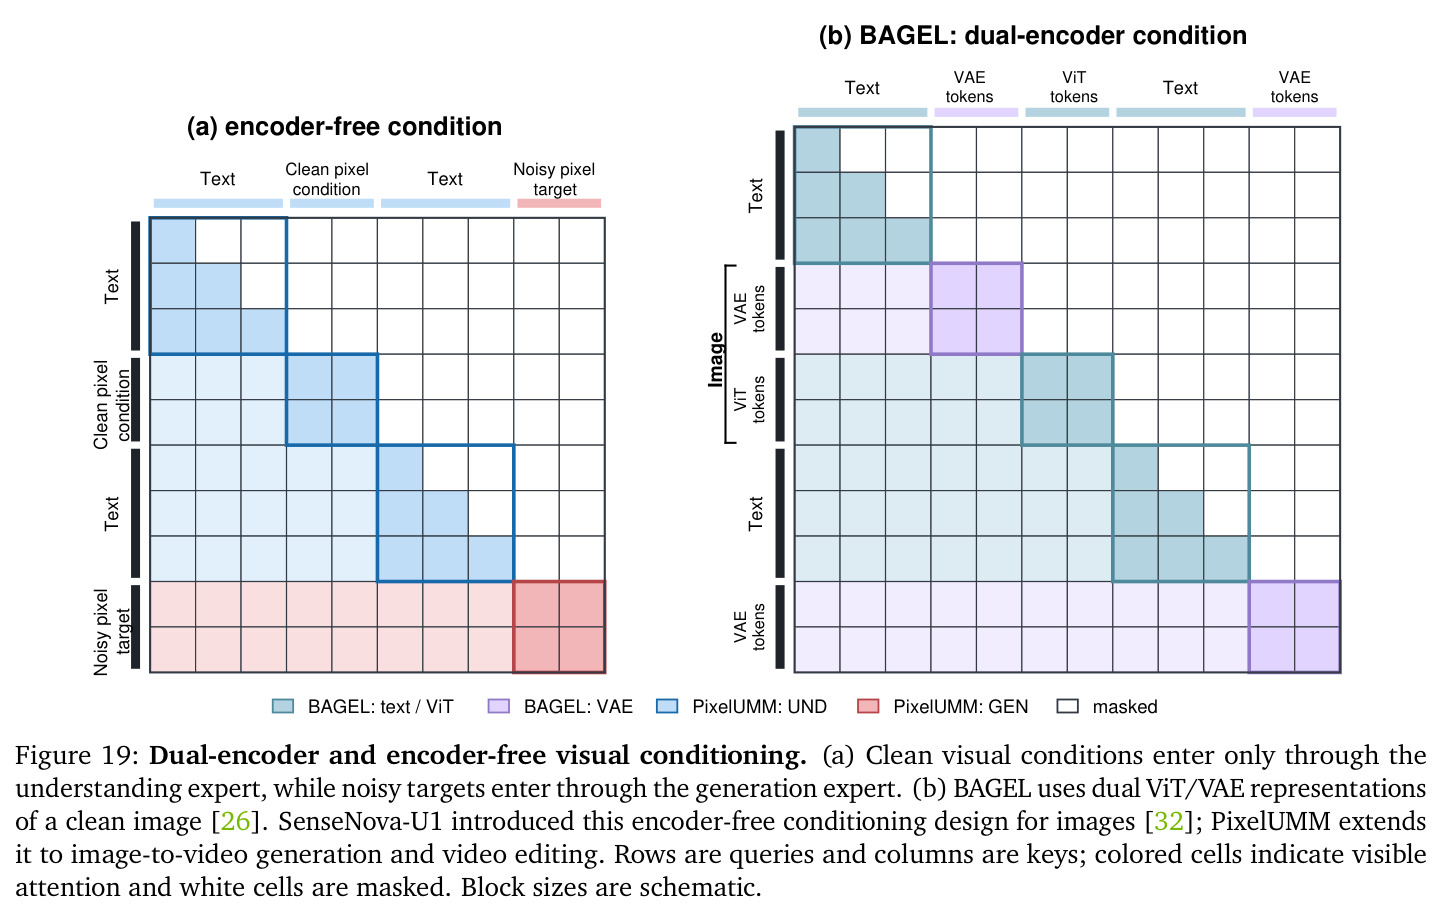
在单一模型中同时完成视觉理解(看图/看视频后用语言回答)与视觉生成(文生图/文生视频)的模型。代表工作 BAGEL 采用『双编码器接口』:ViT 提供语义特征服务理解,VAE 提供重建导向潜码服务生成,两路视觉表征通过不同的投影接入同一个多模态骨干,配合分块广义因果注意力统一自回归文本预测与扩散式视觉生成。
本文的核心命题就是『统一模型需要什么样的视觉接口』。PixelUMM 用单一像素接口取代双编码器,读懂它需要先理解 UMM 的任务集合与双编码器这一主流起点。
VAE 潜空间与双编码器接口的代价
VAE 把图像/视频压缩为低维连续潜码,是 Stable Diffusion、Wan2.2 等生成模型的标配。在 BAGEL 类统一模型中,每张条件图像会同时产出 ViT token 与干净 VAE token 两套视觉序列,使视觉上下文长度相对单视觉流近似翻倍,注意力计算与 KV cache 显存随之增加,且与 VLM 预训练常用的单一视觉流数据管线不兼容。
PixelUMM 的动机正是砍掉 VAE 这条重建通路:理解双编码器的上下文翻倍与管线改造成本,才能理解『无编码器』设计的价值所在。
流匹配与 JiT 清晰像素预测
流匹配(flow matching)训练一个速度场把高斯噪声连续输运到数据分布,训练时把干净样本 x 加噪为 $\mathbf{z}_t=(1-t)\mathbf{x}+t\epsilon$。JiT(Just image Transformer)提出 clean-pixel prediction:网络直接预测干净像素 $\hat{\mathbf{x}}_\theta$,损失在速度空间计算 $\mathbf{v}_\theta=(\mathbf{z}_t-\hat{\mathbf{x}}_\theta)/\bar{t}$,证明不做潜空间自编码也能生成高质量图像。
PixelUMM 的像素目标函数完全继承 JiT,并将其首次从图像扩展到视频生成;本文的 pixel objective 公式与 JiT 几乎一致。
Mixture-of-Transformers(MoT)
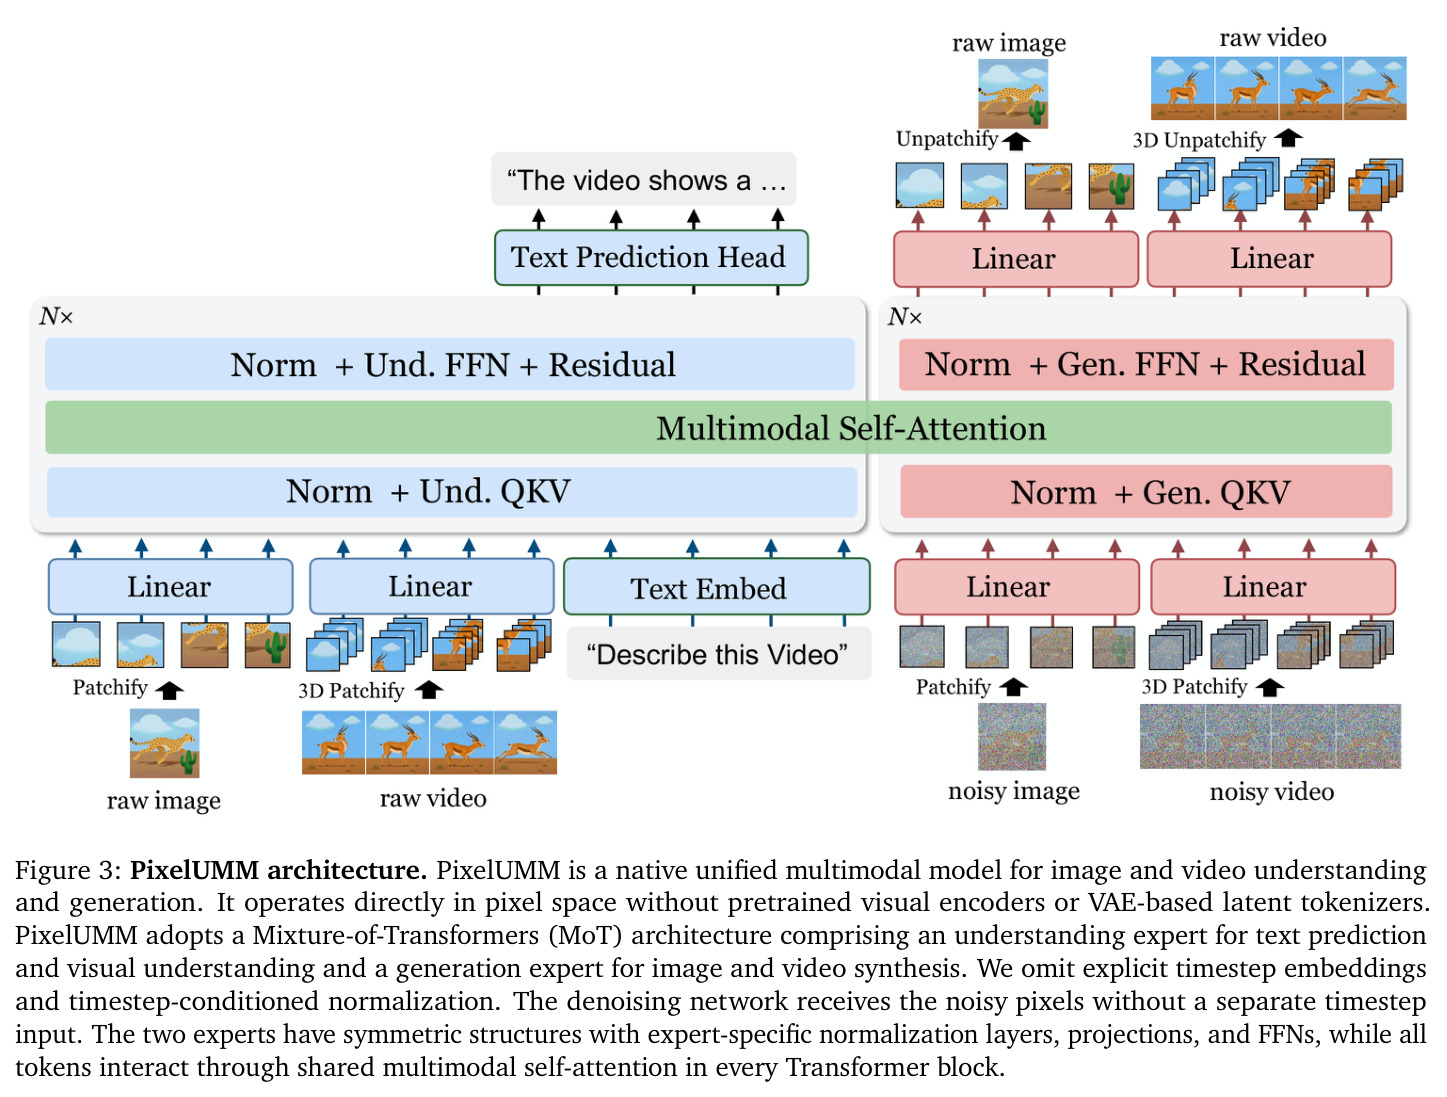
一种稀疏多模态架构:每层 Transformer 中所有 token 共享同一个自注意力操作,但不同模态/任务路由拥有各自的归一化层、QKV/输出投影与 FFN,按 token 硬路由。在 PixelUMM 中,文本与干净视觉 token 走理解路由,噪声视觉 token 走生成路由,两个专家结构对称。
MoT 是 PixelUMM 的骨干设计,理解专家与生成专家参数解耦但通过共享注意力交互,这是它缓解理解-生成任务冲突、同时保持单模型统一性的关键。
Tubelet(时空体素块)
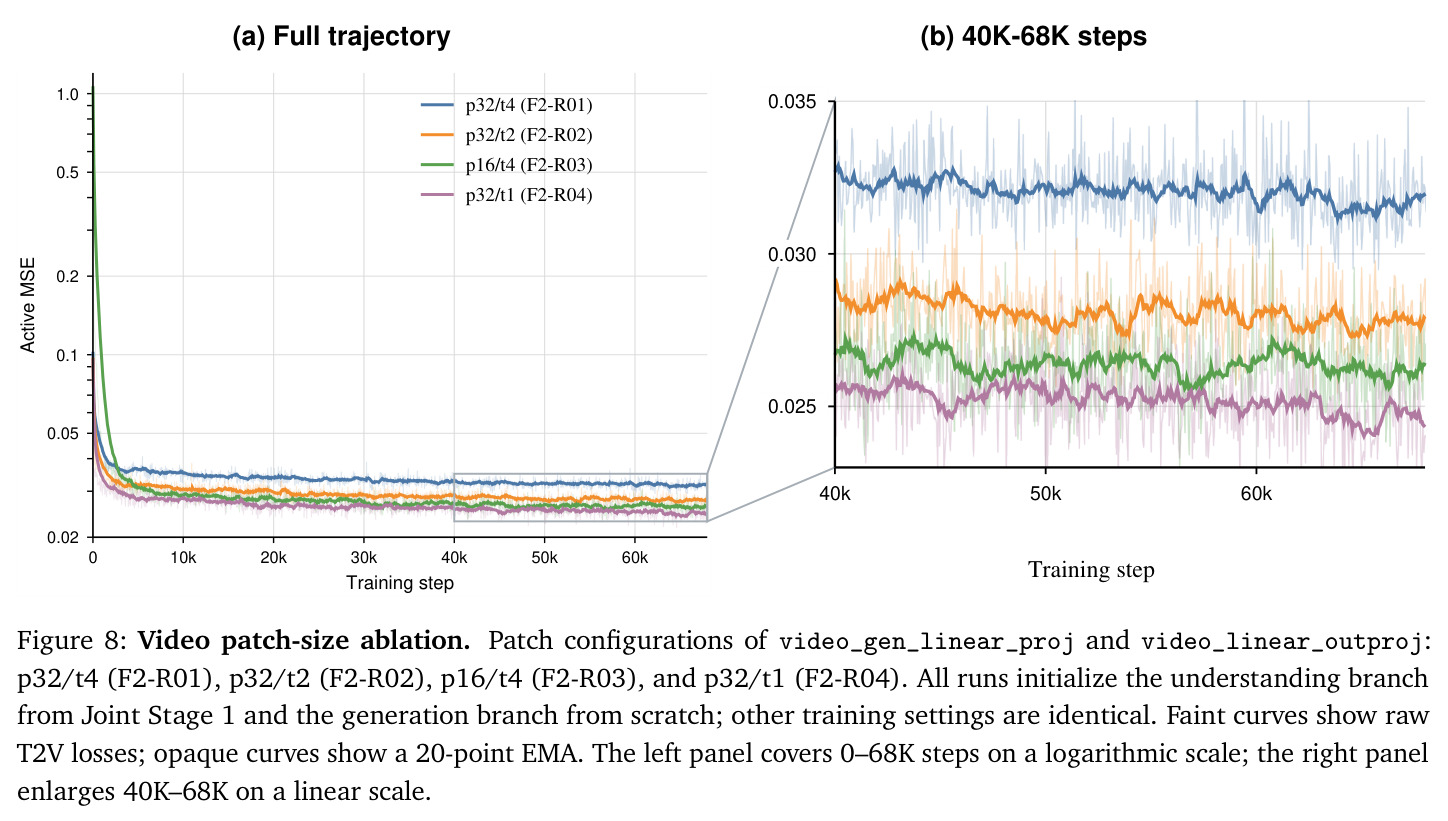
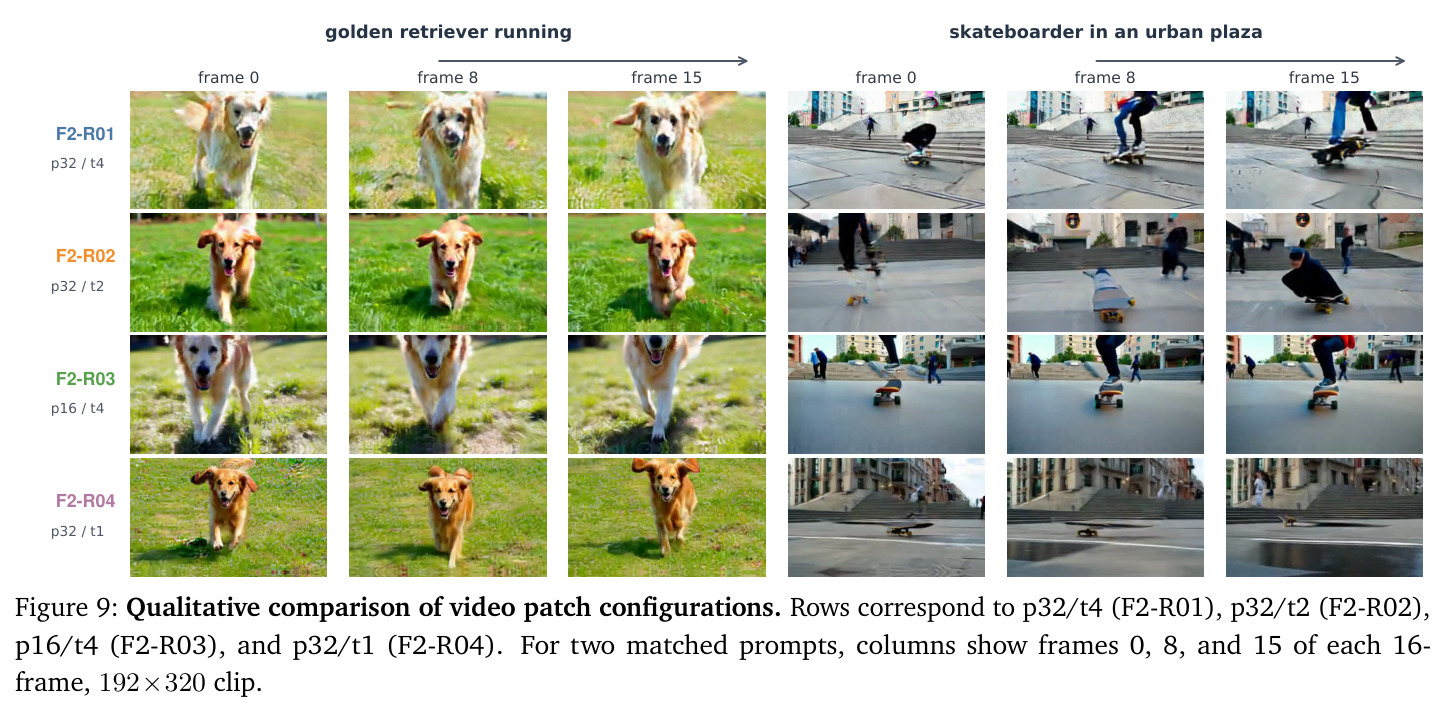
视频版 patch:把视频按 $\tau\times p\times p$(时间×高×宽)切成不重叠的 3D 块,每块经一层线性投影映射成一个 Transformer 隐藏 token。PixelUMM 用 $\tau=4, p=16$,即每个视频 token 压缩 $4\times16\times16\times3=3072$ 个 RGB 像素值;时间压缩比 t 与空间块大小 p 是可调的设计变量。
视频如何切成 token、时间与空间各压缩多少,直接决定序列长度与生成难度,是本文 F2(视频 patch 大小)与 F8(视频理解接口)两个消融的核心变量。
三轴 Native RoPE
把旋转位置编码(RoPE)的每个注意力头维度分配到时间、高、宽三条轴:PixelUMM 分一半给时间轴、高宽各占四分之一;文本 token 只沿时间轴推进(H=W=0),视觉 token 额外携带空间网格坐标,$\theta_H=\theta_W=10^4$、时间轴沿用 Qwen3 的 $\theta_T=10^6$。
统一模型要同时处理一维文本、二维图像与三维视频,三轴 RoPE 是像素接口下让模型区分时空位置、支持任意分辨率与时长的基础设施。
研究动机
统一多模态模型(UMM)长期依赖『理解一套、生成一套』的视觉表征。以 BAGEL 为代表的双编码器方案中,ViT 提供语义特征用于理解,VAE 提供重建导向潜码用于生成,每张条件图像同时贡献两套视觉 token,视觉上下文长度相对同分辨率的单流方案近似翻倍,直接推高注意力计算与 KV cache 显存;在多轮对话、长上下文场景(图像、视频帧、对话轮次不断累积)下代价尤其大。同时,主流视觉语言模型(VLM)预训练使用单一视觉流,引入 VAE token 需要大改数据管线与训练配方,使统一化难以嫁接到既有预训练流程上。扩展到视频时问题更突出:视频生成的惯例是因果 3D VAE(首帧单独编码),视频理解的惯例是用图像编码器逐帧独立处理,两种时序表征天然无法共享接口。因此,当社区想把 JiT/PixelDiT 开创的无编码器像素范式从图像推广到视频时,『统一视觉界面如何设计』成为悬而未决的开放问题。
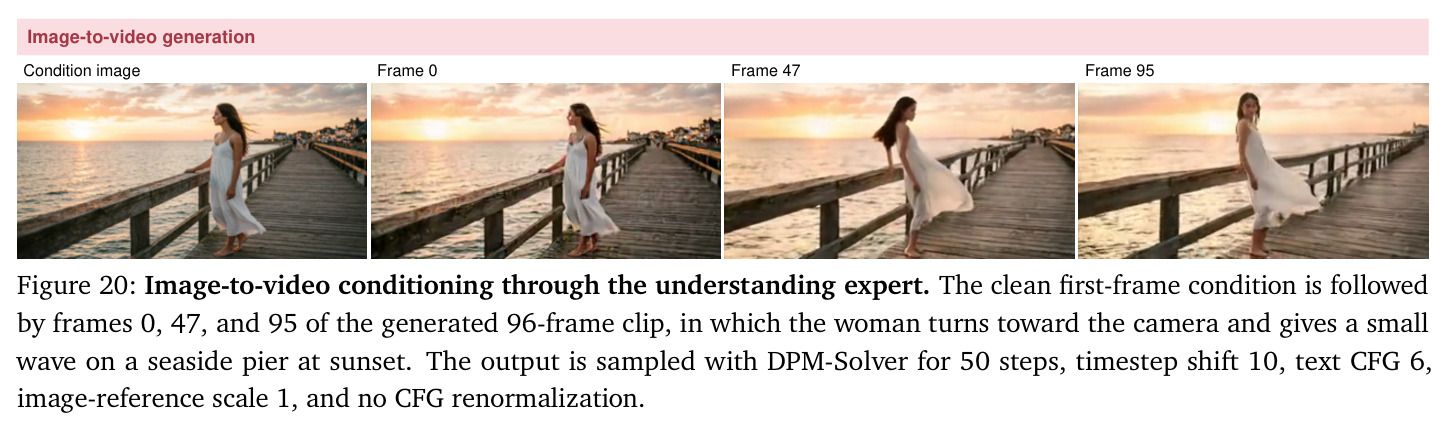
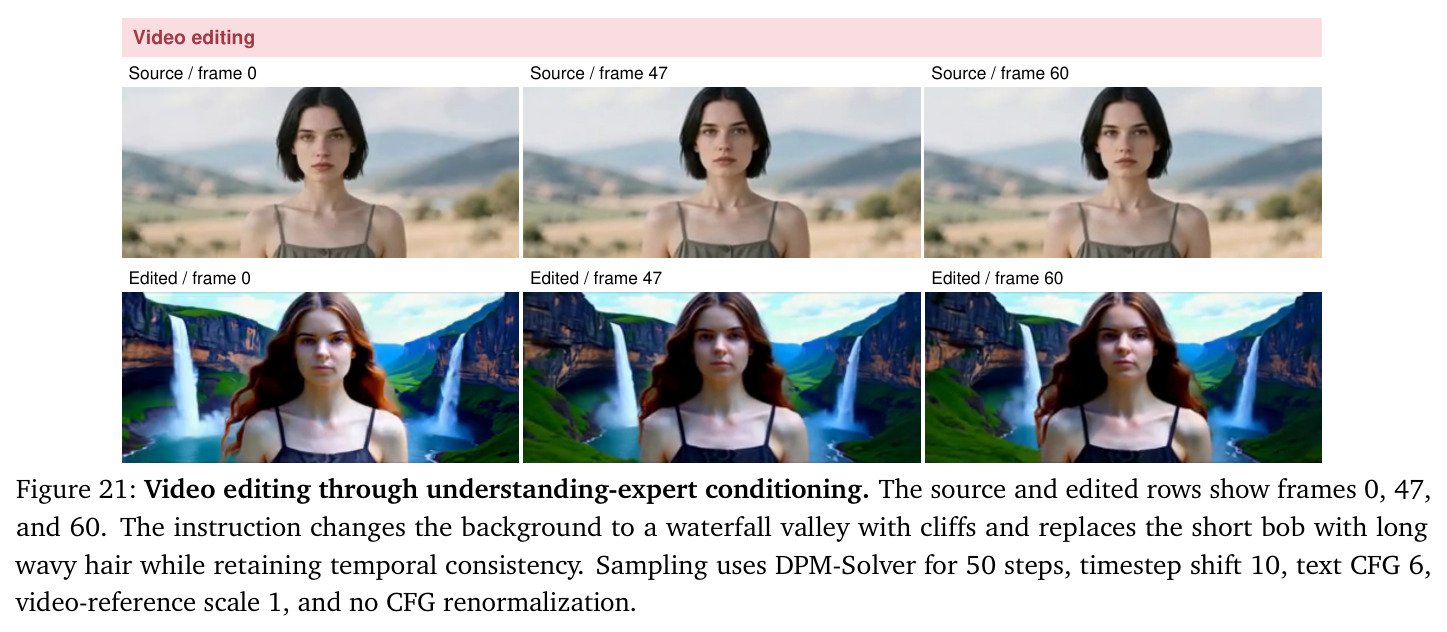
本文的目标是本文的目标是构建 PixelUMM:一个直接在像素空间工作的无编码器统一模型,同时覆盖图像与视频的理解和生成。具体目标包括四个层面。(1) 用单一视觉接口——图像表示为空间 patch、视频表示为时空 tubelet,仅经单层线性投影接入共享多模态骨干——统一支持图像理解(I2T)、视频理解(V2T)、文生图(T2I)、文生视频(T2V)四个核心任务,并扩展到图生视频(I2V)与视频编辑;(2) 验证 JiT 式清晰像素预测能否支撑视频生成,回答『像素范式能否从图像推广到视频』这一开放问题;(3) 在 Mixture-of-Transformers 骨干上联合训练自回归文本预测与像素空间流匹配,用干净视觉输入做理解、噪声视觉输入做生成;(4) 通过 F1–F8 受控消融系统研究图像/视频 patch 大小、解码器设计、像素 vs VAE 空间训练动态、模型规模、算力扩展、多模态条件注入与视频理解接口等设计选择,为后续像素空间统一模型提供可复用的经验,并在各项基准上取得与基线相当的竞争力。
与已有工作不同的是,已有工作各占一角:JiT、PixelDiT 证明图像可以不做潜空间自编码直接在像素空间生成;TUNA-2、SenseNova-U1/U1.5 把无编码器像素接口推进到统一的图像理解+生成,但都未覆盖视频;Cosmos 3 等虽用 MoT 架构统一多模态,仍依赖 VAE 类潜表征。本文的独特切入是补齐『视频』这块拼图:不从任何预训练视觉编码器或视频 VAE 继承接口,而是显式重新设计输入嵌入器与输出解码器——图像做 2D patchify、视频做 3D patchify(τ=4、p=16 的 tubelet),首次把 JiT 的 clean-pixel 预测扩展到视频生成。同时保留 BAGEL 的分块广义因果注意力与 MoT 骨干,但序列中只有文本 token 与干净/噪声像素 token,既无 VAE 潜码也无 ViT 特征。另一个差异化选择是彻底省去显式时间步嵌入与时间步条件化的 AdaLN(跟随 MiniT2I),让去噪网络从含噪像素自身推断损坏程度,使生成分支与语言骨干的接口差异降到最小。
核心方法
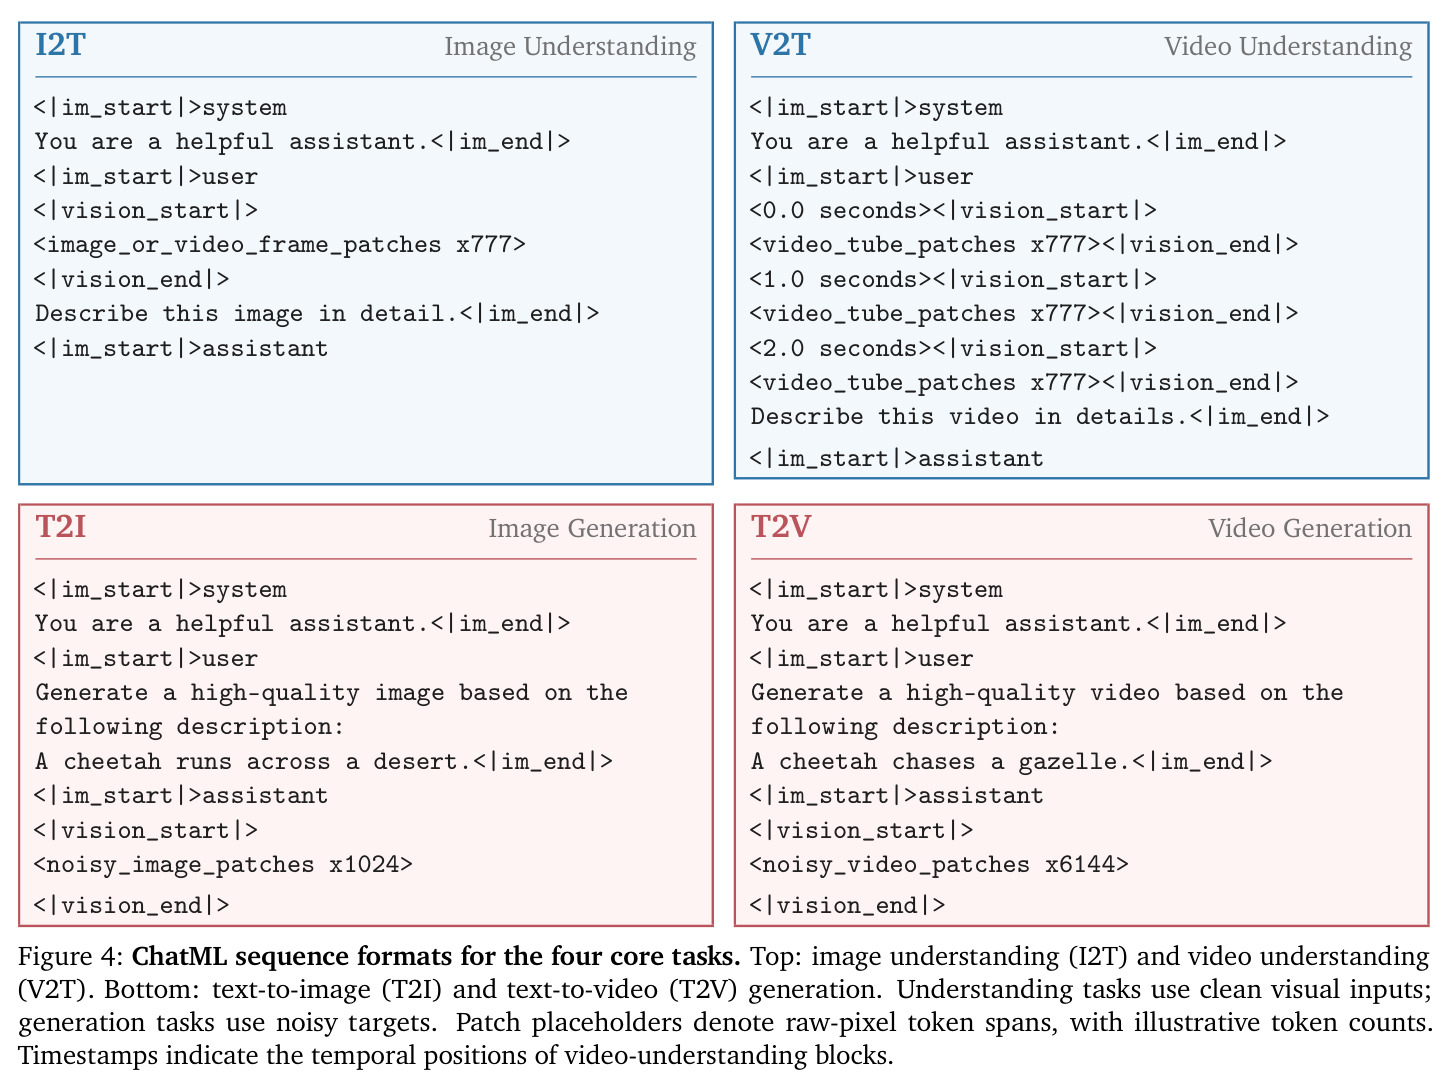
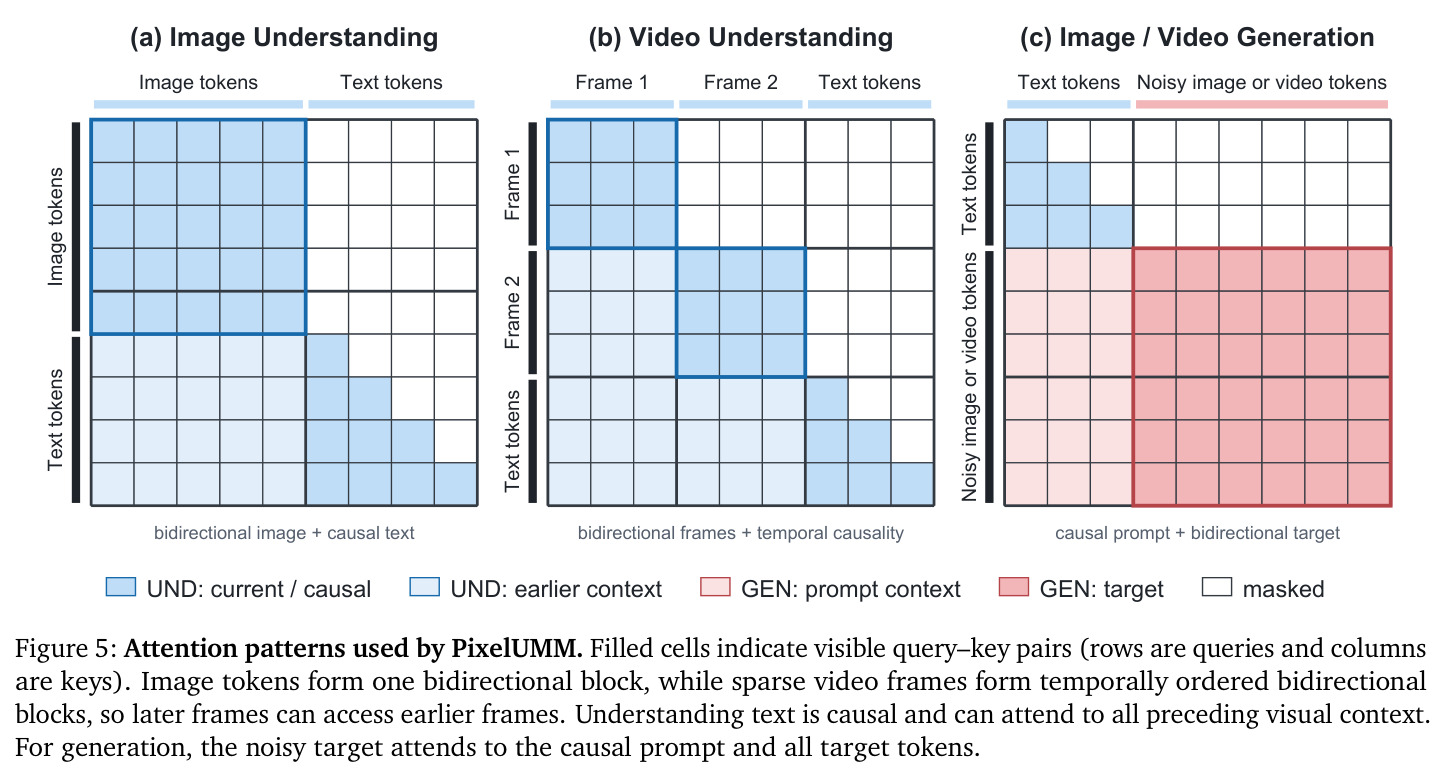
直觉上,PixelUMM 想让『原始像素』成为理解与生成共享的唯一视觉语言:理解时,干净的图像/视频经线性投影进入模型并输出文本;生成时,模型在像素空间做流匹配去噪,直接还原像素。技术路线分四步。第一步,视觉接口:图像 $x^{img}\in\mathbb{R}^{H\times W\times 3}$ 做不重叠的 $16\times16$ 二维 patchify,视频 $x^{video}\in\mathbb{R}^{F\times H\times W\times 3}$ 做 $4\times16\times16$ 三维 patchify 成 tubelet,各经一层线性投影映射到隐藏维度 $d$(理解与生成各有一套投影参数);输出端用 RMSNorm 加反向线性投影还原像素,输出投影零初始化;全模型没有 ViT、VAE 或离散视觉 tokenizer,像素与骨干之间只有单层线性投影和确定性的 patchify/unpatchify。第二步,骨干:从 Qwen3 解码器初始化的 Mixture-of-Transformers,理解与生成两个专家拥有各自的归一化、QKV/输出投影与 FFN,所有 token 在每层共享多模态自注意力;不使用显式时间步嵌入。第三步,序列与注意力:ChatML 序列化四任务,广义因果注意力——文本块内因果、视觉块内双向,生成目标可看全部因果 prompt 且目标块内双向。第四步,目标函数:文本只对 assistant token 算交叉熵;像素按 JiT 预测干净像素并在速度空间算 MSE;总损失 $\mathcal{L}=\lambda_{CE}\mathcal{L}_{CE}+\lambda_{img}\mathcal{L}_{img}+\lambda_{vid}\mathcal{L}_{vid}$,经六个阶段渐进训练从 256² 逐步升到 512²。
核心创新是『一个像素接口管四种任务』。与 BAGEL 的本质区别:BAGEL 每张条件图同时产生 ViT 与干净 VAE 两套 token(视觉上下文翻倍),PixelUMM 只有单流像素 token——干净像素走理解投影、噪声目标走生成投影,两者共享同一骨干与注意力,视觉 token 数与 KV cache 直接减半,且与 VLM 预训练的单视觉流管线天然兼容。与 TUNA-2/SenseNova-U1 的区别:它们只统一了图像,本文证明像素范式可以延伸到视频——tubelet(τ=4、p=16,每 token 压缩 3072 个像素值)与图像 patch 一样只用单层线性投影接入;视频理解还提供两种模式:dense_mode(源帧率≥4FPS 时按 4FPS 采样并 3D patchify 成 tubelet)与 sparse_mode(低于 4FPS 时按 1FPS 采样、逐帧独立投影),避免为凑 tubelet 而重复低帧率帧。第三,彻底去掉显式时间步条件(无 timestep embedding、无 AdaLN),去噪网络直接从含噪像素推断损坏程度 t,架构更贴近纯语言骨干。第四,目标函数把 JiT 的 clean-pixel 预测推广到视频:网络预测干净像素 $\hat{x}_\theta$,损失在速度空间计算 $\mathbf{v}_\theta=(\mathbf{z}_t-\hat{x}_\theta)/\bar{t}$、目标速度 $\mathbf{v}^\star=(\mathbf{z}_t-x)/\bar{t}$,其中 $\bar{t}=\max(t,0.05)$ 防止小时间步数值爆炸;平方速度误差先对活跃像素、再对活跃视觉 token、最后对媒体条目取平均。
方法步骤详情
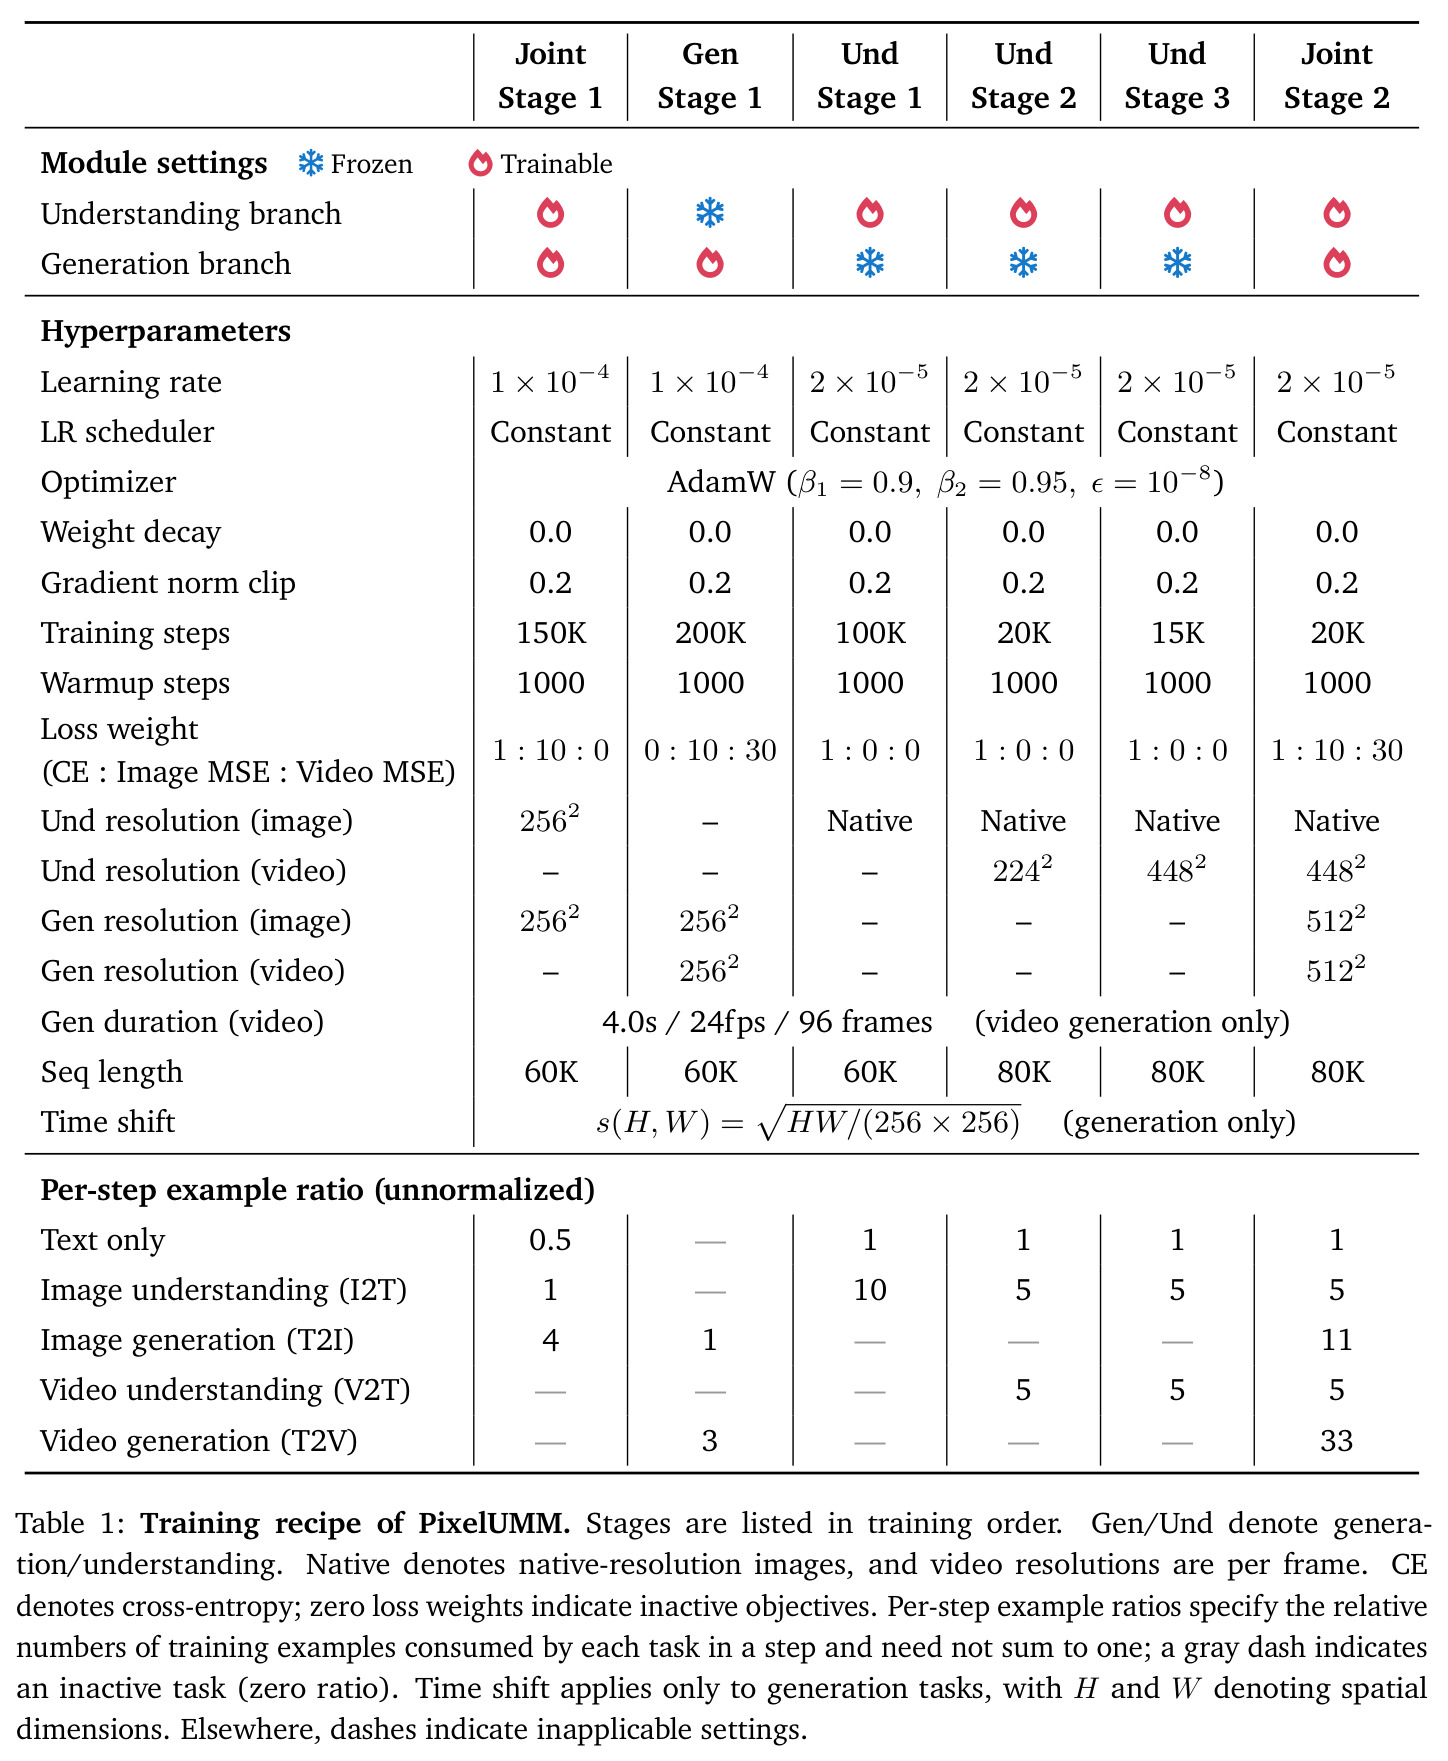
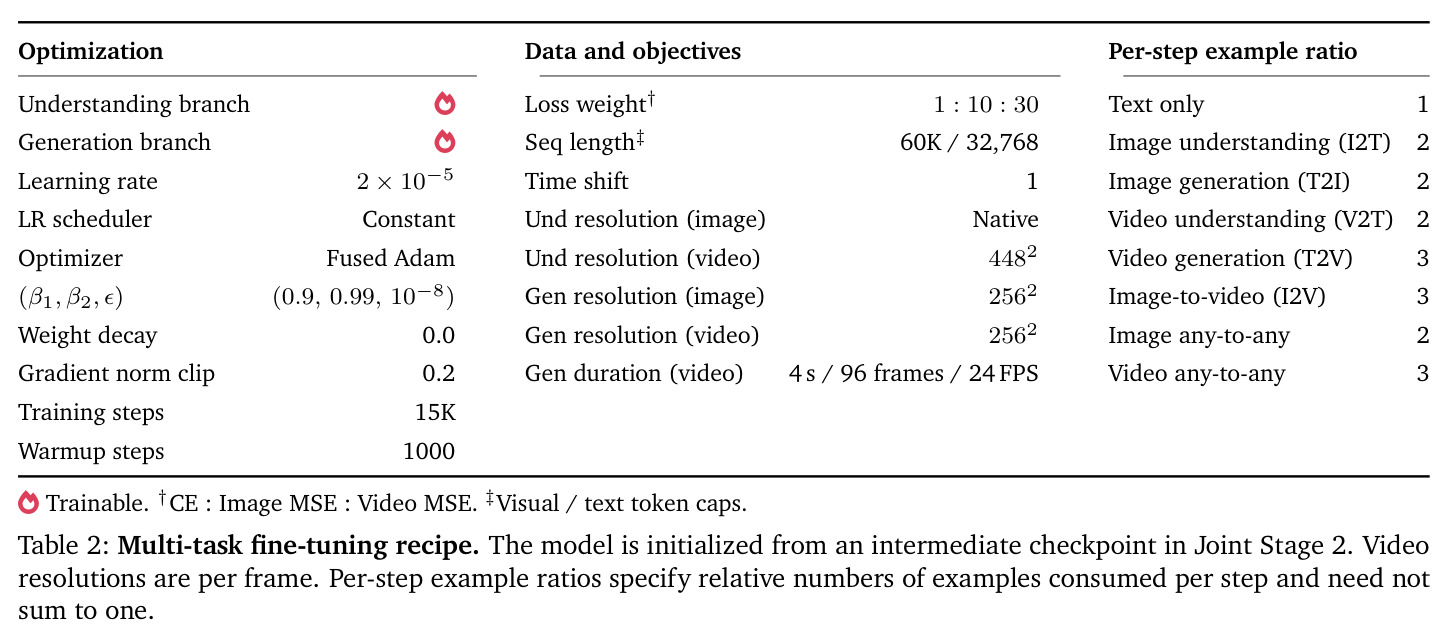
训练分六个阶段(Table 1)。阶段一 Joint Stage 1:从 Qwen3 初始化,混训纯文本+图像理解+文生图 150K 步,图像 256²,学习率 1e-4,损失权重 CE:图MSE:视频MSE=1:10:0,序列长度 60K,每步示例比 text:I2T:T2I=0.5:1:4。阶段二 Gen Stage 1:只训生成分支,T2I+T2V 200K 步(256²,视频 4.0s/24fps/96 帧),权重 0:10:30。阶段三 Und Stage 1:纯文本+原生分辨率图像理解 100K 步,学习率降至 2e-5。阶段四/五 Und Stage 2/3:加入视频理解,先 224² 训 20K 步、再 448² 训 15K 步,比例 text:I2T:V2T=1:5:5。阶段六 Joint Stage 2:全部任务联训 20K 步——T2I/T2V 升至 512²、视频理解 448²、权重 1:10:30、比例 text:I2T:V2T:T2I:T2V=1:5:5:11:33,序列长度 80K。所有阶段 AdamW($\beta_1=0.9$、$\beta_2=0.95$、$\epsilon=10^{-8}$)、权重衰减 0、梯度裁剪 0.2、常数学习率、1000 步 warmup;生成任务用时间偏移 $s(H,W)=\sqrt{HW/(256\times256)}$。数据:图像理解用 FineVision,视频理解用 VideoChat-Flash 集合与 LLaVA-Video-178K,生成用公开真实+合成数据。位置编码为三轴 Native RoPE:每头一半维度给时间轴、高宽各四分之一,$\theta_H=\theta_W=10^4$、$\theta_T=10^6$。理解用 FlexAttention 实现掩码;生成用两次变长 FlashAttention(一次因果处理 prompt,一次双向让噪声目标 token 看 prompt 与完整目标块)。另有可选多任务微调阶段(Table 2):从 Joint Stage 2 中间检查点出发,8 个任务(含图像/视频编辑、I2V、any-to-any)再训 15K 步,学习率 2e-5,赋予条件生成能力。
技术新颖性
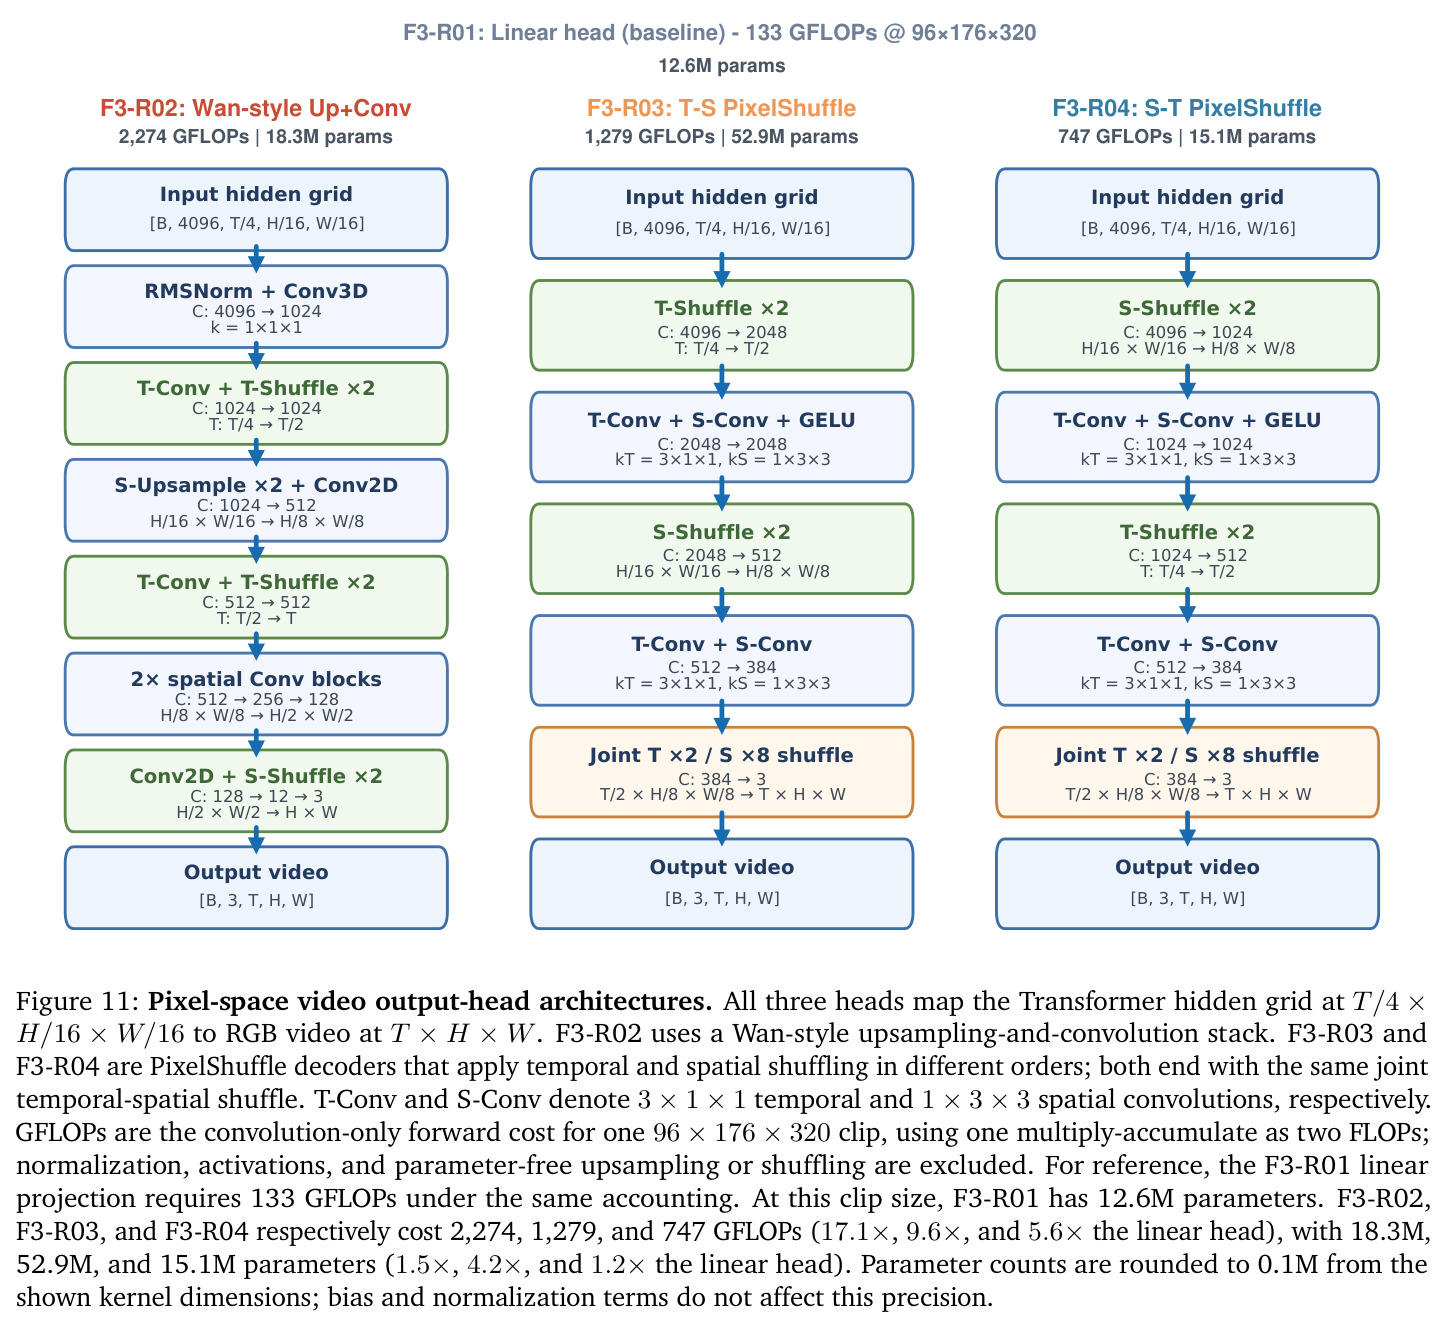
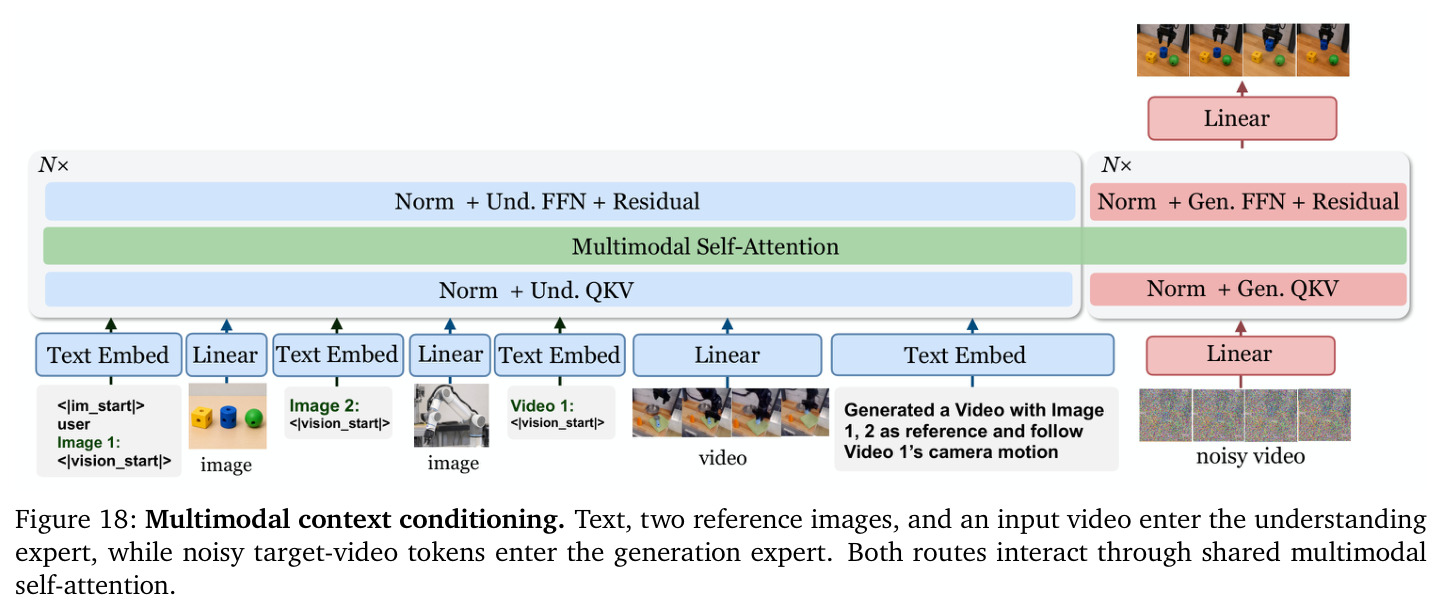
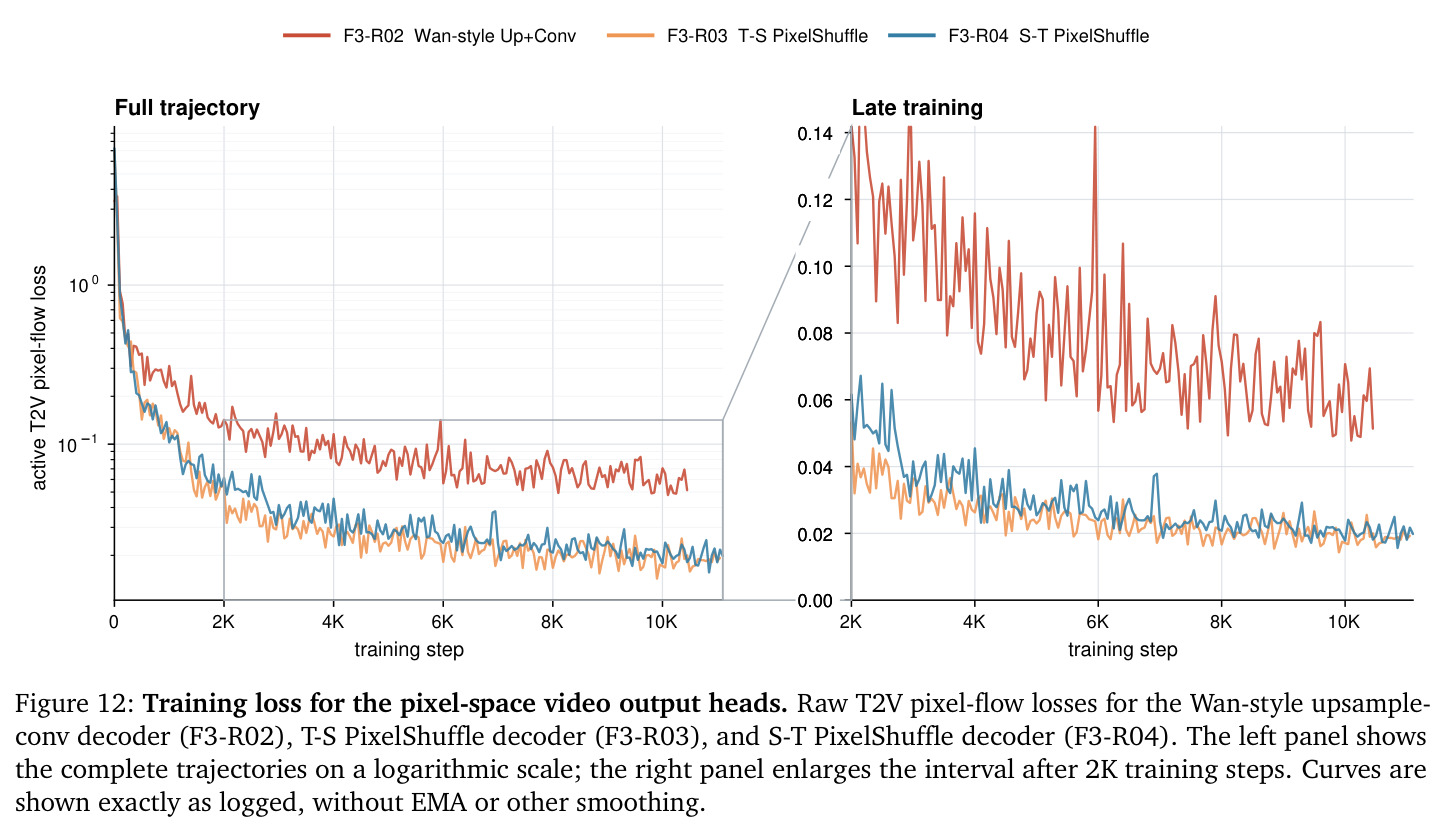
技术新颖性有四点。(1) 范式扩展:首个把无编码器像素空间统一范式从图像推进到视频的工作——此前 JiT/PixelDiT 只做像素生成、TUNA-2/SenseNova-U1 只统一图像,PixelUMM 首次让单流原始像素接口同时覆盖图像与视频的理解和生成。(2) 设计空间的经验刻画:F1–F8 消融是像素统一模型领域少见的系统受控实验,覆盖图像/视频 patch 大小(16²vs32²;p32/t4、p32/t2、p16/t4、p32/t1 四种 tubelet)、输出头设计(线性 133 GFLOPs vs Wan 风格上采样卷积 2274 GFLOPs vs T-S/S-T PixelShuffle 1279/747 GFLOPs)、像素 vs VAE 空间训练动态、1.7B→8B 模型规模、8→128 GPU 算力、条件注入方式与视频理解接口,并提炼出『时空压缩越弱生成损失越低』『卷积头抑制网格伪影』『加卡对 CE 收益(约 9×)远大于 MSE(约 1.3×)』等可迁移结论。(3) 无时间步条件的去噪:把 MiniT2I 的省略思路用于图像+视频统一模型,去掉 timestep embedding 与 AdaLN,网络从噪声像素自推断损坏程度。(4) 编码器免条件注入:将 SenseNova-U1 的『干净条件走理解专家、噪声目标走生成专家』从图像推广到 I2V 与视频编辑,保持单流视觉上下文,避免 BAGEL 双流的 KV 膨胀;并用 F7 实验证明学这种条件注入不会系统性损害理解能力。
实验结果
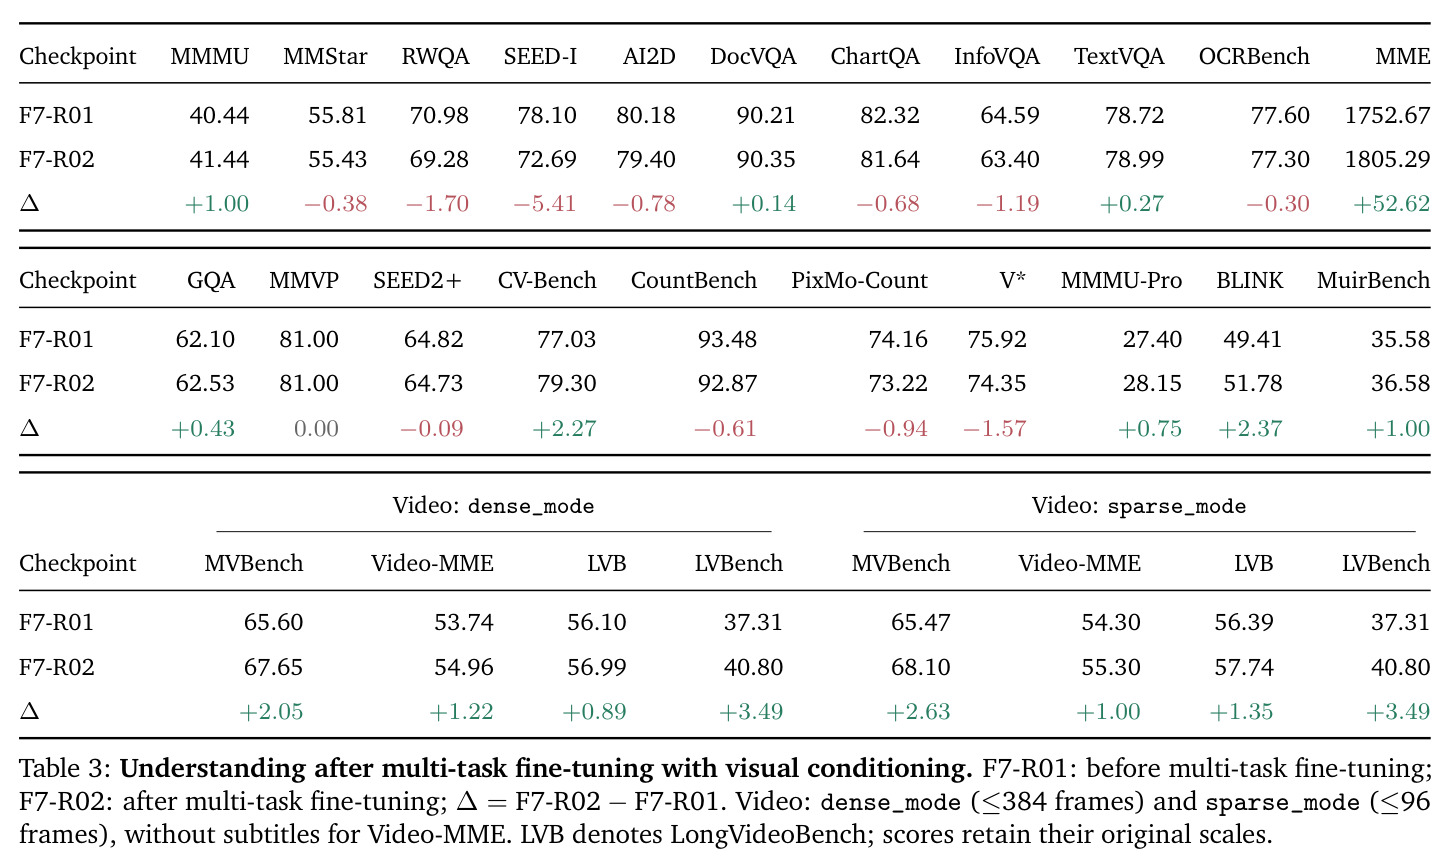
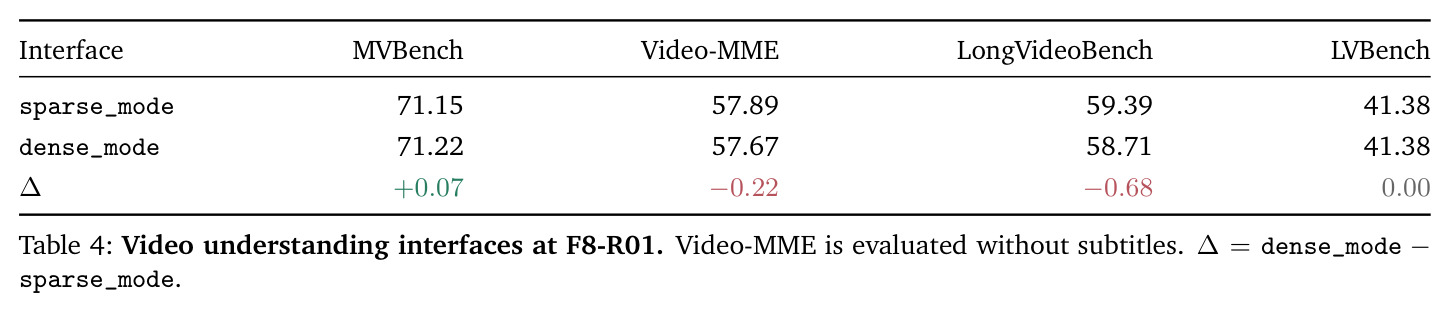
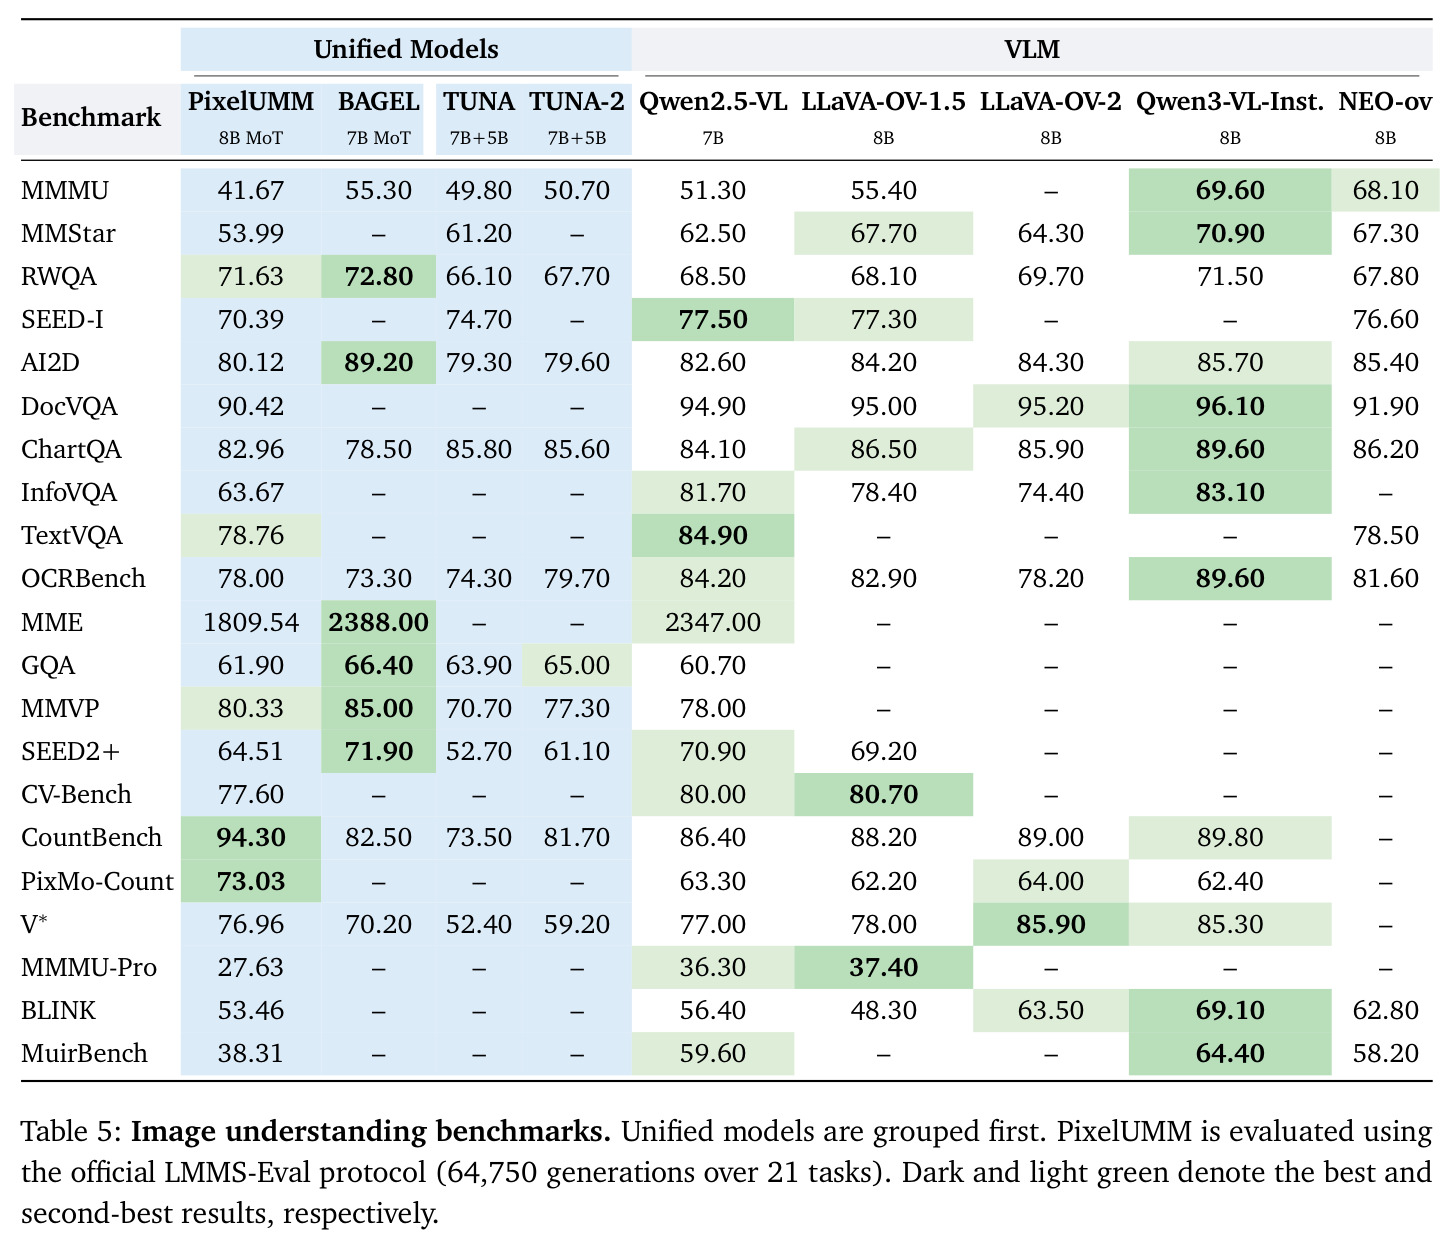
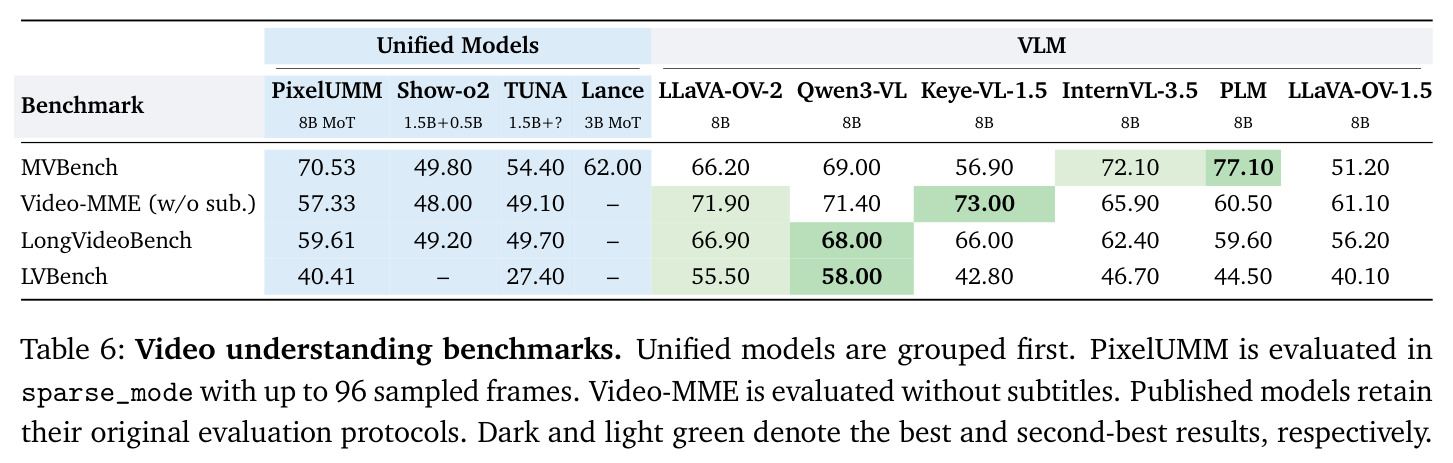
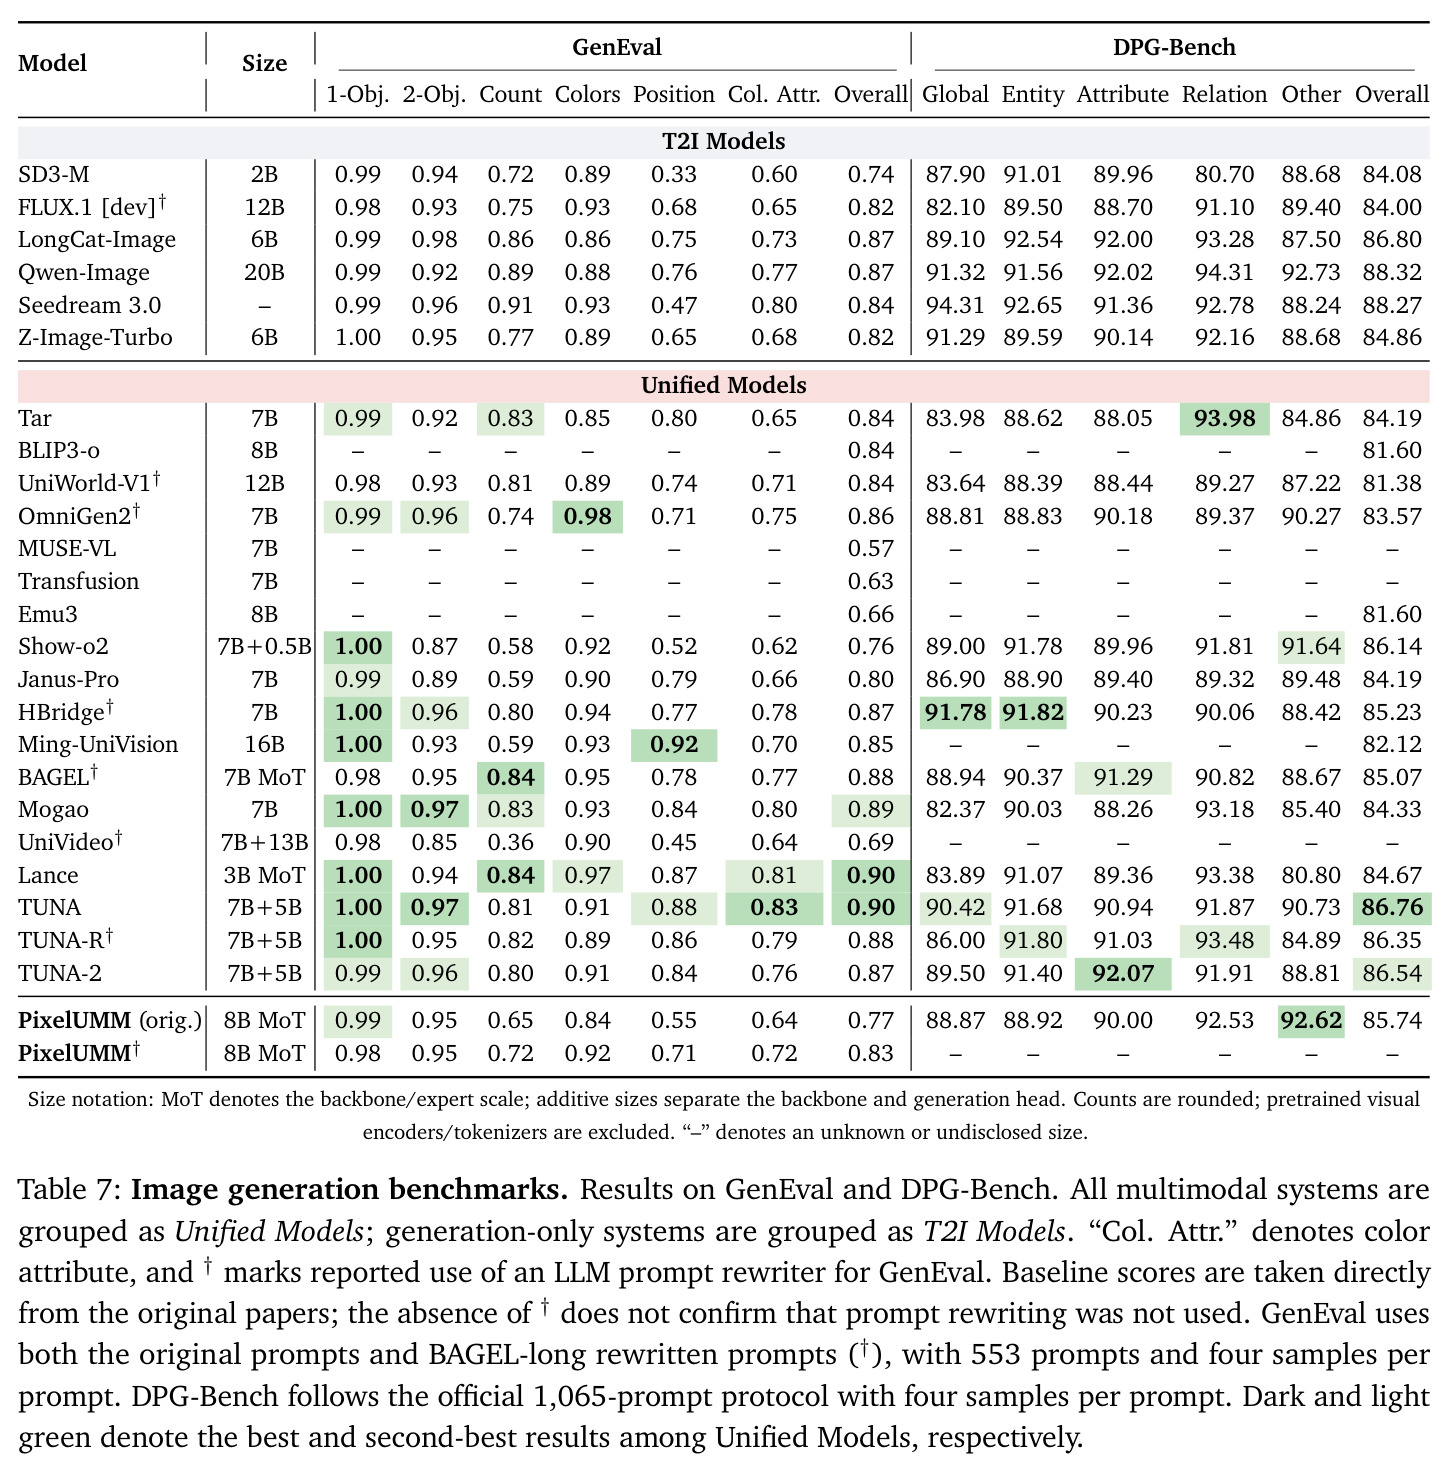
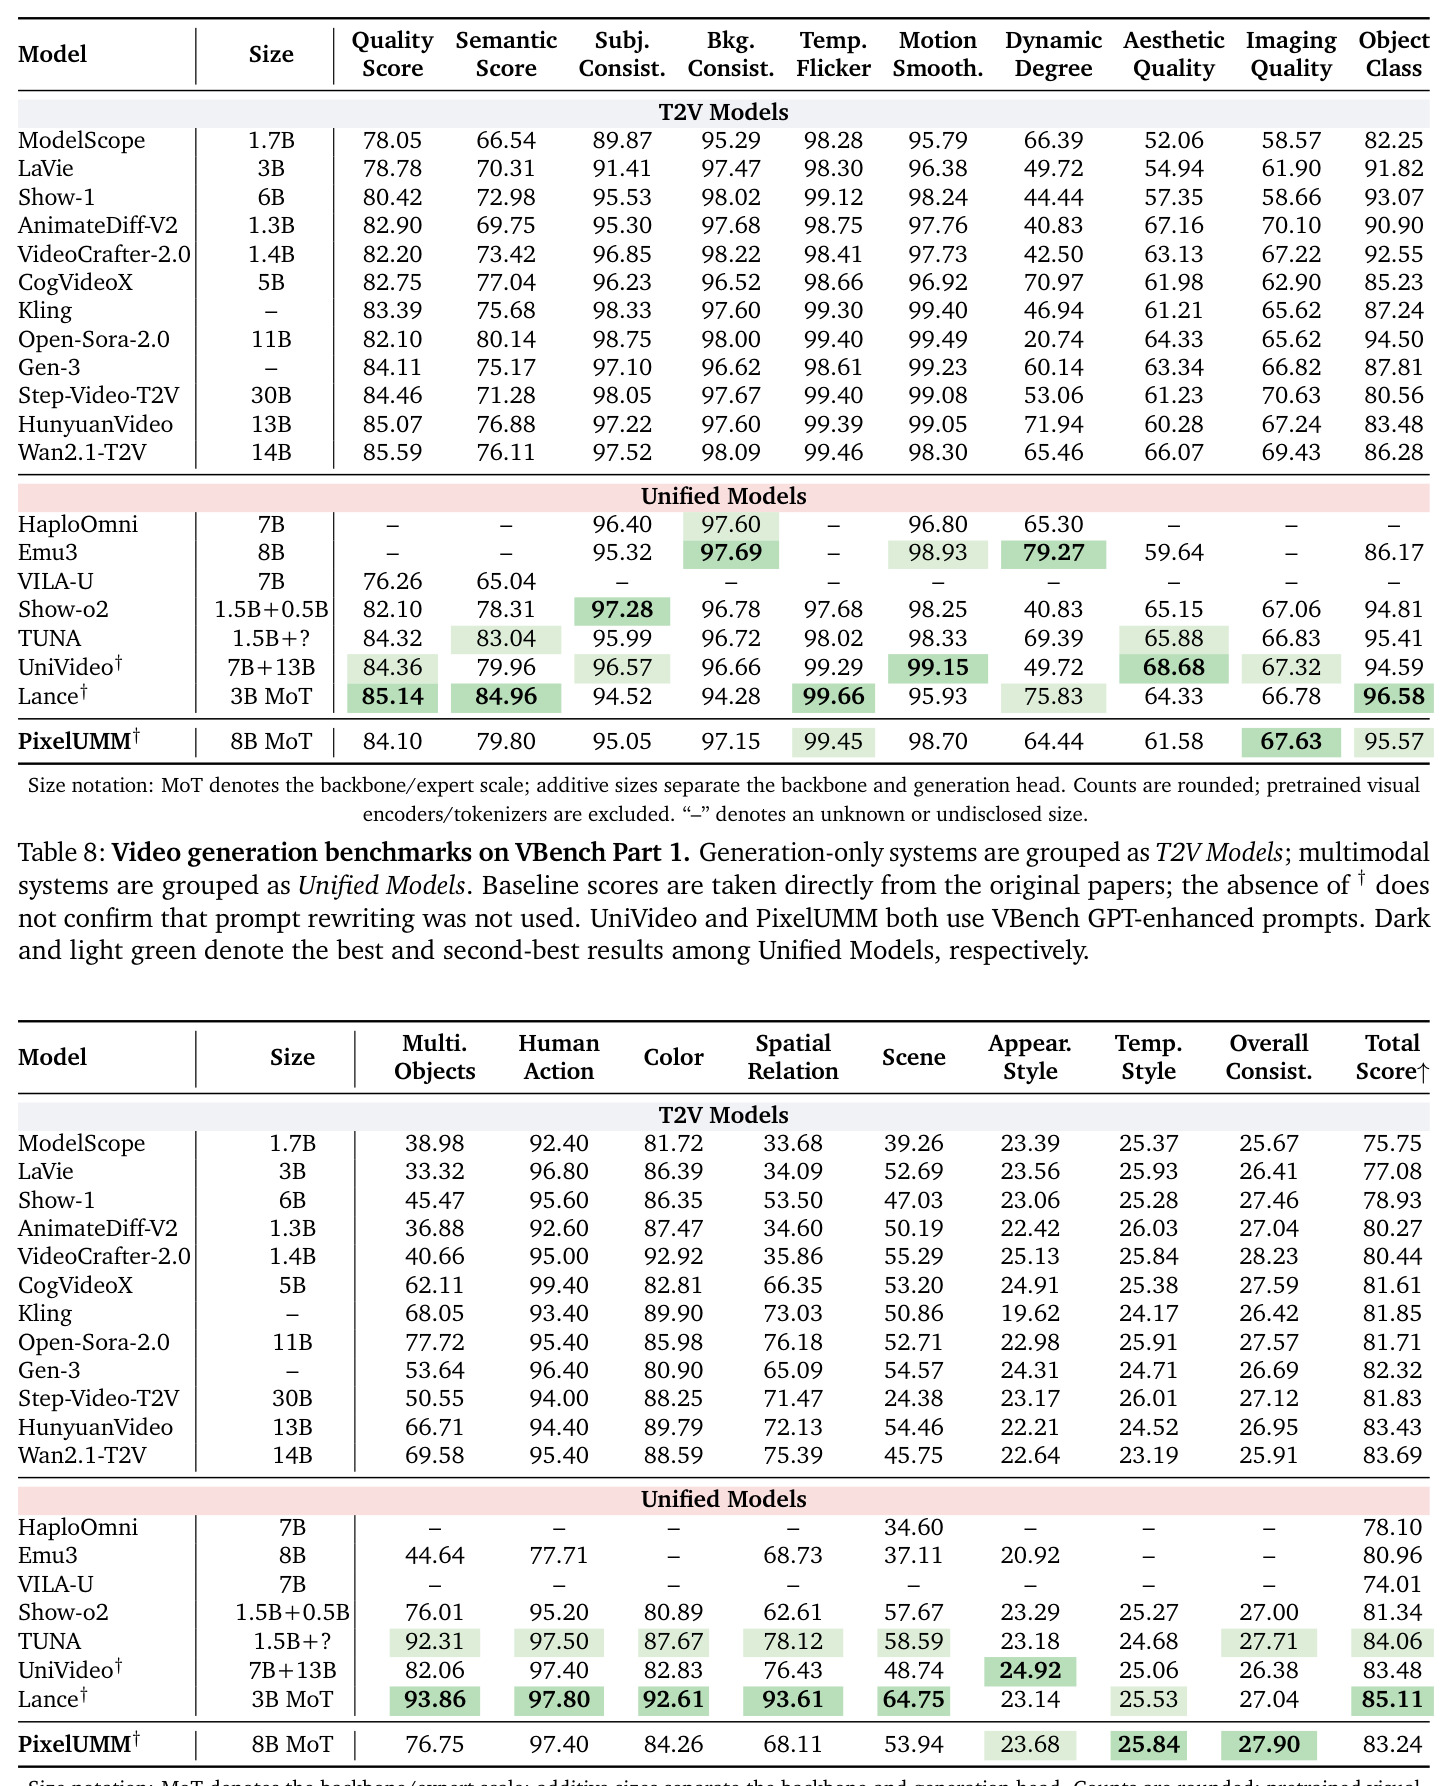
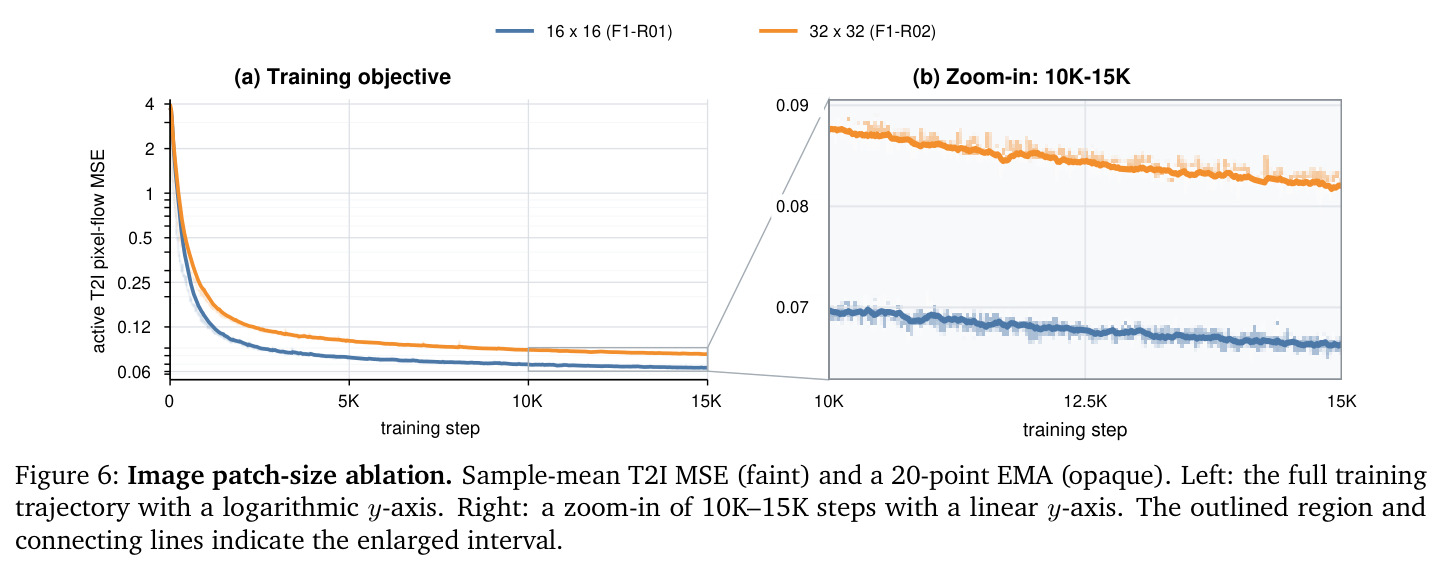
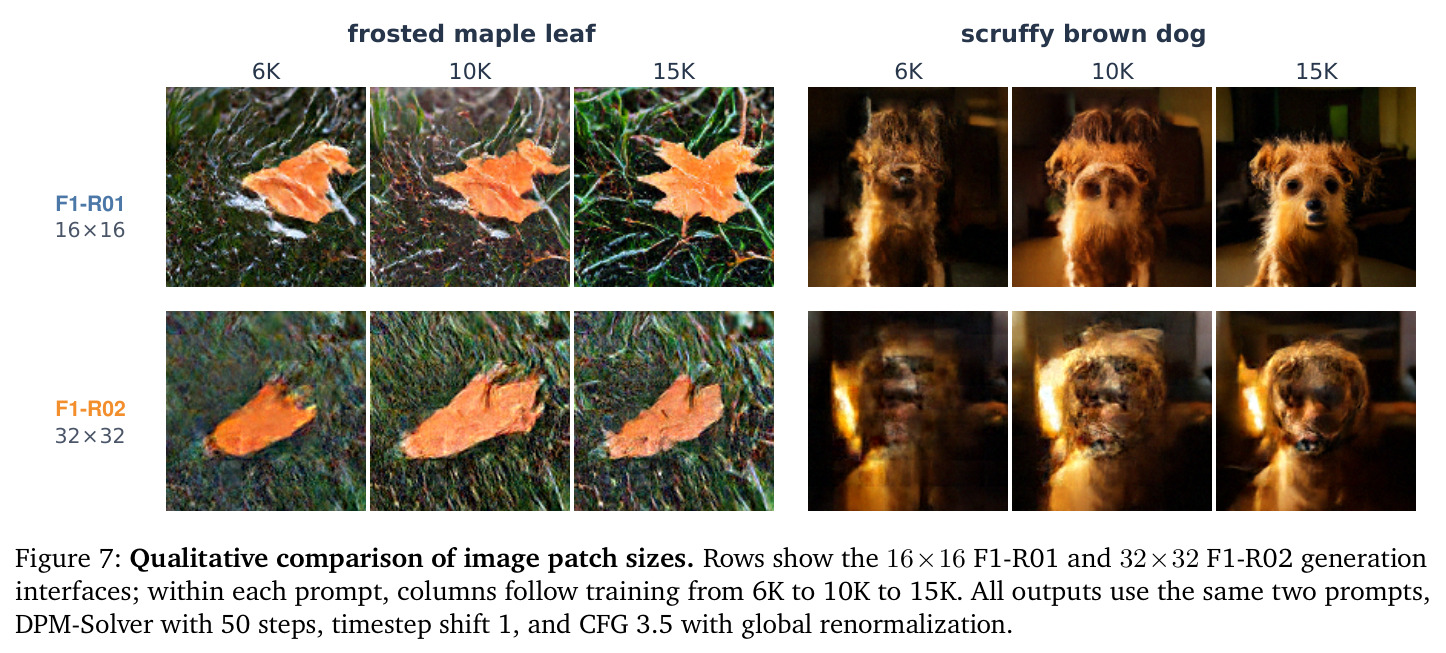
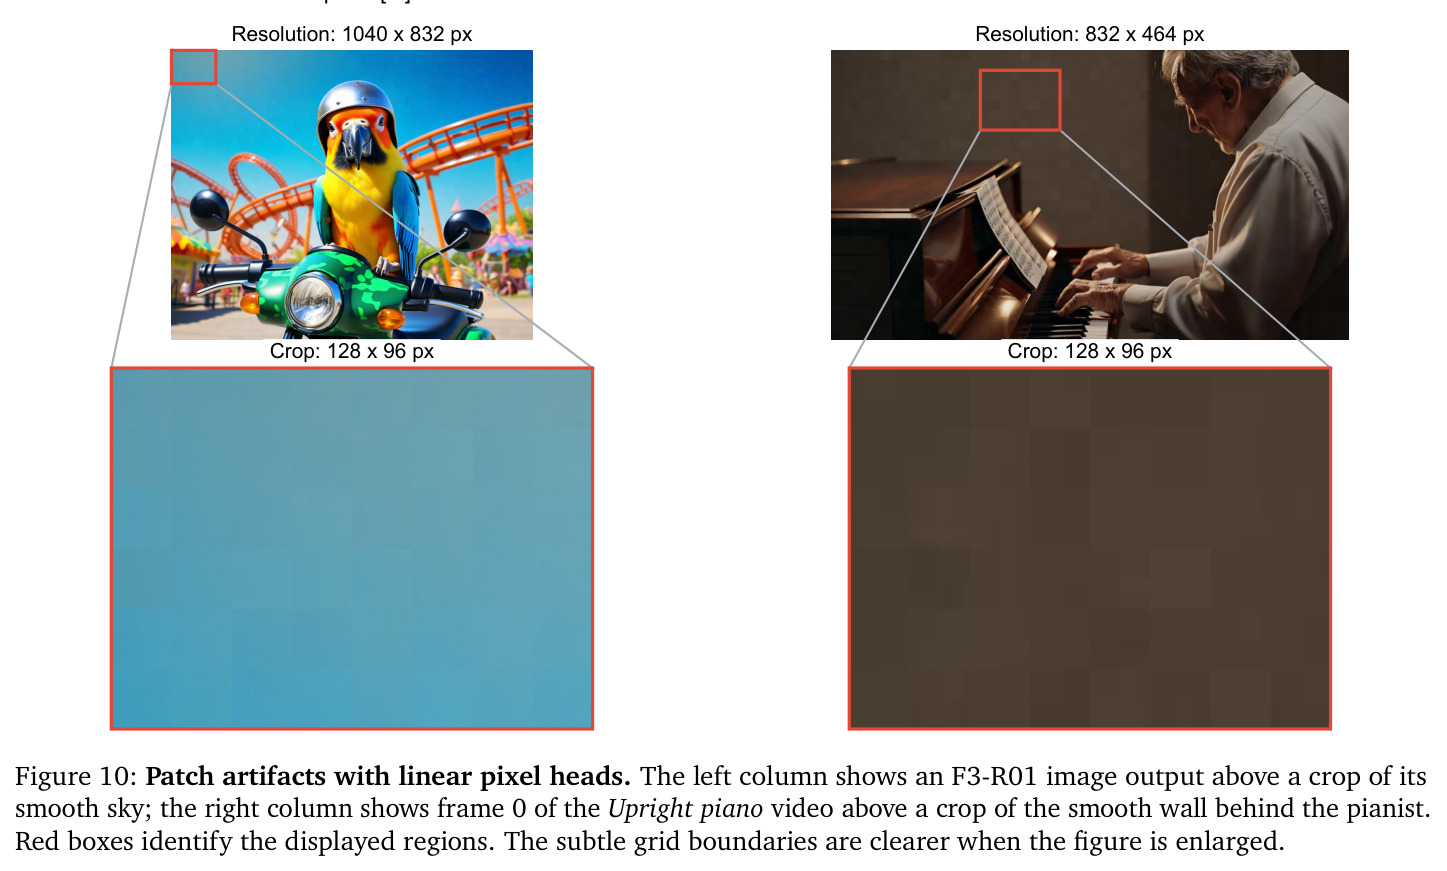
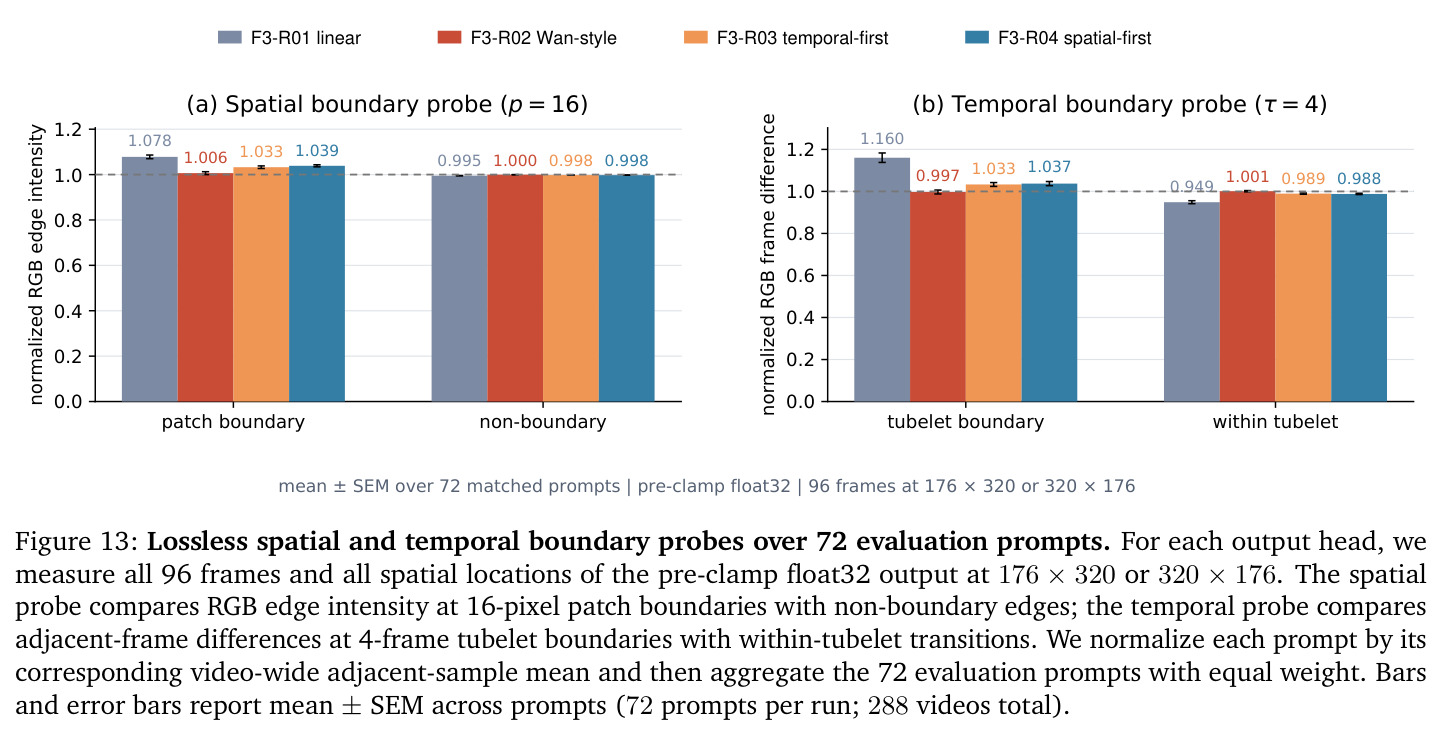
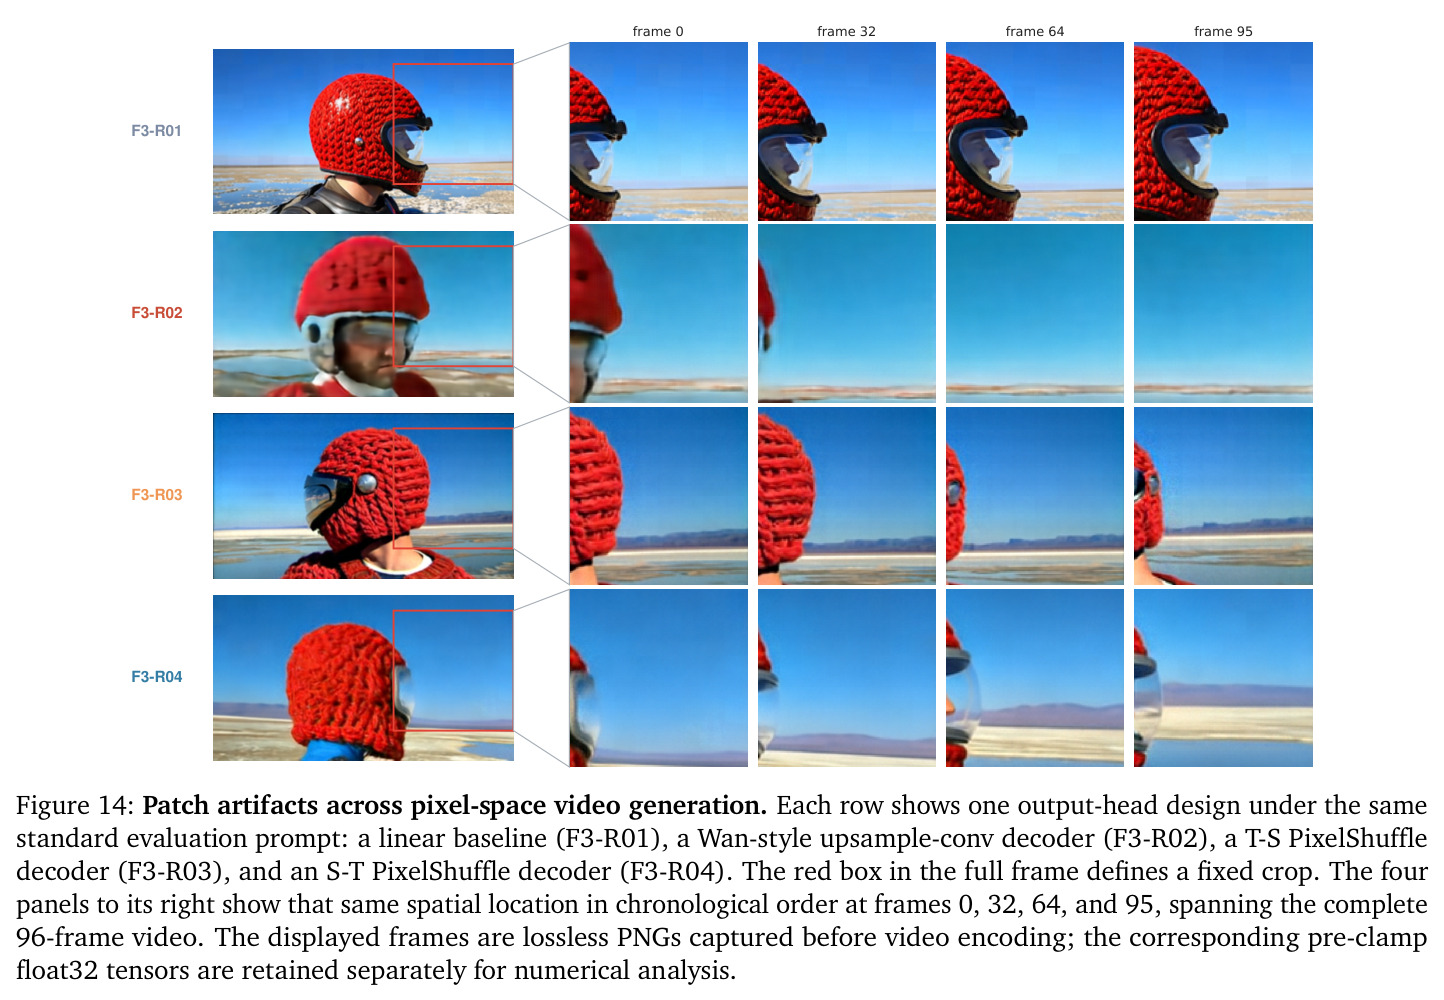
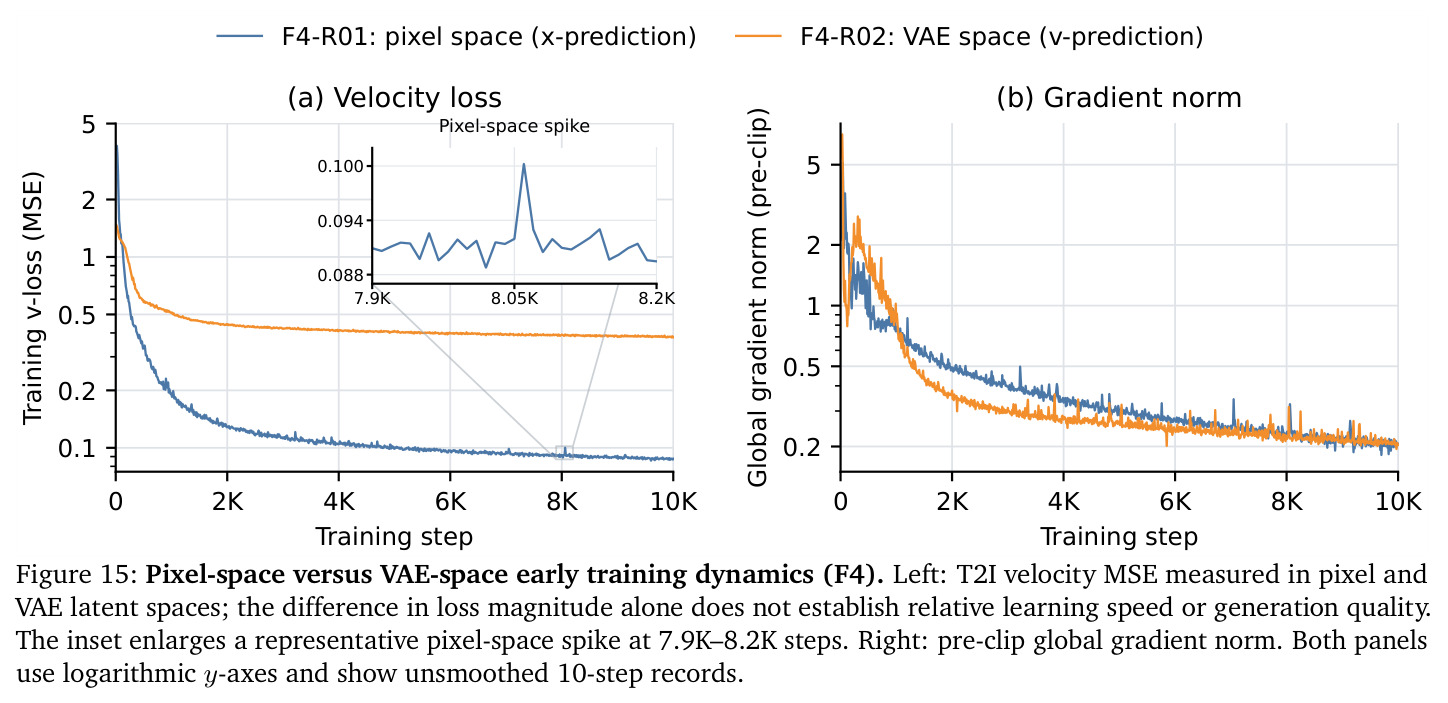
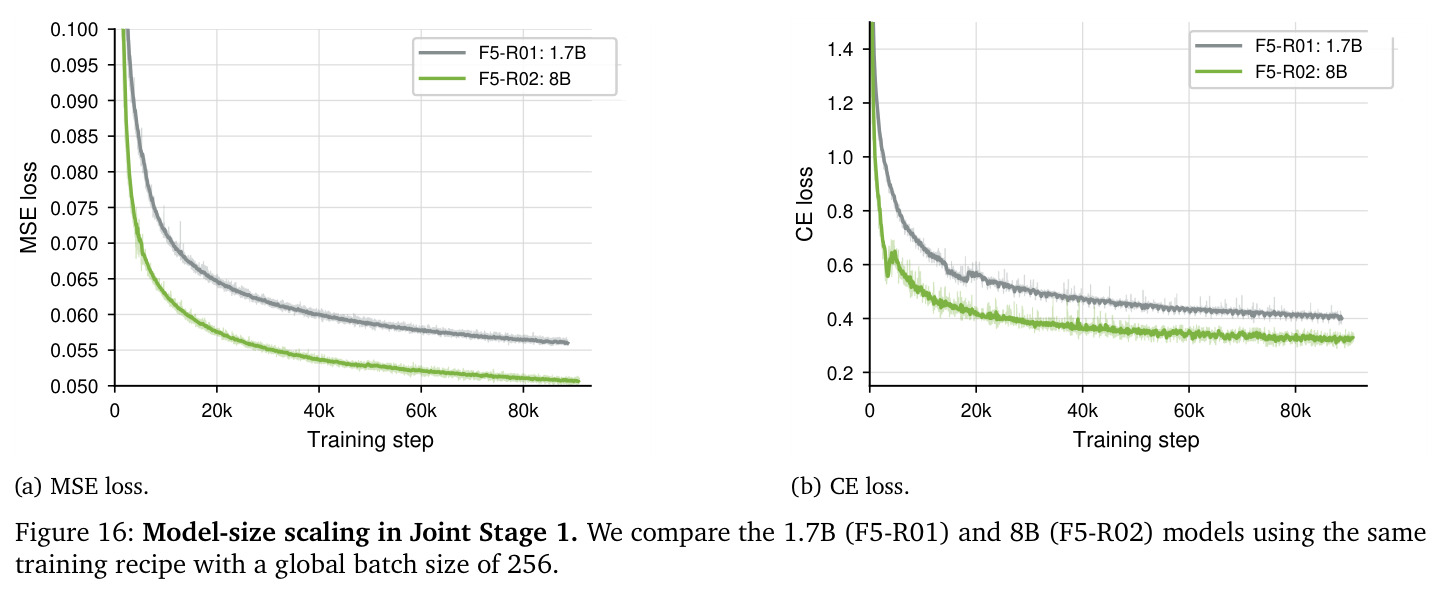
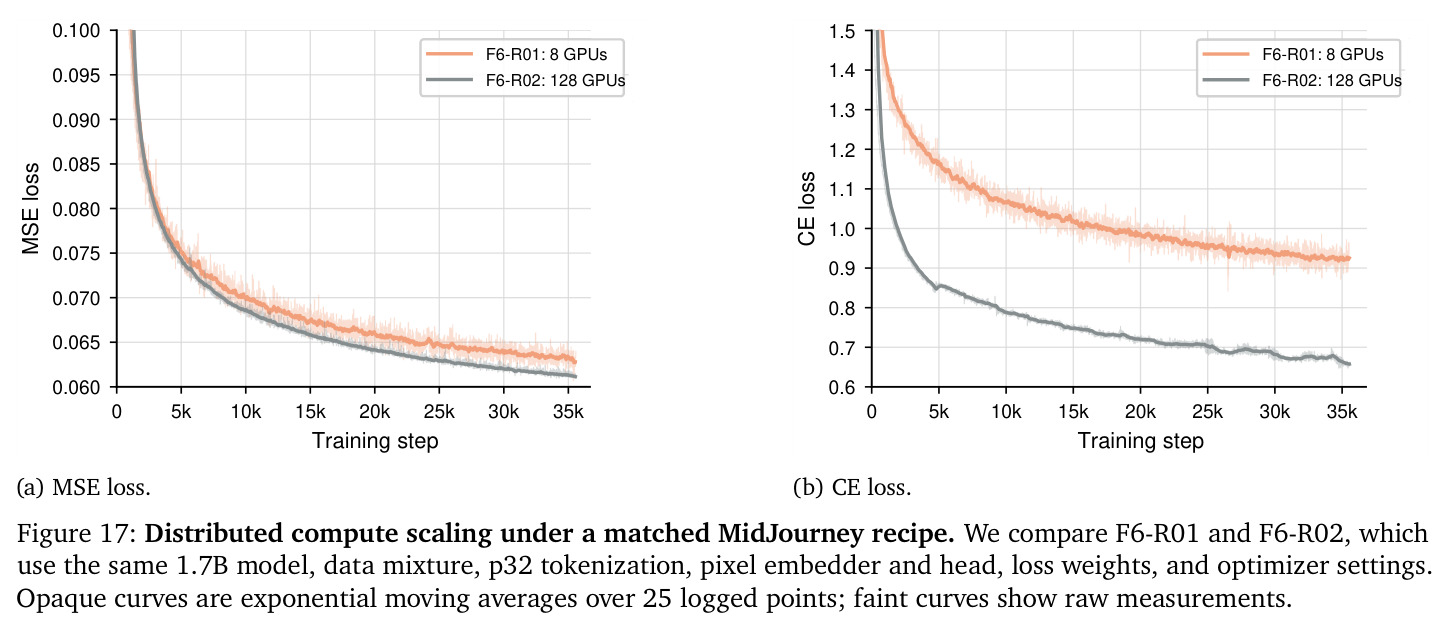
基准测试(Joint Stage 2 后,8B MoT)。图像理解(Table 5,官方 LMMS-Eval 协议,21 项任务共 64,750 次生成):MMMU 41.67、DocVQA 90.42、ChartQA 82.96、AI2D 80.12、TextVQA 78.76、OCRBench 78.00、MME 1809.54、SEED-I 70.39、CV-Bench 77.60、CountBench 94.30、PixMo-Count 73.03(显著高于 Qwen2.5-VL 的 63.30)、MMVP 80.33;整体低于 BAGEL(MMMU 55.30)与 TUNA-2(50.70),但多数指标保持在统一模型前列。视频理解(Table 6,sparse_mode、最多 96 帧):MVBench 70.53,大幅领先 Show-o2 的 49.80、TUNA 的 54.40、Lance 3B MoT 的 62.00;Video-MME(无字幕)57.33、LongVideoBench 59.61、LVBench 40.41,均优于 Show-o2/TUNA。图像生成(Table 7):GenEval 总分原始 prompt 0.77、配 LLM prompt 重写 0.83(BAGEL 0.88、TUNA 0.90),Position 0.55/0.71 与 Count 0.65/0.72 是明显短板;DPG-Bench 85.74,略高于 BAGEL 的 85.07。视频生成(Tables 8-9):VBench 总分 83.24(Lance 85.11、TUNA 84.06、UniVideo 83.48),Quality 84.10、Semantic 79.80、Subject Consistency 95.05、Temporal Flicker 99.45、Object Class 95.57。消融要点:F1 中 32² patch 每步可处理 4 倍图像但训练 T2I MSE 全程高于 16²;F2 压缩最弱的 p32/t1 损失最低,最终模型取 p16/t4 对齐 Wan2.2 VAE 惯例;F3 线性头归一化边界强度空间 1.078/时间 1.160(基线 1.0),PixelShuffle 头收敛到约 0.02、Wan 风格 >0.05;F4 10K 步时 VAE 空间损失约为像素空间的 4.3 倍(跨空间不可直接比较),梯度范数相近、像素空间偶发尖峰;F5 8B 达到 MSE 0.060/CE 0.50 仅需 1.7B 约 1/3 步数(约 14K vs 40K、10K vs 31K 步);F6 GPU 8→128 后 CE 到 1.0 需约 2K vs 17.5K 步(约 9×)、MSE 到 0.065 需约 17K vs 23K 步(1.3×);F7 多任务微调后视频理解四基准全升(dense_mode +0.89~+3.49、sparse_mode +1.00~+3.49),BLINK +2.37、CV-Bench +2.27,但 SEED-I 下降 5.41;F8 dense vs sparse 差异仅在 −0.68~+0.07 之间,4FPS tubelet 无明显优势。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 视频理解 | MVBench | 70.53 | Show-o2 49.80 / TUNA 54.40 / Lance 3B MoT 62.00 | 较最强统一基线 Lance 提升 +8.53 |
| 视频理解 | Video-MME(无字幕) | 57.33 | Show-o2 48.00 / TUNA 49.10 | +9.33 / +8.23 |
| 视频理解 | LongVideoBench | 59.61 | Show-o2 49.20 / TUNA 49.70 | +10.41 / +9.91 |
| 图像理解 | MMMU | 41.67 | BAGEL 55.30 / TUNA-2 50.70 | 落后 13.63 / 9.03 |
| 图像理解 | PixMo-Count | 73.03 | Qwen2.5-VL 63.30 / TUNA-2 59.20 | +9.73 / +13.83 |
| 文生图 | GenEval(含 prompt 重写) | 0.83 | BAGEL 0.88 / TUNA 0.90 | 落后 0.05 / 0.07 |
| 文生图 | DPG-Bench | 85.74 | BAGEL 85.07 / TUNA-2 86.54 | 较 BAGEL +0.67,较 TUNA-2 −0.80 |
| 文生视频 | VBench 总分 | 83.24 | Lance 85.11 / TUNA 84.06 / UniVideo 83.48 | 落后 1.87 / 0.82 / 0.24 |
| 训练效率(消融 F5) | 达到同等损失的步数(8B vs 1.7B) | 8B:MSE 0.060 约 14K 步、CE 0.50 约 10K 步 | 1.7B:约 40K 步 / 31K 步 | 约 3× 步数效率 |
| 视频理解接口(消融 F8) | dense_mode − sparse_mode 分差 | MVBench +0.07 / Video-MME −0.22 / LVB −0.68 / LVBench 0.00 | sparse_mode(1FPS 逐帧) | 无一致优势(±0.7 内) |
局限与改进
作者承认的局限:模型仍采用理解/生成双专家+共享注意力的 MoT,而非完全统一参数的架构(结论中明确列为待解决项);各模型训练数据不同,基准对比不能证明哪个架构更优或收敛更快;总体只做到『与基线相当』的竞争力。我观察到的局限:(1) 生成质量与最强统一模型有代差——GenEval 0.77(无重写)明显低于 BAGEL 0.88、TUNA 0.90,Count 与 Position 子项尤其弱;(2) 理解侧知识密集任务差距大——MMMU 41.67 vs Qwen3-VL 69.60、MMMU-Pro 仅 27.63、MuirBench 38.31 vs Qwen2.5-VL 59.60,纯像素接口缺少语义编码器的知识先验;(3) 发布检查点保留线性输出头,F3 诊断出的网格伪影只是被系统研究而未在正式模型中解决;(4) F4 显示像素空间训练存在偶发损失尖峰,稳定性未完全驯服;(5) p16/t4 使 512² 图像占 1024 token、4 秒视频约 6144 token,叠加 80K 序列长度,训练与推理成本高昂;(6) F7 中 SEED-I 下降 5.41、RWQA 下降 1.70,说明多任务间存在负迁移;(7) 论文未消融『完全共享参数 vs 双专家』,MoT 设计的必要性缺少直接证据。
独立分析的弱点
弱点一:生成精度不足。GenEval 0.77 中 Count 0.65、Position 0.55 显著落后(TUNA 分别 0.81/0.88),像素空间缺乏语义抽象可能削弱属性-空间组合推理;改进方向是引入布局先验、强化学习后训练(如 X-OMNI 证明 RL 可显著提升生成)或更高质量的结构化 caption 数据。弱点二:线性输出头的网格伪影。F3 已证明 T-S PixelShuffle(747 GFLOPs,仅 5.6× 线性头)能以可控代价抑制伪影并降低损失,但正式模型因换头需重新训练而放弃;改进方向是从 Gen Stage 1 起端到端使用卷积头,而非事后替换。弱点三:视频理解的 tubelet 增益存疑。F8 显示 4FPS dense_mode 相比 1FPS sparse_mode 各基准变化在 ±0.7 内,时间压缩可能既浪费建模容量又增加管线复杂度;可探索自适应帧率或可变 τ。弱点四:知识型理解弱(MMMU 差距近 28 点),改进方向是扩大预训练语料、提高知识密集数据配比,或外挂检索增强。弱点五:训练稳定性与成本——F4 观察到的像素空间损失尖峰与 80K 长序列的显存压力;可研究尖峰成因(β2、学习率调度、裁剪策略)并引入 token 剪枝或渐进分辨率。弱点六:双专家参数冗余且硬路由僵化,可探索软路由或共享底层 FFN 的统一 MoE 设计。
未来方向
作者提出的方向:用 MoE 架构更充分地融合理解与生成能力,超越当前 MoT 的硬路由双专家;测试更大空间 patch(p=64)与更长 tubelet(τ=8)能否在不牺牲训练稳定性与生成质量的前提下进一步压缩像素接口。基于本文成果可延伸的方向:(1) 把 F3 中胜出的 T-S PixelShuffle 头纳入正式训练管线,并量化其对编辑/I2V 细节保真度的影响;(2) 沿 F7 扩展到指令式多轮编辑、多参考图生成等复杂交互,并研究条件注入与理解能力之间负迁移的边界(SEED-I −5.41 的成因值得专门分析);(3) 利用 F5/F6 的 scaling 结论(8B 约 3× 步数效率;GPU 数量对 CE 约 9×、对 MSE 仅 1.3×)研究理解与生成的算力最优分配策略;(4) 发挥无编码器单流接口与 VLM 预训练管线天然兼容的优势,把统一生成能力嫁接到现成开源 VLM 上做持续预训练,验证『先语言后视觉』的路线;(5) 与 NVIDIA Cosmos 生态衔接,探索像素空间世界模型与物理一致性评估;(6) 结合自回归+扩散混合推理,把生成时长从 96 帧扩展到更长视频,并测试 RLHF/RLAIF 后训练对 GenEval 短板子项(计数、位置)的修复效果。
复现评估
开源情况:论文附项目主页(https://nv-tlabs.github.io/PixelUMM/),正文多处提到 released checkpoint 与官方 LMMS-Eval 评估协议,表明有模型权重发布;但正文中未见代码仓库、训练代码与数据配方的完整开源说明。算力需求:六个训练阶段合计约 50.5 万步(150K+200K+100K+20K+15K+20K),序列长度 60K–80K,视频生成最高 512²、4 秒 96 帧,F6 实验动用 128 GPU,全量复现 8B 模型需要大厂级集群与海量多模态数据(生成数据仅笼统描述为『公开真实+合成数据』,未列清单,是复现的最大不确定项)。相对容易复现的部分:F1–F8 消融设计清晰、配置表完整(F3 解码器实验仅 16 GPU、F6-R01 仅 8 GPU 即可近似),所有基准(LMMS-Eval、GenEval、DPG-Bench、VBench)都是公开标准协议,复现消融结论在单机 8–16 卡、数天到数周内可行。总体评估:完整复现属于工业级难度;但对工程实践者而言,论文最有价值的是可直接迁移的设计经验——patch 压缩越弱生成越易学、PixelShuffle 头是线性头的低成本升级、像素与 VAE 空间的损失不可跨空间比较、以及『视频理解不需要高帧率 tubelet』这类反直觉结论。
论文图表
上半部分展示文生图结果;下半部分展示 TextVQA、ChartQA、AI2D、MMMU 四个基准的真实输入与模型原始回答(如识别相机品牌 Dakota digital、读出柱状图中食物数量 14)。
一图总览模型在理解与生成两大类任务上的实际输出质量,直观呈现单一模型覆盖四任务的统一性,是读者建立第一印象的入口。
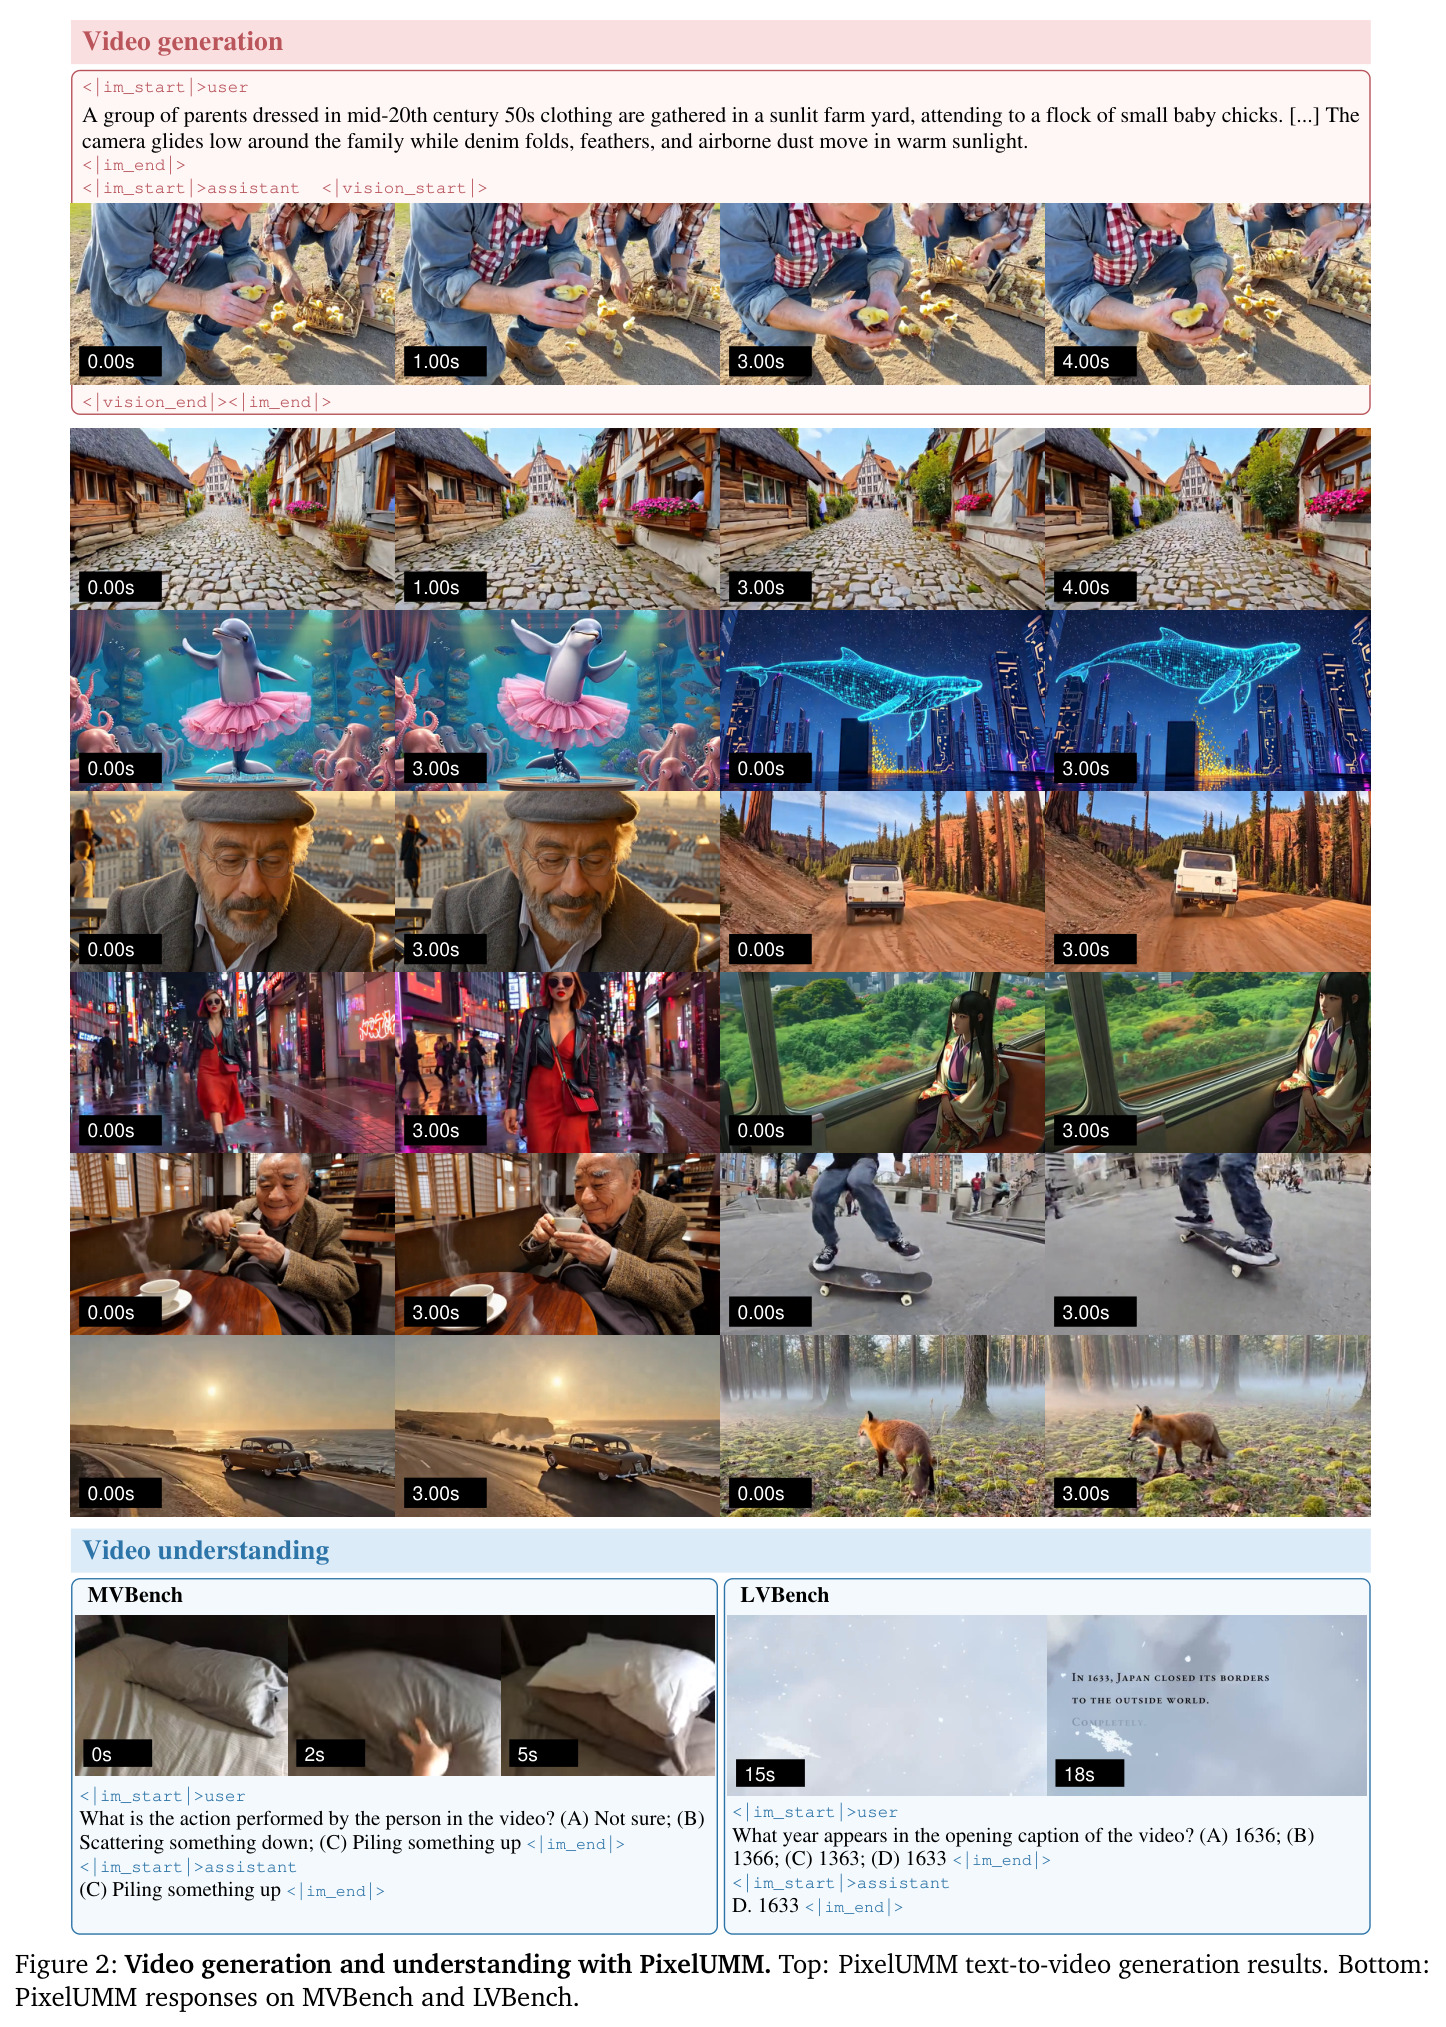
上半部分展示文生视频结果(50 年代农场鸡群场景在 0/1/3/4 秒的帧);下半部分展示 MVBench 与 LVBench 上的问答示例(动作识别、字幕年份识别)。
证明像素范式确实延伸到了视频:既有可看的生成结果,也有真实的视频理解回答,直接回应论文的核心主张。
VBench 第二部分 16 个子项:总分 83.24,Subject Consistency 95.05、Temporal Flicker 99.45、Human Action 97.40 表现好,Spatial Relation 68.11 与 Background Consistency 97.15 中等。
补全视频生成的细粒度画像,识别强弱子项(时序稳定强、空间关系弱),与 GenEval 的短板模式互相印证。