学习元技能以设计智能体线束:测试时 AI4AI Learning Meta-Skills for Agent Harness Design in Test-Time AI4AI
让 Builder 从执行反馈学元技能,为权重冻结的 Target 现场构建更优执行环境。
前置知识
AI4AI(AI for AI,测试时)
用 AI 系统来开发或改进其他 AI 系统的范式。本文聚焦其『测试时』版本:不更新任何模型权重,而是让一个模型(Builder)在推理阶段为另一个模型(Target)设计智能体程序、工作流与执行环境。与之相对的是训练时的模型开发自动化(如 AIDE 自动写机器学习流水线)。
全文的问题设定、目标函数与结论都建立在『权重冻结、只学外部支持』这一 AI4AI 设定上,不理解它就无法理解学习到底发生在哪里。
Harness(智能体线束/执行环境)
围绕模型的整套执行环境,包括指令、记忆、上下文组织、组合工具、执行控制、验证与恢复、工作区准备等组件族。模型在其中感知观察、调用工具并提交结果;好的 harness 把机械性簿记(一致性检查、预算控制等)外置成代码,让模型把有限的交互预算花在判断上。
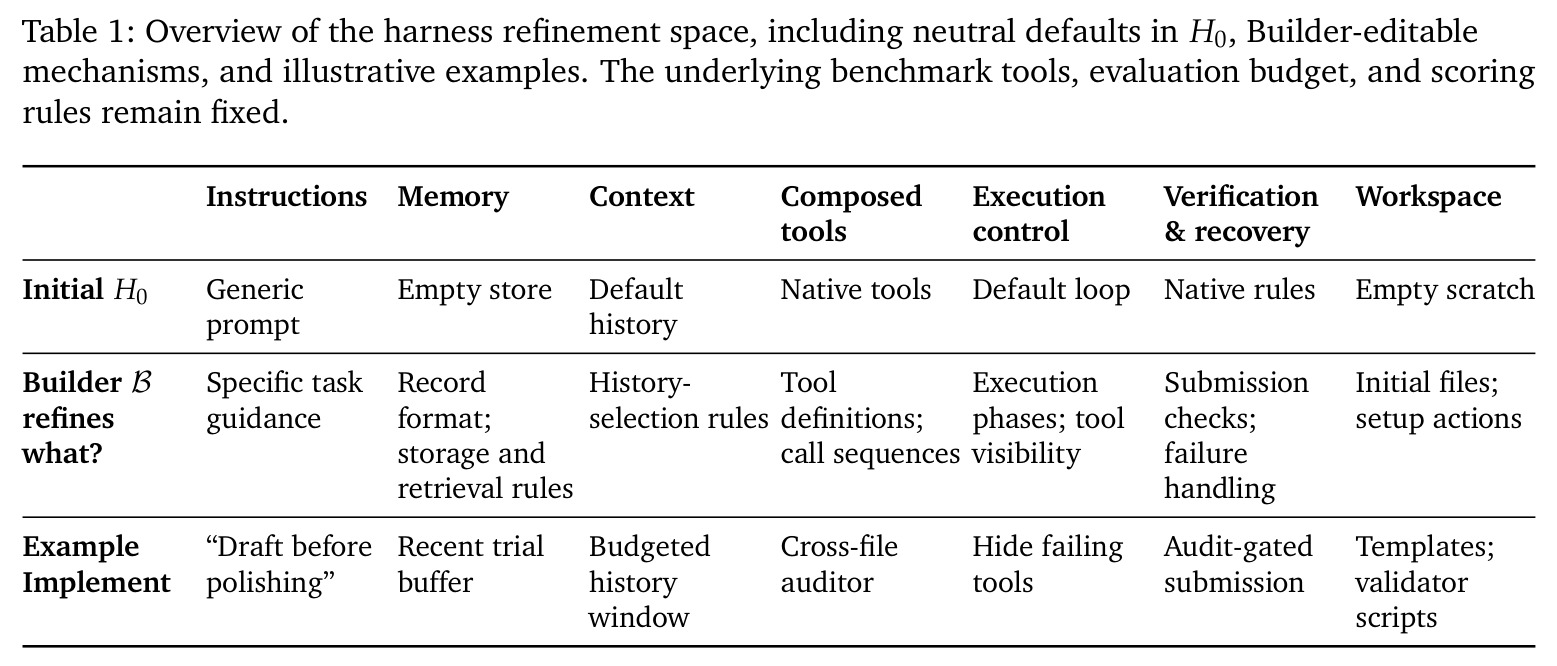
harness 是 Builder 的输出物和本文的优化对象,Table 1 定义的七类组件族构成了 Builder 可编辑的整个设计空间,也是消融实验的对象。
Meta-skill(元技能)
本文提出的可复用支持设计原则,形如 $s=(\mathrm{when},\mathrm{provide},\mathrm{use})$ 三元组:when 描述何种可观察情形需要支持,provide 指定环境应提供什么能力或资源,use 说明 Target 应如何使用它、哪些判断仍归它负责。每条不超过 192 token,存于技能库,由 Builder 落地成具体组件。
这是全文的核心知识表示;理解三个字段的语义,才能看懂技能如何从执行反馈中学出、又如何被编译成 harness。
Builder–Target 分工
Builder 负责设计并提供支持(构建 harness),Target 使用支持完成具体任务,类比导师与博士生。两者可以是不同模型,也可以是同一个模型(自进化实验)。关键约束是两者权重都冻结,学习只改变 Builder 的外部技能库与构建行为。
所有关键对比(Builder 落地 vs 直接把知识交给 Target)都围绕『同一份知识放在哪一侧更有用』展开,这是论文最重要的实证发现。
BM25 稀疏检索
基于词频与文档长度归一的词汇匹配检索算法。本文测试时以任务初始公开 prompt 为查询($k_1=1.5, b=0.75$),从技能库中取至多 2 条正分技能交给 Builder,与『全库注入』形成 sparse vs full 两种对照条件。
理解 full-bank 与 retrieved 两种条件的差异、以及『全库通常更好(六设置胜五,NewtonBench 平均 +7.19)』这一结论,需要知道该检索器只做词面匹配的能力边界。
配对任务 bootstrap 置信区间
对配对比较(同一任务在两个条件下的得分差)重采样 2 万次,取 2.5/97.5 分位作为 95% 区间;区间包含 0 表示平均效应方向不确定。注意它刻画的是任务抽样方差,而非模型生成的随机性。
论文多处结论的强度判断(尤其迁移实验『所有 CI 含 0』)完全依赖对这个统计工具的正确理解,否则会高估或低估结果的可靠性。
研究动机
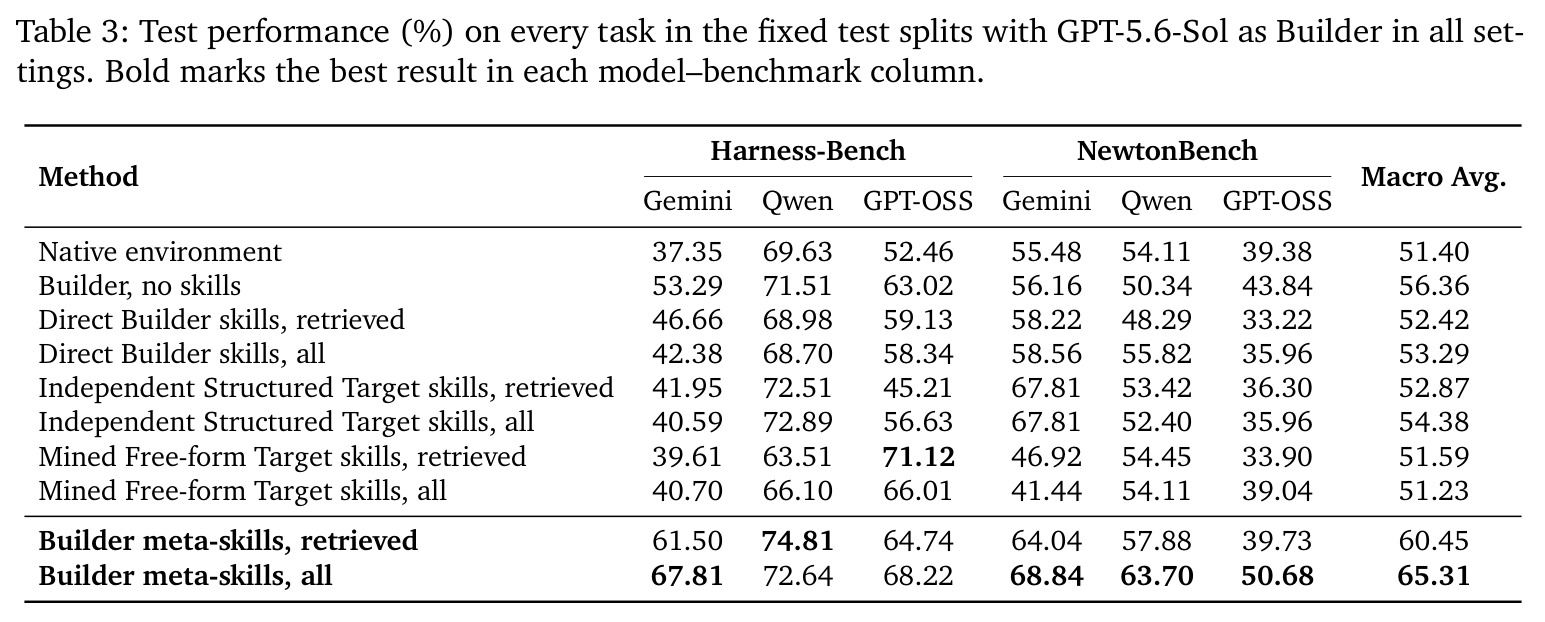
智能体的表现同时取决于推理能力和它所处的执行环境。论文开篇用博士生与导师的类比点出:一个有能力的研究者也会因为配置和结果散落在各处而反复返工,瓶颈往往不在『会不会做』,而在『环境有没有把支持准备好』。现有改进路线大多聚焦给 Target 模型本身灌输任务技能或提示(如 ExpeL、ACE、Evo-Harness 学习求解侧技能),但本文实验显示这条路收益有限甚至为负:在统一以 GPT-5.6-Sol 为 Builder 的六个设置宏平均中,把学到的技能直接交给 Target 只有 53.29%,仅略高于无任何引导的 native 环境 51.40%;同时 NewtonBench 上 no-skill 情况有多达 394 个任务连有效提交都没有,Harness-Bench 上大量任务停留在部分成功(完全成功仅 59 例)。这说明失败主因常是协调性负担——记忆、验证、工具编排、提交控制挤占了模型本就有限的交互预算,而非知识或推理能力不足。
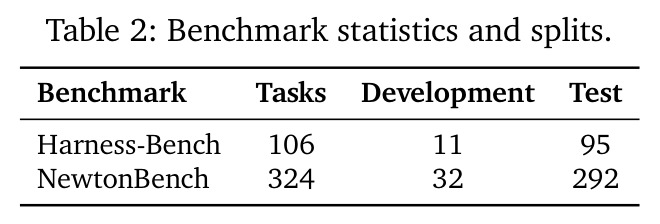
本文的目标是本文的目标是:在 Builder(设计支持方)与 Target(执行方)模型权重均完全冻结的前提下,让 Builder 学会『如何提供支持』的可复用原则(meta-skill),并验证这些原则能否迁移到未见任务。形式化地,每个基准提供中性环境 $H_0$、评估器 $r$ 和 Target 执行预算 $C_x$,harness 策略 $\mathcal{H}$ 把任务输入 $x$ 映射为增强环境 $H_x$,目标是最大化 $J(\mathcal{H})=\mathbb{E}_{x\sim\mathcal{D}_{test},\,\tau\sim T(\cdot|x,H_x)}[r(x,\tau)]$ 且满足 $\mathrm{cost}(\tau)\le C_x$。具体做法:只用约 10% 的开发任务让 Builder 通过执行反馈迭代构建技能库,随后冻结库,为每个测试任务现场构建全新 harness,在固定 Target 预算下提升 Harness-Bench 与 NewtonBench 的端到端得分。
与已有工作不同的是,与相近工作的区别在学习对象和知识形态。ADAS/AFlow 搜索智能体程序与工作流,Darwin Gödel Machine 与 Meta-Harness 用执行反馈直接搜索 harness 实现,Evo-Harness 把执行经验编译成给 Target 的解题技能,Meta Context Engineering 学习构造上下文文件的技能——它们要么学的是任务技能,要么直接搜索实现代码。本文把『支持设计知识』与『任务技能』显式剥离:Builder 从自己构建的 harness 的执行结果中提炼 when/provide/use 三元组原则,并主张知识必须由 Builder 落地为可执行组件才产生价值。配套对照(同一技能库直接交给 Target 的 Direct 基线、技能库为空的 no-skill Builder、独立学习的 Target 技能、一次性整合的自由笔记)系统性解耦了『知识内容、构建能力、落地方式』三个因素,这是本文独特的实证切入角度。
核心方法
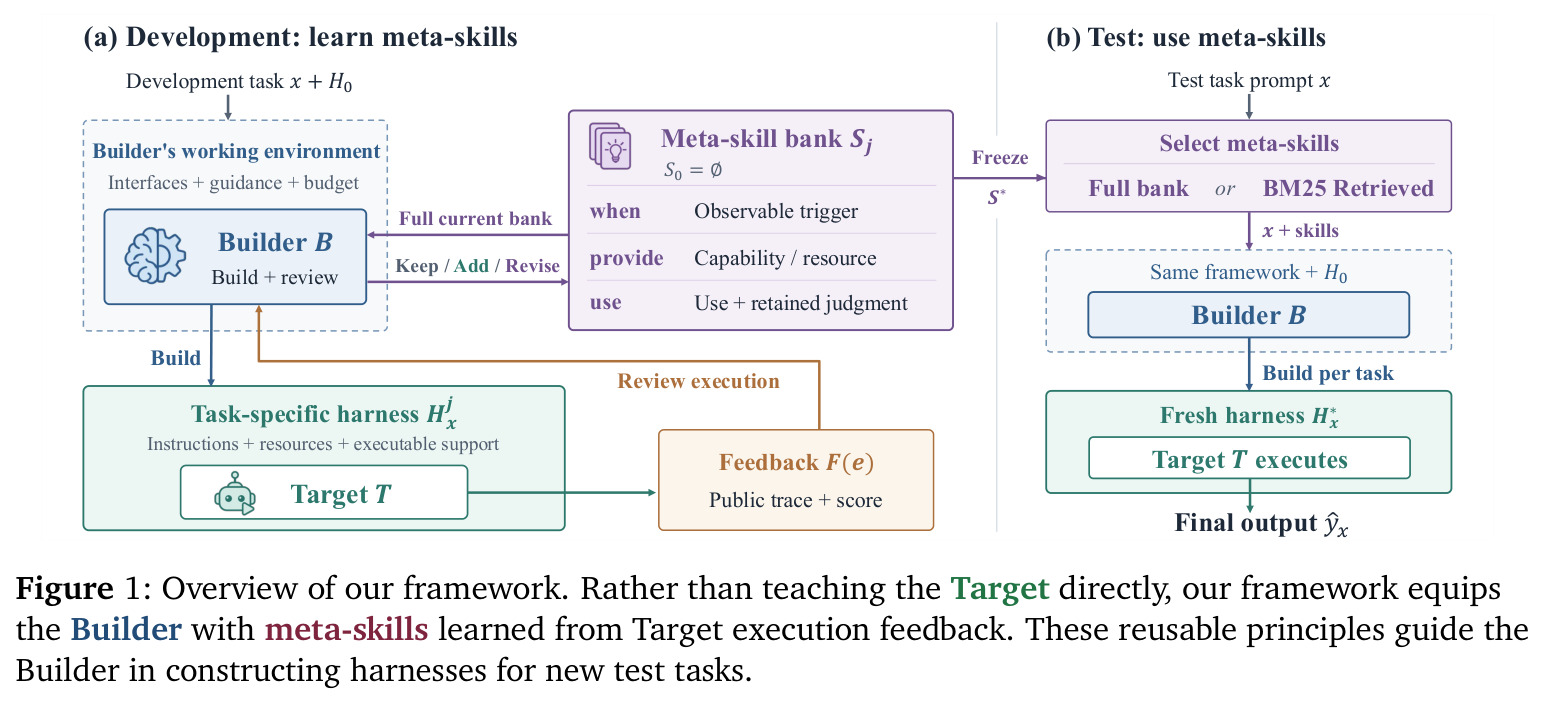
直觉上这是导师与博士生的关系:与其继续给学生灌输知识,不如教导师学会为学生搭建共享实验日志、可复现工具和验证流程。技术路线是『构建–执行–反思』循环:从空技能库 $S^0=\varnothing$ 出发,Builder $B$ 用中性环境 $H_0$、公开组件接口和当前完整库为每个开发任务构建任务特定 harness $H_x^j=B(H_0,x,S^j)$;Target $T$ 执行得 $e_x^j=T(x;H_x^j)$ 及公开执行记录与分数;Builder 复核后做一次基于证据的 keep/revise/add 更新 $S^{j+1}=\mathrm{Revise}_B(S^j,\{(H_x^j,F(e_x^j))\}_{x\in G_j})$。两遍开发集后冻结技能库;测试时以全库注入或 BM25 top-2 检索的方式 $K(x,S^*)$ 提供技能,Builder 为每个测试任务在全新环境中构建 fresh harness $H_x^*=B(H_0,x,K(x,S^*))$,Target 在其中执行并产出最终答案 $\hat{y}_x$。学习与构建开销不计入 Target 执行预算 $C_x$。
核心创新是把可复用知识表示为『支持设计原则』并证明其价值在于被 Builder 落地。每条 meta-skill 是 $s=(\mathrm{when},\mathrm{provide},\mathrm{use})$:when 给出需要支持的可观察触发条件,provide 指定应提供的能力或资源,use 说明 Target 如何使用、哪些判断仍归它(例:『验证后被编辑的产物需重新验证』→提供版本跟踪与重验→Target 提交前必须查看最新验证结果,但内容判断仍归它)。最关键的区别在于:同一技能库交给 Builder 落地比直接给 Target 阅读在全部六个设置中都更好,平均高 12.02 分、最高高 25.43 分(Gemini 在 Harness-Bench 上 67.81 vs 42.38)。这说明增益不是来自『让 Target 看到更好的知识』,而是来自『在执行前把声明性知识操作化』——翻译成持久状态、可执行工具、验证逻辑与控制决策,降低 Target 在推理时解释和应用建议的负担。Meta-skill 因此更像『配置任务特定支持的语言』,而非解题提示。
方法步骤详情
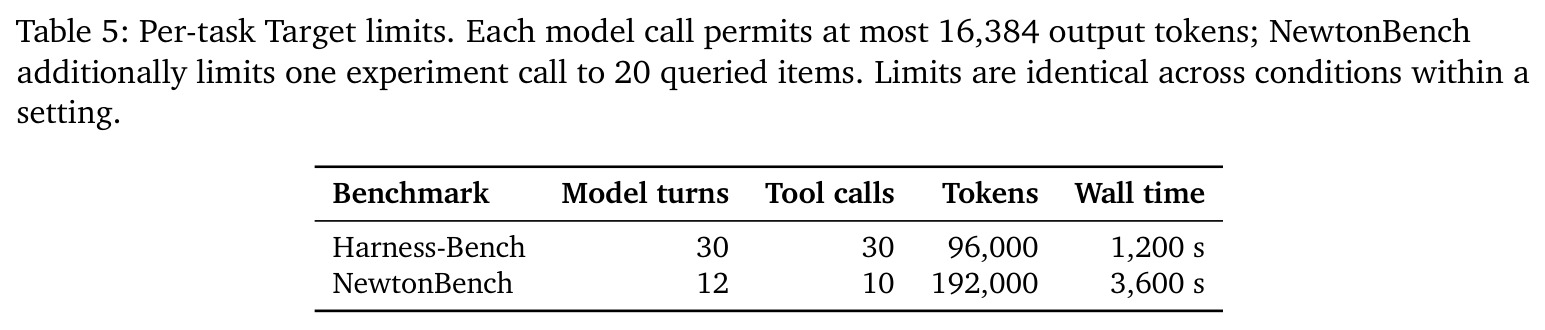
完整流程分五步。第一步,定义技能格式:每条 meta-skill 的三个字段合计不超过 192 tokens。第二步,技能学习:从空库开始,Builder 为每个开发任务构建 harness(16K 输出 token 上限,最多 2 次接口修复),Target 在固定预算内执行——Harness-Bench 每任务 30 次模型调用、30 次工具调用、96K tokens、1200 秒;NewtonBench 为 12 次调用、10 次工具调用、192K tokens、3600 秒——产生公开执行记录与分数,全程不提供参考答案或人工诊断。第三步,库更新:Builder 复核当前库、已生成程序与反馈 $F(e)$,每批至多一次 keep/revise/add,更新必须引用该批内证据,被替换版本归档;两遍开发集后冻结。第四步,测试时构建:全库模式把所有技能放入 Builder 上下文,检索模式用 BM25($k_1=1.5, b=0.75$)以初始公开 prompt 取至多 2 条正分技能;Builder 从七类组件族——instructions、memory、context 组织、composed tools、execution control、verification & recovery、workspace preparation——中选择并实现,决定存什么记忆、何时取回、给哪些工具。第五步,执行与评估:Target 在 harness 中推理、调用工具并负责最终提交;所有声明的测试任务都留在分母中,构建或执行失败记 0 分。
技术新颖性
技术新颖性体现在四层。表示层:when/provide/use 把『支持意图』与『实现』解耦,每条仅 192 token,使紧凑技能库可以全库注入,这与 3K token 的自由格式笔记(mined notes)和面向解题的 Target 技能都不同。学习对象层:Builder 学的是『何时需要何种支持』而非『如何解题』,且每条更新必须引用观测证据,保证原则接地于真实执行行为而非凭空归纳。部署层:技能必须由 Builder 编译为任务特定组件——案例 1 中把 checkpointing 原则实现为可执行 auditor、控制器与提交门(最终原生得分 1.0,14 次模型调用,而 no-skill 与 direct-all 仅 0.0435);案例 2 中把『保留证据并限制计算』实现为独立于分析的内存与失败两次后收窄工具菜单的控制器——Direct-delivery 基线精确隔离了这一步的价值。系统层:两个模型权重均冻结,学习完全发生在外部技能库与构建策略中;同模型双角色实验(三设置平均 +18.71)首次把 harness 设计确立为无需权重更新、无需更强教师的系统级自改进路径。
实验结果
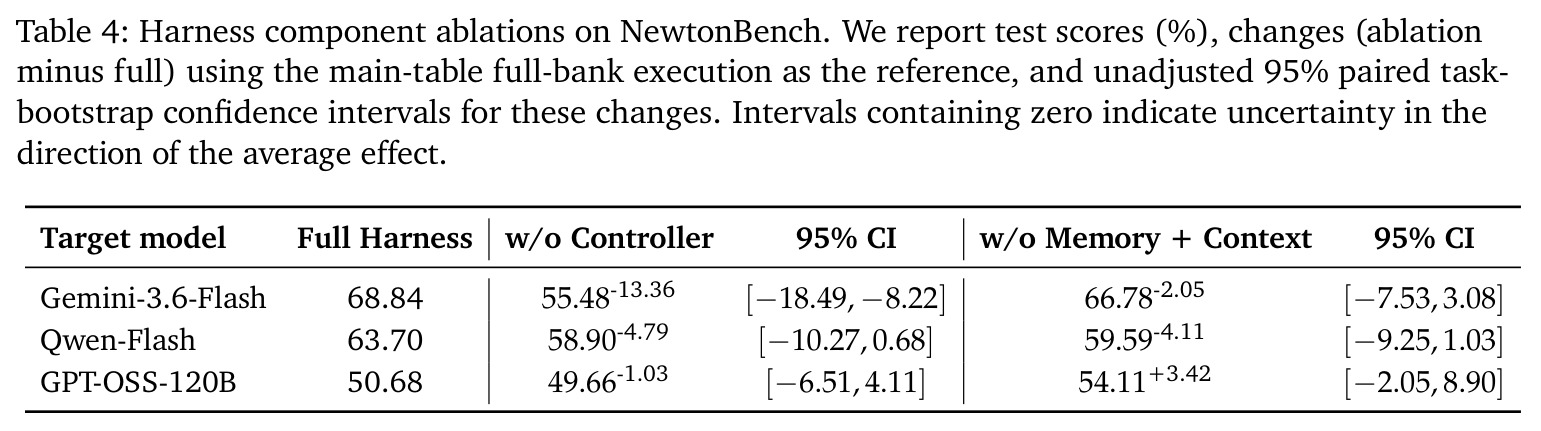
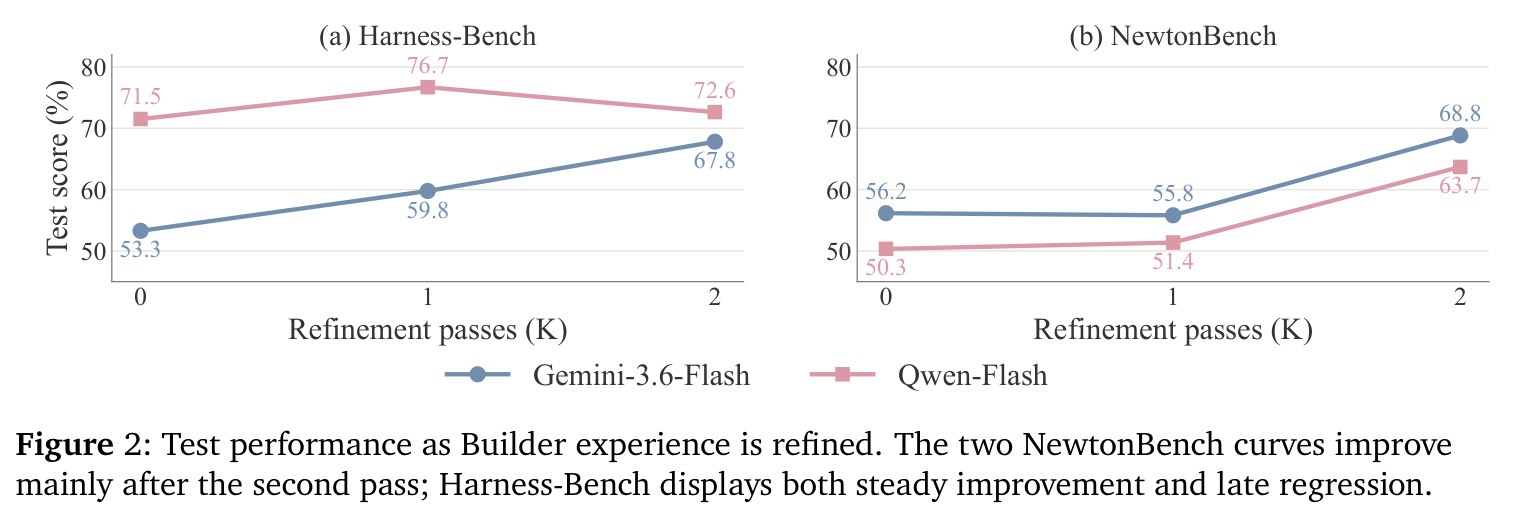
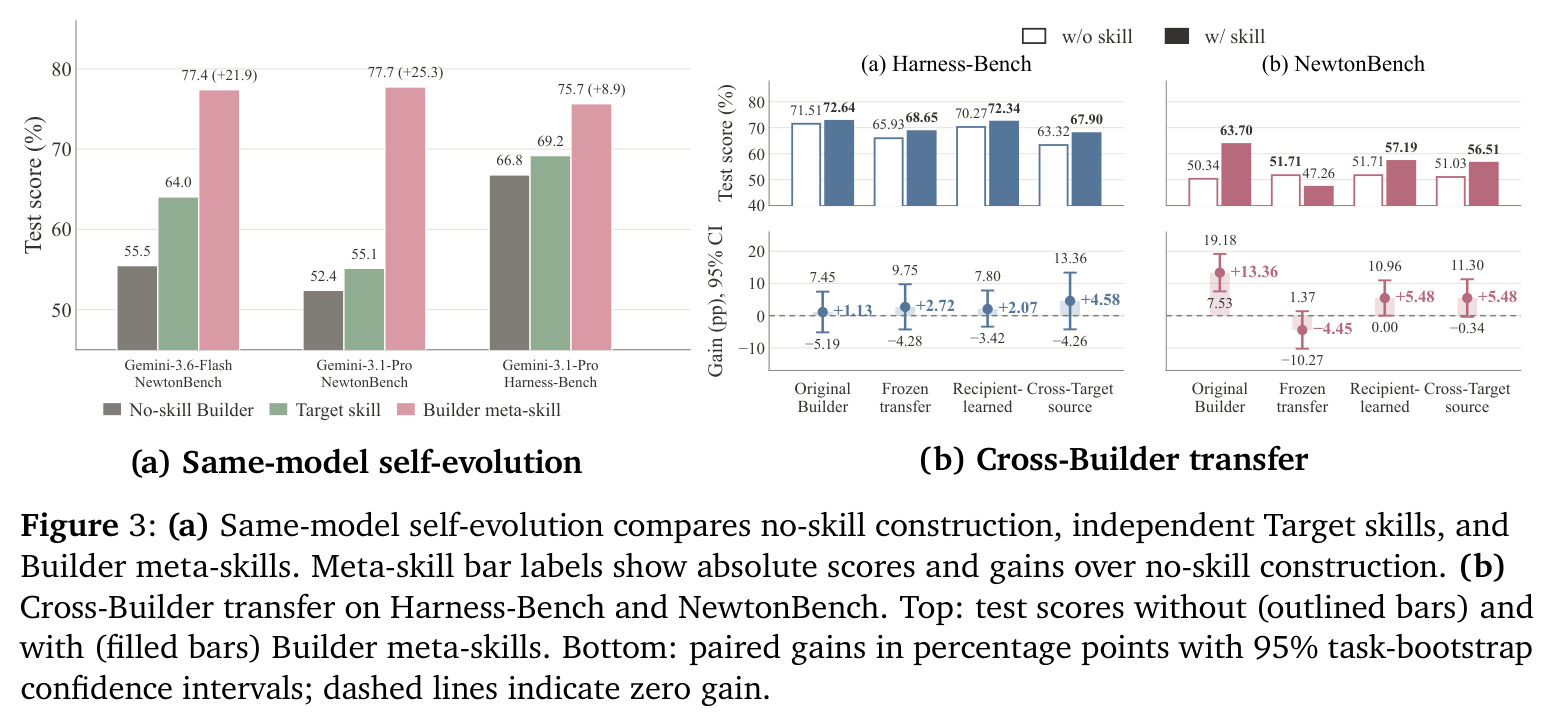
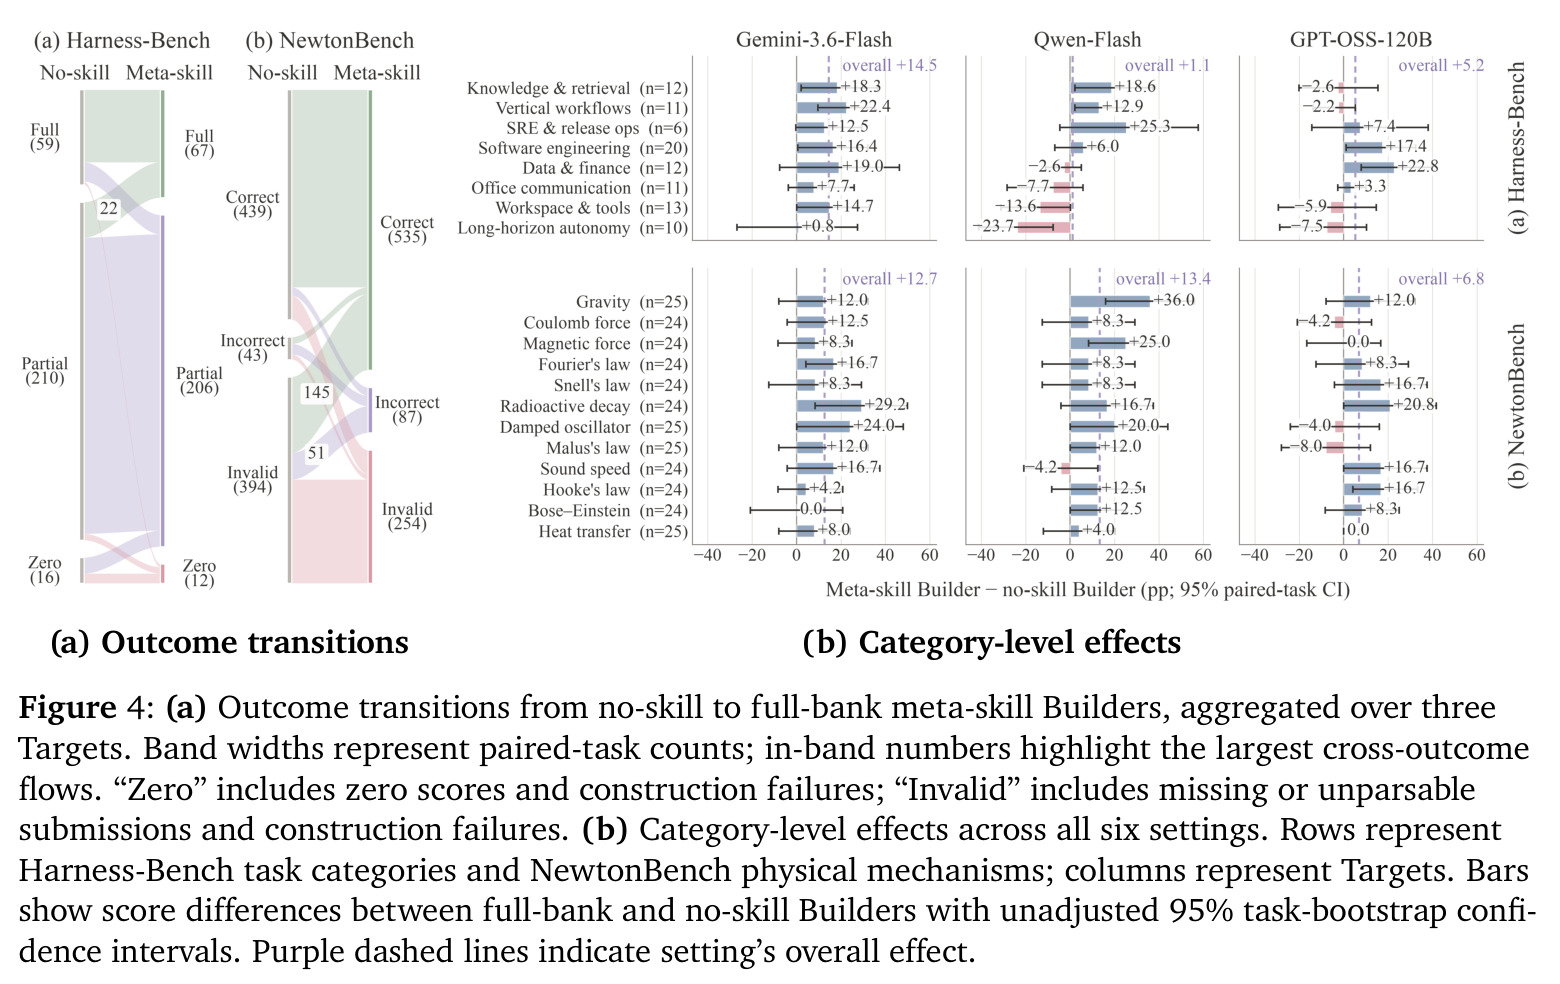
主实验(Table 3,统一 GPT-5.6-Sol 为 Builder):full-bank 元技能达 65.31% 宏平均,高于 native 环境 51.40、no-skill Builder 56.36(+8.95)、独立结构化 Target 技能 54.38(+10.93)、自由笔记 51.23、直接交付同库 53.29(+12.02),六个模型-基准设置全部占优;单点最大优势在 Gemini@Harness-Bench 67.81 vs native 37.35(+30.46)。精炼曲线(Figure 2):NewtonBench 增益集中在第二遍(Gemini +13.01、Qwen +12.33,首遍变化 <1.1,零至两遍平均 +10.42),Harness-Bench 非单调(Qwen 从峰值 76.7 回落 4.06 至 72.6)。同模型自进化(Figure 3a):三设置平均 +18.71(vs no-skill)、+14.14(vs 直接交付),Gemini-3.6-Flash 在 NewtonBench 55.5→77.4(+21.9)。迁移(Figure 3b):Sol 学的 Qwen 库在 Sol 手中 NewtonBench +13.36,换 Gemini-Pro 构建后 −4.45;接收方自学库再高 3.69/9.93 分;跨 Builder+Target 迁移仍为正(+4.58/+5.48),但所有区间含 0。消融(Table 4):去执行控制器使 Gemini −13.36(CI [−18.49,−8.22] 唯一排除 0),memory+context 效应小且不显著。结果转移(Figure 4):NewtonBench 无有效提交 394→254(−35.5%),正确发现 439→535(+21.9%),145 例『无提交→正确』恢复 vs 46 例回退,有效但错误从 43→87;Harness-Bench 完全成功 59→67。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Harness-Bench + NewtonBench 六设置宏平均 | macro-average score (%) | 65.31(Builder meta-skills, full bank) | 56.36(no-skill Builder) | +8.95 pp |
| 同一技能库:Builder 落地 vs 直接交给 Target | macro-average score (%) | 65.31 | 53.29(Direct Builder skills, all) | +12.02 pp(六设置全胜,单点最高 +25.43) |
| 对比独立学习的结构化 Target 技能 | macro-average score (%) | 65.31 | 54.38(Independent Structured Target skills, all) | +10.93 pp |
| Gemini-3.6-Flash @ Harness-Bench | completion-oracle score (%) | 67.81 | 37.35(native 环境) | +30.46 pp |
| GPT-OSS-120B @ NewtonBench | symbolic-structure accuracy (%) | 50.68 | 43.84(no-skill Builder) | +6.84 pp |
| 同模型自进化(3 个 Gemini 双角色设置) | 平均配对增益 (pp) | +18.71(vs no-skill) | no-skill Builder | 较直接交付技能再 +14.14 pp |
局限与改进
作者承认的局限:迁移实验所有成对置信区间都包含 0(效应从 −4.45 到 +13.36 不等),跨 Builder 复用的性能收益尚不确定;证据范围限于一个主 Builder(GPT-5.6-Sol)、两个基准、每条件单次执行;未评估相对构建成本的收益;增益依赖 Target 与任务组合(GPT-OSS 在 Harness-Bench 总体 +5.20 但 vertical workflows −2.23);泛化声明限定在已知工作流类别与物理机制内的 held-out 实例,跨数据集复用留待未来。我的补充观察:valid-but-incorrect 提交从 43 升至 87,说明『完成度提升』不等于『正确性提升』,技能库偏重流程性支持;full-bank vs retrieval 的对照只试了 BM25 top-2 这一种弱检索器,『全库更好』的结论可能随检索器质量而反转;技能库只经两遍、约 10% 数据学习,更长学习动态未知;单次执行且无重复学习运行,生成随机性带来的方差未被刻画;七类组件接口与构建引导是人工设计的重要先验,其本身贡献未被单独消融。
独立分析的弱点
第一,精炼非单调:Qwen 在 Harness-Bench 从第一遍峰值 76.7 回落 4.06 分,说明修订可能过拟合最近观测的证据;改进方向是作者提出的开发集置信评估与回滚机制,例如为每次修订保留父版本,按开发证据决定保留、回退或继续。第二,迁移脆弱:同一库在不同 Builder 手中效果从 +13.36 翻到 −4.45,根源在『原则→实现』的翻译不稳定;可引入接收方少量执行反馈做快速校准(few-shot 适配层),或让迁移库附带实现提示。第三,检索层太弱:BM25 只做词面匹配取 top-2,无法评估技能互补性;可学习同时考虑组合价值与 Target 可能反应的选择器,或按任务类型聚类技能。第四,统计力不足:单次执行、20K 次任务 bootstrap 只反映任务抽样方差,不反映生成随机性与学习运行方差;应报告重复执行与独立学习运行的结果分布。第五,成本未计入:Builder 学习与构建开销在 Target 预算之外,部署价值未知;应报告构建 token/时延与性能的 Pareto 曲线,并缓存通用组件。第六,组件收益 Target 条件化:memory+context 对 GPT-OSS 反而 +3.42,说明技能库应携带 Target 画像并按接收方条件选择支持组合,而非一套原则包打天下。第七,正确性缺口:有效但错误的提交近乎翻倍,需要显式增加针对内容正确性(而非流程完备性)的技能类型。
未来方向
作者提出的方向:把两遍冻结式学习扩展到更长任务流,研究原则如何被保留、修订与组合;在更大技能库上发展自适应检索与技能组合,超越 full-bank vs BM25 的粗对照;把学习、构建、执行纳入统一的计算/时延预算做部署级分配;在保留技能支持意图的同时用接收方反馈精化『存什么信息、给哪些工具、何时介入』;研究技能粒度与复用范围的关系(如『工具失败后保留证据』这类跨域原则与本地实现的分离);将 Builder 学习与 Target 能力提升结合,实现任务能力与支持环境的协同进化。基于本文成果可延伸:跨基准、未见任务族的技能市场与共享库(迁移实验已给出初步正信号);为多 Target 群体做 per-Target 技能路由;把 meta-skill 框架搬到真实软件工程(SWE-bench 类长程任务)验证协调性瓶颈假设;用强化学习或偏好优化直接学习 Revise 策略本身;以及对单条 when/provide/use 原则做干预实验,建立更严格的因果解释。
复现评估
复现条件较为透明:代码已在 GitHub 开源(qiancheng-apodex/MetaSkill-AI4AI),作者承诺接收后发布技能学习、harness 构建、基线与评估的全部提示词和实验配置;附录 B/C 详尽记录了划分协议(按类别/域比例分配约 10% 开发集)、信息访问边界(构建时看不到测试轨迹与参考答案)、失败记 0 的分母规则、以及 20K 次配对任务 bootstrap 的区间算法。数据是公开基准 Harness-Bench(106 任务)与 NewtonBench(324 任务)。算力方面无训练,全部是 API 推理:Builder 为 GPT-5.6-Sol,Target 为 Gemini-3.6-Flash、Qwen3.8-Flash、GPT-OSS-120B;单任务 Target 预算 96K–192K tokens,构建 16K 输出、技能更新 8K。难点在成本与版本敏感性:主表涉及 3 Target × 2 基准 × 约 9 个条件的全量测试,再加开发两遍与消融/迁移实验,API 开销可观;所用模型均为持续迭代的闭源服务,换版本可能改变结论;每条件单次执行也使复现者难以判断数字稳定性。总体属于『协议清晰但成本较高、依赖商业 API』的中等偏难复现。
论文图表