AdviSD:通过定向多轮自蒸馏学习为前沿大模型提供咨询建议 AdviSD: Learning to Advise Frontier LLMs via Targeted Multi-Turn Self-Distillation
定向自蒸馏训练小型顾问模型,为冻结前沿LLM提供有效建议
前置知识
顾问-执行器架构
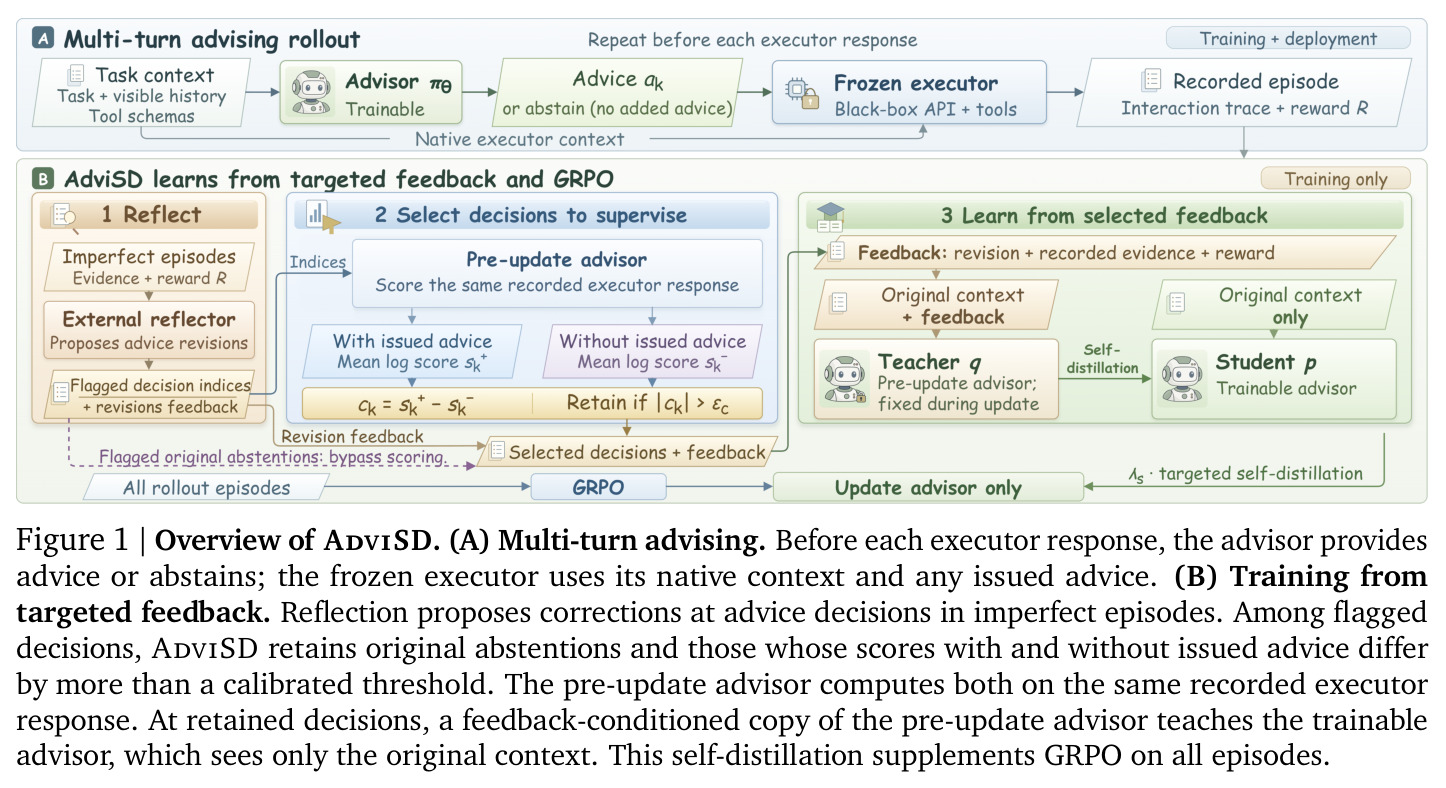
小型可训练的'顾问'模型在每个执行器回合前观察交互上下文,输出自然语言建议或弃权符 ,建议被插入冻结前沿'执行器'(如 Gemini 3.7 Flash)的临时请求中,不进入执行器持久历史。顾问无法修改执行器权重,只能通过文本间接引导其行为。
论文全部理论和实验都围绕'建议经冻结执行器间接生效'这一设定展开:正因为建议不直接决定动作,'纠错看似合理'与'真正改变执行'才会脱节,这是理解本文动机的钥匙。
GRPO(组相对策略优化)
Group Relative Policy Optimization:对同一任务采样 $n$ 个 rollout,用组内奖励均值和标准差归一化得到每个回合的优势 $\hat{A}_i=(R_i-\bar{R})/(s_R+\epsilon_A)$,再以裁剪目标加参考策略正则更新策略,无需价值网络。回合优势作用于该回合所有顾问 token,包括弃权。
AdviSD 的基础损失 $\mathcal{L}_{base}$ 就是 advisor-GRPO,自蒸馏是对它的补充而非替代;论文最重要的对照基线也是它,最终 AdviSD 在 BFCL-v3 上领先 GRPO 4.2-6.4 个百分点。
反馈条件化自蒸馏
把更新前的策略复制为'教师',在原始上下文中额外注入已完成交互的反馈(执行器响应、工具结果、检查项、反思内容),让它监督只看得到原始上下文的'学生'沿原采样轨迹匹配 next-token 分布;教师分布通过 stop-gradient 在训练期保持固定。
AdviSD 的教师就是这种反馈条件化副本,但它只在筛选后的建议决策上施加蒸馏——理解自蒸馏的师生机制是理解'定向'二字含义的前提。
反向KL散度
$\mathrm{KL}(p\|q)=\sum_v p(v)\log\frac{p(v)}{q(v)}$,以学生分布为期望站点,惩罚学生在教师低概率 token 上放置质量,具有 mode-seeking 特性。本文蒸馏损失是对更新前学生 top-$K$ token 支撑集重归一化后的 $\mathrm{KL}(p^S_{i,k,t}\|q^S_{i,k,t})$ 的平均。
Lemma 1 对'教师拟合 vs 执行改善'的分解 $g_h=-\alpha\nabla J_h(\bar{\theta})+e_h$ 正是对反向 KL 梯度的分析,不熟悉该散度就读不懂论文的理论部分。
配对打分(预测对比)
对同一条目标序列,在两个仅差一条信息的上下文中分别计算逐 token 对数似然,用差值度量该信息的影响力。本文中顾问在'含已发建议'与'不含建议'两种上下文里给执行器的同一条已记录响应打分,平均对数似然差 $c_k$ 反映建议对预测的改变幅度。
$|c_k|$ 与校准阈值 $\epsilon_c$ 的比较是 AdviSD 决定'在哪里学习'的全部依据,是整个方法的核心机制,也是它无需执行器似然或额外 rollout 的原因。
BFCL-v3 与 EnvScaler 基准
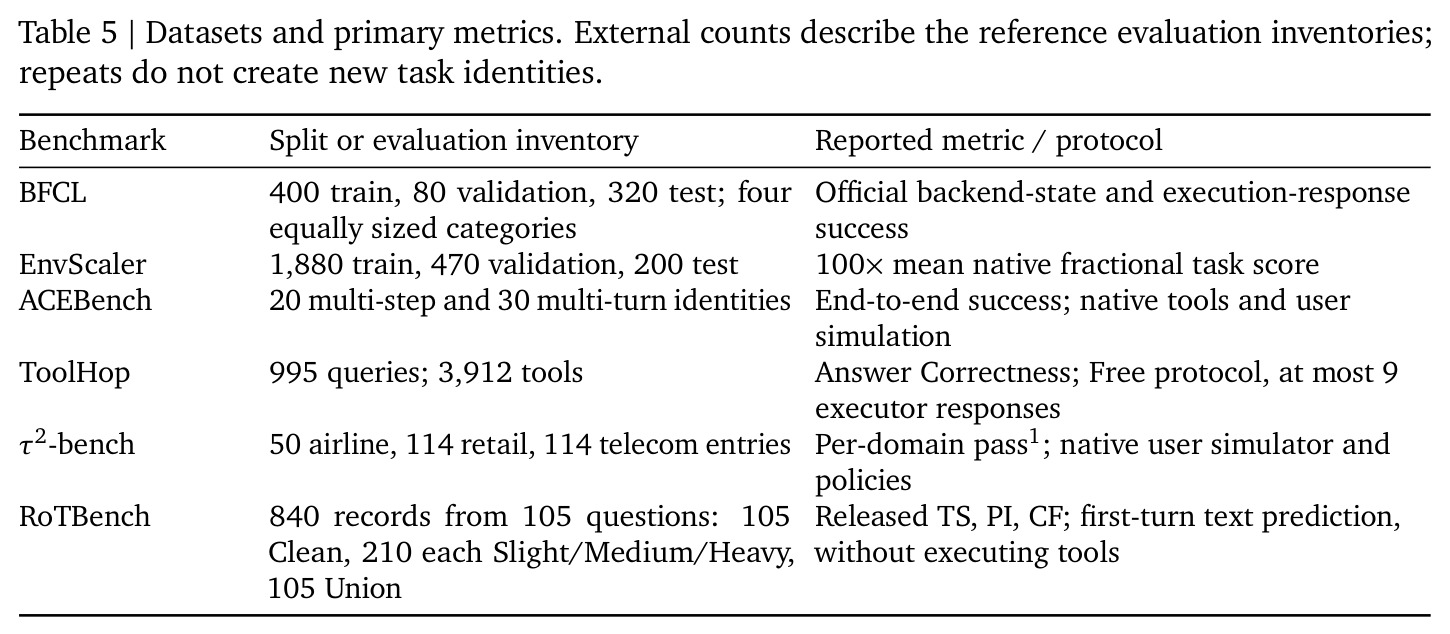
BFCL-v3 是伯克利函数调用排行榜的多轮版本,按 Base、Missing Function、Missing Parameter、Long Context 四类报告官方检查器准确率;EnvScaler 是环境化智能体任务基准,原生得分在 $[0,1]$ 区间。本文固定测试集分别为 320 和 200 个任务。
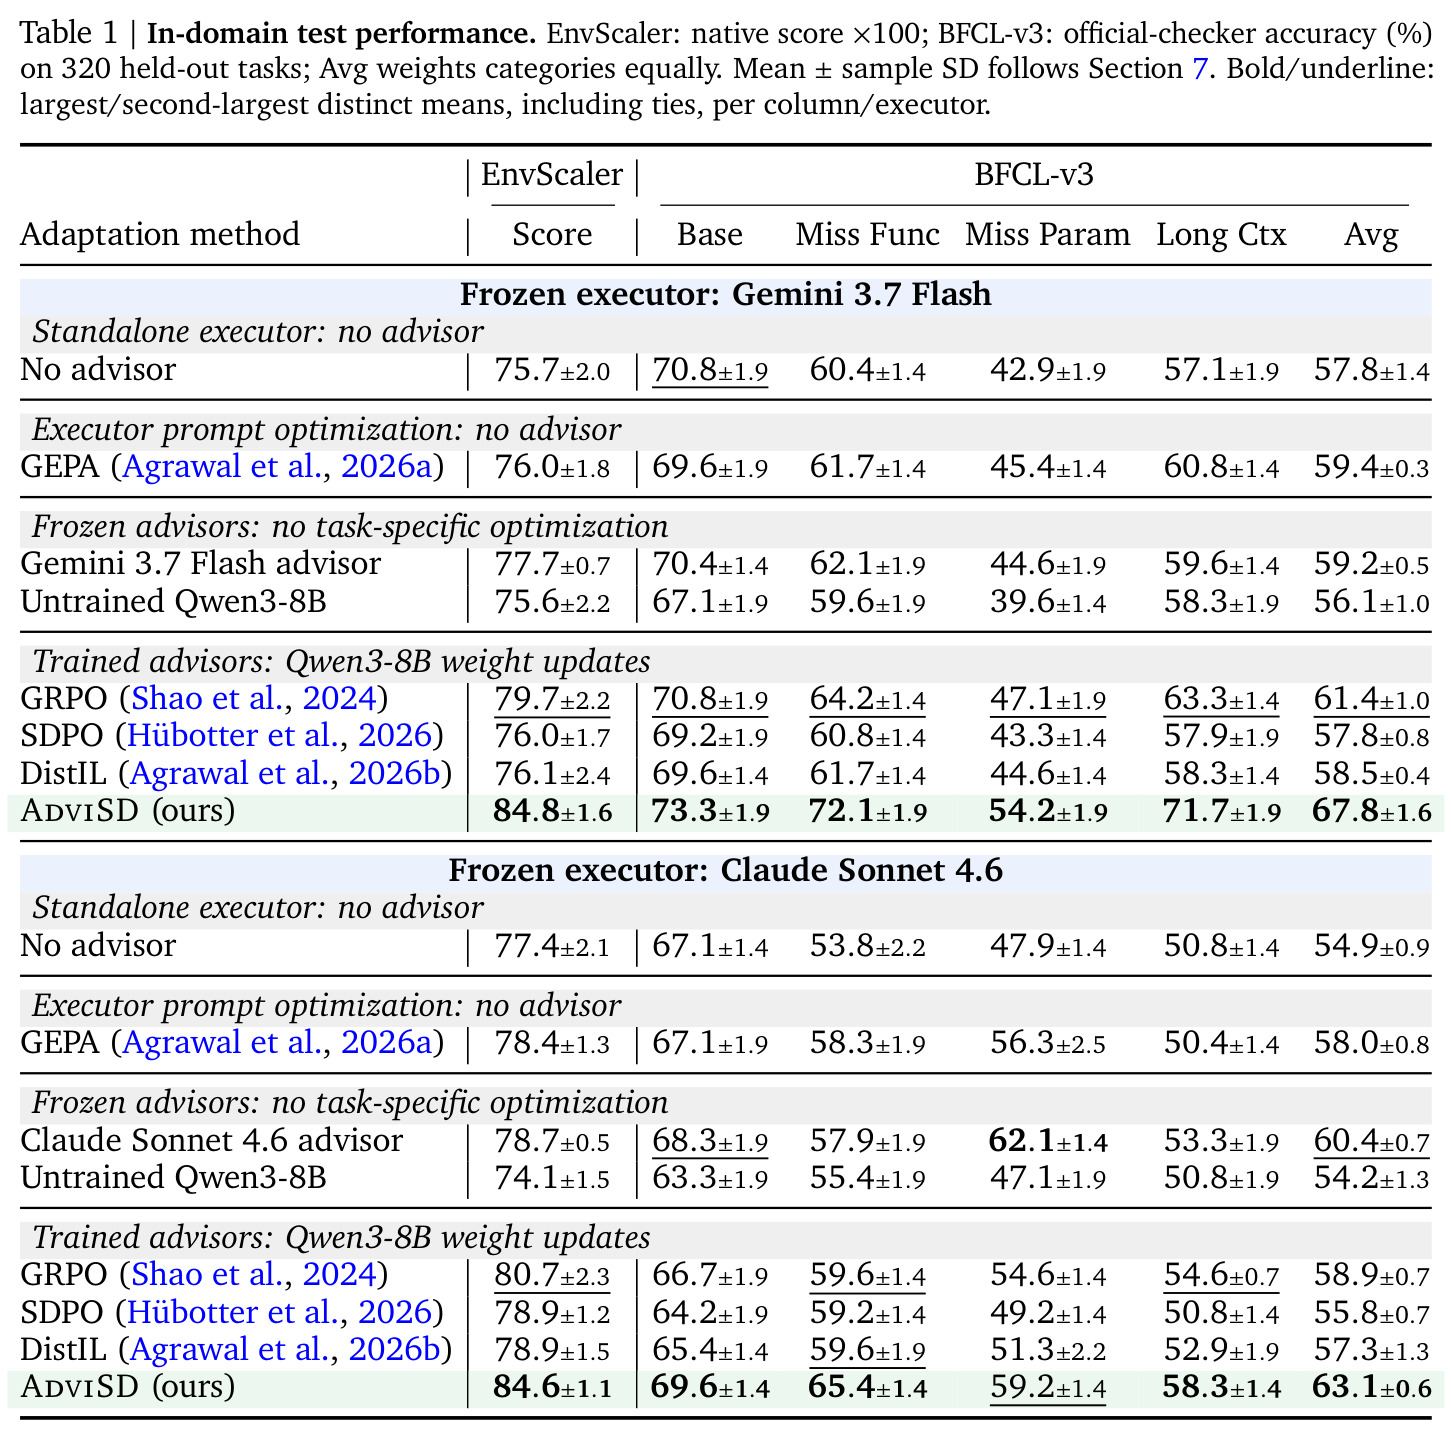
Table 1 的主战场就是这两个基准,所有域内结论(AdviSD 达到 BFCL-v3 平均 67.8%/63.1%、EnvScaler 84.8/84.6 分)都以它们的指标为口径。
研究动机
小型顾问模型可以在不改动前沿大模型权重的情况下,通过自然语言建议从外部适配被冻结的执行器,但训练该顾问的信号质量存在根本缺陷。单纯基于回合奖励的强化学习只给出标量反馈,无法指出回合中哪个建议决策应该改变、如何改变——一个回合奖励总结的是整体表现。反思加自蒸馏看似提供了更细粒度的监督,但一个看似合理的纠错未必改变执行器行为。论文给出具体场景:某执行器搜索航班很可靠,只是订票时偶尔猜错乘客 ID;预订失败后,反思既会提出查乘客 ID 并在订票时使用的纠错(真正有用),也可能建议把早已可靠执行的航班搜索描述得更详细(冗余)。两种修订都有效但有用性天差地别。由于顾问参数在所有决策间共享,从冗余纠错中学习会波及其他场景,可能削弱有用建议。论文进一步证明:随建议改善,可预防的失败越来越少,而不受建议影响的失败持续存在;若这些持续失败提供的纠错对有用建议的偏好更弱,其在监督中占比不断增大,会限制模型最终能达到的性能上限。
本文的目标是本文的目标是训练一个能在外部引导冻结前沿 LLM 的小型顾问,使其同时利用两种学习信号:任务奖励的强化学习和已完成交互反馈的自蒸馏,并且只从真正有用的纠错中学习。具体拆解为三个层面。理论层面回答'哪些纠错值得学习':在共享参数模型中,证明保留低价值纠错的比例如何决定学习极限,并分析加入奖励学习后选择性保留的效果。方法层面设计一个选择规则,使得判断'某条建议是否改变了执行器行为'不需要执行器的似然值,也不需要额外的执行器 rollout——因为执行器是 API 服务,内部概率不可得、反复调用成本高。实验层面要求在 BFCL-v3 和 EnvScaler 上超越 advisor-GRPO 基线 4-6 个百分点,并在不重训的条件下验证域外任务(ACEBench、ToolHop、τ2-bench、RoTBench)、跨执行器版本和跨模型家族的迁移能力,同时证明增益来自'选对了位置'而非单纯'减少了监督量'。
与已有工作不同的是,已有工作的切入角度与本文不同。SDPO、DistIL 等反馈条件化自蒸馏方法用轨迹级反馈(成功 rollout)监督整条轨迹;HERO 构造回合级反馈、HinT-SD 选择失败相关动作片段、SAGE-OPD 在单个回合选择加权教师监督,但它们都假设被训练的策略直接执行任务。本文的独特切入点在于:顾问的建议要通过一个冻结执行器间接生效,因此'拟合教师'与'改善执行'是两回事——Lemma 1 把对教师的反向 KL 梯度分解为价值上升项加残差项,残差可能助长也可能对抗价值上升,说明仅凭教师一致性无法判断纠错的价值。另一个独特设计是预测对比打分:让顾问自己用'含建议'和'不含建议'两种上下文给执行器的同一条已记录响应打分,用平均对数似然差 $|c_k|$ 作为建议是否起作用的预测信号,从而绕开对执行器内部信息的依赖。此外,论文设计匹配数量随机对照实验,把'减少监督量'与'选对监督位置'两个因素干净分离,这是同类工作中少见的严谨设计。
核心方法
AdviSD 的直觉是:一条建议是否值得学习,取决于它是否真的改变了执行器的行为走向;这可以用顾问在有无该建议两种上下文下、对执行器已记录响应的预测差异大小来度量。整体框架是结果奖励学习(GRPO)与定向自蒸馏的组合:$\mathcal{L}=\mathcal{L}_{base}+\frac{\lambda_s}{N_{ep}}\sum_i\frac{1}{\max\{1,|\mathcal{I}_i^*|\}}\sum_{k\in\mathcal{I}_i^*}\ell_{i,k}$,其中 $\mathcal{L}_{base}$ 是带裁剪与参考策略正则的 GRPO 损失、作用于全部回合且优势不变,自蒸馏项只作用于被选中的决策并按回合内平均。流程由四个角色协作:外部反思器在不完美回合提出纠错;预测对比门控用配对打分筛选值得监督的决策;更新前顾问的反馈条件化副本充当教师做蒸馏;结果奖励贯穿全部回合。反思与打分只在训练期运行,部署时顾问仅在每个执行器回合前决定建议或弃权,无额外开销。理论部分证明降低低价值纠错的保留率可严格提高学习极限。
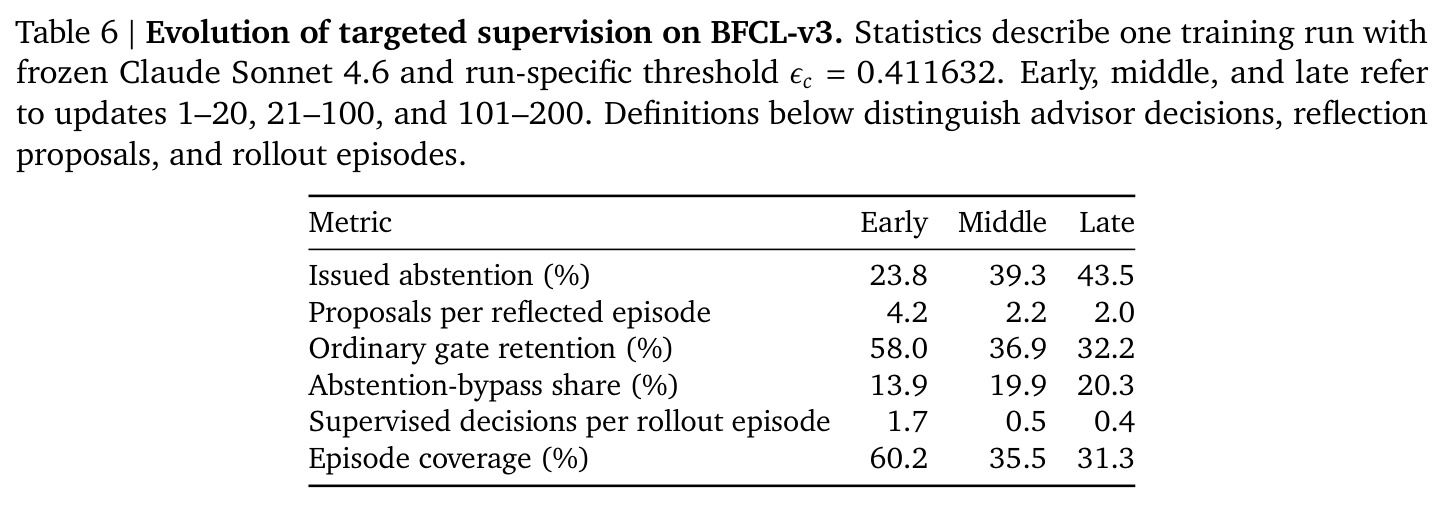
核心创新是把'提出纠错'与'选择学习位置'解耦,用预测对比作选择信号。对被反思器标记的决策,取发给执行器的原始请求构造两个打分上下文:$C^+_k$ 含已发建议、$C^-_k$ 不含,二者仅此不同;用更新前顾问 $\bar{\theta}$ 对同一条已记录响应 $y_k$ 逐 token 打分,得 $c_k=\frac{1}{T_k}\sum_t[\log\pi_{\bar{\theta}}(y_{k,t}|C^+_k,y_{k,\epsilon_c$ 的已发建议决策及被反思标记的原始弃权——弃权的两上下文相同故 $c_k\equiv 0$,须旁路门控才能被监督。
方法步骤详情
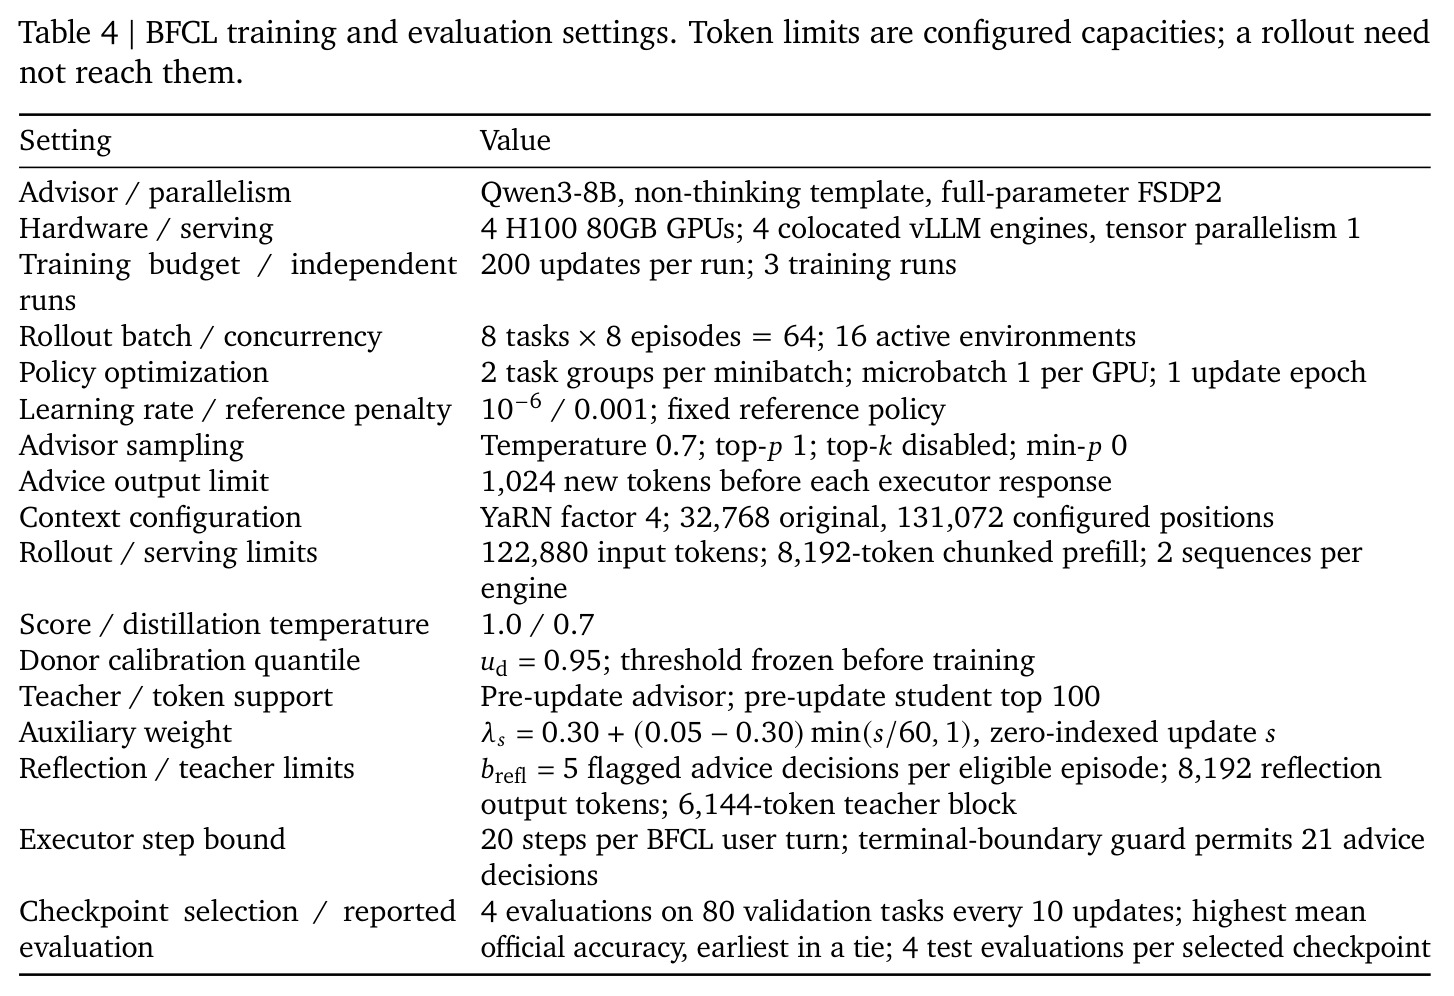
第一步 rollout:顾问在每个执行器响应前读取上下文 $g_k$,采样建议文本或弃权 ,冻结执行器响应,回合结束得 $R\in[0,1]$。第二步反思:对每个不完美回合,反思器基于执行器响应、工具结果和检查项最多标记 $b_{refl}=5$ 个建议决策,纠错只用原决策时刻可得的信息。第三步打分与校准:训练前用初始顾问收集试点 rollout,以供体建议构造对比分布,取 0.95 分位数为阈值 $\epsilon_c$,再对每个被标记决策计算 $c_k$。第四步保留:从标记集 $\mathcal{J}_i$ 保留原始弃权和 $|c_{i,k}|>\epsilon_c$ 的决策,得 $\mathcal{I}_i$;弃权后改发建议的提议仍须过数值门控。第五步蒸馏:教师是更新前顾问的反馈条件化副本,输入为前置反馈 $\zeta_{i,k}$(执行证据、检查、回合得分、反思反馈)拼接 $g_{i,k}$,学生只见 $g_{i,k}$;二者以温度 $T_{SD}$ 沿原采样建议预测,在学生 top-$K$ 支撑集重归一化后算 KL,$\ell_{i,k}$ 取逐 token 均值。第六步联合优化:$\mathcal{L}=\mathcal{L}_{base}+\frac{\lambda_s}{N_{ep}}\sum_i\frac{1}{\max\{1,|\mathcal{I}_i^*|\}}\sum_k\ell_{i,k}$,按决策、回合、批三级平均;教师分布每批固定。
技术新颖性
新颖性有四点。其一,理论首次为'顾问式'自蒸馏证明选择必要性:Lemma 1 把对教师的反向 KL 梯度分解为 $g_h=-\alpha\nabla J_h(\bar{\theta})+e_h$,残差 $e_h$ 可能助长也可能对抗价值上升,教师一致性本身不能判断纠错价值;Theorem 1 证明仅蒸馏的期望梯度 $g(\theta)=B(\theta)p(1-p)[\theta-\mu(\theta)]$,均衡 $\theta^*=\mu(\theta^*)$ 由保留混合目标 $\mu(\theta)=\omega_I\ell_I+[1-\omega_I]\ell_S$ 决定,降低不敏感纠错保留率 $r_I/r_S$ 严格提高极限;Theorem 2 证明加奖励学习后选择性保留仍给出更高均衡 $\theta_\infty^G>\theta_\infty^0$,并把增益分解为构成项与暴露项。其二,选择信号只需顾问对同一条已记录响应的两次打分,无需执行器似然或额外 rollout,适配 API 执行器。其三,供体校准给出任务无关、训练期固定的门控基准。其四,匹配数量随机对照把'减少监督'与'选对位置'分离,实验证明后者才是增益来源(领先 2.5-4.9 分)。
实验结果
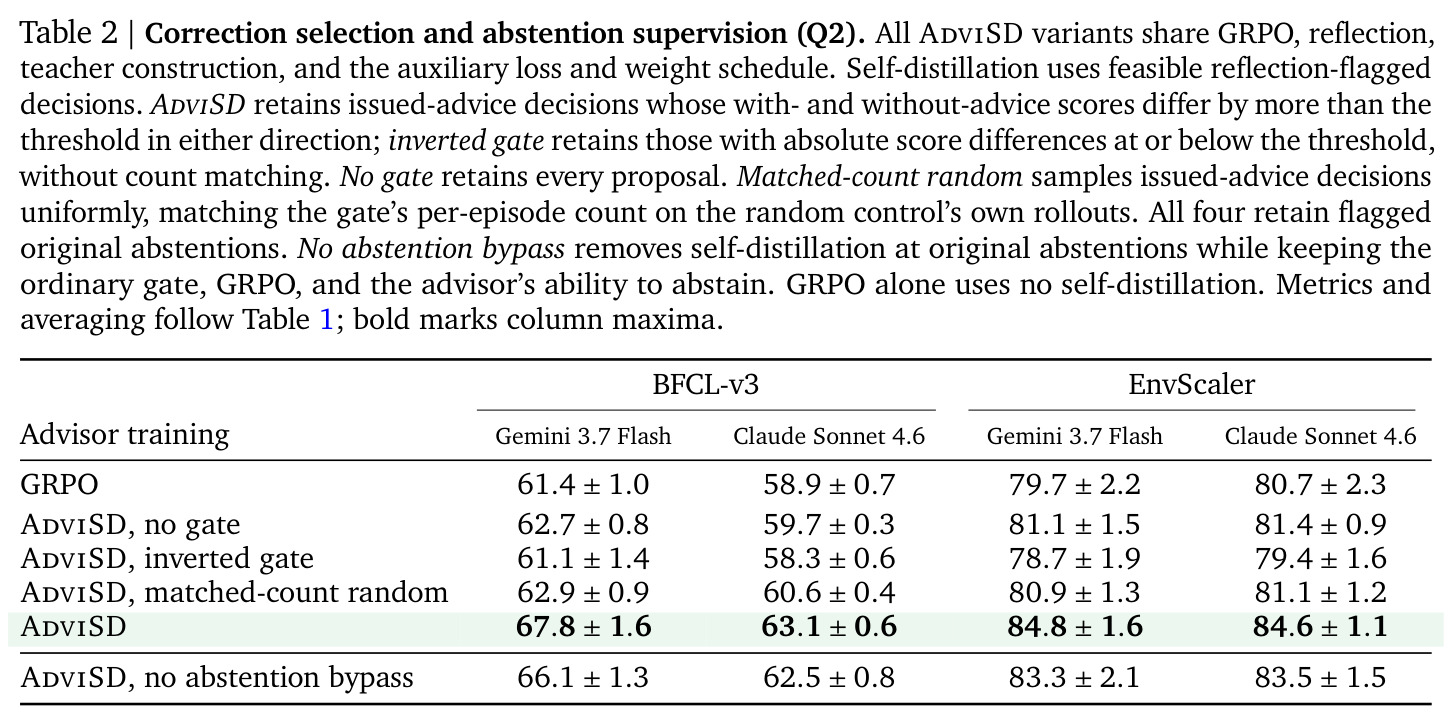
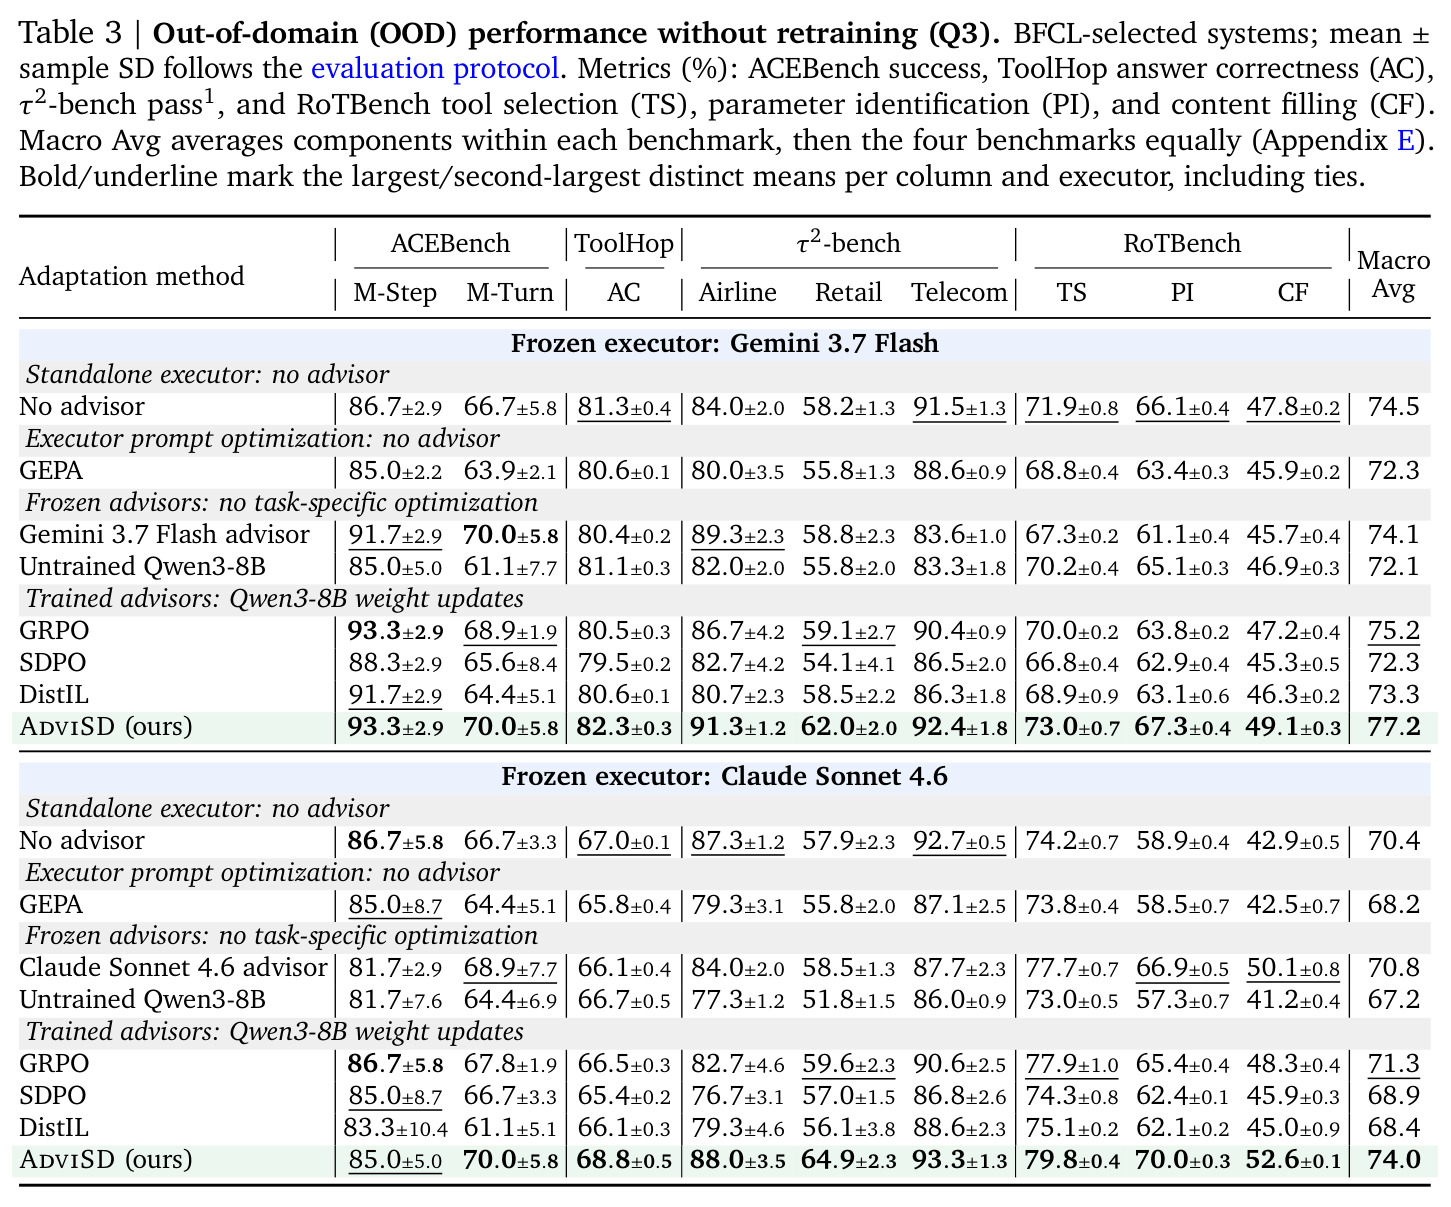
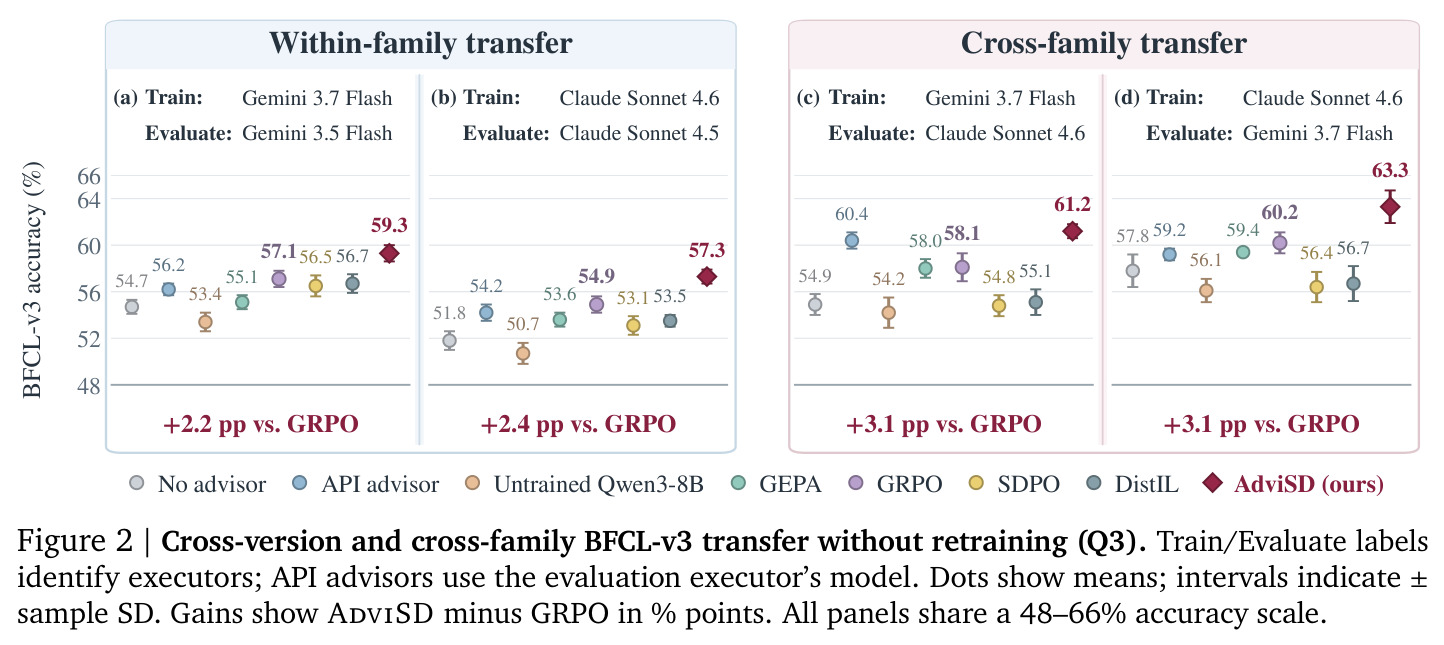
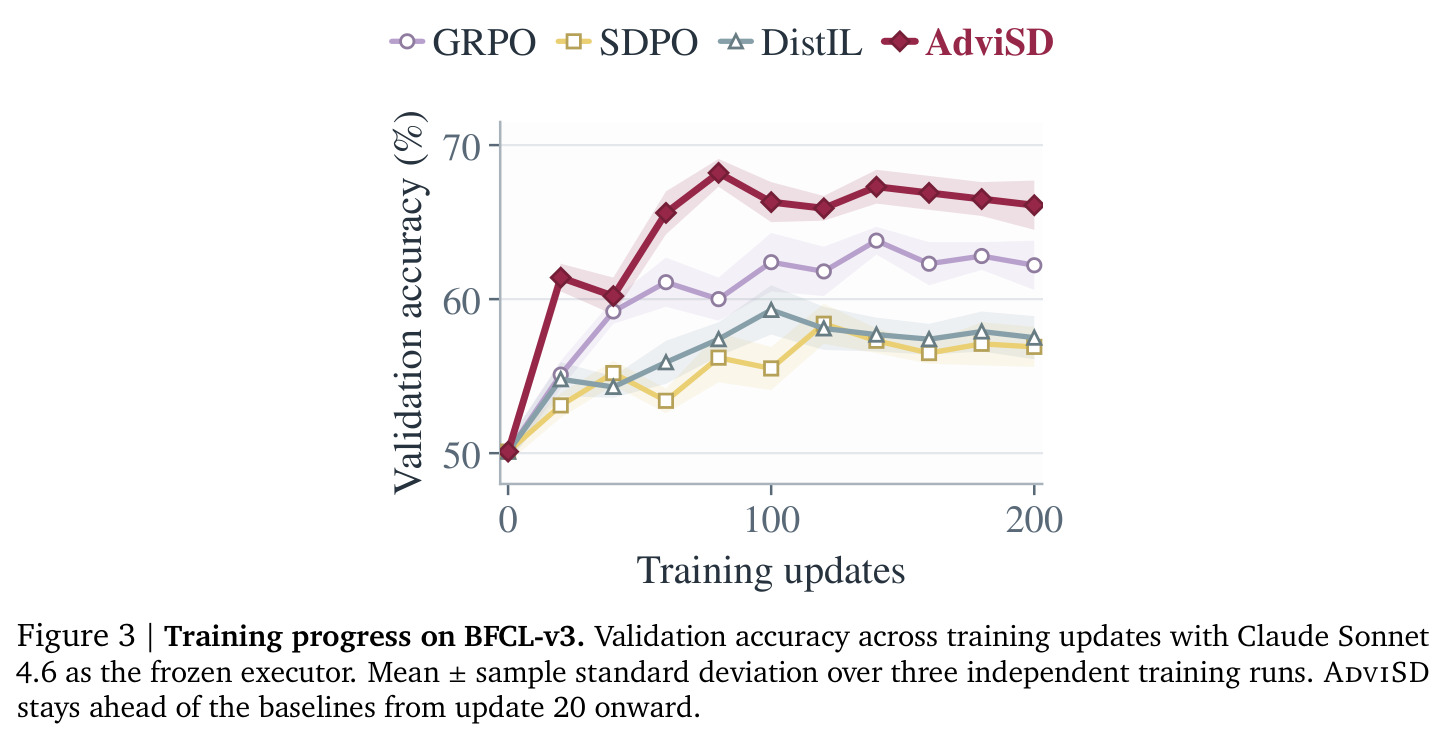
域内测试(Table 1,3 次独立训练、每检查点 4 次评估):Qwen3-8B 顾问在 BFCL-v3 上,Gemini 3.7 Flash 执行器下达 67.8±1.6%,超 GRPO 61.4±1.0%(+6.4pp)、SDPO 57.8%、DistIL 58.5%;Claude 执行器下达 63.1±0.6%,超 GRPO 58.9±0.7%(+4.2pp)。EnvScaler 上分别为 84.8±1.6 对 79.7±2.2(+5.1)和 84.6±1.1 对 80.7±2.3(+3.9)。增益集中在增强类别:Gemini 下 Missing Function 72.1% 对 64.2%、Long Context 71.7% 对 63.3%。训练后小顾问几乎每项反超冻结前沿顾问(唯一例外是 Claude 的 Missing Parameter)。消融(Table 2):领先匹配数量随机对照 2.5-4.9 分、无门控 3.2-5.1 分,两个随机类对照彼此相差不超过 0.9 分;倒置门控低于纯 GRPO;去弃权旁路损失 0.6-1.7 分。域外(Table 3,不重训):四基准宏平均 Gemini 77.2 对无顾问 74.5、GRPO 75.2;Claude 74.0 对 70.4、71.3;18 项比较 17 项最高。迁移(Figure 2):四方向全第一,跨家族超 GRPO 3.1pp。训练曲线(Figure 3):第 20 次更新起持续领先,后期约 +4pp。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| BFCL-v3 多轮函数调用(Gemini 3.7 Flash 执行器) | 官方检查器准确率(%,320 任务四类等权平均) | AdviSD 67.8±1.6 | advisor-GRPO 61.4±1.0;无顾问 57.8±1.4;GEPA 59.4±0.3 | +6.4pp(vs GRPO) |
| BFCL-v3 多轮函数调用(Claude Sonnet 4.6 执行器) | 官方检查器准确率(%) | AdviSD 63.1±0.6 | advisor-GRPO 58.9±0.7;无顾问 54.9±0.9 | +4.2pp(vs GRPO) |
| EnvScaler 环境化智能体任务(Gemini 执行器) | 原生得分×100(200 任务) | AdviSD 84.8±1.6 | advisor-GRPO 79.7±2.2;无顾问 75.7±2.0 | +5.1 分(vs GRPO) |
| EnvScaler 环境化智能体任务(Claude 执行器) | 原生得分×100 | AdviSD 84.6±1.1 | advisor-GRPO 80.7±2.3;无顾问 77.4±2.1 | +3.9 分(vs GRPO) |
| 消融:门控选择 vs 匹配数量随机对照(BFCL-v3,两执行器) | BFCL-v3 平均准确率 | AdviSD 67.8 / 63.1 | 匹配数量随机 62.9±0.9 / 60.6±0.4;无门控 62.7±0.8 / 59.7±0.3 | +4.9 / +2.5pp,证明增益来自选对位置而非减少监督 |
| 域外宏平均(ACEBench+ToolHop+τ2-bench+RoTBench,不重训) | 四基准宏平均(%) | AdviSD 77.2(Gemini)/ 74.0(Claude) | GRPO 75.2 / 71.3;无顾问 74.5 / 70.4;GEPA 72.3 / 68.2 | +2.0 / +2.7(vs GRPO);+2.7 / +3.6(vs 无顾问) |
| 跨模型家族迁移(BFCL-v3,不重训) | 准确率(%) | AdviSD 60.2(Gemini训练→Claude评估)/ 59.3(Claude训练→Gemini评估) | 迁移 GRPO 57.1 / 56.2 | +3.1pp(两个方向均如此) |
局限与改进
作者承认的局限:跨家族迁移仍低于专训——Gemini 训练的顾问在 Claude 4.6 上为 60.2%,低于专训的 63.1%,迁移模型不能替代执行器专属训练;效果随任务波动,Claude 的 ACEBench 多步任务上比无顾问低 1.7%,τ2-bench telecom 上冻结 Gemini 顾问比无顾问低 7.9pp。理论基于高度简化的共享参数模型:单一对数几率参数、每类失败一个固定教师、执行规律与教师目标训练期不变,与真实多 token 多决策、非稳态环境差距明显;实际选择用可观测的预测对比而非理论中的情形类型,其有效性仅由消融间接支持。我的观察:门控完全依赖顾问自身预测对比,若顾问校准差或响应很长导致打分噪声大,可能系统性误选;$|c_k|$ 只看幅度不看方向,无法排除'把执行器带偏但预测变化大'的决策;阈值 $\epsilon_c$ 用初始顾问校准后固定,随顾问变强可能失配;实验限于 8B 顾问、两个执行器家族和中等测试集(320/200 任务),$b_{refl}=5$ 等超参敏感性未系统报告。
独立分析的弱点
第一,打分噪声与方向盲视:$c_k$ 是对长 $T_k$ 个 token 的平均对数似然差,长工具调用响应下方差大;且门控接受两个方向的差异(只要 $|c_k|>\epsilon_c$),无法区分'建议把执行器带向成功'与'带向失败但预测变化大',改进方向是把符号信息或方向化价值估计引入选择。第二,静态阈值:供体校准基于初始顾问的对比分布,训练后期顾问分布漂移,阈值可能过紧漏掉新兴有用决策、或过松放行噪声——可改为周期性重校准或在线分位数估计。第三,教师天花板受限:教师是更新前顾问的反馈条件化副本,容量与学生对等,监督上限受自身能力约束——可探索更强冻结模型做教师并研究跨容量蒸馏偏差。第四,弃权旁路完全绕过打分,依赖反思器准确识别漏建议,误报会把冗余弃权纳入监督——可给旁路加轻量验证或置信度加权。第五,理论假设失败类型二分且执行规律固定,真实环境中执行器响应随建议动态变化,理论与实践的桥接(预测对比 vs 情形类型)目前只有消融证据——可在可控模拟环境中直接验证对比信号的判别力。
未来方向
作者提出的方向:把选择机制的理论分析推广到更一般的多参数、非稳态模型(附录 C/E 已有部分扩展);研究训练期监督的实际分配(附录 E.1)以进一步改进门控;解释为何跨家族迁移仍不及执行器专属训练。基于本文成果可延伸的方向:一是将定向自蒸馏推广到更大的顾问模型或稀疏专家顾问,检验预测对比选择信号随规模的缩放规律;二是在执行器似然可得的场景(开源执行器)中融合真实执行器信号,检验其与顾问预测对比的互补性;三是把配对打分从单条响应扩展到子任务或流程级监督单元,研究更粗粒度选择与更细粒度选择的权衡;四是训练单个顾问同时服务多个执行器,反馈按执行器条件化,服务多模型 API 场景;五是把'匹配数量随机对照'的实验设计范式推广到其他选择式训练方法(经验回放优先级、数据筛选、课程学习)的评估;六是探索部署期持续学习,让顾问在真实服务流量中用失败案例做在线定向更新并监控门控质量漂移。
复现评估
复现难度中高。利好:所用基准全部公开——BFCL-v3(含官方多轮检查器)、EnvScaler、ACEBench、ToolHop、τ2-bench、RoTBench;顾问是开源 Qwen3-8B;方法描述细致(打分公式 Eq.3、供体分位数 $u_d=0.95$、$b_{refl}=5$、top-$K$ 支撑集、蒸馏温度 $T_{SD}$、评估协议均有说明),实验协议明确(3 次独立训练、每检查点 4 次评估、报告均值±样本标准差)。障碍:未声明开源代码或训练配置;训练需要 GRPO/RLHF 基础设施与多 GPU 更新 8B 模型,且每回合都要调用 Gemini 3.7 Flash 或 Claude Sonnet 4.6 的 API(反思、试点校准、消融影子门控均额外增加调用),预算不小;供体校准、教师分布批内固定等工程细节需自行实现。建议路线:先在任务子集上跑通 advisor-GRPO 对齐 61.4/58.9 的量级,再按 Table 2 消融顺序逐模块加入反射、校准门控、弃权旁路与蒸馏,逼近 67.8/63.1 的目标。
论文图表