APM-Bench:面向真实世界自我中心流式视频助手的跨会话持久记忆基准 APM-Bench: Benchmarking Cross-session Persistent Memory for Egocentric Streaming Video Assistants
首个以多会话生活轨迹评测流式视频助手跨会话持久记忆的基准,揭示效用-延迟-存储三难权衡
前置知识
流式视频模型
按时间顺序在线接收视频帧的多模态大模型:任意时刻只能利用当前时刻之前的因果前缀,边看边理解边回答,不能回放整段视频或预知未来,通常以 1 FPS 抽帧并要求秒级响应。代表评测有 StreamingBench、OVO-Bench,代表记忆方法有 ReKV、Flash-VStream 等。
APM-Bench 的所有任务都遵循严格的因果约束(模型只能看到查询时刻之前的视频前缀),不理解流式推理协议就无法理解其任务设计与探针机制。
持久记忆(Persistent Memory)
指一次交互(会话)结束后仍可保存、并在后续会话中恢复使用的历史经验记录,形式可以是原始视频、文本摘要、视觉 token、KV cache、事件树,甚至写入模型参数的快权重。核心矛盾在于:保留越多信息对后续任务越有用,但存储成本与检索延迟也随之上涨,有限存储注定无法保留全部历史。
持久记忆正是本文评测的一等对象:『存什么、何时用、多贵』三问贯穿整个基准的设计与全部实验分析。
第一人称(Egocentric)视频
由佩戴在用户身上的相机拍摄的视频,视角即用户所见,典型任务包括动作识别、物体状态追踪、程序性活动理解等。本文使用两个公开自我中心数据集作为数据源:EgoLife(多日社区共同生活记录,含转录与时间戳字幕)和 HD-EPIC(细粒度厨房程序与物体标注)。
基准的全部数据来自这两个数据集,且任务形式(如『我两天前把切好的芒果放哪了』)高度依赖第一人称视角与跨天的时间结构。
五类流式记忆表示
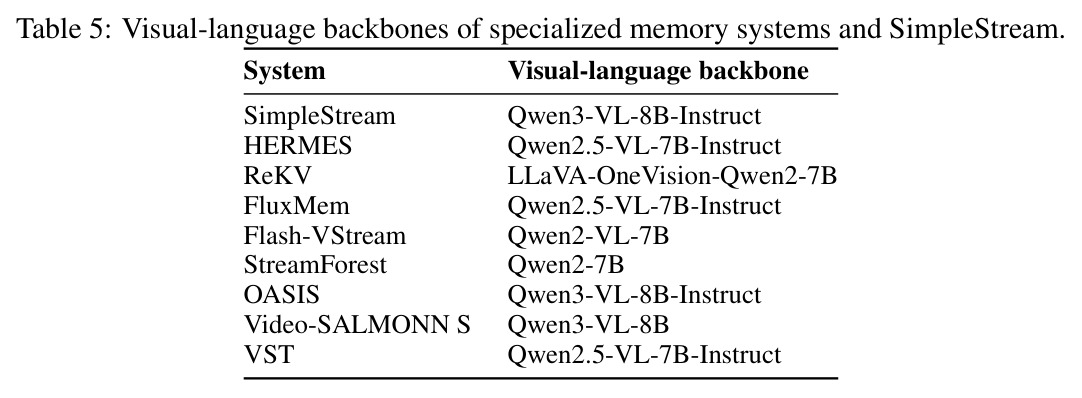
本文横评五种记忆表示:KV Cache(缓存注意力键值对,可检索压缩,如 HERMES、ReKV)、视觉 token/特征(FLUXMem、Flash-VStream)、事件树(如 StreamForest、OASIS)、参数化记忆(如 Video-SALMONN S)、推理思绪(如 VST)。
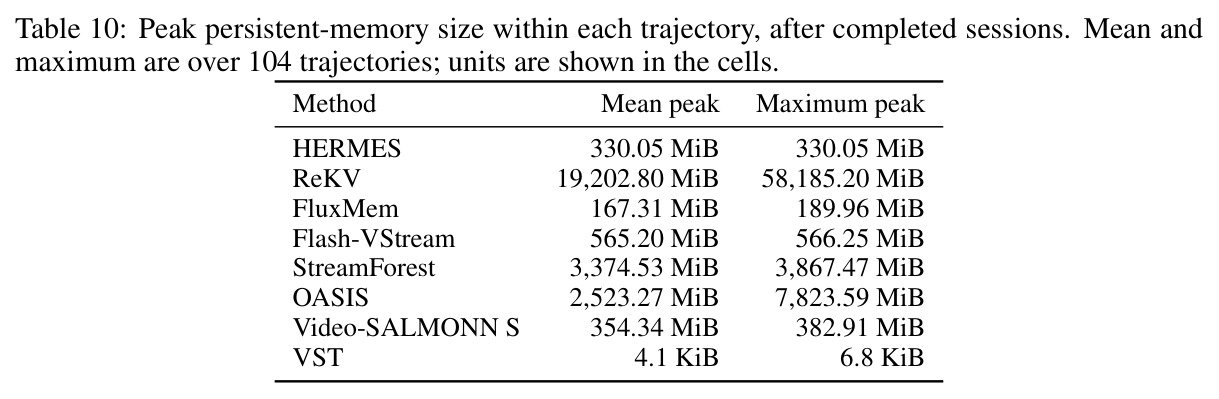
实验部分的大表按这五类表示组织,理解各类表示的存储/延迟特性,才能读懂 GiB 级与 KiB 级成本数字背后的权衡逻辑。
LLM-as-a-Judge
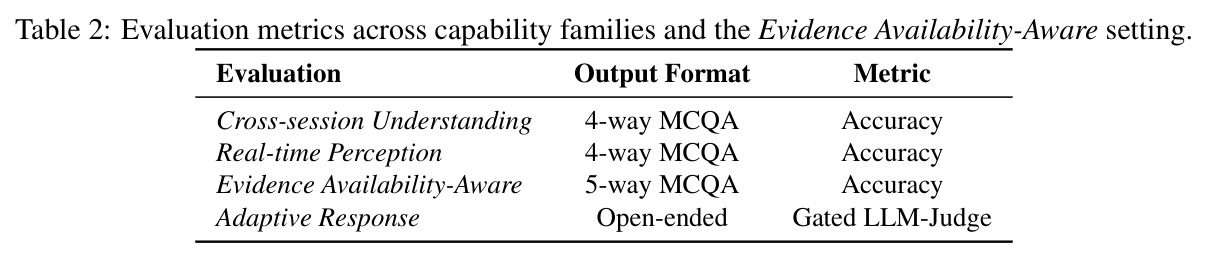
用强 LLM 按评分细则给开放式回答打分的评测范式。本文采用『门控+评审』两级设计:先确定性检查 SILENT/INTERVENE 决策是否正确,再由 DeepSeek-V4-Flash 按 1–5 分评内容质量,最后合成 0–100 的候选分。
主动服务没有唯一标准答案,不理解门控与评审的分工,就无法正确解读自适应响应各任务的得分含义。
研究动机
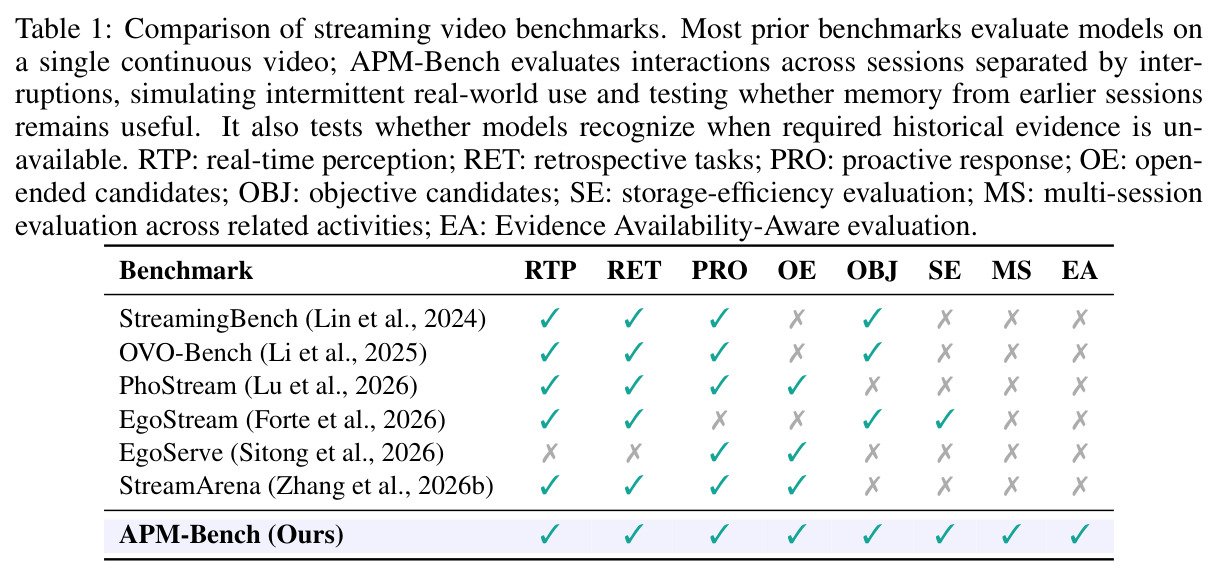
现有流式视频评测几乎都建立在『单条连续视频』之上:StreamingBench、OVO-Bench、RTV-Bench 考察在线理解,StreamArena 把交互拉长到小时级连续流,EgoStream 评测流式情景记忆,EgoServe、ESTP-Bench、EgoPro-Bench、OmniPro 考察主动服务与打断时机。但真实使用是断续的:用户会摘下智能眼镜,几小时甚至几天后才再次唤醒助手,此时已结束的视觉流无法回放,模型只能依赖跨会话存活的持久记忆来回答后续问题、提供主动帮助。更关键的是,已有评测很少把记忆效用与部署成本放在一起考察:原始视频记忆保细节但需要 GiB 级存储并引入重放延迟,文本摘要只要 KiB 级却丢失视觉细节;专用记忆系统(KV cache、事件树、参数化记忆等)大多只针对单条连续视频设计,缺少持久状态的导出与恢复。此外,有限存储注定无法保留全部历史,模型理应在证据缺失时承认『不知道』而不是编造答案,而这种元认知能力在以往基准中几乎没有被测试过(Table 1 显示此前没有一个基准同时覆盖多会话、存储效率与证据可得性)。
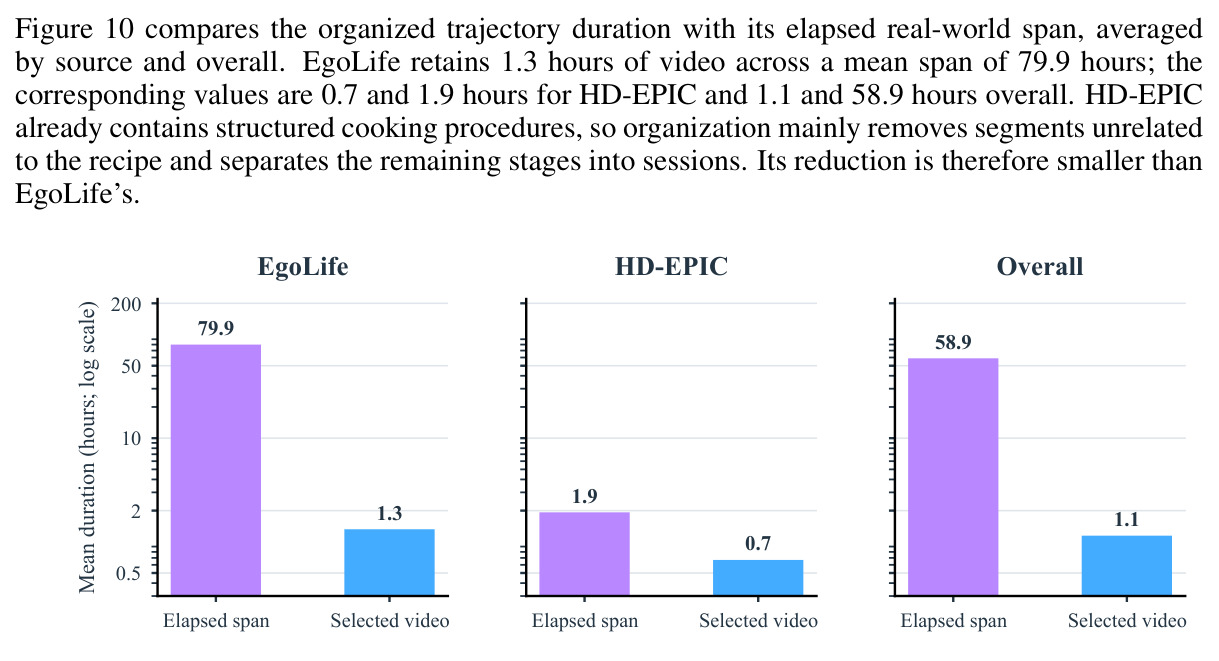
本文的目标是本文的目标是构建一个能模拟断续真实使用的基准 APM-Bench:把自我中心视频流重组为『活动相关的多会话生活轨迹』,会话内部保持连续时间线,会话之间保留真实时间间隔(轨迹平均只含约 69 分钟视频,真实跨度却可达数天),从结构上定义持久记忆的存取边界。在此设定下联合评测三种能力:(1)跨会话理解——利用记忆回答关于既往会话的问题;(2)实时感知——在当前场景中保持流式理解,并考察注入记忆是否会拖累它;(3)自适应响应——判断何时该保持沉默(SILENT)、何时该介入(INTERVENE),并给出有依据的帮助。同时以每视频小时的峰值存储和首 token 延迟量化部署代价,并专门构造『证据可得性感知』子集,测试模型在所需历史证据不可用时能否坦承证据不足而非捏造答案,从而为效用、延迟、存储三者联合优化的持久记忆研究提供统一试验场。
与已有工作不同的是,独特切入角度在于把持久记忆当作被直接评测的对象,而不是附属于视频理解的隐含能力。其一,组织方式上首次以多会话轨迹(104 条轨迹、549 个会话)模拟断续交互:会话围绕相关活动展开并保留真实挂钟时间戳与会话间隔,使『记忆持久性』与『视频时长』解耦,既能测长跨度记忆又控制了历史总量,让存储与延迟可比较。其二,评测协议上为自适应响应设计了门控 LLM 评审:先用确定性的 SILENT/INTERVENE 门控把关『该不该说话』,再由 DeepSeek-V4-Flash 按 1–5 分细则评『说得怎么样』,把时机决策与内容质量解耦。其三,成本度量上提出按视频小时归一化的峰值存储指标 $\text{Storage/hr}=\frac{1}{|T|}\sum_{\tau\in T} B^{\text{peak}}_{\tau}/D^{\text{peak}}_{\tau}$,使 GiB 级原始视频与 KiB 级摘要、KV cache、事件树、参数化记忆可在同一坐标下横向比较。其四,用 260 道五选一题目构造『证据在/不在最近两个已完成会话内』的对照集,专门检验记忆系统对自身覆盖范围的元认知。
核心方法
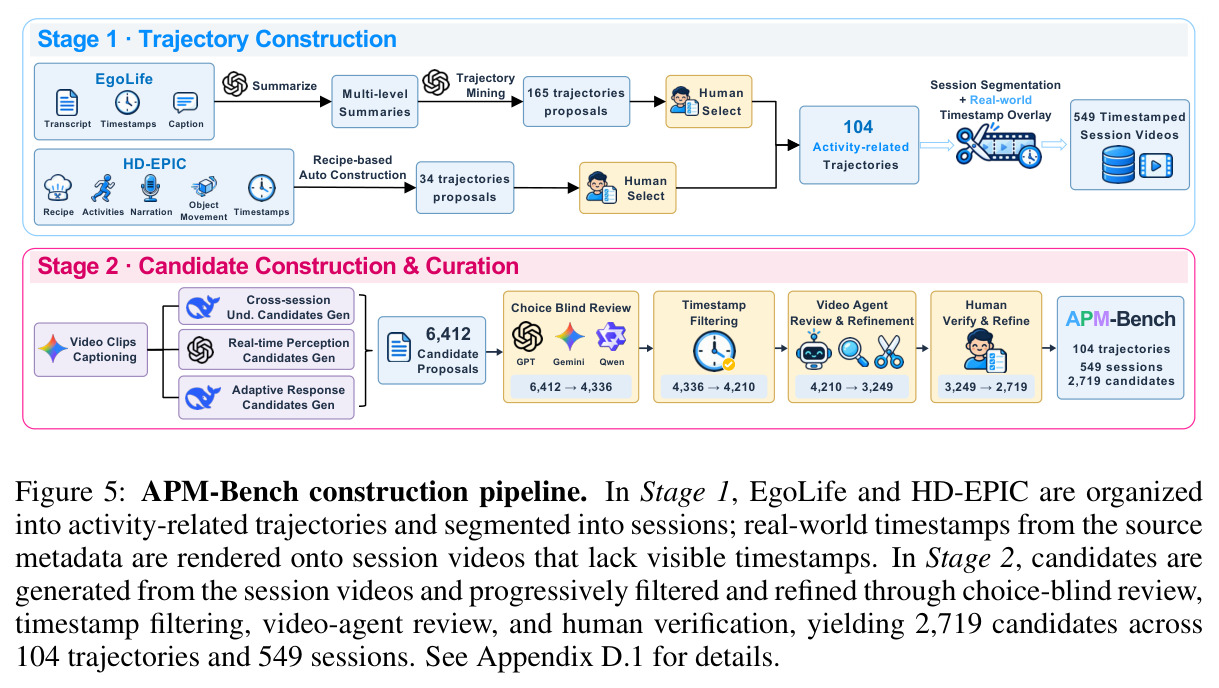
先讲直觉:真实的私人助手不是在看一部电影,而是在过一种断断续续的生活。APM-Bench 把这种生活轨迹作为评测单元:模型在每条轨迹上经历多个会话,会话内按 1 FPS 流式看视频,会话结束后把状态存入持久记忆,下次会话恢复记忆继续。技术路线分三块。数据上,两阶段构建:Stage 1 用 LLM 挖掘加人工筛选,把 EgoLife 与 HD-EPIC 组织成 104 条活动相关轨迹并渲染真实时间戳;Stage 2 由多模型协同生成候选,再经捷径过滤、因果过滤、VLM agent 审核与人工核验得到 2,719 个候选。任务上,12 个任务分三大能力族:跨会话理解(ER/EST/TR)与实时感知(ACR/CT/OCR/STU)为四选一选择题;自适应响应(ERA/RCR/MPA/PRM/TPG)为开放式,共 3,768 个 SILENT/INTERVENE 探针。评测上,在线推理严格因果:选择题(887/716 题)看准确率;自适应响应用门控 LLM 评审打分,另核算存储与延迟并做证据可得性评测。
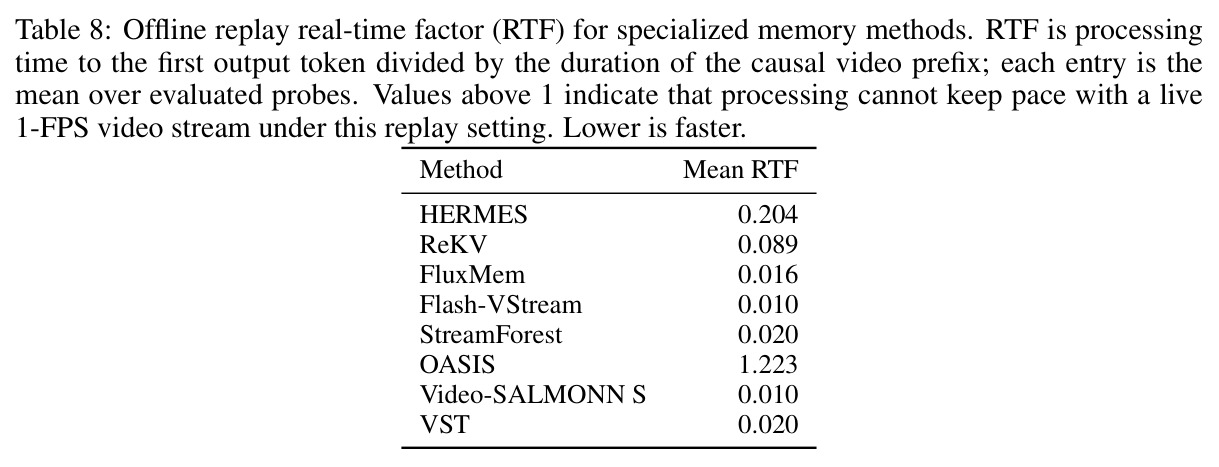
核心创新是『多会话轨迹』这一评测本体及围绕它的四件套设计。与以往在单条连续视频上测记忆不同,轨迹内的会话围绕相关活动展开(如连续多天的甜点制作),中间插入数小时到数天的真实间隔:模型必须把会话 N 的经验存下来、在会话 N+k 恢复使用,记忆是否『持久』因此成为被直接考验的变量,而非能靠长上下文蒙混的细节。第二个设计是探针机制:自适应任务在每个候选的精确时间戳上布置正/负探针——负探针要求 SILENT(证据未就绪或注册条件未满足),正探针要求 INTERVENE 并给出理由与回答,把『何时开口』变成与『说什么』同等重要的被测对象。第三个设计是证据可得性对照:只允许访问最近两个已完成会话,130 题证据在内、130 题在外并增设『可用证据不足』选项,检验模型对自身记忆覆盖的元认知。第四是成本归一化:以 $\text{Storage/hr}$(每视频小时峰值存储)统一度量异构记忆表示,配合首 token 延迟与回放实时因子 RTF,把 GiB 级原始视频与 KiB 级摘要放进同一坐标,联合评价效用、延迟与存储。
方法步骤详情
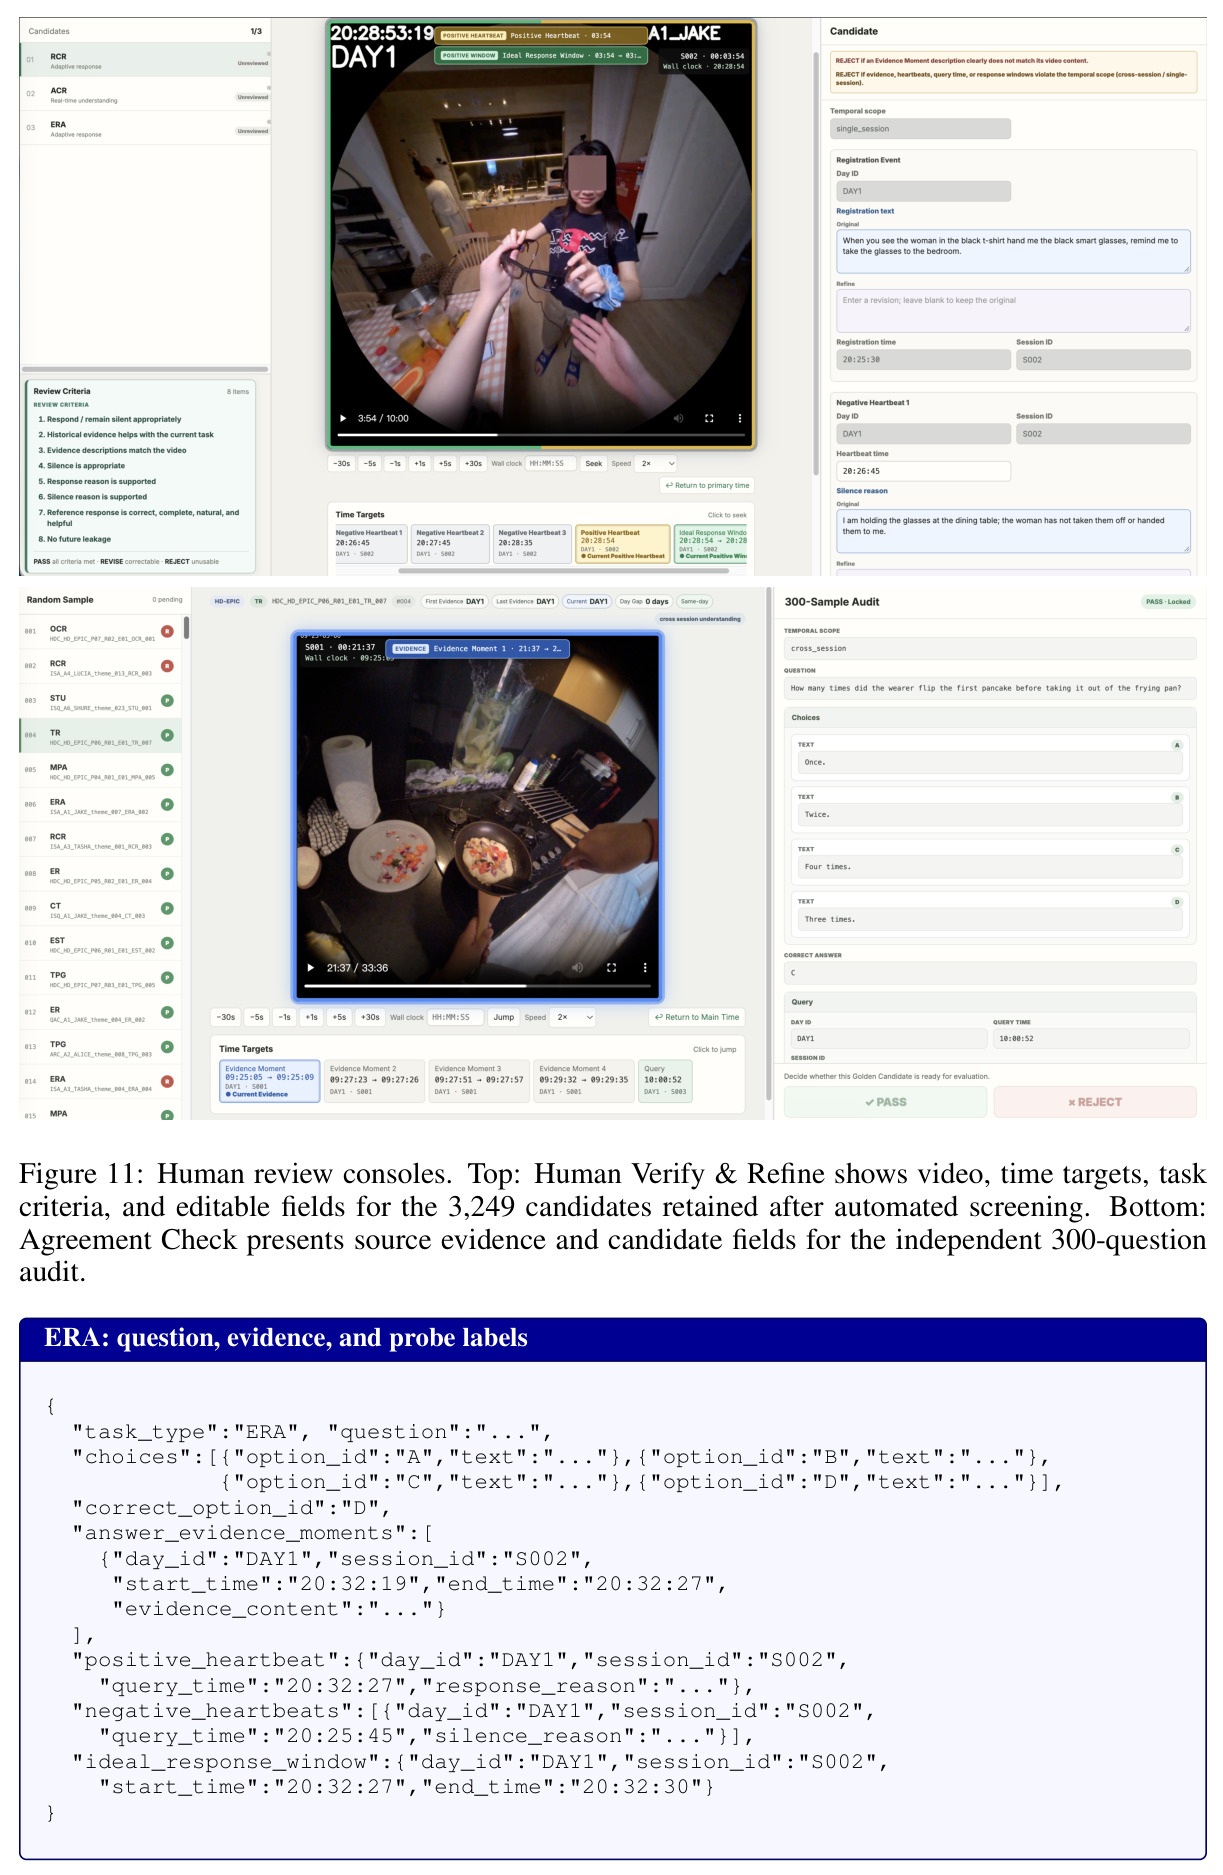
构建分两阶段。Stage 1(轨迹构建):对 EgoLife,GPT-5.4 从小时/日摘要中挖出 165 个轨迹提案,人工保留 76 条;对 HD-EPIC,按食谱构造 34 个提案,人工留 28 条;合计 104 条轨迹、549 个会话,并渲染真实时间戳。Stage 2(候选净化):Gemini-3.5-Flash 生成片段字幕;DeepSeek-V4-Flash 与 GPT-4o 分别出跨会话/自适应与实时感知候选,共 6,412 题;随后剔除捷径题(→4,336)、删违反因果的时间戳(→4,210)、VLM agent 审计修订(→3,249)、人工核验精修(→2,719),300 题双标注员 kappa 0.868。评测协议:模型只能访问既往记忆与当前会话截至探针/查询时刻的因果前缀;3,768 个自适应探针按独立实例评测;先过确定性门控(判对 SILENT/INTERVENE,正探针 ERA 还须选项正确),再由 DeepSeek-V4-Flash 按 1–5 分评内容,按 $s_c=20(\bar{g}_c^+ + \bar{g}_c^-)$ 合成 0–100 任务分。
技术新颖性
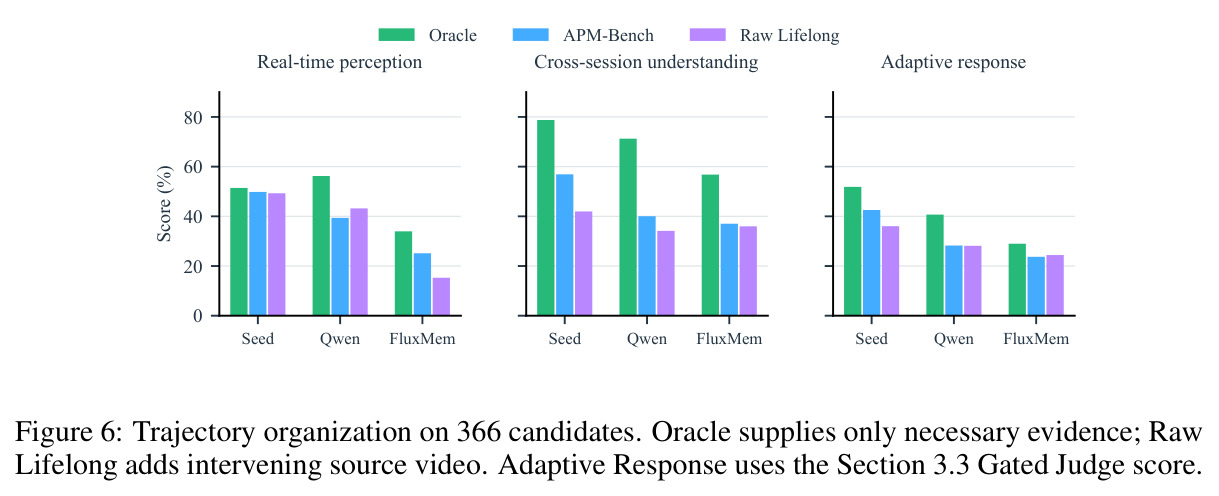
技术新颖性有四点。第一,评测对象从『视频理解』转向『记忆系统』:Table 1 显示 StreamingBench、OVO-Bench、EgoStream、EgoServe 等前作各自只覆盖实时感知、回溯、主动响应中的一两块,没有一个同时考察多会话持久性、存储效率与证据可得性,而 APM-Bench 八个维度全占。第二,门控 LLM 评审把主动交互评测从『答案对不对』升级为『时机+内容』双维度:门控是确定性检查(可复现、无法被评审模型糊弄),内容分仅在门控通过后给出,避免『胡说但嘴甜』得高分。第三,对专用记忆系统做了持久化改造与成本核算:多数被评方法(如 ReKV、HERMES)原本只支持单条连续视频、没有持久状态导出,本文让它们逐会话顺序处理并从推理态估算存储,首次给出五类记忆表示在统一预算下的横向对比。第四,轨迹组织消融(Figure 6)证明该设计并非权宜之计:相对拼回全部原始视频的 Raw Lifelong,活动相关轨迹让三个系统跨会话理解得分的标准差从 3.33 扩大到 8.75,模型差异更可分辨,且 Oracle 条件下仍有 19.78–31.21 分提升空间。
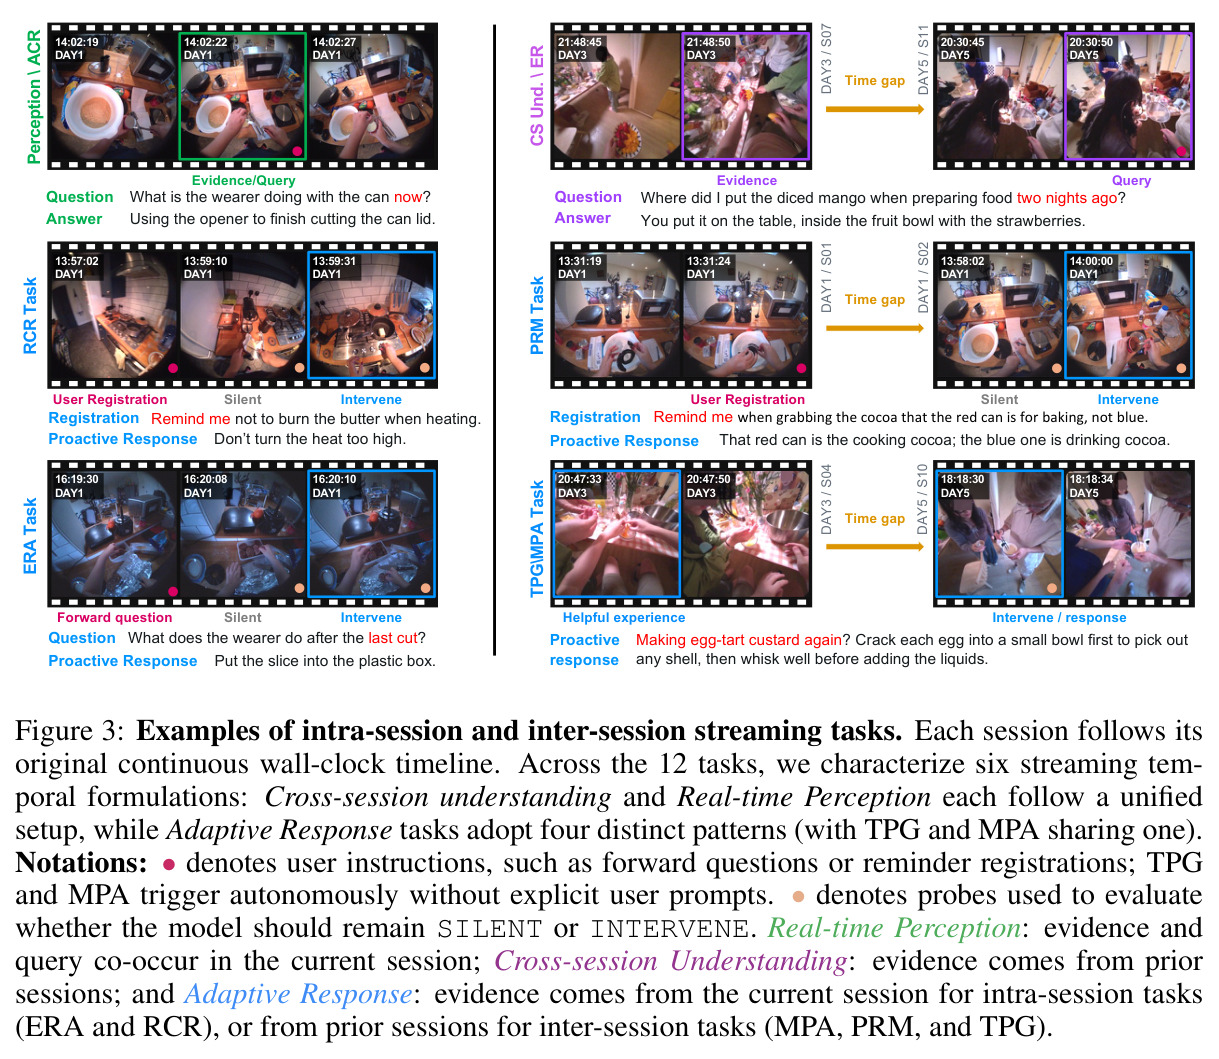
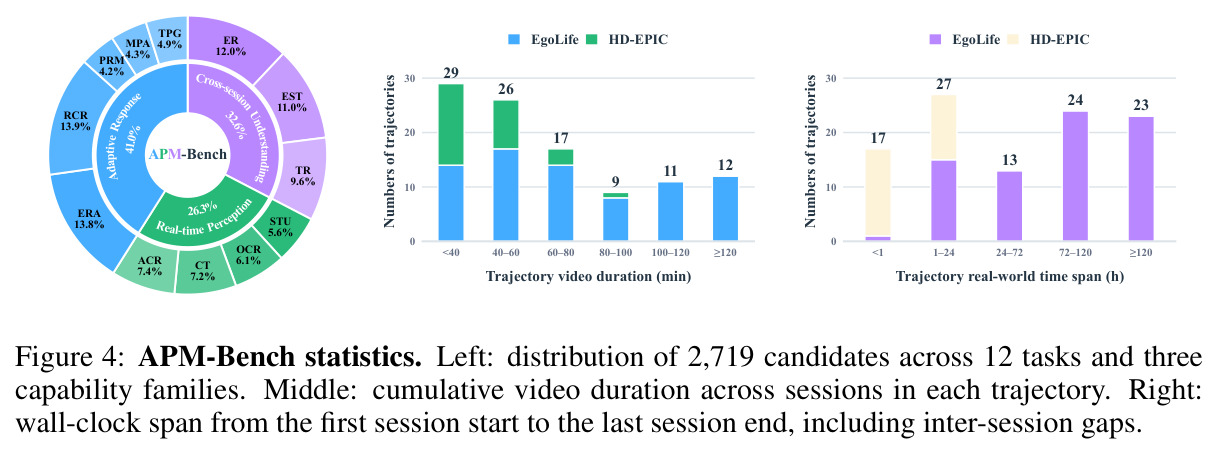
实验结果
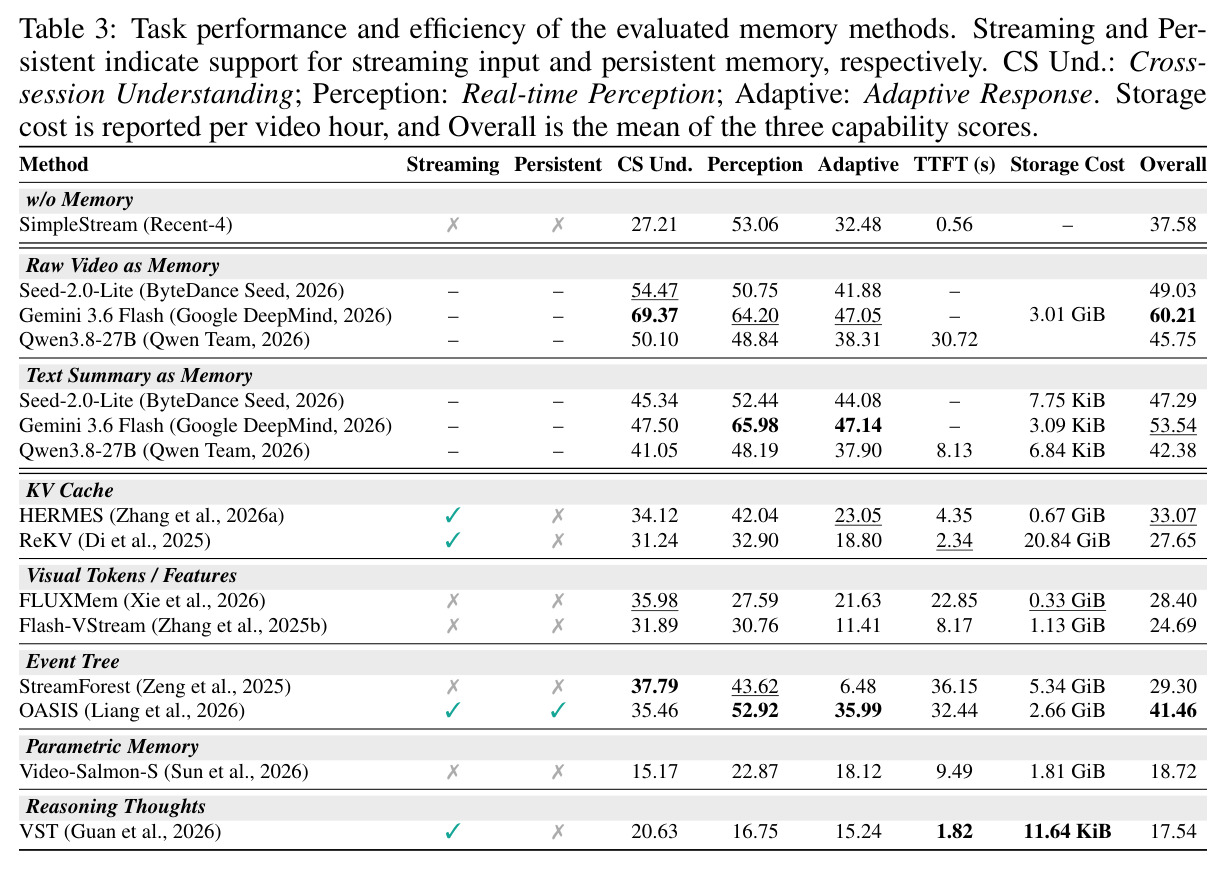
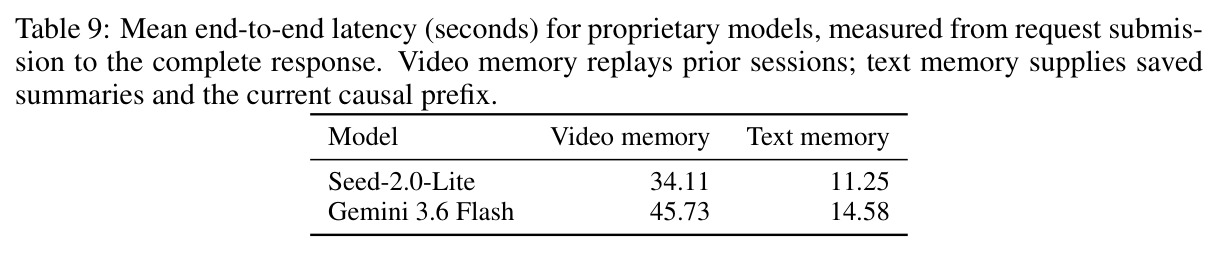
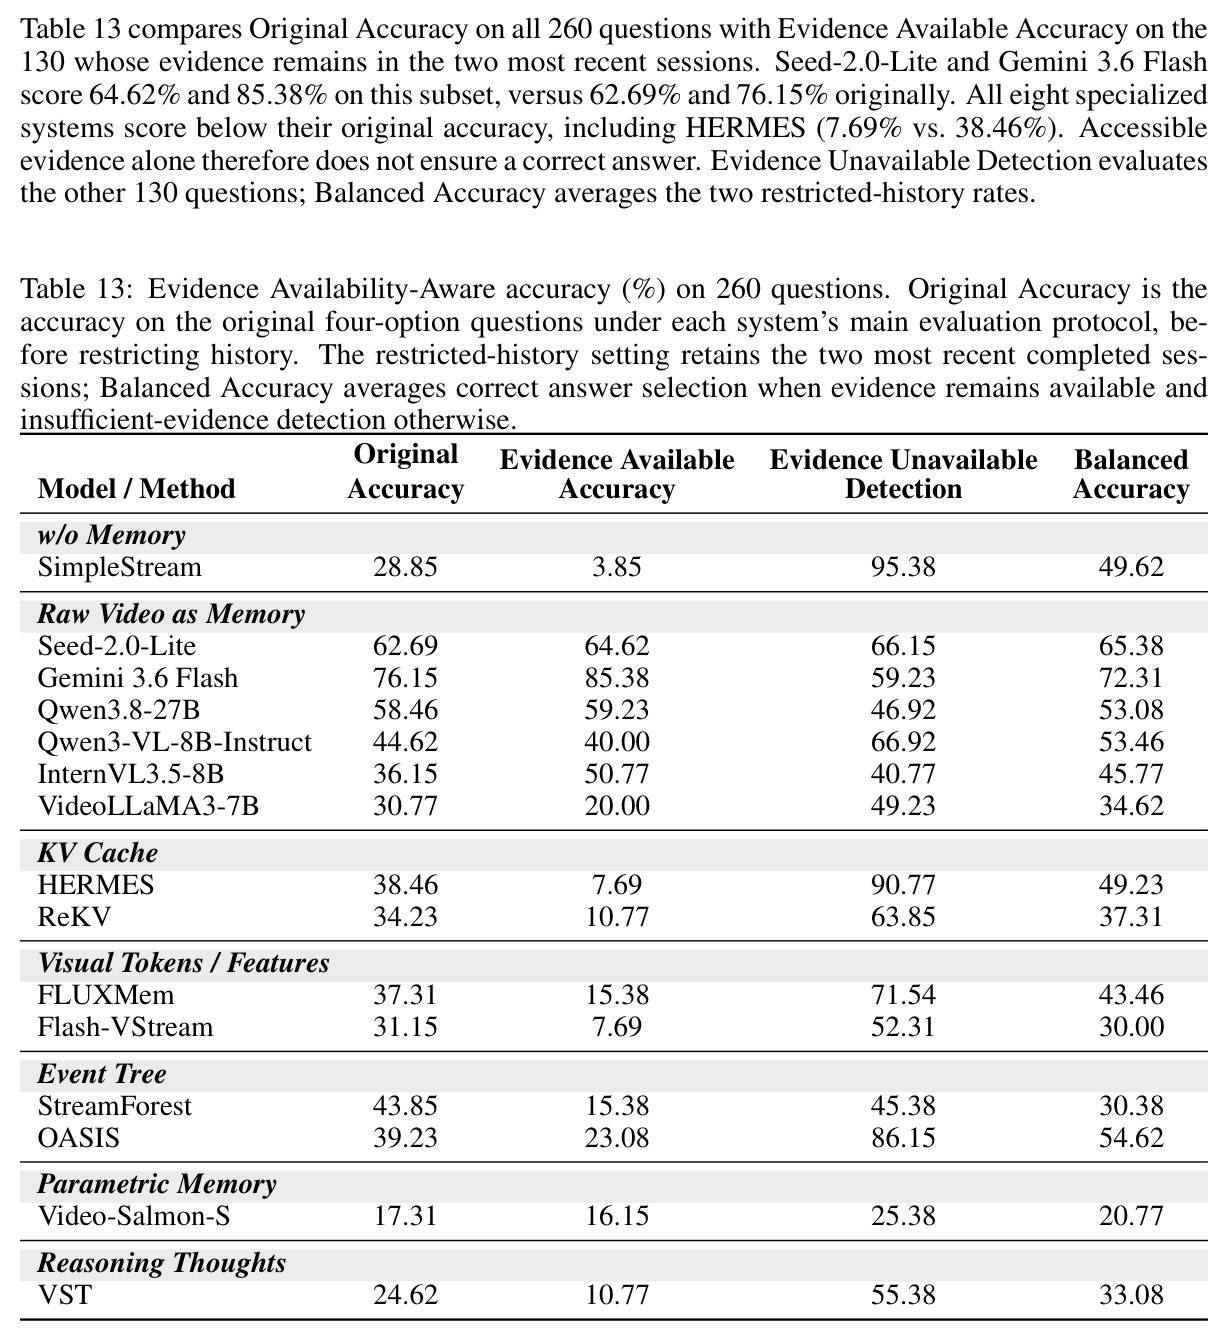
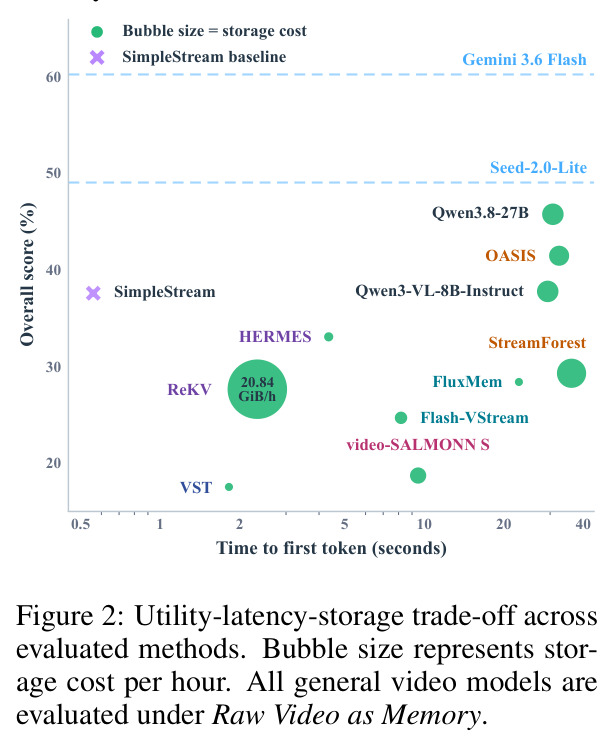
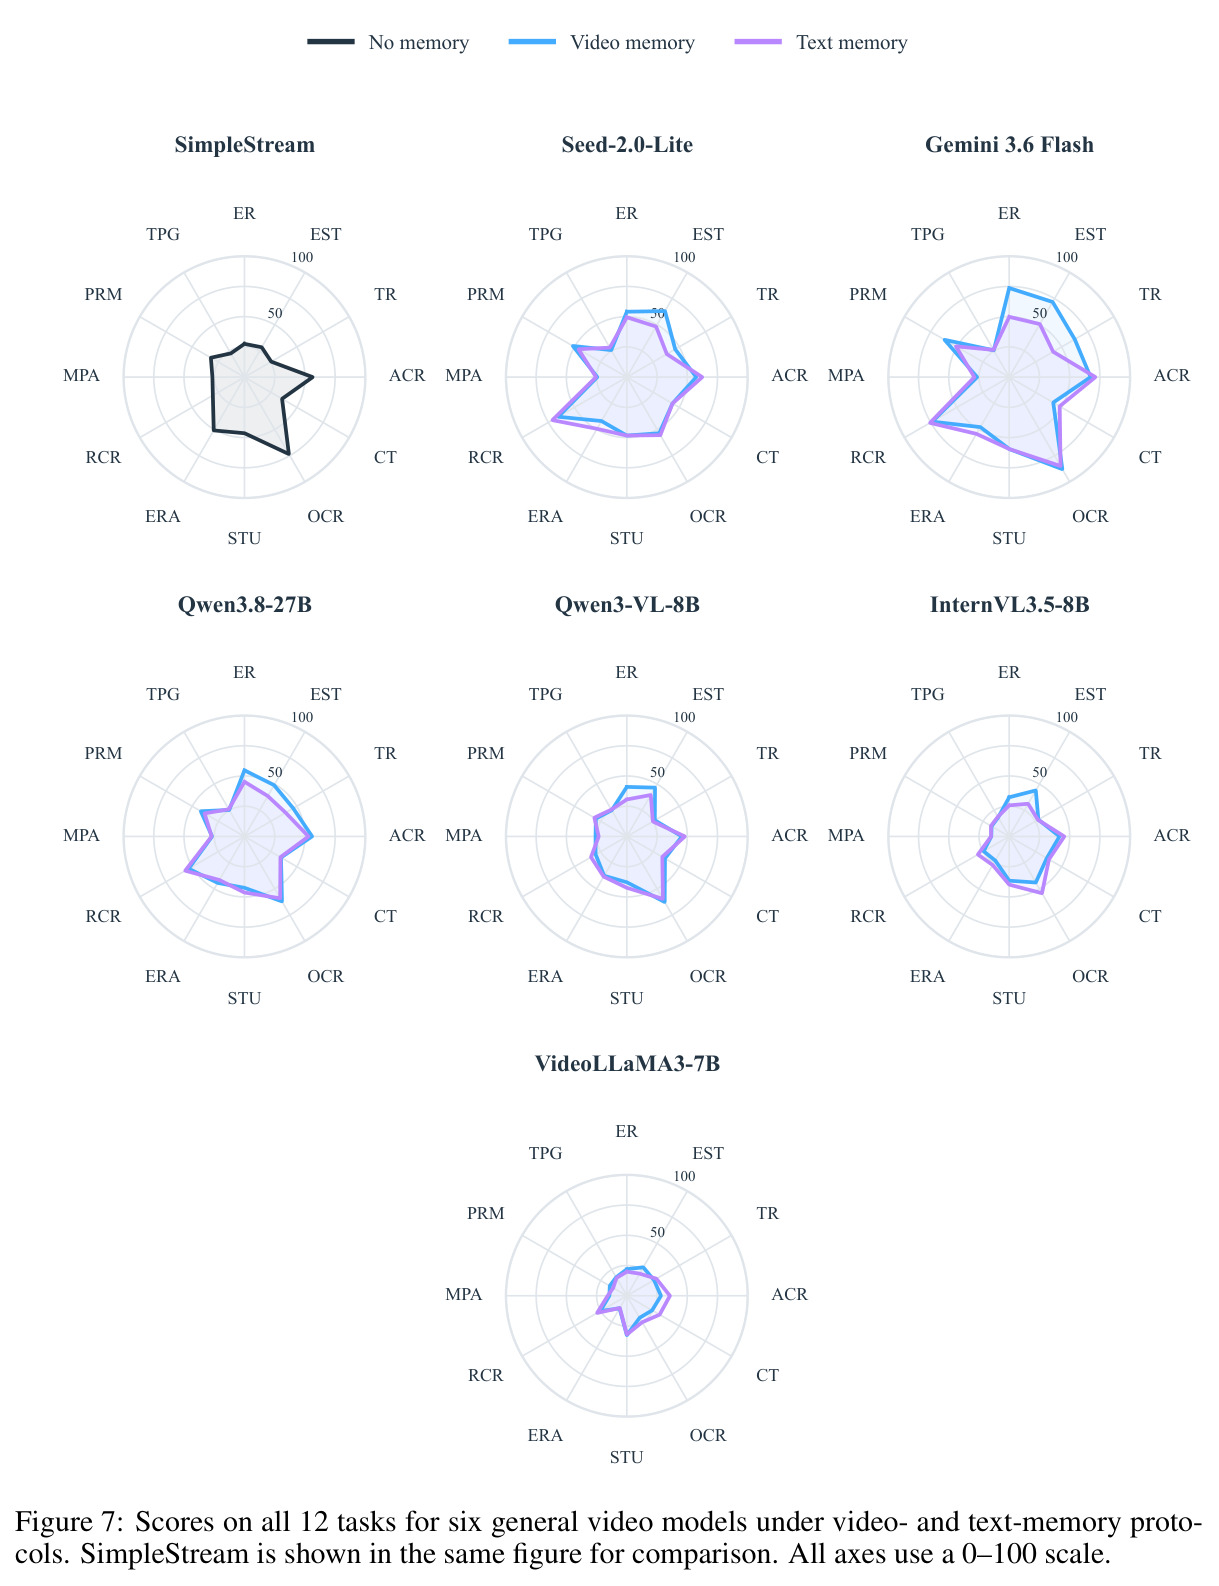
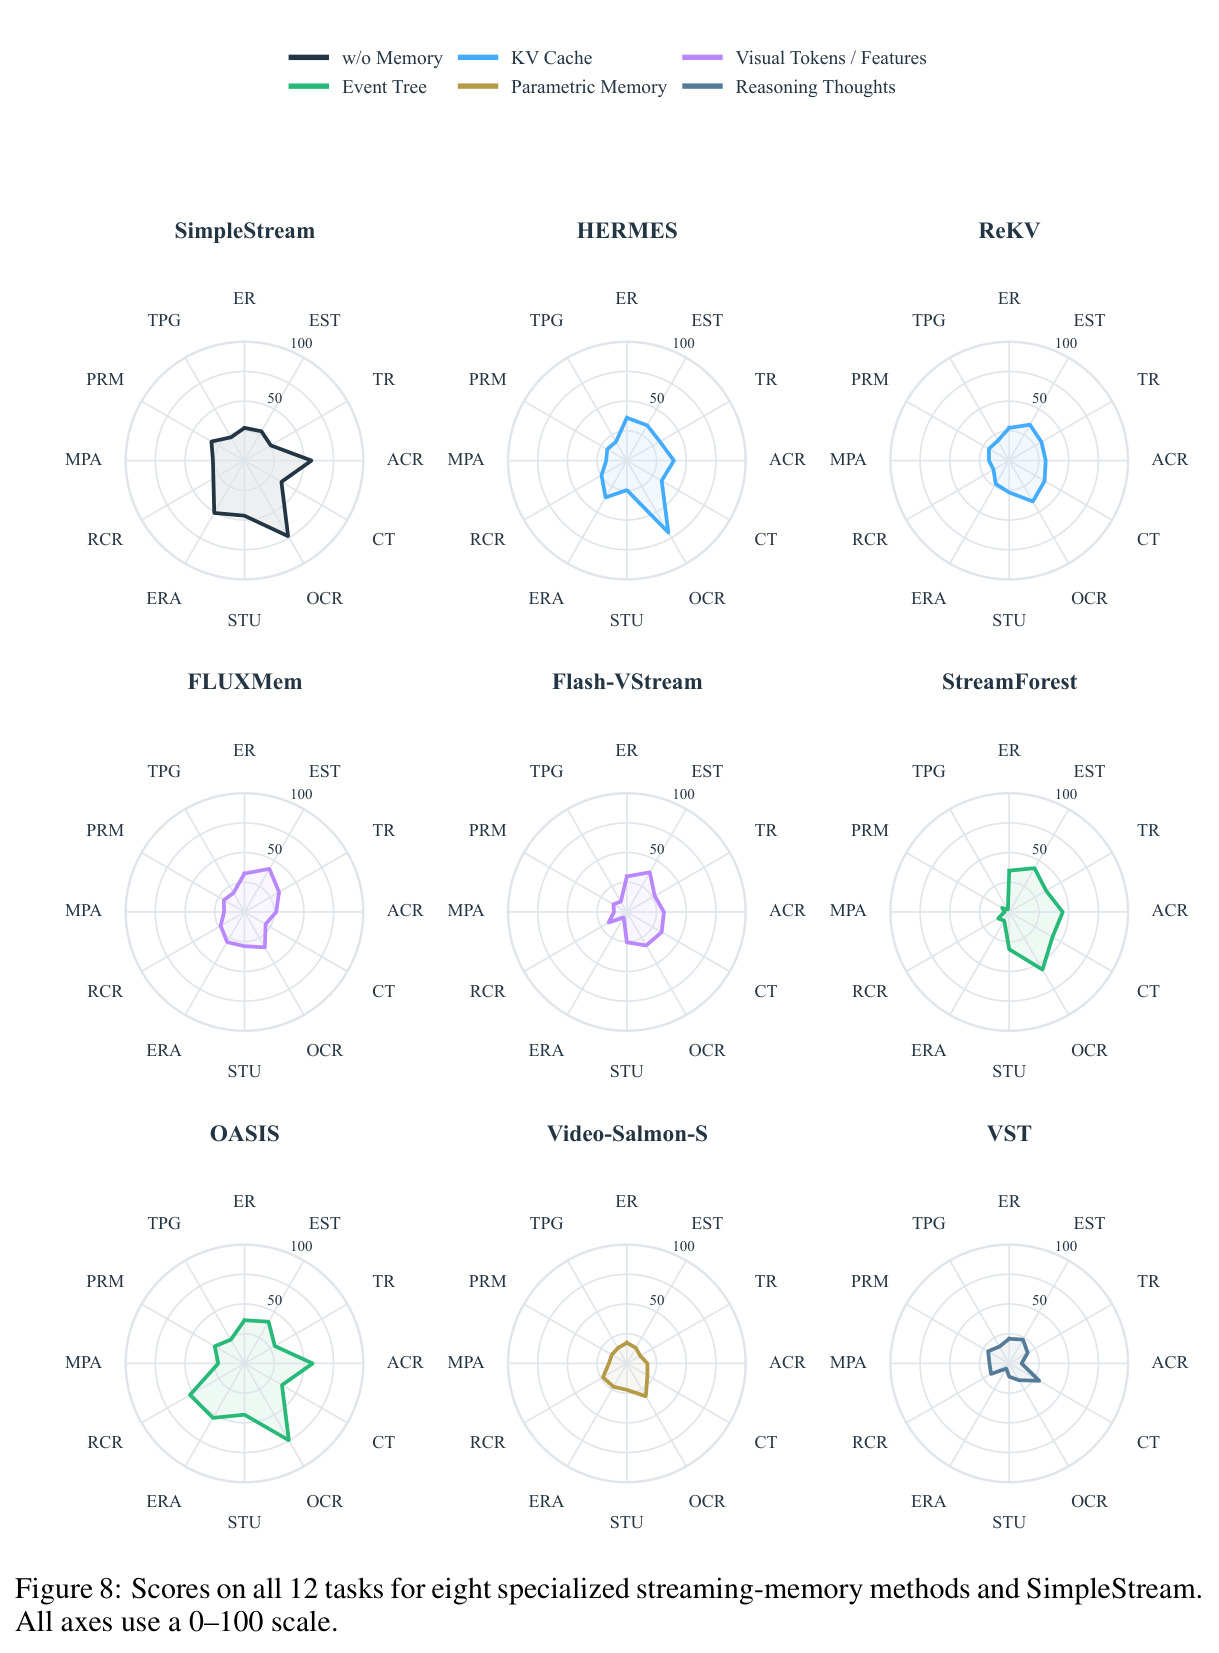
结果呈『一个权衡、两个反差、一个未解难题』。(1)权衡:原始视频记忆最强但最贵——Gemini 3.6 Flash 以原始视频作记忆取得最佳综合 60.21,代价 3.01 GiB/小时存储;换文本摘要后存储仅 3.09 KiB,综合 53.54,跨会话理解暴跌 21.87 分。最强专用系统 OASIS 综合 41.46,仅比无记忆基线 37.58 高 3.88 分,且 TTFT 32.44 秒;ReKV 存储高达 20.84 GiB/h,多个专用系统甚至不如无记忆基线。(2)反差一:历史越多未必越好——换成文本摘要后多数模型实时感知反而上升,无关历史干扰当前感知。(3)反差二:会回忆不等于知道记忆缺失——Gemini 证据可得时准确 85.38%,缺失识别率仅 59.23%;无记忆基线恰好相反,永远怀疑证据缺失。(4)未解难题:即便配全部视频,自主型协助 MPA/TPG 仅 26.52/25.58,与基线持平,而明确注册的 RCR/PRM 达 73.62/61.80;Oracle 只给必要证据能让跨会话理解再涨 19.78–31.21 分,自适应却仍停在 28.98–51.86。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 跨会话理解(原始视频作记忆) | 四选一准确率 | Gemini 3.6 Flash:69.37 | 无记忆基线 SimpleStream:27.21 | +42.16 分 |
| 综合得分(三能力均值,原始视频作记忆) | Overall(0-100) | Gemini 3.6 Flash:60.21 | SimpleStream:37.58 | +22.63 分,但需付出 3.01 GiB/小时存储与 45.73 秒端到端延迟 |
| 综合得分(文本摘要作记忆) | Overall(0-100) | Gemini 3.6 Flash:53.54 | SimpleStream:37.58 | +15.96 分,存储仅 3.09 KiB/小时(较原始视频降约六个数量级) |
| 最佳专用记忆系统 | Overall(0-100) | OASIS(事件树):41.46 | SimpleStream(无记忆):37.58 | +3.88 分,但 TTFT 32.44 秒(基线仅 0.56 秒),RTF=1.223 跟不上实时流 |
| 实时感知(文本摘要 vs 原始视频记忆) | 四选一准确率 | Gemini 3.6 Flash 文本摘要:65.98 | 同模型原始视频记忆:64.20 | +1.78 分(Seed-2.0-Lite +1.69、Qwen3.8-27B -0.65,多数模型换摘要后实时感知更好,说明无关历史干扰当前感知) |
| 证据缺失识别(Evidence Unavailable Detection,130 题) | 五选一准确率 | 最强通用模型 Gemini 3.6 Flash:59.23% | 无记忆 SimpleStream:95.38%(因永远选『证据不足』而歪打正着) | -36.15 分:越强的模型越不会主动承认证据缺失 |
| 记忆驱动主动协助 MPA(原始视频作记忆) | 门控 LLM 评审(0-100) | Gemini 3.6 Flash:26.52 | SimpleStream:26.54 | ≈0:即便最强模型配全部历史视频,自主主动协助仍与无记忆基线持平 |
| 注册式 vs 自主式自适应响应(Gemini,原始视频记忆) | 门控 LLM 评审(0-100) | RCR 73.62 / PRM 61.80 | 同模型 MPA 26.52 / TPG 25.58 | 明确注册的条件比自主触发的协助高约 36–48 分 |
局限与改进
作者承认的局限:数据来自 EgoLife 与 HD-EPIC,活动以日常起居与厨房程序为主,多样性受限;候选由 LLM 生成、虽经人工核验(300 题 kappa 0.868)但审计规模有限;专用系统的存储从推理运行态估算而非真实持久化导出;8 个专用系统与 2 种通用记忆协议无法穷尽设计空间;LLM 评审的主观性难以消除。我补充几点:其一,评测以选择题与离散探针为主,真实助手的连续对话、多轮澄清、用户反馈纠错不在考察范围;其二,延迟只在 H20 GPU 单一主机上测量,本地与云端 API 的对比受硬件网络影响;其三,文本摘要记忆只用单次 LLM 摘要,未探索分层/多粒度摘要,可能低估文本记忆上限;其四,证据可得性子集仅 260 题,『证据在外』的题目全部指向更早会话,难度分布可能偏简单;其五,自适应响应的参考回答由标注流程给定,『有用』定义偏窄,MPA/TPG 的超低分可能部分反映评审严苛——门控后内容质量表显示模型说出的话其实不算差,主要是时机与依据不对;其六,数据全为第一人称居家场景,户外、多人社交、工作场景缺失。
独立分析的弱点
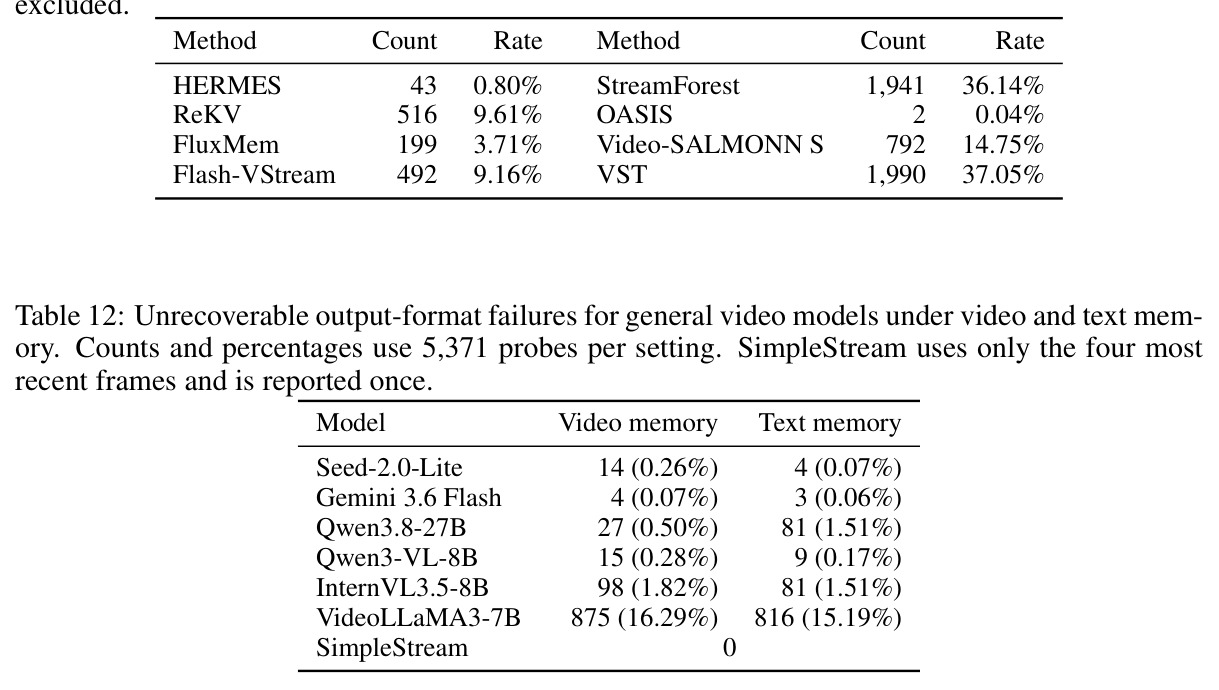
独立分析的弱点及改进方向:(1)记忆注入全有全无——协议要么给全部视频、要么给全部摘要,没有按需检索的中间态,导致无关历史拖累实时感知(FluxMem 从 33.95 跌至 15.28)。改进:训练相关性门控,查询时先判断是否需要历史、再决定注入哪段。(2)自主触发近乎失败——MPA/TPG 需要模型自己发现过去经验与现在相关,最强模型仅约 26 分,而有明确注册的 RCR/PRM 可达 60–74 分。改进:把经验匹配显式化,相似场景先做经验检索再决策。(3)专用系统缺持久化接口与输出稳定性——多数方法不同时支持流式与持久导出,StreamForest、VST 格式失效率达 36%–37%,长上下文下指令遵循崩坏。改进:标准化记忆快照与恢复协议。(4)事件树延迟过高——StreamForest TTFT 36.15 秒、OASIS 32.44 秒且 RTF>1。改进:异步增量索引与流水线化的记忆准备。(5)参数化记忆效用惨淡(Video-SALMONN S 综合 18.72),但其存储零增长(快权重仅 8.02 MiB),值得研究不破坏实时感知的写入方法。
未来方向
作者呼吁持久记忆研究应联合考虑效用、延迟与存储,而非单点突破。基于本文成果可延伸的方向:(1)覆盖感知记忆——让记忆系统显式维护『存了什么、没存什么』的元数据索引,使助手能可靠回答『关于 X 我有没有记录』,直接对症证据缺失识别弱的问题(Gemini 仅 59.23%);(2)查询条件化的记忆路由——利用『摘要比原视频更有利于实时感知』的发现,按当前任务动态选择注入内容,把跨会话理解与实时感知解耦优化;(3)自主触发的时机建模——把 MPA/TPG 的『何时该基于经验主动帮忙』形式化为时机预测问题,3,768 个正负探针可作监督信号或强化学习奖励;(4)带预算约束的分层事件记忆——事件树效用最好但最慢最贵,值得研究在线事件合并、遗忘与压缩机制,逼近 OASIS 的效用与 Flash-VStream 的延迟;(5)参数化记忆复兴——若解决写入破坏感知的问题,零增长的参数化存储最适合全天佩戴设备;(6)评测扩展——纳入音频与对话通道、多用户家庭场景、真实眼镜上的端到端延迟,以及用户在环的数周级纵向部署研究。
复现评估
复现难度中等偏高,但路径清晰。数据完全基于公开的 EgoLife 与 HD-EPIC,论文给出完整构建流水线、全部任务 prompt(附录 E)、评审 rubric(附录 A.3)与标注 JSON 格式(附录 D),正文首页有代码与网站链接。所有本地实验在 H20 GPU 单一主机配置上完成以保证延迟可比;开源模型(Qwen3-VL-8B、InternVL3.5-8B 等)与 8 个专用系统均为公开权重、多为 7–8B 规模单卡可跑,但要在约 5,371 个探针、三种记忆协议下评测,总计算量不小,原始视频协议还需重放海量历史视频。障碍有三:一是重建数据需调用 GPT-5-mini、GPT-5.4、GPT-4o、Gemini-3.5-Flash 等多款商业模型并需两轮人工标注,复现数据构建成本高——直接使用官方发布的 2,719 个候选即可绕过;二是 Seed-2.0-Lite 与 Gemini 3.6 Flash 为闭源 API,只能经 API 复现;三是专用系统的持久化改造由本文完成,部分细节依赖作者开源代码。总体判断:用官方数据复现评测容易,从零重建数据集较难。
论文图表
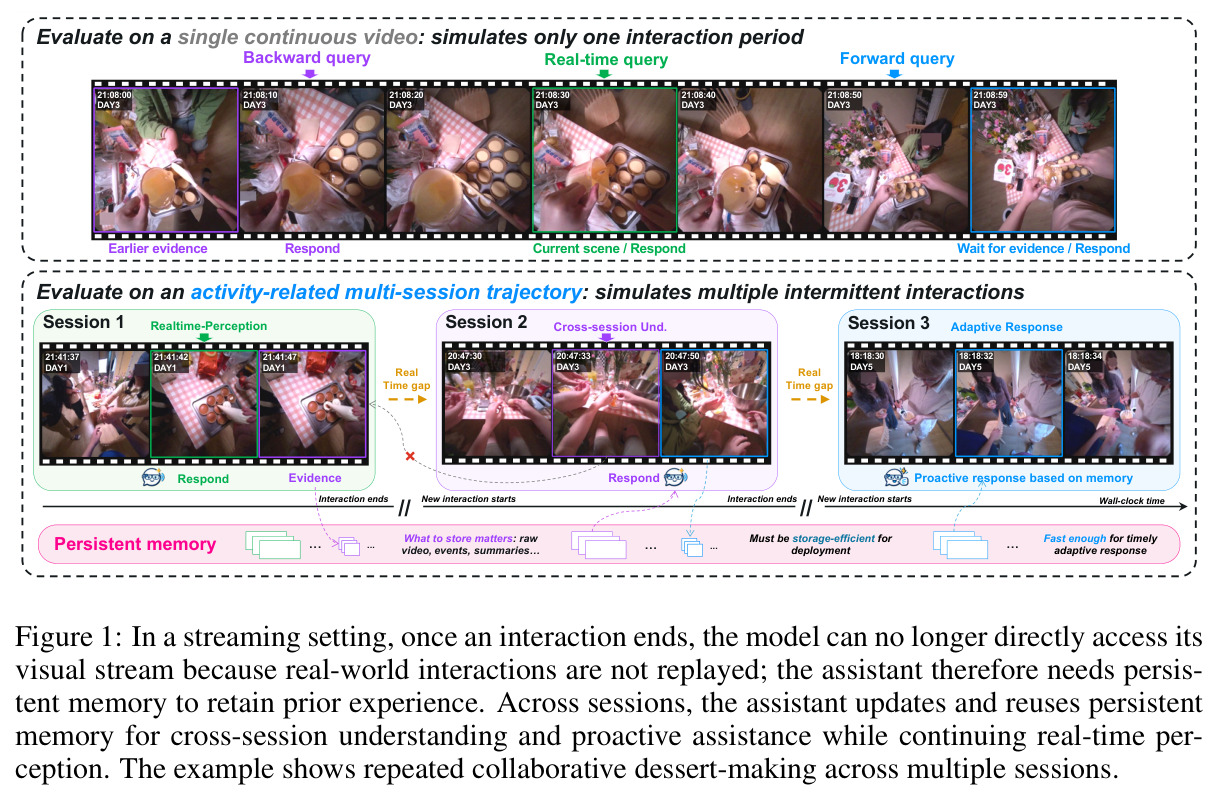
以『连续多天协作做甜点』为例对比两种评测设定:上半部分是单条连续视频评测(只有一次交互时段,含回溯查询、实时查询与前向查询);下半部分是 APM-Bench 的多会话轨迹评测:DAY1、DAY3、DAY5 的三个会话围绕相关活动展开、中间隔着真实时间间隔,助手需在会话内实时感知作答,在会话间更新与复用持久记忆,在证据未出现时等待,并基于记忆主动响应。
一图讲清论文的核心设定与动机:真实交互是断续且不可回放的,记忆必须跨会话存活,这是与以往单视频基准的本质区别。
12 个任务的逐项得分加证据可得(EA)/证据缺失(EU)识别两列。关键数字:Gemini(原始视频)OCR 87.95、ER 73.70,但 MPA 26.52、TPG 25.58;SimpleStream 的 EA 仅 3.85 而 EU 高达 95.38;Gemini EA 85.38 但 EU 仅 59.23;StreamForest 的 TPG 仅 2.30、VST 的 ACR 仅 10.40。
支撑四大发现的主要数据:模型强在注册式协助、弱在自主触发;会回忆不等于知道记忆缺失。
五个自适应任务上正/负探针的决策准确率及总体 P/N/平衡准确率 BA。SimpleStream 几乎总选沉默(P 19.86 / N 92.81);InternVL3.5-8B 与 VideoLLaMA3-7B 几乎总插话(90.37/13.42、84.65/9.33);OASIS(BA 67.50)与 Gemini 原始视频(66.69)最佳;StreamForest BA 仅 25.53。
把门控分数中的『时机决策』单独拆出,揭示不同模型的系统性偏置(过度沉默 vs 过度插话),这是改进触发策略的直接依据。
在通过确定性门控的探针上单独评内容质量(1–5 分换算为 0–100),上标为平衡门控通过率。Gemini(原始视频)平均 72.14 最高,SimpleStream 61.12;ERA/RCR 的内容质量普遍较高(Seed 文本记忆 94.22/90.27),而 MPA/TPG 即便时机对了内容也常空洞(多在 40–55)。
证明『决定说话』与『说得有用』是两种能力:时机正确的回答仍可能缺乏信息量,自主协助的内容质量是独立瓶颈。
每个专用系统在 5,371 个探针上无法确定性修复的输出格式失效率:VST 37.05%、StreamForest 36.14%、Video-SALMONN S 14.75%、ReKV 9.61%,远高于 OASIS 的 0.04%;长历史输入会加剧格式失控。
揭示容易被忽视的工程性失败:部分专用系统在长上下文下连指令格式都无法遵循,实际可用性比分数显示的更差。
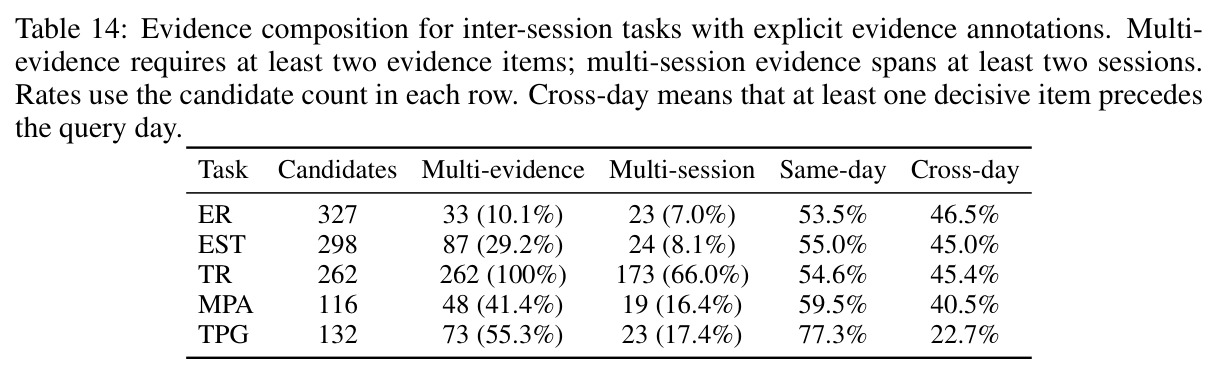
1,249 个跨会话候选中,查询会话与最早决定性证据会话的距离分布:隔 1 个会话 628 题、2 个 298 题、3 个 155 题、4 个及以上 168 题;TR 的远距离(≥4 会话)比例最高(69/262)。另有证据分布统计:987 题证据只在 1 个历史会话中。
刻画记忆需要回溯多远,是理解『持久』二字实际跨度、并据此设计记忆深度策略的关键统计。