SkillGym:用自动生成的可验证环境训练技能使用智能体 SkillGym: Training Skill-Use Agents with Automatic Verifiable Environment Generation
自动把社区技能改造成可验证训练环境,SFT 后 9B 模型在两项基准上超过 397B 模型
前置知识
Agent Skill(智能体技能包)
一种轻量的知识封装格式:通常是一个含 SKILL.md 的文件夹,内含自然语言工作流说明、参考文档和可运行脚本(如 Anthropic 的 pptx、mcp 技能)。智能体在推理时按需读取技能内容,把文档中的流程翻译成具体动作,全程不需要更新模型权重。skills.sh 和 GitHub 上已有数万个社区技能,覆盖软件工程、金融、文档处理等 18 个以上领域。
本文全部出发点就是把这类技能批量转化为训练环境;不理解技能包的结构,就无法理解任务如何围绕技能内容构建。
Agent Harness 与交互轨迹
harness 是驱动 LLM 执行智能体任务的外层框架,负责把模型输出解析为工具调用并把观察结果回填。一次任务执行产生轨迹 $\tau = (o_0, a_0, \ldots, o_L)$,由观察 $o_t$ 和动作 $a_t$ 交错组成。不同 harness 的接口差异很大:MiniSwe-Agent 只允许 Bash 命令,Terminus-2 用 JSON 协议,AgentFly 和 OpenCode 提供专用文件操作工具。
论文用 3 个教师模型 × 4 种 harness 采集轨迹并刻意变化系统提示与工具 schema,轨迹多样性直接决定 SFT 数据质量。
可执行验证器(Executable Verifier)
一段自动判定任务是否完成的脚本,检查最终产物而非解题过程。这是可验证奖励(RLVR)范式的基础。本文要求验证器满足有效性门:在初始工作区上失败、在参考解执行后通过,即 $v(x_0)=0$ 且 $v(\mathrm{Exec}(\rho; E, x_0))=1$,并且要从输入重新计算期望值(recompute-verify)而不是硬编码答案,以接受任何正确解法。
任务可验证性是整条流水线的基石,也是『质量审查比单纯执行校验更好』这一消融结论得以成立的前提。
Builder–Reviewer 双智能体流水线
一种生成-审查式多智能体协作模式:builder 负责构造(Dockerfile、任务包),reviewer 独立验证(构建镜像真实运行测试、逐行审查验证器是否过严或过弱)并给出具体修复反馈,循环直到通过或达到轮次上限。类似代码生成中的 self-repair,但审查对象是环境本身和奖励函数本身。
这是论文的核心工程创新,消融实验证明经过质量审查的任务比仅执行校验的任务带来 4.7~9.3 点的训练增益差异。
监督微调(SFT)
用(指令, 轨迹)对更新模型权重,让模型模仿教师行为。相比 RL 不需要训练时的奖励信号,只要求演示轨迹事先通过验证器筛选。本文设置:2 个 epoch、学习率 $10^{-5}$ 线性衰减、AdamW 优化器、batch size 128,总计算量 64 GPU 小时。
本文所有模型改进都来自 SFT,RL 被留作未来工作;理解 SFT 能学到什么(触发技能)学不到什么(套用方法)是理解论文结论边界的关键。
研究动机
技能(skills)已成为 Claude Code、Codex、OpenClaw 等现代智能体框架的标准配置,但『会用技能』本身是一种未被充分训练的能力:智能体要解读技能内容、判断如何套用到当前任务、再把流程翻译成正确动作,例如按可用输入改编文档化流程、解决依赖、应对意外执行结果。现有技能使用训练方法(SkillRL、SAGE、Skill-to-LoRA 等)大多从智能体自身在少数固定环境中的交互经验里归纳技能,学习被局限在少数任务域。反方向看,社区公开技能规模巨大——skills.sh 排行榜约 9.7k 个、GitHub claude-skill-registry 约 174k 条目,覆盖软件工程、科学、金融、文档处理、营销等——但它们按『可复用资源』而非『训练材料』写成:没有任务、没有环境、没有成功判据。把它们变成训练数据有两大挑战:其一,任务必须『技能关键』(skill-critical),用不用技能应决定成败,但不用技能仍可勉强解出,否则模型学会绕过技能;其二,结果必须可靠可验证,验证器要反映任务需求、承认等价替代解法、并能区分真正完成与貌似合理的输出。
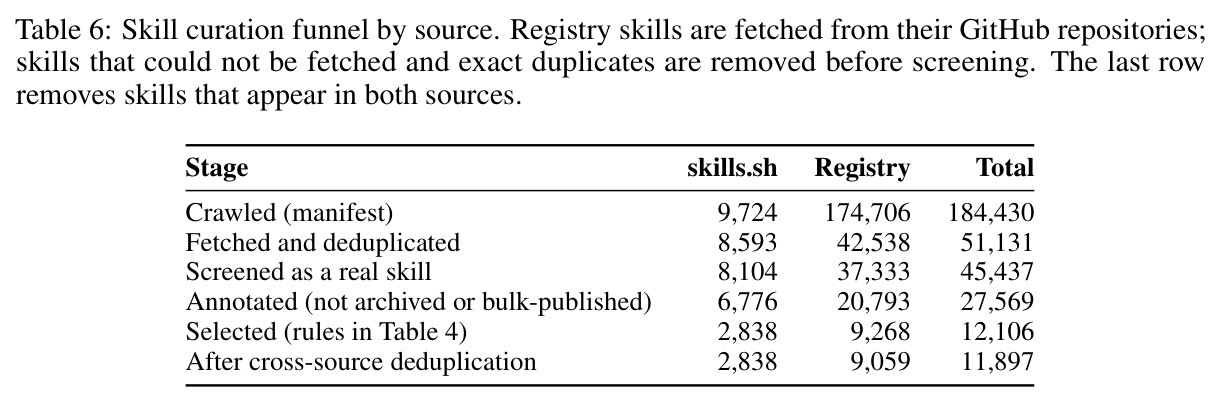
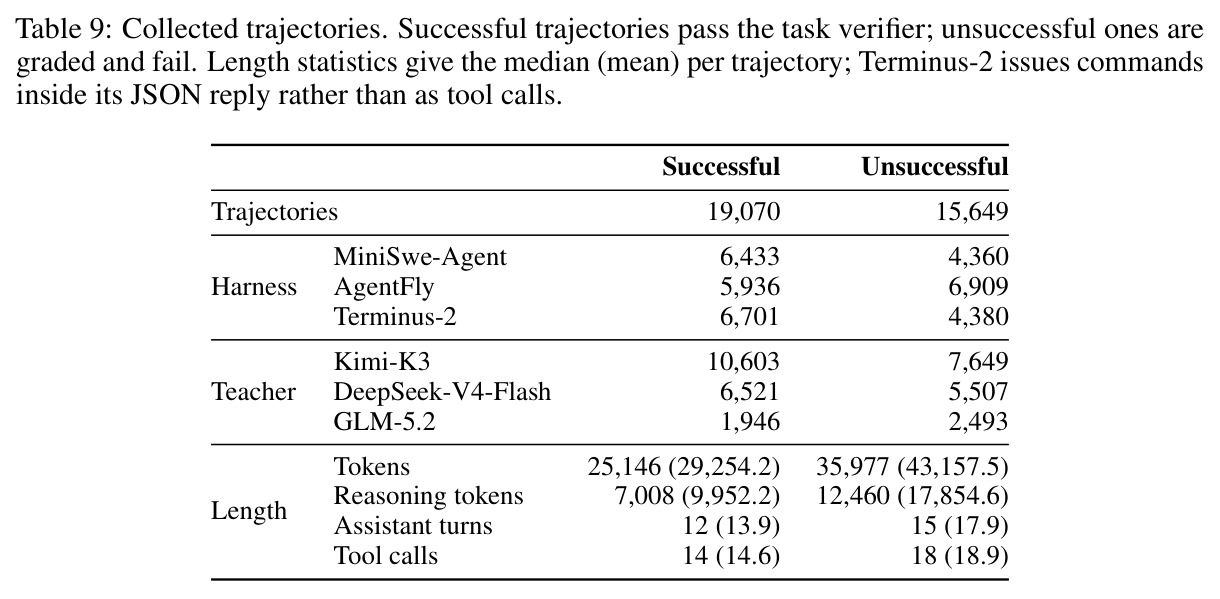
本文的目标是构建一条全自动流水线 SkillGym,把公开社区技能批量转化为技能关键且可验证的训练环境:从 184k 爬取条目中筛出 11,897 个可离线稳定执行的技能,围绕四种推理结构自动构造 6,772 个(约 6.8k)带参考解和可执行验证器的任务,采集 19,070 条通过验证的成功轨迹用于 SFT;量化目标是让 2B 到 122B、三个家族的六个模型在四个技能使用基准上全面提升,并验证增益能迁移到训练中未见过的技能(held-out skills)与少数派推理结构上。
与已有工作不同的是,已有任务/环境合成工作按驱动源分三类:任务驱动(Endless Terminals 先写任务再建容器环境)、环境驱动(EnvScaler、Agent-World 先建环境再配任务)、技能驱动(SKT 用模板从 skills.sh 技能生成任务包)。本文属技能驱动,但抓住两个被忽视的点:一是围绕显式『推理结构』——程序执行、溯因诊断、约束满足、偏序规划——定义四种任务 profile,使技能被应用的方式多样化,而非模板化的规则套用(SKT 评测集几乎全是规则套用);二是在双重执行校验之外增加一道 reviewer 对验证器本身的健全性审计——检查信息泄漏、过严(错杀合法替代解)与过弱(放水错误解),先前流水线只验证『任务可解』,不审计『奖励信号是否可靠』。
核心方法
直觉上,这像把一座开源图书馆改造成驾校:教材(技能)已经写好,缺的是『课程』(任务)、『考卷』(验证器)和『标准答案』(参考解)。技术路线分三阶段。阶段一,技能采集与筛选:从 skills.sh 与 GitHub registry 爬取 184,430 条技能条目,去重后 51,131 个,经 LLM 加规则标注(与人工专家一致率 94%)筛出 11,897 个可离线运行、无 GPU 依赖、非破坏性、≤300 文件的技能。阶段二,任务构造:对每个技能按四种推理结构之一(程序执行、溯因诊断、约束满足、偏序规划)生成任务包 $T=(u, E, x_0, v, \rho)$——任务指令、Docker 环境、初始工作区、可执行验证器、参考解;builder-reviewer 系统先建环境(构建镜像并独立验证依赖),再过三道门:fit-check(技能撑不起该结构就跳过)、有效性($v(x_0)=0$ 且参考解执行后 $v=1$)、质量(审查泄漏与验证器宽严)。阶段三,轨迹采集与训练:Kimi-K3、DeepSeek-V4-Flash、GLM-5.2 三个教师 × MiniSwe-Agent、AgentFly、Terminus-2、OpenCode 四种 harness,产出 19,070 条成功轨迹用于 SFT。
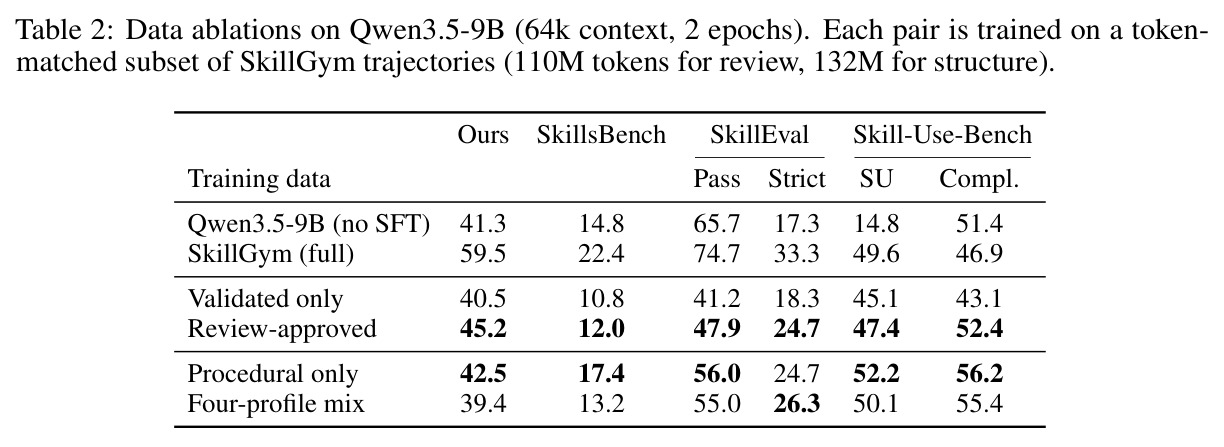
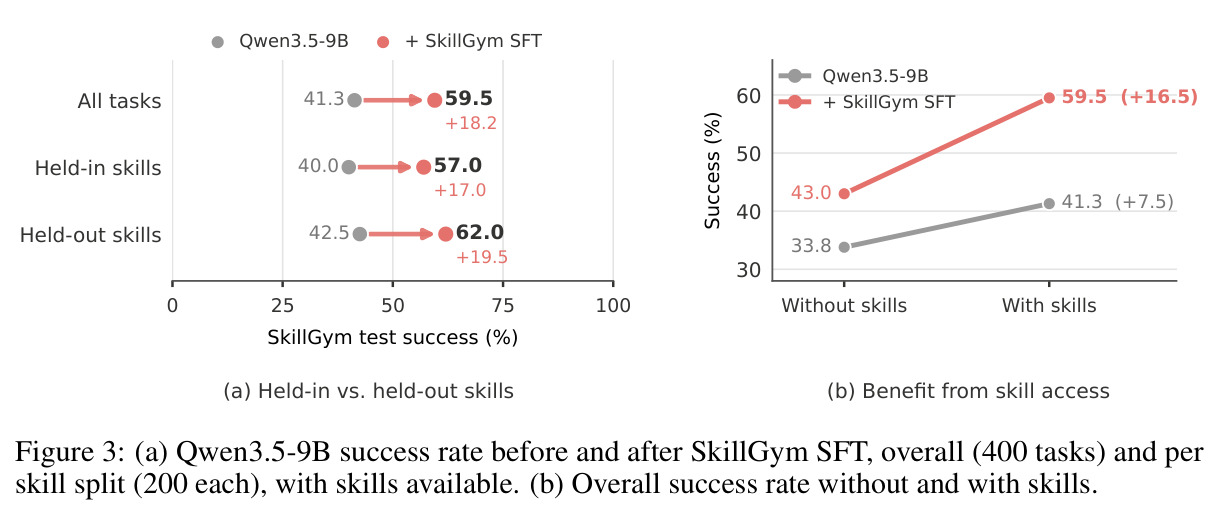
最本质的创新是『方向反转 + 奖励函数审计』。方向反转:先前工作(SkillRL、SAGE 等)让智能体在自己探索的环境中提炼技能,技能学习被锁死在少数域、且技能被编译进权重;SkillGym 反其道而行,从外部已有的 3.5k 个社区技能出发反向构造环境,保持技能外置,训练的是『使用公开技能』这一可迁移的通用行为——对 held-out 技能的增益(+19.5)甚至高于 held-in(+17.0)证明了这一点。奖励函数审计:多数合成环境流水线只做执行校验(初始态失败、参考解通过),但一个能通过双重执行检查的验证器仍可能很糟——只 grep 关键词会放水(过弱),断言导入风格会错杀等价解(过严),或在指令、工作区中泄漏答案。SkillGym 的质量门让 reviewer 按『最紧但接受所有正确解』的标准逐项审查验证器,builder 最多修 5 轮。消融证实:同等 token 预算下,用过审任务训练比只用执行校验通过的任务训练,在自建测试集高 4.7 点、SkillEval 高 6.7 点、Skill-Use-Bench 完成分高 9.3 点。
方法步骤详情
第一步,爬取与筛选:从 skills.sh(9,724 个热门技能)与 claude-skill-registry(174,706 条)下载完整技能文件夹,经 LLM 筛查与规则过滤(真实技能、英文、非存档仓库、无运行时网络、无 GPU、非交互、非破坏性、≤300 文件)得到 11,897 个技能,覆盖 19 个域。第二步,环境构建:builder 读 SKILL.md 写 Dockerfile 与依赖文件,reviewer 构建镜像并在容器内『真跑依赖』(import 并调用而非元数据检查),通过则固化,否则反馈重建。第三步,任务构造:builder 按 profile 的 fit-check 决定跳过或开工,产出 instruction.md、workspace 初始文件、solve.sh 参考解、test.sh 验证器与 grading.json;有效性门要求 $v(x_0)=0$ 且参考解执行后 $v=1$;质量门由 reviewer 审查答案泄漏与验证器过严/过弱(builder 最多修 5 轮)。难度层要求:真实规模输入防手算、验证器从输入重算期望值、至少一步依赖技能文档中的非显然知识。第四步,轨迹与训练:三教师 × 四 harness(变化系统提示、工具名与 schema)执行任务,19,070 条成功轨迹(中位 25k tokens)以 2 epochs、lr $10^{-5}$、AdamW、batch 128 训练 MiniCPM5-2B、Ministral-3-8B 与 Qwen3.5-4B/9B/27B/122B-A10B,共 64 GPU 小时。
技术新颖性
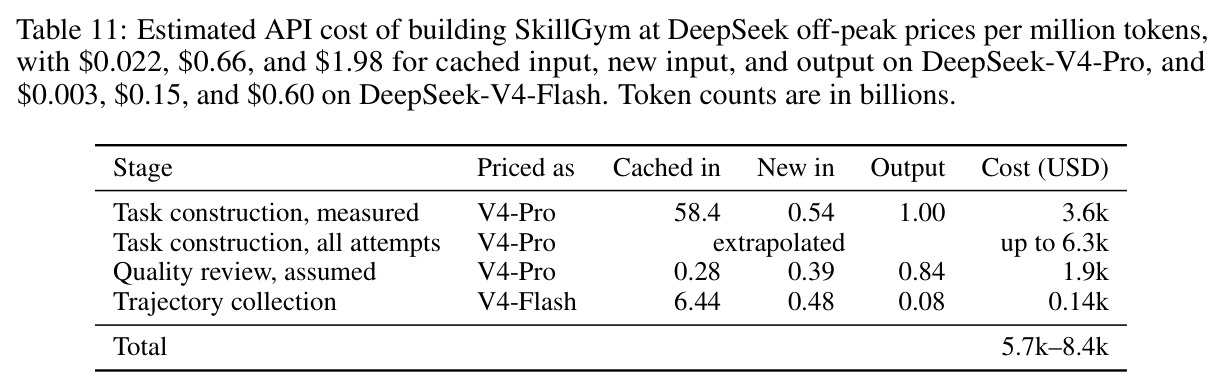
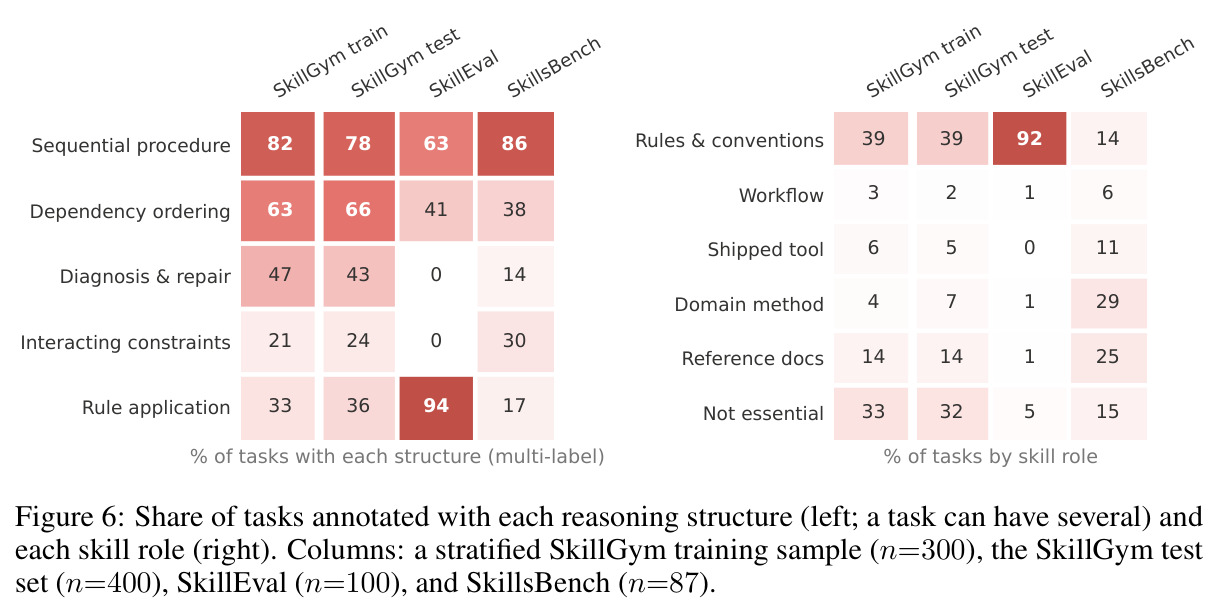
与最近的同方向工作 SKT 相比:SKT 用模板生成任务、评测集集中在『把技能给的规则套到条目列表』一种结构上,且无验证器审计;SkillGym 显式定义四种推理结构契约并配 reviewer 审计,构造的任务覆盖了事后标注的全部五种结构。与 SWE-bench 式溯因诊断、TravelPlanner 式约束满足相比,那些工作各自只覆盖一种结构且依赖人工构造;SkillGym 把它们统一为可自动实例化的 prompt 契约(附录 B 给出全部四套)。与 SkillsBench、Skill-Use-Bench 等基准相比,那些只有几百道人工题、专为评测设计;SkillGym 提供数千道可验证训练题,反用这些基准测迁移。工程化程度也罕见地透明:全程 API 成本仅 $5.7k–8.4k(约每任务 $1),任务构造用 DeepSeek-V4-Pro 离峰价且 58.4B 输入 tokens 命中缓存,轨迹采集仅 $0.14k。
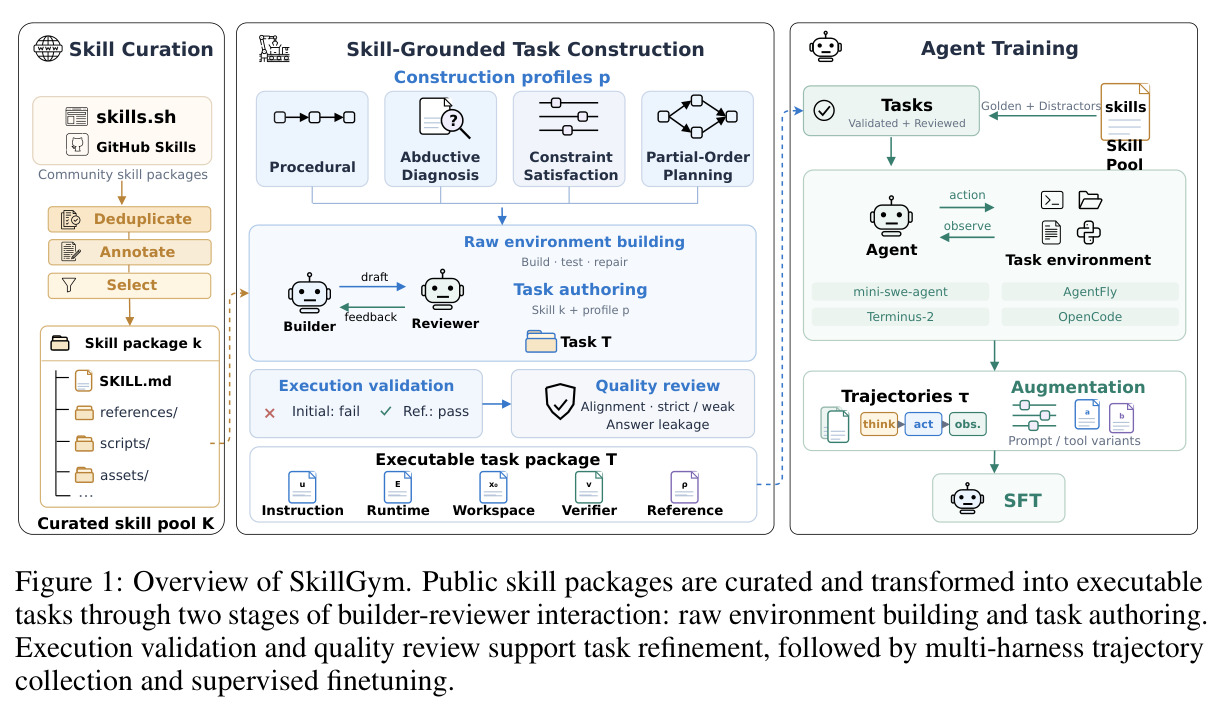
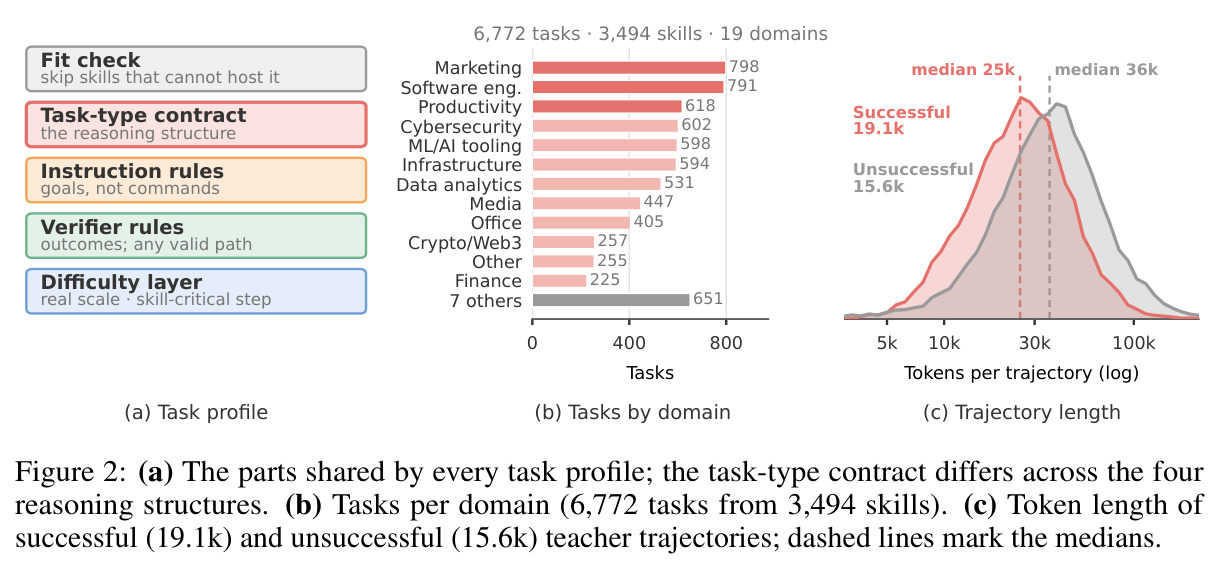
实验结果
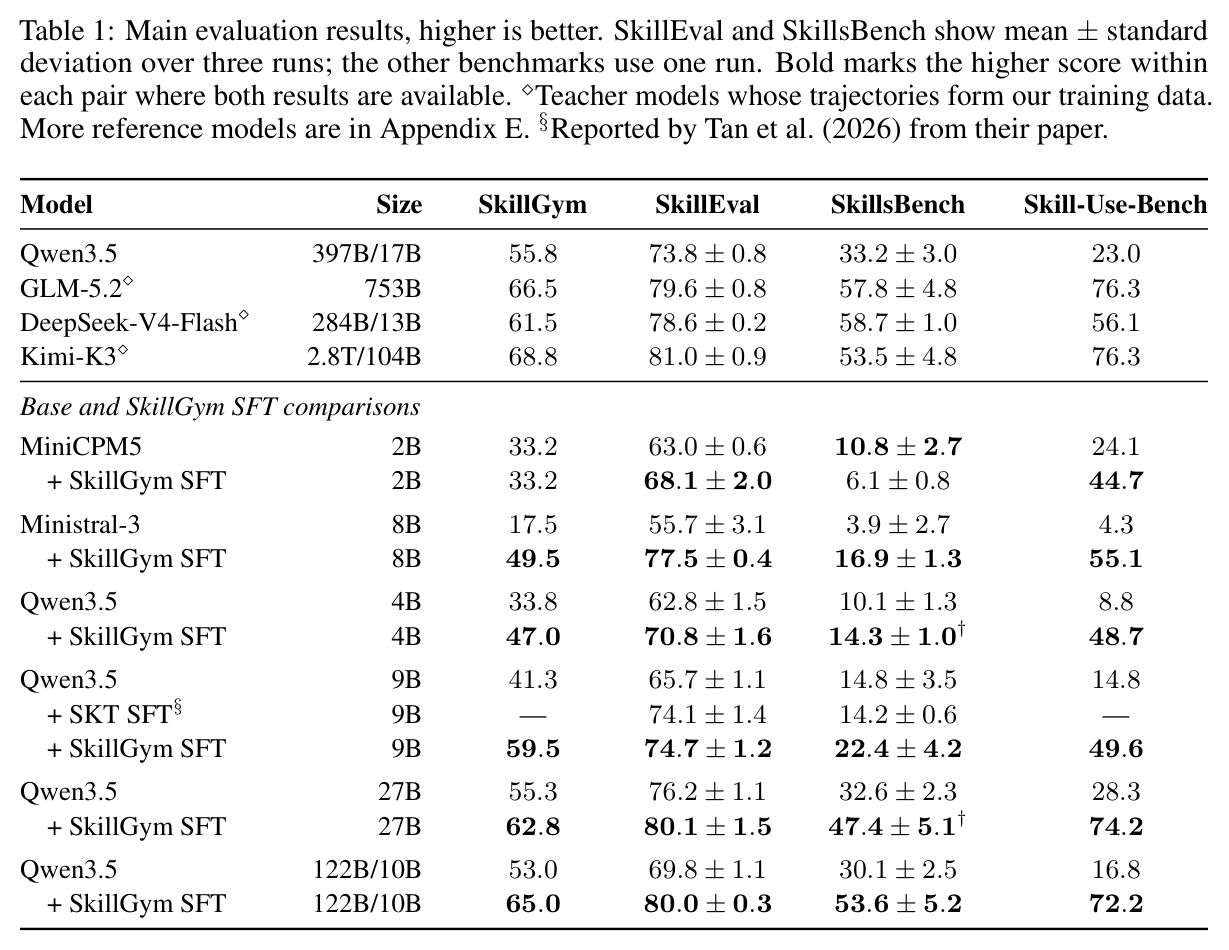
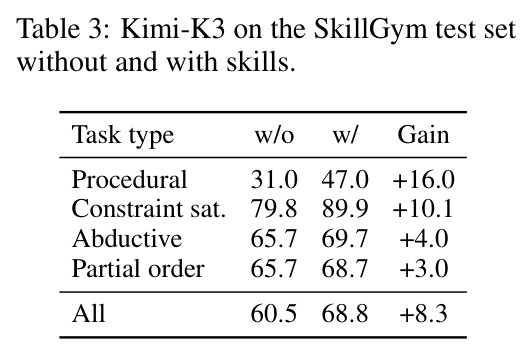
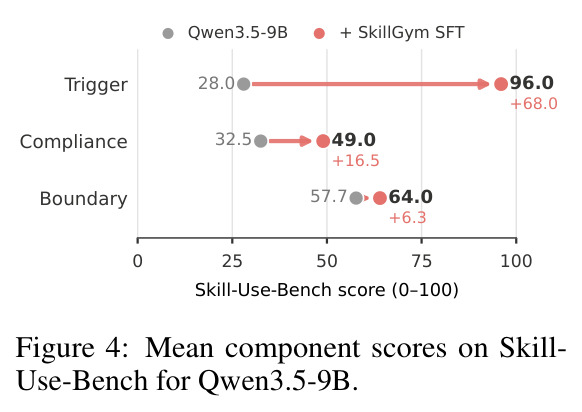
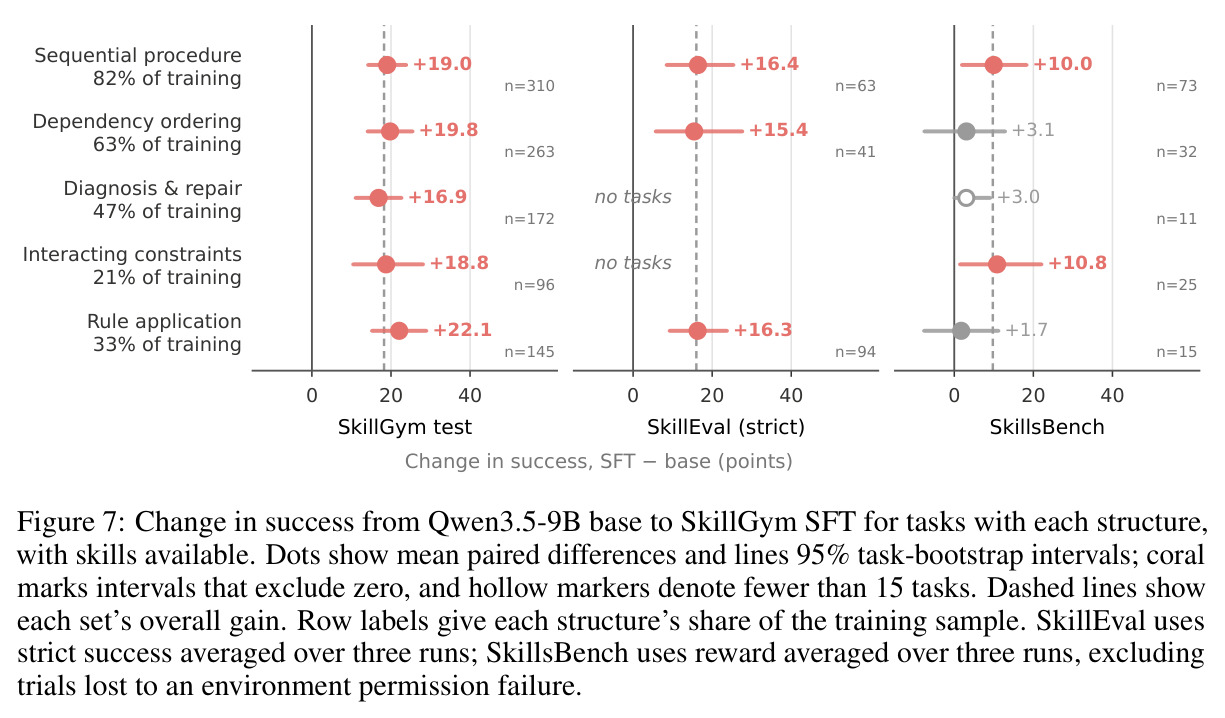
主实验(Table 1)覆盖 6 个骨干 × 4 个基准共 24 组对比,22 组提升,平均增益:自建测试集 +13.8、SkillEval +9.7、SkillsBench +9.7、Skill-Use-Bench SU +41.2。亮点:Qwen3.5-9B 从 41.3→59.5(自建)、65.7→74.7(SkillEval),双双超过 397B 的未训练 Qwen3.5-A17B(55.8/73.8);27B 在 SkillEval 上(80.1)超过三个教师中的两个;Ministral-3-8B 提升最猛(自建 17.5→49.5,SU 4.3→55.1);SkillsBench 增益随规模增长(4B +4.2 → 122B +23.5),2B 是唯一在该基准下降的(10.8→6.1)。迁移分析(Figure 3a):held-out 技能任务 42.5%→62.0%(+19.5),高于 held-in 的 +17.0,说明学到的是通用技能使用行为。技能收益分析(Figure 3b):基模型给技能仅多赚 7.5 点(33.8%→41.3%),SFT 模型多赚 16.5 点(43.0%→59.5%),且不给技能也涨 9.2 点。行为分析(Figure 4):SU 的 Trigger 分量从 28.0 暴涨至 96.0——基模型仅约三分之一任务会打开相关技能,这是其技能使用差的主因;Compliance 32.5→49.0,Boundary 57.7→64.0。结构分析(Figure 7):各结构增益均匀(自建 +16.9~+22.1),训练中仅占 12% 的规则应用结构在 SkillEval 上也涨 13.9 点,控制难度后的回归未见结构特异效应。技能关键性验证(Table 3):教师之一 Kimi-K3 无技能 60.5% → 有技能 68.8%(+8.3),52 题仅凭技能解出(McNemar 检验 p≈10^{-4}),程序类任务收益最大(+16.0)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SkillGym 自建测试集(400 题,含 held-out 技能) | 任务成功率(%) | Qwen3.5-9B + SkillGym SFT:59.5 | Qwen3.5-9B 基模型:41.3;未训练 Qwen3.5-397B-A17B:55.8 | 较基座 +18.2,9B 超过 397B 模型 +3.7 |
| SkillEval(SKT 构造的技能使用评测) | 归一化奖励均值(3 次运行) | Qwen3.5-9B + SkillGym SFT:74.7 | 同模型基座 65.7;未训练 Qwen3.5-397B-A17B:73.8;SKT SFT 报告值 74.1 | 较基座 +9.0,9B 追平/超过 397B(+0.9) |
| SkillsBench(专家编写、8 领域) | 归一化奖励均值 | Qwen3.5-122B-A10B + SkillGym SFT:53.6 | 同模型基座:30.1 | +23.5(增益随规模从 4B 的 +4.2 增长) |
| Skill-Use-Bench(技能触发/流程遵循/边界遵守) | SU 综合分 | Qwen3.5-9B + SkillGym SFT:49.6 | 同模型基座:14.8 | +34.8(六个骨干平均 +41.2) |
| 技能触发率(SUB Trigger 分量,Qwen3.5-9B) | 分量得分(0–100) | 96.0 | 28.0(基模型仅约 1/3 任务会打开相关技能) | +68.0 |
| 质量审查消融(token 匹配子集,Qwen3.5-9B) | SkillEval 归一化奖励 | 过审任务训练:47.9 | 仅执行校验任务训练:41.2 | +6.7(自建测试集 +4.7,SUB 完成分 +9.3) |
局限与改进
作者承认的局限:(1)SkillsBench 增益高度依赖技能角色——参考文档类 +28.0,但『领域方法』类 +2.3、『自带工具』类 +0.0、『修改系统』类 -0.1(Figure 5),说明训练主要教会『查阅技能』而非『套用方法』;(2)数据消融中所有小规模子集模型在 SkillEval 上反而低于基座(41.2 vs 65.7),因 64k 上下文下许多 rollout 重复推理耗尽输出预算;(3)只做 SFT 未做 RL。我的观察:(1)数据分布偏斜——技能池中软件工程占 53%,任务靠每域配额才勉强均衡,agents/meta 与 writing 两个域被整体排除;(2)构造通过率有限:6,772 个任务中 1,581 个(约 23%)reviewer 未在轮次预算内解决严格性担忧,只能标记 unresolved,偏序任务另批构建未计入统计,全自动质量门仍依赖配额干预;(3)成功轨迹中 Kimi-K3 贡献约 56%,多样性受教师能力上限约束,15.6k 条失败轨迹被弃用、未用于偏好学习;(4)『从输入重算期望值』要求技能知识可程序化表达,对文档型技能友好、对工具型技能天然困难,可能正是 Figure 5 结构性偏科的成因之一。
独立分析的弱点
第一,『查』与『用』的鸿沟:Trigger 涨到 96.0 但 Compliance 只到 49.0,模型学会了打开技能却不总照做;改进方向是提高程序执行类任务占比、引入逐步检查的过程奖励。第二,方法/工具型技能零增益:自带工具的技能 +0.0、修改系统的任务 -0.1,部分源于筛选排除了需运行时联网的技能(占 31.4%),而工具价值必须真实调用才能兑现;改进方向是为联网技能构建带 mock API 的离线沙箱。第三,教师数据天花板:56% 轨迹来自 Kimi-K3,教师解不出的任务永远没有训练信号,失败轨迹被完全浪费;改进方向正如作者所言,用现成验证器做 RL,把失败轨迹转为负样本或 DPO 偏好对。第四,质量门不彻底:23% 任务 unresolved,与过审任务混在同一池发布却未区分用途;改进方向是按审查轮次或缺陷类型加权采样,或对 unresolved 任务定向 repair。第五,评测口径单一:评测固定用只允许 Bash 的 MiniSwe-Agent,而训练覆盖 4 种 harness,接口不匹配可能扭曲真实部署时的表现,缺少跨 harness 评测矩阵。
未来方向
作者明确提出两个方向:其一,在 SkillGym 环境上做强化学习——每个任务的验证器已经提供现成的结果奖励(outcome reward),19k 失败轨迹也可转化为负信号或偏好数据;其二,针对『领域方法』与『自带工具』型技能重新设计数据构造,使任务强制要求执行技能脚本而非仅阅读文档,弥补 Figure 5 揭示的短板。基于论文成果可延伸的方向:把四种推理结构 profile 泛化为可组合的『任务文法』,自动搜索技能×结构的组合空间并按训练信号动态配额;用同一流水线为垂直领域(生物信息、合规审查等)的企业内部技能定向生成训练环境;利用 Kimi-K3 在不同任务类型上的技能增益差异(程序类 +16.0 到偏序类 +3.0)构建难度课程表做课程学习;以及研究技能内容渐进式披露(progressive disclosure)策略对 Trigger 与 Compliance 的因果影响,把『会查』进一步转化为『会用』。
复现评估
复现条件相当友好。代码与数据已在 GitHub 开源(github.com/Reason-Wang/SkillGym),包含 6,772 个任务环境与轨迹数据。成本透明:按 DeepSeek 离峰价估算,任务构造 $3.6k(实测,含失败尝试外推上限 $6.3k)、质量审查约 $1.9k、轨迹采集仅 $0.14k,总计 $5.7k–8.4k,约合每个发布任务 $1,中等预算团队即可负担。算力方面 SFT 只需 64 GPU 小时(9B、batch 128、2 epochs),单节点 8×A100 一天内可完成。复现难度中等:主要工程量在容器化执行基建(Docker 沙箱、断网约束、非破坏性检查)与 builder-reviewer 循环的提示词工程;附录 B/C 完整给出四个 profile 的 prompt 契约与 builder/reviewer 系统提示,附录 D 给出四类任务完整示例,可直接照搬。风险点:skills.sh 排行与 GitHub registry 随时间漂移,标注与教师模型版本更替会改变数据分布;部分基线(如 SKT SFT 的 74.1)引用自他文报告值且 harness 不同,严格对齐需自行复跑。
论文图表
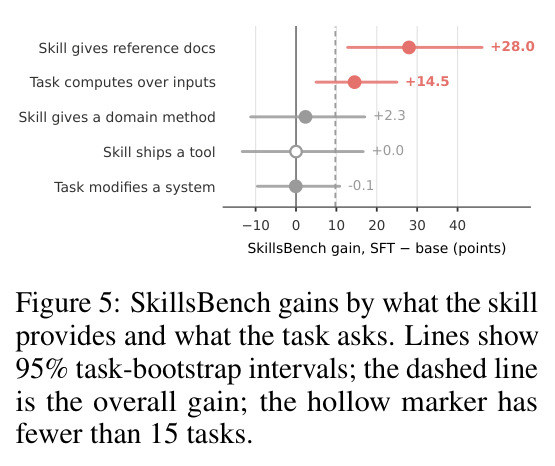
按技能提供物与任务要求交叉切分 SkillsBench 上 SFT 相对基座的增益:技能给参考文档 +28.0、任务对输入计算 +14.5、技能给领域方法 +2.3、技能带工具 +0.0、任务修改系统 -0.1;虚线为总体增益。
这是全文最重要的负面结果:清晰展示迁移边界——训练收益集中在文档查阅型技能,方法与工具型技能几乎没有提升,直接定义了后续数据构造应攻克的方向。