Skill2Env:面向通用智能体的能力导向技能驱动环境合成 Skill2Env: Capability-Oriented Environment Synthesis from Skills for General Agents
从技能出发、以能力需求为导向自动合成可执行环境并迭代加固,用于智能体后训练
前置知识
后训练与监督微调(SFT)
后训练指在预训练之后继续提升模型能力的过程,包括监督微调(SFT)与强化学习(RL)等。SFT 用高质量的轨迹对直接微调参数,让模型模仿教师行为。本文用 DeepSeek-V4-Flash 在合成环境上生成轨迹,保留奖励 $r>0.9$ 的 1.5K 条高分轨迹,对 Qwen3.6-35B-A3B 做 5 个 epoch 的 SFT(全局 batch 32,峰值学习率 $10^{-5}$,余弦衰减,10% 预热)。
本文的全部实验都围绕一个假设:合成环境产出的轨迹能转化为可迁移的 SFT 监督信号,理解 SFT 流程才能看懂实验设计与结果解读。
可执行环境与任务实例
指智能体可在其中真实执行多步操作、调用工具并产生状态变化的沙盒(本文用 Docker/Linux 容器)。论文形式化为 $E=(\mathcal{X}, \kappa, W_0)$:$\mathcal{X}$ 是提供工具与运行时支持的执行基底,$\kappa$ 是技能,$W_0$ 是初始工作区;任务实例 $T=(g, E, V)$ 由指令 $g$、环境 $E$、评估器 $V$ 构成。交互为 $a_t \sim \pi(\cdot|g,h_t)$,$s_{t+1} \sim P_E(\cdot|s_t,a_t)$。
整篇论文的目标就是自动合成这样的 $E$ 和 $T$,这是理解技能筛选、难度模式、蓝图等所有组件的坐标系。
智能体技能
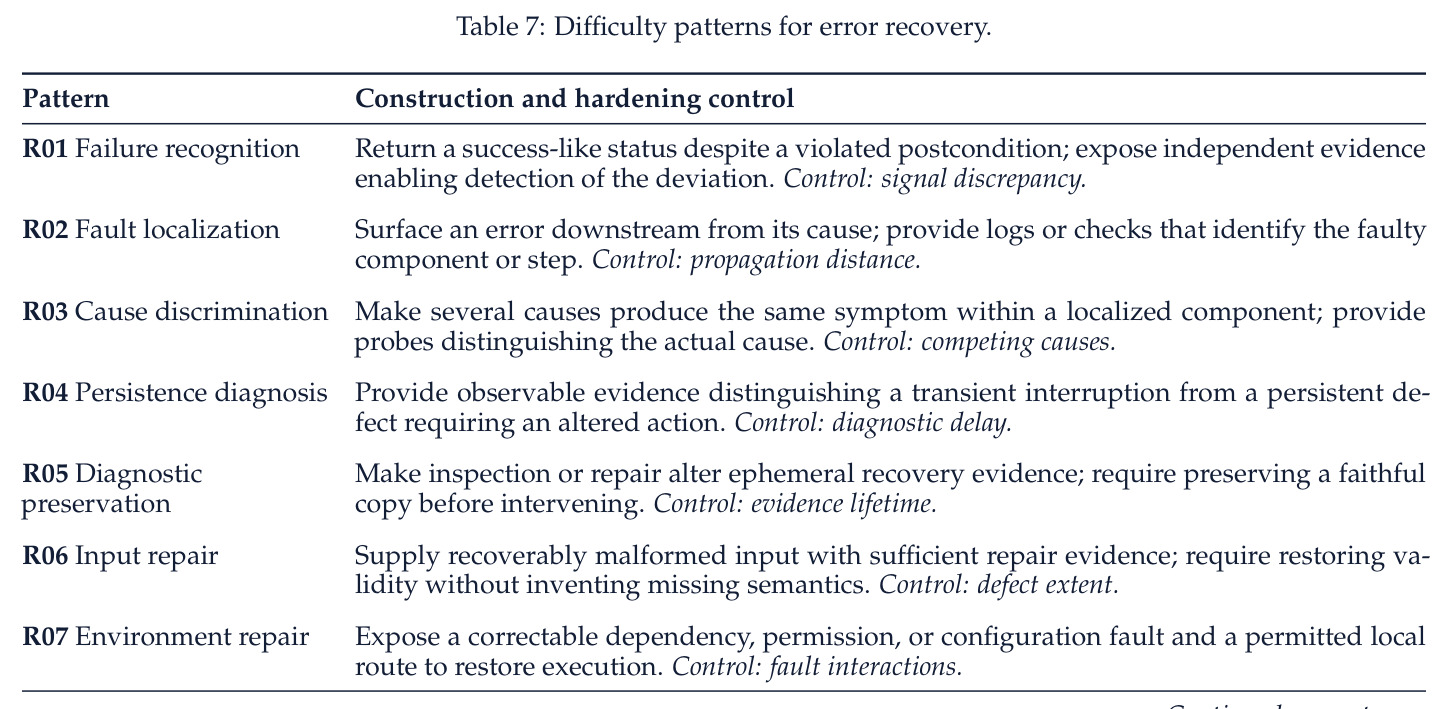
技能是一类任务的可复用程序性指令包,可能附带脚本、模板和参考资源,编码领域知识、操作流程与工具使用方式。本文从 ClawHub 下载 47K+ 公开技能文件夹,按实用价值、运行时兼容性(硬件/OS/权限/算力须兼容 Linux 沙盒)、部署可行性(输入、依赖、数据、服务可供给)三条标准筛选出 3K+ 个作为合成原料。
技能是 Skill2Env 的输入起点,理解技能包含什么、缺什么,才能理解论文所说的从技能到环境之间的「鸿沟」是什么。
难度模式
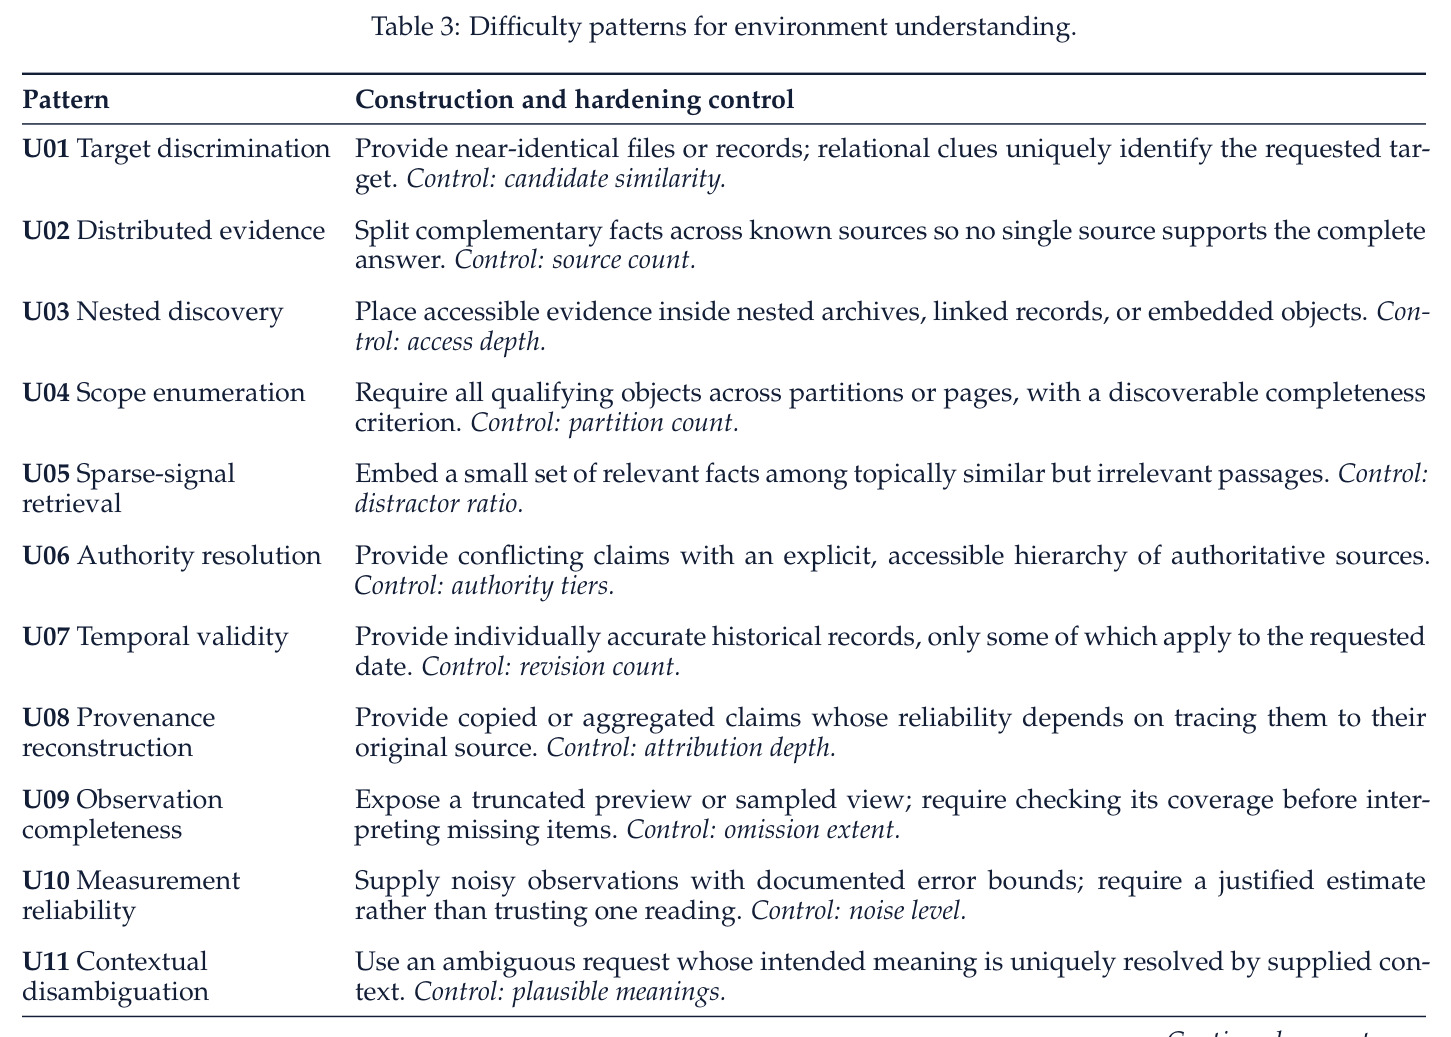
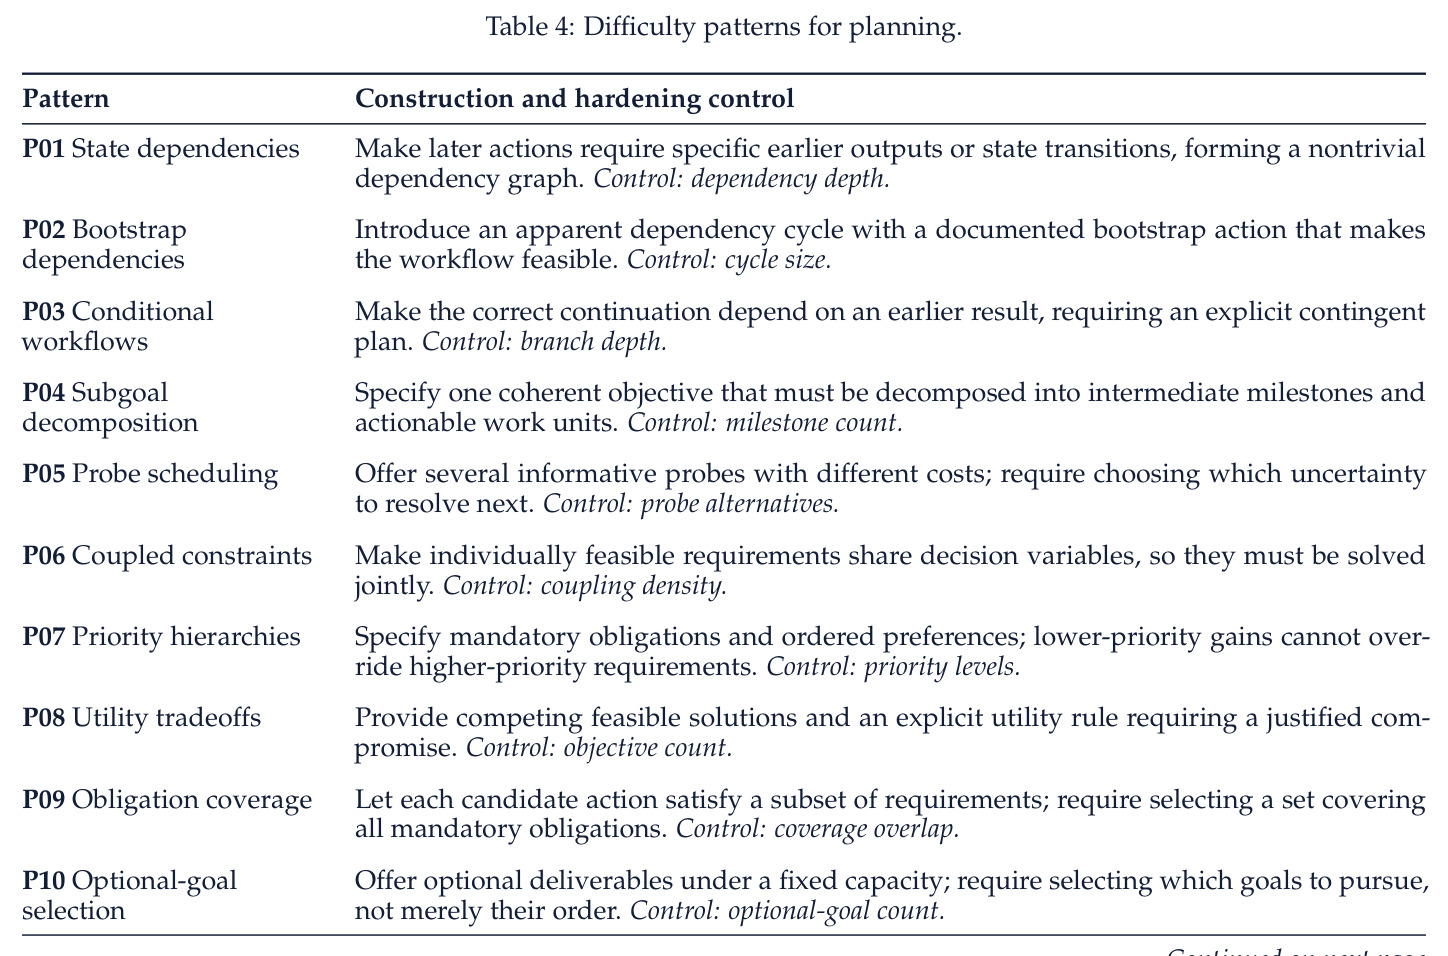
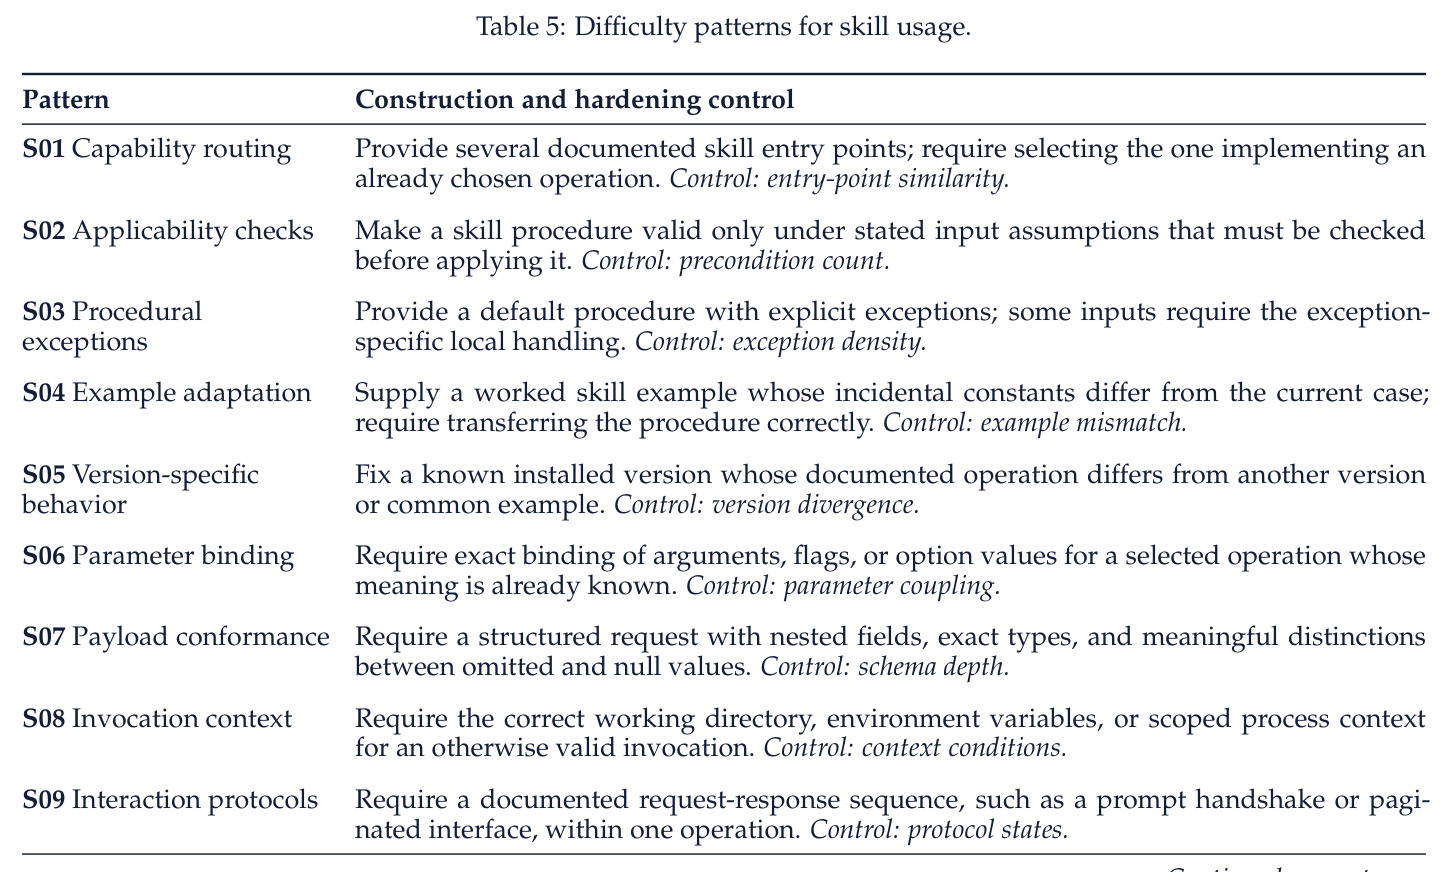
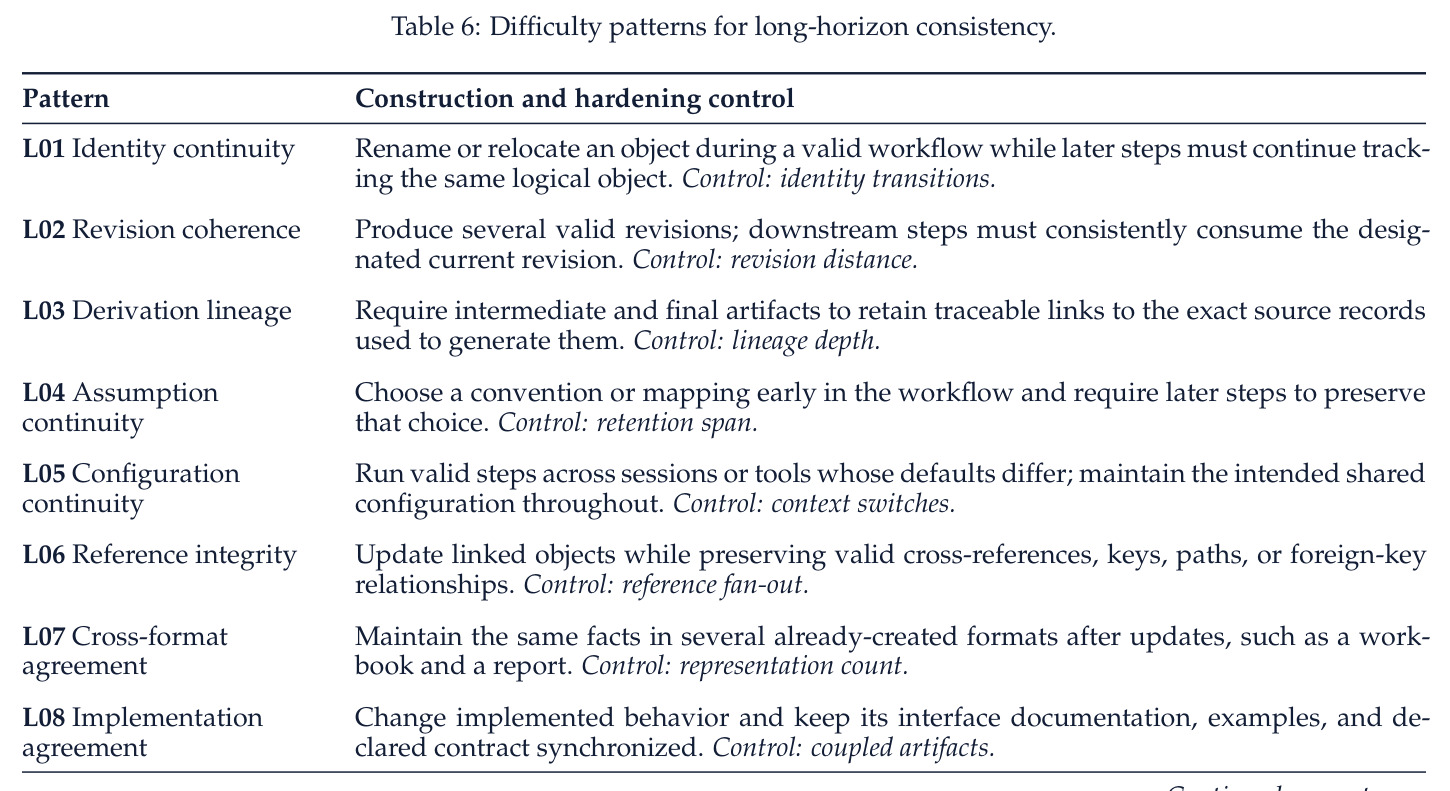
难度模式是对一类可复用任务挑战的抽象描述,说明该挑战是什么以及如何在环境中构造它。例如「分布式证据」把事实拆散到多个来源,「隐式约束」要求推断未言明的规则,「状态依赖」让后续操作依赖早期结果,「资源预算」限制累计资源使用。初始池含 100 个模式,按五个能力维度组织,合成时为每份技能选兼容子集 $P_\kappa \subseteq P$。
难度模式是本文把抽象的「能力需求」翻译成具体环境结构的关键中间层,是整个方法最核心的概念。
Rubric 评估器与 LLM Judge
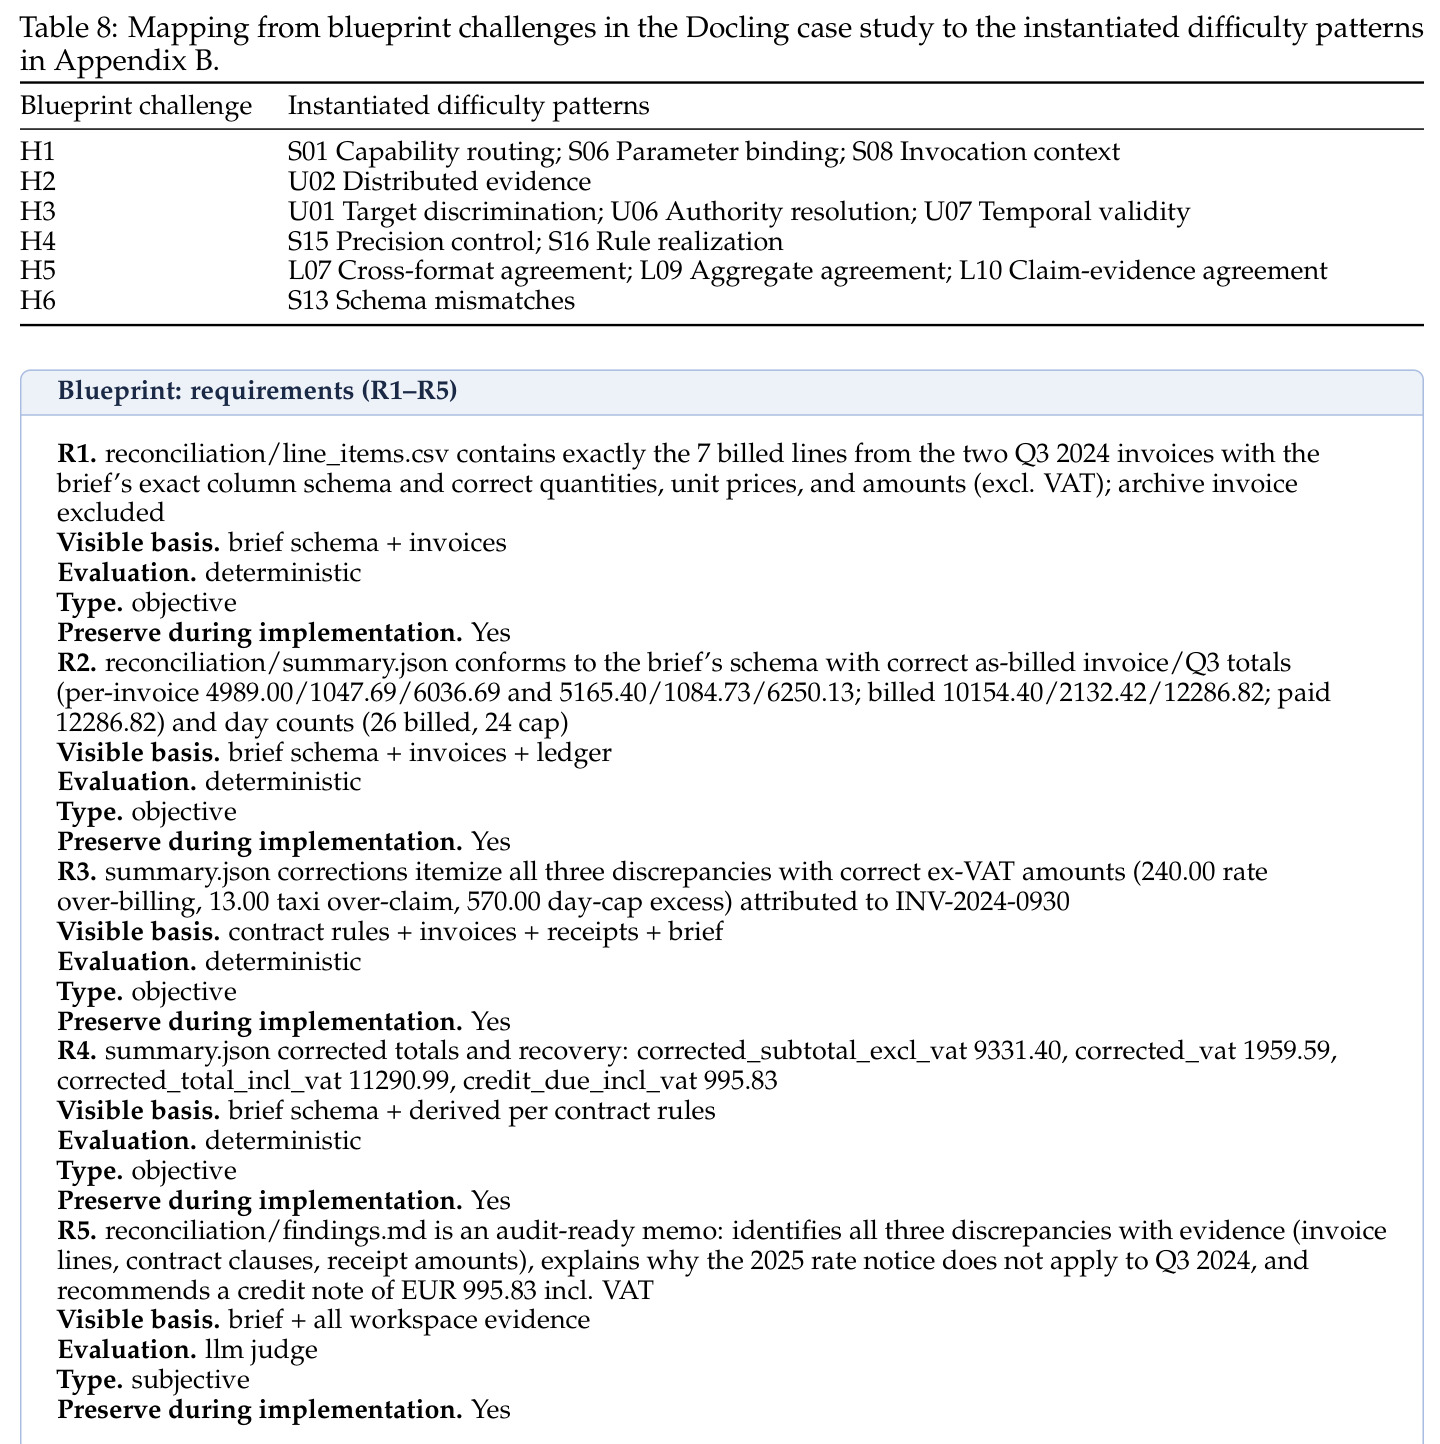
评估器把蓝图的验收标准翻译成一组带权重的评分项 $C$,每项权重 $w_c$ 且 $\sum_{c \in C} w_c = 1$。可程序化确定性验证的项返回二值分数,其余交给 LLM judge 按评分标准给 $[0,1]$ 连续分。任务奖励为加权平均 $r = V(s_L) = \sum_{c} w_c q_c(s_L)$,每项结果须附支持证据。
训练数据用 $r>0.9$ 过滤,任务加固以 $r>0.7$ 为触发阈值,评分器设计直接决定数据质量与难度估计的可靠性。
智能体评测基准
Terminal-Bench 2.1 评终端任务执行(Terminus-2 harness,单次尝试,10800 秒超时);SkillsBench 评跨领域技能使用(OpenHands,Avg@3);SWE-bench Multilingual 评多语言仓库级 issue 修复(mini-SWE-agent,300 实例,7200 秒);Claw-Eval 评自主任务执行(原生 agent loop,Pass3);另有 τ3-Banking、AutomationBench、VitaBench 分别覆盖银行知识、跨应用工作流与交互式服务。
论文用 7 个异构基准验证监督信号的迁移性,知道每个基准测什么,才能判断提升是否真的来自通用能力而非刷题。
研究动机
要让智能体在后训练中学会工具使用与多步交互,仅生成任务指令远远不够:还必须配置可用的工具、搭建承载任务资源与状态的工作区、并建立与任务目标对齐的评估机制。这些组件彼此耦合,逐个任务人工构造和维护根本无法扩展到训练所需的体量与多样性。技能(skill)虽然封装了领域知识、操作流程和工具使用说明,看起来是天然的合成原料,但从一份技能文档到一个具体、有挑战、可执行的任务加环境之间仍有巨大鸿沟。已有尝试如 SkillSynth(把轨迹建模为场景-技能交替序列)、Terminal-World(技能联合驱动指令合成与环境构建)、FACET(跨技能场景重构保证一致性)都从技能出发合成环境,却没有回答一个更根本的问题:给定一份技能,如何围绕智能体需要锻炼的能力来构造任务与环境?结果是合成出的任务要么难度失控、要么挑战设计与能力训练目标脱节,监督信号难以迁移。
本文的目标是本文的目标是构建一条从技能出发、以智能体能力需求为导向的自动化流水线:输入一份经过筛选的技能,输出包含任务指令、执行基底、初始工作区和评估器的完整可执行任务实例,且任务难度要真实对准环境理解、规划、技能使用、长程一致性、错误恢复这五项能力。系统还需能利用求解器智能体的执行证据,自动发现「不够难」的任务并迭代加固,最终用产出的环境生成高质量轨迹做 SFT,并验证这些监督信号能否迁移到 Terminal-Bench 2.1、SWE-bench Multilingual、SkillsBench 等七个领域、接口、任务结构各异的基准上——而非针对某个特定 benchmark 做优化。
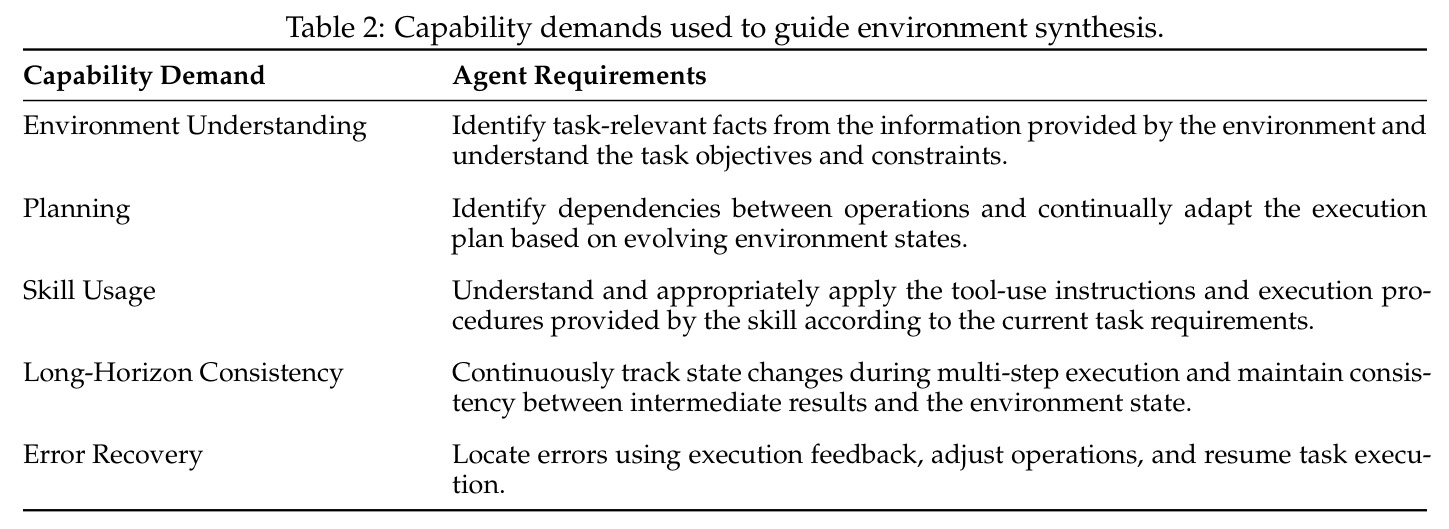
与已有工作不同的是,本文的独特切入是把「能力需求」从口号变成可操作的对象:先归纳出五维能力需求,再用 100 个可复用难度模式作为中间层,把抽象需求翻译成具体环境结构(如「分布式证据」「状态依赖」);随后用任务蓝图作为「作者侧契约」,把目标、挑战、环境事实、信息边界、验收标准一次说清,使指令、执行基底、工作区、评估器四件套全部在契约下联合构造、联合修订——而不是先写指令再补环境。与 workspace-anchored(从已有仓库/PR/失败轨迹恢复改造)或一次性合成方法的本质区别是 Iterative Task Hardening:用 solver 的真实执行证据诊断哪些挑战被轻易绕过,反哺蓝图修订和难度模式池扩展,让任务难度随智能体能力提升而共同进化,形成可持续产出高难度训练环境的机制。
核心方法
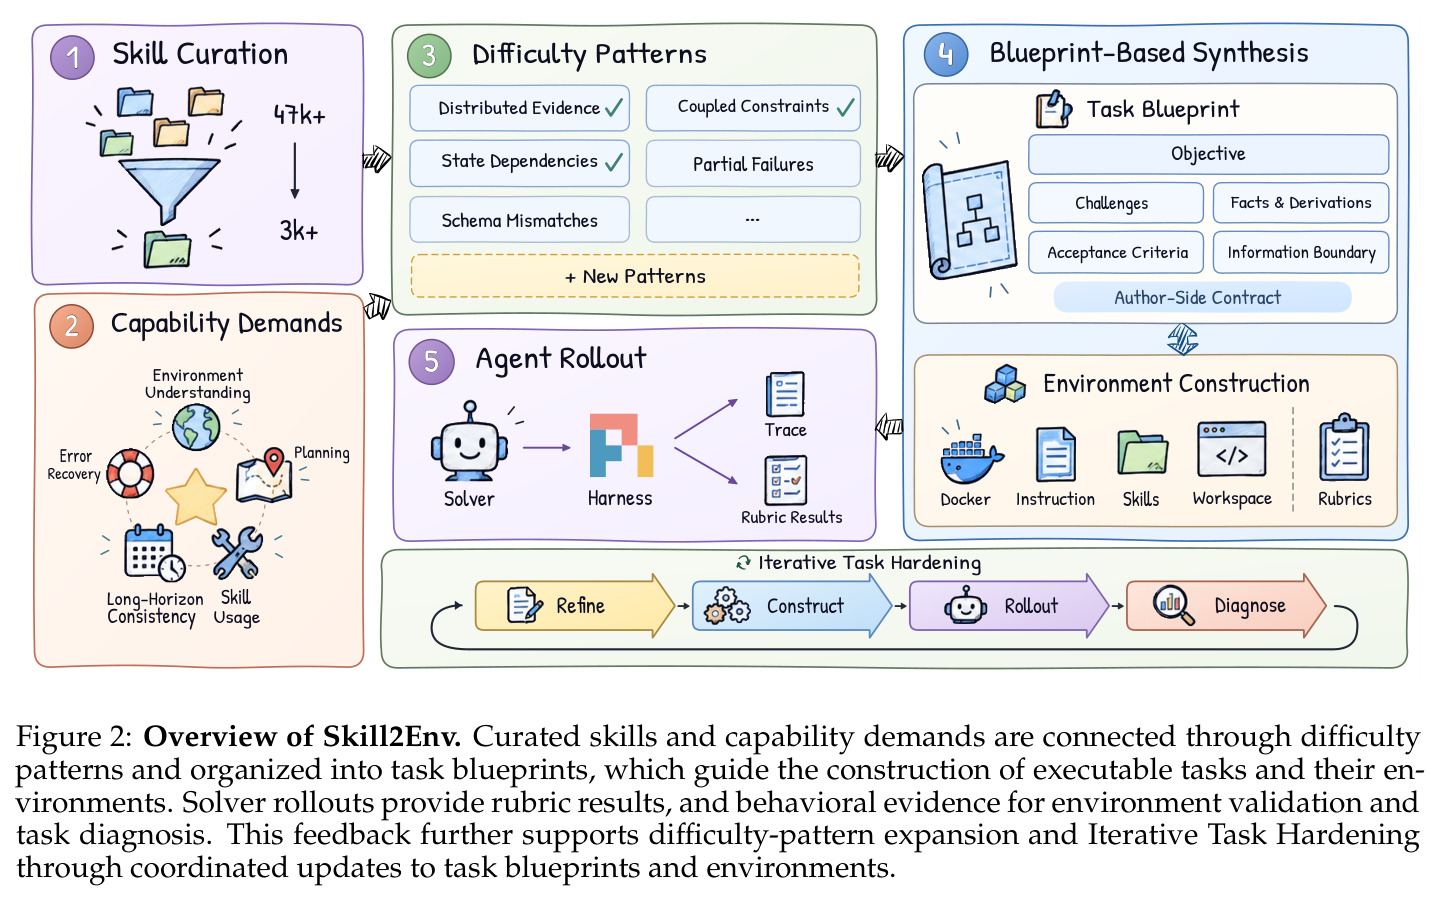
直觉上,Skill2Env 像一个自动化命题团队:先选教材(技能),再定考纲(能力需求加难度模式),写一份命题合同(蓝图),按合同同时出题、搭考场、配评分标准(任务四件套),考完试看成绩单(solver 执行证据),发现题目太简单就改合同重新命题(迭代加固)。技术上,流程从 ClawHub 47K+ 技能筛选出 3K+ 开始;对每份技能,合成智能体识别其支持的工作流并从 100 个难度模式中选出兼容子集 $P_\kappa$;然后起草蓝图 $B$,实例化目标、挑战、事实与推导、信息边界、验收标准,并在蓝图约束下构造任务指令 $g$、Docker 化执行基底 $\mathcal{X}$、初始工作区 $W_0$ 和 rubric 评估器 $V$,得到 $T=(g,(\mathcal{X},\kappa,W_0),V)$;solver rollout 后由验证智能体做一致性校验,诊断智能体对比蓝图与轨迹找薄弱点,加固提议 $H$ 并入蓝图后协同更新四件套。完整流水线产出 2,963 个可执行任务,用于生成 SFT 轨迹。
核心创新有三点。第一,难度模式作为能力需求与环境结构之间的可复用中间表示:每维能力由多个模式实例化,同一技能选择不同模式组合就能产生能力侧重不同的任务,这让「要练什么能力」成为可显式设计、可累积、可由执行证据扩充的资产。第二,任务蓝图作为作者侧契约:它同时规定任务考什么(挑战与验收标准)、环境里有什么(事实与证据)、哪些信息直接给 solver、哪些必须由 solver 自己发现或推断(信息边界),使指令、环境、评估器天然一致,从机制上避免「题目与场景脱节」的常见合成病。第三,Iterative Task Hardening 把任务难度变成动态量:奖励高于 0.7 阈值的任务被判定「太简单」,诊断智能体分析 solver 如何绕过挑战,然后增强已有模式的实例化强度或引入新的兼容模式,修订蓝图后重构任务;诊断中发现的可泛化新挑战还会被抽象成新模式加入池中。这与已有技能合成方法「一次生成、不再进化」的做法有本质区别。
方法步骤详情
第一步,技能筛选:下载 ClawHub 47K+ 技能文件夹,按实用价值、运行时兼容性、部署可行性三准则筛出 3K+。第二步,模式选择:合成智能体识别技能 $\kappa$ 的工作流,从 100 模式池中选兼容子集 $P_\kappa$。第三步,蓝图起草:输出含任务目标、挑战、环境事实与推导、信息边界、验收标准的蓝图 $B$。第四步,联合构造:按 $(\kappa,B) \rightarrow T=(g,(\mathcal{X},\kappa,W_0),V)$ 构造指令、Docker 执行基底、混合材料的工作区与 rubric 评估器(程序验证项二值打分,其余 LLM judge 连续打分,$r=\sum_c w_c q_c$)。第五步,执行与验证:solver rollout 产出轨迹 $\tau$ 与结果 $q$,验证智能体对照蓝图核查条件与证据,排除评估器错误。第六步,迭代加固:$r>0.7$ 的任务进入诊断 $D^{(j)}$,生成加固提议 $H^{(j)}$,经 $B^{(j+1)}=\mathrm{ReviseBlueprint}(B^{(j)},H^{(j)})$ 修订蓝图并重构任务。最后用 DeepSeek-V4-Flash 生成轨迹,保留 $r>0.9$ 的 1.5K 条做 SFT。
技术新颖性
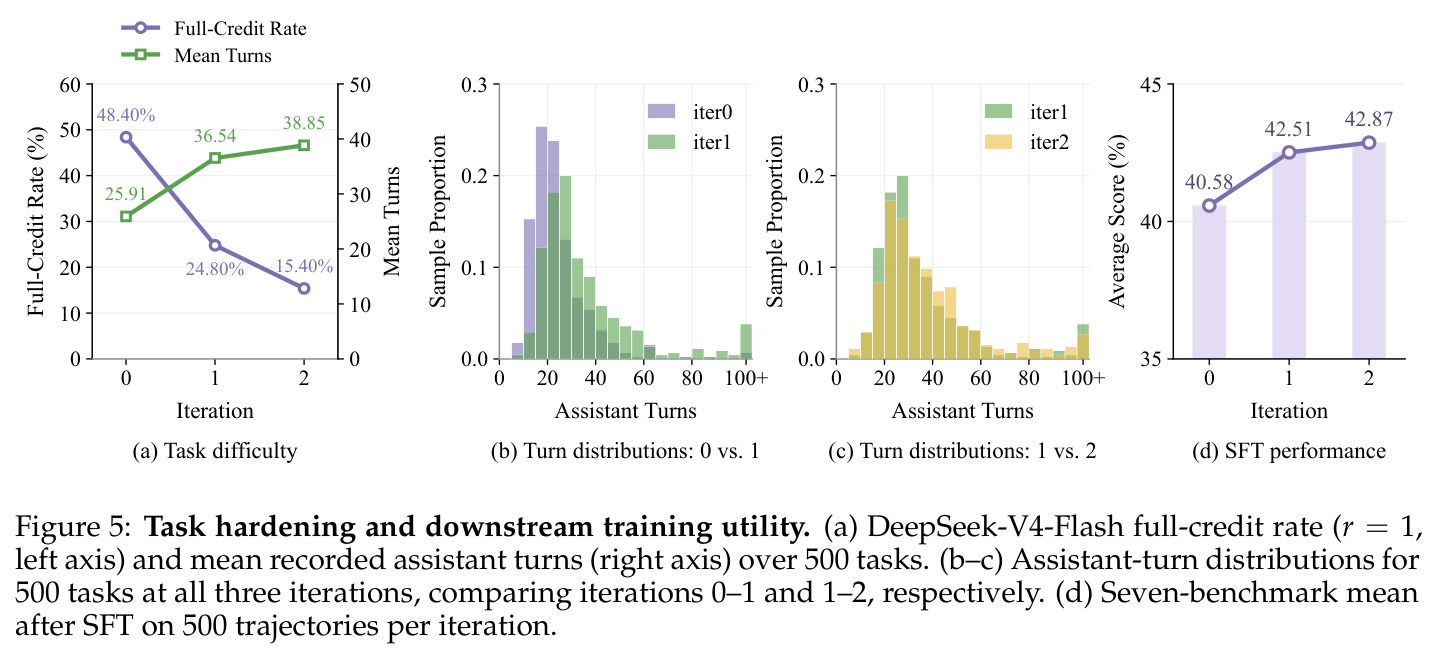
从技术谱系看,环境合成分 workspace-anchored(仓库/PR/失败/轨迹改造)与 from-scratch 两派,本文属后者但给出了新的组织原则。相比 SkillSynth 的场景-技能图采样、Terminal-World 的技能联合驱动、FACET 的跨技能场景重构、SKT 的规则加智能体验证修复,Skill2Env 的差异在于:其一,显式的难度模式层——把「难在哪里」参数化为 100 个可复用、可组合、可由执行证据反哺扩充的模式,而既有工作大多把难度隐含在提示工程里;其二,蓝图作为单一事实来源——信息边界设计(solver 必须发现什么、推断什么)直接对准「环境理解」这类能力的考核,程序化保证考的即练的;其三,以执行证据为反馈的难度闭环——0.7 的触发阈值、成对任务追踪、模式池扩展,形成随 solver 能力提升而自动抬升难度上限的机制,实验显示三轮加固把 full-credit 率从 48.40% 压到 15.40%;其四,把训练信号的可迁移性当作一等目标,用七个异构基准全部提升来支撑「围绕通用能力需求构造的环境能产生可泛化监督」这一论点。
实验结果
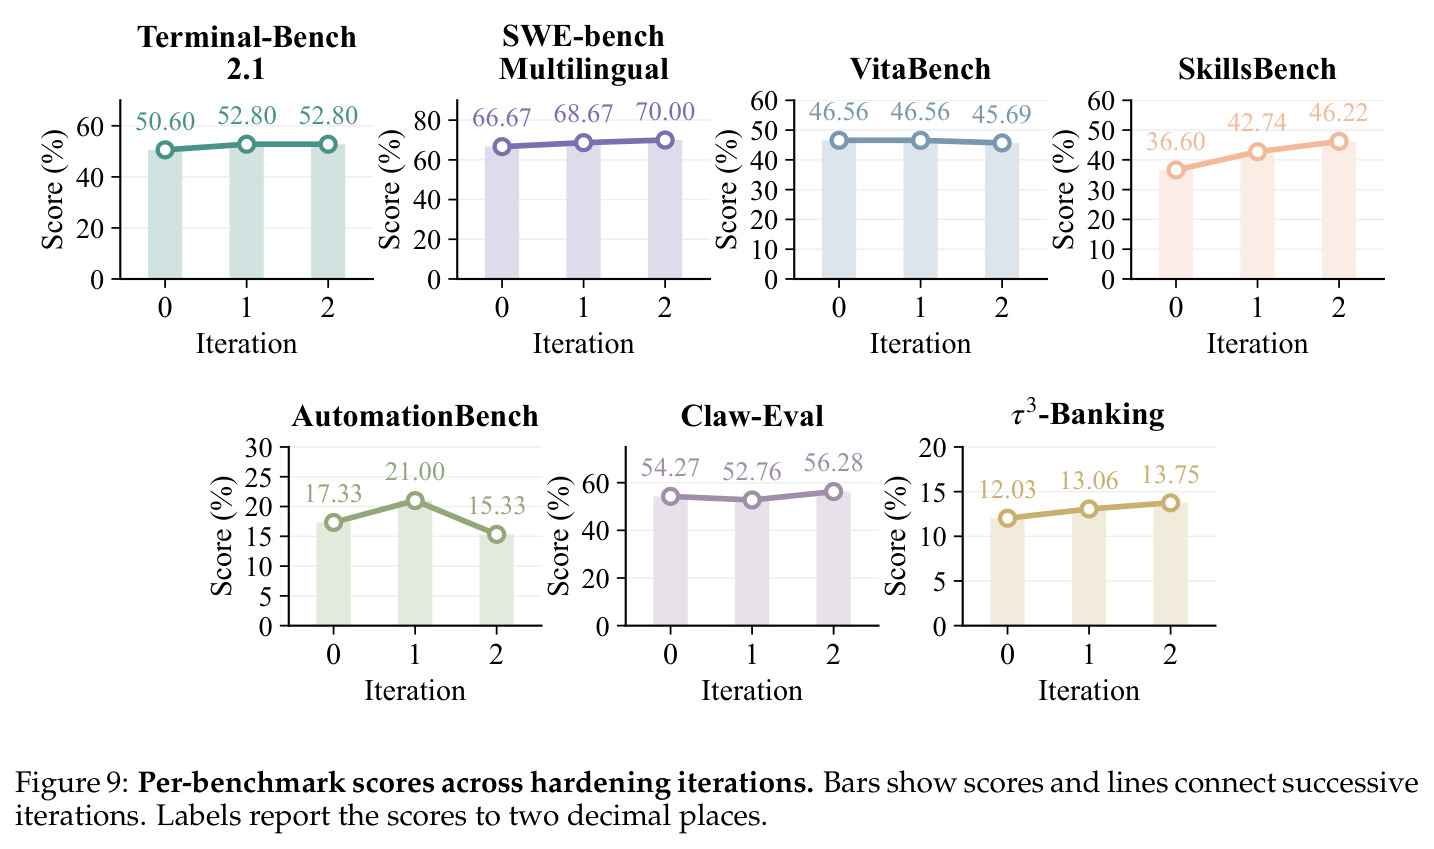
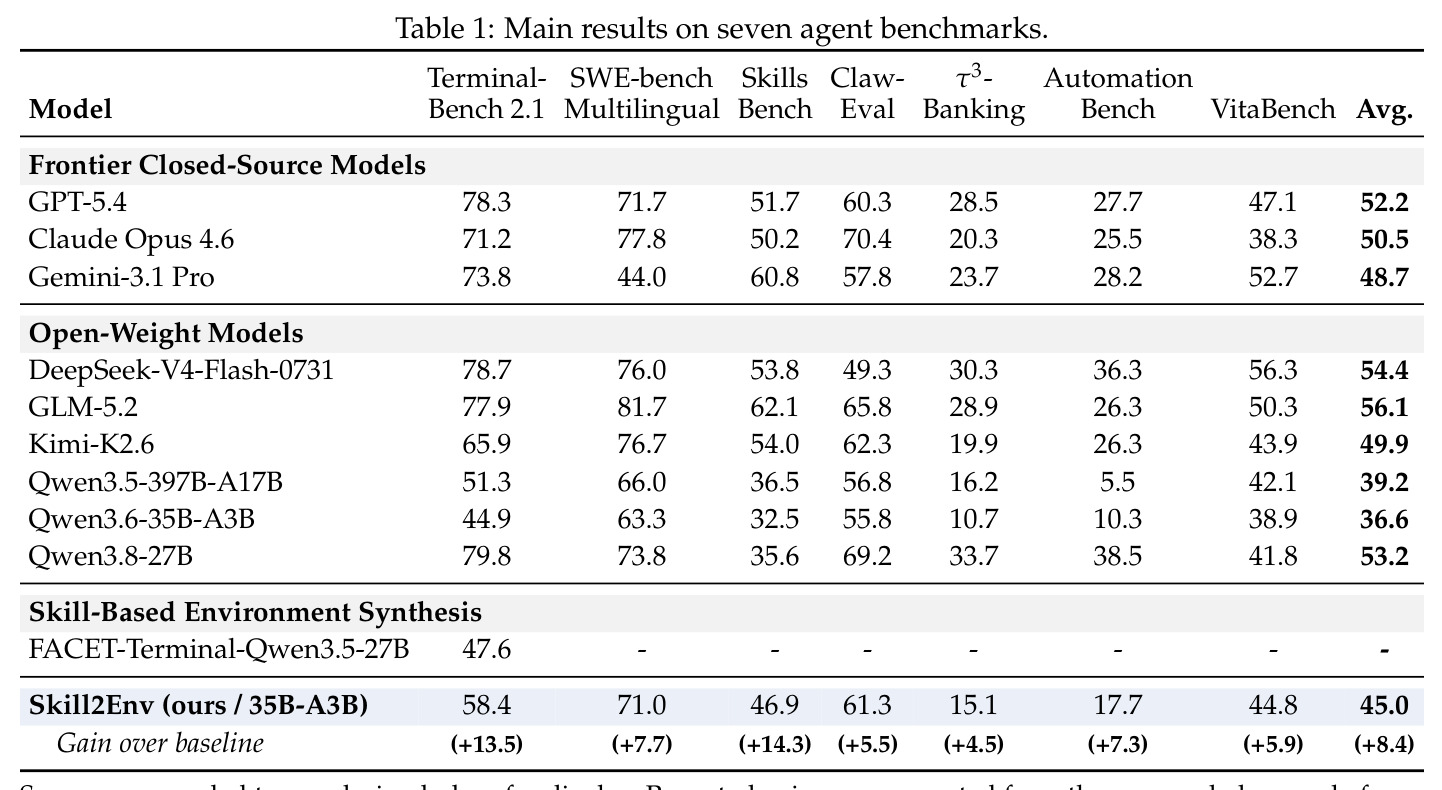
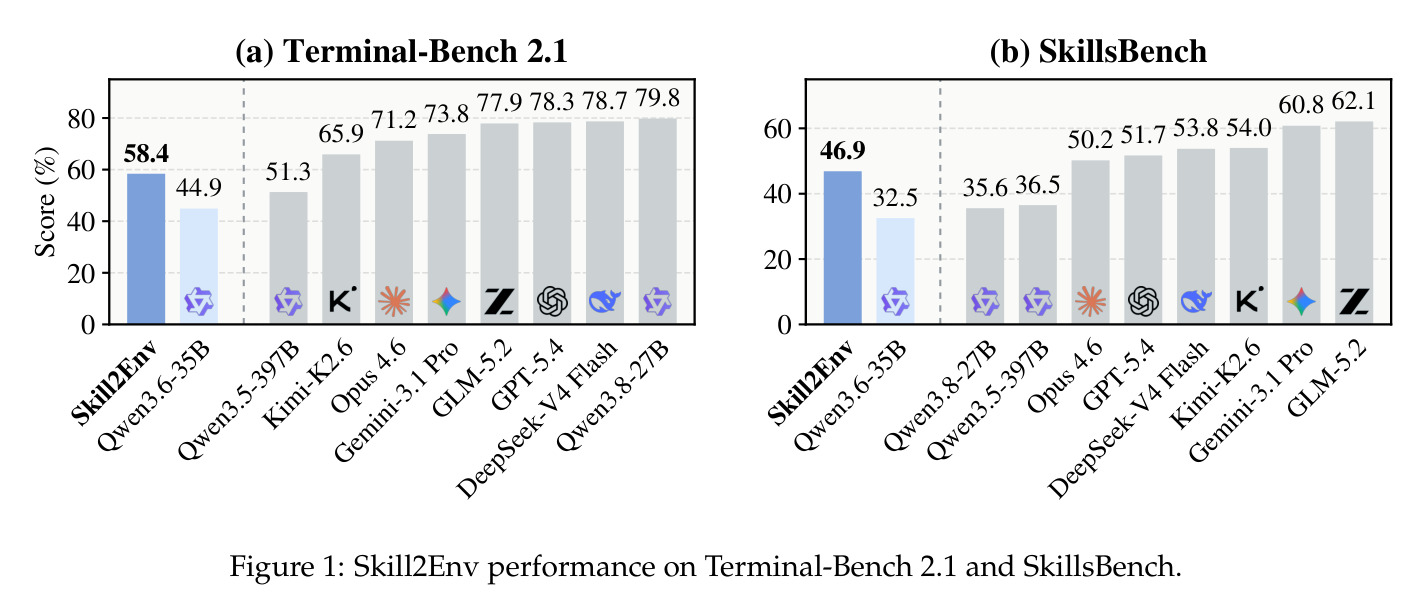
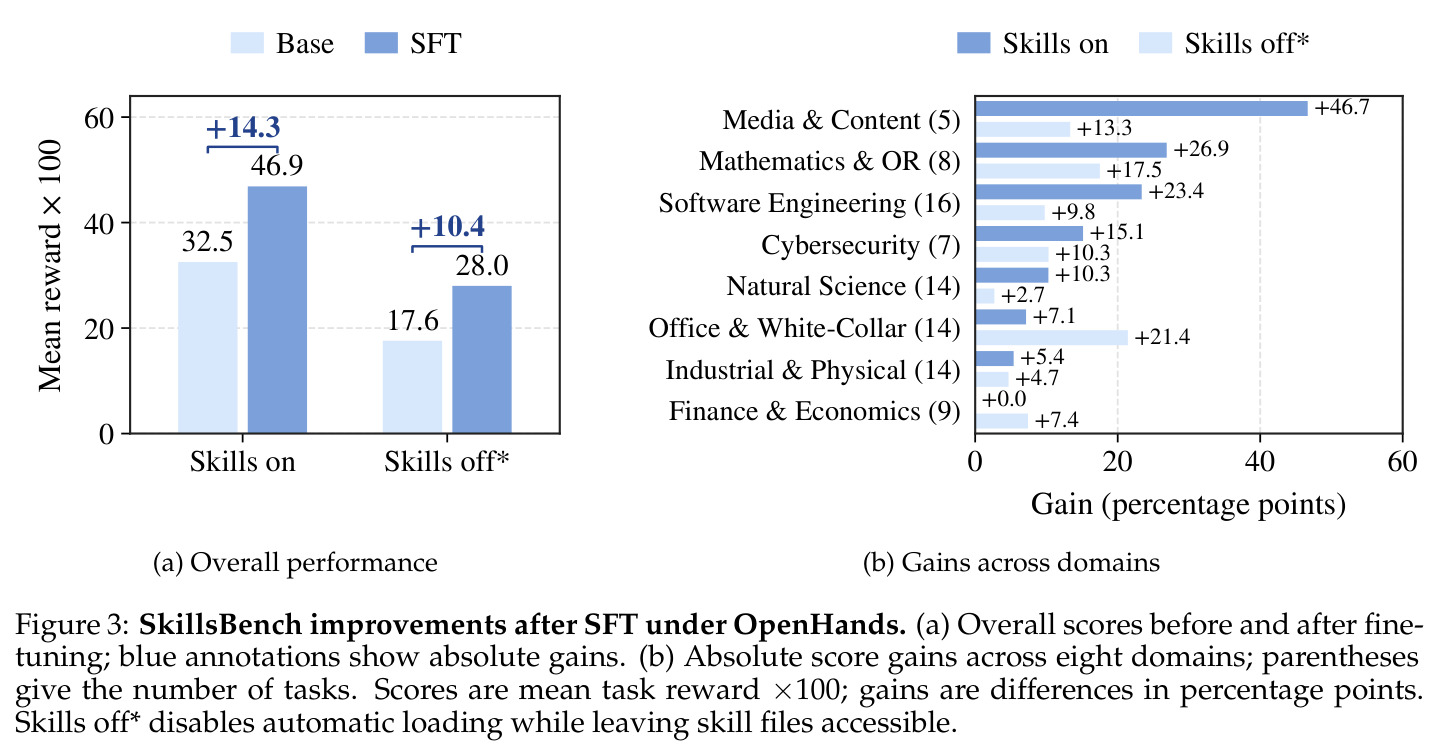
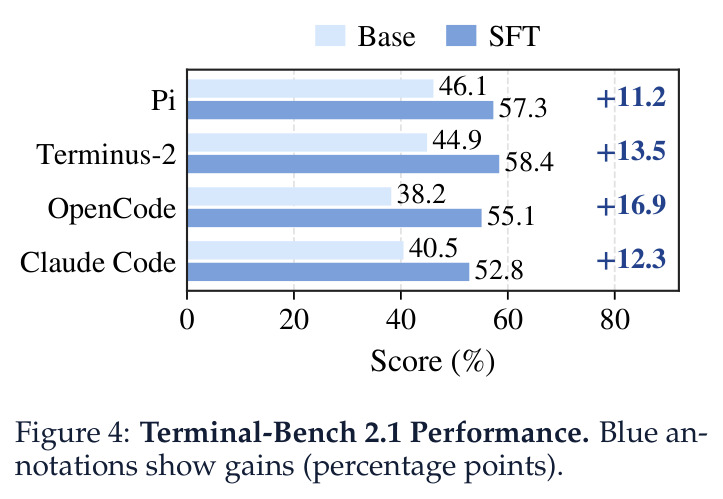
核心结论:围绕能力需求合成的环境能产出可迁移的 SFT 监督。用 1.5K 条 $r>0.9$ 轨迹微调 Qwen3.6-35B-A3B 后,七个基准全部提升,未加权平均从 36.6 升至 45.0(+8.4):Terminal-Bench 2.1 44.9→58.4(+13.5)、SkillsBench 32.5→46.9(+14.3,最大增益)、SWE-bench Multilingual 63.3→71.0(+7.7)、AutomationBench 10.3→17.7(+7.3)、VitaBench 38.9→44.8(+5.9)、Claw-Eval 55.8→61.3(+5.5)、τ3-Banking 10.7→15.1(+4.5)。35B 的 SFT 模型在 7 个基准中的 6 个上超过 397B 的 Qwen3.5-397B-A17B(平均 45.0 对 39.2),但 GPT-5.4(52.2)、GLM-5.2(56.1)仍更强。SkillsBench 分域:skills-on 提升 14.3 分、8 领域中 7 个提升(金融持平),media +46.7、数学运筹 +26.9、软件工程 +23.4 领跑;skills-off 下 8 领域全升。跨 harness:pi +11.2、Terminus-2 +13.5、OpenCode +16.9、Claude Code +12.3。加固实验(500 成对任务):三轮迭代后 full-credit 率从 48.40% 降至 15.40%(-33.0 点),平均 assistant 轮次 25.91→38.85(约 +50%);固定 500 条 $r>0.9$ 轨迹预算下,iteration 0/1/2 的 SFT 七基准平均分为 40.58/42.51/42.87,证明加固提高了训练效用。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 终端任务执行(Terminal-Bench 2.1) | 任务成功率(Terminus-2,单次尝试,10800s 超时) | 58.4 | Qwen3.6-35B-A3B 基座 44.9 | +13.5 |
| 跨领域技能使用 | Avg@3 任务奖励(OpenHands,10800s 超时) | 46.9 | Qwen3.6-35B-A3B 基座 32.5 | +14.3(最大增益) |
| 多语言仓库级 issue 修复(SWE-bench Multilingual) | resolved 实例率(mini-SWE-agent,300 实例,7200s) | 71.0 | Qwen3.6-35B-A3B 基座 63.3 | +7.7 |
| 跨应用工作流 | 通过率 v1.0.6 | 17.7 | Qwen3.6-35B-A3B 基座 10.3 | +7.3 |
| 交互式服务任务 | 平均分 | 44.8 | Qwen3.6-35B-A3B 基座 38.9 | +5.9 |
| 自主任务执行 | Pass3(原生 agent loop,3 次尝试) | 61.3 | Qwen3.6-35B-A3B 基座 55.8 | +5.5 |
| 银行知识支持(τ3-Banking) | Pass1 | 15.1 | Qwen3.6-35B-A3B 基座 10.7 | +4.5 |
| 七基准未加权平均 | 平均分 | 45.0 | Qwen3.6-35B-A3B 基座 36.6;参考:GPT-5.4 52.2、GLM-5.2 56.1、Qwen3.5-397B 39.2 | +8.4 |
局限与改进
作者坦承前沿模型仍然更强:GPT-5.4 平均 52.2、GLM-5.2 达 56.1,而 SFT 后的 35B 模型为 45.0,说明能力天花板尚远,尤其在 τ3-Banking(15.1 对 GPT-5.4 的 28.5)和 AutomationBench(17.7 对 Qwen3.8-27B 的 38.5)这类知识密集任务上差距明显。此外值得注意的局限还有:监督形式仅限 SFT,未探索在这些自带验证器的环境上做强化学习;rubric 中不可程序化的项依赖 LLM judge(Qwen3.5-397B-A17B),judging 噪声会同时污染数据过滤与 hardening 触发;加固触发阈值 0.7 是人工设定的全局常数,未按任务难度分布自适应;五维能力需求与 100 个初始模式来自团队先验,其覆盖面与偏差缺乏系统分析;实验只用 Qwen3.6-35B-A3B 一个 backbone,结论在不同规模与家族模型上的普适性未知;FACET 基线仅引用其在 Terminal-Qwen3.5-27B 上的 47.6 单点成绩,可比性有限。
独立分析的弱点
第一,合成成本高且依赖强模型:合成与诊断用 Kimi-K3、教师轨迹用 DeepSeek-V4-Flash、judging 用 Qwen3.5-397B,每个任务还需多次 Docker rollout,中小团队难以负担,可蒸馏小型合成模型或只对高价值技能跑完整流水线。第二,$r>0.9$ 过滤与 $r>0.7$ 触发都以 rubric 分为唯一依据,LLM judge 的系统性偏差(如偏爱冗长回答)会同时扭曲训练数据与难度估计,可引入人类抽检校准。第三,任务域集中于终端/CLI/文档处理类,47K 筛到 3K 通过率仅约 6%,GUI、多模态、长程真实软件工程覆盖不足。第四,加固只验证到第 2 轮,模式池扩展后的规模与去重质量未披露,长期可能退化为同质模式。第五,「信息边界」防泄漏设计未量化违规(答案意外进入工作区)发生率,而这直接决定任务有效性。第六,35B 模型在 τ3-Banking、AutomationBench 上绝对分值仍很低,知识密集能力难以只靠环境合成补足。
未来方向
顺着本文最自然的延伸是把 2,963 个带验证器的环境用于在线强化学习(如 GRPO/PPO),让策略在难度自动抬升的课程中持续训练,而非一次性蒸馏教师轨迹;加固机制可推广为「环境-策略协同进化」框架:阈值按 solver 当前通过率自适应,并用最少 rollout 数估计任务难度以降低成本。基于五维能力需求可构建能力诊断套件:用控制变量的模式组合单独量化每维能力的训练收益,反哺模式池设计。从失败轨迹聚类抽象新模式目前已有雏形,可进一步发展为跨领域、跨 harness 的开放难度模式库,并研究模式间冲突与依赖的形式化。蓝图契约也可扩展到多智能体协作、GUI/浏览器与多模态环境,检验能力导向合成在交互形态变化时是否依旧成立。作者还指出 frontier 模型仍有明显领先,这提示可以构建 self-improving 闭环:让更强 solver 的失败案例成为新模式来源,同时把能力需求驱动的合成与课程学习、自动难度调度结合,逼近并持续抬高能力天花板。
复现评估
论文标注了 GitHub 资源链接,但正文未明确说明代码、2,963 个任务环境、SFT 数据或轨迹的开源范围,这是复现的最大不确定性。即使资源全部公开,完整复现仍需要:Kimi-K3(合成与诊断)、DeepSeek-V4-Flash(教师生成轨迹)、Qwen3.5-397B-A17B(LLM judge)三个大模型的 API 或部署资源;对每个任务多次 Docker 化 rollout(仅 Terminal-Bench 单次评测超时即 10,800 秒);以及 35B 模型 5 个 epoch 的 Megatron 训练(全局 batch 32,峰值学习率 $10^{-5}$)。相对容易的复现路径是只重做 SFT 与跨 harness 评测部分;最难的是整条加固闭环,因为涉及成对任务追踪、一致性验证智能体、蓝图修订策略等大量未公开的实现细节。对研究者而言,把蓝图 schema、难度模式列表与 rubric 证据格式抽象出来单独复用,是比整体复现更现实的切入点。
论文图表