E-MoE:面向非因子化扩散语言模型的增强混合专家 E-MoE: Enhanced Mixture-of-Experts for Non-Factorized Diffusion Language Models
复用MoE路由为离散共享潜变量,混合因子化专家,突破扩散语言模型因子化误差,大幅改善少步生成。
前置知识
掩码扩散模型(MDM)
一种离散扩散生成范式:前向过程按调度 $\alpha_t$ 逐步把每个 token 独立替换为特殊掩码符 $[M]$;反向过程用带双向注意力的网络在 $T$ 步内逐步还原,每步可并行揭示多个 token,因此生成长度 $L$ 的序列只需 $T<L$ 次前向计算,而非自回归模型的 $L$ 次。
本文的全部改进都作用在 MDM 的反向过程上,必须先掌握其掩码加噪与去噪机制才能理解因子化问题出在哪里。
因子化误差
MDLM 的反向过程写成各位置边缘分布的乘积 $p_\theta(x^s|x^t)=\prod_\ell p_\theta(x^s_\ell|x^t)$,是真实联合分布的秩一近似:同一步揭示的多个 token 被当作条件独立采样,彼此相关性丢失;一次揭示越多 token,伪配对误差越大,在低 NFE 区间最致命。
这是论文要解决的核心问题,E-MoE 的混合结构正是为了打破这一秩一限制,理解它才能理解全文动机。
ELBO 与后验坍缩
含隐变量模型的对数似然 $\log p_\theta(x_0)$ 难以直接计算,借助 Jensen 不等式可得下界:重构项加上隐变量后验与先验的 KL 项。若 KL 被压到 0,隐变量不再携带信息,称为后验坍缩;VADD 等连续潜变量方法需要 KL 退火来规避它。
E-MoE 的训练目标(命题 3.1)就是为其混合反向过程推导的 ELBO,其中的路由 KL 项以及『不坍缩』的实证验证贯穿全文。
混合专家(MoE)
把 Transformer 每层的 MLP 替换为 $E$ 个并列专家网络,由路由器输出 $\rho_\theta\in\triangle^E$ 为每个 token 挑选 top-k 个专家参与计算;总参数量大但每 token 激活参数与稠密模型相当,LLaDA-MoE 等工作已用它扩缩扩散语言模型。
E-MoE 的关键洞察是路由决策本身就是模型已有的、可复用的离散共享潜变量,懂 MoE 才能领会这一结构复用的巧思。
Gumbel-Softmax 与直通估计
离散类别采样不可导。Gumbel-Softmax 用 $\mathrm{softmax}((\log\rho+g)/\tau)$($g$ 为 Gumbel 噪声,$\tau$ 为温度)把采样松弛成可导近似;直通估计(straight-through)让前向取 one-hot、反向流经软权重梯度,使离散路由可以端到端训练。
E-MoE 的潜变量是逐 token、逐层的离散专家选择,训练完全依赖该技巧把梯度传进路由器。
少步生成与评估指标(NFE / Gen-PPL / MAUVE)
NFE 指采样时调用去噪网络的次数,扩散模型相对自回归的速度优势集中在 NFE=1–8 的少步区间。评估上,生成困惑度 Gen-PPL 用 GPT-2-large 给采样文本打分(越低越好),样本一元熵 $H$ 衡量多样性(真实 LM1B 约 4.32),MAUVE 在嵌入空间比较生成分布与真实分布(越高越好)。
论文主要结果都在匹配熵的协议下比较 Gen-PPL 与 MAUVE,读懂这套指标体系才能正确解读实验数字。
研究动机
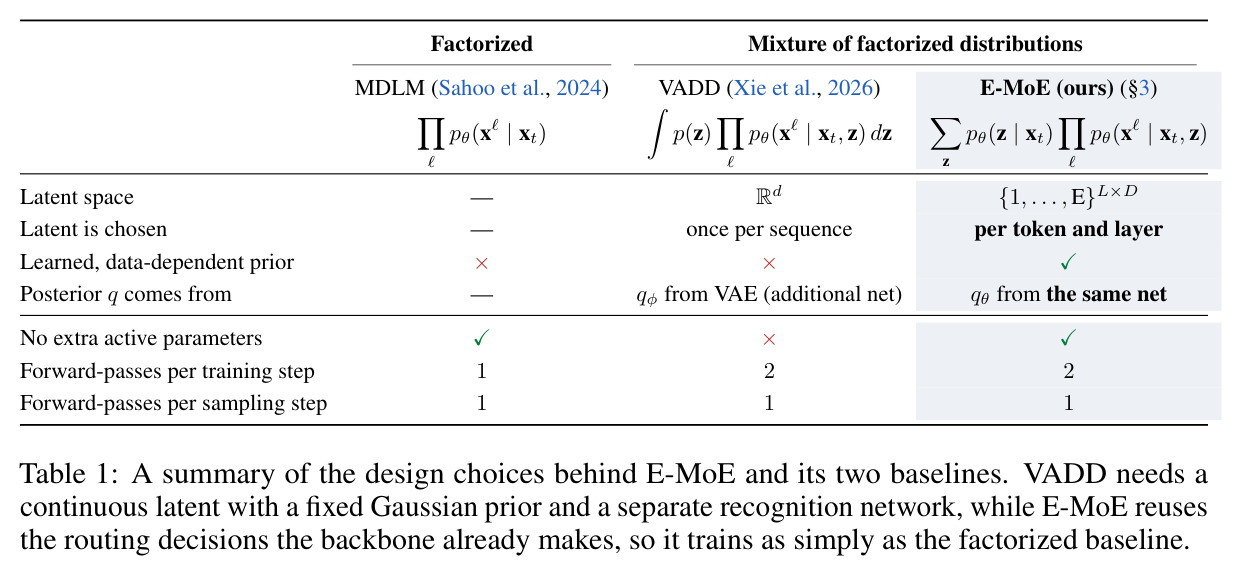
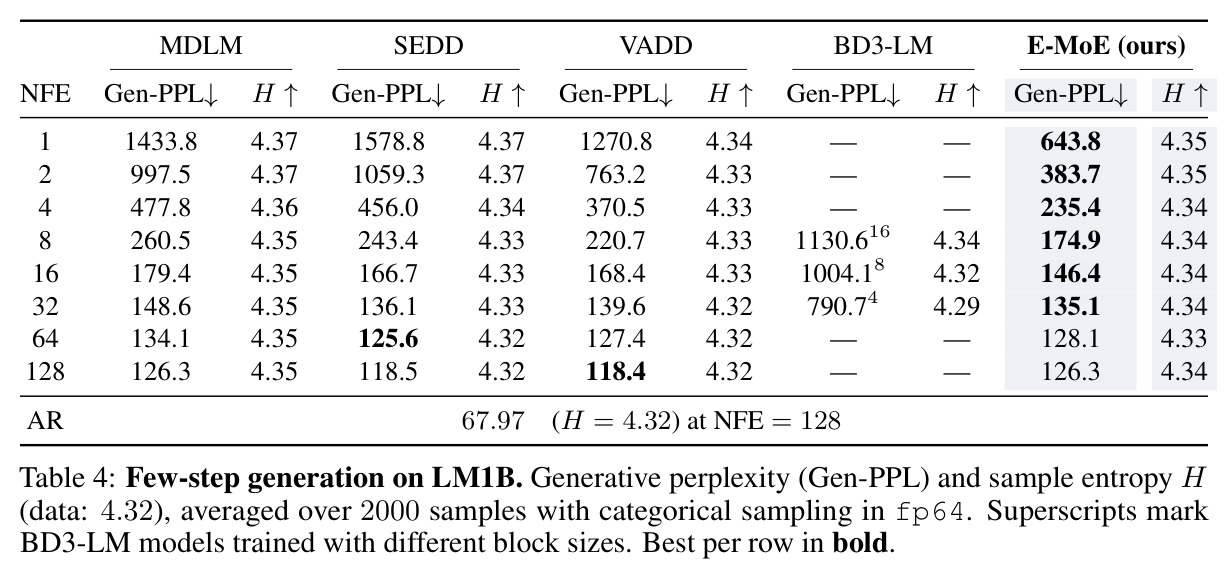
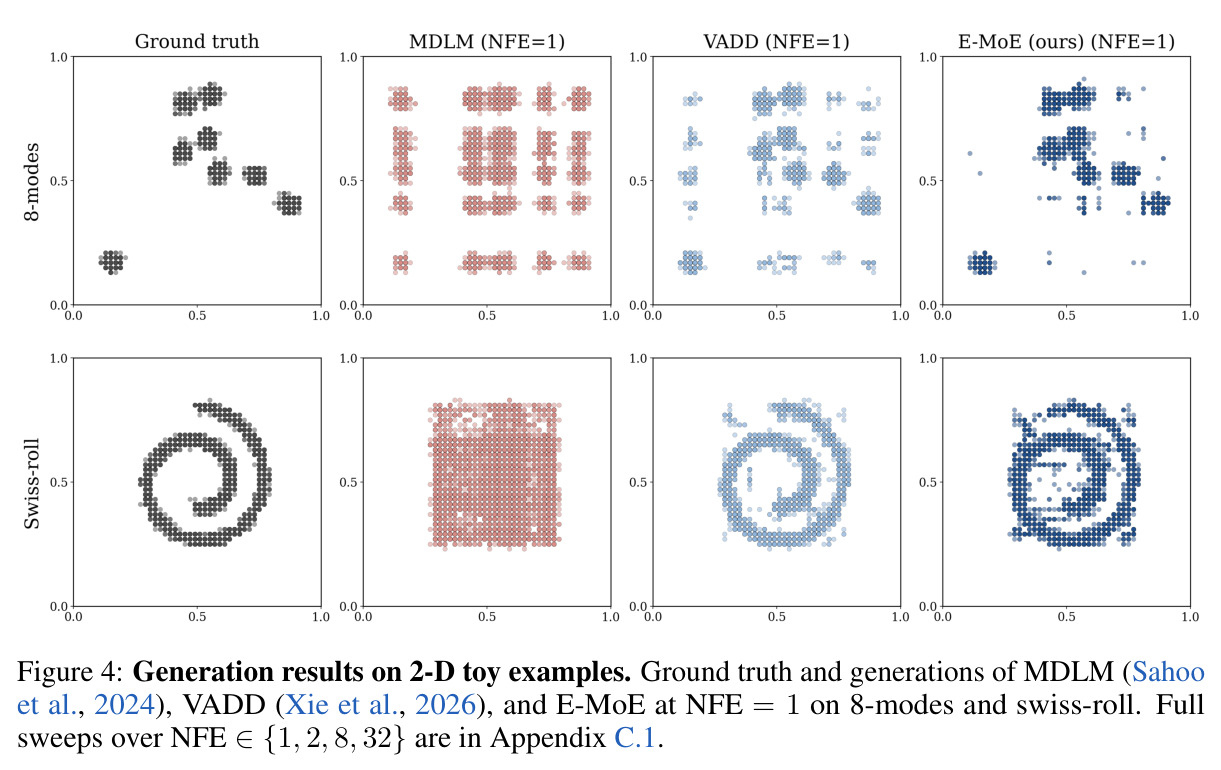
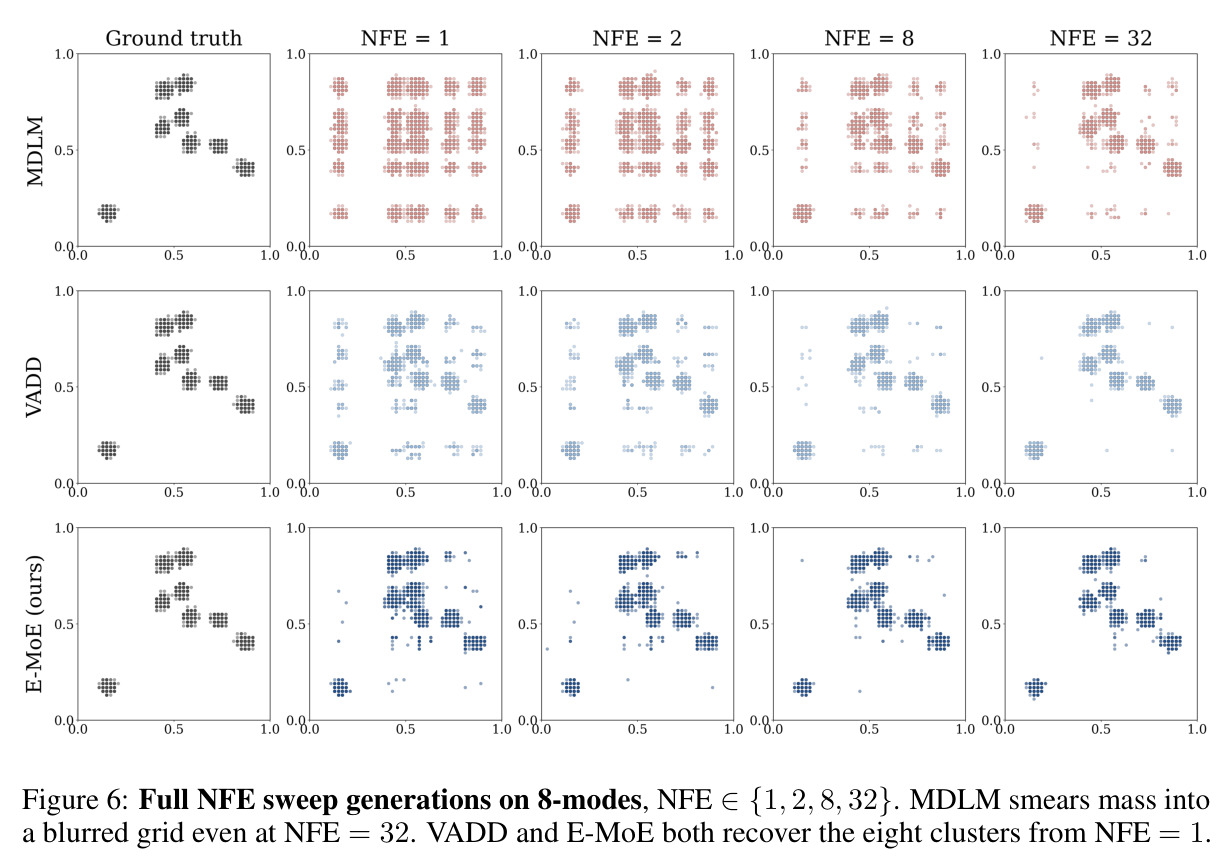
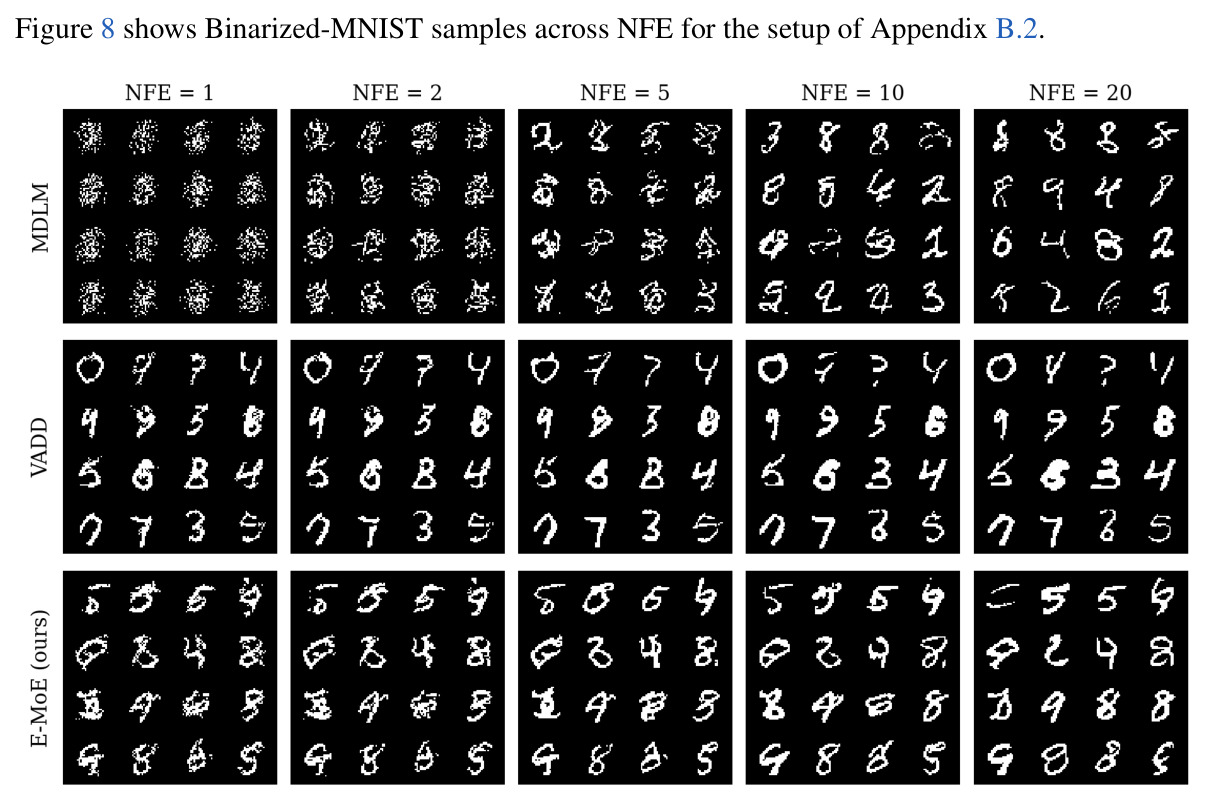
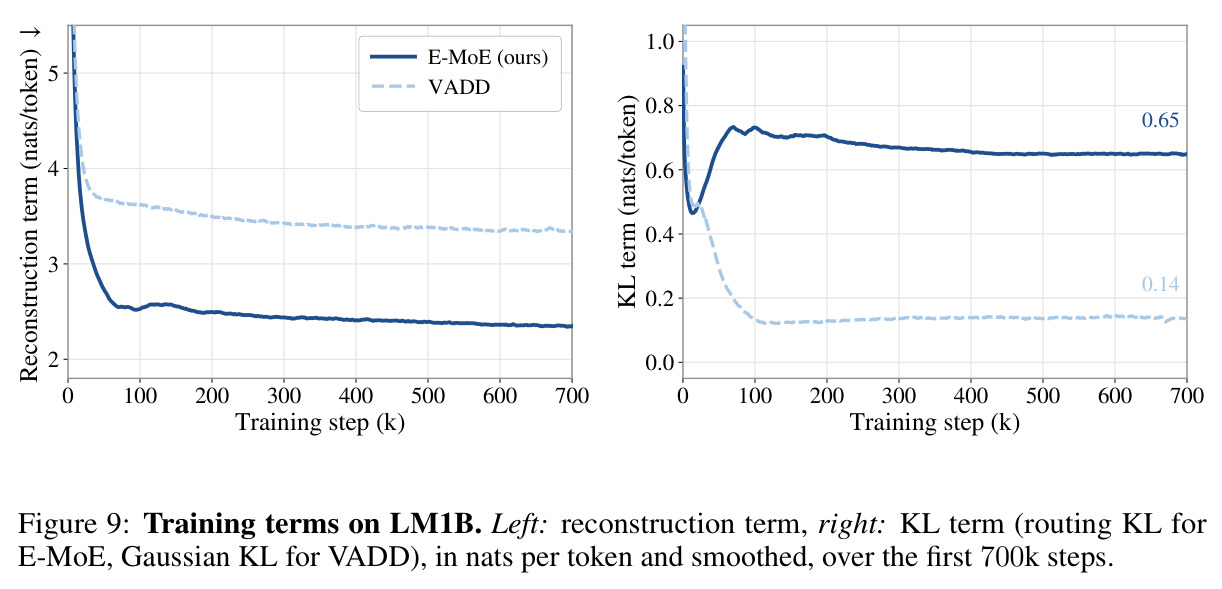
MDM 的反向过程通常在每个去噪步对各位置做因子化:$p_\theta(x^s|x^t)=\prod_\ell p_\theta(x^s_\ell|x^t)$,只预测独立的边缘分布。同一时刻揭示的多个 token 因此被当作条件独立采样,无法表达彼此相关性,且一次揭示越多误差越大——恰好落在扩散模型相对自回归最有速度优势的少步区间。后果非常具体:LM1B 上 MDLM 在 NFE=1 的生成困惑度高达 1433.8(自回归 128 步为 67.97);二维 8-modes 数据上 NFE=1 的 validity 仅 37.7%,样本糊成网格状伪模式;MNIST 上 NFE≤2 时只生成无结构噪点。已有补救 VADD 引入连续高斯隐变量加 VAE 识别网络,但固定高斯先验表达能力受限,KL 需线性退火防后验坍缩(实测其 KL 仍跌至约 0.14 nats/token,隐变量近乎被忽略),且需要额外识别网络(总参数 256.5M 对稠密基线 139.3M)和每步两次训练前向。
本文的目标是本文目标是构造一个非因子化的反向过程:把它写成共享潜变量下因子化分布的混合 $p_\theta(x^s|x^t)=\sum_z p_\theta(z|x^t)p_\theta(x^s|x^t,z)$,对 $z$ 求和后整体不再可分解,从而让同一步揭示的 token 相互耦合。同时对工程代价提出严格约束:(1) 不引入任何额外识别网络、不增加每 token 激活参数;(2) 先验 $p_\theta(z|x^t)$ 不固定为高斯,而是从数据学得的信息性分布;(3) 每个采样步仍只需 1 次前向(1 NFE);(4) 不依赖 KL 退火等防坍缩技巧,潜变量在整个训练期保持被使用。最终在少步区间同时显著优于因子化 MDLM 和连续潜变量的 VADD。
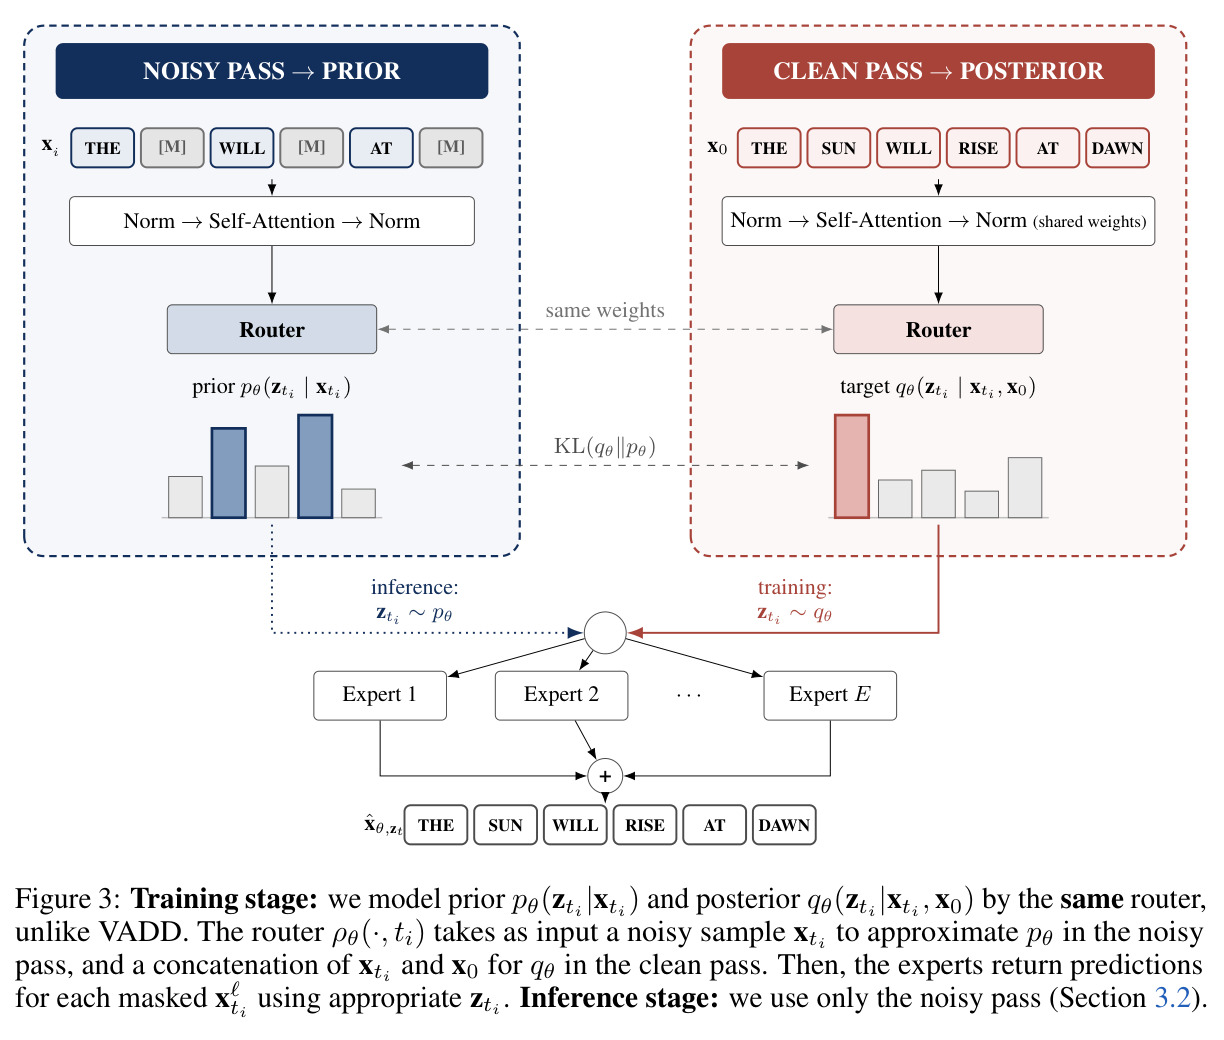
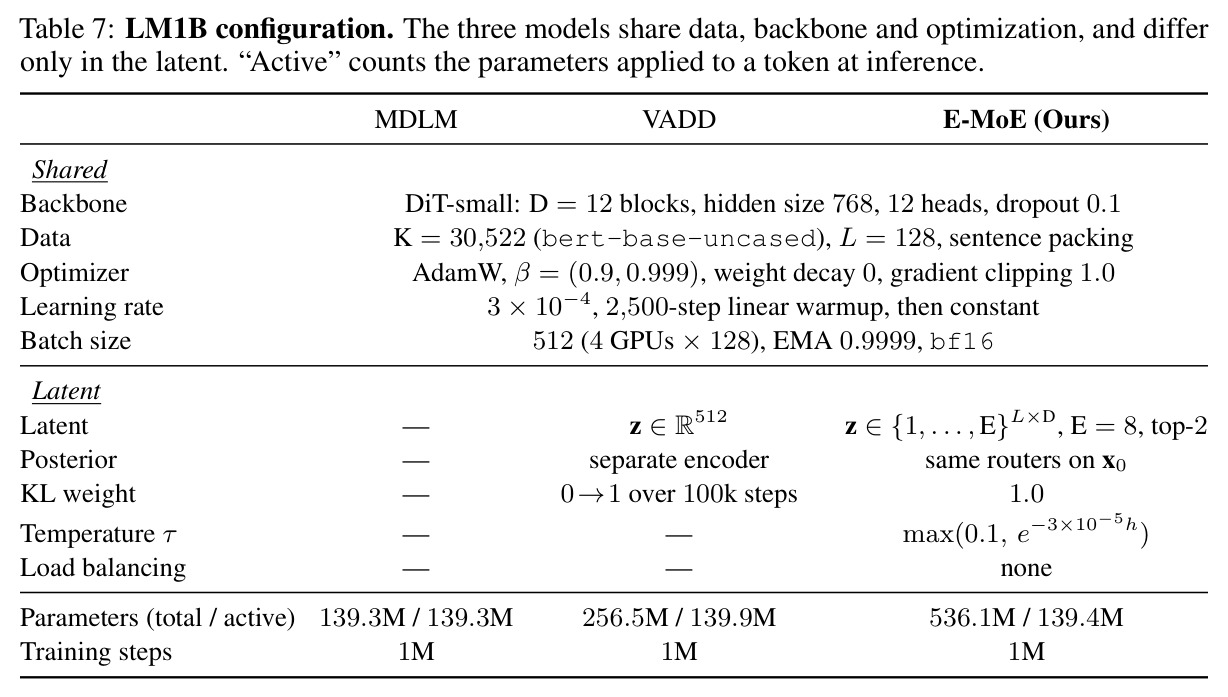
与已有工作不同的是,本文的独特切入点在于『潜变量早已存在于模型之中』。作者注意到 MoE 主干(如已用于扩缩 MDM 的 LLaDA-MoE 一类架构)本来就要为每个 token、每一层计算路由决策,这些离散的专家指派天然构成逐 token、逐层的共享潜码 $z\in\{1,\dots,E\}^{L\times D}$。E-MoE 把同一路由器用两次:输入带噪序列 $x^t$ 得到生成先验 $p_\theta(z|x^t)$,输入干净序列 $x_0$ 得到变分后验 $q_\theta(z|x^t,x_0)$,二者共享全部参数。与 VADD 的本质区别是:无需固定高斯先验、无需额外识别网络、无需 KL 退火,训练只多一次前向,推理零额外开销,且先验是以 $x^t$ 为条件、从数据中学出来的。
核心方法
直觉上,因子化的病根是同一去噪步内 token 条件独立,那就给每一步注入一个共享的『协调信号』:让所有位置在同一个离散决定下各自做因子化预测,再对所有可能的决定求和,联合分布便不再可分解。技术上,E-MoE 把 $D$ 层、$E$ 专家的 MoE 主干中每个 token 每层的专家指派 $z^d_\ell$ 收集为潜码 $z=\{z^d\}_{d=1}^D$,把反向过程参数化为 $p_\theta(x^{t_{i-1}}|x^{t_i})=\sum_z p_\theta(z|x^{t_i})\prod_\ell q(x^s_\ell|x^t_\ell,x^\theta_\ell)$,其中被选中的专家输出对干净 token 的估计 $x^\theta$(估计时注意力仍覆盖整个带噪序列)。训练目标是为此混合反向过程推导的 ELBO(命题 3.1);推理时只从先验采一次 $z$,且与 token 预测在同一次前向中完成,一步去噪仍只花 1 NFE。
核心创新是『同一路由器,双重角色』:MoE 路由器在带噪序列上评估即为生成先验 $p_\theta(z|x^t)$,在干净序列上评估即为训练期变分后验 $q_\theta(z|x^t,x_0)$,二者共享参数。由此带来三点本质区别:其一,VADD 需要单独的识别网络学高斯后验,E-MoE 零新增网络、零新增激活参数(LM1B 上总参 536.1M 但每 token 激活仅 139.4M,对齐 MDLM 的 139.3M);其二,先验以 $x^t$ 为条件从数据学习,而非固定 $\mathcal N(0,I)$,信息量更大;其三,因先验/后验共享同一逐层逐 token 因子化,隐变量 KL 严格化简为路由匹配项 $\mathrm{KL}_{\mathrm{route}}=\sum_{d,\ell}\mathrm{KL}(\mathrm{Cat}(\rho^{\ell,d}_\theta(x^t,x_0,t_i))\,\|\,\mathrm{Cat}(\rho^{\ell,d}_\theta(x^t,t_i)))$,直接拉近干净路由与带噪路由,无需 warmup。对路由 $z$ 边缘化使同一步内各 token 耦合,从结构上消解秩一近似。
方法步骤详情
训练(算法 1):每步采样数据 $x_0$ 与扩散步 $i\sim\mathrm{Unif}\{1,\dots,T\}$,按前向核 $q(x^{t_i}|x_0)$ 加噪。第一次前向(后验通道):把 $x_0$ 喂给共享路由器得到后验路由 $\rho^{\ell,d}_\theta(x^{t_i},x_0,t_i)$,用温度 $\tau$ 下的 top-2 Gumbel-Softmax 直通估计采出路由 $z$,被选专家输出干净 token 估计,计算重构项 $-\frac{1}{t_i}\sum_{\ell\in\mathcal M(x^t)}\log p_\theta(x^0_\ell|x^{t_i}_\ell,z)$。第二次前向(先验通道):仅用 $x^{t_i}$ 得先验路由,与后验路由做逐层逐 token 的类别 KL。总损失 $\mathcal{L}_{\text{E-MoE}}$ 即重构项加 $T\cdot\mathrm{KL}_{\mathrm{route}}$。采样(算法 2):从全掩码序列出发,每步在同一次前向内先验采样 $z\sim p_\theta(\cdot|x^t)$,专家给出各位置分布并采出 $x^{t_{i-1}}$,1 NFE 完成一步。
技术新颖性
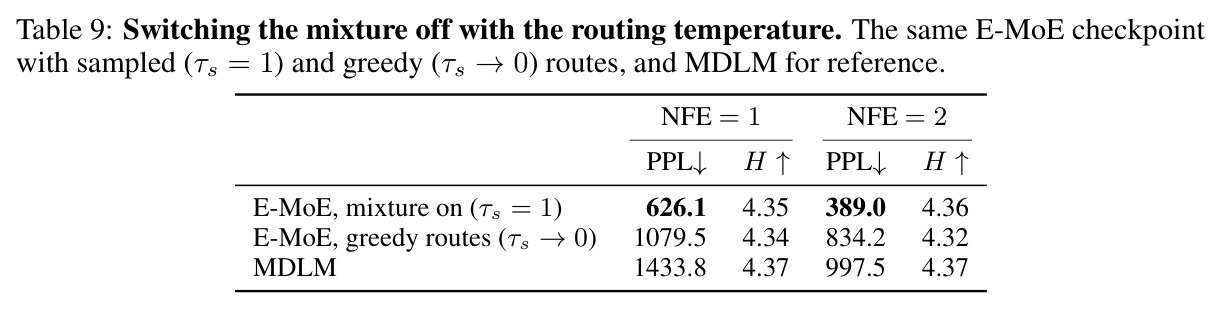
新颖性可从四个层面评估。问题层面:不同于需要预训练教师的蒸馏路线(SDTT、DiMO、IDLM 等),E-MoE 让模型从零训练时就原生表达相关去噪;与同题的 DCD(copula)和 CoDD(可导相关层)相比几乎无计算开销。参数化层面:首个把 MoE 路由决策重释为扩散反向过程离散共享潜变量的工作,属于『结构复用』而非『结构附加』,先验还是可学习的、依赖数据的。理论层面:为混合型反向过程推导了可计算的负对数似然上界(命题 3.1),并证明因先验与后验共享同一逐层逐 token 因子化(式 7),隐变量 KL 精确等于路由器输出之间的类别 KL 之和,无需任何近似采样。实证层面:消融(表 9)显示仅把采样路由从随机($\tau_s=1$)换成贪心($\tau_s\to0$,混合坍缩为单专家),同一权重的 NFE=2 Gen-PPL 就从 389.0 恶化到 834.2,证明收益确实来自混合结构而非参数量。
实验结果
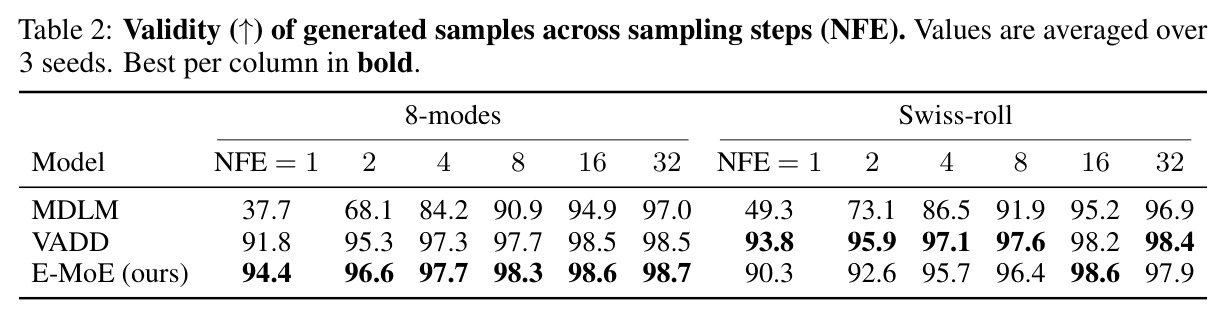
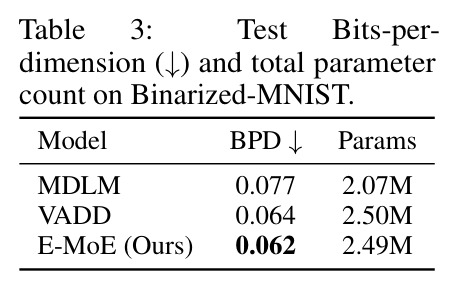
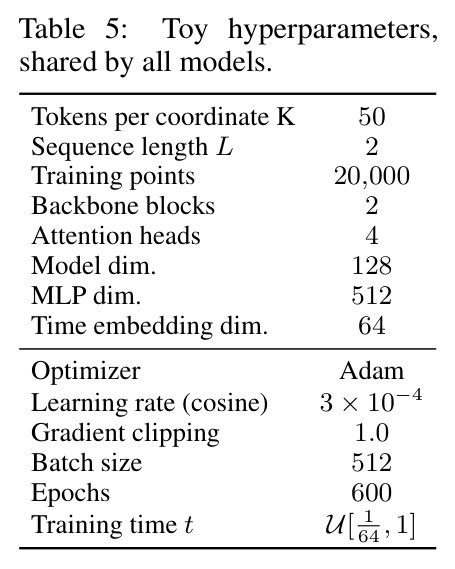
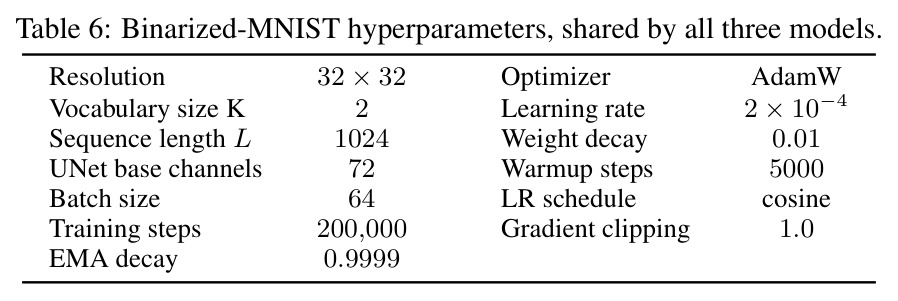
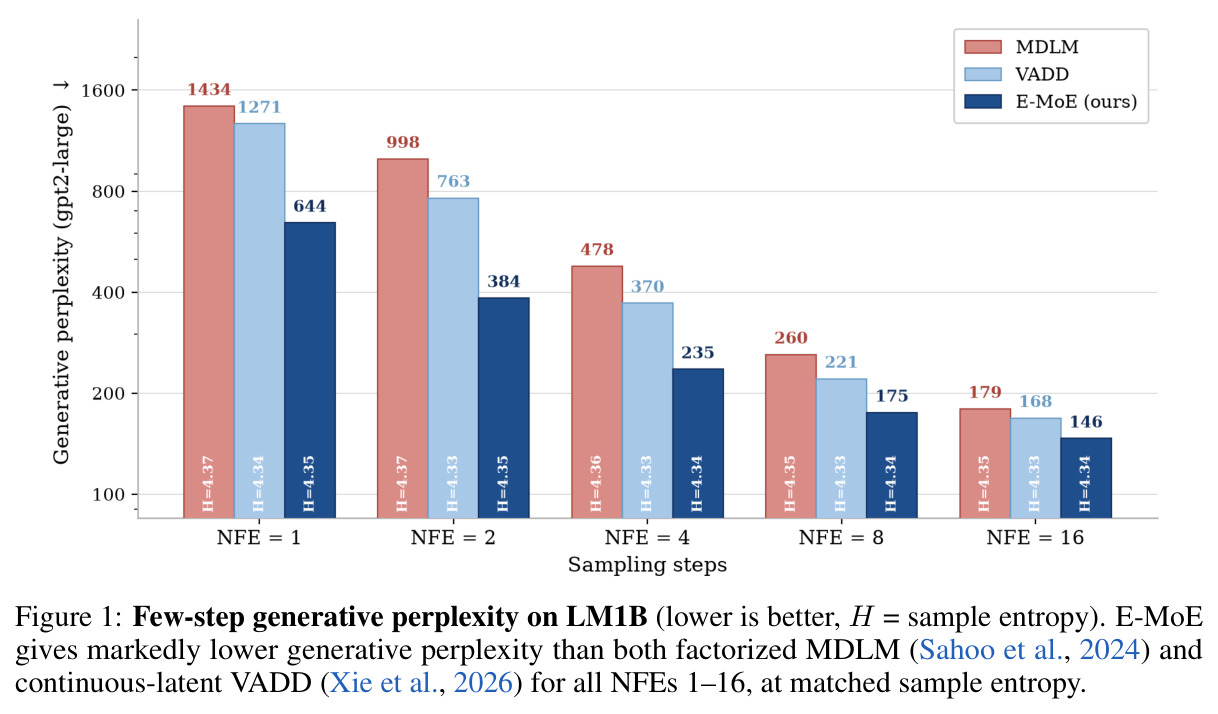
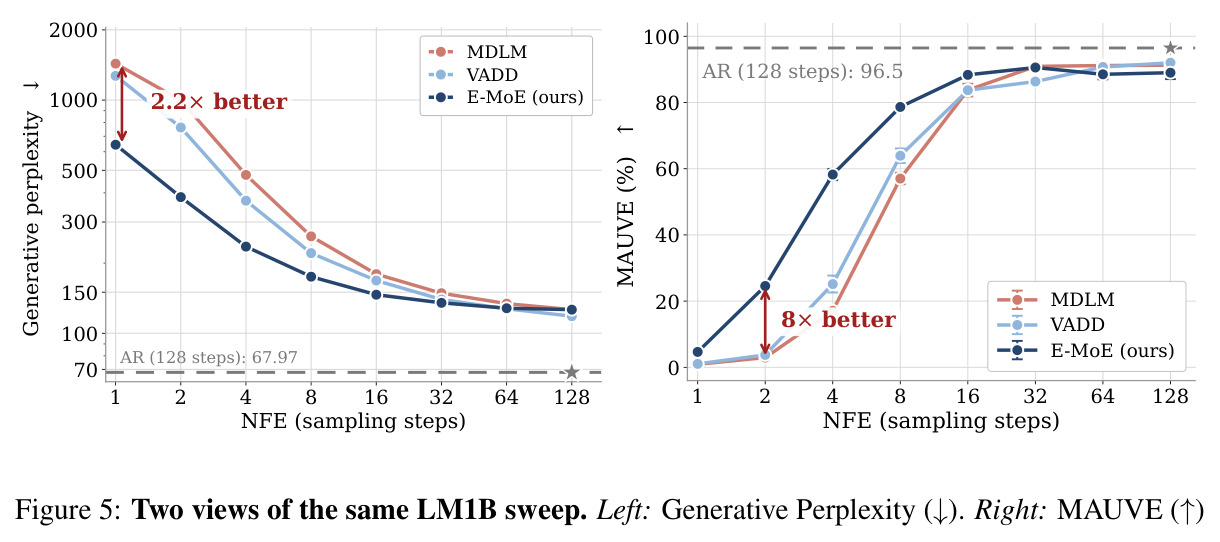
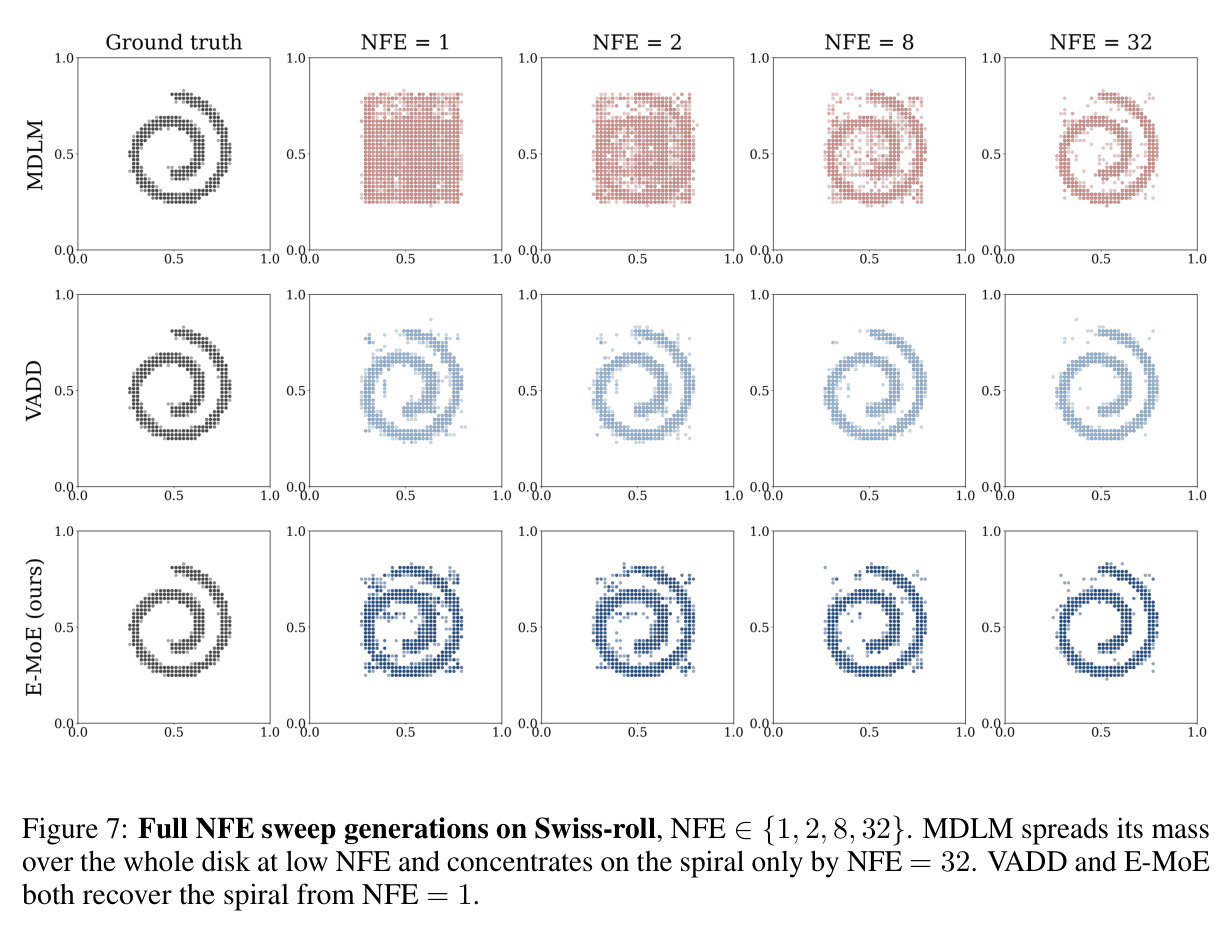
实验覆盖三个尺度。二维玩具(8-modes/swiss-roll,NFE=1 validity):MDLM 仅 37.7%/49.3%,VADD 91.8%/93.8%,E-MoE 94.4%/90.3%,少步下共享离散潜变量基本消除伪模式。Binarized-MNIST($L=1024$):E-MoE 取得最佳 BPD 0.062,优于 VADD 0.064 与 MDLM 0.077,参数 2.49M(激活 2.18M)与 VADD 相当,一步即生成可辨识数字。LM1B 文本(激活参数对齐 139.4M vs 139.3M,各见 65B token):NFE=1 时 Gen-PPL 643.8,比 MDLM 1433.8、SEDD 1578.8、VADD 1270.8 低约 2–2.6 倍,NFE=2 同样(383.7),样本熵匹配(4.34–4.35 对数据 4.32);MAUVE 在 NFE=2 达 24.6%,约为 MDLM 3.0%、VADD 3.8% 的 6.5–8.3 倍,NFE=4 时 58.3% 仍大幅领先;NFE 增大后优势按预期收缩,128 步时 126.3 对 VADD 118.4。两组消融很关键:贪心路由使 NFE=1 的 PPL 从 626.1 升到 1079.5(1.72×),证明收益来自混合;E-MoE 路由 KL 稳定在约 0.65 nats/token 而 VADD 坍缩至约 0.14,且重构项更低,说明离散潜变量无需 warmup 也全程保持使用。
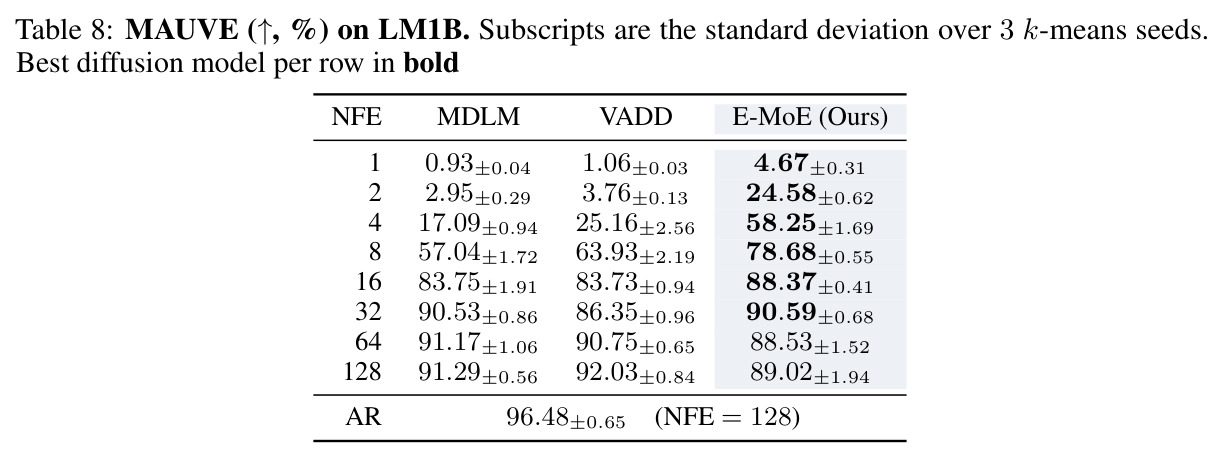
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LM1B 无条件文本生成(NFE=1) | Gen-PPL(GPT-2-large 判分,越低越好) | 643.8(H=4.35) | MDLM 1433.8 / SEDD 1578.8 / VADD 1270.8 | 较最强基线 VADD 降低约 2.0×,较 MDLM 约 2.2×,熵匹配 |
| LM1B 无条件文本生成(NFE=2) | MAUVE(%,越高越好) | 24.58±0.62 | MDLM 2.95±0.29 / VADD 3.76±0.13 | 约 6.5–8.3 倍;同期 Gen-PPL 383.7 亦为基线的 1/2 至 1/2.6 |
| LM1B 无条件文本生成(NFE=8) | Gen-PPL | 174.9 | MDLM 260.5 / SEDD 243.4 / VADD 220.7 / BD3-LM 1130.6 | 较 VADD 低约 21%,较 MDLM 低约 33% |
| Binarized-MNIST 像素级图像生成 | BPD(bits/dim,越低越好) | 0.062(2.49M 参数,激活 2.18M) | VADD 0.064(2.50M)/ MDLM 0.077(2.07M) | 较 VADD 再降约 3%,较 MDLM 降约 19% |
| 二维 8-modes 少步生成(NFE=1) | Validity(样本落在数据支撑上的比例,%) | 94.4 | MDLM 37.7 / VADD 91.8 | 较 MDLM 提升 56.7 个百分点,且优于 VADD |
| 混合结构消融(LM1B,同一检查点权重) | Gen-PPL(NFE=2) | 389.0($\tau_s=1$,混合开启) | 同权重贪心路由 834.2($\tau_s\to0$)/ MDLM 997.5 | 混合开启带来 2.14× 提升,证明收益源于混合而非参数量 |
局限与改进
作者承认两点局限:其一,方法优势集中在低 NFE 区间,去噪步数增多后每步揭示的 token 变少,因子化近似自然变准,收益随之收缩(NFE=128 时 E-MoE 126.3 反而略逊 VADD 的 118.4,MAUVE 89.0 对 92.0);其二,方法依赖『带噪路由能恢复干净路由』的对齐假设,若路由器无法从 $x^t$ 恢复 $x_0$ 的路由决策,或路由分布坍缩,混合退化为单个因子化分量,增益消失。我补充观察:文本实验只用 139M 激活参数的 DiT-small 和 LM1B 新闻语料,未验证 LLaDA 级模型与指令/对话场景;绝对质量仍远逊自回归(NFE=1 的 643.8 对 67.97);训练每步需两次前向,成本约为稠密基线两倍;实现协议不一致——文本设定 KL 权重固定 1.0、无 warmup、无负载均衡,MNIST 设定却需要 0→1 退火加 $10^{-2}$ 的 Switch 负载均衡,暗示超参敏感性未被系统研究;此外 swiss-roll 上 NFE=1–8 时 E-MoE 的 validity 略低于 VADD,说明离散路由并非所有场景都占优。
独立分析的弱点
弱点一:扩展性未验证。文本实验停留在 139M 激活参数与 1B 词新闻语料,NFE=1 的 Gen-PPL 643.8 距实用仍远;改进方向是在 LLaDA/LLaDA-MoE 规模与指令数据上复验,并研究路由 KL 与模型容量的缩放律。弱点二:训练开销翻倍。每步需后验、先验两次前向,训练成本约为 MDLM 的 2 倍;可探索用 EMA 权重或 stop-gradient 在单次前向内近似后验。弱点三:协议不一致——文本与 MNIST 的 KL 退火、负载均衡、温度调度均不同(如 $\tau_h=\max(0.1,e^{-3\times10^{-5}h})$ 对 $\max(0.5,e^{-2\times10^{-5}h})$),方法对超参并非即插即用;改进方向是给出 $\mathrm{KL}_{route}$ 自动调节或路由熵正则的原则性方案。弱点四:理论假设与实现有落差。后验按层间条件依赖 $q_\theta(z^d_\ell|z^{<d}_\ell,x^t)$ 建模,但实现中各层路由独立计算,层间相关性未被显式利用;梯度只经 top-2 软权重流动,可研究更深或层次化的路由结构。弱点五:高 NFE 区间 MAUVE 被反超(89.0 对 92.0),提示路由采样噪声在步数多时是纯害处,可按 NFE 调度采样温度或在高步数退化为确定性路由。
未来方向
作者方向:把 E-MoE 思想移植到 LLaDA 与 LLaDA-MoE 等已部署的 MoE 扩散语言模型——这些模型的路由决策天然存在,只需改训练目标即可协调多 token 预测,若可扩展将改善扩散 LLM 的质量-速度权衡,让更少去噪步数下保持连贯。可延伸方向:(1) 与一致性/自蒸馏(DUO、DiMO、IDLM)叠加,『结构去因子化』与『轨迹压缩』正交,有望冲一步生成的实用质量;(2) 分析先验 $p_\theta(z|x^t)$ 学到的路由模式是否对应主题、句法角色等语义结构,做可解释性研究并据此设计更强先验;(3) 在条件生成与 infilling 任务上量化收益,因为填空场景单步揭示的 token 最多,因子化误差最大;(4) 从信息论角度把路由 KL 与 ReDi 的条件总相关联系起来,给出因子化误差更紧的理论刻画;(5) 研究 $E>8$ 的大规模多专家下路由对齐与负载均衡的相互作用,以及在批内专家坍缩时的恢复机制。
复现评估
复现条件良好。代码随补充材料提供;文本实验基于公开的 DUO 代码库(github.com/s-sahoo/duo)分叉,MNIST 主干用公开的 VDM PyTorch 实现;附录 B 逐项给出数据、超参(学习率 3e-4、全局 batch 512、EMA 0.9999、温度与 KL 权重调度)和评估协议(2000 样本、fp32 网络 + fp64 类别采样、MAUVE 报 3 个 k-means 种子均值±标准差)。算力需求温和:LM1B 为 4 张 GPU(每卡 batch 128)训练 1M 步共 65B token,bf16 混合精度;MNIST 200k 步单卡可及;玩具实验分钟级。作者还自证了管线正确性:复现出 MDLM 测试困惑度 31.90(官方 31.87)与 AR 22.83(官方 22.8)。风险点:结果依赖若干未系统消融的细节(top-2 直通、路由 logit 的 LayerNorm 加 $5\tanh(\cdot/5)$ 截断),且 Gumbel 采样对数值精度敏感,低精度复现可能引入偏差。总体难度中等,具备常规多卡条件的团队可复现。
论文图表
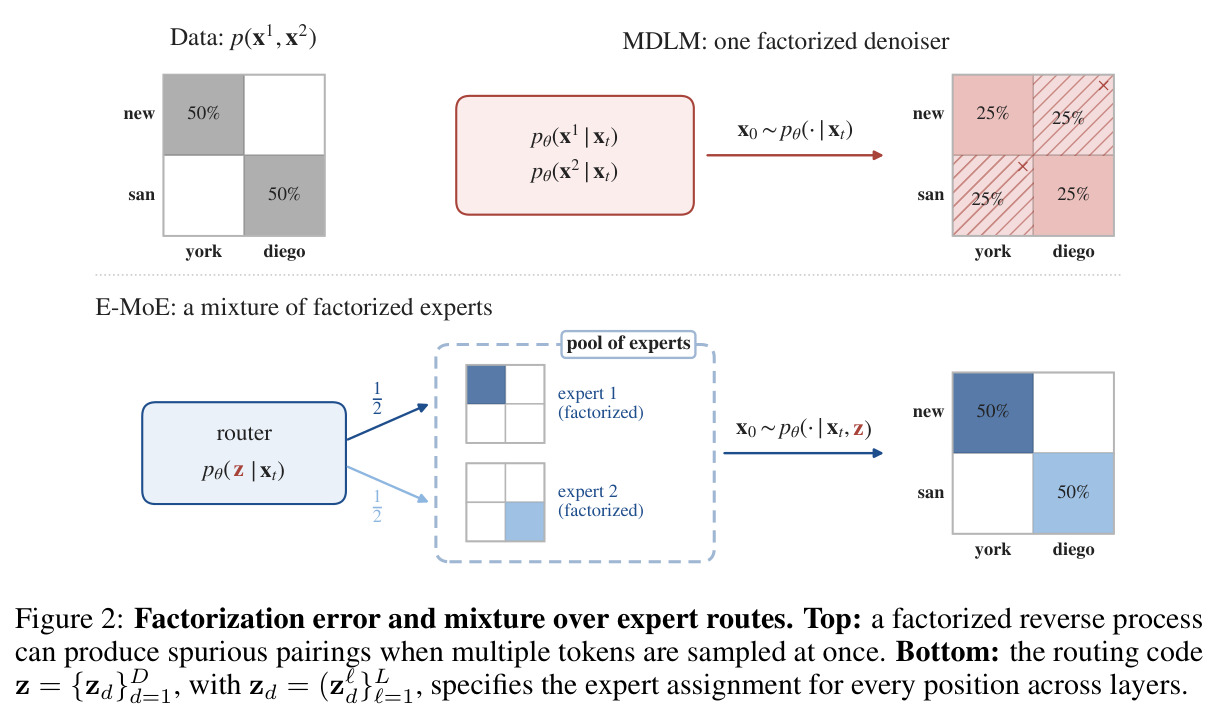
示意因子化误差:数据联合分布 $p(x_1,x_2)$ 中『new york』与『san diego』各占 50%,因子化模型把两个边缘各 50% 独立相乘,产生各 25% 的伪配对『new diego』与『san york』;E-MoE 则由路由器给出潜码 $z=\{z^d\}$(每位置每层的专家指派),选择不同的因子化专家,混合后消除伪配对。
用最小的例子同时讲清问题的根源(秩一近似)与 E-MoE 的解法(路由混合),是理解全文动机的最佳入口。