各向异性表示改进 JEPA 世界模型中的规划 Anisotropic Representations Improve Planning in JEPA World Models
把正则化目标从各向同性换成可学习的各向异性高斯,使潜空间几何对齐任务代价,提升规划成功率。
前置知识
JEPA 与潜空间世界模型
JEPA(Joint-Embedding Predictive Architecture)在学到的表示空间中预测世界如何随动作演化,而不重建像素。视觉目标规划(visual goal planning)流程是:编码器 $f_\theta$ 把当前观测和目标观测编码为潜向量,预测器 $g_\phi$ 在潜空间对候选动作序列 $U$ 自回归 rollout 得到终端预测 $\hat z_H(U)$,用与目标表示的距离给动作打分。
本文的整个论证建立在『编码器不仅提供预测特征,还决定了规划代价的几何』这一事实上,不理解潜空间规划的流程就无法理解为什么正则化会影响规划。
表示坍缩与自监督正则化
联合嵌入类自监督学习若只最小化预测误差,编码器可能把所有输入映射到同一个点(坍缩)。VICReg、Barlow Twins、whitening 等方法通过约束特征二阶统计量(方差、协方差)来防止坍缩。LeJEPA 进一步把特征分布推向各向同性高斯 $\mathcal N(0,I)$。
本文指出:防坍缩的正则化在防止坍缩之外,还悄悄决定了潜空间的距离度量形状,这是以往被忽视的副作用,正是论文的问题来源。
SIGReg(Sketched Isotropic Gaussian Regularization)
LeJEPA 提出的正则项:把特征沿随机方向投影,用经验特征函数与高斯特征函数的加权平方距离(Epps–Pulley 型统计量)衡量特征分布偏离各向同性高斯的程度。LeWM(Maes et al., 2026)把它与预测损失联合训练,得到从像素端到端训练的 JEPA 世界模型。
AnisoWM 是对 SIGReg 的最小改动:只在统计量计算前把特征按可学习的对角协方差 $\Lambda^{-1/2}$ 标准化,其余(预测目标、预测器、规划器)全部不变。
度量矩阵与逆协方差加权
正定矩阵 $M\succ 0$ 通过二次型 $(x-x_g)^\top M(x-x_g)$ 定义状态空间中的距离加权。线性编码器 $A$ 下潜空间欧氏距离诱导 $M=A^\top A$;若编码特征的协方差各向同性($A\Sigma A^\top=sI$),则 $M=s\Sigma^{-1}$——训练数据中方差小的方向被赋予更大权重,这本质上是一种马氏距离。
这是全文最核心的机制:各向同性正则 $\Rightarrow$ 逆协方差度量 $\Rightarrow$ 误差加权方式与任务代价不一致 $\Rightarrow$ 规划选错动作。看懂这一条推导就看懂了半篇论文。
CEM(交叉熵方法)规划
一种零阶优化方法:每轮采样一批候选动作序列(本文 300 条),按代价选出精英集合(30 条),在精英分布上重采样,迭代若干次(30 轮)逼近最优序列。世界模型常用它在潜空间做模型预测控制式的规划。
CEM 只依赖代价的排序而非绝对值,因此『潜代价对候选结局的排序是否与真实任务代价一致』是规划成败的关键,也是论文排序诊断实验(Table 1)的设计依据。
规划遗憾(planning regret)
$\mathrm{Regret}_{\eta,H}(U)=J_{*,\eta,H}(U)-\min_V J_{*,\eta,H}(V)$,即某动作序列的期望终端任务代价超出最优可行序列的部分。论文的分离定理证明:即使预测损失和固定视野 rollout 误差都趋于零,各向同性正则训练出的潜规划器的遗憾仍收敛到一个严格正的常数 $\Delta_H$。
『预测好 ≠ 规划好』是论文的中心论点,遗憾这个量把两者严格区分开:预测误差衡量表示-预测器拟合,遗憾衡量几何错位导致的决策损失。
研究动机
JEPA 类潜世界模型(如 LeWM)从像素联合训练编码器 $f_\theta$ 与动作条件预测器 $g_\phi$,规划时在潜空间 rollout 候选动作并以欧氏距离 $J_z(U)=\|\hat z_H(U)-z_g\|^2$ 打分。这意味着编码器同时决定了规划代价的几何——不同方向上的终端误差如何加权。然而 LeWM 用 SIGReg 把表示正则成各向同性高斯以防坍缩,其动机来自线性/非线性探测下的下游表示质量理论,而非『欧氏潜距离是否适合规划』。作者在线性高斯设定中证明:随过程噪声 $\eta\to 0$,联合预测–SIGReg 目标选出近似白化的表示,潜空间欧氏距离在状态空间诱导逆协方差度量 $q\Sigma^{-1}$——训练分布中方差小的方向被放大权重。即便预测是精确条件均值、表示不坍缩,潜规划器选出的动作也与任务代价最优动作不同,产生严格正的有限视野规划遗憾。非线性 MLP 玩具实验中,过程噪声缩小 30 倍后预测误差大幅下降,归一化物理规划遗憾却几乎不变地停在约 0.16(理论参考值 0.1607),且学到的局部度量确实接近 $\Sigma^{-1}$。这是一个结构性缺陷,不是训练不充分。
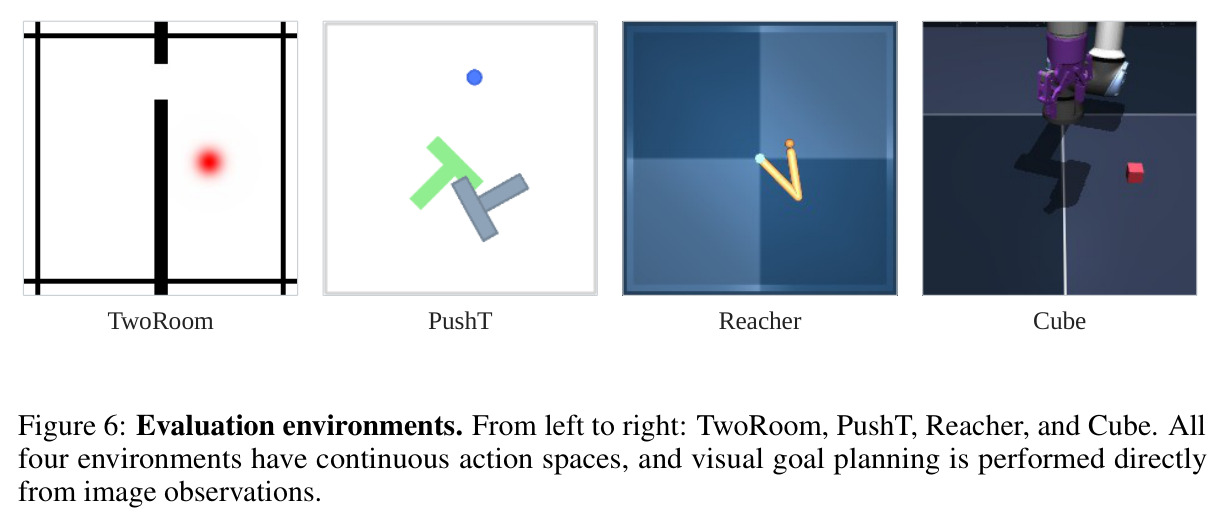
本文的目标是本文的目标是:在不改变预测目标、预测器结构和欧氏规划器的前提下,修复潜空间几何与任务代价的错位。具体做法是把 SIGReg 固定的各向同性高斯目标 $\mathcal N(0,I)$ 替换为可学习的对角高斯目标 $\mathcal N(0,\Lambda)$,让『总方差如何在各潜坐标间分配』由预测训练内生地学出来,并用条件数上限 $\kappa$ 约束各向异性程度以防退化。理论层面要刻画:(1) 可学习目标如何改变联合训练选出的状态空间度量;(2) 什么条件下诱导度量能与任务度量 $Q$ 成比例;(3) 何时能把有限视野规划遗憾降到零。实证层面要在四个视觉控制环境(TwoRoom、Reacher、PushT、OGBench-Cube)中验证规划成功率与潜代价–任务结果一致性同时提升。
与已有工作不同的是,已有工作从别的环节入手修规划几何:Fast-LeWM 改预测结构以降低 rollout 误差,RC-aux 加多视野预测与可达性监督,SCALE 用任务相关状态空间校准 LeWM 距离,TRM 学视野感知的可达性度量替换终端代价,DMA 引入潜–结局排序诊断与动作条件目标;表示正则一侧,LeJEPA 的各向同性目标源于探测风险准则,HamJEPA 研究由指定结构化几何导出的各向异性高斯,TC-LeWM 改变 SIGReg 正则化的特征子集。本文的独特切入点是指出『正则化目标本身』就是规划几何的第一决定因素:在欧氏规划器下,高斯目标的协方差形状直接决定终端误差在状态空间的加权(Lemma 1),因此只需把目标从 $I$ 松弛为受约束的可学习 $\Lambda$,整条流水线原封不动。理论链条完整:从各向同性协方差诱导 $s\Sigma^{-1}$ 度量(Lemma 1),到联合训练确实选出该度量(Proposition 1),到有限视野正遗憾分离(Theorem 1),再到可学习目标的补偿条件(Proposition 2 与定理 4)。
核心方法
直觉上,规划只关心候选结局的排序,而排序由潜空间欧氏距离决定;线性编码器下 $\|A\Delta x\|^2=\Delta x^\top A^\top A\,\Delta x$,所以编码器线性部分 $A$ 定义了状态空间度量 $M=A^\top A$。各向同性正则强迫 $A\Sigma A^\top=sI$,反解得 $M=s\Sigma^{-1}$:训练分布中方差大的方向权重被压低、方差小的方向被放大,这个加权一般与任务代价 $\Delta x^\top Q\,\Delta x$ 不成比例,于是目标不可达、需要跨方向权衡误差时,两种代价会偏好不同的动作。技术路线是 $\Lambda$Reg:把 SIGReg 的目标协方差从 $I$ 换成对角阵 $\Lambda=\mathrm{diag}(v_1,\dots,v_D)$,约束 $\mathrm{tr}\,\Lambda=D$(固定总尺度,不影响排序)且 $\mathrm{cond}(\Lambda)\le\kappa$(限制各向异性上限,$\kappa=1$ 退化为各向同性)。正则项写为 $\hat R_{N,\Lambda}(Z;\omega)=\hat R_N(\Lambda^{-1/2}Z;\omega)$——因为 $z\sim\mathcal N(0,\Lambda)$ 蕴含 $\Lambda^{-1/2}z\sim\mathcal N(0,I)$,原 SIGReg 统计量原封可用。标准化只发生在正则器内部,预测与规划仍用原始表示 $z$;$\Lambda$ 与编码器、预测器联合训练,规划时可丢弃。
核心创新是『用正则化目标学习规划几何』:不给规划器加度量(SCALE/TRM 路线),不改预测器(Fast-LeWM 路线),而是让高斯正则的目标形状成为可学习参数。理论上(Proposition 2),可学习目标把联合训练选出的极限度量族从 $q\Sigma^{-1}$ 扩大为 $q\Sigma^{-1/2}L\Sigma^{-1/2}$,其中 $L=O^\top\Lambda O\in\mathcal S_{D,\kappa}$($O$ 来自编码器的朝向自由度);预测项在极限下归结为最小化 $\mathrm{tr}(LR)$,$R=\Sigma^{-1/2}W\Sigma^{-1/2}$ 是白化过程噪声协方差。换言之:$\kappa$ 只约束各向异性预算的总量,预测误差驱动预算在各方向间的分配——方差大、噪声大的方向该分多少目标方差由任务动力学说了算。当允许 $\kappa=\mathrm{cond}(\Sigma)$ 时,构造中唯一选出 $L\to\Sigma$,从而 $A^\top A\to qI$,潜距离与欧氏任务代价 $Q=I$ 对齐,遗憾 $\to 0$;而同一构造下各向同性目标规划器保持正极限遗憾(式 (6)),两者预测损失与 rollout 误差同样趋于零。与 LeJEPA 的本质区别在于:各向同性目标由探测风险准则外生给定,与规划任务无关;这里的目标形状由规划任务的预测需求内生决定。
方法步骤详情
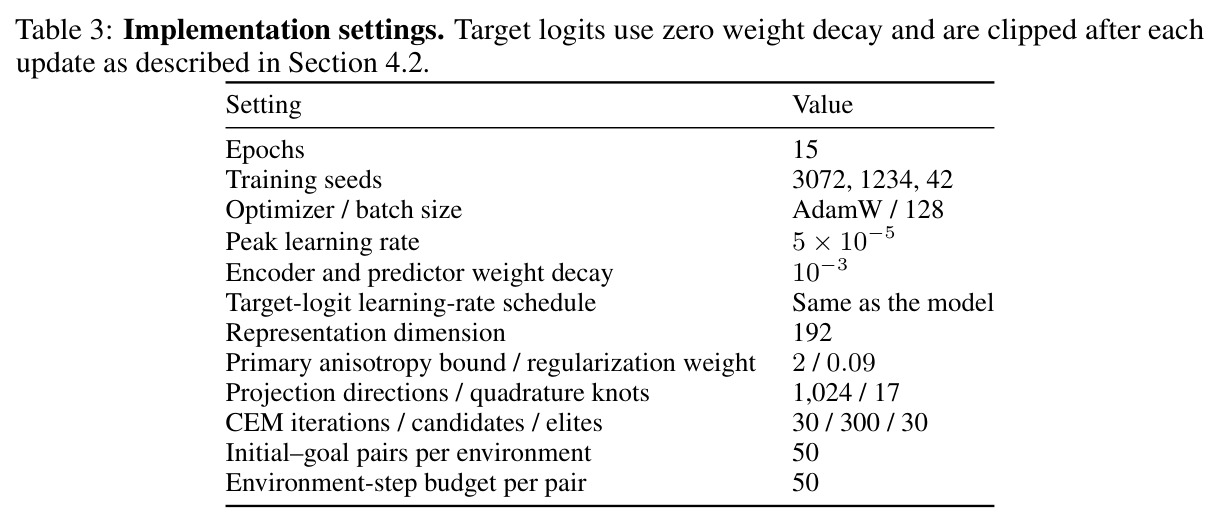
完整流程如下。(1) 模型:随机初始化的 ViT-Tiny 加投影 MLP 输出 192 维表示,因果预测器以三个观测为上下文;训练 clip 含 4 个时间点、每片 batch $N=128$。(2) 目标参数化:$v_i=D\,e^{\alpha_i}/\sum_j e^{\alpha_j}$,logits 限制 $\alpha_i\in[-\tfrac12\log\kappa,\,\tfrac12\log\kappa]$,零初始化(训练从各向同性目标出发),每次优化器更新后裁剪;这自动保证 $\mathrm{tr}\,\Lambda=D$、$\mathrm{cond}(\Lambda)\le\kappa$,且覆盖全部可行集 $\mathcal T_{D,\kappa}$(附录 C.3)。(3) 联合损失:$\hat{\mathcal L}_T=\mathcal L_{\mathrm{pred}}(\theta,\phi;B)+\lambda\hat R_{N,\Lambda}(Z_\theta;\omega)$,$\lambda=0.09$ 沿用 LeWM 调参,1024 个随机投影方向、17 个积分结点($t_k=3k/16$,$k=0..16$);预测损失更新编码器与预测器,$\Lambda$ 只从正则项获得梯度且权重衰减为零。(4) 规划:与 LeWM 完全相同——CEM 在原始潜坐标自回归 rollout 30 轮、每轮 300 候选、30 精英,代价 $J_z(U)=\|\hat z_H(U)-z_g\|^2$;评估用每环境 50 对初始–目标对(目标取同一轨迹 25 步之后),每对 50 步环境预算。(5) 训练:15 epochs,AdamW,batch 128,峰值学习率 $5\times10^{-5}$,编码器/预测器权重衰减 $10^{-3}$,主比较每环境 3 个种子(3072/1234/42),统一 $\kappa=2$。
技术新颖性
新颖性有四层。(1) 概念层:首次明确把『防坍缩正则的目标形状』与『规划代价几何』绑定为同一件事——Lemma 1 证明各向同性特征协方差诱导 $s\Sigma^{-1}$ 度量,Proposition 1 证明联合预测–SIGReg 训练在任意维度都会选出它(即使允许奇异编码器、最优预测器精确恢复编码条件均值),Theorem 1 进一步在任意 $D\ge2$、任意有限视野 $H$、任意非标量 $\Sigma$ 上构造出严格正遗憾 $\Delta_H$ 的分离实例,机制是可达终端均值构成欧氏球、球外目标下欧氏投影与 $\Sigma^{-1}$ 加权投影不同。(2) 方法层:$\Lambda$Reg 只把目标从常数变为受三个约束(对角、迹固定、条件数上限)的可学习参数,实现上只需在统计量前乘 $\Lambda^{-1/2}$,Algorithm 1 约 20 行代码含 DDP 支持,改动量极小且 $\kappa=1$ 精确退化为 LeWM。(3) 理论层:给出预测驱动的谱选择规则 $\min_{L\in\mathcal S_{D,\kappa}}\mathrm{tr}(LR)$、任务对齐的充分条件 $L_Q=D\,\Sigma^{1/2}Q\Sigma^{1/2}/\mathrm{tr}(\Sigma Q)\in\mathcal S_{D,\kappa}$,以及 $\kappa=\mathrm{cond}(\Sigma)$ 时遗憾完全补偿的显式构造。(4) 实证层:用同序列排序诊断($J_{enc}/J_{pred}$ 分解)和局部代价几何可视化(Spearman $\rho$)把表示几何改善与成功率提升因果地联系起来,而非只报端到端数字。
实验结果
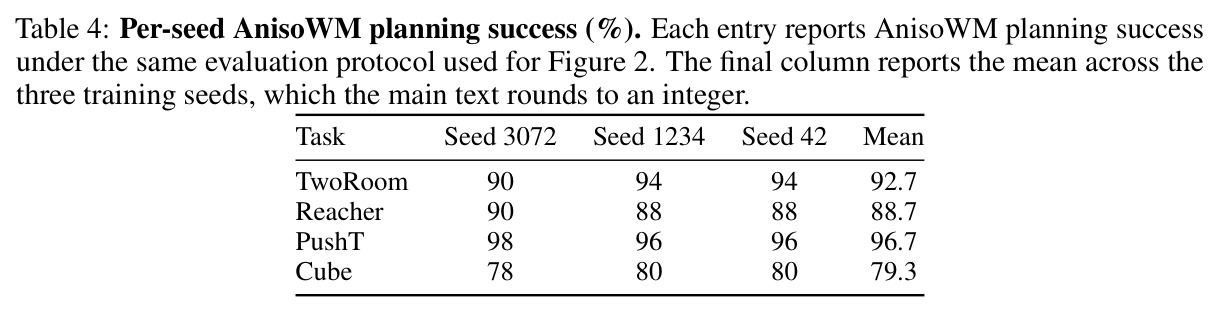
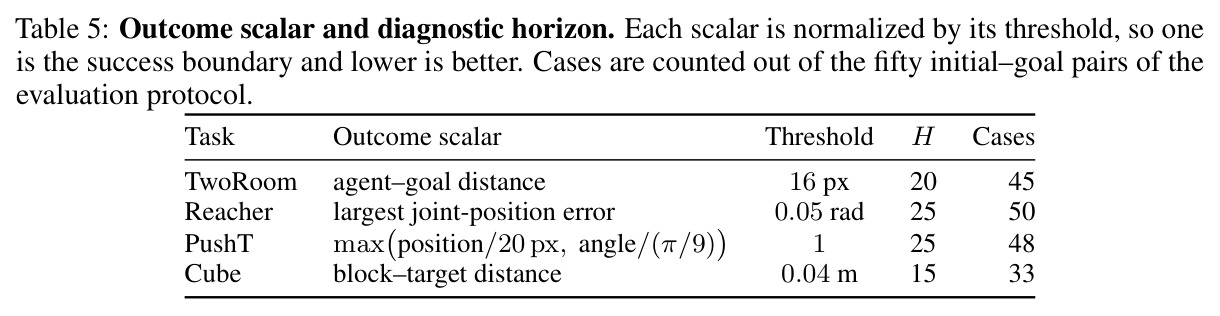
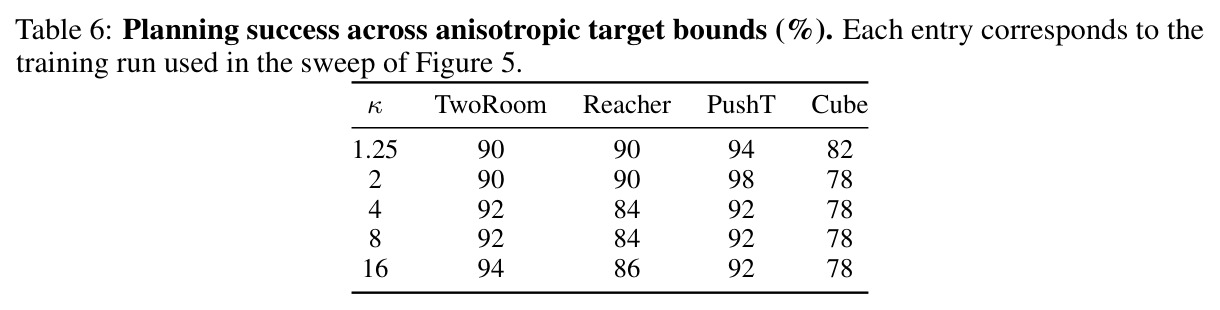
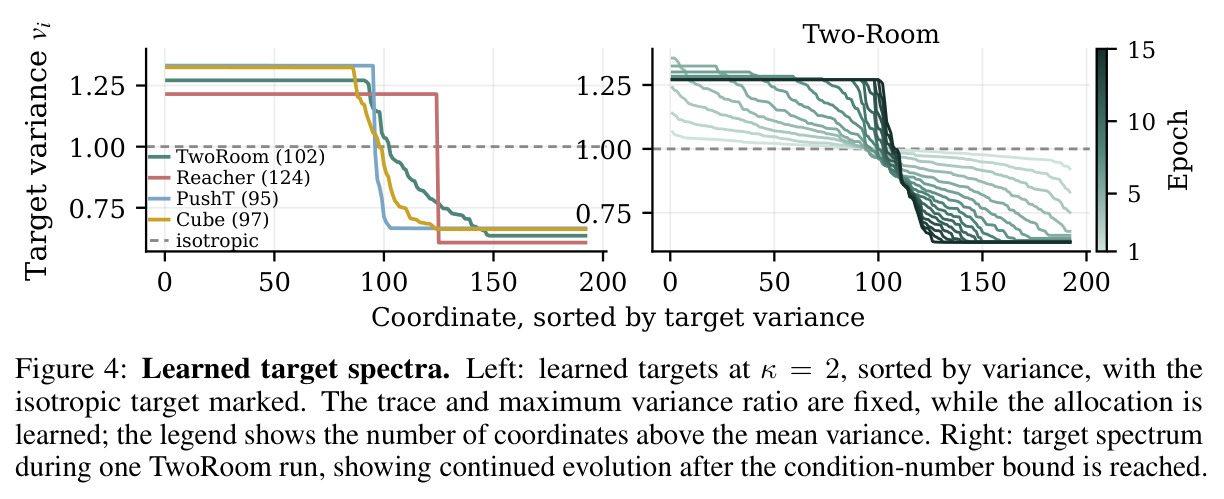
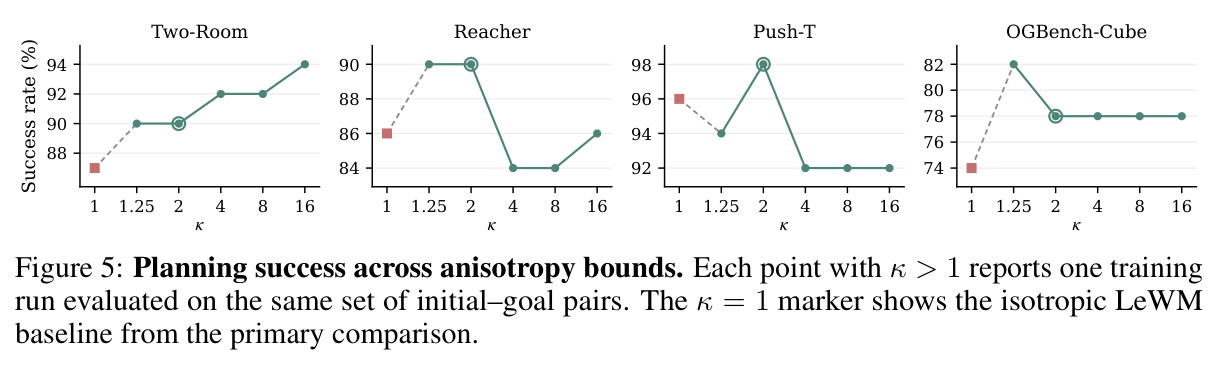
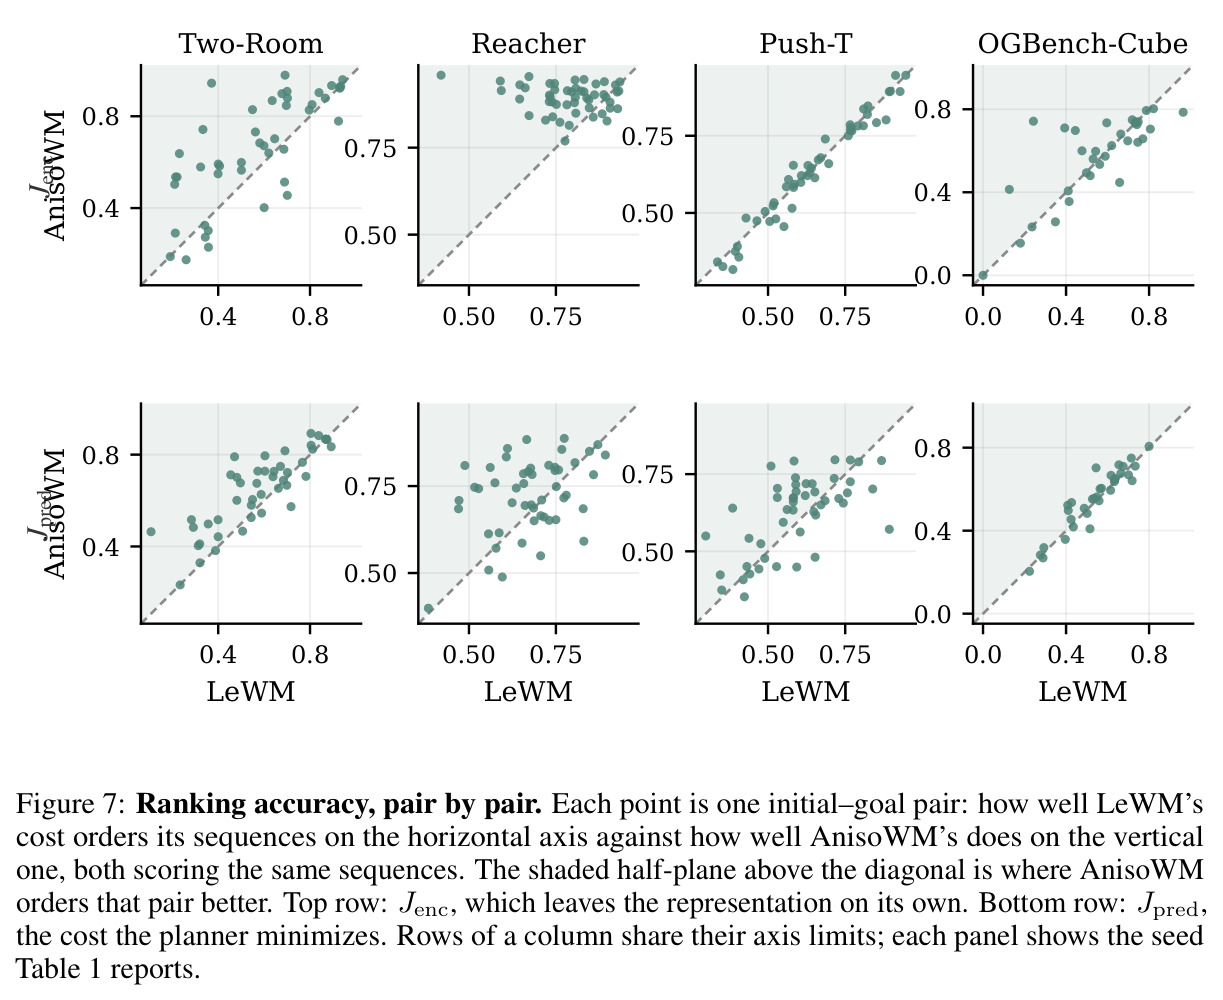
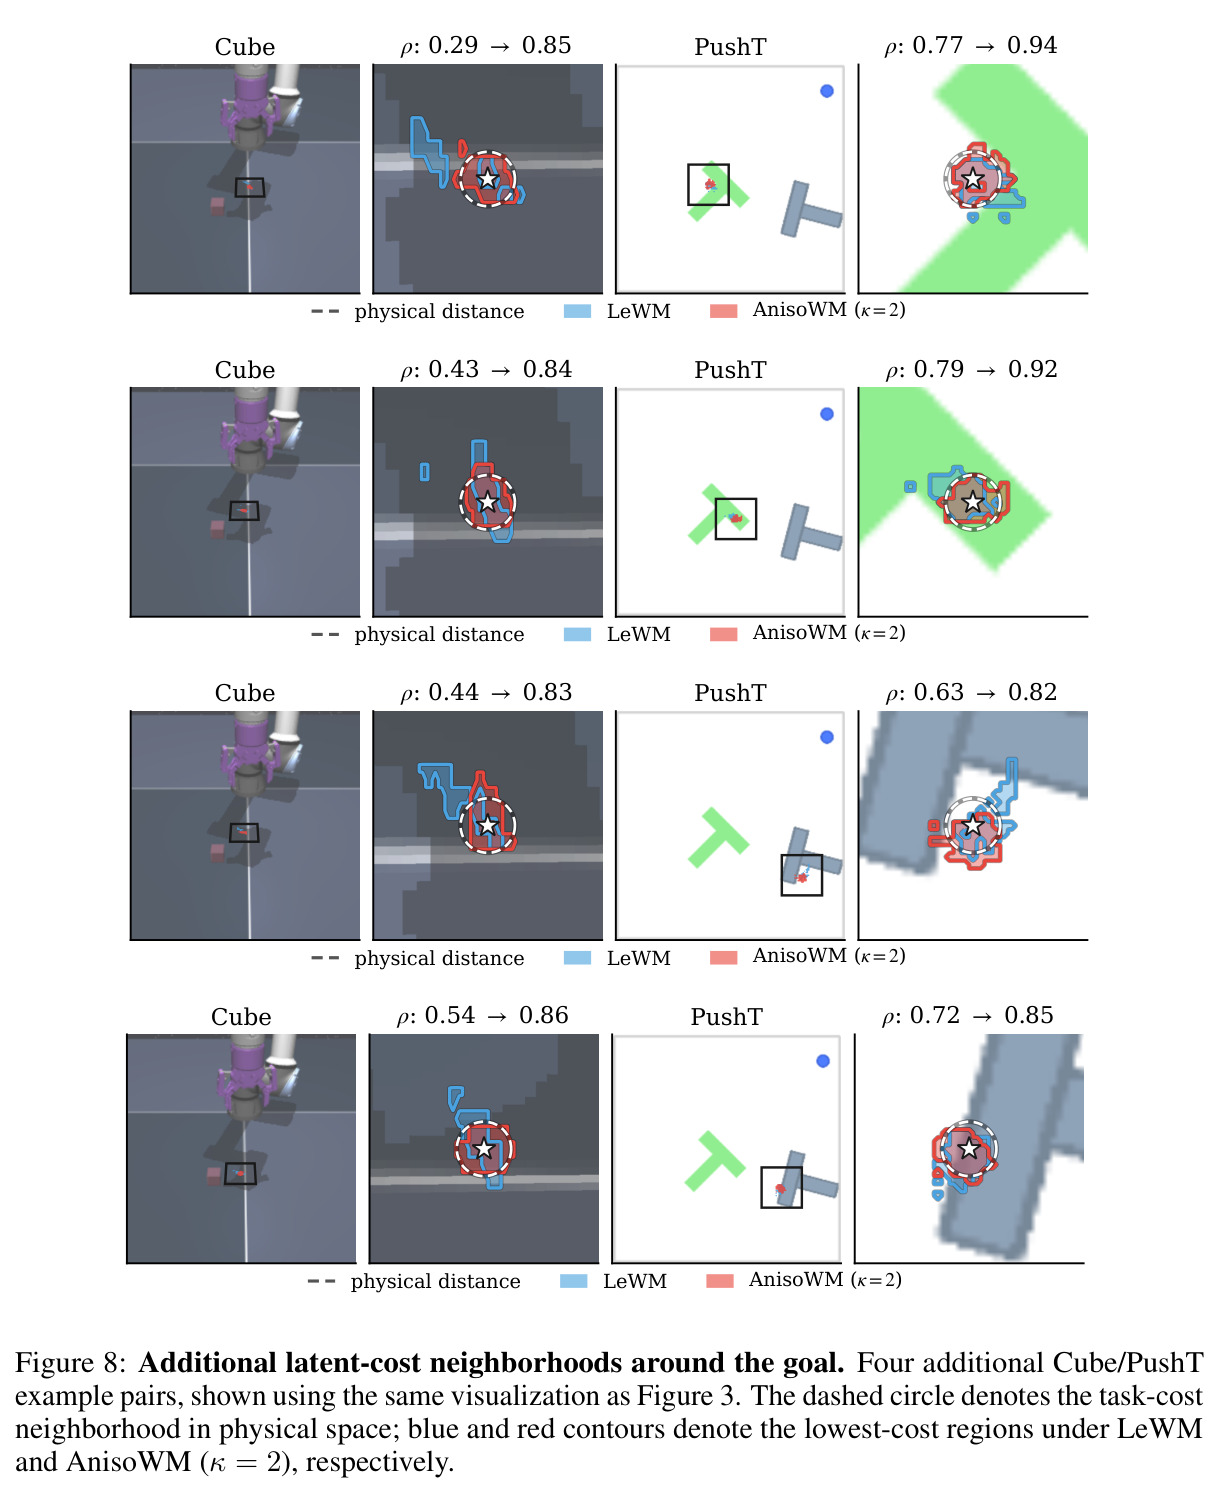
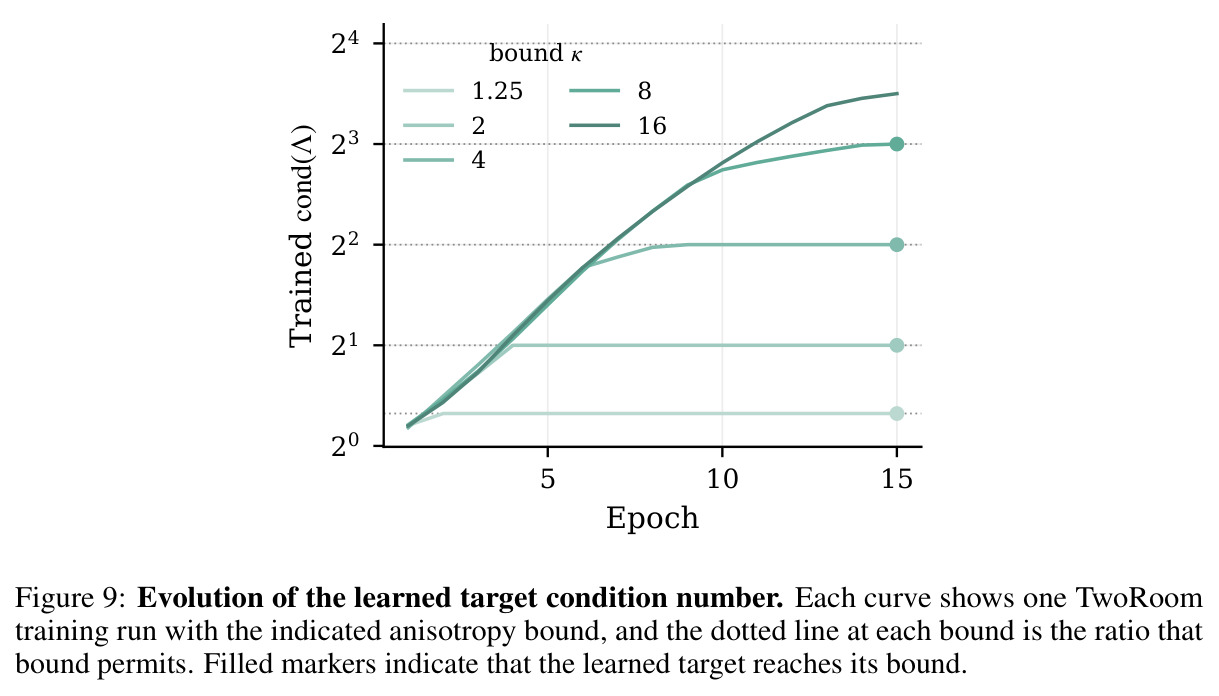
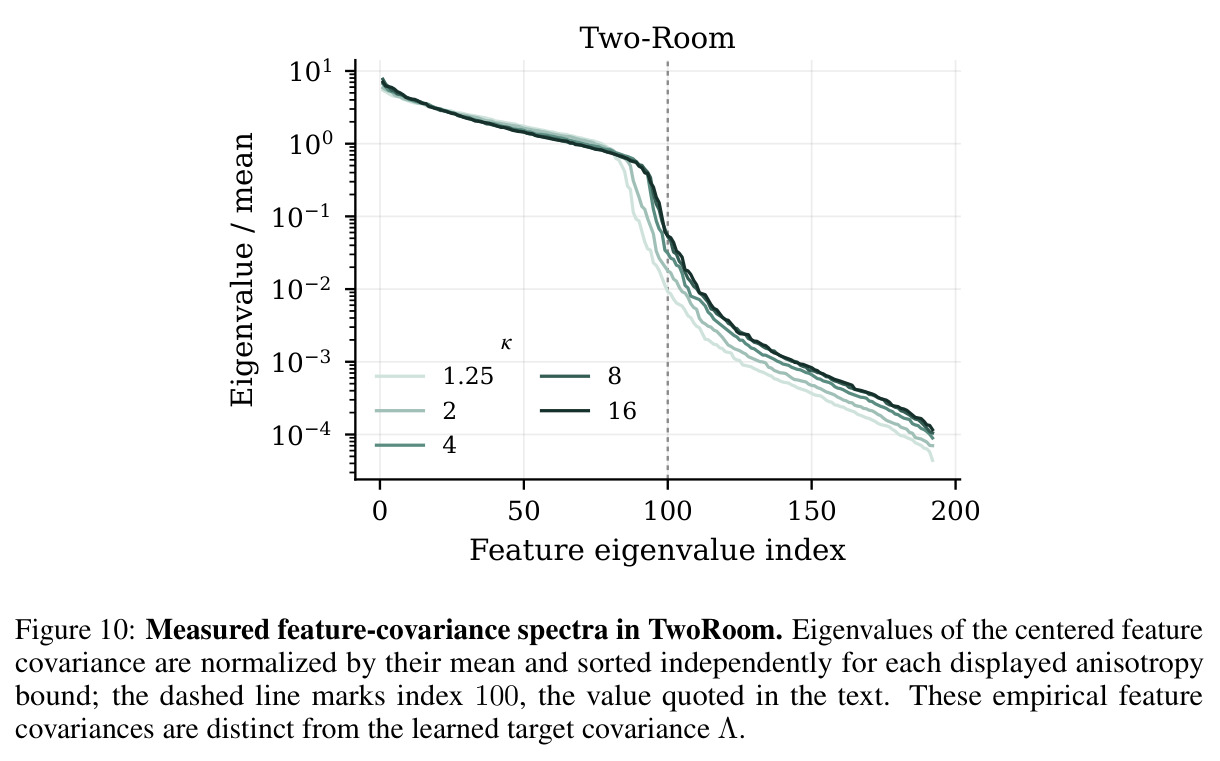
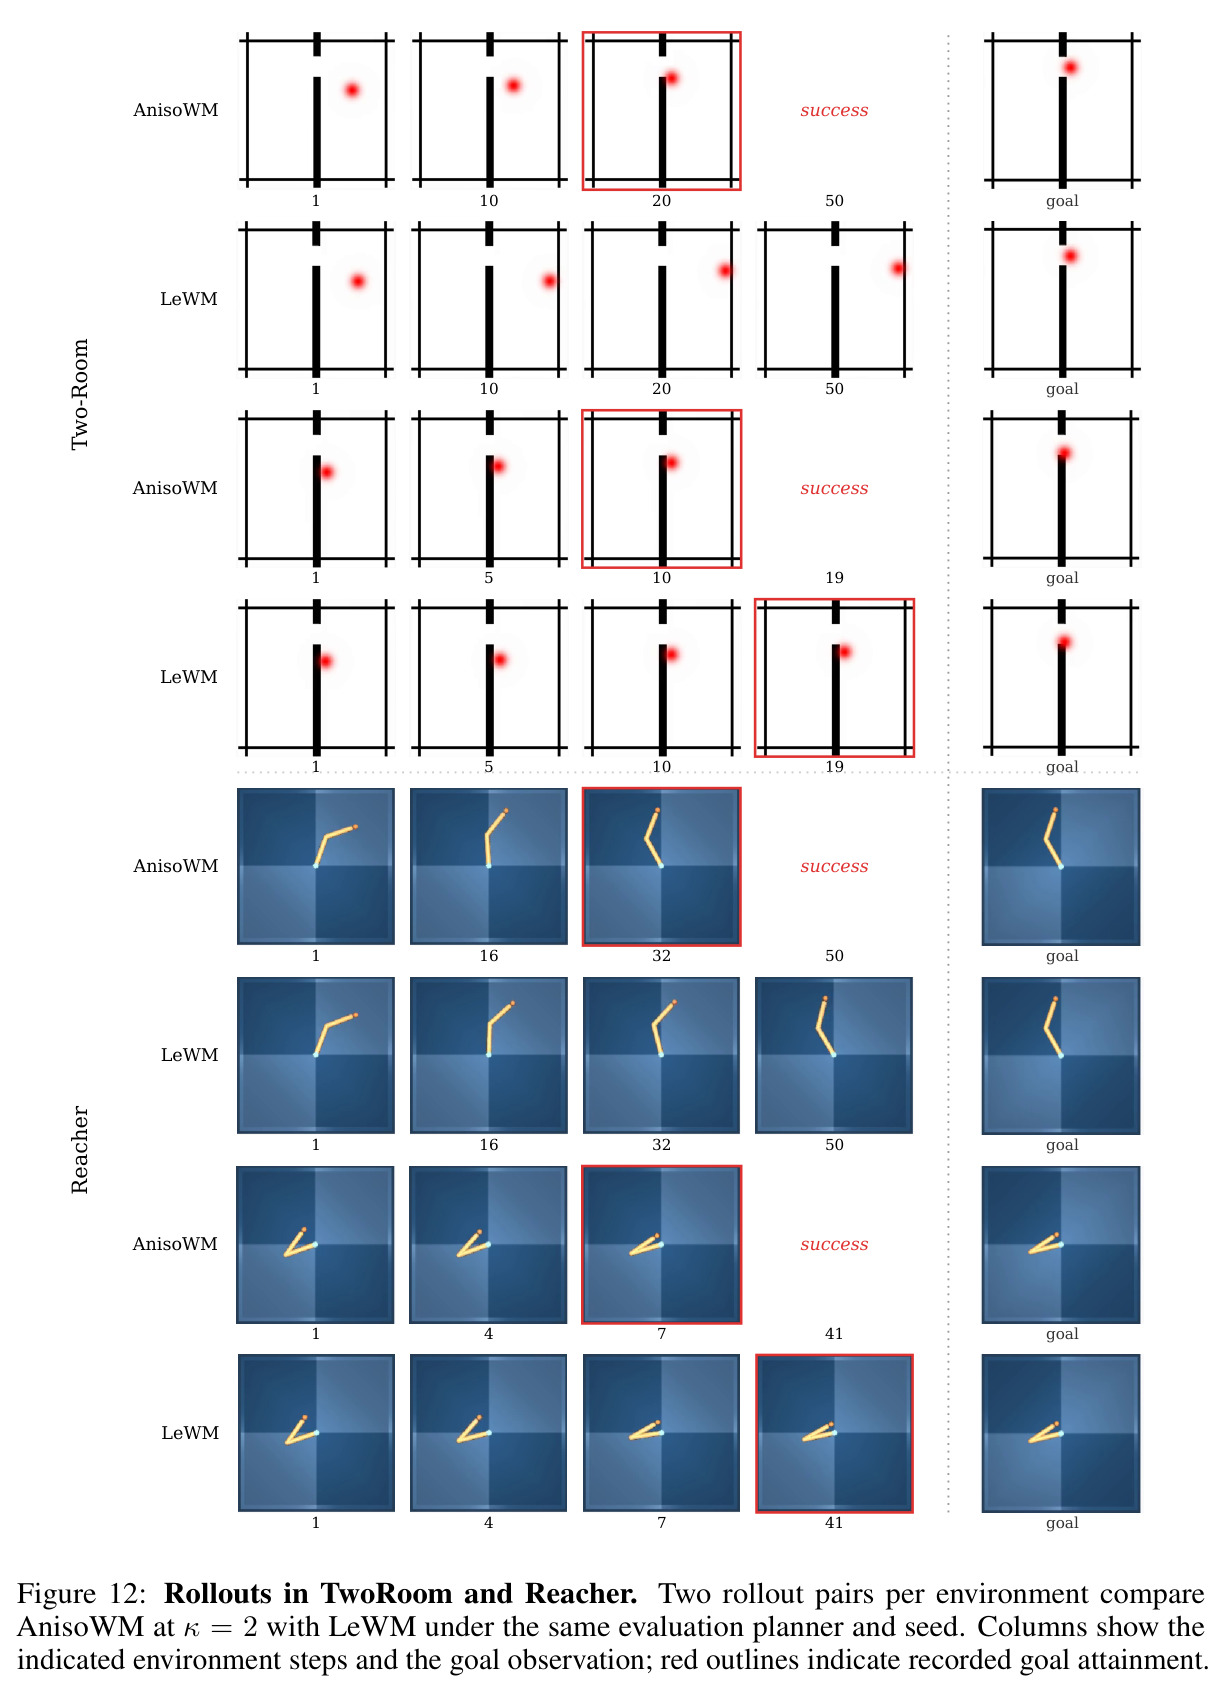
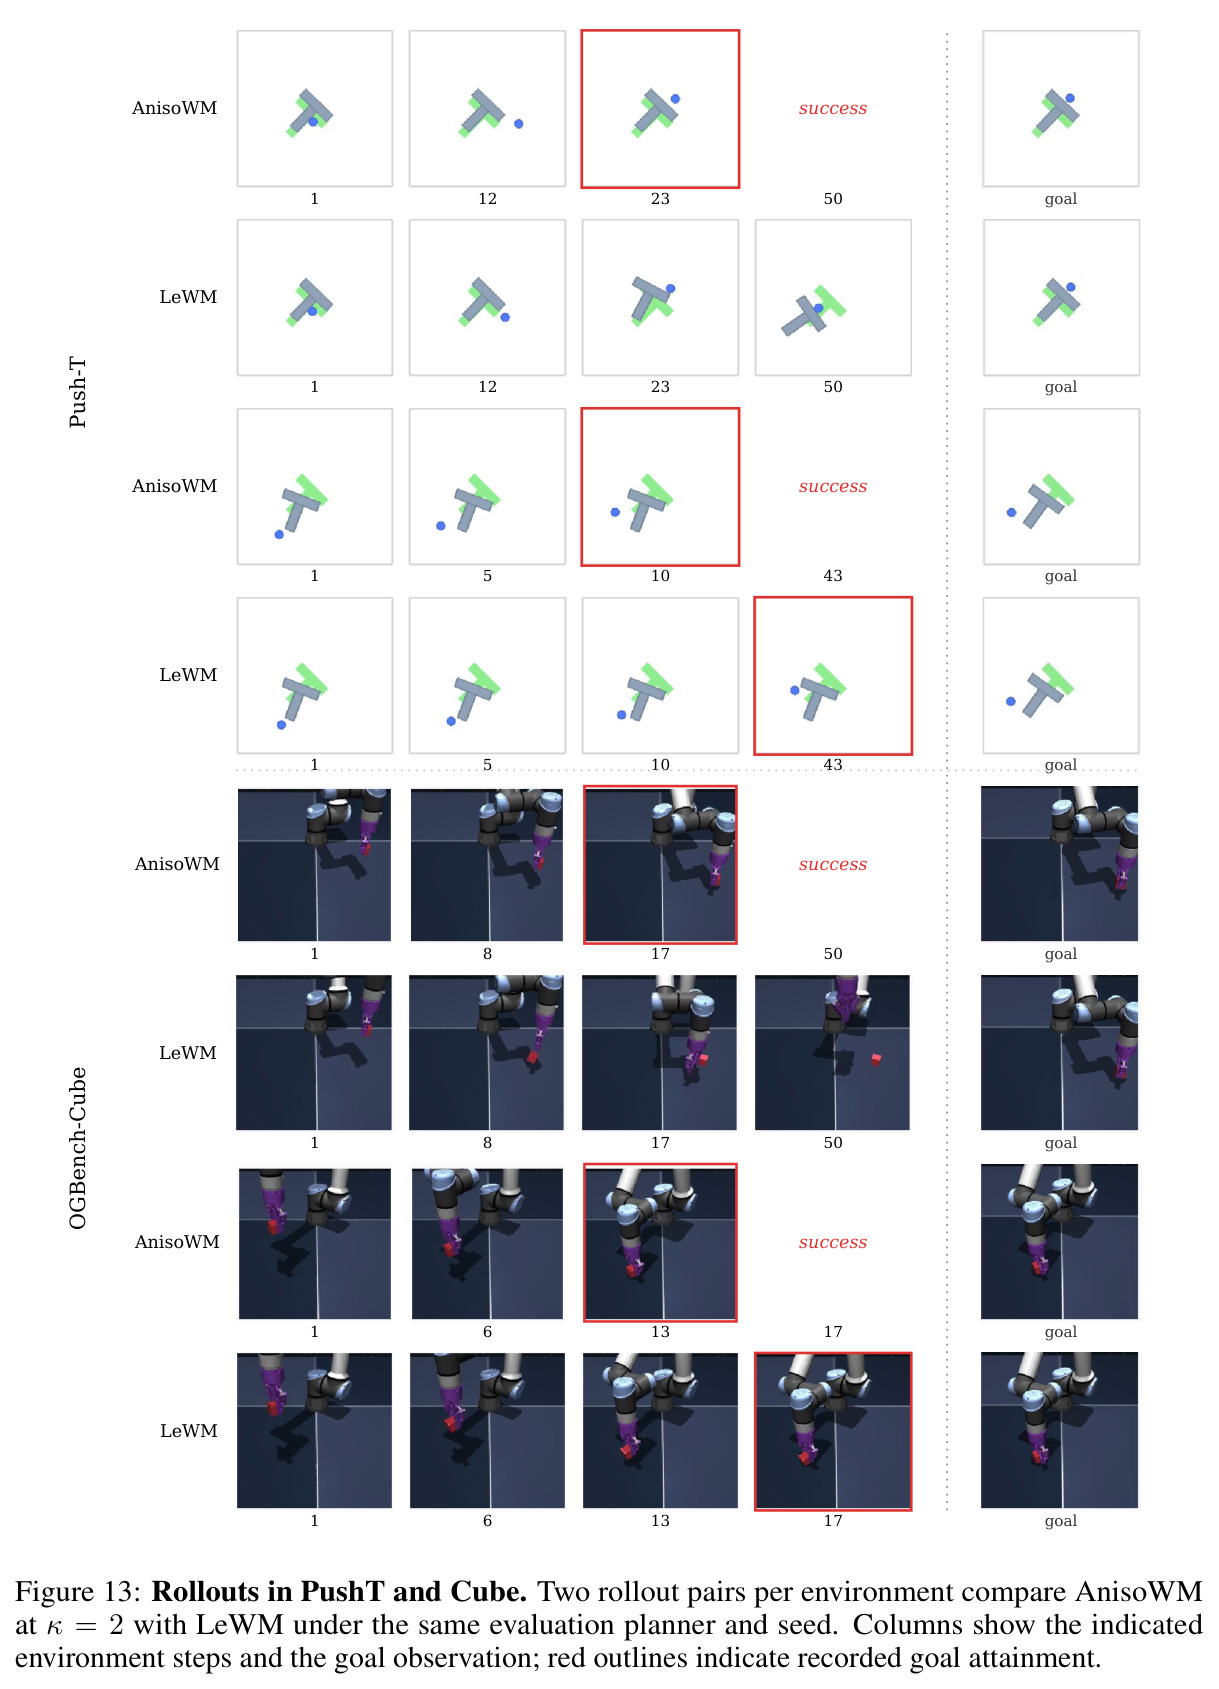
(1)规划成功率($\kappa=2$,3 种子均值):AnisoWM 在全部四个环境超过 LeWM——TwoRoom 93% 对 87%,Reacher 89% 对 86%,PushT 97% 对 96%,OGBench-Cube 79% 对 74%;逐种子为 92.7/88.7/96.7/79.3。部分参考基线(PLDM、DINO-WM、GCBC、GCIQL、GCIVL)在 TwoRoom 和 Cube 上更高,但 AnisoWM 保留了 LeWM 的高效潜空间规划。(2)排序诊断(Table 1):规划代价 $J_{pred}$ 的代价–结局排序一致率四环境全部提升(TwoRoom 0.575→0.646,Reacher 0.676→0.723,PushT 0.594→0.621,Cube 0.537→0.553);仅用表示、不含 rollout 的 $J_{enc}$ 在 TwoRoom(0.564→0.661)、Reacher(0.790→0.893)、Cube(0.555→0.576)提升,PushT 基本持平(−0.005),说明 PushT 收益主要来自预测器与表示的交互而非表示本身。(3)局部代价几何:潜代价与物理距离的 Spearman $\rho$ 在 Cube 从 0.15 升至 0.91、PushT 从 0.65 升至 0.92,附录 8 个附加例子中 AnisoWM 全部更高(Cube 0.29–0.54→0.83–0.86,PushT 0.63–0.79→0.82–0.94)。(4)学到的谱随环境而异:高于均值方差 的坐标数 TwoRoom 102、Reacher 124、PushT 95、Cube 97(共 192 维);TwoRoom 中达到条件数边界后谱仍继续演化,说明 $\kappa$ 约束但不决定分配。(5)$\kappa$ 敏感性非单调(Table 6):TwoRoom 到 $\kappa=16$ 仍改善(94%),其余环境在 $\kappa=1.25$–2 最佳,Cube 在 $\kappa=1.25$ 达 82% 反而高于 $\kappa=2$ 的 78%;$\kappa=16$ 的运行 15 个 epoch 后条件数只到 11.3,名义上限未用满。(6)理论验证:MLP 玩具实验中过程噪声缩 30 倍、预测误差大幅下降而归一化遗憾稳定在约 0.16 ≈ 逆协方差参考值 0.1607。(7)实测特征协方差随 $\kappa$ 变化:TwoRoom 第 100 个归一化特征值从 0.009($\kappa=1.25$)升至 0.054($\kappa=16$),熵有效秩在 74–111/192 之间。
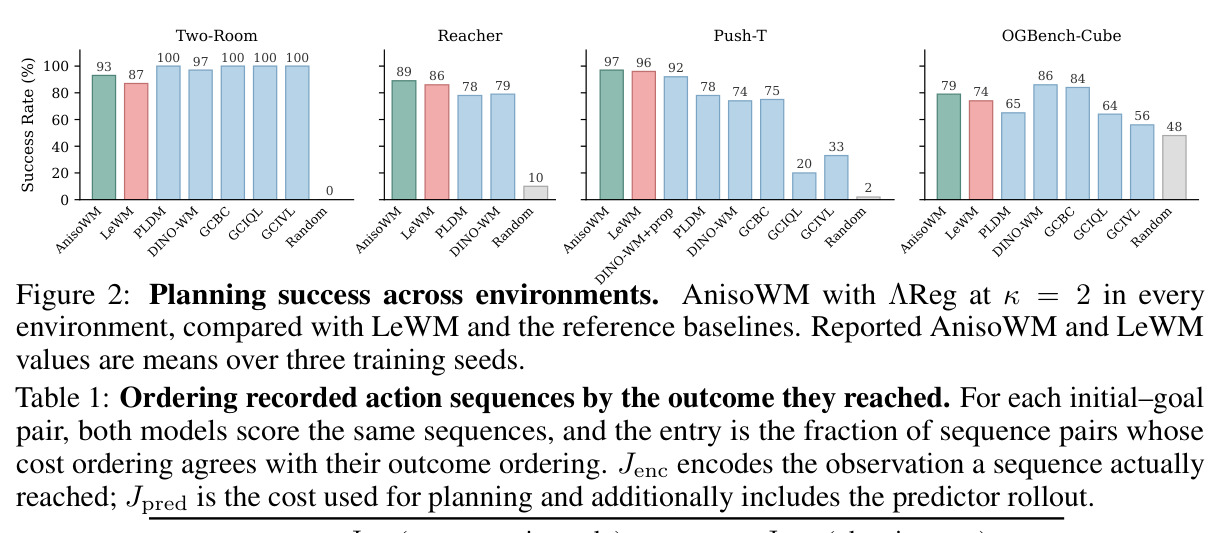
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| TwoRoom 视觉目标规划 | 规划成功率(3 种子均值) | AnisoWM 93%(92.7%) | LeWM 87% | +6 个百分点 |
| Reacher 视觉目标规划 | 规划成功率(3 种子均值) | AnisoWM 89%(88.7%) | LeWM 86% | +3 个百分点 |
| PushT 视觉目标规划 | 规划成功率(3 种子均值) | AnisoWM 97%(96.7%) | LeWM 96% | +1 个百分点 |
| OGBench-Cube 视觉目标规划 | 规划成功率(3 种子均值) | AnisoWM 79%(79.3%) | LeWM 74% | +5 个百分点 |
| TwoRoom 动作序列排序诊断 | 规划代价 Jpred 与结局排序一致率 | AnisoWM 0.646 | LeWM 0.575 | +0.071 |
| Reacher 动作序列排序诊断 | 规划代价 Jpred 与结局排序一致率 | AnisoWM 0.723 | LeWM 0.676 | +0.048 |
| Cube 局部代价几何 | Spearman ρ(潜代价 vs 物理距离) | AnisoWM 0.91 | LeWM 0.15 | +0.76 |
| PushT 局部代价几何 | Spearman ρ(潜代价 vs 物理距离) | AnisoWM 0.92 | LeWM 0.65 | +0.27 |
局限与改进
作者承认的局限:$\kappa$ 扫描是单种子运行,只能作为敏感性诊断而非调优结论;增大允许的各向异性并不单调有益,最优 $\kappa$ 因环境而异,主实验统一 $\kappa=2$ 虽避免逐环境调参但在 Cube 上次优($\kappa=1.25$ 达 82% 对 $\kappa=2$ 的 78%);部分参考基线在 TwoRoom 和 Cube 上成功率更高;$\lambda=0.09$ 直接沿用 LeWM 未为 AnisoWM 重新调参。我的补充观察:(1) 理论建立在线性高斯模型与 $\eta\to 0$ 渐近之上,真实视觉环境的非线性动力学只有定性支撑——一个二维 MLP 玩具实验加上光滑非线性扰动的稳定性推论(Corollary 2),没有真实环境的度量测量;(2) 目标仅限对角协方差,非对角任务结构只能靠编码器自身的朝向 $L=O^\top\Lambda O$ 间接补偿,是否总能找到合适的朝向没有保证;(3) PushT 收益仅 +1 个百分点且 $J_{enc}$ 排序反而 −0.005,提示方法收益高度依赖环境,特别是目标不可达迫使跨方向权衡的场景;(4) 评估目标取自同一轨迹 25 步之内,未测跨轨迹目标泛化,也没有真实机器人实验;(5) 排序诊断平均在 33–50 个案例上(Cube 仅 33 例),统计功效有限;(6) 表示熵有效秩 74–111/192,距离满秩尚远,条件数约束与长期训练动态的交互未被充分探索。
独立分析的弱点
(1)$\kappa$ 需逐环境选择:Cube 最佳 $\kappa=1.25$ 而 TwoRoom 偏好 16,统一 $\kappa=2$ 使 Cube 损失约 4 个百分点。改进方向:把 $\kappa$ 自适应化,例如对约束 $\mathrm{cond}(\Lambda)\le\kappa$ 做拉格朗日松弛让惩罚强度可学,或按验证集上的排序一致率早停选择。(2) 对角目标表达力受限:若任务代价 $Q$ 的特征方向与 $\Sigma$ 不对齐,对角 $\Lambda$ 只能靠编码器朝向 $O$ 旋转,可能收敛慢或停在次优朝向。改进方向:允许低秩或块对角 $\Lambda$,或直接在 $\mathcal S_{D,\kappa}$ 流形上参数化完整 $L$。(3) 收益机制依赖『目标不可达、需跨方向权衡』的情形:目标精确可达时两种度量排序一致,改进方向是先用可达集分析预测哪些任务/环境会受益,避免无谓的计算与超参负担。(4) 排序诊断样本量小且依赖存储的 rollout 序列,Cube 只有 33 例。改进方向:主动采样更多初始–目标对,或用受控扰动合成候选序列扩大候选集。(5) $\lambda$ 与 $\kappa$ 的联合作用未探索:目标形状改变后预测–正则平衡的最优 $\lambda$ 未必还是 0.09。改进方向:小规模 $\lambda\times\kappa$ 网格至少在两个环境上验证稳健性。(6) 训练后期谱仍在漂移(Fig 4 右),15 epochs 是否足以让谱收敛存疑。改进方向:设计谱收敛判据,或给 $\alpha$ 单独的 slower 学习率调度。
未来方向
作者方向:把分离与补偿分析推广到非线性编码器的非渐近情形(目前 Corollary 2 只给出光滑扰动下的稳定性);理解环境依赖的谱选择机制(附录 D 只给出两个训练分布选出不同谱的例子);$\kappa$ 的自动选择。基于成果可延伸的方向:(1) 显式结合任务度量——若能获得哪怕粗粒度的 $Q$(如由成功阈值或奖励结构诱导),可用 $L_Q=D\,\Sigma^{1/2}Q\Sigma^{1/2}/\mathrm{tr}(\Sigma Q)$ 作为目标初始化或先验,而不是纯靠预测驱动搜索;(2) 迁移到基于预训练特征的管线(DINO-WM、V-JEPA 2),检验『正则决定几何』在编码器冻结、只能调预测器输出分布时是否仍然成立;(3) 与 bisimulation 度量家族联接,刻画 $\Sigma^{-1/2}L\Sigma^{-1/2}$ 与行为等价度量的关系,可能统一『几何对齐』类方法的理论基础;(4) 任务条件化的 $\Lambda$:目标分布随任务变化的在线/闭环设定下,让目标协方差以任务描述为条件;(5) 高维谱理论刻画 $\kappa<\mathrm{cond}(\Sigma)$ 时遗憾的下界与最优方差分配(附录 D 是起点),给出 $\kappa$ 的先验选择法则;(6) 真实机器人数据与跨场景视觉目标上的验证,这是通向实用的必经之路。
复现评估
复现条件较好。论文给出项目网站(rkdrn79.github.io/AnisoWM-page/);附录 F.1 提供完整实现细节:Table 3 列出 15 epochs、AdamW、batch 128、峰值学习率 $5\times10^{-5}$、权重衰减 $10^{-3}$、192 维表示、$\lambda=0.09$、1024 投影方向、17 结点、CEM 30/300/30、50 对初始–目标;Algorithm 1 给出约 20 行 PyTorch 伪代码(含 DDP all_reduce),目标 logits 的零权重衰减与逐步裁剪规则明确。数据、预处理与评估协议完全沿用公开的 LeWM(Maes et al., 2026)代码与四个环境数据集,基线成功率取自 LeWM 论文,LeWM 基线也在作者自己的流水线中用相同种子重训。算力:ViT-Tiny 编码器加小型因果预测器、15 epochs、batch 128 属中小规模,单张高端 GPU(A100/H100 级)每个 run 预计小时到天级;主比较为 4 环境 × 3 种子 × 2 模型 = 24 个 run,$\kappa$ 扫描另加 16 个单种子 run。难点不在算力而在细节对齐:SIGReg 有限批次统计的生效条件($N\ge58$)、投影方向的种子管理、目标参数的裁剪时序、CEM 评估对的选取(同轨迹 25 步外)都必须与 LeWM 严格一致才能对齐数字。总体评估:对有世界模型训练经验的小团队,难度中低;从零复现则主要成本在 LeWM 基础设施。
论文图表
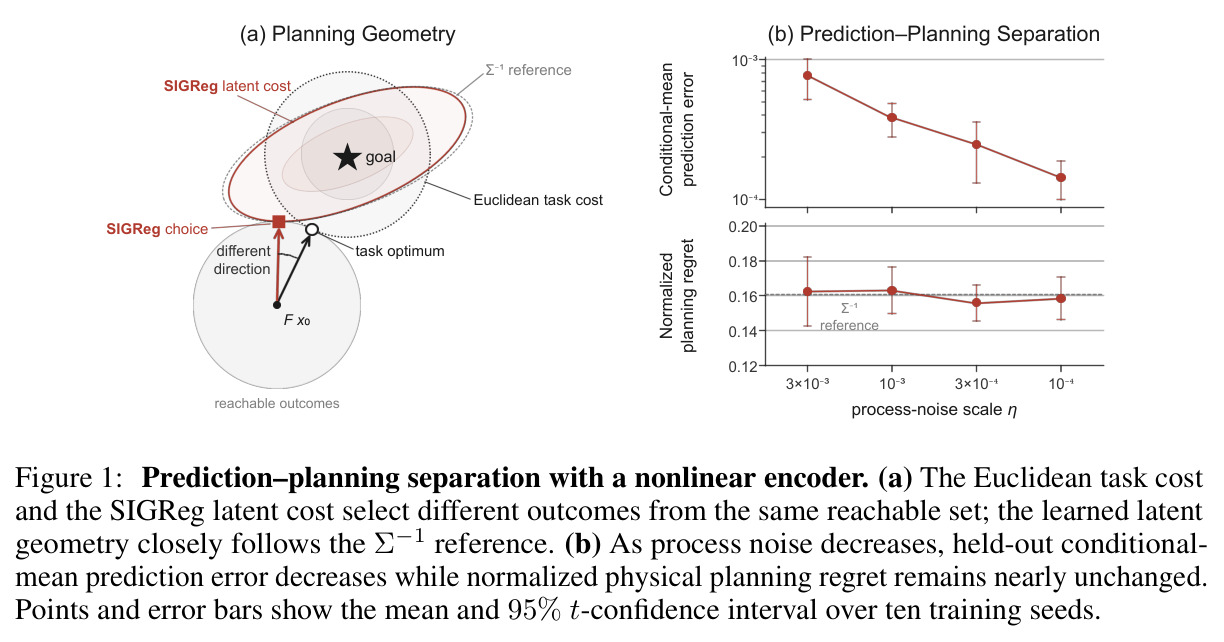
(a) 规划几何示意:欧氏任务代价与 SIGReg 潜代价从同一可达结局集合中选出不同结局,学到的潜几何紧贴 $\Sigma^{-1}$ 参考方向;(b) 随过程噪声尺度 $\eta$ 缩小约 30 倍,held-out 条件均值预测误差持续下降,而归一化物理规划遗憾几乎不变地停留在约 0.16(10 个训练种子的均值与 95% 置信区间),与逆协方差参考值 0.1607 吻合。
这是『预测好 ≠ 规划好』这一中心论点最直接的实证证据:预测误差与规划遗憾在同一实验中被解耦,直接支撑 Theorem 1 并引出各向异性正则的动机。
Cube 与 PushT 各一例:左侧为竞技场渲染与评估区域,右侧显示目标(星标)附近潜规划代价最低的 10% 位置——LeWM(蓝)与 AnisoWM($\kappa=2$,红),虚线圆为物理欧氏距离对应的邻域。Spearman $\rho$ 在 Cube 从 0.15 升至 0.91、PushT 从 0.65 升至 0.92。
把抽象的『度量对齐』变成看得见的空间证据:AnisoWM 的低成本区与物理距离邻域高度重合,而 LeWM 会把离目标很远处误判为低成本,直观解释成功率差异的来源。
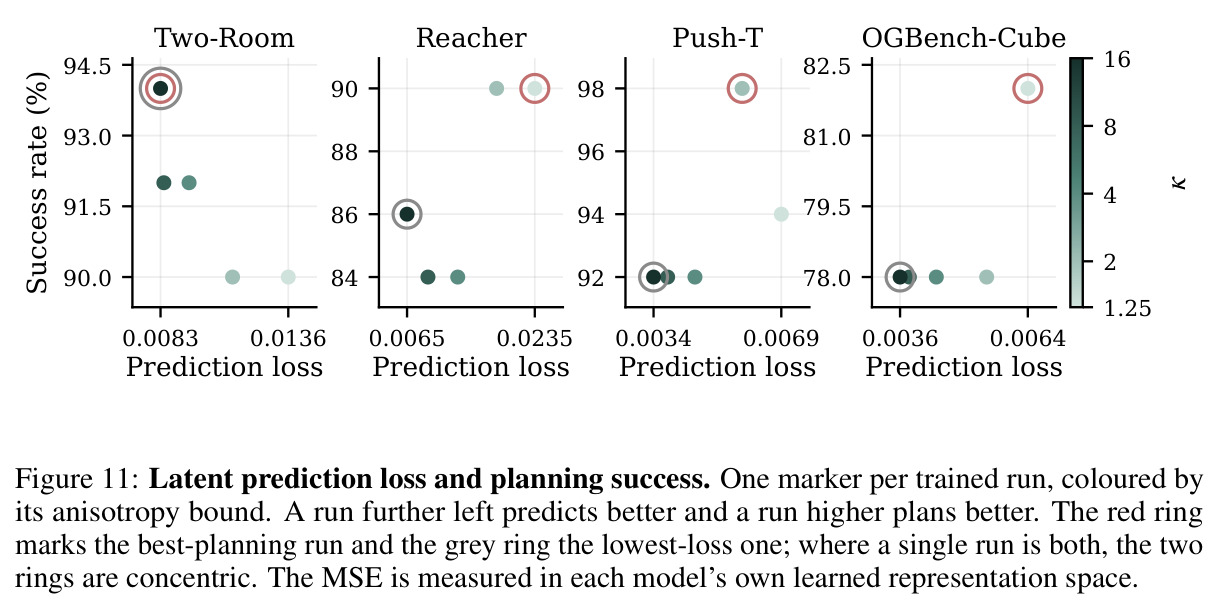
$\kappa$ 扫描中每个训练 run 一个点:横轴为各自表示空间内的潜预测 MSE,纵轴为规划成功率,颜色编码 $\kappa$;红圈标最佳规划 run,灰圈标最低损失 run。潜 MSE 最小的 run 并不总是规划最好的 run。
再次印证『预测–规划分离』在真实环境尺度上成立,并提醒读者潜 MSE 跨模型不可比——这是评估世界模型时容易踩的坑。
排序诊断结果:对每个初始–目标对,两个模型给同一批记录动作序列打分,统计代价排序与真实结局排序的一致的序列对比例。$J_{enc}$ 只用表示编码实际到达的观测,$J_{pred}$ 是规划使用的代价(含预测器 rollout)。$J_{pred}$ 四环境全部提升(+0.071/+0.048/+0.028/+0.016),$J_{enc}$ 在 TwoRoom(+0.097)、Reacher(+0.103)、Cube(+0.021)提升、PushT 持平(−0.005)。
直接检验论文的核心机制主张——潜代价排序与任务结局排序的对齐——是连接理论与端到端成功率之间最重要的中介证据。
全文符号总表:观测/潜变量、编码器 $f_\theta$/预测器 $g_\phi$、规划代价 $J_z$、状态协方差 $\Sigma$、白化过程噪声 $R=\Sigma^{-1/2}W\Sigma^{-1/2}$、Gram 矩阵 $K$、目标协方差 $\Lambda$、条件数上限 $\kappa$、可行集 $\mathcal T_{D,\kappa}/\mathcal S_{D,\kappa}$、遗憾 $\mathrm{Regret}_{\eta,H}$、诊断代价 $J_{enc}/J_{pred}$ 等。
论文数学密度高、符号多,此表是阅读第 3、4 节及附录证明时的必要导航工具。