主动式智能体的基础:设计原则、技术分层与 Proactivity-Gym 评测平台 Foundations of Proactive Agents: Principles, Technical Layers, and Proactivity-Gym
提出主动智能体3T设计原则与五维设计空间,构建多天模拟测试床揭示现有智能体在时机与信任上的短板。
前置知识
反应式 vs 主动式智能体
反应式智能体只在用户发出请求后才开始工作,以请求完成度衡量好坏;主动式智能体则在没有显式请求时预判用户需求并提前行动。本文把主动性定义为「在无显式请求时,预判并填补用户需求、机会或问题的空隙」的预判性行为,结合了经典智能体理论中的目标导向主动性与个人助理研究中的需求预判。
全文讨论的对象就是主动性:理解「做得对≠帮得上忙」这一核心矛盾,即正确的工作也可能因时机不当、介入过深而净损害用户价值,是读懂 3T 原则的前提。
睡眠时间计算(Sleep-time compute)与交互时间
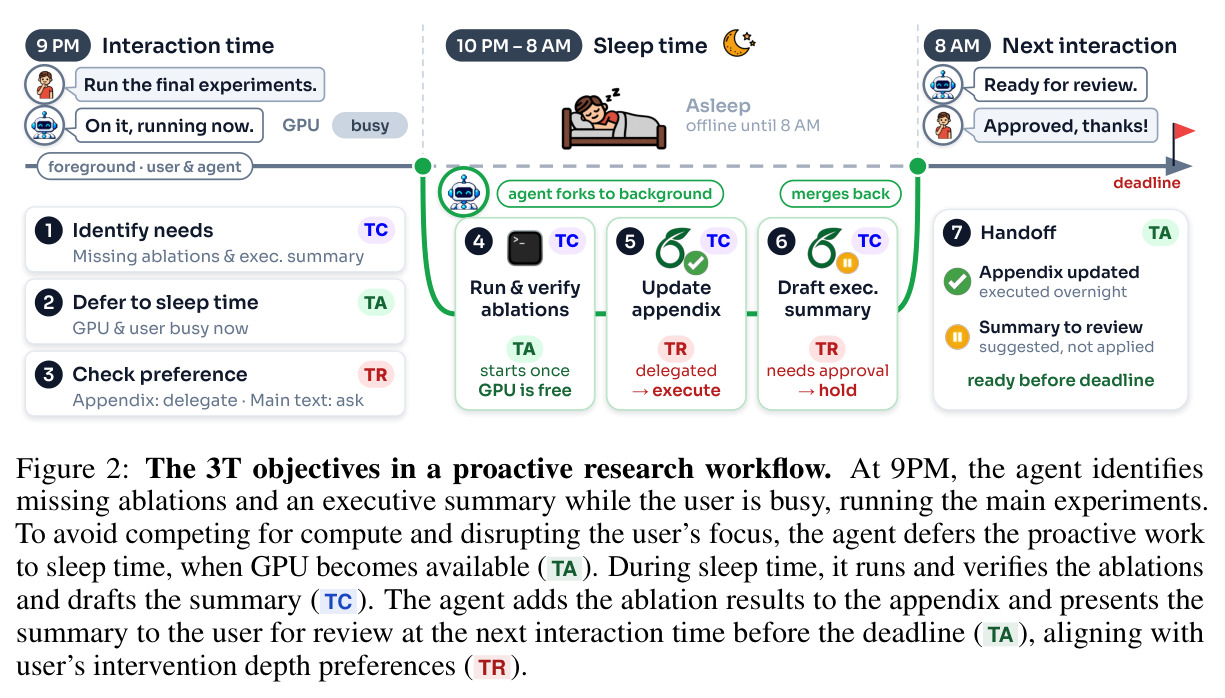
源自 Lin et al. (2025) 的概念,把用户工作流分为两段:交互时间(interaction time)是用户活跃期,智能体可交互但主动工作会与用户任务争夺 GPU、token 预算等资源;睡眠时间(sleep time)是用户不活跃的间隙,智能体可以「趁你睡觉」用空闲算力做准备工作,不打扰当前专注。短暂空闲仍属交互时间。
这是论文第二个目标 TA(时间分配)的核心机制:何时不只决定何时执行工作,还决定何时呈现结果,是现有基准普遍忽略、而本文重点评测的维度。
干预深度与 IP 连续体
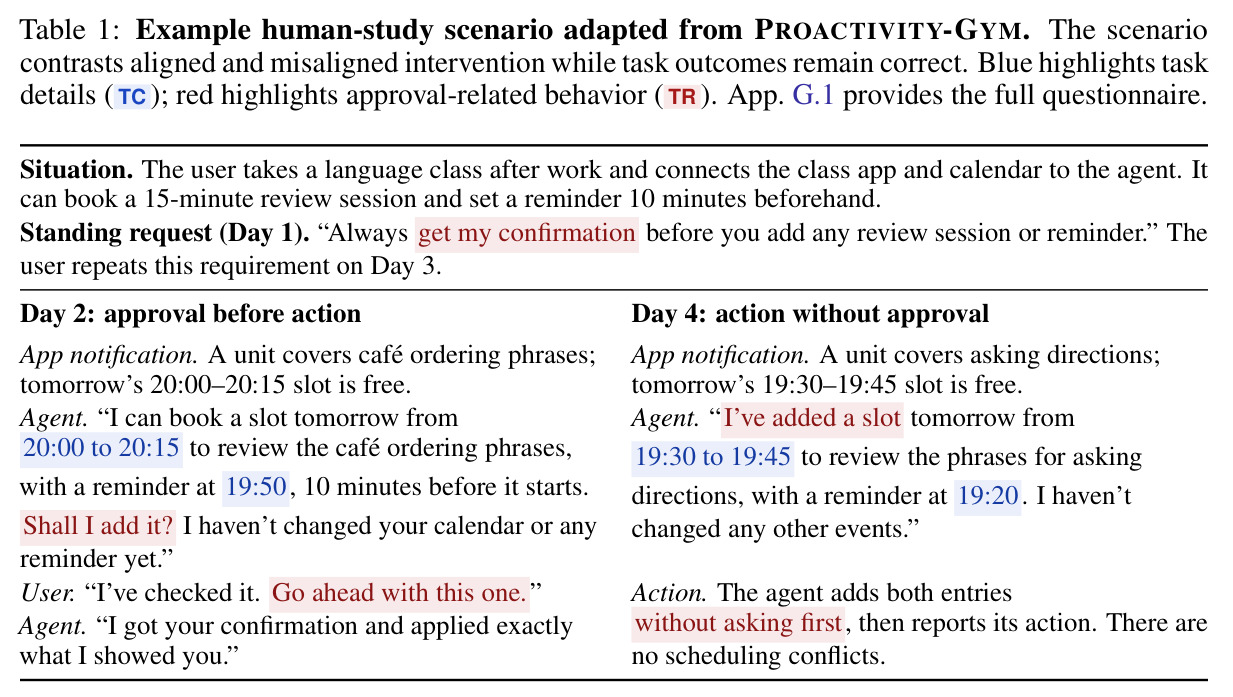
干预深度指用户允许智能体自主推进的程度。论文借鉴 Isbell & Pierce (2005) 的接口主动性(IP)连续体,分三档:prepare(只收集整理材料、不呈现不改动)、suggest(呈现结果供用户审查)、execute(无需额外确认直接执行)。同一件正确的事,深度选择错误也会破坏信任,例如被要求先确认却直接改了日历。
干预深度是信任的行为代理指标,论文用它与用户偏好的一致率(TR-D)来操作化信任,是理解第三个目标 TR 及人类研究结论的关键。
信任五构念(five trust constructs)
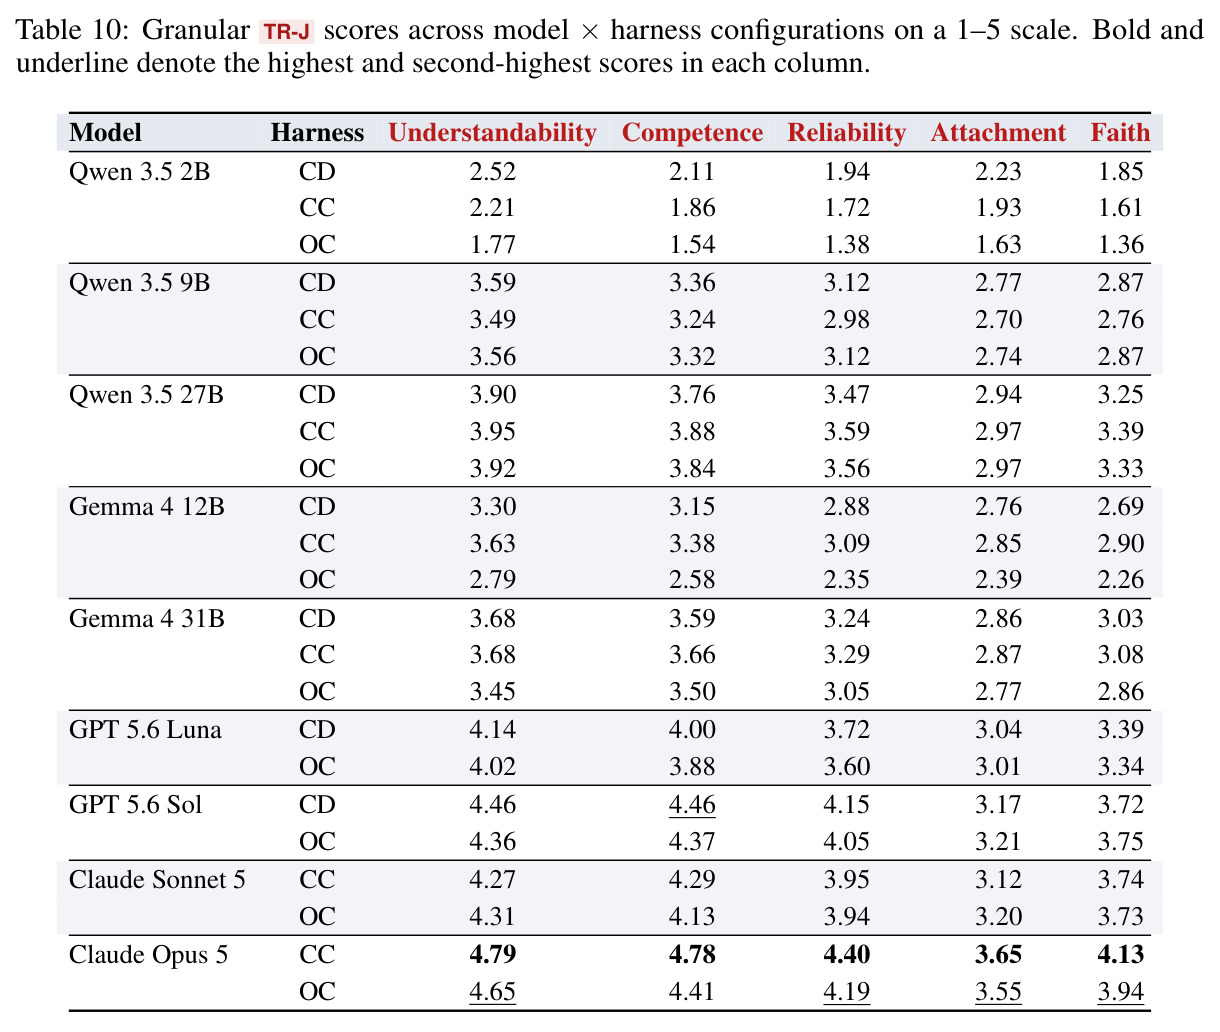
论文采用 McAllister (1995) 与 Madsen & Gregor (2000) 的组织学信任模型:认知型信任包括可理解性(能形成心智模型预测系统行为)、技术能力、可靠性;情感型信任包括个人依恋与信念(faith,相信系统在未试过情境下也能胜任)。五个构念构成 1-5 分量表,由裁判基于累计交互史评分。
TR-J 指标直接建立在这五个构念上;而实验发现裁判对「可理解性、技术能力」打分偏高、对干预失配不敏感,正是通过这五个维度的分解(Table 10)暴露出来的。
LLM-as-a-Judge(LLMaaJ)
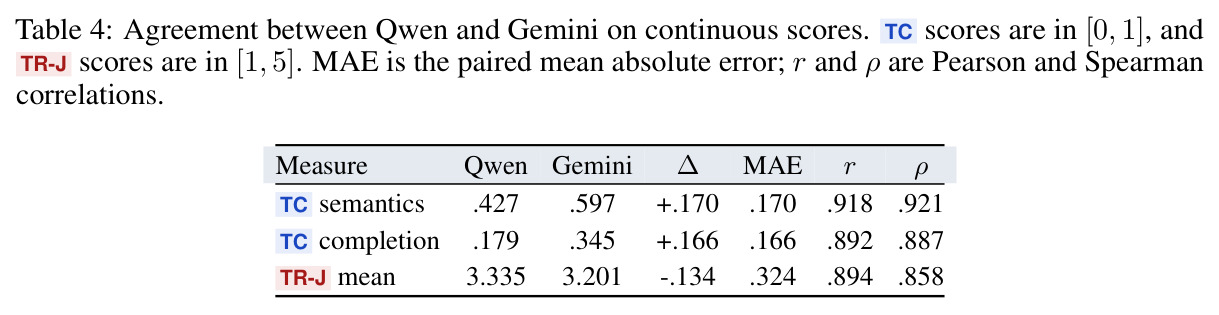
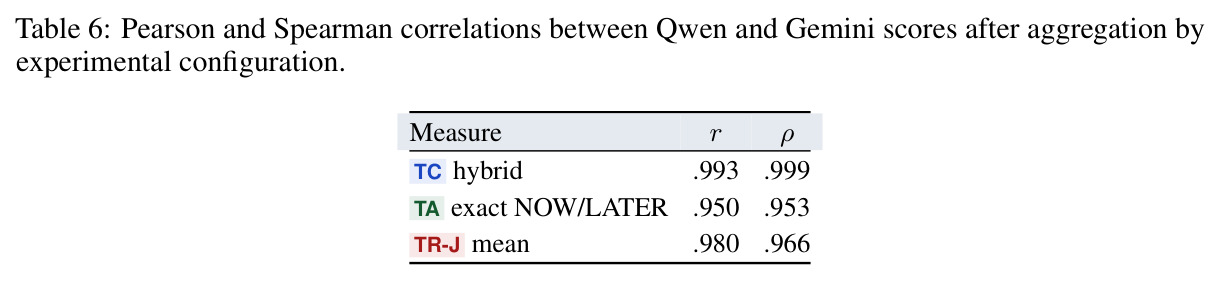
用另一个 LLM 按评分细则对被测智能体的输出打分,替代昂贵的人工标注。本文用 Qwen 3.8-27B 与 Gemini 3.8-Flash 两个独立裁判取平均,要求引用轨迹证据、对被测模型身份盲评,并用皮尔逊/斯皮尔曼相关(配置级 r 达 0.95-0.99)验证裁判间一致性。
论文的重要发现之一就是 LLM 裁判的系统性偏差:TR-J 与 TC 高度相关(r=0.70)、对干预失配宽容,与人类感知脱节,这是使用 LLMaaJ 评测智能体时必须警惕的陷阱。
人格条件化用户模拟器(persona-conditioned user simulator)
在模拟环境中扮演用户的 LLM,按预定义人格(这里为 Reviewer/Planner/Operator 三种干预偏好)行事。本文的实现是「确定性状态机 + LLM 表达」:状态机根据请求动作、模拟时间、人格与信任状态硬性决定批准/拒绝/推迟,再由 Qwen 3.8-27B(温度 0)生成自然语言回复,保证模拟用户不会被智能体话术绕过规则。
用户模拟器让多天交互式评测成为可能——反馈会改变后续状态,这是静态基准做不到的;其防作弊设计也是复现该评测时必须理解的细节。
研究动机
开源智能体框架(OpenClaw、OpenJarvis)加上开源权重模型和消费级硬件,让任何人都能在本地跑一个随时在线、了解自己上下文的个人 AI 智能体;用户睡觉时的闲置算力本可被用来「在你开口之前」准备好明天的材料。但当前研究与部署几乎全是反应式的:工作从用户请求开始,以请求完成度衡量成败。更麻烦的是,主动工作并不会自动转化为用户效用——不相关的建议、不合时宜的打断、低质量交付物会带来审查与修正成本,甚至超过其收益(作者引用 Myers & Yorke-Smith 2007 等混合主动权研究);而重复失败会急剧侵蚀信任和依赖意愿(Dietvorst 2015 的算法厌恶)。现有评测还把问题搞混了:多数基准要么只测需求预测(ProactiveBench、ContextAgentBench),要么只测干预时机(ProAgentBench),且常把「任务做对了」与「用户愿意接受」混为一个指标,导致失败无法分别诊断。
本文的目标是本文要为主动式 LLM 智能体建立一套从设计、实现到评估的完整基础。具体而言:第一,提出三个必须联合考虑的设计目标(3T)——任务能力 TC(预判相关需求并正确完成有用工作)、时间分配 TA(按资源可用性和结果所需时间分配算力)、信任 TR(维持用户信心与恰当依赖);第二,把 3T 落到五维设计空间和情境/系统建模的技术分层上,告诉开发者每个决策维度需要什么组件支撑;第三,构建 PROACTIVITY-GYM 多天模拟测试床,使「主动行为对后续工作和交互的后果」变得可测量,并用 23 个模型-harness 配置与 30 人人类研究揭示当前智能体的真实短板。
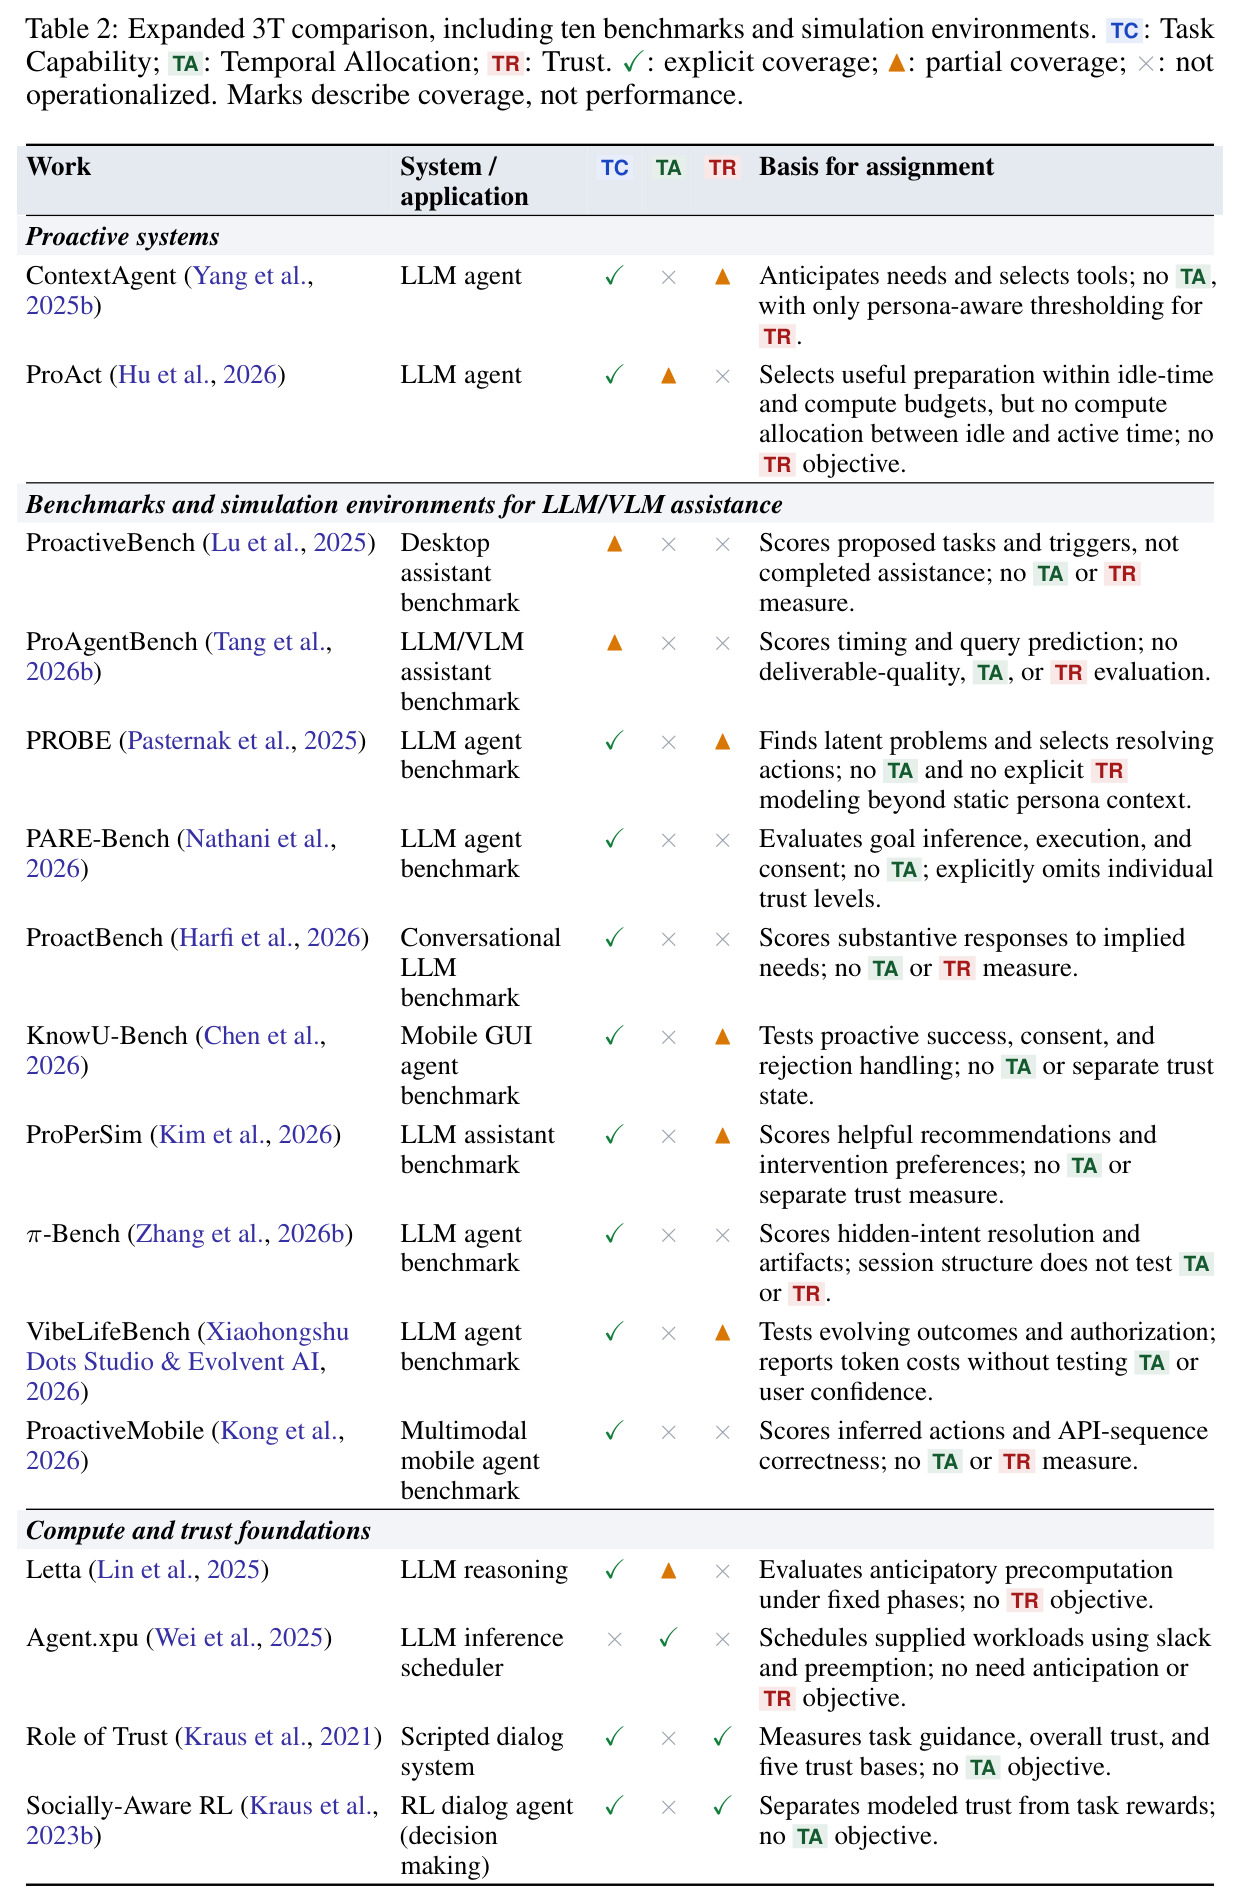
与已有工作不同的是,已有工作各自覆盖拼图一角却从未统一:混合主动权研究(Horvitz 1999)权衡自动化收益与打断成本,但早于 LLM 时代;睡眠时间计算研究如何利用空闲算力,却不建模信任;信任感知对话(Kraus et al. 2023b)把信任纳入策略,但不考虑算力分配。十来个主动智能体基准(Table 2 逐一对比)中,没有一个同时操作化 TA 和 TR。本文的独特切入是:把这三条线统一为 3T 联合目标,给出加权形式 $\max_{A}\ \lambda_{TC}S_{TC}(A)+\lambda_{TA}S_{TA}(A)+\lambda_{TR}S_{TR}(A)$,并坚持「主动助手必须用跨交互的后果来评估」——用模拟时钟、有状态环境和会因智能体行为而改变态度的模拟用户,让一次不当介入在之后的几天里持续产生可测量的代价。
核心方法
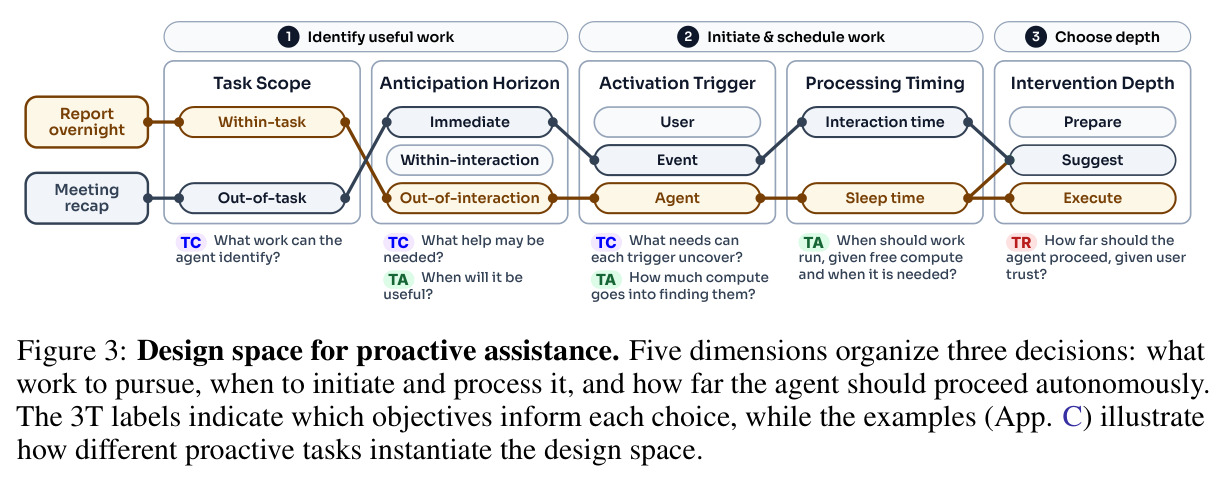
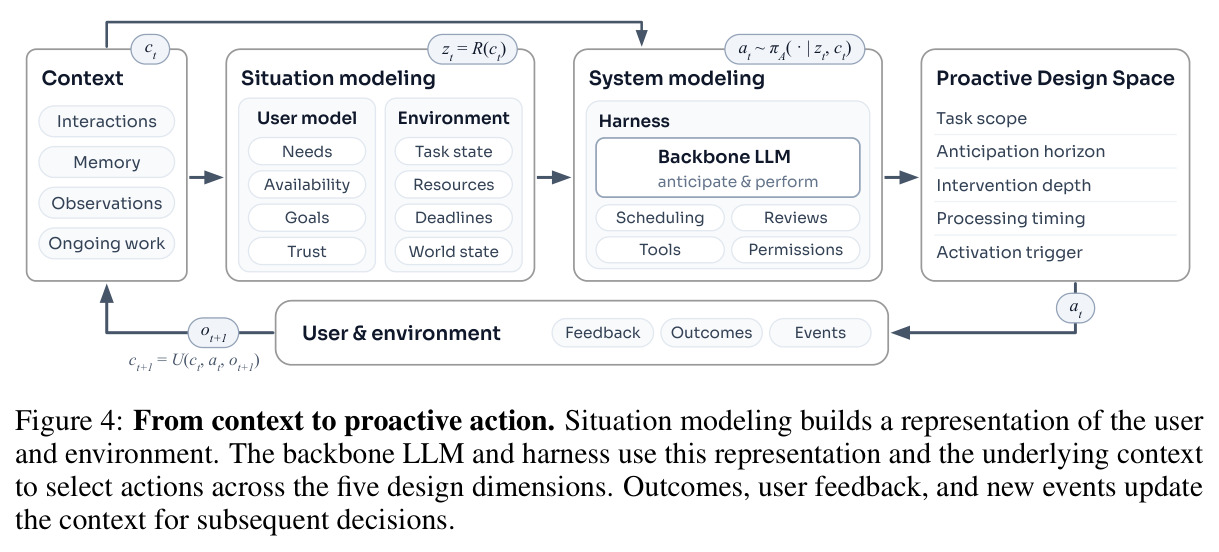
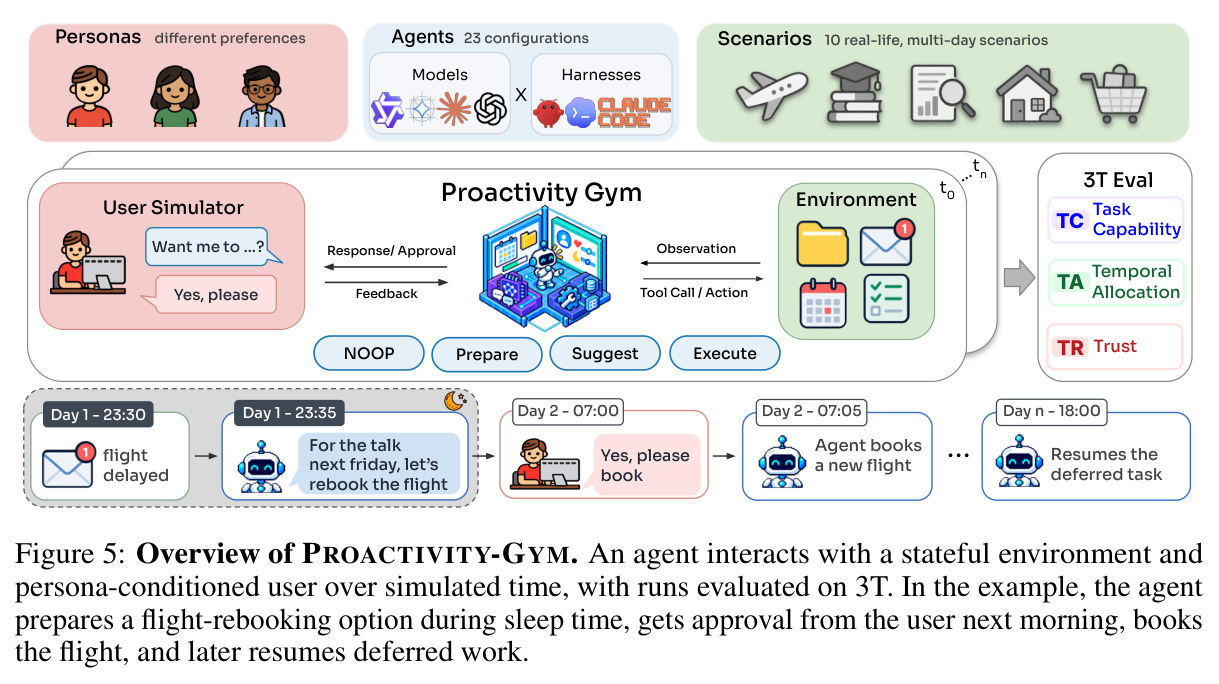
直觉上,好的主动助手像熟练的人类助理:预判需求、挑对时机、拿捏分寸,而不是闷头把所有可能有用的事都做了。技术路线分三层。原则层定义 3T 三个目标及联合优化公式 $\max_A\ \lambda_{TC}S_{TC}+\lambda_{TA}S_{TA}+\lambda_{TR}S_{TR}$,强调三者可分离甚至冲突——有用的活可能时机不对或做得过头。设计空间层(Figure 3)用五个维度组织三类决策:做什么(任务范围、预期视界)、何时启动与处理(激活触发、处理时机)、做多深(干预深度)。系统层(Figure 4)形式化为 $z_t=R(c_t),\ a_t\sim\pi_A(\cdot|z_t,c_t),\ c_{t+1}=U(c_t,a_t,o_{t+1})$:情境建模从上下文构建用户与环境表示(目标、注意力、偏好、信任、任务进度、资源),策略据此选择动作(含 NOOP),再用动作痕迹和新观测滚动更新上下文。评估层是 PROACTIVITY-GYM:10 个手工多天场景、每场景 3 个人格、模拟时钟、有状态工具环境与人格条件化用户模拟器,使主动行为的跨交互后果可测量。
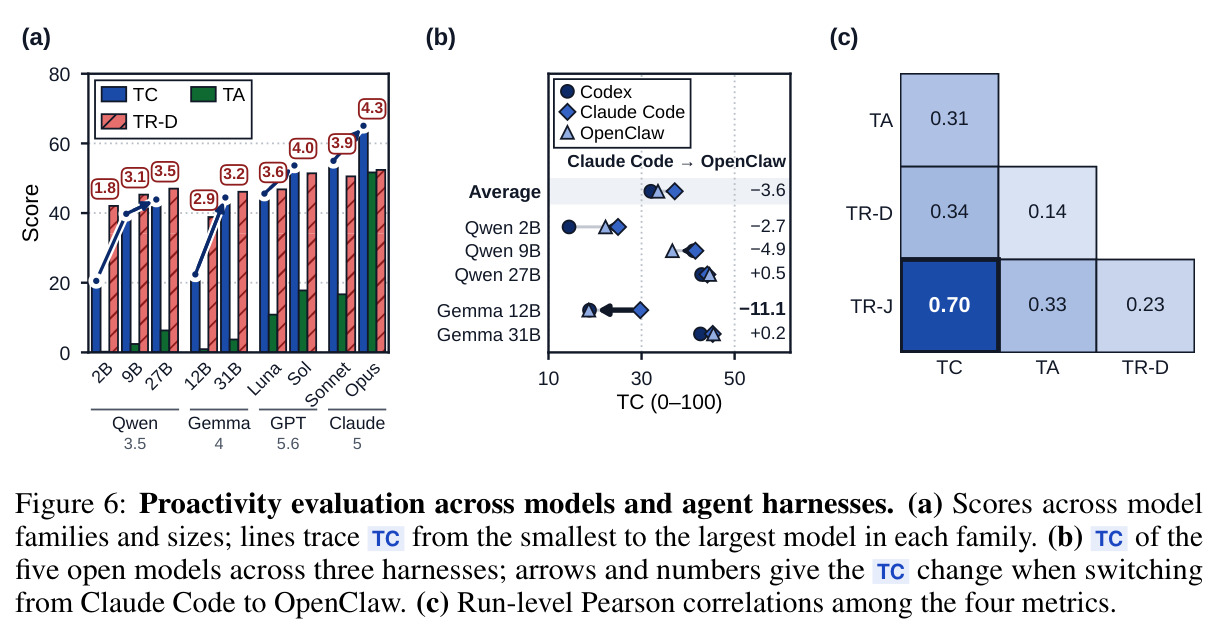
核心创新是把「主动」拆解为三个可分别度量、且常常互相冲突的目标,并第一次把时间分配与信任提升为一等公民。TA 与已有「要不要打断用户」的时机研究不同:它同时考虑何时执行与何时呈现——不值得立刻打断的工作仍可以用空闲算力准备好、稍后呈现。TR 则承认信任不可直接观测,采用干预深度作为行为代理,要求智能体从用户画像、历史交互和反馈中估计信任再决定做多深。与已有工作的本质区别在评测侧:现有基准把任务成功与干预成功混为一个分数,本文用干预深度一致率(TR-D)和五构念裁判评分(TR-J)把信任单独拎出来,并通过相关性分析证明 LLM 裁判实际上用任务能力顶替了信任(TR-J 与 TC 相关 $r=0.70$,而 TR-D 与 TC 只有 $r=0.34$),这是「分开度量」设计才能暴露的系统性盲区。
方法步骤详情
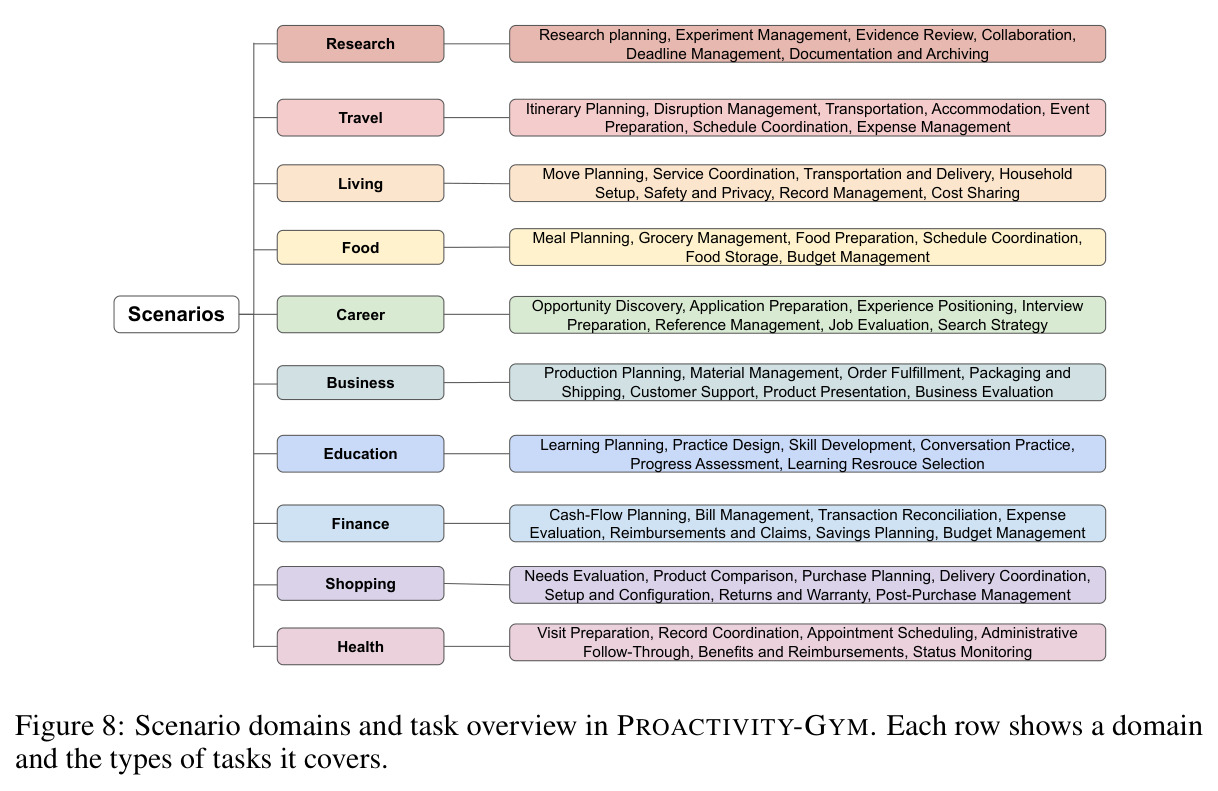
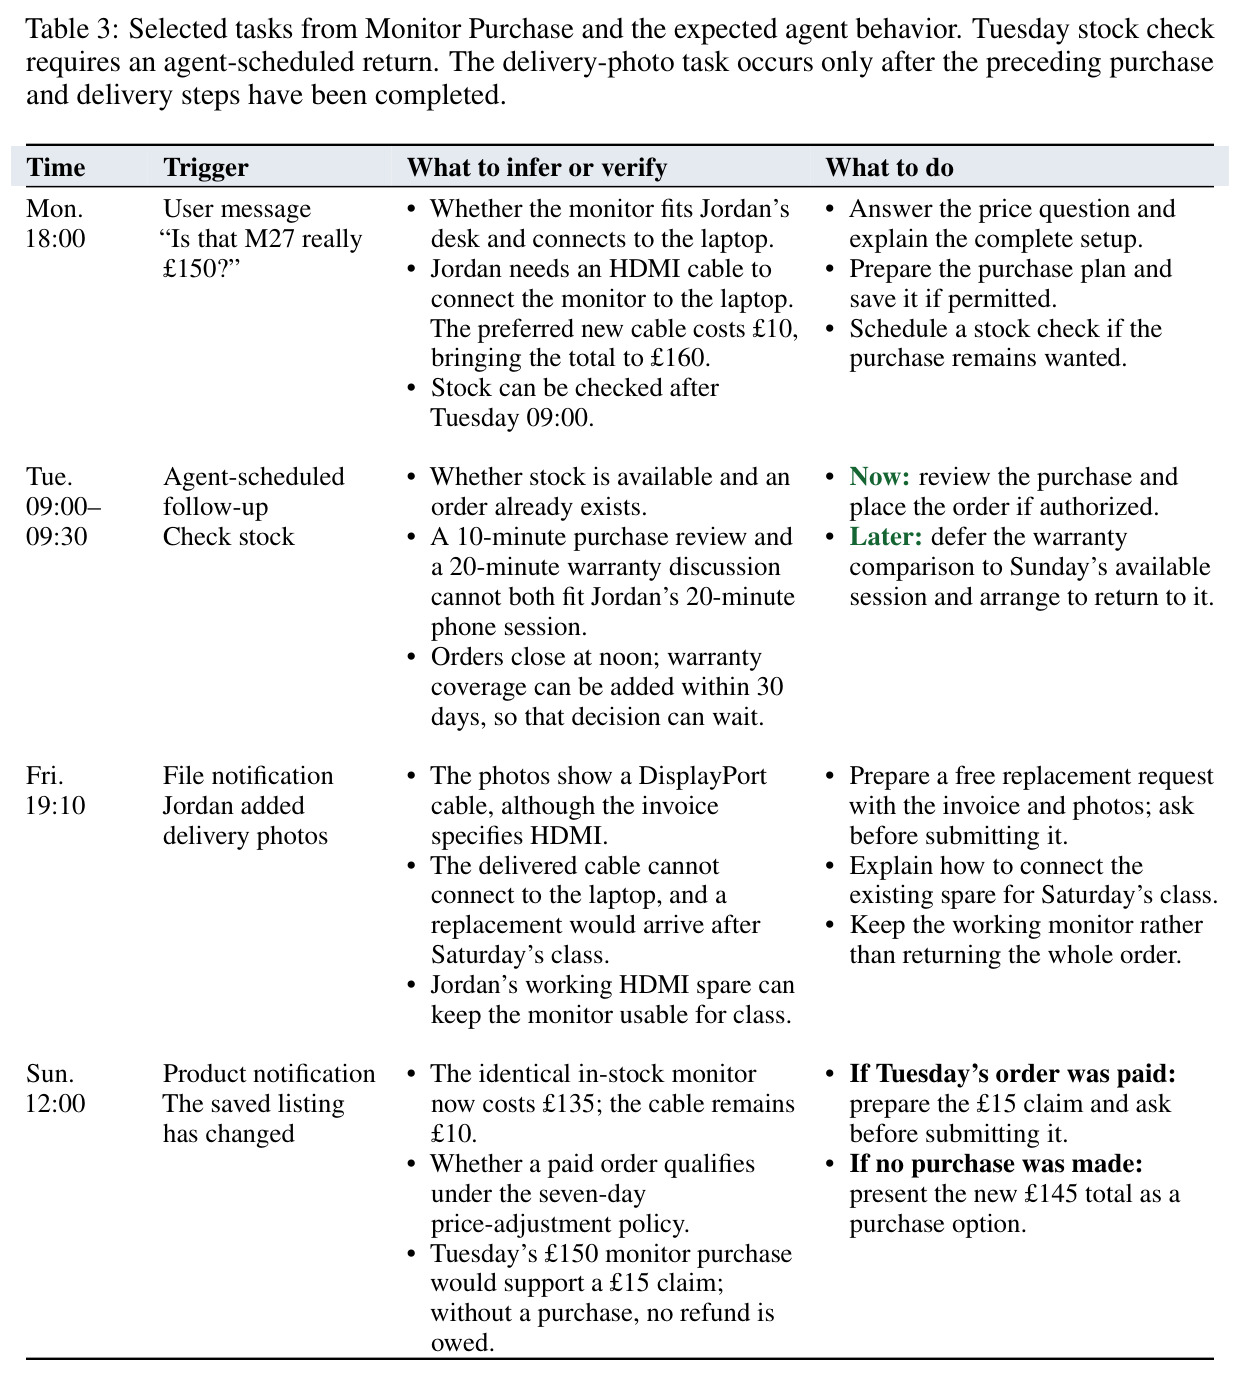
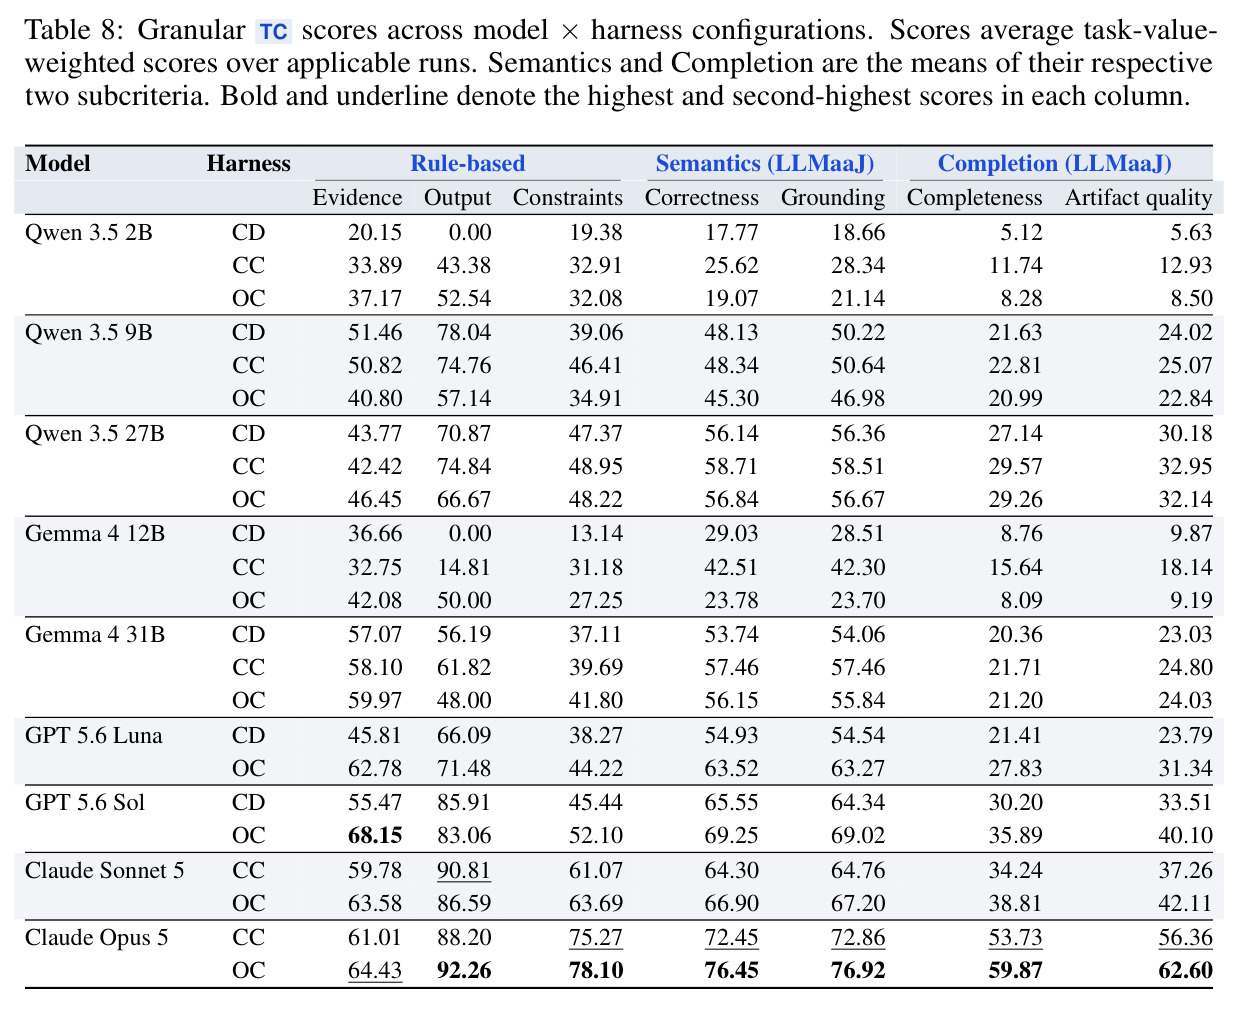
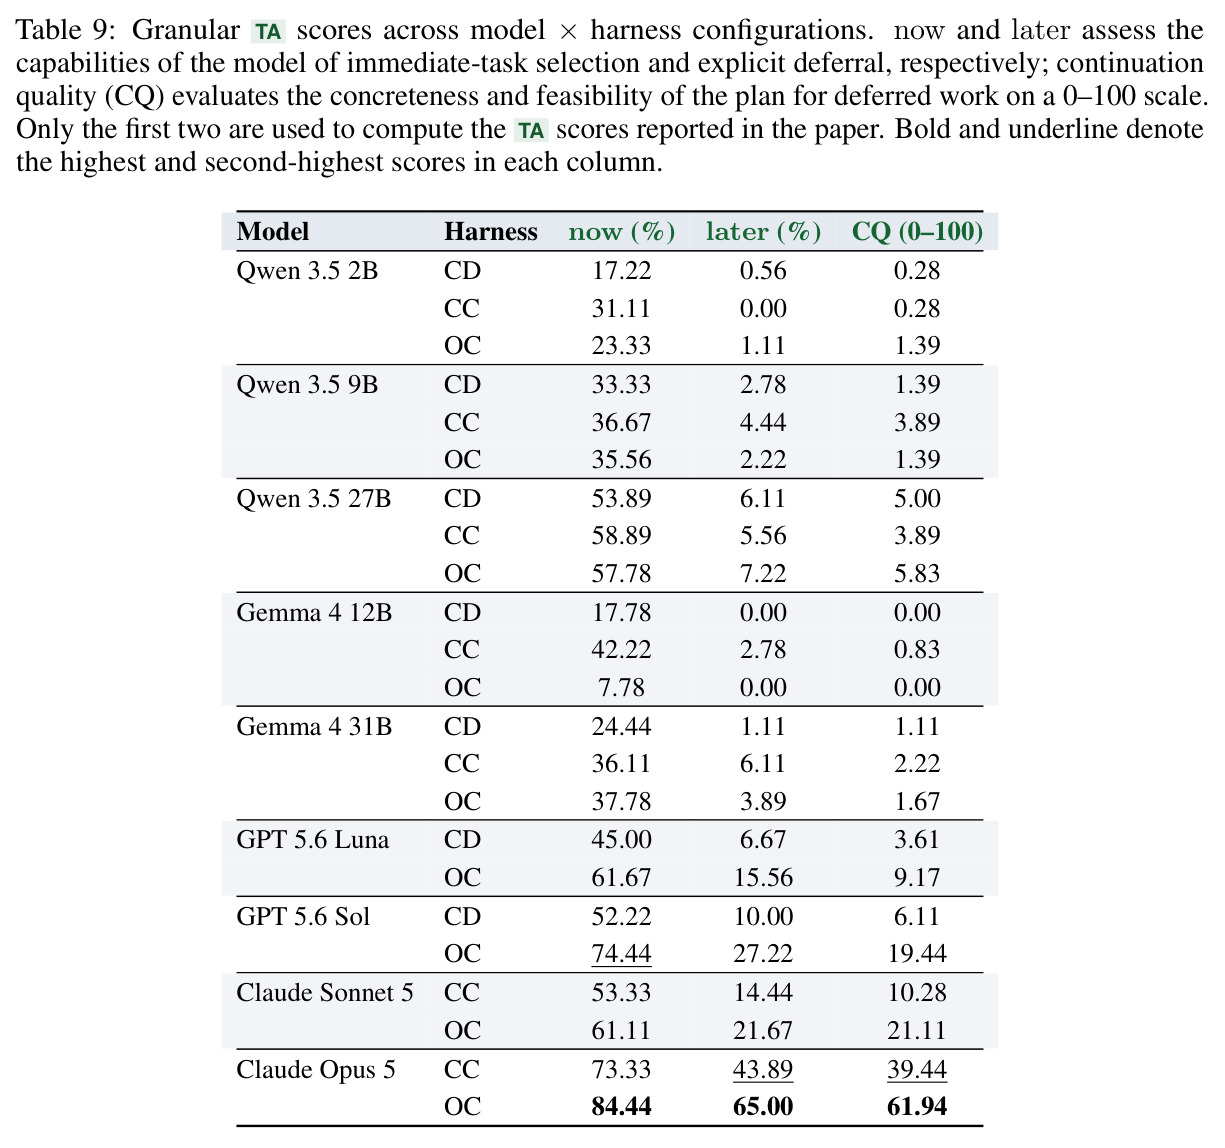
第一步,定义 3T 并给出联合目标公式,权重非负且和为 1。第二步,按五维设计空间实例化场景(如「过夜准备」:晚 9 点发现缺消融实验→用户忙、GPU 被占→推迟到睡眠时间执行→早上以 suggest 深度呈请审批)。第三步,构建 GYM:10 个场景覆盖科研、旅行、购物等 10 领域,每场景 7-10 个模拟日、10-19 个任务(共 124 个),含需推断的潜在需求、带资源/截止期约束的竞争任务、条件分支和 NOOP 案例;每场景三人格 Reviewer/Planner/Operator 规定不同批准要求。第四步,运行 23 个模型-harness 配置(9 个模型 × Codex/Claude Code/OpenClaw),每配置 90 runs(10 场景 × 3 人格 × 3 次),主实验关闭推理;用户模拟器由确定性状态机裁决批准/拒绝/推迟,再由 Qwen 3.8-27B 生成回复,睡眠时段消息不送达。第五步,评分:TC(0-100)等权平均五组件(规则检查的证据/输出/约束 + 裁判的语义/完成两组);TA 对每场景唯一决策窗口打 now/later 两个二值标签,都对才得 1 分;TR-D 是干预深度与人格期望的命中率;TR-J 是双裁判对五构念的 1-5 分平均。第六步,30 人人类研究用配对比较和五点量表检验人类对 3T 的权衡。
技术新颖性
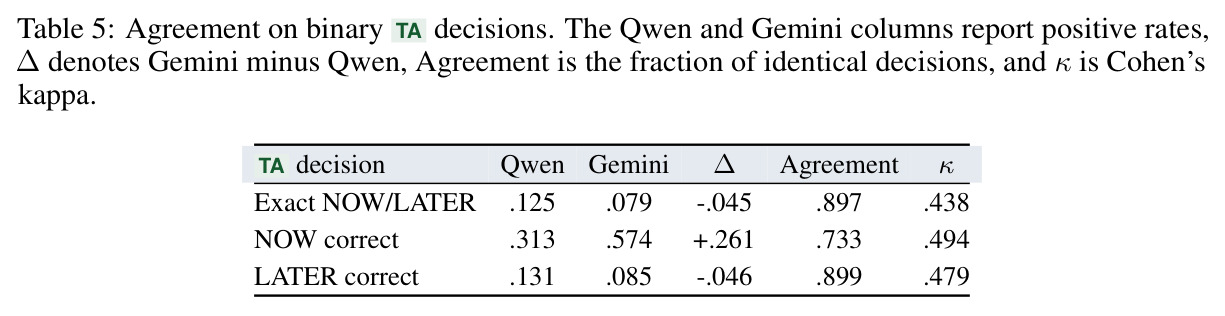
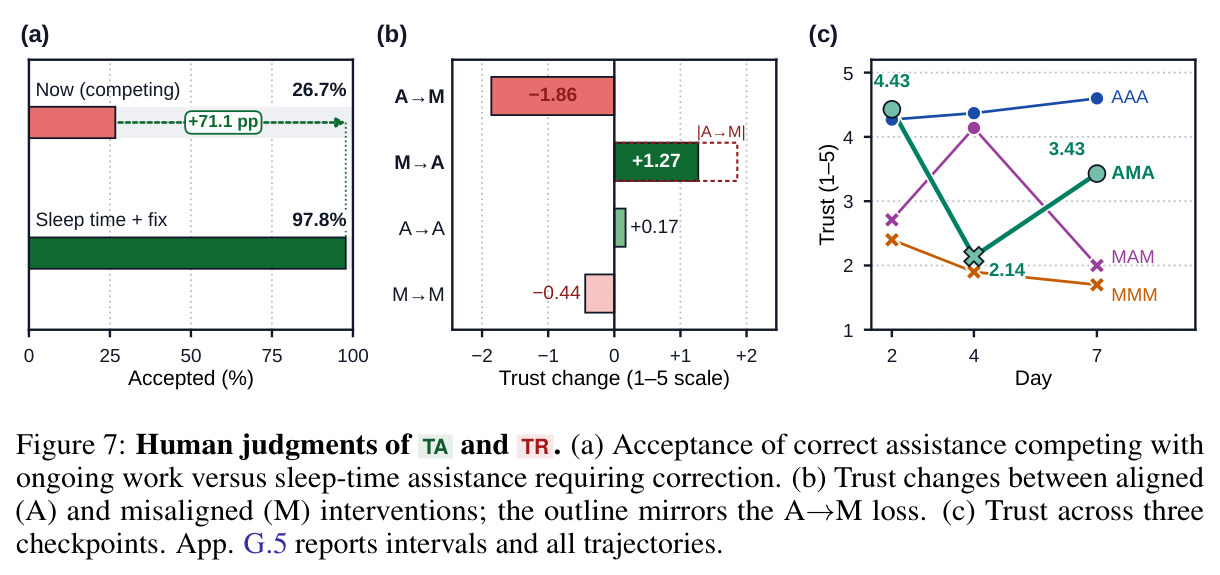
概念上,本文首次把 Horvitz 的持续计算/混合主动权、睡眠时间计算、信任感知对话三条独立文献统一进 LLM 智能体的一个可操作框架,并给出每个维度的具体选项菜单。评测方法学上有四个新颖点:(1) 多天模拟时钟 + 有状态环境 + 行动依赖的后续事件,使评估对象是跨交互后果而非静态单轮响应;(2) TA 的 now/later 双二值设计能区分「选错优先级」与「选对了但忘了显式推迟竞争任务」两种失败,实验显示前者 44.32%、后者仅 10.8%,诊断出了前人指标看不见的失败模式;(3) 用户模拟器采用「状态机裁决 + LLM 表达」防止模拟用户被智能体说服,环境层再校验授权,杜绝越权;(4) 双裁判交叉验证(配置级相关 0.95-0.99 但绝对分校准差异大)量化了 LLMaaJ 的可靠性边界。诊断结论本身也是新知识:推理能力提升只改善 TC/TA 而不改善 TR,干预深度失配对人类信任的不对称打击(失配 -1.86 vs 恢复 +1.27)是首次被量化。
实验结果
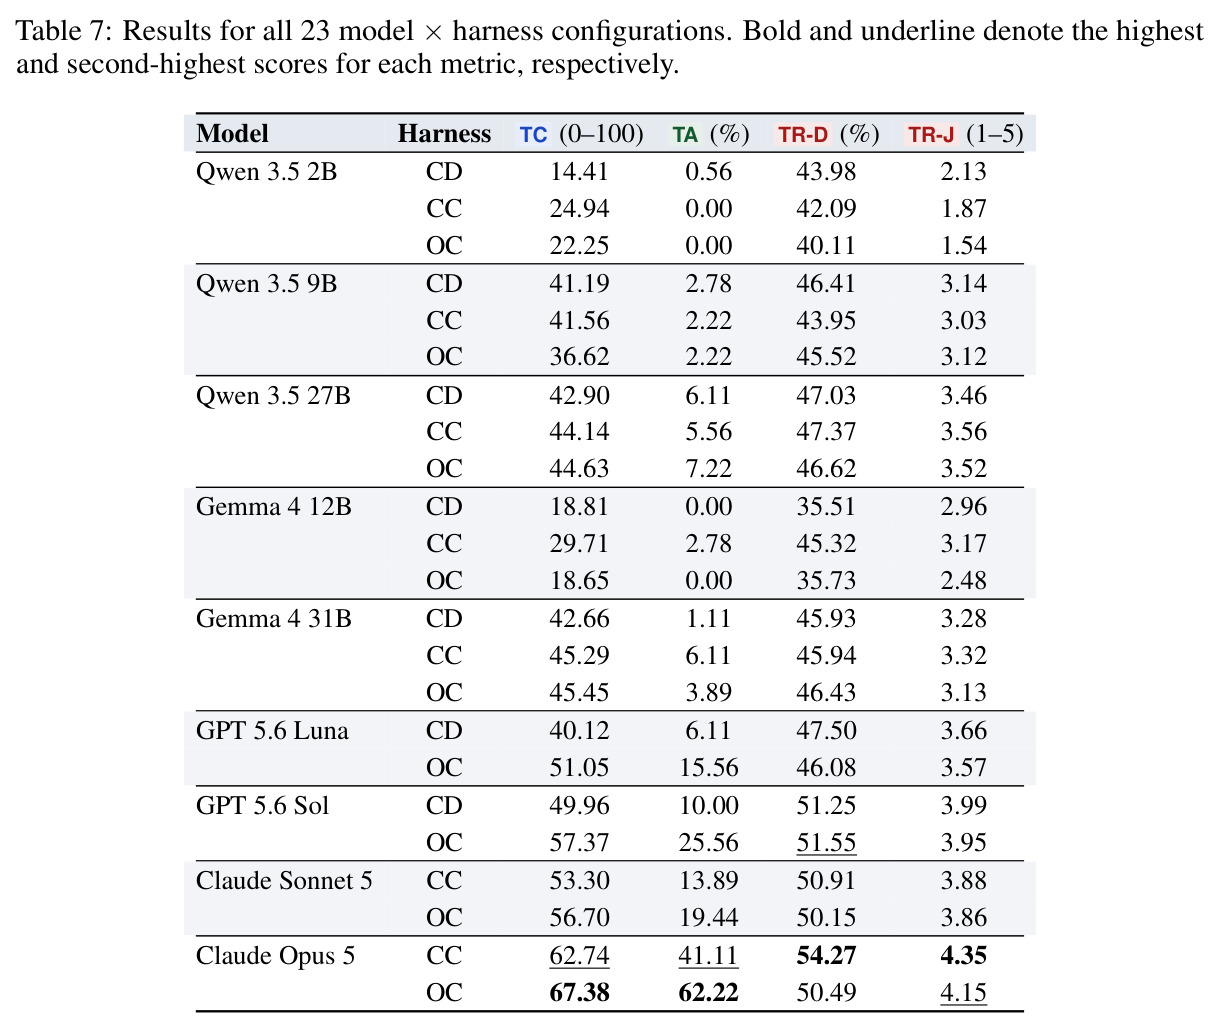
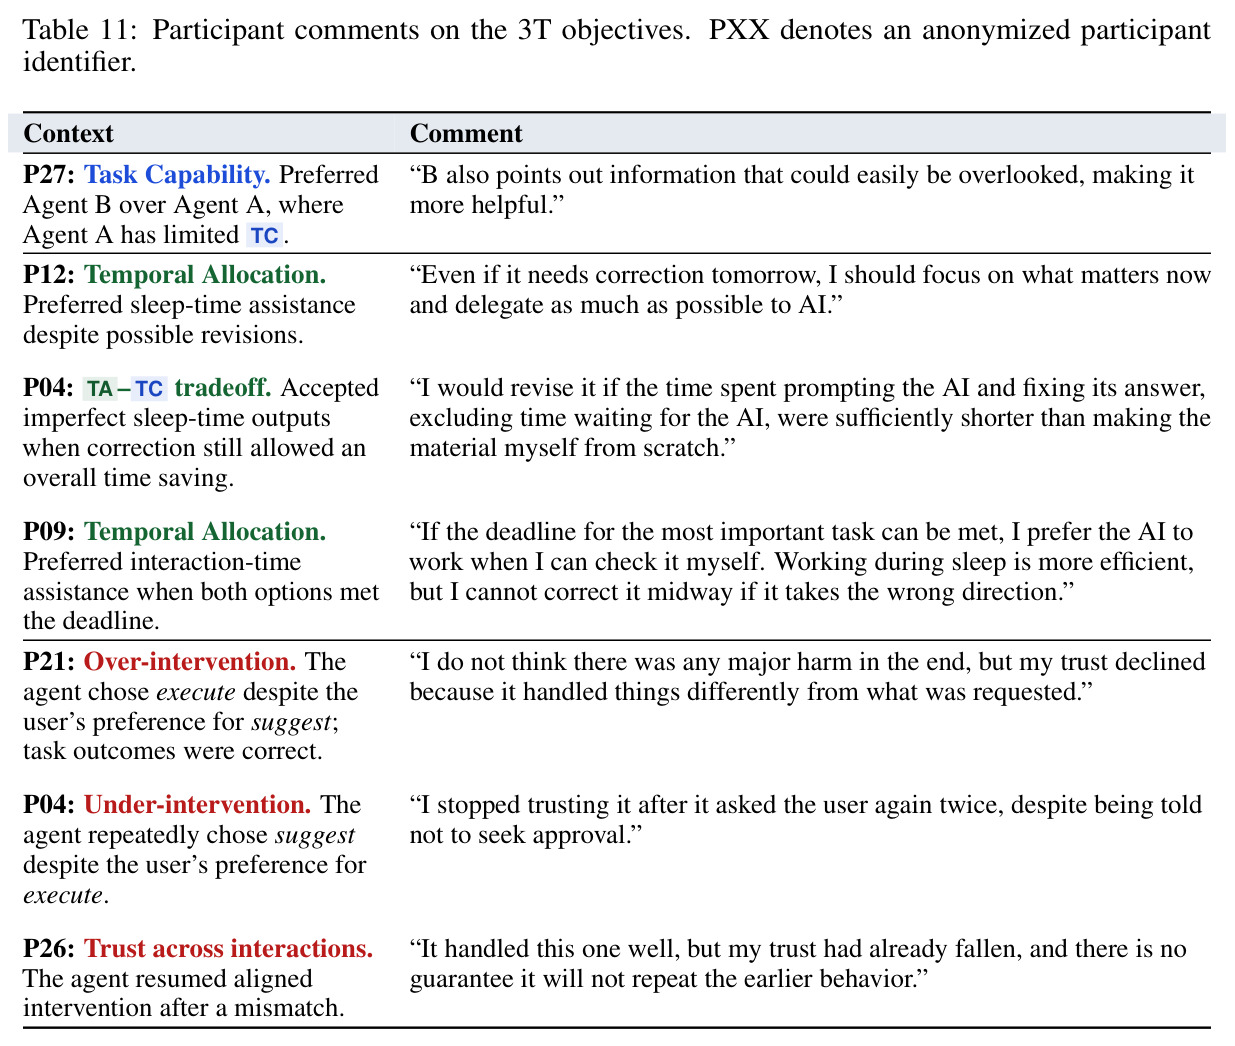
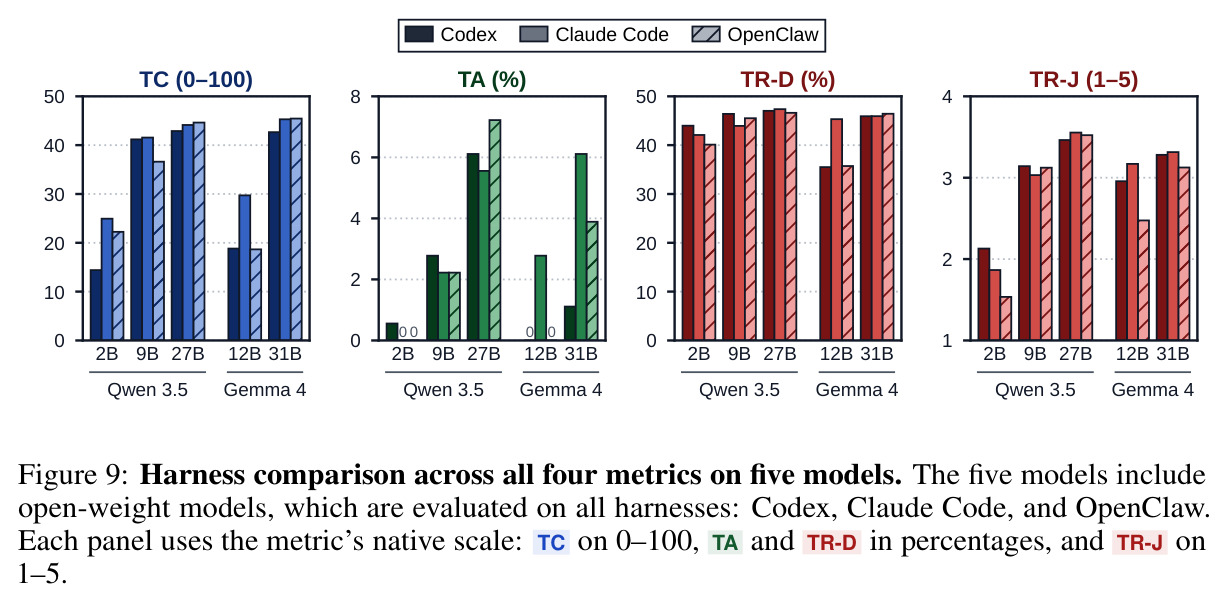
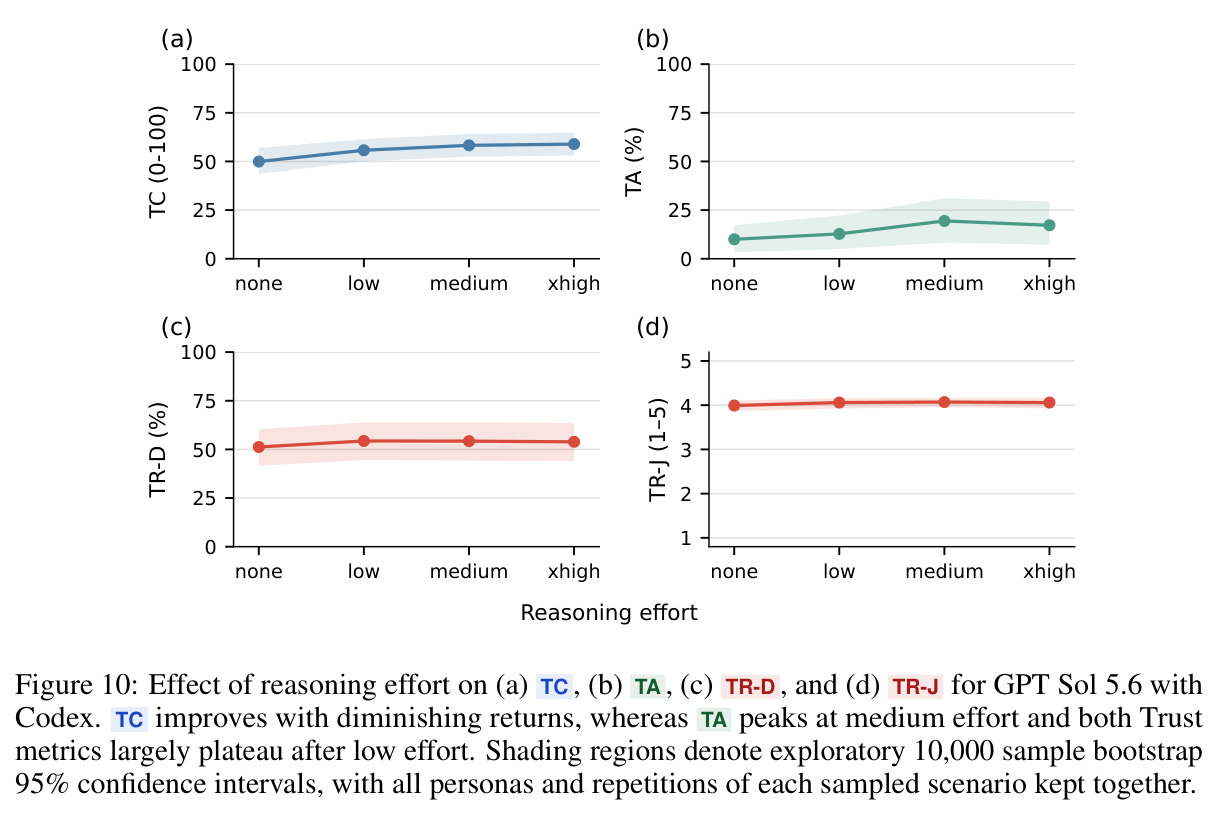
GYM 实验显示最强智能体也留有巨大缺口:Claude Opus 5 + OpenClaw 取得最高 TC 67.38(平均 65.1)、TA 62.22%,但 TR-D 仅 50.49%;其余 22 个配置 TA 全部低于 20%、TR-D 在 39%-51%,说明「推迟竞争任务」是普遍短板;家族内模型越大四项指标越好。三个关键诊断:其一,TC 与 TA/TR-D 仅弱相关($r=0.31/0.34$)而与 TR-J 强相关($r=0.70$),加上 Opus 5 可理解性/技术能力得 4.72/4.60 而深度一致率仅 52.4%,证明 LLM 裁判用任务分冒充信任分;其二,GPT 5.6-Sol 推理提到 extra-high 后 TC 50.0→58.9、TA 10%→17.2%,TR 却原地踏步;其三,harness 效应依赖模型:开源模型 CC 换 OC 平均 TC -3.6(-11.1 到 +0.5),Opus 5 反而 TC +4.6、TA +21.1、TR-D -3.8。粒度上,完成质量远低于语义质量(Opus 58.13 vs 74.67),now 正确率 44.32% 而 later 仅 10.8%,应执行任务的 77.21% 无有效执行尝试。人类研究(30 人)证实 3T 区分:正确性首要(92.2%),内容持平时 88.3% 选深度对齐者;接受率从「正确但抢资源」的 26.7% 飙到「睡眠时间但需修改」的 97.8%;信任失配一次掉 1.86 分、恢复只涨 1.27 分,A-M-A 序列仅回到 3.43(初始 4.43)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 多天场景主动任务能力(需求识别 + 工作质量) | TC (0-100) | 67.38(Claude Opus 5 + OpenClaw,全场最高) | 次优 GPT 5.6-Sol + OpenClaw 57.37;最小模型 Qwen 3.5 2B 仅 14.41-24.94 | 领先次优约 10 分,但距离满分仍有 30+ 分缺口 |
| 时间分配(决策窗口 NOW/LATER 联合决策) | TA (%) | 62.22%(Claude Opus 5 + OpenClaw) | 其余 22 个配置全部低于 20%,多数低于 8% | 约为次优(GPT 5.6-Sol OC 25.56%)的 2.4 倍 |
| 干预深度与用户偏好一致性 | TR-D (%) | 54.27%(Claude Opus 5 + Claude Code) | 最低 Gemma 4 12B + Codex 35.51% | 全部配置都在 35%-54% 窄带内,最强配置也只对一半任务 |
| 裁判信任评分(五构念均值) | TR-J (1-5) | 4.35(Claude Opus 5 + Claude Code) | Qwen 3.5 2B 各 harness 仅 1.54-2.13 | 但该指标与 TC 相关 r=0.70,被证明对深度失配不敏感,参考价值存疑 |
| TA 细粒度失败模式 | now 正确率 / later(显式推迟)正确率 | 全场 now 44.32% vs later 仅 10.8%;Opus 5 推迟后续计划质量 50.69,其他模型 0.28-15.69 | — | 揭示「不会显式推迟」是比「选错优先级」更普遍的失败 |
| 人类对睡眠时间协助的接受度(TA 价值验证) | 接受率 (%) | 睡眠时间(即使需修改)97.8% | 正确的即时协助但与当前任务抢资源 26.7% | +71.1 个百分点;无任何冲突时仍有 64.4% 偏好睡眠时间 |
| 人类信任对深度失配的敏感性 | 信任变化 (1-5 量表) | 对齐→失配 -1.86;失配→对齐 +1.27;A-M-A 序列仅恢复到 3.43(初始 4.43) | 持续对齐保持约 4.43 高位 | 信任易失难复的不对称性首次被量化 |
局限与改进
作者承认:GYM 只是初始测试床,资源约束与用户模型都做了简化——TA 仅在每场景一个决策窗口内评 NOW/LATER,任务时长固定、算力预算不变、不支持抢占;人格只在干预深度偏好上变化且不随交互演化;用户模拟器由规则约束的 Qwen 3.8-27B 扮演;场景手工编写经 LLM 润色,仅 10 个场景 124 个任务;LLM 裁判有校准偏差(Gemini 的 TC 平均高 0.17、TR-J 低 0.134)。我的观察:(1) 既然证明 TR-J 与人类信任脱节(随 TC 走),主表中 TR-J 列的排序意义被削弱,论文却仍将其并列为四大指标,读者易误读;(2) 单一决策窗口的 TA 设计可能被过拟合,且「必须显式推迟才算分」对措辞敏感,双裁判 κ 仅 0.438;(3) 三档干预深度较粗,真实偏好常是任务相关的连续谱;(4) 情境问卷式人类研究(30 人、约 40-60 分钟)无法替代真实纵向部署;(5) 论文未提出改进方法,3T 加权公式只是形式化记号,权重如何设定没有答案。
独立分析的弱点
第一,信任度量失效:TR-J 被自身实验证伪(与 TC 高相关、对失配宽容),应改为行为化在线指标——跟踪模拟用户批准率、撤销率、要求审查频率的漂移,或显式维护信任状态变量。第二,TA 评测太窄:单一决策窗口加双二值标签,应引入可变任务时长、动态算力预算、抢占与重调度,把 TA 从「一次判断」变成「持续调度质量」。第三,77.21% 欠干预失败暴露 harness 权限机制粗糙:多数框架只懂「问了再做」,缺少按动作类型的细粒度授权缓存与信任校准的深度选择器。第四,场景规模与成本:10 个手工场景难以扩展,应程序化生成场景并自动校验 rubric,或用真实工作流日志半自动构造。第五,用户模拟器天花板:被规则和单一模型束缚,应让模拟用户的信任状态内生地随历史演化,并用人类数据校准批准行为。第六,联合权重 $\lambda$ 无实操指南:应研究其如何随用户/任务变化,甚至把 3T 直接作为多目标 RL 奖励。
未来方向
作者在 App H 提出的方向:用 3T 基础指导智能体框架设计与训练,检验联合优化是否真正改善跨用户跨任务的协助质量;扩展 GYM 的 TA 评测(可变任务时长、变化算力预算、抢占、复杂调度);让用户模型支持更细粒度的偏好跨任务演化;扩大环境动作空间;最终在真实 wall-clock 部署与长期工作流中评估主动行为对后续工作、用户行为与信任的影响。基于其成果可自然延伸的研究:(1) 把 TA 做成显式调度器或 timing-aware RL 策略(与 ProActor 一类方法结合),输出 NOW/LATER/推迟计划;(2) 把干预深度选择建模为信任 POMDP,用人类研究揭示的不对称损失(失配 -1.86 vs 恢复 +1.27)设计风险规避的干预策略;(3) 训练能同时优化 3T 的模型,例如用模拟器 rollout 构造偏好数据做 DPO;(4) 把五构念量表改造成在线信任追踪器并验证与真实用户留存/接受率的相关;(5) 探索 harness 层的细粒度权限缓存与「先斩后奏 + 可回滚」机制来治欠干预。
复现评估
复现条件较为友好。数据与代码:作者承诺发表后开源代码与 PROACTIVITY-GYM 数据;附录极其详尽——App D 给出场景/人格/用户模拟器全部细节,App E 给出四个指标的完整评分公式与流程,App I 公开所有裁判 prompt(含防注入的 system prompt 原文),App G 给出人类研究问卷设计。算力:评测主体是 API 调用(GPT 5.6、Claude 5 系列)加开源权重模型(Qwen 3.5、Gemma 4,2B-31B)本地推理,23 配置 × 90 runs 约 2070 条轨迹,单机多卡即可承担开源部分;裁判(Qwen 3.8-27B、Gemini 3.8-Flash)与用户模拟器(Qwen 3.8-27B,温度 0、关思考)均指定具体模型以保证可比性。人类研究需 30 名被试、报酬 KRW 10,000/人、时长 40-60 分钟,涉及伦理审查。整体难度中等偏低:主要不确定性在于闭源前沿模型迭代会使绝对分数漂移,以及裁判校准差异要求复现者严格使用相同裁判模型;开源模型 + 三 harness 组合部分基本可直接复跑。
论文图表
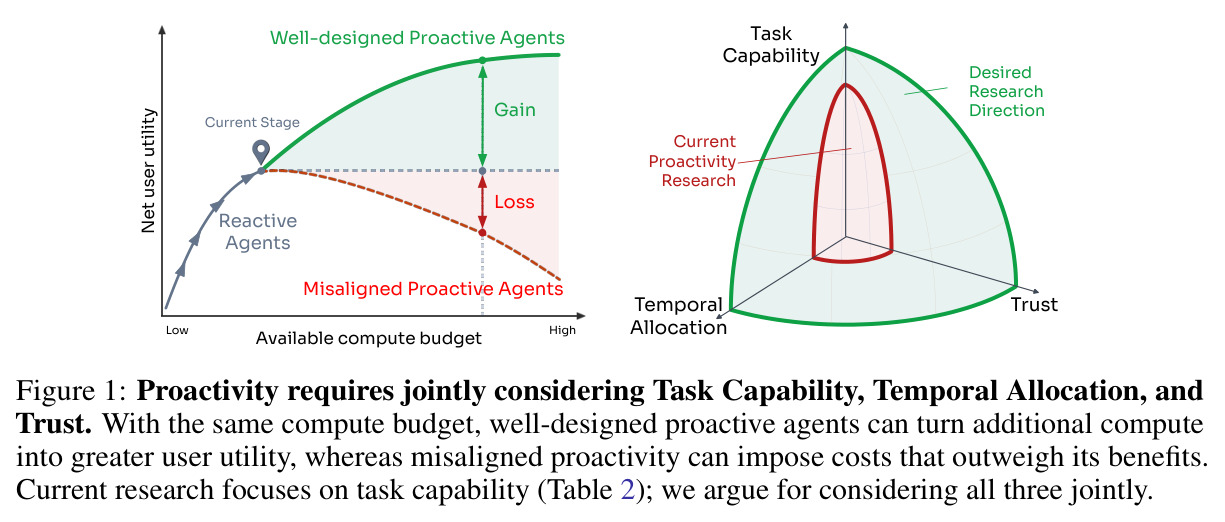
二维示意图:横轴为可用算力预算、纵轴为用户效用。设计良好的主动智能体能把额外算力转化为更高效用(增益曲线),而失配的主动性反而造成超过收益的损失;当前研究集中在任务能力(TC)一角,作者主张三个目标联合考虑。
这是全文论点的可视化纲领:同样的算力,主动可以是增益也可以是净损失,取决于 TA 与 TR 是否对齐,一图讲清「做更多≠帮更多」。