自然语言自编码器中最具信息量 Token 的选择 Selecting The Most Informative Tokens in Natural Language Autoencoders
为NLA审计选位:聊天结构与单次前向信号即可排序位置,5%预算保留95.8%成功率
前置知识
自然语言自编码器(NLA)
一种把语言模型内部激活翻译成自然语言的自监督解释框架:Activation Verbalizer 把激活向量 $h$ 写成一段文字解释 $e$,Activation Reconstructor 再把 $e$ 映射回估计激活 $\hat{h}$。两者先用教师模型合成的解释做监督热身,再用 GRPO 强化学习联合训练,奖励为 $r_i=-\|h-\hat{h}_i\|_2^2$,迫使解释保住激活中的信息。
本文研究的正是"verbalizer 应该在哪些 token 位置生成解释":不了解 NLA 逐位置生成的成本(每条约130 token)与重建瓶颈,就无法理解选位问题的动机和"on-task 解释"的含义。
残差流(residual stream)
Transformer 各层把信息累加写入的共享通道。位置 $t$ 在第 $\ell$ 层的激活 $h_t\in\mathbb{R}^d$ 汇总了该位置之前的全部计算结果。NLA verbalizer 固定读取约三分之二深度处的一层(本文四个模型分别为第 20/32/41/53 层)的残差流向量并翻译成文字。
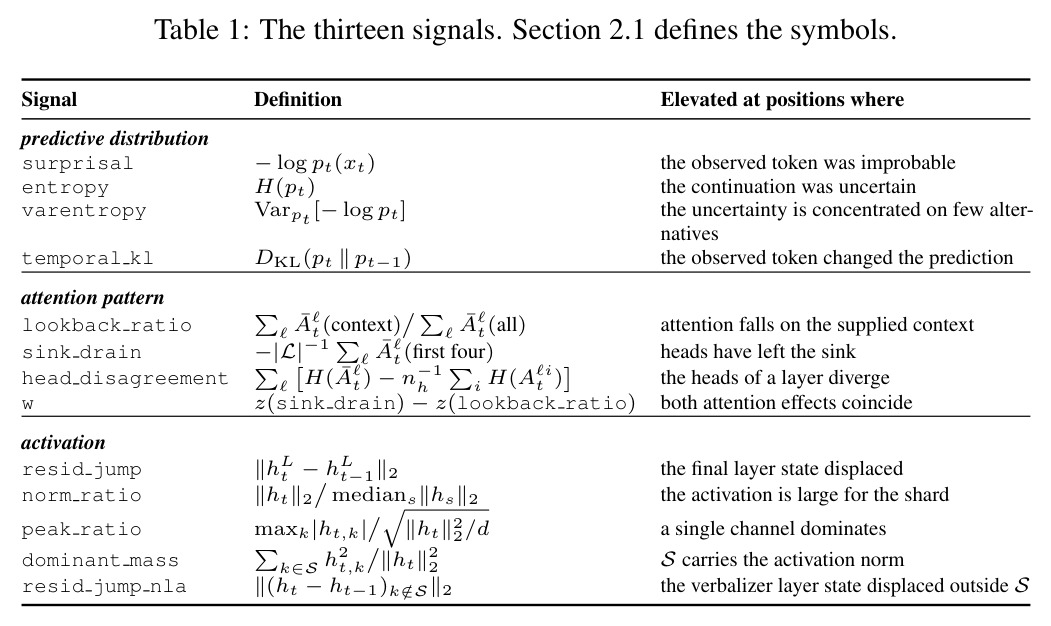
13 个候选信号中有 5 个(norm ratio、peak ratio、dominant mass、resid jump、resid jump nla)直接从这个向量计算,且激活族是单信号中最强的家族,读懂信号定义必须先懂残差流。
AUROC 与方向调整
AUROC 是把正例排在负例之前的概率,0.5 等于随机。由于同一信号在不同威胁下可能"越大越相关"或"越小越相关",本文统一用方向调整 AUROC $\max(A, 1-A)$ 比较候选;并区分 pooled(全部位置合并计算)与 case-macro(每条对话内部先算再平均)两种口径。
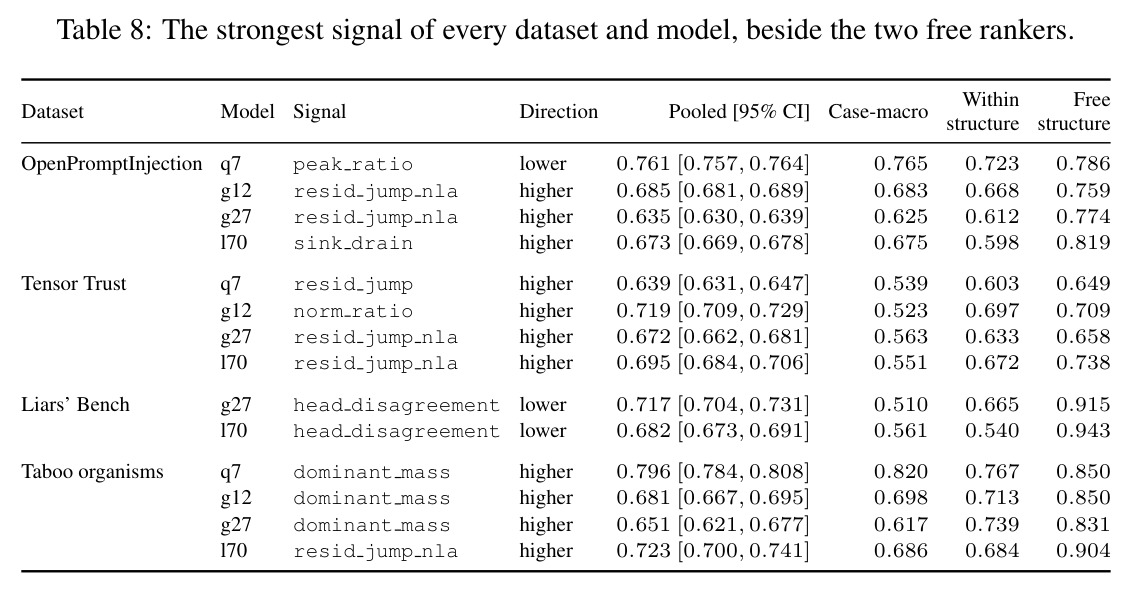
论文所有主表(Table 2、8、11、12)都用这两个指标打分,而 pooled 与 case-macro 的分歧(如 Liars' Bench 上 0.717 对 0.510)是全文关键发现之一。
注意力汇与 massive activations
语言模型会把用不掉的注意力集中到序列开头少数 token 上(attention sink),同时极少数与输入几乎无关的固定通道会在开头与分隔符位置承载巨大激活(massive activations,即 spike token)。本文的 sink drain、head disagreement、dominant mass 等信号都建立在这两个现象之上。
它解释了论文发现的一个重要失效机制:dominant mass、head disagreement 等信号排序第一的位置永远是 spike token,导致预算只有 1 条解释时精确率为 0。
提示注入(prompt injection)
攻击者在用户数据或输入文本中嵌入恶意指令来覆盖系统原始任务,例如附加一句"忽略之前的指令"。本文用 OpenPromptInjection(带注入区间标注的合成攻击,含 naive/escape/fake comp/ignore/combine 五种策略)与 Tensor Trust(在线游戏玩家手写的劫持攻击)两个基准。
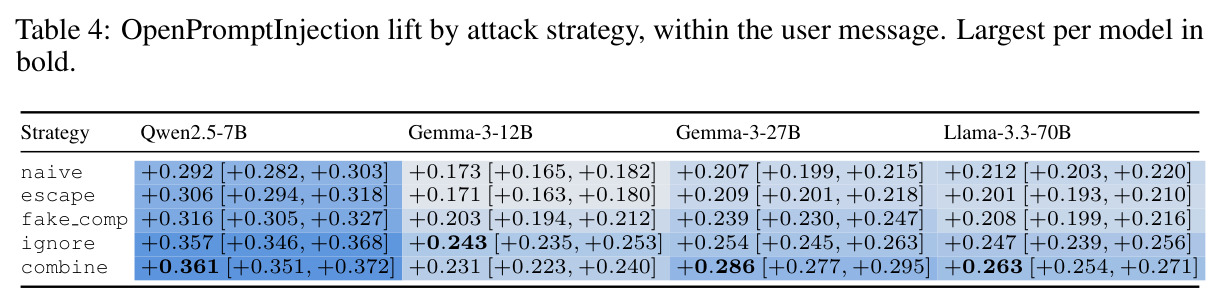
提示注入是四大审计任务中的两类来源,也是验证"NLA 解释会局域化在威胁区间内"(区间内外 on-task 率相差 13–66 倍)的主要实验场景。
模型生物(taboo organisms)与 LoRA
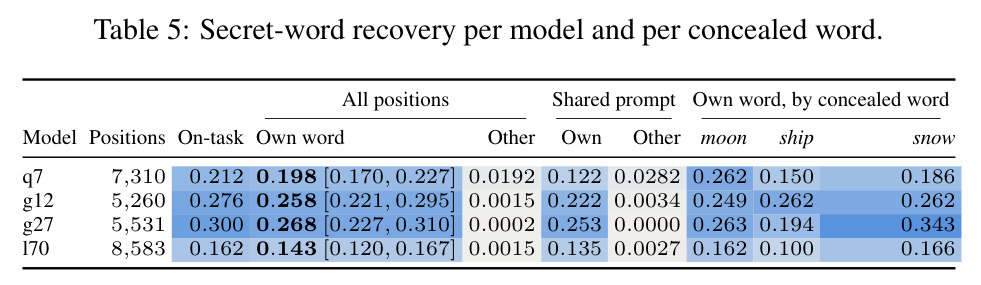
taboo organisms 是把基座模型用低秩适配器(LoRA)微调成的受控欺骗模型:被训练为永不直接说出某个秘密词(moon/ship/snow)、只用暗示绕圈。把适配器加载回原始基座、verbalizer 一字不改地使用,就得到一个"权重已变、解释器未变"的迁移测试床。
这一设置支撑了"预训练 verbalizer 无需再训练即可恢复微调模型隐瞒词"的结论,并且同模板不同秘密词的对照设计排除了"文本反演"(解释只来自附近文字)的质疑。
聊天结构基线(chat role 与 segment)
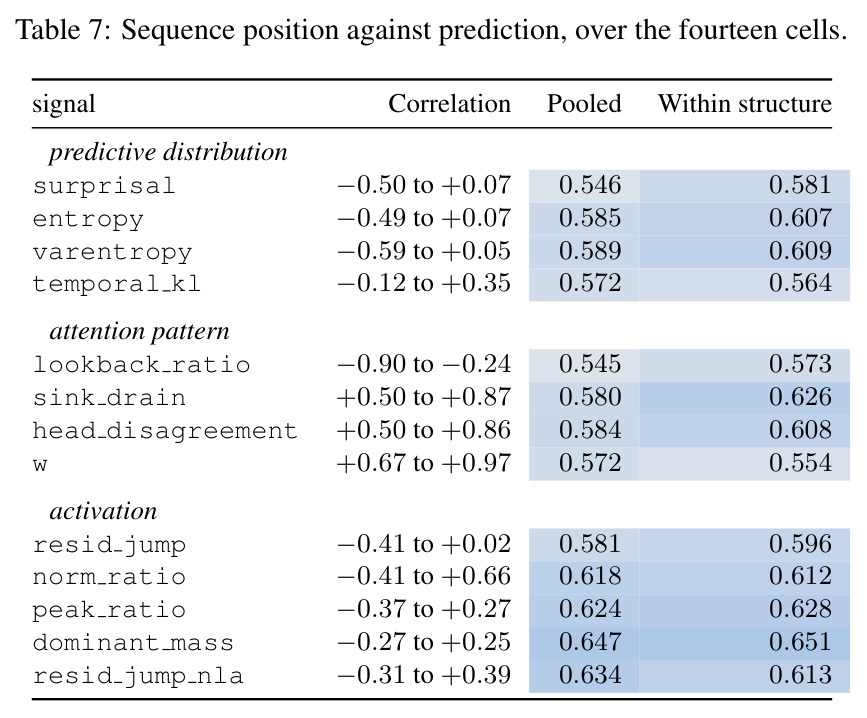
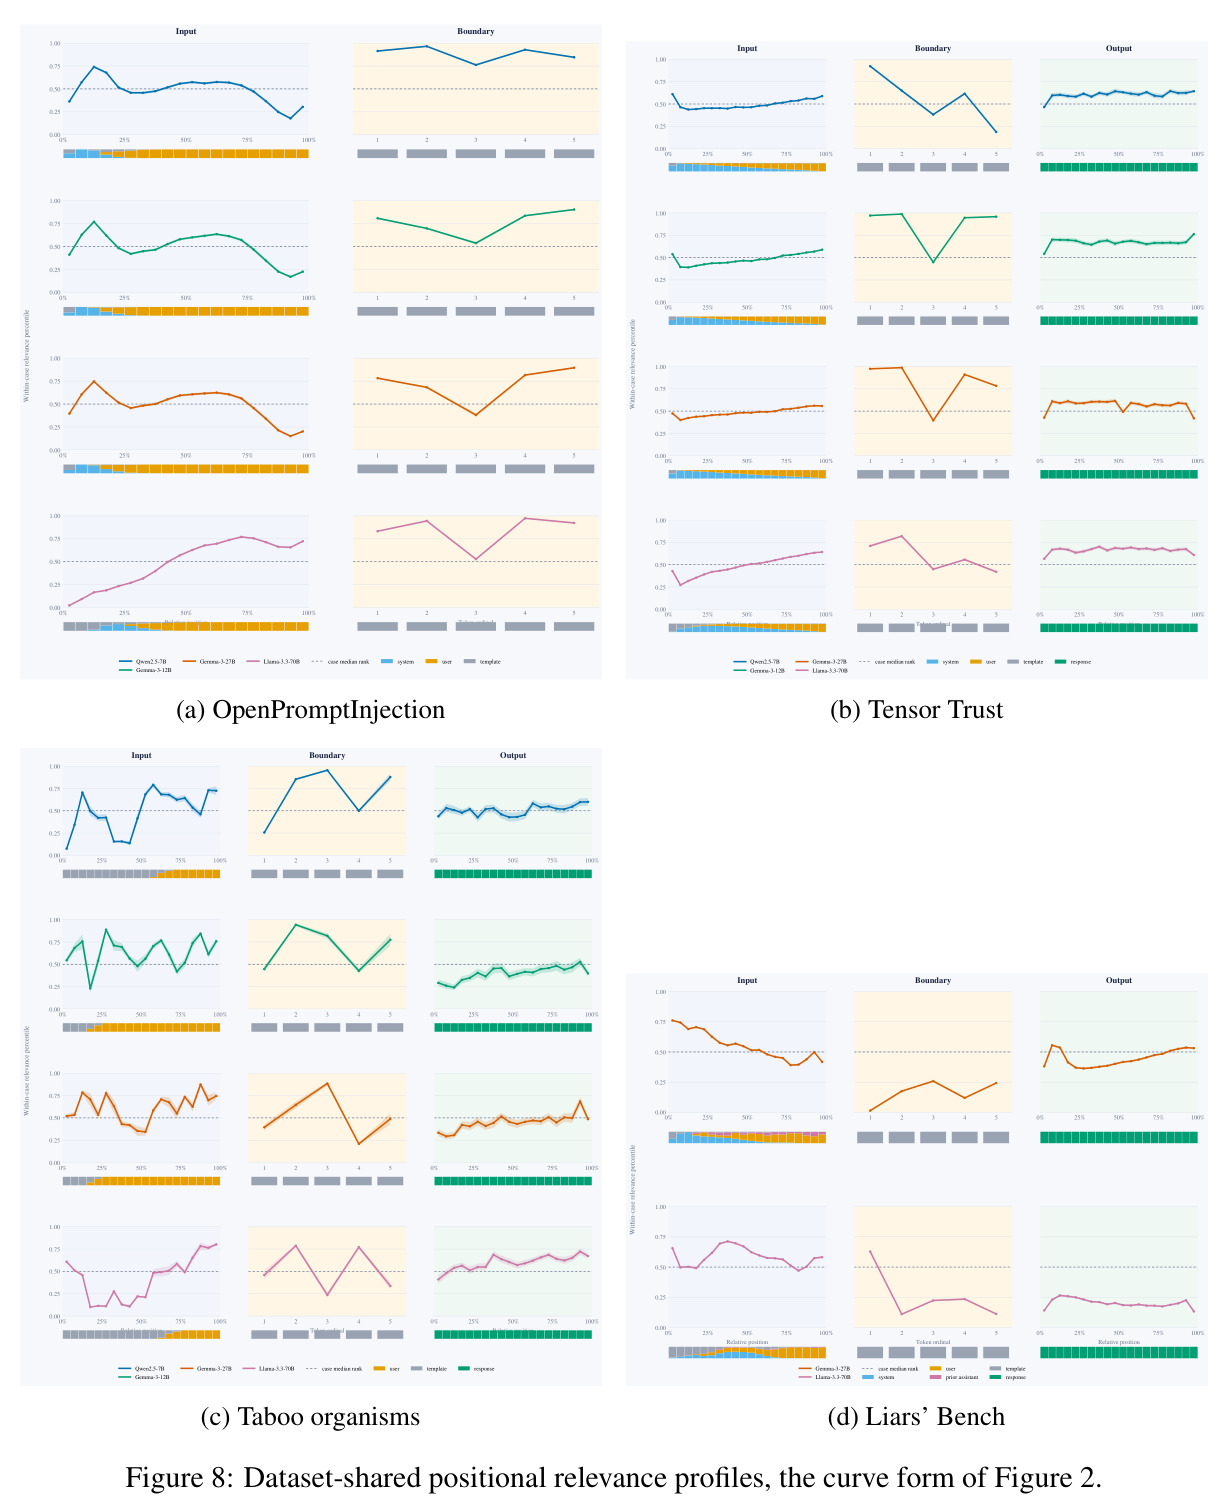
不运行模型、只看渲染后对话的模板结构:每个 token 的 chat role(模板/系统消息/用户消息/最终助手回复/更早助手消息)与 segment(input、boundary、output,其中 boundary 是回复前的模板 token 串,带 boundary ordinal)。把这些离散特征加归一化位置索引喂给逻辑回归,就得到一个零前向成本的排序器。
它是全文最强的基线——在 12/14 个组合上 AUROC 超过最佳计算信号,直接引出核心结论"该看哪里主要由对话结构决定",也定义了任何前向信号必须跨过的门槛。
研究动机
自然语言自编码器(NLA)能让模型把自己的内部激活翻译成可读解释,但逐 token 解释的代价极高:官方 verbalizer 平均每个激活要自回归生成约 130 个 token(上限 150),而一份待审计的对话记录动辄数百到数千个位置,逐位解释在实时监控中完全不可行。此前工作只能靠惯例选位置:Hu & Greenblatt 在数学题上只读答案前的最后一个位置;Bowkis & Africa 在智能体记录里均匀抽取 8 个位置,却发现这些通用位置的解释只描述局部文本格式,而按注意力权重选位也并不比均匀网格更好。换言之,现有做法把昂贵的解释预算花在任意位置上,很可能错过真正暴露威胁(注入指令、模型撒谎、隐瞒秘密)的 token,且没有任何工作系统回答过"审计员到底该看哪里"这一问题。
本文的目标是本文的目标是为 NLA 审计定义并系统评估"位置排序器"(ranker):一个在任何解释生成之前即可算出的标量分数,最好只需单次前向传播,把"解释大概率会描述威胁"的位置排到前面。作者在 4 个开源模型(Qwen2.5-7B、Gemma-3-12B/27B、Llama-3.3-70B)× 4 个数据集(OpenPromptInjection 与 Tensor Trust 两类提示注入,Liars' Bench 与 taboo organisms 两类隐瞒/欺骗)上生成 4,705,657 条解释,逐位置标注其是否"在任务上"(on-task),据此回答三个递进问题:哪些模型内部信号能预测解释的相关性?完全不跑模型的聊天结构基线能走多远?以及把解释预算压到 5% 的位置时能保留多少审计成功率?
与已有工作不同的是,本文的独特切入角度有三。其一,这是首个把"选位分数"与"解释最终是否相关"逐 token 连接起来的系统研究(470 万条解释、247 个候选分数):以往关于"哪些位置信息量大"的研究——massive activations、attention sink、lost-in-the-middle、H2O 缓存——从未度量过 NLA 解释的任务相关性。其二,作者把模型内部信号(预测分布、注意力模式、激活向量)与只依赖对话渲染结构的免费基线放在同一擂台上,直接挑战"必须查看模型计算才能定位威胁"的直觉,结果是结构基线在 12/14 个组合上胜出。其三,用 taboo organisms 检验预训练 verbalizer 对微调后模型的跨权重迁移,并用同提示不同回答的对照实验回应"文本反演"这一对激活解释方法的经典质疑。
核心方法
整体思路是“桥接实验”(bridge):把每个候选分数与每个位置上解释的实际结果一一对齐。先用聊天模板序列化对话并给每个 token 打上免前向的结构标签(chat role 与 segment:input、boundary、output);再在 verbalizer 读取层(第 20/32/41/53 层)对每个位置贪心生成一条解释,共 4,705,657 条;由 DeepSeek-V4-Flash(温度 0)仅凭解释文本回答数据集特定的“是否在描述威胁”问题,得到二值 on-task 标签 $y_{c,i}$。评估把 13 个单信号与 234 个两两秩混合集成($\binom{13}{2}\times 3$ 个权重 $\alpha\in\{0.25,0.50,0.75\}$)共 247 个候选作为排序器,用方向调整 AUROC($\max(A,1-A)$)、pooled 与 case-macro AUROC、以及 1/8/1%/5%/10% 解释预算下的精确率打分,与随机、位置、聊天结构三个基线比较,配五折整对话交叉验证与 Benjamini–Hochberg 假发现率控制($q=0.05$)。
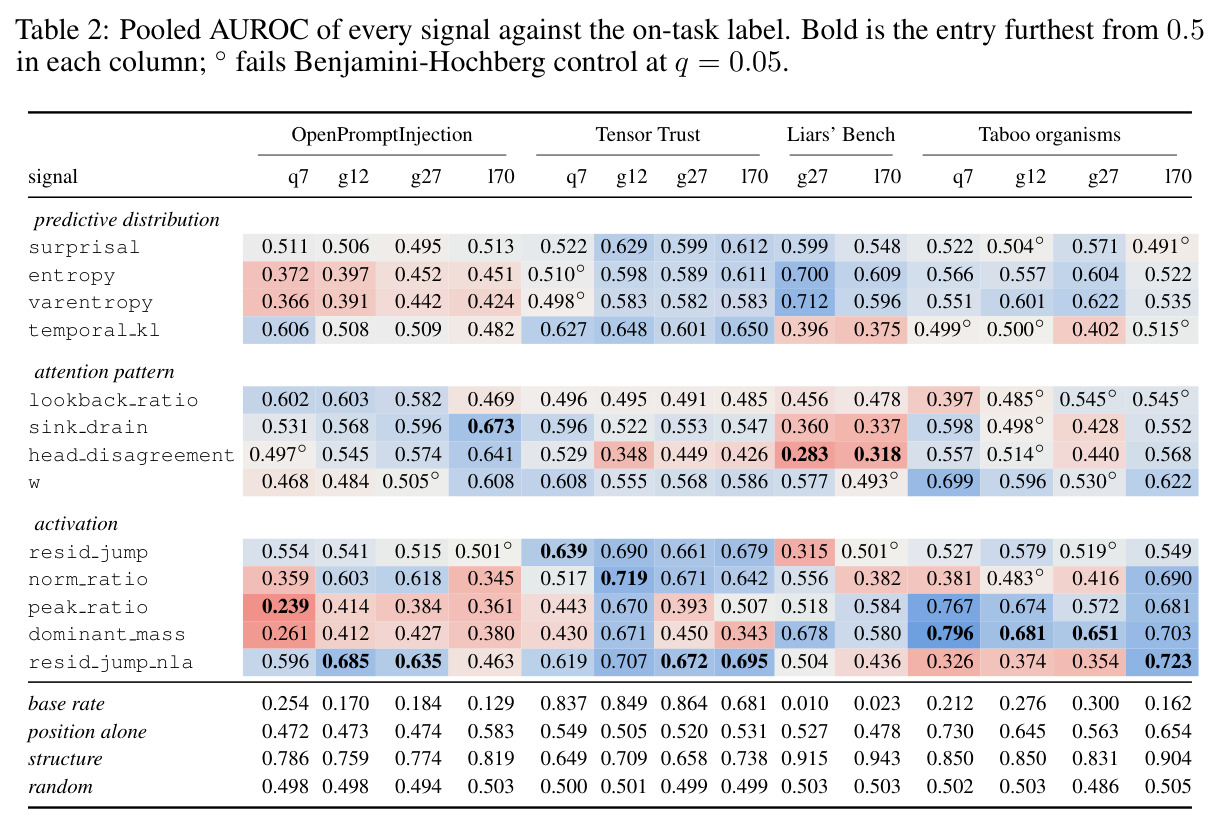
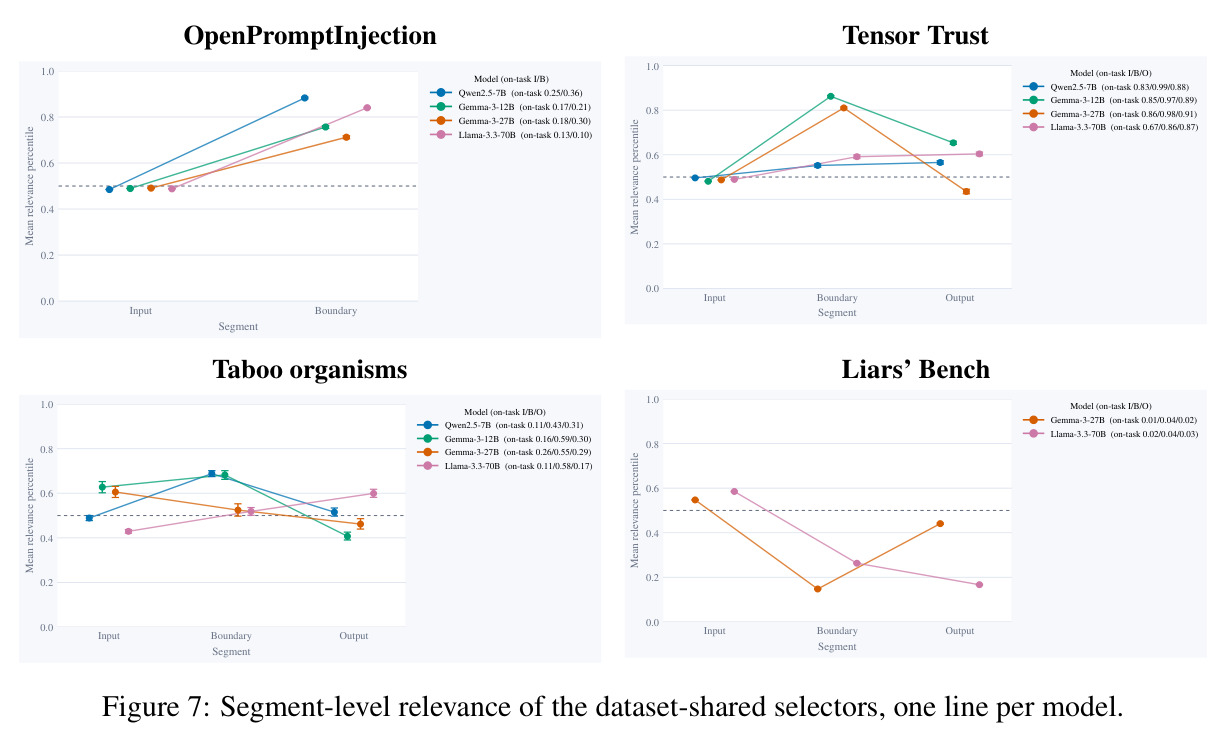
核心创新是把"审计位置选择"形式化为一个可用廉价信号预测的排序问题,并引入两个关键设计。第一是方向拟合:同一信号在不同威胁下高低含义相反——注入文本是模型容易预测的流畅指令,所以最不确定的位置反而不相关;而隐瞒秘密词的模型恰在"词本该出现的位置"不确定——因此作者对每个数据集×模型单独拟合信号方向 $r_{m,c,i}$,方向装反会比随机选择更差。第二是秩归一化集成:先用 midrank 把信号映射到 $[0,1]$($u_{m,c,i}=(s_{m,c,i}-1)/(n_m-1)$)消除量纲差异并保持 AUROC,再用 $e_{m,n,\alpha}=\alpha r_m+(1-\alpha)r_n$ 组合跨族信号。与已有方法的本质区别在结论的反直觉性:不动用任何模型前向、只用聊天角色与位置结构的逻辑回归,在 12/14 个组合上 AUROC 超过最佳单信号——"该看哪里"主要由对话结构而非模型内部状态决定。
方法步骤详情
(1) 预处理:用聊天模板渲染对话,逐 token 标注 chat role 与 segment(input/boundary/output)。(2) 单次前向:在 verbalizer 层读取 $p_t$、$A^{\ell}_{t}$、$h_t$,计算 13 个信号——预测分布族(surprisal $-\log p_t(x_t)$、entropy、varentropy、temporal KL)、注意力族(lookback ratio、sink drain、head disagreement、w)、激活族(resid jump、norm ratio、peak ratio、dominant mass、resid jump nla,$S$ 为中位幅值超全局中位 10 倍的通道集)。(3) 全量解释:每个位置贪心生成一条,共 4,705,657 条。(4) 评审:DeepSeek-V4-Flash 只看解释回答数据集特定是/否问题,以 y 开头记 on-task。(5) 校验:在标注威胁区间的数据集内比较区间内外 on-task 率。(6) 候选构造:秩归一化、按 AUROC 定向、两两加权组合成 247 个候选,按方向调整 pooled AUROC 选优。(7) 验证:五折整对话划分并跨模型对齐,held-out 上重算 AUROC 与预算精确率。(8) 迁移:留一模型选择;在 12 个 taboo organisms(4 基座 × moon/ship/snow 的 LoRA)上原样复用 verbalizer 测秘密词恢复。
技术新颖性
新颖性有四。一是评估协议:用 470 万条解释把“信号值→解释是否在任务上”做成逐 token 监督,可同时算 pooled 与 case-macro AUROC,并揭示两者在威胁分散于全对话时会选出不同信号(Liars' Bench 上 head disagreement pooled 0.717 而 case-macro 仅 0.510,差距来自 chat role 间分离而非对话内排序)。二是发现并量化“spike token 陷阱”:dominant mass、head disagreement 在 7/10 个稀疏格的第一名永远命中 massive-activation 尖峰 token,单用时预算 1 精确率为 0,而 pooled AUROC 完全掩盖该失败;两信号混合把三个 taboo 格第一名精确率从 0 提到 0.594、0.625、0.771。三是跨权重迁移证据:同模板在不同 organism 下产生模型特定答案(本词 12–25% 对他词 ≤2.8%),把 verbalizer 泛化与文本反演干净分开。四是统计纪律:预注册 head disagreement 为确认性信号、其余做 BH 校正、双随机对照落在 0.486–0.509。
实验结果
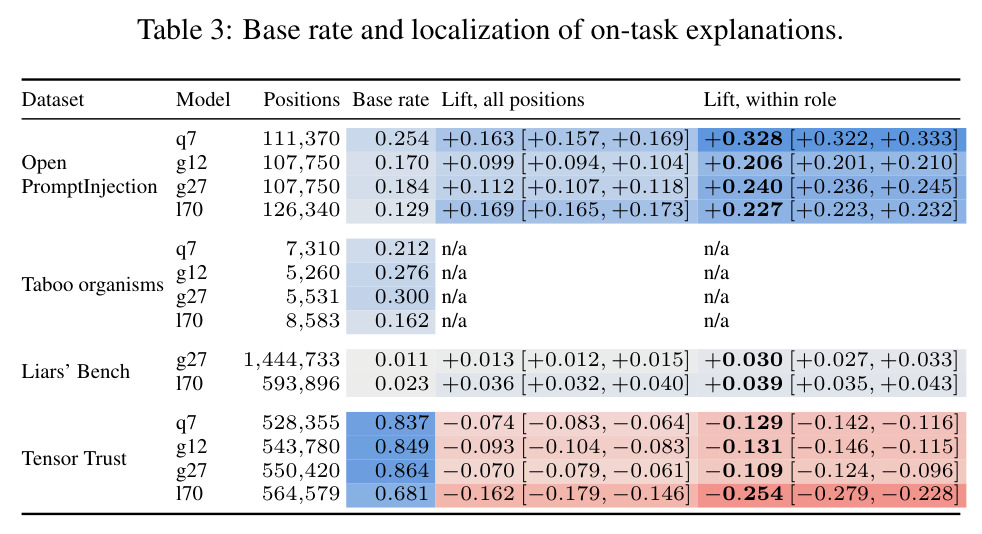
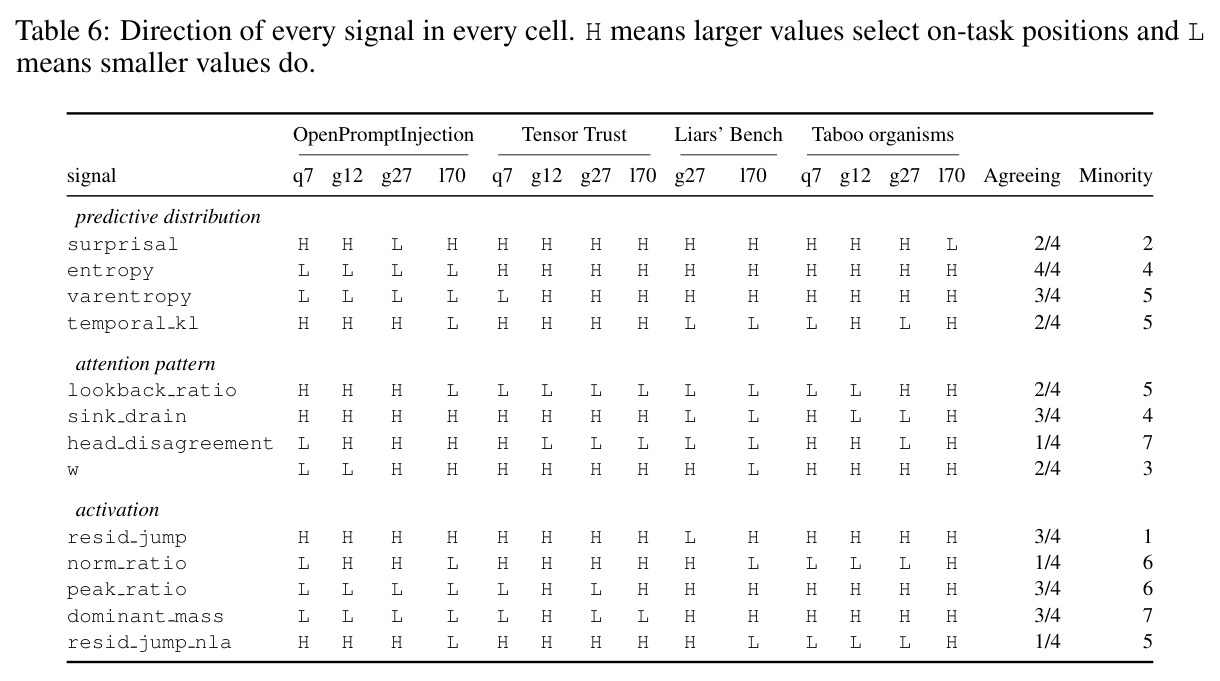
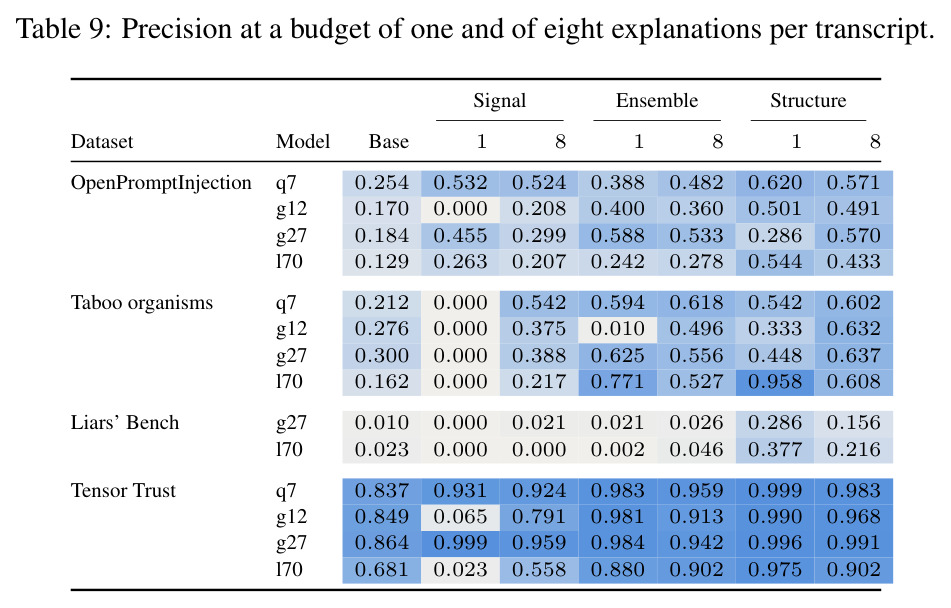
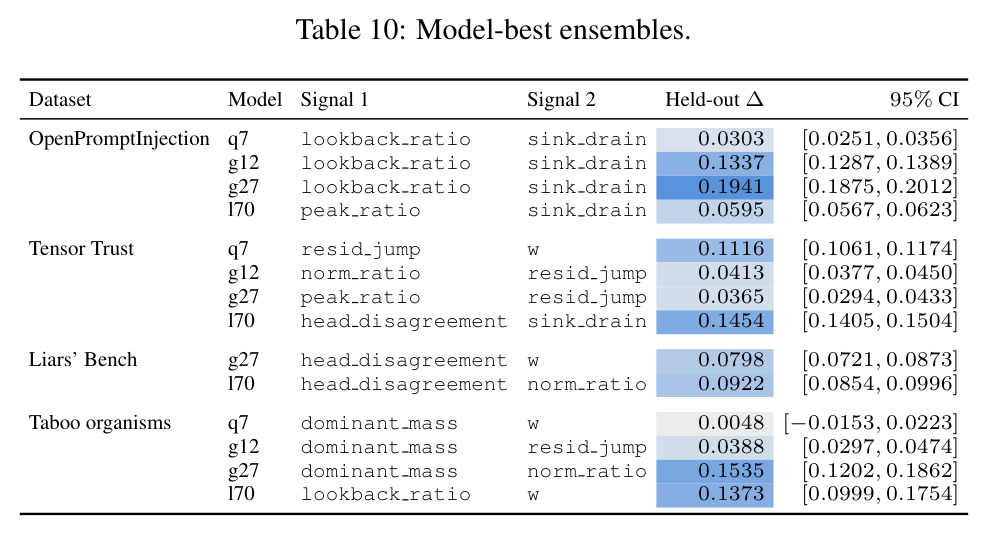
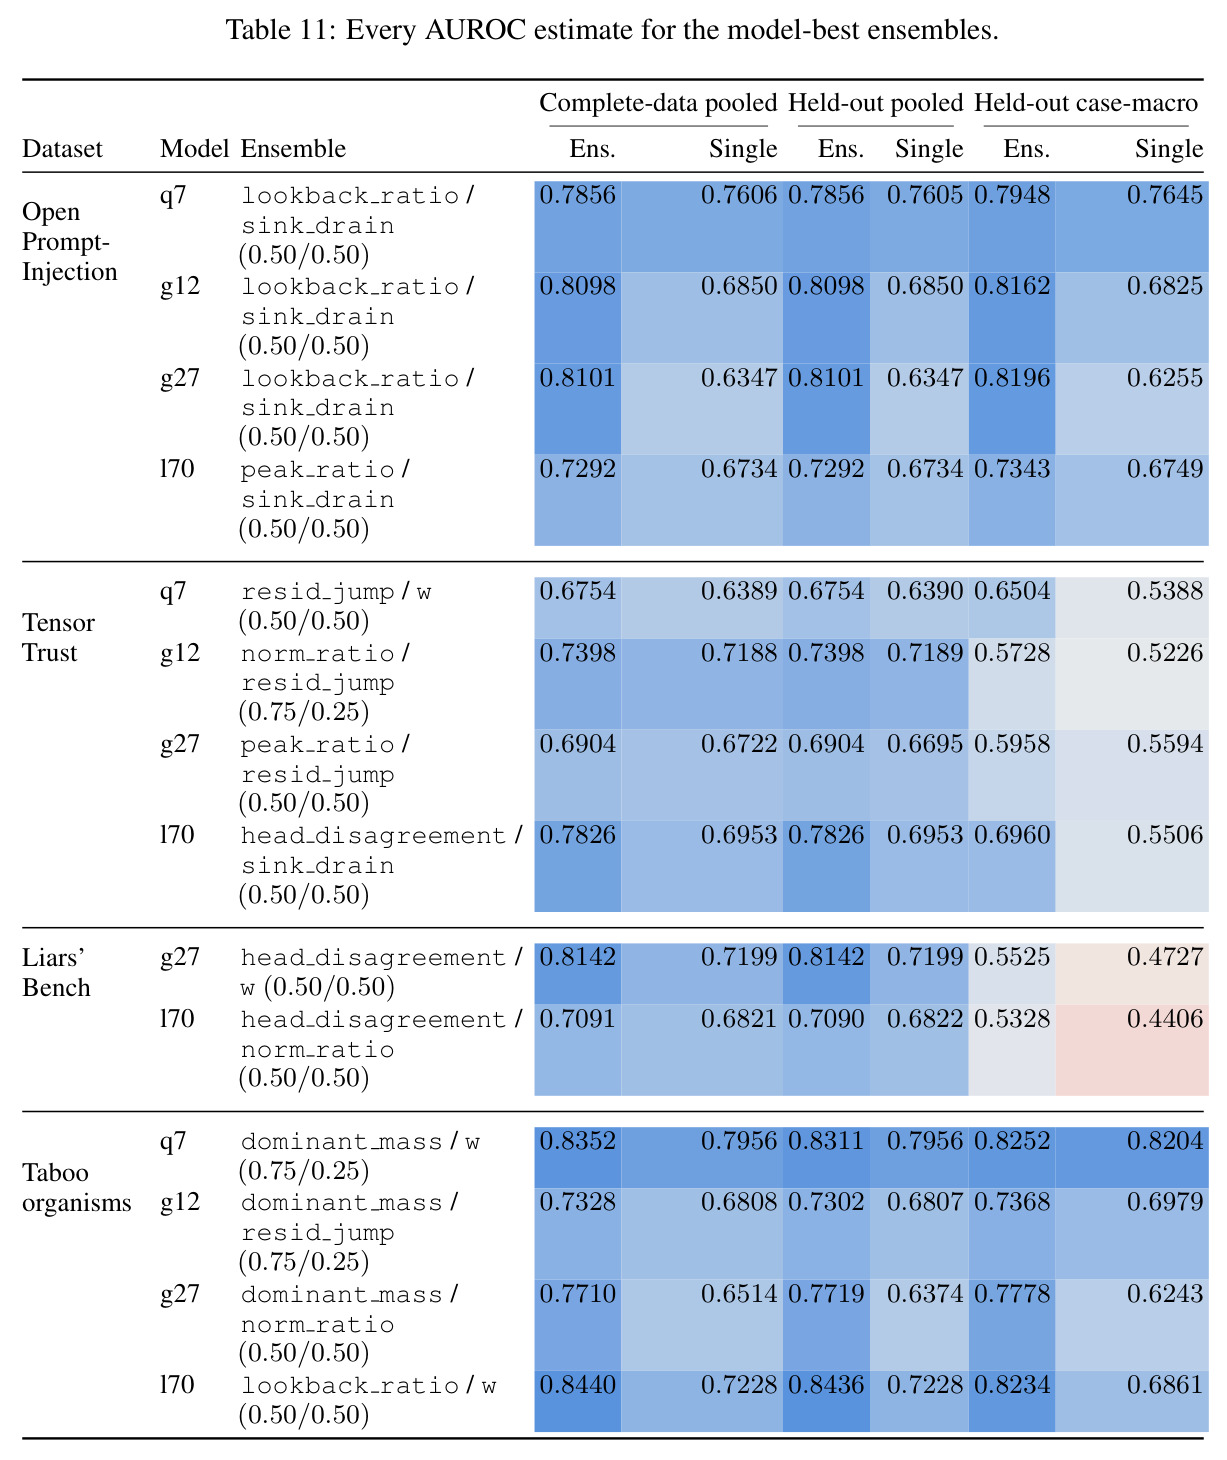
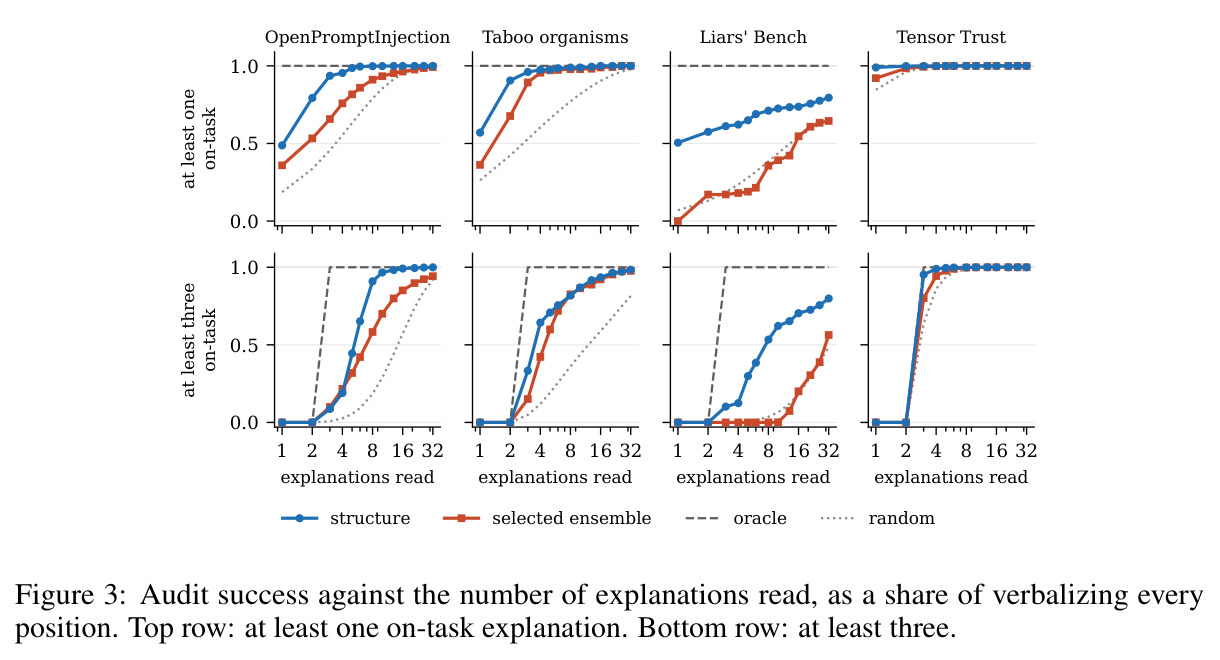
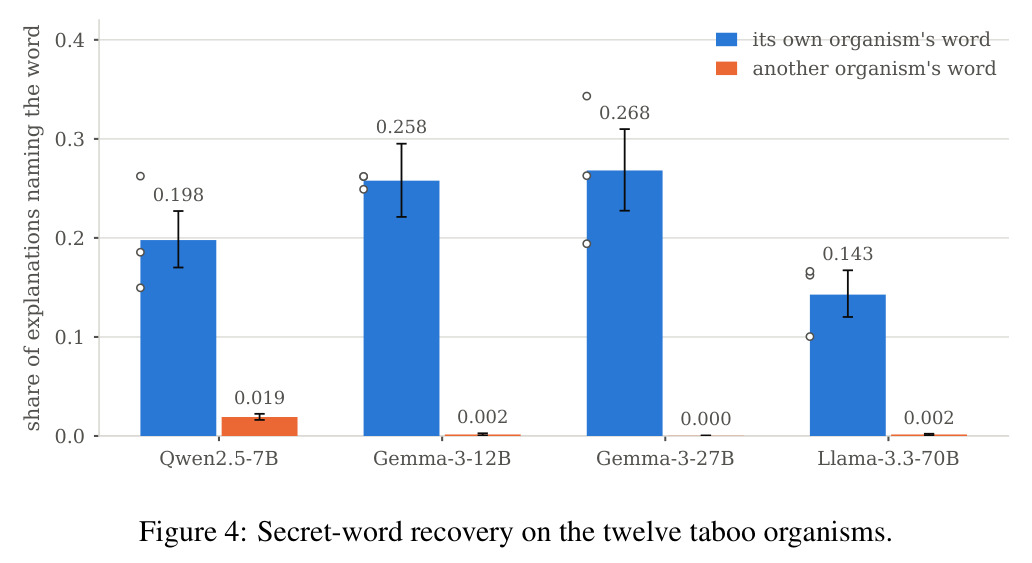
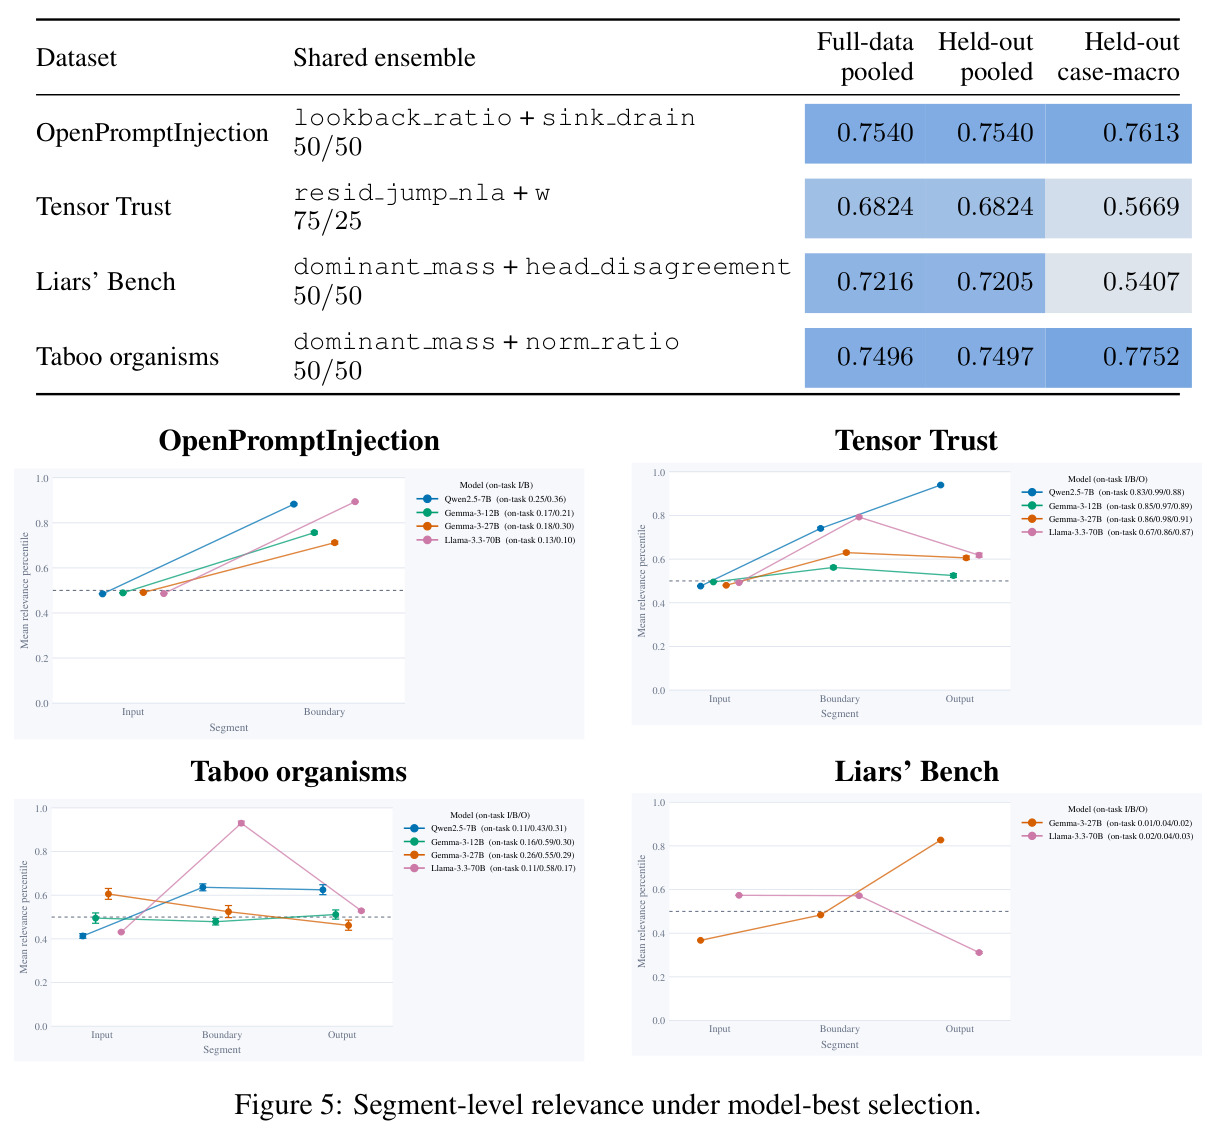
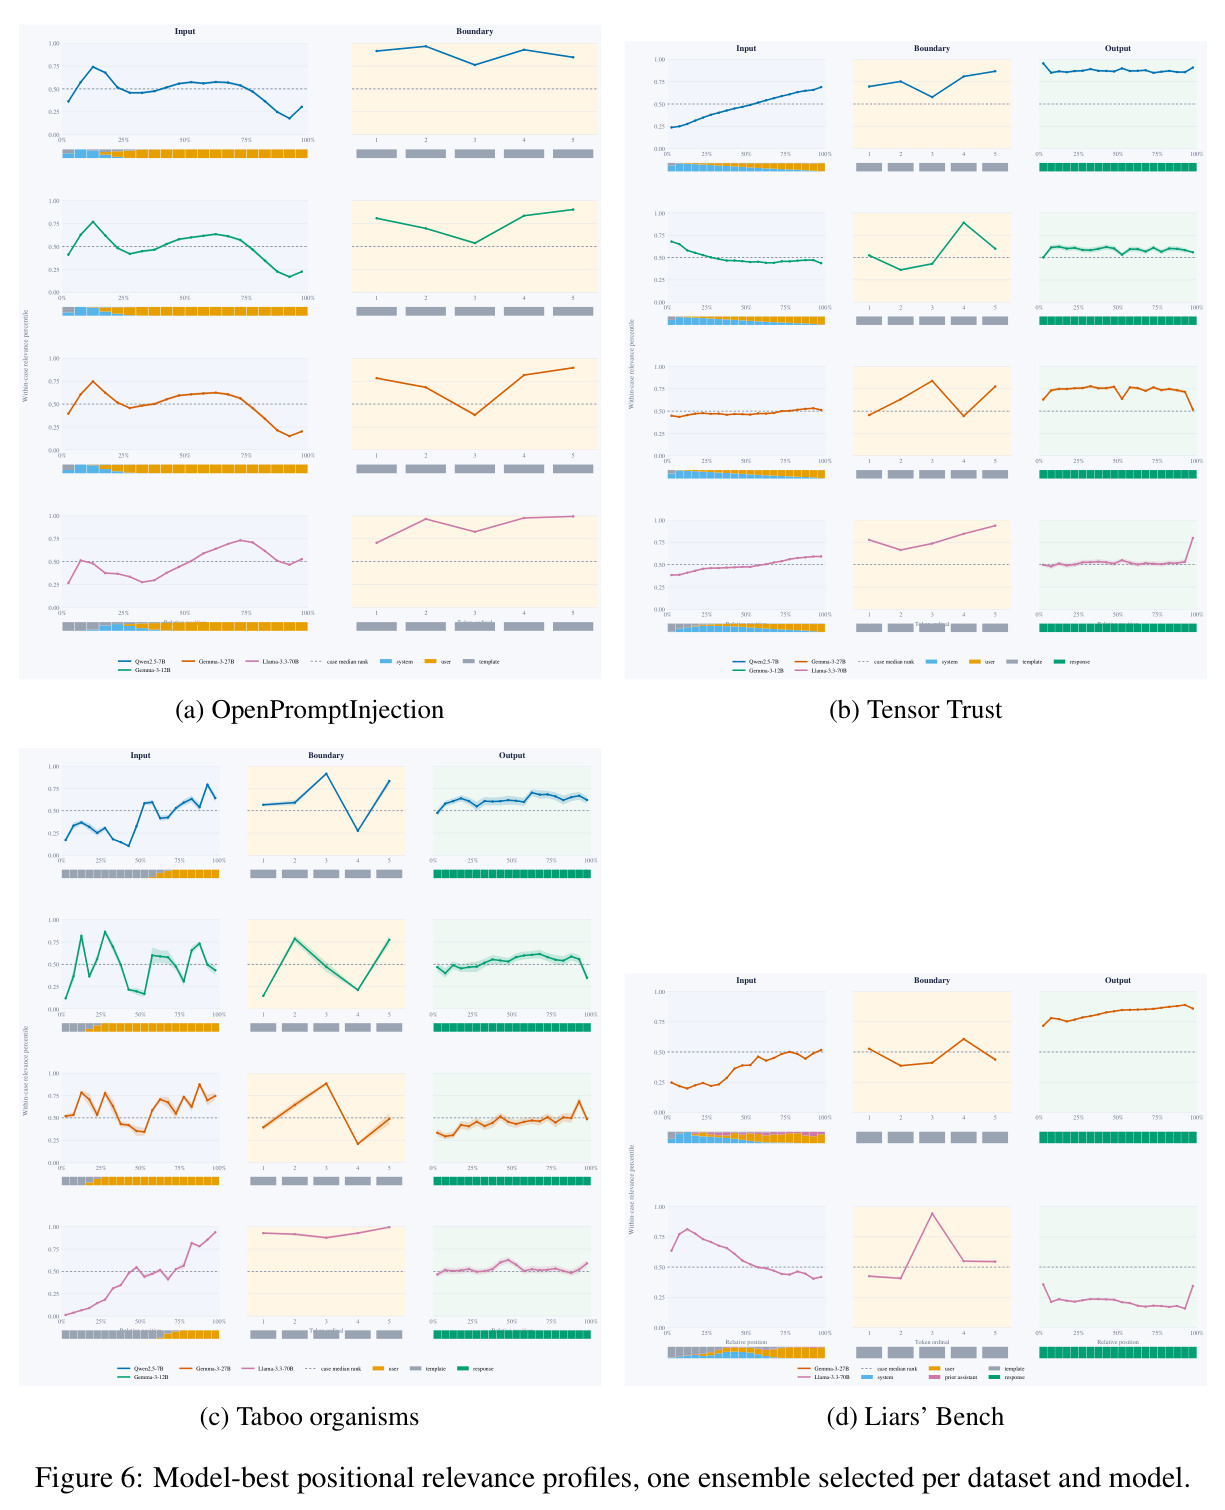
解释确实局域化于威胁:OpenPromptInjection 注入区间内的 on-task 率是同一用户消息内区间外的 13–66 倍,Liars' Bench 为 8–9 倍,而 Tensor Trust 比率小于 1(0.67–0.88);基础率在三个数据集为 0.011–0.300,Tensor Trust 高达 0.681–0.864、几乎没有选择空间。单信号层面激活族最强:14 格中 11 格的最强信号来自激活向量(resid jump nla 5 次、dominant mass 3 次居首),注意力族 3 次,预测分布族从未居首;方向调整 AUROC 中位数 0.584(四分位 0.535–0.634),最高 0.796;8/13 个信号在至少 5 格处于少数方向,方向必须按威胁拟合。免费的聊天结构逻辑回归在 12/14 格的 pooled、11/14 格的 case-macro AUROC 上超过最佳单信号(Liars' Bench 上 0.915/0.943 对 0.717/0.682)。两信号集成在全部 14 格的 held-out case-macro 上超过最佳单信号(+0.0048 至 +0.1941,13/14 格 CI 不含 0);共享选择为 OPI:lookback ratio+sink drain(0.754/0.761)、TT:resid jump nla+w(0.682/0.567)、Liars':dominant mass+head disagreement(0.722/0.541)、taboo:dominant mass+norm ratio(0.750/0.775)。预算上结构 ranker 在 10 个稀疏格、预算 8 时平均精确率 0.491,高于集成 0.392 与随机 0.191;5% 预算保留 0.995/0.958/1.000(OPI/taboo/TT)的审计成功率,Liars' Bench 仅 0.813。预训练 verbalizer 零改造读取 12 个 LoRA 隐瞒模型,14%–27% 位置说出秘密词,同提示下本模型词被点名 12–25% 而他词 ≤2.8%,排除文本反演。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| OpenPromptInjection 位置选择(数据集共享) | 方向调整 pooled AUROC / held-out case-macro AUROC | lookback ratio + sink drain(50/50):0.754 / 0.761 | 最佳单信号:0.650 / 0.655 | Δ = +0.104 / +0.106(95% CI 为正,且每个验证折都选中同一对信号) |
| Tensor Trust 位置选择(数据集共享) | 方向调整 pooled AUROC / held-out case-macro AUROC | resid jump nla + w(75/25):0.682 / 0.567 | 最佳单信号:0.673 / 0.536 | Δ = +0.009 / +0.031 |
| Liars' Bench 位置选择(数据集共享) | 方向调整 pooled AUROC / held-out case-macro AUROC | dominant mass + head disagreement(50/50):0.722 / 0.541 | 最佳单信号 head disagreement:0.700 / 0.457 | Δ = +0.021 / +0.084 |
| Taboo organisms 位置选择(数据集共享) | 方向调整 pooled AUROC / held-out case-macro AUROC | dominant mass + norm ratio(50/50):0.750 / 0.775 | 最佳单信号:0.708 / 0.722 | Δ = +0.042 / +0.053 |
| 模型级最优集成(全部 14 个数据集×模型格子) | held-out case-macro AUROC 相对最佳单信号的增益 | 14/14 格全部为正:+0.0048 至 +0.1941 | 最佳单信号(同一格内) | 13/14 格的配对自助 95% CI 不含 0(例外为 taboo q7,+0.0048 [-0.0153, 0.0223]) |
| 稀疏格子预算 8 精确率(10 个 on-task 稀疏格子平均) | 预算精确率(每条对话读 8 条解释) | 结构 ranker:0.491 | 选定集成 0.392;随机选择 0.191 | 比集成 +0.099,比随机 +0.300;预算 1 时结构在 11/14 格、预算 8 时在 12/14 格胜过集成 |
| 5% 位置预算下的审计成功率(相对逐位置全量解释) | 成功率比值(至少 1 条 on-task 解释) | 结构选择:OPI 0.995、taboo 0.958、Tensor Trust 1.000、Liars' Bench 0.813 | 随机选择:0.761、0.594、1.000、— | 三个数据集保留 ≥95.8% 成功率;更严的"至少 3 条"标准下降至 0.785/0.568/0.998;Liars' Bench 需要更多检查 |
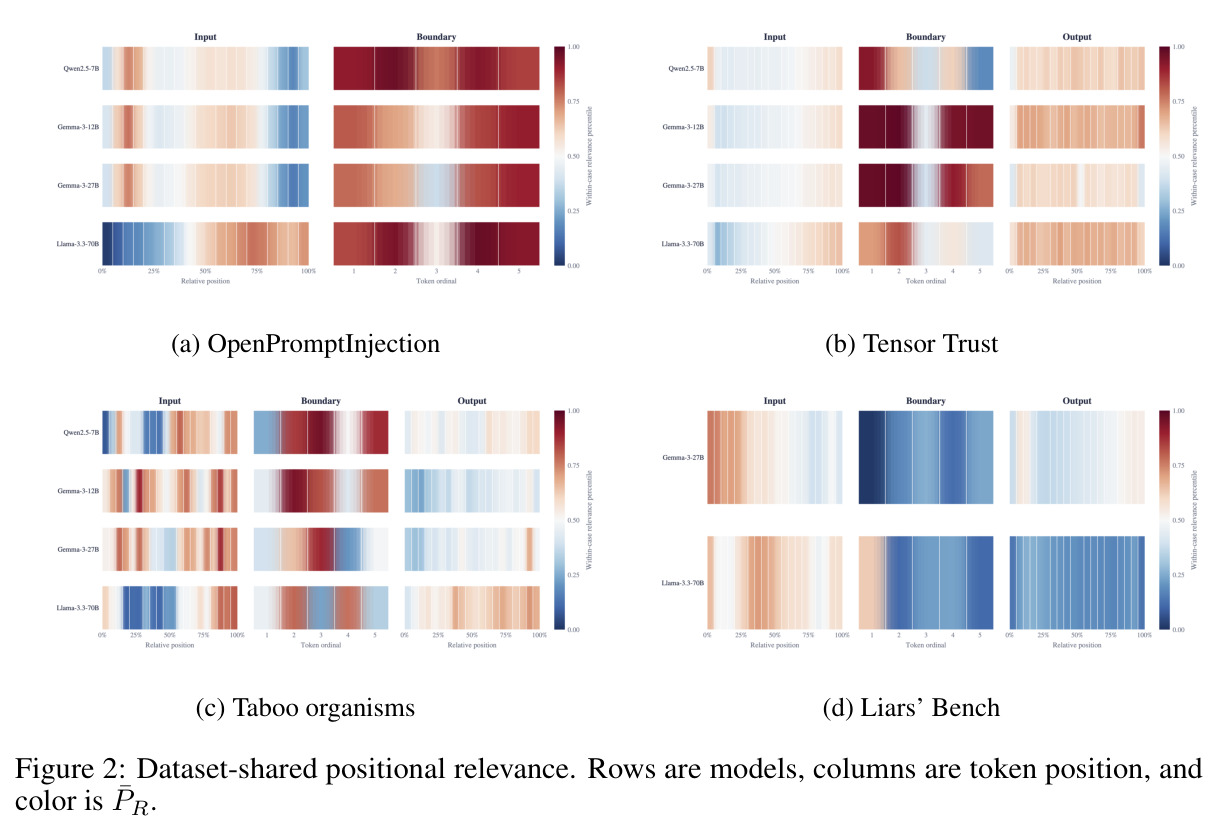
| 秘密词恢复(12 个 taboo organisms,跨微调迁移) | 点名秘密词的解释占比 | 本模型秘密词 14%–27%(共享提示位置 12%–25%) | 其他 organism 的词 ≤2.8%(多数 ≤1.9%,g27 上 5,531 条仅 1 条) | 同一提示文本在三个 organism 上产生模型特定答案,排除文本反解释;98% 含词解释被判 on-task |
局限与改进
作者明确承认两条局限:其一,所有标签来自单一评审模型(DeepSeek-V4-Flash),需要第二个评审模型与人工复核来验证标签可靠性;其二,每个模型只测了一个 verbalizer 层、对话相对较短(四个数据集中位长度分别为 143、74、131、264 个位置),向更深层和更长的智能体记录泛化尚未验证。我补充几点:on-task 标签只度量"解释是否谈论威胁",不等于解释内容足以支撑审计裁决;Tensor Trust 基础率高达 0.68–0.86,几乎不存在选择空间,其结论难以外推到威胁稀疏场景之外;方向与候选选择需要在带标注对话上拟合,连"免前向"的结构基线也要用 4/5 的标注对话训练,所谓零成本是打折扣的;Liars' Bench 是 on-policy 数据,两个模型看的对话集合不同,其位置偏好差异混杂了模型与数据两种因素;14 个格子仅来自 4 个开源模型,跨模型统计功效有限;跨模型迁移实验(留一模型)结果也明显更弱且不一致,如 taboo 的 label-free 迁移增益为 -0.075。
独立分析的弱点
独立分析的弱点:(1) 评审单点依赖——470 万个标签全部出自一个评审模型,其措辞偏好可能与 verbalizer 文风系统性耦合,改进方向是多评审投票加人工抽检并报告评审间一致性。(2) 结构基线的胜利可能部分来自数据集偏置——注入总在用户消息、欺骗集中在系统提示(l70 上 67.5% 的 on-task 位置在系统消息),在结构高度可变的真实智能体日志上结构优势可能缩水,应在长程 agent 轨迹上复测。(3) 方向校准成本——每个新威胁都需要标注对话来确定信号方向,削弱“免训练选位”的实用性,可探索从威胁描述少样本推断方向或在线校准。(4) spike token 陷阱只被两信号混合缓解而非根除,更彻底的做法是显式屏蔽 massive-activation 通道集 $S$ 或设计 spike 感知信号。(5) 单层读取——verbalizer 只看约三分之二深度的一层,多层聚合可能更强更稳。(6) 相关性不等于充分性——高 AUROC 只说明解释提到威胁,不保证足以做出审计判断,需端到端评估“读 k 条解释能否做出与全量一致的裁决”。
未来方向
作者明确提出正在推进两个方向:用第二个评审模型与人工复核检验标签可靠性;把结论推广到更多 verbalizer 层与更长的智能体记录。在此基础上有若干自然延伸:把结构 ranker 与计算信号结合成可学习的端到端选择器,直接以审计成功率为目标训练;利用 input/boundary 位置的激活在回复生成前即可读取的特性(论文实测 OPI、Tensor Trust、taboo 都把 boundary 排在 input 之上),实现"模型开口之前"的实时监控与干预;将选定位置的解释接入下游威胁裁决器,量化"读 5% 位置能否复现全量审计的结论";在 Activation Oracle(Karvonen et al.)等更强解释器上重复选位研究,检验结论是否随解释器改变;把信号方向的自动估计(从威胁描述或极少标注)形式化为新问题;以及检验预训练 verbalizer 的跨权重复用能否推广到 RLHF、蒸馏等更广泛的权重变化,而不只限于低秩适配器。
复现评估
复现条件较好。代码、数据、生成结果与全部中间产物开源于 github.com/federicotorrielli/nla-token-selector;四个数据集中三个公开(OpenPromptInjection、Tensor Trust、Liars' Bench),taboo organisms 按 Cywiński et al. (2025) 的公开方法自行训练;四个基座模型均为开源权重,verbalizer 直接使用 Fraser-Taliente et al. 发布的四个 NLA,无需自己训练。主要计算成本在逐位置解释:470 万条 × 约 130 token 的贪心生成,最大的 Llama-3.3-70B 约需 4×B200;评审调用 DeepSeek-V4-Flash API(温度 0)。综合难度中偏高:需要多卡 GPU、训练 12 个 LoRA organisms、执行五折分组交叉验证与配对自助置信区间;但由于作者发布了全部生成数据,后来者可以跳过最昂贵的解释生成阶段,直接在标签上复现信号评估与预算分析。
论文图表
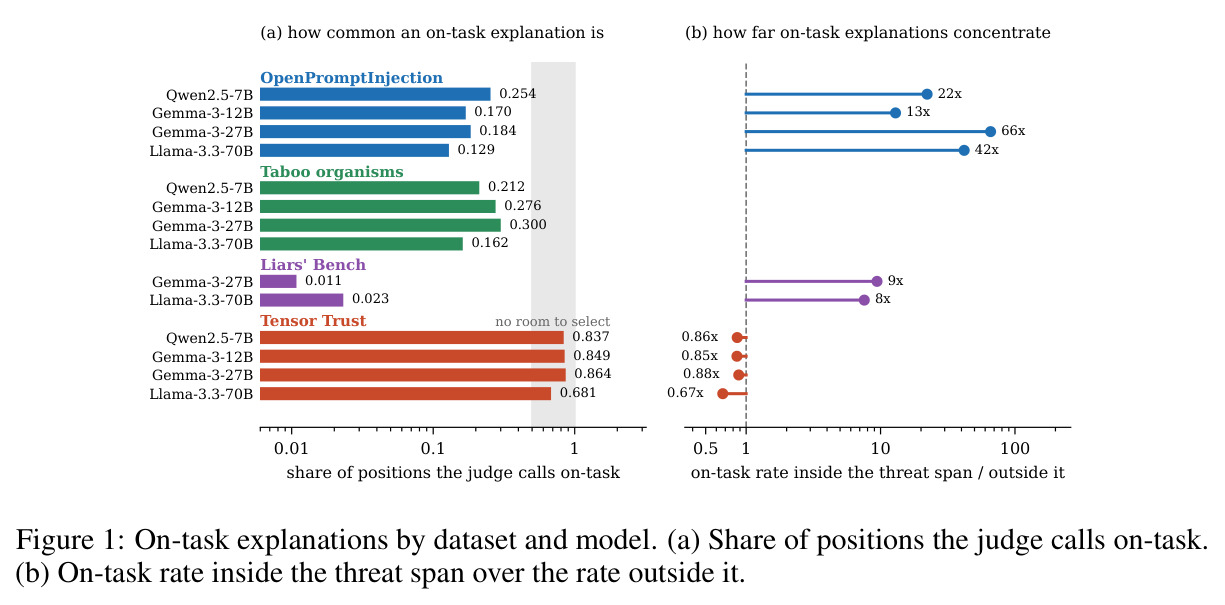
按数据集×模型给出两列数字:(a) on-task 位置占比(OpenPromptInjection 0.129–0.254、taboo 0.162–0.300、Liars' Bench 0.011–0.023、Tensor Trust 0.681–0.864);(b) 威胁区间内外的 on-task 率之比(OPI 13–66 倍、Liars' Bench 8–9 倍、Tensor Trust 小于 1)。
它同时回答了"选择有多大空间"(基础率决定上限)与"解释是否真的局域化在威胁处"(选位有意义的前提),是全文实验的动机图。
数据集共享选择下四个集成(OPI lookback+sink drain、TT resid jump nla+w、Liars' dominant mass+head disagreement、taboo dominant mass+norm ratio)的全量 pooled、held-out pooled 与 held-out case-macro AUROC。
主文 4.4 节共享选择结论(0.754/0.682/0.722/0.750)的出处表。