基于稀疏自编码器的可审计AI文本检测器 Building Auditable AI Text Detectors with Sparse Autoencoders
把黑箱AI检测器改造成由经验证的可解释概念构成、可审计且分布外更稳的分类器
前置知识
稀疏自编码器(SAE)
一种带稀疏约束的自编码器,把语言模型的稠密激活 $x \in \mathbb{R}^{d}$ 编码为高维稀疏特征 $h$,再解码重建输入,损失为 $\mathcal{L} = \|x-\hat{x}\|_2^2 + \lambda\|h\|_1$;本文用 JumpReLU 门控结构(宽度 16,384),使绝大多数特征恒为零、只有少数特征对给定输入激活。
本文全部方法建立在 SAE 之上:检测器的"可解释概念"就是 SAE 特征,理解编码、稀疏惩罚与重建三个要素,才能理解后续的特征过滤、描述生成和分类头训练。
残差流(residual stream)
Transformer 中各层读写共享的中介向量空间:每一层通过加减的方式向残差流写入信息,因此任意一层的残差流近似等于此前所有层信息的叠加总和。对残差流做分解,等价于对模型到该层为止累积的全部处理结果做分解。
作者把 SAE 直接架在检测器第 7/13/17/22 层的残差流上,特征的语义取决于激活的读取位置;不懂残差流就无法理解"在检测器内部训练 SAE"到底在分解什么。
多义性与单义性
多义性(polysemanticity)指单个神经元对看似无关的多种输入都响应,导致无法用一句话解释其行为;SAE 的目标就是把稠密激活重参数化为大量"单义"(monosemantic)方向,每个特征只对应一个清晰概念,从而可以被自然语言描述、被人工审计。
论文的核心假设是 SAE 特征足够单义,才能用 ≤20 词的描述忠实刻画其触发模式,并进一步充当可审计分类器的基本单元。
自动可解释性与模拟分数
自动可解释性(auto-interpretation)用 LLM 查看特征高激活的文本片段并生成描述;随后让 LLM 只凭描述\"模拟\"该特征——预测任意文档属于哪个激活分位桶——用预测桶与真实桶的 Spearman 相关得到模拟分数 $s_i \in [-1, 1]$,衡量描述对特征行为的忠实度。
本文的关键过滤机制就是把 $s_i$ 与全局阈值 $ au$ 比较后决定特征去留,"可审计"承诺完全建立在模拟分数的有效性上。
L1 正则化逻辑回归(稀疏探针)
在逻辑回归的二元交叉熵损失上加 $\lambda_1\|\beta\|_1$ 惩罚,迫使大多数权重精确为零,只保留少数有贡献的特征。本文用 SGD+动量配合软阈值更新 $w \leftarrow \mathrm{sign}(w)\cdot\max(|w|-\eta\lambda_1, 0)$ 得到精确稀疏解(而非 Adam+L1 的近零解)。
最终的检测器就是这个线性头:每条预测 = 一组概念各自带权重的加减分,天然可解释;权重非零的特征集合就是审计者要读的"证据清单"。
TPR@FPR=5% 等低误报指标
TPR@FPR=5% 表示把假阳性率严格压到 5% 时测得的真阳性率,衡量检测器在"不允许冤枉人类作者"约束下的捕获能力;类似地 PRDB 实验用 TPR@FPR=1%。这类指标比 AUC/F1 更贴近高风险部署场景的真实需求。
论文主表以 AUC/F1/TPR@FPR=5% 三列并报,许多"性能相近"的方法在低误报区差距巨大,读懂该指标才能看懂各方法的真实成色。
研究动机
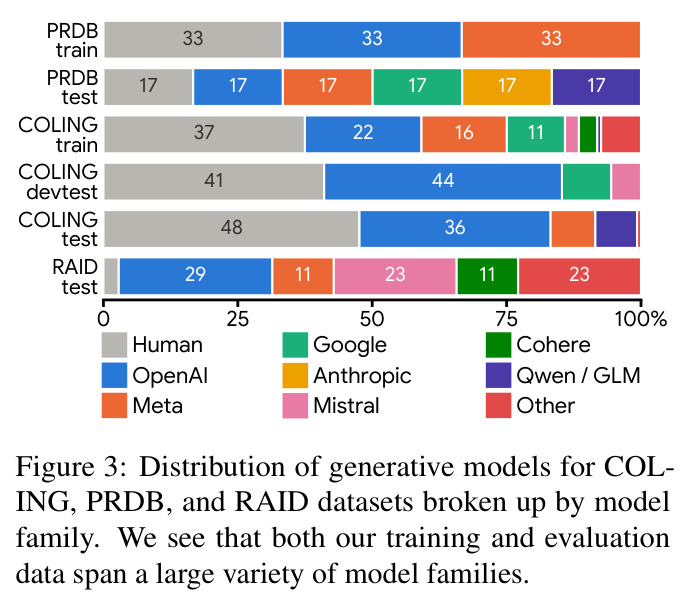
AI 生成文本检测早已走出实验室:同行评审、教育评分、入学申请、新闻报道和内容审核都在用检测器输出直接影响个体的决定,但性能最强的检测器几乎都是微调后的神经分类器,只给出一个黑箱概率,评审人、教师或合规人员既无法查看依据也无法申诉。可解释的替代品(文体特征分类器)性能差距巨大:在 COLING 共享任务(训练集 610,767 篇、覆盖 39 个生成器家族)上,基于 gram2vec 930+ 维语言学特征的逻辑回归分布内 F1 仅 77.9,而微调的 gemma-2-2b 神经检测器达到 98.0;到分布外的 COLING test,gram2vec 的 F1 掉到 72.0、TPR@FPR=5% 仅 33.6。用 LIME/SHAP 解释神经检测器的已有尝试只给出 token 级重要度分数,说不出\"这些 token 为什么有预测性\";而已有的 SAE 分类器工作(如用于奖励模型、幻觉检测、LLM-as-judge)把全部 SAE 特征不加过滤地喂给下游模型,高密度、多义特征混入其中,系统级解释的忠实性没有保证。作者统计 PRDB(106,413 条 NeurIPS/ICLR 2016–2024 人类评审)等真实场景,强调高风险应用迫切需要一个既准又可审计的检测器。
本文的目标是本文的目标是:把一个现成的黑箱神经检测器改造成\"概念瓶颈\"式的可审计分类器,而不显著牺牲精度。具体要求是:(1) 每个输入先表示为一组稀疏自编码器特征,每个特征都附带一句由自动可解释性流水线生成的自然语言描述;(2) 只有描述通过全局忠实性验证(模拟分数 $s_i \geq \tau$)的特征才允许进入分类器,$\tau$ 取 0.7 或 0.85;(3) 最终预测由轻量 L1 正则化逻辑回归在这些概念上完成,任意一次判定都可列出贡献最大的 top-k 特征及其描述(如\"Em dashes (+1.5)\"),供审计者核对、质疑乃至否决;(4) 系统在分布外数据上不弱于甚至强于原检测器与现有最佳方法。作者还要求给出因果证据,证明描述确实忠实反映特征行为、特征集合完整覆盖了检测依据。
与已有工作不同的是,本文的独特切入是把\"可解释性当作显微镜\"(Movva et al. 2025 用 SAE 特征做假设生成)的思路首次完整落到 AI 文本检测上:不是事后解释一个训练好的黑箱,而是让检测器本身由自动发现且经过忠实性验证的概念构成。相比已有工作有三个\"首次\":其一,首次直接在 AI 检测器的残差流上训练 SAE——Scher (2024) 与 Kuznetsov et al. (2025) 只用现成 SAE 特征与 AI 文本的共现,既没在检测器上训练 SAE,也没评估特征描述的准确性;其二,首次提出基于自动可解释性分数的全局过滤阈值 $\tau$,区别于 Kulkarni et al. (2026) 只剔除 M 个最不可解释特征的做法——删掉最差的并不保证幸存者整体可解释;其三,首次用零消融与定向改写双重因果实验,端到端验证\"描述→特征→预测\"链条的忠实性与完备性,把可解释检测从口号变成可检验的系统。
核心方法
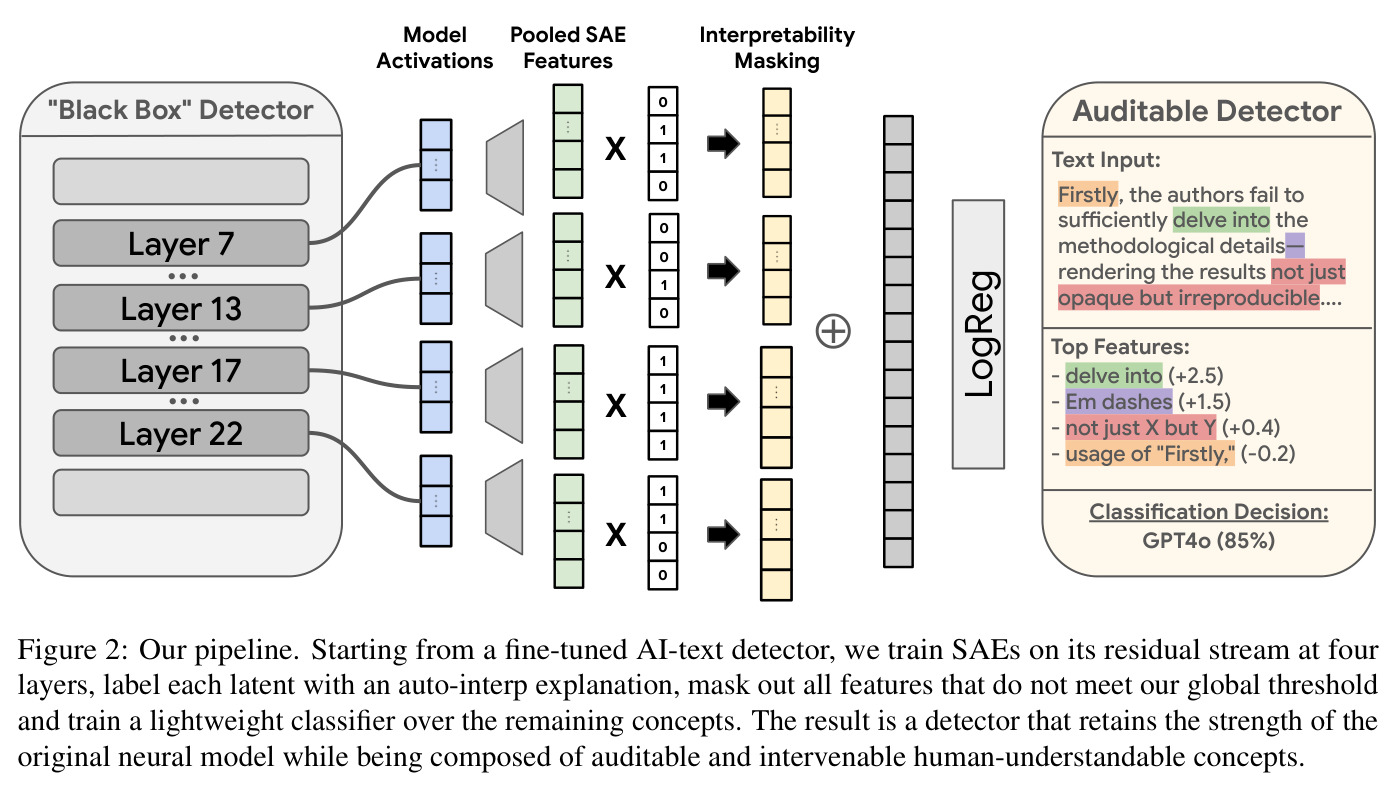
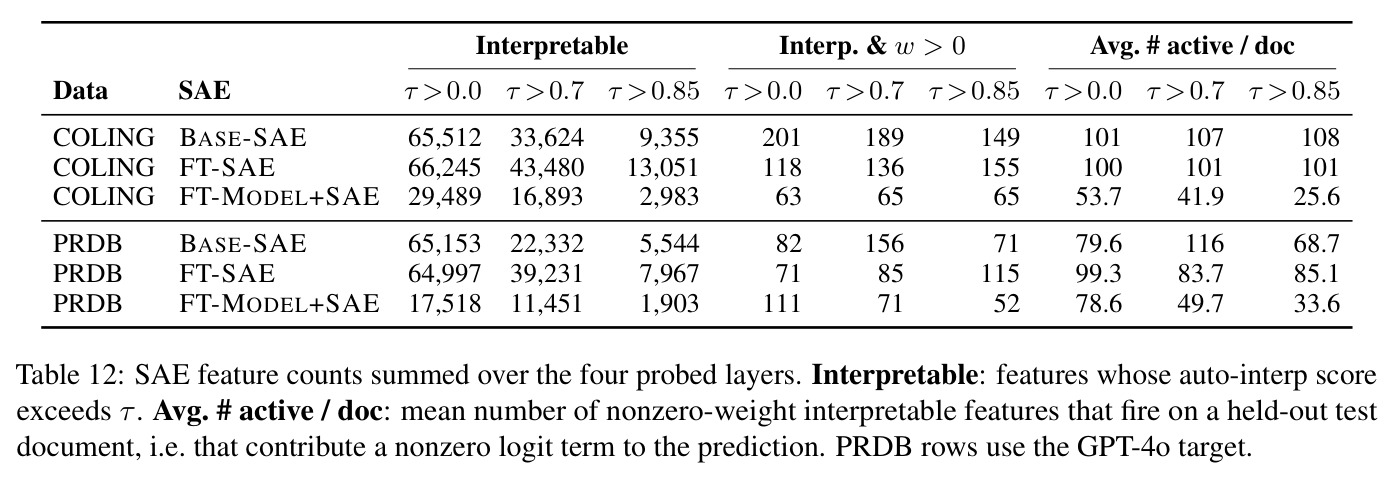
直觉上,作者想回答一个问题:能否让检测器的每次判定都变成一串人类读得懂的加减分项?技术路线是四段流水线(Figure 2)。第一步,在 AI 检测任务上微调 gemma-2-2b 得到强神经检测器(开放域用 COLING 英文数据,闭域用 PRDB 同行评审)。第二步,在检测器(或基座模型)残差流的第 7、13、17、22 层分别训练/微调 JumpReLU SAE,把 $d_{model}$ 维激活映射为 16,384 维稀疏特征;文档级特征向量 $h \in \mathbb{R}^{|\mathcal{L}|\cdot d_{SAE}}$ 由四层 SAE 特征沿层拼接、沿序列维度 max-pool 得到。第三步,对每个特征跑自动可解释性流水线:用 gemini-3.1-flash-lite 生成不超过 20 词的描述,并通过分位数模糊(quantile fuzzing)验证计算模拟分数 $s_i$。第四步,按全局阈值 $\tau$ 构造二值掩码 $m_i = \mathbb{I}[s_i \geq \tau]$,得到 $h_\tau = h \odot m$,在其上训练 L1 正则化逻辑回归。预测时列出 top-k 净贡献特征及描述,形成可读的证据清单。整个系统在两种数据设定上验证:开放域(任意模型、任意领域)与闭域(AI 同行评审检测)。
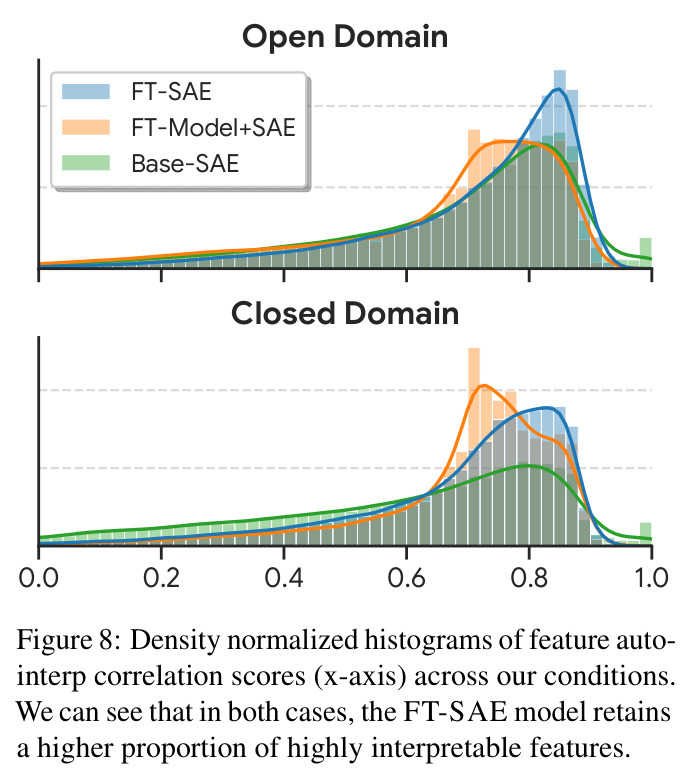
核心创新是\"全局忠实性阈值\"这一特征过滤机制:不是挑选对分类重要的特征,而是只保留\"描述被验证为忠实的\"特征。模拟分数 $s_i$ 的含义是:仅凭那句 ≤20 词的描述,LLM 能多准确地预测特征在任意文档上的激活分位桶(Spearman 相关);因此 $s_i \geq \tau$ 意味着描述确实刻画了特征的行为,审计者读到的解释是可信的。这与概念瓶颈模型的思想相通,但概念是无人监督自动发现的;与稀疏探针文献(Gurnee 2023、Gao 2025、Kantamneni 2025)不同,那些工作证明 SAE 特征能做分类器却从不剔除不可解释特征;与 Kulkarni et al. (2026) 删除 M 个最差特征的做法相比,全局阈值保证的是幸存特征的总体水平。另一个意外的核心发现是:不做任何任务微调,预训练 GemmaScope SAE 特征加逻辑回归(BASE-SAE)本身就是强检测器,作者追随 Quaremba et al. (2026) 猜测基座模型在预训练中已学到线性可分的\"AI 文本\"特征——这既降低了系统门槛,也把三种配置(BASE-SAE/FT-SAE/FT-MODEL+SAE)变成了研究检测器可解释结构的对照实验。
方法步骤详情
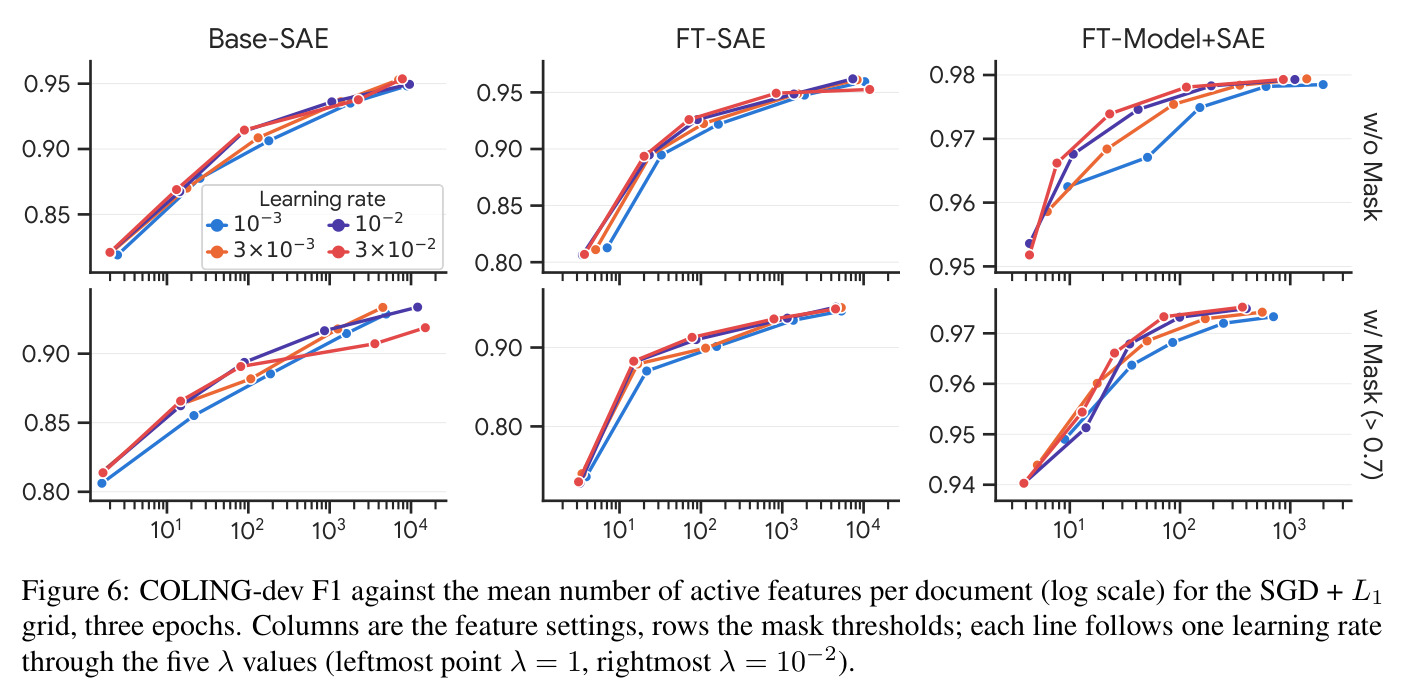
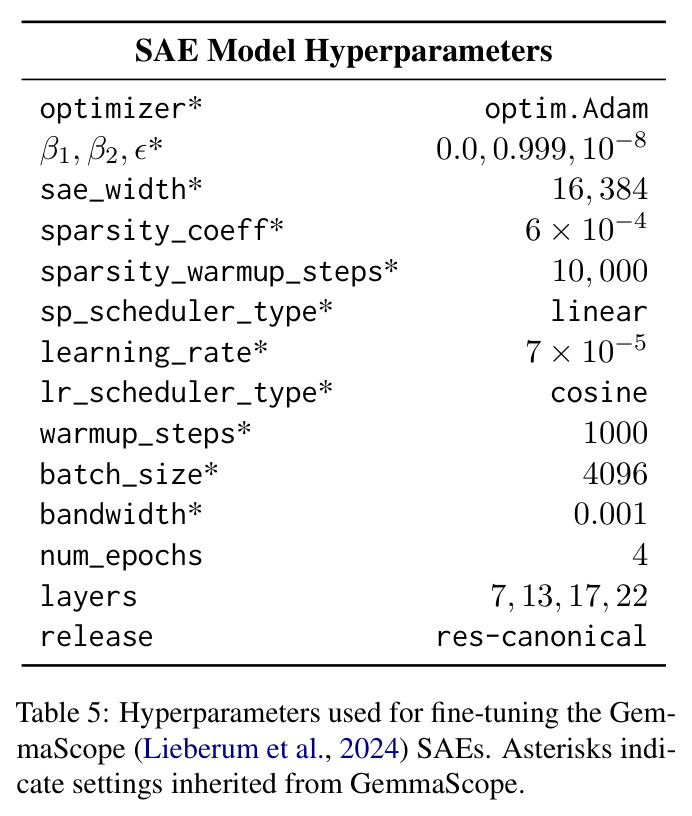
第 1 步(检测器微调):开放域用 COLING 英文划分(train 610,767 / dev 261,758 篇);闭域用 PRDB extended split(含 106,413 条 2016–2024 年 NeurIPS/ICLR 人类评审及配对 AI 文本)分别训练 Human vs GPT-4o 与 Human vs Llama-3.1-70B。gemma-2-2b 换上二分类头,最小化二元交叉熵,学习率 $5\times10^{-5}$、1 epoch、batch 4,其 dev F1 98.0 显著超过官方 RoBERTa 基线(96.2)。第 2 步(SAE 训练):三种条件——BASE-SAE(原版 GemmaScope width_16k/canonical)、FT-SAE(在基座模型激活上微调 SAE)、FT-MODEL+SAE(先微调检测器、再在其激活上微调 SAE)。用 JumpReLU 架构、宽度 16,384、稀疏系数 $6\times10^{-4}$、学习率 $7\times10^{-5}$、4 epochs、batch 4096,四层同时训练;训练前需重参数化抵消 GemmaScope 折叠进权重里的归一化常数 $C_\ell$(逐层经验估计),训练后再折回。第 3 步(自动可解释):按特征文档级最大激活的经验分位把训练语料分为 $Q_1..Q_k$ 桶加不激活桶 $Q_0$,分层采样 10 篇文档用于生成、50 篇用于验证;每篇截取最大激活 token 前后 ±20 词窗口,对激活超过全局最大值 10% 的 token 加 <<高亮>>,让 gemini-3.1-flash-lite 生成 ≤20 词描述;验证时让模型预测每篇文档所属分位桶,$s_i$ 取预测桶与真实桶的 Spearman 相关。第 4 步(掩码+分类头):$m_i=\mathbb{I}[s_i\geq\tau]$,$h_\tau=h\odot m$;特征按 RMS 归一化后,用 SGD+动量(0.9)软阈值逻辑回归训练 3 epochs,$\eta=3\times10^{-2}$、$\lambda_1=0.1$;$\lambda_1$ 按\"每文档 30–100 个活跃特征\"的目标选取,保证单条预测的证据清单可读。解释生成:列出对 logit 贡献最大的 top-k 特征及描述。
技术新颖性
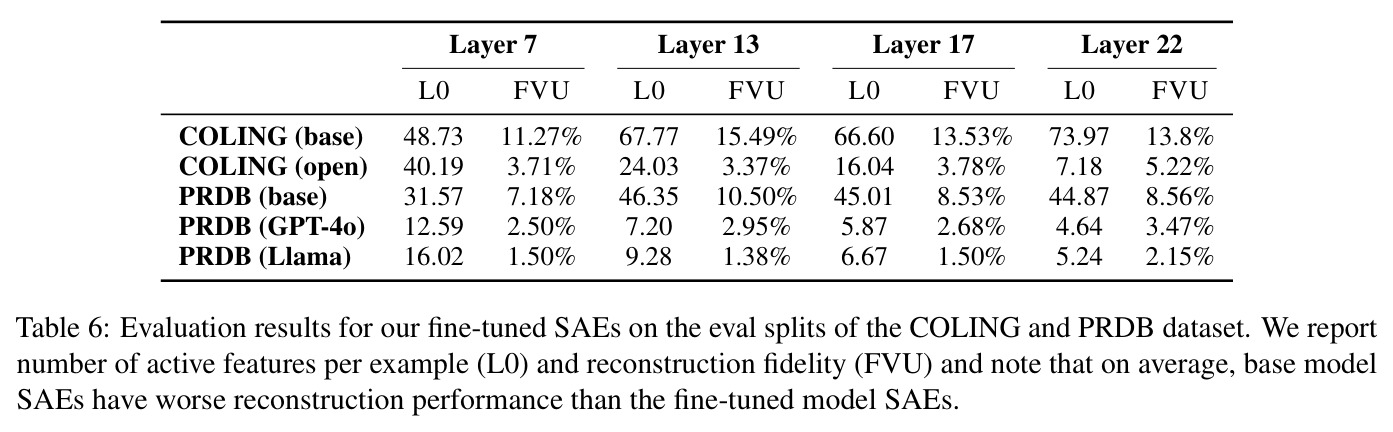
技术新颖性体现在四个层面。第一,把 SAE 作为\"显微镜\"的用法(Movva 2025 的新闻参与度分析)首次系统迁移到 AI 检测,并用全局忠实性阈值补齐了 Zhang 2026(可解释奖励模型)、Park 2025(稠密检索)、Xiong 2026(幻觉检测)、Wedgwood 2026(LLM-as-judge)等\"SAE 特征直接喂下游分类器\"工作普遍缺失的系统级忠实性保障。第二,自动可解释性采用 Paulo et al. (2025) fuzzing 的分位数变体:不预测逐 token 激活而预测文档分位桶,配合 10+50 篇的小样本协议,使对数万级特征的标注在成本上可行且可复现。第三,因果验证设计完整且双向:特征级定向改写(把特征描述喂给 gemini 让它只删除该特征,比较改写后 logit 变化与重要度分数的相关)检验\"描述→行为\"的忠实性;文档级对抗人性化攻击(按证据清单删除 AI 特征)检验特征集合的召回率/完备性——若清单不完整,删除已有特征后应暴露新的 AI 特征而非翻转预测。第四,BASE-SAE 现象本身是新发现:基座 SAE 重建质量更差(FVU 最高 15.49% 对 FT-SAE 最低 1.38%)却在 OOD 检测上更强,与 SAEBench(Karvonen et al. 2025)\"重建指标不预测下游表现\"的结论呼应,提示检测性能与表征结构是两回事。
实验结果
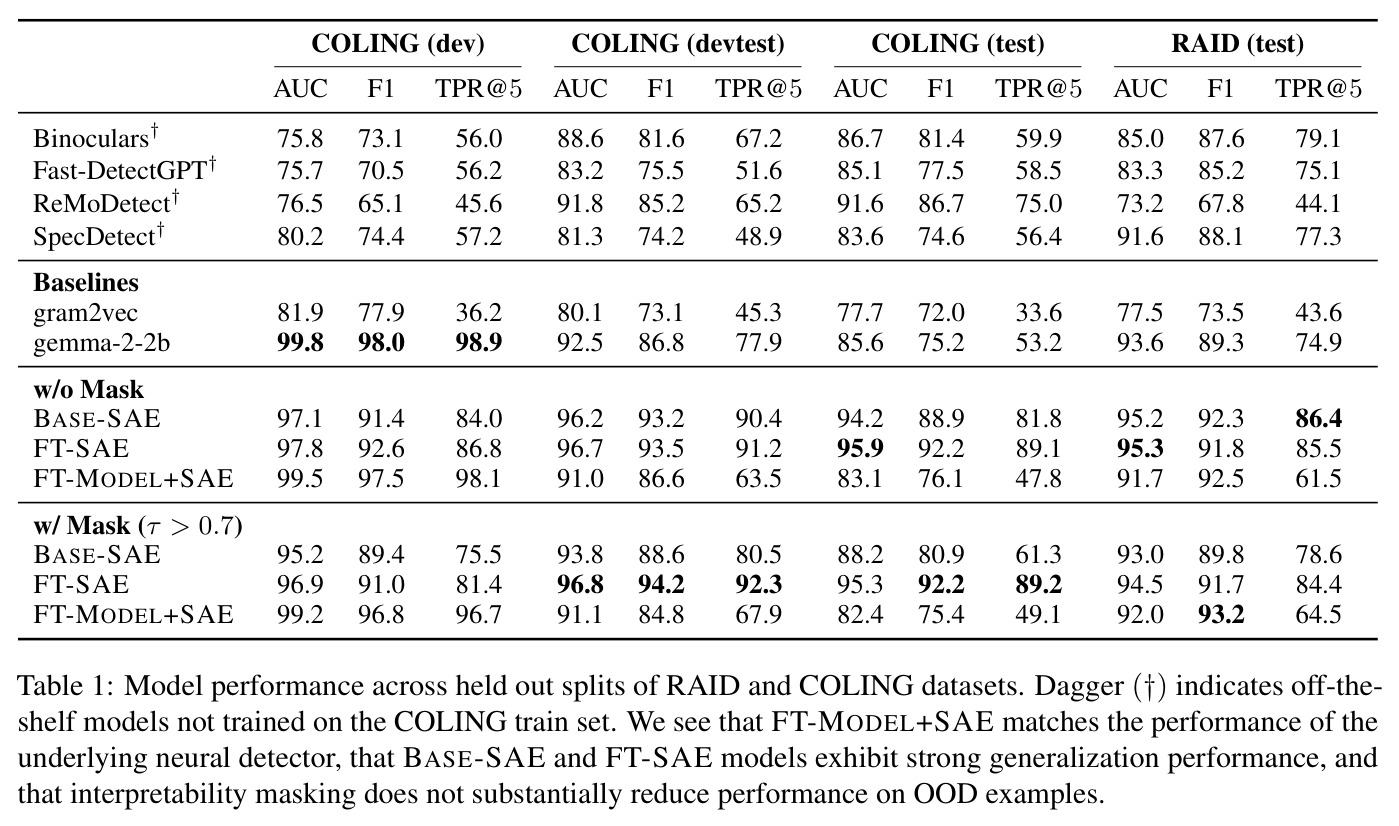
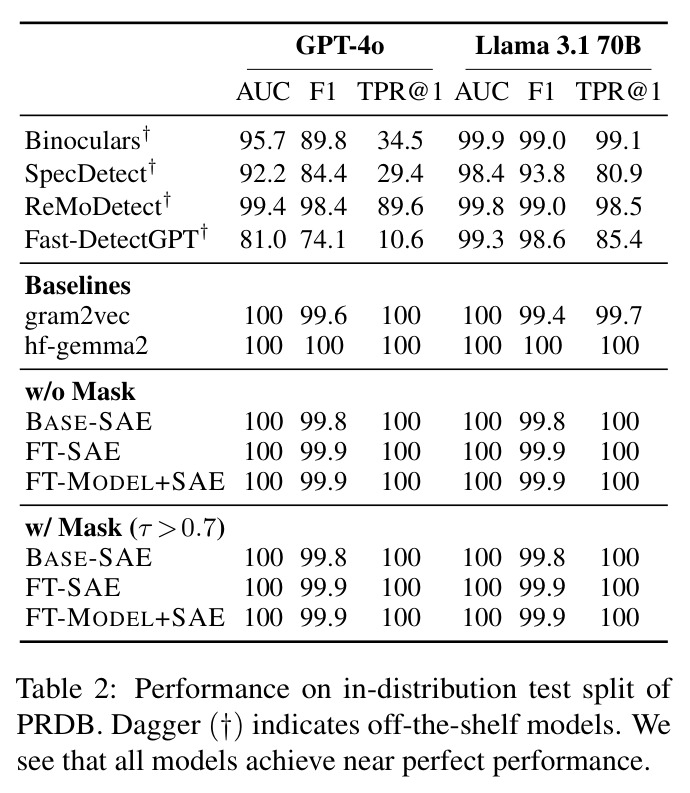
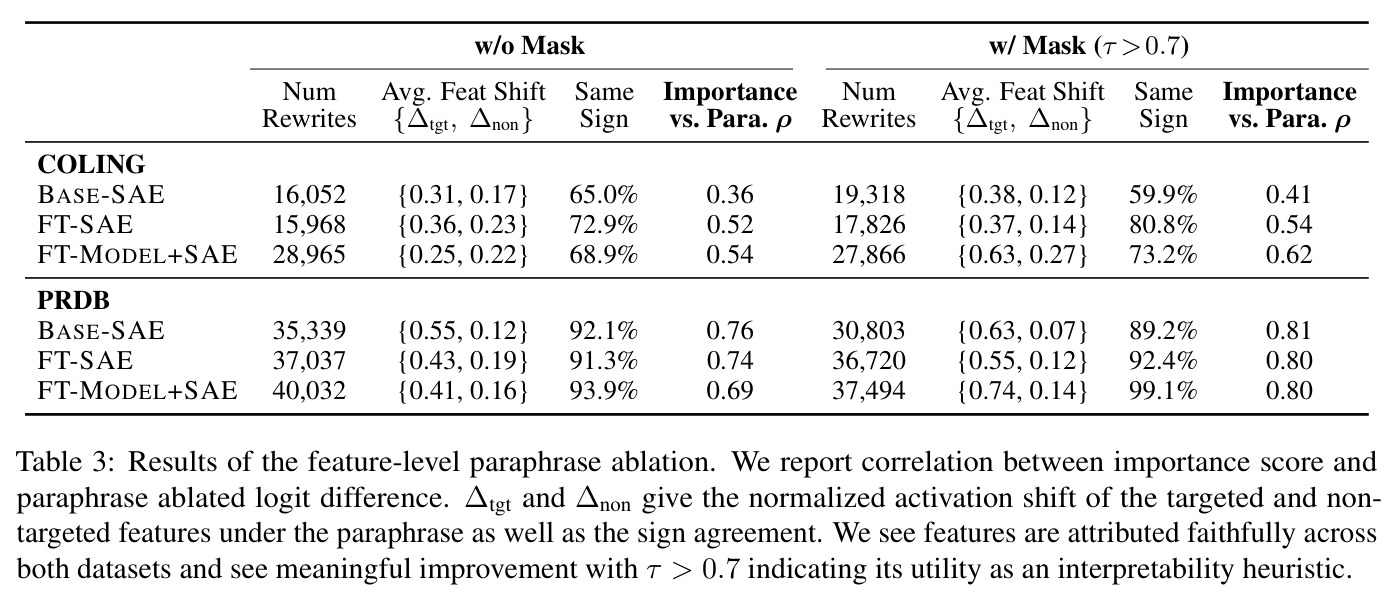
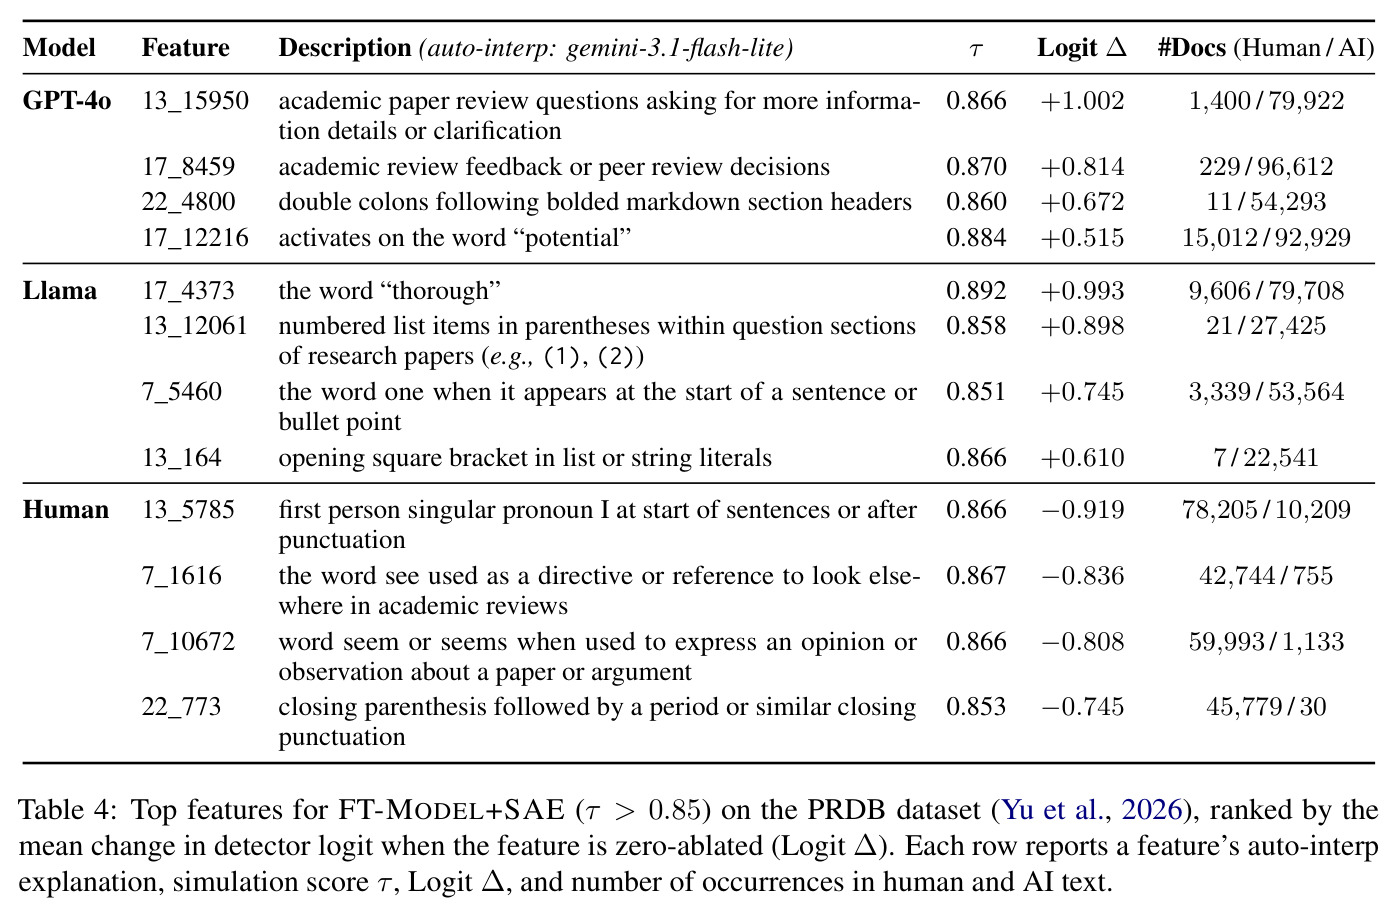
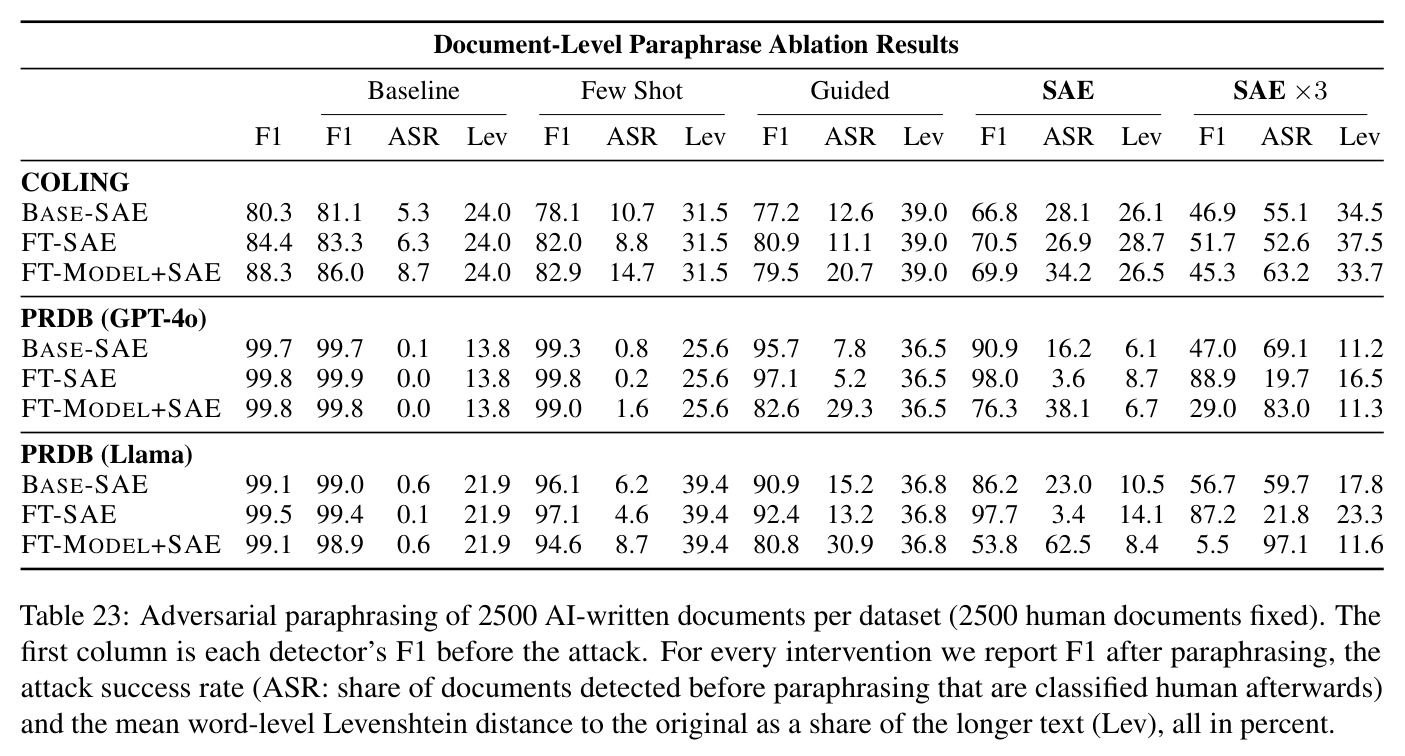
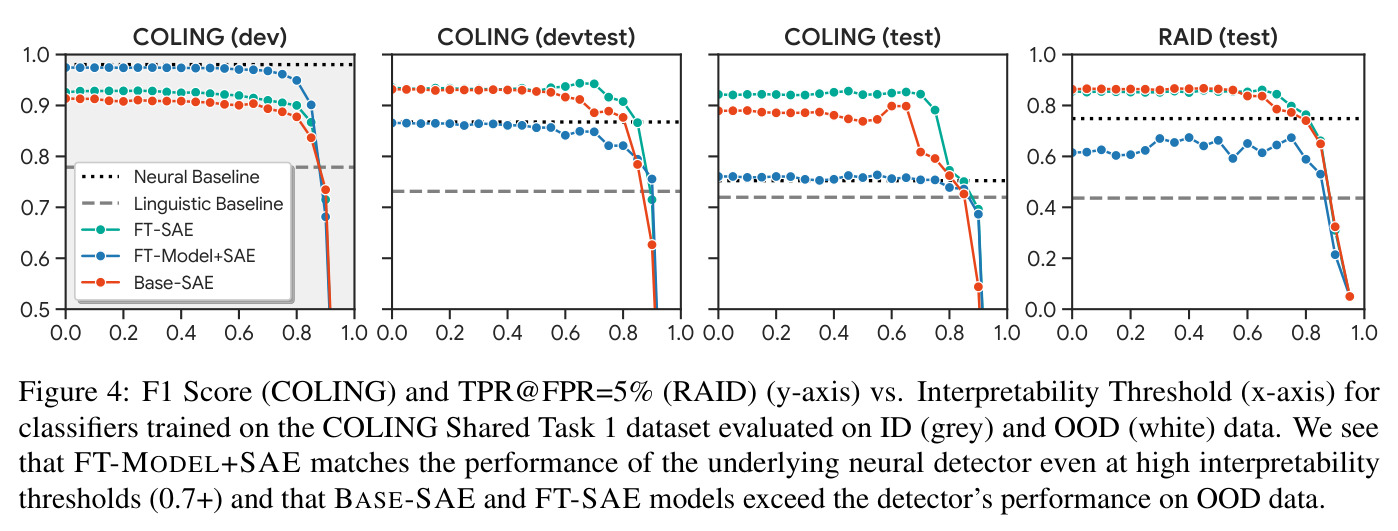
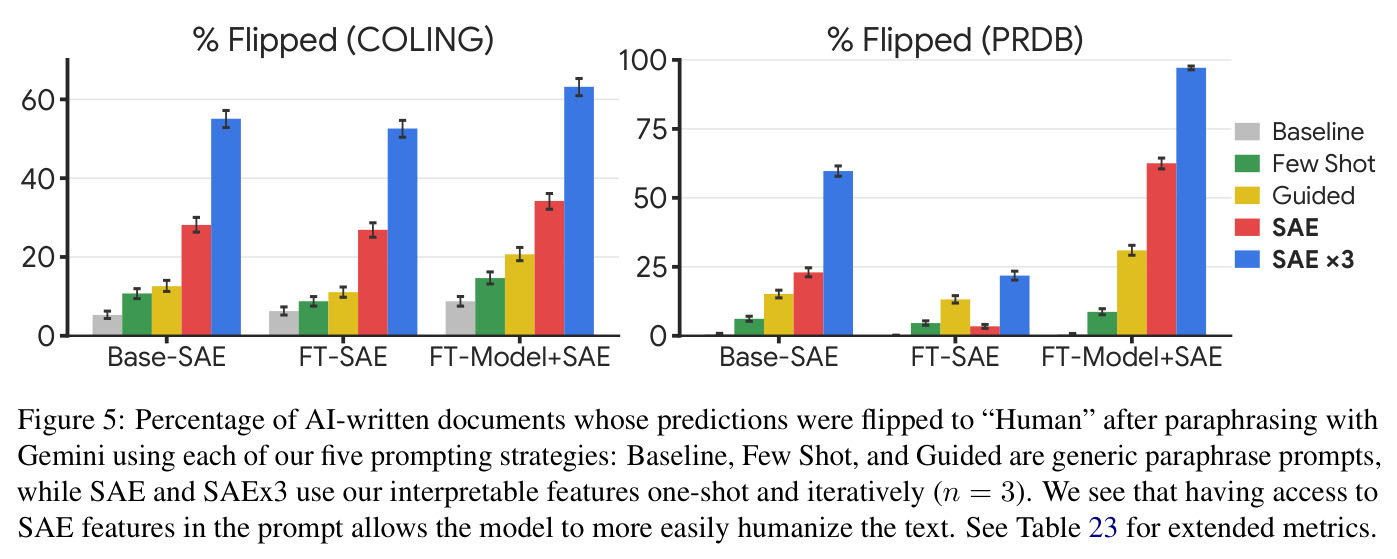
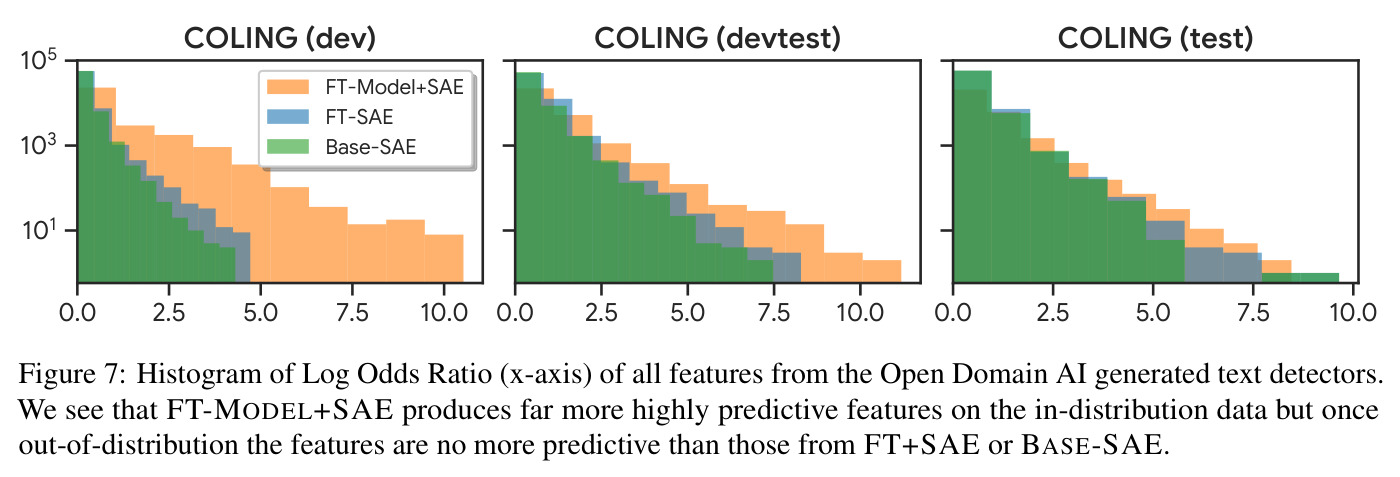
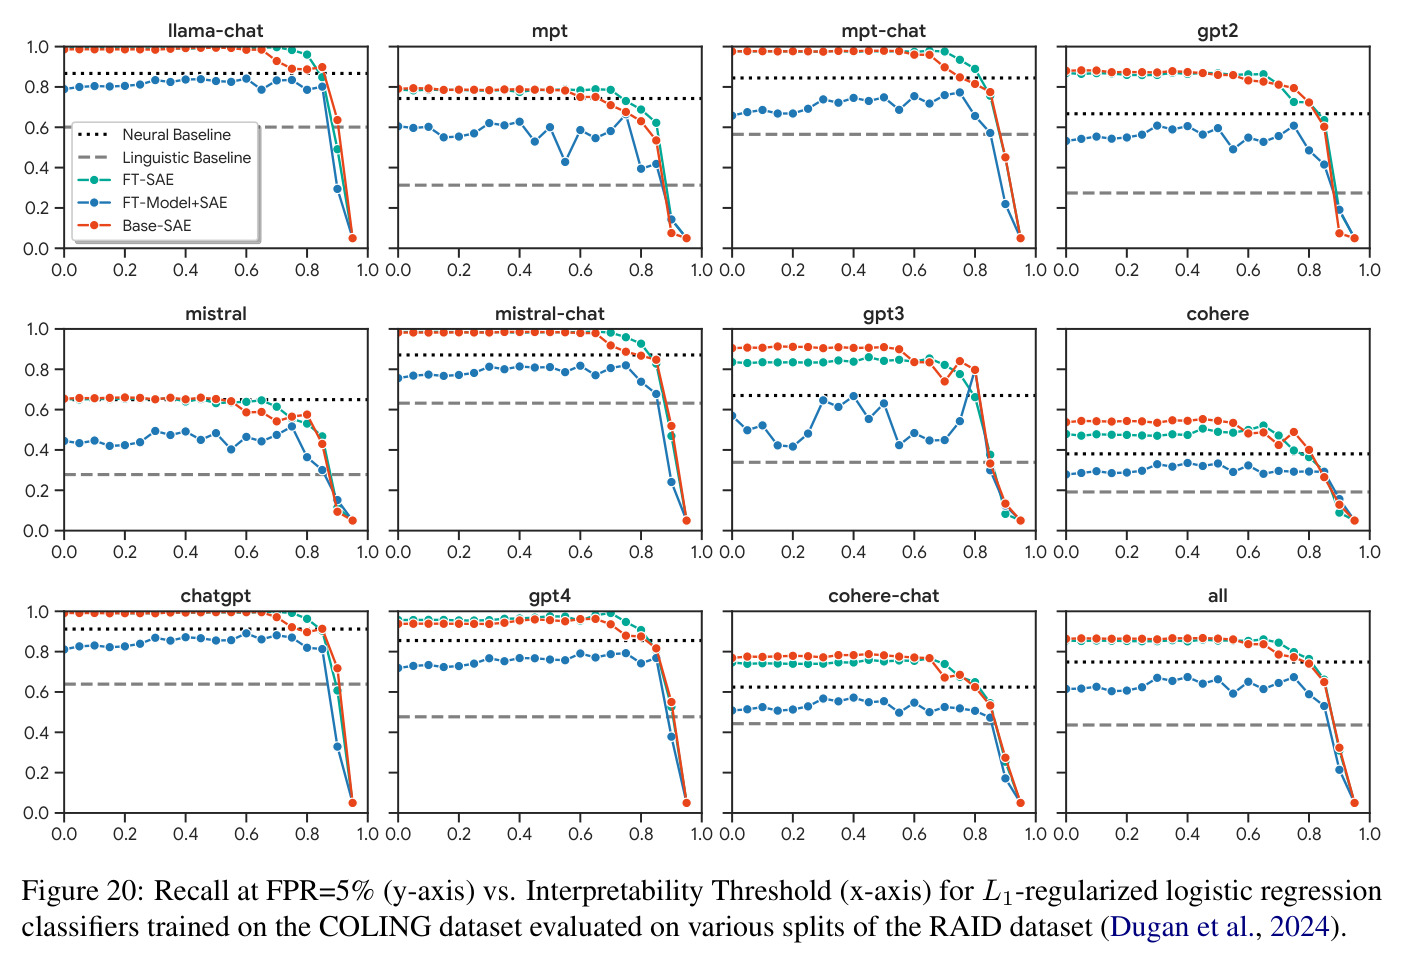
逐项分析。(1) 开放域主实验(Table 1):FT-MODEL+SAE 在分布内完全恢复神经基线——COLING dev AUC 99.5 / F1 97.5 / TPR@FPR=5% 98.1(基线 99.8/98.0/98.9),且 $\tau>0.7$ 掩码后仍有 99.2/96.8/96.7,说明可解释化几乎零成本;但它继承了基线的 OOD 短板(COLING test F1 76.1 vs 基线 75.2)。真正亮眼的是 BASE-SAE 与 FT-SAE:OOD 的 COLING devtest F1 达 93.2–93.5(基线 86.8、Binoculars 81.6),test F1 88.9–92.2(基线 75.2),RAID TPR@5% 达 85.5–86.4(基线 74.9、Binoculars 79.1、Fast-DetectGPT 75.1),论文报告比 Binoculars/Fast-DetectGPT 高约 8–12 F1;$\tau>0.7$ 掩码几乎无损(FT-SAE test F1 92.2、TPR@5% 89.2 反而略升)。(2) PRDB 闭域(Table 2):所有训练过的分类器接近满分(F1 98.4–100,TPR@1% 大多 89.6–100),连 gram2vec 都近乎满分,说明该任务含强捷径特征,为第 8 节的特征审计埋下伏笔。(3) 特征级改写消融(Table 3):重要度分数与定向改写后 logit 变化的 Spearman 相关 $\rho$ 在 PRDB 达 0.69–0.81、符号一致率 89.2–99.1%;COLING 较弱(0.36–0.62),原因是标点类特征无法被保义改写删除;$\tau>0.7$ 一致提升相关性(FT-MODEL+SAE:COLING 0.54→0.62,PRDB 0.69→0.80)。(4) 文档级对抗人性化(Figure 5 / Table 23):通用提示最多翻转 8.7%(常为 0%);把 SAE 证据清单放进提示后一轮攻击翻转率大幅上升,三轮迭代达 60–100%,且编辑量仅 6–29%(一轮)、11–38%(三轮),低于无引导提示的 24–39%——反证特征清单具有高召回与高完备性;FT-SAE(PRDB)最抗攻击,一轮 ASR 仅 3.4%、三轮 21.8%。AUROC 退化远小于 F1(FT-MODEL+SAE COLING 0.96→0.82)。(5) 定性发现(Table 4):AI 侧最预测特征多是格式痕迹,如\"加粗 markdown 标题后的双冒号\"(logit $\Delta$ +0.672,人类 11 篇 vs GPT-4o 54,293 篇)、\"opening square bracket\"(7 vs 22,541 篇)、\"thorough\"一词(+0.993);人类侧则是文体特征:句首第一人称 I(−0.919,78,205 vs 10,209 篇)、指示性\"see\"(−0.836)、表观点的\"seem/seems\"(−0.808)。(6) 描述精确率非正式检查:让 LLM 为部分特征生成正则表达式作真值,约一半特征描述达 99.5+ F1,另一半存在高召回低精确的偏置。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 开放域 OOD 检测(COLING test) | F1 | FT-SAE(τ>0.7 掩码)92.2 | Binoculars 81.4;神经基线 gemma-2-2b 75.2;gram2vec 72.0 | 较 Binoculars +10.8,较神经基线 +17.0 |
| 开放域 OOD 检测(COLING devtest) | TPR@FPR=5% | FT-SAE 92.3(w/o mask 91.2) | Binoculars 67.2;神经基线 77.9 | 较 Binoculars +25.1,较神经基线 +14.4 |
| RAID 非对抗测试(OOD) | TPR@FPR=5% | BASE-SAE 86.4 / FT-SAE 85.5 | 神经基线 74.9;Binoculars 79.1;SpecDetect 77.3 | 较神经基线 +11.5,较 Binoculars +7.3 |
| 分布内检测(COLING dev) | F1 | FT-MODEL+SAE(τ>0.7 掩码)96.8 | 神经基线 98.0 | -1.2(基本持平,掩码几乎无损) |
| 同行评审检测(PRDB test,GPT-4o 与 Llama 3.1 70B 目标) | F1 / TPR@FPR=1% | 三个 SAE 分类器(含掩码)F1 99.8–100,TPR@1% 100 | ReMoDetect 98.4 / 89.6(GPT-4o 目标);gram2vec 99.6 / 100 | 任务近乎饱和,揭示数据集捷径特征而非方法优势 |
| 文档级对抗人性化(2500 篇 AI 文档,COLING+PRDB) | 攻击成功率 ASR(预测翻转为人类的比例) | SAE×3 提示 60–100%(单轮 SAE 提示已大幅高于通用提示) | Baseline 通用提示最高 8.7%(多数条件 0%) | 特征引导改写翻转率为通用提示的 2–10 倍,佐证特征清单的高召回 |
| 描述忠实性(特征级定向改写,PRDB) | 重要度与改写 logit 变化的 Spearman ρ | τ>0.7 掩码后 0.74–0.81(符号一致率 89.2–99.1%) | w/o mask 为 0.69–0.76 | 全局阈值提升相关性最高 +0.11(FT-MODEL+SAE 0.69→0.80) |
局限与改进
作者承认两点局限。其一,自动可解释描述系统性\"高召回、低精确\":若语料中 token \"Tom\" 只在 \"Hello\" 之后出现,描述会写成\"激活于 Tom\"而漏掉对 \"Hello\" 的依赖,且同样的偏置会让该描述在验证时得满分;非正式实验(用 LLM 生成正则当真值)显示约一半特征描述达到 99.5+ F1,另一半存在不同程度的召回偏置。其二,只在 GemmaScope / gemma-2-2b 上验证,未训练 Llama、Qwen 等其他基座的 SAE,BASE-SAE/FT-SAE 的强势是否普适未知。我补充几点观察:(1) FT-MODEL+SAE 的 OOD 失败(test F1 75.4)说明\"可解释化\"救不了不泛化的检测器,论文标题承诺的可审计性必须在 BASE-SAE/FT-SAE 这类基座方案上兑现,方法选择上有隐含的取舍;(2) 模拟分数的生成者与验证者是同一个 gemini-3.1-flash-lite,存在自评分偏环,换模型重测的稳健性未报告;(3) 沿序列 max-pool 丢弃位置与共现信息,逻辑回归假设特征近似可加——作者用 XGBoost 对照证明交互项贡献小,但 PRDB 上 XGBoost 确实能补回 FT-MODEL+SAE 在低 FPR 区的差距;(4) $\tau$ 是手工设定的全局值,未按特征重要性或风险等级差异化;(5) 仅英文、仅 2B 规模基座,向更大模型与多语言扩展的结论均为外推。
独立分析的弱点
弱点一:描述召回偏置直接威胁\"可审计\"承诺。审计者读到的特征描述可能遗漏触发条件(如只认 \"Hello\" 后的 \"Tom\"),在学术诚信申诉这类对抗场景中可能误导人工裁决。改进方向:验证集强制加入难负例与最小对比对,或为每条描述附加\"适用范围/置信区间\"标签,用反事实测试给出描述失效的边界。弱点二:顶级特征大量是格式痕迹(双冒号、方括号、markdown 列表),作者虽论证\"跨上下文稳定出现的格式痕迹可以是有效证据\",但在改写工具普及后会迅速失效,且对导出流程(LaTeX/Markdown)敏感。改进:按特征类型分层评估,提供\"格式特征开关\"让部署方逐条裁决,并定期用新模型家族重训特征库。弱点三:可解释性是双刃剑——文档级实验表明一轮 SAE 引导改写即可翻转 COLING 上约 40–75% 的文档(三轮 60–100%),同一份证据清单既能帮审计也能武装规避者。改进:对证据列表做访问控制、推理期特征子集随机化、或检测\"针对已知特征清单的改写痕迹\"的元特征。弱点四:BASE-SAE 现象缺乏机理解释——为何重建更差(FVU 7–15% 对 1–5%)的 SAE 下游更强?改进:对比两类 SAE 的特征几何与激活统计,用因果干预定位\"AI 文本\"方向在预训练中的来源。弱点五:模拟分数只奖励召回型描述,对\"过宽\"宽容;改进:引入精确率导向的指标(如 token 级 precision@k 或正则精确匹配率)作为第二阈值。
未来方向
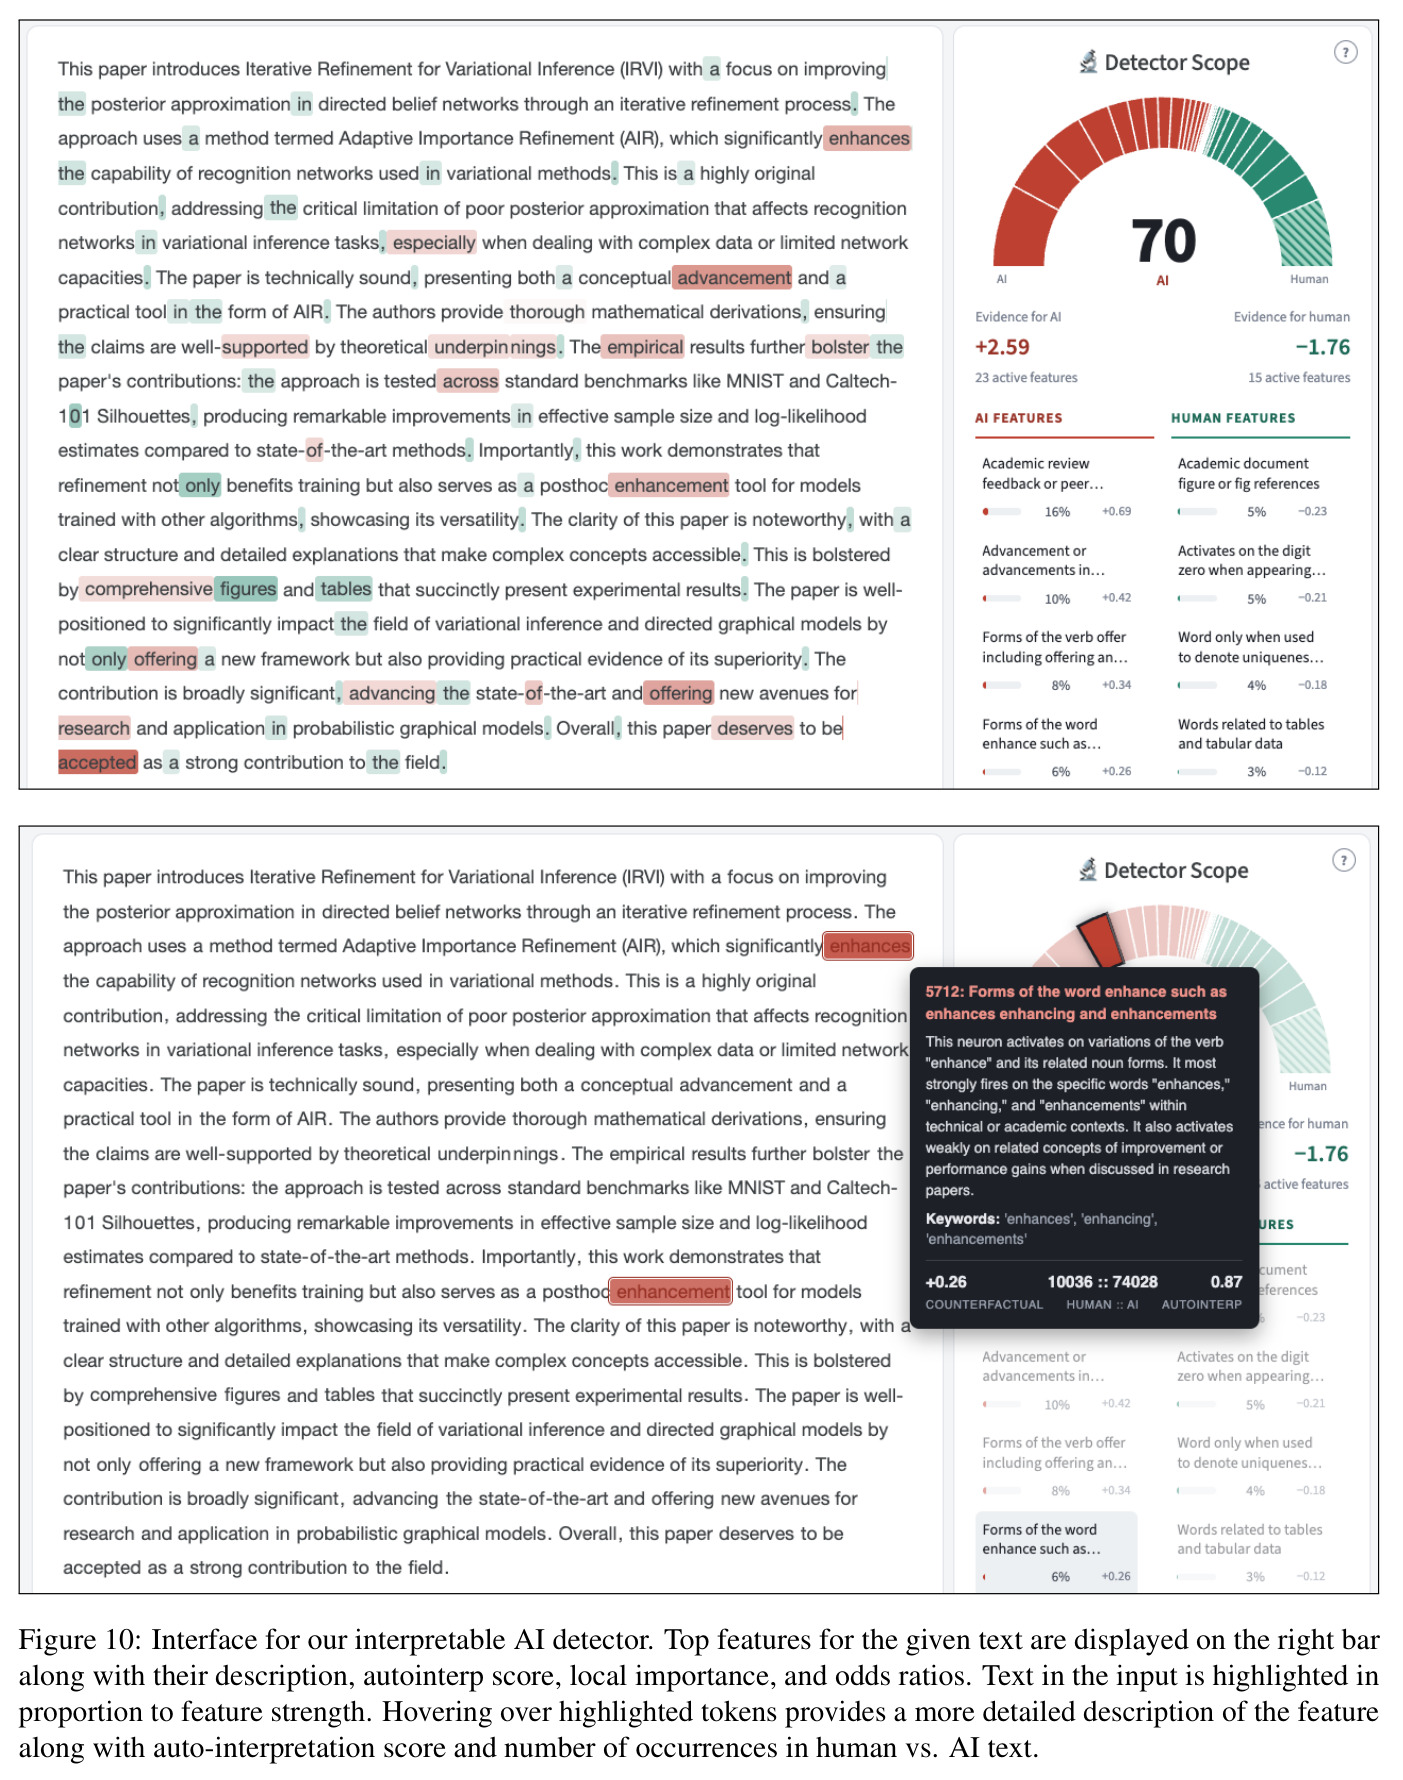
作者明确提出的方向:(1) 用更难的负采样与合成数据生成降低描述召回偏置;(2) 把 SAE 训练扩展到 Llama、Qwen 等其他基座并检验 BASE-SAE/FT-SAE 现象的普适性,尤其是这两个条件为何 OOD 更强;(3) 用这类无监督概念发现做检测器的对抗硬化(adversarial hardening),把特征审计变成持续的安全流程;(4) 研究治理问题——哪些特征允许用于检测(如持续存在的格式痕迹 vs 一次性快捷方式),模型提供方应逐条裁决。基于本文成果可延伸的方向:(1) 把\"SAE+全局忠实性阈值+线性头\"配方迁移到其他高风险分类器——可解释奖励模型、幻觉检测、LLM-as-judge,相关文献已示先例;(2) 完善交互式审计界面(论文 Figure 10 已有原型:激活高亮、悬停详情、动态调 $\tau$),做成评审/招生系统的插件;(3) 反向利用特征清单生成更难的评测数据——按清单定向改写以构造\"特征级可控\"的对抗基准;(4) 从单层 max-pool 走向多层特征组合与电路级解释,刻画 AI 痕迹在网络中的组合方式;(5) 特征级干预的可控文本生成:定向增删概念以做数据增广或去偏;(6) 多语言与代码/公式文本的概念迁移研究。
复现评估
复现条件总体良好。代码与训练好的模型已开源(github.com/google-deepmind/detectorscope);三个数据集全部公开(COLING 共享任务、PRDB、RAID 非对抗测试集 56,000 篇);SAE 基于公开的 GemmaScope width_16k/canonical 权重微调,超参完整给出(JumpReLU、宽度 16,384、稀疏系数 $6\times10^{-4}$、lr $7\times10^{-5}$、4 epochs)。算力门槛中等:SAE 训练共 185 GPU 小时(NVIDIA DGX B200,且四层同时训练以省前向),神经检测器微调 80 小时(单张 RTX A6000),逻辑回归头只需 CPU(激活已缓存为内存映射数组)。主要的外部依赖是 gemini-3.1-flash-lite API——描述生成、验证与全部消融都用它,需要一定 API 预算,且换用其他 LLM 会改变模拟分数分布、需重新校准 $\tau$;论文提示词全部公开(Appendix D/E)。PRDB 多字段评审需按固定 markdown 格式拼接(作者刻意加粗标题以抑制格式捷径,细节已给出)。总体估计:有可解释性经验的团队 1–2 周可复现主表(Table 1/2),数周可复现全部消融;主要不确定性来自 API 行为漂移与文档分桶协议的边角实现。
论文图表
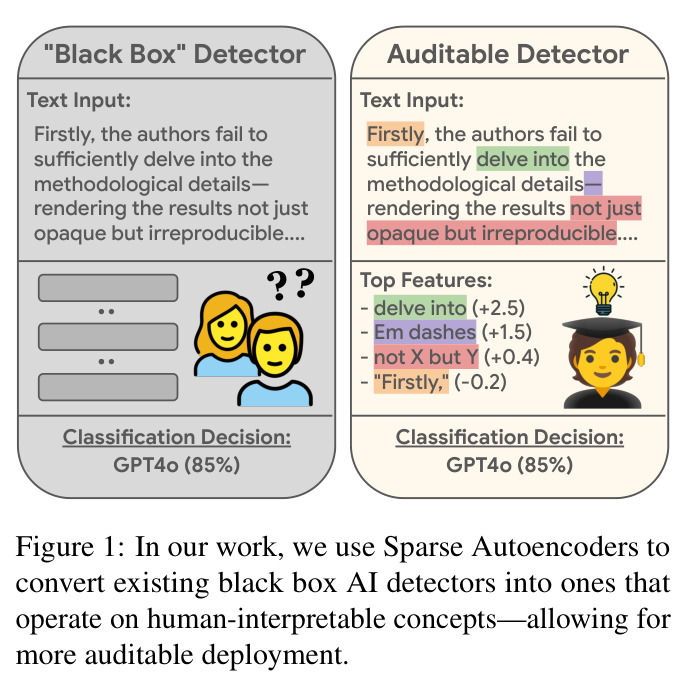
对比"黑箱检测器"与"可审计检测器":同样对一段文本输出 GPT4o (85%) 的判定,黑箱侧的特征栏是不可见的(??),可审计侧列出 "delve into (+2.5)"、"Em dashes (+1.5)"、"not X but Y (+0.4)"、"'Firstly,' (-0.2)" 等带符号权重的可读概念。
一图看懂论文要解决的问题与最终产品形态,是理解全文动机与"可审计"含义的入口。