系统提示词中的隐藏日期会影响 LLM 评测 Dating the Model: Hidden Dates in System Prompts Affect LLM Evaluation
系统提示词中被悄悄注入的当天日期会让 LLM 评测分数逐日漂移,幅度超过批大小等已知因素。
前置知识
系统提示词(System Prompt)
对话模型在用户消息之前接收的一段指令文本,用于设定角色、行为规范和上下文。现代模型把这段文本写进聊天模板的特殊 token 之间;API 用户理论上可以自定义它,但模型厂商的默认模板或推理提供商会在这里追加用户看不到的内容(如当前日期、模型版本等元数据)。
本文的核心发现就是当前日期被自动注入系统提示:这段用户看不见的文本每天都在自动变化,是评测结果逐日漂移的根源,理解系统提示的注入机制才能明白问题为什么'隐藏'。
期望校准误差(ECE)
衡量模型置信度与实际准确率是否对齐的指标。把 $N$ 个样本按预测置信度分成 $M$ 个等宽桶,计算 $ECE = \sum_{m=1}^{M} \frac{|B_m|}{N}\left|\text{acc}(B_m) - \text{conf}(B_m)\right|$,即每个桶内准确率与平均置信度之差的加权绝对值,越低越校准。论文使用 $M=10$。
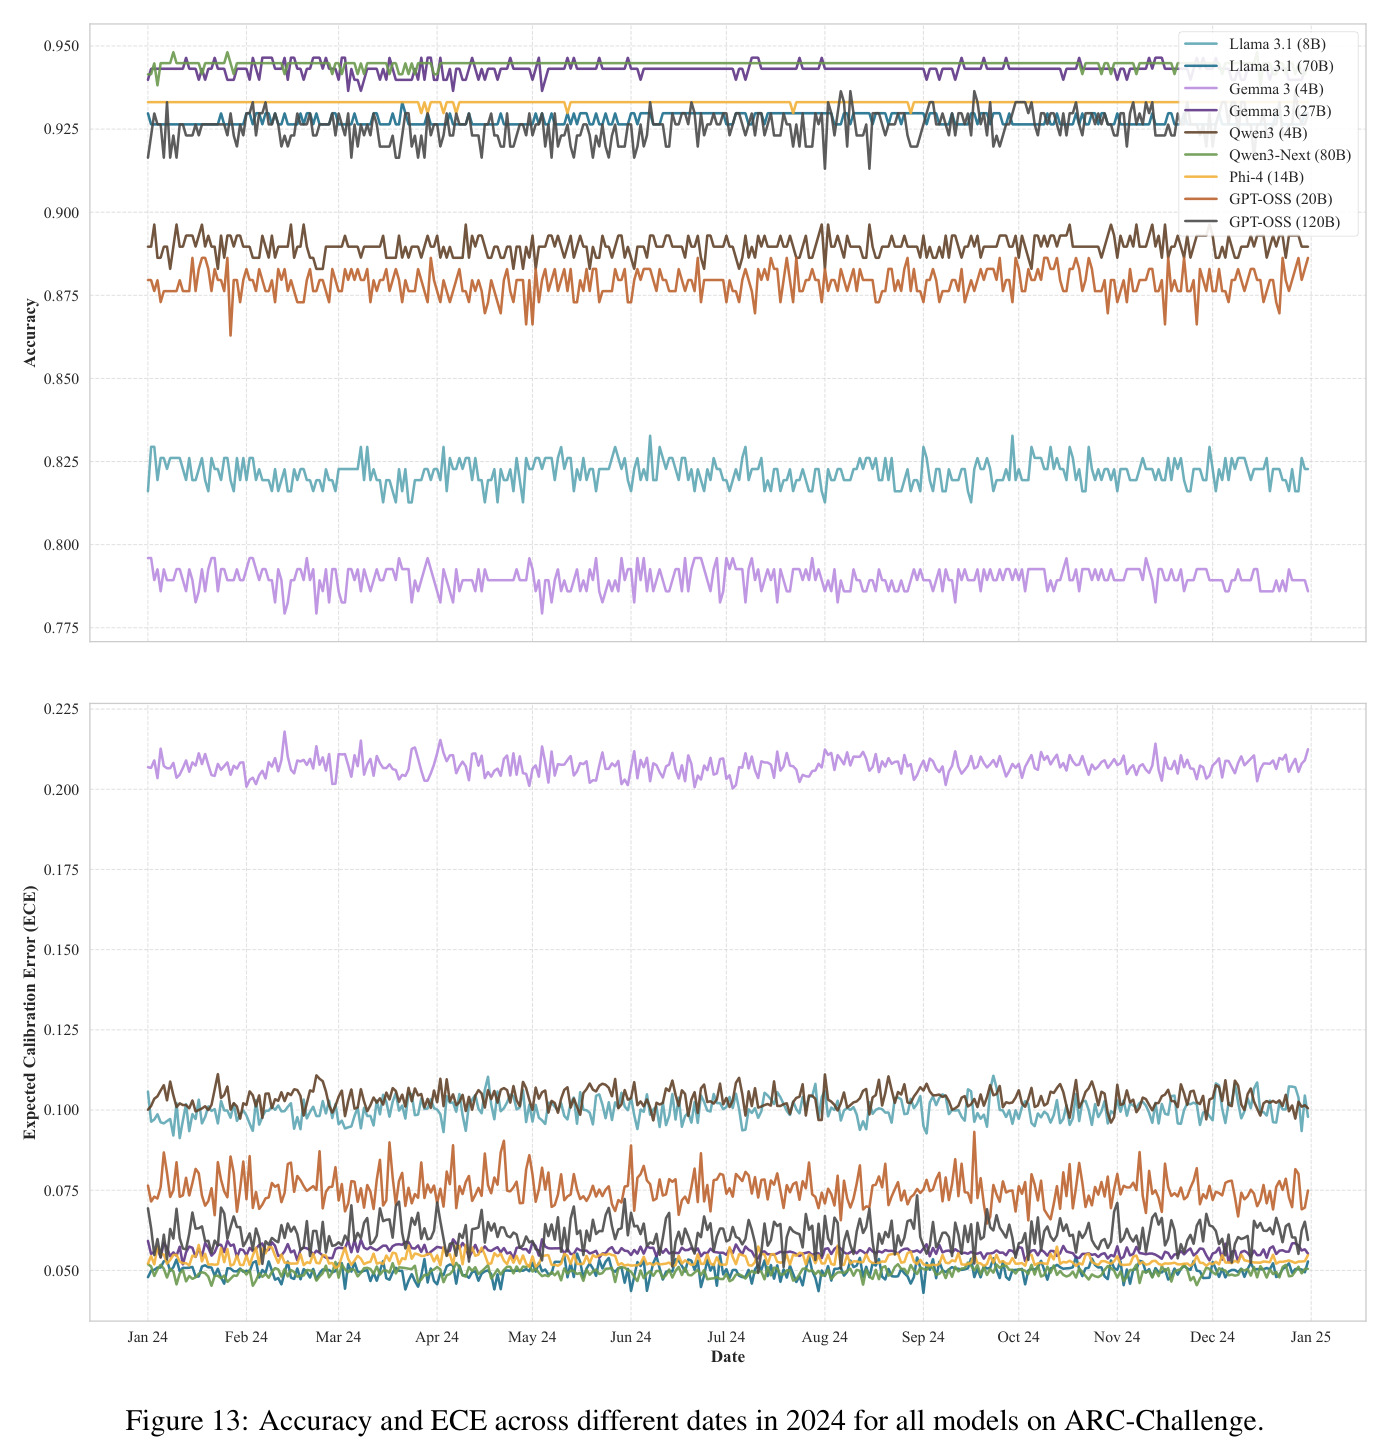
论文用 ECE 证明日期不仅改变模型选哪个答案,还改变模型的自信程度:最差到最佳日期的 ECE 差最高达 6.15%,这是'日期破坏评测'的第二重证据。
非确定性与变异系数(CV)
非确定性指相同配置下模型输出或评测指标仍会变化的现象。本文用'最差日期到最佳日期的差值(delta)'量化日期效应,并在与其他非确定性来源比较时用变异系数 $CV = \sigma/\mu$(标准差除以均值)归一化,使准确率和 ECE 等不同量纲的指标可以放在同一标尺上对比。
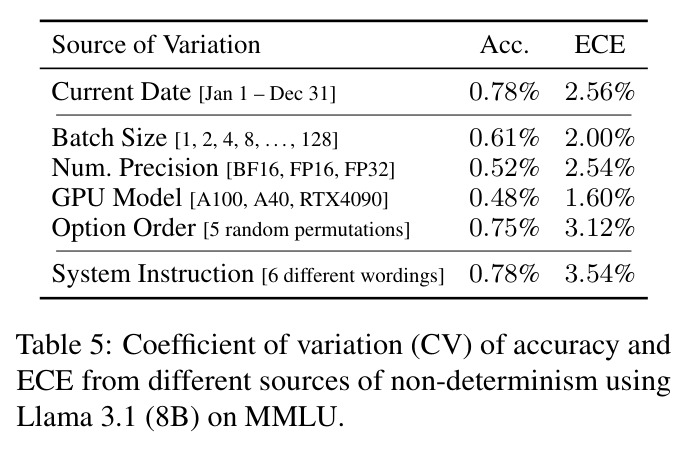
读懂 Table 1/2 的 delta 和 Table 5 的 CV 对比是理解论文结论的关键:日期的准确率 CV 为 0.78%,超过批大小的 0.61%、数值精度的 0.52% 和 GPU 型号的 0.48%。
思维链提示(Chain-of-Thought, CoT)
让模型先输出逐步推理过程再给出最终答案的提示技术。由于 LLM 是自回归生成,开头的 token 会影响后续所有内容,推理链一旦在某处偏离就会级联放大。
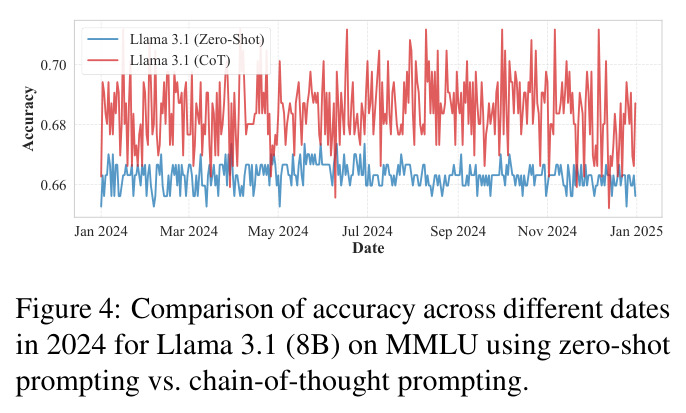
论文最反直觉的结论是 CoT 不但不能缓解日期敏感性反而放大它:日期扰动改变了推理链开头的选择,微小扰动沿着自回归生成滚雪球成完全不同的推理路径和答案。
pass@1、BLEU 与 chrF
pass@1 是代码生成任务中首次生成即通过全部单元测试的比例,是客观的执行级评分;BLEU 基于 n-gram 精确率衡量机器翻译输出与参考译文的相似度;chrF 是字符级 n-gram 的 F 分数。三者分别是论文中代码与翻译任务的报告指标。
论文需要在非 MCQA 任务上排除'单 token 概率读出'这一特殊评测方式的干扰:HumanEval 的 pass@1 和 WMT 的 BLEU/chrF 都是对完整输出的客观评分,效应依然存在才说明问题是普遍的。
研究动机
LLM 评测的可复现性长期受非确定性困扰,但已有研究把原因归结为推理栈的工程因素:He 与 Thinking Machines Lab(2025)和 Yuan 等(2025)证明批大小、数值精度和硬件差异会通过浮点运算误差改变输出;Atil 等(2025)发现即使温度为 0 的'确定性'贪心解码也不稳定;Hochlehnert 等(2025)显示推理基准对随机种子、提示结构和解码超参数高度敏感;Sclar 等(2024)则证明分隔符、空格等提示格式的细微改动就会显著影响性能。本文指出一个被整个社区忽略的因素:当前日期被悄悄注入系统提示。API 提供商会在服务端把日期拼进用户不可见的系统提示(GPT-5.1 在系统提示为空、无工具调用、无联网时仍能答出当天日期);Llama 3.1 和 GPT-OSS 的默认聊天模板会自动在用户系统提示上方插入日期;甚至默认模板不含日期的 Qwen3,经 OpenRouter 调用时同样报出当天日期,证明注入发生在提供商侧。由于这个信息每天自动变化、用户既看不到也无法关闭,同一实验在不同日子运行会得到不同结果,而研究者对此毫无察觉。
本文的目标是本文的目标是严格量化'仅改变当前日期'这单一因素对 LLM 评测的影响。作者构建了完全确定的实验环境:固定提示词、固定解码配置(MCQA 直接读下一个 token 概率,生成任务固定随机种子并启用确定性 CUDA),只把系统提示中的日期从 2024 年 1 月 1 日扫描到 12 月 31 日、覆盖 365 天,从而把一切性能波动干净地归因于日期。具体回答四个问题:(1) 在 9 个模型、6 个数据集、4 类任务上,性能随日期变化的幅度有多大;(2) 模型排行榜是否因此重排;(3) 与批大小、数值精度、GPU 型号、选项顺序、系统提示措辞等其他非确定性来源相比,日期效应处于什么量级;(4) 思维链和 5-shot 提示等常用技术能否消除该效应。最终给出可操作的协议建议:尽量从聊天模板中删除日期,否则固定日期并随结果一并报告。
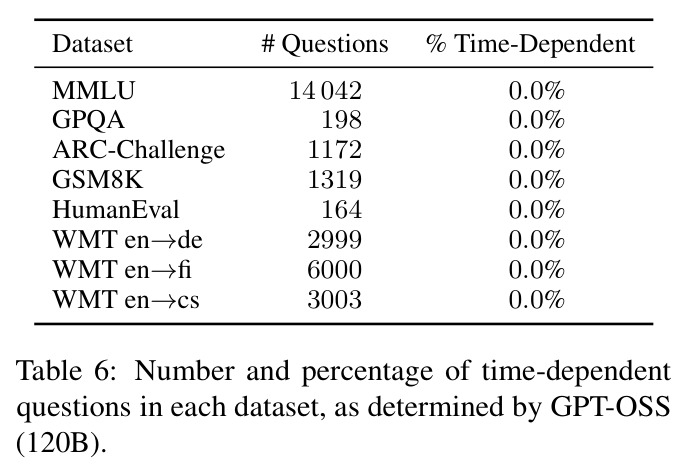
与已有工作不同的是,以往非确定性研究聚焦于批处理、数值精度、GPU、随机种子等推理层因素,或提示格式敏感性(Sclar 等 2024)。这些因素要么研究者可以控制并记录,要么至少在一次实验内保持恒定。本文的独特切入是发现了一个随时间自动变化、对用户不可见且无法关闭的提示元数据——当前日期。它与选项顺序、提示措辞同属'提示表层扰动',但有三点独有属性:(1) 时间性,每天自动变化,使昨天和今天的评测天然不可比;(2) 隐蔽性,注入发生在聊天模板或提供商侧,标准交互和 API 日志中完全看不到;(3) 不可控性,API 用户无法像改批大小那样把它固定。另外,作者用 LLM 辅助审计(让 GPT-OSS 120B 逐题判断)验证 8 个数据集的题目均与时间无关(时间依赖题比例全部为 0.0%,见 Table 6),排除了'题目本身随时间变化'的混淆解释,使'性能变化完全由日期引起'的因果归因干净成立。
核心方法
整体思路是极端控制变量:在完全确定的推理配置下,把系统提示中的日期当作唯一自变量做全年扫描。实验覆盖 9 个近期模型(Llama 3.1 8B/70B、Gemma 3 4B/27B、Qwen3 4B、Qwen3-Next 80B、Phi-4 14B、GPT-OSS 20B/120B)和 6 个数据集:MCQA 用 MMLU(14042 题)、GPQA(198 题)、ARC-Challenge(1172 题),数学推理用 GSM8K(1319 题),代码生成用 HumanEval(164 题),机器翻译用 WMT 英德/英芬/英捷三个语言对。每个模型每个数据集跑 365 次(每天一次)。MCQA 报告准确率和期望校准误差 ECE,GSM8K 报告准确率,HumanEval 报告 pass@1,翻译报告 BLEU 和 chrF,核心汇总是最差日期到最佳日期的差值(delta)。作者验证了固定日期下输出完全确定:GPT-5.1 的 42 次重复运行得分全部相同,因此所有波动只能来自日期。
核心创新是把'当前日期'从一个被忽略的背景变量提升为被系统研究的实验因子。直觉依据是:系统提示在 SFT 和 RLHF 阶段通常是固定的,模型对提示的任何微小改动都很脆弱,而日期恰恰是每个请求都在变化却无人注意的改动。技术上,作者给所有模型使用统一模板:系统段为 'Current date: {current_date}.',用户段为题目本身,中间用各模型专属的特殊 token 拼接(Figure 6-10),保证除日期外的一切逐字节相同。与已有工作的本质区别有三:(1) He、Lab、Yuan 等研究的是推理系统工程误差,日期效应则是提示表层扰动,但量级反而更大;(2) 它是'隐藏'的——Llama 3.1、GPT-OSS 的默认聊天模板自动在用户系统提示上方插入日期,OpenRouter 等提供商会服务端注入,研究者事后无法察觉;(3) 由于配置完全确定、题目经审计与时间无关(Table 6 显示所有数据集时间依赖题为 0.0%),任何准确率变化都可归因于日期这一个变量,这是以往提示敏感性研究没有做到的干净程度。
方法步骤详情
第一步,构造提示:MCQA 用系统 'Current date: {date}.' 加四选一题目(Figure 6),从'空格+选项标签'的下一个 token 概率读出预测,并按各模型分词器选择正确的标签编码;CoT 版本要求先逐步推理再输出 'The answer is X.';GSM8K 以 'Answer: ' 结尾;HumanEval 补全函数后跑单元测试算 pass@1;翻译输出译文后算 BLEU/chrF(Figures 7–10)。第二步,解码控制:MCQA 无采样,生成任务用默认温度和 top-p、固定随机种子、开启确定性 CUDA。第三步,2024 年每天跑一次得到逐日成绩曲线。第四步,模式分析:对 27 个模型-数据组合算日期与准确率的 Spearman 相关,同模型跨数据集 27 组、同数据集跨模型 108 组算 Pearson 相关及同向比例。第五步,对照实验:用 CV 比较批大小 1–128、BF16/FP16/FP32、三种 GPU、5 种选项排列、6 种系统措辞。第六步,GPT-5.1 验证与置信度分析。
技术新颖性
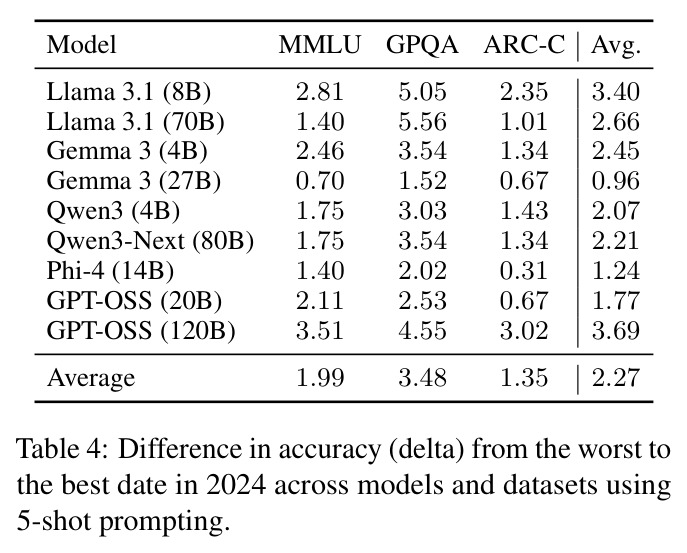
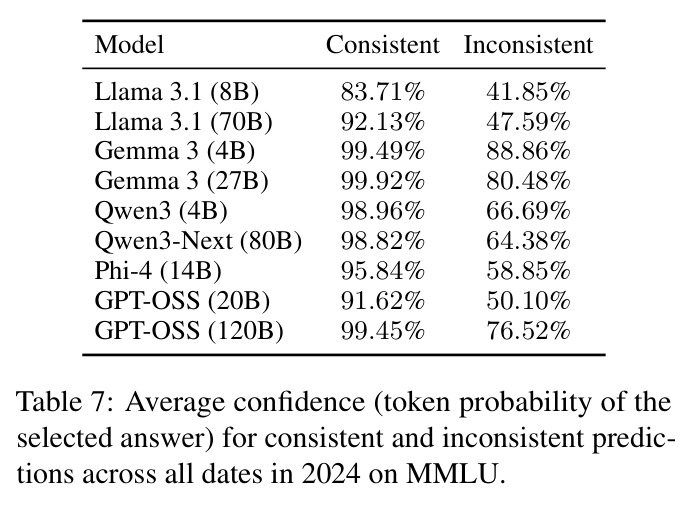
技术新颖性体现在三点。第一,问题发现本身:这是首个指出隐藏日期注入会系统性扰动 LLM 评测的工作,把可复现性文献的关注点从硬件与批处理扩展到提示元数据,并证明这个新因素的效应量反而超过批大小、数值精度和 GPU 型号等已知来源(Table 5 中日期的准确率 CV 为 0.78%,高于批大小 0.61%、精度 0.52%、GPU 0.48%)。第二,反直觉结论:思维链不仅不能缓解反而放大日期敏感性——日期影响思维链开头 token 的选择,自回归特性使微小扰动级联成不同推理路径(Figure 4);5-shot 也无效(平均 delta 2.27% vs 零样本 2.52%)。第三,机制解释与等效性证据:不一致预测的平均置信度显著低于一致预测(Llama 3.1 8B 为 41.85% vs 83.71%,Table 7),说明日期只在模型不确定的题目上起作用;而刻意改写系统提示措辞的 CV 与日期效应完全相同(准确率 CV 均为 0.78%),支持'模型对任何系统提示变化都脆弱,日期只是其中一种隐蔽的每日自动变化'这一假说。
实验结果
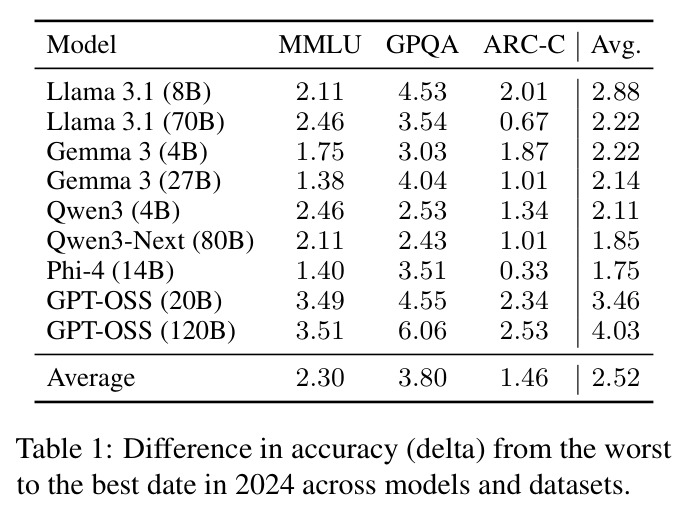
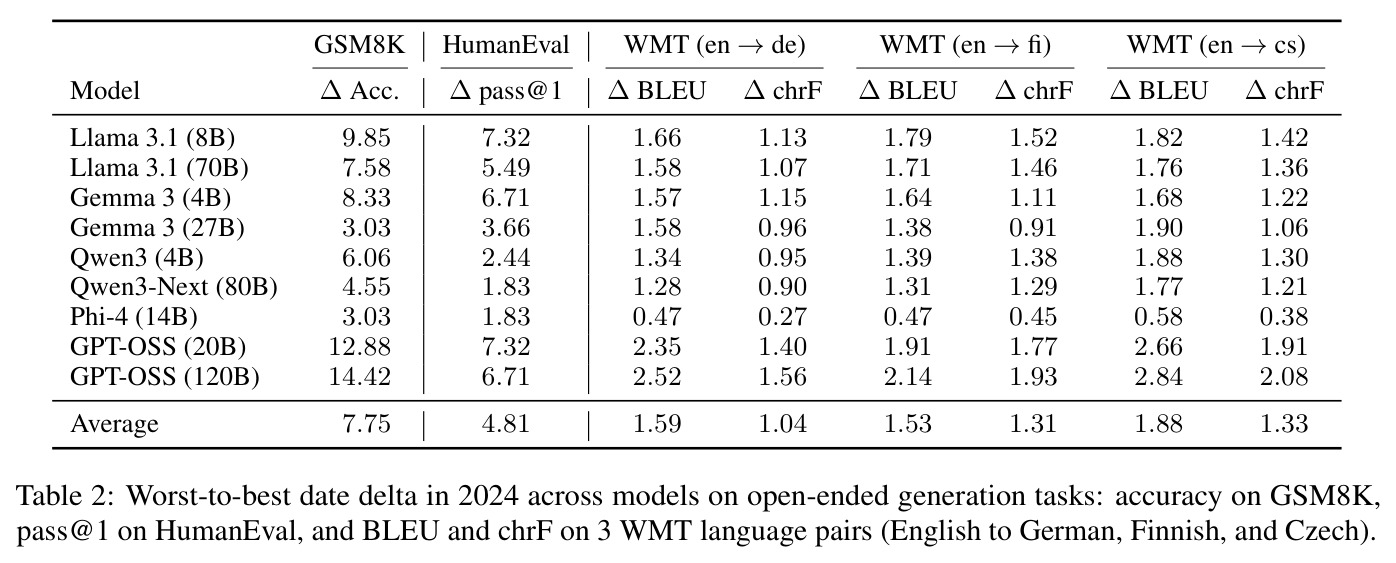
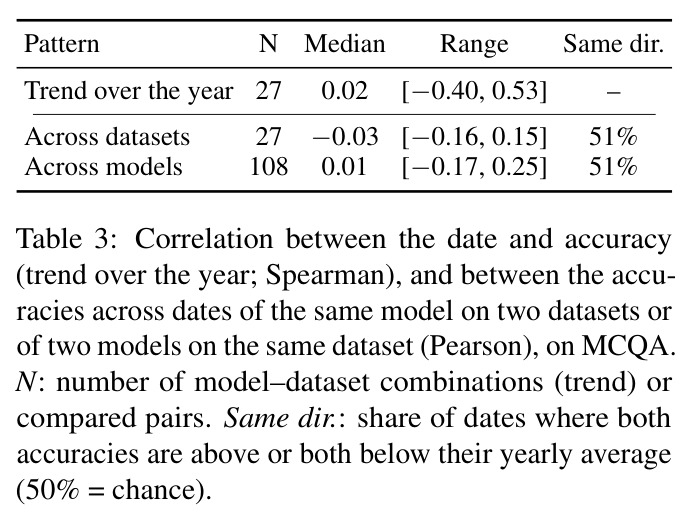
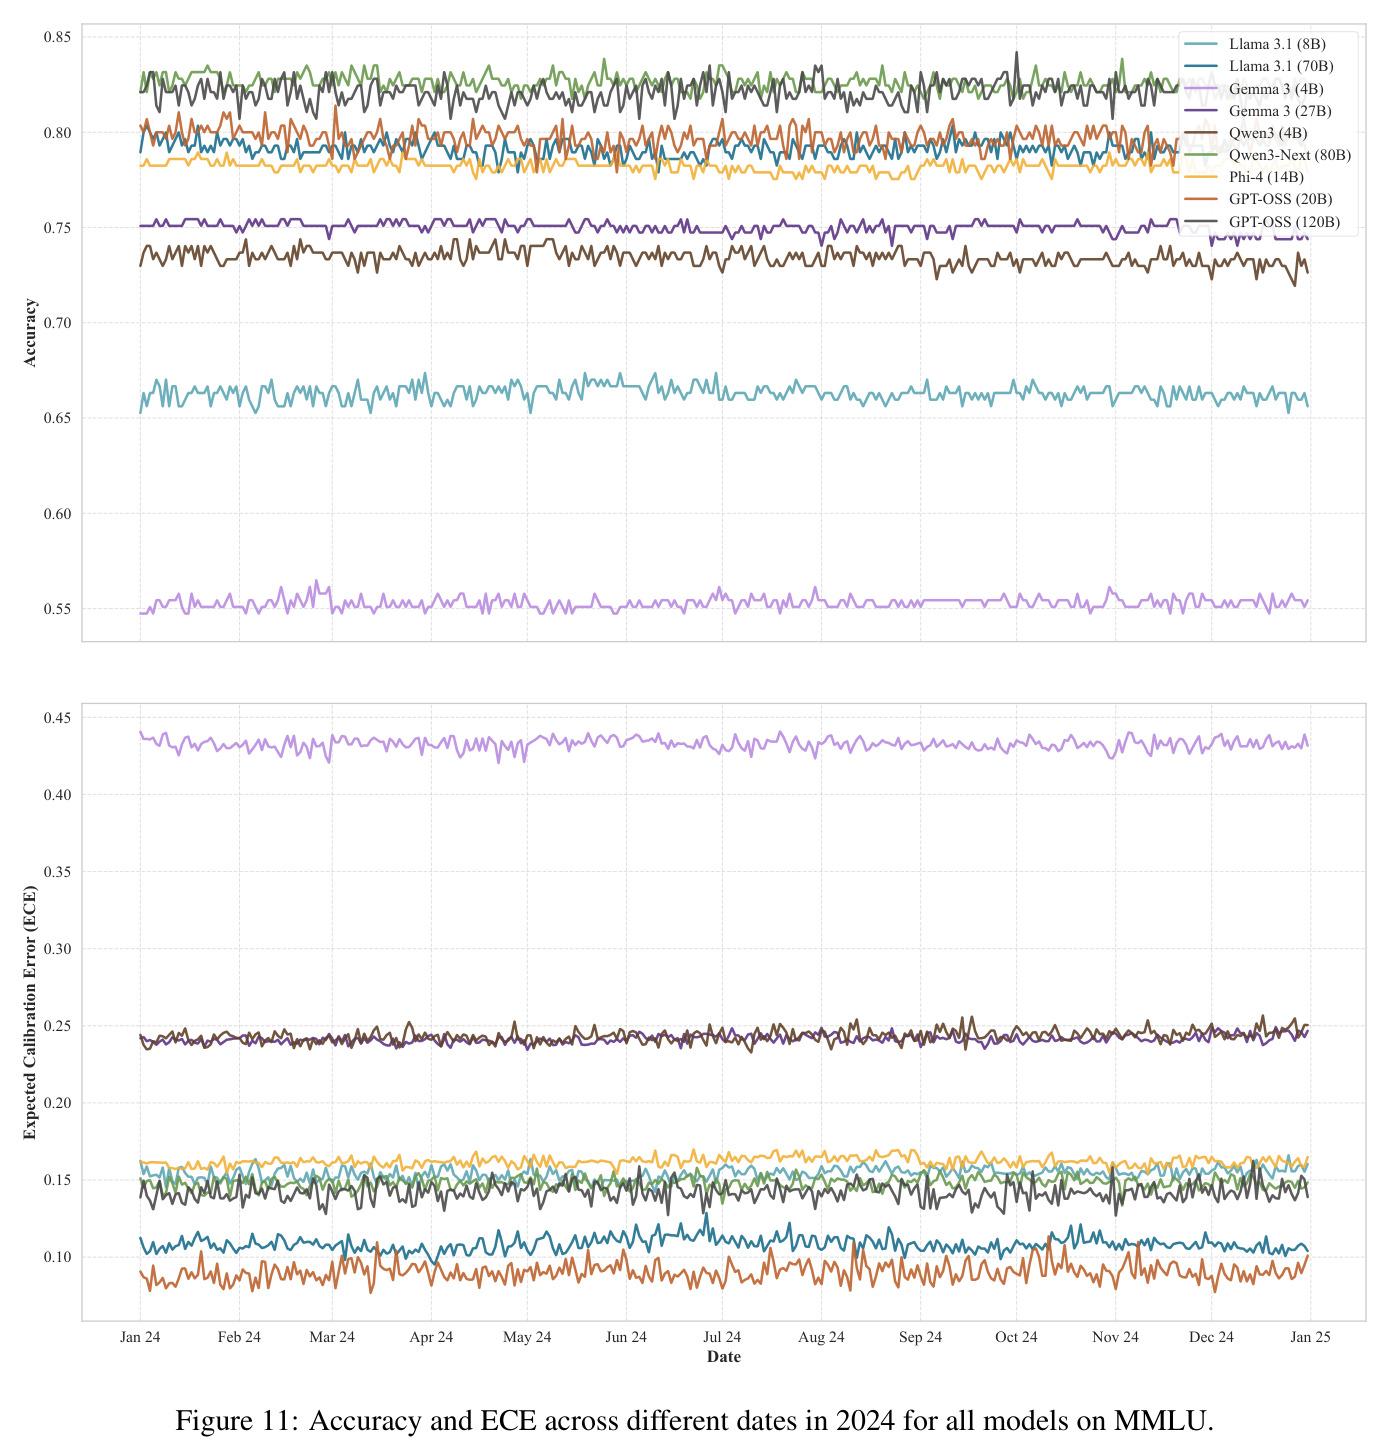
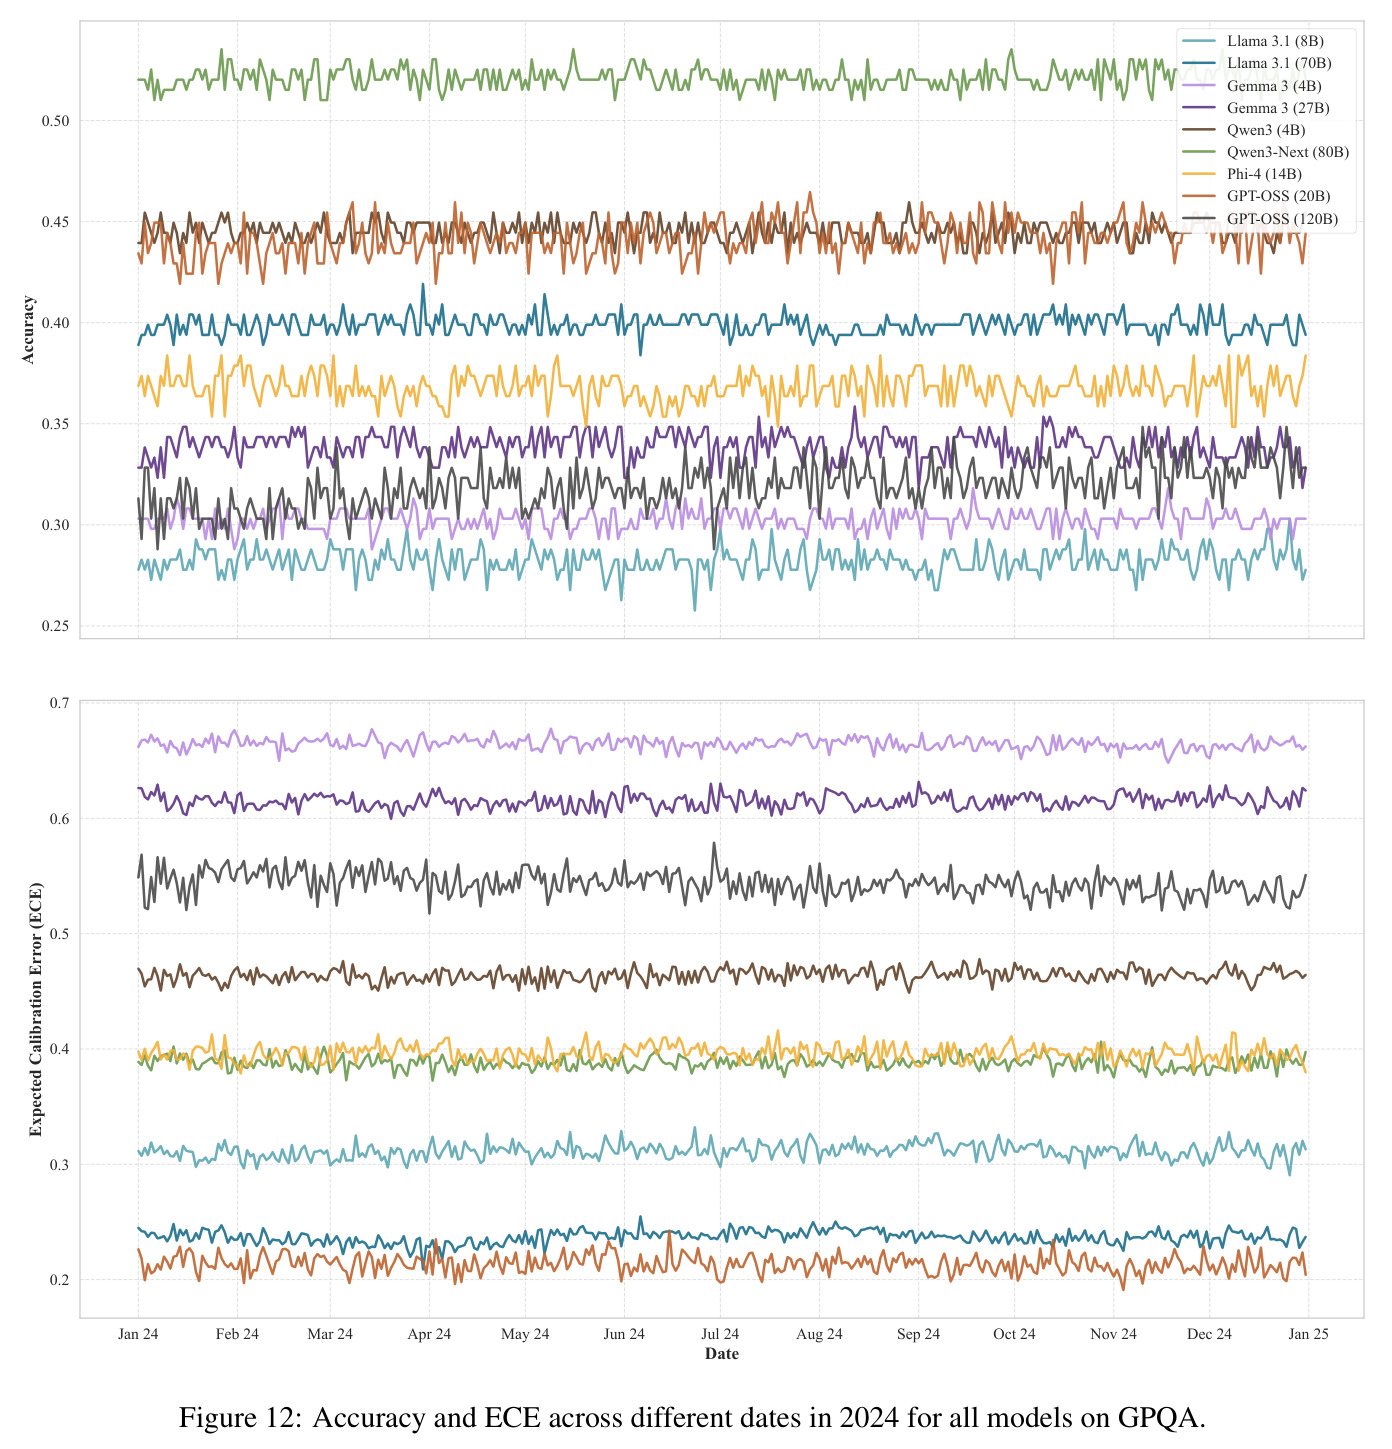
多选 QA:9 个模型在 MMLU/GPQA/ARC-C 上仅因日期不同,最差到最佳准确率平均差 2.52%(Table 1),GPT-OSS 120B 在 GPQA 达 6.06%;排行榜随之重排:6 月 26 日 MMLU 冠军 Qwen3-Next 80B,次日易主 GPT-OSS 120B(Figure 1b);ECE 最高差 6.15%。生成任务效应更大(Table 2):GSM8K 平均 7.75%、GPT-OSS 120B 达 14.42%;HumanEval pass@1 平均 4.81%、最高 7.32%;翻译平均最高 1.88 BLEU、1.33 chrF,英捷方向达 2.84 BLEU。专有模型 GPT-5.1 一周内 GPQA 也波动近 4%。模式分析(Table 3):日期-准确率 Spearman 相关中位数仅 0.02,跨数据集/跨模型同向各约 51%,无'好日期'。对照实验(Table 5):日期准确率 CV 0.78%,超过批大小 0.61%、精度 0.52%、GPU 0.48%。不注入日期时成绩落在全年区间内(Table 9),日期是纯噪声源。
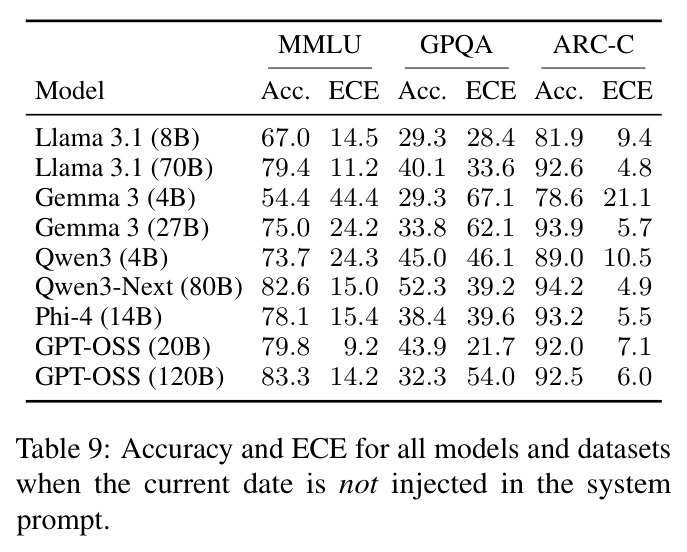
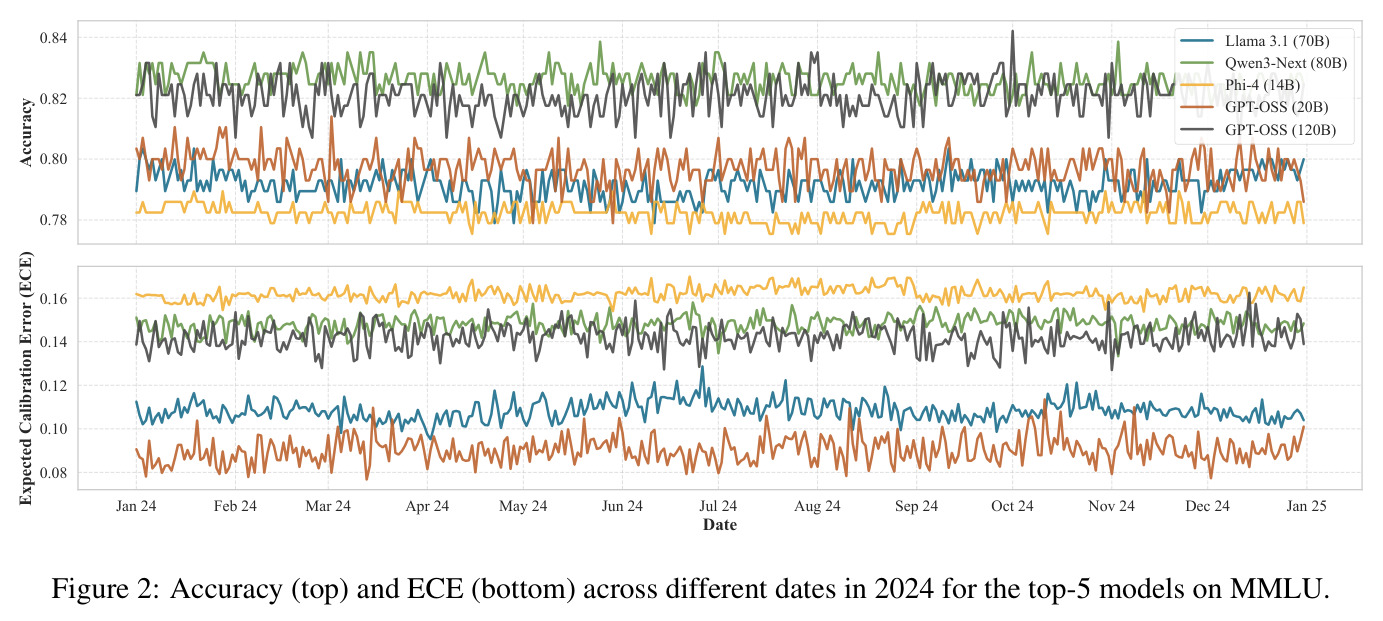
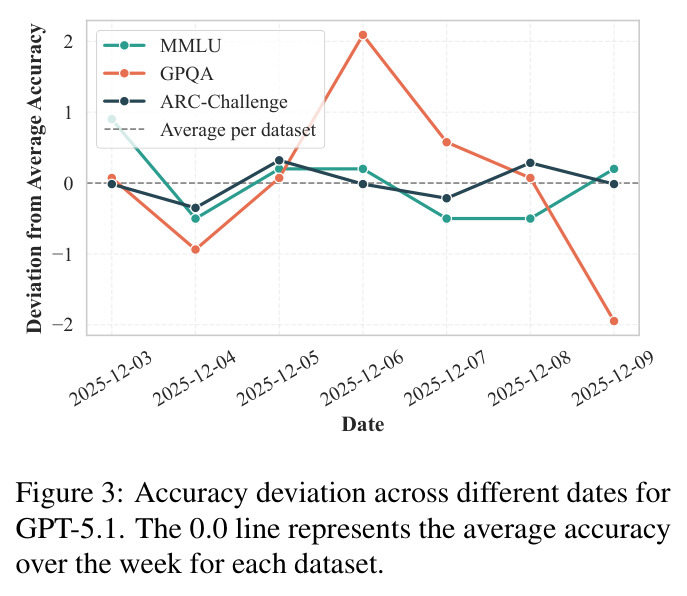
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 多选题 QA(MMLU) | 准确率最差-最佳日期差(百分点) | 最高 3.51(GPT-OSS 120B),9 模型平均 2.30 | 固定日期时多次运行完全一致(差为 0) | 仅改日期即引入最高 3.51 个百分点的不可控波动 |
| 多选题 QA(GPQA) | 准确率最差-最佳日期差(百分点) | 最高 6.06(GPT-OSS 120B),平均 3.80 | 固定日期时差为 0 | 专有模型 GPT-5.1 一周内也波动近 4 个百分点 |
| 数学推理(GSM8K) | 准确率最差-最佳日期差(百分点) | 最高 14.42(GPT-OSS 120B),平均 7.75 | 固定日期时差为 0 | 生成式任务效应约为 MCQA 平均(2.52)的 3 倍 |
| 代码生成(HumanEval) | pass@1 最差-最佳日期差(百分点) | 最高 7.32(Llama 3.1 8B 与 GPT-OSS 20B),平均 4.81 | 固定日期时差为 0 | 执行级客观评分下效应依然存在,排除评测方式干扰 |
| 机器翻译(WMT en→cs) | BLEU 最差-最佳日期差 | 最高 2.84(GPT-OSS 120B),平均 1.88(chrF 最高 2.08) | 完全确定的解码设置下差为 0 | 波动远超 MT 领域常以零点几 BLEU 报告的进步幅度 |
| 非确定性来源对比(Llama 3.1 8B, MMLU) | 准确率变异系数 CV | 日期效应 0.78% | 批大小 0.61%、数值精度 0.52%、GPU 型号 0.48% | 日期效应超过批大小、精度、硬件,与选项顺序(0.75%)和措辞改写(0.78%)相当 |
局限与改进
作者承认的局限:模型和数据集覆盖有限(9 个模型、6 个数据集、4 类任务);专有模型只测了 GPT-5.1 一周;完整扫描每模型每数据集需 365 次运行、成本高,对话、摘要等开放式任务未覆盖;日期只以固定格式、固定位置注入且只扫描了 2024 年,其他格式、位置和年份的敏感性未知。我补充几点观察:第一,'最差到最佳 delta'是极差统计,取 365 个点中的两个极值,会系统性高估典型波动,论文没有同时报告逐日标准差或分布形状;第二,'SFT/RLHF 中系统提示固定导致模型脆弱'只是机制假说,证据是间接的(措辞改写等效性、置信度分析),没有通过在训练时随机化日期做因果干预验证;第三,MCQA 用答案 token 概率读出是评测社区的特定做法,真实多轮对话中日期的影响路径可能不同;第四,用户位置实验(Figure 14)只在 Llama 3.1 8B 和 MMLU 上做了初步探索,不足以支撑普遍结论;第五,论文未做显著性检验或置信区间,个别小 delta(如 Phi-4 在 WMT 上仅 0.58 BLEU)可能接近实现层面的测量噪声。
独立分析的弱点
(1) 极差指标——最差到最佳 delta 取 365 天两个极值,会夸大典型波动,应同时报告标准差与分位数区间;(2) 机制证据不足——'SFT/RLHF 固定系统提示导致脆弱'只是类比假说,应做干预实验:用随机化日期/措辞微调模型,观察敏感性是否消失;(3) 单一注入方式——只用 'Current date: {date}.' 这一种格式和位置,应扫描多种格式(ISO/自然语言)、位置(前缀/后缀)和训练截止后的年份;(4) 任务代表性——MCQA 读单 token 概率并非真实用法,应测试对话与智能体任务中日期对多轮行为和工具调用的影响;(5) 缓解方案未验证——作者建议删日期或固定日期,但没有量化删除后时序问答能力的损失,也未评估固定某天是否引入方向性偏差;(6) 汇总层面分析——同家族模型共享分词器与聊天模板却无跨模型相关,值得逐题层面的细粒度解释。每个弱点都对应一个具体可做的后续实验。
未来方向
作者提出的方向:扩展到更多 LLM、任务(对话、摘要)和其他日期格式/位置/年份;作者只对用户位置做了初步实验(Figure 14 显示改变用户所在国家对 Llama 3.1 8B 在 MMLU 的影响与日期效应相当),并呼吁关注模型版本、位置等所有隐藏元数据。基于本文成果可延伸:(1) 训练侧修复——在 SFT/RLHF 中随机化日期(date augmentation),研究评测稳定性与时序能力的权衡;(2) 协议标准化——把'报告评测日期'写入模型卡和排行榜规范,要求固定日期或使用去日期模板;(3) 逐题脆弱性预测——用置信度/校准信号预测哪些题目易被元数据翻转,构建鲁棒题目子集或加权指标;(4) 理论建模——解释思维链为何放大而非吸收前缀扰动,与 Sclar 等的格式敏感性理论统一;(5) 检测工具——开发影子测试(如直接问模型今天几号)自动探测提供商是否注入日期/位置,帮助研究者在评测前审计推理环境。
复现评估
论文方法学披露完整:附录给出全部提示模板(Figures 6–10)、解码细节(默认温度和 top-p、固定种子、确定性 CUDA)、ECE 公式($M=10$ 等宽桶)、6 种系统提示措辞全文,并验证固定日期下 42 次运行零方差。除 GPT-5.1 需 API 外,所有模型均为开放权重,数据集全部公开。主要障碍是算力:完整复现每模型每数据集 365 天扫描,如 MMLU 14042 题 × 365 天 ≈ 512 万次前向(MCQA 只读单 token 概率尚可承受),WMT en→fi 6000 句 × 365 天 ≈ 219 万次完整生成,9 个模型叠加后开销可观,80B 级模型需多卡。务实路径是先取 2–3 个模型、每月抽 10–15 天做稀疏扫描验证效应存在,再按需扩展。论文未明确给出代码开源链接,提示与协议需按附录手工实现,工作量中等。整体:方法易复现、全量算力门槛高。
论文图表
(a) 展示 GPT-5.1 在隐藏系统提示含 {current_date}、用户提示只有'What is today's date?'的情况下直接答出 2025-12-03,说明日期确实被服务端注入且用户不可控;(b) 展示 2024 年 6 月 26 日与 27 日连续两天的 MMLU 前五排行榜,仅日期不同,第一名就从 Qwen3-Next (80B) 变为 GPT-OSS (120B),多对模型互换座次。
一图点题:同时呈现'隐藏注入'这一现象和'排行榜重排'这一后果,是全文动机与最直观证据的浓缩。
Qwen3 经 OpenRouter 调用(系统提示为空、无工具、无联网)时回答'今天是 2026 年 7 月 10 日',并自述这是基于所提供上下文推断的。由于 Qwen3 默认聊天模板不含日期,说明提供商在服务端注入了日期。
把问题范围从'自带日期模板的模型'扩展到'任何经第三方提供商调用的模型',说明即使选了无日期模板也躲不开该效应。
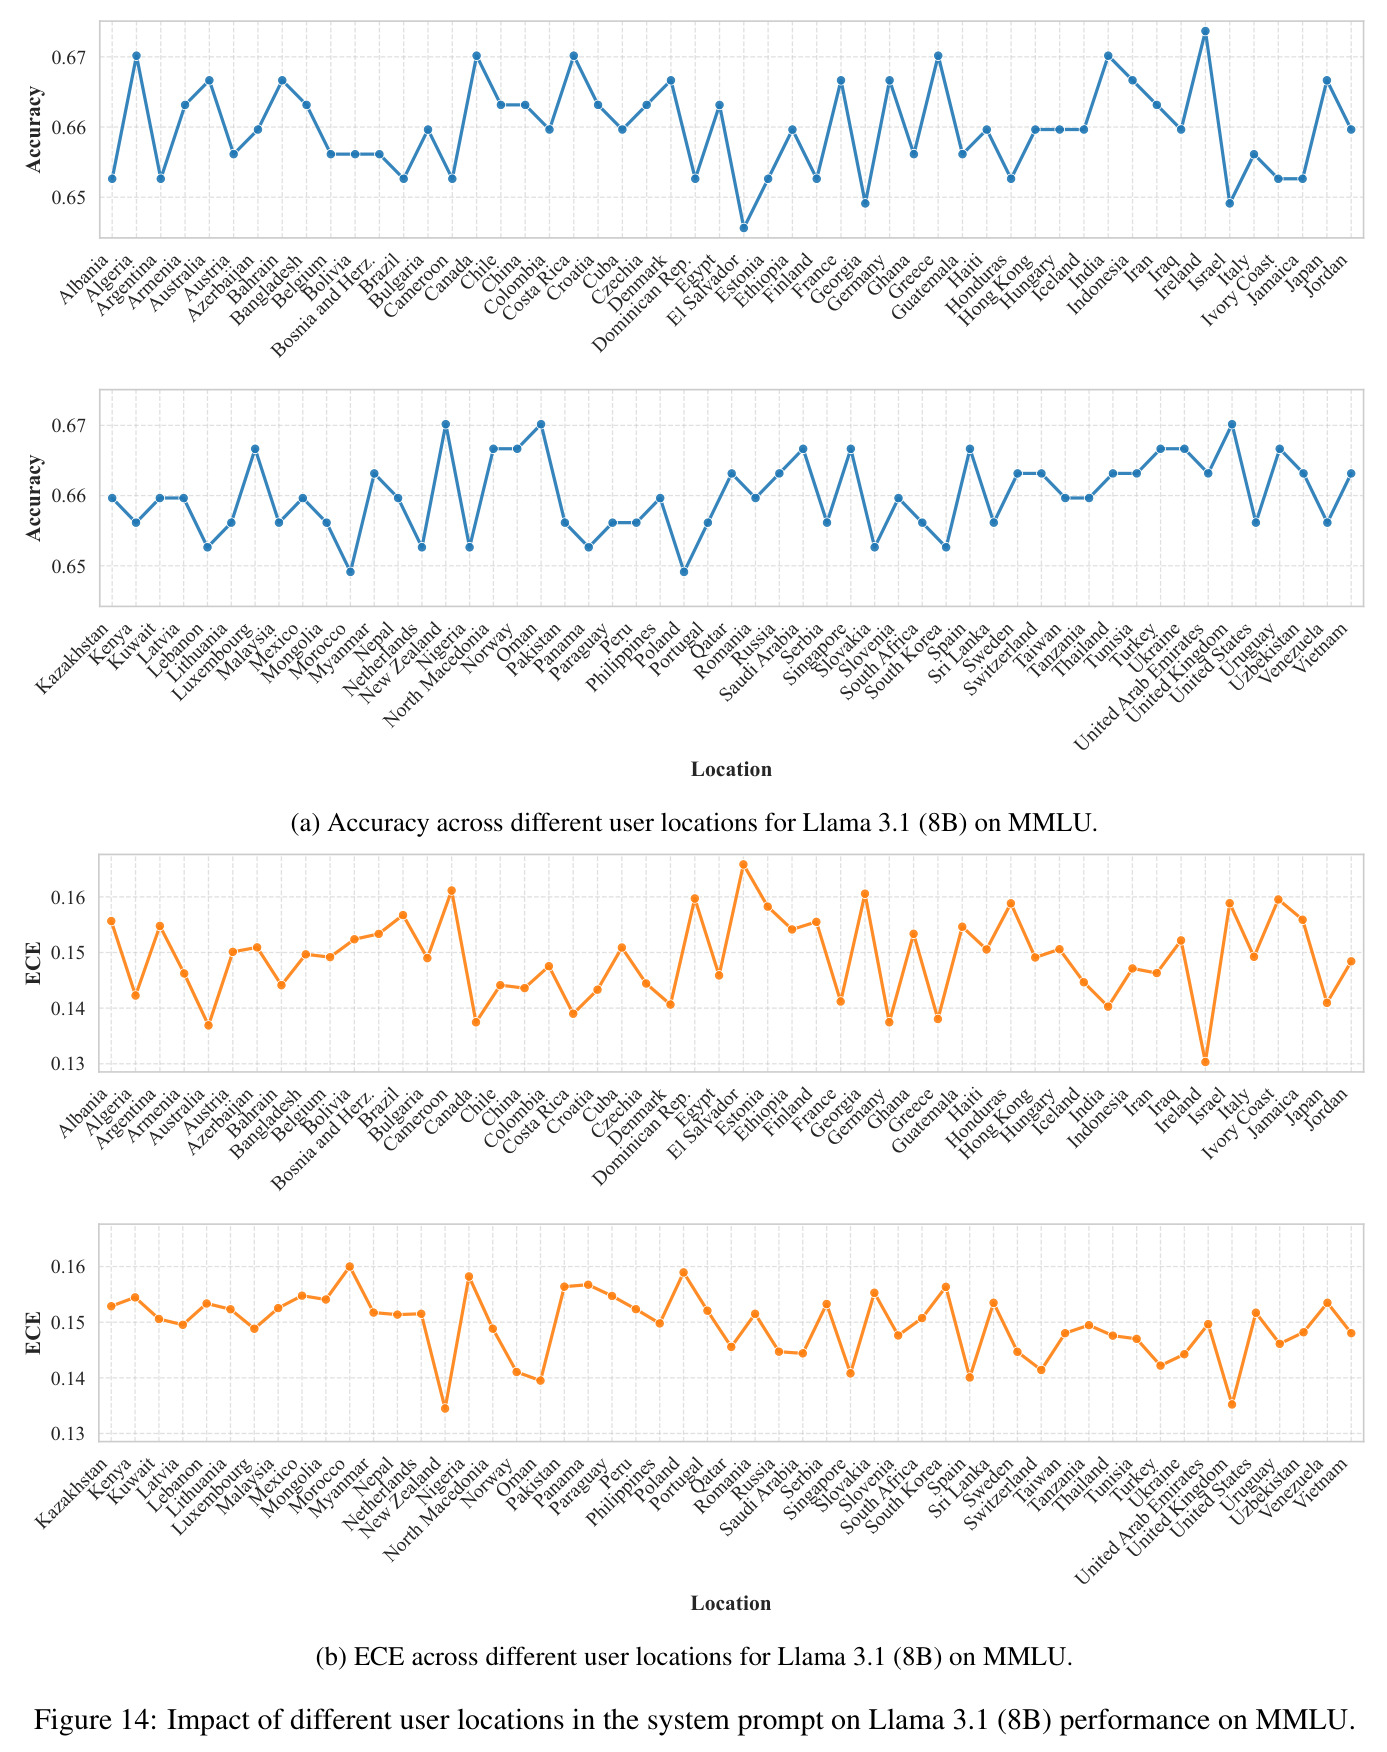
在系统提示中把用户位置设为全球上百个国家/地区,Llama 3.1 (8B) 在 MMLU 上的准确率(约 0.65–0.67 波动)和 ECE(约 0.13–0.16 波动)均出现与日期效应相当幅度的变化。
把结论从日期推广到其他潜在隐藏元数据(用户位置、模型版本),指出问题是一类现象而非孤立案例,引出更广泛的评测协议议题。