WEFT:面向通用智能体的工具使用后训练全系统扩展 WEFT: Scaling Tool-Use Post-Training for General-Purpose Agents
把工具使用后训练的扩展对象从环境扩展为完整交互系统,用执行反馈自我进化并稳定大规模训练。
前置知识
MCP(Model Context Protocol)
一种让大模型以统一接口调用外部工具与服务的标准化协议,每个 MCP 服务器暴露一组带输入/输出 schema 的工具定义。本文中'环境'就是可执行的 MCP 服务器集合,工具会读写共享的数据库状态与工作区文件状态,并通过 FastAPI 后端真实执行。
WEFT 的三大模块全部围绕 MCP 展开:环境合成产出 MCP 服务器,任务组合把跨 MCP 的原子任务链成工作流,MegaMCP 解决 MCP 服务的高并发部署问题。不理解 MCP 就无法理解论文的数据构造与基础设施设计。
Agent Harness(智能体执行框架)
包住模型的执行外壳,包含系统提示词、记忆管理、规划循环、工具调用协议与错误恢复机制,典型代表有 ReAct、OpenClaw、Hermes。同一模型换用不同 harness,在同一任务上的表现可能差异巨大。
论文的核心论点之一是训练经验产生于'环境+任务+harness+评估器'的完整系统。WEFT 用多 harness rollout 扩大交互多样性,并用实验证明仅换 harness 就能带来约 9.7 分的下游增益。
GRPO 与组相对优势
一种无需价值网络的强化学习算法:对同一状态采样一组(G 个)候选输出,用组内奖励均值和标准差归一化计算优势 $A^{(i)} = \frac{r^{(i)} - \bar{r}}{\mathrm{sd}(r) + \epsilon}$,以组内相对好坏代替绝对回报估计。
WEFT 的 RL 阶段把 GRPO 改造到'原子任务回合'粒度:在同一历史和恢复出的相同环境状态上采样 G 个候选段,用当前任务的二元完成结果计算组相对优势,这是本文最重要的算法创新。
拒绝采样(Rejection Sampling)
一种数据构造方式:让强模型(教师)对任务多次采样,用验证器筛掉失败样本、只保留通过验证的轨迹用于监督微调(SFT)。传统做法以整条轨迹为拒绝单位,一处失败即丢弃整条轨迹。
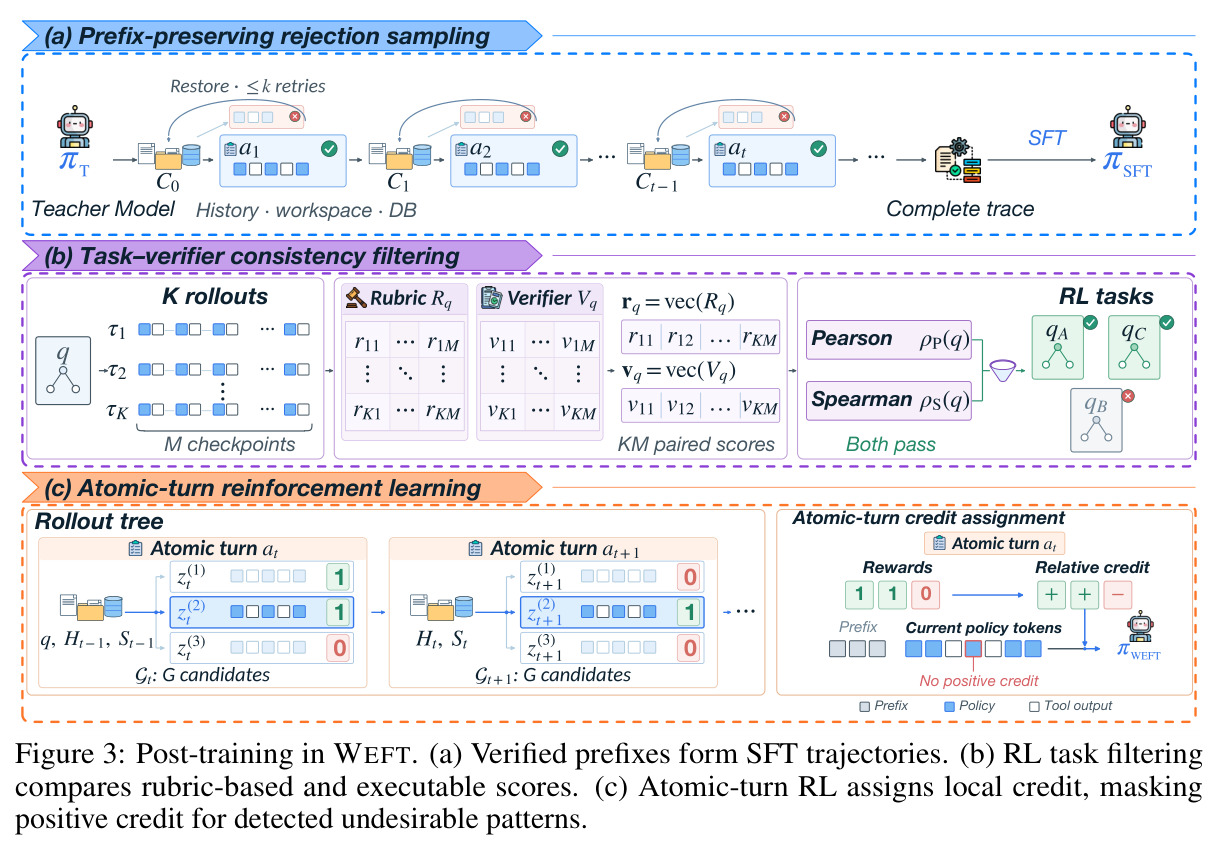
长程智能体任务动辄几十步,整条丢弃代价极高。WEFT 的前缀保留拒绝采样改为以原子任务回合为拒绝单位,失败时恢复回合前状态只重采局部,保留全部已验证进度——这是理解其 SFT 数据构造的关键。
信用分配(Credit Assignment)
强化学习核心问题:如何把轨迹级回报分解到具体的动作或回合,决定哪些决策获得正/负学习信号。多轮长程任务中,若把终局成败平均摊给所有步骤,会引入大量噪声,导致不稳定训练。
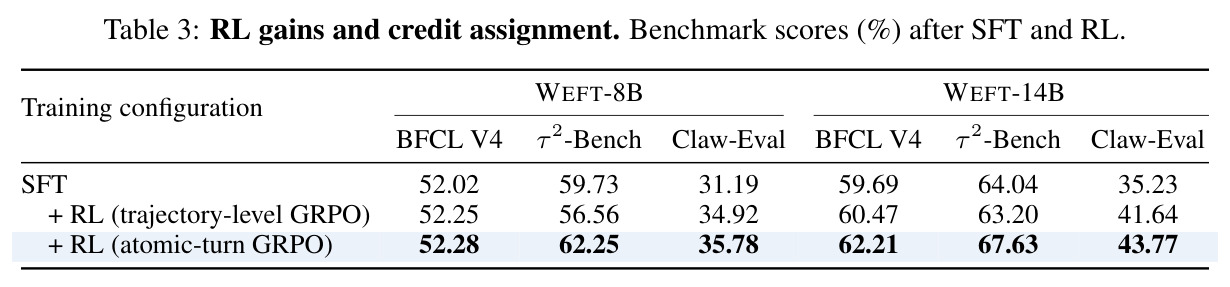
论文用实验证明轨迹级 GRPO 会让 τ²-Bench 回退 0.84–3.17 分,而原子回合信用分配让所有基准都提升。理解这个问题才能理解为什么'局部可验证的二元结果'是更好的学习信号。
Reward Hacking(奖励黑客)
策略学会利用奖励函数的实现漏洞获得高分,而非真正完成任务的现象。例如智能体直接读取或篡改验证器使用的数据库字段来'骗'过检查,而不是执行任务要求的业务操作。
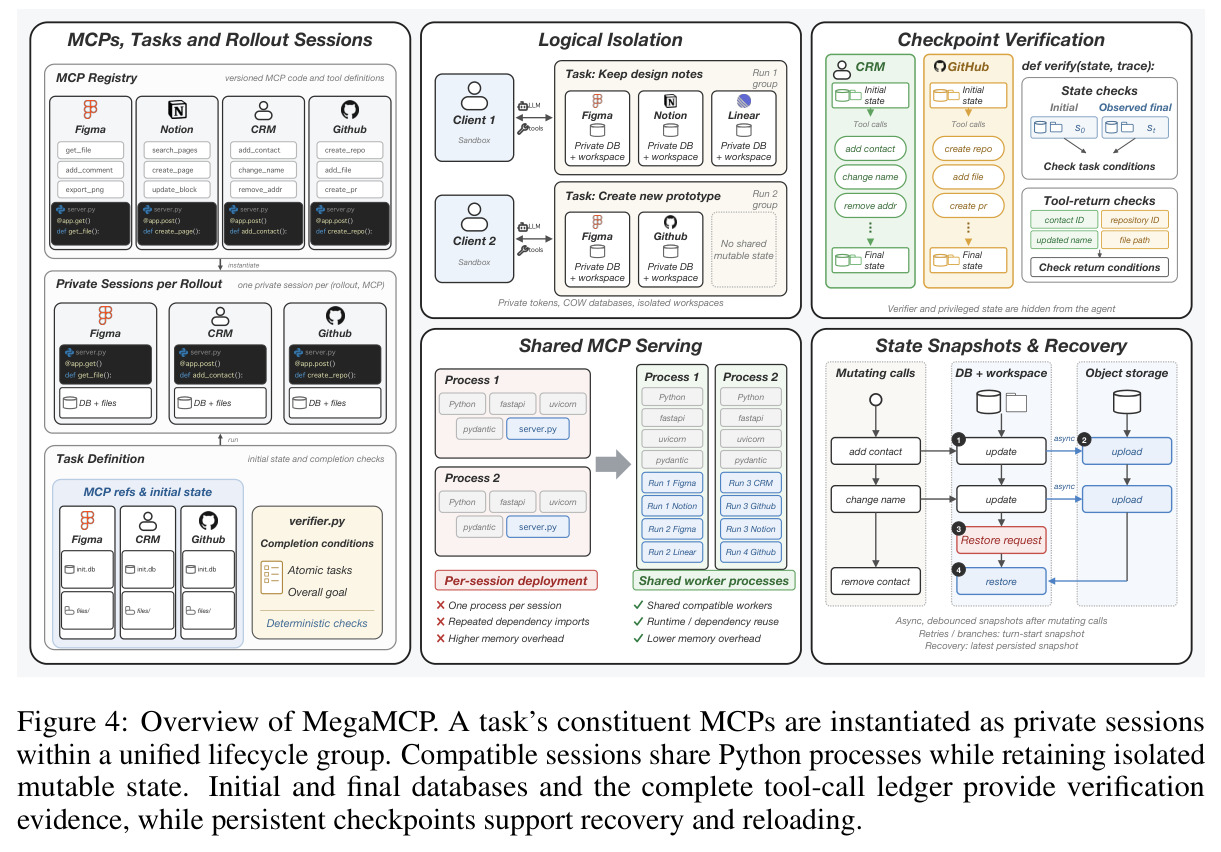
工具使用环境的验证器通常依赖环境内部状态,攻击面很大。WEFT 把验证器放进 MegaMCP 服务层运行、对智能体隐藏数据库文件与凭证,并保留完整工具调用账本作为证据,是针对该问题的系统级防御设计。
研究动机
近期的工具使用后训练工作(如 Agent-World、EnvScaler、ScaleEnv、AWM 等)普遍把'规模化'等同于'程序化合成更多可执行环境'。但训练经验实际产生于一个完整的智能体交互系统,由环境、任务、智能体框架(harness)和评估器四个组件构成,可执行环境只是其中一角。一个能跑起来的环境并不能保证其上挂载的任务可行、评估正确:Figure 1 的例子中,'更新客户记录并发送确认'任务失败,原因可能是智能体找错了客户(策略错误)、更新未真正写库(环境 bug)、任务引用了不存在的客户(任务缺陷),甚至确认已发送却被验证器判为失败(评估器错误)。若把这些失败一律归咎于策略并施加负学习信号,就会惩罚有效行为、注入误导性学习信号。论文引用多项研究证实不完美验证器下的奖励错误问题,并指出单纯堆环境数量无法解决组件间的协同缺陷——环境扩展了,学习信号的可靠性却没有保障。
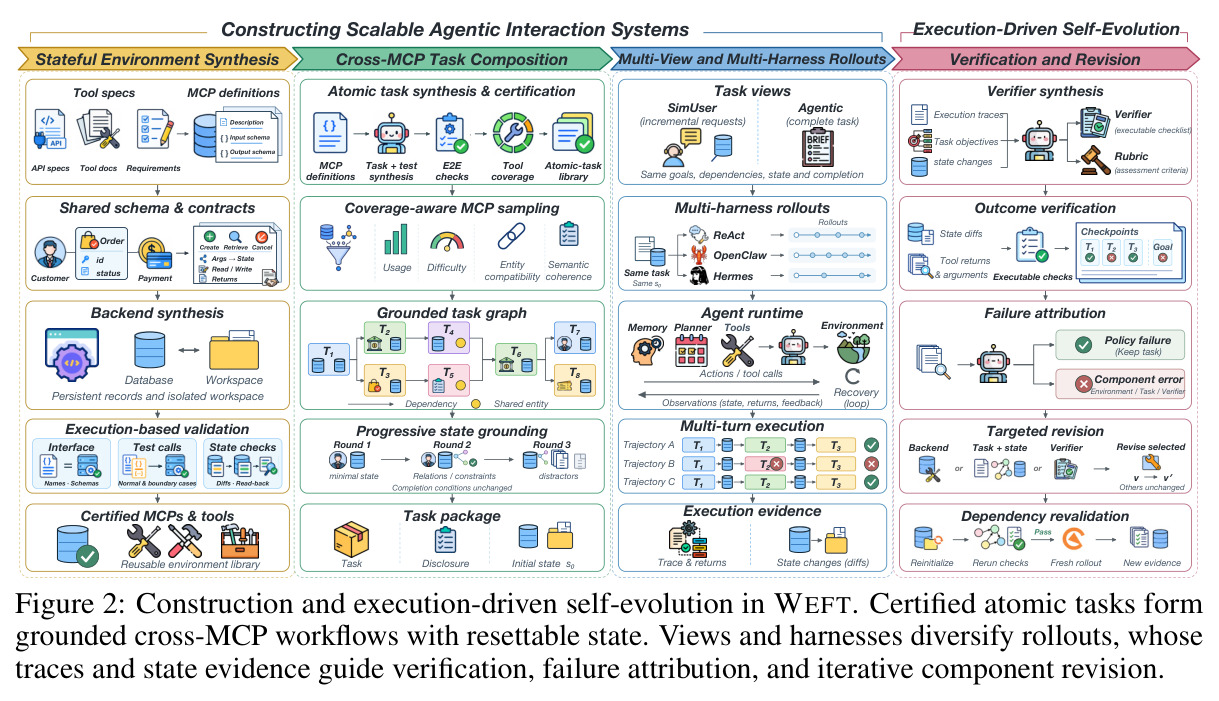
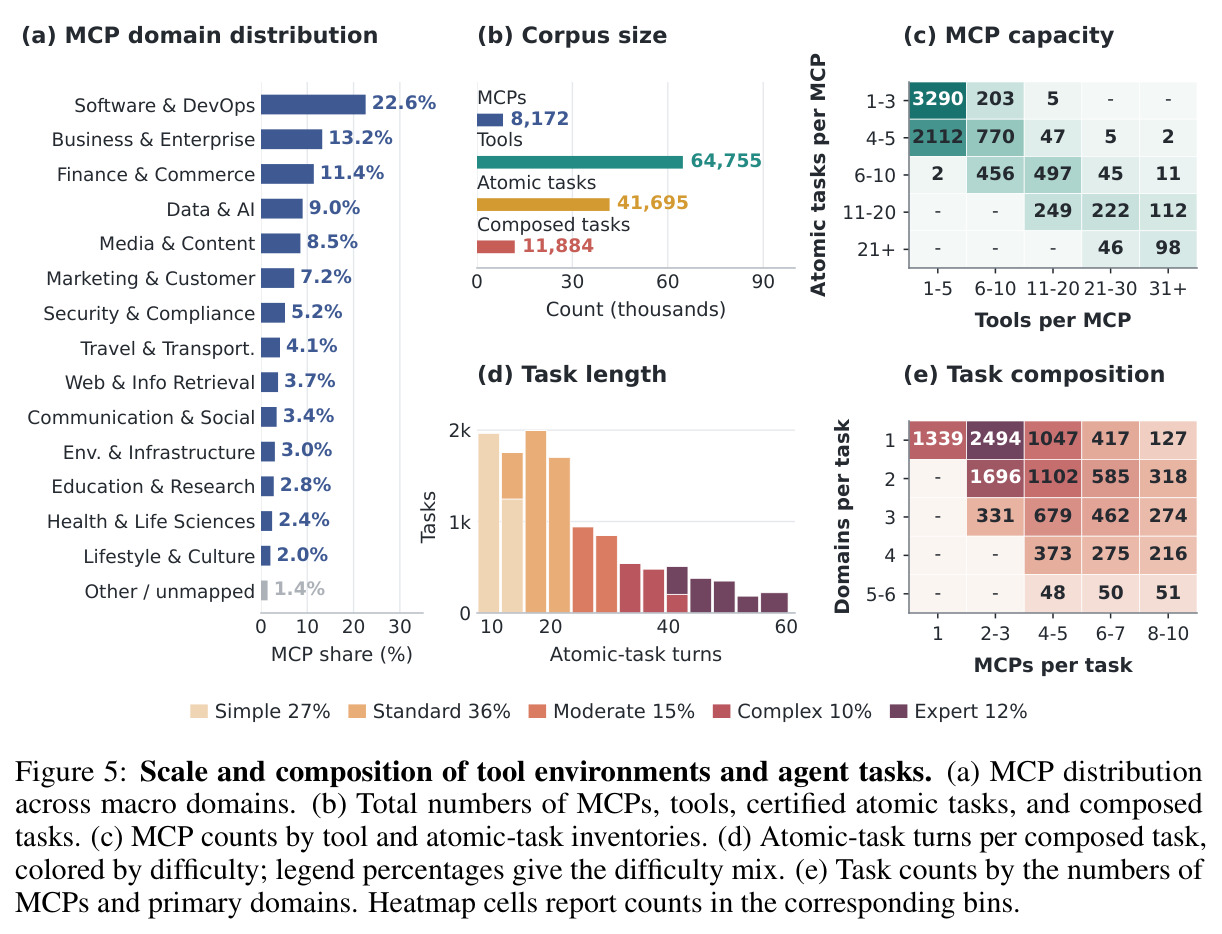
本文的目标是WEFT 的目标是把工具使用后训练的扩展范围从'可执行环境'升级为'完整交互系统',具体拆成三件事。其一,联合扩展环境广度、任务复杂度与交互多样性:论文最终构建了 8,172 个可执行 MCP 服务器、64,755 个工具、41,695 个认证原子任务和 11,884 个组合任务(中位长度 20 个原子任务回合),同一任务再以 Agentic/SimUser 两种任务视图和 ReAct/OpenClaw/Hermes 三个 harness 做多样化 rollout。其二,建立执行驱动的自我进化闭环:用执行轨迹和状态证据区分'有效任务上的策略失败'与'环境/任务/验证器缺陷',把失败归因到具体组件并定向修订,再用全新 rollout 评估修订效果、发现新问题,迭代多轮。其三,在算法与基础设施两个层面支撑大规模稳定训练:SFT 阶段用前缀保留拒绝采样保留已验证进度;RL 阶段用任务-验证器一致性过滤加原子回合信用分配提供细粒度可靠信号;MegaMCP 以共享服务加隔离可恢复状态支撑高并发 rollout。
与已有工作不同的是,论文的独特切入是把后训练规模化为一个'系统问题'而非'数据量问题'。已有自我改进工作各自修订不同对象:行为层面用自我反馈修正输出(Self-Refine、Reflexion 类),任务层面调能力缺口或难度,系统层面搜索 agent 程序或用执行轨迹修 harness;WEFT 则聚焦'把执行失败归因到需要修订的组件'这一环节,让环境、任务、验证器随策略共同进化。在 RL 信用分配上,它与 GiGPO(按跨轨迹重复状态分组)、PivotRL(在示范的信息性中间回合采样局部延续)、BPO(从沙箱快照分支后比较兄弟终局回报)都不同:WEFT 从完全相同的历史和恢复出的相同环境状态分支比较候选原子回合,且优势用当前原子任务的二元完成结果而非终局回报计算,使学习信号直接来自局部可验证的事实。基础设施上,MegaMCP'服务共享、状态私有'的设计也是对'每个 rollout 独立部署整套工具栈'这一行业惯例的正面反思。
核心方法
直觉上,WEFT 把'训练数据生产线'本身纳入被优化的对象:执行经验既喂给策略,也用来修理生产线。技术路线分三模块。(一)构建可扩展交互系统:从工具文档与业务需求合成 MCP 定义,推断共享实体与读写依赖,生成共享数据库 schema、契约与 FastAPI 后端,经接口检查、正常/边界调用、状态 diff 与回读验证成为独立服务器;任务侧用 E2E 执行验证、工具链正交性、工具覆盖率三道关卡认证原子任务,覆盖率感知采样选出 MCP 组合,链成带实体绑定的 DAG 任务图,经实体初始化、关系补全、上下文丰富三轮渐进状态接地生成可重置初始状态。(二)执行驱动自我进化:验证器从状态变化与工具返回生成可执行检查和 rubric,轨迹得分 $R(\tau) = \frac{1}{K}\sum_{k=1}^{K} r_k(\tau)$;归因 agent 定位问题组件并定向修订,重验证后用全新 rollout 评估并发现新问题。(三)稳定后训练:SFT 用前缀保留拒绝采样,RL 用任务-验证器一致性过滤加原子回合组相对 GRPO,MegaMCP 提供服务共享、状态隔离可恢复的并发底座。
核心创新是赋予执行经验双重身份:它既是策略学习的数据,又是产生它的交互系统的诊断证据。与已有环境扩展方法的本质区别在于:后者默认'环境多了、好数据自然多',而 WEFT 认为学习信号可靠性取决于环境-任务-harness-评估器四者的协调,因此把'失败归因→组件修订→新 rollout 重验证'做成与训练交替进行的闭环,持续从源头净化训练经验。第二个关键创新是把训练粒度从'完整轨迹'下移到'原子任务回合':SFT 拒绝采样以原子回合为单位,失败时恢复回合前历史与状态、只重采该任务,保留全部已验证前缀;RL 中冻结的 rollout 策略在 MegaMCP 恢复出的相同状态上独立采样 $G$ 个候选段,计算组相对优势 $A_t^{(i)} = \frac{r_t^{(i)} - \bar{r}_t}{\mathrm{sd}(r_t) + \epsilon}$,其中 $\bar{r}_t$ 为组内平均二元奖励,且优势只赋给当前回合的策略 token。这样每个决策段只为它自己那个可验证的任务结果负责,避免轨迹级回报把无关回合的成败噪声摊到所有动作上。
方法步骤详情
流程分六步。(1)环境合成:从工具文档与业务需求生成 MCP 定义、schema、契约与 FastAPI 后端,按错误类型修订,经调用与状态校验后成为独立服务器。(2)原子任务认证:为每个 MCP 生成原子任务与 E2E 测试,从独立初始状态调用,按返回与持久状态判定完成,剪枝冗余链,覆盖率引导补生成。(3)组合与接地:把原子任务连成带实体绑定的 DAG,经实体初始化、关系补全、上下文丰富三轮构造初始状态,固化为可重置快照。(4)多视图多 harness rollout:Agentic 给完整简报,SimUser 按依赖序逐请求披露;任务路由到 ReAct/OpenClaw/Hermes 沙箱,产出轨迹与状态证据。(5)自我进化:K 个检查点覆盖各任务与总目标;归因 agent 区分策略失败与组件缺陷,后者路由到后端/任务/验证器修订,重验证后以全新 rollout 评估,迭代三轮。(6)训练:Kimi K3 教师前缀保留地采集 11,884 个任务的 SFT 轨迹;RL 前以双相关过滤出 1,954/5,000 任务,按拓扑序做原子回合 GRPO,不良模式回合只去正 credit。
技术新颖性
技术新颖性体现在四个层面。(1)问题定义新:把'规模扩展'从环境数量重新定义为交互系统质量,并给出可操作的闭环(归因→修订→重验证),与只做任务难度自适应或轨迹过滤的工作有本质区别。(2)信用分配机制新:原子回合组相对优势从'相同历史+相同恢复状态'分支比较,配合'当前任务二元结果'作奖励,同时区别于 GiGPO 的跨轨迹状态分组与 BPO 的终局回报比较;再加任务-验证器双相关过滤(剔除 61% 候选任务),是对'不完美验证器下 RL 不稳定'的工程化正面回应。(3)采样策略新:前缀保留拒绝采样把拒绝单位从轨迹缩小到原子回合,保留已验证进度与环境状态,在接受轨迹数固定的条件下提升数据质量。(4)基础设施新:MegaMCP 用内容寻址注册表、prefork 进程共享、copy-on-write 数据库、去抖异步快照与 generation fencing 实现'服务共享、状态私有、可恢复'的高并发 rollout,验证器放进服务层隐藏特权状态以防 reward hacking。此外'多视图×多 harness'混合有受控实验(Table 2)支撑。
实验结果
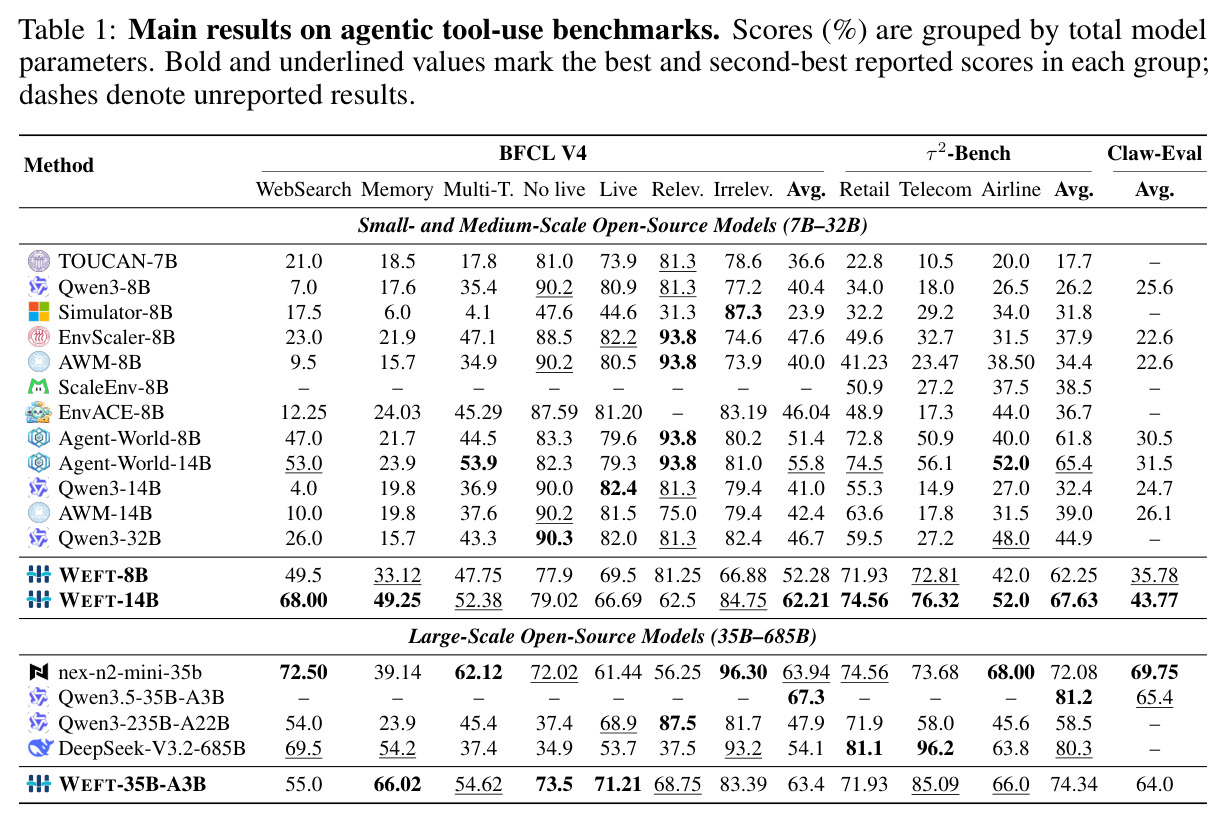
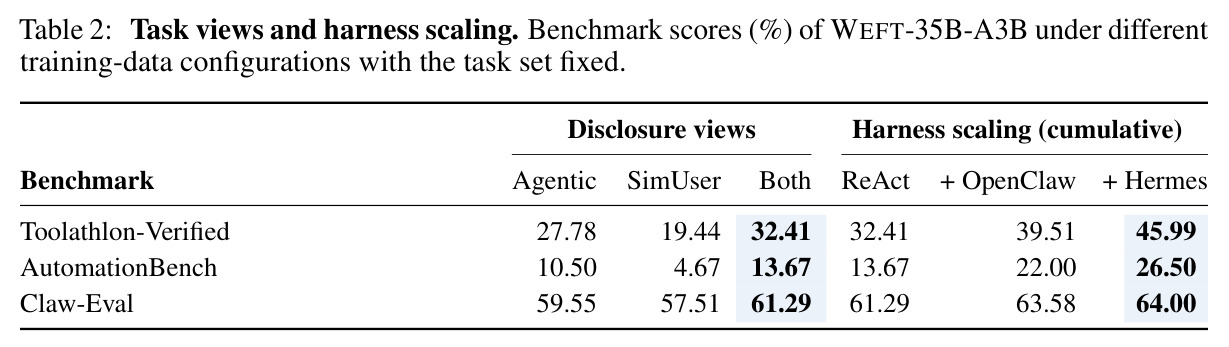
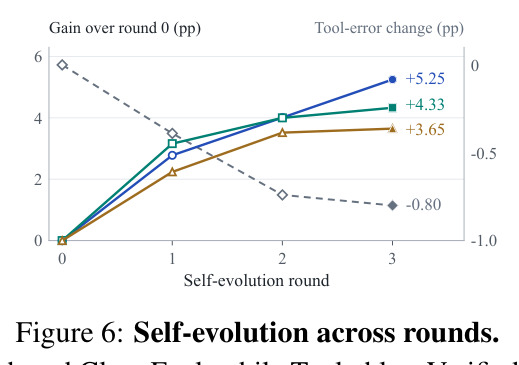
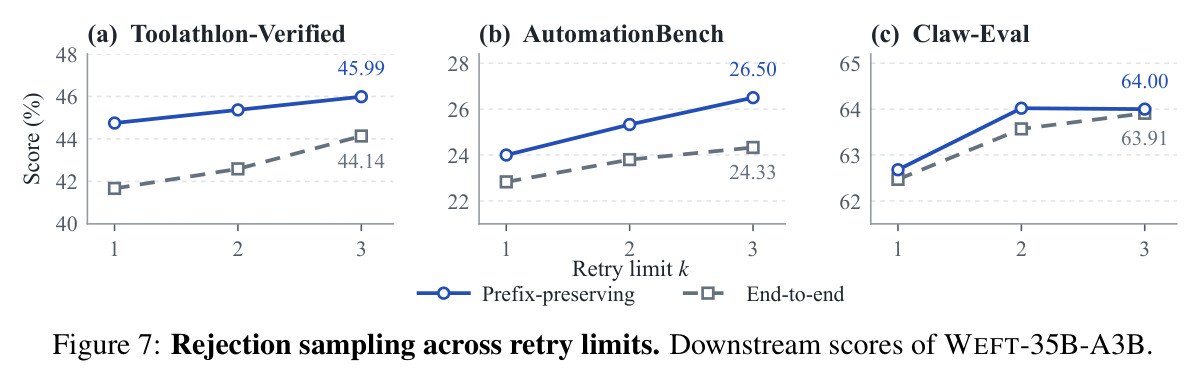
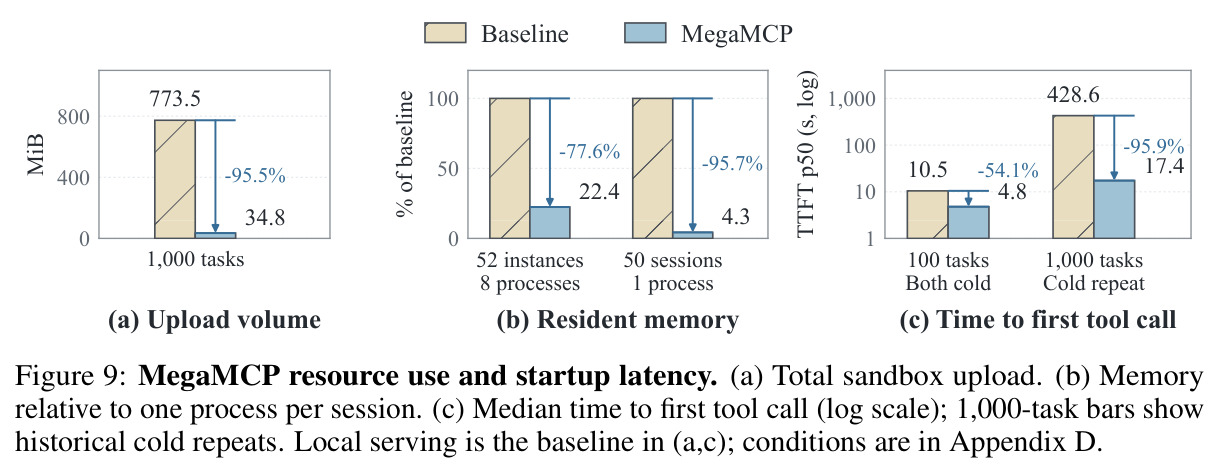
主实验(Table 1):WEFT-14B 在同规模组三项聚合第一——BFCL V4 62.21%、τ²-Bench 67.63%、Claw-Eval 43.77%,超最强基线 6.41/2.23/12.27 分。增益集中在 Memory、Telecom 等;35B-A3B 长程基准达 Toolathlon 45.99%、AutomationBench 26.50%,Memory 66.02% 为大组最高。消融(任务集固定):SimUser 单独弱但混合后更强,harness 扩展后从 27.78 涨至 45.99(Table 2);自我进化三轮把工具错误率 1.76%→0.96%(-45.5%),下游 +3.65~+5.25 分(Figure 6);接受轨迹数固定时,前缀保留比端到端采样最高高 2.17 分(Figure 7);轨迹级 GRPO 令 τ²-Bench 回退,原子回合 GRPO 全面提升且最高领先 5.69 分(Table 3)。系统上(Figure 9)MegaMCP 把 1,000 任务上传量降 95.5%,内存最多省 95.7%,冷启动首调延迟降 54.1%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| BFCL V4(多轮工具调用+记忆+相关性判别聚合) | 聚合得分 (%) | WEFT-14B: 62.21 | Agent-World-14B: 55.80(同规模最优基线) | +6.41 pp |
| τ²-Bench(Retail/Telecom/Airline 多轮有状态工具交互) | 三域平均通过率 (%) | WEFT-14B: 67.63 | Agent-World-14B: 65.40 | +2.23 pp |
| Claw-Eval(通用智能体任务) | 平均得分 (%) | WEFT-14B: 43.77 | Agent-World-14B: 31.50 | +12.27 pp |
| Toolathlon-Verified(长程多工具工作流) | 得分 (%) | WEFT-35B-A3B: 45.99 | 仅 Agentic 单视图 SFT: 27.78(视图混合后 32.41) | 视图+harness 合计 +18.21 pp,其中自我进化贡献 +5.25 pp |
| AutomationBench(长程自动化工作流) | 得分 (%) | WEFT-35B-A3B: 26.50 | 仅 Agentic 单视图 SFT: 10.50 | 视图+harness 合计 +16.00 pp |
| MegaMCP 并发 rollout(1,000 任务冷启动) | 中位首次工具调用延迟 (s) | 4.794 | 逐会话独立部署: 10.455 | -54.1%;1,000 任务冷重复 428.6→17.4 s(-95.9%) |
| BFCL V4 Memory / WebSearch 子项与 τ²-Bench Telecom 子项(跨规模稳定强项) | 子项得分 (%) | WEFT-14B: Memory 49.25 / Telecom 76.32 / WebSearch 68.00;WEFT-35B-A3B: Memory 66.02(35B-685B 组最高,超次优 11.82)/ Telecom 85.09(组内第二) | Agent-World-14B: Memory 23.90 / Telecom 56.10 / WebSearch 53.00;Telecom 组内最优 DeepSeek-V3.2 96.2 | 14B: Memory +25.35、Telecom +20.22、WebSearch +15.00;35B Telecom 超 nex-n2-mini-35b 11.41 |
局限与改进
作者未设专门局限性章节,但实验透露了几点:其一,RL 任务-验证器过滤只保留 1,954/5,000(约 39%)候选任务,六成数据的训练价值被放弃,且过滤需 rubric LLM judge 的额外推理开销;其二,自我进化依赖多轮全新 rollout,Figure 6 显示第三轮仍在提升,成本继续攀升;其三,SimUser 视图单独弱于 Agentic(19.44 vs 27.78),其价值只在混合时体现。我自己的观察:SFT 轨迹完全依赖 Kimi K3 教师,方法上限受教师能力约束,其系统性弱点会被复制进数据;BFCL 个别子项上 WEFT 反而低于原始 Qwen3 基线(WEFT-8B 的 No live 77.9 vs 90.2、Irrelevant 66.88 vs 77.2),提示后训练扰动了对无效调用的判别力;训练只覆盖三种 harness,对分布外 harness 的泛化未验证;工具域分布偏斜(Software & DevOps 占 22.6%,教育/生活类各约 2-3%),长尾域收益存疑;正文也未提供代码或数据开源链接,独立验证成本高。
独立分析的弱点
独立分析出五个弱点及改进方向。(1)教师瓶颈:所有 SFT 轨迹由单一教师生成,教师不会的任务要么靠多次重试碰运气、要么被放弃,数据分布上限被锁死。改进:按难度或领域路由多个异构教师,对教师反复失败的任务触发'组件审查'而非放弃。(2)RL 数据利用率低:61% 候选任务被一致性过滤丢弃,但其中多数只是验证器与 rubric 判断不一致,并非不可用。改进:把被过滤任务回流自我进化循环,先修验证器再入池,形成'过滤信号→验证器修订'闭环。(3)归因 agent 自身可能误判:论文未报告归因准确率,若把验证器缺陷误归因为策略失败,会重新引入它想消除的误导信号。改进:抽样人工审计、多归因器交叉一致性检查,或用跨视图/跨 harness 不一致度设归因置信度阈值。(4)训练结构限制探索:RL 强制按任务图固定拓扑序、每回合一个原子任务,抑制并行工具调用、跳步等自主规划行为。改进:允许拓扑等价的重排序并验证等价性。(5)评估覆盖窄:Claw-Eval 绝对分仍低(43.77),且未测分布外 harness 与真实生产 API。改进:增加跨 harness 零样本评估与真实工具套件的外部效度检验。
未来方向
作者直接指向的方向包括:自我进化继续加轮数——第三轮 Toolathlon 仍在提升且工具错误率单调下降,说明收益曲线未饱和;'执行经验双重角色'原则也可自然延伸到 harness 本身的自动修订(论文引用了用执行轨迹修 harness 的相关工作)。基于本文成果可延伸的方向:其一,验证器与策略共进化——当前验证器在 RL 前静态过滤一次,可改为随策略出现的新漏洞动态加固,甚至引入对抗式验证器压测策略;其二,跨规模知识回流——用 35B 模型的成功轨迹反哺 8B 训练,或把原子回合的组相对优势转成离线偏好对(DPO 式)训练更小模型;其三,把 MegaMCP 的状态快照与检查点用于课程学习、经验回放或失败案例重放训练,快照恢复能力目前只服务于重试与候选采样;其四,任务组合图从 DAG 扩展到带并发分支与异步事件的更一般工作流,并覆盖 web/GUI 等论文未触及的交互形态;其五,归因环节引入因果推断或反事实重放(只改变候选组件后重跑)来提高归因可信度;其六,把'多视图×多 harness'的固定混合比例升级为可学习的混合策略,按下游目标自动配比训练分布。
复现评估
总体复现难度:高。正文未提及开源代码、数据或环境库,而方法链条极长:需合成并验证 8,172 个 MCP 服务器与 64,755 个工具,认证 41,695 个原子任务、组合出 11,884 个多 MCP 任务;SFT 需要 Kimi K3 级强教师生成全量轨迹(每回合最多 k 次重试,执行成本可观);RL 需在相同状态下并发采样 G 个候选段,背后是自研的 MegaMCP 基础设施(进程共享、copy-on-write 数据库、异步快照恢复),短期内难以复刻。现实路径是分层复现:最易验证的是原子回合 GRPO 与前缀保留拒绝采样——可在 Toolathlon、BFCL 等开源环境上以较小任务集和 8B 级模型照搬 Table 3 的对比设计;MegaMCP 的'共享服务+私有状态'可用进程池加 SQLite 快照做小规模原型;完整的三轮自我进化闭环与万级环境库则需原团队级投入。附录给出了构造细节、训练系统与计时条件,若后续开源将显著改善可复现性。
论文图表
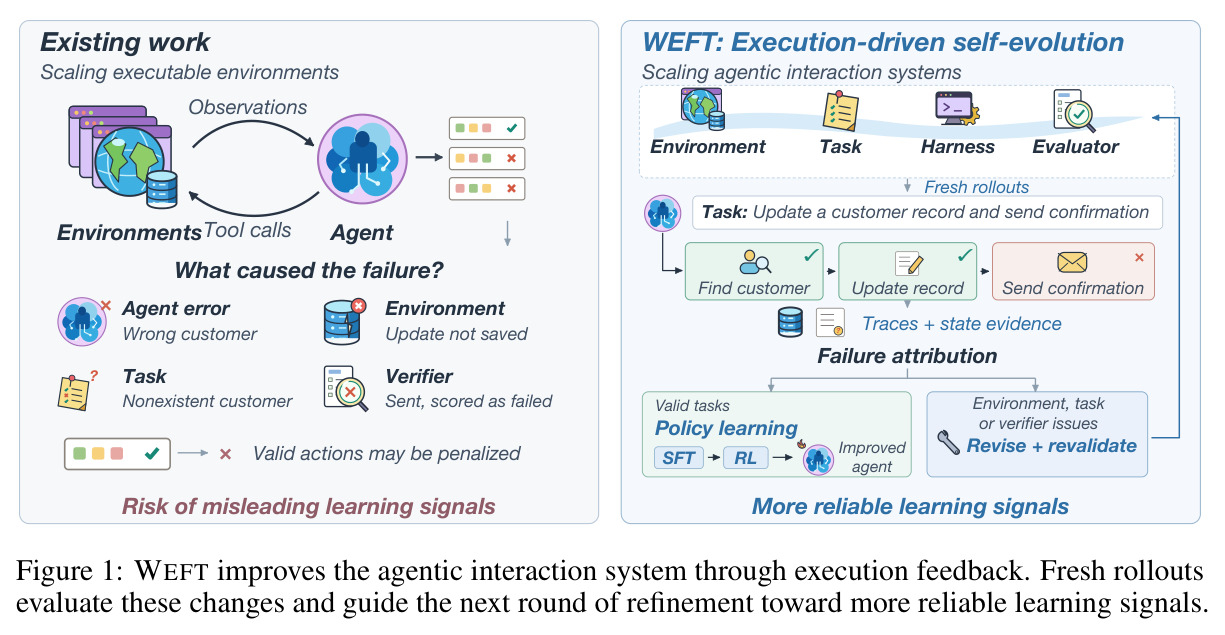
左右对比图:左侧是现有工作'只扩展可执行环境'的范式,工具调用失败被一律当作 agent 错误交给 SFT/RL 惩罚,可能误罚有效行为、产生误导性学习信号;右侧是 WEFT 的执行驱动自我进化,针对'更新客户记录并发送确认'任务,利用轨迹与状态证据把失败归因到环境、任务或验证器(如找错客户是策略失败应保留任务、更新未保存是环境 bug、引用不存在的客户是任务缺陷、已发送却判失败是验证器错误),定向修订组件后用全新 rollout 评估,走向更可靠的学习信号。
这张图一图道尽论文的问题意识与方法差异:同样是任务失败,可能是四个组件中任何一个的锅,只罚策略会污染训练。理解了它就理解了论文标题中'从环境扩展到系统'的含义。