Video2Skill:从流式经验到可复用的具身技能 Video2Skill: From Streaming Experience to Reusable Embodied Skills
提出SESD任务与Video2Skill基准,揭示VLM难以从流式视频中积累可复用技能
前置知识
视觉语言模型(VLM)
由视觉编码器与大语言模型拼接而成的多模态模型,输入图像/视频和文本提示,自回归地输出文本,可做开放词表的事件描述、视频问答等,代表如 Qwen3.5-VL、InternVL3.5、LLaVA-OneVision、Cosmos-Reason。
本文的被试就是 19 个开源 VLM,SESD 被建模为以视频块 $x_t$ 和文本状态 $z_{t-1}$ 为条件的文本生成,不理解 VLM 的输入输出形式就无法理解统一/因子化两种推理范式的区别。
符号技能库与技能模式(schema)
技能用模式 $s=(n_s,d_s,A_s)$ 表示:自由命名、定义和类型化参数槽,如 $\mathrm{grasp}(\mathrm{object}, \mathrm{source})$;事件是模式对具体参数的绑定。技能库 $L_t$ 跨视频持久,按 $L_t=L_{t-1}\cup D_t$ 增长,并条件化后续所有预测。
SESD 的全部要点就是维护这个库,并对每个事件决定 REUSE 已有模式还是 CREATE 新模式,这是理解任务定义、评测指标和失败模式分析的基础。
tIoU 与时间定位
temporal IoU 衡量预测时间段与真实时间段的重叠程度(交集长度除以并集长度)。本文规定每条参考段独立选取 tIoU 最大的预测,且 $\mathrm{IoU}\ge 0.3$ 才算匹配,匹配集合 $M$ 给出 Coverage$=|M|/|R_v|$。
后续所有分组与新建/复用指标都只在匹配事件上计算,理解匹配规则才能正确解读覆盖率与分区分数之间的联动关系,避免被单项指标误导。
Pair precision/recall 与 ARI
把匹配事件按参考类 $c_i$ 与预测名 $\hat{s}_i$ 各自分组,$Q_{\mathrm{ref}}, Q_{\mathrm{pred}}$ 记同类事件对集合;Pair precision$=|Q_{\mathrm{ref}}\cap Q_{\mathrm{pred}}|/|Q_{\mathrm{pred}}|$(低说明过度合并),Pair recall$=\cdot/|Q_{\mathrm{ref}}|$(低说明碎片化);ARI 对随机一致性做校正,可为负。
论文的核心结论——统一模型过度合并、因子化模型碎片化——完全用这组指标刻画,不会读它们就看不懂 Table 1/2 里数字的对比含义。
SFT、CLARE 与 on-policy correction
三种监督策略共享目标 $\mathcal{L}_{\mathrm{SFT}}=-\mathbb{E}\log p_\theta(y^*_t\mid o_t,z_{t-1})$,差别在训练状态分布:Oracle-history SFT 回放参考库状态;CLARE 对库做反事实编辑(删除必需模式使复用变新建、插入干扰项应保持决策不变);on-policy correction 在学生自 rollout 得到的库状态上由教师重算目标。
第 4 节的所有实验都在比较这三种策略,理解它们构造训练分布的差异,才能解读 Table 2 中收益随骨干与范式剧烈变化的结论。
研究动机
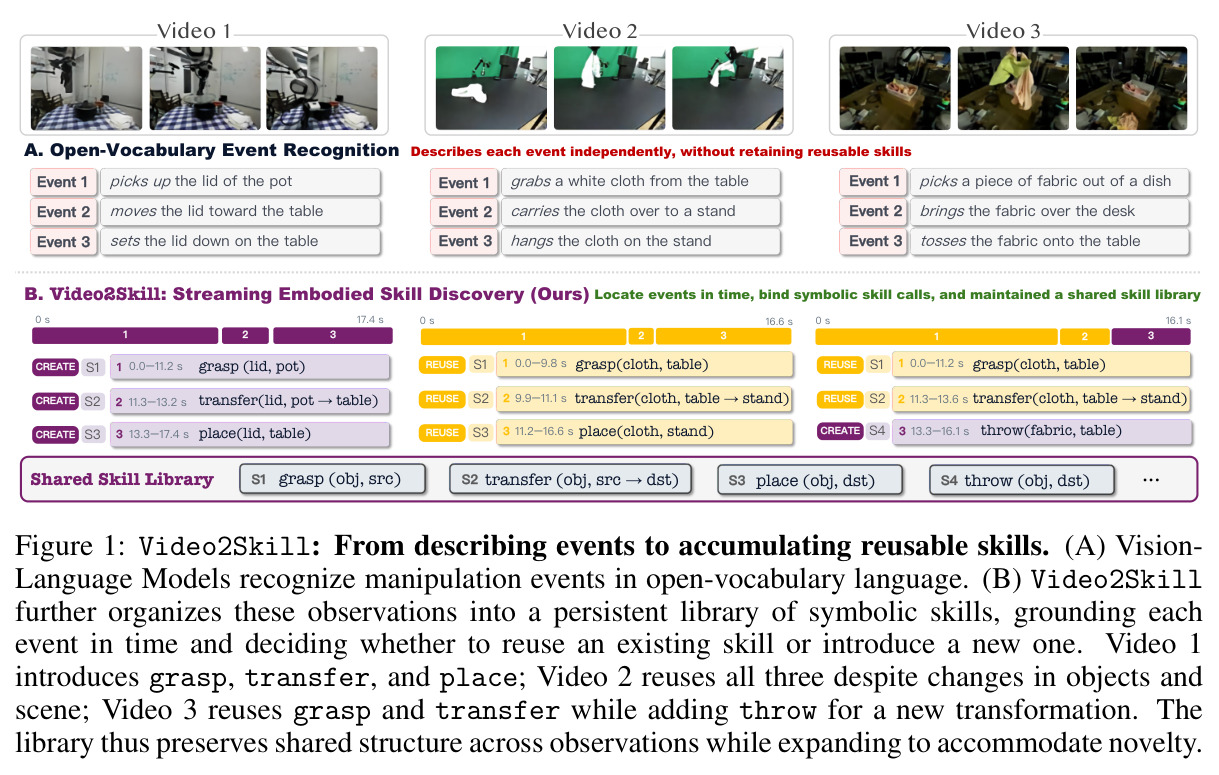
规划是具身智能体完成长时程任务的核心:擦桌子、擦盘子、擦窗户外观上千差万别,背后却共享同一个擦拭技能,基于技能符号规划可以泛化到新任务。但规划的前提是拥有技能库,而现有技能获取途径各有局限:一类系统直接组合人工预定义的技能集(如 Code as Policies 一脉),另一类必须依赖代码执行与环境反馈(Voyager 类智能体)、任务成功信号或机器人轨迹等额外监督才能扩充技能库。视觉语言模型虽然能以开放词表准确描述单个操作事件,却在把连续事件流组织成可复用技能时表现糟糕:流式设定下每次「复用还是新建」的决策都基于自己此前构建的库,错误会级联放大——重复建库把反复出现的经验碎片化,过度复用又把不同变换混为一谈。此前没有任何基准系统性地度量这种从被动视觉流中积累符号技能的能力。
本文的目标是本文提出流式具身技能发现(SESD)任务:模型按顺序观看视频块,为每个操作事件预测时间边界并绑定符号化技能调用(模式+参数),同时维护一个跨视频持久的技能库,库会条件化后续所有预测。为系统度量该能力,作者构建 Video2Skill 基准,覆盖机器人桌面操作(ROBOINTER,源自 DROID 与 RH20T)与人类厨房第一视角活动(HD-EPIC),考察三种核心能力:(i) 事件的时间定位(Coverage);(ii) 对同一变换事件的命名不变分组(Pair precision/recall、ARI);(iii) 新建/复用决策(CREATE/REUSE recall、决策准确率)。在此基础上评测 19 个开源 VLM 的两种推理范式,并用三种监督微调策略在 Qwen3.5-4B 与 LLaVA-OneVision-2-8B 两个骨干上检验监督能否修复观察到的失败模式。
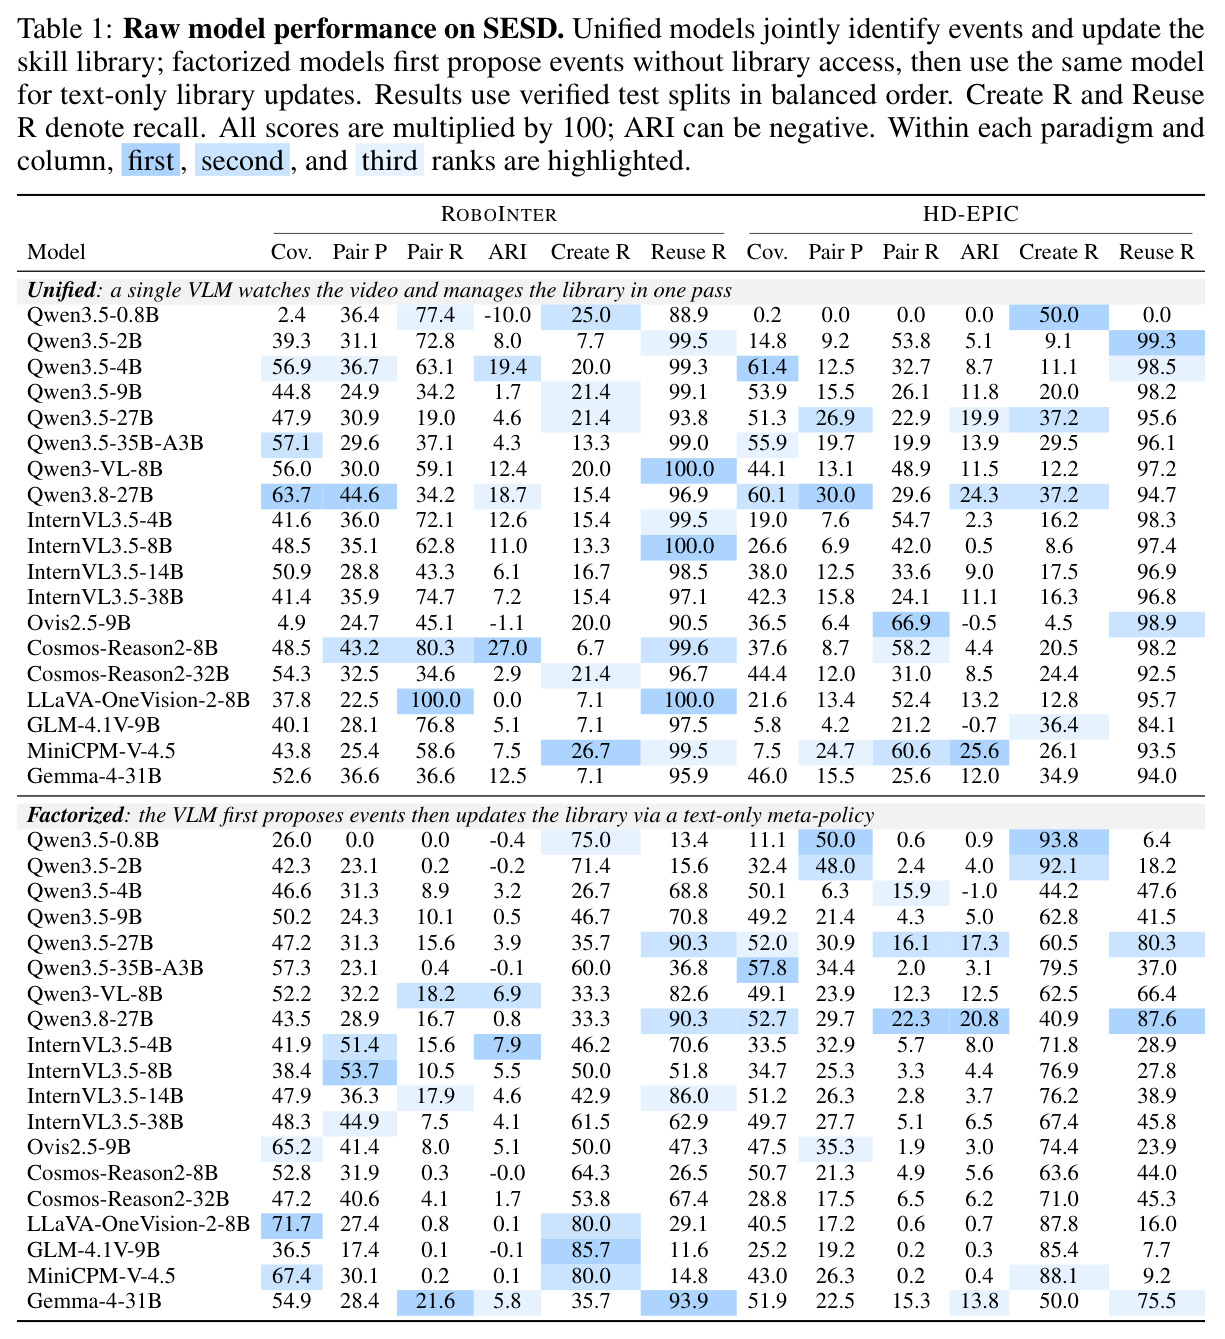
与已有工作不同的是,与已有工作的本质区别在于:以往技能库增长研究要么使用固定技能集,要么依赖执行反馈、成功信号或机器人轨迹,本文研究的是仅凭被动观看视频、在线构建符号技能库这一纯感知问题,即「规划的反问题」——从观察到的经验中恢复产生它的技能。评测设计同样独特:技能等价以底层变换定义 $e_i\sim e_j \Leftrightarrow \tau(e_i)=\tau(e_j)$,与模式名称无关,从而实现命名不变的分组评测;同时把事件覆盖、分区一致性与新建-复用决策三者联合度量,论文用 MiniCPM-V-4.5(HD-EPIC ARI 最高 25.6 但覆盖率仅 7.5%)等案例证明单项指标会得出完全相反的结论。此外,统一/因子化两种范式的对照设计直接暴露了感知与库更新耦合方式如何决定失败方向。
核心方法
直觉上,人看别人做饭时会把「拿起锅盖」「拿起抹布」归并为同一个抓取技能,把「把布扔到桌上」识别为不同于「放置」的新技能,并在后续视频中不断复用或扩充这个心智库。Video2Skill 把该过程形式化为流式决策问题:给定有序视频流 $V=(v_1,\dots,v_N)$,第 $t$ 步模型接收视频块 $x_t$ 与状态 $z_{t-1}=(L_{t-1},u_{t-1})$(持久技能库加未完成事件),输出 $y_t=(D_t,E_t,u_t)$,其中 $D_t$ 是新模式集合、$E_t$ 是完成事件集合、$u_t$ 是跨块延续的未完成事件;每个事件 $e=(b_e,d_e,s_e,a_e)$ 含视频内时间边界、模式与参数绑定,模式 $s=(n_s,d_s,A_s)$ 含名称、定义与类型化参数槽。库按 $L_t=L_{t-1}\cup D_t$ 更新,视频边界处未完成事件被关闭或丢弃而库保留。技能是所观察物理变换的语义抽象,不是可执行控制器。
核心创新有三点。第一,把「从流式视觉经验中在线积累符号技能库」确立为独立研究问题(SESD),此前的技能库增长工作都依赖执行反馈或轨迹监督,本文证明仅靠被动观看已是开放难题。第二,评测协议以底层变换定义事件等价 $e_i\sim e_j \Leftrightarrow \tau(e_i)=\tau(e_j)$,分组指标(Pair precision/recall、ARI)对一致重命名不变,迫使模型学到真正的变换抽象而非记忆表面名称。第三,设计统一/因子化两种范式对照:统一范式让单个 VLM 边看视频边更新库(感知与库更新耦合);因子化范式先生成不含库信息的纯文本事件描述,再用同一模型做纯文本库管理。这一解耦设计揭示了失败模式与耦合方式的因果关系——统一模型倾向把不同变换并入过宽的技能(低 Pair precision),因子化模型倾向为重复变换建立重复模式(低 Pair recall),且库由自身早期预测构建使错误自我强化。
方法步骤详情
流程分三步。第一步基准构建:从 HD-EPIC(42 个训练视频、5,726 条调用;40 个测试片段、1,137 条参考段)与 ROBOINTER(2,992 个训练视频、5,032 条调用;132 个测试视频、534 条参考段)整理数据,逐条核对画面支持并修正 12,429 条调用中的 241 条;参数绑定取自 object、source、destination 等 7 种角色,调用归入 48 个规范变换类,训练/测试在源视频级互斥。第二步评测:每条参考段独立选 tIoU 最大的预测,IoU≥0.3 记为匹配,Coverage 为匹配数除以参考段数;再按参考类与预测名构建同类事件对集合,计算配对精确率/召回率与 ARI;沿情节顺序把参考类首次出现标为 CREATE、其余标为 REUSE,报告两类召回率与决策准确率。第三步监督微调:比较 Oracle-history SFT(回放参考库状态)、CLARE(反事实编辑库状态并调整目标)与 on-policy correction(学生 rollout 状态上教师重算目标)三种策略。
技术新颖性
技术新颖性体现在四处。(1) SESD 任务形式化把时间定位、符号绑定与库维护统一进单一流式预测 $y_t\sim\pi_\theta(\cdot\mid x_t,z_{t-1})$,库的持久性让早期决策塑造后续语境,形成非平稳的决策分布,与离线动作分割、预定义类别动作识别有本质区别。(2) CLARE 反事实库状态重平衡:保持观察不变、编辑库状态并相应调整目标,同时监督对相关编辑的敏感性与对无关编辑的鲁棒性,相当于对库状态做因果干预式数据增广;因子化版本还包括等价模式插入(新建变复用)与未完成事件干预。(3) on-policy correction 借鉴在线教师-学生蒸馏思想,在学生自身错误累积产生的库状态上提供监督,缓解参考历史与推理分布的失配,但目标仍是纯监督学习。(4) 指标体系强调 Coverage、Pair P/R、ARI 与 CREATE/REUSE recall 必须联合解读,并给出反例:统一 LLaVA 在 ROBOINTER 的 Pair recall 高达 100.0 却因 Pair precision 仅 22.5 而 ARI 为 0.0。
实验结果
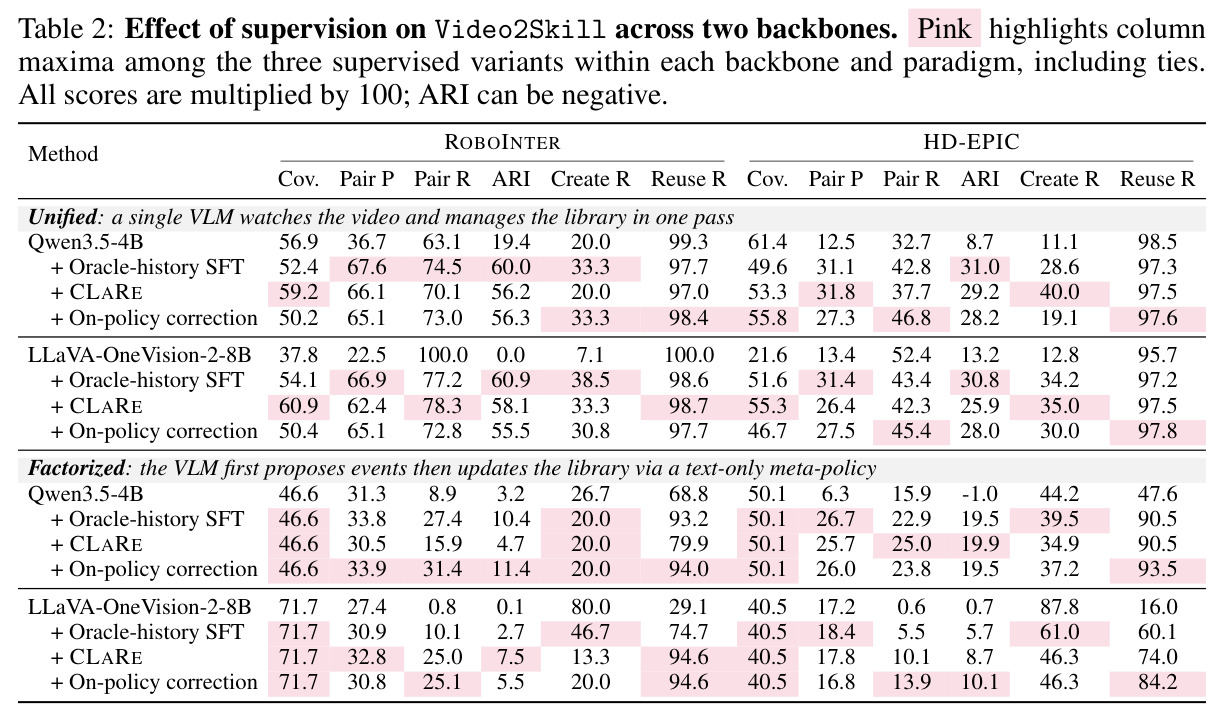
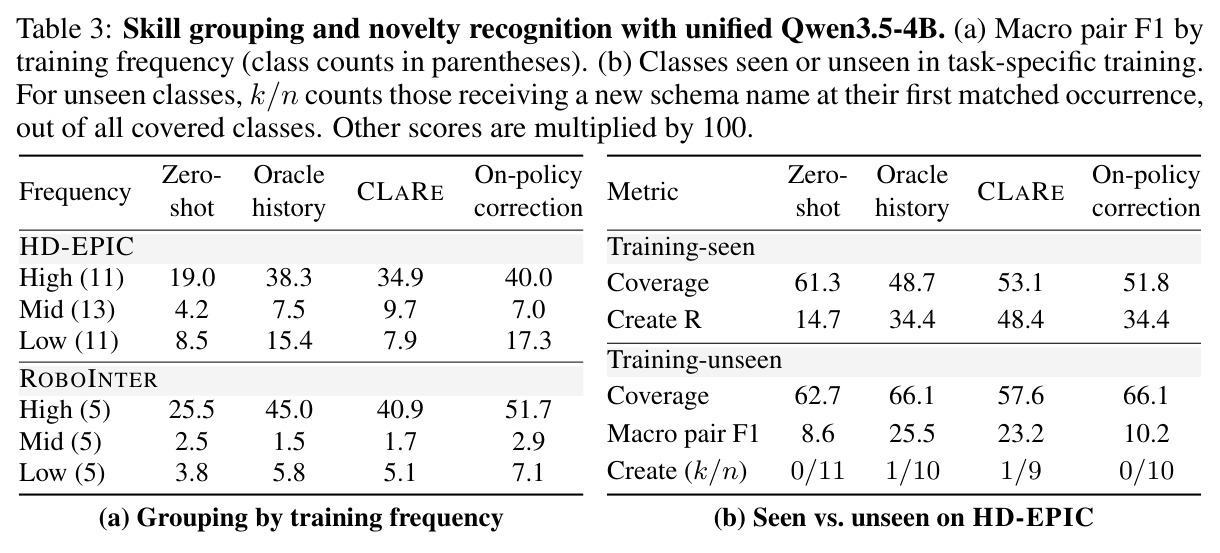
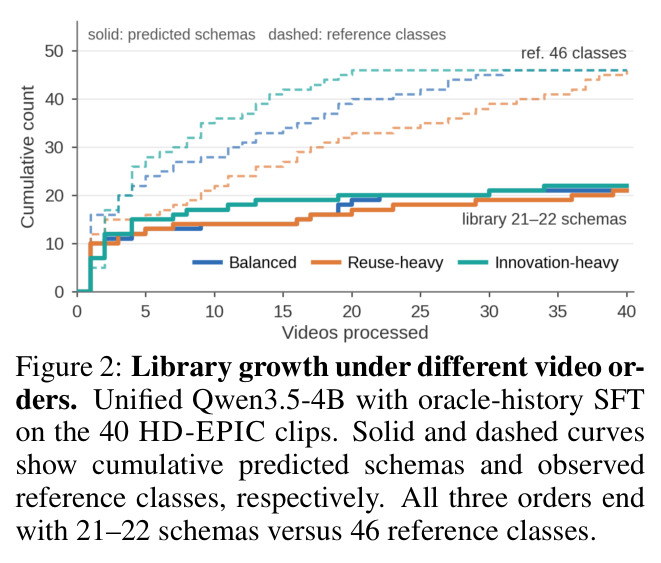
零样本评测(Table 1)显示全部配置 ARI ≤ 27.0、分组接近随机,且两种范式失败方向相反:HD-EPIC 上 Qwen3.5-2B 统一→因子化,配对精确率 9.2→48.0 而召回 53.8→2.4,新建召回 9.1→92.1 而复用召回 99.3→18.2;统一 LLaVA 在 ROBOINTER 召回 100.0 而精确率仅 22.5、ARI 0.0。规模不保证提升:Qwen3.5 4B→27B,HD-EPIC ARI 8.7→19.9 而 ROBOINTER 19.4→4.6。监督微调(Table 2)修复分组但未修复新建:统一 Qwen3.5-4B 在 ROBOINTER ARI 19.4→60.0、LLaVA 同设定 0.0→60.9,但训练后复用召回仍 97.0–98.7、新建召回仅 19.1–40.0。Table 3/Figure 2 显示:高频类获益最大(配对 F1 19.0→40.0),11 个未见类覆盖率 57.6–66.1 却几乎不新建(9–10 个覆盖类仅 0–1 个获新名),库最终停在 21–22 个模式(参考 46 类),识别「技能不够用」是核心瓶颈。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 技能分组(ROBOINTER,统一范式,监督微调后) | ARI | 60.9(LLaVA-OneVision-2-8B + Oracle-history SFT) | 同一模型零样本 0.0;19 个零样本模型全表最高 27.0(Cosmos-Reason2-8B) | 绝对提升 60.9,且远超任何零样本配置的最高分 |
| 技能分组(HD-EPIC,统一范式,监督微调后) | ARI | 31.0(Qwen3.5-4B + Oracle-history SFT) | 同一模型零样本 8.7 | +22.3,但仍不足参考类分区的一半水平 |
| 事件覆盖(ROBOINTER,零样本因子化范式) | Coverage (%) | 71.7(LLaVA-OneVision-2-8B) | 该模型统一范式 37.8 | +33.9,但其 Pair recall 仅 0.8、ARI 0.1——覆盖高不等于分组好 |
| 新建/复用决策(两个骨干、统一范式、微调后) | CREATE recall vs REUSE recall | CREATE 19.1–40.0,REUSE 97.0–98.7 | 训练未见类首次出现时新建比例:0–1 / 9–10 个覆盖类 | 无正向提升:库最终仅 21–22 个模式,远低于 46 个参考类,暴露新建瓶颈 |
局限与改进
作者承认的局限:基准只覆盖机器人桌面操作与第一视角厨房活动,户外等更广场景未探索;技能模式只是观察到的物理变换的语义抽象,对下游规划与可执行控制的价值尚未验证。我自己的观察:(1) 参考标注并非全覆盖——ROBOINTER 训练段仅覆盖 55% 视频时间、验证测试段 82%,Coverage 分母只计已验证操作,其绝对值解释需谨慎;(2) 监督策略收益高度依赖骨干与领域组合,如 CLARE 在 ROBOINTER 因子化上把 LLaVA 的 ARI 从 2.7 提到 7.5 却把 Qwen 从 10.4 降到 4.7,缺乏可迁移的选型结论;(3) 微调实验只做了 4B/8B 两个骨干,前沿规模模型的行为未知;(4) CREATE/REUSE 指标只考察参考类首次出现时的命名是否为新,不评估完整库历史与 CONTINUE 操作,可能低估或高估真实库维护质量。
独立分析的弱点
独立分析的弱点:(1) 新建/复用被建模为单步命名选择,模型缺少对「当前变换是否落在已有模式泛化范围内」的显式不确定性估计,改进方向是引入相似度阈值或可学习的 novelty head 辅助决策;(2) 因子化范式的库管理器只看文本事件描述,丢失了区分 throw 与 place 所需的运动轨迹细节,可让库管理器回看关键帧或短视频片段再决策;(3) 三种 SFT 策略的目标仍是模仿参考决策,而「何时新建」本质是边界模糊、代价不对称的问题,更适合用按决策后果设计的偏好优化或奖励建模;(4) 库只增不减且无合并/淘汰机制,长视频流下重复模式与冲突如何处理未讨论;(5) 分组评测对一致重命名不变,但同义字符串仍算不同名称,对生成自由命名模型略有不公平,可引入名称嵌入相似度做软匹配;(6) 微调只覆盖 Qwen3.5-4B 与 LLaVA-OneVision-2-8B,结论对更大或混合专家模型的适用性存疑。
未来方向
作者指出需要开发既能巩固重复变换、又能适时引入新抽象的模型,并验证技能库对下游规划与控制的作用。基于本文成果可延伸:(1) 闭环设定——把 SESD 技能库接入任务规划器或低层策略,用任务成功信号反向监督新建决策,弥合被动观看与主动执行的差距;(2) 主动探索——允许智能体暂停回看、请求演示或调用工具来消解新建/复用的不确定性,而非单次前向被迫决策;(3) 检索式库与参数化技能结合,把符号模式与嵌入表示互查,缓解文本同义导致的碎片化;(4) 持续学习视角——把 CLARE 的反事实状态编辑推广为通用的库状态增广,系统研究库的合并、分裂与淘汰;(5) 跨具身与跨领域迁移实验,检验 $\mathrm{grasp}(\mathrm{cloth}, \mathrm{table})$ 到 $\mathrm{grasp}(\mathrm{lid}, \mathrm{pot})$ 的抽象是否真正共享;(6) 用更强的时序定位专用模型重测,厘清失败多少来自时间定位、多少来自抽象本身。
复现评估
复现条件总体友好:基准基于公开数据集 HD-EPIC、DROID 与 RH20T 构建;评测对象全部是开源 VLM(Qwen3.5/Qwen3-VL 系列、InternVL3.5 系列、Cosmos-Reason2、LLaVA-OneVision-2、Gemma-4、GLM-4.1V、MiniCPM-V、Ovis2.5 共 19 个),论文提供项目页面(andyzworks.github.io/video2skill)。测试集仅 40 个 HD-EPIC 片段加 132 个 ROBOINTER 视频,用 vLLM 推理一遍可控;微调只需 4B/8B 模型,单机多卡(如 4×A100)即可完成,CLARE 与 on-policy 数据生成依赖参考标注回放,成本主要在多次推理。不确定之处:论文正文未明确标注文件、代码与微调超参是否全部开源,训练数据规模与学习率等细节需查项目页面;总体复现难度中等,最费人力的是重新核验 ROBOINTER 标注(作者修正了 12,429 条已验证调用中的 241 条)。
论文图表