ProgressCompass:失去正确上下文便会迷失的具身进度奖励模型 ProgressCompass: Embodied Progress Reward Models Are Lost Without the Right Context
进度奖励模型不是不会估进度,而是缺正确上下文;智能体循环补上后误差降63%
前置知识
进度奖励模型(PRM)
为长程任务的每个观测打分、输出任务完成比例(0 到 1 或 0–100)的模型。在环境不提供奖励信号时它充当三种角色:给策略训练提供密集奖励、判定某一步是否完成的验证器、发现执行停滞的监视器。近年模型在大规模机器人语料上训练,可对任意指令和轨迹打分。
全文的诊断对象和系统核心都是 PRM,理解它的输入输出与三种用途是读懂问题的前提。
上下文依赖的进度估计
当前帧加指令不足以唯一确定进度,还差一条只存在于历史中的事实,例如方块来自哪块垫子、前几步是否完成、当前是第几次重复。作者把这个缺失事实定义为上下文 $c_t$,形式化为 $f(o_t\mid x)\neq p_t$ 而补上 $c_t$ 后 $f(o_t\mid x,c_t)=p_t$。
这是全文的问题定义,基准的三类设置与定理 1 的误差地板都由它派生。
视觉语言模型(VLM)
以图像/视频和文本为输入、文本为输出的大模型。它擅长理解任务、把指令拆成步骤、描述画面内容,但对连续的数值进度估计缺乏校准——让它直接输出进度分数并不可靠。
ProgressCompass 的分工前提是 VLM 擅长提供上下文而不擅长打分,Orienter 与 Verifier 都由 VLM 担任。
MAE 与 Spearman ρ
MAE 是预测进度与真实进度的平均绝对误差(本文用 0–100 量表),衡量数值准不准;Spearman ρ 是预测曲线与时间的秩相关系数,衡量一路走来的估计顺序对不对。两者可以一好一坏,论文同时报告。
表 1 与图 5 的所有结论都用这两个指标表达,不认识它们就读不懂实验部分。
oracle 与 self-chained 上下文
诊断实验的两种给上下文方式。oracle:人工把正确子任务指令(含标注的上下文)替换给模型,相当于上帝视角;self-chained:以模型自己上一步打分的终点为锚续接,考察误差是否随步骤累积。
表 1 的核心对照,两者的差距直接说明自锚误差的累积有多严重。
智能体循环(agentic loop)
多个模型角色按固定协议互相调用、循环推进直至任务结束的系统结构。每个角色只做一件擅长的事,由一个控制器决定下一步调用谁,典型如 ReAct 式的思考—行动循环。
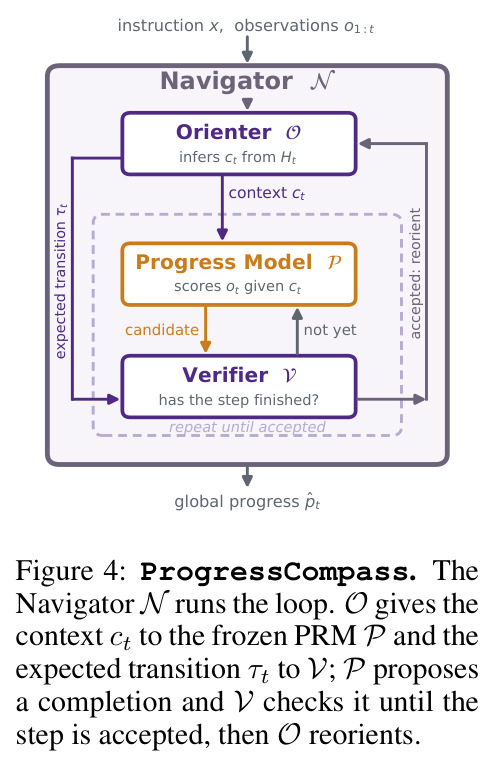
ProgressCompass 本身就是一个四角色循环,读懂图 4 和附录实现细节需要这个概念。
研究动机
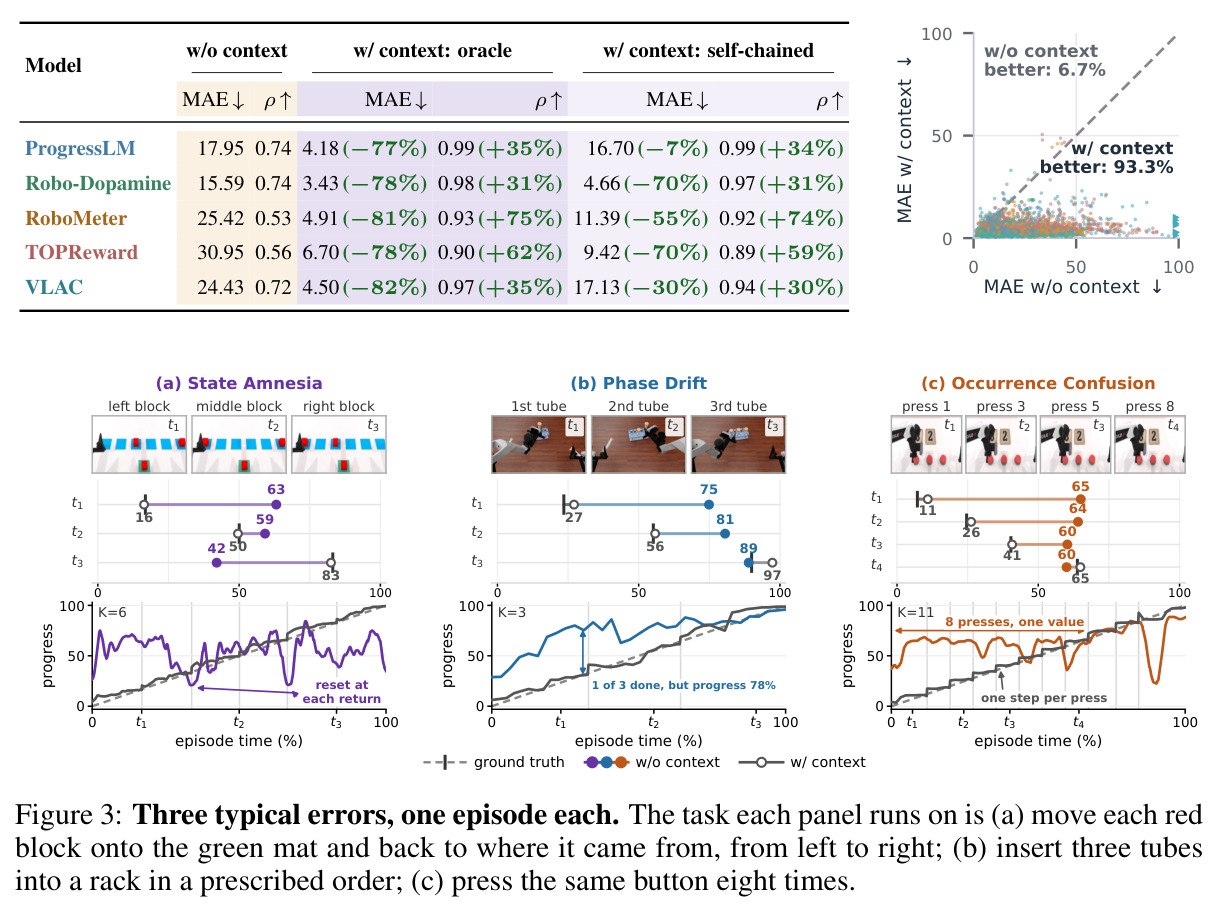
具身智能体承担的任务越来越长,对长任务只看最终成败信息量很小,过程每一步更重要。进度奖励模型(PRM)为每一步打 0–1 的进度分,在环境不给奖励时充当密集奖励、步骤完成验证器和执行停滞监视器。但现有 PRM 隐含一个假设:当前帧能读出进度——杯子看起来半满就是倒了一半。对长任务这不成立。论文举了一条指令:把每个红色方块搬到绿色垫子再放回原位、从左到右一次一个。方块被搬回时画面里看不到它来自哪个蓝色垫子;中间方块移动时看不出最左边的方块是否已完成往返;放置前后两帧几乎一样但进度不同。作者实测,五个主流 PRM 在这种任务上的 MAE 高达 15.6–31.0(0–100 量表),Spearman ρ 最低仅 0.53。而现有进度估计基准(如 value-order 评测、Progress-Bench)大多只考短任务、进度可从当前观察直接读出,需要上下文时 PRM 行不行,始终缺乏系统检验。
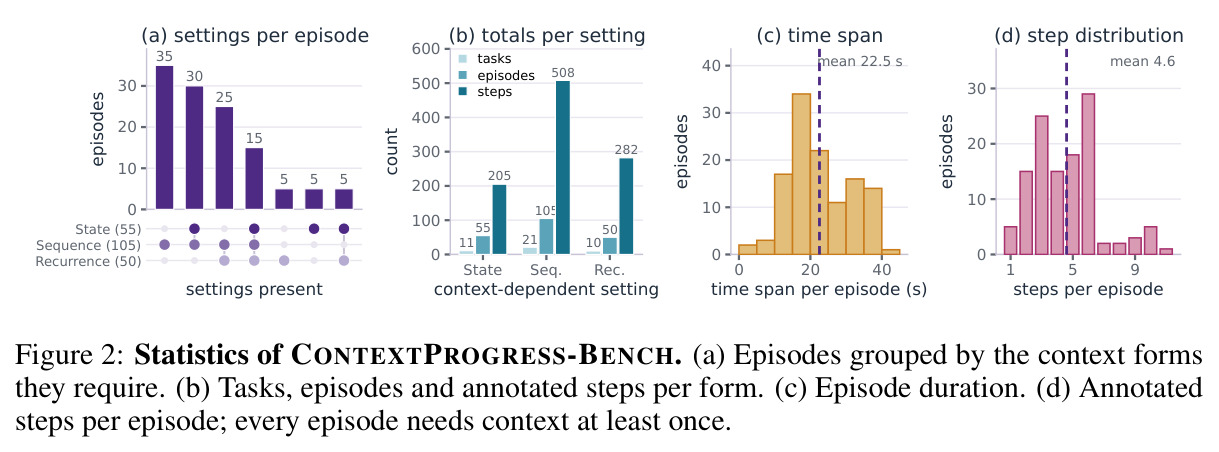
本文的目标是本文目标分三层。第一层是形式化:定义上下文依赖的进度估计——存在任务相关事实只出现在历史 $H_t$ 中而不在当前帧 $o_t$ 里,使得 $f(o_t\mid x)\neq p_t$,而补上上下文 $c_t$ 后 $f(o_t\mid x,c_t)=p_t$;并把上下文需求分为状态回忆、序列追踪、循环消歧三种形态。第二层是度量:构建 ContextProgress-Bench,含 24 个操作任务、120 条轨迹、71,708 帧、552 个人工标注的子任务区间,每个任务都经人工筛选确认为必须靠上下文才能估准进度,并逐区间标注所需上下文。第三层是回答与解决:用配对诊断判断 PRM 究竟是能力不足还是缺上下文,并据此设计零训练的 ProgressCompass——保持 PRM 冻结,用通用 VLM 供给上下文,使同一模型在长任务上误差减半以上,并在少做、多做、做无关事这三种指令—执行不匹配情形下保持稳健。
与已有工作不同的是,最独特的切入是区分拥有历史与拥有上下文。常识补救是把整段历史喂给模型,但历史只是原始观察流;模型真正需要的是一条被指令和当前帧共同选中的具体事实——方块来自哪块垫子、完成了几次往返、当前是第几次重复。作者把它写成解释算子 $c_t=\phi(H_t\mid x,o_t)$:$\phi$ 依赖指令 $x$(决定找什么)与当前帧 $o_t$(决定还缺什么),同一历史在不同时刻读出的上下文不同,因此这是解释而非检索。第二个独特角度是能力分工:诊断显示 PRM 一旦被告知当前是哪一步,打分就很准,却无法自己从历史推出这一点;VLM 正相反,擅长理解任务、拆步骤、提供上下文,数值进度估计却未经校准。两者各做对方做不好的事,于是作者不去训练更大的进度模型,而是围绕给冻结 PRM 重新定向构建系统,并用定理 1 把无上下文误差下界 $\delta_S+\delta_Q+\delta_R$ 与系统误差上界 $(\eta_{PC}+\lambda)/K$ 分开陈述。
核心方法
直觉上,PRM 的问题是不知道身处任务的哪一步,而不是不会给已知步骤打分。既然打分能力无损,就把定位当前步骤外包给擅长任务理解的 VLM,再用一个纯文本控制器把各角色串成自动循环。技术路线四步走。第一步形式化:把任务拆成 $K$ 个有序步骤,真实进度 $p_t=((a_t-1)+p^{loc}_t)/K$($a_t$ 为活动步序号,$p^{loc}_t$ 为步内进度),并证明任何只依赖 $x$ 和 $o_t$ 的估计器误差不低于三类场景的上下文地板之和 $\delta_S+\delta_Q+\delta_R$。第二步构造 ContextProgress-Bench 并做配对诊断:同一冻结模型、同一输入格式,仅指令中是否注入正确上下文之差,发现五个 PRM 无上下文时 MAE 为 15.6–31.0,有上下文时下降 77–82%。第三步设计 ProgressCompass 四角色循环:Orienter(Qwen3.5-27B)读帧产出自包含子任务句与预期转移 $\tau_t$;冻结 PRM(RoboMeter-4B)只对当前步开始后的帧打分;Verifier(Qwen3.5-9B)依据三帧与 $\tau_t$ 裁决步骤是否完成;纯文本 Navigator 调度全流程并维护计划与已验证记忆。第四步工程化:跨 episode 并行调度,单轨迹耗时从 114.7 s 降到 39.5 s,精度不变。
核心创新是重新定向而非再训练:不改 PRM 权重、不改其输入格式,只把它看到的整段任务指令换成 Orienter 生成的自包含子任务句,让它退回到局部可辨识步骤内打分这一被证明可靠的能力上(Definition 1:每步有含对象、来源、目标、完成条件的自包含描述,配上该步开始后的帧即可确定步内进度)。与已有方法的本质区别有三点。其一,与 R2VLM 等把整段历史或检索片段喂给模型的方法不同,作者论证历史不等于上下文:$\phi$ 是解释而非检索,且从历史均匀采 $B$ 帧会以至少约 $1-BL/t$ 的概率完全错过长度为 $L$ 的关键窗口(Lemma 2),所以模型读了历史不等于用上了历史。其二,Verifier 不是抽象地问完成了吗,而是要求 Orienter 一并产出可检验的预期转移 $\tau_t$(步骤完成后画面应显示什么),按陈述结果裁决,用文字补足像素看不出的信息,拒绝时记录不被污染。其三,理论把组件与误差一一对应:提前推进需要 PRM 早提名且 Verifier 误接受(概率 $\alpha\beta\le\alpha$),错误完成不会进入记忆,漏检只造成一步延迟,最终误差上界为 $(\eta_{PC}+\lambda)/K$。
方法步骤详情
完整流程如下。(1)建计划:Orienter(Qwen3.5-27B,温度 0、关闭思考、按固定 JSON schema 输出)首次调用时看当前帧,列出可见物体及数量,把指令拆成有序计划:重复动作为每次出现单列一步,每步附一个可目视检验的完成判据;之后可增删改排序开放步骤,已满足步骤固定不变。(2)定向:O 对下一个待做步骤输出自包含子任务句、步骤前状态、预期转移 $\tau_t$、步骤后状态与完成类型提示(持续状态/短暂交互/观察)。(3)打分:冻结的 RoboMeter-4B 输入当前步骤开始以来的帧加子任务句,视频每 10 帧采样、至多 128 帧,从分数曲线取完成候选:高分帧、持续回落前的峰值或视频结尾。(4)验证:Verifier(Qwen3.5-9B)看步骤开始、进行中、候选三帧,加上子任务句、$\tau_t$、预测后状态与已验证记忆,先逐帧描述可见变化(多个相同物体必须数数量),再判定该步骤是否新近完成;O 的描述只作参照,帧文冲突以帧为准,证据不确定即拒绝;接受则候选帧描述写入已验证记忆、Navigator 前进一步,拒绝则该步继续,每步至多验证 8 次。(5)导航:Navigator(Qwen3.5-9B,从不看帧)依据计划、各步满足状态、已验证记忆与当前序号按固定规则每轮发一次调用;全部步骤满足后让 O 复查一次有无遗漏,随后结束。(6)并行:episode 之间无依赖,调度器同时跑至多 5 条轨迹,把就绪调用派给空闲模型,单轨迹耗时 114.7 s 降到 39.5 s,MAE 与 ρ 在配对 bootstrap 区间内不变。
技术新颖性
新颖性体现在四个层面。问题层面:首次提出并形式化上下文依赖的进度估计,指出上下文 $c_t=\phi(H_t\mid x,o_t)$ 是随时刻变化的解释而非可检索对象,并给出按三种场景分项的误差地板 $\delta_S+\delta_Q+\delta_R$,从理论上说明为什么单纯堆模型容量无效。诊断方法层面:配对设计让同一冻结模型在仅差 $c_t$ 的两次运行之间自比,把缺上下文从模型容量、输入格式等混杂因素中干净剥离,552 个标注区间中 93.3% 的配对都因上下文而改善,结论不依赖少数简单 episode。系统层面:以冻结 PRM 为核心、通用 VLM 供给上下文,零训练零微调就把骨干 MAE 从 25.4 降到 9.3;预期转移 $\tau_t$ 把说该发生什么(Orienter)与裁决是否发生(Verifier)分离,使验证基于可检验承诺而非抽象判断,是对 VLM-as-judge 范式的实质改进。理论层面:Lemma 3 与 Lemma 4 证明无验证的提前推进既造成 $\ge(1-p^{loc}_t)/K$ 量级的高估、又会用假完成污染后续记忆,而验证把提前推进概率从 $\alpha$ 压到 $\alpha\beta$、漏检只延迟一步,把每个组件的价值都写成可分析的误差项。
实验结果
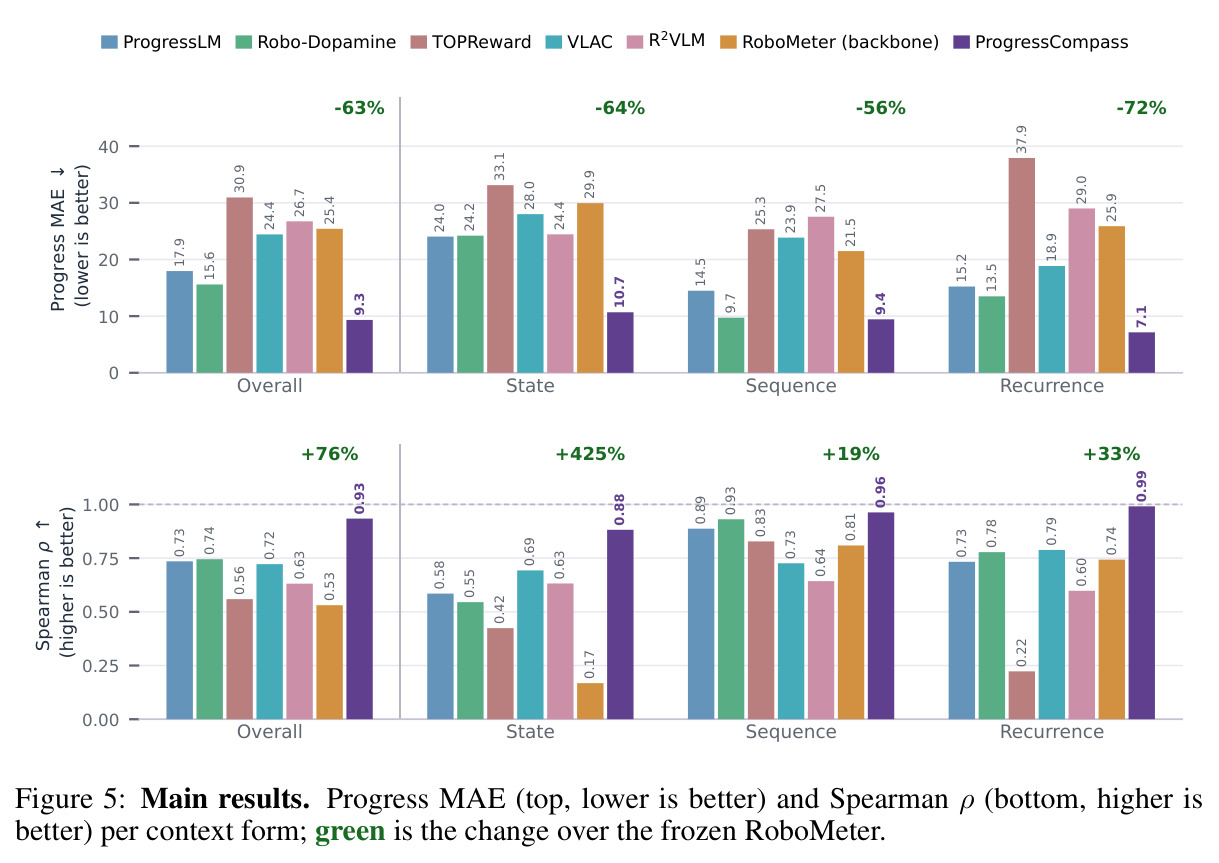
逐项看。诊断(表1):无上下文时五个 PRM 的 MAE 为 15.59–30.95(ProgressLM 17.95、Robo-Dopamine 15.59、RoboMeter 25.42、TOPReward 30.95、VLAC 24.43),ρ 最低 0.53;换入 oracle 上下文后 MAE 全面降到 3.43–6.70,相对下降 77–82%(RoboMeter 25.42→4.91 即 −81%,VLAC 24.43→4.50 即 −82%),ρ 升至 0.90–0.99,且 93.3% 的配对区间改善,说明不是靠少数简单样本拉平均。self-chained(以模型自己上一步终点为锚)提升明显缩水:ProgressLM 仅 −7%、VLAC −30%、RoboMeter −55%、Robo-Dopamine 与 TOPReward −70%,揭示自锚误差会累积。主结果(图5):把冻结 RoboMeter 包进 ProgressCompass,MAE 25.4→9.3(−63%)、ρ 0.53→0.93(+76%),收回 oracle 上下文缺口的 78%;三类场景分别比冻结骨干降 64%/56%/72%,全面优于读全历史的五个 PRM 与最接近的已有方法 R2VLM;子任务边界误差降约三分之二,5% 时长内命中的边界比例约增至三倍。鲁棒性(图7):Early stop 偏离仅 7.3(TOPReward 50.3、RoboMeter 32.7);Extra steps 偏离 15.8(对手 24.0–40.2)且是唯一到达 100 的方法;Mismatch 下曲线从不超过 0(VLAC 虽也为 0,但喂正确指令时会跑到 −63.8)。消融(图8):去掉 $\tau_t$ 使子任务末端误差从 8.6 升到 17.2(仅 V 无 $\tau_t$)和 18.8(O、V 都无),整体 MAE 9.3→17.5/18.3,卡死 episode 从 7 升到 40/45,而三版计划的步数相同——$\tau_t$ 改善的是验证而非规划。并行化把每轨迹耗时降到 39.5 s(−65.6%)而精度不变。
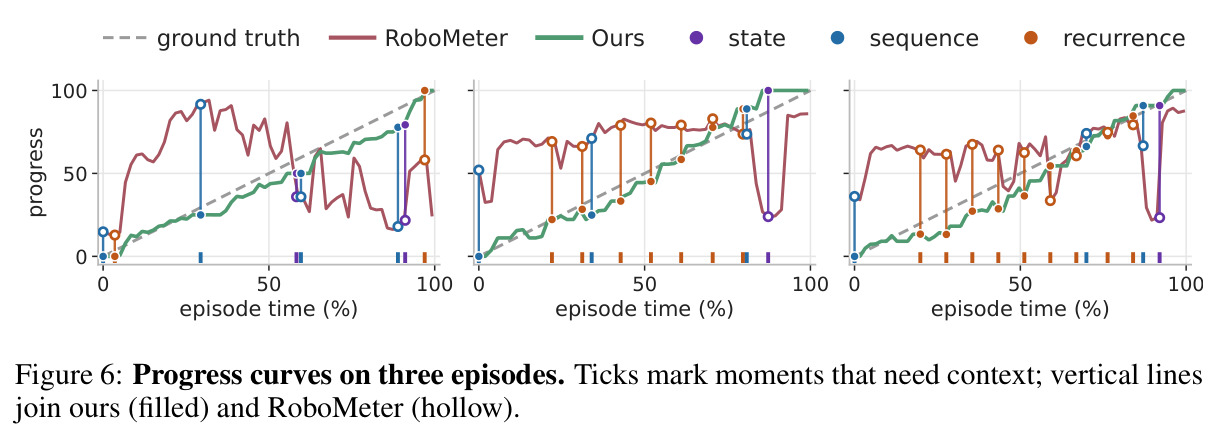
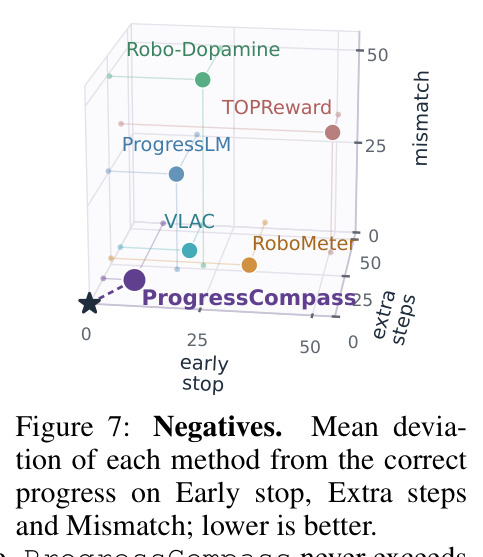
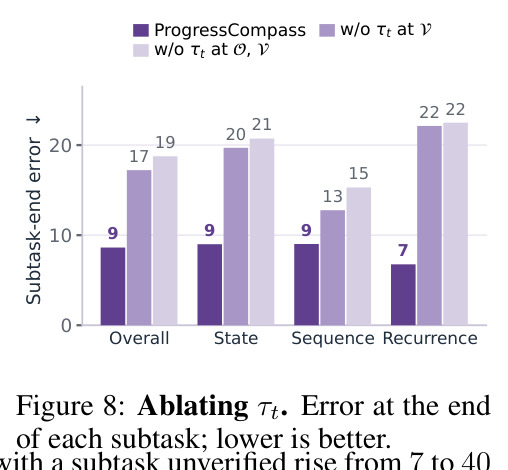
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 上下文依赖进度估计·配对诊断(5 个 PRM) | MAE(0–100,越低越好) | 给定 oracle 上下文:3.43–6.70 | 无上下文:15.59–30.95 | 相对下降 77–82% |
| 进度估计(冻结 RoboMeter-4B ± ProgressCompass) | MAE | 9.3 | 25.4(冻结 RoboMeter) | −63%,收回 oracle 缺口的 78% |
| 进度估计(同上) | Spearman ρ | 0.93 | 0.53(冻结 RoboMeter) | +76% |
| 分场景进度估计(State / Sequence / Recurrence) | MAE | State 9.4 / Sequence 7.1 / Recurrence 10.7 | 冻结 RoboMeter 骨干 | −64% / −56% / −72% |
| 子任务边界定位 | 边界误差;5% 时长内命中率 | 误差降约三分之二;命中率约增至三倍 | 冻结 RoboMeter | −67% 量级 / 约 ×3 |
| 负样本·Early stop(视频提前结束) | 与正确曲线的平均偏差(越低越好) | 7.3 | TOPReward 50.3;RoboMeter 32.7 | 对 RoboMeter 约 −78% |
| 负样本·Extra steps(视频多做少说) | 偏差 | 15.8(唯一到达 100) | 各对比模型 24.0–40.2 | −34% 至 −61% |
| 负样本·Mismatch(无关指令) | 偏差 | 0(曲线从不超过 0) | ProgressLM 25.4 / TOPReward 32.5 / Robo-Dopamine 49.1 | 绝对零偏差 |
局限与改进
作者承认的与我的补充。作者层面:诊断中的 oracle 上下文和子任务边界全部由人工书写与设定,真实运行时这些由 VLM 生成,定理 1 的第二行是条件而非保证——计划与标注步骤不匹配时按最大误差 $K$ 记罚;定理第一行只覆盖当前帧估计器,读全历史的 PRM 为何失败只是经验发现而非定理结论;基准只有 24 个任务、120 条轨迹,全部来自机械臂操作(RMBench、RoboDojo、LIBERO-Mem),单轨迹平均仅 22.5 s、平均 4.6 步,距真正的长程任务还有距离。我的补充:其一,正确性强依赖 Orienter 的计划质量与 VLM 的帧理解,计划错序几乎无法恢复(只在全部步骤满足后复查一次遗漏),换成更弱的 VLM 时会按 $K$ 记罚;其二,Verifier 每步至多 8 次验证,漏检只造成延迟但连续漏检会显著拖慢进度,系统对长期停滞缺乏显式处理;其三,论文只评测进度估计本身,没有验证该信号作为 RL 密集奖励训练策略的实际效果,也没有真实机器人在线部署;其四,四模型循环即使并行后单轨迹仍需 39.5 s(轨迹本身平均 22.5 s),对实时监视或训练期海量打分场景开销偏高。
独立分析的弱点
独立分析的弱点与改进方向。(1)计划单点故障:Orienter 首次建计划若漏步或错序,误差按最大值 $d_t=K$ 记罚,而系统只在全部步骤满足后复查一次遗漏,错序几乎没有恢复机制。改进:依据验证失败率触发在线重规划,让 V 的拒绝反馈回流到 O。(2)上下文生成与验证同源:O 与 V 都是 Qwen3.5 系 VLM,可能共享同种幻觉(例如把多个相同物体数错),验证的独立性存疑。改进:引入物体级检测与计数的客观状态跟踪作为 V 的证据源。(3)步内进度完全继承 PRM:误差上界中的局部项 $\lambda$ 由 RoboMeter 决定,骨干弱则整体上限低。改进:对局部可辨识性差的步骤回退为二值完成判定。(4)判据必须是可目视检验的:力矩、声音、力反馈等非视觉完成信号全部缺失,限制了可覆盖的任务类型。改进:接入本体感知/触觉状态作为额外语义。(5)成本结构:四模型循环、每步多次调用,作为 RL 奖励时需为海量转移打分,即使并行化后单轨迹 39.5 s 也难以实时。改进:把循环行为蒸馏进单个带记忆的 PRM,或只在高不确定性时刻调用完整循环。
未来方向
作者明确提出方向隐含在定位中:把 ProgressCompass 的进度信号真正用作长程任务的密集奖励、步骤完成验证与执行停滞监视,并把评测扩展到更长、更复杂的任务。基于成果可延伸的方向:其一,上下文内化——用循环的输出作为监督信号训练带显式记忆的 PRM(把 verified memory 压缩进隐状态),消除推理时的多模型调用,检验解释算子 $\phi$ 能否被学进单一模型;其二,主动感知——机器人发现自己无法定位当前步骤时主动回头观察(例如看向方块来源的垫子),把被动补上下文变成主动收集上下文;其三,与世界模型结合,用想象 rollout 为 $\tau_t$ 提供像素级预期,降低对 VLM 语言描述的依赖;其四,概率化验证——把 V 的二值判定换成带置信度的贝叶斯更新,使提前推进的风险可控可调;其五,跨具身与跨任务扩展——导航、家庭服务等非操作任务与真实机器人部署;其六,反向利用基准——把 ContextProgress-Bench 当训练集微调 PRM 的历史编码能力,直接检验读完整个历史能否替代 $\phi$。
复现评估
复现评估:所有组件均为公开模型——Orienter/Verifier/Navigator 用 Qwen3.5-27B/9B,冻结 PRM 用开放权重的 RoboMeter-4B,五个对比 PRM(ProgressLM-3B-RL、Robo-Dopamine-GRM-3B、RoboMeter-4B、TOPReward+Molmo2-4B、VLAC-8B)与 R2VLM 均有公开出处;基准基于公开数据源 RMBench、RoboDojo、LIBERO-Mem 构造,论文给出了项目主页。全程零训练,只有推理成本,主要开销是 27B 级 VLM 的调用(多卡或 API)。附录 B 给出相当完整的实现细节:温度 0、固定 JSON schema、每 10 帧采样至多 128 帧、每步至多 8 次验证、Navigator 固定调度规则;附录 C 逐一给出五个对比模型的推理配置,这在对比较公平性上做得较到位。最大障碍是基准标注:24 任务 × 5 轨迹、552 个子任务区间的上下文与边界全部人工完成,若作者不发布标注文件则需重做大量人工工作;正文未见明确承诺开源代码与标注,需以项目页为准。总体判断:能部署 27B VLM 的团队复现主结果难度中等,完整重建基准的成本显著更高。
论文图表
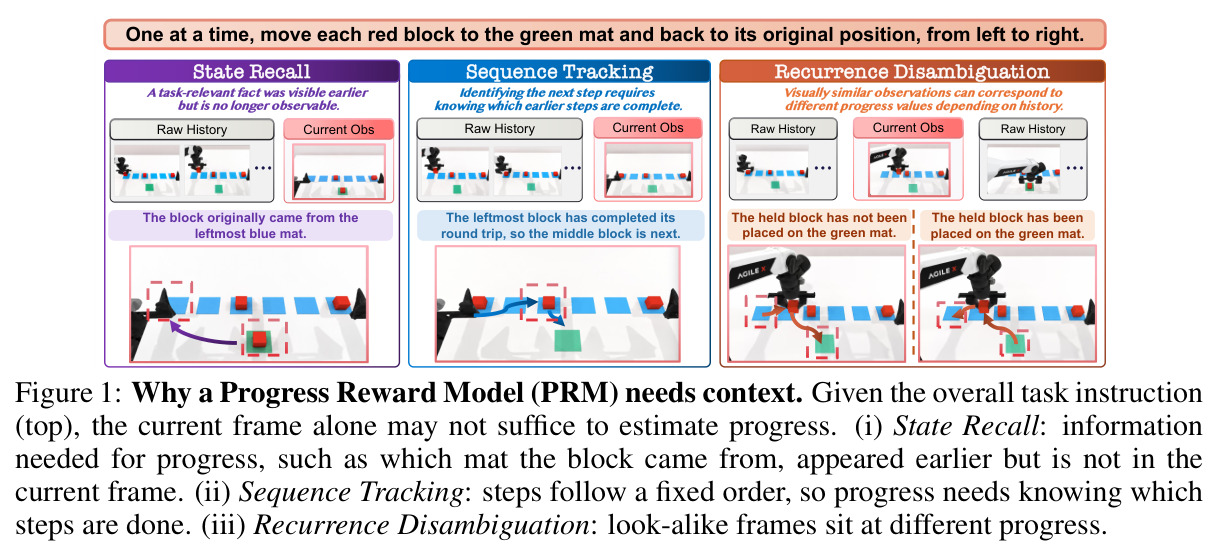
用同一条指令(把每个红色方块搬到绿色垫子再放回原位、从左到右一次一个)展示三种需要上下文的时刻:状态回忆——画面里看不到方块来自哪块蓝色垫子;序列追踪——需要知道最左边的方块是否已完成往返才能判断下一步;循环消歧——放置前后两帧几乎一样但进度不同。图下方对比了原始历史与当前观察两种输入下模型应当读出的结论。
这张图用具体画面定义了全文的核心问题和三种场景,是理解任务设定、基准设计与三种失败模式的起点。
五个 PRM 在无上下文、oracle 上下文、self-chained 上下文三种条件下的 MAE 与 Spearman ρ:无上下文 MAE 15.59–30.95、ρ 最低 0.53;oracle 上下文使 MAE 下降 77–82% 至 3.43–6.70,ρ 升至 0.90–0.99;self-chained 提升明显缩水(ProgressLM −7%、VLAC −30%、RoboMeter −55%)。右侧散点图逐区间配对两次运行,绝大多数点位于对角线下方。
全文最重要的证据表:同一模型仅差一条上下文就有四五倍的误差差,直接证明 PRM 是迷失而非无能,并量化了自锚误差累积。