从仅结果奖励的强化学习中诱导过程监督 Inducing Process Supervision from Outcome-Only Reinforcement Learning
仅用结果对错做RL奖励,让生成式PRM的思维链自发学会逐步过程验证
前置知识
过程奖励模型(PRM)
对推理轨迹的每个中间步骤给出质量判断(通常是 0/1 标签或分数)的奖励模型,区别于只评判最终答案对错的结果奖励模型(ORM)。典型用法是在 Best-of-N 中为候选解答打分、在 RL 训练中做逐步信用分配,代表工作有 PRM800K、Math-Shepherd、Qwen2.5-Math-PRM。
本文的目标就是低成本训练出强 PRM,全文核心评测(ProcessBench F1、AgentProcessBench FirstErrAcc)衡量的都是 PRM 的步骤验证能力。
GRPO
DeepSeekMath 提出的无 critic 的 PPO 变体:对同一输入采样一组 G 条响应,用组内平均奖励作基线计算相对优势 $\hat{A}^{(i)} = r^{(i)} - \frac{1}{G}\sum_j r^{(j)}$,再以 clip 目标更新策略,无需训练价值网络。本文使用不做标准差归一化的变体。
TIPS 的全部训练信号都来自 GRPO 的组内相对优势,理解它才能看懂附录 C 的 Eq. 6-7 以及训练实现细节。
Monte Carlo 步骤标注
Math-Shepherd 等方法用来自动构造过程标签的技巧:把解答在第 t 步截断,采样大量续写并统计最终答对的比例,以此作为该步骤的质量估计。省去人工标注,但每个步骤都要几十上百次 rollout,计算昂贵,且“存在正确续写”并不等于该步骤本身推理正确。
这是 TIPS 想替代的主流监督来源,论文动机与相关工作对比都围绕它的成本高、标签会偏离步骤内在正确性展开。
Fano 不等式与条件互信息
信息论工具。条件互信息 $I(Z;D \mid R)$ 度量在已知表示 R 之后思维链 Z 还额外携带多少关于结果 D 的信息;Fano 不等式把二分类错误率与熵联系起来,给出 $H(D \mid \hat{D}) \leq H_b(P_e)$,其中 $H_b$ 是二元熵函数。
论文的 Theorem 1、Theorem 2 和核心公式 Eq. 5 的下界推导完全建立在这两个工具上,是读懂第 3.3 节理论分析的前提。
ProcessBench 与 FirstErrAcc
ProcessBench 是数学过程错误识别基准:给定多步解答,要求找出第一个错误步骤或判定全部正确,官方指标为 F1;AgentProcessBench 把同样任务搬到多轮工具调用 agent 轨迹上(子集含 HotPotQA、GAIA、BFCL、$\tau^2$-Bench),指标为首个错误定位准确率 FirstErrAcc。
两大基准是本文所有主表的评测对象,85.2 F1 等关键数字均出自它们,不清楚任务形式就看不懂结果表。
研究动机
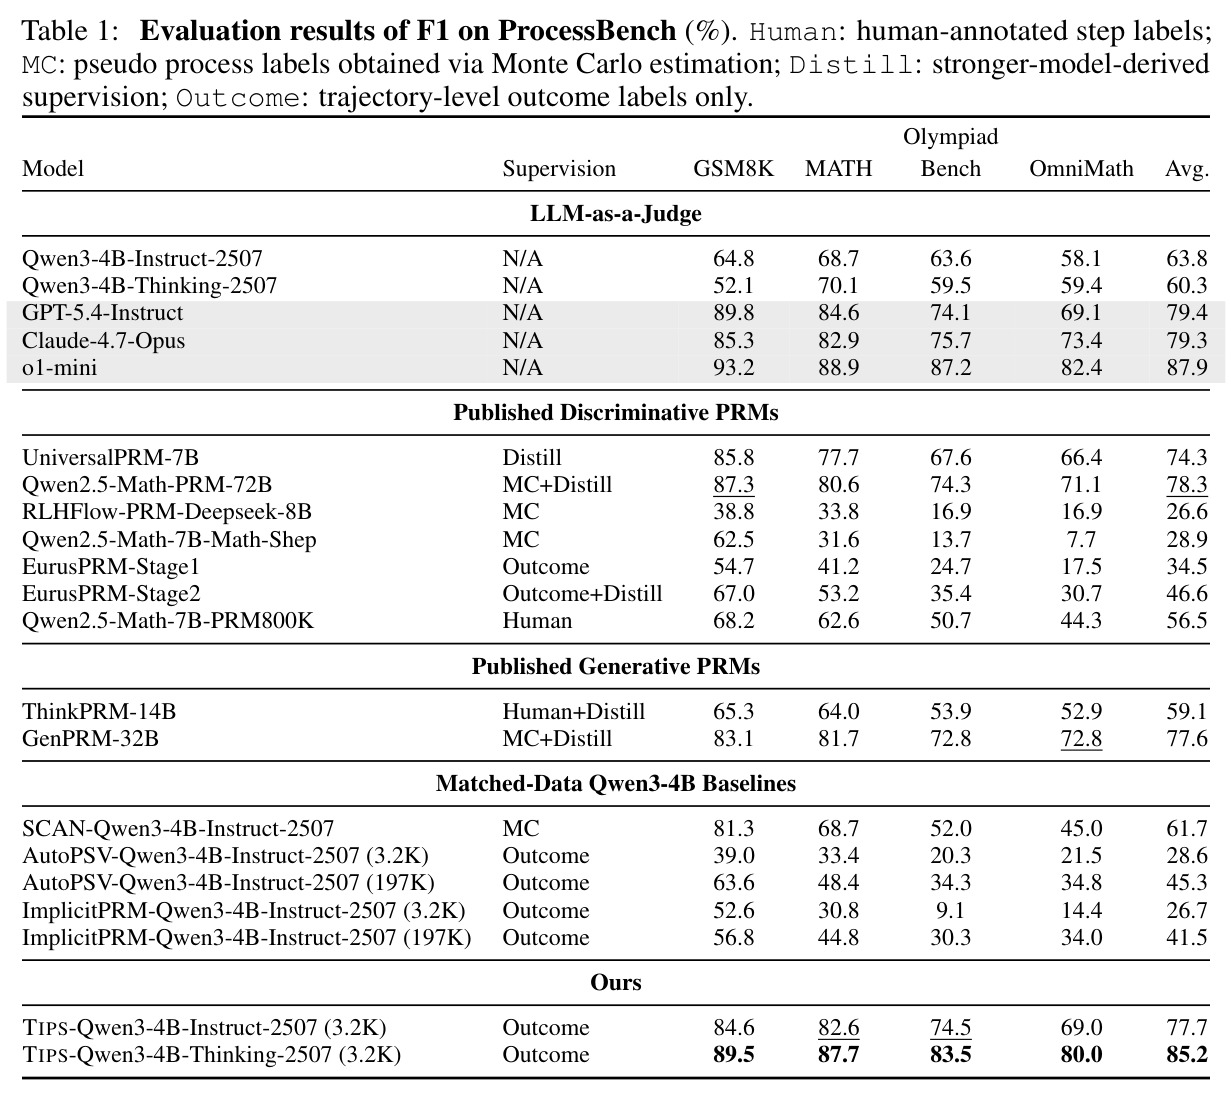
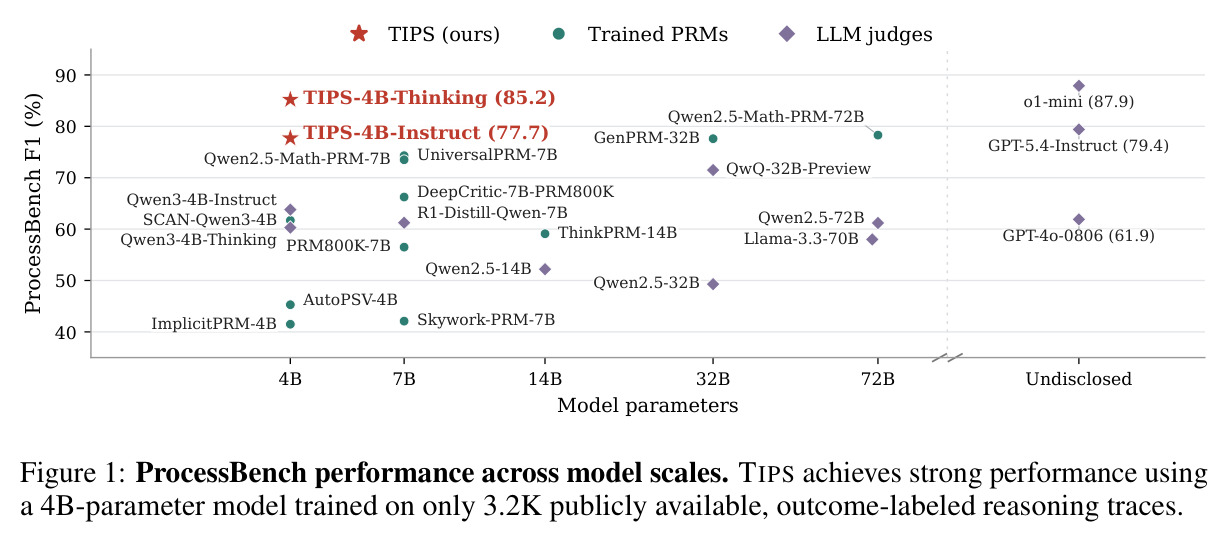
过程奖励模型(PRM)为 LLM 提供步骤级反馈,是测试时扩展和细粒度信用分配的核心组件,但训练强 PRM 代价高昂。第一条路线是人工逐步标注(如 PRM800K,Lightman et al., 2023),标签可靠但昂贵且难以规模化;第二条路线是 Monte Carlo 估计(如 Math-Shepherd、SCAN),对每个中间步采样大量续写来估计“能否到达正确答案”,虽然省人力,却需要海量 rollout、计算开销巨大,而且“存在正确续写”并不等于该步骤本身正确,伪标签会系统性偏离步骤的内在正确性(Zhang et al., 2025)。与本文设定最接近的仅用结果标签的隐式方法 AutoPSV 和 ImplicitPRM 表现也不佳:即使用 197K 条数据,ProcessBench 平均 F1 只有 45.3 和 41.5,无法可靠定位步骤级错误。直接用闭源强模型当裁判效果尚可(GPT-5.4-Instruct 79.4 F1),但推理成本高、不可控且难以私有化部署。
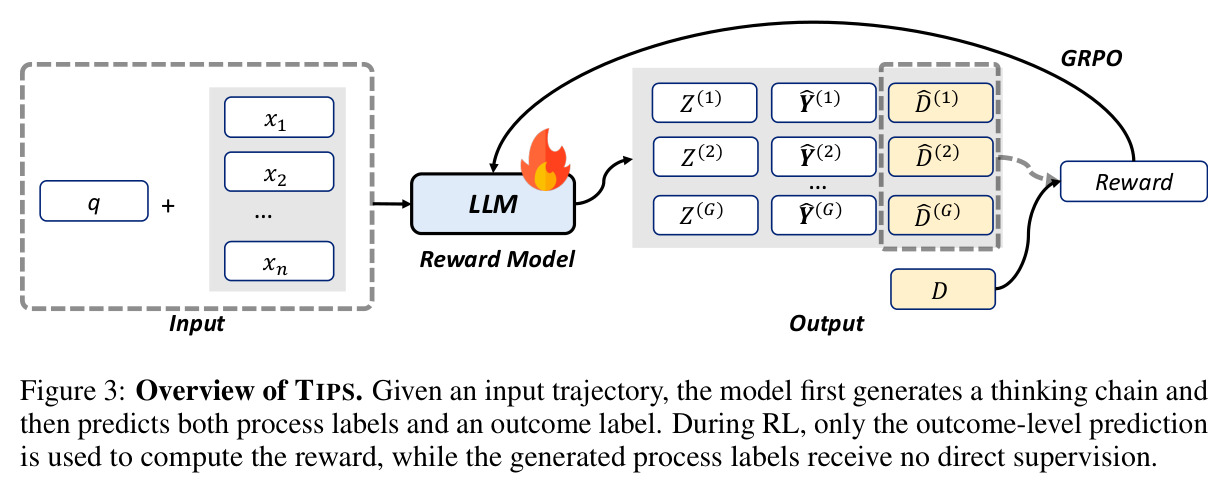
本文的目标是本文目标是:只用轨迹级结果标签——即只知道整条解答最终对错,完全不使用任何步骤级标注——用极少量数据训练出强过程验证能力。具体做法是设计一个 outcome-only 的 RL 框架 TIPS,把 LLM 训成生成式奖励模型:推理时先生成思维链,再输出逐步骤的 0/1 有效标签和整条结果的对错标签,其中步骤标签可直接当 PRM 使用。理想情况下,3.2K 条结果标注数据就能让 4B 模型在 ProcessBench 上超越 72B 判别式 PRM 和闭源 LLM 裁判,并能迁移到数学之外的 agent 轨迹验证任务;同时作者希望给出信息论层面的分析,说明这种“结果→过程”的信号转移在什么条件下成立、什么条件下失效,从而把直觉变成可检验的理论。
与已有工作不同的是,已有工作都没占住这个位置:判别式 PRM(Math-Shepherd、Qwen2.5-Math-PRM 等)把 LLM 仅当作带标量打分头的表示编码器,其生成推理能力被浪费;AutoPSV、ImplicitPRM 虽同样只用结果标签,但过程信号是隐式的,无法外化为显式步骤分析;GenPRM、ThinkPRM 等生成式 PRM 虽然也先推理再判断,但仍依赖人工步骤标注或 32B 级思考模型蒸馏,再加 Monte Carlo 估计做昂贵过滤;另一条线(RM-R1、J1、Reward Reasoning Models)用 RL 提升 ORM 准确率,但目标止步于更强的结果裁判。TIPS 的独特切入是反问:提升结果验证能否反过来强化过程验证?它把 PRM 能力当作 outcome-only RL 的“副产品”来诱导,并配套信息论下界解释机制与失效边界,这是与所有前作的本质区别。
核心方法
直觉起点是一个观察:把 LLM 当 ORM 提示时,其思维链已自发包含步骤检查。论文 Figure 2 中,Qwen3-4B 判断 $0^{56431564}$ 时逐段核查,发现第 1 段把“正数的 0 次幂等于 1”用反了方向(实际是 0 的大正数次幂),据此判定最终答案错误——即步骤验证信息在没有任何过程训练时就已存在。由此推论:如果思维链中准确的步骤检查有助于判对最终结果,那么奖励结果判断的 RL 就会强化“做过程验证”的思维模式。技术路线:对每个问题 $q$ 和候选解答 $x=(x_1,\dots,x_n)$,提示模型先生成思维链 $Z \sim \pi_\theta(\cdot \mid q, x)$,再输出步骤标签 $\hat{Y} \in \{0,1\}^n$ 与结果标签 $\hat{D} \in \{0,1\}$;奖励仅取决于结果预测是否正确 $r = \mathbb{1}[\hat{D} = D]$;用 GRPO 采样 $G$ 条 rollout,把组内相对优势加到整条响应的所有 token 上(思维链、步骤标签、结果标签一视同仁),让结果反馈同时塑造推理过程与过程判断。
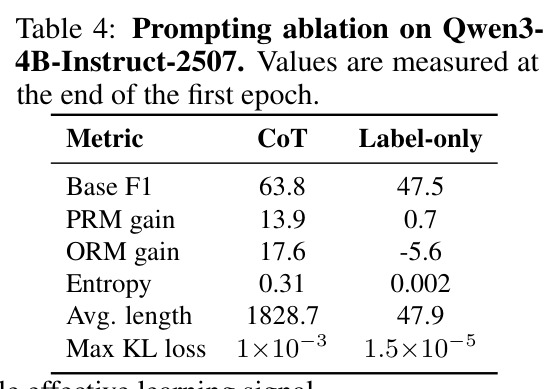
核心创新是奖励函数中完全不出现过程标签:$r = \mathbb{1}[\hat{D} = D]$,步骤标签 $\hat{Y}$ 只生成、不监督,过程监督是被结果奖励“诱导”出来的副产品。与 AutoPSV/ImplicitPRM 的本质区别在于把过程证据显式外化为语言化思维链——Table 4 消融证明这是信号载体:把 CoT 提示换成只输出标签的提示,PRM 增益从 +13.9 跌到 +0.7,几乎学不到过程验证。理论上,Theorem 1 用 Fano 不等式给出 $I(Z; D \mid R) \geq H(D \mid R) - H_b(P_e)$:结果判得越准,思维链必须携带越多关于结果的信息;Theorem 2 进一步给出 $I(Z; Y \mid R) \geq I(Z; D \mid R) - H(D \mid Y, R)$:当步骤正确性几乎决定结果时(数学推理中残差熵 $H(D \mid Y, R)$ 很小),结果信息必然转化为过程信息。合并成 Eq. 5 后,迁移强度被分解为验证难度、结果误差、步骤-结果耦合残差三项,直接预测出四种失效模式。
方法步骤详情
训练分四步。(1) 备数据:数学域从公开 SCAN-Pro 数据集抽 3,200 条带结果标签的轨迹;agent 域从 HotpotQA、GAIA、$\tau^2$-Bench、BFCL 构造 2,905 条轨迹,按任务提示 5-gram Jaccard 相似度 > 0.8 过滤去污。(2) 构造提示:把问题 $q$ 与按段落索引的候选解答 $x$ 拼入提示,要求模型先思考“推理从哪里开始失效”,再输出 JSON 格式的 step_labels(段落索引到 0/1,0 表示该段错误或依赖了前面的错误段落)和 final_label。(3) RL 优化:用 verl 框架做 GRPO,每个输入采一组 rollout,按 $r^{(i)} = \mathbb{1}[\hat{D}^{(i)} = D]$ 打分,计算非归一化组内优势 $\hat{A}^{(i)} = r^{(i)} - \frac{1}{G}\sum_j r^{(j)}$,以 clip 式 PPO 目标更新;KL 系数 0、rollout 上限 16K token、1 个 epoch、batch size 32、学习率 $1 \times 10^{-6}$,8 张 A800 80GB。(4) 推理:直接把生成的 $\hat{Y}$ 当步骤标签;Best-of-8 时先按预测结果过滤候选,再按平均步骤有效率排序。
技术新颖性
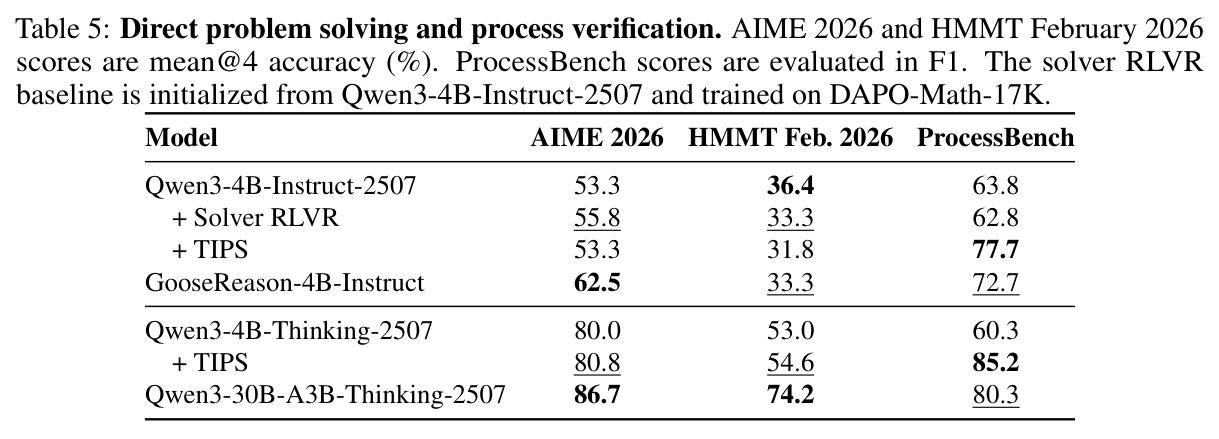
新颖性有四点。其一,机制上首次把“outcome-only RL 能诱导过程验证”从经验现象提升为可计算的理论断言:用互信息链式法则和 Fano 不等式推出 $I(Z; Y \mid R)$ 的显式下界,并据此给出失效预测——输入级捷径($H(D \mid R)$ 小)、结果优化无效($H_b(P_e)$ 大)、步骤-结果耦合松($H(D \mid Y, R)$ 大)、骨干表达力弱——这四条在 4.4 节和 Figure 5/6 中被逐条实证。其二,与隐式方法把过程信号压进标量头不同,TIPS 把过程证据显式写出来,Table 4 证明显式 CoT 是信号载体(CoT 变体 PRM 增益 13.9 vs label-only 0.7)。其三,设计极简:非归一化 GRPO、KL 系数 0、单一二值结果奖励、全 token 共享优势,没有过程奖励塑形、课程学习或辅助损失。其四,数据效率惊人:3.2K 条结果标签超过 197K 条数据的隐式方法(85.2 vs 45.3/41.5 F1),且发现 thinking 骨干会放大涌现(77.7→85.2)。
实验结果
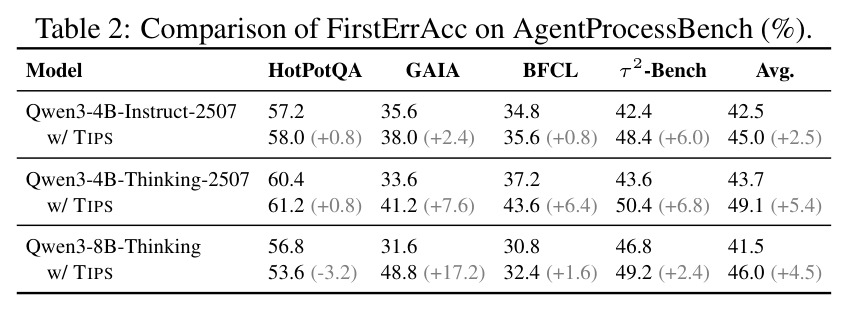
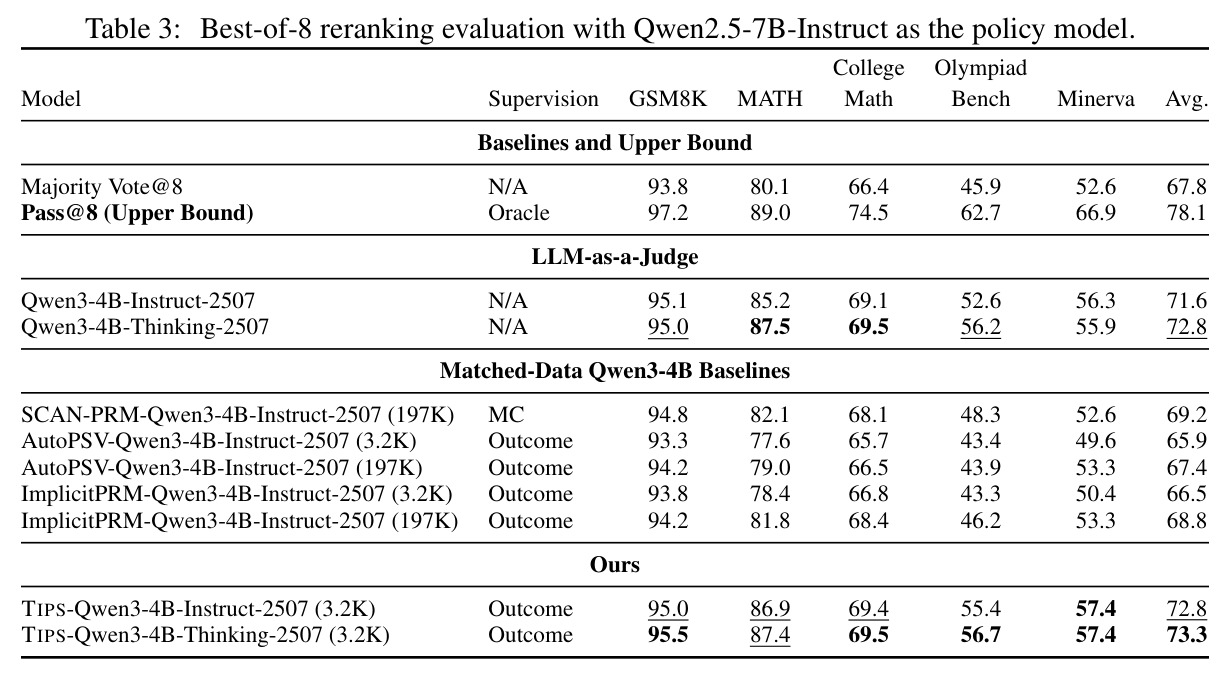
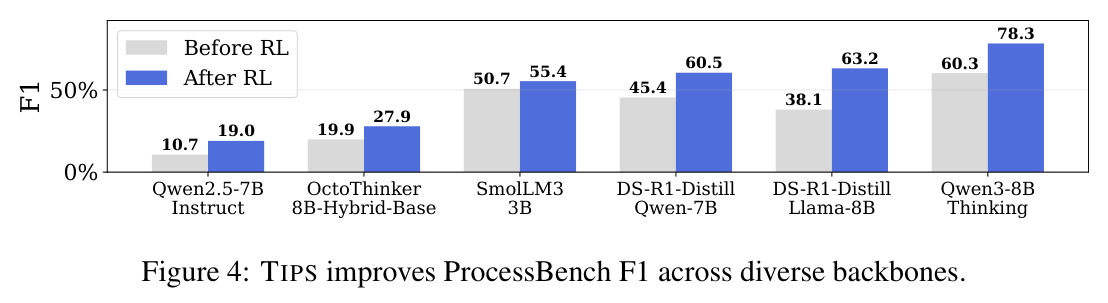
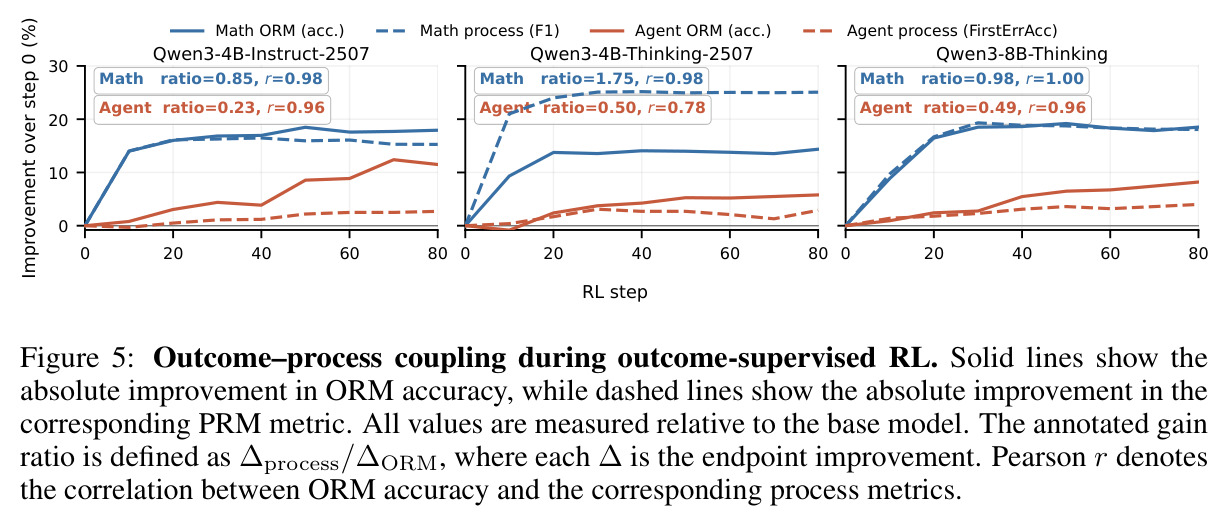
ProcessBench(Table 1):TIPS-Qwen3-4B-Thinking-2507 仅用 3.2K 条结果标注轨迹达到 85.2 平均 F1(GSM8K 89.5 / MATH 87.7 / OlympiadBench 83.5 / OmniMath 80.0),超过所有已训练 PRM——Qwen2.5-Math-PRM-72B 78.3、GenPRM-32B 77.6——也超过闭源裁判 GPT-5.4-Instruct 79.4 与 Claude-4.7-Opus 79.3,仅落后 o1-mini 87.9;Instruct 版 77.7 同样碾压同数据 AutoPSV 28.6 与 ImplicitPRM 26.7,197K 数据版也只有 45.3/41.5。AgentProcessBench(Table 2):三个骨干 FirstErrAcc 全部提升,4B-Instruct 42.5→45.0、4B-Thinking 43.7→49.1(+5.4)、8B-Thinking 41.5→46.0。Best-of-8(Table 3):TIPS-Thinking 达 73.3,高于多数投票 67.8 与 197K ImplicitPRM 68.8,距上界 78.1 还差 4.8。跨骨干(Figure 4):六个家族全部提升,Qwen3-8B-Thinking 升至 78.3。训练动态(Figure 5):ORM 与过程指标同步上升,Pearson r 0.78–1.00,数学增益比 0.85–1.75 远大于 agent 的 0.23–0.50。人工评估(附录 G):47/60(78.3%)首错定位正确,其中 80.9% 解释合理。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ProcessBench 数学过程错误识别(Thinking 骨干) | 平均 F1 (%) | 85.2(TIPS-Qwen3-4B-Thinking-2507,仅 3.2K 条结果标注) | Qwen2.5-Math-PRM-72B 78.3;GenPRM-32B 77.6;GPT-5.4-Instruct 79.4;Claude-4.7-Opus 79.3 | 较最强已训练 PRM(72B)+6.9,较 GPT-5.4-Instruct +5.8;仅落后 o1-mini(87.9)2.7 分 |
| ProcessBench(Instruct 骨干,同数据对比) | 平均 F1 (%) | 77.7(TIPS-Qwen3-4B-Instruct-2507,3.2K 条) | AutoPSV-3.2K 28.6 / ImplicitPRM-3.2K 26.7;197K 数据版 45.3 / 41.5;SCAN-Qwen3-4B 61.7 | 较同数据隐式方法 +49 以上,较 20 倍数据(197K)的 ImplicitPRM +36.2,较 MC 监督的 SCAN +16.0 |
| AgentProcessBench 智能体首错定位 | FirstErrAcc (%) | 45.0 / 49.1 / 46.0(4B-Instruct / 4B-Thinking / 8B-Thinking 加 TIPS 后) | 对应骨干裸模型 42.5 / 43.7 / 41.5 | 平均分别 +2.5 / +5.4 / +4.5,thinking 骨干收益更大 |
| Best-of-8 重排序(Qwen2.5-7B-Instruct 采样) | 五个数学基准平均准确率 (%) | 73.3(TIPS-Qwen3-4B-Thinking-2507) | Majority Vote@8 67.8;197K ImplicitPRM 68.8;Pass@8 上界 78.1 | 较多数投票 +5.5,较 197K ImplicitPRM +4.5,距上界还差 4.8 |
局限与改进
作者承认三点局限:只覆盖纯文本推理与工具型 agent 轨迹,未验证多模态场景;方法依赖结果-过程耦合,agent 任务中失败可能源于缺失动作或无效探索而非某个明显错误的已观察步骤,导致收益更小更不稳定(Table 2 中 8B-Thinking 在 HotPotQA 上甚至 -3.2);依赖骨干的 CoT 先验,Qwen2.5-7B-Instruct 的 PRM F1 在 step 30 达峰 +25.7 后退化到 +9.4(Figure 6),弱模型会走捷径只拟合结果对错。我补充几点:步骤标签是 0/1 级联式定义(依赖错误前段的段落一律记 0),丢失了错误类型与严重度信息;生成式验证每次要产出约 1.8K token 的思维链(Table 4 中 CoT 变体平均 1828.7),批量打分推理成本高;奖励是纯二值、无部分得分;被诱导的标签可能有偏且失准,作者也在 Broader Impacts 中警告不宜在高风险场景当 ground truth;此外 o1-mini(87.9)仍领先,绝对上限尚未触及。
独立分析的弱点
独立分析四个弱点。第一,捷径退化:Figure 6 显示 Qwen2.5-7B-Instruct 的 ORM 快速提升(最终 +41.1)但 ProcessBench F1 先升后降,说明结果目标可被“直接预测解答对错”的捷径满足,而步骤判断未被真正塑造;改进方向是把作者的经验性早停(ORM 准确率进入平台期且响应长度下降时停止)形式化为基于输出熵或 KL 的在线准则,或先用少量 CoT 蒸馏做预热再 RL。第二,级联 0/1 标签过粗:后段只要依赖错误前段就记 0,无法区分“首次错误”与“错误传播”,也不含错误类型与严重度;可改为直接预测 first-error 索引或引入细粒度错误类别。第三,agent 域耦合弱、增益异质:HotPotQA 上 8B-Thinking 反而 -3.2,因为任务失败常来自缺失动作而非错误步骤;可设计分段级结果信号或层次化奖励把反馈局部化。第四,推理成本:每个候选约 1828.7 token 思维链,Best-of-8 要对 8 条轨迹逐一生成;可把思维链蒸馏进判别式打分头,或先用便宜 ORM 粗筛再用 TIPS 精判的级联方案。
未来方向
作者提出的方向:把 TIPS 与轻量 Monte Carlo 先验或 CoT 蒸馏结合,以弥补弱耦合域与弱先验骨干的不足;向多模态扩展(图像、视频等非文本观察上的过程验证)留作未来验证。基于成果还可延伸:其一,把 TIPS 诱导的步骤标签当作数据引擎,批量生成伪过程标注再训练判别式 PRM,兼得生成式信号的质量与判别式的推理速度;其二,在 RLVR 训练管线中用 TIPS 作过程 critics 做逐步信用分配,检验能否提升策略模型的样本效率与稳定性;其三,对诱导标签做校准与不确定性估计,界定其可安全用于教育反馈与 agent 调试的边界;其四,把 Eq. 5 的三项分解做成可测量的诊断量(估计 $H(D \mid R)$、$H_b(P_e)$、$H(D \mid Y, R)$),在选择骨干、设计早停时直接优化可迁移性;其五,探索 soft 结果奖励或部分得分,缓解二值奖励的稀疏性;其六,研究 TIPS 与测试时扩展(自一致性、多轮重验)的组合收益。
复现评估
复现条件相当友好。代码与数据已在 GitHub 开源(https://github.com/RUCBM/TIPS);数学训练集直接取 HuggingFace 公开的 SCAN-Pro(dyyyyyyyy/SCAN-Pro)抽 3,200 条,agent 域 2,905 条轨迹由 HotpotQA、GAIA、$\tau^2$-Bench、BFCL 构造,并给出明确去污染规则(5-gram Jaccard > 0.8 剔除);完整提示词见附录 F。训练用 verl 框架,8 张 NVIDIA A800 80GB,1 个 epoch、batch size 32、学习率 $1 \times 10^{-6}$、KL 系数 0、rollout 上限 16K token,超参完整披露。评估协议清晰:ProcessBench 官方 F1、AgentProcessBench 官方 FirstErrAcc、Best-of-8 统一用 Qwen2.5-7B-Instruct 的采样候选,附录 G 还给出 60 条人工评估细则。主要门槛是需要 RL 基础设施(rollout 引擎 + 8×80GB 显存),但数据成本几乎为零。总体属中等难度:有 RL 训练经验的团队可在单机 8 卡完成。
论文图表
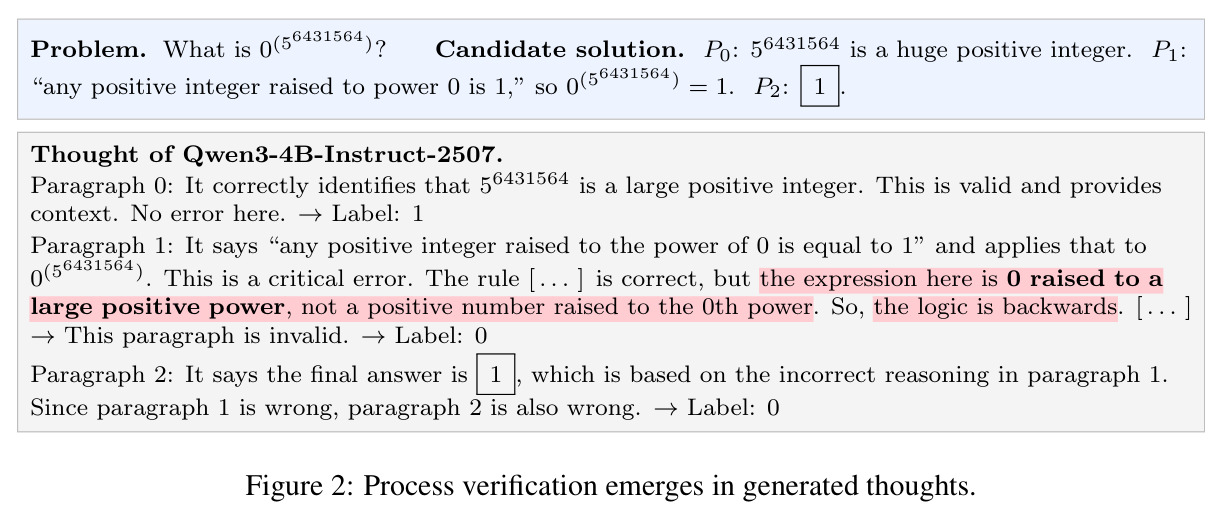
展示一个具体案例:题目求 $0^{56431564}$,候选解答 P0 正确识别大正整数、P1 把指数法则方向用反得出 1、P2 沿用错误结论。Qwen3-4B-Instruct-2507 在思维中逐段核查,给第 0 段标 1,指出第 1 段把“正数的 0 次幂”与“0 的正数次幂”搞反并标 0,第 2 段因依赖错误前段也标 0,最终判定结果错误。
这是全文动机的经验起点:说明 ORM 提示下模型思维链已自发含有步骤级验证,从而引出“结果 RL 能否强化它”的核心问题,不理解此图就看不懂方法设计的逻辑。
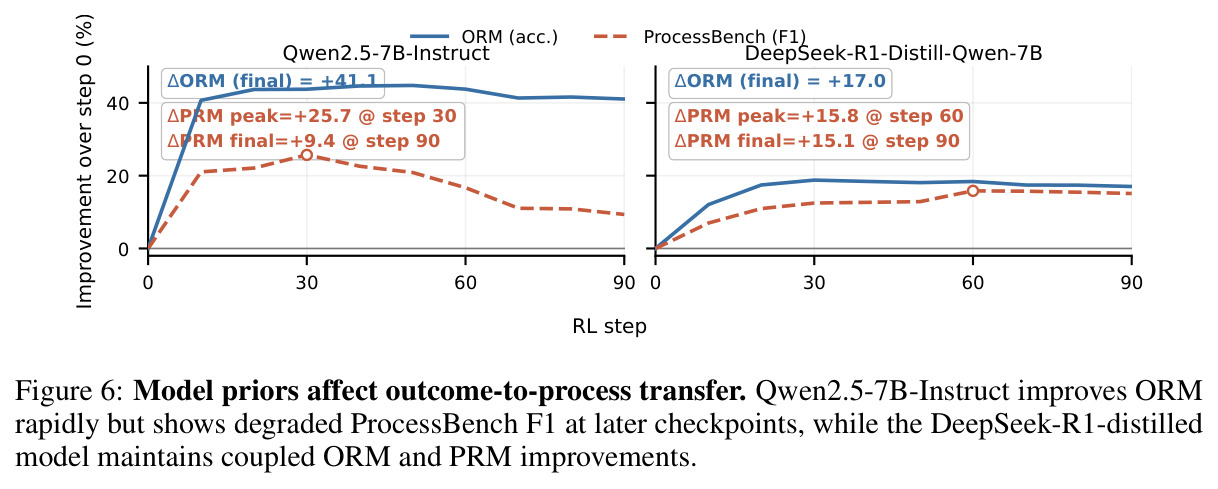
对比 Qwen2.5-7B-Instruct 与 DeepSeek-R1-Distill-Qwen-7B 的训练动态:前者 ORM 最终 +41.1,但 ProcessBench F1 增益在 step 30 达峰 +25.7 后回落至 +9.4;后者 ORM +17.0 与 PRM +15.8(step 60)保持耦合、稳定收敛。
揭示 TIPS 最重要的失效模式——弱 CoT 先验骨干会走捷径——并支撑作者提出的“ORM 平台期且响应长度下降即早停”启发式,对实践者选择骨干和停止时机最有指导价值。