Cliff:从第一个错误学习过程奖励 Cliff: Learning Process Rewards from the First Mistake
教师定位推理首个错误,把rollout切成对错两段分别赋优势,以极低成本增强RLVR
前置知识
RLVR(可验证奖励的强化学习)
用自动验证器代替人工标注来产生奖励的强化学习后训练范式:数学题比对最终答案、代码跑测试用例,答对得1分答错得0分。因为验证全自动且无偏,可以在海量题目上无限扩展,已成为训练推理型大模型(如 DeepSeek-R1、o1)的标准做法。但其奖励只看最终结果,是典型的稀疏、粗粒度信号。
Cliff 的全部工作就是在 RLVR 框架内做奖励塑形(reward shaping):保留可验证奖励的客观性,同时注入过程级信息。不理解 RLVR 的稀疏性缺陷,就无法理解 Cliff 的动机。
GRPO(组相对策略优化)
DeepSeekMath 提出的 RL 算法:对同一 query 采样 N 条 rollout,用组内奖励的均值和标准差做标准化得到优势 $A_i = \frac{R_i - \mathrm{mean}}{\mathrm{std}}$,同一条 rollout 内所有 token 共享同一优势值,从而省去 PPO 的价值网络。二值奖励下组内优势只有两个取值:正确 rollout 共享 $A^{cor}$,错误 rollout 共享 $A^{inc}$。
Cliff 是直接长在 GRPO 之上的扩展:它的优势公式(论文式 3、4、5)就是对 GRPO 组内两个离散优势值做 token 级重分配。看懂式 (2) 是看懂式 (4) 的前提。
优势与信用分配(Credit Assignment)
强化学习中优势衡量某个动作好于平均期望的程度,决定该动作被强化还是被抑制。LLM 的 RL 里每个 token 都是一个动作,但 GRPO 把整条 rollout 的分数平均摊给所有 token——算对的步骤和算错的步骤得到同样的信号,这就是信用分配过粗的问题。
Cliff 的核心贡献是一种新的信用分配粒度:用第一个错误的位置 $p(a)$ 把 rollout 内的 token 分成两组,前缀拿更高的优势、后缀拿负优势。整篇论文本质上是在回答'信用分配需要做到多细'。
过程奖励模型(PRM)
对推理链的每一步打分的奖励模型,如 Lightman et al. 的 'Let's Verify Step by Step' 和 Math-Shepherd。相比只看结果的结果奖励模型(ORM),PRM 能定位中间错误。但训练一个好 PRM 需要海量逐步标注或蒙特卡洛rollout估计,且近期研究(Zheng et al. 2024, Tiwari et al. 2026)表明 PRM 易被奖励黑客攻击、甚至退化成结果奖励。
PRM 是 Cliff 的头号对照路线。Cliff 用'只找第一个错误'这一极粗信号替代 PRM 的逐步打分,省掉了训练奖励模型的整条管线。理解 PRM 的数据饥饿和黑客风险,才能体会 Cliff 设计的取舍。
在线策略蒸馏(OPD)
让教师在学生自己采样的 rollout 上计算 token 级对数概率,学生的每个 token 向教师的分布靠拢(如 Thinking Machines 的 k1 估计器)。因为学生在自己的轨迹上学习而非模仿教师的轨迹,避免了暴露偏差。但教师必须能给学生的 token 打分,这要求师生共享 tokenizer、推理模式相似(最好同家族)。
OPD 是 Cliff 的另一个主要基线。论文声称 Cliff 跨教师家族时比 OPD 平均高约 15%——因为 Cliff 的信号是'对/错+位置'的事实判断,与教师用什么 tokenizer、什么表达风格完全解耦。
奖励黑客与长度黑客(Length Hacking)
策略不提升真实能力、只利用奖励函数漏洞刷分的现象。长度黑客是 LLM RL 的经典形态:模型学会把输出拉长(复读、灌水、无限自我修正)来获取更高奖励,因为更长的回答在统计上更容易'蒙'对或包含更多被部分奖励的片段。
Cliff 给错误 rollout 的正确前缀发优势,天然存在'故意拖长正确前缀刷分'的风险。论文的 $\lambda=0$ 选择、超长 rollout 置 $p(a)=0$ 的硬截断、以及附录 C 整套'长度质量'$\Phi$ 理论分析,全是为了堵住这个漏洞。
研究动机
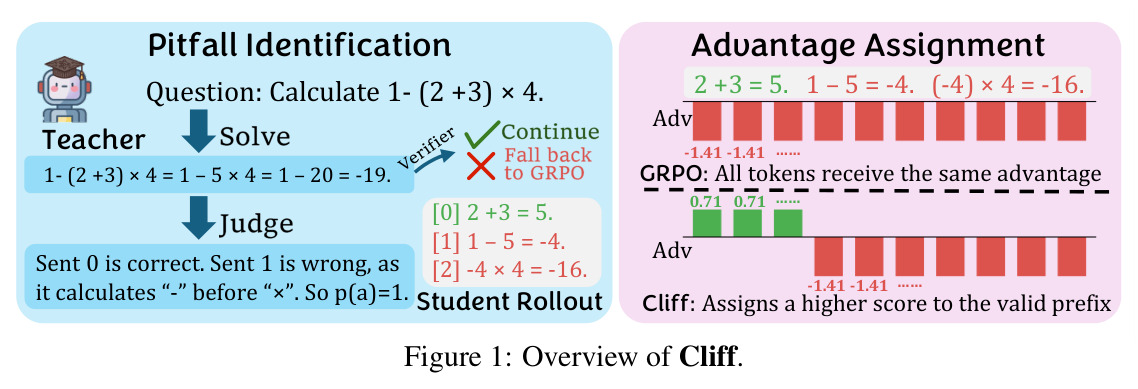
RLVR 已成为 LLM 推理后训练的标准范式,但其结果奖励极其粗粒度:一条只差最后一步就完全正确的解,和一条从第二步就跑偏的解,收到的是同一个 0 分。论文图 1 给了个直观例子:学生计算 $1-(2+3)\times 4$ 时先算减法后算乘法,尽管前面的去括号完全正确,整条轨迹仍被判错,正确前缀的推理得不到任何肯定。这种稀疏的结果导向监督既无法区分推理过程的质量差异,也无法把功劳/过错分配到具体步骤,降低学习效率。为引入细粒度监督,两条主流路线各有硬伤:过程奖励模型(PRM)需要额外训练一个专门奖励模型,Zheng et al. (2024)、Zeng et al. (2025a) 指出其需要海量数据才能保证泛化,且频繁遭受奖励黑客攻击(Cheng et al. 2026; Tiwari et al. 2026),甚至退化为结果奖励(Zhang et al. 2025);在线策略蒸馏(OPD)只在教师与学生共享相似推理模式、属于同一家族甚至同一 tokenizer 时才最优(Fu et al. 2026),跨模型家族时性能明显崩塌(Table 2 中开源教师的 OPD 反而低于 GRPO)。
本文的目标是论文没有顺着'把过程信号做得更细'的惯性走,而是反过来追问一个更基本的问题:过程监督信号到底需要多细(how fine-grained does a process signal really need to be)?目标是设计一种不需要训练专门奖励模型、不要求师生同分布、能跨模型跨任务通用的过程监督,同时完整保留 RLVR/GRPO 的简单形式。具体做法是:用现成的 LLM 教师为每条学生 rollout 定位'第一个错误'的位置(Pitfall Step,记作 $p(a)$),把 rollout 天然分解为正确前缀(correct prefix)和错误后缀(incorrect suffix)两段,再把这一二元结构转换成 GRPO 框架下的 token 级优势——前缀获得相对更高的优势,后缀像 GRPO 一样接受负反馈。验证目标是在数学推理和算法代码两个域、2 个学生模型(Qwen3-4B、Phi-4-Mini)乘 3 种教师(闭源 SOTA、Qwen3-32B、Gemma3-27B)共 12 个场景中取得一致超越 GRPO、蒸馏和 OPD 的表现。
与已有工作不同的是,独特的切入角度来自形式逻辑中的'空洞蕴含'(Vacuous Implication):当前件 $A$ 为假时,蕴含式 $A \to B$ 无论 $B$ 取值如何都恒为真。类比到推理链:一旦推理在某个位置首次出错,后续所有内容都已经条件化于一个无效前缀,继续精细评估它们能提供的额外信息非常有限。由此得到一条极简的设计原则:我们只需要找到推理第一次出错的位置,而不必精确评估之后的一切。这与 PRM 的'每步打分'和 OPD 的'逐 token 蒸馏'形成鲜明对照——Cliff 是一种'最粗但足够'的过程监督,每条 rollout 只切一刀。作者还论证该设计天然抗奖励黑客:奖励由第一个错误的位置决定,把错误推迟总是优于早犯同样错误,而完全正确的 rollout 按定义仍是全局最优,策略无法通过表面动作(如拉长输出)获得超过真解的奖励。
核心方法
直觉上一条失败的推理链并非一无是处:出错之前的部分往往是对的,这些 token 不应该和错误部分一起被同等惩罚,否则模型学不到'哪些推理步骤是可靠的'。技术路线上,Cliff 是 GRPO 的一个纯奖励塑形扩展。先回忆 GRPO:对每个 query 采样 $N$ 条 rollout,二值奖励下组内优势只有两个值——正确 rollout 全体共享 $A^{cor} = \frac{1-\mu}{\sigma}$,错误 rollout 全体共享 $A^{inc} = \frac{0-\mu}{\sigma}$,其中 $\mu$ 是组内平均奖励、$\sigma = \sqrt{\mu(1-\mu)}$(式 3)。Cliff 在此之上加一个教师评判环节,分两步改造这个信号:第一步(Pitfall 识别),教师先独立解题,用自动验证器验证其参考解,仅保留教师解正确的组(否则回退 vanilla GRPO,因为教师自身都做错时其指导不可靠);第二步(优势分配),教师对照参考解逐步审查学生 rollout,判断正误并输出第一个错误句的索引 $p(a)$。拿到 $p(a)$ 后按式 (4) 给错误 rollout 的前缀和后缀分配不同优势,并用偏移项 $b$ 重新中心化,保证组内 token 级优势均值为零(与 GRPO 的无偏基线性质对齐)。
核心创新是'单一分割点的过程监督'(只切一刀),与已有方法的本质区别有三。其一,相比 PRM 需要训练专门奖励模型并对每步打分,Cliff 把过程信号压缩到一个标量位置 $p(a)$:任何具备'自己能解题 + 能对照参考解找茬'能力的 LLM 都可以直接当教师,包括闭源 API 模型,无需任何奖励模型训练管线。其二,相比 OPD 要求教师对学生的 token 逐个给出分布(因此必须同 tokenizer、推理模式同家族),Cliff 的信号只依赖'推理进行到某一点时是否仍然正确'这一事实判断,与教师的表述方式、符号习惯完全无关,因此是模型无关、任务无关的。其三,相比 GRPO 整条 rollout 一个分数,Cliff 以近乎零的额外标注结构(一个句索引)区分了'有效推理'与'首次失效点',把结果级信号升级为过程级信号。抗黑客性也是设计出来而非碰运气:错误前缀的正向强度由 $\lambda$ 控制,$\lambda = 0$ 时延长正确前缀不会带来超额奖励,附录 C 用'长度质量'分析证明 $\lambda = 0$ 消除了纯靠变长获益的可能。
方法步骤详情
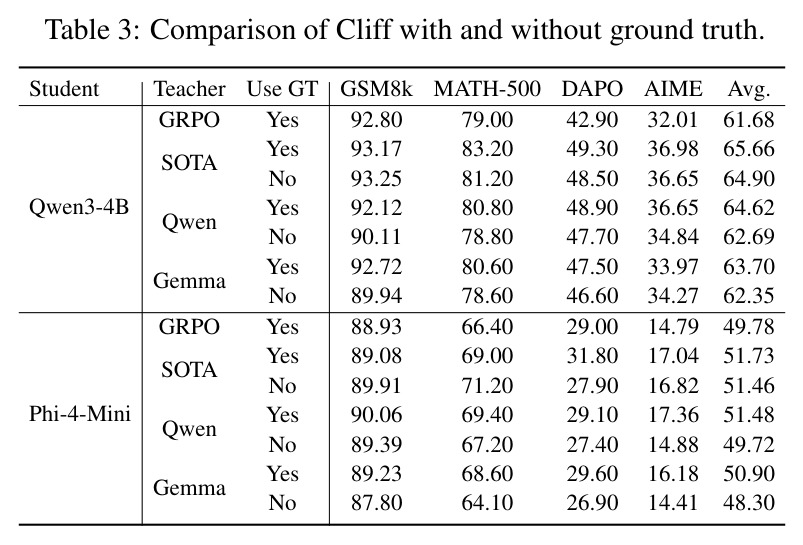
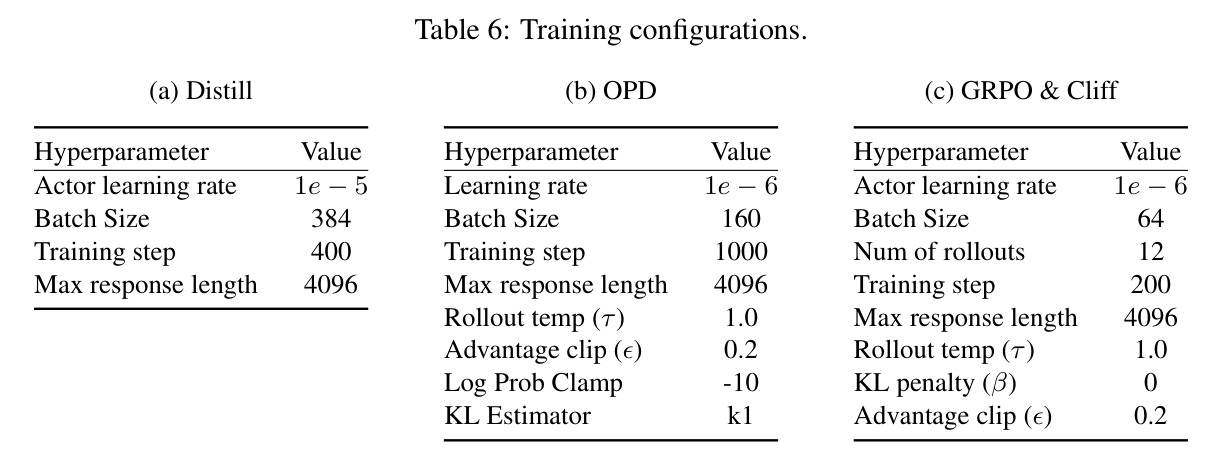
完整流程分三步。第一步,教师解题与过滤:教师以温度 0.6 独立生成参考解,自动验证器判定其正误;只有参考解被验证正确的 query 组才启用 Cliff,其余组回退 vanilla GRPO。这一过滤的作用在 Table 3 得到量化——弱教师(Qwen3-32B、Gemma3-27B)去掉过滤后性能下降约 2%,而前沿教师几乎不受影响。第二步,教师评判:把学生 rollout 按句切分为 $[0], [1], \dots$ 编号句子,连同题目和已验证的参考解交给教师;教师按精心设计的提示词输出三段式回答,最终给出 JSON 格式的 correctness 与 first mistake id。提示词的关键规则包括:最终答案与参考一致时除非存在无可辩驳的致命错误否则判对;不惩罚不同但正确的解法、代数等价改写、后来被纠正的失败尝试;推理卡死或复读退化为 gibberish 也算 pitfall;超长截断的 rollout 直接置 $p(a) = 0$、整条视为错误(既省算力也是防长度黑客的必要保障)。为节省算力,验证器判为全对或全错(奖励零方差)的组跳过教师评判。第三步,优势分配:按式 (4),$A_{i,j} = A^{cor} - b$(正确 rollout 的所有 token);$A_{i,j} = \lambda A^{cor} - b$(错误 rollout 中 $j < p(a_i)$ 的正确前缀);$A_{i,j} = A^{inc} - b$(错误 rollout 中 $j \ge p(a_i)$ 的错误后缀)。偏移 $b$ 由式 (5) 计算,等于重中心化前的 token 级优势均值,确保组内优势均值为零。主实验取 $\lambda = 0$。训练基于 veRL:batch 64、每 query 12 条 rollout、200 步、最大长度 4096、4 张 H100 80GB 或 B200 192GB。
技术新颖性
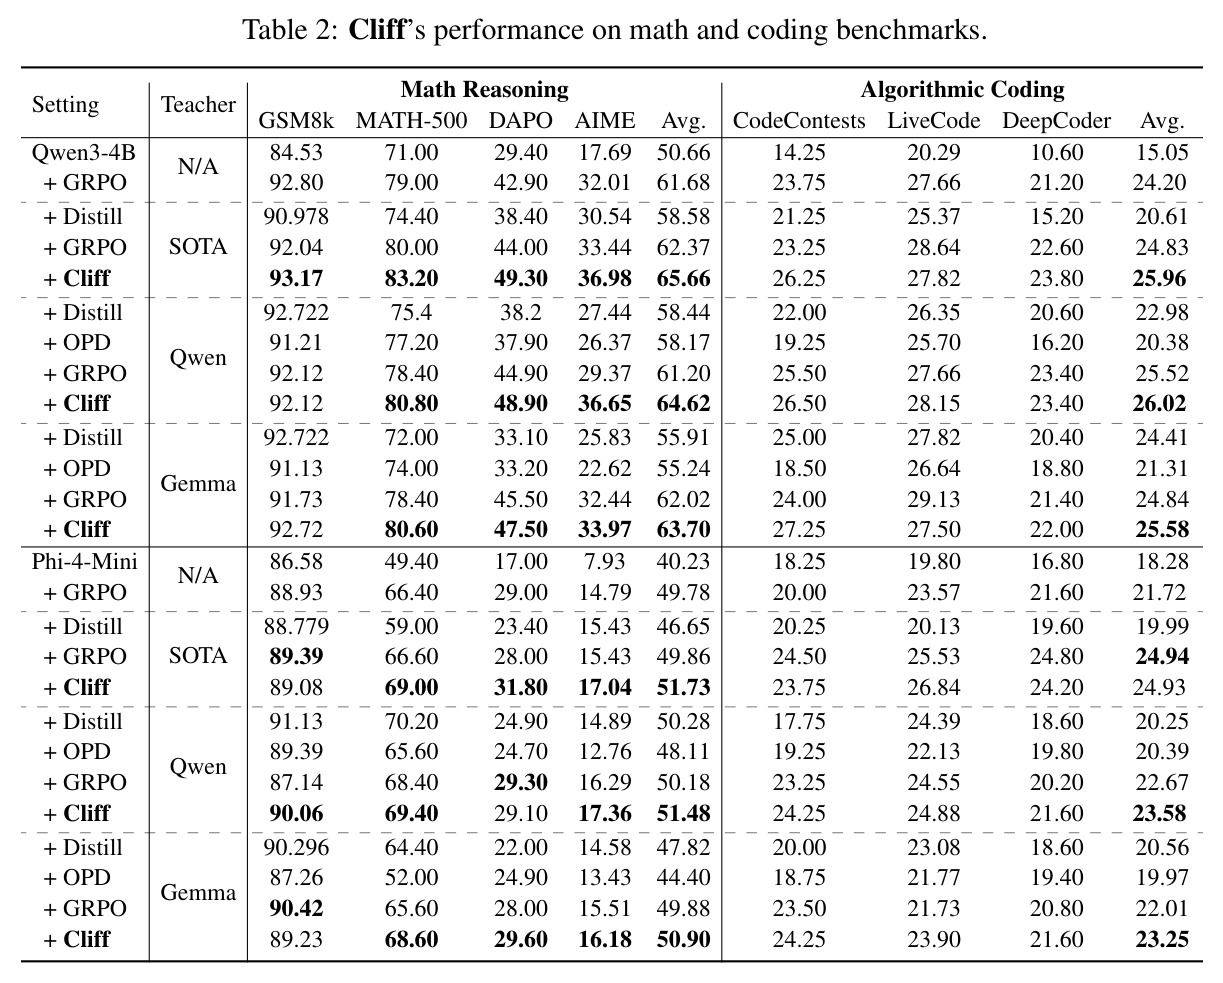
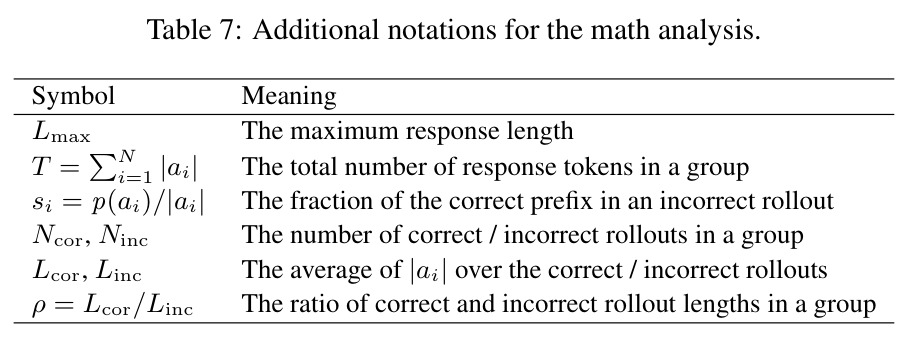
技术新颖性可从四个层面评估。概念层面:论文把过程监督重新表述为'找第一个错误',用空洞蕴含的逻辑直觉论证了粗粒度信号的价值下限,并显式回答了'过程信号需要多细'这一被大量增量工作忽视的基本问题——答案是不需要逐步、更不需要逐 token,一个分割点就够。方法层面:零新增训练模块——PRM 需要奖励模型训练数据和管线,OPD 需要教师 logits 访问权与 tokenizer 兼容性,Cliff 只需要一个会解题会挑错的现成 LLM,且 Table 2 显示开源教师(Qwen3-32B、Gemma3-27B)与闭源 SOTA 教师带来的学生性能差距很小(数学 64.62/63.70 vs 65.66),说明方法不依赖前沿模型。理论层面:附录 C 定义组级'长度质量' $\Phi = \sum_i A_i |a_i|$,证明 GRPO 的 $\Phi$ 与 $\rho = L^{cor}/L^{inc} - 1$ 同号(GRPO 只是放大样本自身的正确-长度相关性,无从 hack),而 Cliff 的长度化条件变为 $\rho > 1 - \bar{s}(1 + \lambda\frac{1-\mu}{\mu})$,比 GRPO 更宽松且随 $\lambda$ 增大更宽松,由此给出 $\lambda = 0$ 与超长截断的原则性依据。实证层面:'GRPO with Teacher' 消融干净地分离出'引入教师'与'两段信用分配'各自的贡献,证明增益来自后者。
实验结果
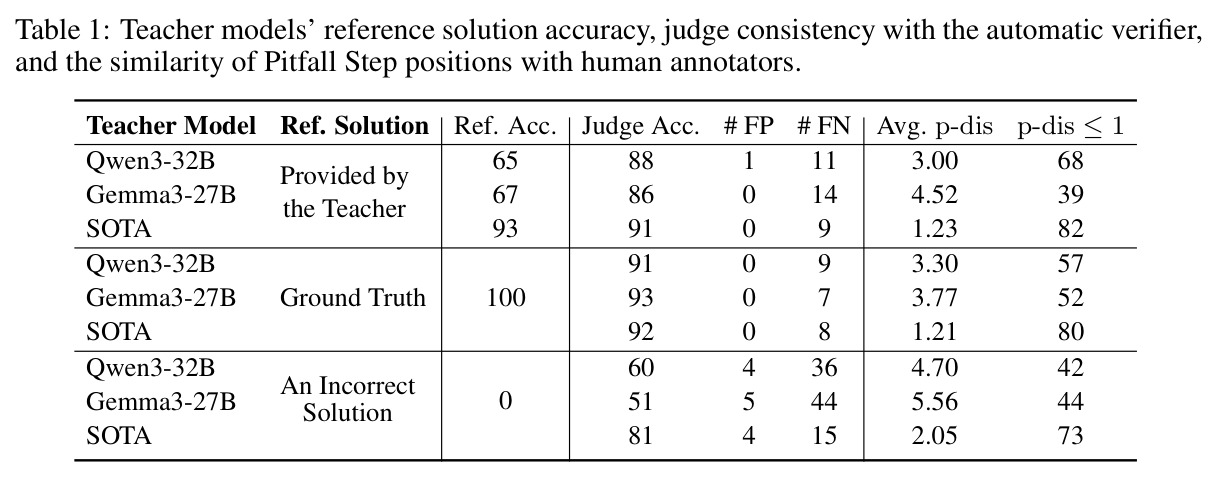
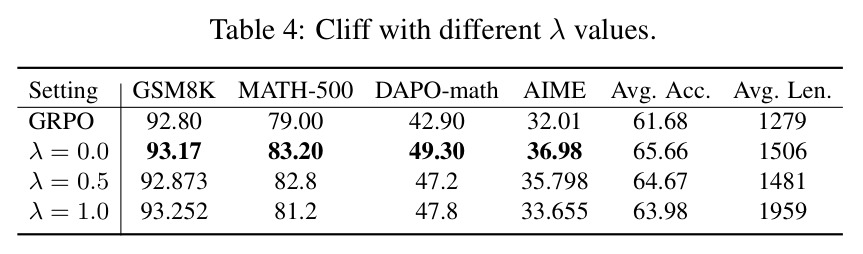
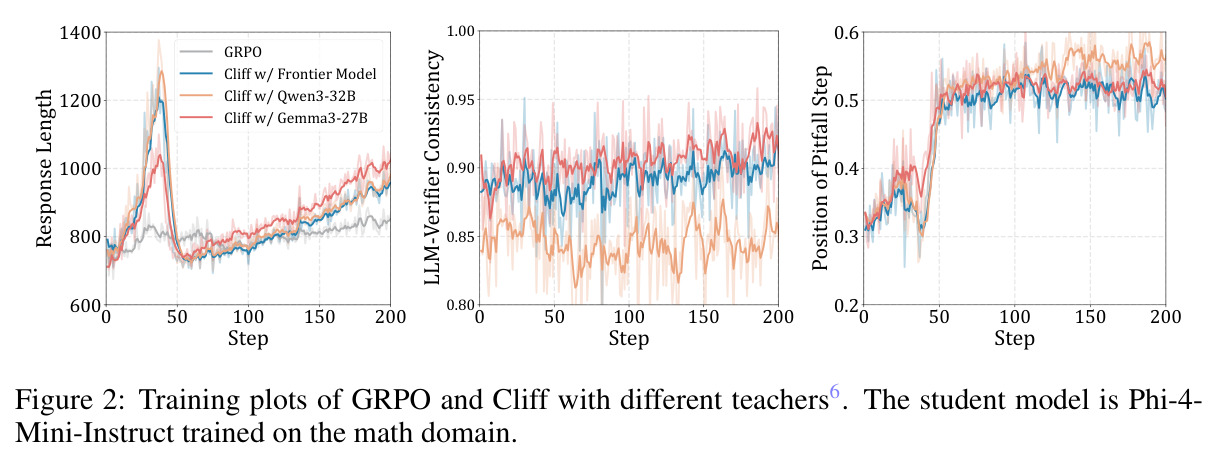
主结果覆盖 12 个场景(Table 2)。以 Qwen3-4B 为例:SFT 起点(OpenThoughts 上热身)数学四基准平均 50.66(GSM8k 84.53 / MATH-500 71.00 / DAPO 29.40 / AIME 17.69),代码三基准平均 15.05;GRPO 将其提到数学 61.68、代码 24.20。Cliff 在全部设置下第一:SOTA 教师 + Cliff 达数学 65.66(GSM8k 93.17 / MATH-500 83.20 / DAPO 49.30 / AIME 36.98)、代码 25.96;Qwen3-32B 教师 + Cliff 达数学 64.62、代码 26.02(代码上甚至超过 SOTA 教师的 25.96);Gemma3-27B 教师 + Cliff 达数学 63.70、代码 25.58。对比蒸馏(SOTA 教师数学 58.58、代码 20.61)和 OPD(Qwen 教师 58.17/20.38,Gemma 教师 55.24/21.31),Cliff 平均比 OPD 高 15%、比标准 GRPO 高 7%,且开源教师的 Cliff 仍普遍胜过无教师的 GRPO。Phi-4-Mini 上趋势一致:GRPO 数学 49.78 → SOTA Cliff 51.73,代码 21.72 → 24.93。'GRPO with Teacher' 消融(教师判对错但整条 rollout 同一优势)只把数学从 61.68 提到 62.37,远小于 Cliff 的 65.66,证明增益来自两段信用分配而非引入教师本身。评判质量(Table 1):提供已验证参考解时,SOTA/Qwen3-32B/Gemma3-27B 的判断准确率为 92%/91%/93%,与人类标注的 Pitfall 位置平均差 p-dis 为 1.21/3.30/3.77 句;值得注意的是判断比解题容易——Qwen3-32B 自己解题只有 65% 准确率,判断学生正误却有 88%。消融与动态:去掉 GT 过滤(Table 3),SOTA 教师 65.66 → 64.90 几乎无损,弱教师掉约 2%;$\lambda$ 消融(Table 4)中 $\lambda = 0/0.5/1.0$ 数学平均 65.66/64.67/63.98,$\lambda = 1.0$ 平均生成长度从 1506 暴涨到 1959,验证长度黑客;训练动态(Figure 2)显示教师与验证器一致性维持 85–90%,错误 rollout 的有效前缀占比在约 50 步内升至 0.5 后稳定,说明模型学到的是更长的正确推理而非对教师的 hack。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 数学推理(Qwen3-4B 学生,SOTA 教师) | GSM8k/MATH-500/DAPO/AIME 四基准平均准确率 | Cliff 65.66(93.17 / 83.20 / 49.30 / 36.98) | GRPO 61.68(92.80 / 79.00 / 42.90 / 32.01) | +3.98 点(相对约 +7%) |
| 数学推理(Qwen3-4B 学生,Qwen3-32B 教师) | 四基准平均准确率,对比在线策略蒸馏 | Cliff 64.62 | OPD 58.17(Gemma 教师为 55.24) | +6.45 点(相对约 +15%) |
| 算法代码(Qwen3-4B 学生,Qwen3-32B 教师) | CodeContests/LiveCode/DeepCoder 三基准平均通过率(全测试通过得 1 分) | Cliff 26.02(26.50 / 28.15 / 23.40) | GRPO 25.52;OPD 21.31 | 对 GRPO +0.50,对 OPD +4.71 |
| Pitfall Step 定位质量(50 条人工标注错误 rollout,GT 参考解) | 判断准确率;与人类的平均位置差 p-dis;p-dis≤1 占比 | SOTA 教师:92%,1.21 句,80%;Qwen3-32B:91%,3.30 句,57% | Gemma3-27B:93%,3.77 句,52% | SOTA 教师定位精度最优(论文 Table 1 内部对比) |
| 教师消融(Qwen3-4B,数学) | 教师判对错但不分段(GRPO with Teacher)vs Cliff 分段优势 | Cliff(SOTA 教师)65.66;Cliff(Qwen 教师)64.62 | GRPO with Teacher(SOTA)62.37;GRPO with Teacher(Qwen)61.20 | +3.29 / +3.42,证明增益来自两段信用分配本身 |
局限与改进
作者承认的局限:假阴性为主——教师很少冤枉正确解(50 条中 FP 仅 0–1 个),但约 10–15% 的错误解被漏判为正确(FN 7–14 个),部分源于自动验证器本身会放过蒙对答案或有缺陷推理的解;开源教师的错误定位精度有限,Gemma3-27B 的 p-dis≤1 仅 39–52%、平均偏差 3.3–4.5 句;弱教师依赖 GT 参考解过滤,去掉后掉约 2%;$\lambda$ 设置敏感,$\lambda = 1.0$ 触发长度黑客(平均长度 1506 → 1959,准确率降 1.68 点);训练中教师判断与验证器存在 10–15% 的分歧。我自己的观察:其一,教师评判是训练期的额外推理开销,每个混合对错的组要对 12 条 rollout 各调一次教师,论文虽提到跳过全对/全错组,但未报告总成本与 GRPO 的比值或 API 延迟;其二,Case 3 暴露系统性'过严'偏差——教师把'不充分但不算错'的陈述(周期 20 的正确命题)判为首个错误,而人类专家认为真正的错误在结尾,这类偏差会持续惩罚探索性推理;其三,实验只覆盖有唯一答案的数学题和单轮代码生成,开放式任务或长程 agentic 任务中'第一个错误'的定义本身就模糊;其四,句级切分既是实现手段也是约束,教师按句子索引定位,长代码块或连续公式推导中定位噪声会直接转化为错误的 token 级优势;其五,$\lambda = 0$ 意味着错误 rollout 的正确前缀并无正向奖励,只是比后缀'少负一些'($-b$ vs $A^{inc} - b$),与'奖励正确推理'的直觉仍有距离。
独立分析的弱点
弱点一:教师评判的训练期开销与可扩展性。训练中每个奖励非零方差的组需要 12 次教师推理,使用闭源 SOTA 教师时 API 费用与延迟可观,且论文未量化该开销。改进方向:用 Cliff 训练过程中积累的(rollout, $p(a)$)判断对训练一个轻量错误定位器,早期用强教师冷启动、后期切换到本地小判断器。弱点二:开源小教师的定位精度不足(Gemma3-27B 的 p-dis≤1 仅 39%),而 $p(a)$ 的偏差会直接、逐 token 地转化为错误的信用分配,且训练中没有独立指标监测这种偏差。改进方向:同一 rollout 让教师自一致性采样 k 次取多数 $p(a)$,或多教师投票,用判断一致性作为置信度对前缀优势加权。弱点三:非二值奖励被强行二值化。代码域只有全测试通过才得 1 分,部分通过的中间信息被丢弃;论文脚注建议阈值化或组内比较,但未实验。改进方向:保留 $p(a)$ 切分,再在后缀内部按测试通过率做连续缩放。弱点四:对教师系统性偏差(过严/过松)敏感且不可在线检测,只有教师-验证器一致性这一个间接代理指标。改进方向:定期抽样人工审计,或与现成 PRM(如 ProcessBench 上的模型)交叉验证检测漂移。弱点五:agentic 场景未验证——多轮工具调用轨迹中的'第一个错误'可能是不当的工具调用行为而非文本推理错误,纯文本评审式教师未必能定位。改进方向:结合环境反馈与轨迹回放来定义行为级 pitfall。
未来方向
作者明确提出的方向有二:一是扩展到 agentic 设置,在多轮、含工具调用的轨迹中定位第一个错误并做分段信用分配;二是探索规则式(rule-based)Pitfall Step 检测器,摆脱对 LLM 教师推理的依赖,降低评判成本。基于本文成果可以自然延伸的方向:其一,把 Cliff 运行中积累的教师判断数据用于蒸馏训练专用过程判断器,形成'强教师冷启动 → 轻量判断器自举'的闭环,这同时回应了成本与可扩展性两个问题;其二,多教师集成与置信度加权以压缩开源教师的 p-dis 差距(Gemma3-27B 的 p-dis≤1 仅 52%);其三,与 PRM 融合成层级监督——先按 $p(a)$ 切一刀,再在前后缀内部用轻量 PRM 细打分,兼顾 Cliff 的抗黑客性与 PRM 的细粒度;其四,把式 (3)、(4) 从二值奖励推广到连续奖励域,适配偏好对齐等不可验证任务;其五,附录 C 的长度动态分析假设特定损失聚合方式,可推广到 DAPO 的 token 级聚合及其他变体,给出更一般的 $\lambda$ 选择准则;其六,检验'只对高分歧题目启用教师'的课程式调度,进一步压低评判开销。
复现评估
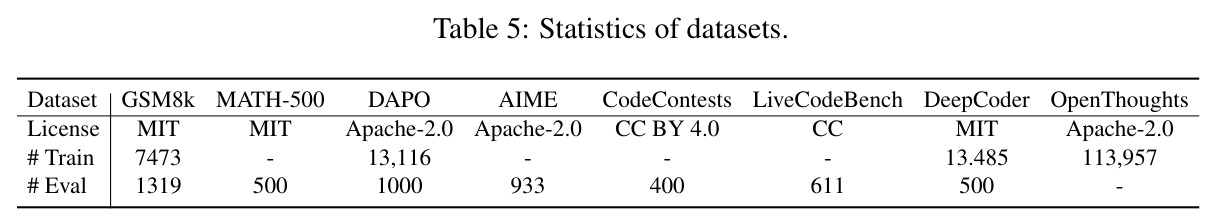
复现难度中低,透明度较高,但论文未提及官方代码开源。有利因素:方法本身极简——在 veRL 框架的 GRPO 训练循环中插入一个教师评判模块即可,无需训练奖励模型或搭建蒸馏管线;附录 D 完整公开了数学域和代码域的系统提示词(含'只标记第一个真实错误''不惩罚不同但正确的解法'等全部规则)以及三段式 JSON 输出格式;Table 6 给出全部训练超参(actor lr $10^{-6}$、batch 64、rollout 12 条、200 步、温度 1.0、clip $\epsilon = 0.2$、KL $\beta = 0$;Cliff 特有的 $\lambda = 0$ 与教师 rollout 温度 0.6),关键工程细节(跳过全对/全错组、超长 rollout 置 $p(a) = 0$)均有说明;所用数据集全部公开且许可明确(DAPO-math-17k-processed、DeepCoder、OpenThoughts、GSM8k、MATH-500 等,见表 5)。算力需求为 4 张 H100 80GB 或 B200 192GB、200 步训练,属学术实验室可负担的规模;最大变数是教师模型——闭源 SOTA 教师需要持续的 API 预算,开源替代(Qwen3-32B、Gemma3-27B)需要额外推理显存但效果只低 1–2 点。注意事项:作者发现 vLLM 在 H100 与 B200 上对 Phi-4-mini 行为不一致,故 Phi-4-mini 实验固定用 H100;100 条人工标注的评判校准集未说明是否发布,复现 Table 1 的评判质量需要自建小规模标注(按论文描述约数百条 rollout 的人工工作量)。
论文图表