Transformer 过早停止思考:一个微型 LoRA 即可修复 Transformers Stop Thinking Too Early, and a Tiny LoRA Fixes It
冻结模型只能跟随1.4–3.6行引用链,单层rank-8 LoRA启动中继将其扩展到50–160行
前置知识
LoRA 与低秩表示干预
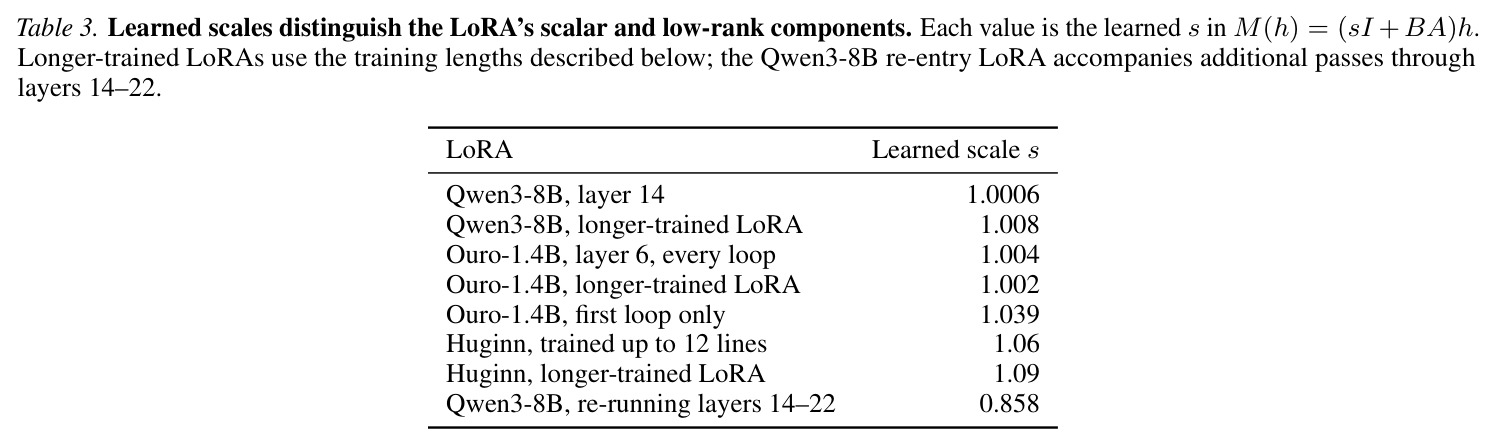
LoRA 是参数高效微调方法:冻结原模型权重,只在指定位置加一个低秩增量。本文用的是作用在残差流上的特殊形式 $h \leftarrow M(h) = sh + BAh$,其中 $A\in\mathbb{R}^{8\times n}$、$B\in\mathbb{R}^{n\times 8}$ 为可训练矩阵,$s$ 是接近 1 的可训练标量(如 Qwen 上 1.0006),即 ReFT 论文中的 DiReFT 式表示干预。秩为 8 意味着只新增一个 8 维子空间的改动,Qwen3-8B 上仅 65,537 个参数,不到模型参数的 0.01%。它独立作用于每个 token,所有 token 间通信仍由冻结的注意力与 MLP 完成。
论文标题里的"修复"就是单层 rank-8 LoRA;理解它的数学形式($sI+BA$)、训练目标(答案交叉熵 + WikiText-103 上 $KL(p_0\|p_M)$ 正则)和极小参数量,是理解"为什么这么小的改动就够"这一核心问题的前提。
残差流与中间层
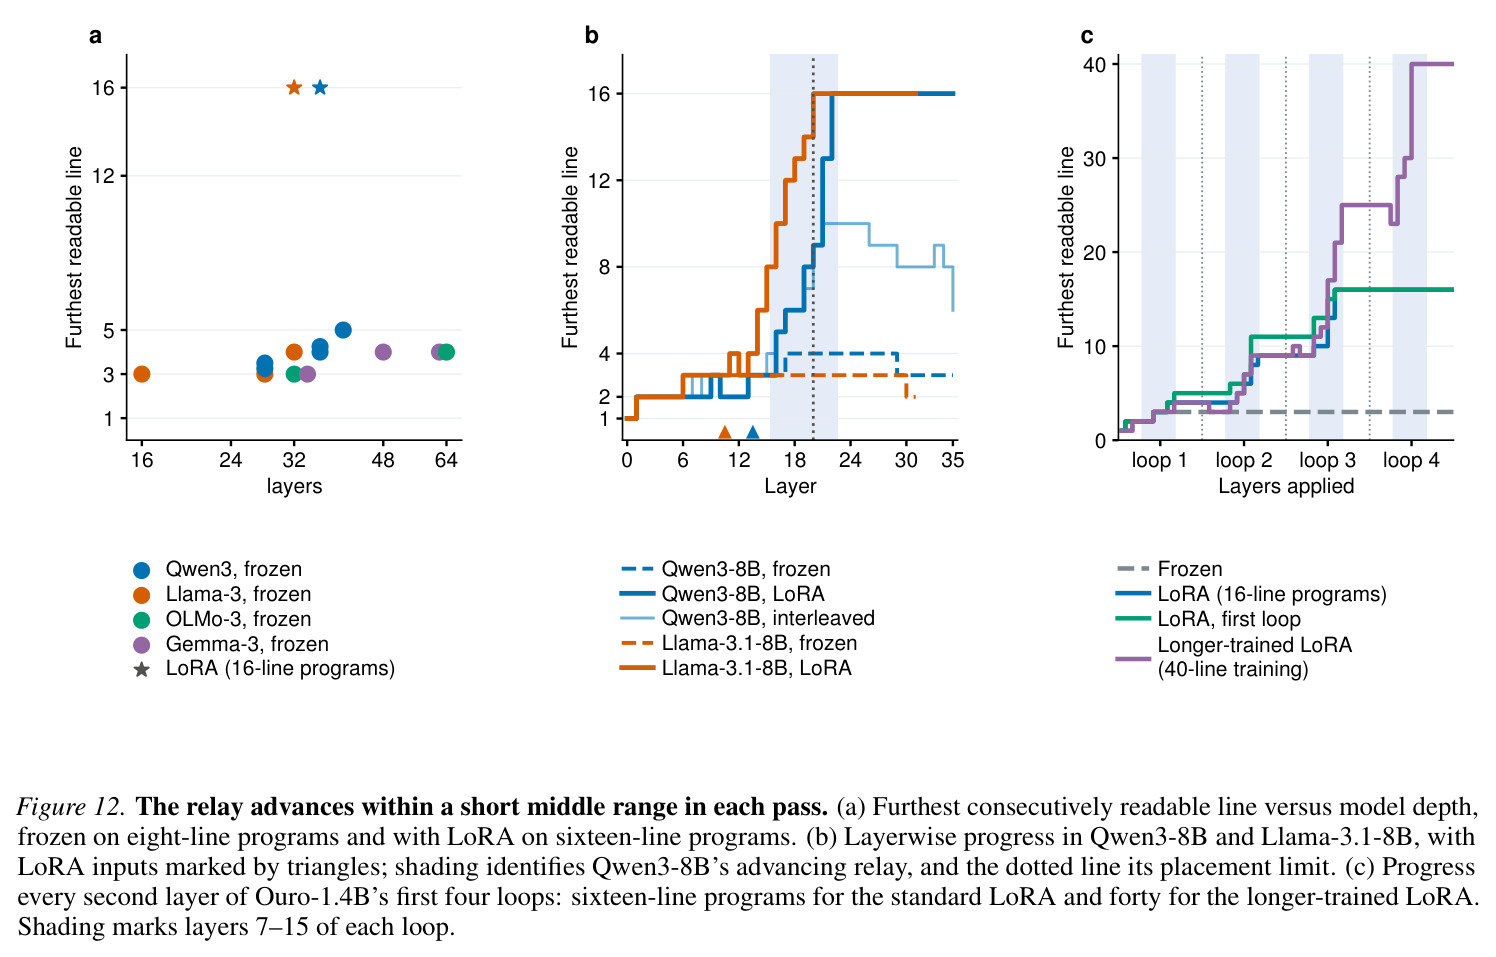
Transformer 每层的输入输出都叠加在一条共享的残差流 $h$ 上,任意两层之间都可以直接读写信息。本文的 LoRA 加在某一层的输入处(如 Qwen3-8B 的第 14 层,共 36 层),"中间层"指约 40%–60% 深度处的层带。所谓"中继(relay)"就是链身份信息在程序行 token 的残差流里、沿这一层带逐层向前推进的过程,Qwen 上发生在 16–22 层,Ouro 上发生在每个循环的 7–15 层。
论文的三个关键问题——干预放在哪一层、放置上限为何存在、中继在哪些层推进——都需要以残差流的层间读写视角来理解;"最后一层有效输入层"(放置上限)是全文最具实用价值的结论之一。
因果追踪与激活修补
源自 Meng 等人 ROME 工作的定位技术:构造反事实输入(如把根值名词换掉、或把某个指针重定向到另一条链),再把干净运行的残差状态恢复到反事实运行的位置 $p$、层输入 $\ell$,用归一化恢复效应 $S(p,\ell)=\frac{g(x_{cf};h^{clean}_{p,\ell})-g(x_{cf})}{g(x_{clean})-g(x_{cf})}$ 量化该状态的因果贡献,从而画出根值和指针在层间的传播路径。
几乎所有机制结论都来自这类干预:查询要到第 32 层才拿到根值、指针效应在 7.1±1.4 层的窗口内离开源 token、放置上限(cutoff 层)的定义本身就是一个恢复效应测量。
引用链与实体追踪任务
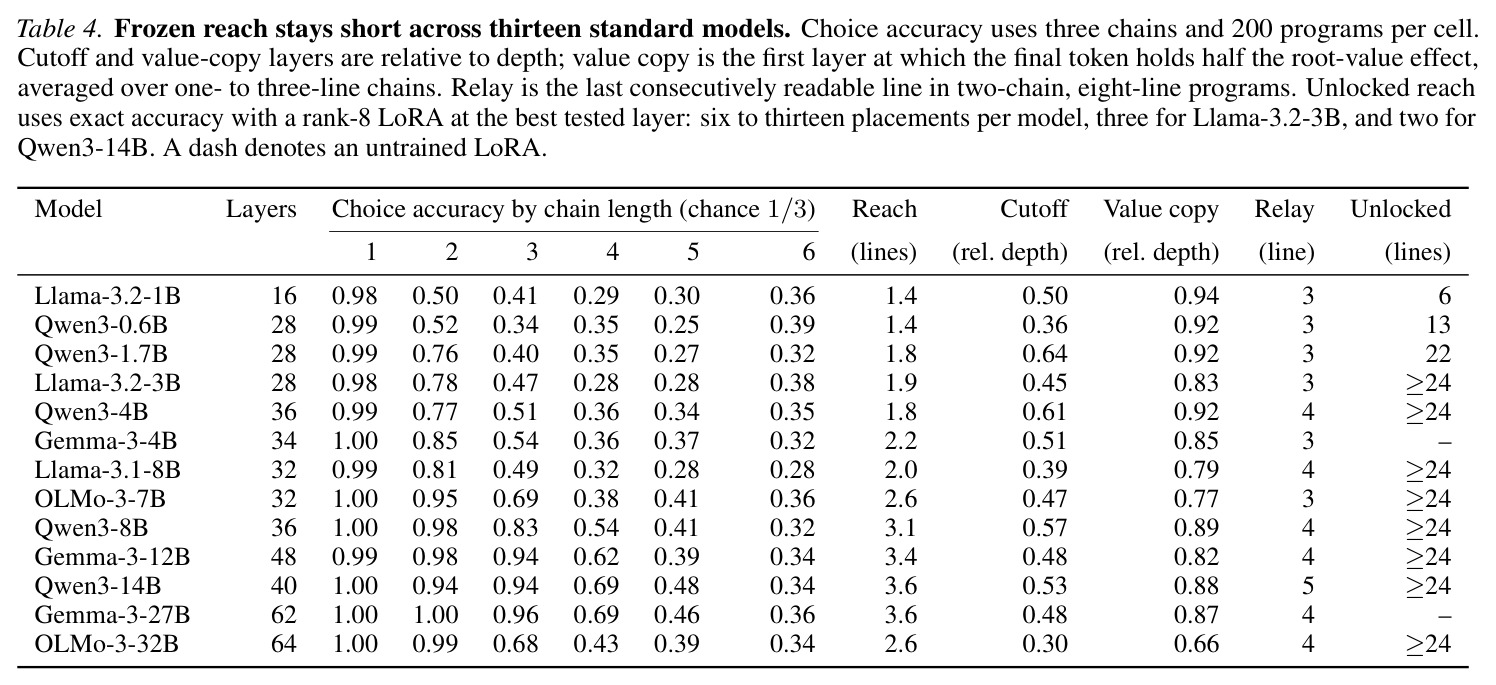
程序式任务:每行形如 $B = K$ 的变量赋值,每条链的根存一个单 token 名词(如 $K = apple$),后续行指向前一个变量,最后查询 $\texttt{print}(D)$ 并要求输出根名词。这模拟了语言模型在上下文中做变量绑定与实体追踪的能力。核心指标 reach 定义为准确率不低于 80% 的最长链长(在首次下穿处线性插值);choice accuracy 只在候选根之间比较,exact accuracy 要求正确根在全词表 logits 排第一。
全文所有实验对象都是这类链:13 个模型的冻结失败、LoRA 的解锁倍数、中继读出、注意力分析和消融实验全部建立在该任务与 reach 指标之上。
循环深度模型(Ouro、Huginn)
把同一段 Transformer 体(权重共享)重复应用多次以换取更多串行计算量的模型。Ouro-1.4B 用 24 层的体循环 4 次训练,Ouro-2.6B 每循环 48 层;Huginn-0125 用 4 层循环核,预训练时平均重复 32 次,且每次递归都重新接收嵌入的提示。理论上循环次数在推理时可以外推,但本文发现冻结状态下额外循环几乎不增加链跟随长度。
论文证明:LoRA 一旦启动中继,这些原本"空转"的循环就变得有用——Ouro-1.4B 在 8 个循环下 reach 达到至少 160 行,这是"计算承载在冻结权重中、缺的只是启动"这一论点最有力的证据。
注意力 knockout 与头消融
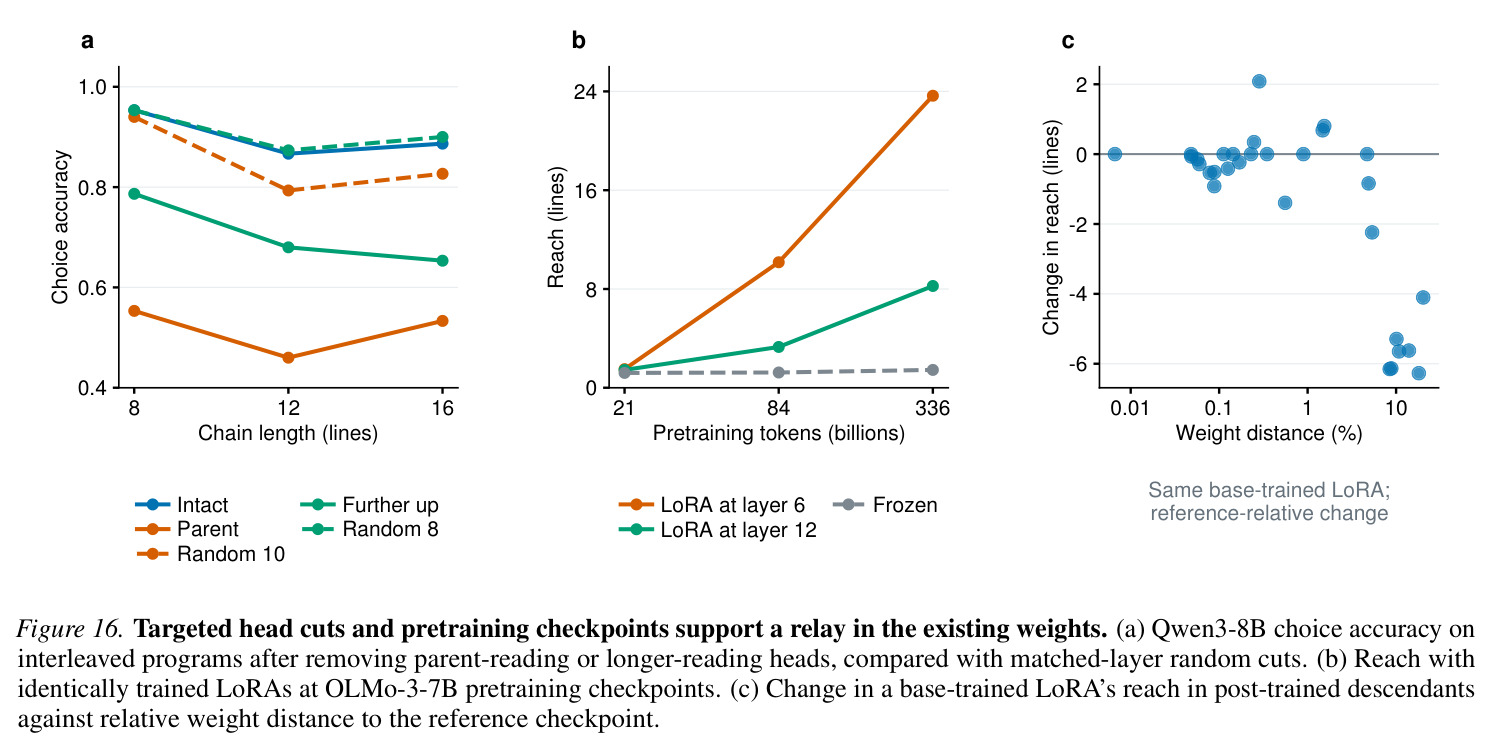
通过切断特定注意力边(如禁止某程序行 attend 到定义其指针变量的"父行")或删除特定注意力头来检验因果必要性。做法分两种:把被禁 key 的权重在 softmax 后置零,或重新归一化剩余注意力权重。对照实验用同层数量的随机头消融做匹配比较,以排除"删掉任何头都会掉点"的解释。
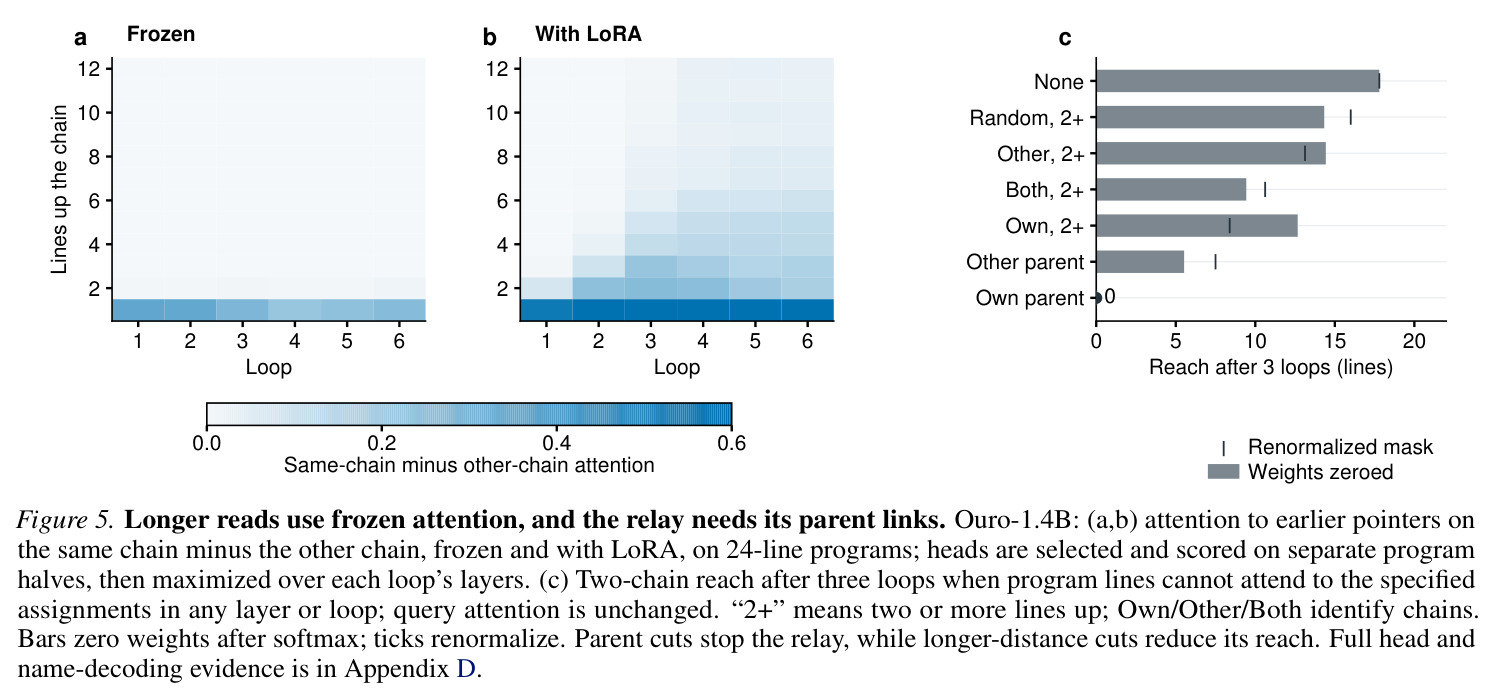
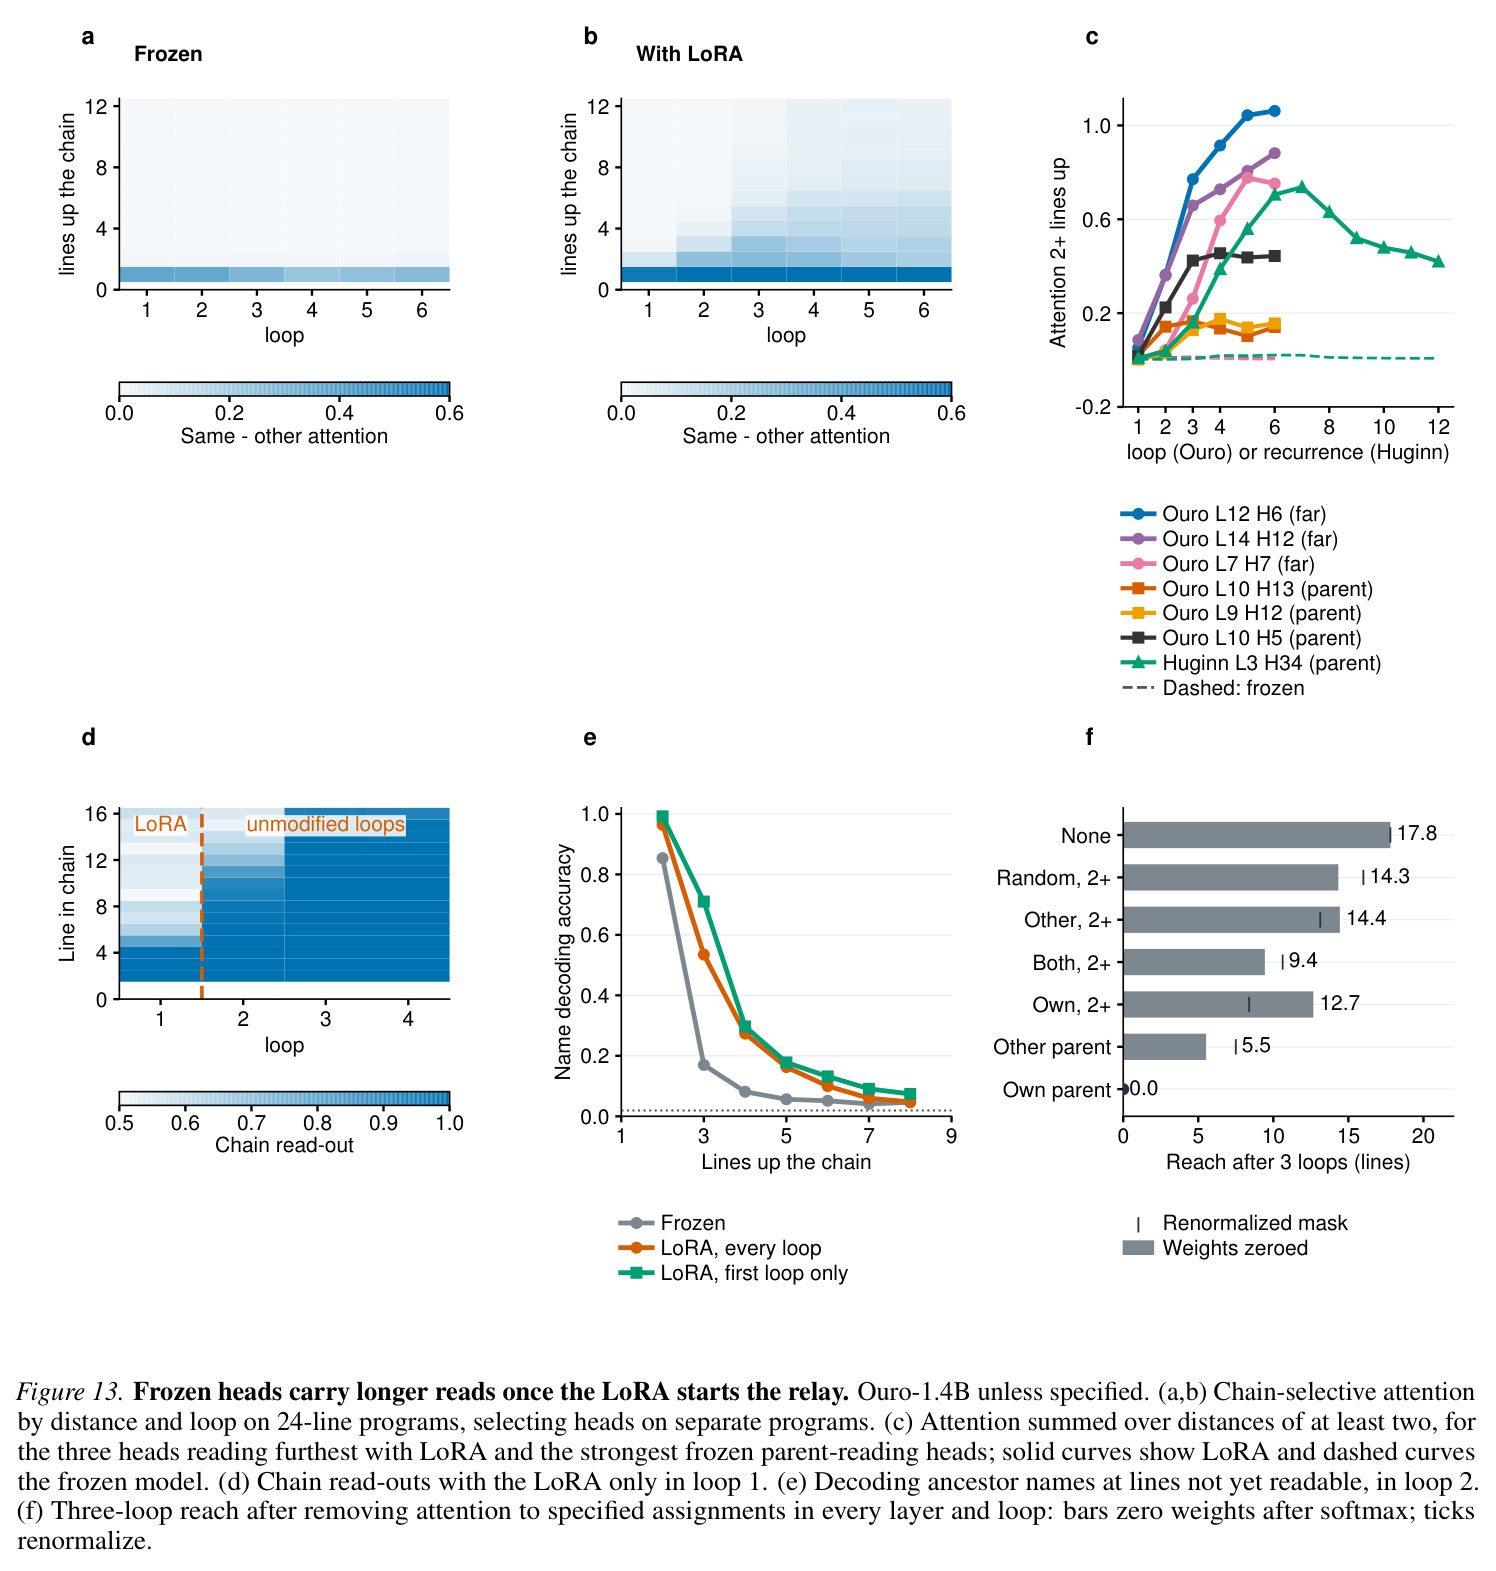
机制章节的核心证据链——父行注意力必要(切断后 Qwen 六/八/十二行链准确率掉回 53%/48%/55% 随机水平)、更长距离的读取贡献增量 reach(17.8→9.4)、特定头承载长读——全部依赖这类消融及其随机对照。
研究动机
预训练 Transformer 在"直接给答案"(不写思维链)设定下几乎不使用自身深度去跟随上下文引用。作者用引用链程序系统测量:13 个基座模型的可靠 reach 只有 1.4–3.6 行(中位数 2.2 行);Qwen3-8B 对三链、三行程序的 choice accuracy 为 83.5%,四行掉到 54%,五行只剩 41.5%(随机水平 33%)。深度似乎无关:OLMo-3-7B 与 64 层的 OLMo-3-32B 都只有约 2.6 行,连 292B MoE 的 DeepSeek-V4-Flash 也只有 4.0 行,六行、八行时准确率 42%、38%,接近 33% 的随机水平。循环深度模型同样如此:Ouro-1.4B 在 1–5 个循环下 reach 为 0、1.6、2.3、2.2、2.2 行,Huginn 在 8/16/32 次递归后只有 1.4–1.6 行,few-shot 示例只修复输出格式。也就是说,加深度、加循环、加示例都无济于事——但已有理论工作表明 Transformer 原理上能实现更长的引用跟随计算,这说明"直接回答失败"严重低估了冻结权重中实际可访问的计算能力。
本文的目标是本文的目标分三层。第一,诊断:在 13 个标准基座模型和两个循环家族(Ouro、Huginn)上,量化模型对上下文引用链的默认计算到底有多短、在哪些层进行、为什么停止。第二,修复并解释:用尽可能小的冻结权重干预解锁更长的链,并因果地回答"为什么不到模型参数 0.01% 的改动(65,537 个参数)就能把 24 行链的 exact accuracy 从 15.5% 提到 99%"——计算究竟被谁承载。第三,前瞻与应用:找到干预放置位置的规律(哪个层还能启动中继),给出可以在冻结模型上提前测量的预测指标并做预注册的 held-out 检验,最后在真实多跳问答基准 MuSiQue 和虚构事实任务上验证"早层适配"原则的实用价值。
与已有工作不同的是,以往研究多把直接回答的多跳失败当作"权重不会组合"的证据,缓解手段是外部化推理(CoT、分解提示)或训练循环模型做每循环一跳的监督。本文的独特切入点是区分"默认前向行为"与"指定干预下可访问的计算":不改变任何注意力/MLP 权重,只在单一残差层加一个表示编辑去"启动"预训练权重里已有的计算,再让冻结层自己把链条走完。方法上它把 LoRA 从"提升任务表现"重新定位为"暴露潜在计算能力的探针",把干预的层位置本身作为研究对象,并用预注册的前瞻性预测实验(在得到任何 held-out 结果之前提交预测协议)检验放置理论——这种可证伪的实验设计在可解释性研究中相当少见。机制上,它给出的图景是渐进扩展注意力的"中继",既不同于归纳头的局部复制,也不同于指针倍增式的跳跃算法。
核心方法
流程可概括为"测量—干预—溯源—放置—迁移"。任务由 $c$ 条链、每链 $d$ 行赋值加一个查询构成:链根存单 token 名词(如 $K=apple$),后续行指向前一变量,答案为被查询链的根。先在三链 choice accuracy(随机 $1/c$)与两链 exact accuracy 下测冻结模型的 reach(80% 准确率首次下穿的链长)。干预是在某一层输入处加 rank-8 残差流 LoRA $h \leftarrow sh + BAh$($A\in\mathbb{R}^{8\times n}$,$B\in\mathbb{R}^{n\times 8}$,$s$ 为接近 1 的可训练标量),只训练 $A,B,s$,目标为答案交叉熵加 WikiText-103 上的 $KL(p_0\|p_M)$ 正则(1,200 步、batch 16、AdamW 学习率 $10^{-3}$),Qwen3-8B 仅 65,537 参数。随后用线性探针读出、恢复效应 $S(p,\ell)$、same-minus-other 注意力、父行 knockout 与头消融对扩展计算做因果溯源;再定义放置上限与冻结 cutoff 预测并做预注册的 held-out 检验;最后把"早层适配"原则迁移到 MuSiQue 与虚构事实多跳问答,比较早层与晚层 LoRA 及 projection LoRA 的增益。
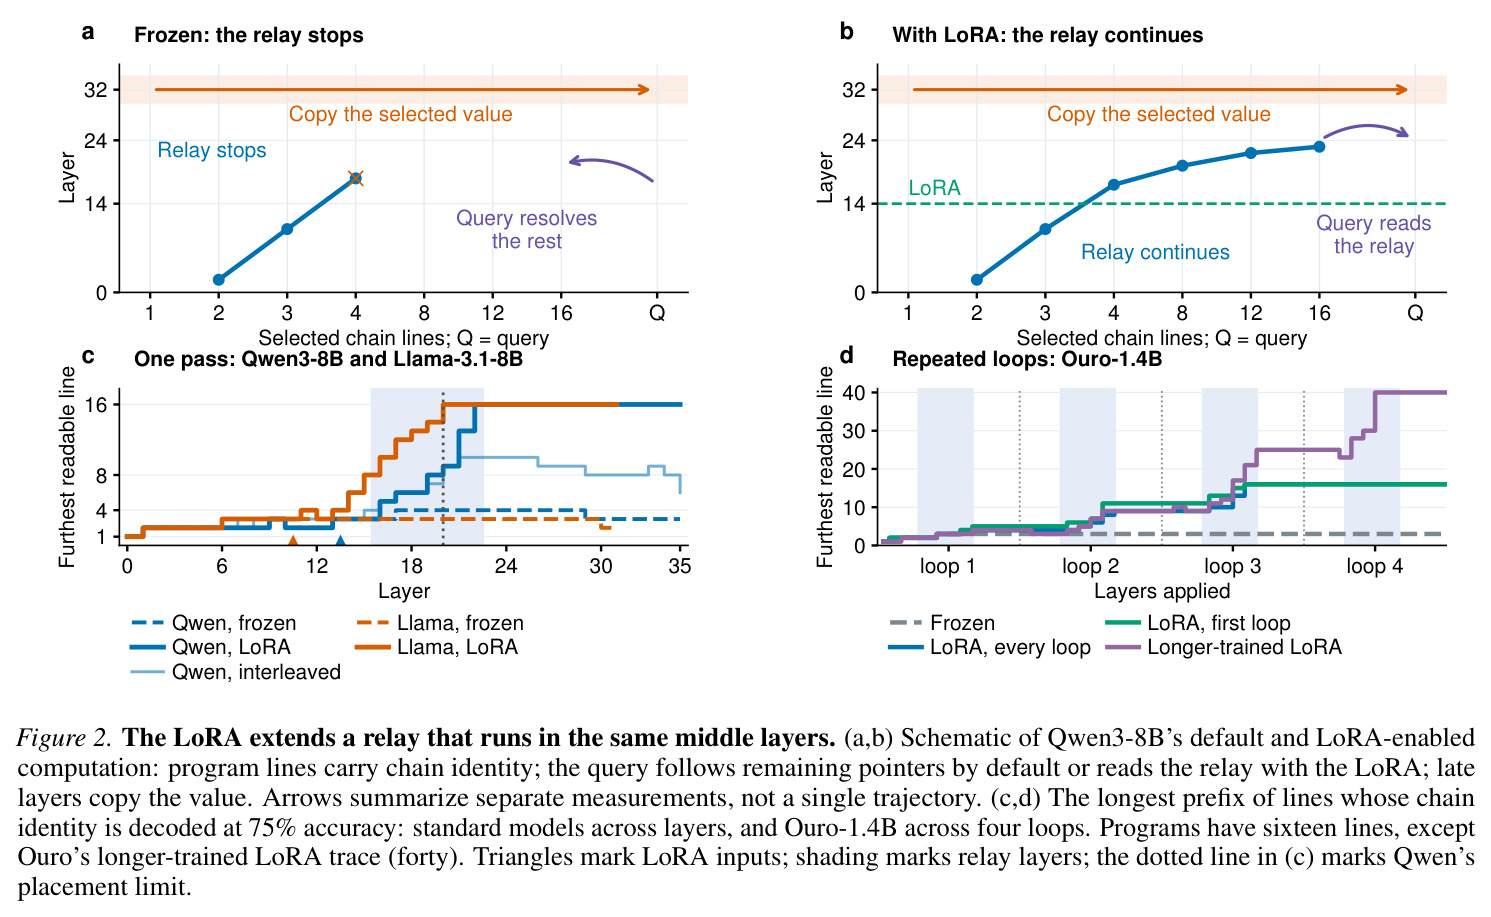
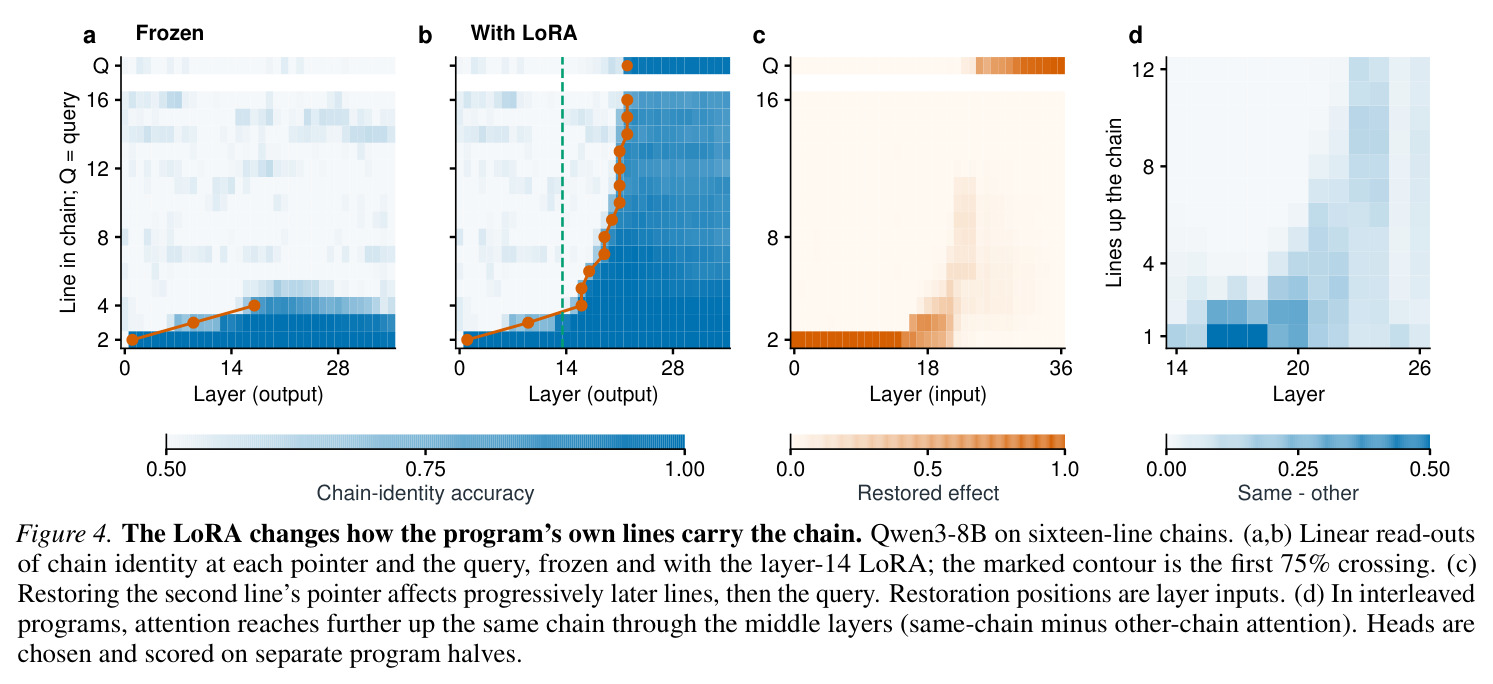
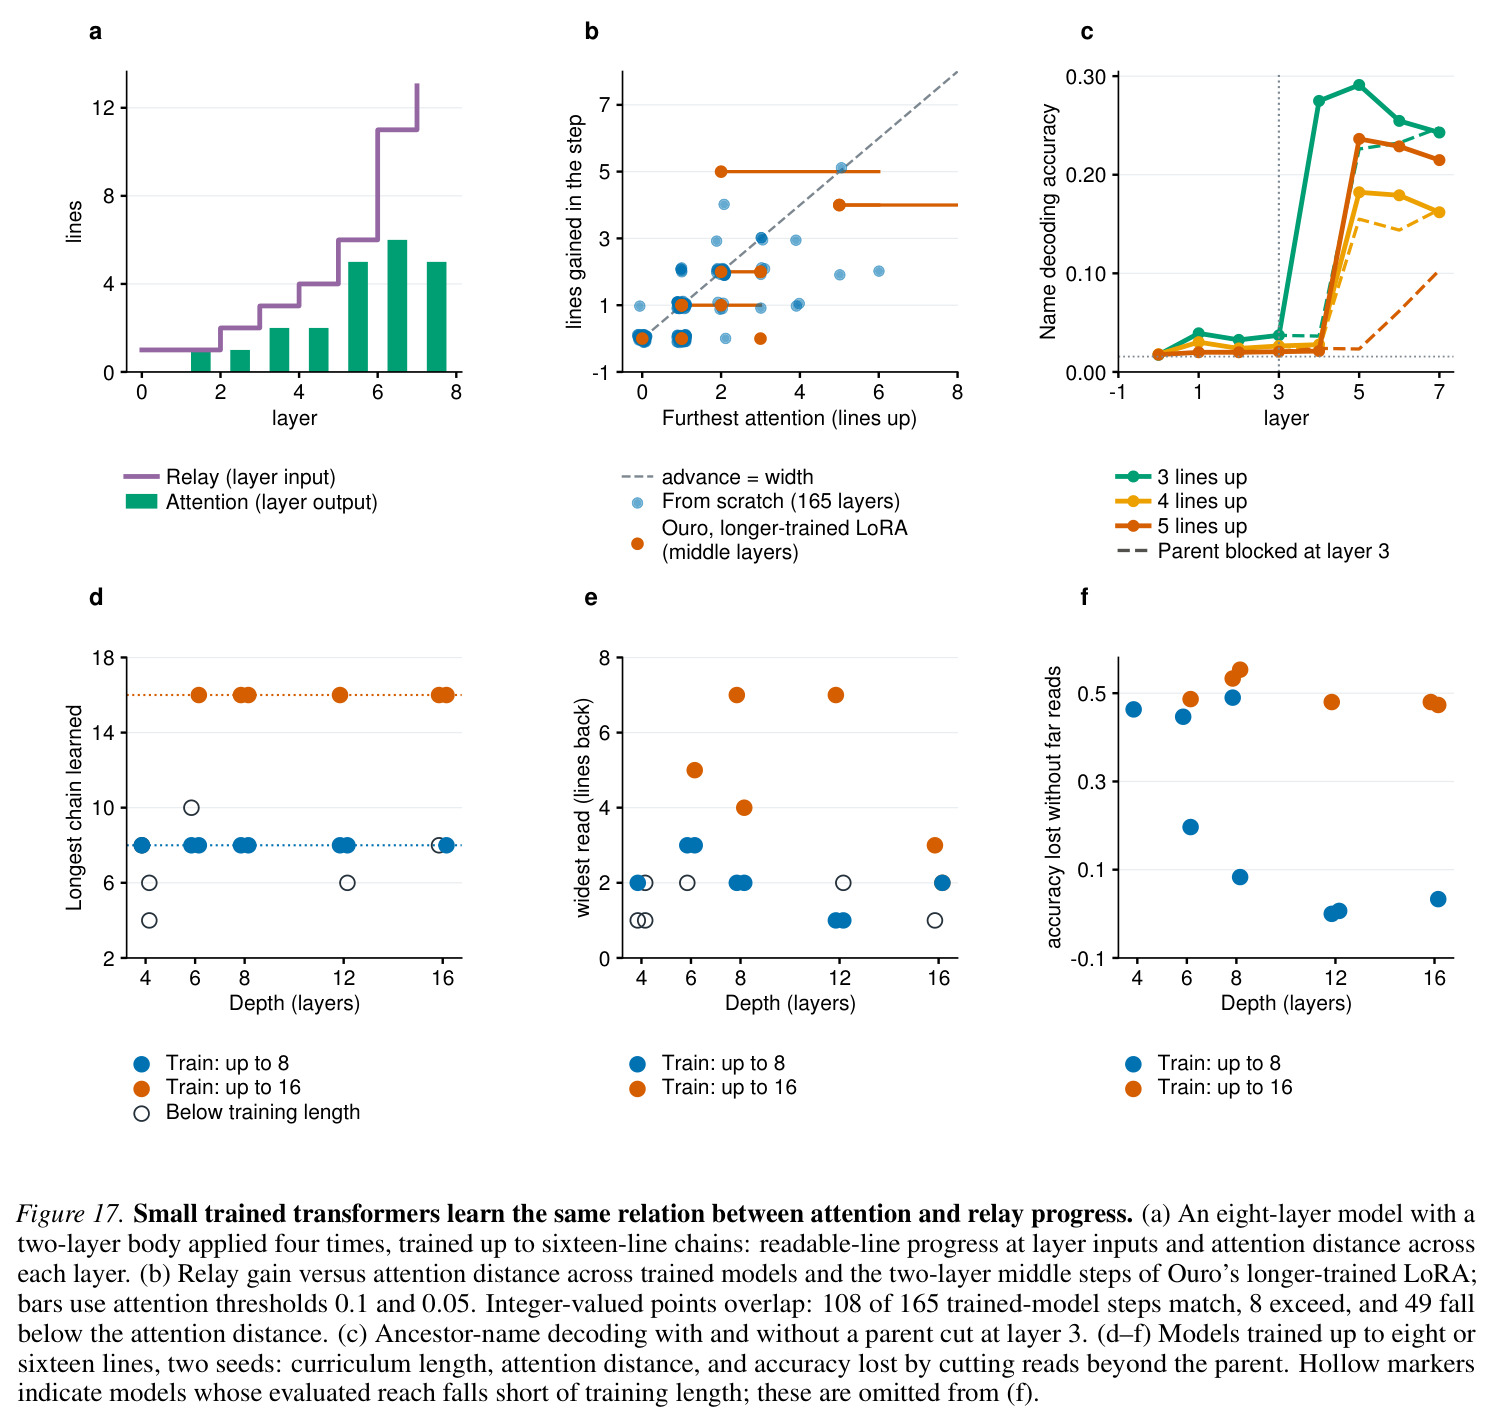
核心洞察是:LoRA 不是替模型算链,而是给一场已有的接力赛发令。默认计算分三段——程序行只把"本行属于哪条链"的身份传 2–3 行;查询位置在中间层自行解析最近的一两个指针;深层(Qwen 约第 32 层)才把选中的根值拷贝出来。加 LoRA 后,程序行的残差流开始携带更多祖先的名字,冻结的注意力头逐层向上多看一行(层 16–18 看 2 行,层 19–22 依次达 3、4、6、7 行),链身份像接力棒一样在 16–22 层的窄带里逐行推进,16 行链全部可读。关键在于:承载中继的完全是冻结层——只把 LoRA 放在 Ouro 的第一个循环,未经修改的后续循环仍能把 reach 推到约 25 行;OLMo 预训练检查点显示这种能力随预训练自然出现(21B/84B/336B token 时 LoRA 后 reach 为 1.5/10.2/23.7);从头训练的小 Transformer 也自发学会"relay 前进量=注意力距离"。所以 65K 参数足以接通整条链:模型不是不会,而是没人发令。
方法步骤详情
第一步,构造任务与指标:两/三链、1–24+ 行赋值程序(level 或 interleaved 排布),choice/exact accuracy 与 reach,每格通常 200 个程序。第二步,冻结基线与默认计算定位:测 13 个标准模型与 Ouro/Huginn 的 reach;用恢复效应 $S(p,\ell)$ 定位根值(停驻至约 32/36 层)与指针读取窗口(7.1±1.4 层);用 75% 准确率的链身份线性读出测"最远连续可读行"(relay)。第三步,训练 LoRA:单层 $h \leftarrow sh+BAh$,CE+KL 训练(长版本 2,000 步、链长至 40、更大名字表)。第四步,测量解锁后的 reach:Qwen 层 14 的 24 行 99%;Ouro 每循环层 6 注入并按循环数测曲线;另做交错/多链/迁移控制与重入实验(重入 Qwen 层 14–22 一次、两次,64 行准确率 34%→66%→92%)。第五步,机制溯源:读出中继推进层带(Qwen 16–22 层推进到 5,6,6,8,9,13,16 行),注意力逐层达 1–7 行远,父行 knockout(六/八/十二行掉回 53%/48%/55%),长读头消融与随机头对照,祖先名字解码。第六步,放置研究:定义 cutoff 层(三行三链程序上恢复效应低于一半的第一层平均),定义有效放置 $R(a)\ge R_0+\tfrac12\max_b(R(b)-R_0)$,预注册后在 4 个 held-out 模型上扫层验证。第七步,真实任务:MuSiQue(900 开发题、gold 段落、答案监督)与虚构事实任务上按层训练 LoRA/projection LoRA 并比较 EM 增益。
技术新颖性
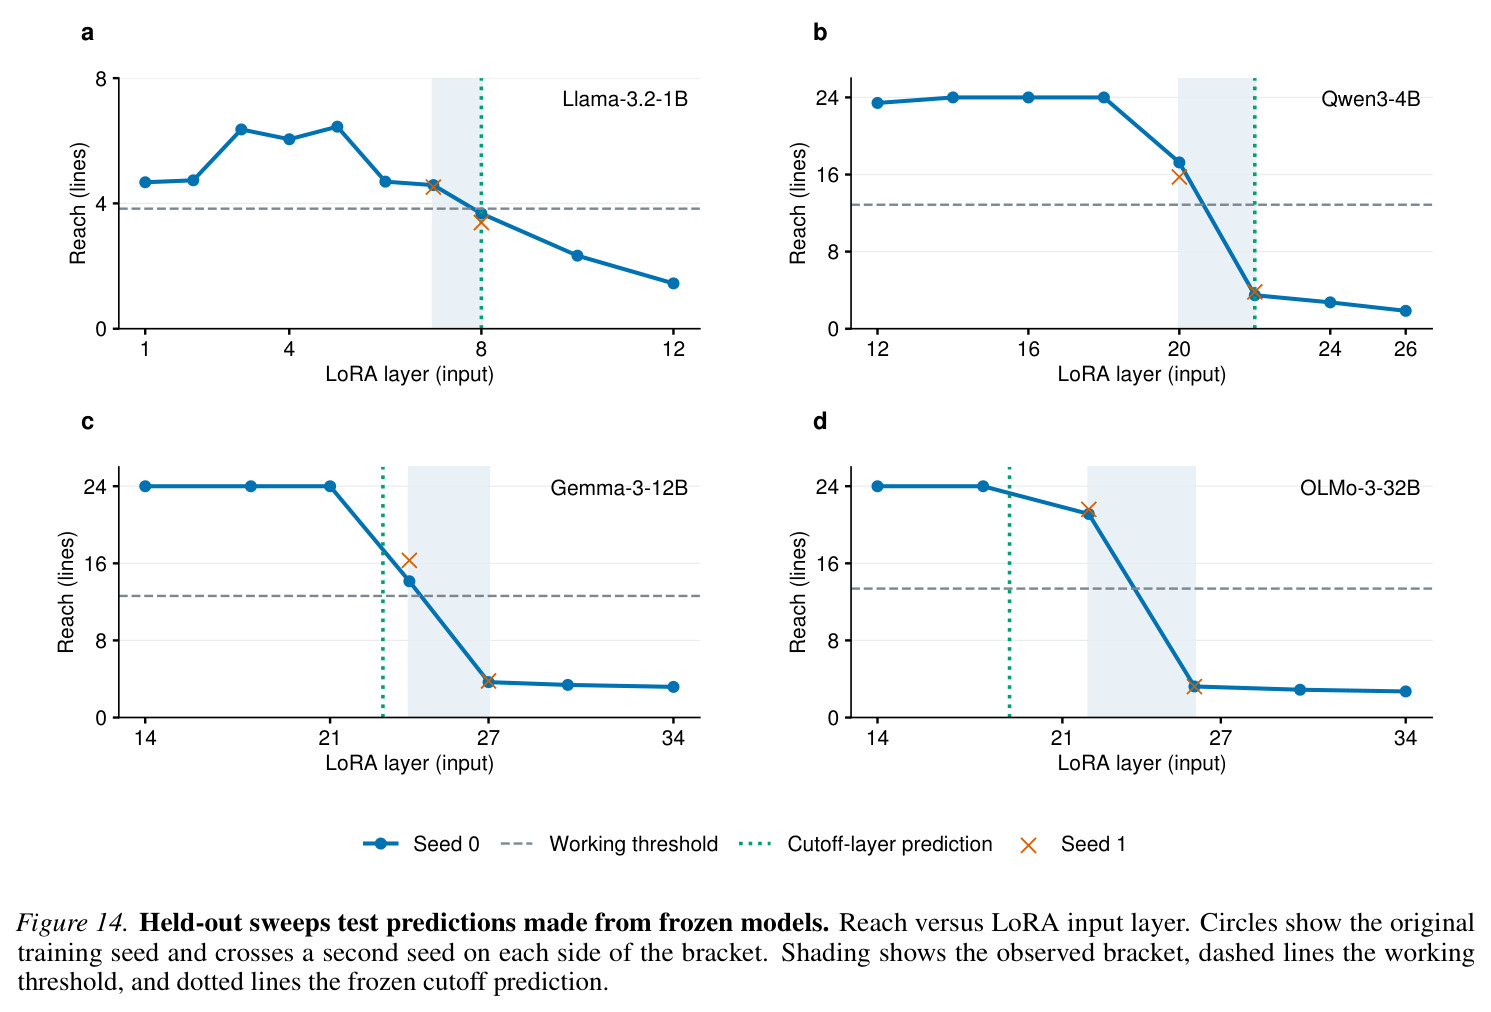
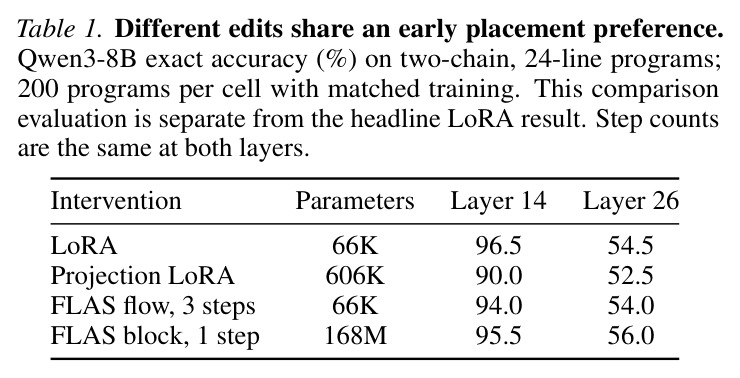
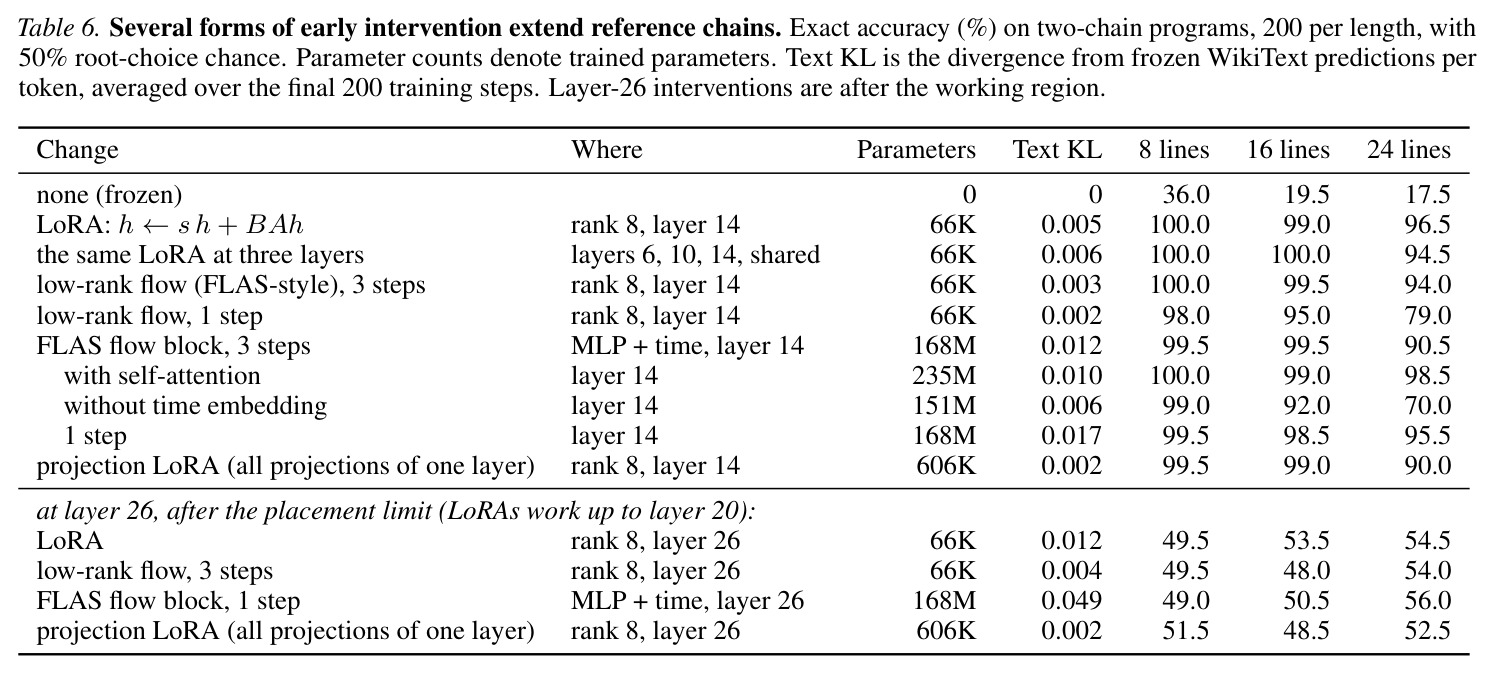
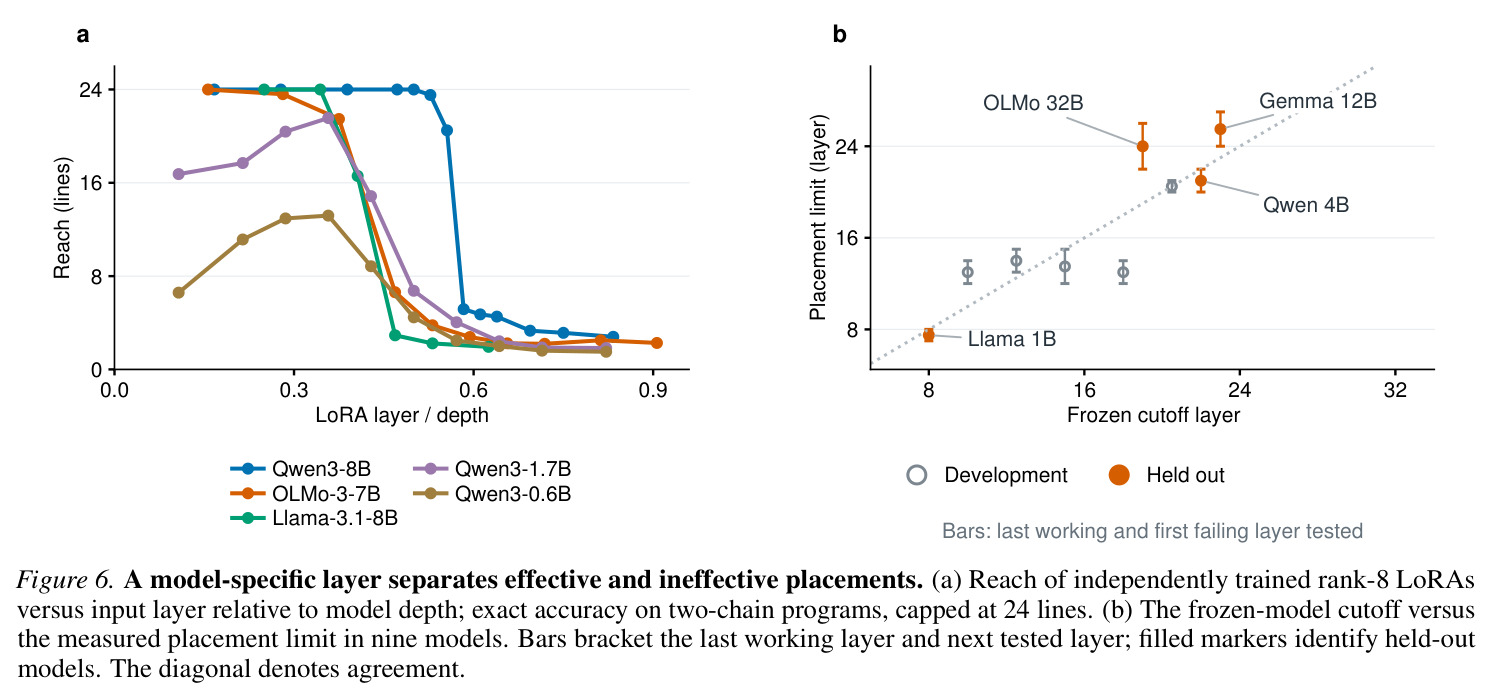
技术新颖性有四点。其一,把"干预放哪一层"变成可研究、可预测的对象:放置上限是模型特定的陡峭边界(Qwen 从层 20 移到 21,reach 从 20.5 行跌到 5.2 行),而作者提出只用冻结模型就能测量的 cutoff 预测指标,并做了预注册的 held-out 检验(3/4 命中,MAE 2.25 层)。其二,"启动 + 冻结承载"的实验设计:first-loop-only LoRA 与层带重入实验(34%→66%→92%)从因果上把扩展计算定位在未修改的权重里,区别于"LoRA 学到了新算法"的解释。其三,机制刻画精细:中继的注意力每层最多前进其读取距离(1–7 行,渐进而非指针倍增)、父行链接必要而两行以上的长读贡献增量 reach、祖先名字先于链身份可解码——这些把现象与 induction head、指针倍增等已知机制区分开来。其四,干预形式的受控比较:同层同数据下,残差流 LoRA、projection LoRA、FLAS 式流 $\ z \leftarrow z + \tfrac{1}{N}B^\top\text{silu}(Az + e(t))\$ 与 168M 参数的 FLAS block 都有效且共享放置偏好,说明关键是位置而非干预形式。
实验结果
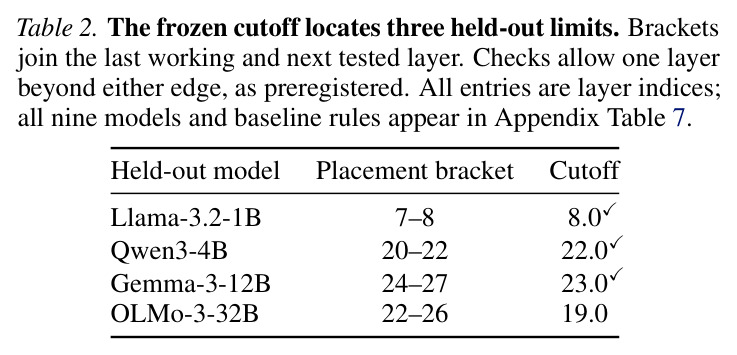
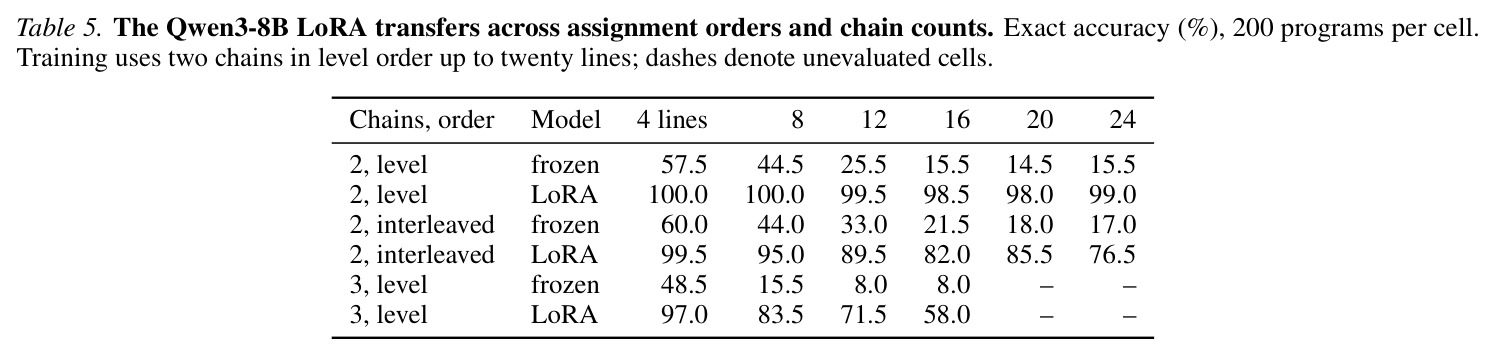
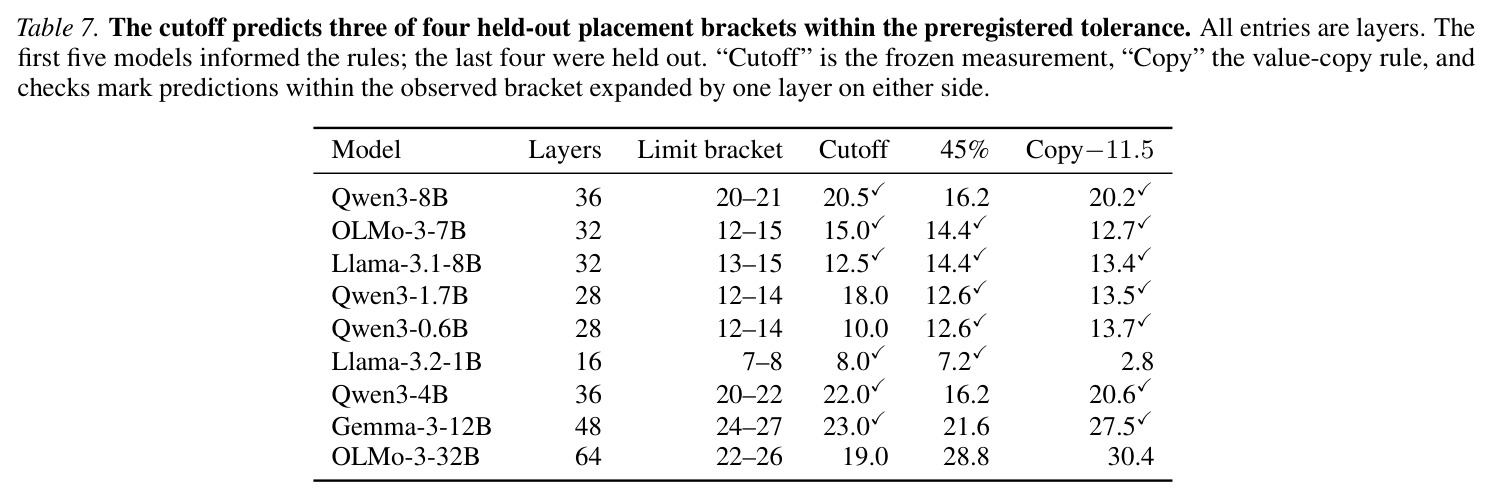
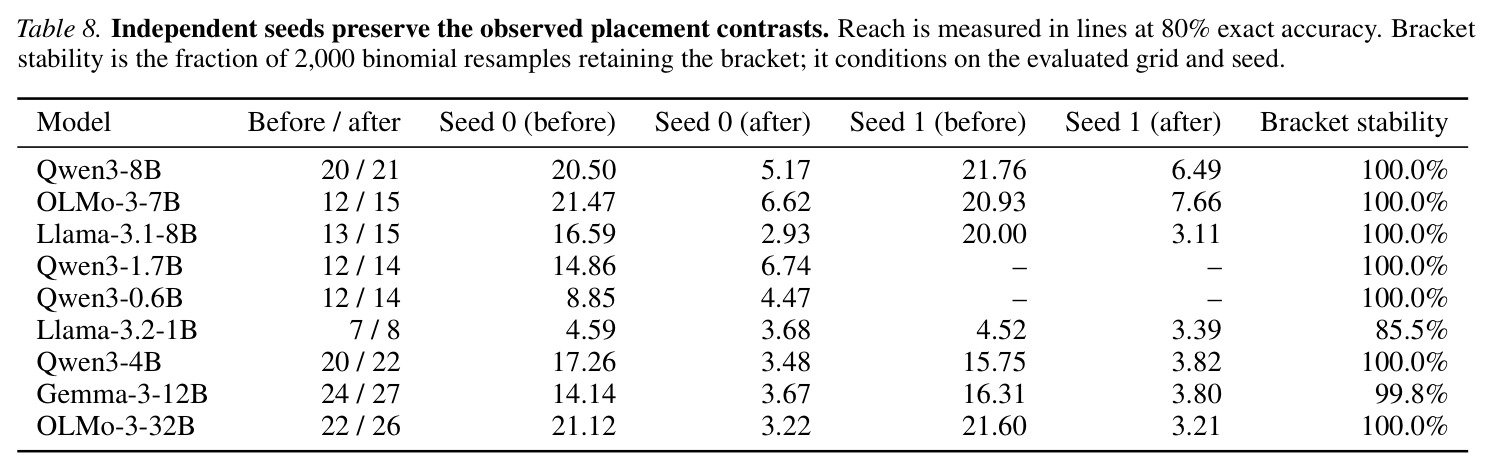
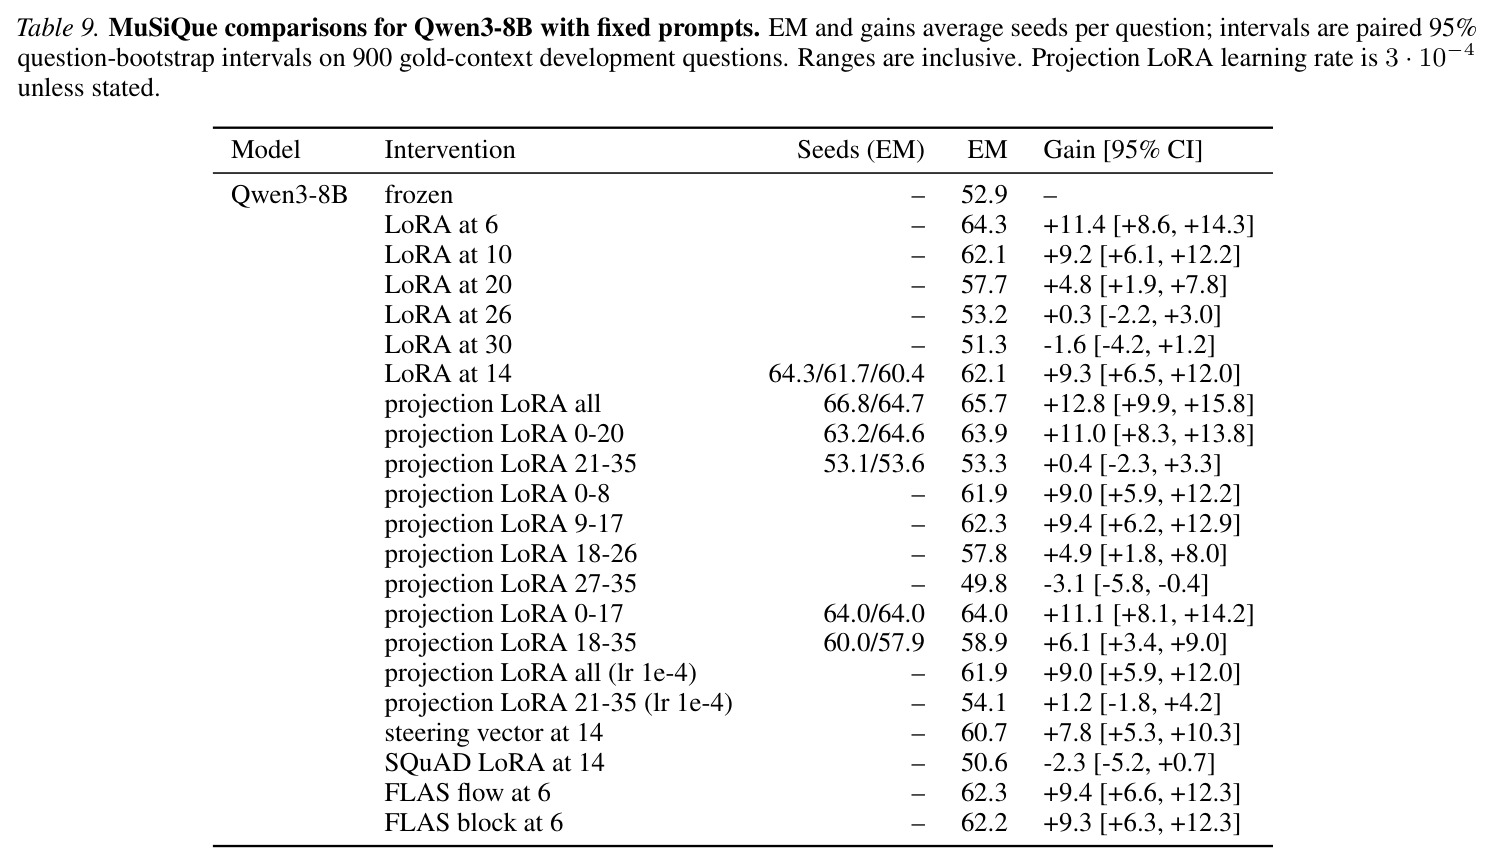
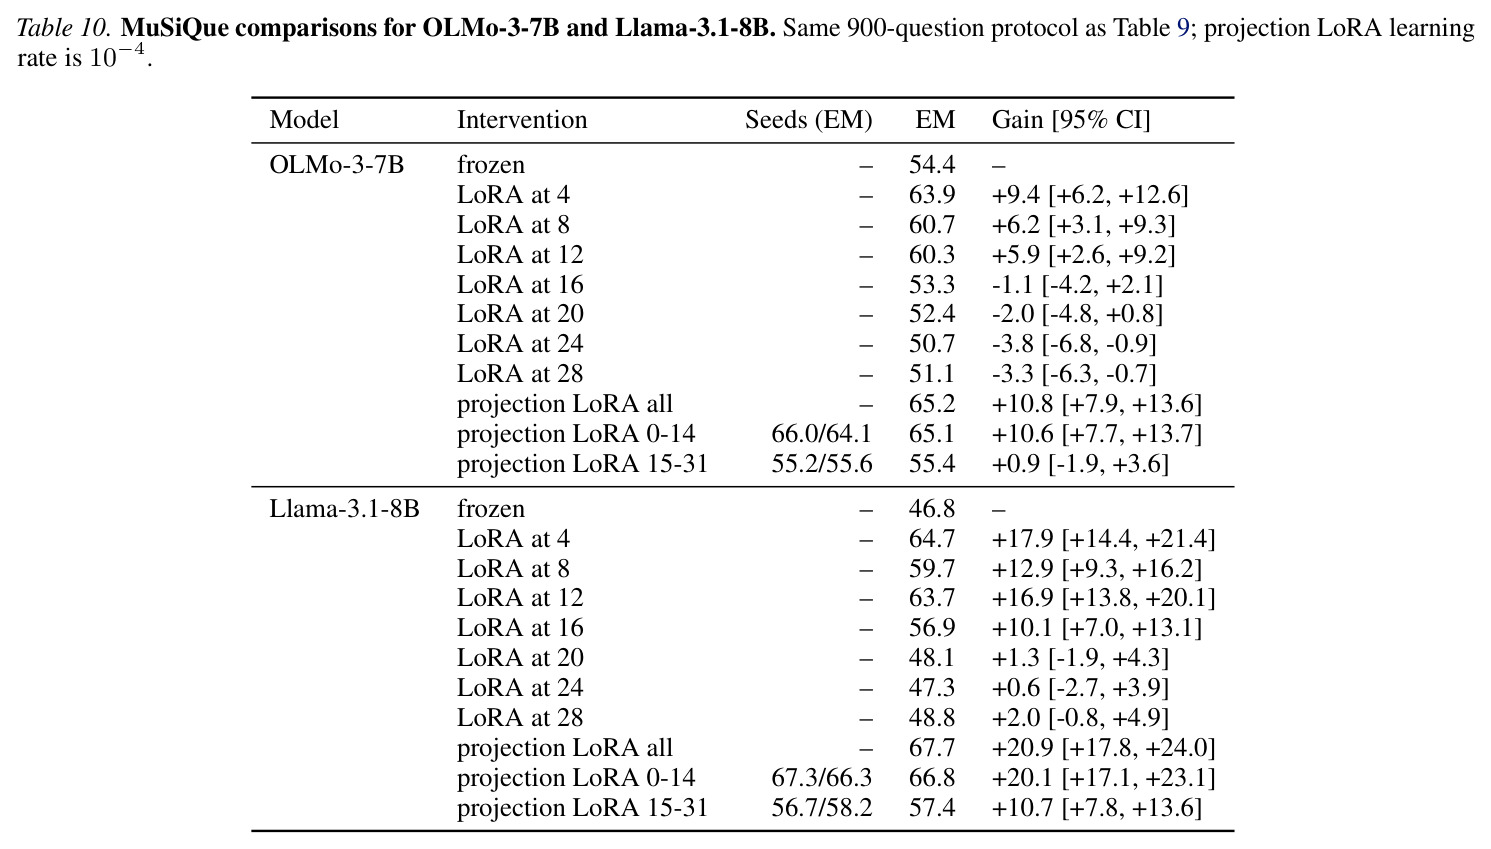
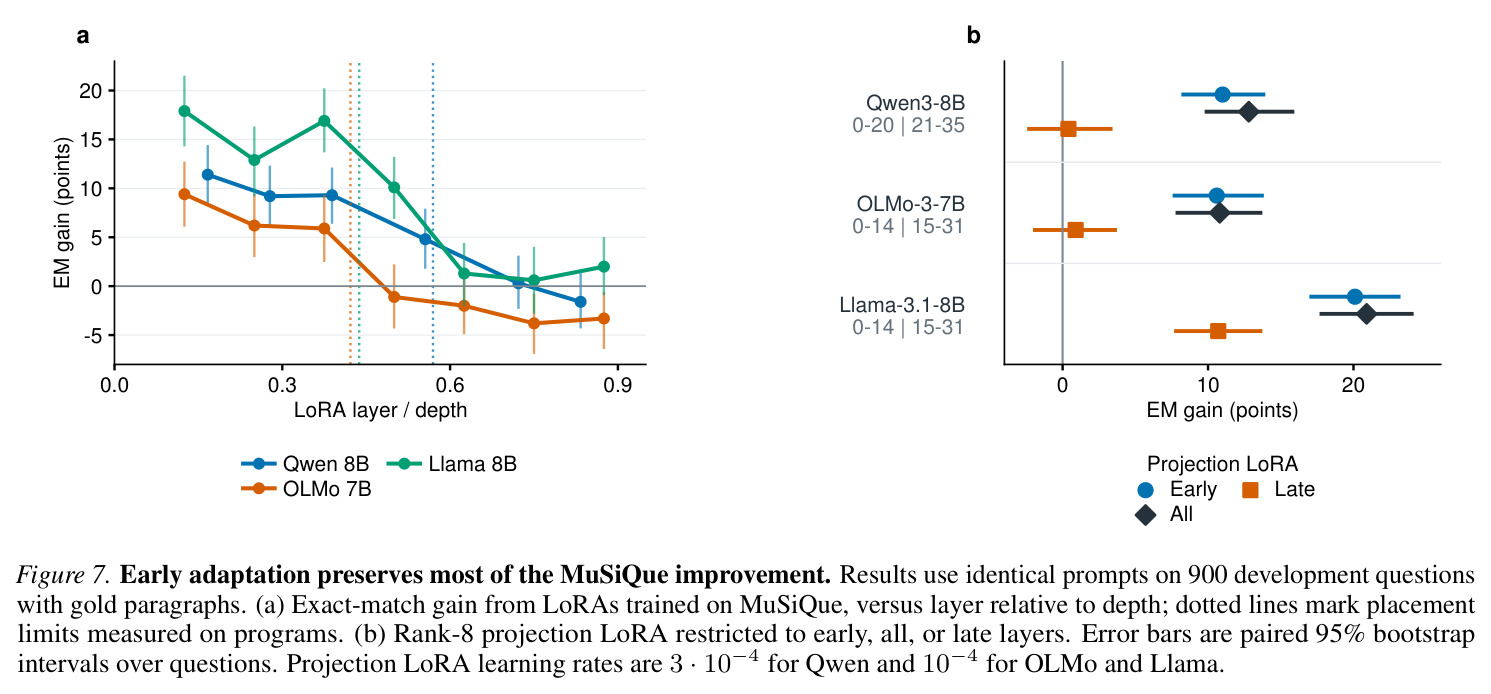
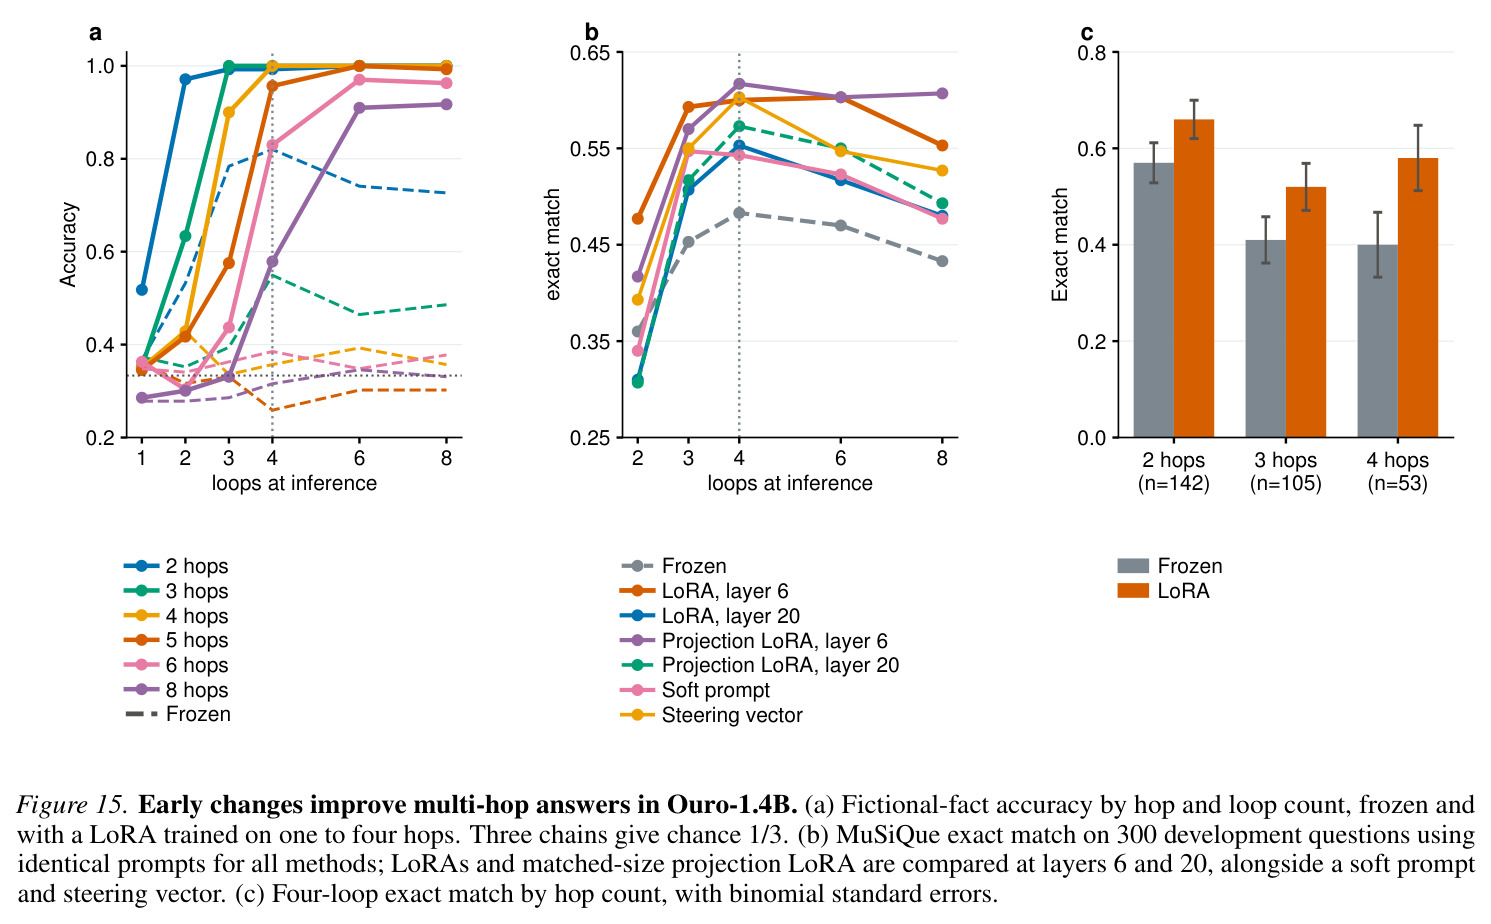
合成任务上,Qwen3-8B 的层 14 rank-8 LoRA(65,537 参数)把 16/20/24 行链的 exact accuracy 从冻结的 15.5%/14.5%/15.5% 提到 98.5%/98.0%/99.0%(24 行为 198/200,95% Wilson 区间 96.4–99.7%;三个种子 94.7–97.5%);更长训练的 LoRA 在 40/48 行得 98%/88%(冻结 4%/9%),单次前向 reach 达 50 行。交错排布把 24 行降到 76.5%,三链把 16 行降到 58%。循环模型收益最大:Ouro-1.4B 每循环层 6 的 LoRA 在 1/2/3/4 循环 reach 为 1.9/7.1/17/24+ 行,长训练版 4 循环 60 行、6 循环约 146 行、8 循环至少 160 行(160 行准确率 87%,为训练链长的 4 倍);只放第一个循环也有 9.5/21.5/约 25 行;Huginn 长训练版 8/16 次递归达 31/58 行(95% 区间 37–64)。重入 Qwen 层 14–22 使 64 行准确率从 34%(单次)升至 66%/92%。同一位置(层 14)的替代干预同样有效:projection LoRA 99.0%/90.0%(16/24 行),FLAS 三步流 99.5%/94.0%,FLAS block 99.5%/90.5%;而全部移到层 26 后都只剩 52.5–56.0%(随机 50%)。机制上,LoRA 后 Qwen 中继在层 16–22 输出处推进到 5,6,6,8,9,13,16 行,注意力逐层看 2/3/4/6/7 行远;切断父行注意力使六/八/十二行链掉到 53%/48%/55%(中继后层 23–29 切断无影响,100%/100%/98%);消融 10 个父读头使 89%→53%(随机头对照 83%)。能力确系预训练所学:OLMo-3-7B 在 21B/84B/336B token 检查点上,同法训练的 LoRA reach 为 1.5/10.2/23.7。放置研究:Qwen LoRA 从层 20 移到 21,reach 由 20.5 崩到 5.2(OLMo-3-7B 21.5→6.6,Llama-3.1-8B 16.6→2.9,第二种子复现);预注册的冻结 cutoff 预测在 4 个 held-out 模型中 3 个落在一层容差内(MAE 2.25 层,对比 45% 深度规则的 3.45)。真实任务:MuSiQue(900 开发题、gold 段落)上早层 LoRA 分别给 Qwen3-8B +11.4(52.9%→64.3%)、OLMo-3-7B +9.4、Llama-3.1-8B +17.9 个 EM 点,Qwen 层 6 比层 30 高 13.0 点 [10.1, 16.0];早层 projection LoRA(层 0–20)得 11.0 点,保留全层 LoRA(12.8 点)的大部分增益,晚层(21–35)仅 0.4 点。虚构事实任务上 Qwen3-8B 从 41.2% 升至 97.4%(增益 56.2 [51.8, 60.6]),训练 2–5 hop 后未见过的 6-hop 从 23% 升到 88%;Ouro 层 6 LoRA 在 4 循环把 300 题的 EM 从 48.3% 提到 60.0%(四 hop 从 40% 到 58%),训练 1–4 hop 后可靠回答扩展到 6 hop,6/8 循环下 8 hop 达 91–92%。
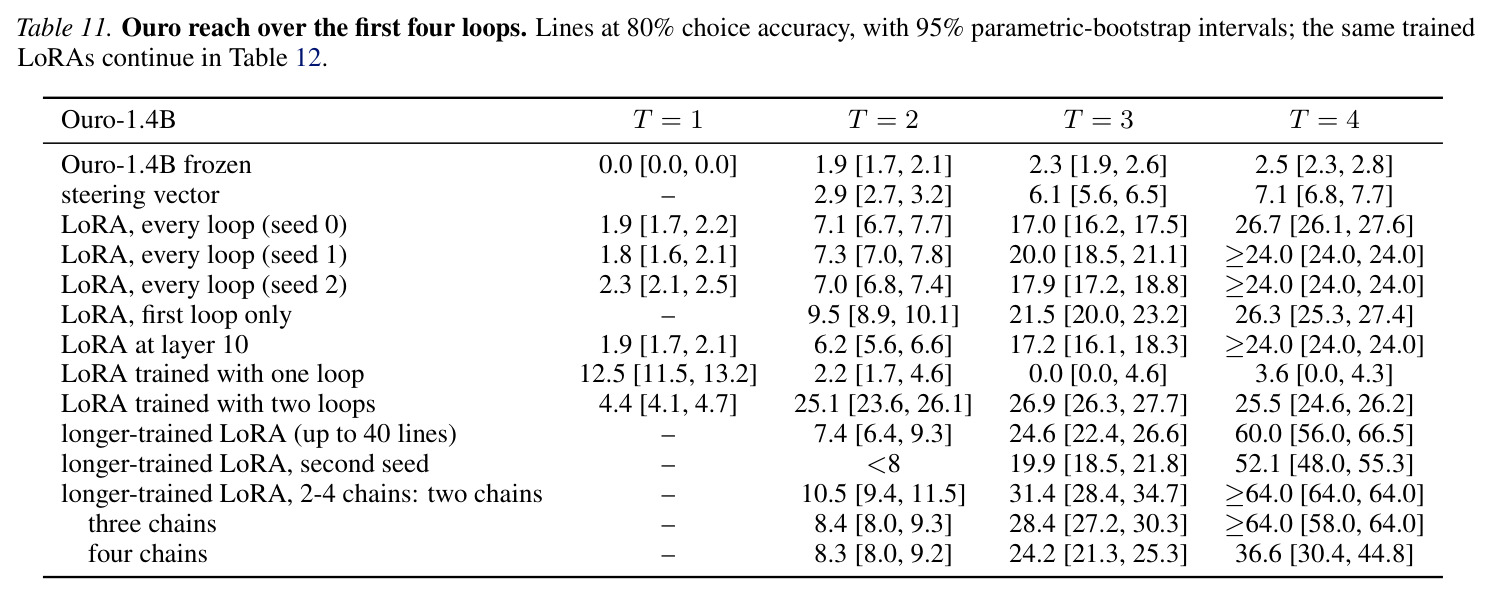
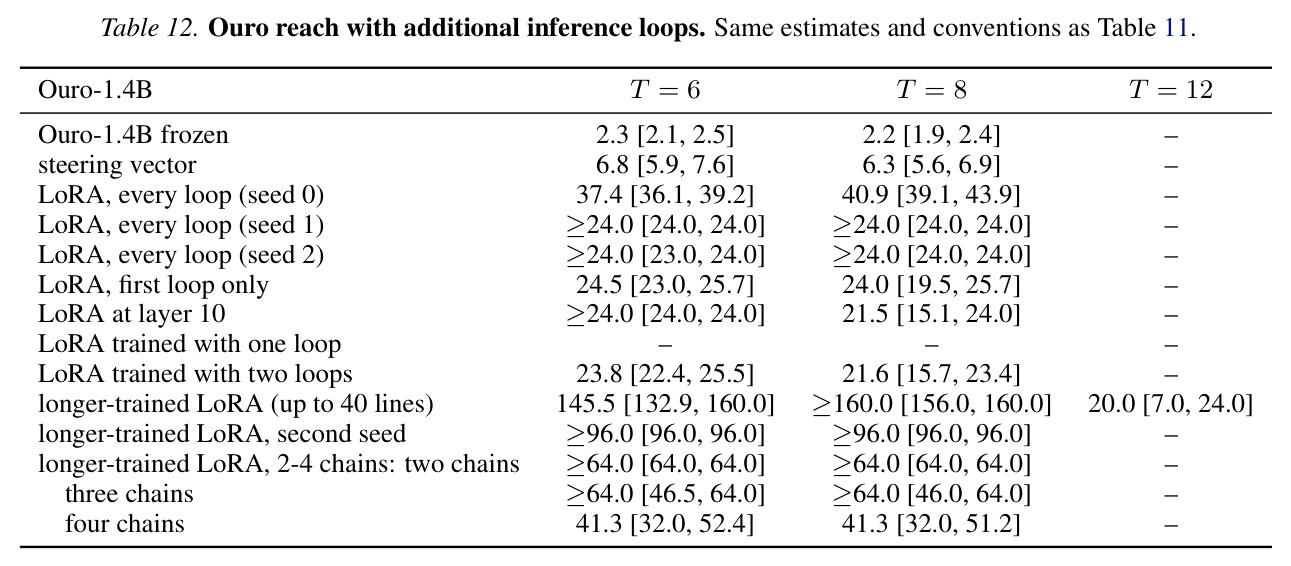
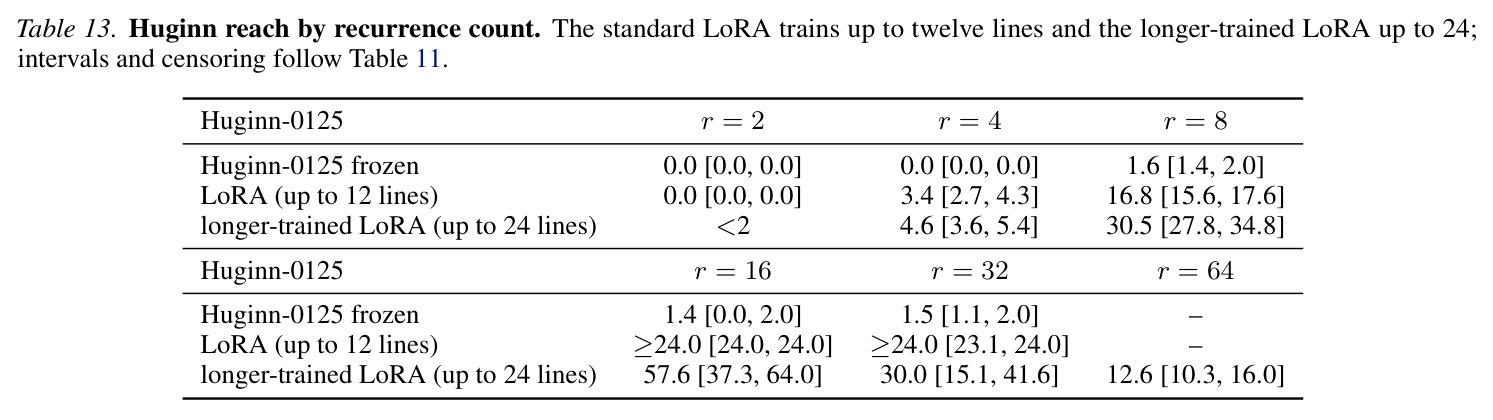
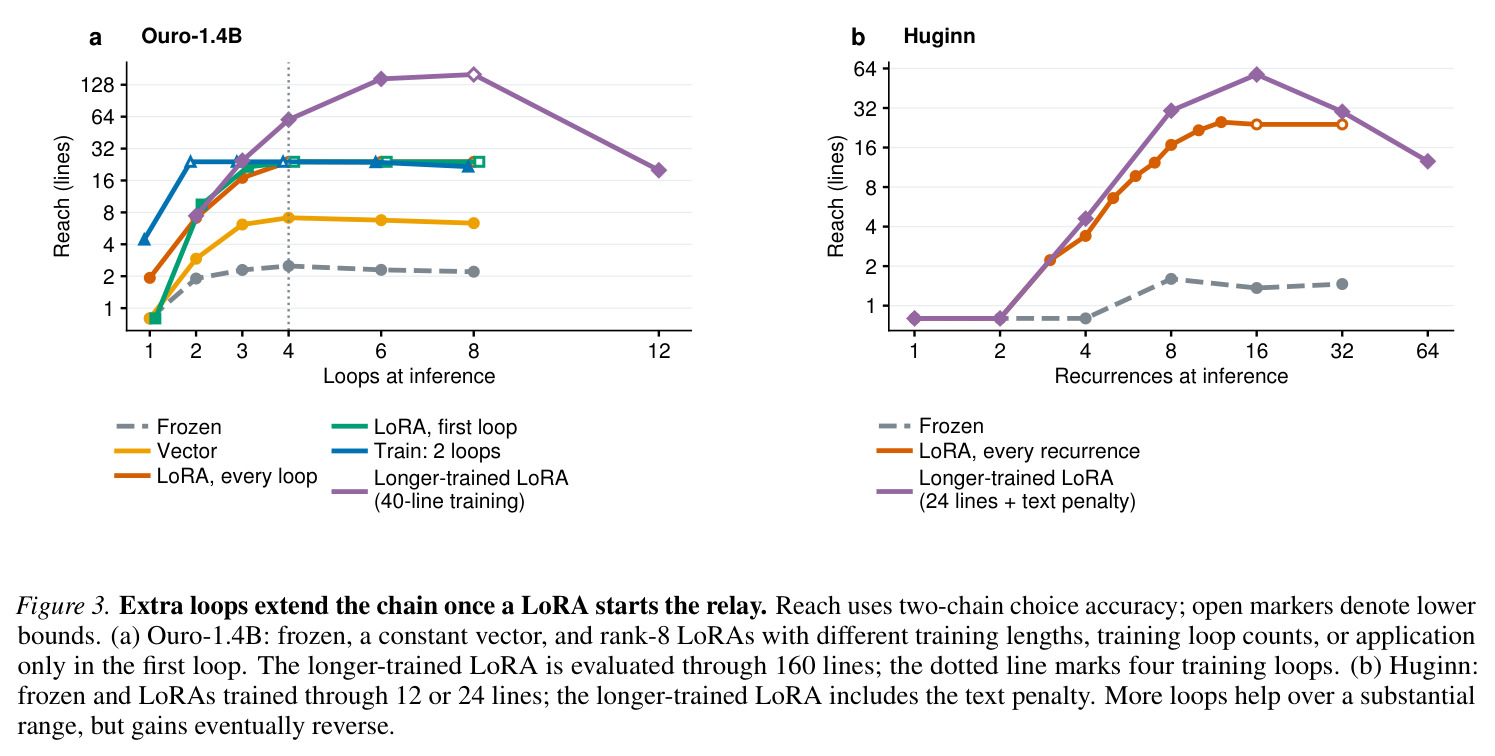
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 合成引用链,Qwen3-8B,两链 24 行(level order) | exact accuracy | 99.0%(198/200,层 14 rank-8 LoRA) | 冻结 15.5% | +83.5 个百分点(95% Wilson 区间 96.4–99.7%) |
| 合成引用链,48 行,更长训练的 LoRA 单次前向 | exact accuracy / reach | 88%,reach 50 行 | 冻结 9%,reach 约 3.1 行 | +79 个百分点,reach 约 16 倍 |
| Ouro-1.4B 循环引用链(8 个推理循环,长训练 LoRA) | reach(80% choice accuracy 的链长) | ≥160 行(160 行准确率 87%) | 冻结 2.2 行 | 约 70 倍 |
| MuSiQue 多跳问答,Qwen3-8B(900 gold-context 开发题) | exact match | 64.3%(层 6 LoRA) | 冻结 52.9% | +11.4 [+8.6, +14.3];层 6 比层 30 高 13.0 [10.1, 16.0] 点 |
| MuSiQue,Llama-3.1-8B | exact match | 64.7%(层 4 LoRA) | 冻结 46.8% | +17.9 [+14.4, +21.4] |
| MuSiQue,OLMo-3-7B | exact match | 63.9%(层 4 LoRA) | 冻结 54.4% | +9.4 [+6.2, +12.6] |
| 虚构事实组合问答,Qwen3-8B(训练 2–5 hop,500 配对问题) | exact match | 97.4%(未见 6-hop 为 88%) | 41.2%(6-hop 为 23%) | +56.2 [51.8, 60.6] 点 |
| Ouro-1.4B MuSiQue(300 开发题,4 循环,层 6 LoRA) | exact match | 60.0%(四 hop 从 40% 到 58%) | 48.3% | +11.7 [6.0, 17.3];层 20 仅 +7.0 |
| 放置层预测(4 个 held-out 模型的预注册检验) | 平均绝对误差(层) | 2.25(3/4 命中预注册容差) | 45% 深度规则 3.45;value-copy−11.5 规则 3.37 | 约 1.2 层;但全九模型上与事后 48% 深度规则基本持平(2.22 vs 2.27) |
局限与改进
作者明确承认的限制包括:机制任务全部是合成的、在上下文内的程序;MuSiQue 只为"放置偏好"提供证据(且主设定用 gold 段落),并非同一中继机制在真实任务上的直接证据;详细因果追踪集中在 Qwen3-8B 和 Ouro-1.4B,循环模型只覆盖两个家族且 Ouro-2.6B 是从 Ouro-1.4B 长出来的;LoRA 需按任务格式分别训练;WikiText 文本 KL 正则只是"测得到的控制"而非一般行为保证;放置预测精度一般(OLMo-3-32B 偏离区间中点 5 层);first-loop-only 的充分性只验证到约 25 行;最长的循环链结果依赖 level order 和每循环都加 LoRA 的设定;学习到的路由方向和最小充分秩都未确定,因果测试只约束计算而不唯一指定算法。我自己的观察补充几点:其一,收益并非单调——超过训练循环数约两倍后 reach 回落(Ouro 12 循环时 4 行准确率跌到 91%,Huginn 32/64 次递归时 reach 从 58 回落到 30/12.6),呈现明显的 overthinking;其二,交错排布和多链设定下性能明显下降(24 行 76.5%、三链 16 行 58%),说明机制对排布统计仍敏感;其三,cutoff 预测在全部九个模型上的 MAE(2.22)与事后拟合的 48% 深度常数规则(2.27)几乎无差别,说明其作为预测器的附加价值证据有限;其四,所有基准评估使用 gold 支持段落,真实检索噪声下的效果未知。
独立分析的弱点
第一,任务生态单一:所有机制结论都建立在"一行一个赋值"的合成程序上,而真实多跳阅读中的同义改写、指代变化、长上下文干扰会显著改变注意力模式;MuSiQue 部分缓解但用了 gold 段落。改进方向是把引用链嵌入自然语言文本,或在 RULER 式变量追踪与实体追踪基准上复测中继机制。第二,干预是任务特定的:每个任务格式都要重新训练一个 LoRA,且最优层需要局部扫描(cutoff 只能给出起点)。改进方向是学习跨任务共享的"启动"干预,或把放置搜索自动化(如用可读性探针在线选层)。第三,循环收益非单调:超过训练循环数约两倍后 reach 反转(Ouro 12 循环、Huginn 64 次递归),推理时缺少"何时停止"的准则。改进方向是引入基于中继读出的自适应循环数或早停信号。第四,鲁棒性缺口:交错排布(76.5%)与三链(58%)下准确率下降,父行注意力又是单点故障(切断即归随机),提示机制脆弱。改进方向是在训练分布中加入排布/链数多样性,或冗余化父链接。第五,机制未完全白盒化:路由方向、最小秩、注意力头组合都未确定;改进方向是用稀疏字典学习/子空间分析定位最小充分干预方向,把 66K 参数进一步压缩并解释其语义。
未来方向
作者提出的方向:评估范式应区分"默认行为"与"指定干预下可访问的计算",这会改变我们解读模型能力基准的方式;推理时通过重入承载中继的中间层带来增加计算(重入实验已显示 34%→66%→92% 的阶梯收益);循环与重入的价值在于重复执行携带有用计算的那个层带,而不是笼统的"多想一会儿"。基于本文成果可延伸的方向:把"早层启动 + 深层承载"原则推广到指令微调模型与 agent 的多跳工具调用链;与 LoFiT、单层 RL 定位(39–47% 深度)等 localized 适配方法合并成一个统一理论并直接比较;在数学、代码等有天然中间状态的推理域检验放置规律是否重现;探索 training-free 的替代启动方式(检索、缓存、更长的 steering 向量);对 MoE 与超深模型(如 DeepSeek-V4-Flash)做系统的放置测量;以及从理论上解释为什么承载窗口宽度(7.1±1.4 层)几乎不随深度增长——这关系到加深 Transformer 是否根本无法提升串行引用计算。
复现评估
复现条件相当好。项目页 https://lunamos.github.io/stop-thinking-too-early/ 公开了实验脚本、能从实验输出重新计算每张表和每幅图的分析脚本,以及从每条结论到对应脚本和命令的对照指南。所 用模型全部公开(Qwen3 系列、Llama-3、OLMo-3、Gemma-3、DeepSeek-V4-Flash-Base、Ouro-1.4B/2.6B、Huginn-0125),数据公开(WikiText-103、MuSiQue)或可自行生成(合成程序只依赖名字表和随机种子)。算力门槛低:标准 LoRA 只需 1,200 步、batch 16(AdamW,学习率 $10^{-3}$),65K 参数,单张消费级/单张 A 级 GPU 即可完成;大头在评估——因果追踪(每格保留 24 个配对样本,Llama-3.2-1B 的 line-2 指针只剩 13 对)和放置扫描需要大量前向,但仍属单机范围。需要注意的复现细节:头的选择与打分必须在不相交的程序两半上进行;统计区间(Wilson、paired bootstrap 2,000 次重采样)与预注册协议(在看到 held-out 结果前提交)要严格遵守;MuSiQue 对比必须固定 hash 种子以保证提示一致。总体难度中等偏低,机制分析部分对统计严谨性要求高,但脚本齐全,属于可解释性论文中复现友好度最高的一类。
论文图表
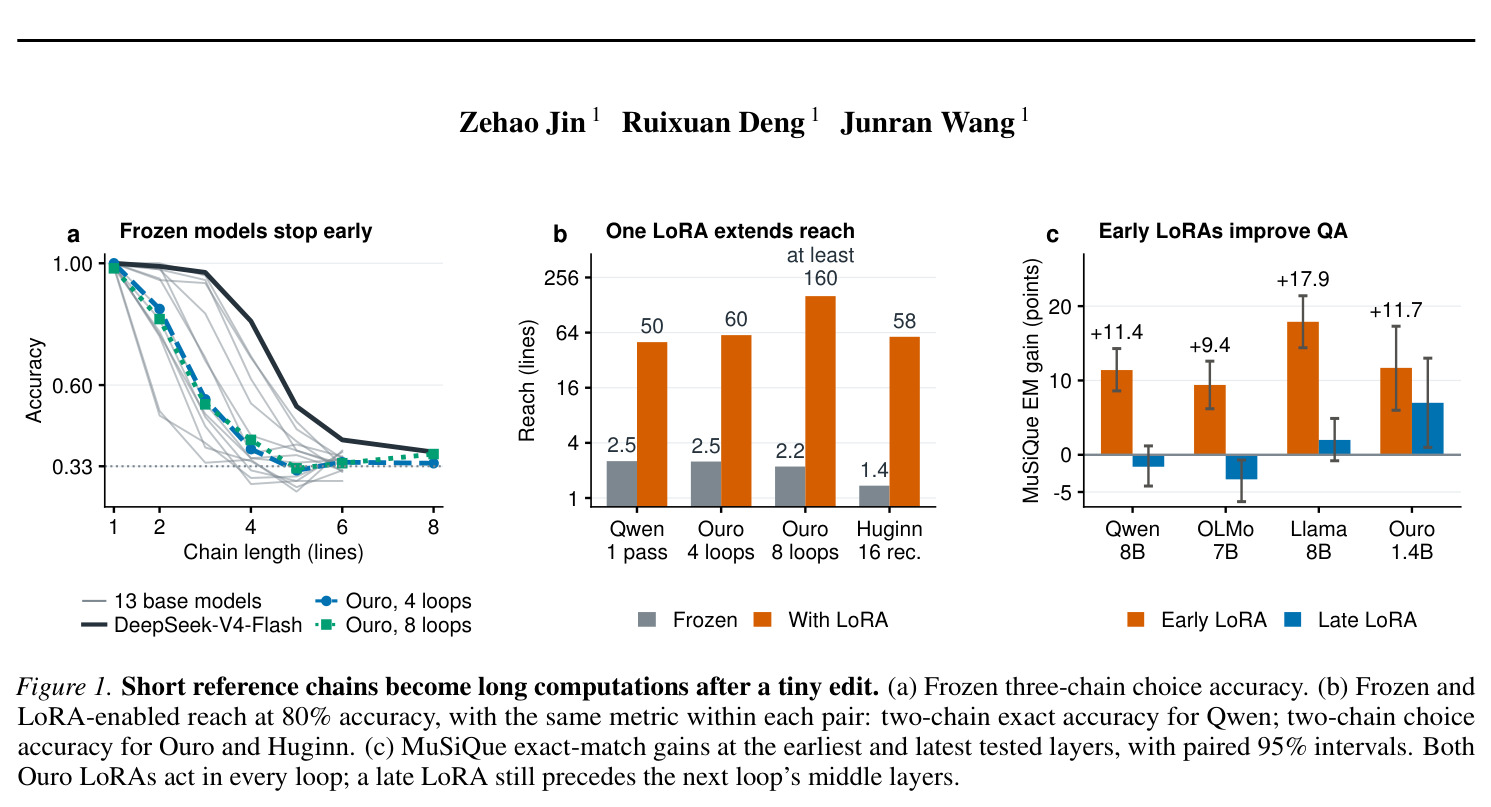
三面板总览图。(a) 冻结模型在三链选择任务上的准确率随链长骤降,13 个基座模型可靠 reach 仅 1.4–3.6 行,Ouro 加循环几乎无改善;(b) 冻结与加 LoRA 后的 reach 对比:Qwen3-8B 16→2.5、Ouro 4 循环 64、8 循环 160、Huginn 16 次递归 58 等;(c) MuSiQue 上最早层与最晚层 LoRA 的 EM 增益配对比较(+11.4/+9.4/+17.9 点,晚层约 -5 到 +10.7)。
这是全文的摘要图:一眼看清问题(冻结模型早早停止)、修复(单层 LoRA 数量级扩展 reach)和应用(早层适配优于晚层)三大支柱。
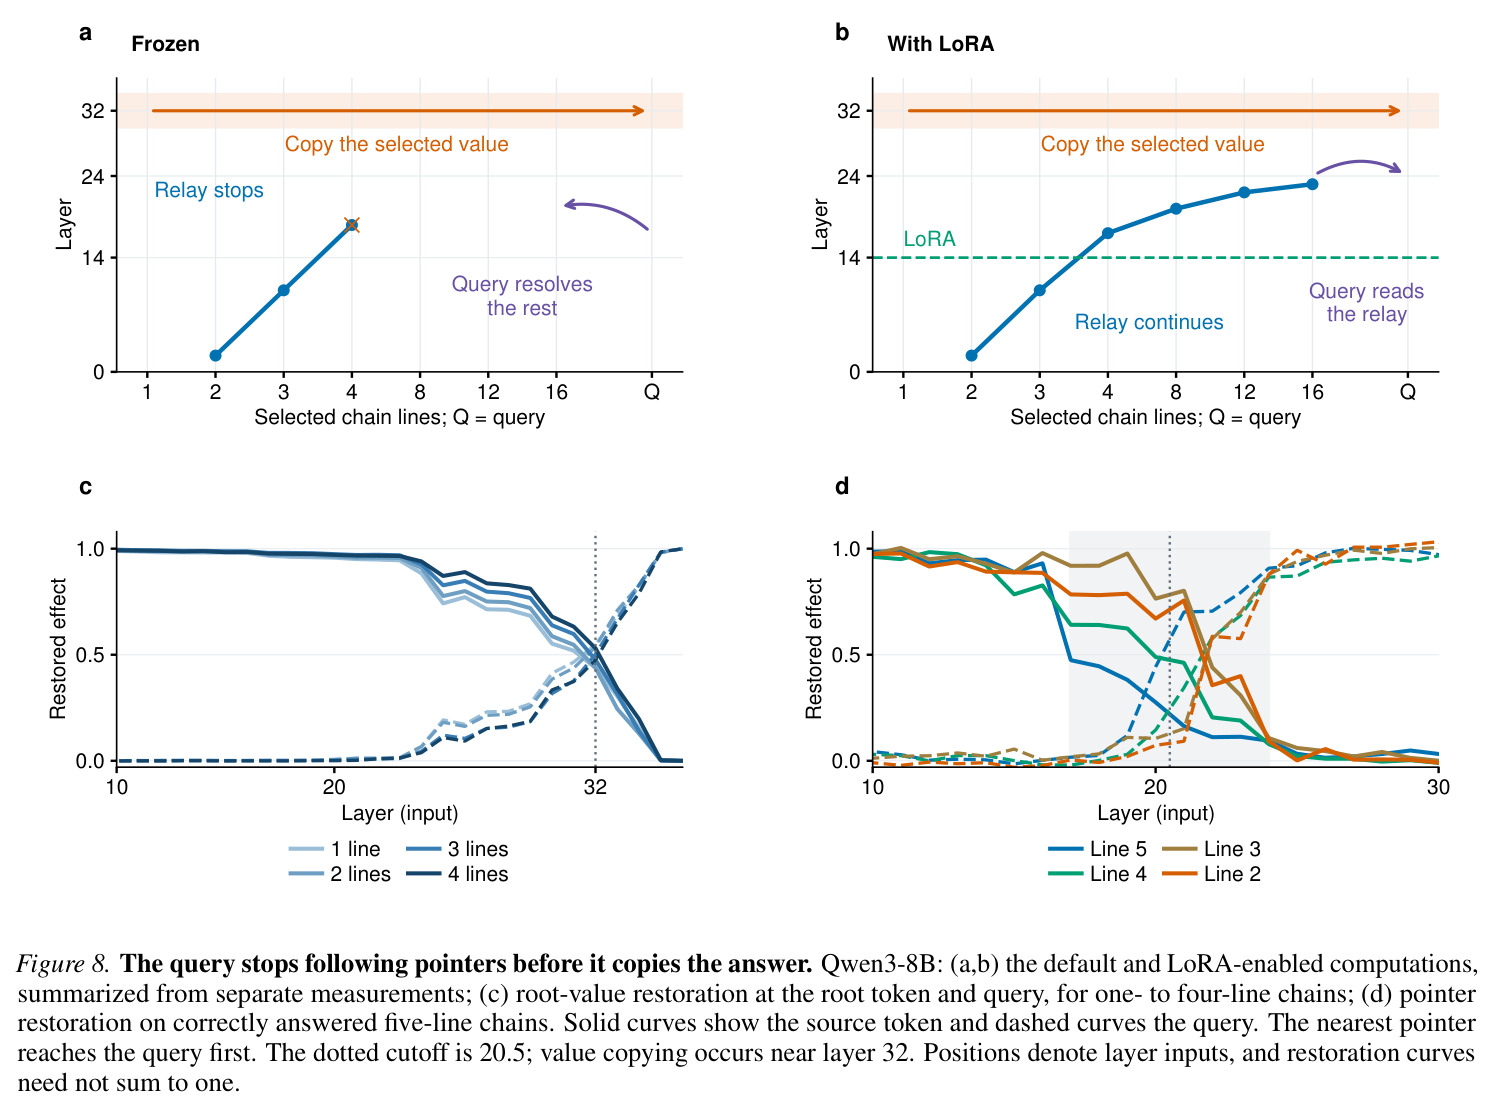
Qwen3-8B:(a,b) 默认与 LoRA 启用后计算的示意图。(c) 根值恢复效应:根值在源 token 停留到约 32 层才被查询拿走一半,且几乎不依赖链长。(d) 五行链上指针恢复效应:最近的指针最先到达查询;虚线 cutoff 为 20.5。
精确刻画冻结模型的默认计算三段式(短中继 + 查询解析一两个指针 + 晚层值拷贝),是理解'为什么停在 2–3 行'的基础。
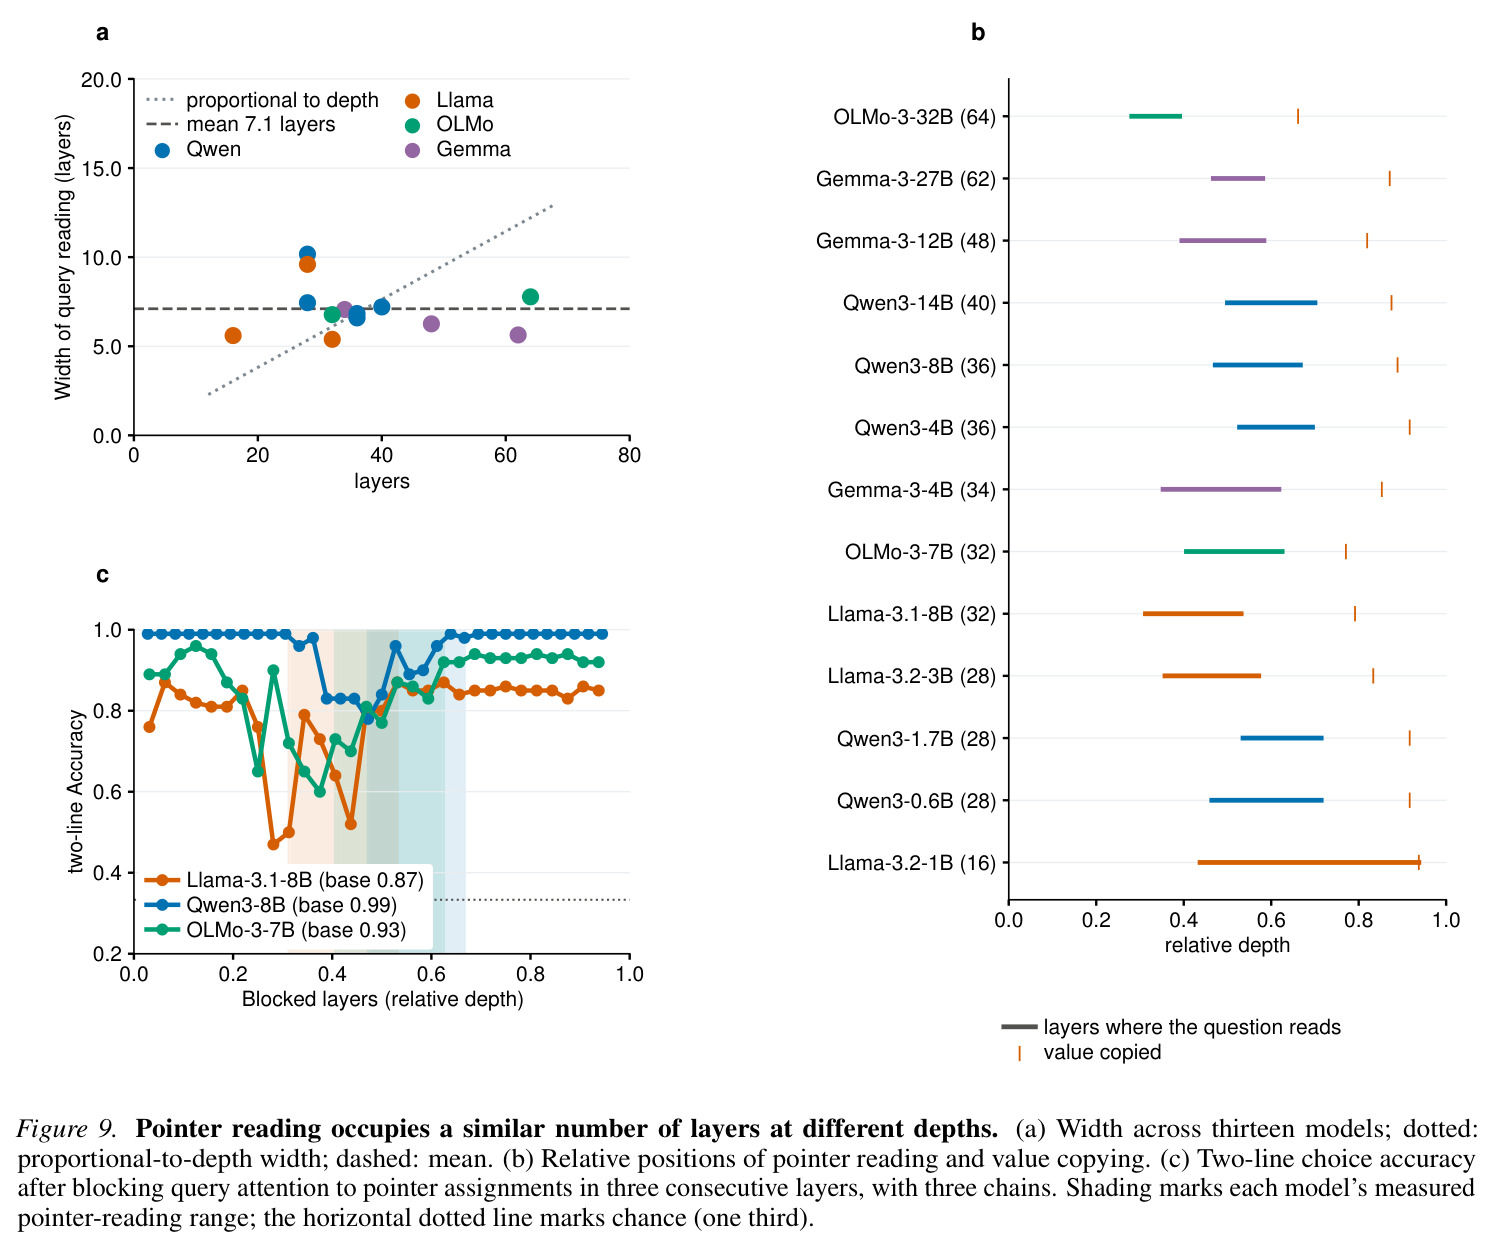
(a) 13 个模型上指针读取窗口宽度(90%→10% 衰减)约为 7.1±1.4 层,几乎不随深度增长(斜率 -0.017)。(b) 各模型指针读取与值拷贝的相对位置。(c) 三层滑动切断查询对指针行的注意力:仅在各自测得的读取窗口内掉点。
揭示一个反直觉的结构事实:加深模型并不会等比扩大可用的串行读取窗口,为'深度换不来更长引用跟随'提供机制解释。
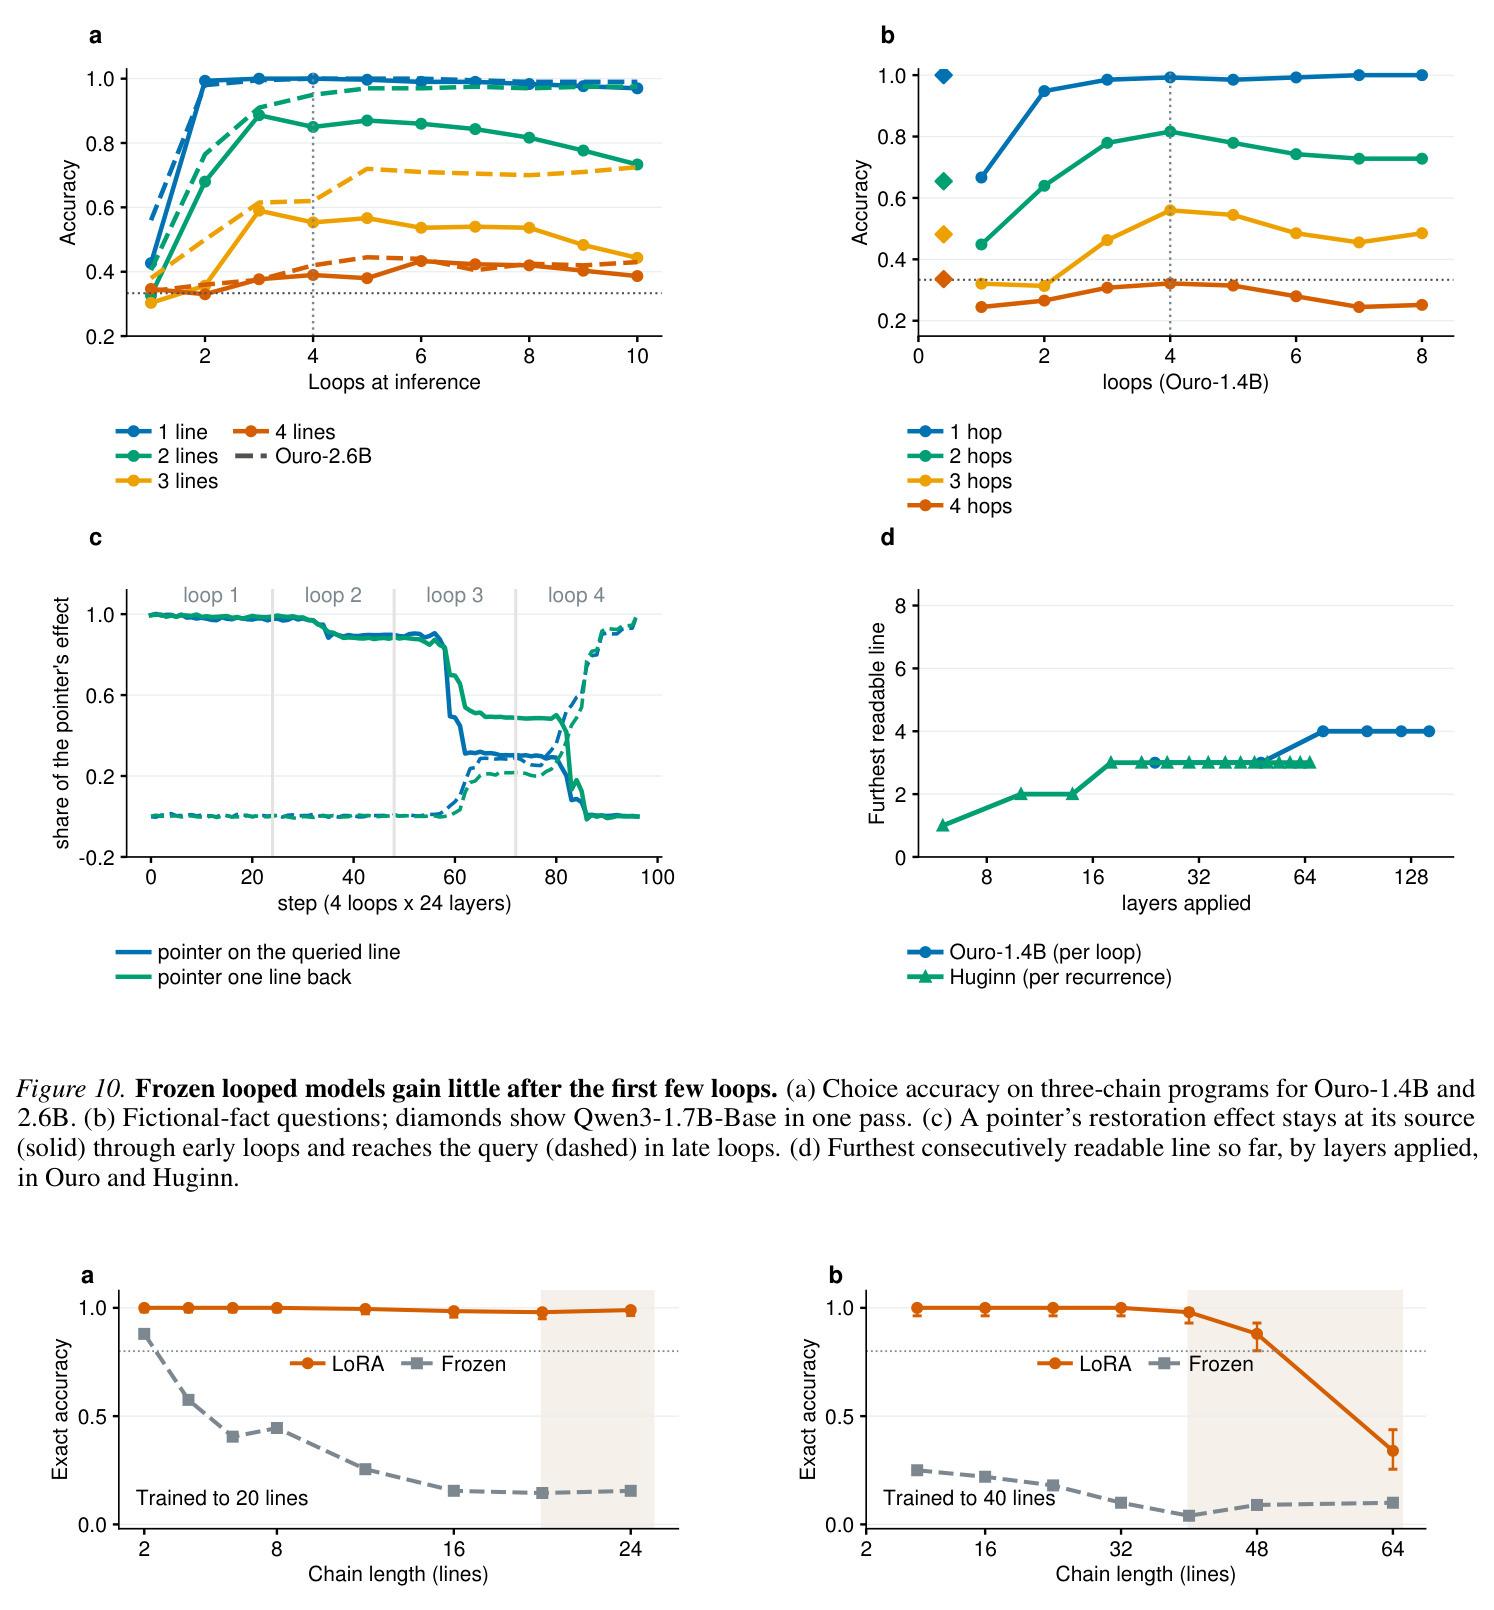
(a) Ouro-1.4B 与 2.6B 三链程序的 choice accuracy 随循环数:第 4 行准确率在 10 个循环内都距随机不到 10 点。(b) 虚构事实多跳准确率随循环数。(c) 指针恢复效应在早期循环停留在源 token、后期循环才到达查询。(d) Ouro 与 Huginn 按层数累计的最远连续可读行:冻结状态基本停滞。
证明循环模型的额外推理循环在冻结状态下几乎空转,为'LoRA 让循环重新有用'提供对照基线。
从头训练的小型循环 Transformer(4–16 层、宽 256):(a) 一个 8 层模型的逐层中继推进与注意力距离;(b) 165 个层步中 108 步 relay 前进量恰好等于注意力距离(8 步更多、49 步更少),Ouro 长训练 LoRA 的中间层步也符合;(c) 层 3 切断父行注意力使三行外名字解码从 0.27 降到 0.04;(d–f) 课程长度、注意力距离与切断长读的准确率损失随深度的关系。
用受控小模型复现'中继前进量=注意力距离、父行送名字、长读找链'的规律,为机制主张提供因果可控的佐证。