在学生状态处学习教师续写(OLIVE) Learning from Teacher Continuations at Student States
学生生成前缀、教师在线续写接管,仅用教师文本训练,效果超 OPD 且训练更省时
前置知识
知识蒸馏
让更强的教师模型把能力传给更弱的学生模型:既可以让让学生拟合教师的逐 token 概率分布(KL 蒸馏),也可以让学生在教师生成的文本上做监督训练(SeqKD/SFT)。本文属于后者——用教师生成的文本作为监督信号。
全文讨论的就是蒸馏监督的形式与放置位置,理解这两类基本范式才能看清 OLIVE 在谱系中的位置。
在策略蒸馏(OPD)
从学生策略自身采样 rollout,再由教师对 rollout 上每个 token 给出分布并计算反向 KL 损失,使监督落在学生实际到达的状态上。但它本质是“给已有 rollout 打分”,后续目标仍条件在学生原本的续写上。
OPD 是本文最主要的在线基线,OLIVE 的设计处处针对其碎片化监督、师生能力差距大时失效、需要教师 logits 这三点局限。
顺序协变量偏移
训练时模型见到的是教师(或固定数据集)的轨迹,推理时却以自己此前的输出为条件,两者分布不一致;长视野下小误差不断被放大并复合,是行为克隆与离线 SFT 的经典问题(Ross & Bagnell 2010)。
这是 OLIVE 用“从滚动学生策略在线采前缀”要解决的核心问题,理解它才能明白为什么前缀必须随训练不断刷新。
DAgger 与专家干预
模仿学习算法 DAgger 让学习器自己滚动环境、由专家在学习器实际到达的状态上标注正确动作,从而使监督分布与策略分布一致;“专家接管/干预”则指专家从学习器的半成品轨迹处继续示范后续动作(learner roll-in + expert continuation)。
OLIVE 的“学生前缀 + 教师续写”正是这套思想在 LLM 蒸馏上的翻版,论文动机部分直接引用这两条研究线。
掩码交叉熵(suffix CE)
把完整序列喂给模型,但只在指定片段上计算预测下一个 token 的负对数似然,其余位置被 mask 掉。OLIVE 只对教师生成的后缀计算 CE,学生的前缀与提示仅作为条件上下文参与注意力而不产生损失。
这是 OLIVE 只需教师文本、无需 logits 就能训练的机制基础,也是教师与学生学习器使用不同 tokenizer 时仍可蒸馏的原因。
研究动机
现有蒸馏方法各有硬伤。其一是离线 SFT:学生在教师固定轨迹上训练,但推理时以自身输出为条件,产生顺序协变量偏移,长视野下误差不断复合;固定数据集也无法跟踪学生策略更新后实际访问的状态,还可能损害学生已有能力。其二是在策略蒸馏(OPD):它虽沿学生自身 rollout 逐 token 计算教师反向 KL,但即便教师在某个 token 处建议改写,后续目标仍条件在学生原始续写上——监督是“碎片化”的,只给过去的 token 打分,却没有示范修正之后该怎么走。论文数据显示这种失配很实际:RLVE 上 OPD 使 Qwen3-4B 的 pass@8 从 46.1 反而降到 45.6(−0.5);多轮环境 ScienceWorld 上学生本来有 0.12% 成功率,OPD 训练后归零;学生早期动作一旦走偏,整条轨迹脱离教师分布支撑,打分式监督彻底失效。其三,分布匹配式蒸馏需要教师 token 概率(logits),GPT-5.4-mini 这类只暴露生成文本的 API 模型根本无法充当教师。
本文的目标是论文的目标是在与 OPD 可比的算力预算下,构造“放在学生实际到达的状态上、且随学生策略滚动刷新”的教师监督,同时满足三个约束:监督要直接示范修正之后如何继续(而不是评价学生已经写出的 token);只需教师生成的文本,兼容黑盒 API 教师与不同 tokenizer;训练成本与 OPD 持平甚至更低。覆盖场景上,作者瞄准当代后训练的两大主线——长思维链推理(单轮,用 RLVE 合成环境构造 18 个环境、每环境 500 题、共 9K 道难度可调的硬题)与长视野多轮智能体任务(AgentGym 的 ALFWorld、ScienceWorld、TextCraft、BabyAI、SearchQA 五个环境),并希望在推理 pass@8/avg@8、智能体 avg@4 成功率、通用能力遗忘幅度、总训练 GPU 小时等维度全面超过离线 SFT 与 OPD。
与已有工作不同的是,本文的独特切入是把“监督放在哪里、是否随学生变化刷新”提升为与“监督形式(KL 还是文本)”并列的设计轴。已有工作纠结于监督的形式:是匹配教师分布还是模仿教师文本;OLIVE 指出即便形式不变,只要把教师的接管点移到学生自己生成的前缀上、并让前缀随训练不断重新采样,监督的有效性就完全不同。这一思想直接借自模仿学习的 DAgger/learner roll-in 与近期的专家干预式智能体训练:学生先自由发挥一段,教师在关键处接手示范后续,使得“之后的决策(在交互环境中还包括之后的观测)”都沿教师自己的选择展开,学生因此学到“从自己真实会到达的上下文如何继续”,而不必先自己走出正确的修正路径。作者还强调滚动性:每步迭代都从当前策略重采前缀(DAgger 式刷新),区别于 OEC 等“前缀由初始策略一次性采完再离线训练”的变体。
核心方法
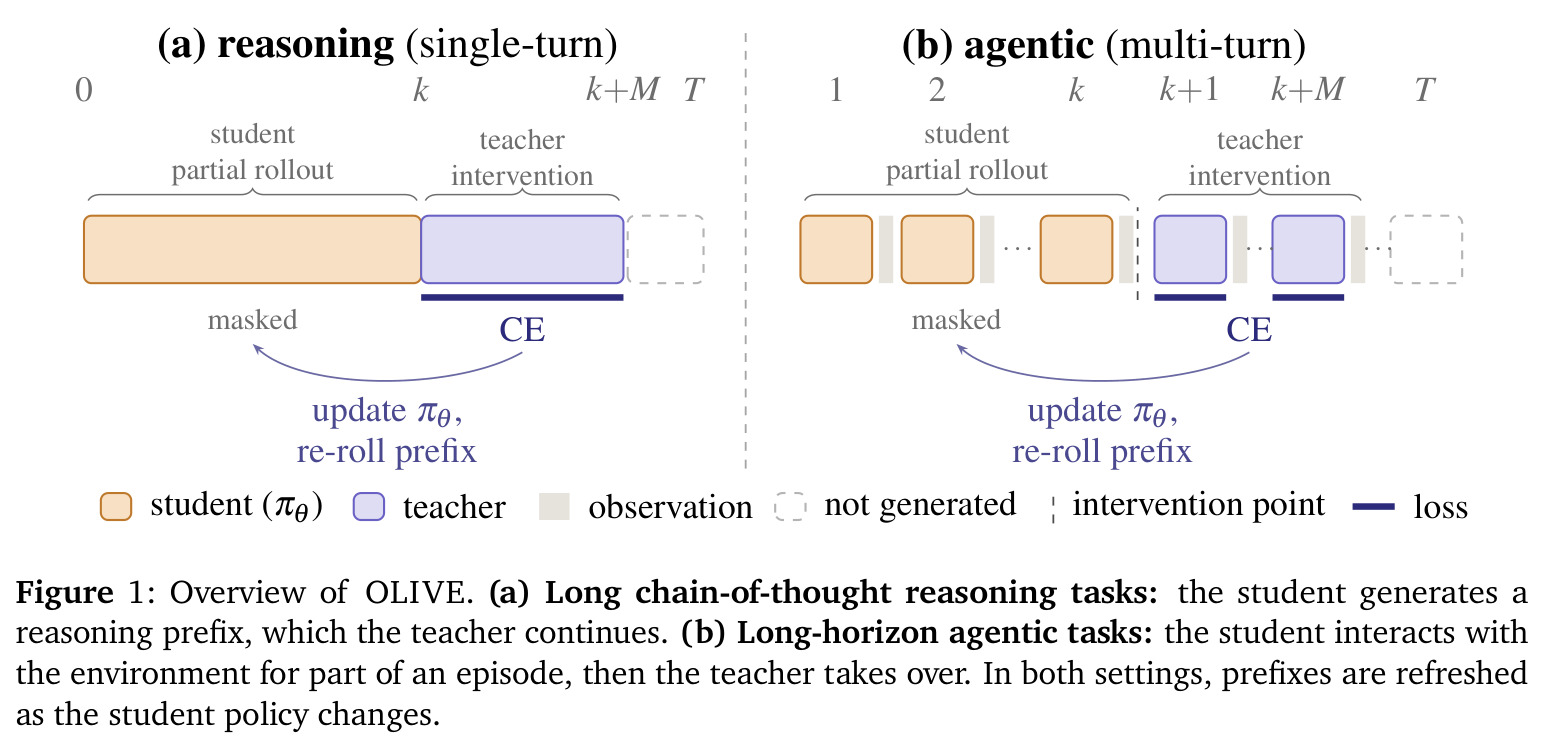
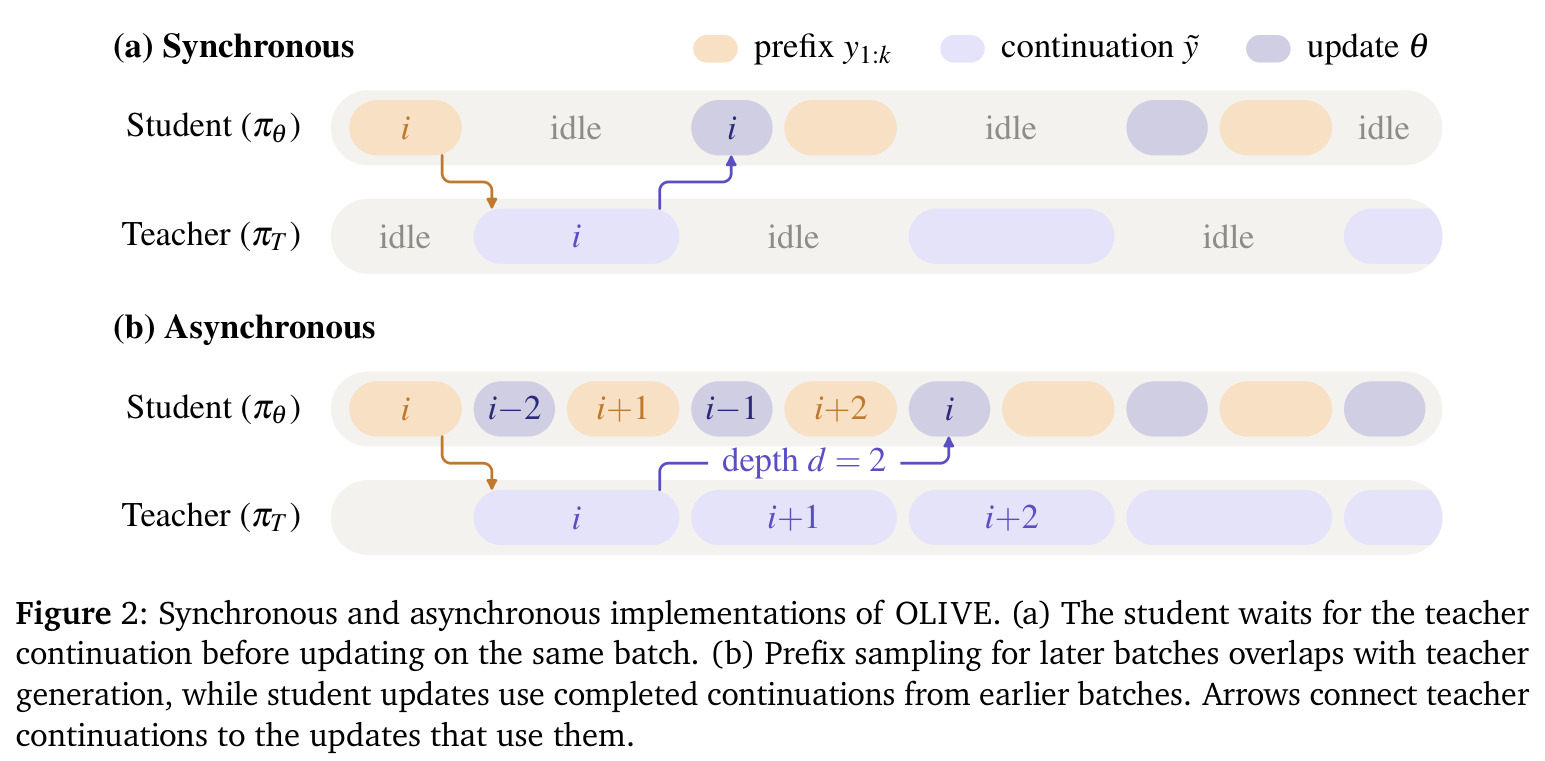
直觉上,OLIVE 像一位不打分、而是“接管方向盘”的教练:学生先按自己的方式做一段(生成 $k$ 个 token 的前缀 $y_{1:k}$,或多轮任务中交互 $k$ 轮),教师随即从该状态自回归续写至多 $M$ 个 token(多轮则 $M$ 轮)$\tilde{y}\sim\pi_T(\cdot\mid x,y_{1:k})$,学生只在教师生成的 token 上计算交叉熵并更新,前缀与提示仅作条件、被 mask 掉。损失为 $$\mathcal{L}(\theta;x,y_{1:k},\tilde{y}_{1:\ell})=-\sum_{j=1}^{\ell}\log \pi_\theta(\tilde{y}_j\mid x,y_{1:k},\tilde{y}_{<j})$$ 其中教师续写用学生 tokenizer 重编码为长度 $\ell$ 的序列。每步迭代为“在线采前缀→教师续写→后缀 CE 更新”,随后立即重采新前缀,使监督始终跟随正在变化的策略。多轮版本把 token 换成轮次:学生交互 $k$ 轮留下动作与观测历史,教师以完整历史为条件接管至多 $M$ 轮并在环境中执行动作;更新时 mask 学生轮次与所有观测,只对教师动作算 CE。为减少等待,异步实现让学生在教师为当前批生成续写的同时并行采下一批前缀,用陈旧度上限 $d$(推理实验取 $d=3$)约束前缀来源策略与被更新策略的失配。
核心创新是“在学生状态处由教师续写接管”这一监督放置方式及其在线滚动。与 OPD 的本质区别:OPD 在学生的 rollout 上逐 token 算教师分布的反向 KL,属于“给过去打分”——即使教师建议在某一 token 改写,其后的目标仍条件在学生原来的续写上,永远没有示范“按修正走之后会怎样”;OLIVE 让续写完全由教师自回归生成,后续每个 token 都条件在教师自己前面的选择上,因此只要前缀尚可挽回,监督就能直接演示如何完成修正。与离线 SFT/OEC 的本质区别:SFT 在固定教师轨迹上训练,前缀与被更新策略脱节;OEC 虽用学生前缀但来自一次性采集的初始策略并需过滤;OLIVE 每次迭代都从当前策略重采前缀(DAgger 式刷新),因此离线蒸馏平台期后仍能继续进步、更好地保持可塑性。此外,监督仅为教师文本上的 CE:不需要教师 logits,不需要完整可验证的解答(部分续写即可),配合学生 tokenizer 重编码,实现跨 tokenizer 的黑盒蒸馏。
方法步骤详情
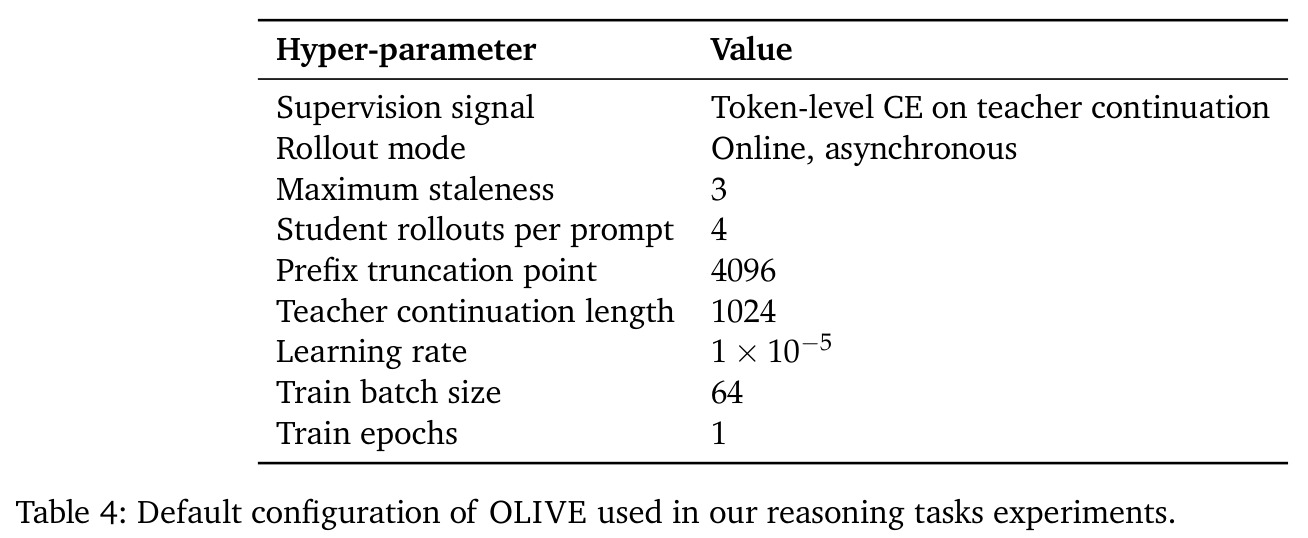
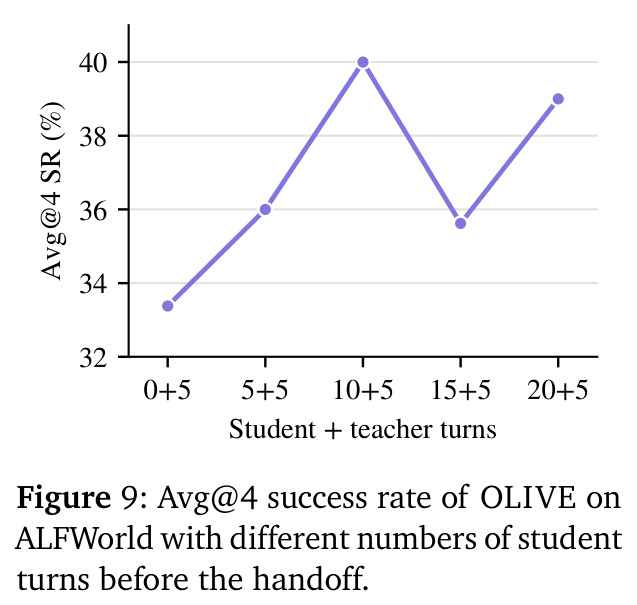
算法 1 每个训练步执行:(1) 从提示分布 $\mathcal{D}$ 采样 $x$;(2) 在线 roll-in:学生自回归采样 $k$ token 前缀 $y_{1:k}\sim\pi_\theta(\cdot\mid x)$,推理任务默认 $k=4096$;(3) 教师续写:教师以 $(x,y_{1:k})$ 为条件、在自己 tokenizer 下生成至多 $M$ token 的 $\tilde{y}$,推理任务 $M=1024$,无需验证器或完整解答;(4) 更新:用学生 tokenizer 把 $\tilde{y}$ 重编码为 $\tilde{y}_{1:\ell}$,把 $(x,y_{1:k},\tilde{y}_{1:\ell})$ 整体输入学生,仅对教师 token 计算式 (1) 的掩码 CE,采样内容在更新期间冻结;每 rollout 蒸馏 token 预算 7168 与基线对齐。多轮版本中 $k,M$ 按轮计:长任务(ALFWorld/ScienceWorld)取 $k=10$ 个学生轮、短任务取 $k=5$,教师接管 $M=5$ 轮,动作按 ReAct 格式生成并在环境中执行得到下一观测。异步版本:教师为第 $i$ 批续写时学生并行采第 $i+1$ 批前缀,用于更新的迹可能来自最多 $d=3$ 步之前的策略;所有前缀不过滤、全部保留。
技术新颖性
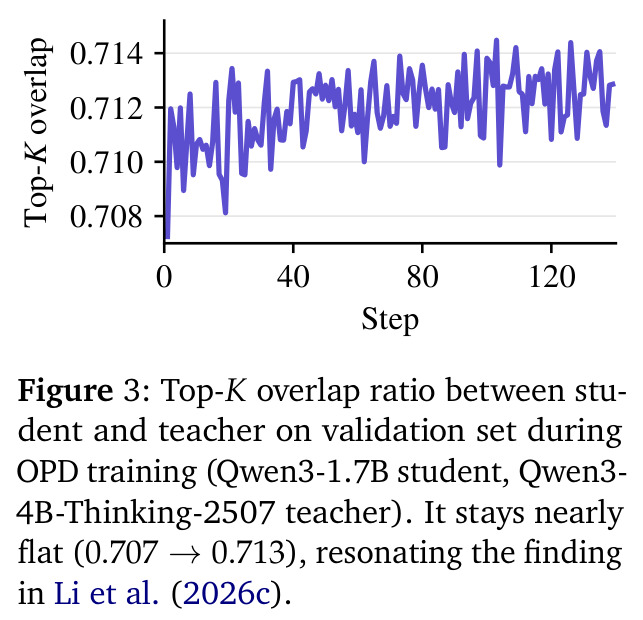
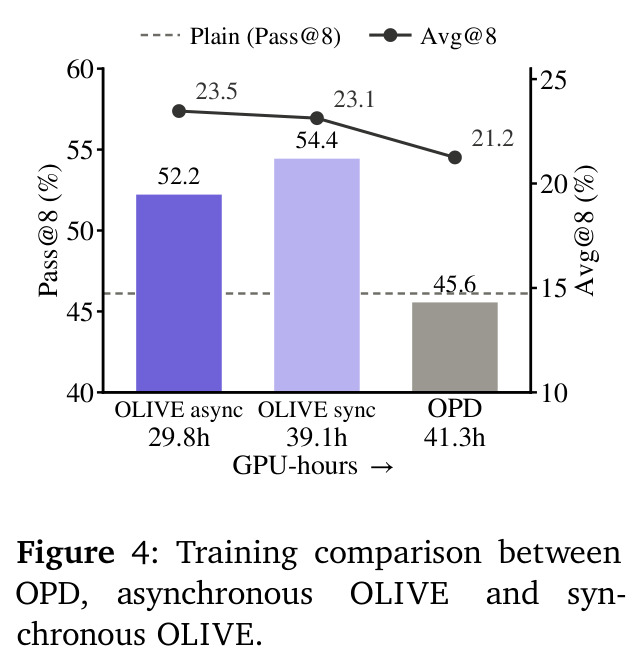
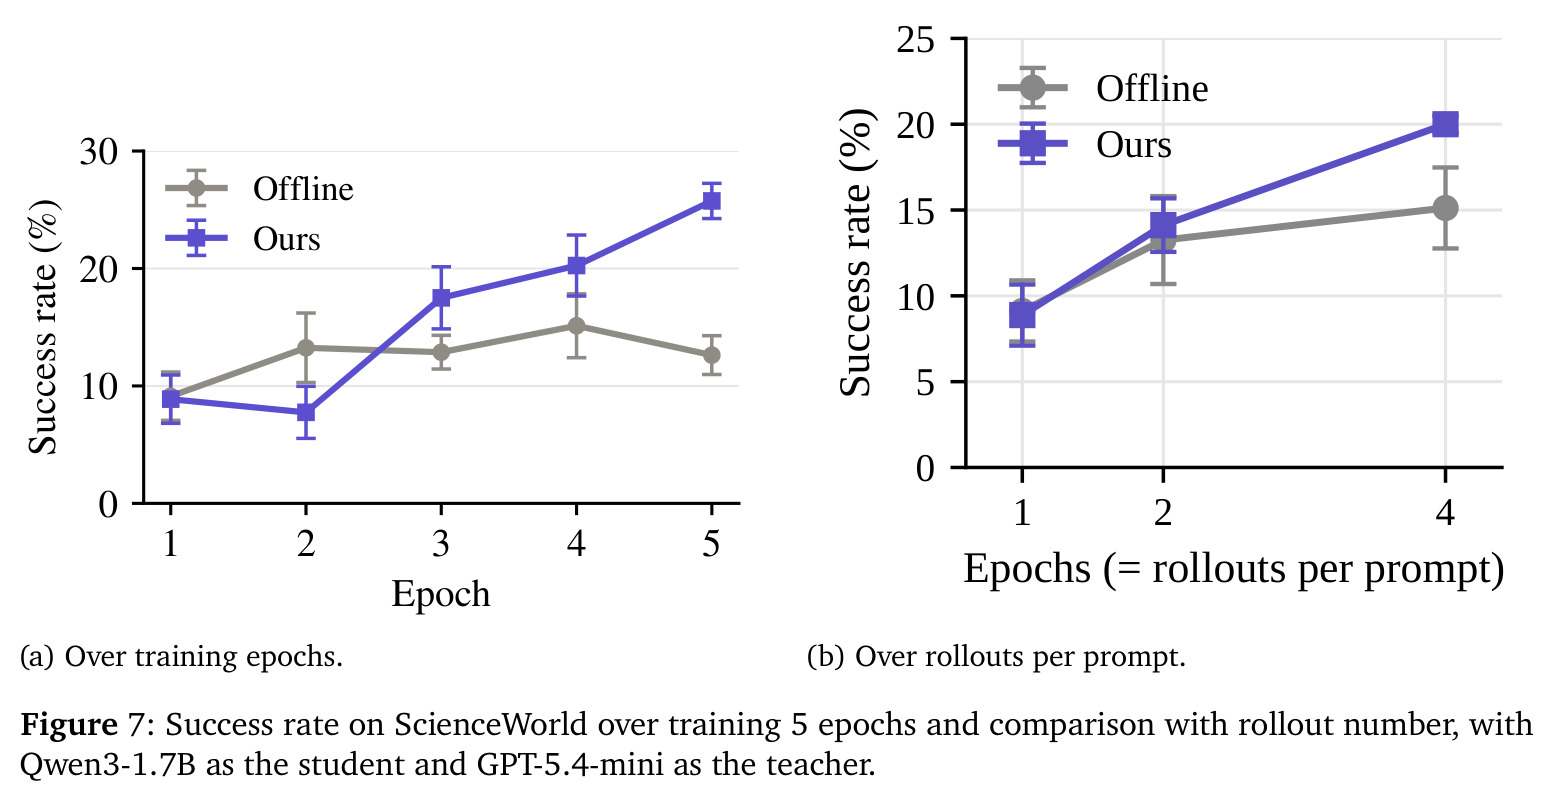
新颖性体现在三点耦合的设计。第一,“部分续写”是有意的成本设计:教师只续写 $M$ 个 token(1024,约为前缀 4096 的四分之一),不必完成整条思维链,却能在同等 GPU 小时下胜过要完成全 rollout 的 OPD——说明监督的价值来自放置位置而非长度。第二,文本接口带来通用性:续写经学生 tokenizer 重编码后做 CE,使 GPT-5.4-mini 这类黑盒模型可以当教师,这是 logit 级 OPD 与 KL 蒸馏原理上做不到的;论文用其在 ScienceWorld 上 5 个 epoch 反超离线 SFT 13% 加以验证。第三,异步系统工程:借鉴异步 RL(A3C/IMPALA 一脉),用陈旧度 $d$ 显式权衡并行度与策略失配,把总训练时间比同步版缩短 23.8%(39.1h→29.8h)、比 OPD 缩短约 28%(41.3h→29.8h),性能几乎无损(pass@8 54.4 vs 52.2)。论文还用 Fig. 3 显示 OPD 训练中学生-教师 top-K 重叠率几乎不动(0.707→0.713),从分布层面佐证打分式监督的局限。
实验结果
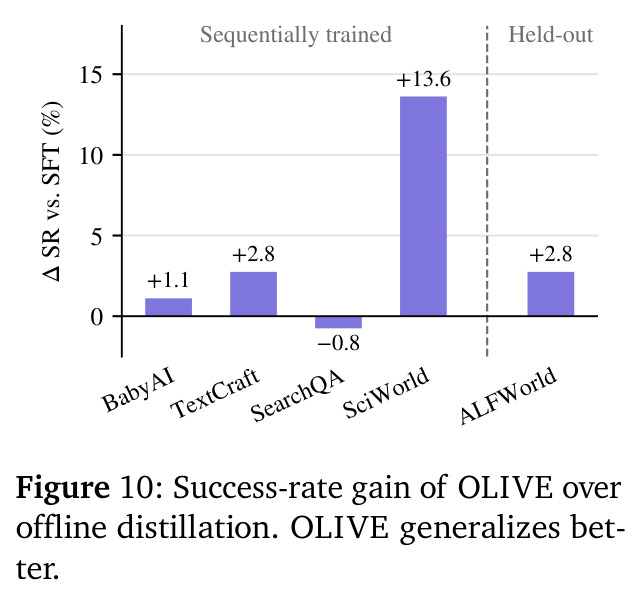
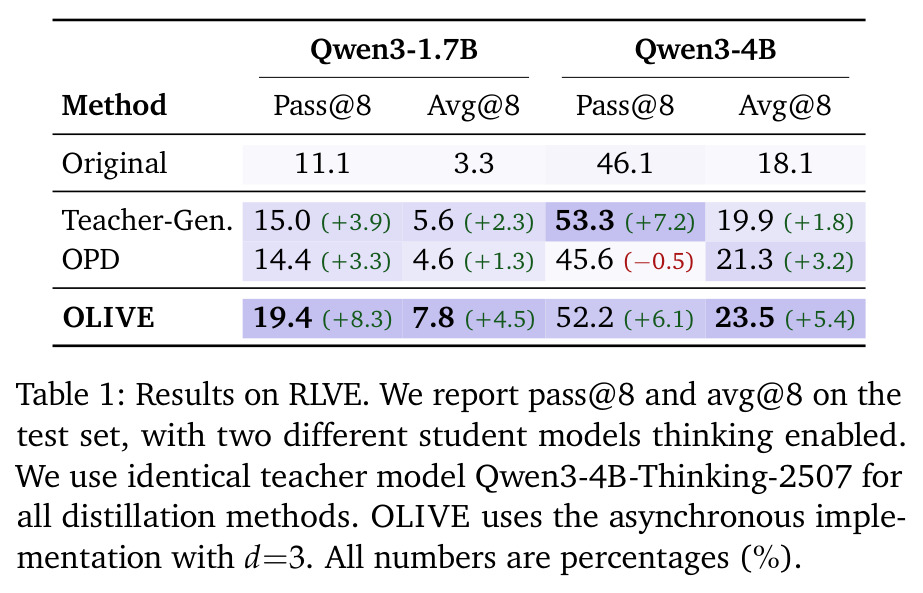
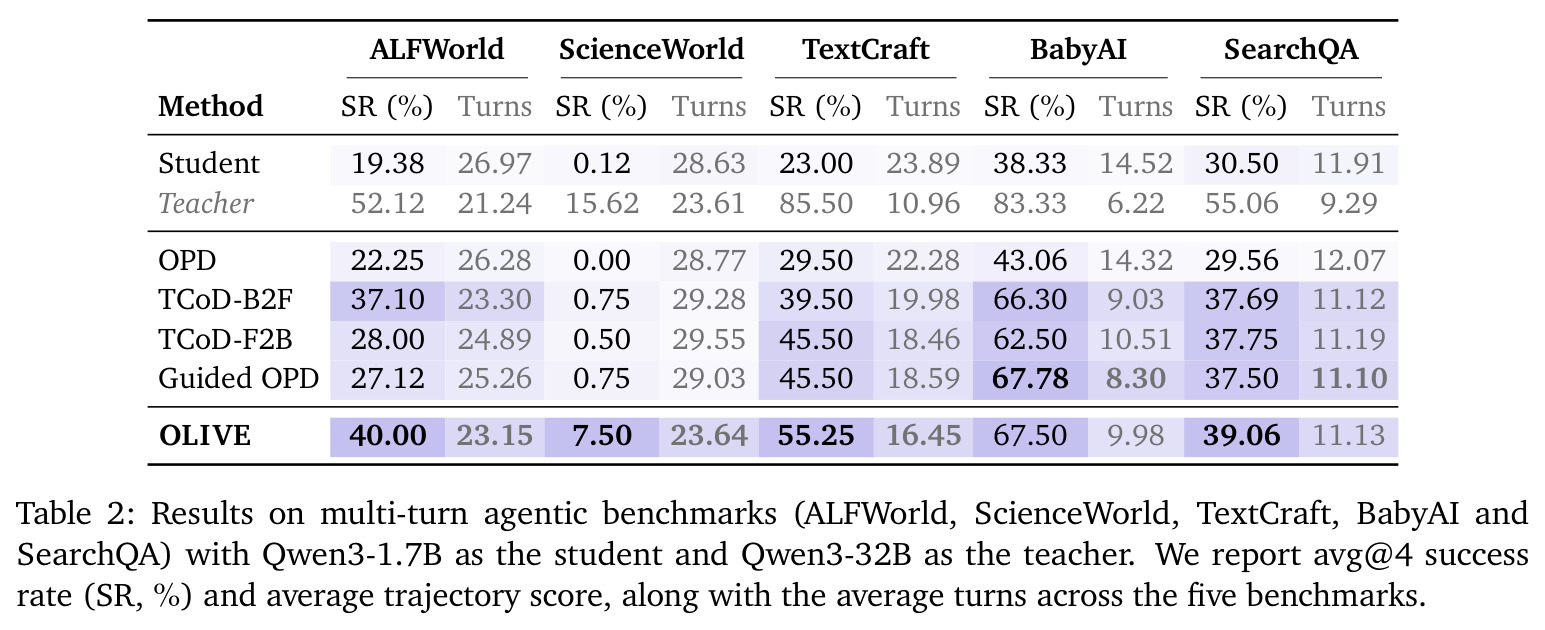
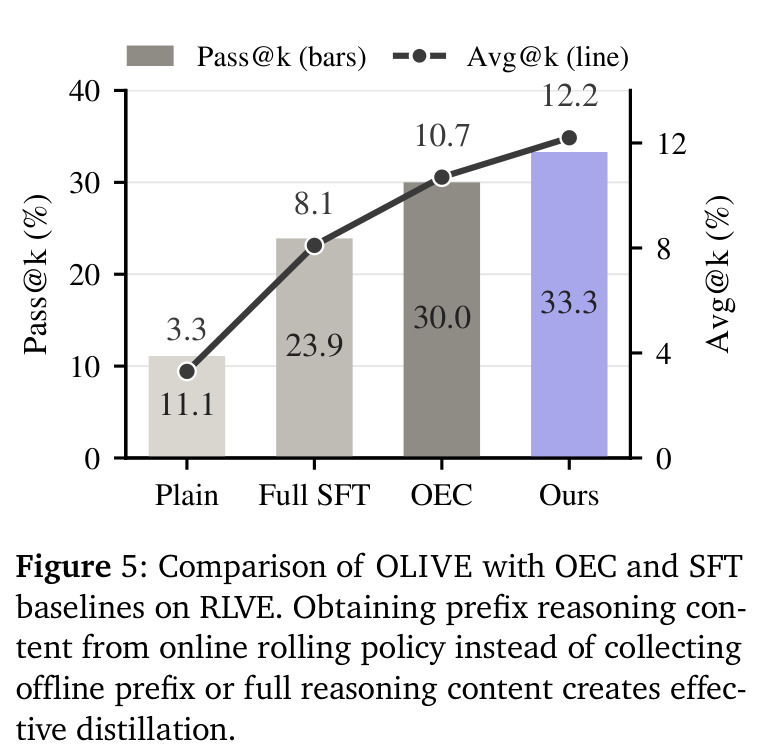
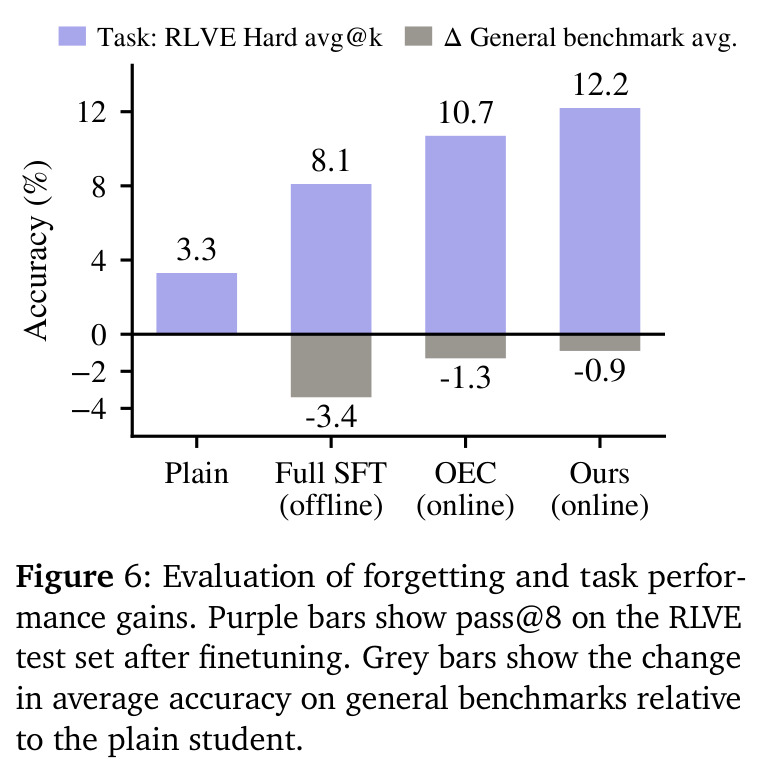
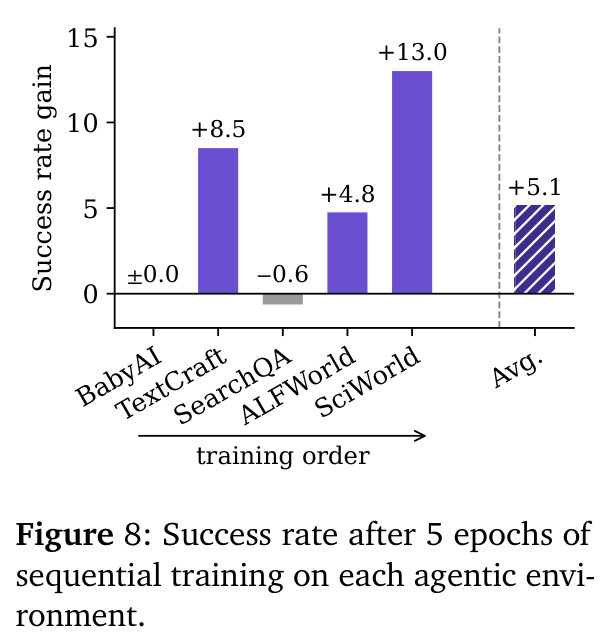
四大块结论。(1) 推理(Table 1,教师统一为 Qwen3-4B-Thinking-2507,预算对齐 7168 token/rollout):Qwen3-1.7B 学生上 OLIVE 达 pass@8 19.4/avg@8 7.8,较原始 11.1/3.3 提升 +8.3/+4.5,明显高于教师轨迹 SFT(15.0/5.6)与 OPD(14.4/4.6);Qwen3-4B 学生上达 52.2/23.5,较原始 46.1/18.1 提升 +6.1/+5.4,而 OPD 的 pass@8 反而降 0.5。(2) 多轮智能体(Table 2,1.7B 学生 + Qwen3-32B 教师,avg@4 SR):OLIVE 在 ALFWorld 40.00、ScienceWorld 7.50、TextCraft 55.25、BabyAI 67.50、SearchQA 39.06;除 BabyAI 与 Guided OPD(67.78)持平外全面领先。最大亮点是 ScienceWorld:OPD 为 0.00,OLIVE 把近乎为零的学生(0.12)提到 7.50,且平均轮次更少(TextCraft 16.45 轮 vs 学生 23.89)。(3) 效率(Fig. 4,8×H200):异步 OLIVE 29.8h/pass@8 54.4/avg@8 23.5,同步 OLIVE 39.1h/52.2/23.1,OPD 41.3h/45.6/21.2;异步比同步省 23.8%、比 OPD 省约 28%。(4) 分析(Fig. 5–8):在线前缀优于离线——RLVE Hard avg@k 10.7 vs OEC 8.1、Full SFT 4.0;通用能力仅降 0.9%(Full SFT 约 −3.4%);黑盒教师 GPT-5.4-mini 下离线蒸馏 2 epoch 平台化,OLIVE 5 epoch 后领先 13%;顺序学 5 个环境时 OLIVE 各环境增益 +4.8~+13.0(SciWorld +13.0 最大),平均 +5 左右,离线平均 ±0.0/−0.6。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| RLVE 硬推理(Qwen3-1.7B 学生) | pass@8 / avg@8 (%) | OLIVE 19.4 / 7.8 | OPD 14.4 / 4.6;教师轨迹 SFT 15.0 / 5.6;原始学生 11.1 / 3.3 | 较原始学生 +8.3 / +4.5,pass@8 超 OPD 5.0 点 |
| RLVE 硬推理(Qwen3-4B 学生) | pass@8 / avg@8 (%) | OLIVE 52.2 / 23.5 | OPD 45.6 / 21.3;教师轨迹 SFT 53.3 / 19.9;原始学生 46.1 / 18.1 | 较原始学生 +6.1 / +5.4;avg@8 超 OPD 2.2 点 |
| ScienceWorld 多轮智能体(1.7B 学生 / 32B 教师) | avg@4 成功率 (%) | OLIVE 7.50 | OPD 0.00;TCoD-B2F 0.75;原始学生 0.12;教师 15.62 | 约为最强在线基线的 10 倍,收回近半师生差距 |
| ALFWorld 多轮智能体 | avg@4 成功率 (%) | OLIVE 40.00(23.15 轮) | OPD 22.25;TCoD-B2F 37.10;原始学生 19.38;教师 52.12 | 较学生翻倍以上,超最强在线基线 2.9 点 |
| TextCraft 多轮智能体 | avg@4 成功率 (%) | OLIVE 55.25(16.45 轮) | OPD 29.50;Guided OPD 45.50;原始学生 23.00;教师 85.50 | 较 Guided OPD +9.75,且用轮更少 |
| BabyAI 多轮智能体 | avg@4 成功率 (%) | OLIVE 67.50 | Guided OPD 67.78;OPD 43.06;原始学生 38.33 | 与最强基线基本持平(−0.28),远超学生 +29.17 |
| SearchQA 多轮智能体 | avg@4 成功率 (%) | OLIVE 39.06 | OPD 29.56;TCoD-F2B 37.75;原始学生 30.50 | 较 OPD +9.50,超最强变体 +1.31 |
| 训练效率(RLVE,8×H200,Qwen3-4B) | GPU 小时 / pass@8 / avg@8 | 异步 OLIVE 29.8h / 54.4 / 23.5 | 同步 OLIVE 39.1h / 52.2 / 23.1;OPD 41.3h / 45.6 / 21.2 | 比 OPD 省约 28% 时长且 pass@8 高 8.8 点;比同步版省 23.8% |
| ScienceWorld 黑盒教师(GPT-5.4-mini,5 epochs) | 成功率相对离线 SFT | OLIVE 持续上升并反超 | 同教师离线 SFT(2 epoch 后平台化) | 5 epoch 后领先离线 SFT 13 个百分点 |
局限与改进
作者承认或可从文中读出的局限。(1) 异步引入策略陈旧:靠陈旧度 $d$ 权衡,实验中损失极小(avg@8 23.5 vs 23.1,pass@8 反而 54.4>52.2),但在策略快速变化或更大 $d$ 下风险未验证。(2) 教师只接管 $M$ 个 token/轮,不产出完整可验证解答;若学生前缀已不可挽回(如 ScienceWorld 早期动作即错),续写的示范价值有限,方法没有筛选或检测“前缀可挽回性”的机制,且推理实验中所有前缀不加过滤全部保留。(3) 实验规模有限:学生仅 Qwen3-1.7B/4B,教师仅 Qwen3 系列加一个 API 模型;智能体评测 avg@4、SearchQA 仅 400 题留出集,未报告置信区间;BabyAI 上以 67.50 微弱落后 Guided OPD 的 67.78。(4) 通用能力仍有 0.9% 平均下降,未做到零遗忘。(5) 关键超参 $k$、$M$、$d$ 均为经验设定,缺乏自适应机制;论文自述 ongoing work,亦无理论分析支撑。
独立分析的弱点
独立分析几点弱点。(1) 无差别续写浪费教师算力:对已不可挽回的前缀,教师续写产生低价值监督;改进方向是用轻量值估计器或教师续写困惑度做前缀门控,或按学生当前成功率自适应调整 $k$。(2) CE 对教师所有 token 等权:续写中同样有平庸甚至错误 token,缺少置信加权;改进是结合教师概率(可得时)或多次续写 + 验证器自洽过滤——论文 §5.1 其实已用 4 次续写过滤的变体,说明与验证器结合空间很大。(3) 陈旧度 $d=3$ 固定:训练初期策略变化快,陈旧迹价值低;改进是按策略参数漂移量动态触发重采或调整 $d$。(4) 学生侧开销仍大:异步只掩盖等待,自采 4096 token 前缀本身昂贵;可做前缀长度退火(初期短前缀多干预、后期放长)。(5) 未与 RL 结合对比:教师续写天然是 off-policy 演示数据,可与 PPO/GRPO 混训而非互相替代。(6) 缺少接管点位置与 $M$ 的系统消融,读者难以判断监督收益对“教师接管比例”的敏感度。
未来方向
作者层面:把 OLIVE 规模化并发布代码(项目页 dylanzsz.github.io/olive/),在更真实的智能体环境(超越 AgentGym)与更多闭源 API 教师上验证。可延伸方向:(1) 学习化干预调度——用价值模型或不确定性估计自动选择接管点与 $k/M$,把“教师何时接管”变成可学习决策;(2) 与强化学习混训——把教师续写作为 off-policy 演示注入 GRPO/PPO 的经验回放,加速探索并稳定训练;(3) 理论化——对滚动前缀下的协变量偏移、陈旧度 $d$ 与收敛性给出界;(4) 多教师路由——按状态专长在不同教师间切换接管,或推广到视觉-语言与具身智能体;(5) 系统优化——教师侧投机解码、前缀缓存进一步压缩异步版 29.8h 的开销;(6) 自修正结合——让学生先生成多个候选修正再由教师裁决,缓解不可挽回前缀问题;(7) 遗忘机制细化——分析为何在线前缀能少遗忘 0.9% vs 3.4%,把“保持可塑性”变成可控旋钮。
复现评估
论文自述 ongoing work,正文未承诺开源代码,仅给出项目页 https://dylanzsz.github.io/olive/,复现目前依赖自建。有利条件是要素齐全:数据全部公开——RLVE 合成推理环境、AgentGym 及其五个子环境(SearchQA 自建 6K 训练集 + 400 留出题);模型公开可得——Qwen3-1.7B/4B 学生、Qwen3-4B-Thinking-2507 与 Qwen3-32B 教师、API 级 GPT-5.4-mini;超参交代详细——前缀 4096、续写 1024、蒸馏 token 预算 7168、$d=3$、多轮 $k=5/10$、$M=5$、epoch 1–3、ReAct 格式、各环境最大轮数 16–30。门槛在于算力:效率实验用 8×H200,且需在线托管教师模型(异步实现可缓解闲置),学生侧自采 4096 token 前缀的推理成本不小。主要难点是异步调度系统工程与 AgentGym 环境搭建;若代码如约发布,整体复现难度中等。
论文图表