SolveEdit:面向生成式模型的视觉问题求解基准 SolveEdit: Benchmarking Visual Problem Solving in Generative Models
让模型看图解题并直接改图:最强生成模型在SolveEdit上也只得57.0分
前置知识
指令式图像编辑
指用户用自然语言描述修改要求,模型接收原图与指令后直接输出编辑后的图像,代表系统包括 FLUX.1 Kontext、Qwen-Image-Edit、GPT-Image 系列等。模型需要理解指令、在图中定位目标区域并重绘,同时保持其余像素内容不变,失败常表现为改错位置或误伤无关物体。
SolveEdit 的被评测对象正是这类图像编辑模型,理解其输入输出形式(图+指令→图)是读懂任务设定、实验协议和结果表的前提。
VLM 评委(基于问答的自动评测)
用视觉语言模型代替人工或单一参考图像来判分:把评分标准拆成一个个原子问题(如“目标车是否停在有效车位内”),让 VLM 逐条作答并给出证据,再由确定性代码聚合。因为开放式编辑存在多种正确输出,这种基于问答的评测比逐像素或嵌入相似度更合适。
SolveScore 的每个原子条件都由 VLM 评委(辅以 SAM、YOLO 等工具)打分,理解这一机制才能正确解读论文的分数含义与可信度边界。
图像到图像与图像到视频生成模型
图到图模型以一张输入图为条件生成新图,分为开源权重(FLUX.2、OmniGen2、BAGEL 等)与商业 API(GPT-Image-2、Seedream 等)两类;图到视频模型(Kling、HunyuanVideo)以图为首帧生成视频。它们架构各异,但都暴露统一的“图+指令”调用接口。
论文在 9 个图到图和 2 个图到视频模型上用同一契约比较完成度与破坏度,并测试规划方法能否经指令接口跨模型迁移。
测试时规划(test-time planning)
指在推理阶段不改动模型权重,而是在调用生成模型之前先做显式中间推理:观察图像、提取未定变量、比较候选方案、生成更精确的指令。典型形式是智能体工作流,用额外的 LLM 调用换取更高质量的最终输出,属于“用推理时计算换能力”的路线。
SolveEdit-Plan 正是一个两阶段测试时规划器(Inspect + Resolve),论文用它来验证“先确定变换再生成”这一诊断假设是否成立。
SAM 与 YOLO 感知工具
SAM(Segment Anything Model)是通用图像分割基础模型,给定点或框提示即可输出目标的像素级掩码;YOLO 是实时目标检测器,输出目标边界框与类别。两者可为“物体是否出现在指定位置”“数量是否正确”等判断提供比 VLM 更客观的几何证据。
论文把部分原子判分条件预先固定分配给这两个专用检查器,以保证评测中空间与计数类判断的客观性,是理解评测管线的关键细节。
研究动机
现有评测把机器智能的各个环节割裂开来。指令式编辑基准在提示里把要做的修改说得明明白白,模型只需执行“把 P2 和 P3 用黄线连起来”这类已声明的操作;较新的图到图基准虽补充了时序、因果、空间、逻辑、规划等任务类型,却没有区分“要做的变换究竟从哪里来”,导致执行明确变换与推断未知变换被混在一起计分。这带来两个具体问题:其一,模型可以靠套用熟悉的编辑模式拿分,而不必推断当前场景真正需要什么改动——就像背熟模板的学生换一道题就不会做;其二,传统基于单一参考图的打分会惩罚合理但与作者答案不同的有效解,例如“修复电路”的接通方案不止一种,只对照一张参考图会误判。而真实世界的问题大多是视觉的:整理物品布局、修复平面图、按规则分类物品,都要求理解场景、推断该改什么、执行改动且不破坏无关内容,这一“目标驱动的视觉问题求解”恰恰缺少专门评测。
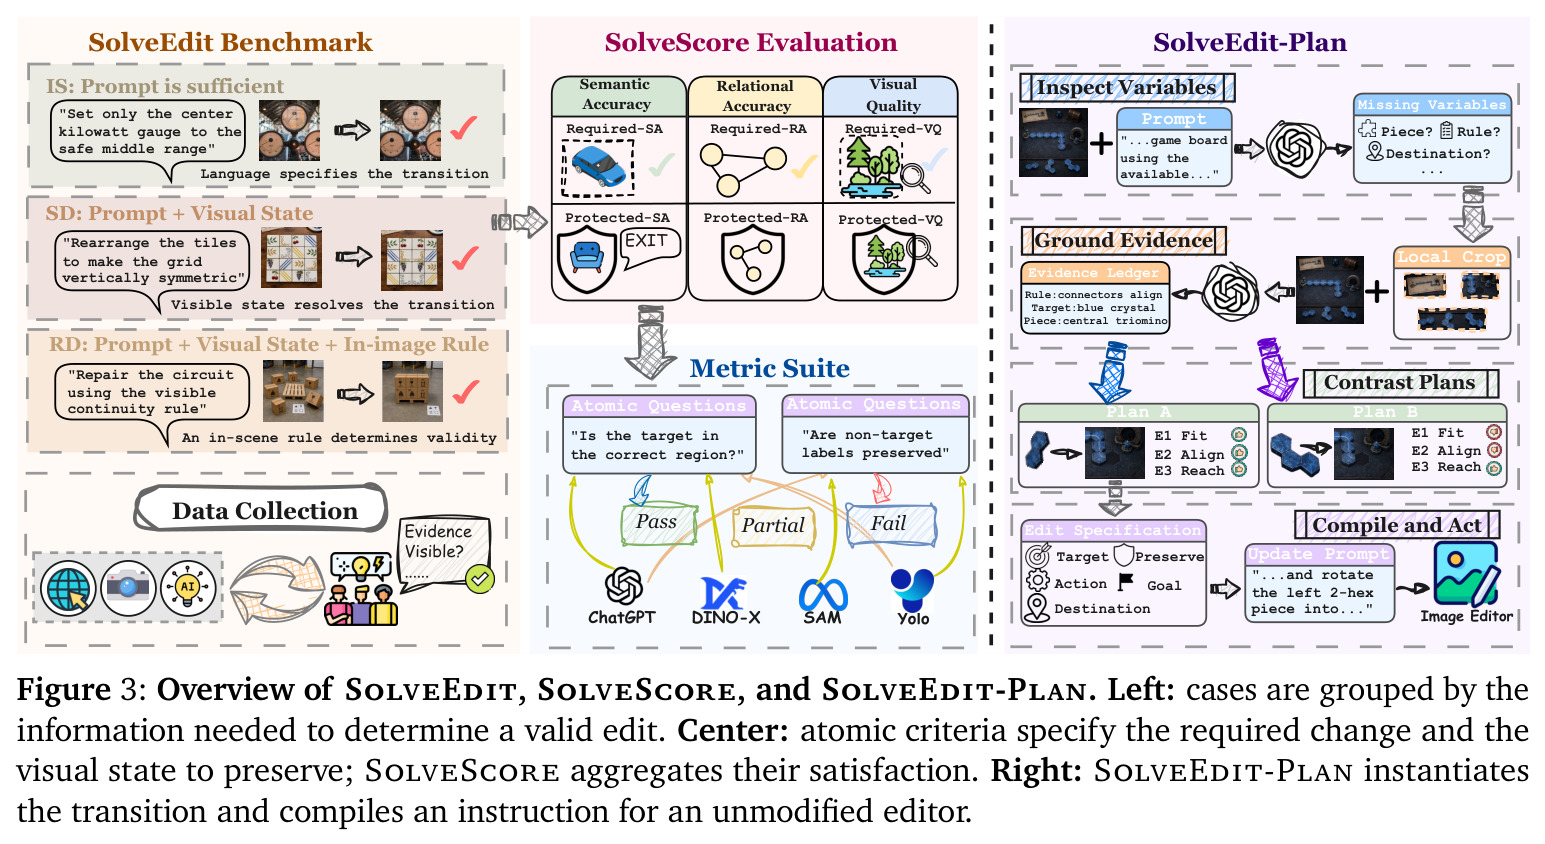
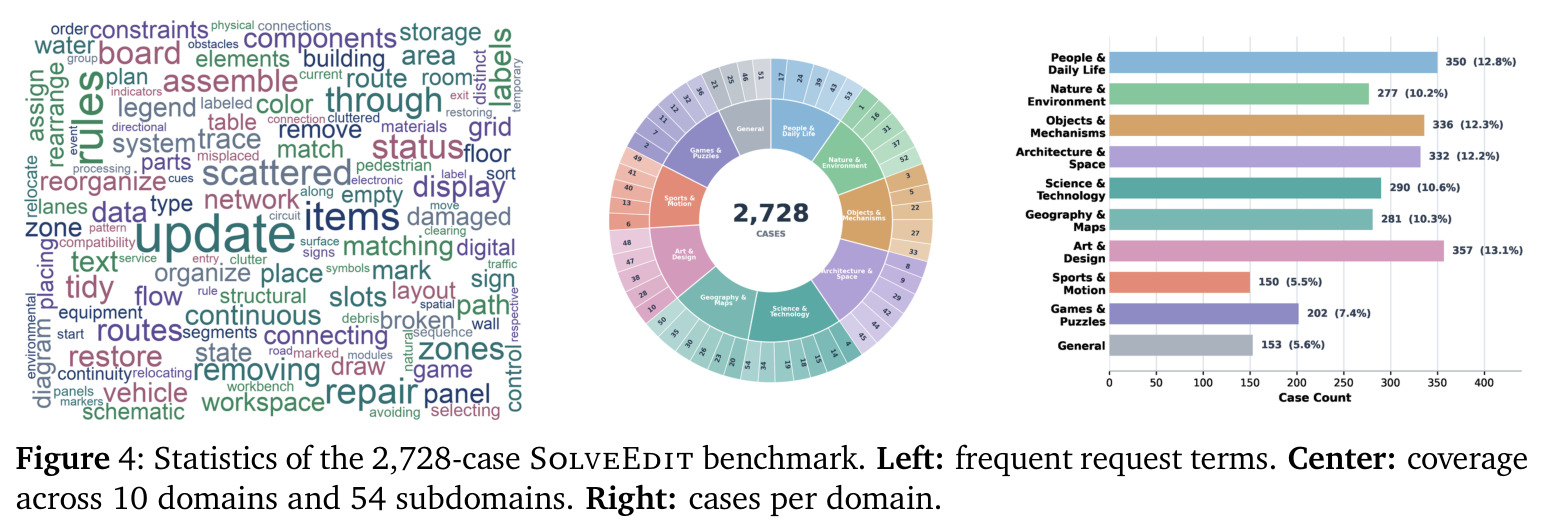
本文的目标是论文要回答的核心问题是:生成模型能否从源图像和目标出发,自主确定一个有效的视觉变换,并在同一场景中把它实现出来?具体目标分三层。第一,提出“通过场景变换进行视觉问题求解”的任务形式化:给定图像和目标请求,正确答案不是一张固定参考图,而是一个可满足变换的集合;第二,构建 SolveEdit 基准,包含 2,728 个案例、覆盖 10 个应用领域和 54 个子领域,并按“决定变换的信息来源”把案例分为指令指定(IS)、状态依赖(SD)、规则依赖(RD)三种情形,使指令遵循、场景理解和规则推断在同一生成任务内被分开计量;第三,设计无需单一参考输出的契约式评测 SolveScore,区分“必须完成的”与“必须保护的”,对 9 个图到图模型和 2 个图到视频模型做系统诊断,并用 SolveEdit-Plan 干预实验验证失效根因。
与已有工作不同的是,本文最独特的切入角度是把“变换信息的来源”本身变成一条显式评测轴。同一个空间操作,取决于什么决定了它的正确结果,可落入三种情形:提示写明的(IS,如“抹掉接地标记”)、由可见场景状态决定的(SD,如“把积木放进唯一的空槽”)、由图内规则决定的(RD,如“按图中图例给碎片排序”)。这条轴与内容领域、任务类型正交,使论文能定量回答“模型缺的是解题能力还是执行能力”。第二个独特设计是原子变换契约:每个案例用若干“必须完成”的要求条件与“必须保护”的保护条件刻画正确性,允许多个有效终态共存,用有界扣分处理误伤,摆脱对单一参考图的依赖。第三,论文把失败显式拆成“方案恢复错误”(选错该做什么)与“视觉执行错误”(想做但画不对),并用同一契约给图像编辑和视频终帧打分,实现跨模态可比。
核心方法
直觉上,看图解题应分两步:先想清楚该做什么变换,再把变换渲染出来;现有模型把两步揉在一次生成里,导致看似合理的图像掩盖了错误解。形式化地,设输入图为 $I$、请求为 $x$,直接写 $Y=f(I,x)$ 会把满足请求的编辑规格 $z$(涉及实体、动作、终态、保护范围)隐藏起来。论文显式引入可满足变换集合 $Z^*(I,x)=\Phi(x, B(I,x), K, S(I), R(I))$,其中 $B$ 是请求到实体的绑定,$K$ 是背景知识,$S(I)$ 是当前场景事实,$R(I)$ 是图内规则(图例、约束、重复模式);输出 $Y$ 合法当且仅当它实现了某个 $z\in Z^*(I,x)$ 且保护了其余内容。每个案例存储为 $c=(I,x,m,C_{req},C_{pro},A)$,配原子契约计算 SolveScore。诊断显示解题(方案恢复)而非渲染是主要瓶颈后,论文提出 SolveEdit-Plan:两阶段测试时规划器,先 Inspect 找出请求未定死的变量并定向取视觉证据,再 Resolve 比较候选变换并编译成编辑指令,交给完全不改动的原编辑器一次性生成。
核心创新有二。其一是“变换来源”评测轴与原子契约:与指令编辑基准把修改写进提示不同,SolveEdit 的提示只给目标,模型必须自行推断变换;与基于参考图的评分不同,契约把正确性写成独立的原子断言——要求条件与保护条件跨越语义准确(SA:实体、计数、文字、符号、内在状态)、关系准确(RA:位置、次序、包含、连通、拓扑)与视觉质量(VQ:残影、形变、模糊)三类属性,交叉成六个诊断格。完成度 $R=\sum_{q\in C_{req}} w_q a_q$,误伤 $D=\sum_{q\in C_{pro}} u_q(1-a_q)$,总分 $\mathrm{SolveScore}_\lambda = G_{quality}\,\max(0, R-\lambda D)$,主协议取 $\lambda=0.5$。其二是 SolveEdit-Plan:与普通提示词优化有本质区别——它显式枚举未定变量(目标、动作、目的地、终态、保护范围),用局部裁剪图取证、对候选变换做对比检验,再把选中的变换连同保护义务编译进指令;对照实验中 Generic Vision Rewrite 使用同样的规划后端和调用预算却只做无约束改写,从而把增益严格归因于结构化变换推断本身。
方法步骤详情
基准构建分三步。第一步,标注者先把请求绑定到图中可见实体,判断绑定后的请求加背景知识是否已固定变换:若是则标 IS;若否,必须找一个场景事实或图内规则来定案,该证据决定 SD 或 RD 标签,标签记录的是固定解所需的最小信息。第二步,记录解题证据、一个或多个可接受终态以及允许改动的范围,案例存为 $c=(I,x,m,C_{req},C_{pro},A)$,可选的参考编辑图只是示例、不参与判分。第三步质检:只有满足“改动可语义检查、证据图内可见、正确性无需对照单一参考、改动可与保护内容分离”四条的案例才保留,近重复场景在切分前先归组。评测时每条判据写成单一可观察断言并附通过与部分通过条件,VLM 评委返回 $a_q\in\{1,0.5,0\}$,证据不足时弃权 $\perp$;SAM 和 YOLO 预先承担固定子集判据,确定性聚合器输出六个诊断分与 SolveScore,生成方全程看不到契约。SolveEdit-Plan 则执行 $(\hat{z},\hat{O},\tilde{x})=H(I,x)$:Inspect 阶段识别未定变量、请求定向裁剪、记录证据账本;Resolve 阶段对比候选变换选出 $\hat{z}$,连同可观察义务 $\hat{O}$ 编译为指令 $\tilde{x}$,最后只调用原编辑器一次 $\hat{Y}=f(I,\tilde{x})$。
技术新颖性
技术新颖性体现在四个层面。任务层:把视觉问题求解定义为场景变换而非文本作答,解题与执行必须同时在线,任何一步缺失都会在契约上露馅。评测层:原子契约加 SolveScore 是对开放终态任务评分的新范式——每个原子断言独立计分、弃权不重分配权重、层级化权限制止拆分刷分,误伤以有界折扣 $\lambda D$ 进入总分,六个诊断格让“语义错、关系错还是画质崩”一目了然;同一契约还能原样给视频终帧打分,实现跨模态可比。组织层:IS/SD/RD 用“固定解所需的最小信息”这一操作性判据划分,与领域和任务类型正交,论文由此能做领域加权后的对照分析,把“规则依赖短板”从领域构成差异中剥离。干预层:SolveEdit-Plan 不训练任何参数、不改编辑器,只在推理期插入两步规划;与同预算同后端的 Generic Vision Rewrite 严格对照,保证 6.3 分的净增益可归因于显式变换推断这一结构,而非更长的提示词。
实验结果
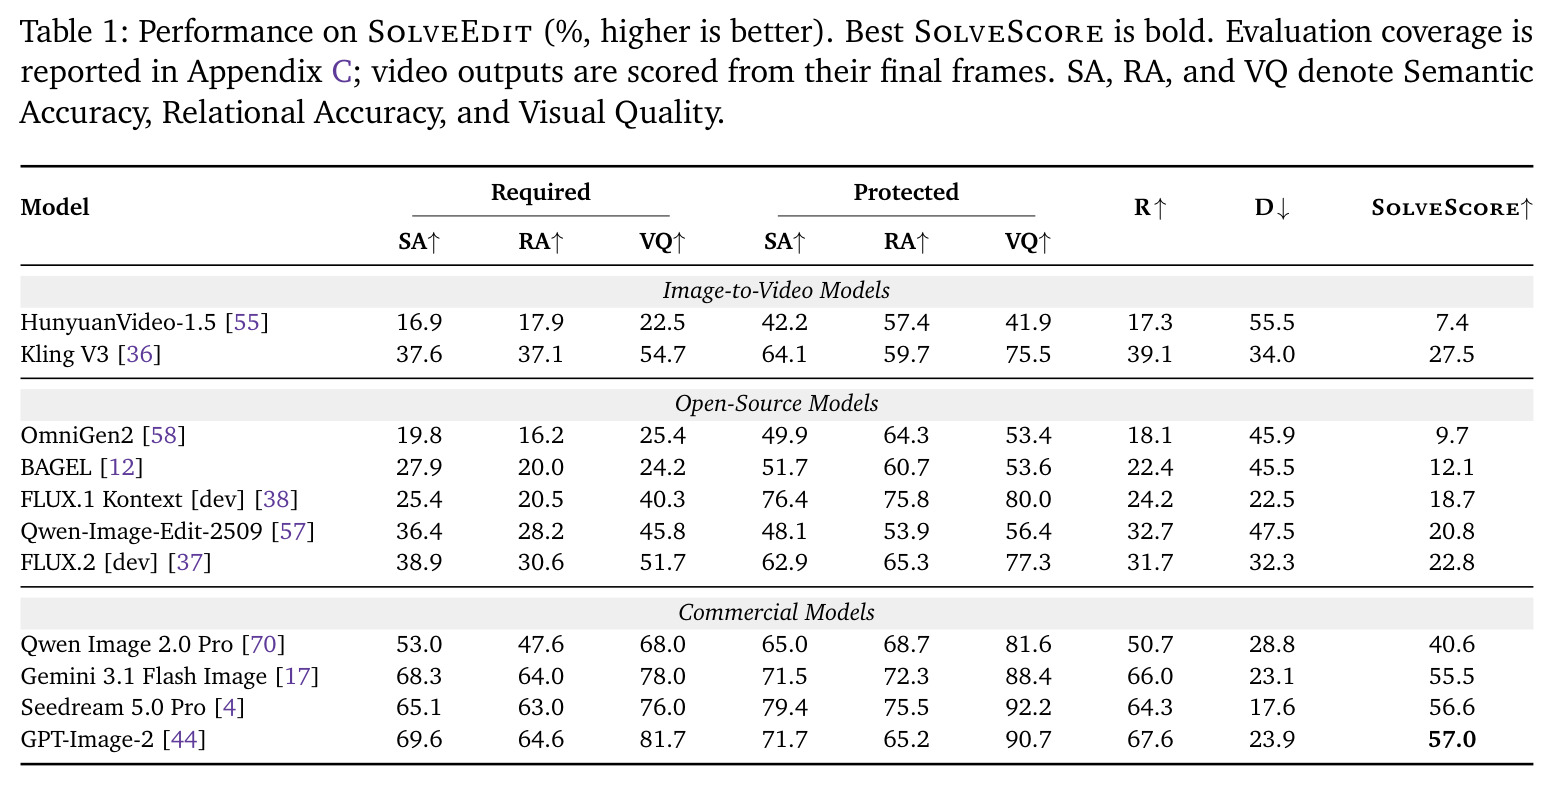
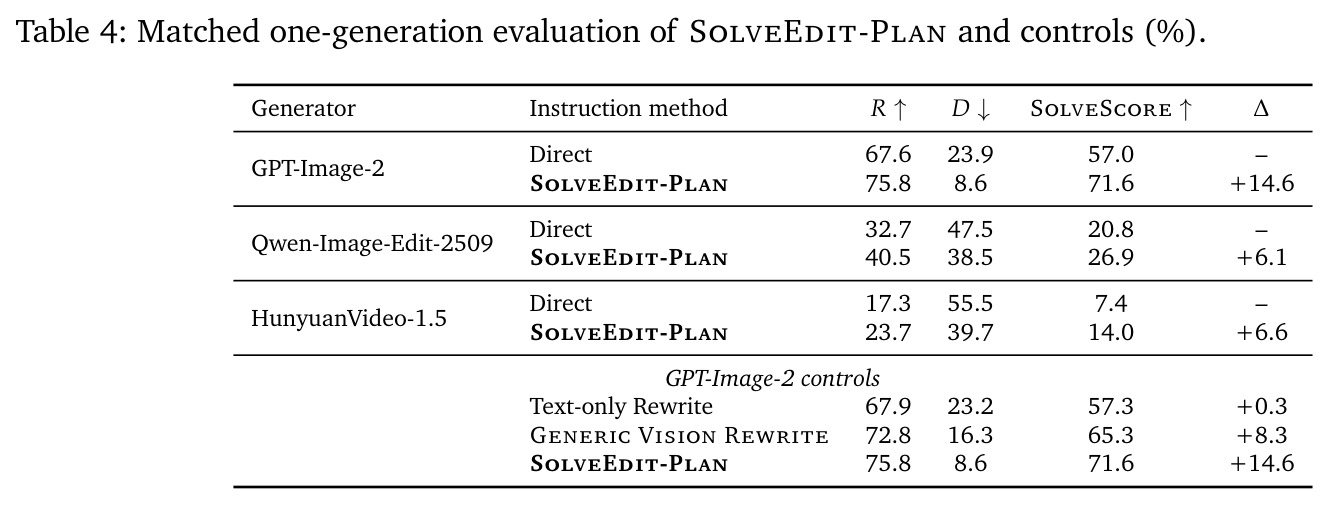
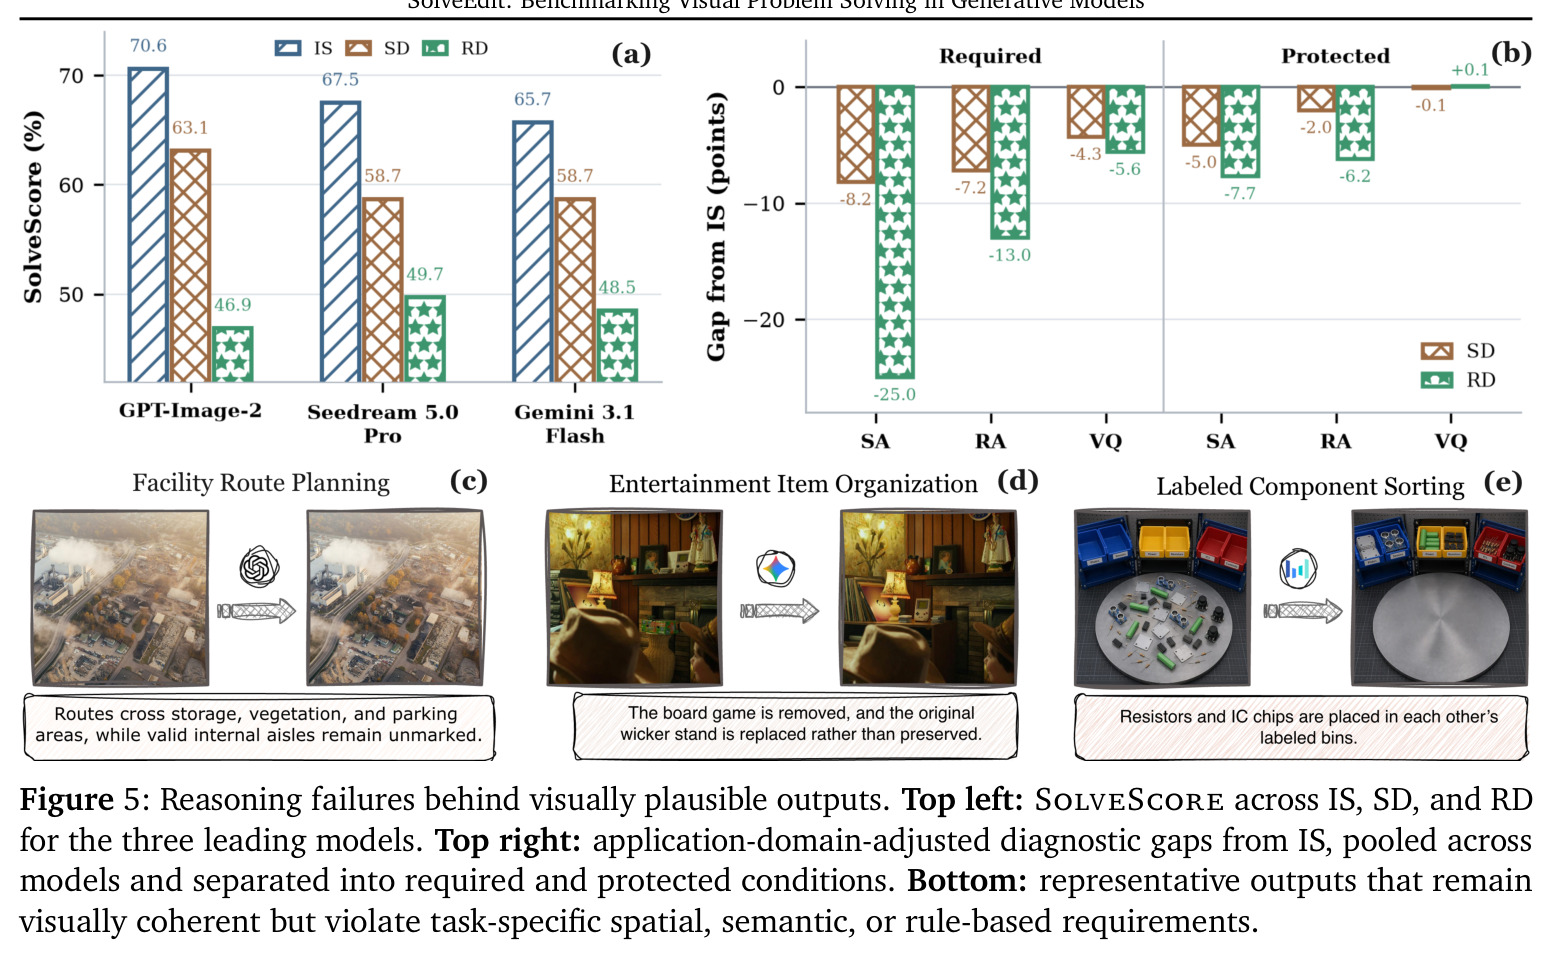
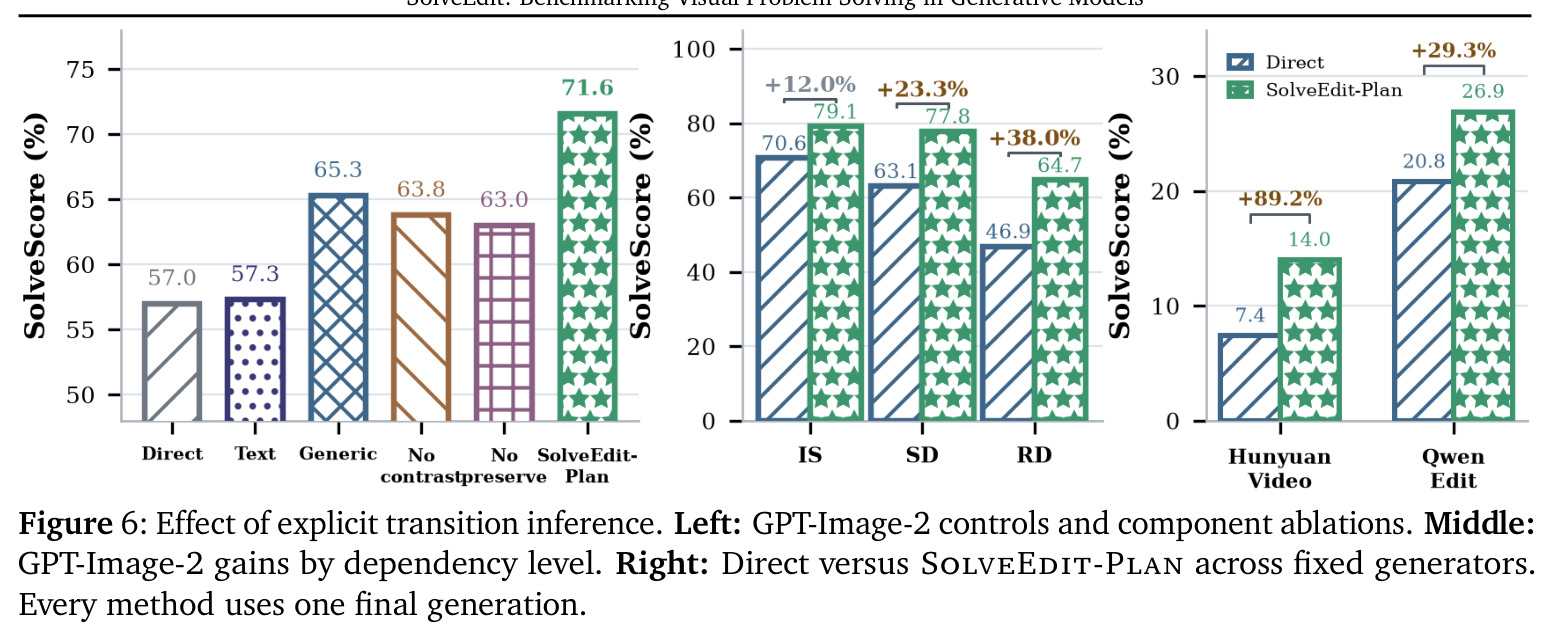
RQ1(模型能解多少):11 个系统中 GPT-Image-2 以 57.0% SolveScore 居首,Seedream 5.0 Pro(56.6%)与 Gemini 3.1 Flash Image(55.5%)紧随其后;商业模型明显领先开源:Qwen Image 2.0 Pro 40.6%,开源最佳 FLUX.2 [dev] 仅 22.8%,Qwen-Image-Edit-2509 20.8%、FLUX.1 Kontext 18.7%、BAGEL 12.1%、OmniGen2 9.7%;视频模型 Kling V3 27.5%、HunyuanVideo-1.5 仅 7.4%。头部三家完成度 R 为 67.6%/64.3%/66.0%,但 GPT-Image-2 误伤 D=23.9% 高于 Seedream 的 17.6%,说明两者靠不同路径追平总分;且三家“要求-视觉质量”均高于“要求-语义/关系”,视觉上说得过去不等于解题成功。RQ2(失败揭示什么):领域加权后 RD 比 IS 低 17.2–23.7 分、SD 低 7.0–8.8 分;缺口集中在要求侧语义(-25.0)与关系(-13.0),视觉质量仅 -5.6,保护侧近乎中性(-7.7/-6.2/+0.1),指向方案恢复是主要失败模式。RQ3(规划是否有用):SolveEdit-Plan 把 GPT-Image-2 从 57.0 提到 71.6(+14.6),比同预算 Generic Vision Rewrite 高 6.3 分,相对该对照 R 从 72.8 升至 75.8、D 从 16.3 降至 8.6;SD/RD 上增益更大;零训练迁移至 Qwen-Image-Edit-2509(20.8→26.9)与 HunyuanVideo-1.5(7.4→14.0)。代价是每例两次 LLM 调用,平均 3,207 输入加 635 输出 token。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 视觉问题求解(SolveEdit 全集) | SolveScore (%) | GPT-Image-2 + SolveEdit-Plan:71.6 | GPT-Image-2 直接编辑:57.0 | +14.6 |
| 预算匹配对照实验 | SolveScore (%) | SolveEdit-Plan:71.6 | Generic Vision Rewrite(同后端同调用预算):65.3 | +6.3 |
| 开源图像编辑器迁移 | SolveScore (%) | Qwen-Image-Edit-2509 + Plan:26.9 | Qwen-Image-Edit-2509 直接:20.8 | +6.1 |
| 视频生成迁移(终帧评分) | SolveScore (%) | HunyuanVideo-1.5 + Plan:14.0 | HunyuanVideo-1.5 直接:7.4 | +6.6 |
| 基准原生榜单(商业 vs 开源) | SolveScore (%) | 最强商业模型 GPT-Image-2:57.0 | 最强开源模型 FLUX.2 [dev]:22.8 | 商业领先开源 34.2 分 |
局限与改进
作者承认的局限:其一,视频仅在终帧上按同一契约打分,时序质量被排除在外,跨模态结论只是互补性研究;其二,开源模型与视频模型绝对分数过低(7.4%–27.5%),迁移实验只能证明方向正确,无法判断残余错误来自规划还是生成;其三,规划有代价——每例两次 LLM 调用和约 3,842 个 token 的额外开销,且调用数相同不代表 token 成本相同;其四,IS/SD/RD 标签刻画信息依赖而非难度,不能把 IS→RD 的分数差直接读作难度递增。我自己的观察:第一,整条评测链依赖 VLM 评委的主观判断,SAM/YOLO 只覆盖预先分配的固定子集,论文未报告评委与人类标注的一致率校准;第二,契约式评分天然偏向离散可核查的改动(位置、计数、文字、连通性),光照、质感等写实类编辑可能被系统性低估;第三,基准是静态公开的 2,728 个案例,长期存在被训练数据污染的风险;第四,SolveEdit-Plan 的规划后端若是闭源大模型,增益可能部分来自其世界知识而非规划结构本身,尽管匹配对照已部分控制了这一点。
独立分析的弱点
弱点一:评测瓶颈在 VLM 评委。原子断言中大量空间与关系判断(连通、包含、次序)对当前 VLM 仍不可靠,工具检查器只覆盖固定子集,弃权率与评委偏差会直接进入分数;改进方向是构建人工双人标注的校准子集、报告评委与人类的一致率,并对关系类判据引入程序化仿真器精确判分。弱点二:案例构成偏“可形式化”的题目。入选标准要求改动可语义检查、可与保护内容分离,这天然排除了风格迁移、光影重绘等开放型任务;改进方向是增设美学与写实维度的软契约并单独汇报。弱点三:规划器与生成器仅靠自然语言指令耦合,保护义务在编译时可能丢失,开源编辑器上仅 26.9% 的绝对分数说明指令接口带宽有限;改进方向是把契约式奖励用于强化学习训练编辑器本身,或把规划过程蒸馏进端到端模型。弱点四:静态基准易被污染,随着案例公开,模型可能在训练中见过类似题目,导致分数虚高;改进方向是维护不公开的保留集或程序化生成新场景。弱点五:视频只测终帧,对轨迹、时序一致性等真正考验规划的任务暂无约束。
未来方向
作者层面:论文明确指出下一步应把残余失败归因到规划或生成,并把评测扩展到时序生成。基于成果可延伸的方向:其一,把原子契约当作可验证的奖励信号,用强化学习训练编辑器,使“完成要求、保护无关内容”内化进模型而非依赖推理期提示;其二,把 SolveEdit-Plan 的两阶段规划蒸馏到端到端模型,或让编辑器先输出显式的中间变换表示再渲染;其三,向多轮交互扩展——真实解题往往需要改一步看一步,可把契约升级为状态反馈循环,支持“尝试-检查-修正”;其四,把 SD/RD 中的场景事实与图内规则接上符号求解器或仿真环境,实现零弃权的精确判分;其五,把跨模态契约从终帧推广到视频全序列,用要求条件约束中间帧与运动轨迹;其六,利用六个诊断格系统研究规模规律:语义与关系缺口随模型规模是否收敛,这直接检验“解题能力”能否被更大的生成器自动补齐;其七,探索多模型协作,让理解模型产出契约、生成模型执行、第三方模型仲裁的闭环。
复现评估
复现条件较好。项目页与代码已开源,2,728 个案例的清单和隐藏契约随发布物提供,评分聚合器是确定性的,所有模型使用同一协议、同一 VLM 版本和同一份评分代码。全程无需训练:直接评测只需对 11 个模型各生成一次输出;SolveEdit-Plan 也只是每例两次 LLM 调用(平均 3,207 输入加 635 输出 token),无任何梯度更新。主要成本在推理与评分的 API 费用:GPT-Image-2、Gemini 3.1 Flash Image、Seedream 5.0 Pro、Qwen Image 2.0 Pro 等商业模型只能通过付费 API 调用,开源编辑器(FLUX.2、Qwen-Image-Edit 等)的本地推理需要高端 GPU,而 2,728 案例乘以多模型的 VLM 评分调用本身也是一笔可观开销。复现时最需注意的坑是评委对 VLM 版本敏感,更换版本可能造成分数漂移,应锁定论文所用版本或重新校准;其余流程文档化程度高,属于“工程量大但路径清晰”的可复现工作,研究生级别的团队一到两周可搭建起评测管线。
论文图表
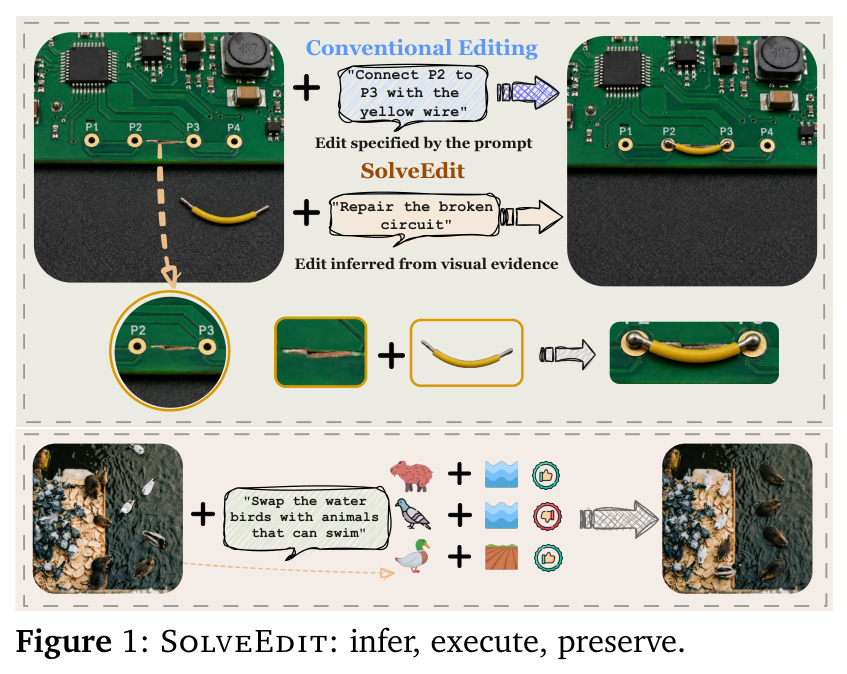
开篇示意图,对比两类编辑:传统编辑的提示完整指定了操作(“把 P2 和 P3 用黄线连起来”),而 SolveEdit 的提示只给目标—— repairing broken circuit(修复断路)需要从视觉证据推断该做什么,另一例则需按图内规则交换动物位置。
这张图用最直观的方式定义了论文的核心区分:执行被指定的变换与推断未解决的变换是两种不同能力,正是全文评测轴(IS/SD/RD)的出发点。
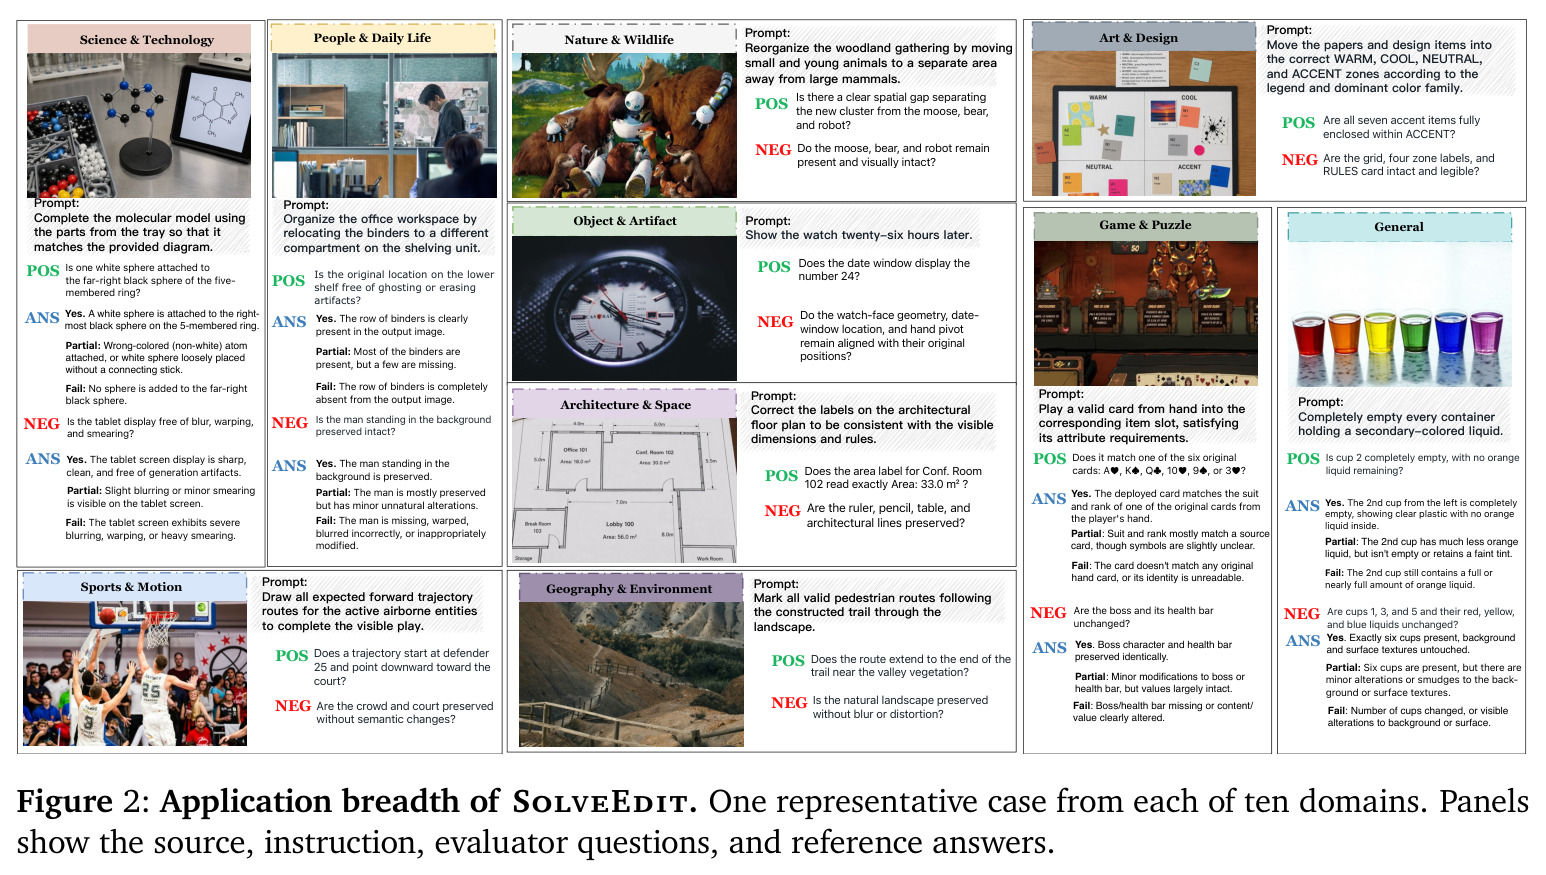
从分子模型组装、办公桌整理、暖/冷色调设计分区、表针推演、建筑平面图标正、倒空容器、游戏出牌、运动轨迹预测、徒步路线标注到背景人物保护,每个领域各展示一个完整案例:源图、只含目标的指令、评估员的 POS/NEG 原子问题及分档参考答案(通过/部分/失败)。
展示了基准 10 个领域的真实题目形态与原子契约的具体写法,读者可据此判断评测覆盖面以及契约式判分的实际粒度。