ReSPO:面向离策略学习梯度饥饿的重塑序列策略优化 ReSPO: Reshaped Sequence Policy Optimization for Gradient Starvation in Off-Policy Learning
用α散度变分推导的双分支核替代裁剪,修复RLVR离策略训练的梯度饥饿
前置知识
RLVR(可验证奖励的强化学习)
用可自动验证的标量奖励(如数学答案严格匹配)替代人类偏好或奖励模型来训练大模型的强化学习范式,无需价值网络。DeepSeek-R1 等工作确立了这一路线。本文即用 DAPO-MATH 数据集上的严格框式验证器(strict-box verifier)作为训练奖励。
本文的问题设定——为省生成成本而复用 rollout 导致离策略训练——正是 RLVR 实践引入的,理解这一背景才能明白梯度饥饿为何出现、在何处最严重。
GRPO(组相对策略优化)
对同一 prompt 采样 $G$ 条回复(本文 $G=8$),用组内奖励标准化 $(R-\text{mean})/(\text{std}+\epsilon)$ 得到优势 $\hat{A}$,免去价值网络;再对每个 token 的比率 $w_t$ 做 PPO 式裁剪。它是当前 LLM RLVR 训练的主流算法。
ReSPO 的动机直接来自 GRPO 裁剪造成的两个梯度失衡问题,且本文实验完全沿用 GRPO 的优势估计器,只替换其重要性权重整形方式。
重要性采样与离策略学习
当数据由旧策略 $\pi_{old}$ 生成而模型已更新为 $\pi_\theta$ 时,用比率 $W=\pi_\theta(o|q)/\pi_{old}(o|q)$ 修正分布偏移,使旧样本仍可用于估计新策略梯度。同一批 rollout 复用 $N$ 次会让 $W$ 逐渐偏离 1,即离策略漂移。
论文的核心对象就是序列级重要性权重 $W$ 在两端的分配行为:裁剪在 $W\to 0$ 与 $W\to\infty$ 的缺陷正是通过重要性采样视角被识别的。
序列级比率与 GSPO
GRPO 逐 token 算比率,与序列级奖励的粒度不匹配;GSPO 改用长度归一化的几何平均比率 $s=W^{1/|o|}$ 并裁剪,在 MoE 模型上更稳定。但两者硬裁剪在未裁剪区域仍让梯度随 $\rho$ 线性增长,且长度归一化引入长度相关偏差(附录 A.6)。
ReSPO 站在序列级比率这一起点上,但用平滑核替换硬裁剪,并刻意作用于未归一化的 $W$ 以保持变分推导的几何结构。
α-散度与 Bregman 散度
Bregman 散度由严格凸函数 $f$ 生成:$D_f(p\|q)=\sum_o[f(p)-f(q)-f'(q)(p-q)]$,$f$ 的选择决定插值的几何形态。取 $f(x)=x\log x-x$ 得 KL 散度(VESPO 的选择),取 $f(x)=\alpha(\alpha-1)x^\alpha$ 得 α-散度,产生幂均值插值。
ReSPO 把 VESPO 的 KL 变分框架推广到 α-散度族:α 的取值(大于 1 还是等于 1)直接决定核在 $W\to 0$ 与 $W\to\infty$ 的尾行为,是双分支设计的关键旋钮。
KL 投影与指数倾斜
在满足矩约束(控制二阶矩 $\mathbb{E}_\mu[\varphi(W)^2]$ 与测度总质量)的候选中,用广义 KL 散度找离初始解最近的投影,其 KKT 条件给出指数倾斜 $\tau^*\propto\tau_0^*\exp[-\lambda\varphi_0(W)]$,把硬边界变成平滑的乘性衰减。
这一投影步骤解释了 ReSPO 核中指数因子的来源——它不是手工设计,而是方差控制约束下变分问题的解析解,使训练稳定性有原则依据。
研究动机
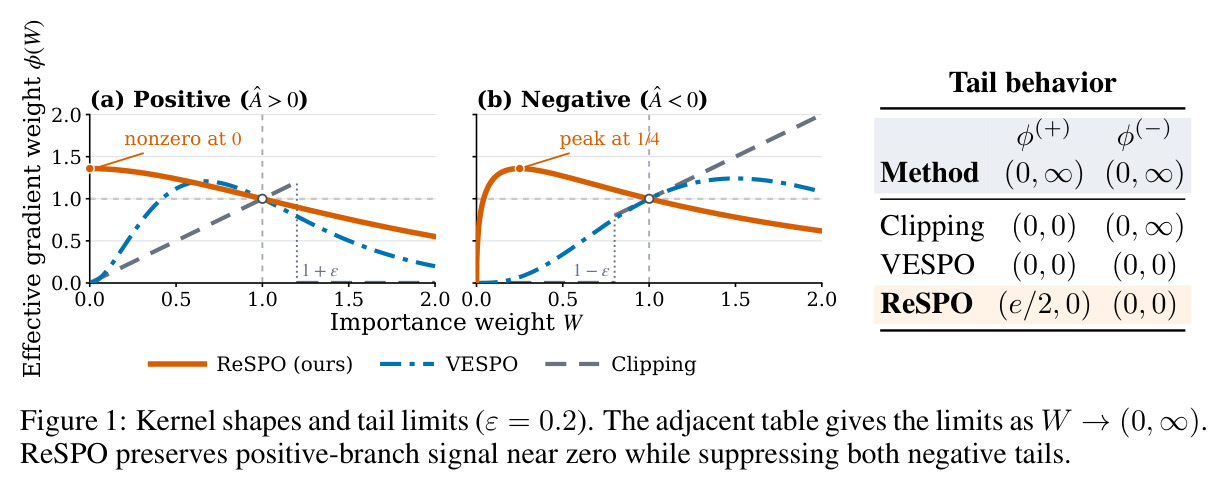
RLVR 训练中昂贵的 rollout 生成促使多个策略更新复用同一批采样数据,当前策略 $\pi_\theta$ 与生成数据的旧策略 $\pi_{old}$ 之间出现失配,序列重要性比率 $W$ 逐渐偏离 1。GRPO 裁剪 token 比率 $w_t$、GSPO 裁剪长度归一化比率 $s=W^{1/|o|}$,但两者在未裁剪区域的梯度权重都随 $\rho$ 线性增长,产生符号相关的"梯度饥饿":对 $\hat{A}>0$ 的正回复,欠生成 token 的 $w_t\ll 1$ 几乎拿不到恢复信号,$w_t=0.01$ 的梯度权重比 $w_t=1$ 低 100 倍,有价值的长推理链在早期训练中悄然流失;对 $\hat{A}<0$ 的负回复,严重过生成的 $w_t\gg 1$ 没有裁剪上界,权重无界增长,会在重复离策略更新中淹没其他梯度贡献。这一失效随复用倍率 $N$ 增大而放大,MoE 模型的路由波动进一步加剧训练-推理失配,GSPO 的长度归一化还引入额外的长度偏差。
本文的目标是目标是设计一个作用在序列级重要性权重 $W=\pi_\theta(o|q)/\pi_{old}(o|q)$ 上的平滑整形核 $\varphi(W;\hat{A})$,替代硬裁剪,并满足符号特定的尾部要求:正分支要求 $\varphi^{(+)}(0)>0$、$\varphi^{(+)}(\infty)=0$,为欠生成的正回复保留非零恢复梯度;负分支要求 $\varphi^{(-)}(0)=\varphi^{(-)}(\infty)=0$,同时压制已被抑制与被严重放大的负回复。核还需满足 $\varphi(1)=1$(在策略点不扭曲权重)、两支在 $W=1$ 处值与斜率连续、log 空间数值可稳定落地,并有变分原理支撑而非手工拼凑;最终要在密集模型 Qwen3-1.7B 与 MoE 模型 Qwen3-30B-A3B、$N\in\{8,16,32\}$ 三档复用倍率下系统超越 GRPO、GSPO、VESPO 三个基线。
与已有工作不同的是,已有方案各有缺口:GRPO/GSPO 的裁剪在低比率尾把有效权重置零、高比率尾却无界增长,恰好弄反了两端应有的行为;VESPO 从 KL 变分目标推出 $\varphi_{KL}(W)=W^\beta\exp(\lambda(1-W))$,能压双尾但 $\varphi(0)=0$,在 $W\to 0$ 处饿死正回复;REAL 把梯度饥饿重构为分类问题,放弃重要性采样,丢失了对离策略陈旧度的显式度量。ReSPO 的独特切入是保留重要性采样框架、把核设计转化为测度变换的变分问题:先在 α-散度几何下解双邻近插值,再在矩约束下做 KL 投影得到指数倾斜,最后按优势符号选择 $\alpha^{(+)}>1$ 与 $\alpha^{(-)}=1$ 两个分支。论文证明没有任何单一 α 能同时满足四条尾部要求,因此双分支是必需而非可选的设计。
核心方法
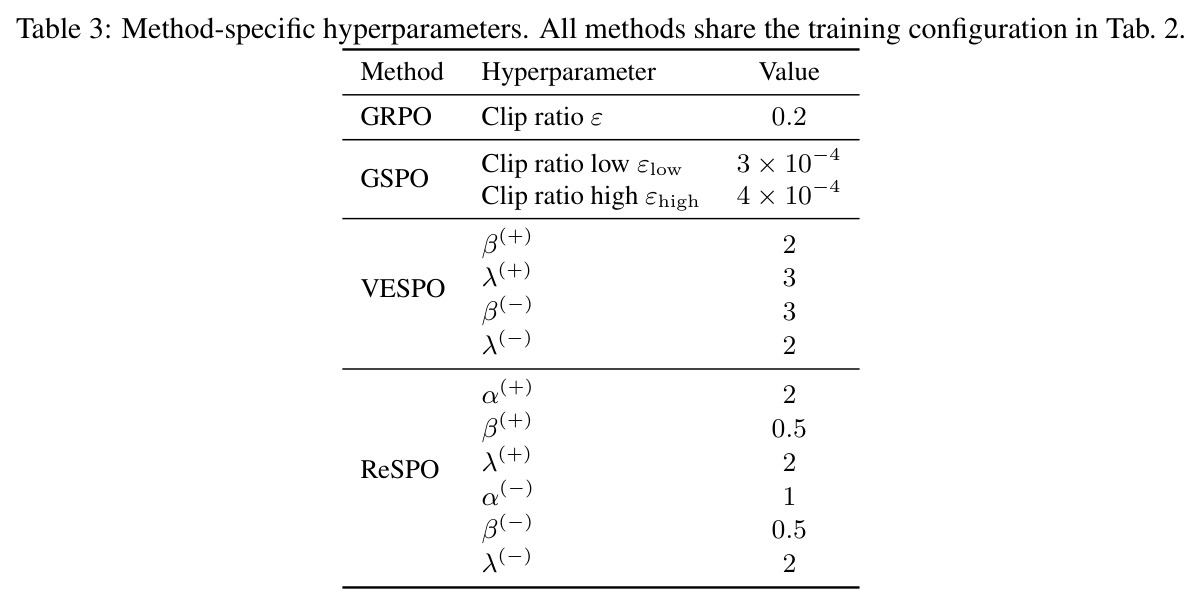
ReSPO 的直觉是:梯度权重不应在重要性比率两端同时失效,而应按优势符号重新分配。技术上它作用于未归一化的序列级权重 $W=\prod_t w_t$,送入平滑双分支核 $\varphi(W;\hat{A})$,以 stop-gradient 系数进入 REINFORCE 式梯度 $\nabla_\theta J=\mathbb{E}[\tfrac{1}{G}\sum_i \mathrm{sg}(\varphi(W_i;\hat{A}_i))\hat{A}_i\sum_t\nabla_\theta\log\pi_\theta]$。核的推导分三步:先把整形解释为测度变换 $\tau(o)=\mu(o)\varphi(W(o))$;再用 α-散度 Bregman 双邻近目标解出幂均值核 $\varphi_0(W)=[(1-\beta)+\beta W^{\alpha-1}]^{1/(\alpha-1)}$;最后在二阶矩与总质量约束下做广义 KL 投影,KKT 条件给出指数倾斜 $\varphi(W)=\varphi_0(W)\exp[\lambda(1-\varphi_0(W))]$。超参取 $\beta^{(\pm)}=0.5$、$\lambda^{(\pm)}=2$,正支 $\alpha^{(+)}=2$、负支取极限 $\alpha^{(-)}=1$。
核心创新是符号相关双分支核与变分推导的结合。与 GRPO/GSPO 的硬裁剪不同,ReSPO 不在阈值处截断而是平滑重分配权重;与 VESPO 的单支核不同,ReSPO 指出没有单一 α 能同时满足正负优势的尾部要求:正优势要 $\varphi^{(+)}(0)>0$ 留住正在流失的好回复,负优势要 $\varphi^{(-)}(0)=\varphi^{(-)}(\infty)=0$ 压制两端坏回复。于是按 $\hat{A}$ 符号选 α:正支 $\alpha^{(+)}=2$ 退化为线性 $\varphi_0^{(+)}(W)=(1+W)/2$,得 $\varphi^{(+)}(W)=\frac{1+W}{2}e^{1-W}$,在 $W=0$ 取全局最大 $e/2\approx 1.36$;负支取 $\alpha^{(-)}=1$ 极限 $\varphi_0^{(-)}(W)=\sqrt{W}$,得 $\varphi^{(-)}(W)=\sqrt{W}\,e^{2(1-\sqrt{W})}$,双尾归零、$W=1/4$ 处峰值 $e/2$。$\lambda^{(-)}=2$ 由两支在 $W=1$ 处斜率匹配解析确定,切换无缝。
方法步骤详情
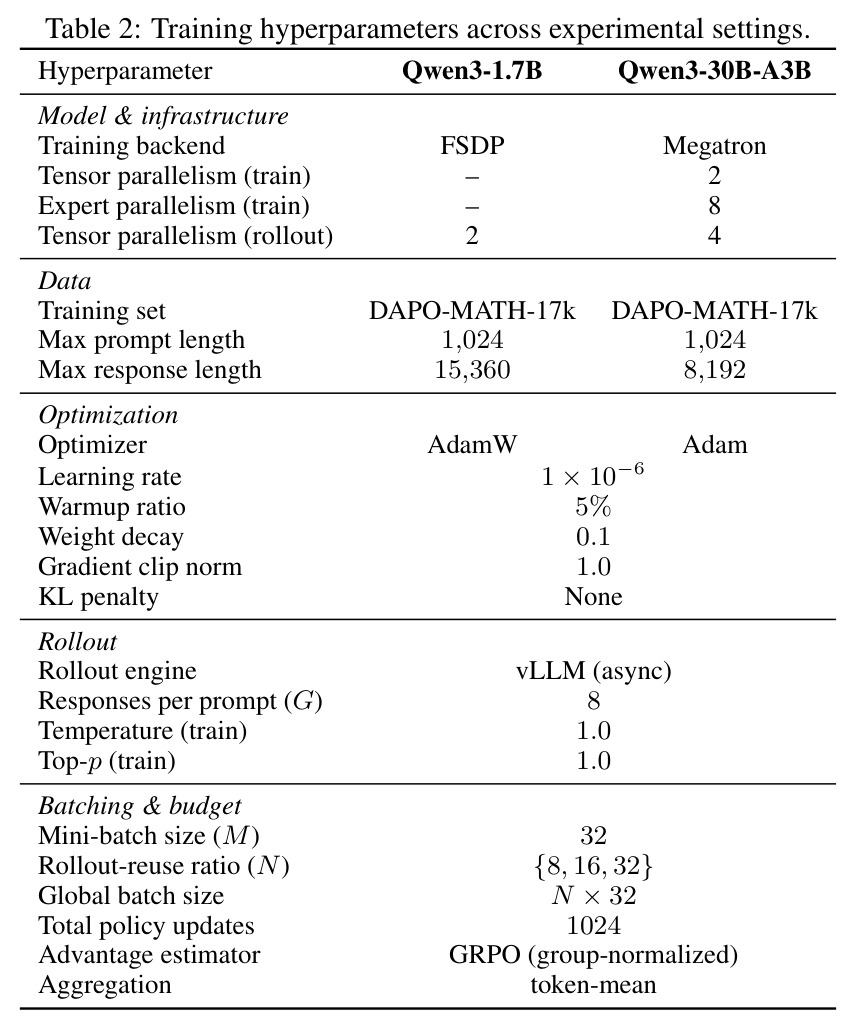
完整流程:(1) 每个 prompt 从旧策略采 $G=8$ 条回复,按 GRPO 组归一化算优势 $\hat{A}_i$;(2) 用当前策略重打分旧 rollout,log 空间累加 token 比率得 $W_i=\prod_t w_{i,t}$(附录 B 给出稳定实现与 Alg. 1);(3) 按 $\hat{A}_i$ 符号选核:$\hat{A}\ge 0$ 用 $\varphi^{(+)}(W_i)=\frac{1+W_i}{2}e^{1-W_i}$,$\hat{A}<0$ 用 $\varphi^{(-)}(W_i)=\sqrt{W_i}\,e^{2(1-\sqrt{W_i})}$;(4) 把 detach 的 $\varphi(W_i;\hat{A}_i)\hat{A}_i$ 作为序列级梯度缩放系数,乘到该序列全部 token 的 $\nabla_\theta\log\pi_\theta$ 上求和更新,同批 rollout 连续喂给 $N$ 个 mini-batch($M=32$,全局批 $NM$);(5) 在策略时 $W=1$ 两支退化为单位权重。训练基于 verl + 异步 vLLM,学习率 $10^{-6}$、无 KL 惩罚,响应上限 1.7B 15360 / 30B 8192 token(30B 配软长度惩罚),共 1024 步。
技术新颖性
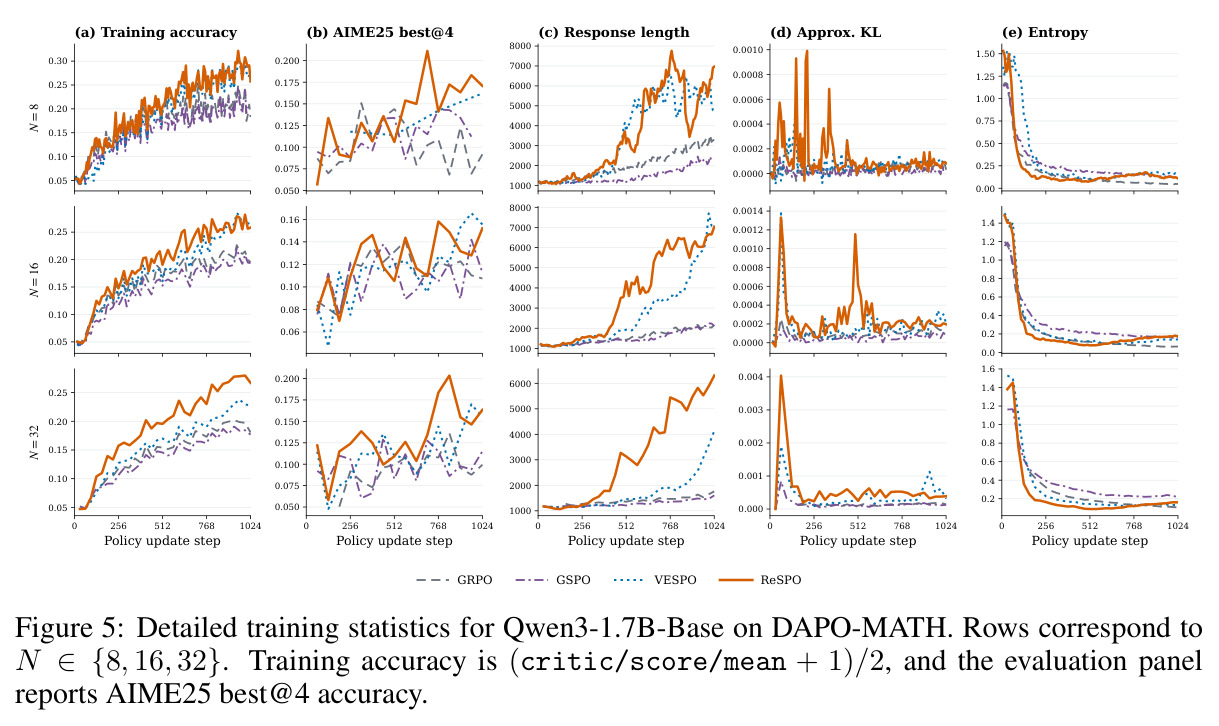
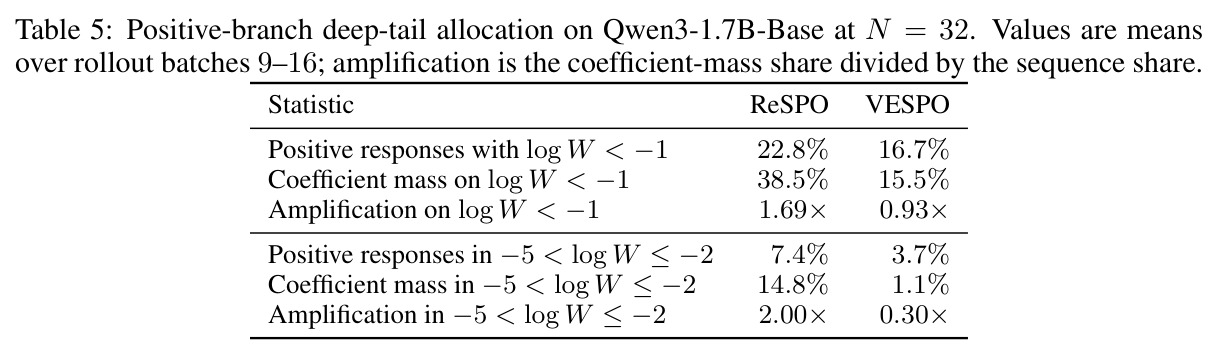
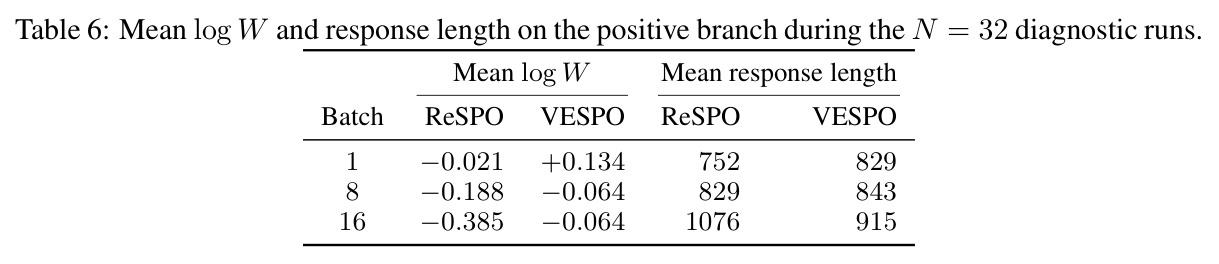
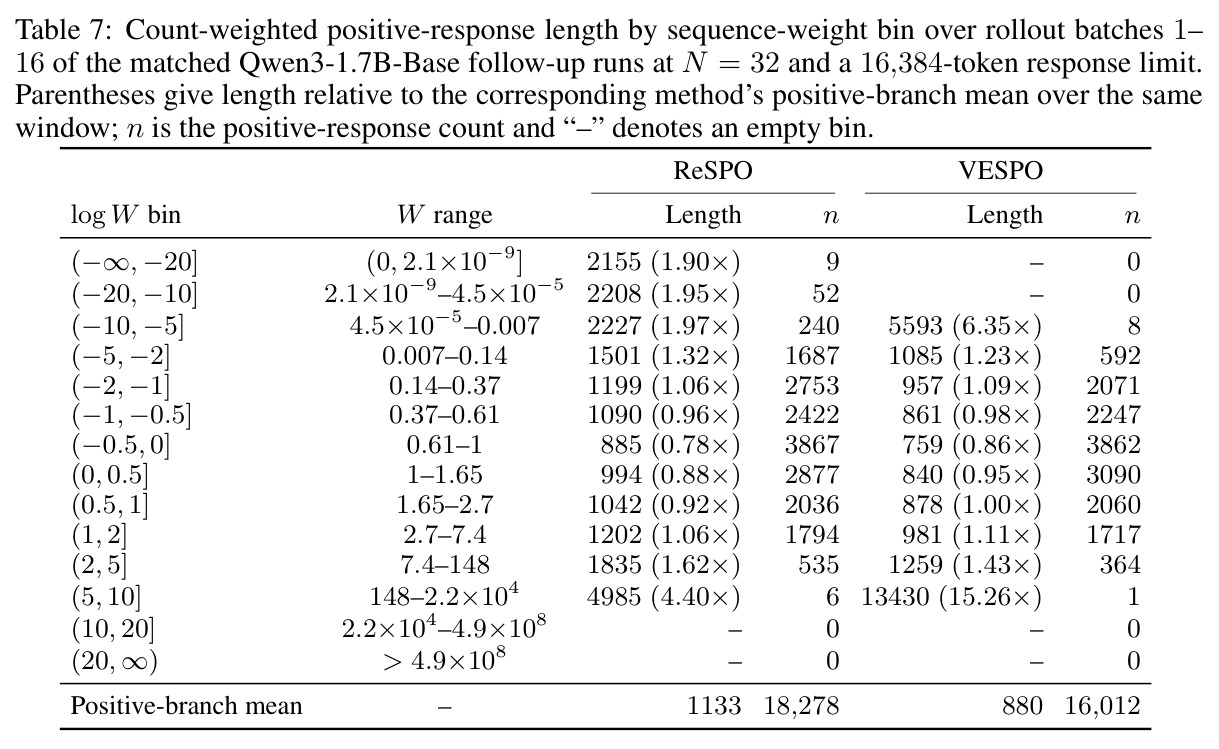
新颖性有三处。第一,把权重整形形式化为测度变换 $\tau=\mu\varphi$,使核可由变分法解析求解而非手工设计:α-散度决定幂均值插值与尾部形态,KL 投影把线性矩约束转化为平滑乘性倾斜,两个散度分工明确(附录 A 给出完整推导,含 Bregman 对偶邻近目标与 KKT 条件)。第二,双分支符号设计被证明是必需的:无单一 α 同时满足四条尾部要求,$\alpha^{(+)}>1$ 给出正支非零尾,$\alpha^{(-)}=1$ 连续极限给出负支双零尾——这是对 VESPO 单支 KL 核的实质推广(VESPO 的指数因子作用于原始 $W$,ReSPO 作用于整形后的 $\varphi_0(W)$)。第三,显式拒绝 GSPO 的长度归一化、直接在未归一化 $W$ 上操作以保持变分几何,并用附录 E.3 的正支诊断实证:模型能在最早期训练步从落入低权重尾的长正推理轨迹中有效学习,直接回应了梯度饥饿的实际危害而非仅在合成指标上占优。
实验结果
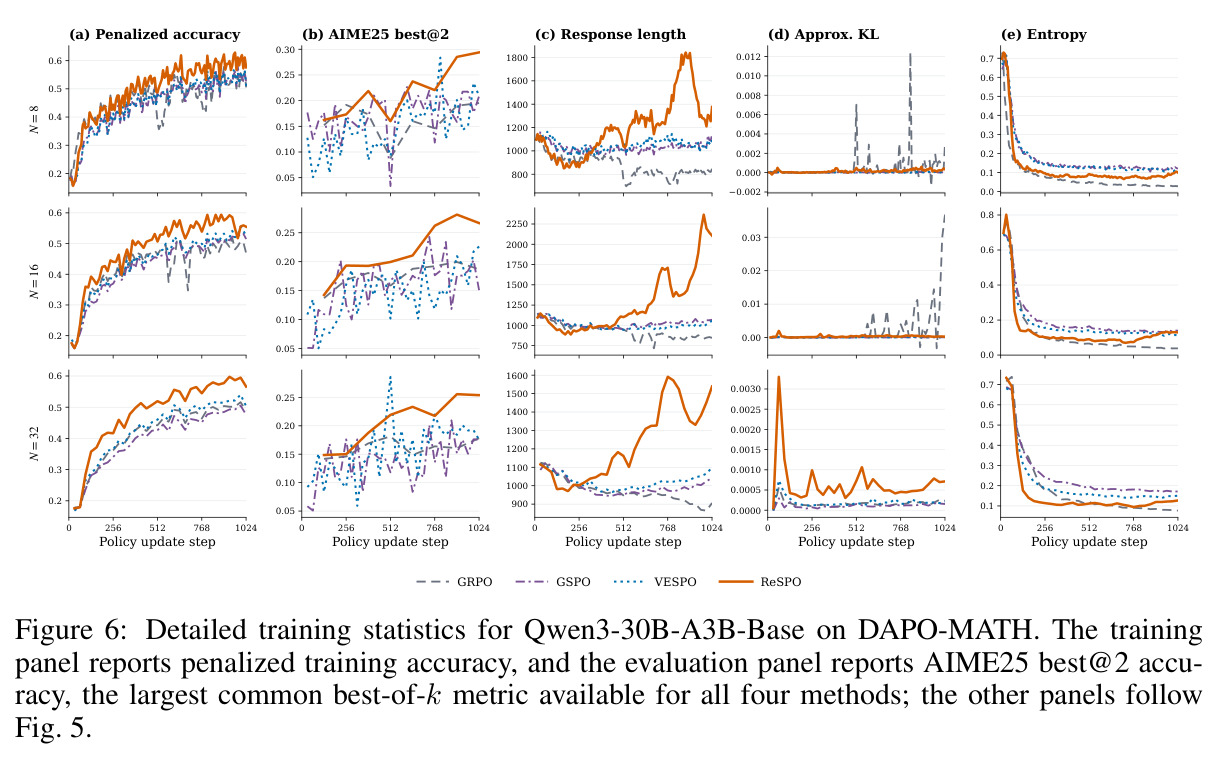
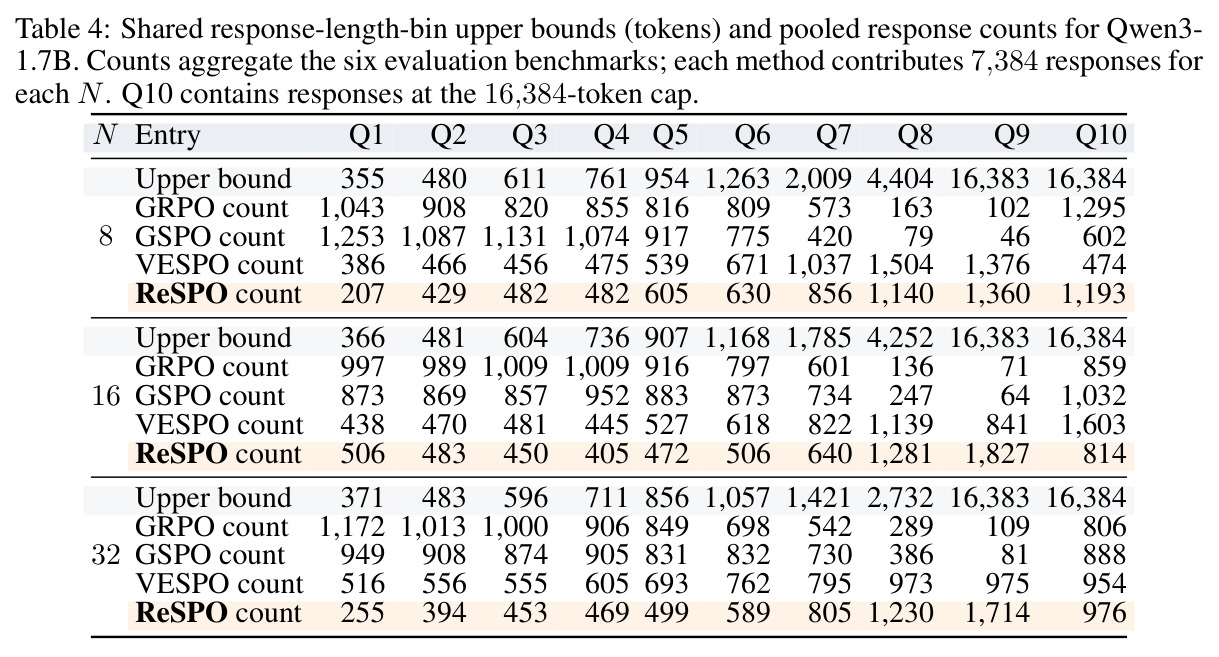
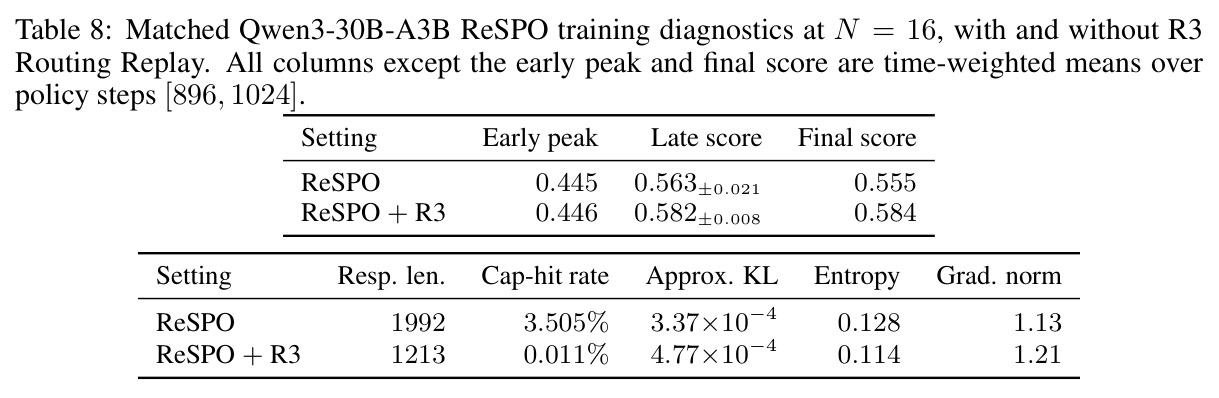
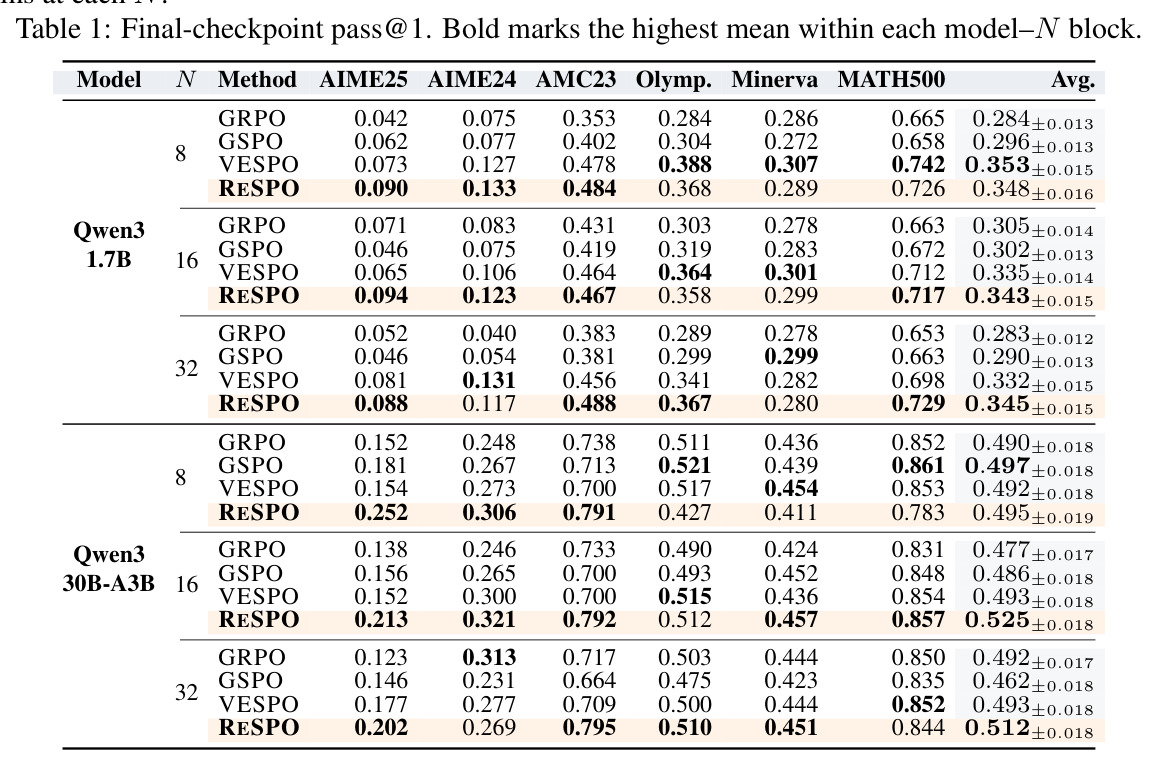
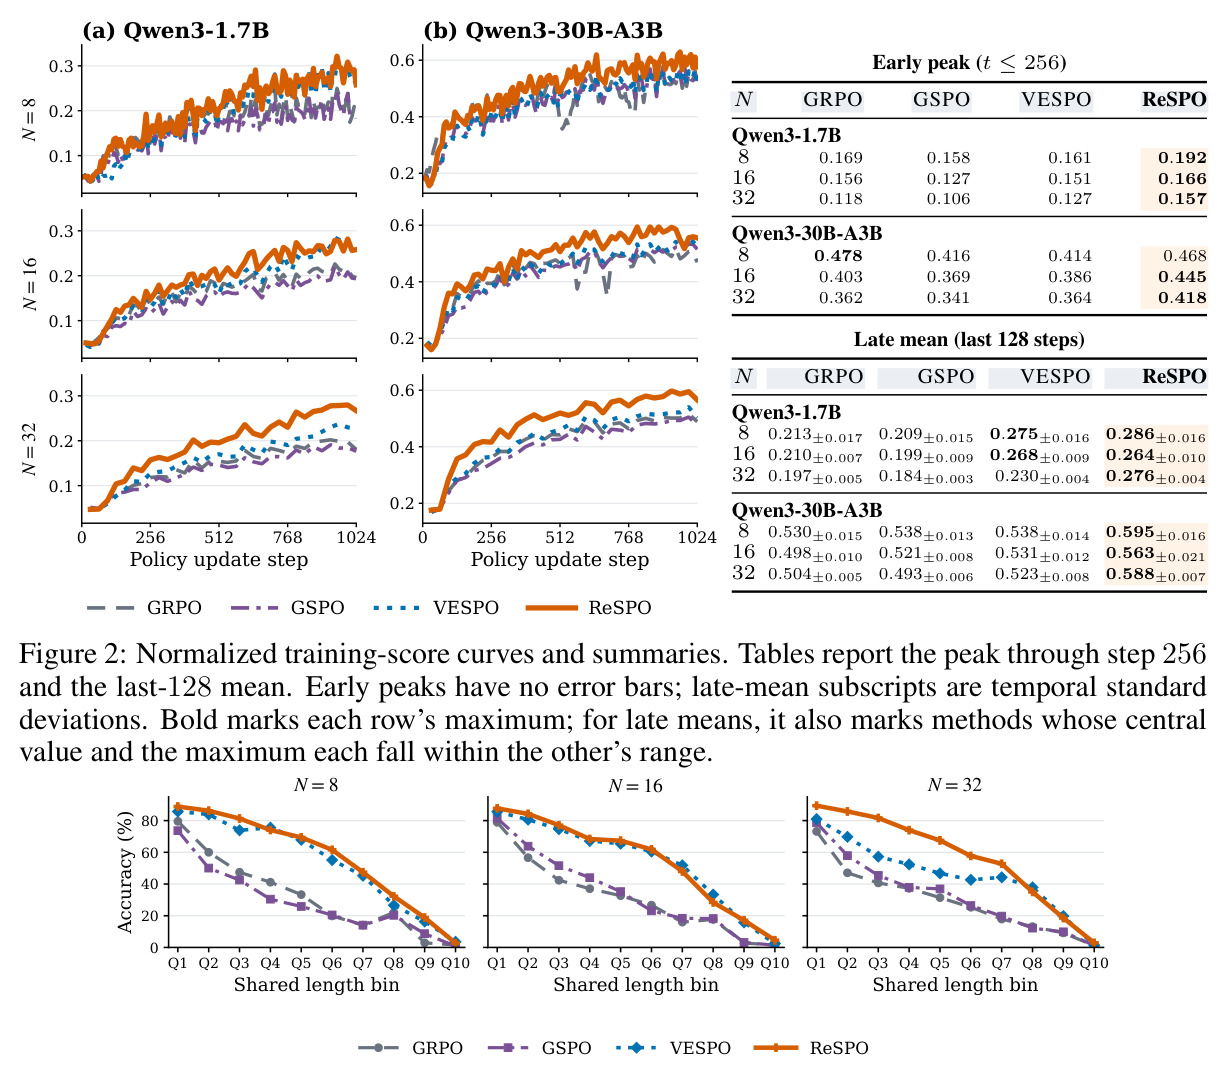
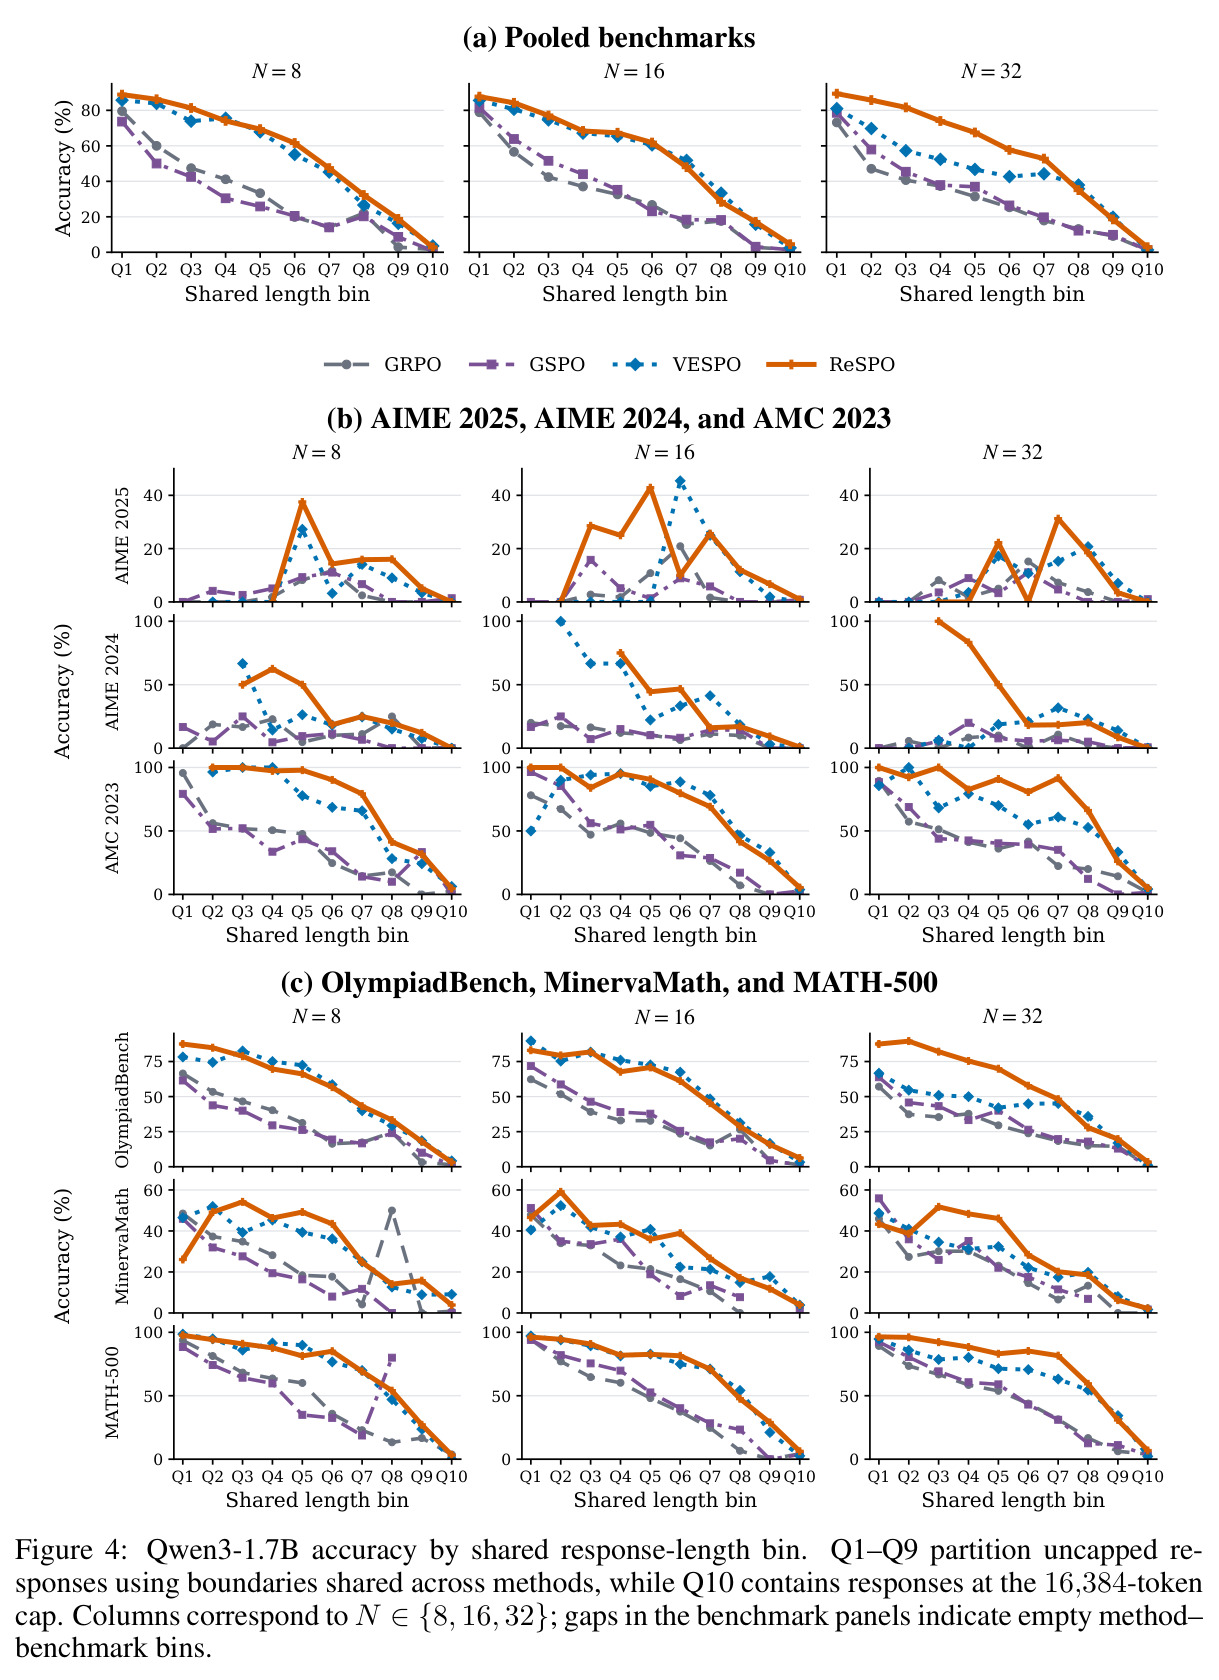
在 Qwen3-1.7B 与 Qwen3-30B-A3B、$N\in\{8,16,32\}$ 共 6 个设定中:训练侧 ReSPO 在 5/6 设定取得最高早期峰值(1.7B N=32 为 0.157 vs 最强基线 VESPO 0.127)与最高后段均值,后段均值在全部 6 个设定超过最强裁剪基线 4.2–8.4 pp(N=32 时 1.7B 0.276 vs 0.230、30B 0.588 vs 0.523)。评测侧(最终 checkpoint pass@1 六基准宏平均):N=16/32 时全部 4 个模型-N 设定居首(1.7B +0.8/+1.3 pp、30B +3.2/+1.9 pp);AIME25 与 AMC23 每个设定均最高,30B 竞赛三题平均领先 6.3/5.8/3.4 pp(N=8/16/32)。共享长度分箱中 30 箱占 24 箱最高,N=32 时 Q1–Q7 领先 8.4–24.4 pp。三种子检验(N=32):1.7B 后段均值 27.07%±0.54 vs VESPO 23.00%;30B 57.92%±0.95 vs 52.30%;竞赛平均 41.94%±0.47 vs 38.77%,标准差远小于增益。Routing Replay 消融(30B N=16)把后段均值从 56.32% 提到 58.16%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 数学推理训练(Qwen3-30B-A3B,N=32,DAPO-MATH) | 惩罚化训练准确率(最后 128 步均值) | ReSPO 0.588±0.007 | VESPO 0.523±0.008(最强基线) | +8.4 pp,时间范围不重叠 |
| 数学推理训练(Qwen3-1.7B,N=32) | 归一化训练分数(最后 128 步均值) | ReSPO 0.276±0.004 | VESPO 0.230±0.004(最强基线) | +7.9 pp |
| 六基准评测宏平均(Qwen3-30B-A3B,N=16) | pass@1(最终 checkpoint) | ReSPO 0.525±0.018 | VESPO 0.493±0.018(最强基线) | +3.2 pp |
| 六基准评测宏平均(Qwen3-1.7B,N=32) | pass@1(最终 checkpoint) | ReSPO 0.345±0.015 | VESPO 0.332±0.015(最强基线) | +1.3 pp |
| AIME 2025(Qwen3-30B-A3B,N=16) | pass@1 | ReSPO 0.213 | GSPO 0.156(最高基线) | +5.7 pp |
| AMC 2023(Qwen3-30B-A3B,N=32) | pass@1 | ReSPO 0.795 | VESPO 0.709(最高基线) | +8.6 pp |
| 竞赛基准平均 AIME25+24+AMC23(30B,N=32,3 种子) | pass@1 | 41.94%±0.47 | VESPO 38.77%、GRPO 38.43%、GSPO 34.70% | +3.17 pp(vs VESPO) |
局限与改进
作者在附录 F 承认受算力预算与超参搜索范围限制:$(\alpha,\beta,\lambda)$ 主要由解析条件设定而非大规模搜索,实验仅覆盖 DAPO-MATH 数学推理与 Qwen3 两个模型。我自己的观察:(1) N=8 时优势明显缩小——1.7B 宏平均 ReSPO 0.348 略低于 VESPO 0.353,30B 上 OlympiadBench 0.427 vs GRPO 0.511、MinervaMath 0.411 vs 0.454、MATH500 0.783 vs 0.853 反而落后,说明轻微软策设定下正支在 $W\to 0$ 处 $e/2\approx 1.36$ 的峰值加权并非必需甚至有害;(2) 正支给低 $W$ 高权重会鼓励长回复,30B 不得不附加软长度惩罚,方法与长度控制存在内在张力;(3) 除 N=32 的三种子外主结果多为单次运行,评测误差用聚类 bootstrap 估计,但训练侧随机性未完全覆盖;(4) 未归一化的序列级 $W$ 随回复长度增长方差增大,仅靠 log 空间实现缓解,超长回复下的稳定性未单独分析。
独立分析的弱点
第一,双分支在 $W\to 0$ 的不对称处理虽是卖点,但正支 $\varphi^{(+)}(0)=e/2\approx1.36$ 意味着几乎不可能被当前策略生成的回复反而获得最大权重——在奖励噪声或错误标注场景下这会放大错误信号,可引入按 $|\hat{A}|$ 或验证器置信度的门控来缩放峰值。第二,核只作用在序列级标量上,同一序列内所有 token 无差别共享权重,无法处理部分正确的长思维链;可结合过程奖励把核分解到段级或 token 级。第三,$\lambda^{(\pm)}=2$ 固定且 $\beta^{(\pm)}=0.5$ 对称是手工设定,随实测二阶矩或策略漂移在线调整 $\lambda$、甚至学习 α 可能更优。第四,实验域单一:代码生成、多轮 agent、奖励非二值任务上双分支是否仍成立未验证。第五,与 DAPO 的动态采样、REINFORCE++ 的全局优势归一化、截断重要性采样等互补技术缺乏系统消融,仅初步测试了 Routing Replay。第六,正支加速早期学习与 30B 软长度惩罚并存,说明目标函数内部存在需要显式调和的冲突。
未来方向
论文明确指出的方向包括与 Routing Replay 的正交组合(初步消融 56.32%→58.16%)以及更大规模的超参搜索。可延伸的方向:(1) 自适应倾斜——让 $\lambda^{(\pm)}$ 随实测 $\mathbb{E}_\mu[\varphi(W)^2]$ 或 KL 漂移在线更新,替代固定值 2;(2) 在 α-散度族之外系统扫描 Bregman 生成子的全空间,建立尾形态与任务特性(奖励稀疏度、序列长度分布)的对应关系;(3) 结合步级优势或过程奖励,把序列级核推广为段级核,缓解长回复内 token 无差别问题;(4) 理论侧补齐 ReSPO 梯度估计器的方差上界与收敛性分析(论文只论证了倾斜导致二阶矩有界);(5) 在更大模型与非数学域上检验可扩展性,尤其 MoE 路由漂移与权重整形的交互;(6) 研究 N 的在线选择策略——论文显示增益随 N 增大而扩大,反推最优复用倍率与核参数的联合自适应值得一试。
复现评估
复现条件较好:论文附带代码工件,含 ReSPO 实现与密集、MoE 两套启动配置;附录 B 给出 log 空间稳定实现与完整 Alg. 1,附录 C/D 交代 GRPO 细节、DAPO-MATH 奖励与软长度惩罚、评测管线(Math-Verify 等价判定、温度 1.0、top-p 0.7),Tab. 2/3 完整记录共享与方法超参,VESPO 用其发表最优设置 $(\beta^{(+)},\lambda^{(+)})=(2,3)$、$(\beta^{(-)},\lambda^{(-)})=(3,2)$,对比公平。数据全部公开(DAPO-MATH-17k 训练,AIME 2024/2025、AMC 2023、OlympiadBench、MinervaMath、MATH-500 评测)。算力是主要门槛:1.7B 用 FSDP+AdamW 单机多卡可复现 1024 步训练,30B-A3B 需 Megatron+Adam 大规模集群。核本身实现极简(几行指数运算),最经济的验证路径是先在 1.7B、N=32 上对照三种子后段均值 27.07%±0.54。
论文图表