永不放弃:用自适应采样破解大模型强化学习的马太效应 Learning to Solve Hard Problems in RL for LLMs by Never Giving Up
揭示RL后训练中的马太效应,提出NGU自适应采样,动态重分配算力攻克难题。
前置知识
GRPO(组相对策略优化)
DeepSeek-R1 以来 LLM 后训练最主流的 RL 算法。对每个提示采样 $K$ 个补全,用组内平均奖励 $\bar{r}=\frac{1}{K}\sum_i r_i$ 作为基线计算优势 $A_i=r_i-\bar{r}$,从而省去价值网络。其代价是:组内全部正确或全部错误时优势恒为零,该提示对参数更新没有任何贡献,训练中通常直接被过滤。
全文分析都建立在 GRPO 的组基线与零梯度现象之上:难题全错导致无信号、简单题容易形成混合组留在批内,NGU 正是对这一采样结构的改造,不懂 GRPO 无法理解问题成因。
pass@1 与难度分桶
评测生成能力的核心指标:对每题采样若干次,pass@1 是单次采样即正确的概率,pass@k 是 $k$ 次中至少一次正确的概率。论文用初始模型的 pass@1(小实验)或 pass@64(大规模实验)给题目划分难度桶:easy/medium/hard/extra hard,例如 pass@1 为 25%/10%/5%/0% 的四档。
马太效应的定义与所有实验结论都以难度桶呈现(分桶报告 pass@1 随训练的变化),不理解分桶方式就读不懂每张图的横轴含义。
异步 off-policy RL 与样本陈旧性
生成(rollout)与训练(update)解耦的 RL 系统:worker 持续采样,训练器用到达的数据流持续更新,数据可能是几步之前旧策略生成的(off-policy),用 age(落后步数)衡量陈旧度。现代工业级大规模后训练流水线普遍采用这种架构以打满算力。
NGU 的算力再分配完全依赖异步基建:简单题被秒级过滤后,worker 立即从队列领取更难的题;论文附录 C.1 证明没有异步性 NGU 就失去意义,而陈旧样本处理(阈值 $T$、锚定正样本)也正是 off-policy 带来的新问题。
马太效应
源自经济学与网络科学的累积优势现象,概括为'强者愈强、富者愈富',最初用于描述学术引用中知名学者获得不成比例的更多关注。本文将其定义为:RL 对某任务的提升幅度与模型初始能力成正比——简单的任务变得更简单,难的任务依旧困难。
这是论文命名和定义的核心现象:图 1 中易题 pass@1 提升 +0.63 而难题仅 +0.03 的不对称提升,是全文要解释和解决的根本问题。
几何分布采样
离散概率分布:每轮独立试验以概率 $p$ 继续、以概率 $1-p$ 停止,总试验轮数服从几何分布,期望值为 $\frac{1}{1-p}$,特点是众数在最小值处、右尾很长(偶尔出现极多次数)。
NGU 中每题总采样量正是几何分布:先采 $K$ 个,之后每轮以 $p_{NGU}$ 的概率继续再采 $K$ 个,期望总量为 $\frac{K}{1-p_{NGU}}$,一举兼顾'简单题只花 $K$'与'难题平均可采上百次'。
信号丢失 vs 信号效率
解释 RL 学不会难题的两种对立假说。信号丢失假说(Xiong et al., 2025)认为难题学不会是因为从未采到正确答案、组内零梯度,药方是加大 $K$ 提高采中概率;信号效率假说(本文提出)认为瓶颈是大量算力被浪费在重复采样已会做的简单题上,RL 本质是单位算力性能的优化问题,应动态重分配预算。
两者的对立就是本文的问题定义:受控实验否证了前者(固定算力下 $K=4$ 反而全面最优),支持后者,NGU 是后者的具体解法。
研究动机
实践者普遍假设:用 RL 在覆盖易到难的问题分布上训练,模型就会学会解决整个分布。论文用三组开源 RL 模型证伪了这一假设:Olmo 3.1 RL-Zero Math 在 AIME 数学评测上,初始模型已能解的简单题 pass@1 提升 +0.63,而最难档仅 +0.03;DeepCoder 在 LCBv5 代码评测上按难度分桶增益为 +0.19/+0.05/+0.00,越难提升越小;DeepSWE 在 SWEBenchVerified 上按人工预估时长分桶,15 分钟内可完成的简单题 +0.12,超过 4 小时的难题仅 +0.06。作者称之为 RL for LLMs 的马太效应:提升幅度与初始能力成正比。主流解释是信号丢失假说:GRPO 对每个提示采 $K$ 个补全,若 $K$ 个全错则优势为零、无梯度,而难题恰恰经常全错,于是标准药方是加大 $K$。但这个解释是否成立、加大采样量能否真正救回难题,此前缺乏受控实验验证。
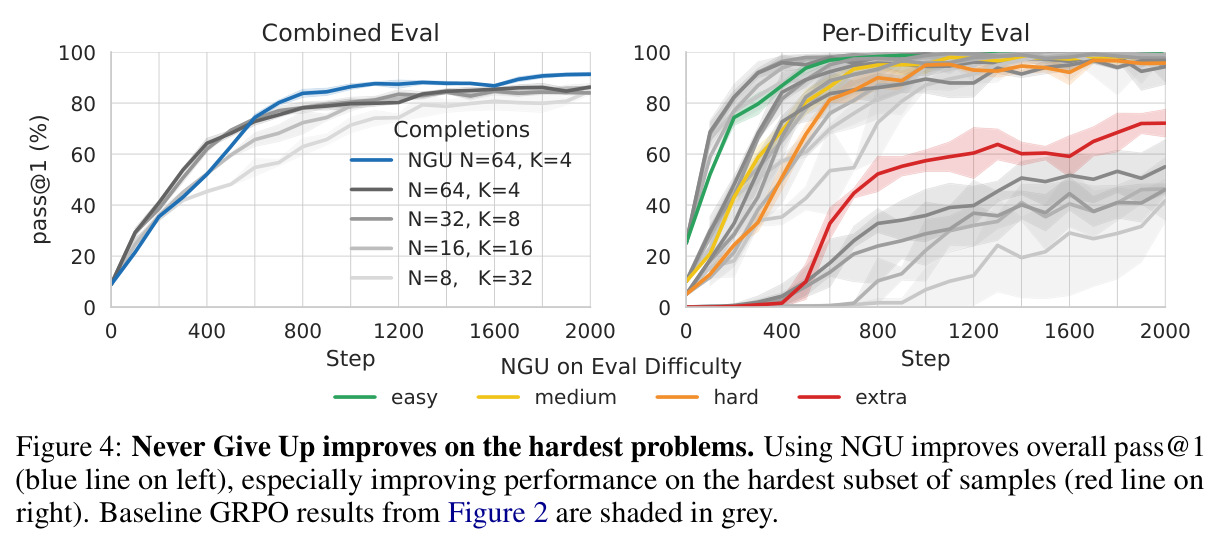
本文的目标是本文目标分三层。第一,用受控实验检验信号丢失假说:在 Qwen 2.5 0.5B Instruct + GSM8k Platinum 的测试床上,固定总批大小 $N\times K=256$,对比 $K\in\{4,8,16,32\}$、$N\in\{64,32,16,8\}$ 四种 GRPO 配置,看加大 $K$ 能否让难题受益,并按初始 pass@1=25%/10%/5%/0% 划分 easy/medium/hard/extra hard 四档评测。第二,若假说不成立,给出替代性机理:作者提出信号效率假说——瓶颈不是难题采样不足,而是算力被浪费在重复采样已会做的简单题上,RL 应按单位算力性能优化。第三,据此设计一个无需显式难度标注、无需课程表的在线自适应采样方法 NGU(Never Give Up),在不牺牲简单题性能的前提下把采样预算动态重分配给难题,并在两个更大规模场景验证:数学(Qwen 3 4B-base + Deepscaler,评测 AIME 2025 与 BRUMO Nov 2025)和代码(Qwen 3 4B Instruct + Manufactoria)。
与已有工作不同的是,独特之处在视角反转与基建利用两点。视角上,此前最相近的工作 Reinforce-AdaSeq-Positive(Xiong et al., 2025)把难题学不动归因于正样本欠采样,解法围绕如何采出正确答案;本文实验证明固定算力下加大 $K$ 反而全面变差($K=4$ 最好,难题上尤其明显),因为大 $K$ 使简单题只要混入一个错误补全就会留在训练批内,等于把算力倒灌回已解决的题——问题从'信号丢失'被重新定义为'信号效率'。方法上,NGU 不显式估计难度、不删除数据、不修改损失函数,而是利用现代大规模后训练普遍具备的异步 off-policy RL 基建:被快速过滤的简单题腾出的算力自然被队列中更难的题填补,训练分布随模型进步自动漂移。此外作者注意到代码任务中难度不只存在于题与题之间,还存在于一题内部的多个测试用例之间,提出 Harness-Aware 马太效应,把该现象的分析颗粒度从题目推进到测试级别。
核心方法
直觉:既然 GRPO 的病灶是对每道题固定花费 $K$ 份采样算力——简单题浪费、难题不够——那就让采样次数随难度自适应:简单题一轮就过滤掉,难题一直采到出现正确答案为止。技术上 NGU 的流程是:对每个提示先采 $K=4$ 个补全。若全部正确,立即过滤(太简单,无梯度且是浪费);若正误混合,作为正常 GRPO 组进入更新;若全部错误,标准做法是放弃换题,NGU 则以概率 $p_{NGU}$ 把该题放回异步队列再采 $K$ 个,以概率 $1-p_{NGU}$ 放弃,防止对不可能的题无限采样。重复直到某次采样出现正确答案。于是每题总采样量服从几何分布,期望为 $\frac{K}{1-p_{NGU}}$:$K=4, p_{NGU}=0.95$ 时平均约 80 个样本,但绝大多数简单题仍然只花 4 个。这一切依赖异步 RL 基建:被过滤的简单题由队列中的难题即时补位,批组成自动向难题倾斜。找到正确答案后,NGU 把该题历史上 $T$ 步内的所有补全与新的正确答案合并成一个大组计算 GRPO 优势,用更丰富的组内对比放大稀有正确答案的梯度。
核心创新是把'难题解决不了'从采样量问题转化为算力分配问题,并用一个极简的重排队机制实现隐式课程。与显式课程的本质区别:课程学习按初始通过率给难题固定大 $K$、或直接删除简单题,但难度是动态的——附录 C.2 显示基线训练后期会在曾完美解决的题上回退,固定分配随之失效,且删题会缩小训练分布;NGU 保留全分布、在线自适应,实验显示 NGU 优于按初始难度分配 $K$ 的课程基线,后者虽在最难子集追平 NGU 却牺牲了简单题。与 Reinforce-AdaSeq(最相近工作)的本质区别:后者基于同步 RL,重采样不节省任何算力,目标是补足欠采样;NGU 依赖异步基建实现真正的算力再分配,附录 C.1 证明异步性是方法成立的必要条件。此外'锚定正样本'技巧解决了复用陈旧补全计算基线会导致优势组去中心化的新问题,使得旧样本的奖励信息可以被基线利用而不污染更新。
方法步骤详情
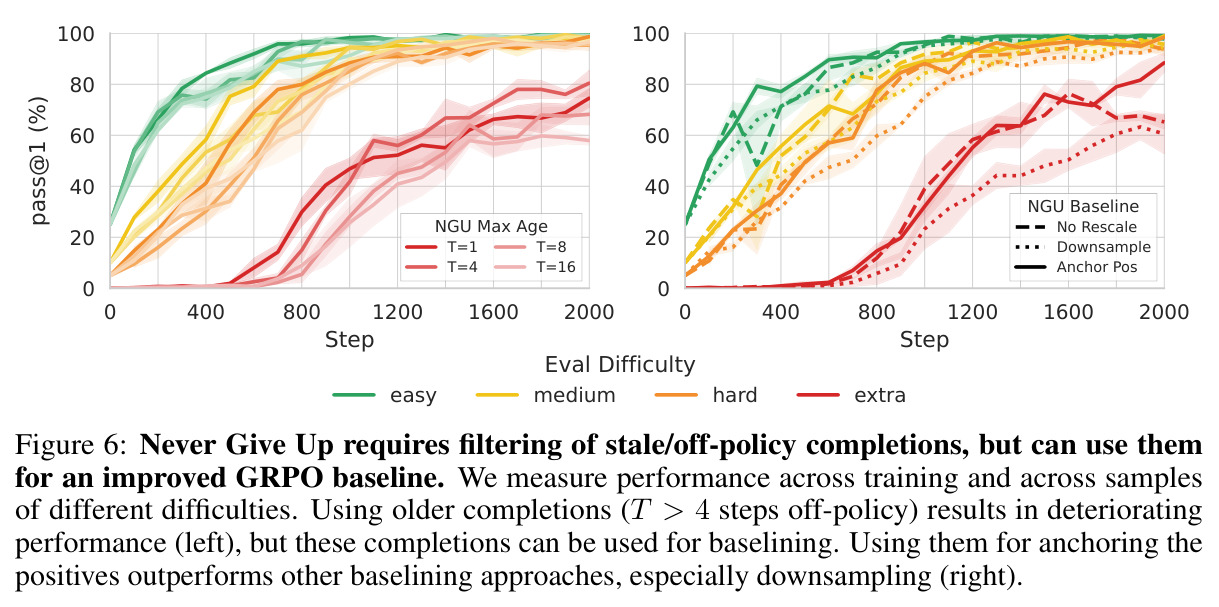
第一步:初始采样。对批内 $N=64$ 个提示各采 $K=4$ 个补全,奖励来自可验证答案(数学为答案比对,代码为逐测试通过)。第二步:分组判定。全对则过滤为太简单;正误混合则作为正常 GRPO 组进入更新;全错则进入 NGU 循环。第三步:重排队。以概率 $p_{NGU}$(实验取 0.95)把全错的题放回异步队列再采 $K$ 个,以 $1-p_{NGU}$ 概率放弃;被过滤的简单题腾出的 worker 立即领取新题,维持批大小恒定。第四步:组构造。某题一旦采出正确答案即停止采样,把最近 $T$ 步内的历史补全与新正确答案合成一个大组;扫描 $T\in\{1,4,8,16\}$ 后 $T=4$ 最优。第五步:基线与优势。用含历史补全的全部奖励计算基线 $\bar{r}_{NGU}$,正样本优势为 $1-\bar{r}_{NGU}$;过滤陈旧负样本会使优势总和偏离零,故把剩余 $n_-$ 个负样本优势重缩放为 $-\frac{n_+}{n_-}(1-\bar{r}_{NGU})$,保证更新组优势之和为零,即'锚定正样本'。
技术新颖性
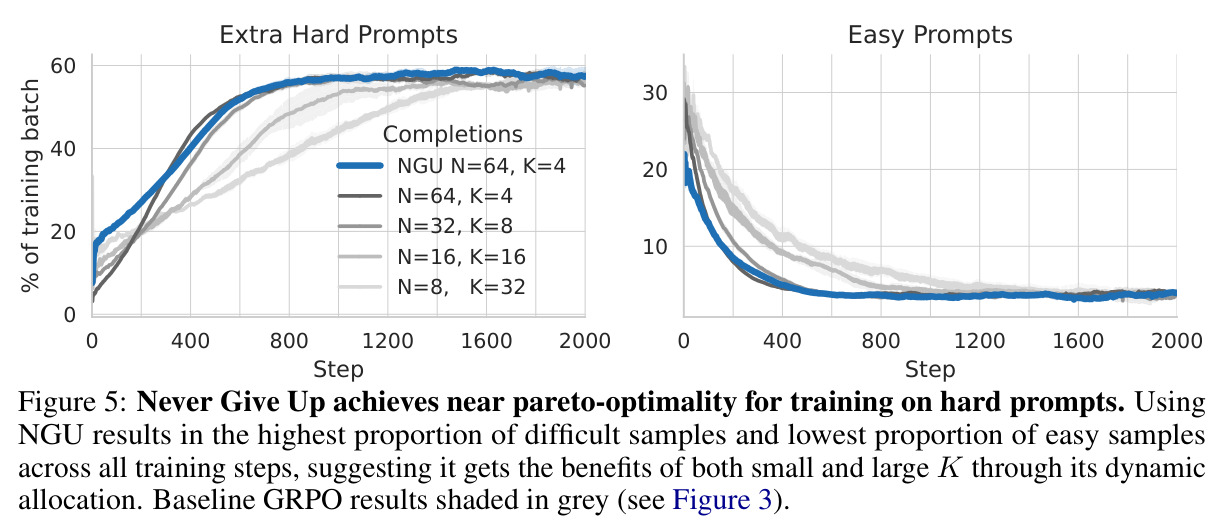
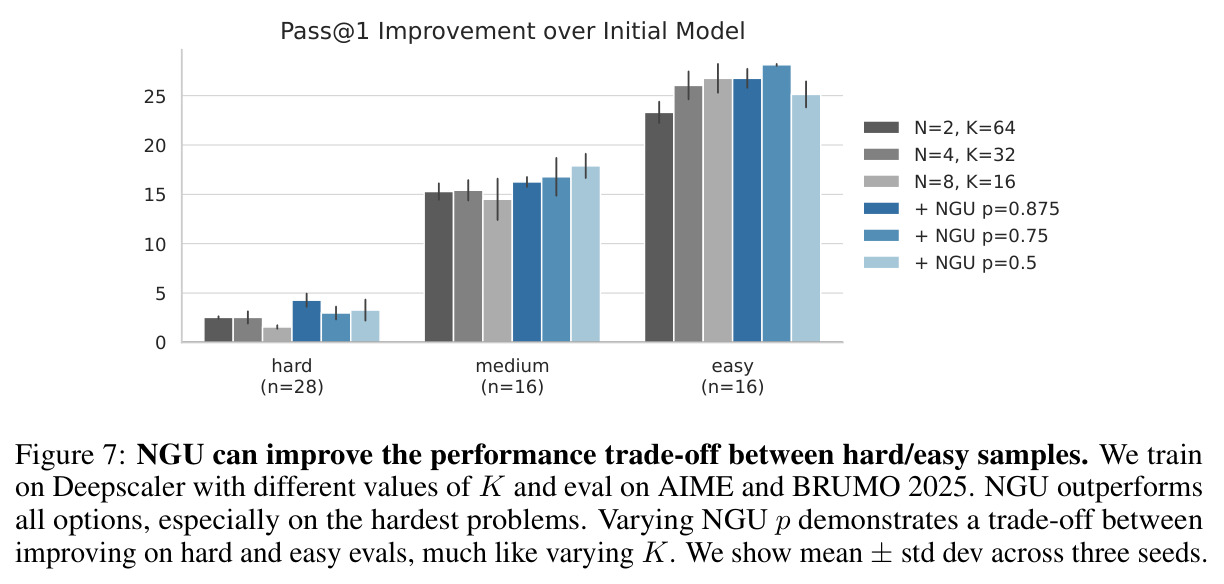
技术新颖性有四点。其一,几何分布采样次数:用 $p_{NGU}$ 一个标量把'每题固定 $K$'变成期望 $\frac{K}{1-p_{NGU}}$、右尾可达数百的重尾分布;图 7 显示调节 $p\in\{0.5,0.75,0.875\}$(对应理论平均采样 $K=32/64/128$)可像调节 $K$ 一样在难题/简单题性能间连续权衡,但帕累托前沿整体优于任何固定 $K$。其二,批组成的帕累托最优性:图 5 显示 NGU 早期批内难题占比媲美 $K=32$、训练后期媲美 $K=4$,同时简单题占比始终最低,等于同时获得大 $K$ 的探索力与小 $K$ 的过滤力。其三,锚定正样本:允许用全部历史奖励计算基线、却只训练新鲜样本,对比'不重缩放'与'下采样负样本至正负等量再乘 $1/\bar{r}_{NGU}$'两种基线,锚定在最难题上最好,而下采样因丢弃有用负样本明显有害。其四,Harness-Aware 马太效应:发现模型面对新提示/新格式时前约 100 步是适应期,初始通过率不能反映真实难度,须在适应后重新标定难度才能观察到马太效应,纠正了该现象在代码任务上的测量方法。
实验结果
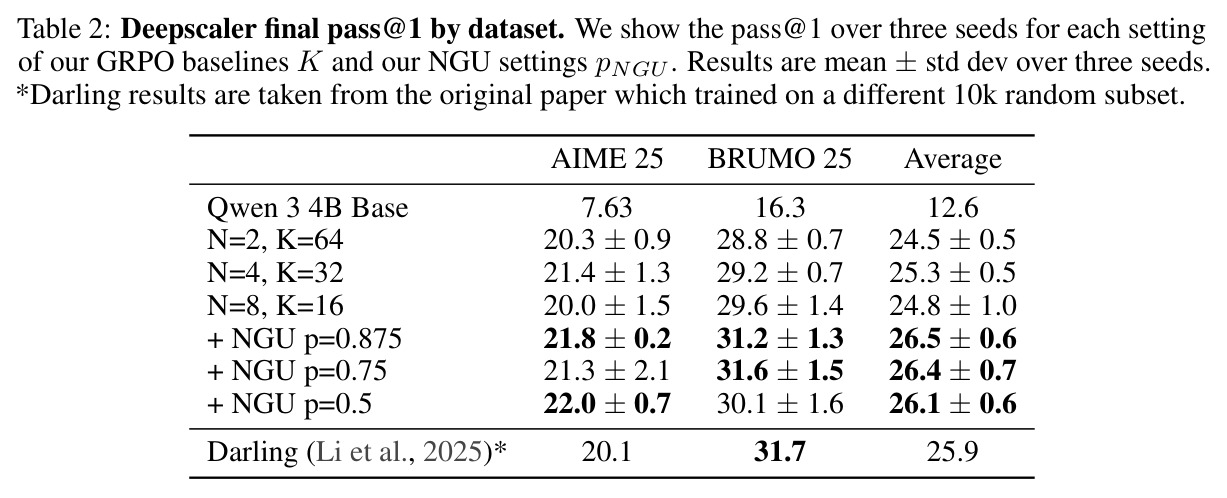
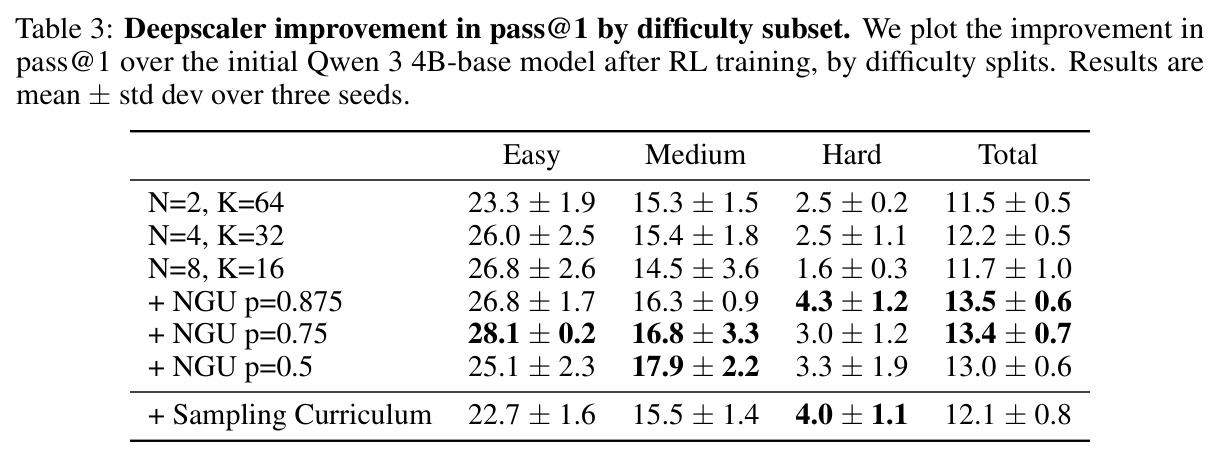
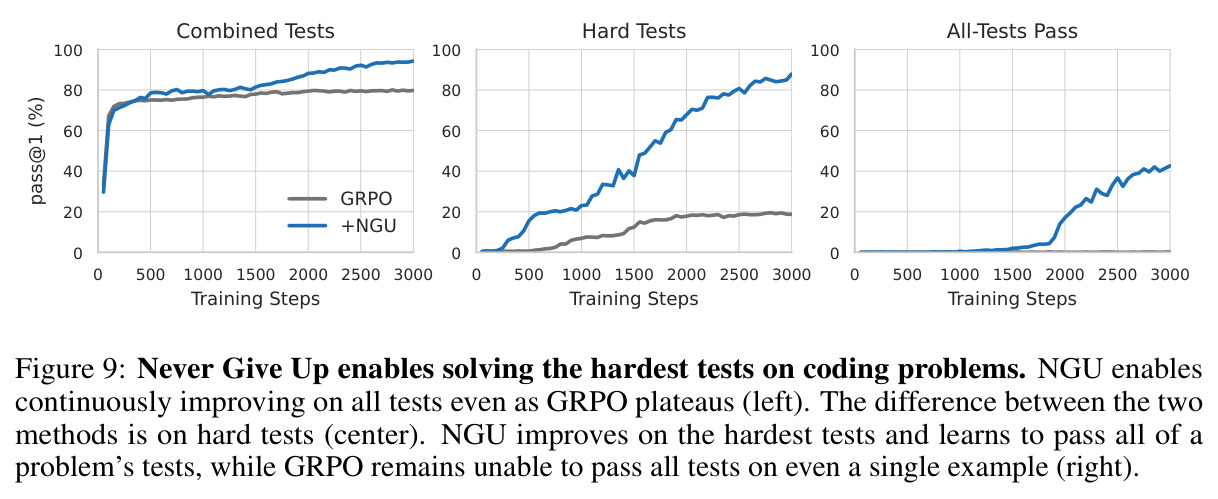
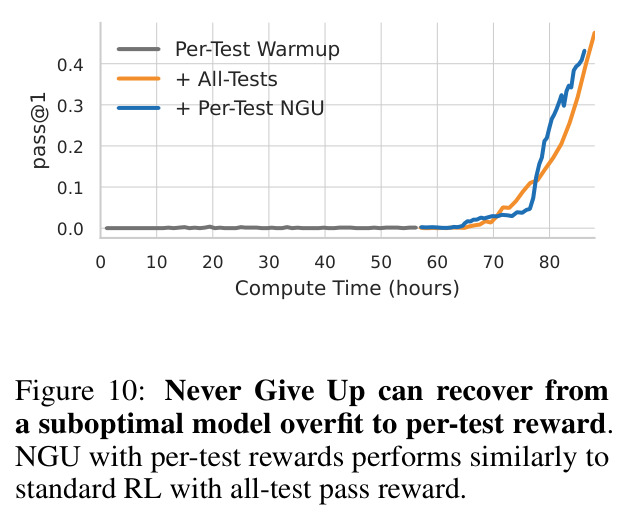
证据链分四步。(1)检验信号丢失假说:GSM8k Platinum + Qwen 2.5 0.5B,固定批 $N\times K=256$、2000 步、3 种子,$K\in\{4,8,16,32\}$ 全部呈现马太效应,且反直觉地 $K=4$ 综合最优、extra hard 档(初始 pass@1=0%,3/4 的题 1024 次采样内无解)差距最明显;图 3 揭示机制——$K=32$ 让简单题凭单个错误补全留在批内,$K=4$ 到 200 步已把批浓缩向难题。(2)小规模 NGU:$p_{NGU}=0.95$ 全面超越所有 $K$ 基线(图 4),增益集中于 extra hard;$T=4$ 最优,锚定正样本优于不重缩放与下采样(图 5、6)。(3)大规模数学:Qwen 3 4B-base 训练 Deepscaler 10k,评测 AIME 2025+BRUMO Nov 2025,按初始 pass@64 分桶(hard=0%、medium 均值 2.9%、easy 均值 46.1%),基线 $K\in\{16,32,64\}$ 呈难/易权衡,NGU($K=16$,$p\in\{0.5,0.75,0.875\}$)在最难 28 题上超越全部基线与课程学习基线,每配置对齐约 120 H100 小时、3 种子(图 7)。(4)代码:Manufactoria + Qwen 3 4B Instruct,逐测试奖励 GRPO 解约 80% 测试但从未整题全通过;NGU 在难测试上持续爬升并最终完全解题(图 9);从 3000 步检查点续训,逐测试+NGU 算力效率与全通过奖励方案相当(图 10),证明 LLM 的 RL 可从次优目标恢复、区别于塑性损失。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| GSM8k Platinum 数学推理(Qwen 2.5 0.5B Instruct,小规模测试床) | pass@1(按 easy/medium/hard/extra hard 四档难度桶) | NGU(N=64, K=4, p_NGU=0.95)综合与各难度档全面领先,增益集中于 extra hard 档 | GRPO 固定采样 $K\in\{4,8,16,32\}$(批大小恒为 256),其中 $K=4$ 为最强基线 | 固定算力下加大 K 不但无益反而更差,NGU 在最难档上的优势随训练持续扩大(图 2 vs 图 4) |
| Deepscaler 10k 训练 → AIME 2025 + BRUMO Nov 2025 评测(Qwen 3 4B-base) | pass@1 按初始 pass@64 分桶(hard 桶 pass@64=0,n=28;medium 均值 2.9%;easy 均值 46.1%) | NGU(K=16,p∈{0.5,0.75,0.875})在 hard 桶(28 题)上超过所有基线 | GRPO $K\in\{16,32,64\}$;按初始通过率固定大 K 的课程学习基线 | 每配置约 120 H100 小时算力对齐、3 种子下,NGU 提升 hard 桶且不明显牺牲 easy 桶;课程基线虽追平 hard 桶却损伤 easy 桶 |
| Manufactoria 代码生成(Qwen 3 4B Instruct,每题 14-30 个测试用例) | 综合测试通过率 / 难测试通过率 / 整题全通过率(pass@1) | NGU(p_NGU=0.95)在难测试上持续改进,最终学会通过整题全部测试 | 逐测试奖励 GRPO:约解 80% 测试后停滞,整题全通过数为 0 | 整题全通过从 0 提升到能完全解题;从 3000 步检查点续训时与全通过奖励 RL 算力效率相当 |
局限与改进
作者承认的局限:方法目前只在数学与代码这类可验证奖励的'上下文老虎机'设定中验证,尚未扩展到多步智能体环境(结论中列为未来工作);$p_{NGU}$ 是新引入的超参数,需要在难/易性能之间权衡调参;NGU 依赖异步 off-policy 基建,同步 RL 设置下得不到算力收益(附录 C.1);标量总分掩盖难度结构性差异,作者呼吁转向更稠密的评测信号。我的补充观察:其一,几何分布右尾很重,个别几乎不可能的题仍可能消耗巨量采样,$1-p_{NGU}$ 的放弃机制只是概率性兜底,缺乏基于进度信号的显式止损;其二,新鲜度阈值 $T=4$ 来自网格搜索,与训练步长、批大小耦合,跨设置迁移性存疑;其三,异步队列中难题补位速度取决于数据集难度构成,若数据集本身简单题占绝对多数,过滤带来的收益会被稀释;其四,逐测试奖励可能诱发出部分通过、投机取巧的代码解,论文未讨论奖励黑客风险;其五,全程依赖可验证奖励,开放性任务无法直接套用。
独立分析的弱点
独立分析的弱点与改进方向:(1)放弃机制无信息量——全错后仅按固定概率 $p_{NGU}$ 决定去留,不参考历史轮数或策略改进幅度,可改为随失败轮数衰减的 $p$,或基于验证器置信度的止损规则;(2)$T$ 阈值静态——off-policy 程度应由策略漂移量(KL 散度或参数更新距离)决定而非固定步数,自适应 $T$ 可能消除 $T=8,16$ 的劣化;(3)锚定正样本把所有留存负样本优势均匀重缩放,隐含'所有负样本同等无信息'假设,可按新鲜度或似然加权;(4)每题采样量方差极大,造成 rollout 长尾与 worker 负载不均,需要弹性批调度;(5)Harness-Aware 难度标定需在第 100 步额外采 128 个样本,可用训练中在线通过率滑窗估计替代;(6)Manufactoria 上 NGU 前期整体通过率略低于 GRPO,说明重尾采样在适应期有代价,可用先小 $p$ 后大 $p$ 的两阶段调度;(7)图 1 的证据来自不同模型/数据集横向对比,未在同一模型上做初始能力与增益的受控回归,因果链仍有加强空间。
未来方向
作者明确提出的方向:把 NGU 推广到多步、智能体(agentic)环境,那里稀疏奖励与探索问题更接近经典 RL 的探索文献(如基于状态回访与地图构建的探索方法);用更稠密的评测/奖励信号替代标量总分;与显式课程、数据分布调整类方法正交组合(NGU 不显式移动数据分布,与它们互补)。基于成果可延伸的方向:(1)将几何采样与测试时搜索结合,把'不放弃'延伸到推理时算力分配;(2)在 RLVR 之外的弱监督或模型评判(LLM-as-judge)场景检验信号效率假说的普适性;(3)理论化:建模固定批大小下 $K$ 与过滤率的关系,解释'$K=4$ 最优'的适用边界;(4)研究马太效应与预训练先验强度的因果关系——初始难度谱由预训练覆盖决定,或许可在 mid-training 阶段干预以改变效应强度;(5)把锚定正样本推广为一般化的陈旧样本基线复用框架,服务于各类异步 RL 系统;(6)在持续训练设定下检验 NGU 能否缓解'已解题回退'现象(附录 C.2 观察到的基线回退),将该方法从采样扩展到知识保持。
复现评估
复现条件评估:代码已开源(github.com/mnoukhov/never-give-up)。模型全部公开:Qwen 2.5 0.5B Instruct(小规模)、Qwen 3 4B base(数学)、Qwen 3 4B Instruct(代码);数据集公开:GSM8k Platinum、Deepscaler 10k 子集、Manufactoria。主要算力门槛在两个大规模实验:每个配置对齐约 120 H100 小时、每设置 3 个种子,单个结论点约 360 H100 小时;加上超参扫描($T$、$p_{NGU}$、$K$、锚定/下采样消融),全量复现在数千 H100 小时量级,普通实验室难以完整复现消融,但复现单一配置可行。难点在工程而非算法:必须具备异步 off-policy RL 基建(生成与训练解耦、队列式补题、样本 age 跟踪),作者基于 Ai2 Beaker 集群实现;无异步设施的团队需按附录 E 伪代码在同步框架近似,但会失去算力收益这一核心卖点。小规模 GSM8k 实验(0.5B、2000 步、批 256)单节点可复现,适合作为方法正确性的第一道验证。
论文图表
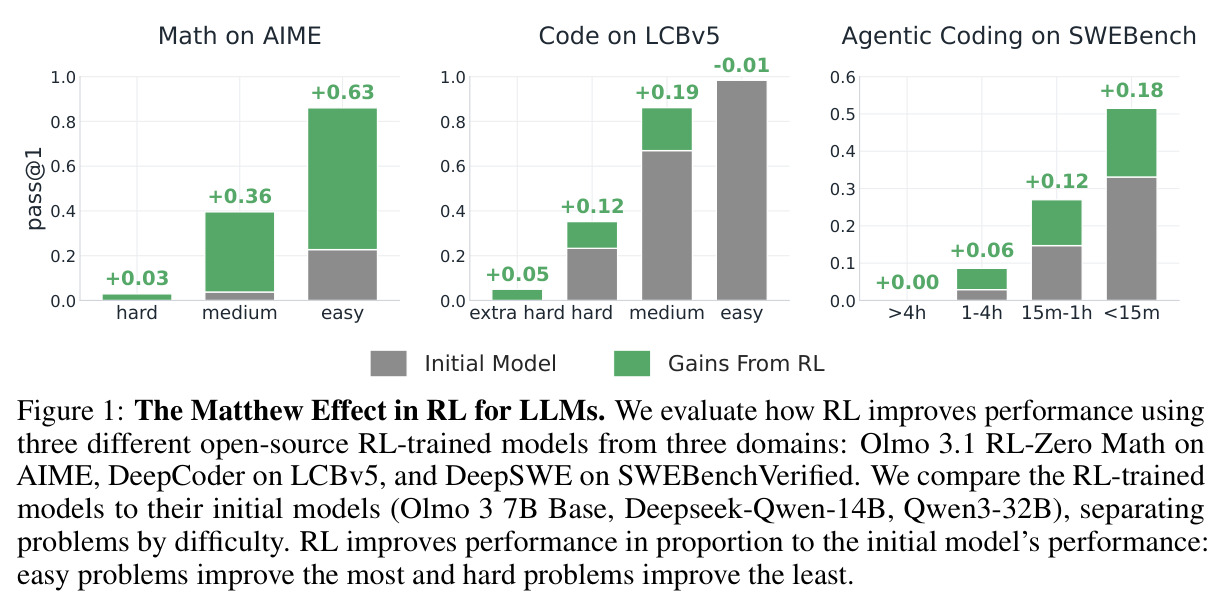
三组开源 RL 模型与其初始模型的分组柱状图:Olmo 3.1 RL-Zero Math 在 AIME、DeepCoder 在 LCBv5、DeepSWE 在 SWEBenchVerified 上,按初始通过率或人工预估时长分难度桶,标注各桶 pass@1 增益。AIME 易题 +0.63 对比最难档 +0.03;LCBv5 越难增益越小(+0.19/+0.05/+0.00);SWEBench 中 <15m 的题比 >4h 的题提升更大。
一张图定义全文核心现象'马太效应',是问题动机最直接的证据,展示该效应跨数学、代码、智能体代码三个领域、三个模型家族普遍存在。
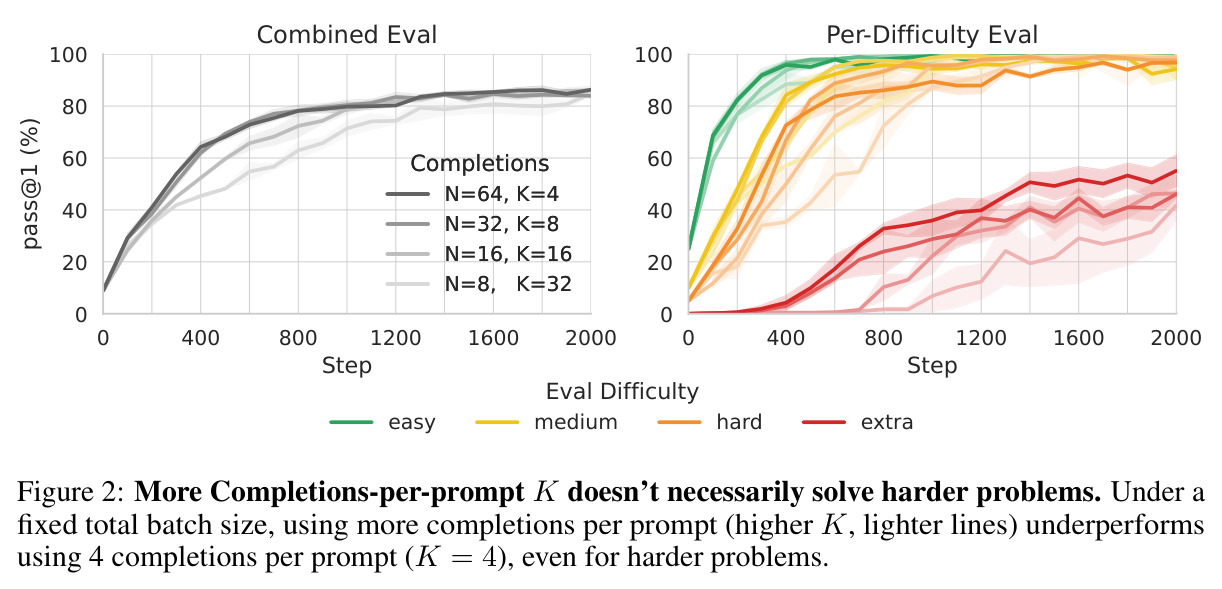
GSM8k Platinum 上固定批大小 $N\times K=256$、四种 GRPO 配置($K\in\{4,8,16,32\}$,$N$ 相应为 64/32/16/8)的训练曲线:左为综合 pass@1,右为分难度档曲线。$K=4$(最深色)综合最优,且在 extra hard(红线)上优势最明显;加大 $K$ 各难度均变差。
否证'信号丢失假说'(加大 K 就能采出正确答案)的关键实验,确立信号效率的替代视角,是本文论证的转折点。
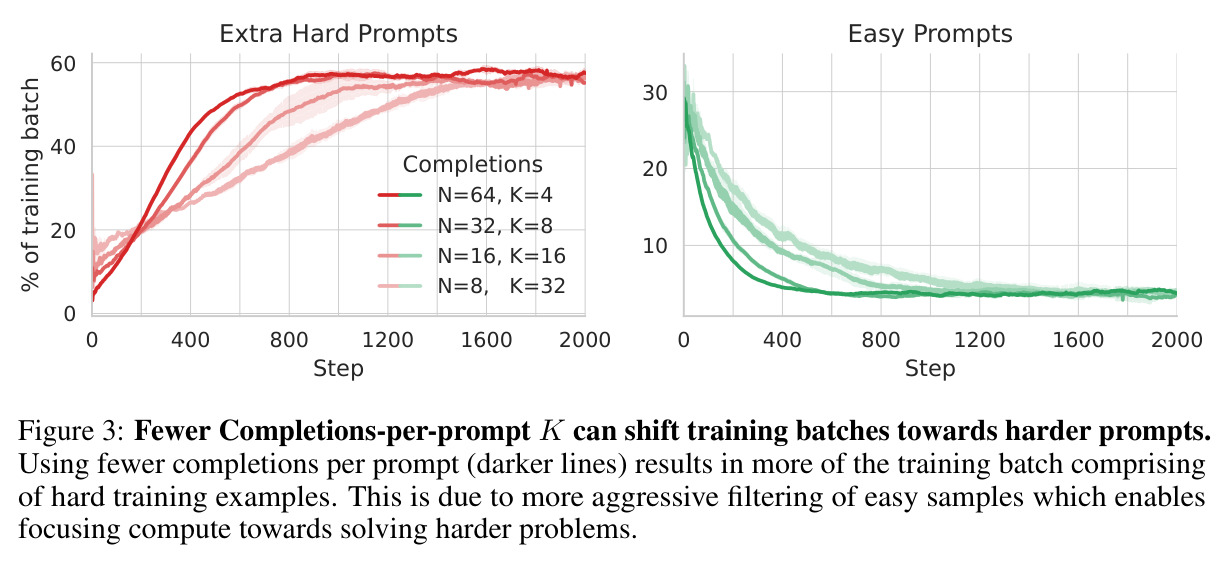
训练批组成随步数的变化:左为 extra hard 题占批内比例,右为 easy 题占比。$K=4$ 初期难题占比低,但约 200 步后因更激进地过滤简单题,批内难题占比反超 $K=32$;$K=32$ 则始终把大量简单题留在批内。
揭示 Figure 2 现象的机制——大 K 让简单题只要混入一个错误补全就留在训练批,算力被持续倒灌回已会做的题;这是'信号效率假说'的机理证据。
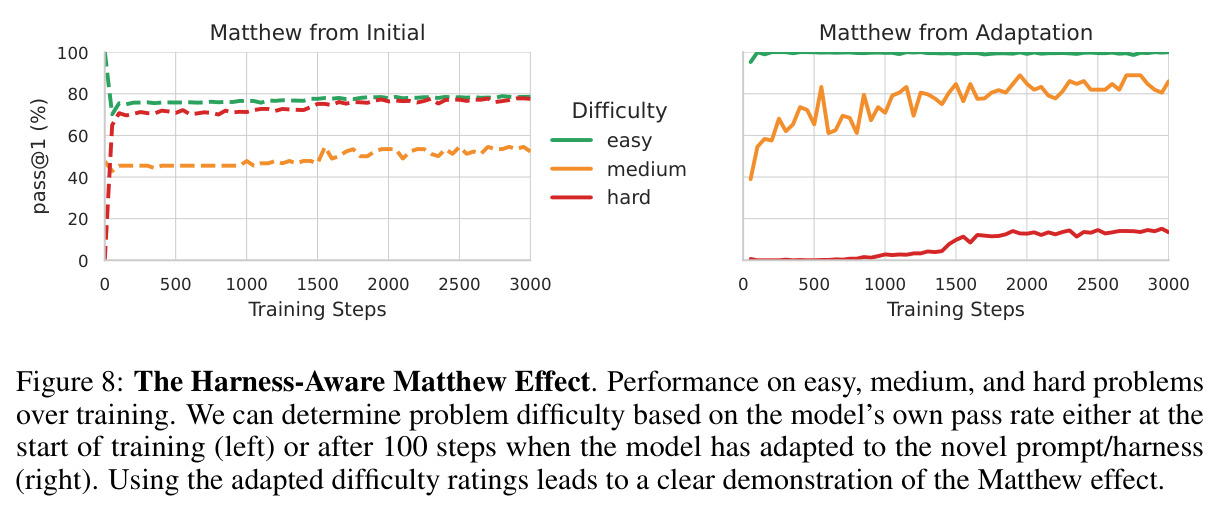
Manufactoria 上按难度分桶的性能曲线:左图用初始模型(128 个采样)的通过率分桶,看不到马太效应;右图在第 100 步模型适应新提示/格式后重新标定难度,马太效应清晰显现——易/中/难三桶的提升随难度递减。
提出并验证'适应期会掩盖马太效应'这一测量学贡献:新任务上前 100 步是提示/框架适应而非真实能力提升,纠正了难度评估方法。