VLA 强化学习的低秩结构 The Low-Rank Structure of VLA Reinforcement Learning
RL 在 VLA 的 Timestep 模块留下低秩更新,shift 方向可预测成败并可引导提分
前置知识
VLA(视觉-语言-动作模型)
由预训练视觉-语言主干加专用动作专家组成的机器人基础模型,输入图像与语言指令,输出连续动作块(action chunk)。代表工作包括 π0.5、GR00T N1.5/N1.6、SmolVLA。现代 VLA 普遍采用流匹配(flow matching)动作专家生成动作块,相比离散动作 token 推理延迟更低、时序一致性更好。
本文的研究对象就是这类模型的动作专家:RL 后训练到底改写了哪些参数、改成了什么结构。
流匹配与去噪时间步 τ
生成式训练目标:模型学习从噪声指向数据的速度场。行为克隆(BC)时采样 $a_\tau=(1-\tau)\epsilon+\tau a$,用 $\mathcal{L}_{\mathrm{FM}}=\mathbb{E}\,\|V_\theta(a_\tau,\tau,o)-(a-\epsilon)\|_2^2$ 回归,$\tau\sim U(0,1)$ 连续采样;推理时则从固定的少数离散时间步(如 5 步)迭代去噪出动作块。
训练用连续 $\tau$、推理只用离散 $\tau$ 这一错位,是本文解释低秩更新成因的关键:RL 恰好只在离散时间步上产生梯度。
Timestep Modules(时间步模块)
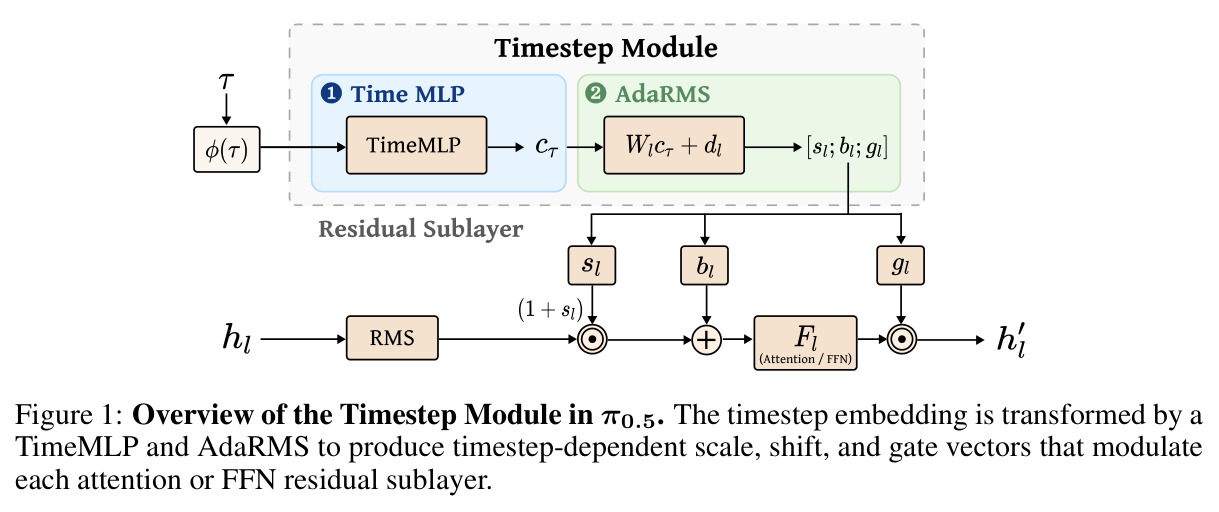
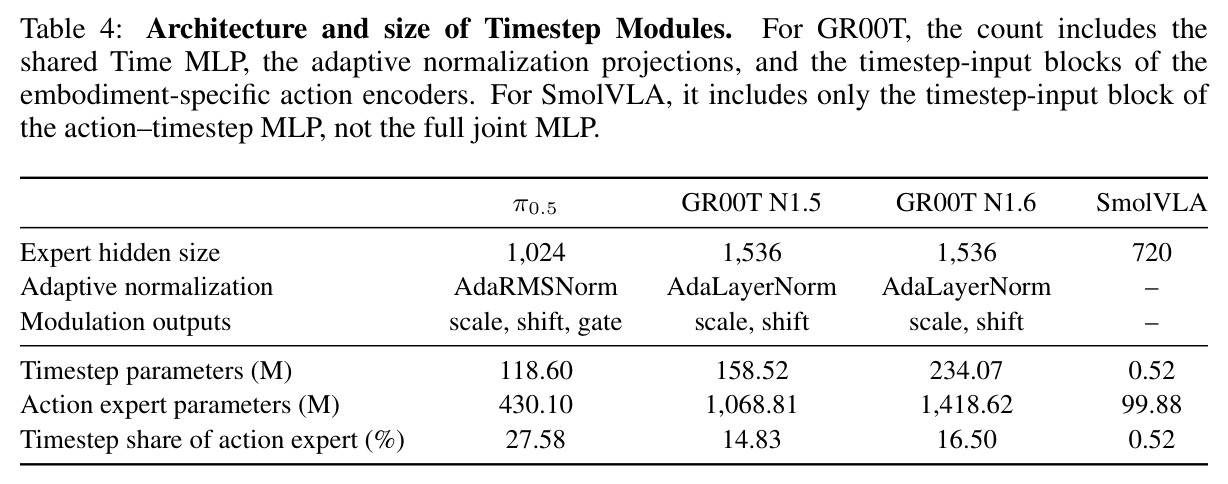
把标量去噪时间步 $\tau$ 变成调制向量的组件。以 π0.5 为例:Time MLP 先算 $c_\tau=\mathrm{TimeMLP}(\phi(\tau))$,再由 AdaRMS 输出 $[s_\ell;b_\ell;g_\ell]=W_\ell c_\tau+d_\ell$ 得到 scale/shift/gate,对每层残差子层做调制:$z_\ell=(1+s_\ell)\odot\mathrm{RMS}(h_\ell)+b_\ell$,$h'_\ell=h_\ell+g_\ell\odot F_\ell(z_\ell)$。它只依赖 $\tau$,与图像、语言、任务进度完全无关,仅占动作专家参数的 14.83%–27.58%。
本文的核心发现:RL 更新以低秩形式高度集中于这个此前被忽视、甚至被主流 LoRA 配置排除的小模块。
PPO 与 Flow-SDE
近端策略优化(PPO)用裁剪比率目标 $\mathcal{L}_{\mathrm{PPO}}=-\mathbb{E}[\min(\rho_i\hat{A}_i,\mathrm{clip}(\rho_i,1-\epsilon,1+\epsilon)\hat{A}_i)]$ 做稳定策略梯度;Flow-SDE 则在去噪过程中注入受控噪声实现探索。本文沿用 πRL 的配方:PPO 加 Flow-SDE,4–5 个去噪步,actor 学习率 $5\times10^{-6}$。
这是论文的 RL 后训练基线;其 on-policy 属性决定了动作专家只在 rollout 所用的离散时间步上被训练,直接引出低秩成因。
LoRA 与低秩适应
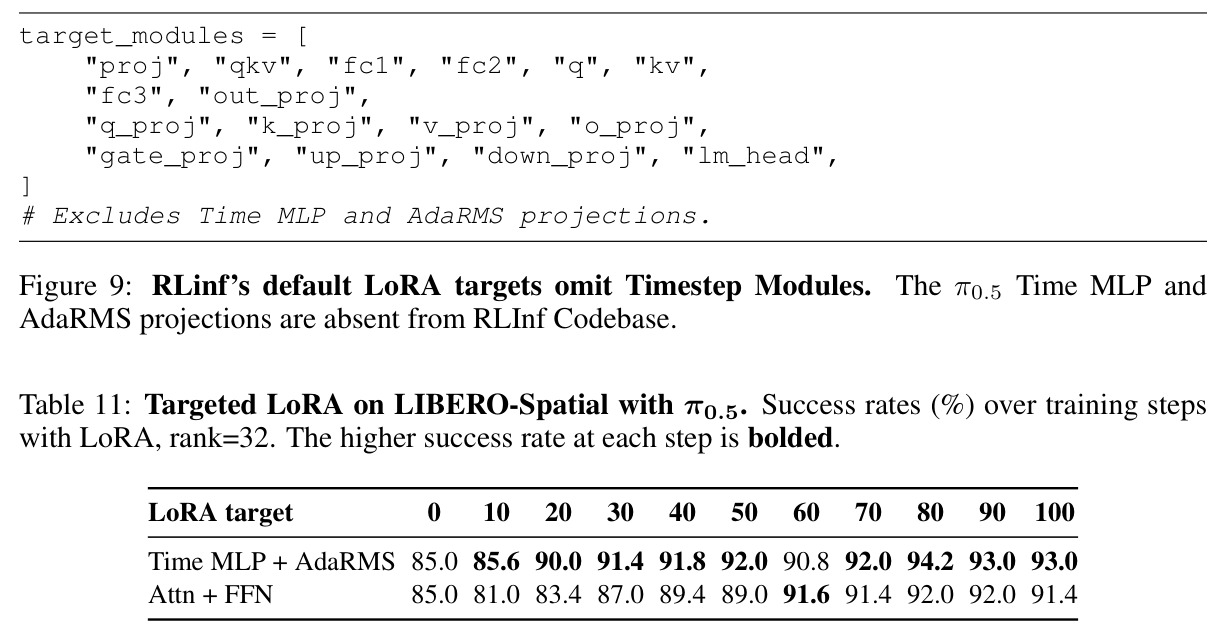
微调大模型时不直接更新 $\Delta W$,而是用低秩分解 $\Delta W\approx BA$(秩 $r\ll\min(m,n)$)只训练 $B,A$ 两个小矩阵,大幅省参数省显存。常见默认配置把 LoRA 打在 attention 与 FFN 的投影矩阵上。
论文发现 RL 更新天然低秩,且 RLinf 等框架的默认 LoRA 目标恰恰漏掉了 Timestep Modules;把 LoRA 定向到该模块反而更快更准。
SVD 与有效秩
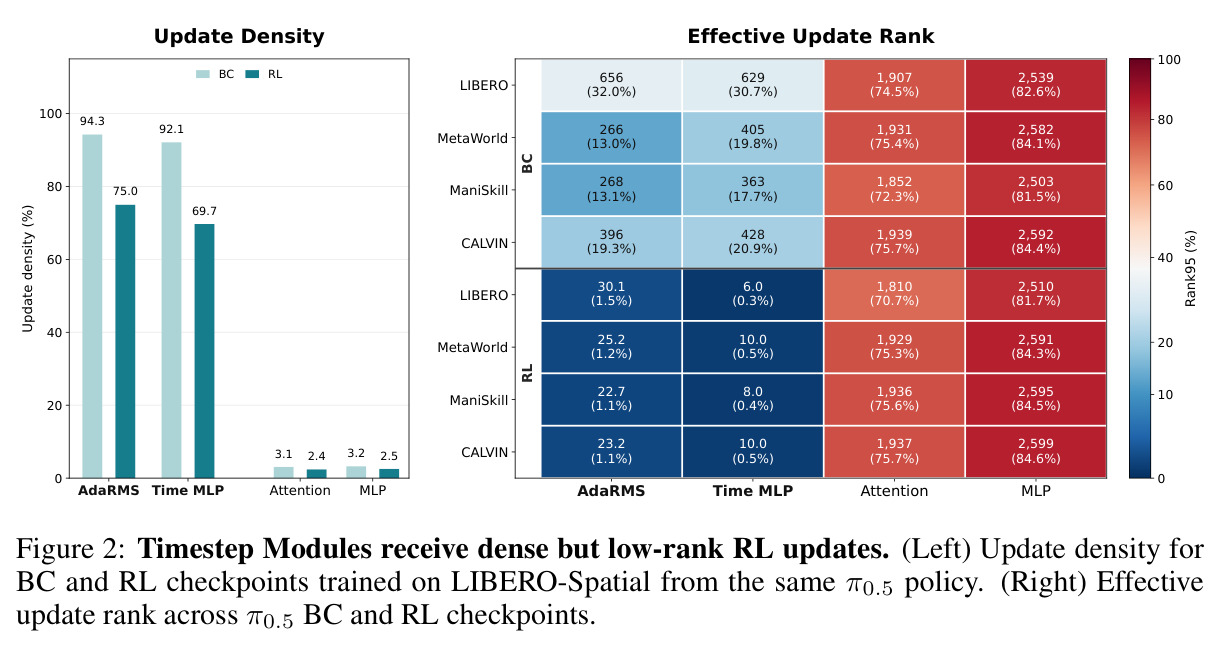
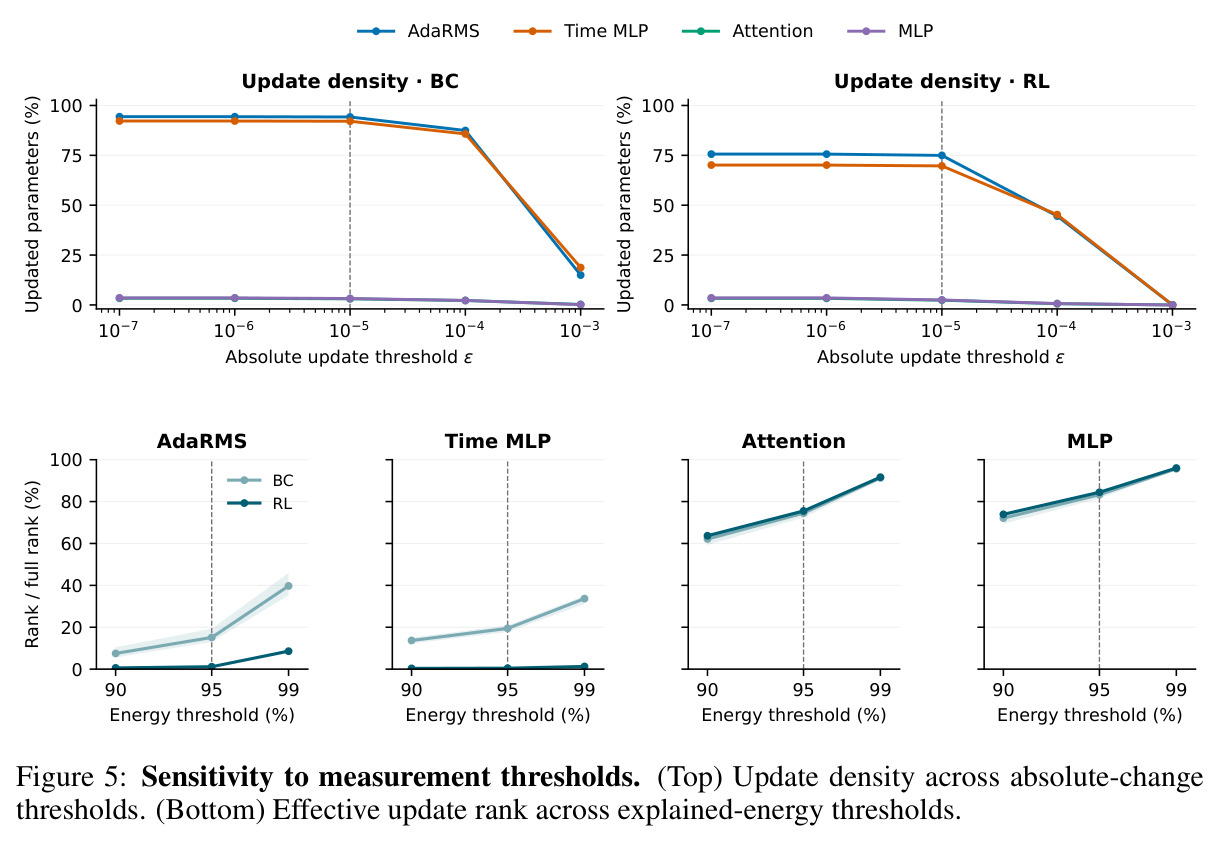
对更新矩阵做奇异值分解可得其能量沿奇异方向的分布。论文定义有效更新秩 $r_{95}(\Delta W)=\min\{r:\sum_{i=1}^{r}\sigma_i^2/\sum_i\sigma_i^2\ge 0.95\}$,即解释 95% 更新能量所需的最少方向数;更新密度则是绝对变化超过阈值 $10^{-5}$ 的参数占比。
「更新落在哪里(密度)+ 有多低秩(有效秩)」是全文的第一层证据,所有后续分析都建立在这两个度量上。
线性探针与激活引导
线性探针在隐状态表示上训练线性分类器,检验某个方向是否携带特定信息;激活引导(activation steering)则在推理时沿某方向平移隐状态,因果地改变模型输出。两者结合可以既诊断又干预模型内部表示。
论文把 RL 引起的 shift 更新 $\Delta b=b_{\mathrm{RL}}-b_{\mathrm{base}}$ 同时用作探针方向(预测成败 AUC 至 99.6%)和引导方向(测试时再涨 2–4 个百分点),是全文第二、三层证据的核心工具。
研究动机
LLM 社区对 RL 后训练已有相当成熟的参数级理解:RL 只微调稀疏子网络(Mukherjee et al., 2025)、更新存在主导低秩方向(Cai et al., 2026),这些认识直接催生了 LoRA 等参数高效方法。机器人侧的情况完全不同。由于高质量遥操作演示极其昂贵,SimpleVLA-RL、πRL 等工作已证明在线 RL 在仿真中后训练 VLA 十分有效(如 π0.5 在 ManiSkill 上成功率从 42.2% 提到 89.1%),但这些工作把策略当黑箱,没人知道 RL 的学习信号究竟写进了哪些参数。与此同时,动作专家的架构与 LLM 截然不同——它带去噪时间步条件化和自适应归一化——LLM 的结论无法照搬;而主流 RL 框架(如 RLinf)的默认 LoRA 目标列表只包含 attention/FFN 投影,恰好漏掉了流匹配 VLA 独有的 Timestep Modules。结果是参数高效后训练全靠经验试错:既浪费算力,又可能把预算花在错误的模块上。
本文的目标是本文要在参数空间系统回答一组递进问题:(1) Where & How——RL 更新落在 VLA 的哪些模块,密度和秩是什么结构;(2) 因果性——这些更新是否真的承载了 RL 的性能收益,还是无关副产品;(3) 机理——被更新的 Timestep Modules 内部到底编码了什么,为什么呈现低秩;(4) 利用——能否反过来利用这些结构,做出更快的参数高效 RL(定向 LoRA)和免训练的性能提升(测试时引导)。作者在 π0.5、GR00T N1.5/N1.6、SmolVLA 四个模型族和 LIBERO、ManiSkill、MetaWorld、CALVIN 四个操作基准上做跨架构、跨基准的一致性验证,目标是给出 VLA RL 的第一份参数级刻画,为高效、可解释的 VLA 后训练奠定基础。
与已有工作不同的是,独特切入角度有三点。第一,对象新:不问「RL 能提多少分」,而问「RL 把东西写在了哪」,并锁定 Timestep Modules——这个流/扩散策略独有的组件,此前在 RL 分析、PEFT 目标选择和 VLA 可解释性工作中都无人碰过。第二,机制归因新:作者注意到 on-policy RL 与 BC 有一个本质训练差异——BC 在 $\tau\in[0,1]$ 连续采样训练,而 RL 只在 rollout 使用的 $K$ 个固定离散去噪时间步上训练——并设计了「离散时间步 BC」对照实验,干净地证明这一训练机制差异正是低秩结构的成因,而不是 RL 本身的某种玄学性质。第三,方法视角新:把参数更新 $\Delta W$、$\Delta b$ 当作表示空间中的方向统一使用,同一组 shift 更新方向既能做预测(探针)又能做干预(引导),把参数分析、表示探测和行为控制连成闭环;还用 RL 训练的图像/视频 DiT 做对照,排除了「流架构通病」的替代解释。
核心方法
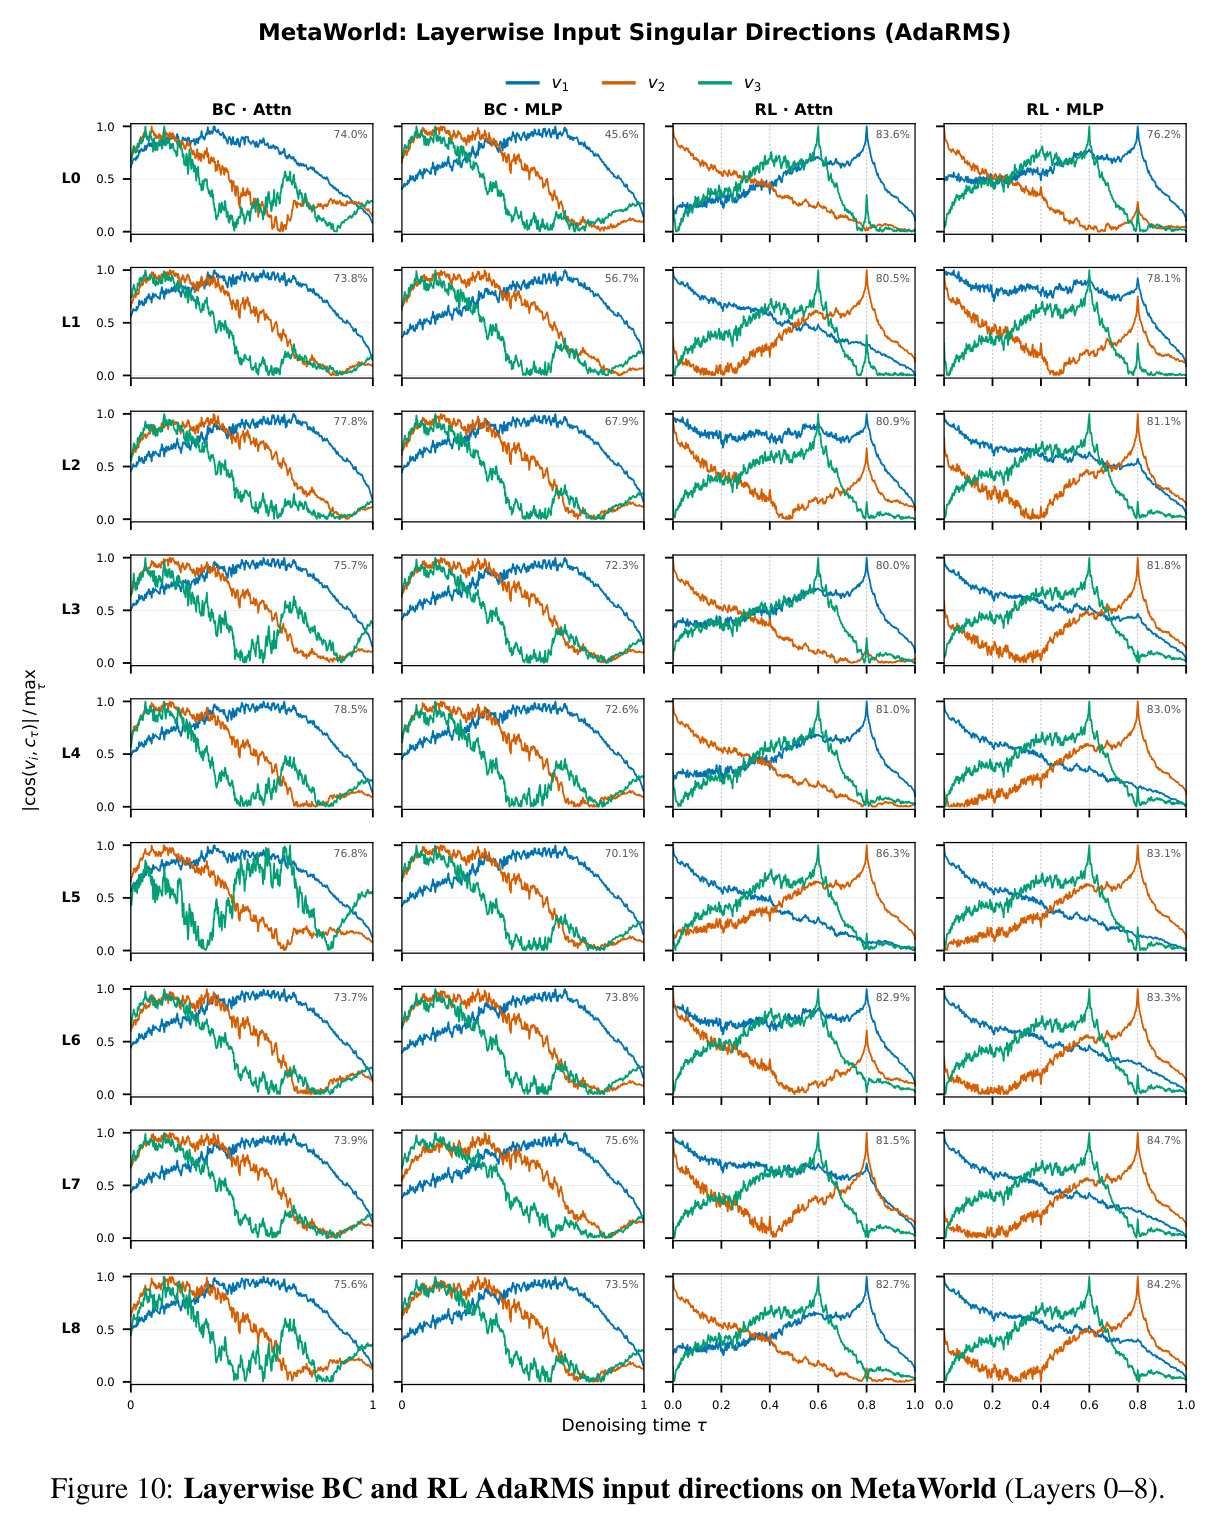
直觉先行:流匹配 VLA 推理时只用少数几个固定时间步迭代去噪,而 Timestep Modules 只看 $\tau$、不看任何观测,所以「RL 学到的东西」很可能只是一小组与输入无关、按时间步索引的调制向量修正——这种东西天然只需要几个方向就能表达。技术路线分四步。第一步度量:定义 $\Delta W=W_{\mathrm{trained}}-W_{\mathrm{reference}}$,逐矩阵计算更新密度($|\Delta|>10^{-5}$ 的参数占比)与有效秩 $r_{95}(\Delta W)=\min\{r:\sum_{i\le r}\sigma_i^2/\sum_i\sigma_i^2\ge0.95\}$,在 π0.5/GR00T N1.5/N1.6/SmolVLA × LIBERO/ManiSkill/MetaWorld/CALVIN 上扫描,并对照 FLUX、Wan2.2 等 RL 训练的图像/视频 DiT。第二步因果:模块替换实验,从 RL 检查点出发分别把 MLP+Attn 或 Timestep Modules 回退到 base 权重,看谁保住了收益。第三步机理:对 AdaRMS 更新做 SVD 取前三个输入奇异方向,测其与条件向量 $c_\tau$ 的响应曲线 $|\cos(v_i,c_\tau)|$ 随 $\tau$ 的变化,用离散时间步 BC 做对照;再分别对 scale/shift/gate 计算 base 输出与 RL 增量的余弦相似度。第四步利用:以 $\Delta b=b_{\mathrm{RL}}-b_{\mathrm{base}}$ 为方向做线性探针、跨任务几何分析与自适应激活引导,并把 rank=32 的 LoRA 定向到 Timestep Modules 与标准配置对比。
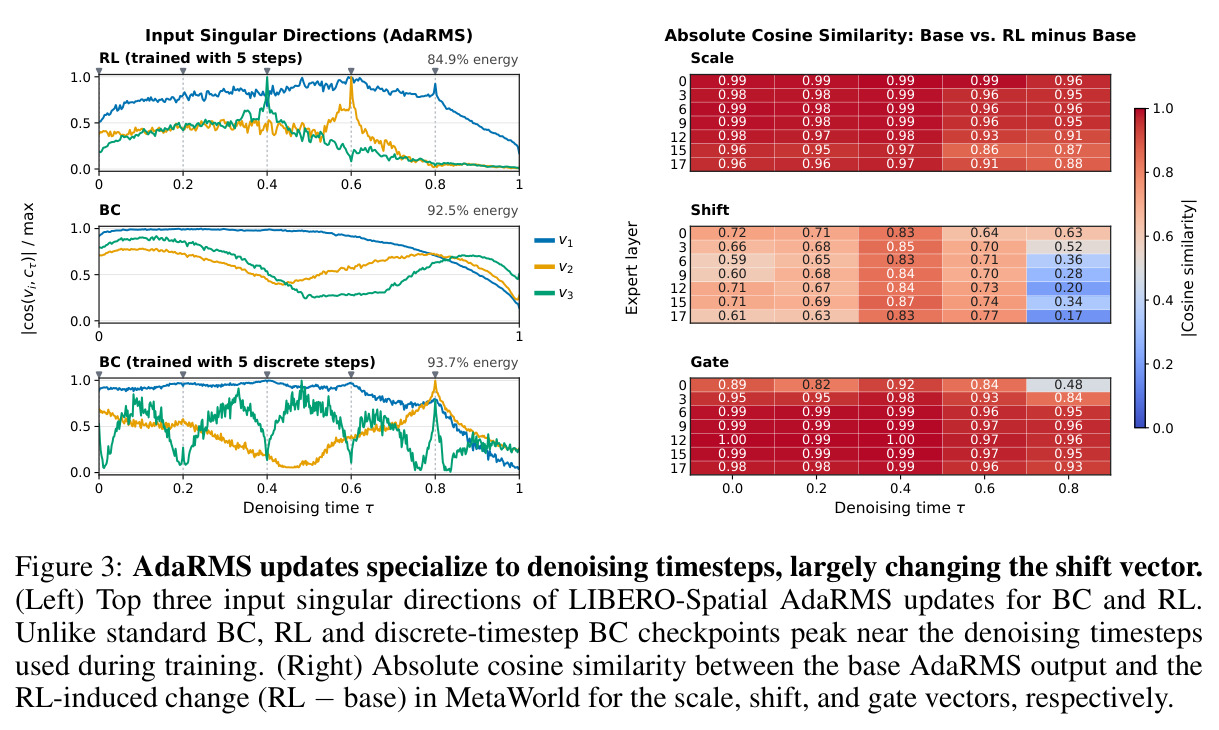
核心洞察:RL 更新的低秩不是经验巧合,而是「离散时间步训练 × 只依赖 $\tau$ 的调制模块」的必然结果。BC 训练时 $\tau$ 连续采样,AdaRMS 必须在整个 $[0,1]$ 区间上平滑响应,其更新天然高秩(有效秩 250–650);而 on-policy RL 只在 rollout 使用的 $K$ 个固定 $\tau$ 上产生梯度,模块只需记住 $K$ 组与输入无关的调制偏移,几个方向就足够(有效秩 6–30)。这一个机制同时解释了三个现象:为何低秩集中在 Timestep Modules;为何模块替换实验中它们承载不成比例的 RL 收益;为何 shift 向量变化最剧烈——它被直接加到隐状态上,是承载任务相关新方向的最佳通道。与 LLM RL 文献中「RL 更新稀疏/低秩」的纯经验观察不同,这里给出了架构加训练机制的机理性因果链(用离散时间步 BC 这一对照隔离了变量),并且对照实验显示图像/视频 DiT 的 RL 并不出现该结构,说明它是动作策略特有的性质,而非流匹配架构的通病。
方法步骤详情
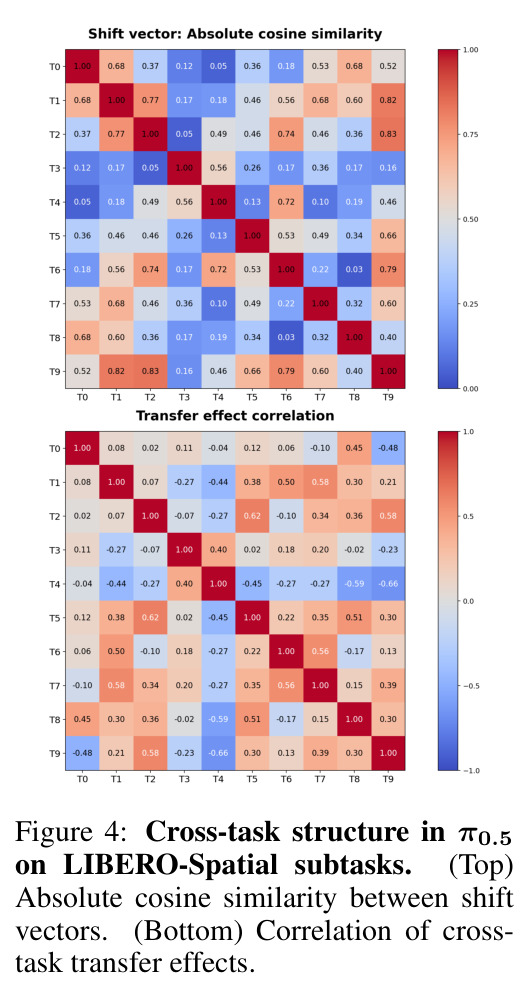
第一步,检查点准备:使用 OpenPI 公共 π0.5 base、RLinf 发布的 BC/RL 检查点(MetaWorld/ManiSkill/CALVIN 的 RL 用 Flow-SDE 版本),并在 4×H100 80GB 上自训 π0.5 LIBERO 三套 RL(PPO,actor lr $5\times10^{-6}$,5 步去噪,Flow-SDE $\sigma=0.3$–$0.5$,全局 batch 2048)、GR00T 短程 RL(5–25 步)以及 π0.5 BC 与离散时间步 BC。第二步,参数分析:逐矩阵计算 $\Delta W$ 的密度与 $r_{95}$,并对密度阈值($10^{-7}$–$10^{-3}$)和能量阈值(90/95/99%)做消融确认稳健。第三步,模块替换:从每个 RL 检查点出发,构造「仅 Timestep Modules 保留 RL 训练」与「仅 MLP+Attn 保留 RL 训练」两种混合模型并评估成功率;再对 Timestep 更新做 SVD,分别用「仅前 4 个奇异方向重构」与「删去前 4 个方向」两种消融定位低秩成分的贡献。第四步,时间步特化:对每个 AdaRMS 更新取前三个输入奇异方向 $v_i$,绘制 $|\cos(v_i,c_\tau)|$ 随 $\tau$ 的响应曲线,对比标准 BC、RL、离散时间步 BC 三种训练。第五步,输出分离:在 RL 训练用到的每个 $\tau$ 上,分别计算 scale/shift/gate 的 base 输出与 RL−base 增量之间的绝对余弦相似度。第六步,探针:以每个「子层×时间步」位置的 $\Delta b$ 为方向,rollout 中提取对应子层输入的隐状态投影并按 episode 平均,特征向量喂给 $\ell_2$ 正则逻辑回归,任务按 70:30 划分、在 held-out 任务上测试,随机标签做对照。第七步,跨任务几何:对 10 个 LIBERO-Spatial 任务各训单任务 RL 策略,构造每任务的 shift 更新向量与迁移效应向量(10 个策略对该任务的成功率增益),比较前者的余弦相似度与后者的 Spearman 相关的关联。第八步,应用:选探针 F1 最高的位置,当投影偏离成功 episode 均值时沿 $\Delta b$ 平移最小所需量做自适应引导;另做 rank=32 定向 LoRA 对比。
技术新颖性
技术新颖性体现在三个层面。对象层面:Timestep Modules 是流/扩散策略独有的组件,LLM 没有对应物;此前没有工作从 RL 角度审视它,RLinf 的默认 LoRA 目标甚至明确不包含它,本文首次证明 RL 的学习信号恰恰高度集中于此。结论层面:首次发现 VLA RL 更新「稠密且低秩」地集中于单一模块——注意与 LLM RL 的「稀疏子网络」(低密度)结论形成有趣对照,这里密度高达 70–95% 而秩极低;更重要的是给出了机制级因果链:离散时间步训练导致时间步特化、特化导致低秩,其中每环都有对照实验支撑(离散时间步 BC 复现了低秩与尖峰化响应),并用图像/视频 DiT 的反向证据说明该结构依赖「策略」而非「架构」。方法层面:把参数更新 $\Delta W/\Delta b$ 当作表示空间中的方向统一复用——同一组 shift 方向既做预测(探针 ROC-AUC 99.6%)又做干预(测试时引导 +2~4 个百分点),实现「参数→表示→行为」的三段式闭环分析,这种研究范式在 VLA RL 文献中是第一次出现。
实验结果
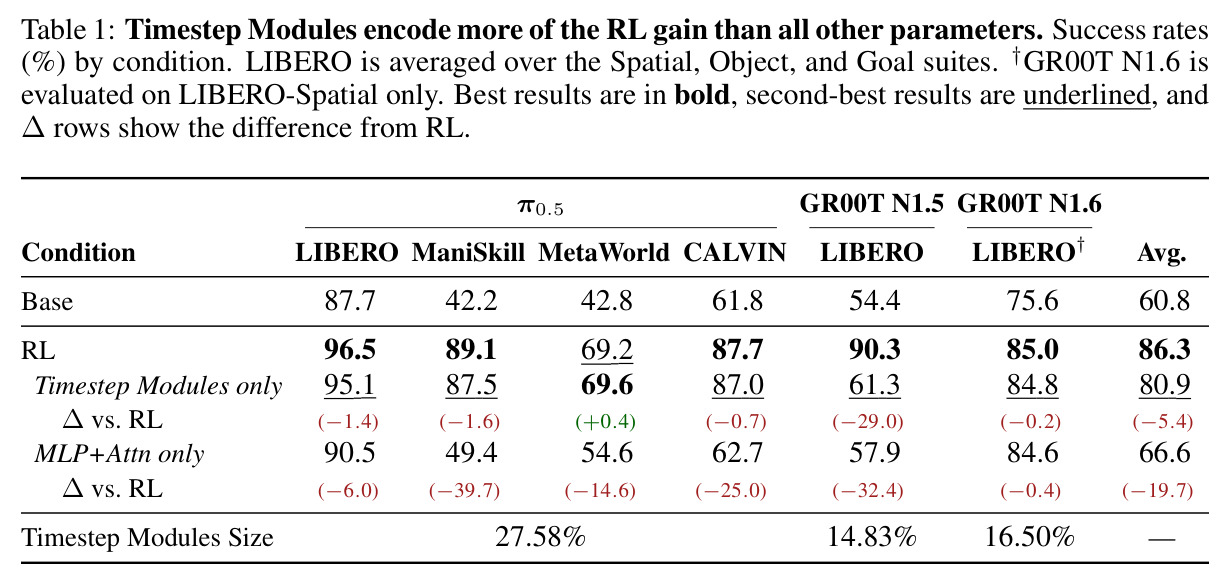
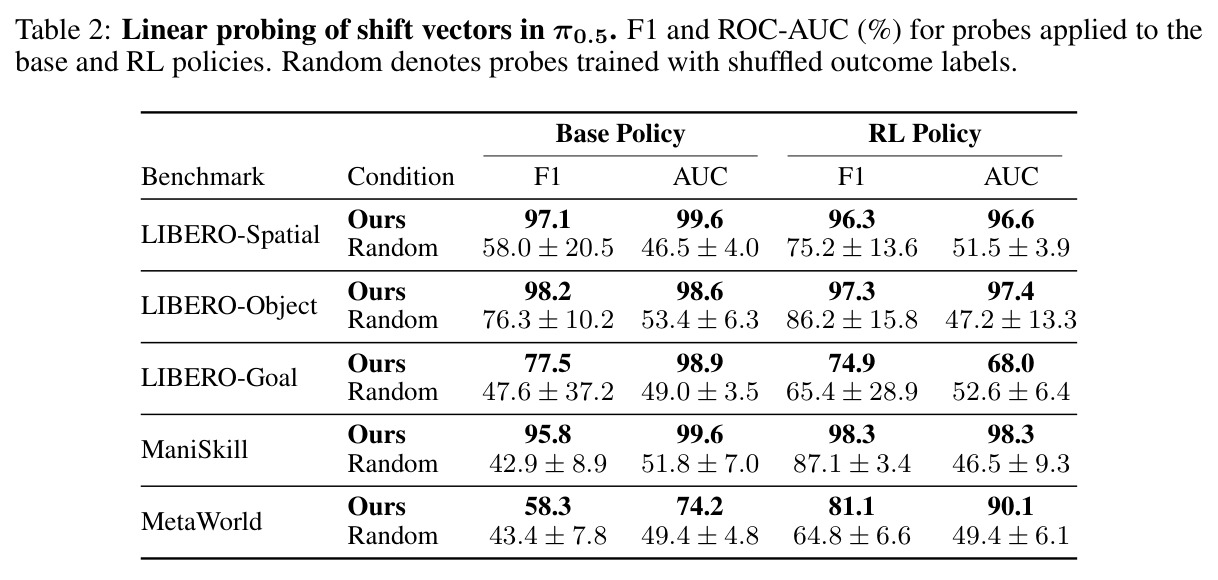
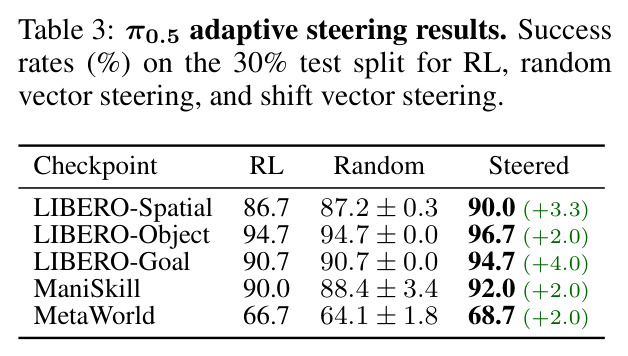
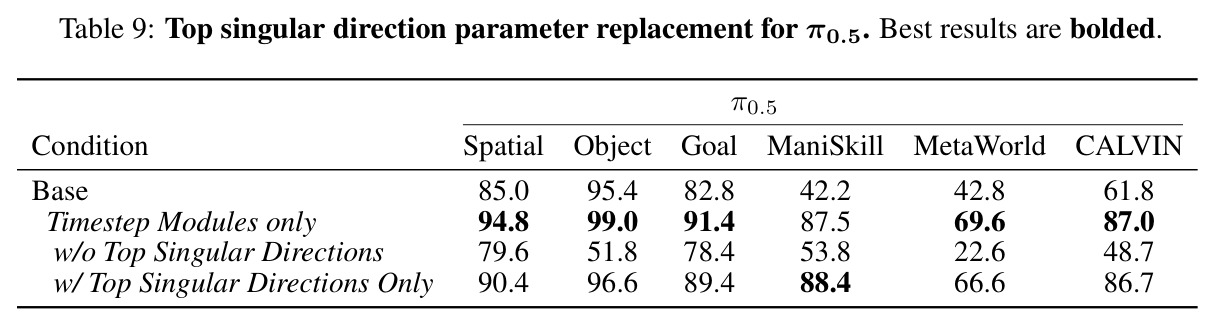
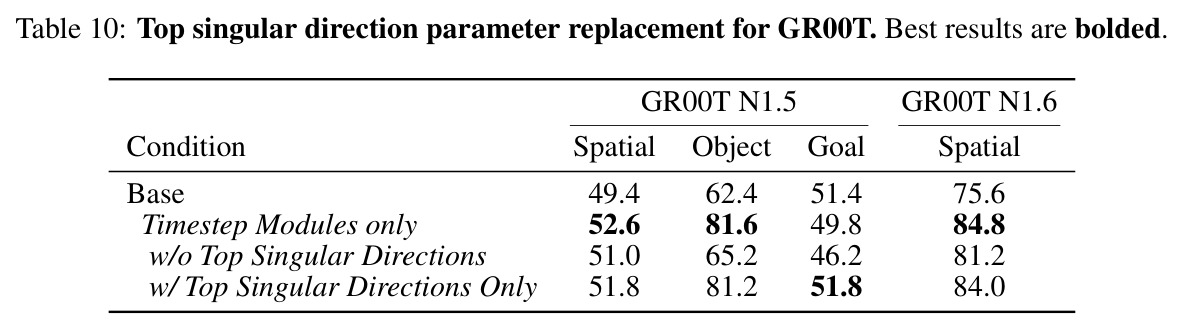
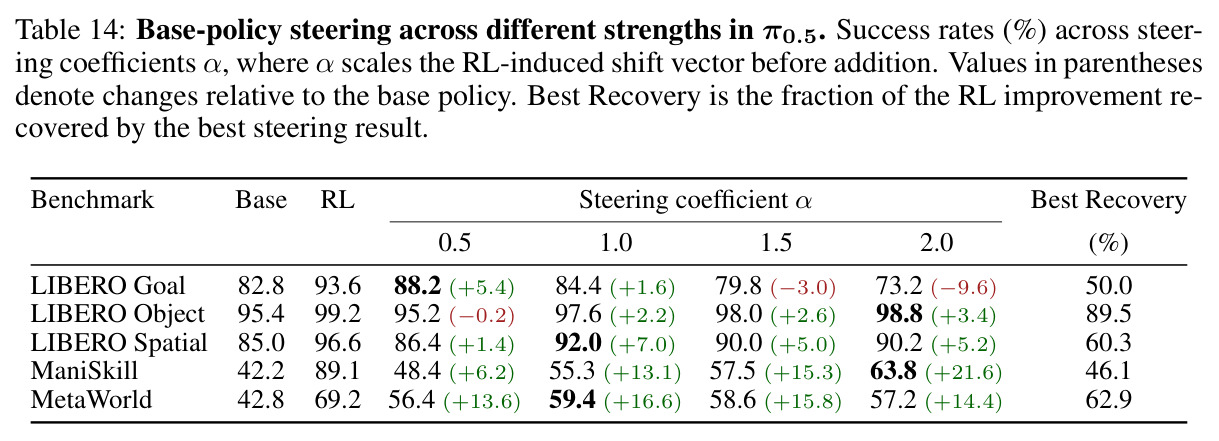
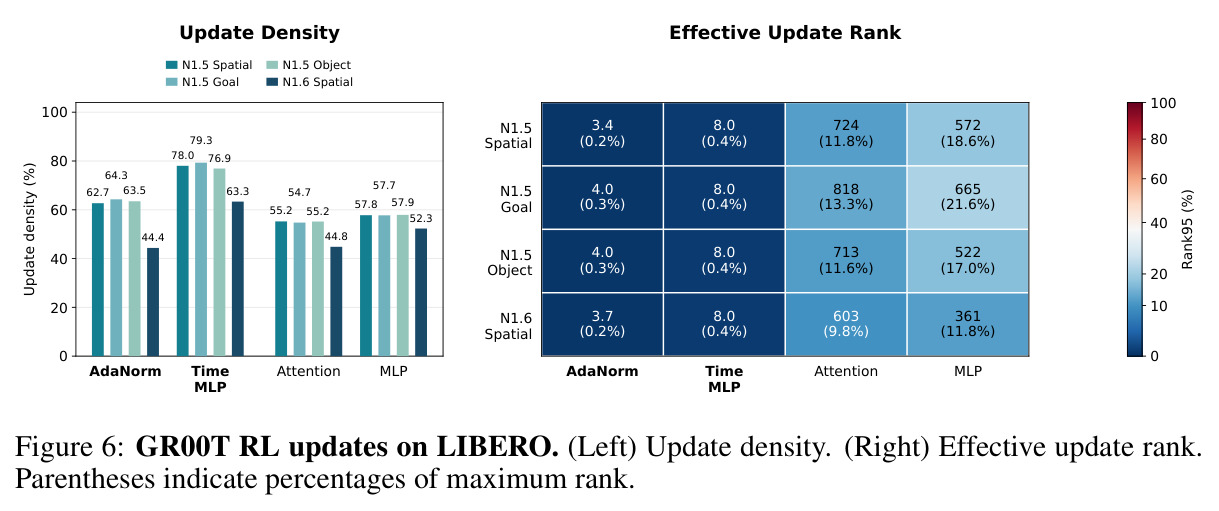
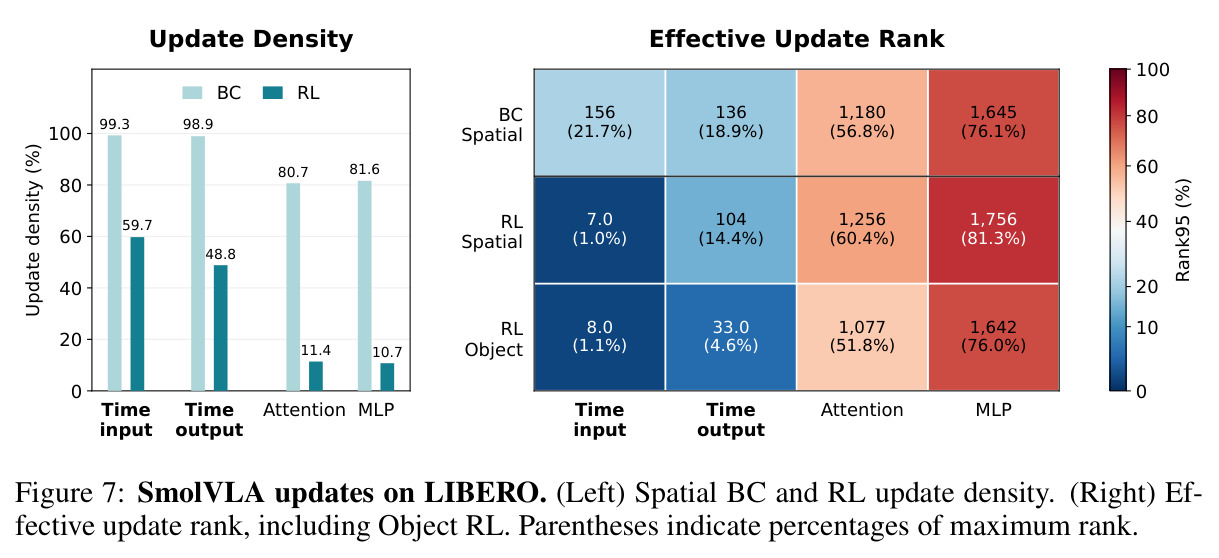
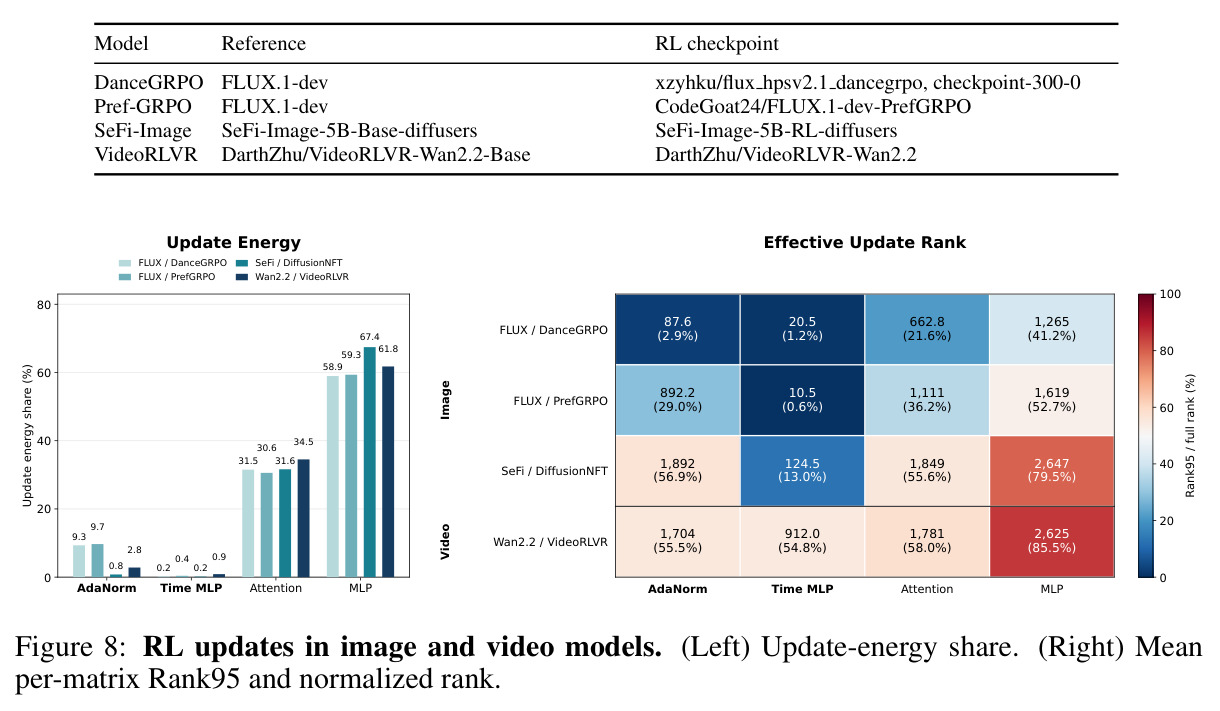
逐实验拆解。(1) 参数结构(Fig 2/5/6/7):π0.5 上 Timestep Modules 更新密度 70–95%(AdaRMS 75.0%、Time MLP 69.7%),而 attention/MLP 不足 5%(3.1%/2.4%);RL 使 AdaRMS 有效秩从 BC 的 250–650 骤降至 6–30(仅满秩的 0.3–1.5%),attention/MLP 在两种训练下都保持高秩(约 1800–2600,70–85%)。GR00T 更极端:AdaNorm 更新只需 3.4–4.0 个方向、Time MLP 需 8.0 个;SmolVLA 时间步输入块 RL 需 7–8 个方向 vs BC 的 156 个。99% 能量阈值下 AdaRMS 的 RL 更新也只需 8.2–9.3% 满秩(BC 为 35.3–46.0%)。反观 FLUX(DanceGRPO/Pref-GRPO)、SeFi-Image、Wan2.2(VideoRLVR)等图像/视频 DiT:更新能量 90–99% 落在 attention/MLP,Timestep 模块更新需 29–80% 满秩——低秩集中是 VLA 策略特有的。(2) 模块替换(Table 1/9/10):仅保留 Timestep Modules 的 RL 训练平均成功率 80.9%,接近完整 RL 的 86.3%,远超 MLP+Attn-only 的 66.6%;π0.5 上与完整 RL 只差 −1.4/−1.6/+0.4/−0.7(LIBERO/ManiSkill/MetaWorld/CALVIN),而 MLP+Attn-only 在 ManiSkill 暴跌 −39.7。只用前 4 个奇异方向重构即保留大部分收益(ManiSkill 88.4 vs 87.5),删去它们则在 6 个基准中 5 个跌破 base。(3) 机理(Fig 3):RL 与离散时间步 BC 的时间步响应在训练用 $\tau$ 处尖锐峰值化,标准 BC 平滑;scale/gate 的 RL 增量与原方向余弦高达 0.86–0.99(主要是缩放),shift 低至 0.17–0.92(引入新方向)。(4) 探针(Table 2/12):shift 更新方向预测 episode 成败,base 策略在 LIBERO-Spatial/Object/Goal 与 ManiSkill 上 ROC-AUC 达 98.6–99.6,单个「子层×时间步」方向也有 96.9–99.0,远超随机标签对照(约 47–53)。(5) 跨任务几何(Fig 4):shift 更新对齐度与迁移相似度的任务级 Spearman 相关平均 0.504(最高 0.794)。(6) 应用(Table 3/11/14):自适应引导使 RL 策略再涨 2.0–4.0 个百分点(Goal 90.7%→94.7%),等范数随机方向无增益(87.2±0.3 vs 86.7);对 base 策略引导最多恢复 RL 增益的 46.1–89.5%(ManiSkill 42.2%→63.8%);定向 LoRA(rank 32)收敛更快、终值 93.0 vs 91.4。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 模块替换(π0.5,LIBERO 三套平均) | 成功率 (%) | 仅 Timestep Modules 保留 RL:95.1 | 完整 RL 96.5;仅 MLP+Attn 保留 RL:90.5 | 以 27.58% 的参数量保住 RL 增益(−1.4),MLP+Attn-only 则损失 −6.0 |
| 模块替换(π0.5,ManiSkill) | 成功率 (%) | 仅 Timestep Modules:87.5 | 完整 RL 89.1;仅 MLP+Attn:49.4 | Timestep-only 仅降 1.6 点,MLP+Attn-only 暴跌 39.7 点 |
| shift 更新探针(π0.5,LIBERO-Spatial / ManiSkill,base 策略) | ROC-AUC (%) | 99.6 | 随机标签对照 46.5±4.0 / 51.8±7.0 | 接近完美的成败可分性;单个子层×时间步方向也达 96.9–99.0 |
| 自适应引导(π0.5 RL,LIBERO-Goal,30% 测试集) | 成功率 (%) | 94.7 | RL 策略 90.7;随机方向引导 90.7±0.0 | +4.0 个百分点,且五个基准全部 +2.0~+4.0 |
| 定向 LoRA(π0.5,LIBERO-Spatial,rank 32) | 成功率 (%),100 步 | 93.0(Time MLP+AdaRMS) | 标准 Attn+FFN LoRA 91.4 | +1.6 且前期收敛显著更快(第 20 步 90.0 vs 83.4) |
| AdaRMS 更新有效秩(π0.5,95% 能量,跨四基准) | 秩(占满秩 %) | RL:6–30(0.3–1.5%) | BC:250–650(13.0–32.0%) | RL 更新比 BC 低约一个数量级,且对阈值选择稳健 |
局限与改进
作者承认且可从数据中观察到的局限:(1) 架构依赖性——GR00T N1.5 上 Timestep-only 比完整 RL 低 29.0 个点(61.3 vs 90.3),是全部实验中唯一的反例,作者仅以「检查点含低精度训练的高秩噪声」部分解释,未给出定论;N1.6 上反而 MLP+Attn-only 也几乎无损(−0.4)。(2) 探针与引导实验集中在 π0.5,GR00T 只做了参数分析,结论的跨架构完整性打了折扣。(3) 探针拟合需要仿真中的 episode 成败标签,真机场景难以获得;引导强度 α 较敏感——base 策略引导时 α=2.0 在 LIBERO-Goal 上反而 −9.6。(4) 全部实验在仿真基准(LIBERO/ManiSkill/MetaWorld/CALVIN)完成,无真机验证。(5) GR00T N1.6 RL 只训了 5 步、N1.5 训 5–25 步(因官方检查点浮点不匹配),短程 RL 的结论外推到长程训练存疑。我的补充观察:(6) 「为什么图像/视频 DiT 不出现此结构」只有经验对照,缺乏理论解释;(7) 只覆盖 flow-based 策略,扩散策略与离散动作头(如 π0 FAST 类)未验证;(8) 测试时引导的绝对增益(+2~4)有限,且推理时需额外提取投影与维护探针,部署成本未讨论。
独立分析的弱点
独立分析出的弱点及改进方向:(1) 单检查点快照分析——所有结论基于训练结束后的最终检查点,无法区分低秩结构是收敛性质还是训练早期暂态,GR00T N1.5 的 −29.0 反例很可能与仅训 5–25 步有关。改进:沿训练过程追踪秩与模块贡献曲线,做训练动力学分析。(2) 探针与引导依赖外部监督——需要每个 episode 的成败标签,真机上标签昂贵且奖励常有歧义。改进:用 value function 估计或自监督时序一致性信号替代二值成败标签。(3) 因果链最后一环较弱——「RL 收益主要经由 shift 实现」的证据是相关性加模块级干预,尚未做到参数级:改进:设计「只重置 shift 相关行、保留 scale/gate」的精细消融,或训练时对 shift 更新做正则/屏蔽。(4) 与 DiT 的差异停留在观察——改进:控制去噪步数、数据维度与模型规模做系统对照,定位差异来源(动作空间低维、奖励稀疏、chunk 长度等候选因素)。(5) 定向 LoRA 只在 LIBERO-Spatial 单基准验证,增益 +1.6 有限。改进:在更多基准与模型上验证,并尝试把秩压到 4(与 top-4 奇异方向发现呼应)。(6) 时间步特化可能损害跨步数泛化——若部署时改变去噪步数(5→10),特化于 5 个离散 $\tau$ 的模块响应可能错位。改进:训练时做步数随机化,或评估跨步数迁移的性能损失。
未来方向
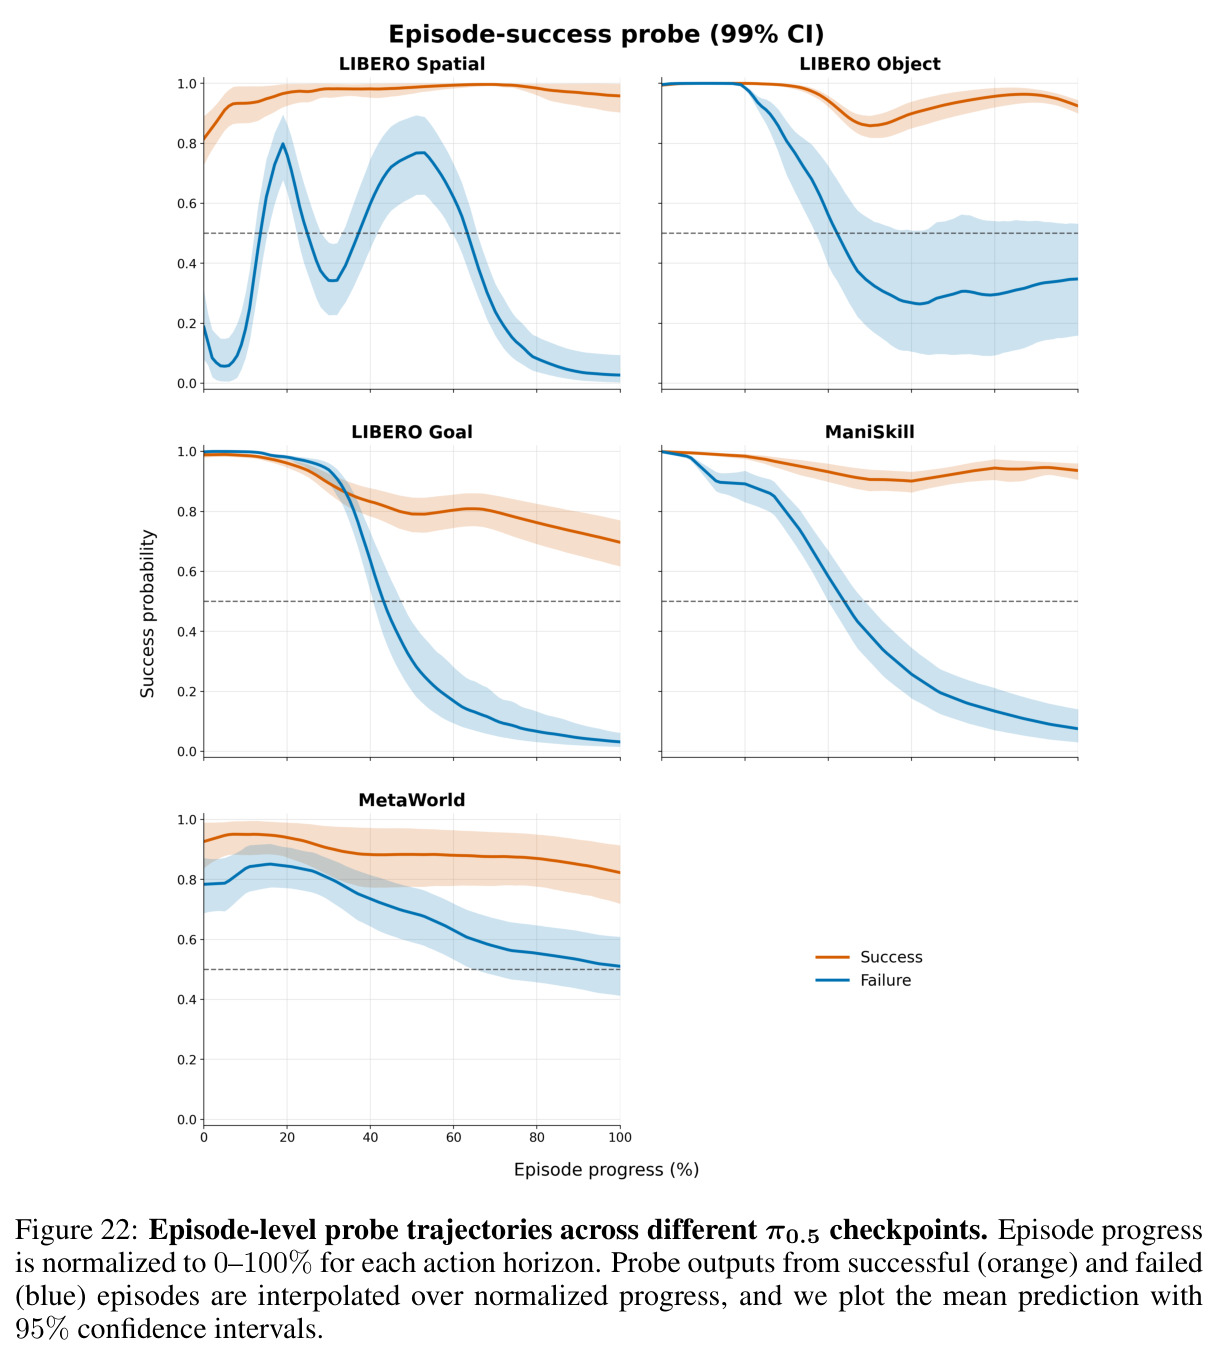
作者明确提出三个方向:(1) 把「离散时间步 BC」当作独立训练配方研究——既然它复现了 RL 式的低秩结构与尖峰化响应,可能比标准连续 $\tau$ BC 更契合低步数推理,甚至更高效;(2) 为残差 RL(residual RL)提供设计依据——若全参数 RL 大体退化为低秩调制,冻结 VLA 加一个小残差模块可能足以捕获大部分收益,可直接指导 XU 等残差 RL 方法的设计;(3) 更参数高效的 RL 后训练配方。基于本文成果可自然延伸:(4) 任务向量算术——shift 更新的几何与跨任务迁移结构高度相关(Spearman 最高 0.794),可以做多任务向量合并、负向量遗忘、少样本新任务的向量插值初始化,把 RL 后训练变成可组合的操作;(5) 在线失败检测——Fig 22 显示探针预测在 episode 早期就分离成败与失败轨迹,可作实时中断或人类接管的触发信号,与 SAFE 等失败检测器衔接;(6) 自适应推理——按探针置信度动态调整引导强度或去噪步数;(7) 把密度-秩分析产品化为 RL 训练健康度诊断工具(检测过拟合、遗忘或训练不足);(8) 跨本体扩展——GR00T 的时间步输入块是本体特定的,正好用来检验该低秩结构在跨本体迁移中的普适性与真机有效性。
复现评估
复现条件在同类论文中属于较好的水平。数据与模型几乎全公共:OpenPI π0.5 base、RLinf 发布的全部 BC/RL 检查点(MetaWorld/ManiSkill/CALVIN/LIBERO)、SmolVLA 社区检查点均可在 HuggingFace/官方渠道获取;作者承诺接收后公开代码与自训检查点。超参数披露完整(Table 6/7:PPO clip $\epsilon=0.2$、$\gamma=0.99$、GAE $\lambda=0.95$、actor lr $5\times10^{-6}$、critic lr $1\times10^{-4}$、Flow-SDE $\sigma=0.3$–$0.5$、4–5 去噪步、动作视野 10–50)。算力门槛分层:若要自训 RL 需 4×H100 80GB(π0.5 LIBERO 150 步、全局 batch 2048、64 并行环境);但纯分析部分(SVD、密度、有效秩、探针、引导)只依赖公共检查点加单卡推理采集 rollout,探针只是 $\ell_2$ 逻辑回归,门槛低。主要坑:GR00T 官方 RL 检查点存在浮点不匹配需自训替代;探针实验要为每个基准采集 rollout 并做任务级 70:30 划分(避免任务泄漏);复现模块替换需正确处理参数回退与偏差项。综合评估:拿到检查点后核心结论(Fig 2、Table 1)数天内可验证,全量复现约需数周与单节点 4×H100,难度中等。
论文图表
展示 RLinf 代码库的默认 LoRA target_modules 列表:包含 proj、qkv、fc1、fc2、lm_head 等 attention/FFN 投影,完全没有 Time MLP 与 AdaRMS 投影。
把抽象研究发现锚定到工程现实:主流 VLA RL 框架的参数高效配置恰好漏掉了 RL 更新最集中的模块,直接凸显本文的实用价值。