SlideDP:面向共享主机多GPU节点的全参数LLM微调扩展运行时 SlideDP: Scaling Host-Resident LLM Fine-Tuning Across Multiple GPUs
共享主机的同步数据并行运行时,让全参数LLM微调在显存之外的多GPU上高效扩展
前置知识
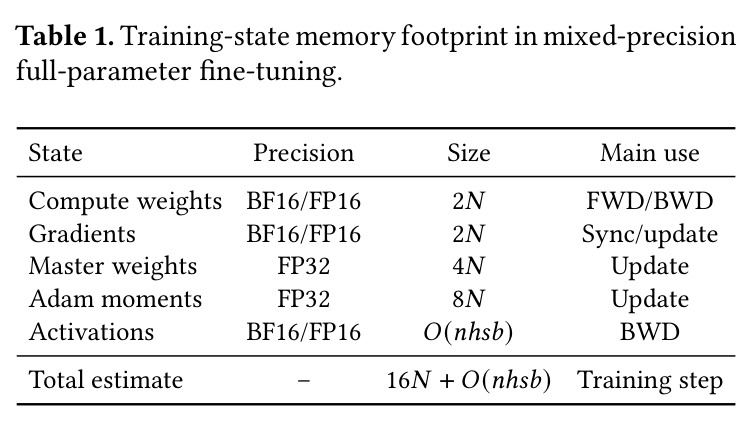
混合精度 Adam 的 $16N$ 字节训练状态
混合精度训练中,对 $N$ 参数的模型需要同时维护多类状态:BF16/FP16 计算权重与梯度各占 $2N$ 字节,FP32 主权重占 $4N$ 字节,Adam 优化器的一阶矩和二阶矩(均为 FP32)共占 $8N$ 字节,合计约 $16N$ 字节;再加上随层数 $n$、隐藏维 $h$、序列长 $s$、batch $b$ 增长的激活内存 $O(nhsb)$。72B 模型仅持久状态就超过 1.1 TB。
论文要解决的核心约束正是这个 $16N+O(nhsb)$ 的内存足迹超出 GPU 显存。理解各类状态的精度、大小与生命周期,才能看懂为什么把持久状态搬去主机内存、GPU 只留有界窗口是可行的,以及 Table 1/2 中流量的推导。
数据并行(DP)与梯度归约
数据并行让每个 rank(GPU 进程)持有完整的层计算逻辑,各自处理不同的数据分片,反向传播后同步梯度(all-reduce,或 reduce-scatter + all-gather)。同步 DP 要求每一步开始时所有 rank 使用相同版本的参数,保证数学上等价于单卡大 batch 训练。
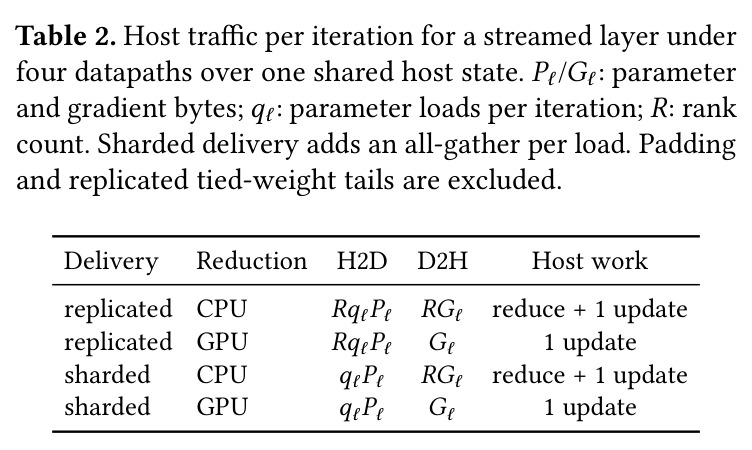
SlideDP 是一个同步 DP 运行时,其三条不变量(同版本参数、每层一次聚合梯度更新、下轮调度等待更新完成)都源自同步语义。梯度是在 GPU 侧归约还是传回 CPU 归约(差 $R$ 倍 D2H 流量)是本文的关键路线选择之一。
主机驻留层流式(host-resident layer streaming)
把 FP32 主权重和优化器状态常驻 CPU 内存,GPU 上只保留一个可复用的小型 BF16 层窗口,逐层把参数'流'过 GPU:前向按序换入、反向逆序换入。其效率取决于隐藏条件——主机侧参数下发、梯度回传、CPU Adam 更新必须与 GPU 前反向计算重叠,并在被需要之前完成。
这是 SlideDP 的基础范式(继承自 LoHan/SlideFormer/MegaTrain)。本文的全部贡献都在回答:当 $R$ 个 GPU rank 共享同一个主机时,如何消除冗余数据移动并把剩余主机工作与计算重叠。
GPU 互联拓扑:PCIe、NVLink 桥、NVSwitch
同一节点内 GPU 间的物理通路决定集合通信的带宽:所有 GPU 共享 PCIe fabric(最慢);NVLink 桥只在成对 GPU 间提供快速直连;NVSwitch fabric 让任意 GPU 对之间都有高带宽 P2P。all-gather、reduce-scatter 等集合通信的代价随拓扑数量级变化。
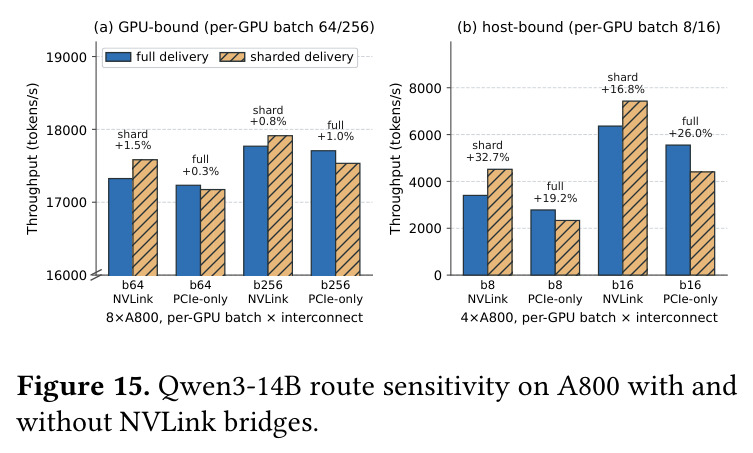
论文 Observation 3 表明最优参数下发路线由拓扑决定:4×A800 有 NVLink 桥时分片下发快 17%,摘掉桥后复制式反而快 26%。看懂拓扑才能理解为什么需要 AutoPolicy 在运行时探测路线而非写死。
激活检查点与选择性重计算(activation checkpointing / SAC)
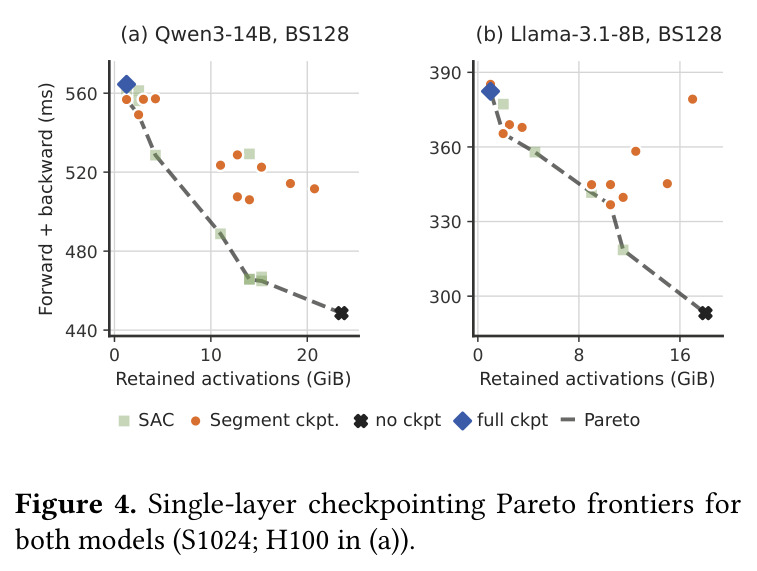
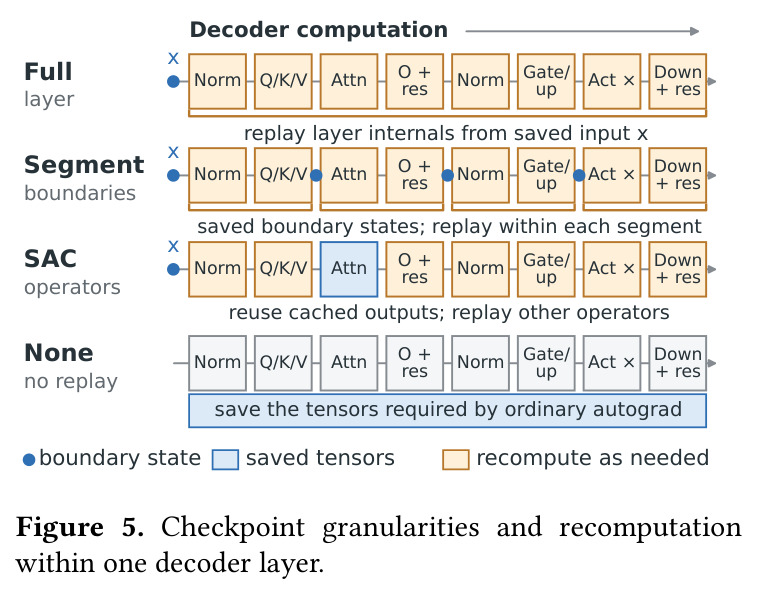
为省激活内存,可在前向只保存少量边界张量、反向时重算中间结果:整层检查点只存层输入、重算整层;段级检查点用位掩码划出更细的重算边界;选择性激活检查点(SAC)缓存部分算子输出、只重算其余算子;也可以完全不存而依赖普通 autograd。四者构成内存-计算权衡谱系。
SlideDP 的 Elastic Checkpointing 把这四种粒度与 offload 比率组合成每层策略空间。论文的核心洞察是:空闲 HBM 用于省 offload 流量还是省重计算,取决于当前瓶颈,所以显存分配是运行时策略而非常量。
弱缩放与强缩放
弱缩放指固定每卡 batch、增加卡数(总负载随卡数增长),理想情况下吞吐近线性增长;强缩放指固定全局 batch、增加卡数(每卡 batch 按 $1/R$ 缩小),理想情况下步时按 $1/R$ 下降。强缩放会缩小每步的计算窗口,使原本被计算隐藏的主机工作暴露出来。
论文的第二个挑战(残余流水线暴露)就是强缩放效应:Qwen3-14B 全局 batch 256 从 4 卡到 8 卡,计算参考从 27.2 s 降到 14.4 s,SlideFormer 步时却停在 43 s。Figure 1(d,e) 和 Figure 14 都围绕这两种缩放展开。
研究动机
全参数微调对 $N$ 参数模型在混合精度 Adam 下需维护约 $16N$ 字节持久状态:BF16 权重与梯度各 $2N$、FP32 主权重 $4N$、Adam 一二阶矩 $8N$,外加激活内存 $O(nhsb)$;72B 模型仅持久状态就超 1.1 TB,八张 80GB GPU 也难以容纳。主机驻留层流式把持久状态移到 CPU 内存、GPU 只留小窗口流式加载层,但直接扩展成多 GPU 数据并行会撞上两个结构性问题。其一是可避免的放大:SlideFormer 的多 GPU 实现与 MegaTrain 的多 GPU 模式都采用复制式传递加 CPU 侧梯度归约,每层 $P_\ell$ 字节参数重复下发 $R$ 份、$R$ 份梯度各自传回主机聚合,而主机服务容量固定——A800 上单 GPU 做 800M 参数层的 cast+H2D 可维持 15.6 GB/s,两卡并发时每卡只剩 8.7 GB/s;H100 上 CPU Adam 16 核约 182–184 GB/s,32 核仅再提升 8.5–10.0%。其二是残余流水线暴露:即使消除冗余流量,CPU 更新与跨 rank 依赖仍需被计算隐藏,而强缩放会缩小计算窗口——Qwen3-14B 全局 batch 256 下 A800 从 4 卡到 8 卡,计算参考从 27.2 s 降到 14.4 s,SlideFormer 步时却停在约 43 s,暴露近 29 s 主机开销。
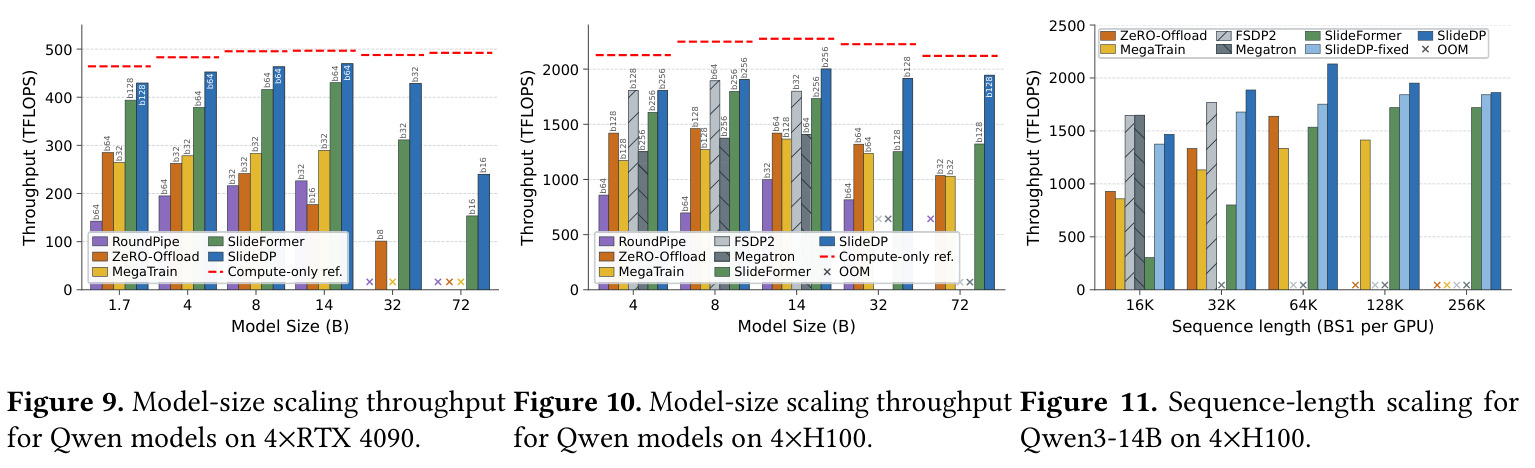
本文的目标是本文目标是构建一个面向“单节点多 GPU、共享固定主机资源”场景的同步数据并行全参数微调运行时 SlideDP,在严格保持同步 DP 语义(所有 rank 使用同版本参数、每层只做一次聚合梯度更新、下一轮参数下发等待该层更新完成)的前提下,把参数下发、梯度归约回传与 CPU 优化器更新同 GPU 前反向计算深度流水线化,使剩余主机工作尽可能被计算隐藏。具体包括三件事:设计单一权威主机状态并让通信路线与状态布局解耦,使路线可按拓扑与负载切换而不改变语义;建立刻画共享资源瓶颈与依赖暴露的解析步时模型 $T_{step}\ge\max_j W_j/\beta_j^{max}$,指导何时省流量有效、空闲显存该省什么;让通信路线、分块与激活布局依据硬件拓扑(PCIe-only、NVLink 桥、NVSwitch)和负载状态(host-bound 或 GPU-bound)自动选择。工程目标是在 RTX 4090、A800、H100 三类平台上支撑 4B–72B 模型、最长 256K 序列,把 72B 微调带到四张 24GB 消费卡、单步超 1M tokens,并对现有卸载基线取得 1.46–2.64× 几何平均吞吐优势、接近 GPU 驻留 FSDP2。
与已有工作不同的是,现有工作各有侧重但都没回答“多个 rank 共享一个主机时,同步 DP 如何高效”。ZeRO-Offload/ZeRO-Infinity 与 FSDP 是 rank 中心的分片所有权设计,靠切分状态省显存,但引入 all-gather/reduce-scatter 集合通信,且未针对共享 PCIe 与主机带宽做路由协调。SlideFormer 与 MegaTrain 本质是单 GPU 流式引擎,其多 GPU 模式只复制单卡数据通路,造成 $R$ 倍放大;LoHan 关注激活流量与重计算权衡,但缺少多 GPU DP 运行时;RoundPipe 用流水线并行加异步优化器更新实现多卡流式,允许下次迭代在 CPU 更新完成前推进——放宽了同步语义,恢复标准同步微调时步末停顿重现;StrongHold 证明层的 CPU 更新可在后续层反向中提前重叠,但基于 Megatron 模型并行栈而非 DP 优先。SlideDP 的独特切入是把“状态放在哪”(布局)与“数据怎么走”(路线)解耦:持久状态只有一份权威主机拷贝,每层的传递/归约路线可按拓扑与负载独立选择;并用解析模型加实测校准,把通信、分块、显存分配当作受共享资源约束和参数版本依赖约束的联合策略问题,而非逐项独立优化。
核心方法
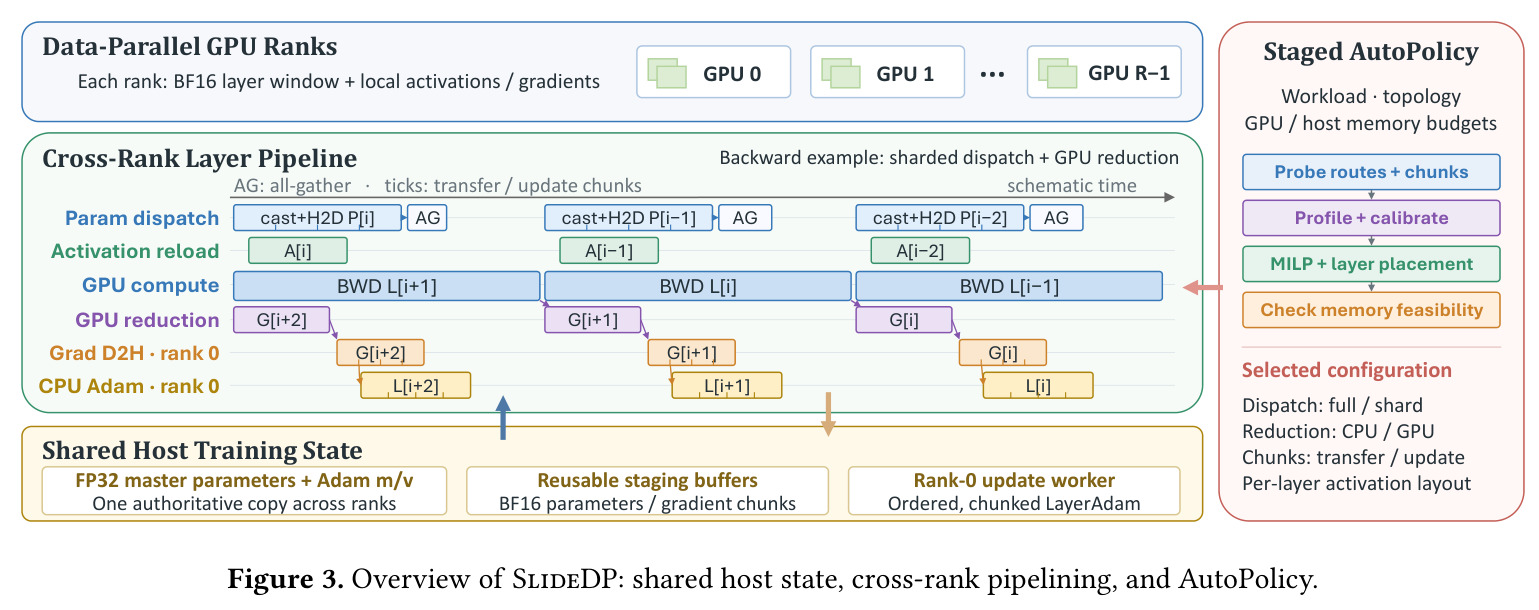
直觉上,SlideDP 把一台多 GPU 服务器当作“一个大脑(主机)+ 多只手(GPU)”:主机内存持有唯一一份 FP32 主权重和 Adam 动量 $(m_l, v_l)$,$R$ 个 GPU rank 各自维护有界、可复用的 BF16 层窗口,让层像流水线一样“滑”过 GPU(Slide 之名由此而来)。技术路线分四层。第一层是共享状态与路线选择:每层 $\ell$ 的 $\Theta_l^{32}$ 与 $(m_l, v_l)$ 只存一份,rank-0 优化器 worker 每迭代更新一次;参数下发可全量(H2D 流量 $R q_\ell P_\ell$)或分片加 GPU all-gather($q_\ell P_\ell$),梯度可 GPU 归约后只回传一份 $G_\ell$,或经 CPU 归约回传 $R G_\ell$,两种路线都不改变主机状态的权威布局。第二层是跨 rank 流水线:六条逻辑通道(参数准备+H2D、激活 offload/reload、GPU 计算、梯度归约、梯度 D2H、CPU LayerAdam)跨层跨 rank 重叠,层完成即释放更新。第三层是解析步时模型:以 $T_{step}\approx\max\{C,H\}+E$ 区分 GPU-bound 与 host-bound,用依赖图 $f(v)=d_v+\max\{a_v\}\cup\{f(u):u\in P(v)\}$ 刻画缓冲复用与参数版本门控,解释何时省流量才真能省时间。第四层是 AutoPolicy 与 Elastic Checkpointing:分阶段探测路线与分块、校准激活候选,用 MILP 在显存预算内给每层分配策略并整模型验证。
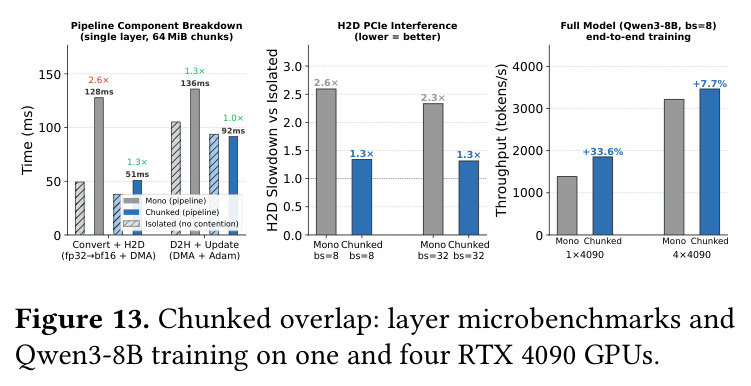
核心创新是三个环环相扣的想法。第一,“一个权威状态、多条可行路线”:与 ZeRO/FSDP 把分片所有权写死、SlideFormer/MegaTrain 把复制式通路写死不同,SlideDP 的持久状态布局(主机上一份未分片的 FP32 主权重+Adam)与执行期通信路线(全量/分片下发、CPU/GPU 归约)彻底解耦,因此当拓扑变化导致最优路线反转时(4×A800 有 NVLink 桥时分片下发快 17%,摘桥后复制式快 26%),只需换路线而不动状态与语义。第二,GPU 侧归约加分块流水:每层各 rank 先在 GPU 上归约成一份聚合梯度再 D2H,把每层梯度回传流量从 $R G_\ell$ 降到 $G_\ell$;层内按块流水——CPU 把块 $k{+}1$ cast 成 BF16 与 DMA 传块 $k$ 并行、AVX-512 非临时存储减少缓存污染、整层 D2H 改为逐块并逐块释放 Adam——单层实验中 cast+H2D 从 127.8 ms 降到 50.8 ms、D2H+更新从 135.9 ms 降到 91.7 ms,争用下 H2D 减速从 2.3–2.6× 降到约 1.3×。第三,“空闲 HBM 的价值取决于暴露的流水线工作”:80GB H100 上固定策略仅用 15.0 GiB,把余量用于保留激活(省 offload 往返)或保留中间结果(省重计算),收益取决于当前暴露的是传输还是计算——显存分配因此成为运行时策略,而非固定的检查点选择。
方法步骤详情
方法可按“一次性策略准备 + 每步执行流程”描述。策略准备:AutoPolicy 先探测参数路线 $(p_{param}, p_{red})$ 与分块 $(c_{H2D}, c_{D2H})$;再单层剖析各检查点候选的计算时间、保留内存与 offload 流量;在缩减的真实流水线(替换 $k_j$ 个参考层)中校准边际成本 $\tau_j=\tau_0+(T_j(k_j)-T_0)/k_j$;最后解 MILP $\min\sum_j n_j\tau_j$(约束 $\sum_j n_j m_j+\max_j p_j+\max_j h_j\le B_{avail}$,$\sum_j n_j=L$)得到每层激活布局 $p_{ckpt}$,offload 层连续分组、GPU 保留策略按内存从轻到重放在解码器尾部,并整模型验证。每步执行:前向时参数准备与当前层计算重叠——CPU 将块 $k{+}1$ cast 成 BF16 的同时 DMA 传块 $k$;分片路线下每 rank 先收 $P_\ell/R$ 再 all-gather 重建;激活按选定策略保留、以比率 $r$ offload 或存检查点边界。反向时逆序重载参数与激活,每层算完局部梯度后按路线归约——GPU 归约链为 $\{\mathrm{BWD}_{l,r}\}\to\mathrm{Reduce}_l\to\mathrm{D2H}_{l,k}\to\mathrm{Adam}_{l,k}$,归约完成即向 rank-0 更新 worker 释放梯度块,已完成层的 CPU 更新与更早层反向重叠,把优化器工作移出步末串行尾巴。版本门控与缓冲回收贯穿全程:迭代 $t{+}1$ 对层 $\ell$ 的下发等待迭代 $t$ 该层更新完成,保证所有 rank 看到同版本参数;GPU 槽位在计算、集合通信与拷贝全部完成后释放,缓冲满时反压暴露待完成工作。
技术新颖性
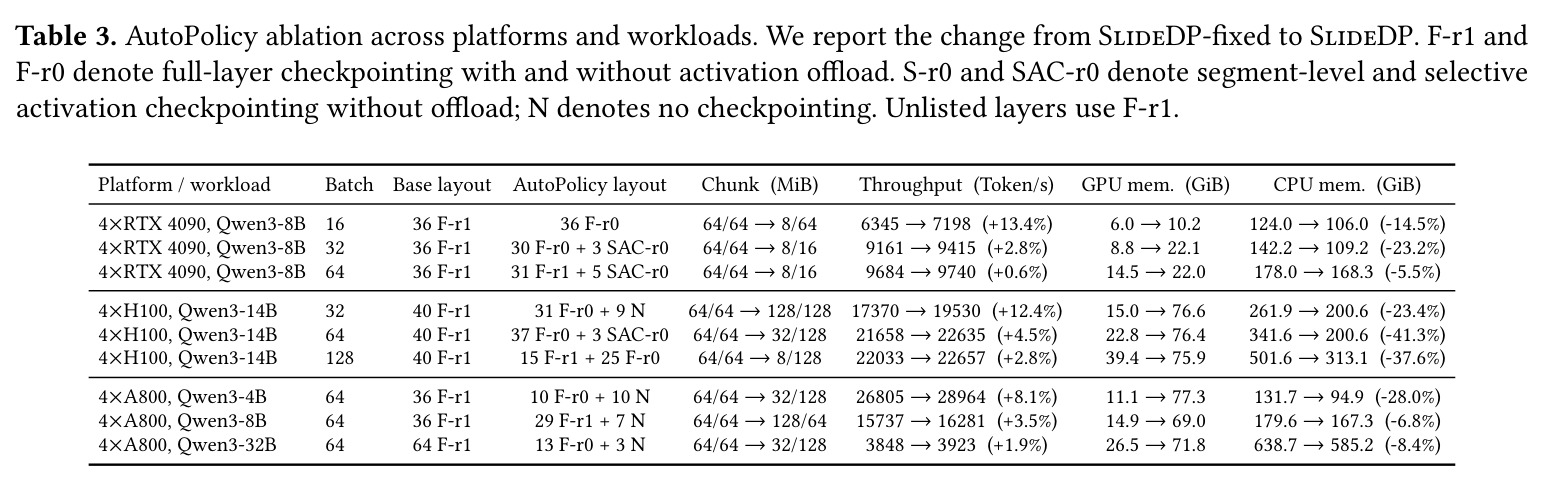
技术新颖性体现在四处。其一,同步 DP 语义下的共享主机运行时是新的系统设计点:RoundPipe 靠异步更新换吞吐,SlideDP 用每层参数版本门控+GPU 侧归约+分块重叠证明,严格同步语义下 8 卡强缩放的超额步时可压到 0.90 s(SlideFormer 28.57 s、MegaTrain 9.77 s),4→8 卡仍达 1.94× 扩展。其二,解析模型把“资源需求”与“执行依赖”统一进一张图:$D_j^{min}=W_j/\beta_j^{max}$ 给出稳态下界,依赖函数 $f(v)$ 刻画三类前驱(数据/参数版本、串行流次序、缓冲释放),从而解释“省流量不等于省时间”——只有被削减的资源是当前瓶颈、且其完成是关键路径上最晚前驱时才有效,对应 host-bound 时节省 $\delta_H$ 只实际节省 $\min(\delta_H, H-C)$。其三,策略选择靠测量校准而非固定规则:路线对拓扑敏感(A800 摘桥即反转 17%/26% 的优劣势)、激活策略对负载敏感(b16 时全部层保留输入省 13.4% 主机流量,b128 时 25 层 F-r0+15 层 F-r1 混布),AutoPolicy 用缩减流水线实测边际成本再 MILP 分配,比固定策略稳定提升 0.6–13.4%。其四,Elastic Checkpointing 把四种检查点粒度(整层/段级七位掩码/SAC/无)与 offload 比率 $r\in[0,1]$ 组成统一策略空间,与通信路线共享同一显存预算,形成可自动搜索的完整设计空间。
实验结果
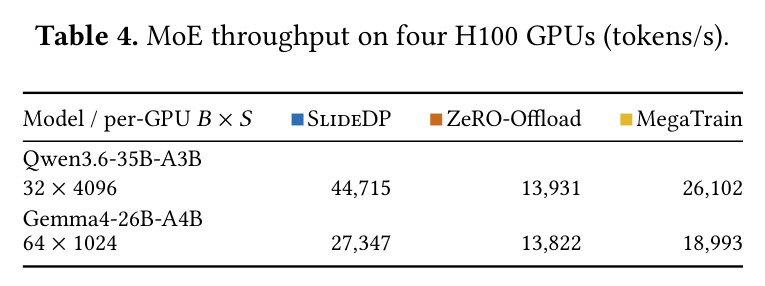
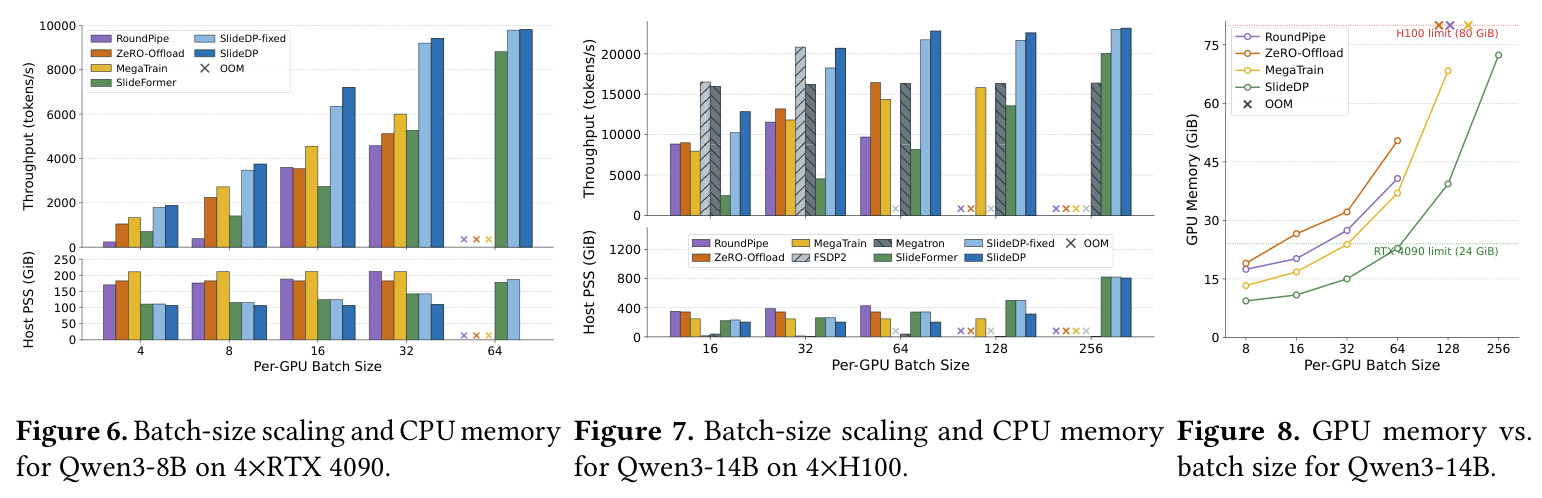
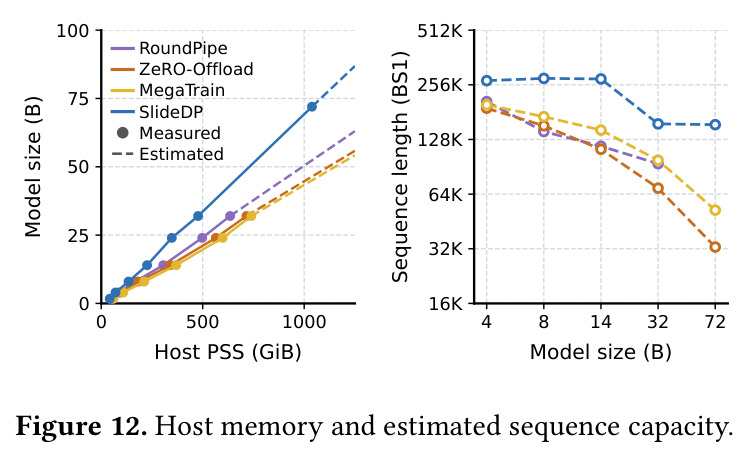
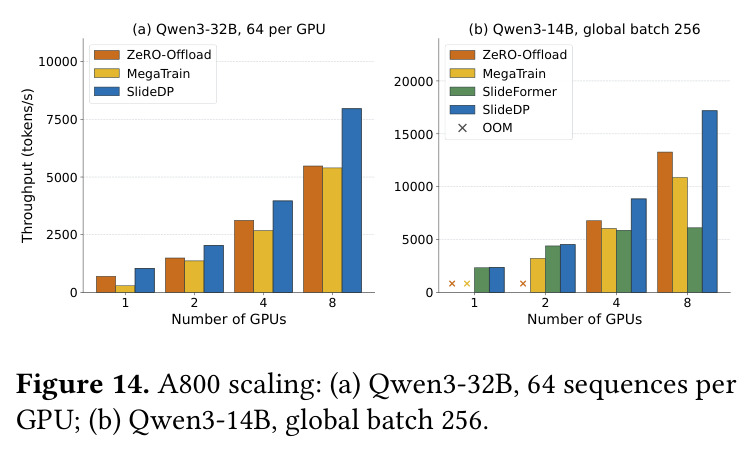
实验覆盖三类平台(4×RTX 4090 PCIe-only、8×A800 NVLink 桥、8×H100 NVSwitch 只用 4 卡)。端到端吞吐:匹配 batch 扫描中对 SlideFormer/MegaTrain/ZeRO-Offload 取得 1.46–2.64× 几何平均吞吐比;4×4090 上 Qwen3-8B 对 ZeRO-Offload 1.83×、对 MegaTrain 1.48×,batch 64 达 9.81K tokens/s 而基线全部 OOM;4×H100 上 Qwen3-14B batch 256 达 23.2K tokens/s、单步 1,048,576 tokens 无梯度累积,为基线峰值的 1.41×/1.47×。对照 GPU 驻留系统:4B/8B 与 FSDP2 差距在 1% 内,14B(batch 256)反超 FSDP2 11.2%;4B–72B 达到单 GPU 投影 compute-only 参考的 85–92%。容量:Qwen2.5-72B 在 4×4090 上 240 TFLOPS(SlideFormer 的 1.56×,其余基线 OOM);Qwen3-14B 峰值显存比 ZeRO-Offload 低 51–59%;主机 PSS 每 B 参数 14.2 GiB(其他系统 19.8–22.9),估计 14B 序列容量 276K vs 113K/144K tokens。长序列:64K 达 2.13 PFLOPS(1.30×/1.60×),并完成 256K 全注意力训练(1.86 PFLOPS),FSDP2/TP4 在 64K 即不可行。缩放:A800 弱缩放 2/4/8 卡并行效率 95–98%;强缩放 4→8 卡 1.94×(SlideFormer 仅 1.04×),8 卡超额步时 0.90 s vs 28.57 s/9.77 s。机制:fixed 版本已达 SlideFormer 的 2.32–2.54×/4.03–4.18×,分块再增 7.7%/33.6%,AutoPolicy 再提 0.6–13.4%(b16 +25.4%)且主机 PSS 降 5.5–41.3%。MoE:Qwen3.6-35B-A3B 44,715 tokens/s,为 ZeRO-Offload 3.21×。正确性:与 FSDP2 同训 200 步损失最大绝对差 5.2–6.3×10⁻⁴。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 匹配 batch 吞吐扫描(Qwen3-8B/14B,4×4090 与 4×H100,batch 4–256) | 几何平均吞吐比 | SlideDP 1.46–2.64× | SlideFormer / MegaTrain / ZeRO-Offload(1.0×) | 相对三个基线的几何平均 1.46–2.64× |
| Qwen3-14B,4×H100,batch 256 大 batch 训练 | 吞吐(tokens/s)与单步 tokens | 23.2K tokens/s,单步 1,048,576 tokens(无梯度累积) | ZeRO-Offload 与 MegaTrain 的 sweep 内峰值 | 分别为基线峰值的 1.41× 与 1.47× |
| Qwen3-14B,4×H100(batch 256)对 GPU 驻留 FSDP2(batch 32) | 吞吐 | 超过 FSDP2 实测峰值 11.2%;4B/8B 与 FSDP2 差距 <1% | FSDP2(GPU 驻留、完全分片) | 14B +11.2%,同时单步 tokens 远大于 FSDP2 可行 batch |
| Qwen2.5-72B 全参数微调,4×RTX 4090(24GB) | 吞吐(TFLOPS) | 240 TFLOPS | SlideFormer 154 TFLOPS(1.56× 倒推);ZeRO-Offload/MegaTrain/RoundPipe 均 OOM | 对 SlideFormer 1.56×,对其他基线从不可行变为可行 |
| Qwen3-14B 长序列,4×H100,每卡 1 序列 | 吞吐(PFLOPS) | 64K:2.13;128K:1.95;256K:1.86(完成训练) | 64K:ZeRO-Offload 1.64 / MegaTrain 1.34;FSDP2 与 TP4 在 64K 即不可行 | 64K 时 1.30×/1.60×,且可行序列上限从约 64K 扩展到 256K |
| Qwen3-14B 强缩放,8×A800,全局 batch 256 | 4→8 卡扩展比与超额步时 | 1.94×(8.84K→17.18K tokens/s),超额步时 0.90 s | SlideFormer 1.04×,超额 28.57 s;MegaTrain 超额 9.77 s | 扩展比接近线性(2.0× 理想),暴露开销降低约 32× |
| AutoPolicy 消融(Qwen3-14B,4×H100,batch 32) | 吞吐(tokens/s)与主机 PSS | 17,370→19,530(+12.4%),PSS 261.9→200.6 GiB(−23.4%) | SlideDP-fixed(整层检查点+激活 offload+固定 64/64 MiB 分块) | 吞吐 +12.4%,同时主机内存 −23.4%(另见 4090 b16 +13.4%) |
| MoE 微调(Qwen3.6-35B-A3B 与 Gemma4-26B-A4B,4×H100) | 吞吐(tokens/s) | 44,715(35B-A3B,32×4096);27,347(26B-A4B,64×1024) | ZeRO-Offload 13,931 / 13,822;MegaTrain 26,102 / 18,993 | 1.98–3.21× ZeRO-Offload,1.44–1.71× MegaTrain |
局限与改进
作者承认或设计中隐含的局限:实验范围为单节点——H100 平台虽是 8 卡 NVSwitch 但只用 4 卡,没有 8 卡 H100 或跨节点结果;A800 强缩放基于全局 batch 256,更大模型或更小全局 batch 下计算窗口更小、重叠更难;AutoPolicy 选择开销 1218 s(20.3 分钟),需约 1257 步(基线 2.72 小时)才盈亏平衡,短程微调不划算,且剖析缓存要求硬件、负载与实现身份完全匹配。我的补充观察:其一,正确性验证只有 200 步训练损失对比(最大差 5.2–6.3×10⁻⁴),没有下游任务或更长训练的一致性证据,BF16 下数值差异的长期累积效应未讨论;其二,rank-0 上单一 update worker 串行消费所有层的 Adam 块,论文数据显示 CPU Adam 在 16 核后近饱和(32 核仅 +8.5–10%),模型更深或卡更多时 worker 将成为 $H$ 项新瓶颈;其三,AutoPolicy 的吞吐收益以占满显存为代价(H100 b32 从 15.0 升到 76.6 GiB),同卡需驻留推理或多任务共享时不友好;其四,基线偏保守——未与 ProTrain 等自动显存管理或 8-bit 优化器组合比较;其五,路线结论依赖具体 PCIe/NVLink 代际与 NUMA 拓扑,外推到未测硬件需重新剖析。
独立分析的弱点
独立分析的弱点与改进方向。第一,单 update worker 的可扩展性:所有层的 LayerAdam 由 rank-0 一个 worker 串行消费,而 CPU Adam 吞吐在 16 核后近乎饱和,向更深模型或更多卡扩展时 worker 将成为 $H$ 项瓶颈;可按 NUMA 域放置多个 worker,把层子集分片给各 worker 并就近路由归约结果。第二,同步语义的尾部成本:每步末尾仍有 update drain 独立完成区间,步间存在气泡;可探索有界陈旧性(staleness ≤ 1)的准同步模式,提前下发下一迭代中不依赖本层更新的参数。第三,AutoPolicy 对短任务不经济:20 分钟剖析加约 1257 步盈亏平衡意味着数小时内的微调应直接用保守计划;可训练以拓扑/负载特征为输入的代价预测器,离线直接给出近似最优策略。第四,显存换吞吐缺用户接口:选定布局用满 76.6 GiB,但很多用户需预留显存;框架已有 $B_{avail}$ 约束,应暴露显存上限滑点并在约束内重解。第五,评估覆盖不足:缺少 FSDP2+CPU offload、量化优化器(8-bit Adam 可把 $16N$ 压到约 $8N$,与本文正交可叠加)等组合基线;MoE 只报吞吐,未分析路由负载不均对层流水线的影响。第六,256K 长序列依赖位置上限 262,144 的全注意力配置,未与序列并行(如 ring attention)结合,无法覆盖更长上下文。
未来方向
作者提出的方向:结论中把“按暴露流水线工作管理通信与显存”总结为更普遍的设计原则,暗示可推广到更多执行场景;实验将 MoE 与损失比较定位为覆盖性与正确性验证,系统性 MoE 评估留待后续。基于成果可自然延伸的研究:其一,跨节点扩展——把路线选择模型扩展到节点间网络,$\beta_j$ 加入 IB/以太网项,研究权威主机状态跨节点复制与归约树设计;其二,异构 GPU 节点(消费卡与服务器卡混插)下的路线/分块决策,PCIe-only 实验已显示强拓扑敏感性,异构环境会放大这一维度;其三,与量化训练结合——FP8 计算或 8-bit Adam 把主机持久状态从 $16N$ 压缩,直接提高 host-bound 转 GPU-bound 交叉点 $R_{cross}\approx C(1)/H$ 前的可行规模;其四,把 MILP 拓展为多目标优化(吞吐、显存上限、功耗),支持训练中途重配置(batch 变化、课程切换序列长度)与增量再剖析;其五,与序列并行/上下文并行组合,把 256K 以上超长上下文与层流式统一调度,激活 offload 与序列分片存在联合优化空间;其六,理论完善:给 $T_{step}\approx\max\{C,H\}+E$ 中的暴露项 $E$ 更紧的界,把 copy engine、NCCL 与 CPU 间的队列化争用显式建模,使模型在新硬件上零剖析预测步时。
复现评估
复现评估:论文给出项目页与开源仓库(GitHub: RegiaYoung/SlideDP),实现基于 PyTorch Distributed + NCCL + Transformers + FlashAttention-2 + Liger Kernel/Transformer Engine,均为常见工程栈。硬件门槛是主要障碍:最低配置为 4×RTX 4090(24GB)+ 1 TiB DDR4 双路 Xeon 工作站,可复现核心结论(1.83×/1.48× 加速、OOM 边界、AutoPolicy 消融);A800/H100 级实验需要 2 TiB 主机内存的服务器——主机内存需求(每 B 参数约 14.2 GiB PSS,72B 模型约 1 TiB)往往比 GPU 更难凑齐。数据与模型全部公开(Qwen3/Qwen2.5、Mistral-Small-24B、C4、MoE 模型卡)。测量协议描述充分:批量扫描每点 15 迭代弃前 8、两轮取平均;吞吐按全局 tokens 除以稳态步时;显存用 CUDA 峰值保留内存、主机用 PSS。策略剖析可缓存但要求硬件、负载、实现身份匹配,换环境需重跑约 20 分钟。未报告随机种子与方差,正确性验证仅 200 步。总体难度中高:软件开源加协议清晰使工程复现可行,但完整重现 H100 级结果(对 FSDP2 优势、1M tokens/步、256K 序列)需要高端服务器与较大主机内存。
论文图表
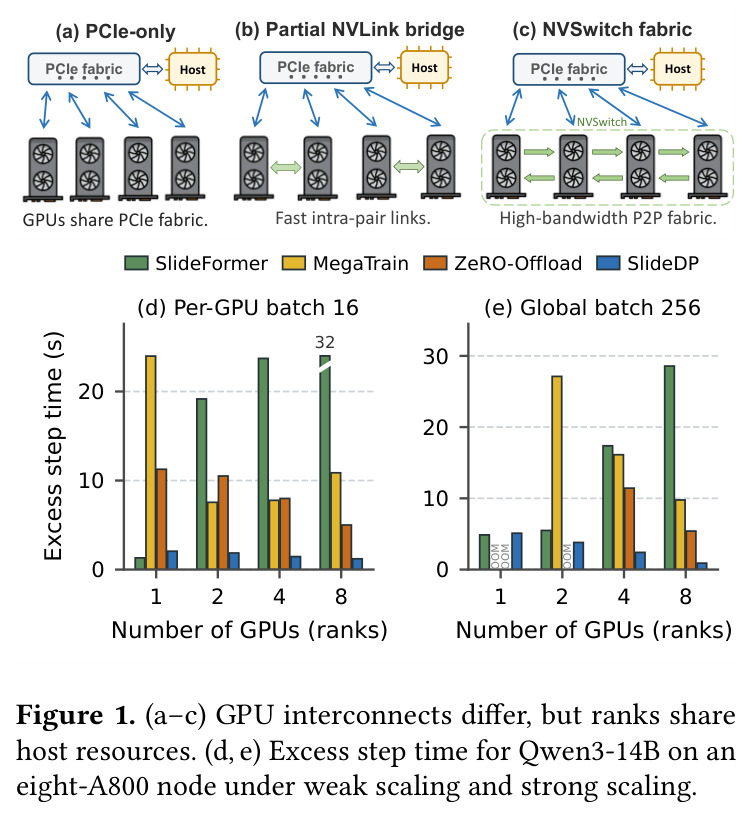
(a–c) 展示三种互联拓扑:共享 PCIe fabric、部分 NVLink 桥、NVSwitch fabric。(d) 弱缩放(每卡 batch 16)与 (e) 强缩放(全局 batch 256)下,各系统在 1–8 卡 A800 上相对匹配计算参考的超额步时:SlideFormer 强缩放下 8 卡时超额约 28.57 s,MegaTrain 约 9.77 s,SlideDP 仅 0.90 s;弱缩放下 SlideDP 超额始终约 1–2 s,并在 8 卡处避免 OOM。
一张图同时呈现论文的两个核心问题——多 rank 共享主机资源、强缩放缩小计算窗口导致主机工作暴露——以及 SlideDP 相对基线的量级优势,是理解全文动机与最强结论的入口。
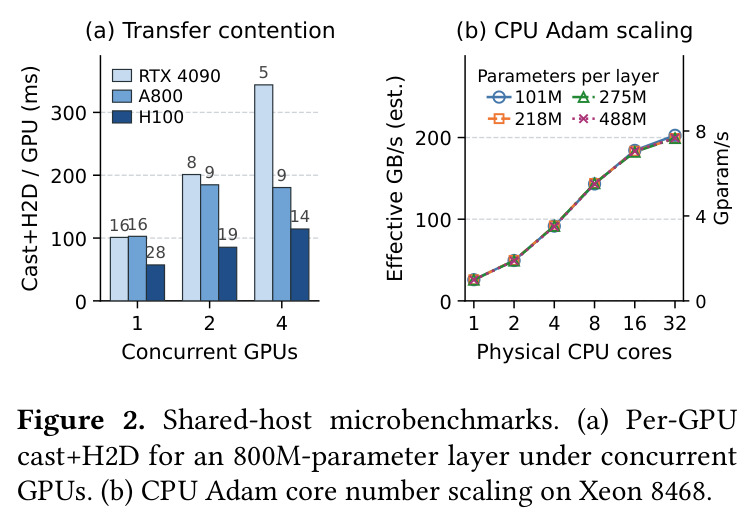
(a) 800M 参数层的 cast+H2D 有效带宽随并发 GPU 数下降:A800 单卡 15.6 GB/s,两卡并发时每卡仅 8.7 GB/s。(b) CPU Adam 吞吐随物理核数变化:H100 主机 16 核达 182–184 GB/s(101–488M 参数层),32 核仅再提升 8.5–10.0%。
用微基准量化'主机服务容量不随并发用户增长'这一关键事实,是 Observation 1(可避免放大)与 Observation 2(残余暴露)的实证基础。
(a) BS1 实测主机足迹拟合:SlideDP 斜率 14.2 GiB/B 参数,其他系统 19.8–22.9 GiB/B,虚线为斜率外推。(b) 在 78 GiB/GPU、1984 GiB 主机预算下由实测工作集估计的序列容量:14B 模型 SlideDP 约 276K tokens,ZeRO-Offload 约 113K,MegaTrain 约 144K。
把'共享权威状态'的设计落到主机内存效率上:更低的每参数主机足迹直接换算成更大的可行模型与序列容量,是容量主张的定量支撑。
左:单层微基准(64 MiB 块)显示流水线争用下转换+H2D 从 127.8 ms(整层)降至 50.8 ms,D2H+CPU 更新从 135.9 ms 降至 91.7 ms,H2D 相对隔离执行的减速从 2.3–2.6× 降至约 1.3×;右:Qwen3-8B 端到端训练,分块使 4×4090(全长度输入)吞吐从 3,218 升至 3,465 tokens/s(+7.7%),单卡(填充变长输入)从 1,386 升至 1,852(+33.6%)。
隔离验证'分块重叠'这一核心机制的价值:微基准与端到端一致,且计算窗口越小(单卡)收益越大,与暴露模型预测相符。
(a) 弱缩放:Qwen3-32B 每卡 64 序列,SlideDP 8 卡达 7,963 tokens/s(ZeRO-Offload 5,478、MegaTrain 5,396),2/4/8 卡并行效率 95–98%。(b) 强缩放:Qwen3-14B 全局 batch 256,SlideDP-fixed 从 4 卡 8.84K 到 8 卡 17.18K tokens/s(1.94×),SlideFormer 仅 1.04×。
直接检验'计算窗口收缩时是否仍能扩展'这一论文核心命题:弱缩放近线性、强缩放 1.94× 对 1.04×,是共享主机运行时设计成功与否的试金石。
在 8×A800(GPU-bound,每卡 batch 64/256)与 4×A800(host-bound,每卡 batch 8/16)上比较全量与分片参数下发:host-bound 且有 NVLink 桥时分片快 16.8–32.7%,摘桥后全量反超 19.2–26.0%;GPU-bound 的 8 卡负载中所有路线/拓扑组合差距均在 2.5% 以内。
实证 Observation 3'最优路线取决于拓扑与负载状态',是 AutoPolicy 必须在运行时探测路线而非硬编码规则的直接依据。
十步伪代码:输入工作负载 W、拓扑 T、内存预算 B;依次执行 ProbeRoutes 得 $(p_{param}, p_{red})$、TuneChunks 得 $(c_{H2D}, c_{D2H})$、ProfileCkpt 剖析激活候选、ShortlistAndProbe 缩减流水线校验、SolveMILP 求解层分配、CalibrateSelectedSpans 校准选中区间、二次 SolveMILP 与 PlaceLayers 得最终布局 $p_{ckpt}$、ValidateAndRefine 做内存可行的验证与有限次重解,返回策略 Π 或保守可行计划。
AutoPolicy 的可执行规格:分阶段设计(先路线/分块、后激活)控制选择开销,MILP+验证保证返回配置必然内存可行,是复现策略选择逻辑的权威参考。