从 EER 到嵌入几何:重新思考自动化语音相似度 Rethinking Automated Voice Similarity by Shifting from EER to Embedding Geometry
EER 与人类听感脱钩,嵌入有效维度 deff 才是音色相似度的真指标
前置知识
EER(等错误率)
说话人验证中错误接受率与错误拒绝率相等的操作点,是 VoxCeleb1-O 等基准上的标准精度指标,数值越低代表模型区分不同说话人越准。社区长期默认用 EER 最低的模型来做音色相似度评测。
论文的核心目标就是证伪这一默认前提:EER 与人类听感对齐的 35 条件汇总 Spearman 相关仅 +0.07,几乎不含感知信息。
说话人嵌入(speaker embedding)
把任意一段语音映射成固定维度向量(本文为 192 或 512 维)的神经网络编码器输出,常被称为 x-vector/d-vector 风格表示。两段语音的嵌入余弦相似度被 TTS/VC 系统直接当作音色相似度分数。
本文研究的问题正是:这些向量的空间几何(而非模型的验证精度)如何决定它们与人类听感判断的一致程度。
分类损失 vs 度量学习损失
分类损失(NSL、AM-Softmax、AAM-Softmax)对归一化后的余弦相似度加角边际,把说话人当类别训练;度量损失(Prototypical、Angular Prototypical、GE2E、SupCon)直接在批内比较嵌入与质心的距离。两者塑造出截然不同的嵌入空间几何。
训练目标是决定感知对齐的真正因素:prototypical 系比分类系 ρalign 高三倍以上,这一对比是全文实验矩阵的自变量。
有效维度 deff(participation ratio)
把每个说话人的嵌入平均成质心,中心化后做 PCA,取特征值谱的参与比 $d_{eff} = \frac{(\sum_i \lambda_i)^2}{\sum_i \lambda_i^2}$,衡量说话人分布被摊在多少个方差均匀的正交方向上,相当于矩阵秩的连续版本。名义嵌入维度只是上界。
它是论文提出的核心指标:与感知对齐的 Spearman 相关高达 −0.95,且只需说话人质心即可计算、无需任何人工评分。
Spearman 秩相关与置换检验
SRCC 度量两组数值秩之间的单调关系,对异常值稳健;置换检验通过随机打乱其中一列重算相关来构造零分布,得到双边 p 值。论文中 n=7 用精确检验,n=35 用 200 万次蒙特卡洛置换。
全文所有结论(EER 的 +0.07 不显著、deff 的 −0.95 高度显著)都以 SRCC 加置换 p 值表述,理解它才能读懂 Table 2 的统计证据。
研究动机
在 TTS 和 VC 系统评测中,由于人工听评稀缺昂贵,社区普遍用说话人嵌入的余弦相似度作为合成语音与参考说话人音色相似度的自动代理;而挑选嵌入模型时,又默认沿用验证精度最高(VoxCeleb1-O EER 最低)的说话人验证模型。这个前提隐含假设 SV 判别能力可以细粒度地反映人类听感,却从未被实证检验。事实上两者有本质错位:人类对音色相似度是『很像/有点像』的连续判断,SV 只是『同一人/不同人』的二元判别。在 VoxSim 数据集上,一个只按是否同一人打 0/1 分的 identity-only 基线在全部 27,697 对语音上就能拿到 0.715 的 SRCC——同说话人对的二元身份信号会严重膨胀相关性,掩盖模型对不同说话人之间梯度相似度的真实捕捉能力,这正是该隐含前提长期未被发现的统计原因。
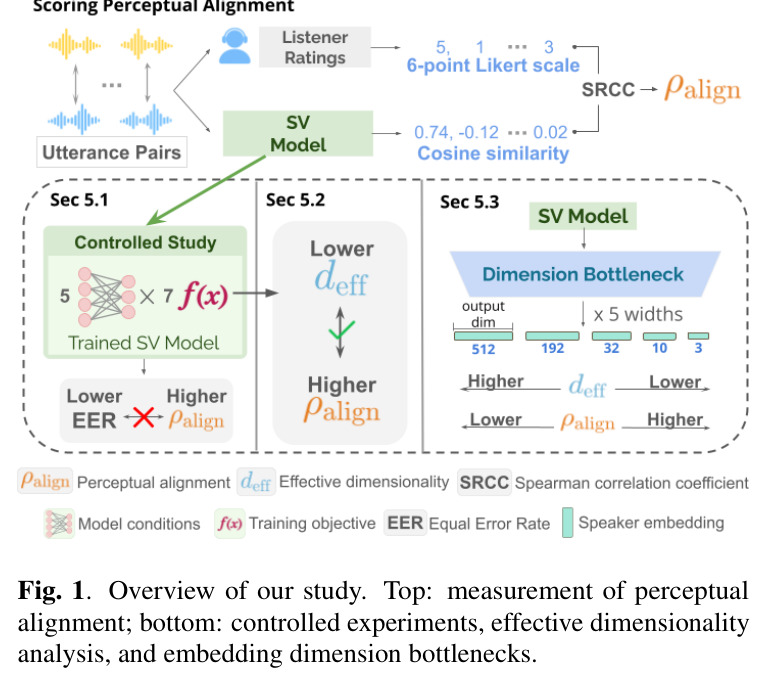
本文的目标是本文要回答两个研究问题:RQ1——EER 更低的说话人验证模型是否真的与人类听感更一致;RQ2——训练好的嵌入模型中究竟什么性质在追踪感知对齐。具体目标有三层:第一,建立严格的感知对齐指标 $\rho_{align}$,把评测限制在 VoxSim 的 16,905 个不同说话人对上,剔除身份判别的捷径信号,度量模型对『不同人之间有多像』的排序能力;第二,在完全受控的设置下——同一架构、同一训练数据、只变训练目标、每个配置 3 个随机种子——系统测量 5 种架构 × 7 种损失共 35 个条件的 EER、$\rho_{align}$ 与嵌入几何性质,分离『学得多好』和『学成什么形状』两个因素;第三,找到一个无需任何人工评分、可直接从嵌入计算的替代指标,并通过干预实验(压缩嵌入维度)验证因果关系,而不只停留在观察性相关。
与已有工作不同的是,本文的独特之处在于视角的转换:不从『模型验证得多准』出发,而从『嵌入空间的几何形状』出发。此前工作要么只按验证精度 benchmark 各训练目标(如 In defence of metric learning 一文),要么只在自监督对比学习中记录维度坍缩现象(Jing et al.、Roth et al.),都没有把表示维度与人类听感对齐定量联系起来。本文把训练目标当作自变量、把有效维度 $d_{eff}$ 当作中介变量,用 participation ratio 从 PCA 谱中量化『说话人被摊在多少个方向上』,并进一步做因果干预——证明对齐全场最差的 AM-Softmax 在 3 维嵌入下反而成为全场最佳($\rho_{align}$ 从 0.080 到 0.738)。这种『观察相关 + 干预验证』的完整证据链,是纯基准测试类研究无法给出的。
核心方法
直觉来自心理声学:Baumann & Belin (2010) 表明人类对音色身份的判断本身就能被低维空间捕捉;而 AAM/AM-Softmax 这类分类损失为了拉开类间角边际,会把说话人摊到很多方向上,与人类感知的低维结构天然冲突,prototypical 类度量损失则更集中。技术路线分四步。第一,构建受控实验矩阵:log-mel 输入的 ECAPA-TDNN(192 维)、ReDimNet-B2(192 维)、Fast ResNet-34(512 维)各训 80 epochs;再加两个 WavLM Base+ 主干加 ECAPA 头(输出 192 维)的阶段——WavLM-p1 冻结主干训头部 20 epochs,WavLM-p2 再解冻编码器训 5 epochs。每架构配 7 种损失(NSL、AM-Softmax、AAM-Softmax、Prototypical、Angular Prototypical、GE2E、SupCon)× 3 种子,共约 105 个模型,全部在 VoxCeleb2-dev 的 5,994 个说话人上训练。第二,在 VoxCeleb1-O 测 EER,在 VoxSim 的 16,905 个不同说话人对上测 $\rho_{align}$。第三,计算每个模型的有效维度 $d_{eff}$。第四,做相关分析并用嵌入维度瓶颈做因果干预。
核心创新是提出并验证『嵌入有效维度决定感知对齐』这一几何判据。与 EER 不同,$d_{eff}$ 只需说话人质心即可计算:$d_{eff} = \frac{(\sum_{i=1}^{K} \lambda_i)^2}{\sum_{i=1}^{K} \lambda_i^2}$,其中 $\lambda_1 \geq \cdots \geq \lambda_K$ 是质心协方差矩阵的 PCA 特征值,它等价于『能产生同样方差结构的等方差正交方向数』,是矩阵秩的连续化,取 PR 而非其他谱统计是因为它对长尾噪声特征值更不敏感。关键发现是 $d_{eff}$ 与 $\rho_{align}$ 的 Spearman 相关达 −0.95(35 个条件汇总,p<.001),而 EER 与 $\rho_{align}$ 只有 +0.07。更重要的是,作者没有停留在相关:通过把 ECAPA-TDNN 的嵌入维度硬性压到 $n_{out} \in \{512, 32, 10, 3\}$ 重训,证明压缩 $d_{eff}$ 会因果性地抬高对齐,且呈现完整的剂量—响应关系。这使 $d_{eff}$ 成为可在训练前评估、可主动优化的设计准则,而非事后解释。
方法步骤详情
第一步,训练:分类损失用固定 200 条语音的批,度量损失用 N=400 说话人 × M=2 条的大批,得到 5 架构 × 7 损失 × 3 种子的模型池。第二步,测对齐:在 VoxSim 的 46,348 条语音上抽取全录音嵌入,计算 16,905 个不同说话人对的余弦相似度 $s_{ij}$,与 13 名听者的均分 $r_{ij}$ 做 Spearman 相关:$\rho_{align} = \text{SRCC}(\{s_{ij}\}, \{r_{ij}\})$;只保留不同说话人对是为排除同人对的二元身份捷径(该捷径基线 SRCC 达 0.715)。同时在 VoxCeleb1-O 报 EER。第三步,测几何:嵌入先 L2 归一化、按说话人平均成 1,251 个质心(滤掉句子级噪声、对齐跨说话人评测范围),中心化后做 PCA,对特征值谱算 participation ratio 得 $d_{eff}$。第四步,统计:把 7 个(模型内)或 35 个(汇总)条件各当一个观测点,分别对 EER 与 $d_{eff}$ 和 $\rho_{align}$ 做 Spearman 相关,配精确/蒙特卡洛置换检验。第五步,干预:以 ECAPA-TDNN 为载体,在 $n_{out} \in \{512, 32, 10, 3\}$ 下重训 AAM-Softmax、AM-Softmax、Angular Prototypical、Prototypical 各 3 种子,观察三者的联动变化。
技术新颖性
新颖性有三层。问题层面:首次系统证伪『更好的验证器 = 更好的感知代理』这一社区默认前提,给出 35 个条件下 EER–对齐相关仅 +0.07(p=.71)的统计证据,并展示 4 个公开 SOTA checkpoint(ECAPA、WavLM、ReDimNet、SpeechBrain 系)虽然 EER 极低,却恰好落在感知对齐最差的左下角区域,直接挑战『选 EER 最低的模型』的选型惯例。指标层面:提出用 participation ratio 式有效维度作为感知对齐的免标注预测子——与 [17][18] 只描述维度坍缩现象不同,本文给出跨 5 种架构稳定成立的 −0.71 到 −1.00 秩相关和置换检验 p 值,且计算 $d_{eff}$ 不需要任何人工听评。证据层面:用嵌入维度瓶颈做因果干预,观察到 $d_{eff}$ 被逐级压缩(98→24→5→1.5)时对齐逐级上升(0.080→0.252→0.501→0.738)的完整剂量—响应关系,把相关性结论提升为机制性结论,这是既有文献完全缺失的环节。
实验结果
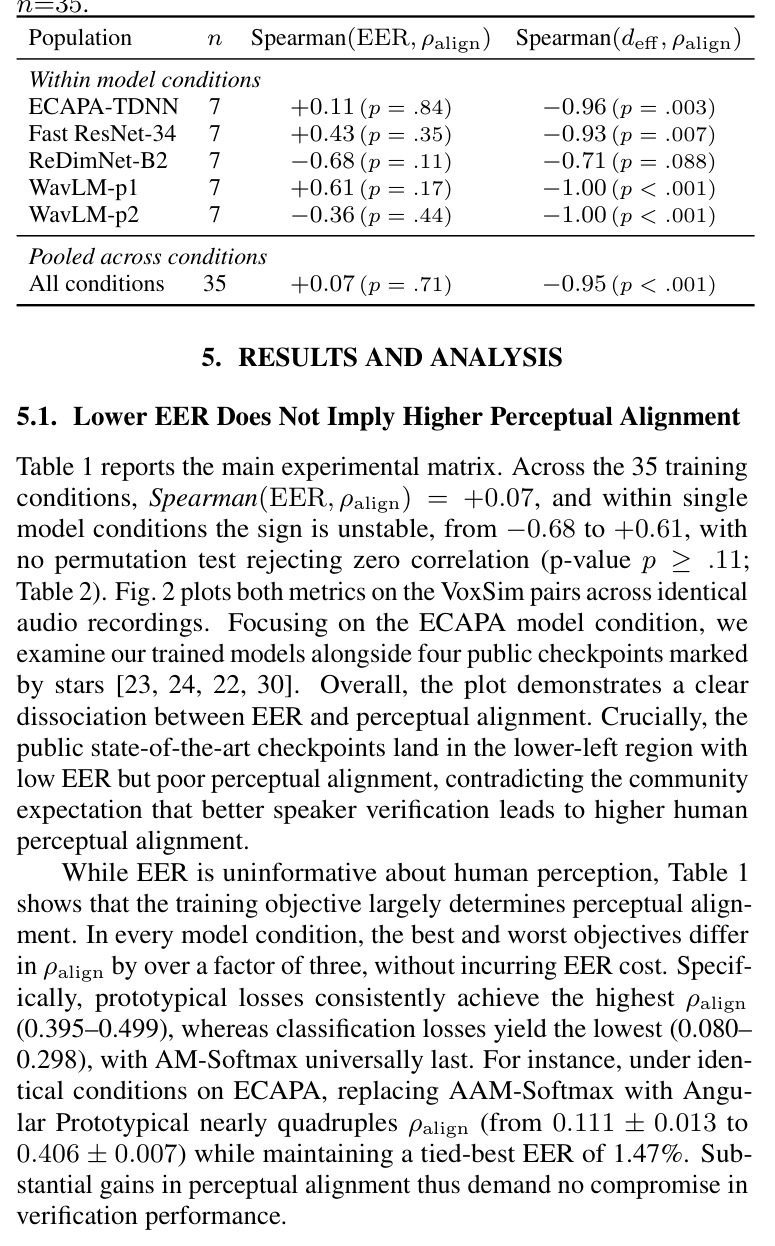
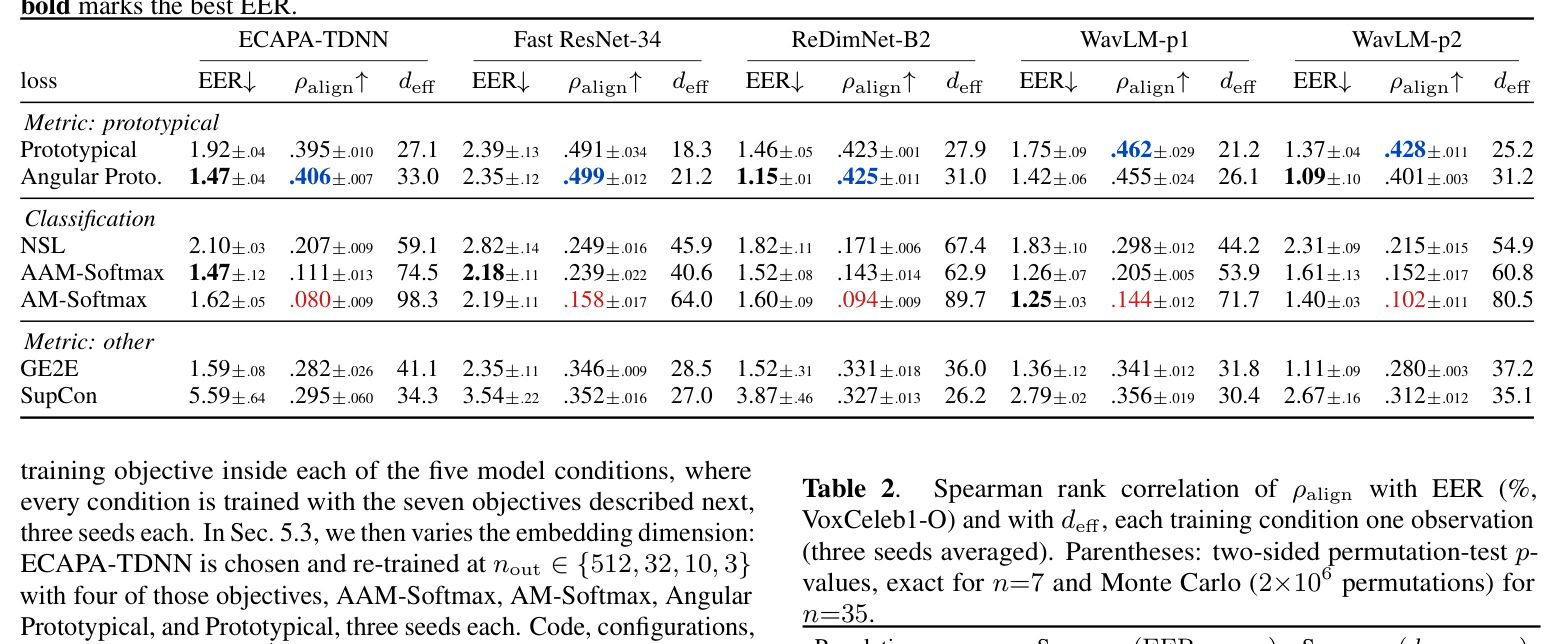
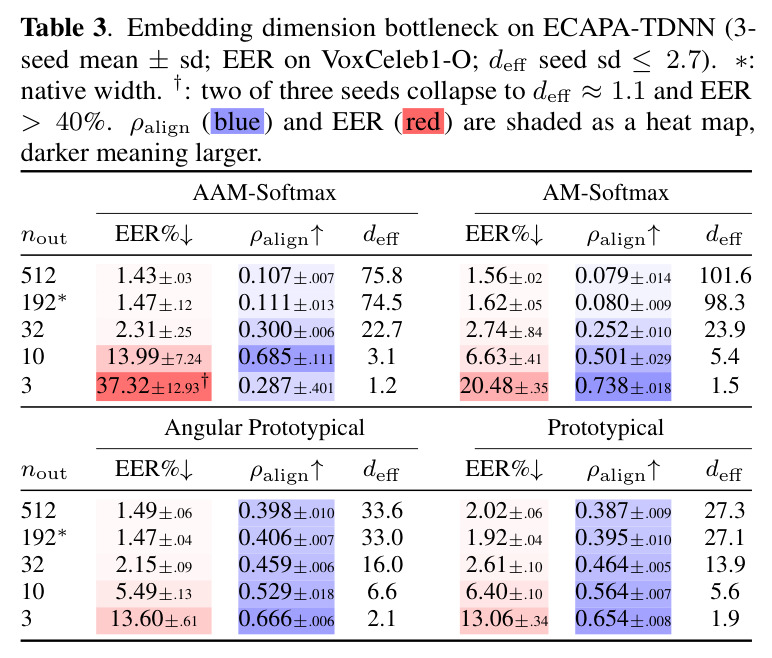
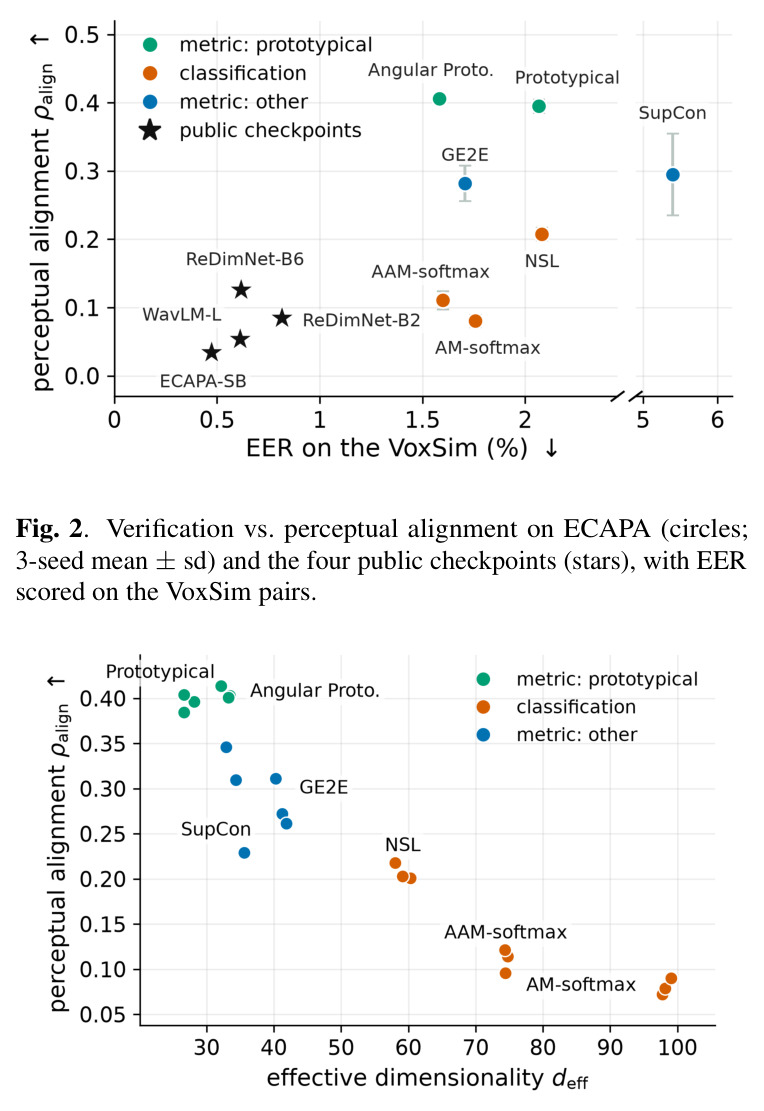
主实验(Table 1、Fig. 2):汇总 35 个训练条件,Spearman(EER, $\rho_{align}$)=+0.07(p=.71),单个模型条件内符号在 −0.68 到 +0.61 间摇摆且无一显著(p≥.11),说明 EER 对人类听感几乎没有信息量;4 个公开 SOTA checkpoint 恰好落在低 EER、低对齐的左下角,直接反驳按 EER 选型的惯例。训练目标才是决定因素:每个架构下最好与最差目标的 $\rho_{align}$ 相差 3 倍以上——Prototypical 系稳定在 0.395–0.499,分类系只有 0.080–0.298,AM-Softmax 在全部 5 个架构中垫底(ECAPA 上仅 0.080±.009)。在 ECAPA 上把 AAM-Softmax 换成 Angular Prototypical,$\rho_{align}$ 从 0.111 升到 0.406(近 4 倍)而 EER 持平于 1.47%,提升对齐无需验证代价。几何分析(Table 2、Fig. 3):$d_{eff}$–$\rho_{align}$ 秩相关在 5 个模型条件内为 −0.71 到 −1.00,4 个条件置换检验 p≤.007(ReDimNet-B2 p=.088),汇总 35 个条件达 −0.95(p<.001)。干预实验(Table 3):$n_{out}$ 从 192 压到 3,AM-Softmax 的 $\rho_{align}$ 从 0.080 单调升到 0.738($d_{eff}$ 从 98.3 压到 1.5),EER 升至 20.48%——已接近人类区间(人类在 VoxSim 上 17.7%、VoxCeleb1 上 15.8–26.5%);$n_{out}$=512 与 192 几乎无差别,说明维度只是上界;AAM-Softmax 在 $n_{out}$=3 时 3 种子里 2 个不收敛($d_{eff}$≈1.1,EER>40%)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 感知对齐(VoxSim,16,905 个不同说话人对) | ρalign(SRCC) | 0.738±.018(ECAPA-TDNN + AM-Softmax,nout=3) | 0.080±.009(同架构同损失,nout=192) | 提升 0.658,约 9.2 倍 |
| 对齐预测因子(35 个训练条件汇总) | Spearman 秩相关(对 ρalign) | deff:−0.95(p<.001) | EER:+0.07(p=.71,不显著) | 从不显著变为近完全负秩相关 |
| 训练目标选择(ECAPA-TDNN,192 维) | ρalign / EER% | Angular Prototypical:0.406±.007 / 1.47% | AAM-Softmax:0.111±.013 / 1.47% | ρalign 近 4 倍,EER 完全持平 |
| 维度瓶颈(ECAPA-TDNN + AM-Softmax) | ρalign / deff / EER% | nout=10:0.501 / 5.4 / 6.63% | nout=192:0.080 / 98.3 / 1.62% | EER 仅升至 6.63% 即换得 6 倍对齐 |
局限与改进
作者承认的局限:维度瓶颈以验证性能为代价,$n_{out}$=3 时所有目标的 EER 都升到 13–37%,需按应用场景权衡『像谁』与『是不是谁』;极低维度下分类损失训练不稳定,AAM-Softmax 在 3 个种子中 2 个不收敛;对齐的绝对水平仍有限(最好 0.738),余弦相似度本身可能不是感知的完美度量。我的补充观察:全部感知证据来自 VoxSim 一个数据集——13 名听者、每对仅约 2 次评分,评分噪声不小,且语料与听者以英语为主,跨语言/跨文化的普适性未验证;$d_{eff}$ 只在说话人质心层面计算,句子级几何(韵律、情绪、风格所在的方向)被刻意抹平,因此结论对 TTS 表现力类评测的适用性存疑;五个架构全部训练于 VoxCeleb2,未覆盖自监督预训练目标本身或更大规模数据的影响;『为什么人类音色感知偏好低维』仍停留在引用心理声学的唯象层面,论文未给出计算机制的解释。
独立分析的弱点
弱点一:$\rho_{align}$ 绝对水平偏低(最佳 0.738),意味着即使几何对了,原始余弦相似度也只解释了约一半的感知排序方差,改进方向是学习感知校准的相似度函数——如对余弦分数做单调校准,或直接在低维空间学一个可学习的感知度量。弱点二:硬维度瓶颈粗暴且伤害验证精度($n_{out}$=3 时 EER 13–37%),更优雅的做法是把 participation ratio 本身写成可微正则项(谱正则化把特征值谱拉向低秩),在不砍维度的情况下约束 $d_{eff}$,从而保留模型容量。弱点三:margin 类损失在极低维度下优化崩溃(AAM 2/3 种子失败),可用渐进降维、边际退火或谱归一化稳定训练。弱点四:$d_{eff}$ 依赖全体说话人质心的整体 PCA,当说话人集合或语料分布变化时数值是否稳定、能否增量估计,论文未讨论,这限制了它作为在线监控指标的使用,可研究滑动窗口或子采样下的估计方差。弱点五:感知数据只有 VoxSim 一个来源、13 名听者、每对约 2 评分,统计根基偏薄,应纳入多语言听感数据集或更大规模众包评分,检验 $d_{eff}$–对齐关系的跨数据集可重复性。
未来方向
作者明确提出的方向:把 $d_{eff}$ 作为无需人工标注的评测与优化准则,用于语音生成任务中的说话人嵌入选择与设计。基于其成果可以延伸:第一,把 participation ratio 直接写进损失(谱正则化/软约束),端到端优化对齐而绕开硬瓶颈的精度损失;第二,解释性方向——结合 Baumann & Belin 的心理声学维度,检查质心 PCA 的主方向是否对应基频、共振峰、音色亮度等可解释声学轴,从而回答『人类音色感知为什么是低维的』;第三,跨模态验证——在人脸识别、图像感知质量等领域检验『有效维度假说』是否普适,形成表示学习的一般规律;第四,考察 utterance 级残差几何与风格/情感相似度的关系,把判据扩展到表现力评测;第五,刻画对齐–验证精度的 Pareto 前沿,为不同应用(音色克隆保真 vs 防伪区分)给出系统化的维度与损失选择建议;第六,把分析延伸到自监督语音模型(WavLM/HuBERT 各层)的 $d_{eff}$ 与感知对齐。
复现评估
复现条件良好。代码、完整训练配置和随机种子已在 GitHub 开源(47zzz/voice-similarity-embedding-geometry)。训练数据 VoxCeleb2-dev(5,994 个说话人)公开可下载;评测所用的 VoxCeleb1-O trial 清单和 VoxSim 感知评分(46,348 条语音、13 名听者对 27,697 对的 1–6 分评分)均已随原数据集发表,无需自行组织听评。算力方面,ECAPA-TDNN、ReDimNet-B2、Fast ResNet-34 都是轻量模型(log-mel 输入,80 epochs),WavLM 分支需要 Base+ 主干(20 epochs 冻结 + 5 epochs 解冻微调),单张消费级/入门级 GPU 即可承担;完整矩阵约 105 个主实验模型加 20 个瓶颈模型,若只复现核心结论(单架构 × 7 损失 × 3 种子 + 相关分析)成本更低。指标实现(EER、SRCC、participation ratio)都是标准操作,无隐藏工程难点。整体复现难度评估为中等:主要成本在批量训练次数,而非数据获取或工程门槛。
论文图表
ECAPA 条件下 21 个模型点(7 损失 × 3 种子)的 $d_{eff}$–$\rho_{align}$ 散点图,各点紧密贴合对角趋势线,Spearman 相关 −0.96(条件均值)到 −0.95(全部点),直观展示『嵌入维度铺得越开、与人类听感越不一致』的单调关系。
论文核心假说的关键可视化:−0.95 的紧密拟合是 $d_{eff}$ 作为感知对齐免标注预测子的最有力单图证据。