Opera:面向长程编程智能体的言语批评框架 Opera: A Verbal Critic Framework for Long-horizon Coding Agents
把每次纠错变成带判据的持久便签,跟踪到真正解决,最高提升15个百分点
前置知识
长程编程智能体
能在真实代码仓库中多轮执行搜索、查看、编辑、运行测试、提交补丁的 LLM 代理,运行在 OpenHands、Terminus-2、mini-swe-agent 等 harness 上。任务动辄几十上百轮,智能体容易重复失败动作、做冗余探索,甚至在测试未验证时就报告完成。
Opera 的批评对象正是这类智能体的执行轨迹,理解其多轮工作方式和典型失败模式,才能明白反馈在哪个环节介入、为什么需要持续跟踪。
过程批评 vs 结果验证
过程批评(如 SWE-PRM)在轨迹执行中途给出自然语言纠正意见;结果验证(如 LLM-as-verifier、Agentic Rubrics 的仓库级评分表)在任务结束后对最终补丁打分。前者及时但易被不完整的中间证据误导,后者证据充分却为时已晚。
Opera 的定位介于两者之间:执行中介入、又带结果式的固定解决判据。这是它与论文中两类基线对比的核心维度,也是表 1 结论的解释框架。
测试时扩展(test-time scaling)
不改模型权重,在推理阶段投入更多计算来提升性能,例如树搜索(LATS、SWE-Search)、多次采样、串行精化(S*)。批评者本质上是一种测试时计算的分配方式:决定在哪些时刻审查、在哪些时刻干预。
论文把 Opera 放在 test-time scaling 谱系中讨论,其混合审查调度就是把额外计算集中花在『值得干预』的时刻,而非均匀撒在整条轨迹上。
on-policy 数据与分布偏移
on-policy 数据由学生模型自身的动作构成,off-policy(教师轨迹)来自更强模型。对 off-policy 数据做监督微调会把学生拉向教师分布,遗忘风险随偏移增大;DAgger 与 on-policy 蒸馏的思路是让学生在自己实际会访问的状态上获得专家纠正。
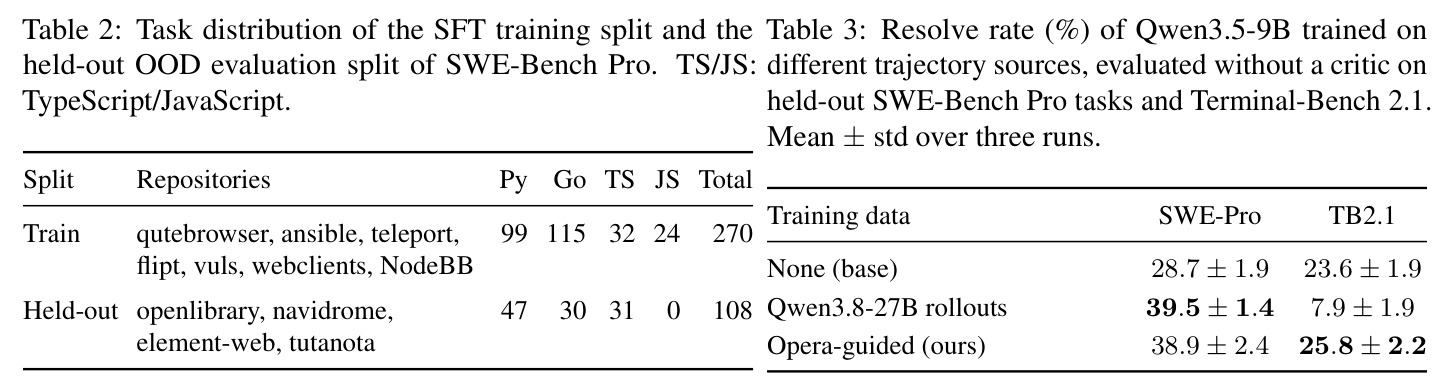
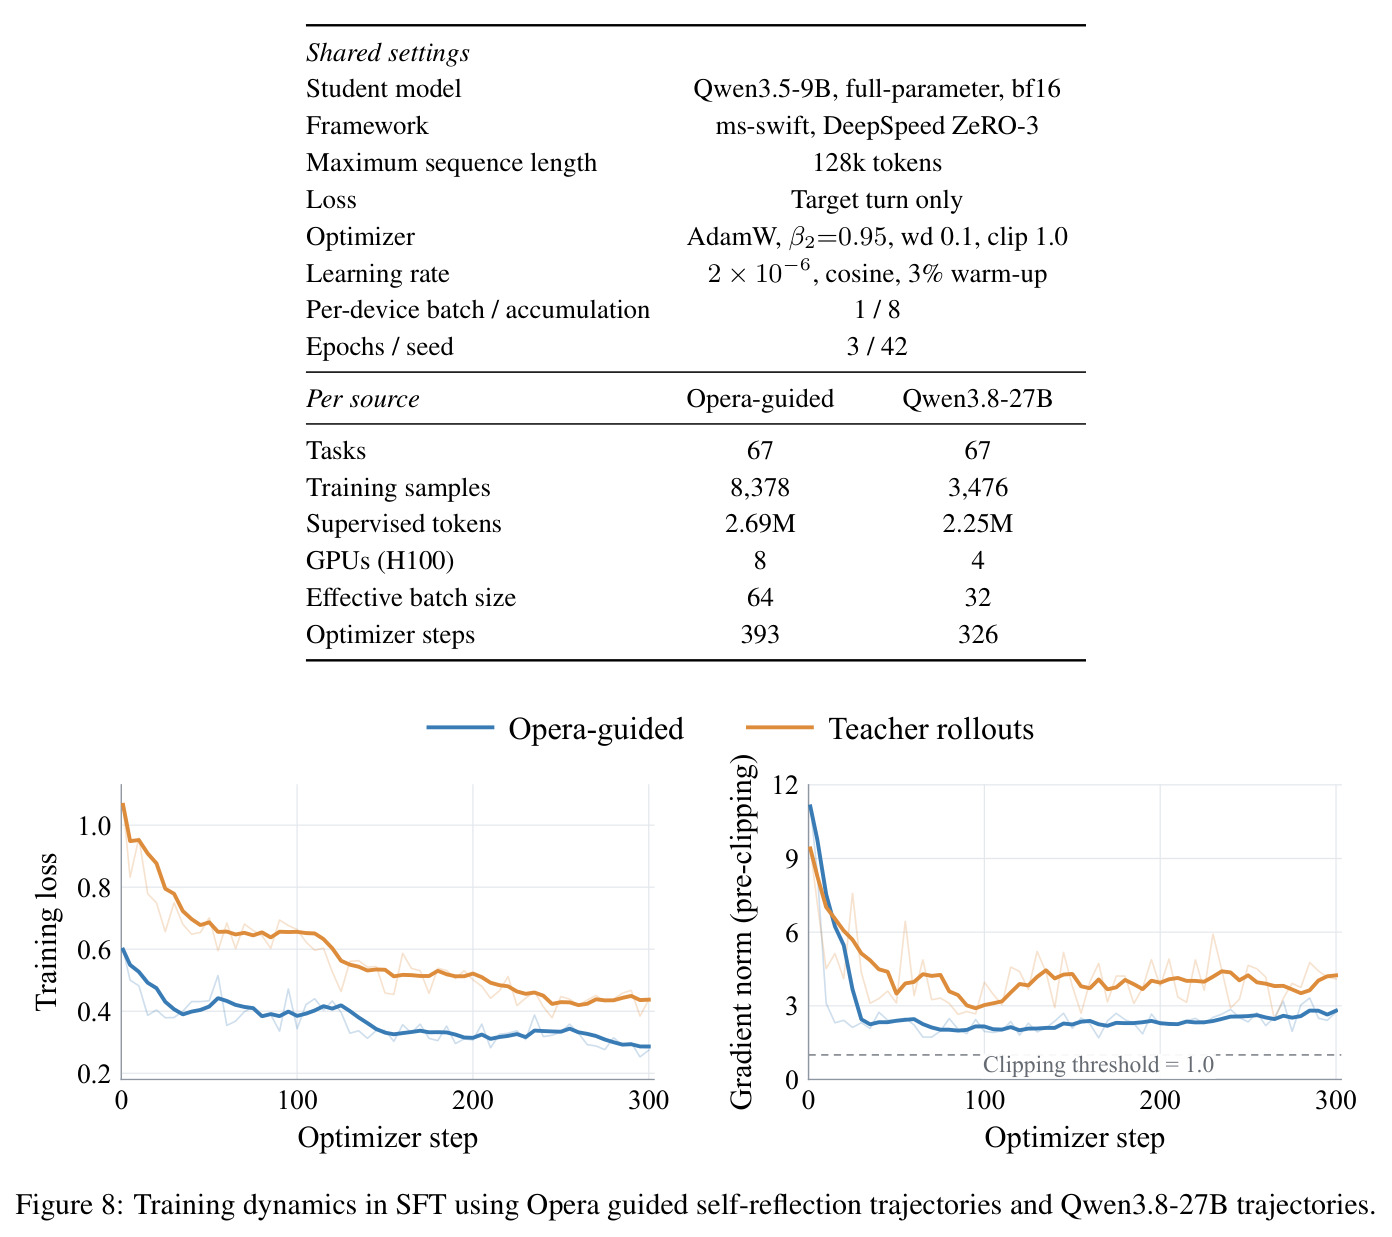
第 4.3 节的核心结论依赖这个概念:Opera 引导的学生 rollout 近似 on-policy,微调后保留跨基准泛化(TB2.1 保持 25.8%),而教师轨迹微调使 TB2.1 从 23.6% 崩到 7.9%。
LLM 评审噪声与审计
RuVerBench(Peng et al., 2026)表明 LLM 评审即使面对明确的评分标准仍会产生大量错误判断。Opera 的对策是两个只做接受/拒绝、不改写内容的门控审计:交付前的准入审计和关票前的放行审计。
审计是框架成立的关键组件:消融实验(表 5)显示去掉审计后 Terminal-Bench 2.1 的增益从 +7.9pp 掉到 +2.6pp,损失约三分之二。
研究动机
长程编程智能体在仓库级任务中经常重复失败的动作、做冗余探索,甚至在测试未经验证时就报告完成。一个在执行过程中诊断问题的批评者是自然的补救手段,但已有批评者(Self-Refine、Reflexion、CRITIC、SWE-PRM、SWE-Search、Agentic Rubrics)几乎只关注『评估轨迹+生成反馈』,很少跟踪反馈交付之后发生了什么。这留下三个未解决的问题:其一,何时介入——固定周期审查可能太迟(智能体在两次审查之间会把同一条失败命令重跑好几遍),而每个事件都触发审查又会打断本可成功的轨迹;其二,反馈是否站得住——看似合理的诊断可能误读不完整的中间证据,把原本会成功的实现方向带偏(Vasudev et al., 2026),且 LLM 评审即使面对明确标准仍有大量噪声(RuVerBench);其三,干预是否生效——智能体可能照做了建议,但底层故障原封不动,『顺从』不等于『解决』。
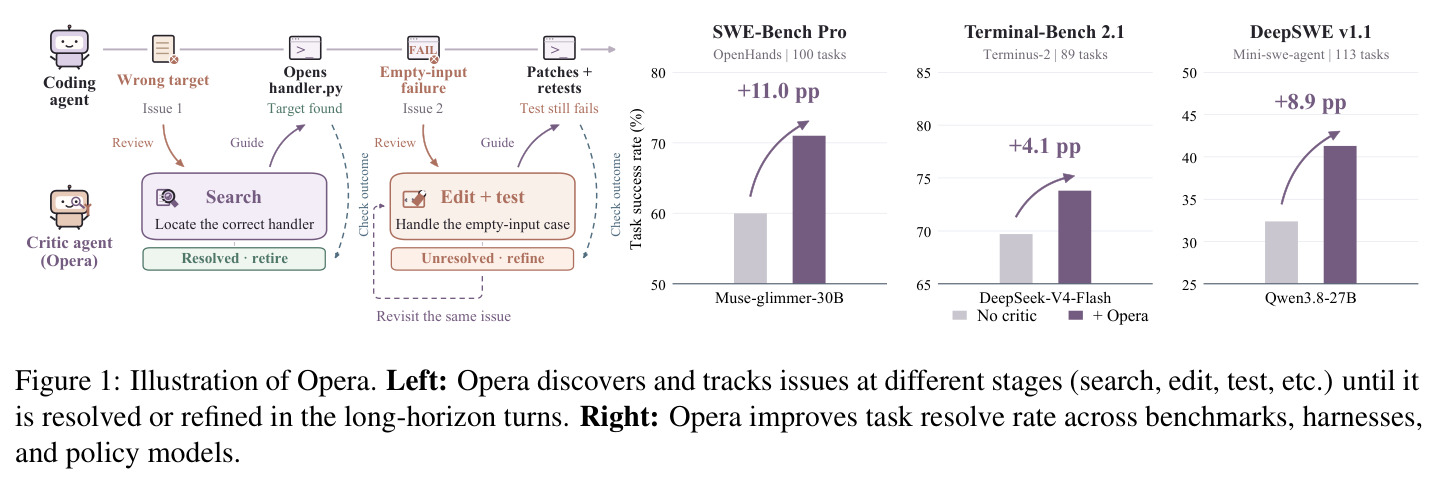
本文的目标是目标是构造一个言语批评框架 Opera:把每一条纠正意见当作一张持久便签来管理——发现问题即开票,经过审计确认后才交付给智能体,随执行过程持续跟踪,直到证据表明被诊断的问题真正解决才关票。框架只通过执行轨迹和自然语言反馈与智能体交互,不更新权重、不侵入 harness,因此可以直接插到 OpenHands、Terminus-2、mini-swe-agent 等现成框架上,在 Terminal-Bench 2.1、SWE-Bench Pro 子集、DeepSWE v1.1 三个基准、四个策略模型上稳定提升解题率(最高 +15.0 个百分点)。附带目标:让同一过程顺带产出『近似 on-policy』的纠错训练数据,用于微调更小的开源模型而不牺牲泛化。
与已有工作不同的是,独特切入是把反馈视为『事后才能验证价值的干预』,并为此补上完整的生命周期管理。此前工作要么研究怎么生成反馈(自我精化、分类学引导的 SWE-PRM、仓库评分表 Agentic Rubrics),要么研究怎么用分数搜索轨迹(SWE-Search 的蒙特卡洛树搜索),没有人系统追问『反馈交付之后呢』。Opera 的三个差异点:①混合审查调度——固定间隔加五类执行事件(Idle/Repeat/Error/Claim/Submission),且审查不等于干预,批评者可以选择沉默;②每条诊断必须挂到一个带契约的类型化算子上(适用条件、所需证据、纠正方向、解决判据、排除条款),避免『注意边界情况』式的空泛建议;③两条独立的审计在交付前后把关,并把『是否照做』与『是否解决』分开跟踪,关票必须依据固定判据而非最新的说辞。
核心方法
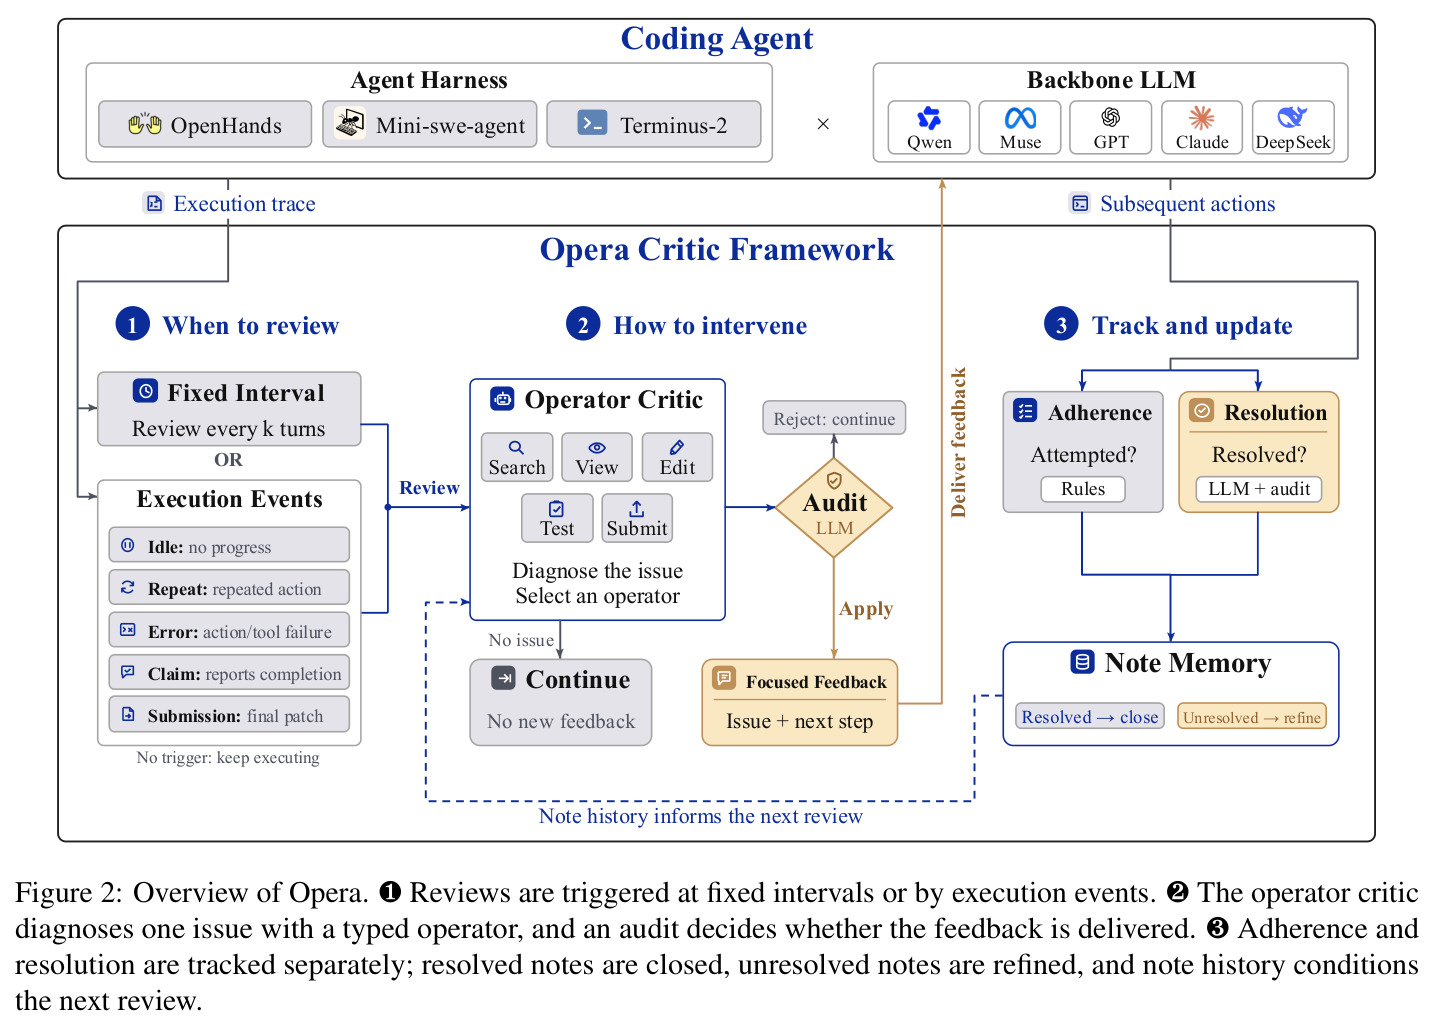
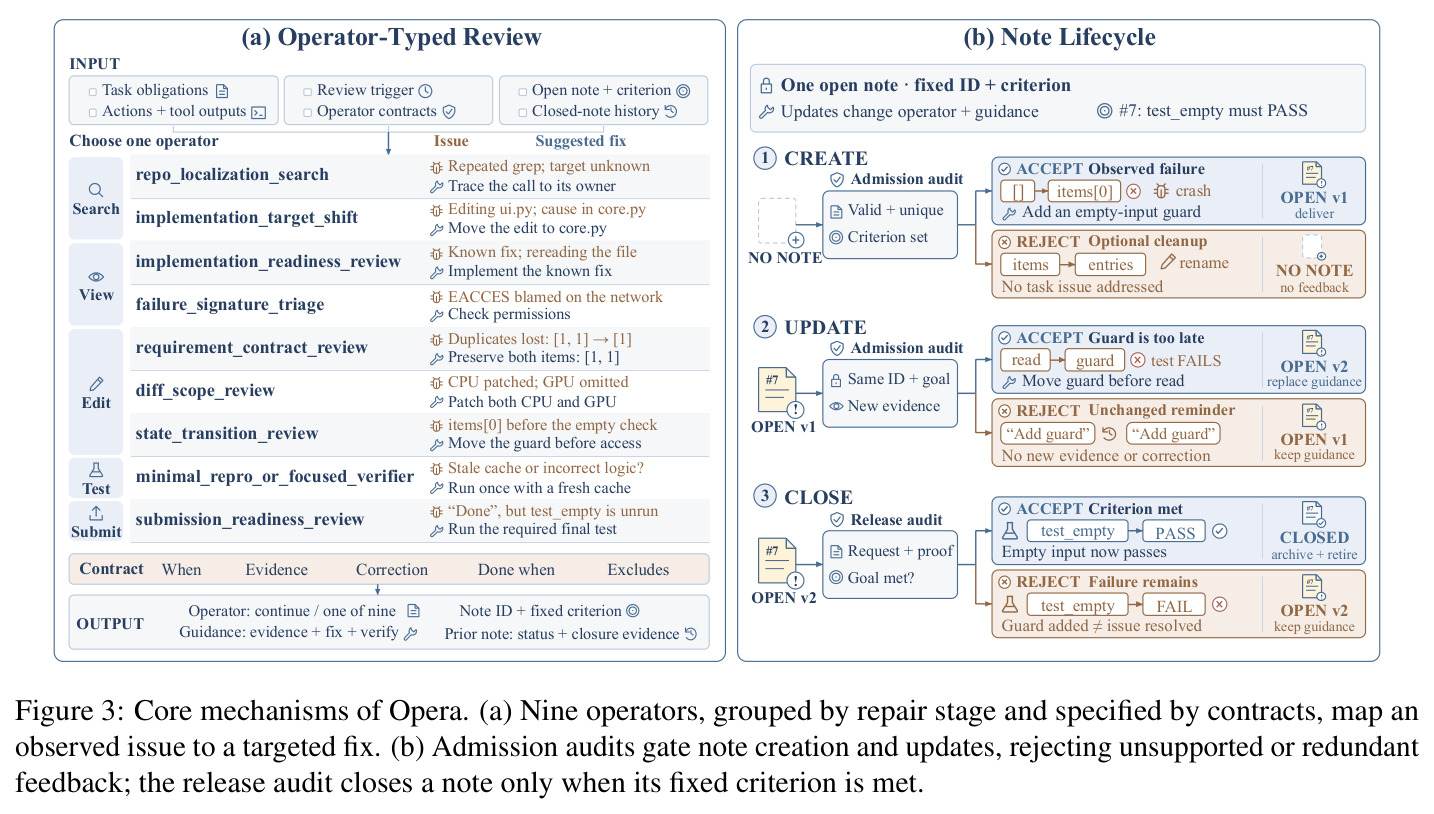
直觉:好的审稿人不只指出问题,还要确认作者改对了才算完。Opera 把这个直觉工程化为『持久便签』管理,每条便签形式化为 $n = (\text{id}, \text{operator}, \text{guidance}, \text{criterion})$——固定 ID 和固定解决判据,同一时间至多一张在办。框架由三个机制组成:①混合审查调度——每 $k$ 轮周期审查,外加五类执行事件立即触发(Idle 无进展、Repeat 重复动作、Error 动作或工具失败、Claim 报告完成、Submission 最终补丁),同时到达的信号合并为一次审查,事件审查重置周期计时器;②算子类型化审查——批评者从 9 个算子中至多选一个(Search 阶段的 repo_localization_search、implementation_target_shift;View 的 implementation_readiness_review、failure_signature_triage;Edit 的 requirement_contract_review、diff_scope_review、state_transition_review;Test 的 minimal_repro_or_focused_verifier;Submit 的 submission_readiness_review),也可返回 continue 不干预;③审计化便签管理——准入与放行两个审计都只做接受/拒绝、不改写内容。默认批评模型为 GPT-5.6-Sol (high),策略模型涵盖 Qwen3.5-9B、Muse-glimmer-30B、Qwen3.8-27B、DeepSeek-V4-Flash。
核心创新是『把纠正意见变成有身份、有判据、可跟踪的对象』。与已有方法的本质区别有三层:第一,便签更新可以换算子、换指引,但 ID 和解决判据不变——目标始终钉死在最初诊断的问题上,避免跟着最新建议走却忘了原本要修什么;第二,准入审计在交付前验证证据是否支持诊断、纠正是否必要、提议的检查能否确立解决,从而拒绝与任务无关的可选清理和没有新证据的重复提醒,把 RuVerBench 指出的 LLM 评审噪声过滤在智能体之外;第三,交付后分开跟踪两个量——遵守(adherence)用规则判断是否尝试了纠正,解决(resolution)用固定判据判断原问题是否消失,因为照做不等于修好:论文图 3b 的例子里智能体按建议加了空输入守卫,但必需的 test_empty 测试仍然失败。对比 SWE-PRM 只做固定周期审查且不管后续,Agentic Rubrics 只对最终补丁按评分表打分,Opera 同时具备过程批评的及时性与结果验证的判据严谨性。
方法步骤详情
完整流水线分六步:①触发审查:满足每 $k$ 轮周期或五类执行事件之一时发起,输入为任务描述、执行历史、触发信号与当前便签状态,无触发则不打扰智能体。②诊断:算子批评者依据九个算子契约(每个契约写明适用条件、所需证据、可要求的纠正、何时算解决、排除哪些问题)选择至多一个有证据支撑的问题,输出算子名、证据引用、位置、当前行为、所需修改与验证方法;同时独立报告在办便签是否仍未解决,保证即使没有新建议也继续跟进旧问题。③准入审计:先做有效性与去重检查,再验证证据-诊断支持性、纠正必要性、判据可检验性;被拒绝的提议(如与任务无关的代码清理)不改变现有便签。④交付聚焦反馈,智能体据此行动。⑤双轨跟踪:规则判断遵守(是否尝试),固定判据判断解决(原问题是否消失)。⑥放行审计关票:行为性要求需附执行结果(如 test_empty PASS),静态要求需附可见编辑;通过后归档便签并将其指引从智能体上下文中移除。关票在开票之前处理,因此一次审查可以关闭旧问题并开启新问题;便签历史作为下一次审查的输入,形成闭环。
技术新颖性
技术新颖性体现在四点:①『便签生命周期』的形式化——受反思记忆(Reflexion)与持久目标(Cohen & Levesque, 1990)启发,但首次把 LLM 批评的产出当成一等公民的状态机来管理(CREATE/UPDATE/CLOSE 加两个门控审计),而不是一次性文本;②审计被严格限定为验证者而非共同作者,只接受或拒绝、绝不改写,这与常见的『让 LLM 重写反馈』做法不同,保证了责任边界清晰、结果可归因;③同一时间只允许一张在办便签,使每次任务成功或失败都能归因到具体的某条纠正,也让 rescue/regression 分析(图 6)成为可能;④训练数据视角——批评者以便签和聚焦反馈的形式进入学生上下文,而动作全部来自学生本身,构成近似 on-policy 的纠错数据,原理上与 DAgger 和 on-policy 蒸馏一致;这是教师蒸馏做不到的,因为更强的教师很少犯学生才会犯的错误,其轨迹里缺少学生最需要的『错误现场+纠正』配对。
实验结果
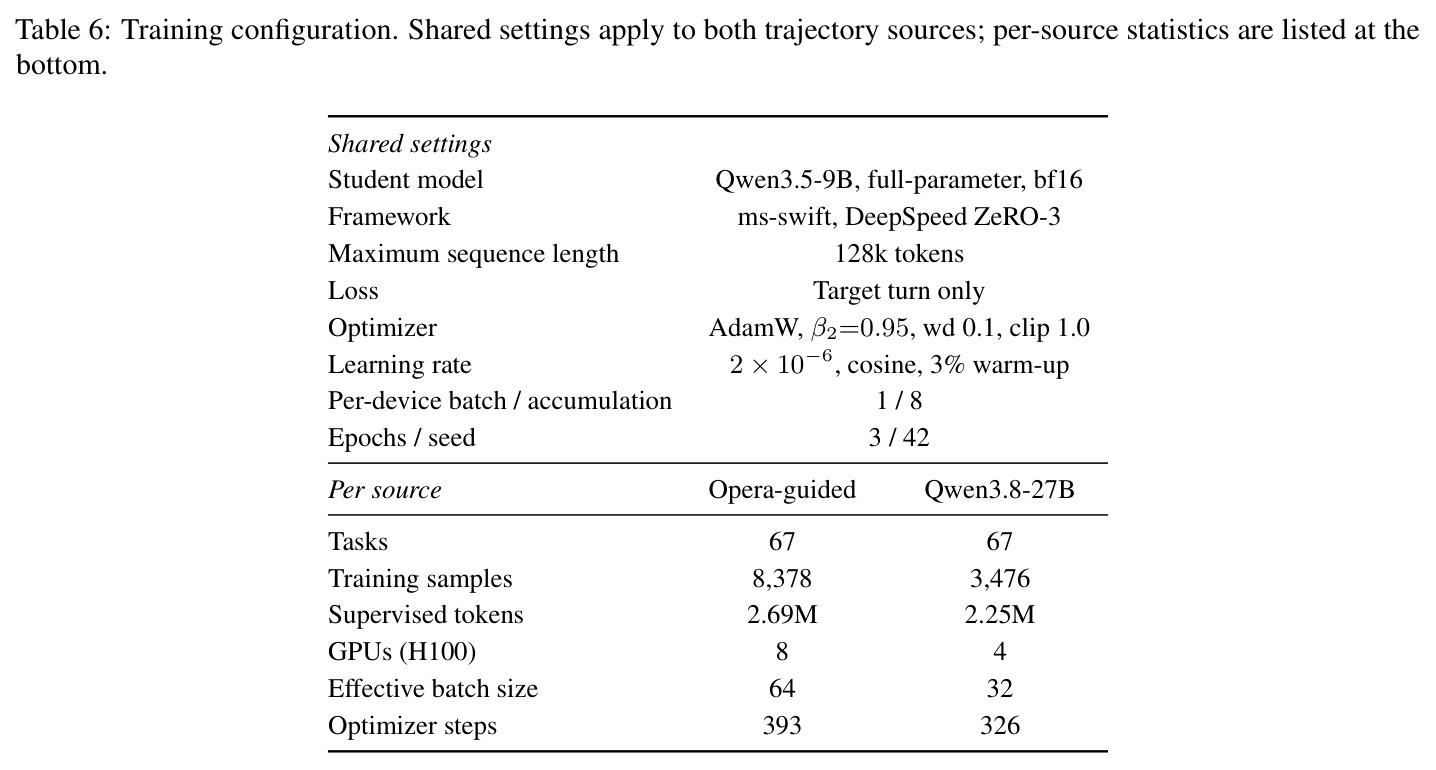
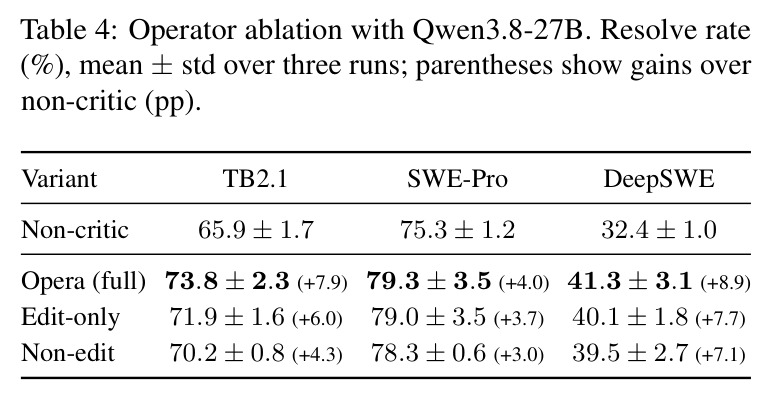
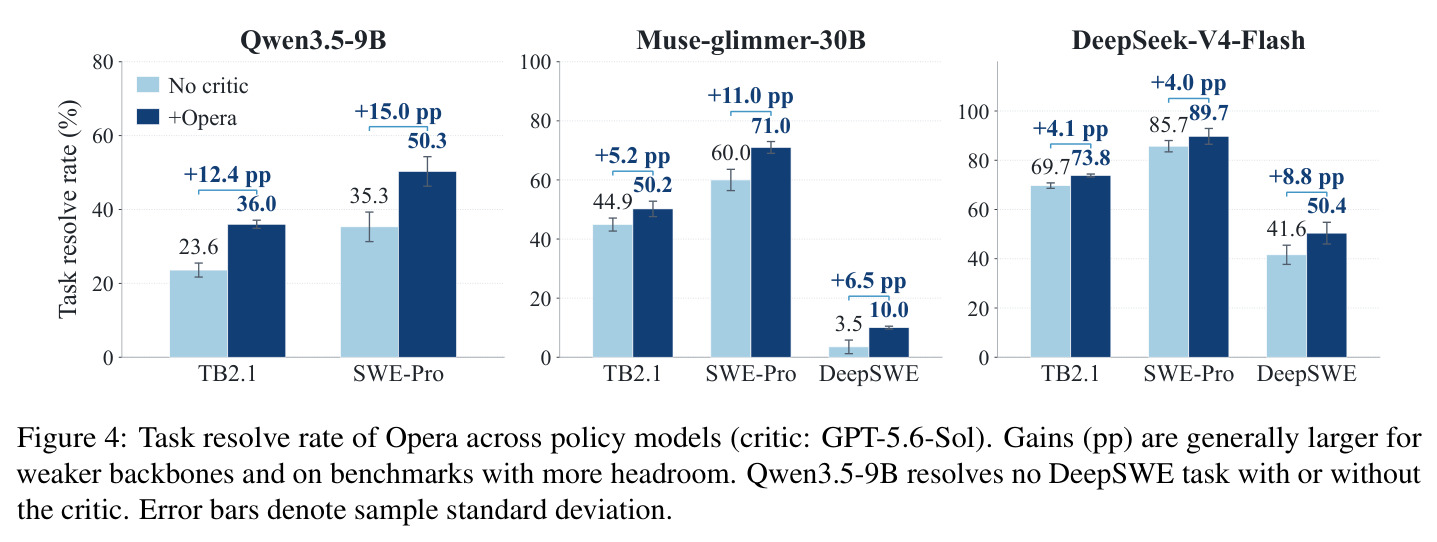
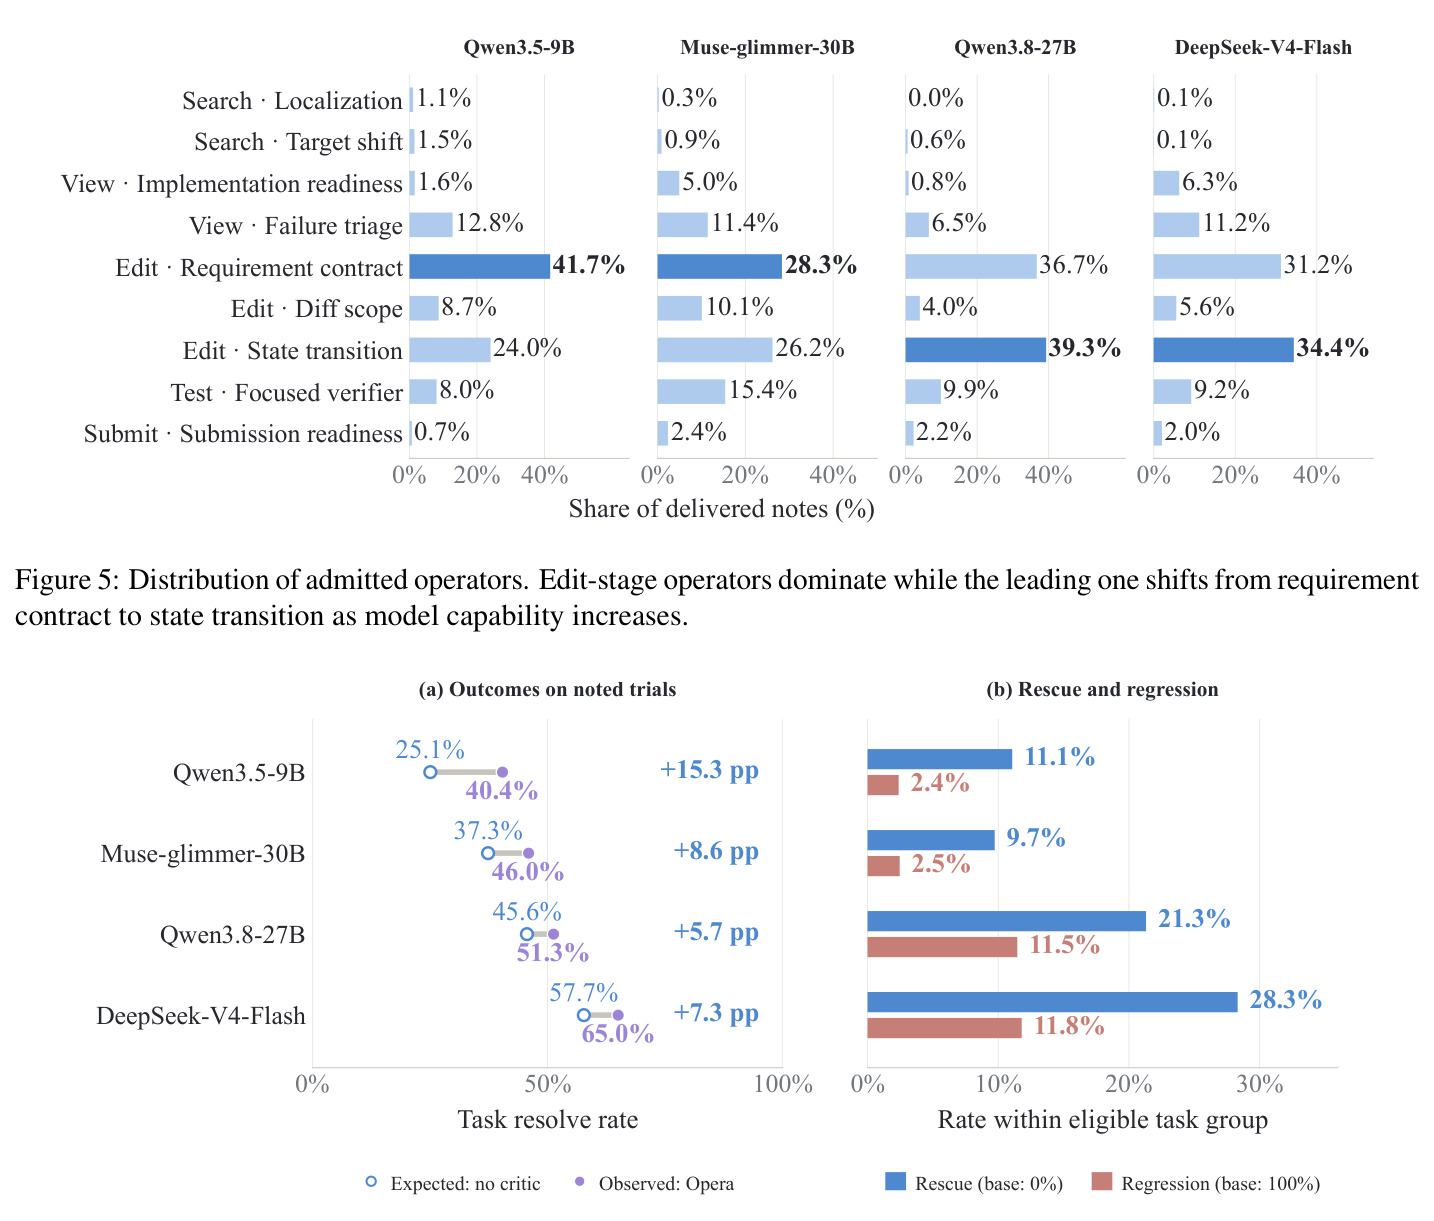
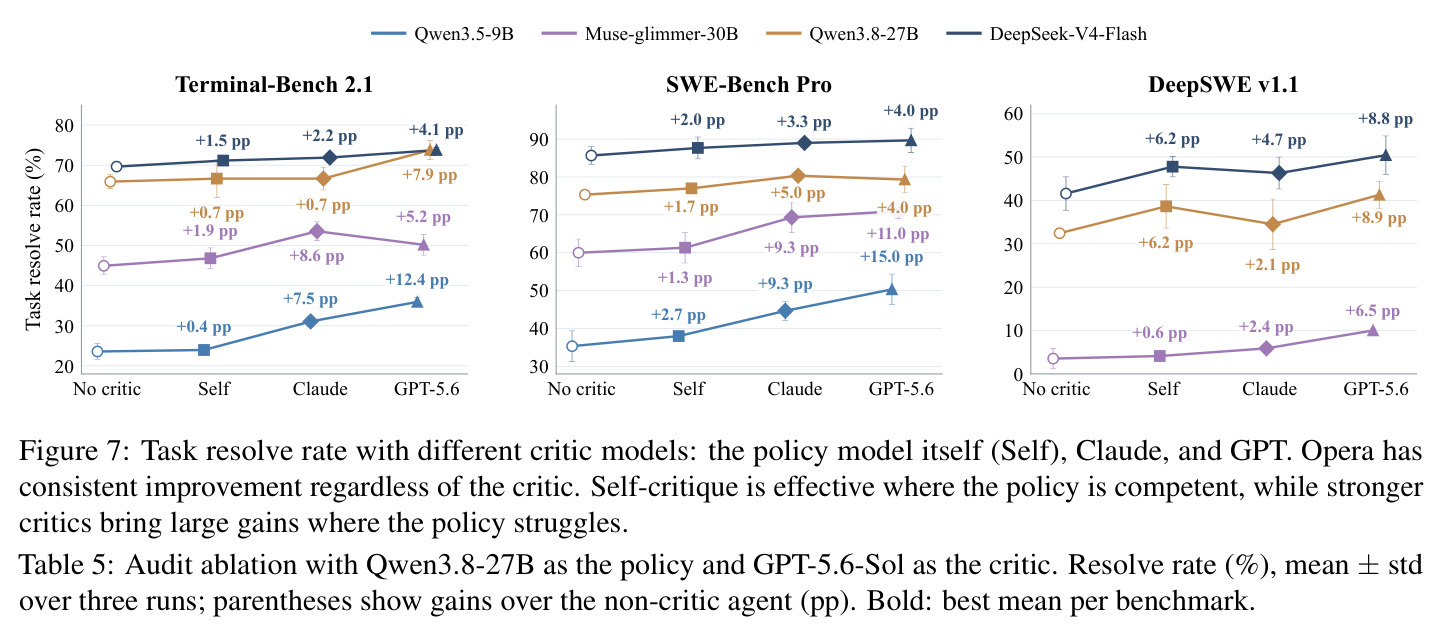
①与基线对比(表 1,策略 Qwen3.8-27B,批评 GPT-5.6-Sol):Opera 在三个基准全部第一——TB2.1 解题率 73.8%(非批评 65.9%,+7.9pp;最强基线 Agentic Rubrics 71.9%);SWE-Pro 子集 79.3%(75.3%,+4.0pp;最强基线 LLM-as-verifier 78.7%,仅领先 0.6pp);DeepSWE 41.3%(32.4%,+8.9pp,领先 1.8pp)。②跨策略模型(图 4):四个策略模型全部获益且弱模型空间更大——Qwen3.5-9B 在 TB2.1 从 23.6% 升至 36.0%(+12.4pp)、SWE-Pro 升至 35.3%(+15.0pp);DeepSeek-V4-Flash 在难基准 DeepSWE 上 +8.8pp;Muse-glimmer-30B 在 DeepSWE 从 3.5% 近三倍到 10.0%;Qwen3.5-9B 在 DeepSWE 上无论有无批评者均为 0,批评无法替代缺失能力。③训练配方(表 3):用 Qwen3.8-27B 做批评者的 Opera 引导 rollout 微调 Qwen3.5-9B,held-out SWE-Pro 从 28.7% 升至 38.9%(+10.2pp),与教师轨迹微调(39.5%)相当,但 TB2.1 保持 25.8%,教师轨迹微调则崩到 7.9%。④行为分析(图 5/6):Edit 阶段算子占被采纳便签的多数(Qwen3.8-27B 约 80%),Qwen3.5-9B 最多的是 requirement_contract(41.7%),更强模型转向 state_transition(39.3%/34.4%);rescue-regression 权衡明显——DeepSeek rescue 65.0% 但 regression 11.8%,Qwen3.5-9B rescue 40.4%、regression 仅 2.4%。⑤消融:表 4 显示 Non-edit 算子便签仅约五分之一却在三个基准恢复一半以上增益;表 5 显示去掉审计后 TB2.1 增益从 +7.9 掉到 +2.6pp、DeepSWE 从 +8.9 掉到 +4.5pp;图 7 显示自我批评对有能力的策略有效(DeepSWE +6.2pp),弱策略需更强批评者(Qwen3.5-9B 用 GPT 至少 +12.4pp,自我批评至多 +2.7pp)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Terminal-Bench 2.1(89 任务,Terminus-2 harness) | 解题率 (%),三次运行均值±标准差 | Opera 73.8 ± 2.3 | 非批评 65.9 ± 1.7;最强基线 Agentic Rubrics 71.9 ± 4.5 | +7.9 pp,领先最强基线 1.9 pp |
| SWE-Bench Pro 100 任务子集(OpenHands harness,按 OpenAI benchmark audit 修正后抽样) | 解题率 (%),三次运行均值±标准差 | Opera 79.3 ± 3.5 | 非批评 75.3 ± 1.2;最强基线 LLM-as-verifier 78.7 ± 2.3 | +4.0 pp,领先最强基线仅 0.6 pp |
| DeepSWE v1.1(113 任务,mini-swe-agent harness) | 解题率 (%),三次运行均值±标准差 | Opera 41.3 ± 3.1 | 非批评 32.4 ± 1.0;最强基线 Agentic Rubrics 39.5 ± 2.8 | +8.9 pp,领先最强基线 1.8 pp |
| 弱策略模型 Qwen3.5-9B 的提升(批评:GPT-5.6-Sol) | 解题率提升 (pp) | TB2.1 23.6→36.0;SWE-Pro 约 20→35.3 | 无批评者的同一策略模型 | TB2.1 +12.4 pp;SWE-Pro +15.0 pp(全文最大单点增益) |
| Qwen3.5-9B 微调(Opera 引导 rollout,批评:Qwen3.8-27B),held-out SWE-Bench Pro 108 任务 | 解题率 (%),三次运行均值±标准差 | 38.9 ± 2.4 | 未微调 base 28.7 ± 1.9;教师轨迹微调 39.5 ± 1.4 | +10.2 pp,与教师蒸馏持平,且 TB2.1 保持 25.8%(教师轨迹微调降至 7.9%) |
局限与改进
作者承认的局限:训练配方只在一个模型(Qwen3.5-9B)加一个 OOD 基准上做了 SFT,未扩展到更大数据集、未用训练后的模型做迭代、未与 RL 结合;自我批评的对比没有匹配额外的推理计算开销;在 SWE-Bench Pro 上优势很小(0.6pp),当非批评智能体已经很强时所有批评者的增益都有限;批评无法替代能力缺口——Qwen3.5-9B 在 DeepSWE 上无论有无批评者均为 0。我的补充观察:①每次审查需要批评者调用加两次审计,长轨迹下 token 成本与延迟显著增加,论文未报告任何开销数字;②同一时间只允许一张在办便签,多个独立问题时只能串行修复,可能拖慢本就很强的模型;③审计本身也是 LLM,可能误拒有价值的反馈(假阴性),论文只统计了被采纳诊断的分布,没有给出审计拒绝的精度分析;④评测方差不小(标准差最高 ±4.7),部分结论(如全集算子相对 Edit-only 的 0.3pp 优势)落在运行间方差之内。
独立分析的弱点
①成本-收益未被量化:五类事件加周期审查意味着审查远比每 $k$ 轮一次频繁,每次审查又包含诊断、准入审计、可能的放行审计至少两三次 LLM 调用,而论文未报告任何开销数字;对 65-79% 本就能解出的任务,这是给大多数轨迹白白加钱。改进方向:学习『何时值得审查』的轻量触发策略,或用小模型审计、大模型诊断的级联。②单便签串行化:真实任务常有多处独立缺陷(同时存在需求误读和逻辑错误),串行处理拉长轨迹。改进方向:允许并行少量便签并做冲突消解。③审计的拒绝边界不明:论文只展示了拒绝坏建议的收益,没测量误拒好建议的频率。改进方向:报告审计的 precision/recall 式统计并用被拒样本迭代提示。④依赖轨迹可见性:五类事件全部来自可观察的执行痕迹,『自信地改错文件』这类静默失败要等周期审查才能发现。改进方向:增加基于仓库状态 diff 的语义事件,如检测大范围无关改动。⑤训练结论单薄:只有 SFT、单模型、单 OOD 基准,且批评者是更强的 Qwen3.8-27B,知识仍从外部注入。改进方向:把便签作为 RL 的过程奖励信号做对比。
未来方向
作者明确提出的方向:把训练配方扩展到更大数据集;用训练后的模型作为新策略迭代该流程(self-improvement 循环);把批评者反馈与强化学习结合,让自我纠错内化到权重里而非依赖推理时的外部批评。基于成果可延伸的方向:①自适应审查调度——利用 rescue/regression 统计为每个策略模型学习最优的 $k$ 和事件阈值,把审查预算花在刀刃上;②审计模型小型化——审计只做二元判断,可以蒸馏成便宜的小模型甚至规则分类器,大幅降低常驻成本;③把便签机制移植到代码之外的长程代理任务(网页操作、科学实验自动化),按领域重写算子契约;④用关票数据(问题→纠正→解决证据的三元组)训练可复用的过程奖励模型,让 Opera 的副产品变成独立资产;⑤多便签加依赖图管理,处理复合缺陷,并研究便签间的冲突与优先级。
复现评估
代码已在 GitHub 开源(https://github.com/dongyuanjushi/Opera)。三个基准均为公开数据集:Terminal-Bench 2.1(89 任务)、SWE-Bench Pro(按 OpenAI benchmark audit 修正后抽样 100 任务,覆盖原始集全部仓库)、DeepSWE v1.1(113 任务),并使用公开的 Harbor 框架管理任务、Pier 做防作弊网络隔离,超时采用 Harbor 官方 dataset card 的任务级配置。复现门槛主要在模型侧:默认批评者 GPT-5.6-Sol 与 Claude 为闭源商业 API,四个策略模型中 Qwen3.5-9B 和 Qwen3.8-27B 开源;主表和消融均为三次重复实验,API 费用或 GPU 时不小。方法细节(九个算子契约、审计规则、五类事件的定义)在正文与图 3 中描述充分,配合开源代码复现表 1/4/5 属于中等难度;训练部分需要自建 rollout 管线并在 270 个训练任务上跑 Opera 引导轨迹(图 7 级别的批评者敏感性实验最贵),难度更高。
论文图表
三种数据来源微调 Qwen3.5-9B 后(推理时无批评者)的解题率:未微调 base 在 SWE-Pro held-out 28.7、TB2.1 23.6;教师轨迹(Qwen3.8-27B rollout)微调后 39.5、7.9;Opera 引导的学生 rollout 微调后 38.9、25.8。结论:两种数据在目标基准上等效(约 +10 pp),但只有 Opera 引导数据不牺牲跨 harness、跨任务格式的泛化。
训练配方一节的关键证据表,直接展示了 on-policy 纠错数据相对教师蒸馏在抗遗忘上的优势(7.9% vs 25.8%)。
审计消融:去掉准入与放行审计(所有提议的便签都交付、所有提议的关票都接受)后,解题率降为 TB2.1 68.5、SWE-Pro 78.3、DeepSWE 36.9——TB2.1 的增益从 +7.9 pp 缩水到 +2.6 pp(损失约三分之二),DeepSWE 从 +8.9 pp 缩水到 +4.5 pp(约一半)。
证明审计过滤有害干预是框架的关键组件,直接回应了 RuVerBench 提出的 LLM 评审噪声问题。