改变乘积、保留参数:面向 Transformer 的结合代数层 Change the Product, Keep the Parameters: Associative Algebra Layers for Transformers
保持权重参数量不变,把矩阵乘法换成更便宜的结合代数乘积:吞吐+7%,质量略降
前置知识
分块矩阵乘法与 GEMM
把大矩阵按特征维度切成子块后,普通矩阵乘法在块层面展开为固定数量的子块乘加:2×2 分块需要 8 次块 GEMM。GEMM 是 GPU 上高度优化的稠密矩阵乘内核,MAC(乘加)次数是算术量的基本计量单位。文中所有成本分析都以“保留几个块 GEMM”来计数。
本文的核心操作是“删掉乘法表中的某一项=删掉一个 GEMM”。理解块乘计数才能读懂算术占比 $\rho_q=(2q-1)/q^2$、训练成本 $9BDF\to 9\rho BDF$ 等全部推导。
双线性秩与 Alder–Strassen 下界
双线性映射可写成 $\mu(x,w)=\sum_{\ell=1}^{r}\gamma_\ell\alpha_\ell(x)\beta_\ell(w)$,最少项数 $r$ 称为双线性秩 $R(\mu)$;对兼容的分块形状,每个秩一项恰好对应一次块 GEMM。Alder–Strassen 定理证明:维数为 $\dim A$、极大双边理想数为 $t(A)$ 的结合有单位代数满足 $R(A)\ge 2\dim A - t(A)$。
本文用这一定理证明图代数 $Q_G$ 的秩恰好等于 $|V|+2|E|$,即所给算法对该乘法表是精确最优的——“不能再省”的证书是它与启发式稀疏化的本质区别。
结合有单位代数
向量空间上一个双线性乘法若满足结合律 $(xy)z=x(yz)$ 且存在单位元 $1_A$($1_A x = x 1_A = x$),就构成结合有单位代数。在本文中它表现为层复合封闭:$\Phi_{W_2}(\Phi_{W_1}(X))=\Phi_{W_1\star W_2}(X)$,且单位元满足 $X\star E=X$,保证每个权重槽都可能影响输出。
结合性是作者决定“能删哪些乘积项”的设计约束:乱删会破坏层间复合封闭,多层堆叠后权重失去一致语义。这是整个方法成立的数学根基。
Strassen 算法与快速矩阵乘
Strassen(1969)证明 2×2 分块矩阵乘法可用 7 次块乘而非 8 次精确完成,开创了“固定乘积、寻找更便宜求值算法”的代数复杂度方向;后续有 Alder–Strassen、Bläser 的秩下界,以及 AlphaTensor、AlphaEvolve(Dupont et al., 2026)等自动化搜索继续压低矩阵乘法指数。
本文的问题是反向的:保持参数块不变、改变乘积本身。论文标题“Change the Product, Keep the Parameters”就是对 Strassen 传统的镜像反转,理解原方向才能看清新意。
KV cache 与自回归因果性
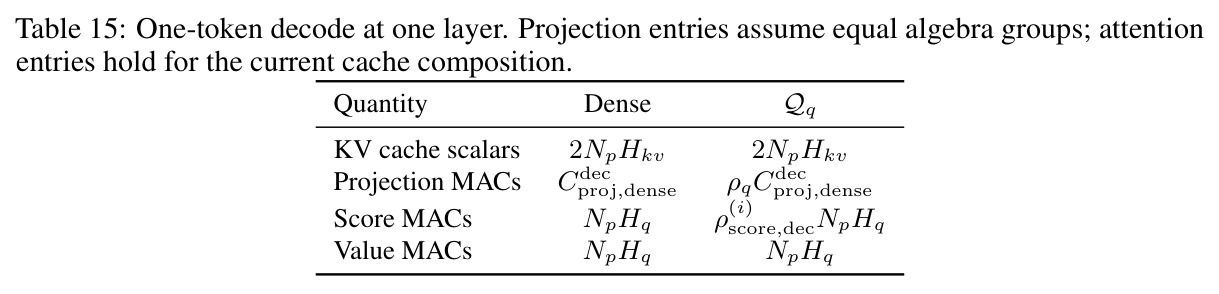
自回归生成时每个新 token 要与全部历史做注意力,KV cache 把历史的 key/value 存下来($2NH_{kv}$ 个标量)避免重算;训练用三角掩码保证位置 $p$ 只关注 $\le p$ 的位置,且因果性可逐层归纳证明。
代数层要能用于 LLM,必须兼容这套机制:论文要求行类型由绝对位置决定、每步只算新位置的行、cache 格式与稠密模型完全相同——这些约束筛选出了“行类型化投影”这一落地形式。
MoE 专家与 FFN 投影形状
DeepSeek-V3、Qwen3-MoE 等模型把 FFN 换成多个小专家,每个专家被路由到的 token 数 $M$ 远小于全 batch;专家形状如 $(D,F)=(7168,2048)$(DeepSeek-V3)或 $(2048,768)$(Qwen3-30B-A3B),与稠密模型 $(4096,12288)$ 差异巨大,直接决定 GEMM 的效率区间。
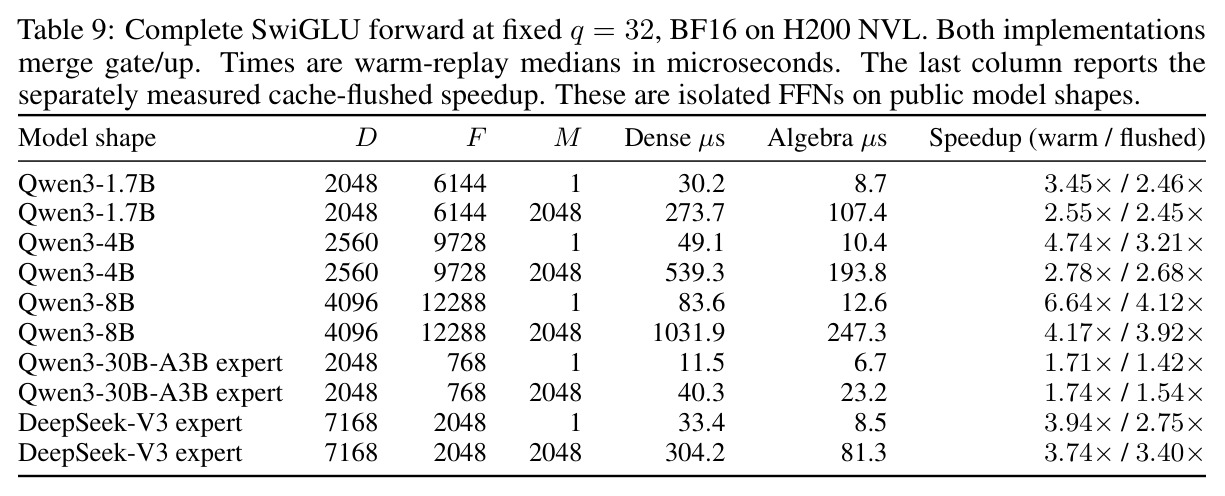
kernel 基准覆盖了这些公开部署形状,展示方法收益的边界:大形状加速可达 5–11.5 倍,而窄专家形状只有 1.3–2.9 倍,训练梯度核甚至可能变慢。
研究动机
Transformer 每层都在反复计算学习到的线性映射 $Y=XW$,FFN 和注意力投影是算力大头。现有加速思路几乎都沿“固定乘积、寻找更便宜算法”的方向:Strassen 把 2×2 分块乘法从 8 次块乘降到 7 次,AlphaTensor/AlphaEvolve 等继续降低矩阵乘法指数,但目标乘积始终是普通矩阵乘法。另一类结构化方法(Monarch、Block Tensor-Train、超复数/四元数层)通过参数因子化削减参数量,实际上改变了模型容量。作者指出的空白是:隐表示与层是联合训练的,中间乘积本身未必必须是普通矩阵乘法——此前没有工作在“精确保持参数量 $K\times N$ 不变”的前提下,把乘法规则本身当作架构超参数来设计,并用端到端 LLM 预训练检验其可训练性与实际收益。
本文的目标是本文要构造一族“更弱但更便宜”的乘积:保留与普通投影完全相同的权重块(同样的 $KN$ 个独立可学习标量),但用一张更稀疏的交互表决定哪些激活块与哪些权重块相乘。具体目标有四个:(1) 新乘法必须结合、有单位,使层间复合封闭在同一族内($\Phi_{W_2}\circ\Phi_{W_1}=\Phi_{W_1\star W_2}$);(2) 其双线性秩被 Alder–Strassen 下界证明精确最优,而非启发式近似;(3) 能落地为行类型化的矩形投影,兼容因果掩码与 KV cache 解码;(4) 固定物理块大小时,算术复杂度可随分组数增长降到平方阶 $\Theta(n^2)$。最终用同配方的双模型预训练(各约 110M 参数、12.3B token)回答两个实证问题:受限层能否从头训练?算术节省能否转化为端到端吞吐?
与已有工作不同的是,切入角度的反转性体现在三个层面。第一,与快速矩阵乘法相反:Strassen 传统保持乘积固定、改变算法,本文保持参数块固定、改变乘积规则——“change the product, keep the parameters”。第二,与结构化低秩方法不同:Monarch、TT、双曲层等削减或因子化参数,本文精确保留 $d_{in}d_{out}$ 个标量、只改乘法表,并用经过证明的双线性秩为每张表给出计算代价证书。第三,与 AlgebraNets 等替代代数网络不同:本文给出完整的 Transformer 落地路径——固定位置调度保证因果性、KV cache 不变、训练与解码共用同一行规则,且以严格对照的预训练实验量化质量-吞吐权衡。此外,它把代数复杂度理论的下界工具从“分析算法”转为“认证架构”,这一反向用法在架构论文中相当罕见。
核心方法
直觉上,$XW$ 的分块乘法就是一张“哪些激活组与哪些权重组交互”的表;删掉表中的项就删掉对应的 GEMM,但不能乱删——只留四个对角项会退化成逐组缩放,失去跨组交互。作者要求删完后的规则是结合、有单位的代数。技术上用无自环有向图 $G=(V,E)$ 定义乘积 $Q_G$:顶点是对角槽、边是非对角槽,基乘积规则为 $e_ie_i=e_i$、$e_ia_{ij}=a_{ij}$、$a_{ij}e_j=a_{ij}$,其余全为零。该代数维数 $|V|+|E|$,Alder–Strassen 界给出 $R\ge 2\dim-t=|V|+2|E|$,与显式算法匹配,故秩精确为 $|V|+2|E|$。最小例子 $Q_2$($q=2$)把普通块乘的 8 项中去掉闭合非对角循环的 $UW_v$ 与 $VW_u$,用 6 次块 GEMM。对 $q$ 顶点完全图 $Q_q$:$\dim=q^2$,$R=2q^2-q$,算术占比 $\rho_q=(2q-1)/q^2$。随后把表的每一“行”实现为 Transformer 投影:位置 $p$ 的类型 $\tau(p)$ 决定该 token 走哪一行。
核心创新是“把乘法规则本身变成架构选择”,本质区别有三点。(1) 带证书的最小实现:$Q_2$ 只删两项、用 6 次块乘,而 Alder–Strassen 定理给出 $R\ge 2m-v=2\cdot4-2=6$,证明这就是该乘法表的精确秩——不是启发式剪枝,而是数学上不可再省。(2) 参数守恒:权重银行仍存 $KN$ 个独立标量,每个权重块都保留在规则中($W_v$ 出现在 $DW_v$、$W_u$ 出现在 $AW_u$),跨行类型看权重作用是单射的——这与削减参数的结构化矩阵方法根本不同,交换的是“每个位置可见的交互模式”而非容量。(3) 固定块大小的平方复杂度:槽内保留普通 $b\times b$ GEMM、令 $q=n/b$ 增长,代价 $C(n,q)=(2q^2-q)(n/q)^3=2bn^2-b^2n=\Theta(n^2)$,避免 Strassen 类算法递归到标量级导致 GPU 效率崩塌的问题——块大小可以维持在对 GEMM 友好的规模。
方法步骤详情
流程分五步。(1) 设计代数:选定乘法表,如完全图 $Q_q$,或试点用的张量平方 $Q_2^{\otimes 2}$(16 维、36 次块乘、精确秩在 $[28,36]$,而直接 $Q_4$ 是 28)。(2) 行类型化投影:把输入/输出特征分为 $q$ 组(宽 $s_j,r_j$),位置 $p$ 的类型 $\tau(p)=1+((p-1)\bmod q)$ 等固定调度决定行;类型 $i$ 的 token 计算 $y_i=x_iW_{ii}$、$y_j=x_iW_{ij}+x_jW_{jj}\ (j\ne i)$,每个输出组 $j$ 的输入支撑 $B(i,j)$ 由代数决定。训练时全部行类型并行求值。(3) 反向传播:附录 B 给出的 vector–Jacobian 乘积保持与前向完全相同的块支撑,故前向+反向等于 3 倍前向 MAC;宽度 $D,F$ 的门控 FFN 三投影训练成本从 $9BDF$ 降到 $9\rho BDF$。(4) 推理:解码只算新位置一行(Algorithm 1 同样适用),绝对位置调度保证训练/prefill/解码类型一致,KV cache 格式不变;实现含批式与单 token 前向 kernel、对角优先调度、专用解码 kernel 与梯度 kernel,用 CUDA Graph 降低发射开销。(5) 尺寸筛选:有限形状约束 $q\le\min\{M/m_0,K/k_0,N/n_0\}$ 且 $q$ 整除特征宽度,实测加速还需 $\rho_q/\eta_q+\delta_q<1$($\eta_q$ 为有效算力比、$\delta_q$ 为相对开销)。
技术新颖性
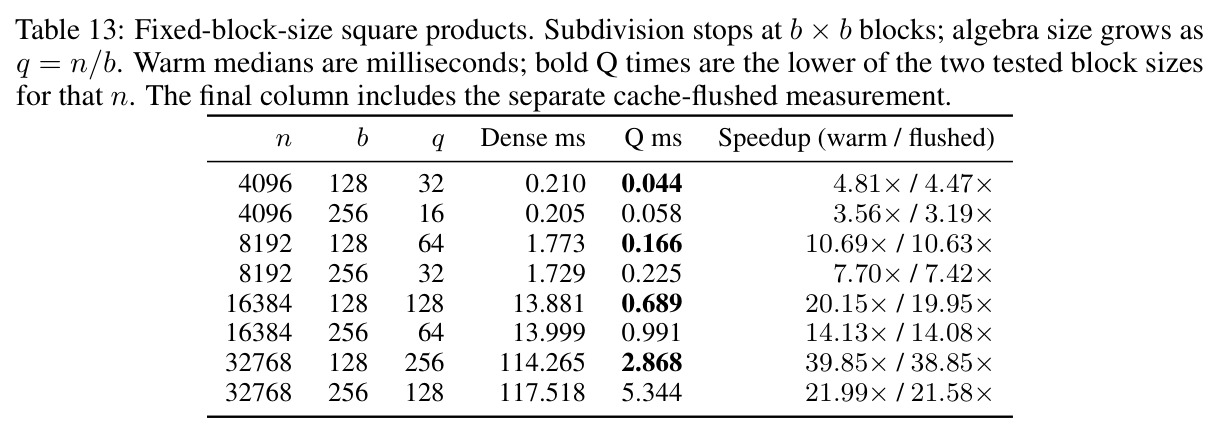
技术新颖性有四点。(1) 理论工具的反向使用:代数复杂度理论的 Alder–Strassen 下界通常用来证明“算法不能再快”,这里反过来为架构选择提供最优性证书——每张乘法表都附带精确双线性秩。(2) 结构图景:对角槽是顶点、保留的非对角槽是边、边-边乘积为零;边张成的空间 $J$ 是满足 $J^2=0$ 的幂零双边理想,商代数 $Q_G/J\cong\mathbb{F}^{|V|}$ 的半单结构直接决定秩下界,这给了“稀疏交互表”一个完整的代数刻画。(3) 工程闭环:行类型化把抽象代数律变成可训练层——训练并行评估全部行类型、解码只评一行、位置决定类型使 KV cache 完全兼容,因果性有归纳证明(Proposition 6.1)。(4) 有限尺寸分析:论文不满足于 $\Theta(n^2)$ 渐近论断,而是给出 $q$ 的整除性约束、$\eta_q$/$\delta_q$ 的加速判据,并实测 $b=128$、$n$ 从 4096 到 32768 的对数-对数斜率为 2.01,把理论标度落到真实硬件。
实验结果
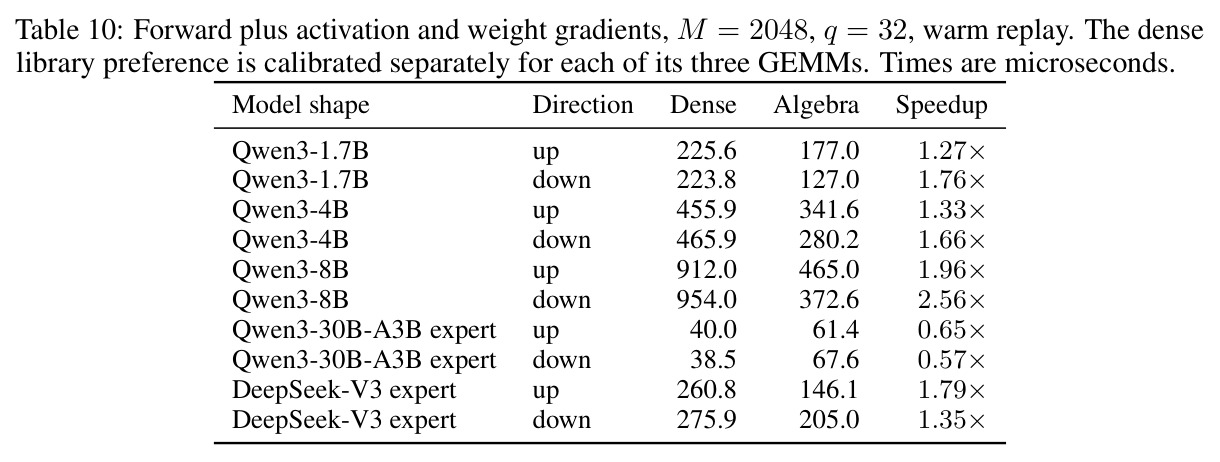
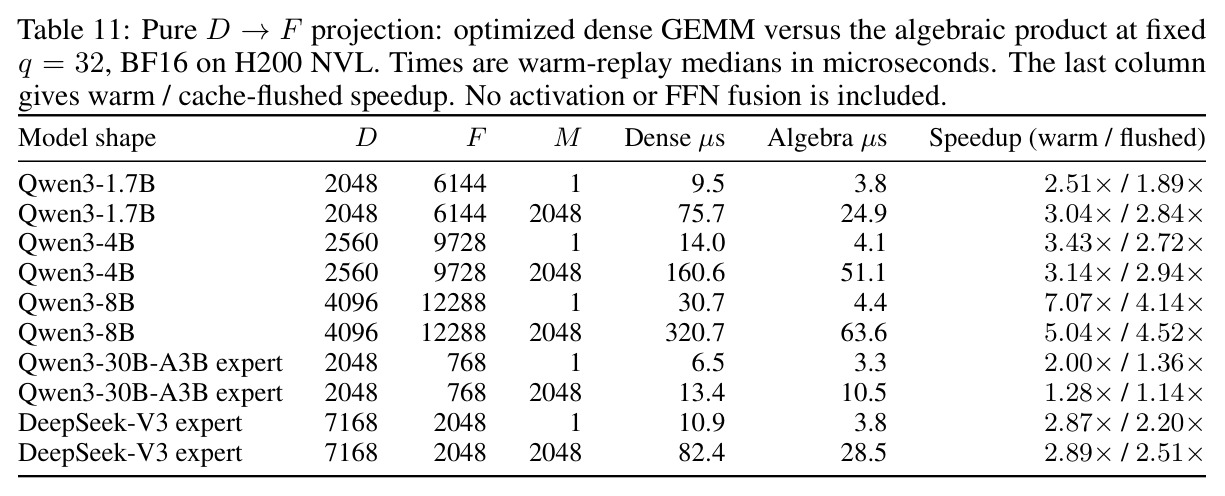
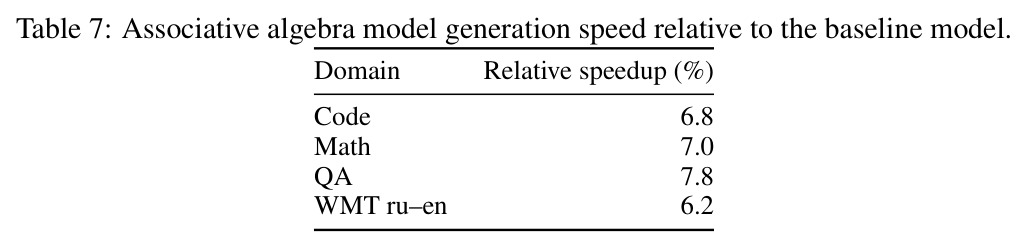
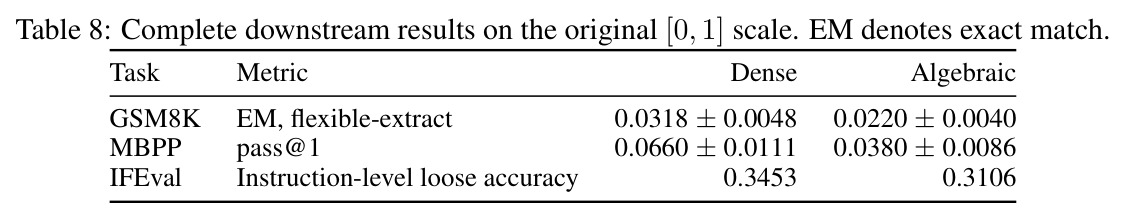
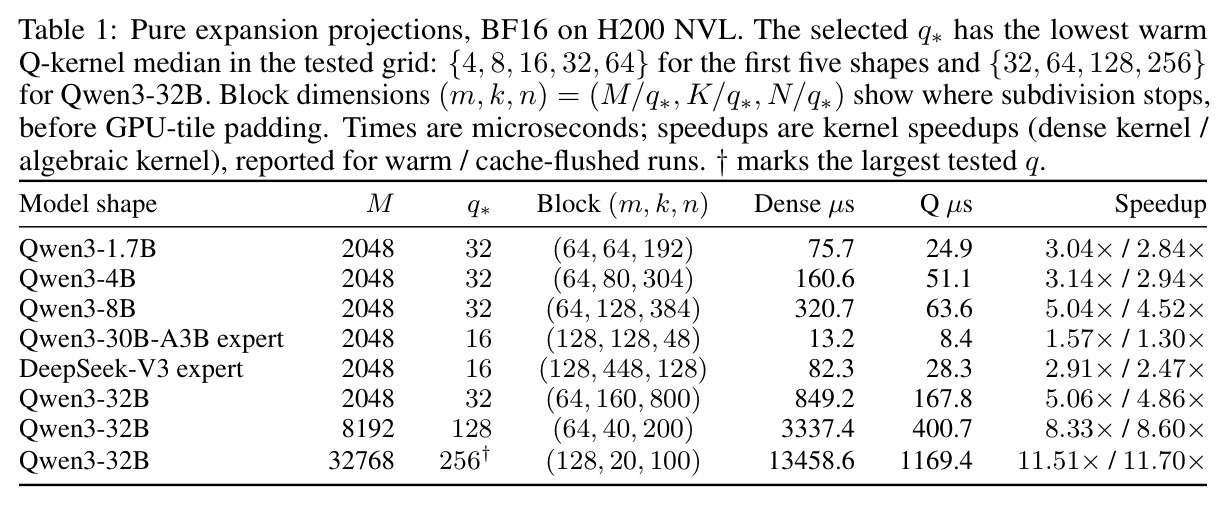
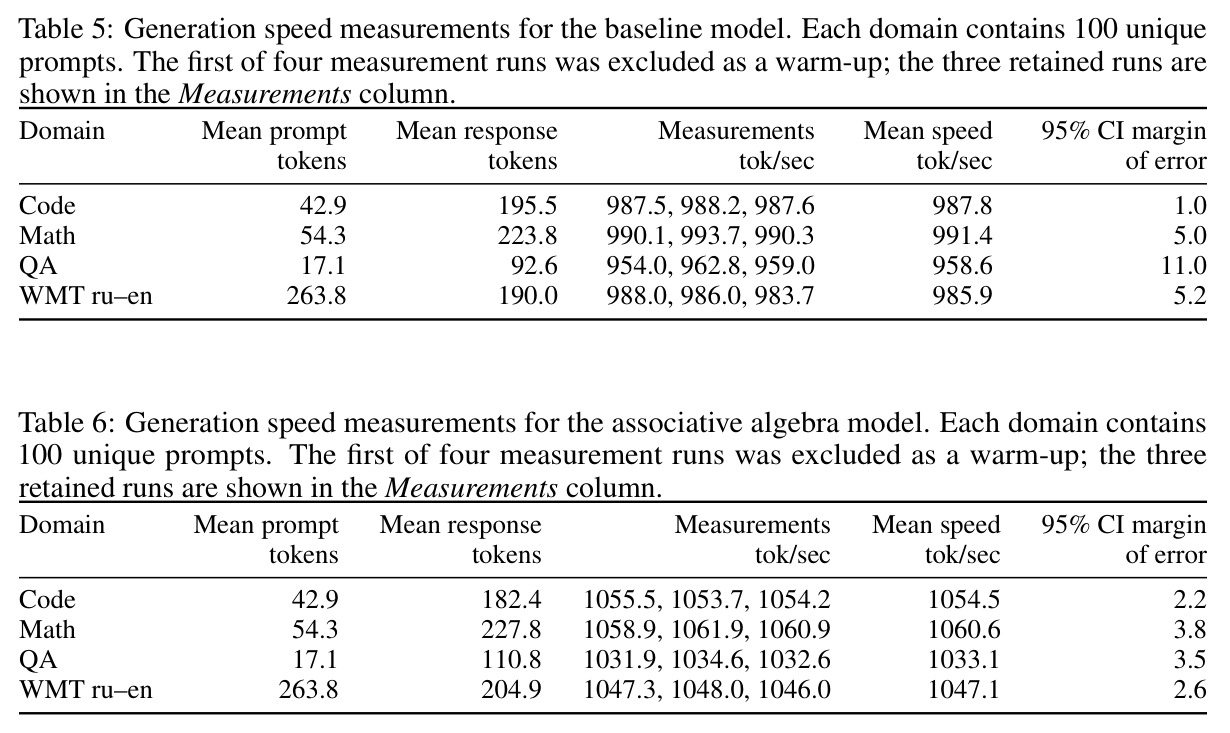
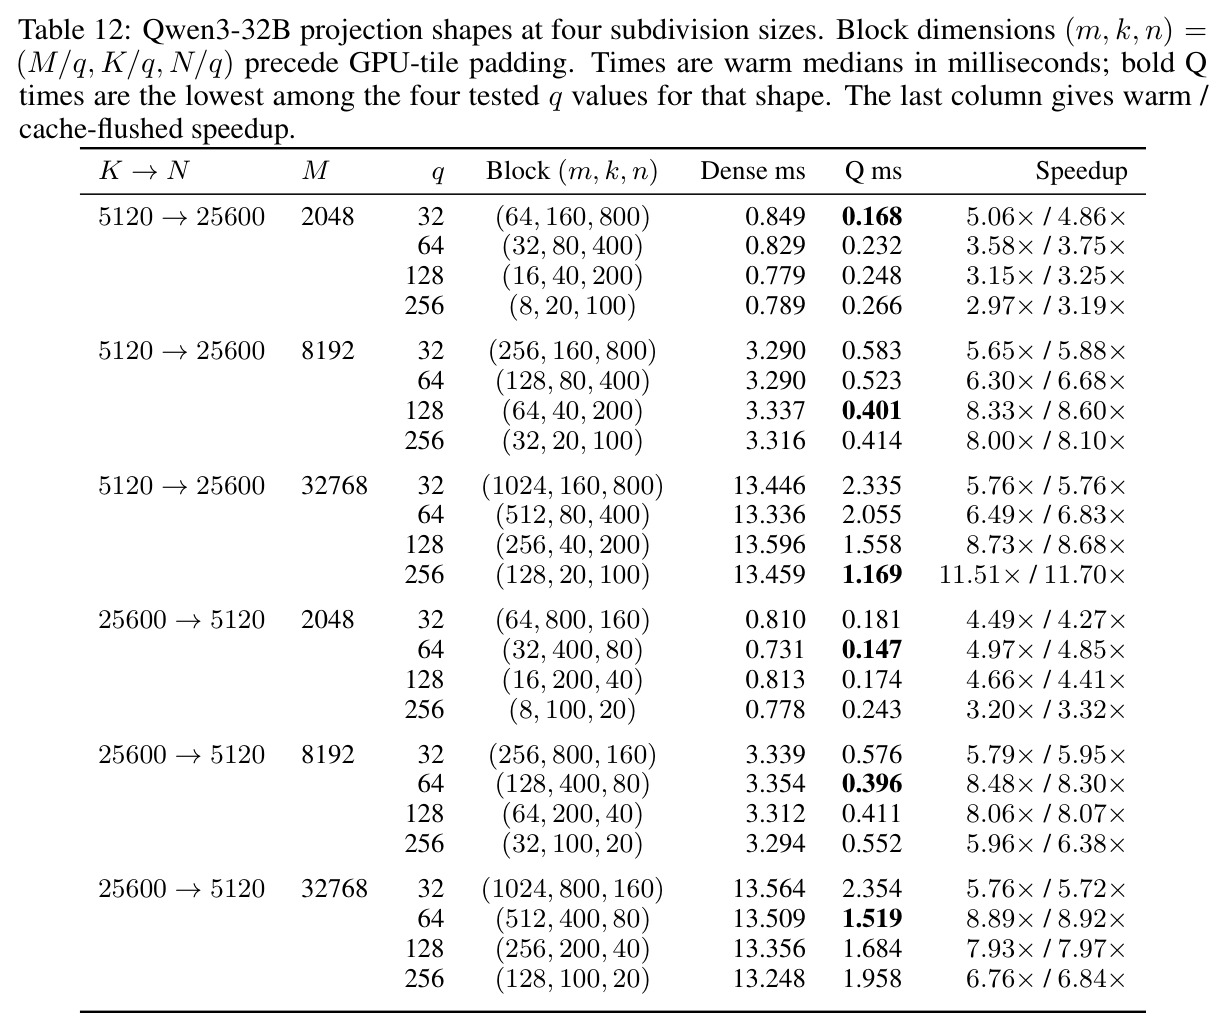
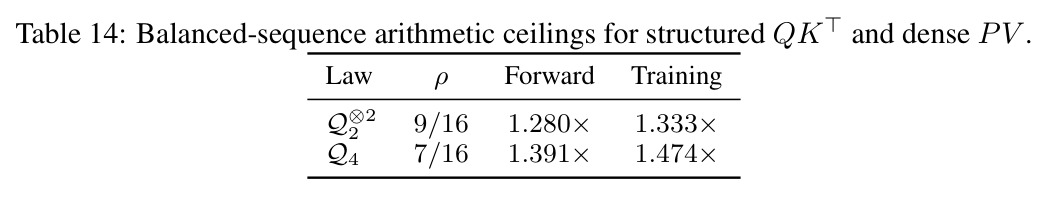
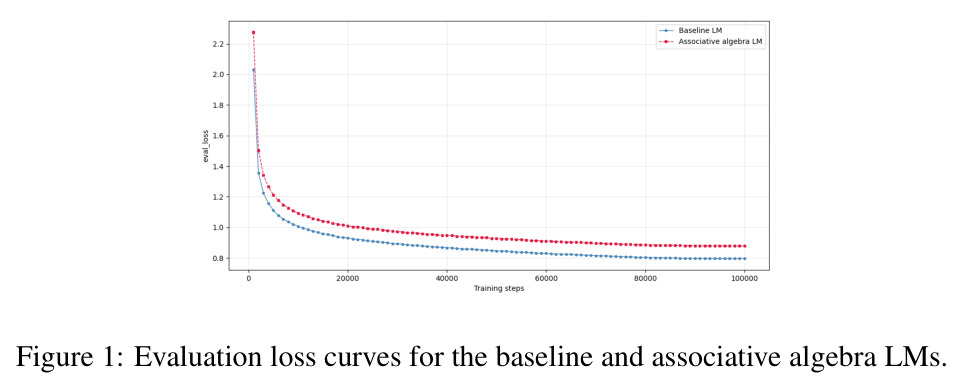
论文报告三组实验。第一,kernel 微基准(表1/表11/表12):H200 上 BF16 合成张量,对 Qwen3-1.7B/4B/8B、Qwen3-30B-A3B 专家、DeepSeek-V3 专家、Qwen3-32B 的 FFN 投影形状选每形状最优 $q^*$:Qwen3-8B($M{=}2048$,$q{=}32$)5.04×/4.52×(63.6µs vs 320.7µs,warm/flushed);Qwen3-32B 在 $M{=}32768$、$q{=}256$ 时达 11.51×/11.70×(1169.4µs vs 13458.6µs);窄专家形状收益小(Qwen3-30B-A3B 专家仅 1.57×/1.30×)。完整 SwiGLU(表9)在 $q{=}32$ 下加速 1.54×–4.12×;训练梯度核(表10)1.27×–2.56×,但 Qwen3-30B-A3B 专家反向变慢至 0.57×–0.65×。固定块平方乘积(表13)在 $n{=}32768$、$b{=}128$、$q{=}256$ 达 39.85×/38.85×,实测 log-log 斜率 2.01 验证平方标度。第二,预训练试点(表2/表3):两个 110,631,168 参数模型各训 12.3B token,唯一区别是 FFN 三投影换成 $Q_2^{\otimes 2}$(算术占比 9/16):生成吞吐四域全升 6.2–7.8%(Code +6.8%、Math +7.0%、QA +7.8%、WMT ru–en +6.2%,平均 1.070),但 GSM8K 3.18→2.20(−0.98)、IFEval loose 34.5→31.1(−3.4)、MBPP pass@1 6.60→3.80(−2.8)全面下降。第三,注意力扩展(附录 G)仅给公式与上限:结构化 $QK^\top$+稠密 PV 前向加速上限 1.280×($Q_2^{\otimes 2}$)、1.391×($Q_4$),实验未启用。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| FFN 投影 kernel(Qwen3-8B,M=2048,q=32) | kernel 延迟加速(warm / cache-flushed) | 5.04× / 4.52×(63.6µs vs 320.7µs) | 校准后的稠密 cuBLAS/cuBLASLt GEMM | 约 4.5–5 倍 |
| FFN 投影 kernel(Qwen3-32B,M=32768,q=256) | kernel 延迟加速(warm / flushed) | 11.51× / 11.70×(1169.4µs vs 13458.6µs) | 稠密 GEMM(13458.6µs) | 约 11.5 倍 |
| 固定块平方矩阵乘积(n=32768,b=128,q=256) | 延迟加速(warm / flushed) | 39.85× / 38.85×(2.868ms vs 114.265ms) | 稠密 GEMM;实测 log-log 斜率 2.01 | 约 39 倍,验证 $\Theta(n^2)$ 标度 |
| 端到端生成吞吐(110M LM,四域均值) | tokens/s 相对提升 | +6.2% ~ +7.8%(如 QA 958.6→1033.1 tok/s) | 同配方稠密 FFN 模型(958.6–991.4 tok/s) | 平均 +7.0%(吞吐比均值 1.070) |
| GSM8K(5-shot,EM flexible) | 精确匹配 % | 2.20 ± 0.40 | 稠密 3.18 ± 0.48 | −0.98 分(下降) |
| IFEval(instance-level loose) | 准确率 % | 31.1 | 稠密 34.5 | −3.4 分(下降) |
| MBPP(zero-shot pass@1) | 通过率 % | 3.80 ± 0.86 | 稠密 6.60 ± 1.11 | −2.8 分(下降) |
局限与改进
作者承认的限制:实验只测了一个递归 FFN 律($Q_2^{\otimes 2}$)、一个模型规模(约 110M)、每个模型仅训练一次(无多种子重复);更大的代数、代数注意力、更大模型均未测试。投影基准用合成张量,评估标准误只量化任务样本不确定性而非训练波动;吞吐增益(6.2–7.8%)远小于 FFN 算术缩减(省 43.75%),因为注意力、LM head、采样、分词与访存都在稀释;两模型生成长度不同(代码域平均 195.5 vs 182.4 token),需要定长重复计时才能隔离层效应;等参数存储允许不同函数类,结合律只保证复合封闭而非质量保持,因此结果不建立同质量优势。我自己的观察:110M/12.3B 模型绝对分数极低(GSM8K 3.18%、MBPP 6.6%),处于“基本不会做题”的区间,此 regime 下的质量差距未必外推到强模型;试点选了 36 次块乘的 $Q_2^{\otimes 2}$ 而非 28 次的 $Q_4$,二者非同构,论文未用实验论证这个选择;MoE dispatch/通信、kernel 融合均未纳入,性能上限未被充分释放。
独立分析的弱点
(1) 质量损失缺乏机理解释:论文只说“可训练性检查”,没有解释为何 MBPP 掉近一半(6.60→3.80)而 IFEval 只掉 3.4 分。改进方向:损失曲面与梯度方差分析、中间层表征探针、混合方案(关键层稠密、其余代数)、或代数预算递增的课程训练。(2) 行类型调度可能欠优:固定循环调度 $\tau(p)$ 把类型绑定到绝对位置,训练与解码虽一致但未必内容最优;可学习或内容自适应调度值得探索,但需重新证明因果性。(3) 收益稀释:FFN 算术省 43.75% 只换来 6.2–7.8% 端到端吞吐,因注意力与 LM head 未替换——附录 G 的代数注意力(分数归一化 $s=r/\sqrt{k_{ij}}$、cache 存完整 key)给出 1.28×–1.39× 的注意力上限,实测后可放大收益。(4) kernel 生态薄弱:$q$ 必须整除特征宽度、非对齐尺寸 padding 后实际算术可远超活跃计数(公式 24)、窄专家形状收益低且梯度核变慢(0.57×);方向是融合 kernel、专家形状定制 tile、FP8 支持。(5) 递归构造次优:$Q_2^{\otimes 2}$ 用 36 次块乘而 $Q_4$ 只需 28(多 28.6% 算术),其卖点是保留非同构的两步 radical 交互($J\otimes J\ne 0$),但论文没有消融证明这个交互增益值得额外算术。
未来方向
作者提出的方向:更大代数与更大模型的 scaling 研究、代数注意力的端到端实测、多训练种子重复、融合 kernel 开发、MoE 全链路(含 dispatch 与通信)测量。基于其成果可延伸:(1) 质量恢复配方——加大 token 预算、两阶段训练(先代数后稠密微调)或稠密教师蒸馏,检验质量差距是否可关闭到实用水平;(2) 自动搜索乘法表:以“结合律+单位元+可证秩上界”为约束,用程序合成或 RL(AlphaTensor 的反向用法)搜索针对特定模型形状的最优表;(3) 代数注意力实现:结构化 $QK^\top$ + 稠密 PV 已给出 1.280×/1.333×($Q_2^{\otimes 2}$)与 1.391×/1.474×($Q_4$)的算术上限,配合 $1/\sqrt{k_{ij}}$ 方差匹配归一化值得完整落地;(4) 理论问题:等参数、不同乘法表之间的函数类表达力差异,以及 $\rho_q\to 0$ 时质量如何随算术占比标度——类似 Chinchilla 的“代数标度律”;(5) 与推测解码、量化的协同:代数层释放的算术余量是否适合更大 batch、更低位宽部署。
复现评估
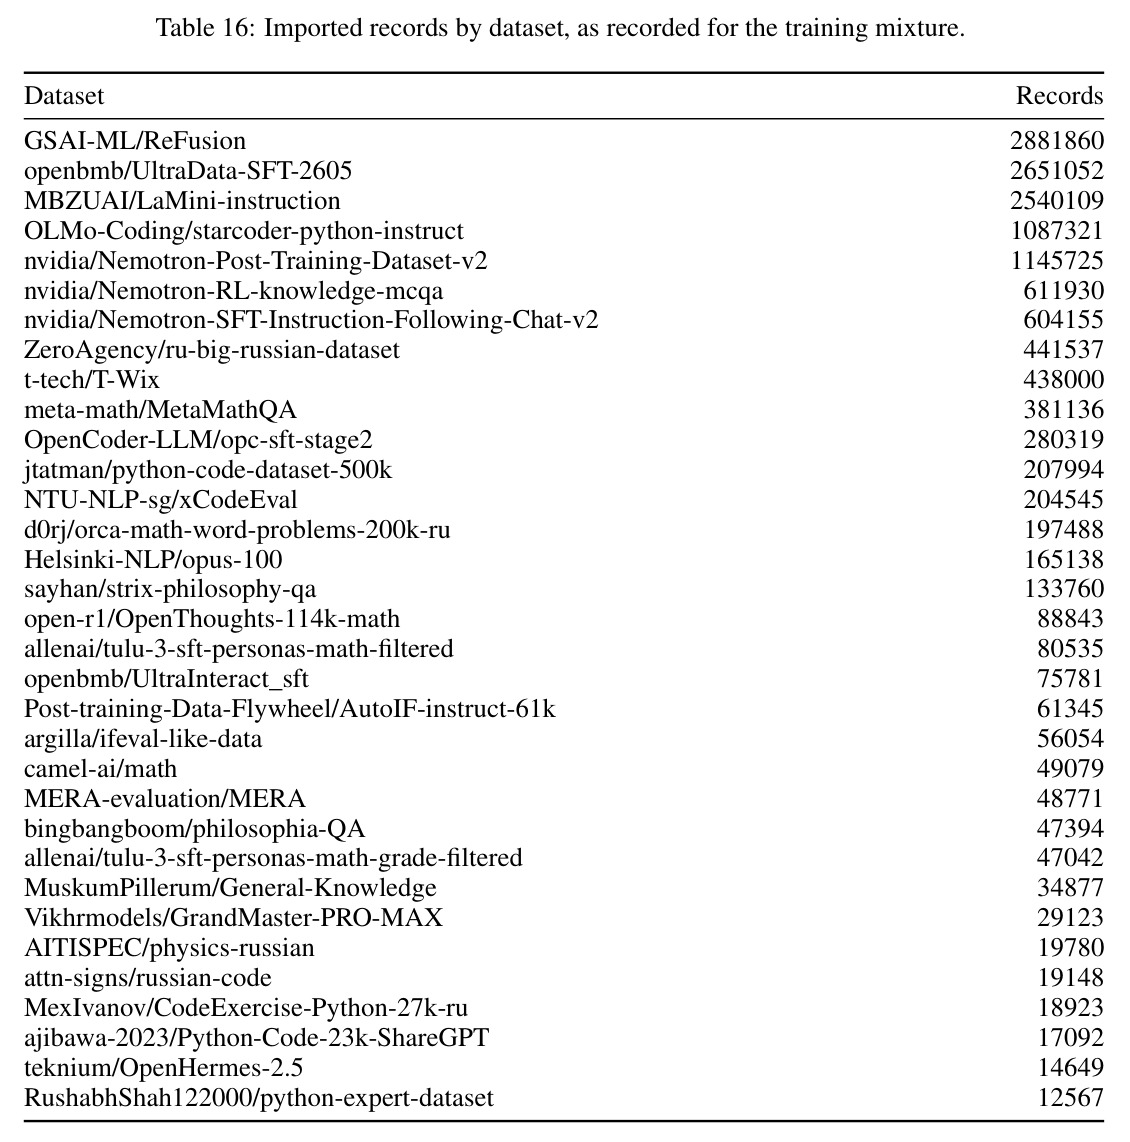
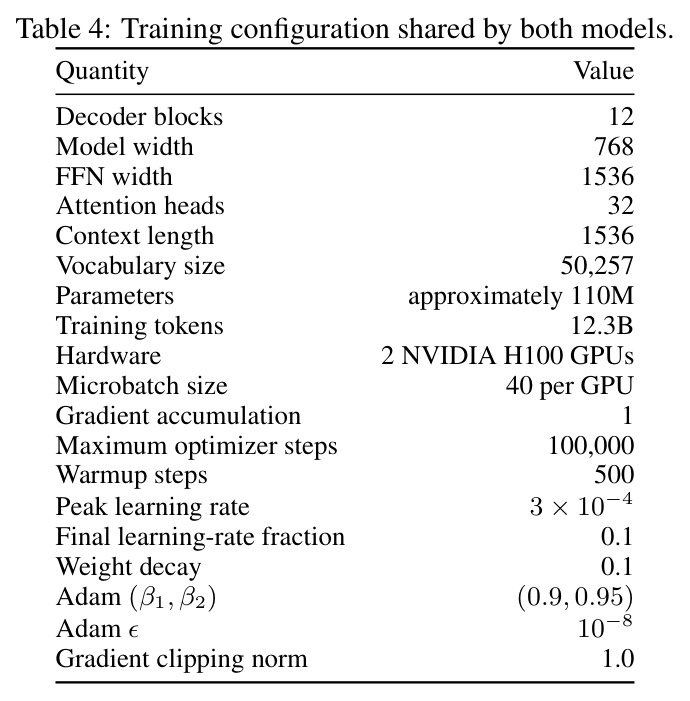
论文处于 under review 状态,未提及公开代码仓库,但复现信息异常详尽:完整训练配置(表4:12 块、$D{=}768$、$F{=}1536$ SwiGLU、32 头、上下文 1536、GPT-2 BPE 词表 50257、AdamW $\beta{=}(0.9,0.95)$、峰值学习率 $3\times10^{-4}$、500 warmup、cosine 衰减至 10%、权重衰减 0.1、梯度裁剪 1.0、100k 步、2×H100、每卡 batch 40);训练数据混合逐条列出 40+ 个 HuggingFace 数据集(表16)并描述去重与 MinHash+LSH 消污染流程(Jaccard 阈值 0.80);生成测量协议(4 域×100 prompts、temperature 0.8、top-p 0.95、top-k 50、4 跑去首跑、t 分布 95% CI)与 lm-eval-harness 0.4.9.1 设置齐备;kernel 协议(86 项 forward/backward 数值检查、最大相对 L2 误差 0.00208、12 次交替计时取中位数)也都有描述。算力门槛:预训练需 2×H100×100k 步(数 GPU-天量级),kernel 基准单卡 H200 即可。最大障碍是 Triton/CUDA 代数投影与解码 kernel 的自行实现,需要较强工程能力;若作者放出代码,整体复现是可行的。
论文图表