DEFINE:样本引导的零样本文本转语音口音控制 DEFINE: Exemplar-Guided Accent Control for Zero-Shot TTS
一条口音样本加单个权重 w,在冻结 F5-TTS 内解耦音色与口音
前置知识
零样本 TTS
零样本文本转语音指模型无需对目标说话人做任何微调,仅凭几秒参考音频即可克隆其音色并朗读任意文本。实现上通常把参考音频编码为条件向量,通过掩码填充(in-context infilling)或流匹配在 mel 频谱上生成语音,代表工作有 VALL-E、Voicebox、F5-TTS 等。
DEFINE 的全部实验都建立在零样本 TTS 框架上,论文要解决的核心问题正是这类模型把参考音频中的说话人身份与口音耦合在一起、无法分别指定。
条件流匹配(Flow Matching)
一种生成建模训练目标:把高斯噪声 $x_0$ 与数据 $x_1$ 线性插值得到 $x_t=(1-t)x_0+t x_1$,训练网络预测向量场 $(x_1-x_0)$,推理时沿学到的场从噪声积分到数据。相比扩散模型路径更直、所需迭代步数更少。
F5-TTS 即以条件流匹配训练;DEFINE 的口音向量直接注入其向量场 $v_\theta$,消融还证明流匹配梯度必须能更新口音通路,编码器才能学到有用的条件表示。
F5-TTS
基于 mel 频谱掩码填充与条件流匹配的非自回归零样本 TTS,参数量约 3.43 亿,能仅凭一段参考音频较高质量地克隆未见说话人,是当前流行的开源 TTS 骨干之一。
DEFINE 完全复用冻结的 F5-TTS 骨干,只新增 LoRA 与口音注入通路,理解本文前需熟悉它的输入输出约定与训练目标。
LoRA
低秩适配:冻结预训练权重 $W$,旁路训练低秩增量 $\Delta W = BA$(秩 $r$ 远小于矩阵维度),只更新极少量参数即可改变模型行为。本文用 rank-16,可训练参数仅 630 万,占骨干的 1.8%。
DEFINE 对 F5-TTS 的 query/value 投影、FFN 与 adaLN 调制加 LoRA,实现骨干冻结、口音行为可控的参数高效改造。
XLS-R
Meta 发布的大规模自监督跨语言语音预训练模型(wav2vec 2.0 架构),其隐藏层特征被证明携带丰富的说话人、口音与语言信息,常被冻结后作为各类语音任务的特征提取器。
冻结 XLS-R 第 15 层(由逐层口音探针选出)用作口音样本编码器的输入,评估用的 15 类口音探针也建在同一层特征上。
分类器自由引导(CFG)
扩散/流模型的推理技巧:同时计算条件预测与无条件预测 $v_u$,用外推 $\hat{v}=v_u+s(v_c-v_u)$ 放大条件影响,$s$ 为引导强度。本文把它推广为针对口音单因子的引导项。
DEFINE 的核心推理机制 $\hat{v}=v_\varnothing+s(v_\varnothing-v_u)+w(v_a-v_\varnothing)$ 正是 CFG 的双因子推广,权重 $w$ 就是口音强度旋钮。
梯度反转层(GRL)
对抗式解耦组件:前向传播为恒等映射,反向传播把梯度乘以 $-1$,使紧跟其后的分类器在训练自身的同时迫使上游主干特征丢失目标属性信息。
DEFINE 用带梯度反转的说话人分类器构成损失 $\mathcal{L}_{spk}$,抑制口音向量 $a_{enc}$ 携带说话人信息,是实现音色-口音解耦的关键手段。
研究动机
零样本 TTS(F5-TTS、VALL-E、Voicebox 等)已能凭几秒参考音频克隆未见说话人,但参考音频同时携带音色与口音,两者被隐式耦合:训练语料(如 Common Voice)中每个说话人通常只以一种口音出现,训练目标没有动力把它们表示成独立可控的因子,因此用户无法提出「用参考说话人的声音、但换成苏格兰口音」这类请求。已有两条路线都不理想。其一是在训练中引入显式口音条件,用口音标签或从带标注语音学习的嵌入(如 DART、多层 VAE 方法)做条件,个别方法能调强度,但依赖标注数据,且一般只能表达训练中出现过的口音,遇到新口音需要重新适配模型。其二是合成后再接口音/语音转换模型,例如 F5-TTS 生成后过 Seed-VC 的两模型级联:这条流水线多一次完整的波形变换,表 1 显示说话人相似度 SPK 从 stock F5-TTS 的 0.732 掉到级联的 0.600,音质 UTMOS 也从 3.99 降到 3.92;且两种方案都没有提供「音色与口音都由音频样本指定、口音强度训练后仍可调」的统一机制。
本文的目标是论文目标是构建端到端框架 DEFINE(Disentangled Exemplar Framework for Identity and Novel-accent Expression):说话人身份由常规参考音频 prompt 指定,目标口音由另外一至三条目标口音的短音频样本 exemplar 指定,二者完全独立;推理时不给任何口音标签,模型直接从样本推断口音,因此原则上可表达训练集之外的口音;训练结束后用单一标量引导权重 $w$ 连续调节口音强度而无需重训;同时在三种评估条件下(训练见过的 seen 口音、完全留出的 held-out 口音、任何训练数据中都不存在的 out-of-domain 口音)保持说话人相似度、可懂度与预测音质。量化目标是在 seen 口音上追平并超过 F5-TTS→Seed-VC 级联(最终 ACC 0.196 对 0.188、SPK 高 0.024),在 OOD 口音上与级联统计不可区分(0.087 对 0.083)。
与已有工作不同的是,本文的独特切入有三点。第一,流匹配目标对全局条件嵌入只提供间接的弱监督,作者不满足于让编码器自发生长,而是引入「原型锚定」:为 23 个训练口音各学一行归一化原型向量,组成可学习原型表 $P\in\mathbb{R}^{C\times d}$,用余弦对齐加对比项直接监督样本编码器,并用 stop-gradient 精确分工——原型负责学出解码器兼容的条件、编码器负责匹配原型,训练结束后原型表整体丢弃。第二,口音向量不走 cross-attention,而是以 RMS 归一化的加性偏移注入时间步与文本嵌入,借助 adaLN 触达每个 transformer 块,且 $a=0$ 时严格不扰动原嵌入,保证口音关闭分支与原模型行为一致。第三,把分类器自由引导推广为「因子级引导」,新增一项只放大口音条件的 $w(v_a-v_\varnothing)$,得到训练后连续可调的口音强度旋钮。据作者所知,这是第一个在单个零样本 TTS 模型内用纯音频样本同时独立指定音色与口音、且强度可调的工作。
核心方法
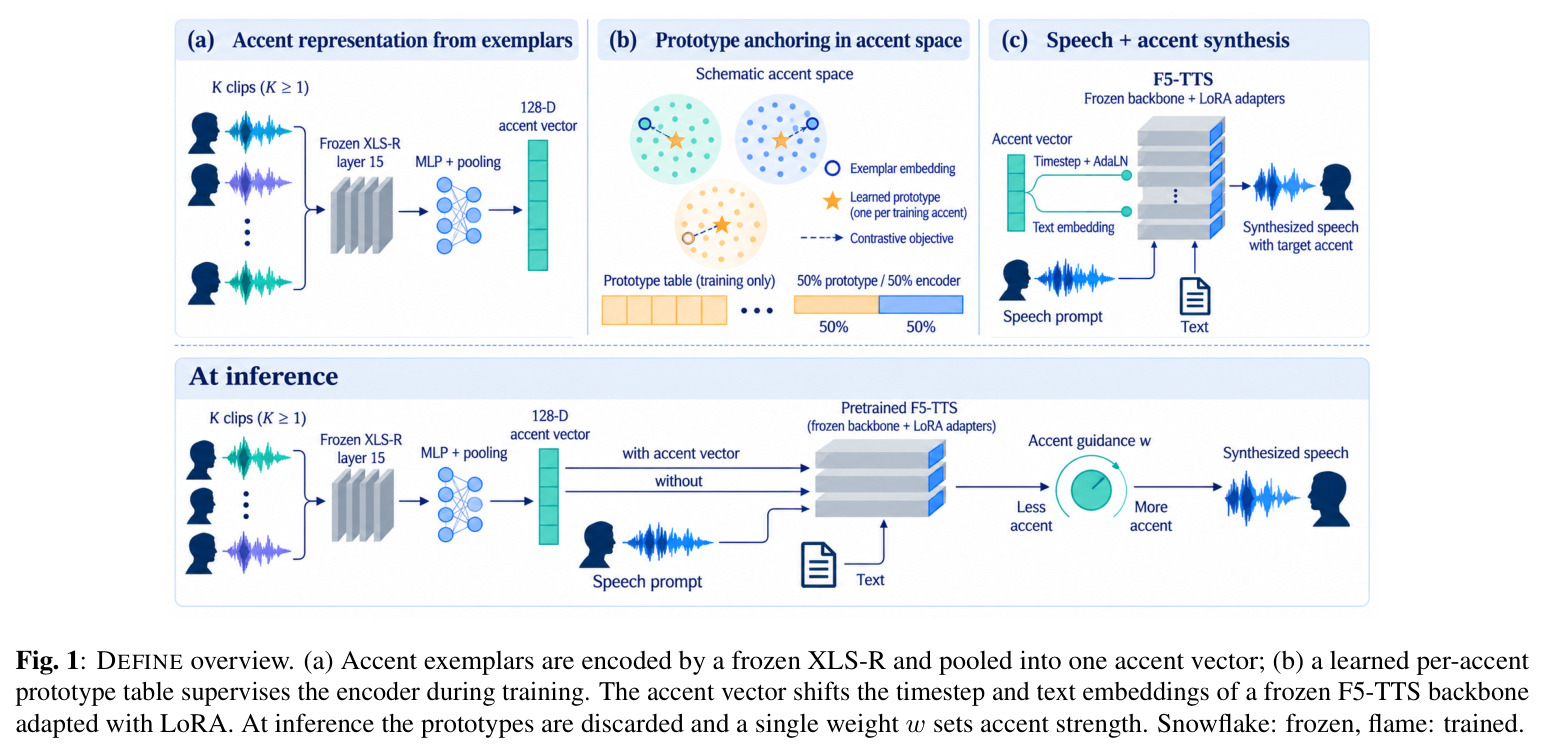
直觉上,DEFINE 让模型同时听两类音频:参考 prompt 说「模仿这个人」,口音样本说「但用这个口音讲」。技术上以冻结的 F5-TTS(3.43 亿参数、条件流匹配)为骨干,仅加 rank-16 LoRA(630 万可训练参数)。口音样本裁剪到语音段,经冻结 XLS-R 第 15 层输出帧特征 $h_k\in\mathbb{R}^{T_k\times1024}$,掩码均值池化后由 MLP $g_\phi$ 映射到 $d=128$ 维并 L2 归一化,多条样本平均得 $a_{enc}$;训练时 $C=23$ 行的原型表 $P$ 通过 $\mathcal{L}_{proto}$ 锚定编码器。口音向量 $a$ 以 RMS 归一化加性注入:$e_t\leftarrow e_t+\gamma_t\rho(e_t)\mathrm{LN}(W_t a)$、$e_y\leftarrow e_y+\gamma_y\rho(e_y)\mathrm{LN}(W_y a)$;由于 $e_t$ 控制 adaLN,口音条件影响每个 transformer 块,且 $a=0$ 时严格不扰动原嵌入。推理时丢弃原型表,仅用样本编码,每步求解器用 $\hat{v}=v_\varnothing+s(v_\varnothing-v_u)+w(v_a-v_\varnothing)$($s=2$)执行口音引导,$w=0$ 即回到无口音分支。
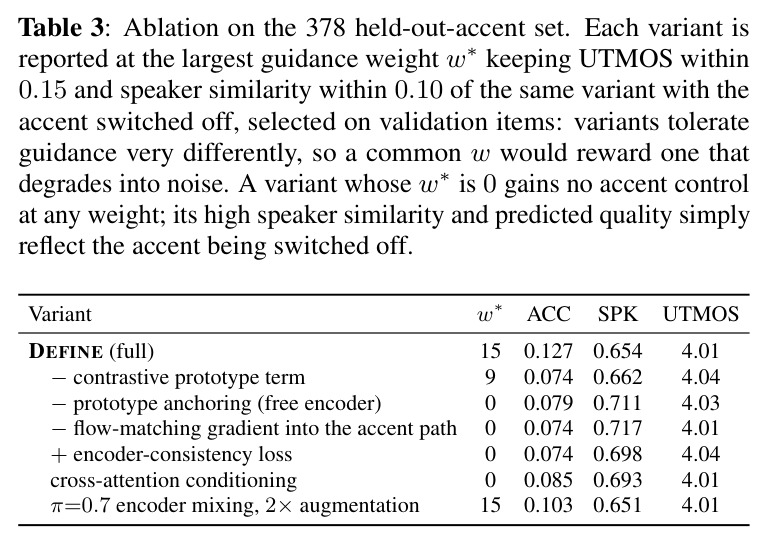
核心创新是「原型锚定 + 推理时口音引导」。作者发现仅用流匹配损失 $\mathcal{L}_{fm}$ 训练样本编码器只能得到极弱的间接全局监督:消融中去掉原型锚定后任何 $w$ 都无法改善口音($w^*=0$,ACC 仅 0.079)。为此引入原型表 $P\in\mathbb{R}^{C\times d}$($C=23$),每行归一化为 $p_c=P_c/\|P_c\|_2$,以损失 $\mathcal{L}_{proto}=1-a_{enc}^\top\mathrm{sg}[p_c]-\lambda_{ce}\log\frac{\exp(a_{enc}^\top p_c/\tau)}{\sum_j\exp(a_{enc}^\top p_j/\tau)}$($\tau=0.1$,sg 为 stop-gradient)把样本嵌入拉向稳定锚点。训练时以 $a=b\,\mathrm{sg}[a_{enc}]+(1-b)p_c$、$b\sim\mathrm{Bernoulli}(0.5)$ 随机混合样本路径与原型路径:$\mathcal{L}_{fm}$ 只更新原型表、不更新编码器,原型学出解码器兼容的条件,编码器专注匹配原型;推理时丢掉 $P$,模型可从任意未见口音的样本直接编码。与已有方法的本质区别:显式口音条件只能覆盖训练标签集;级联方案需两阶段波形变换且音色损失大(SPK 0.732→0.600);DEFINE 用样本与原型学出连续口音空间,并以 CFG 式外推项实现训练后强度调节。
方法步骤详情
第一步,数据构建:Common Voice 英语子集保留 15 个口音类(Australian、Irish、Filipino 留作 held-out,Welsh、West Indian 保留为域外),再加 13 个从不评估的类,原型表共 $C=23$ 行;用 Seed-VC 把 Common Voice 语音转成商业 TTS 合成的 studio 说话人音色,得 9.47 万条故意音色错配的 prompt–target 对,另加 13.7 万条真实录音。第二步,口音编码:样本裁剪到语音区,冻结 XLS-R 第 15 层提帧特征 $h_k$,掩码均值池化经 $g_\phi$ 得 $\bar{a}_k$,归一化后平均为 $a_{enc}$。第三步,条件注入:把 $a$ 以 RMS 缩放的加性偏移加到时间步嵌入 $e_t$ 与文本嵌入 $e_y$;训练时以 $p_{drop}=0.15$ 置 $a=0$,学出无口音分支。第四步,联合训练:$\mathcal{L}=\mathcal{L}_{fm}+\lambda_p\mathcal{L}_{proto}+\lambda_c\mathcal{L}_{con}+\lambda_s\mathcal{L}_{spk}$,其中 $\mathcal{L}_{con}$ 为有监督对比损失(同口音聚拢),$\mathcal{L}_{spk}$ 为梯度反转说话人分类器(阻止口音向量泄漏音色)。第五步,推理:在 $w\in\{0,7,9,11,15,19,23\}$ 上扫描选操作点,每步融合一次 CFG 调用与一次口音条件调用,共三次序列求值(F5-TTS 原生两次),无级联的额外波形变换。
技术新颖性
新颖性有三方面。其一,原型锚定是最有辨识度的设计:它承认流匹配目标对全局条件的监督天然稀薄,构造 $C=23$ 的可学习锚点,并用 Bernoulli 混合与 stop-gradient 把「学条件」与「学编码」拆开,这一分工使 held-out 口音 ACC 从 0.079 提升到 0.127($w^*=15$)。其二,注入位置的系统性对照:用 zero-initialised cross-attention 替代加性 adaLN 注入后,$w=23$ 时 ACC 虽达 0.175,但 UTMOS 崩到 1.52、SPK 0.22,生成不可懂却能骗过探针的音频,证明注入通路的选择对口音-质量平衡起决定作用;encoder-consistency 回环损失与切断流匹配梯度同样得到 $w^*=0$。其三,把 CFG 推广为因子级引导 $w(v_a-v_\varnothing)$:听测显示 $w=0$ 时口音票数远低于随机($p<10^{-7}$),说明可听到的口音完全来自引导项而非 LoRA 本身;SPK 随 $w$ 单调下降,构成平滑连续的权衡曲线。此外梯度反转去音色、监督对比聚拢同口音、RMS 缩放注入等均为已有技术的审慎组合,整体呈现「最小改动、逐项消融」的工程风格。
实验结果
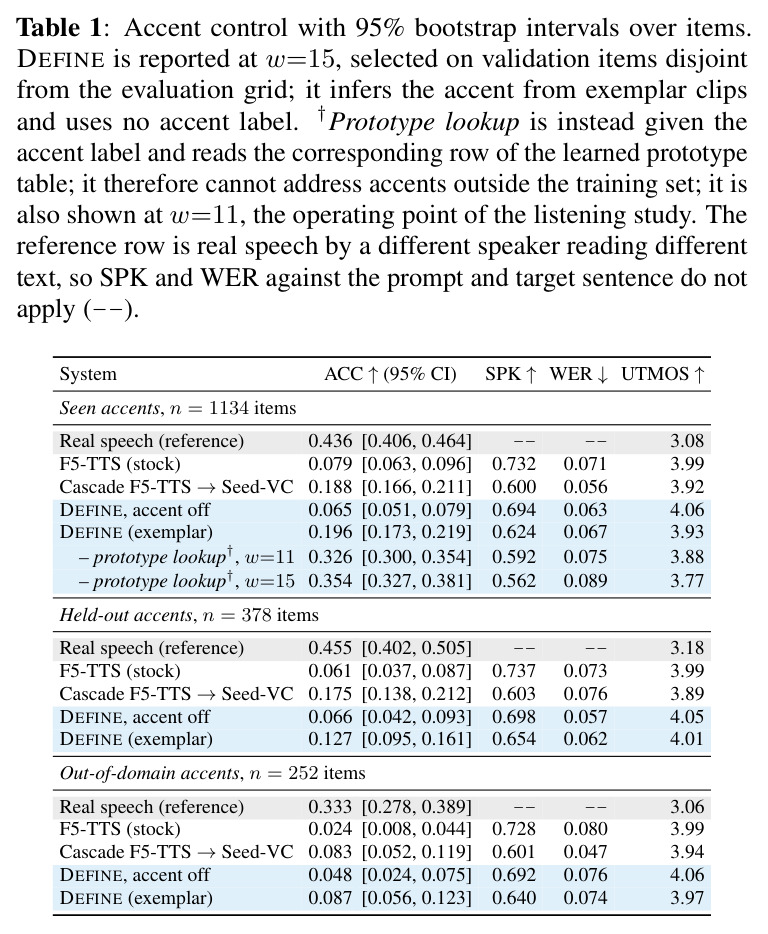
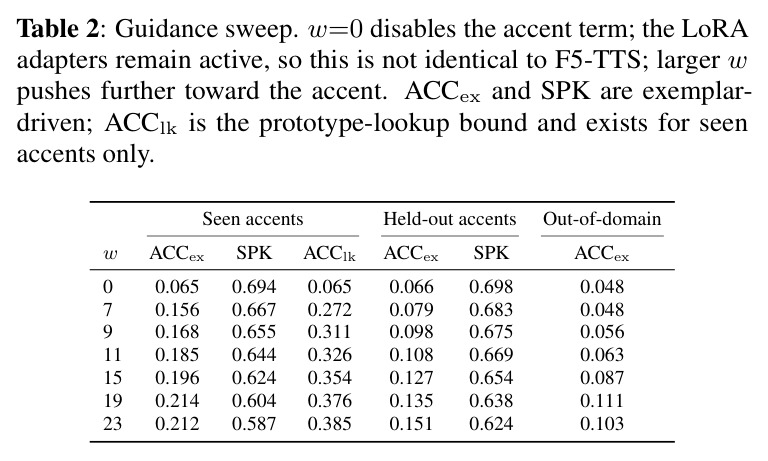
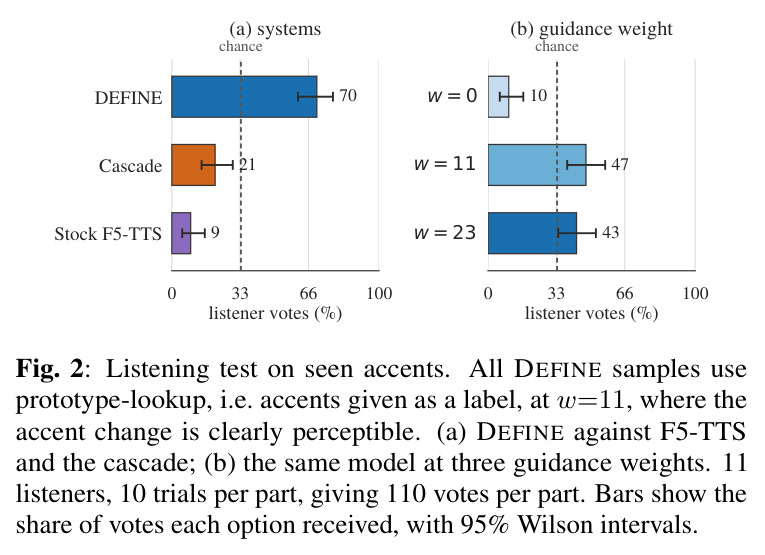
评估集共 1,764 条(seen 1,134 / held-out 378 / OOD 252),ACC 为 15 类探针准确率(chance 0.067),SPK 用 ECAPA-TDNN 余弦,WER 用 Whisper large-v3,UTMOS 评预测质量。(1)seen 口音:DEFINE(exemplar,$w=15$)ACC 从关闭时的 0.065 升至 0.196,追平 Seed-VC 级联的 0.188,SPK 0.624 高于级联 0.600,UTMOS 3.93 对 3.92 相当,WER 0.067 对 0.056。(2)held-out:DEFINE 0.127,低于级联 0.175,但比自身口音关闭的 0.066 提高 0.061。(3)OOD:DEFINE 0.087 对级联 0.083 统计不可区分,比口音关闭 +0.040(CI [+0.004,+0.079]),比 stock F5-TTS +0.064(CI [+0.032,+0.099])。(4)引导扫描:exemplar ACC 在 $w=19$ 达峰(seen 0.214、OOD 0.111),原型查询持续升至 $w=23$ 的 0.385,说明高引导下瓶颈是从样本推断口音的编码器;SPK 随 $w$ 从 0.694 单调降至 0.587。(5)消融:去原型锚定 $w^*=0$(0.079),去对比项 0.074,cross-attention、encoder-consistency、切断流匹配梯度均 $w^*=0$,全配置 0.127。(6)听测:11 人两轮各 110 票,系统对比中 DEFINE 得 0.70、级联 0.21、F5-TTS 0.09(9/11 人最常选 DEFINE,$p=0.0014$);$w=0$ 仅 11 票远低于随机($p<10^{-7}$),$w=11$ 得 52、$w=23$ 得 47,两者不可分($p=0.69$)。(7)瓶颈:最近原型准确率训练说话人 0.873、未见说话人 0.540(chance 0.043),编码器音色过拟合是主因。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Seen 口音控制(1,134 条评估项) | ACC(15 类口音探针准确率,chance 0.067) | 0.196(w=15) | F5-TTS→Seed-VC 级联 0.188;口音关闭 0.065;stock F5-TTS 0.079 | 追平级联(+0.008),比口音关闭 +0.131,且 SPK 高 0.024 |
| Held-out 口音控制(378 条) | ACC | 0.127 | 级联 0.175;口音关闭 0.066 | 仍低于级联 0.048,但比口音关闭 +0.061 |
| Out-of-domain 口音控制(252 条) | ACC | 0.087 | 级联 0.083;口音关闭 0.048;stock F5-TTS 0.024 | 与级联统计不可区分;比口音关闭 +0.040(CI [+0.004,+0.079]),比 stock F5-TTS +0.064 |
| 说话人相似度(seen 口音) | SPK(ECAPA-TDNN 余弦相似度) | 0.624 | 级联 0.600;stock F5-TTS 0.732 | 比级联高 0.024(级联因二次波形转换损失音色) |
| 主观偏好(seen 口音听测,11 人) | 三选一投票份额(110 票) | DEFINE 0.70(77/110 票) | 级联 0.21(23 票)、F5-TTS 0.09(10 票) | 9/11 名听众最常选 DEFINE(二项检验 p=0.0014) |
| 原型查询上界(seen 口音,需口音标签,非部署配置) | ACC | 0.354(w=15) | exemplar 路径 0.196 | 揭示编码器仍有约 0.158 的口音推断改进空间 |
局限与改进
作者承认的局限:held-out 口音上级联仍明显更强(0.175 对 0.127);exemplar 路径的 ACC 在 $w=19$ 后饱和(0.214)而原型查询能持续升到 0.385,说明从少量样本推断口音是瓶颈——编码器在未见说话人上的最近原型准确率从训练说话人的 0.873 跌至 0.540;SPK 随 $w$ 单调下降,需人工在音色保真与口音强度间选择操作点。作者还主动回应探针公平性:探针与编码器共享 XLS-R 特征提取器,但不用 XLS-R 推理的原型查询反而得分最高(0.354),完全不用 XLS-R 的级联也追平了 exemplar。我的补充观察:ACC 绝对水平仍低(0.196 对真实语音参考的 0.436),距「可信的口音迁移」尚远;UTMOS 3.93 略低于 stock F5-TTS 的 3.99,且 UTMOS 只是预测 MOS 而非人耳评测;训练依赖 Seed-VC 合成的 9.47 万条错配对,合成伪影可能污染口音表示;全部实验限于英语口音,跨语言场景未验证;听测仅 11 人、各 10 题,统计功效有限。
独立分析的弱点
独立分析的弱点与改进方向:(1)编码器音色泄漏是首要瓶颈,证据是原型查询与 exemplar 的差距(seen 0.354 对 0.196)以及未见说话人最近原型准确率骤降(0.873→0.540)。改进:加强对抗去音色(多判别器或频带级对抗)、用海量无标注多说话人口音语料先做自监督对比预训练、或在嵌入空间做说话人成分的正交投影与白化。(2)held-out 泛化有限:0.127 距真实语音的 0.455 甚远,对训练中从未出现的口音类别仍接近失效。可尝试训练时随机屏蔽部分原型行模拟 unseen、引入口音的连续地理或语言学先验(如按元音系统参数化口音嵌入)、或对原型做元学习。(3)强度调节缺乏自适应:SPK 随 $w$ 单调下降,用户需手选操作点。可引入逐句校准的引导(按能量或探针反馈自动调 $w$),或把目标强度作为条件输入模型。(4)评估自动化程度过高:探针 ACC 可能高估人耳感知且与编码器共享特征提取器,应补充大规模口音相似性主观 MOS 与分级强度听测。(5)数据管道复杂:依赖商业 TTS 合成 studio 说话人与 Seed-VC 批量转换,成本高且引入级联偏差,可改用真实多口音语料聚合或检索增强构造正样本对。
未来方向
作者在结论与讨论中指出的方向集中在改进样本编码器:原型查询上界 0.354 对 exemplar 的 0.196 说明编码器还有约 0.16 的提升空间,包括更强的预训练、更多样本与去音色手段;以及把原型查询路径做成可部署版本。基于本文成果可自然延伸的方向:(1)把标量 $w$ 升级为文本可控描述(如「轻微苏格兰口音」),实现语言级的强度与风格指定;(2)把原型锚定推广到口音之外的风格因子——语速、情感、嗓音年龄,构建多因子可分解的 TTS 条件体系;(3)口音空间插值与几何分析:在原型间线性插值研究生成口音的连续过渡,服务语言学与感知研究;(4)与语音翻译、影视配音结合,在保留原说话人音色的同时统一目标语言口音;(5)用 DEFINE 批量合成口音平衡语料,反哺 ASR 与口音鲁棒性研究;(6)探索少样本个性化:允许用户上传自己的几条录音作为新口音原型,实现零训练的个人口音定制。
复现评估
复现评估:代码已声明开源(GitHub: AMAAI-Lab/define)。骨干 F5-TTS、XLS-R、Seed-VC、ECAPA-TDNN、Whisper large-v3、UTMOS 全部为公开模型;评估集构造规则(1,134 seen / 378 held-out / 252 OOD、字对齐 prompt–target 切分、时长与转写置信度筛选)在正文有描述,但筛选脚本与确切条目清单是否随代码发布未知。数据方面:Common Voice 公开可得;studio 说话人录音由商业 TTS 合成、属 in-house 资源,外部研究者只能用替代 TTS 重建;9.47 万条 Seed-VC 错配对的转换管道需自行批量复现,这是最大的工程量。算力上骨干 3.43 亿参数全程冻结,仅训 630 万 LoRA 加编码器与原型表,单张 A100 级别即可训练;推理每步需三次序列求值,开销约为 F5-TTS 的 1.5 倍。难点在于正文未给出损失权重 $\lambda_p,\lambda_c,\lambda_s$、学习率、batch size 与训练时长等超参,需查阅仓库配置。总体属于中等难度复现,认真投入一至两周可逼近表 1 结果。
论文图表