超越双人对话记忆:面向多方口语对话的交互感知多模态记忆与自适应智能体检索 Beyond Dyadic Memory: Interaction-Aware Multimodal Memory with Adaptive Agentic Retrieval for Multi-Party Spoken Conversations
VoxPolyMem:交互感知多方口语记忆框架,配合证据增益EG-GRPO检索策略大幅超越基线
前置知识
GRPO(组相对策略优化)
GRPO 是一种无需价值网络的强化学习算法:对同一状态采样一组候选动作(本文 K=8),用组内奖励的均值 $\mu$ 与标准差 $\sigma$ 做归一化得到优势 $\hat{A}_i = (r_i - \mu)/(\sigma + \delta)$,再以 PPO 风格的裁剪目标和 KL 正则更新策略。它省去 critic、训练稳定,适合大模型的 token 级策略微调。
本文核心训练方法 EG-GRPO 就是 GRPO 的改进版,只有理解其组采样与组内优势归一化机制,才能明白逐轮奖励信号如何转化为检索策略的更新。
声纹嵌入与在线说话人识别
声纹嵌入把一段语音编码为固定维向量(本文用 ECAPA-TDNN),经 L2 归一化后向量内积即余弦相似度,同一人的不同话语向量距离更近。在线识别维护一个声纹库:新语音与库中所有向量比对,相似度 $s_i$ 超过阈值 $\tau_{match}$ 就归入既有说话人 id,否则新建 id,并可用指数滑动平均(EMA)平滑更新声纹。
多方口语记忆的前提是跨会话认出'同一个人'。论文的身份匹配、碎片 id 合并、口语查询提问者识别全部建立在声纹嵌入之上,这是理解第 4.1 节的基础。
迭代式智能体检索与 RRF 融合
Agentic retrieval 把检索建模为多步决策:智能体观察已有证据,改写查询、选择检索工具,逐轮收集信息后再回答。多路检索结果用倒数排名融合(RRF)合并——每条结果按其在各列表中排名的倒数 $1/(k+\text{rank})$ 累加得分,再去重后选入最终上下文。
本文将检索形式化为序列决策过程,状态包含已保留证据与剩余预算,检索智能体既是框架的三大组件之一,也是被 RL 训练的对象,不懂迭代检索就看不懂方法主线。
DCG 式排名折扣
折扣累积增益(DCG)是信息检索的经典指标:文档的贡献按其排名位置折扣,$\text{DCG}=\sum_e \frac{1}{\log_2(p(e)+1)}$,排名越靠前对总分贡献越大,常用理想排名归一化为 NDCG。它刻画'好结果不仅要找得到,还要排得靠前'。
EG-GRPO 奖励的第二项 $N_i=\sum_{e\in D_i} Z_q/\log_2(p_i(e)+1)$ 正是 DCG 思想——新支撑证据在上下文中排得越靠前奖励越高,理解 DCG 才能读懂论文公式 (6)。
研究动机
现有长期记忆研究几乎完全围绕双人(dyadic)文本或图文对话展开:Mem0 整理事实、A-Mem 链接上下文笔记、Zep 维护时序知识图谱,LoCoMo、LongMemEval、Mem-Gallery 等评测基准也以文本和图文为主。但在车载助手、会议系统、家庭助手等真实场景中,系统往往需要通过语音同时面对多个参与者,并跨会话记住他们的信息和互动。仅把音频存成 ASR 转写会丢失声学身份线索,无法把'声音'关联到跨会话的具体参与者;现有记忆方法也不显式存储说话人与受话人等交互角色,'谁对谁说了什么'无从追溯;检索上,证据可能分散在多个会话、多个记忆层、多种模态中,固定检索策略容易遗漏,而基于终端答案奖励训练的检索策略(如 Search-R1)无法区分每一轮检索各自贡献了多少新证据,信用分配粗粒度。
本文的目标是本文要构建一个面向多方口语对话的长期记忆系统,具体目标有四层:第一,无需预设说话人数量即可增量式识别跨会话重复出现的说话人,把声学身份稳定地链接起来;第二,显式保留'谁对谁说了什么'的有向交互结构,并在此基础上抽取自包含的事实记忆与参与者画像;第三,训练一个检索智能体,能根据已积累的证据自适应地改写查询、选择记忆层与检索工具,用尽可能少的轮次找齐支撑证据;第四,构建评测基准 VoxPolyBench,覆盖跨会话身份识别、记忆演化、个性化回答、检索推理与交互归因等任务,并在其与 Mem-Gallery、H2HMem-Multi 两个公开图文记忆基准上全面超越现有最强基线。
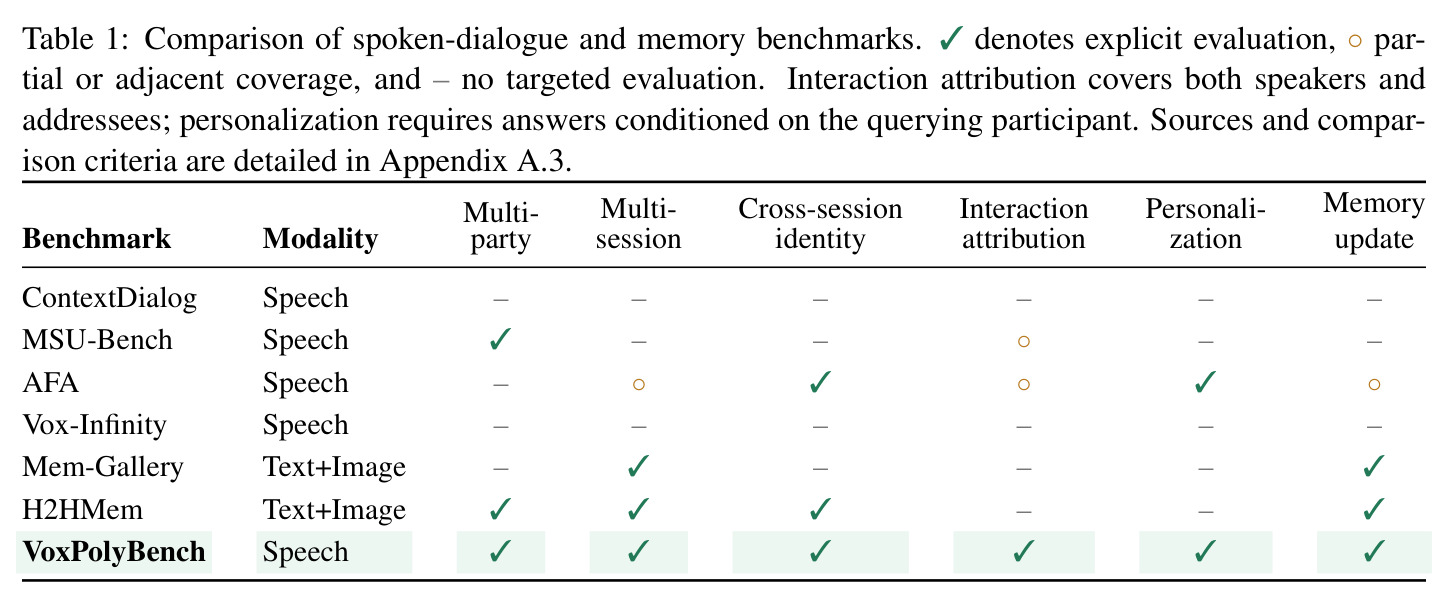
与已有工作不同的是,本文的独特切入是把'交互感知'提升为一等公民:不是先存转写再事后抽事实,而是先用在线声纹识别钉住'这是谁',再用有向交互图记录 speaks/addresses 边钉住'谁对谁说',事实与画像都锚定在交互结构上抽取并保留 refer id 回链。检索侧的差异化在于把逐轮证据增益作为奖励信号:EG-GRPO 只对本轮新保留进上下文的支撑证据计分,已保留证据不再得分,从而塑造'互补式检索'行为,这与 Search-R1 的终端答案奖励、Terminal-coverage GRPO 的轨迹级覆盖奖励形成鲜明对比。基准侧,VoxPolyBench 是首个同时评测声学身份恢复与参与者相关记忆的口语多方基准,填补了 Table 1 所示的评测空白。
核心方法
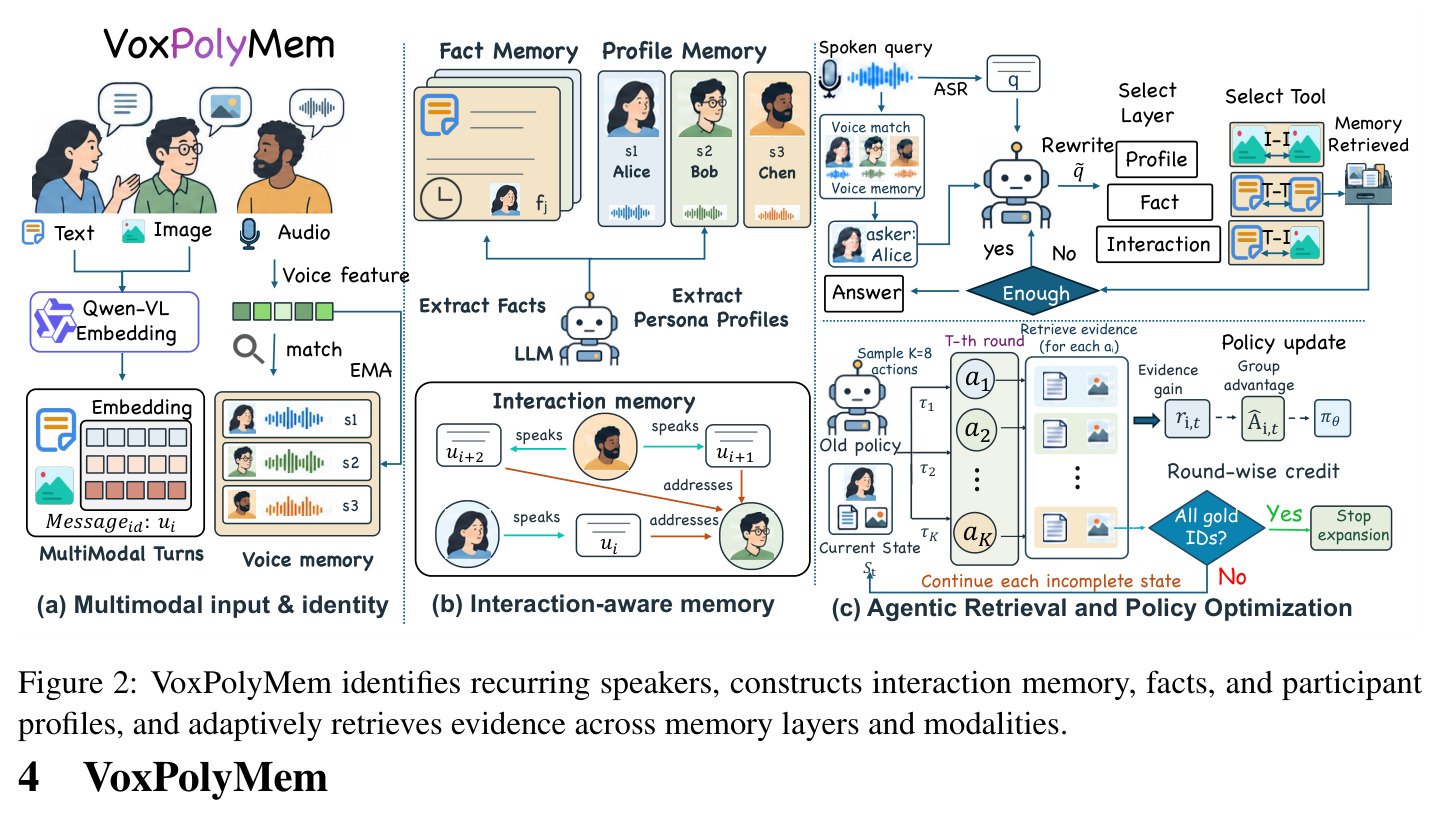
直觉上,多人语音对话的记忆要回答三件事:这是谁的声音、谁对谁说了什么、哪些事实属于谁。VoxPolyMem 分三步走。第一步在线说话人识别:每轮音频经 ECAPA-TDNN 编码为声纹 $e_i=\text{norm}(E_{spk}(x_i^{audio}))$,与声纹库做余弦相似度匹配,$s_i\ge\tau_{match}$ 归入现有匿名 id,否则新建;$s_i\ge\tau_{update}>\tau_{match}$ 时以 EMA 更新 $v_{k^*}\leftarrow\text{norm}((1-\alpha)v_{k^*}+\alpha e_i)$,会话末保守合并碎片 id。第二步分层记忆:交互记忆 $M_{int}$ 为有向图 $(P\cup U, E)$,边记录 speaks/addresses;LLM 结合当前轮与前三轮上下文,联合抽取事实记忆 $M_{fact}$(内容、说话人、受话人、时间)与画像 $M_{prof}$(名字、别名、声纹、偏好)。第三步可训练检索:查询(口语先声纹识别提问者)经策略 $\pi_\theta$ 在最多 3 轮内改写查询、选择记忆层与工具,RRF 融合去重后保留最多 k=15 条记录作答,答案模型为 GPT-4.1-mini。
核心创新有二。其一,交互感知的分层记忆:与 Mem0/Zep 只存扁平事实或时序图不同,VoxPolyMem 把说话人身份(声纹)、有向交互关系(speaks/addresses 边)与抽象记忆(事实、画像)绑成统一层级,检索时可按说话人/受话人过滤,是个性化与归因任务高分的直接来源。其二,EG-GRPO 的逐轮信用分配:已有方法用终端答案奖励(Search-R1)或轨迹级累积覆盖(Terminal-coverage GRPO),无法隔离单轮检索的贡献。EG-GRPO 在每个状态采样 K=8 个候选构成 GRPO 组,奖励 $r_i=\lambda|D_i|+(1-\lambda)N_i$,新证据集合 $D_i=(U_i\cap G_q)\setminus B$ 只计本轮新命中、此前未保留的 gold 支撑 id,排名折扣项 $N_i=\sum_{e\in D_i} Z_q/\log_2(p_i(e)+1)$ 按证据最早排名折算并以理想排名 $Z_q$ 归一化。训练采用树状展开:仅当候选找到新 gold 证据且预算未用尽时才扩展后继状态,优势只作用于生成的层/工具/查询/过滤 token,答案模型冻结。
方法步骤详情
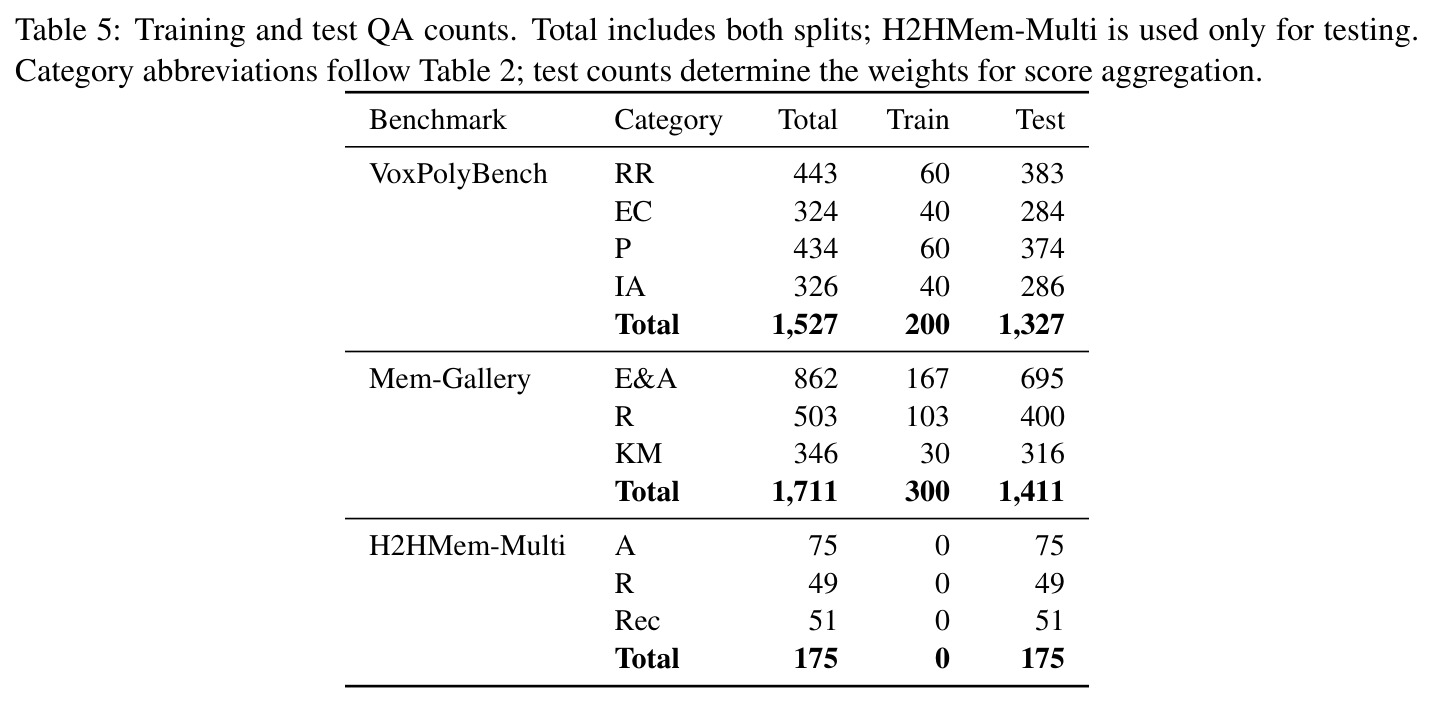
完整流程四步。(1)输入处理:每轮音频经 Whisper-turbo 转写与 ECAPA-TDNN 声纹编码,在线匹配或新建匿名说话人 id,EMA 置信门控更新声纹,会话末按累计声纹证据合并碎片 id,无需参与者名册。(2)记忆写入:LLM 读当前轮加最多三轮上文,把匿名 id 关联到人名/别名(identity mapping),抽取自包含事实写入 $M_{fact}$(图片相关事实保留图片 id),抽取背景与偏好写入 $M_{prof}$,同时推断受话人集合 $A_i$ 补全交互图边;每条事实与画像保留 refer id 指回源对话轮。(3)检索作答:状态 $s_t=(q,\text{asker}_q,C_{t-1},H_{t-1},b_t)$,动作 $a_t=(\ell_t,\rho_t,e_t^q,f_t)$ 选择记忆层(交互/事实/画像)、工具(向量、BM25、文搜图、图搜图)、改写查询与说话人/受话人过滤器;RRF 融合、去重、上下文选择更新证据 $C_t$;LLM 判断证据是否足够,最多 3 轮。(4)训练:用 Mem-Gallery 300、LoCoMo 400、VoxPolyBench 200 共约 900 条带支撑标注的 QA 定义 gold 集合 $G_q$,EG-GRPO 单轮训练 8B Qwen-VL 策略。
技术新颖性
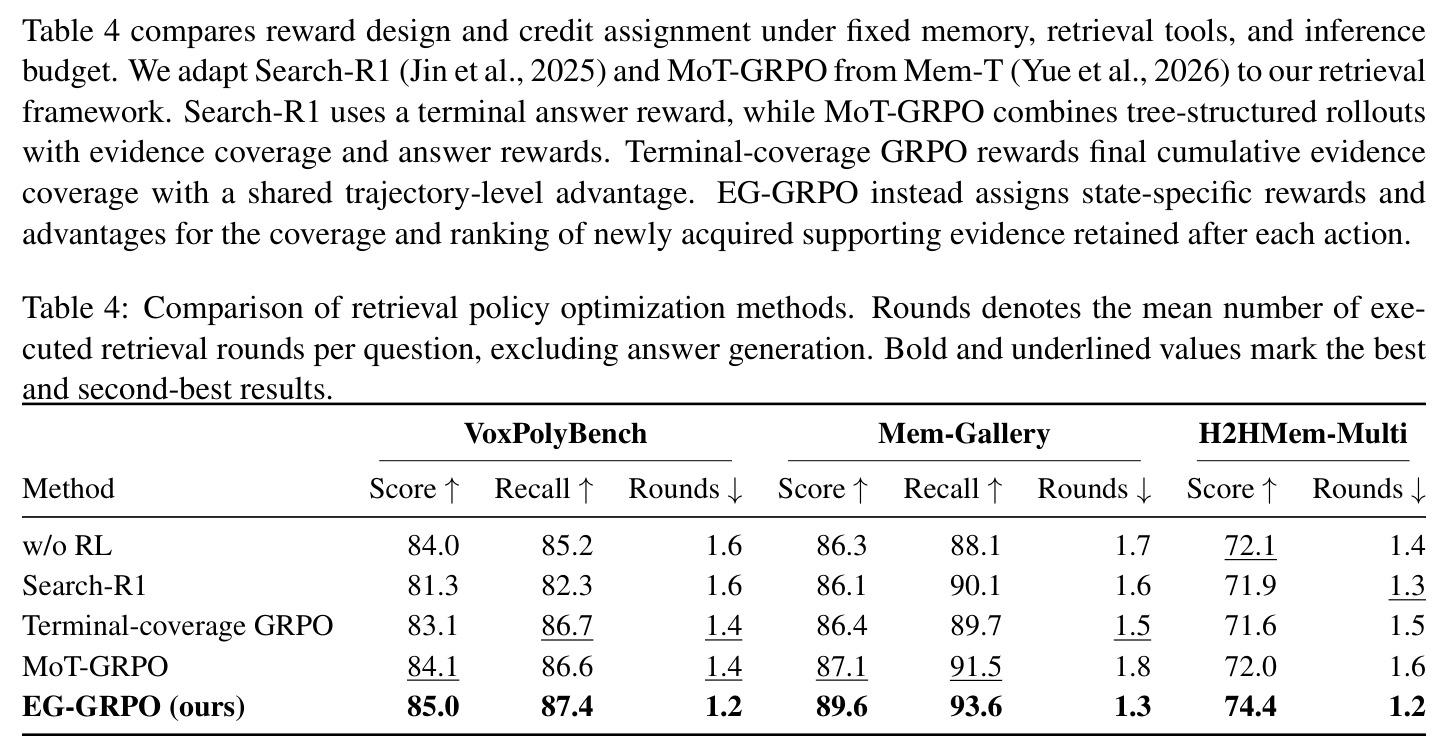
技术新颖性体现在三处。第一,框架层面:这是首个针对多方口语场景的交互感知记忆框架,把在线声纹身份、有向交互角色、事实抽象与参与者画像统一进一套层级结构,且说话人识别全程在线、无需预设人数——对比 AFA 只做基于声音的用户分离,VoxPolyMem 进一步保留了受话人维度。第二,算法层面:EG-GRPO 的逐轮证据增益奖励是新设计,Table 4 的对比极具说服力——Search-R1(81.3/86.1/71.9)在三个基准上全面低于无 RL 版本,Terminal-coverage GRPO 提升召回却不能转化为答案分,MoT-GRPO 次优,而 EG-GRPO 用更少检索轮数(1.2–1.3 对 1.4–1.8)同时拿到最高答案分与最高召回,说明'新证据增益'比'最终覆盖'或'答案正确'更能塑造健康的检索行为。第三,评测层面:VoxPolyBench 首次把跨会话说话人身份、说话人与受话人双重归因、记忆演化放进同一个口语基准。
实验结果
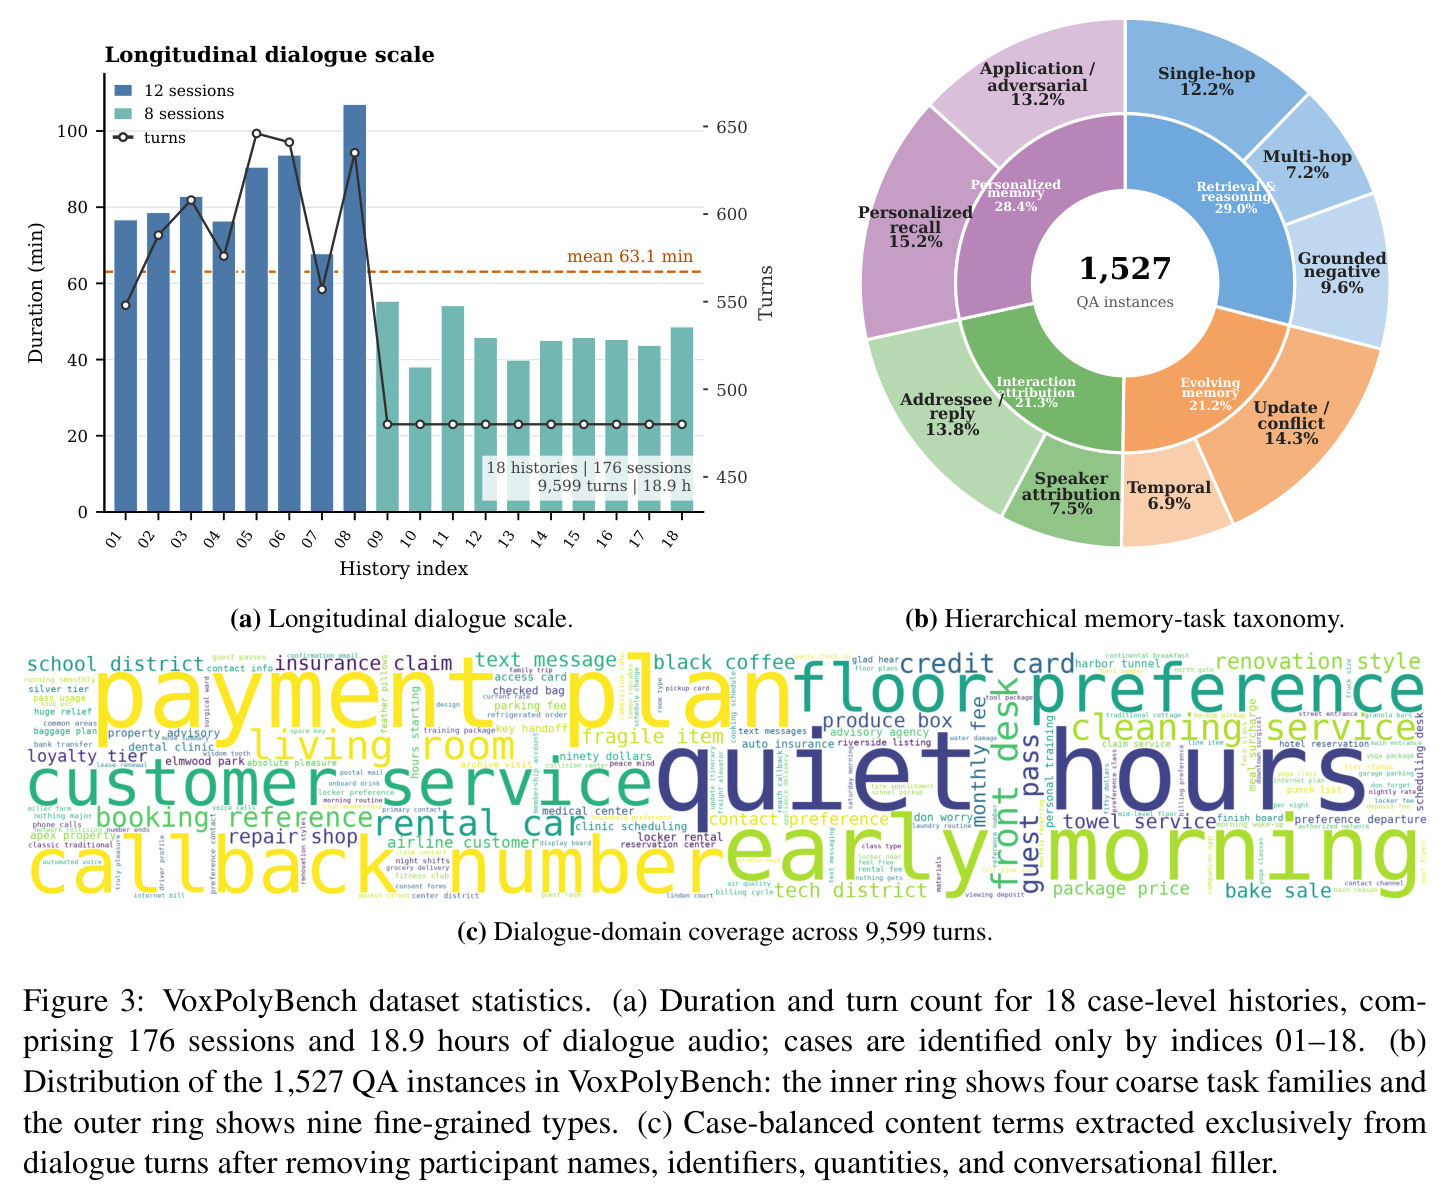
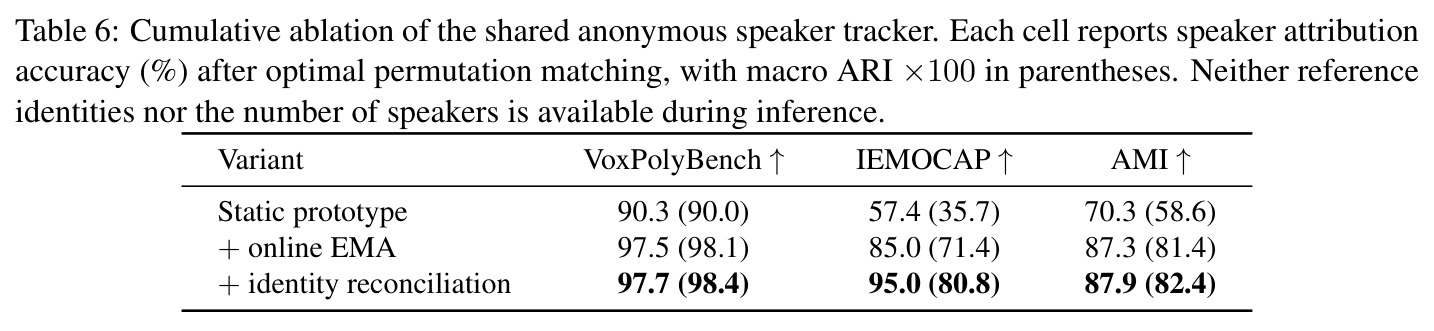
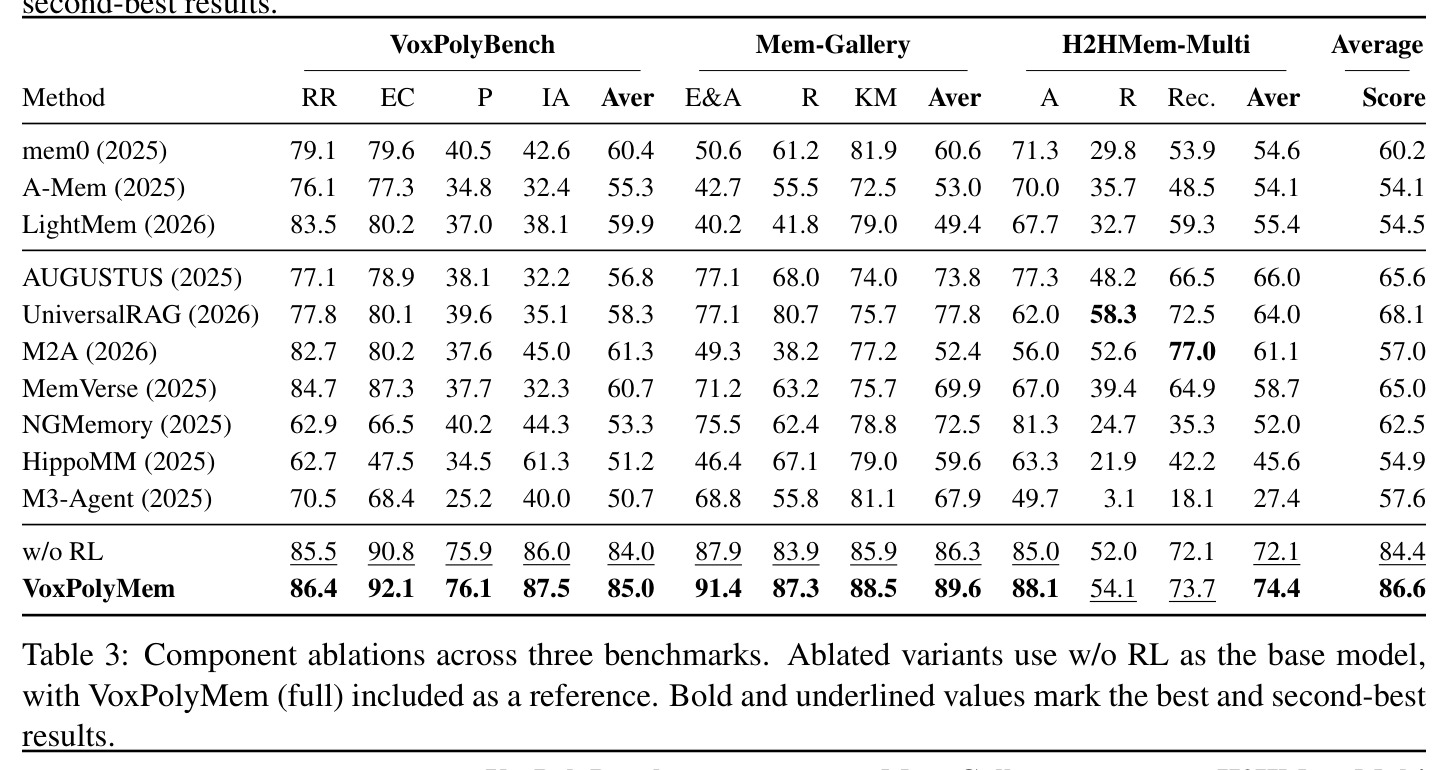
主实验(Table 2):VoxPolyBench 总分 85.0,超最强外部基线(UniversalRAG 58.3)23.6 分,四子集全部第一——检索推理 86.4、演化冲突 92.1、个性化 76.1、交互归因 87.5,后两项正是交互感知结构的直接受益者;Mem-Gallery 89.6(超基线 11.8)三个子集全领先;H2HMem-Multi 74.4(超 8.4);按测试题数加权平均 86.6 对基线 68.1。无 RL 版本加权已达 84.4,说明记忆结构与检索流程本身贡献最大。组件消融(Table 3,无 RL 为底座):去分层记忆 VoxPolyBench 84.0 降至 79.8、H2HMem 72.1 降至 63.6;去交互关系边 84.0 降至 78.6——抽象记忆助触达分散信息,交互结构助区分参与者证据;单轮检索跌至 76.1,去查询改写仅 83.2,迭代检索比改写更关键。策略优化对比(Table 4):EG-GRPO 三基准全面第一,轮数最少(1.2–1.3),召回 87.4 与 93.6 均最高。附加:说话人跟踪在 IEMOCAP 归因准确率 95.0%、AMI 87.9%(给定参考话语边界)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| VoxPolyBench 多方口语长期记忆(总体) | Score(GPT-4.1-mini 与 GPT-4.1 双裁判平均,×100) | 85.0 | 最强外部基线 UniversalRAG 58.3 | +23.6 |
| Mem-Gallery 图文长期记忆(总体) | Score | 89.6 | 最强外部基线 UniversalRAG 77.8 | +11.8 |
| H2HMem-Multi 多方图文记忆(总体) | Score | 74.4 | 最强外部基线 AUGUSTUS 66.5 | +8.4 |
| 三基准加权平均 | Score(按测试题数加权) | 86.6 | 最强外部基线 68.1 | +18.5 |
| 检索策略优化对比(VoxPolyBench) | Score / Recall / 平均检索轮数 | EG-GRPO:85.0 / 87.4 / 1.2 | Search-R1 81.3;Terminal-coverage GRPO 83.1;MoT-GRPO 84.1(轮数 1.4–1.6) | 分数最高且轮数最少 |
局限与改进
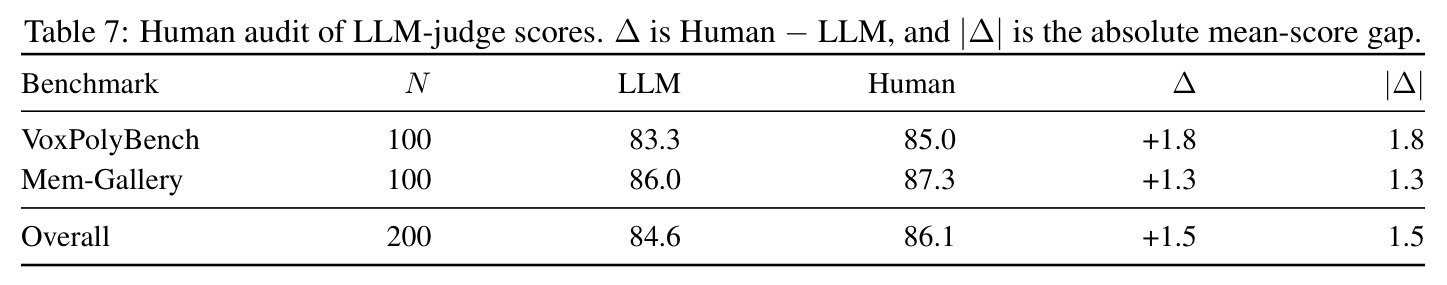
作者承认的局限:VoxPolyBench 的对话与语音全部为合成数据(GPT-4.1 生成对话、固定参考音色 TTS 合成,语料级 WER 2.14%),无法证明在真实说话人、口音与录音条件下的鲁棒性;声纹嵌入、身份链接与参与者画像包含敏感信息,可能被滥用于追踪或披露,真实部署需知情同意、访问限制与删除机制;依赖 GPT-4.1-mini 做记忆抽取、GPT-4.1-mini 与 GPT-4.1 双裁判评分,可复现性受 API 版本与采样波动影响。我自己的观察:奖励依赖 gold 支撑标注(推理时不可得),训练仅约 900 条且与评测基准存在同源风险,策略可能过拟合标注风格;个性化子集 76.1 明显低于其他子集,是相对短板;说话人归因指标是在给定参考话语边界的条件下测得的,真实场景中分句错误会级联影响声纹匹配与交互图构建;评测上下文预算固定 k=15,超长历史下的信息损失未被量化。
独立分析的弱点
独立分析的弱点:第一,sim-to-real 差距——合成语音干净且音色固定,电话噪声、远场录音、多人重叠说话会同时打击 ASR 与声纹匹配两个入口,进而污染交互图,改进方向是在 AMI/ICSI 等真实会议语料上做端到端评估,并引入说话人分离(diarization)联合建模而非假设话语边界已知。第二,交互图边质量完全依赖 LLM 从文本推断受话人,没有显式验证手段,错误边会误导后续按参与者的过滤检索,可引入视线、语音朝向等多模态线索或跨会话一致性校验。第三,奖励需要支撑轮标注,限制了向无标注域扩展,且训练集仅约 900 条,可探索用答案不确定性下降或 LLM 裁判的增益作为代理奖励。第四,上下文预算固定 k=15、轮数上限固定 3,长历史场景下的容量瓶颈与预算的动态分配(何时值得继续检索)未被学习。第五,个性化子集 76.1 相对演化冲突子集 92.1 差距明显,训练数据中个性化类样本占比与难度可能不足,值得针对性增补。
未来方向
作者提出的方向:把评测扩展到声学与对话多样性更高的真实世界口语交互。基于其成果可进一步延伸:第一,将在线说话人识别与 EG-GRPO 联合训练,让身份不确定性(匹配分数、碎片 id)直接进入检索决策状态,而非仅做硬性阈值判别。第二,把有向交互图推广为时序演化的社交图,建模关系变化与群体动力学,以支持'两人关系如何变化'这类更深层的推理问题。第三,探索端侧部署:增量 EMA 声纹更新与分层记忆天然适合边缘计算,配合本地小模型可实现隐私友好的持久助手。第四,奖励去标注化:用自监督的证据一致性或答案增益替代 gold 支撑集,使方法能迁移到无标注的企业会议、客服记录等场景。第五,扩展到视频与具身模态(口型、视线、空间位置),进一步丰富交互归因信号。第六,学习式停止策略替代固定 3 轮上限,在困难问题上允许更深的多跳检索。
复现评估
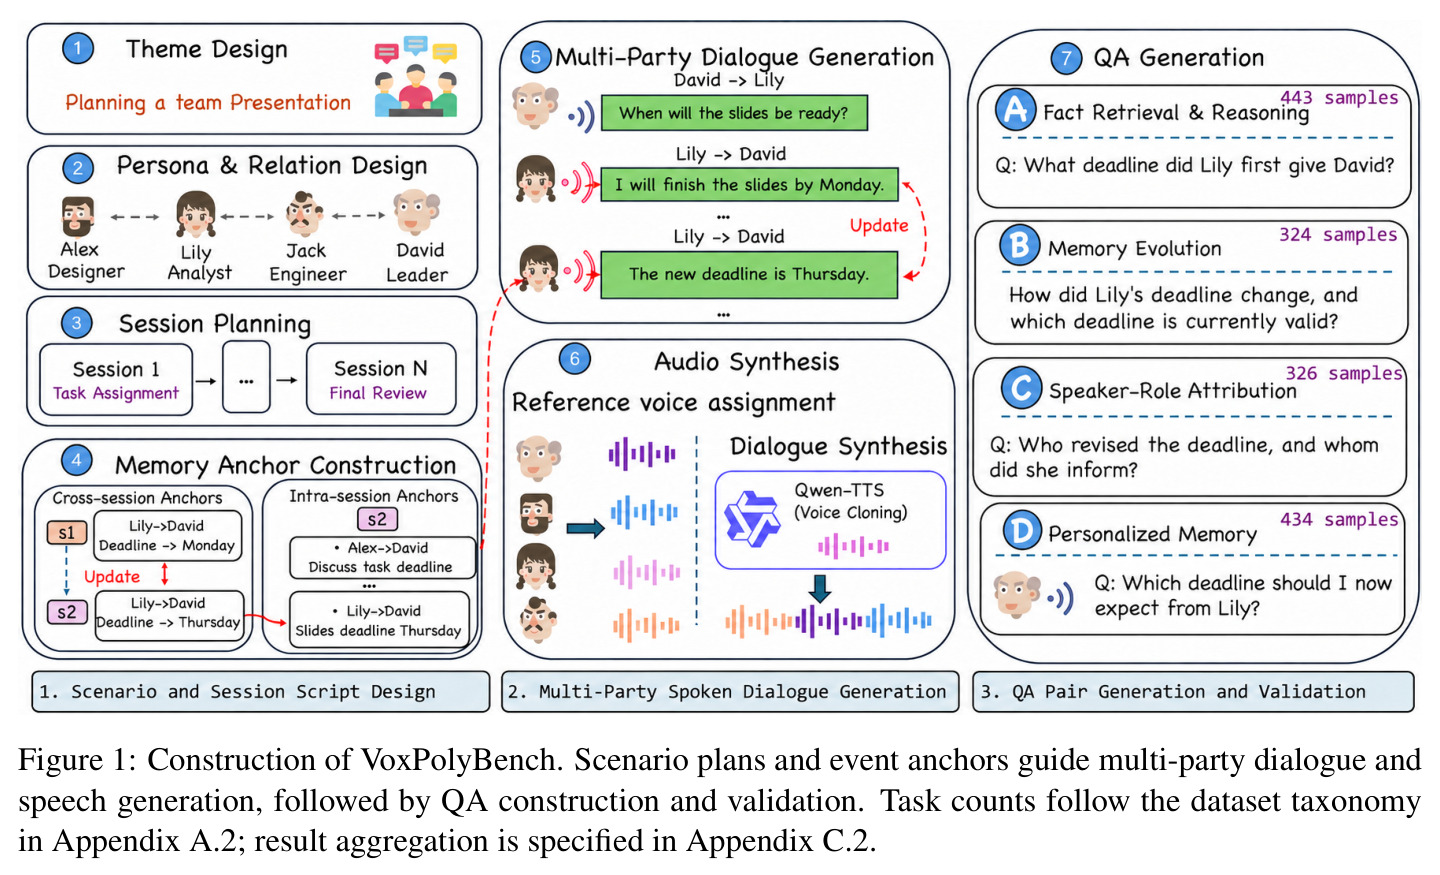
复现条件评估:代码与数据集已在项目主页公开(voxpolymem.github.io/VoxPolyBench/demo),附录 A–D 提供了数据质量控制、实现细节、评测协议与人工审计,描述相当充分。有利因素:VoxPolyBench 的构造流程(事件锚点规划、GPT-4.1 对话生成、固定音色 TTS、Whisper 校验)逐步可复刻,Whisper large-v3-turbo 语料级 WER 2.14% 提供了质量锚点;公开基准 Mem-Gallery、H2HMem-Multi 需另行获取。风险因素:记忆抽取用 GPT-4.1-mini、评分用 GPT-4.1-mini 加 GPT-4.1 双裁判,API 版本漂移与采样波动会影响分数可比性;RL 训练为 8B Qwen-VL 上的 GRPO(K=8 树状展开),显存与算力需求较高,估计需要多卡 A100 级别才能舒适完成,但仅训练一个 epoch、约 900 条数据,训练时长可控。综合判断:评测复现难度中等,普通实验室 1–2 周可搭建;完整复现含 RL 训练需要一定算力投入。
论文图表