更少 Token、更多自我教学:面向极端视觉 Token 压缩的在线策略自蒸馏 Fewer Tokens, More Self-Teaching: On-Policy Self-Distillation for Extreme Visual Token Reduction
冻结的全Token自身副本当教师,在学生自采样轨迹上做分布蒸馏,5%视觉Token保留82.3%性能
前置知识
视觉 token 与 token 削减
多模态大模型把图像经 ViT 编码器切成 patch 并映射为与文本同构的视觉 token(一张图通常数百到上千个),与文本 token 拼接后进入语言模型。视觉 token 占输入序列大头,prefill 计算量和 KV cache 主要由它们决定。token 削减(剪枝)按注意力分数(FastV)、多样性(DivPrune)、条件行列式点过程(CDPruner)等准则保留一部分视觉 token,通常无需训练、即插即用。
本文的场景是只保留 5% 视觉 token 的极端削减,理解视觉 token 从哪来、占多少开销、怎么被选择,是理解问题设定和方法输入输出的前提。
在线策略蒸馏
学生模型先按当前策略自采样生成完整回答,教师在学生生成的每一步前缀上给出 next-token 分布作为监督信号(用 KL 或 JSD 散度对齐),而不是在数据集固定答案前缀上训练。这样监督恰好落在推理时学生真正会经历的状态分布上,缓解离线蒸馏的训练-推理偏移,代表工作有 Agarwal 等(2024)与 OPSD。
LT-OPD 的名字与方法主体就是把 OPD 迁移到极端视觉压缩场景,理解『状态来自谁、监督来自谁』是读懂公式 (2)–(7) 以及与 fixed-prefix 方法区别的关键。
Jensen-Shannon 散度(JSD)
衡量两个分布差异的对称有界度量:取两分布的混合 $m=\frac{1}{2}(p^T+p^S)$,JSD 为各自与 $m$ 的 KL 散度之平均 $\ell=\frac{1}{2}D_{KL}(p^T\|m)+\frac{1}{2}D_{KL}(p^S\|m)$。与 forward KL(均值追逐、易过平滑)和 reverse KL(模式寻找、易塌缩)不同,JSD 行为居中、对两侧梯度都温和,训练更稳定。
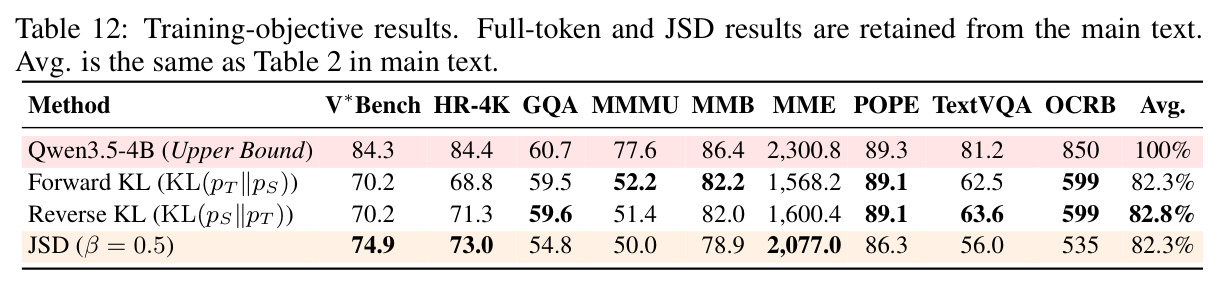
JSD 是 LT-OPD 的默认蒸馏损失(式 5–6),附录 G 还对比了 forward/reverse KL 与 JSD 在不同基准上的差异,不懂三种散度的行为差异就看不懂该消融。
曝露偏差与训练-推理失配
自回归模型训练时消费 ground-truth 前缀、推理时消费自己生成的 token;若模型在某些状态下偏离训练分布,错误会随解码逐步累积。对压缩模型该问题被放大:视觉证据骤减使其预测分布明显偏离全 token 模型,在静态前缀上训练无法覆盖这些由自身输出诱导的状态。
这是作者论证 fixed-prefix 训练在 5% 预算下失效、必须转向 on-policy 的核心机理,也是 Figure 1 中间『答错书名』示例的理论解释。
课程学习
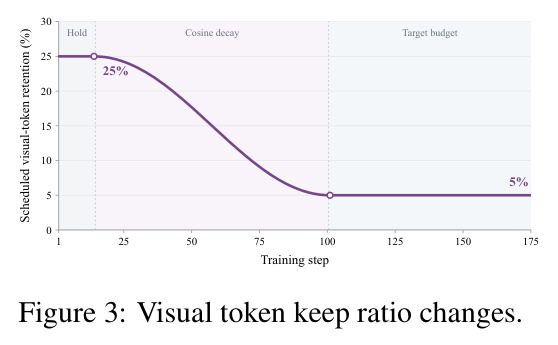
由易到难安排训练任务的策略(Bengio 等,2009)。经典做法按数据难度或样本长度排课程,本文的创新是把『视觉 token 预算』本身作为难度维度:先在 25% 保留率下让学生建立有效的 on-policy 轨迹,再按余弦计划在 14–100 步间平滑降到 5%,最后 75 步在目标预算上固定适配。
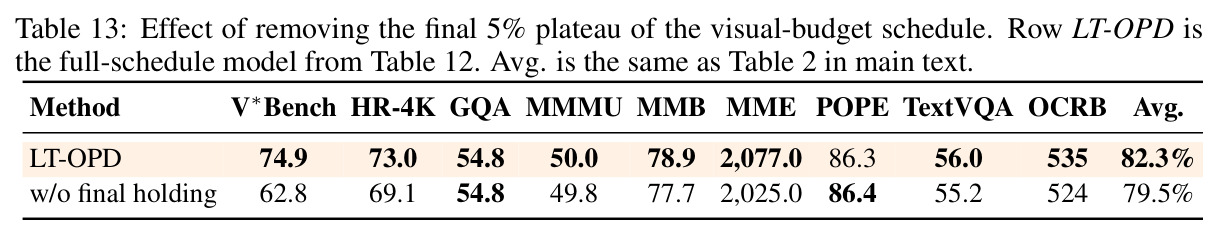
预算级课程是 LT-OPD 的第二个组件(式 8、Figure 3),消融显示它使 SFT 提升 2.7 个百分点、去掉最后 5% 平台期会从 82.3% 掉到 79.5%,不看懂课程就看不懂训练稳定性从哪来。
KV cache 与 prefill FLOPs
语言模型推理分两阶段:prefill 对全部输入(含视觉 token)并行计算,生成每个 token 时读写 KV cache。视觉 token 数直接决定 prefill FLOPs 与 KV cache 大小,剪掉 95% 视觉 token 理论上可省约 95% 的这两项开销;但解码阶段每步耗时由模型权重访存主导,token 削减对其帮助有限。
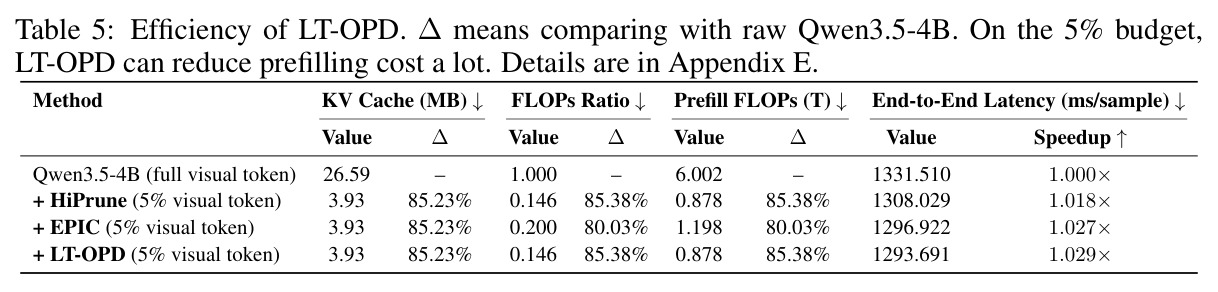
效率是论文动机的一半,Table 5 报告 KV cache 降 85.2%、prefill FLOPs 降 85.4% 而端到端延迟仅 1.029×,需要上述背景才能理解为什么『省很多计算却只快一点点』。
研究动机
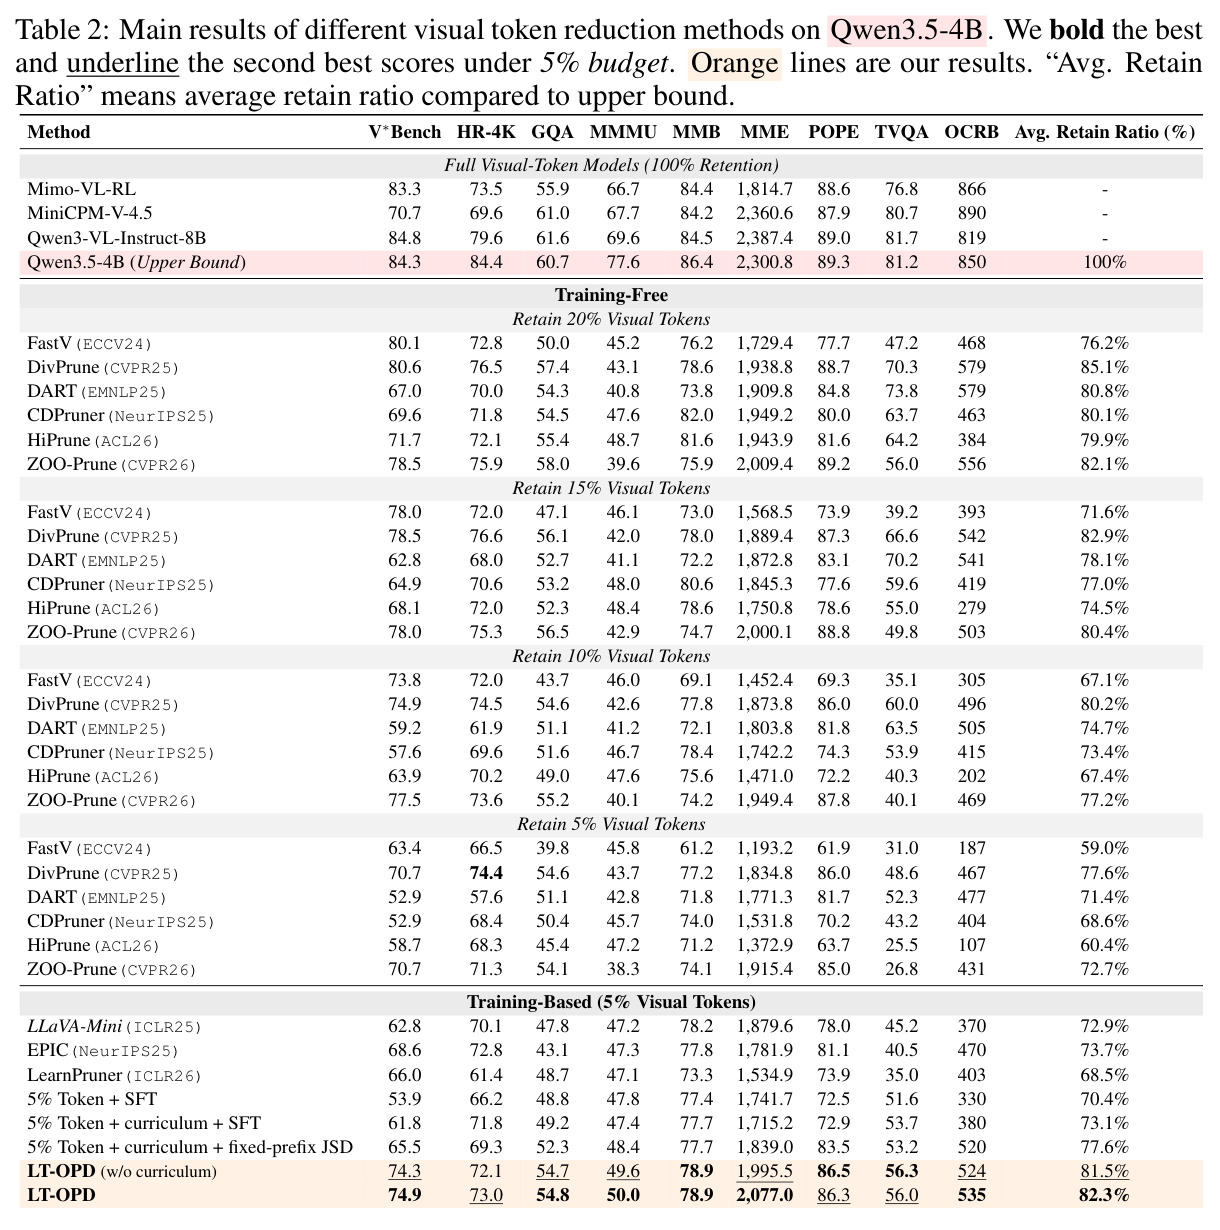
视觉 token 是多模态大模型推理开销的主要来源:一张高分辨率图像经视觉编码器和 merger 后产生数百甚至上千个视觉 token,prefill 计算量与 KV cache 占用主要由它们决定。现有缓解手段分两类:training-free 的 token 选择(FastV、DivPrune、DART、CDPruner、HiPrune、ZOO-Prune 等)和 training-based 的适配训练(MQT-LLaVA、LLaVA-Mini、EPIC、LearnPruner)。两者在 20% 预算下尚可,但资源受限场景必须压到 5% 这种极端预算时集体失效:Table 2 显示,Qwen3.5-4B 保留 5% 视觉 token 时,FastV 平均保留率跌到 59.0%、HiPrune 60.4%、CDPruner 仅 68.6%,最强的 training-free 方法 DivPrune 也只有 77.6%;训练方法中 LLaVA-Mini 72.9%、EPIC 73.7%、直接 SFT 只有 70.4%。作者进一步指出更深层的机理问题:极端压缩不仅删掉视觉证据,还改变了压缩模型推理时实际经历的生成状态——此时学生的预测分布显著偏离全 token 模型(Figure 1 中间:同一书封识别问题,fixed-prefix 训练的压缩模型答成 Deathly Hallows,on-policy 训练则答对)。在固定响应前缀上训练,无法覆盖这些由模型自身输出诱导的状态,误差在自回归解码中逐步累积。
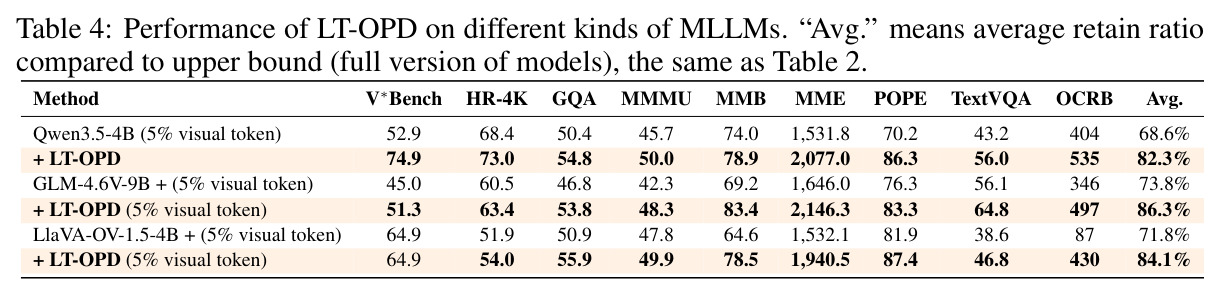
本文的目标是本文目标是在仅保留 5% 视觉 token 的极端预算下,通过专门的训练方法让压缩后的 MLLM 尽可能恢复全 token 模型的能力,且不引入任何额外推理开销。具体量化目标:在 Qwen3.5-4B 上把九个基准(V*Bench、HR-Bench 4K、GQA、MMMU、MMBench、MME、POPE、TextVQA、OCRBench)的平均性能保留率(相对全 token 上限)从未训练压缩版的 68.6% 提升到 80% 以上,全面超过同预算下的 training-free(DivPrune 77.6%)、training-based(EPIC 73.7%)和强化学习(DAPO 78.2%)基线;同时完整保住 5% 压缩的效率收益——KV cache 减少 85.2%、prefill FLOPs 减少 85.4%。方法还需具备通用性:跨模型规模(4B/9B)、跨家族(Qwen3.5、GLM-4.6V、LLaVA-OV-1.5)都要一致有效。
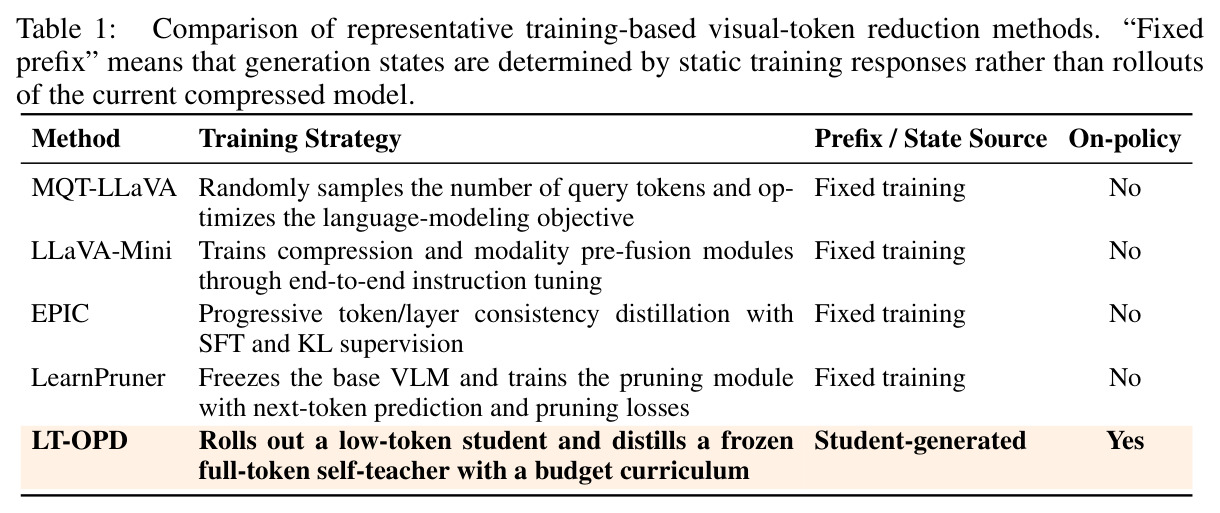
与已有工作不同的是,本文的独特切入是一次视角转换:从『该保留哪些视觉 token』转向『压缩模型应如何在自己实际经历的生成状态上学习』。作者指出了两条研究线各自的盲区:其一,token reduction 领域的训练类方法(MQT-LLaVA、LLaVA-Mini、EPIC、LearnPruner,见 Table 1)全部是 fixed-prefix 训练——监督落在静态训练响应上,而非压缩模型自己 rollout 出的状态上,在 5% 预算下这种训练-推理失配被急剧放大;其二,on-policy distillation(Agarwal 等 2024、OPSD、Vision-OPD)的目标都是借助更强或信息更丰富的教师来抬高策略本身,从没人在『学生和教师是同一个模型、能力差距完全来自视觉信息量』的设定下用 OPD 恢复被极端压缩丢掉的能力。把两条线交叉——用冻结的全 token 自身副本作教师、在学生自生成轨迹上做分布蒸馏——正是本文占据的空白点,再加上『预算本身作为课程维度』的设计,构成完整的独特贡献。
核心方法
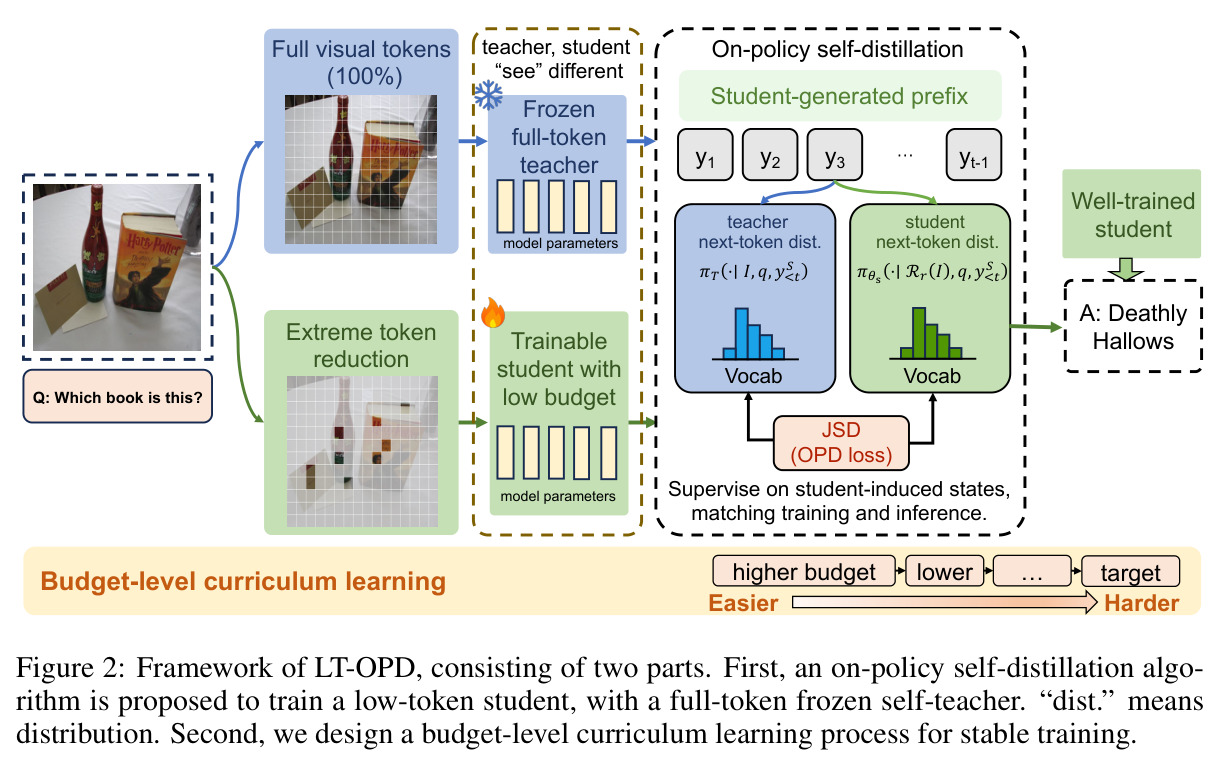
直觉上,方法建立在一个朴素分工上:压缩模型最清楚自己推理时会走到哪些状态(它就是按 5% token 生成答案的那个模型),而全 token 模型拥有最完整的视觉证据、知道每一步『正确』的分布长什么样。让前者自采样、后者打分,就能把监督精准投放到推理时真正会遇到的状态上。技术路线:student 与 teacher 从同一组预训练参数 $\theta_0$ 初始化,teacher 冻结并接收全部 $N$ 个视觉 token,student 只接收剪枝算子 $R_r$ 保留的 $N_{\text{stu}}=\mathrm{round}(r\cdot N)$ 个 token($r$ 最终为 5%)。每个训练步,student 先按当前策略自采样一条完整回答,然后 teacher 在这条学生生成的前缀上逐步给出 next-token 分布,用 Jensen-Shannon 散度约束学生的对应分布。由于极端预算下学生初期 rollout 质量很差,再用预算级课程把保留率从 25% 经余弦衰减降到 5%。训练在自建 LT-14K 数据集(1.4 万题)上进行 175 次更新;推理时只保留压缩学生,零额外开销。
核心创新是『在学生自己诱导的状态上做蒸馏』+『信息丰富的自教师』这一组合。与 fixed-prefix 蒸馏(EPIC、LLaVA-Mini 等)的本质区别在训练状态分布的来源:前者在数据集给定的静态响应前缀上对齐师生分布,本文则让教师在 $y^S_{<t}\sim\pi_{\theta_s}(\cdot\mid R_r(I),q)$ 采样出的每一步前缀上评分——训练分布与推理分布严格一致,从机理上消除被极端压缩放大的 train-test 失配。与已有 OPD 工作(OPSD、Vision-OPD)的本质区别在教师角色:它们靠外部更强教师或给教师补充细粒度视觉信息来抬升策略上限,本文师生参数完全相同、唯一差别是视觉证据量(5% vs 100%),因此蒸馏语义非常纯粹——『找回被剪枝丢掉的视觉信息对每一步预测的影响』,不会引入超出原模型的能力先验。两个要素缺一不可:消融显示把 on-policy 换回 fixed-prefix JSD,保留率从 82.3% 掉到 77.6%;去掉课程掉到 81.5%。
方法步骤详情
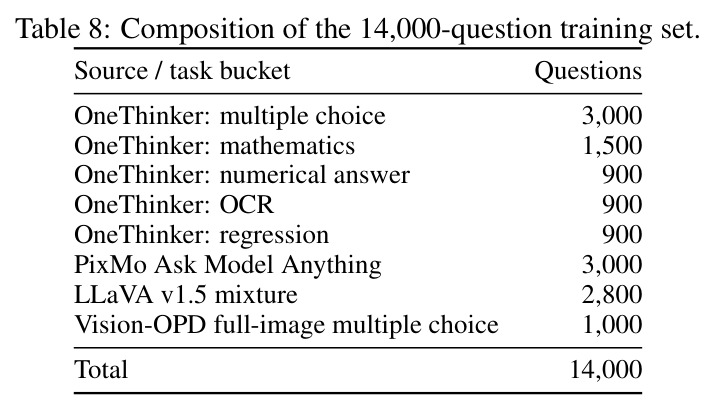
完整流程分五步。第一步,问题设定:给定图像-问题对 $x=(I,q)$,视觉编码器产生 $N$ 个 token;冻结教师 $\pi_T$ 收全部 token,学生 $\pi_S$ 经剪枝算子 $R_r$ 只留 $N_{\text{stu}}=\mathrm{round}(r\cdot N)$ 个(本文用适配到 Qwen3.5 的 CDPruner,在 merger 之后、语言模型之前执行,FP32 无梯度贪心选择并保留原始多模态旋转位置编码),目标是把学生适配到 $r=\beta=5\%$。第二步,on-policy rollout:训练第 $s$ 步,学生以 temperature 1 采样完整回答 $y^S\sim\pi_{\theta_s}(\cdot\mid R_r(I),q)$,轨迹按 stop-gradient 处理,不通过离散采样回传梯度。第三步,分布监督:在每个解码步 $t$,师生在同一学生前缀 $y^S_{<t}$ 上求 next-token 分布 $p^S_{t,\theta}$ 与 $p^T_t$,用 JSD 约束:$m_{t,\theta}=\frac{1}{2}(p^T_t+p^S_{t,\theta})$,$\ell^{\text{JSD}}_t=\frac{1}{2}D_{KL}(p^T_t\|m_{t,\theta})+\frac{1}{2}D_{KL}(p^S_{t,\theta}\|m_{t,\theta})$,对序列位置平均得 $\tilde{\mathcal{L}}_{\text{OPD}}$;实现上取学生 top-100、教师 top-100 与采样 token 的并集作词表支撑,剩余概率合并为一个尾部类。第四步,预算课程:$r(s)$ 分三段——前 14 步保持 $(2\alpha+1)\beta=25\%$,第 14–100 步按余弦计划平滑衰减,第 100–175 步固定在 $\beta=5\%$,其中 $\alpha=2$。第五步,数据与工程:LT-14K 共 1.4 万题(OneThinker 7200、PixMo 3000、LLaVA v1.5 2800、Vision-OPD 1000),175 次更新、每次 80 题、每题 8 条 rollout,共 11.2 万条轨迹;AdamW,语言模型学习率 $1\times10^{-6}$、视觉编码器 $2\times10^{-7}$;8×A100 80G 训练 15.1 小时。推理只保留压缩学生。
技术新颖性
从四个维度看新颖性。其一,问题设定:Table 1 系统对比显示 MQT-LLaVA、LLaVA-Mini、EPIC、LearnPruner 全部是 fixed-prefix 训练,本文是把 on-policy 蒸馏引入极端视觉 token 缩减的首次尝试。其二,自教师设计:与 Vision-OPD 给教师喂细粒度视觉信息、OPSD 用 ground-truth 奖励不同,本文师生唯一的差异轴是视觉证据量,使『蒸馏=信息恢复』的语义干净,也避免了外部教师能力先验的干扰。其三,课程维度:经典课程学习(Bengio 等)在数据难度上做文章,本文把『视觉 token 预算』本身作为课程变量,从 25% 余弦衰减到 5%——先让学生在有足够证据时学会行为,再逐步学会在稀缺证据下维持同样行为;附录 H 显示去掉最后 5% 平台期会使保留率从 82.3% 降到 79.5%(V*Bench 从 74.9 跌到 62.8)。其四,即插即用性:LT-OPD 与具体剪枝算子解耦,直接用 CDPruner 选择 5% token 就能把保留率从 68.6% 提到 82.3%,证明收益来自 on-policy 学习本身而非更好的 token 选择。
实验结果
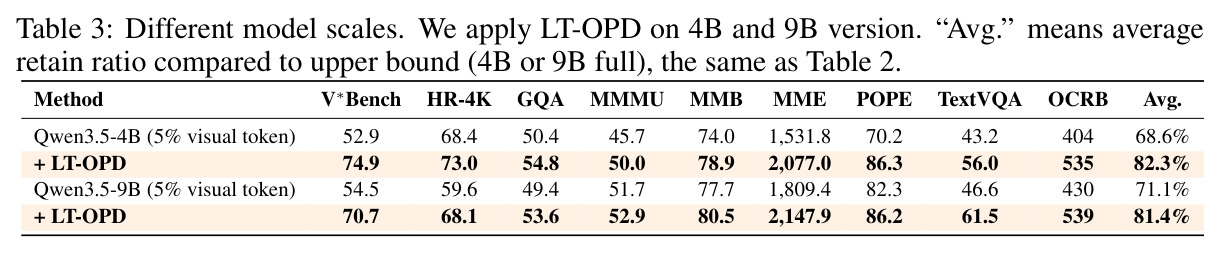
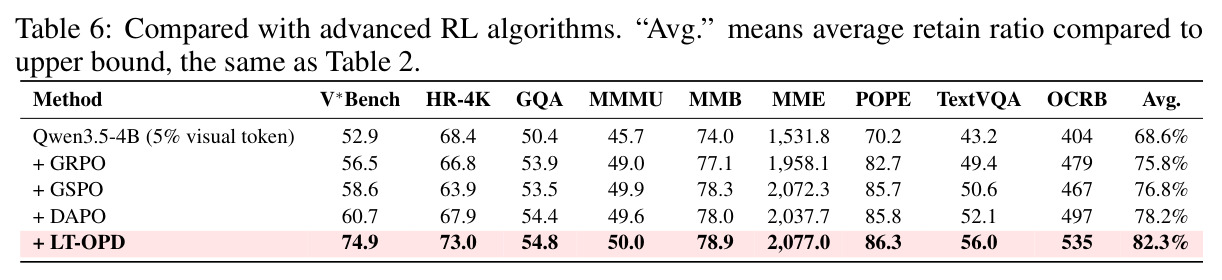
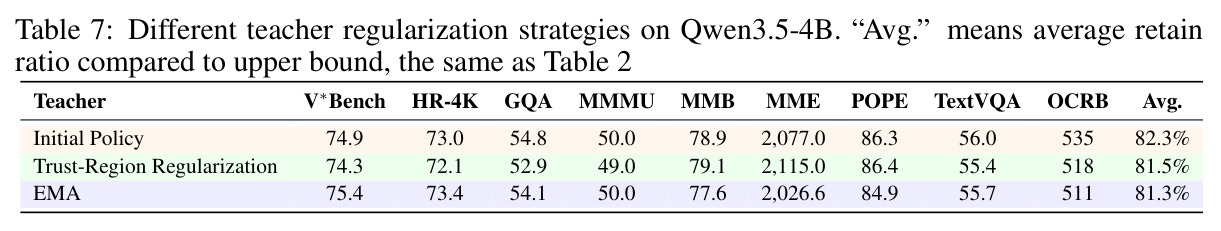
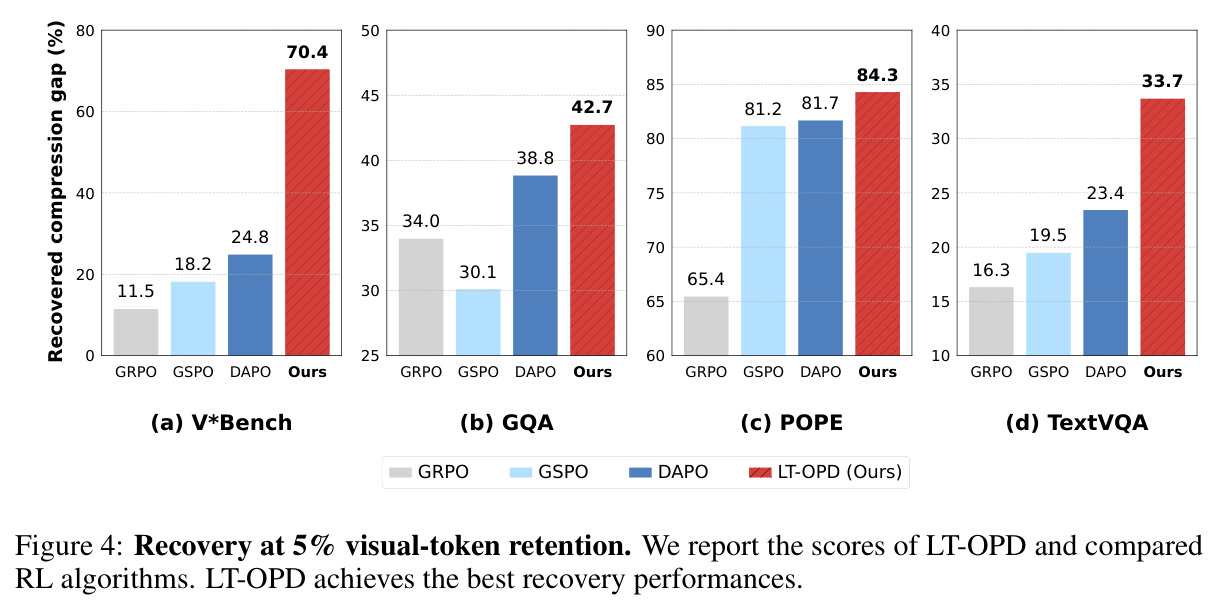
核心结果有六组。第一,主实验(Table 2):Qwen3.5-4B 上 5% 预算,LT-OPD 平均保留率 82.3%,未训练压缩版 68.6%,最强 training-free 基线 DivPrune 77.6%(+4.7 个百分点),最强训练基线 EPIC 73.7%(+8.6 个百分点),并在 9 个基准中的 8 个拿下第一;V*Bench 74.9(对手最好 70.7)、MME 2077.0(1915.4)、OCRBench 535(477);且 82.3% 已超过所有 training-free 方法在 10% 预算下的最好成绩(DivPrune 80.2%),接近 15%–20% 预算水平。第二,消融(Table 2 末四行):纯 SFT 70.4%,加课程 73.1%(+2.7pp),加 fixed-prefix JSD 蒸馏 77.6%,on-policy 无课程 81.5%,完整版 82.3%——on-policy 状态源贡献最大(约 4.7pp)。第三,跨规模(Table 3):9B 从 71.1% 提到 81.4%。第四,跨家族(Table 4):GLM-4.6V-9B 73.8%→86.3%,LLaVA-OV-1.5-4B 71.8%→84.1%。第五,效率(Table 5):KV cache 降 85.2%、prefill FLOPs 降 85.4%,FLOPs ratio 0.146 与 HiPrune 持平、低于 EPIC 的 0.200,端到端延迟 1331.5→1293.7 ms(1.029×),训练仅 15.1 小时。第六,与 RL 对比(Table 6):GRPO 75.8%、GSPO 76.8%、DAPO 78.2% 均不及 82.3%;按 recovery 指标 $100(S_{\text{method}}-S_{\text{pruned}})/(S_{\text{full}}-S_{\text{pruned}})$,LT-OPD 在 V*Bench 上比 RL 方法高 45 个点以上(Figure 4)。此外:教师策略消融(Table 7)中 initial policy/trust-region/EMA 三种教师都在 81.3–82.3%,方法鲁棒;目标函数消融(Table 12)中 forward KL 82.3%、reverse KL 82.8%、JSD 82.3%,JSD 在感知类更强、KL 在 OCR 类更强;多图基准(Table 14)平均 78.3%,比 CDPruner(65.7%)和 EPIC(69.8%)高 8.5–12.6 个百分点;案例研究(Figure 5–7)中 LT-OPD 在塑料凳材质、红帽颜色、文档日期识别上全部答对而基线全错。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 九基准平均性能(Qwen3.5-4B,5% 视觉 token) | 平均保留率(相对全 token 上限) | 82.3% | DivPrune(training-free 最强)77.6%;未训练压缩 68.6% | +4.7 个百分点(对 DivPrune);+13.7 个百分点(对未训练) |
| 九基准平均性能(Qwen3.5-4B,5% 视觉 token) | 平均保留率 | 82.3% | EPIC(training-based 最强)73.7% | +8.6 个百分点 |
| 与强化学习算法对比(Qwen3.5-4B,5% 视觉 token) | 平均保留率 | 82.3% | DAPO 78.2%(GSPO 76.8%、GRPO 75.8%) | +4.1 个百分点 |
| 跨模型规模(Qwen3.5-9B,5% 视觉 token) | 平均保留率 | 81.4% | 未训练压缩 71.1% | +10.3 个百分点 |
| 跨模型家族(GLM-4.6V-9B,5% 视觉 token) | 平均保留率 | 86.3% | 未训练压缩 73.8% | +12.5 个百分点 |
| 跨模型家族(LLaVA-OV-1.5-4B,5% 视觉 token) | 平均保留率 | 84.1% | 未训练压缩 71.8% | +12.3 个百分点 |
| 推理效率(Qwen3.5-4B,5% 视觉 token) | KV cache / prefill FLOPs / 端到端延迟 | 3.93 MB(−85.2%)/ 0.146×(−85.4%)/ 1293.7 ms(1.029×) | 全 token 26.59 MB / 6.002 TFLOPs / 1331.5 ms;HiPrune 0.146×;EPIC 0.200× | 与 HiPrune 同等 FLOPs 下保留率高 21.9 个百分点 |
| 多图/视频理解(MuirBench + MVBench 平均,5% 视觉 token) | 平均保留率 | 78.3%(52.0 / 55.6) | CDPruner 65.7%;EPIC 69.8% | +8.5 ~ +12.6 个百分点 |
局限与改进
作者承认的局限较少,但数据透露了不少。第一,恢复并不完全且不均衡:平均仍损失约 18% 性能——MMMU 50.0 对上限 77.6(恢复约 64%)、OCRBench 535 对 850(约 63%)、TextVQA 56.0 对 81.2,说明知识推理型和密集文字任务在 5% 预算下最难恢复。第二,端到端延迟收益有限:只从 1331.5 降到 1293.7 ms(1.029×),因为自回归解码耗时由每 token 计算与访存主导,视觉 token 削减主要省 prefill,这是该技术路线的固有限制。第三,课程超参($s_1{=}14$、$s_2{=}100$、$\alpha{=}2$)为经验设定,换模型/数据规模是否需要重调未验证。第四,训练开销不小:8×A100 80G 跑 15.1 小时,且每步都要做全 token 教师的前向。我自己的观察:其一,5% 预算是统一刀切,没有按样本难度或图像信息密度自适应分配;其二,蒸馏目标只约束分布形状、不含答案正确性信号,学生可能精确模仿教师『在 5% 证据下的犹豫分布』;其三,多图/视频只有初步验证(MVBench 55.6 对上限 71.8,恢复率偏低),扩展到长视频时跨帧预算分配会成为新问题。
独立分析的弱点
独立分析四个弱点并给出改进方向。弱点一:知识密集型任务恢复率低。MMMU 需要学科知识与图像细读,5% token 连图像细节都难以覆盖,MMMU 只恢复到约 64%;改进方向是按任务路由——简单感知任务走 5% 压缩路径,知识推理任务回退到更高预算或引入文本增强。弱点二:OCR 类任务恢复差(OCRBench 约 63%),因为文字在图像中空间密集、可压缩性低;改进方向是文本感知的预算分配,先用轻量检测器定位文字区域并为其分配更多 token。弱点三:统一预算对所有输入一刀切,『是什么颜色』的简单问题和复杂图表题拿到的 token 数相同;改进方向是把课程思想延伸到推理期——训练 Matryoshka 式多预算头,按学生自身的熵或置信度动态决定保留比例。弱点四:纯分布监督缺乏正确性锚点,教师就是原模型、自身也会错,在教师本就偏弱的样本上蒸馏会强化错误;改进方向是把 OPD 与 RL 混合,例如用 ground-truth 校验的样本做 OPD、其余做 RL,或像 OPSD 那样以正确性奖励门控蒸馏信号。
未来方向
作者明确提出的方向:一是把 token 选择与训练适配联合设计而非割裂使用(结论段原话),即剪枝器与 on-policy 学习端到端协同优化;二是推广到视频理解,附录 I 的 MVBench 初步结果(55.6,比 CDPruner 高 4 个点)只是开始,视频帧序列下如何跨帧分配 5% 预算是开放问题。基于本文成果可延伸:其一,把 on-policy 自蒸馏应用到其他压缩轴——层剪枝、KV cache 压缩、量化,让『低资源学生 rollout + 全资源自教师监督』成为通用配方;其二,自适应预算课程,课程终点 $\beta$ 不再固定,随学生能力增长动态收缩;其三,混合目标设计,Table 12 显示 reverse KL 在 OCR 类更强(599 对 JSD 的 535),可按任务混合 JSD 与 KL;其四,为蒸馏加入正确性信号,探索 OPD 与 GRPO/DAPO 的插值或分阶段组合;其五,从理论上刻画 on-policy 监督在『输入信息被压缩』场景下相对 fixed-prefix 的收益边界,目前只有经验证据。
复现评估
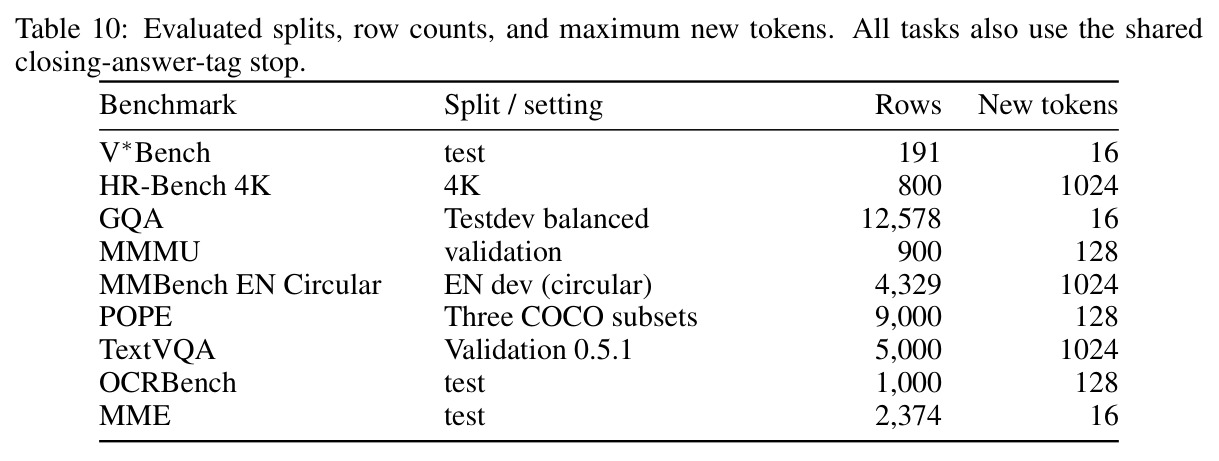
复现条件相当充分。代码已在 GitHub 开源(Yrxxxxxxxx1007/LT-OPD);训练数据 LT-14K 全部来自公开数据集并给出精确构成(Table 8)与采样种子(20260824/20260830);训练超参在 Table 9 逐项列出(175 updates、80 题/更新、8 rollouts/题、AdamW、语言模型 lr $1\times10^{-6}$、视觉编码器 $2\times10^{-7}$、BF16/FP32、FSDP 8 卡、初始化种子 42);蒸馏实现细节(top-100 词表支撑、尾部类合并)与全部训练/评估 prompt 在附录 C/D;效率测量协议(305 条 TextVQA、294 图、5 次重复、CUDA-graph)在附录 E。主要门槛是算力:8×A100 80G、15.1 小时,学生 rollout 与教师全 token 前向并存,显存压力大(需 FSDP + 梯度检查点 + CPU offload);评估基于 lmms-eval 与 VLMEvalKit 两个公开框架、基准划分行数明确(Table 10)。总体判断:对拥有 8 卡 A100 级集群的实验室,复现难度中等偏低;小团队可换用 LLaVA-OV-1.5-4B 级别的模型先验证方法。风险点是论文基于 Qwen3.5-4B 等 2026 年模型,且依赖较新版本栈(PyTorch 2.10、Transformers 5.5),代码库成熟度需实际检验。
论文图表
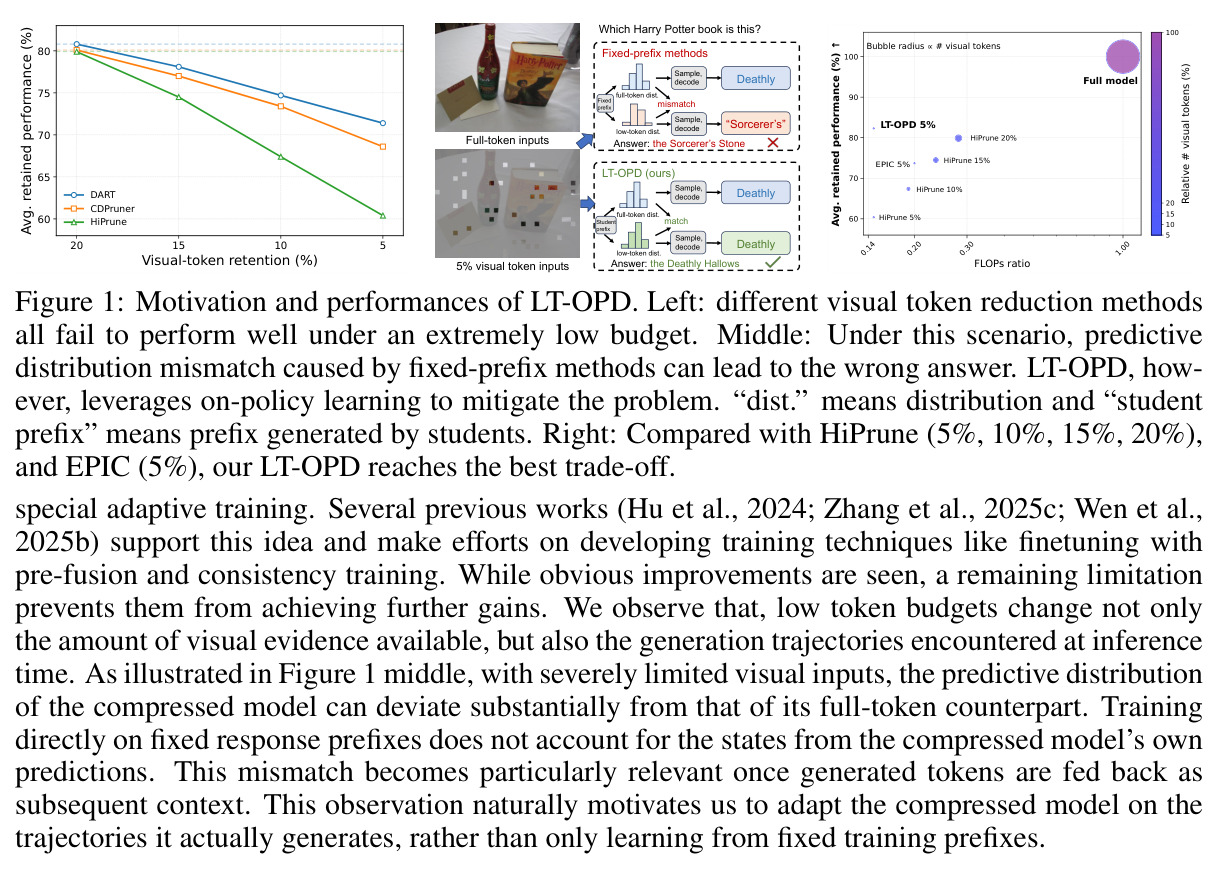
三联图。左图:各视觉 token 削减方法(fixed-prefix 类与训练类)在 20%→5% 预算下的性能曲线,所有方法在 5% 极端预算下都大幅退化。中间图:以《哈利·波特》书封识别为例,fixed-prefix 方法因师生预测分布失配答错,LT-OPD 在学生自生成前缀上做分布监督后答对 Sorcerer's Stone。右图:FLOPs 比率—平均保留率权衡散点,LT-OPD 在 0.146× FLOPs 下达到最高保留率,优于 HiPrune(5%–20%)和 EPIC(5%)。
一张图浓缩了问题(极端预算下全体失效)、机理(on-policy vs fixed-prefix 的分布失配)与结果(效率-性能权衡),是理解全文逻辑的入口。
拥挤场景中塑料凳材质选择题:HiPrune 答 bamboo、EPIC 答 wood,LT-OPD 答对 plastic。
定性案例,说明 on-policy 蒸馏保留了细粒度材质识别能力,支撑主表中 V*Bench 的大幅提升。
泳池边小红帽颜色题:HiPrune 与 EPIC 都答 white,LT-OPD 答对 red。
展示小目标属性识别上的优势——5% token 下仍能保留被剪枝方法丢失的小区域证据。
文档日期识别:EPIC 把正文提到的会议日期 December 1, 1960 当作文档日期,HiPrune 给出 March 13, 1975,LT-OPD 正确读出信头日期 January 9, 1961。
说明 5% token 下仍保留小字阅读与『区分文档日期和正文日期』的精细推理能力,对应 OCRBench 535 对 477 的领先。