1%的Token就够了:在线策略蒸馏中的梯度估计 1% of Tokens Can Be Enough: On Gradient Estimation in On-Policy Distillation
提出信息效率比IER衡量token梯度估计可靠性,0.1%-1%预算即可匹敌全量OPD
前置知识
在线策略蒸馏(OPD)
一种知识蒸馏范式:学生模型自己生成rollout轨迹,教师模型在学生产生的每个前缀上对下一token的完整分布打分,用反向KL散度把学生分布逐token拉向教师分布。相比序列级损失和只对最终答案的可验证奖励,它提供密集的token级监督,且监督发生在学生自身的生成分布上,缓解训练与推理分布不一致的问题。
本文全部讨论建立在OPD框架之上,IER要解决的问题正是'OPD中哪些token位置值得让教师监督',不理解OPD的采样-打分流程就无法理解梯度噪声从何而来。
反向KL散度
$D_{KL}(p\|q) = E_{a\sim p}[\log(p_a/q_a)]$,以学生分布$p$为期望测度。与正向KL不同,反向KL使学生倾向集中在教师的高概率模式上(mode-seeking),且其梯度可写成关于采样token的期望形式,因此支持单样本蒙特卡洛估计——这正是实践中sampled-token OPD的做法,也是噪声的来源。
本文的信号-噪声分解就是针对单样本反向KL梯度估计器做的,对数似然比$\rho(a) = \log(p_a/q_a)$是贯穿全文的核心量,定理1的所有结论都围绕它展开。
Fisher信息矩阵与自然梯度
Fisher矩阵 $F = diag(p) - p(p)^\top$ 刻画分布参数空间的局部几何:对无穷小扰动$\Delta z$,KL散度近似为 $D_{KL} \approx \frac{1}{2}\Delta z^\top F \Delta z$。用其伪逆$F^+$加权定义自然梯度,使优化步长在概率分布的几何(而非把概率当普通坐标的欧氏空间)中度量。
IER的信号与噪声都在Fisher几何中以 $\|\cdot\|_{F^+}$ 度量,作者明确论证欧氏噪声度量把概率值当作标准几何坐标并不合理,Fisher度量才与'分布匹配'的训练目标几何一致。
控制变量法与最优基线
方差缩减技术:给估计量减去一个期望已知的量再加回,期望不变而方差降低。策略梯度中常用动作无关的标量基线$b$,估计器变为$\hat{g}_b(a) = (\rho(a)-b)\phi_a$。本文定理1证明最优基线有解析解 $b^\star = E_p[\rho(a)L(a)]/E_p[L(a)]$,其中杠杆因子 $L(a) = (1-p_a)/p_a$。
IER定义在'最优基线下的最小方差'之上,信号与噪声两个闭式表达式都依赖该最优基线的存在,不掌握控制变量思想就看不懂定理1为何成立。
信噪比(SNR)
信号能量与噪声能量之比,衡量估计量中有效信息相对随机扰动的强度。SNR高意味着有限样本即可可靠恢复信号方向;SNR低则估计被噪声主导。策略梯度文献中Greensmith等的方差分析与Roberts & Tedrake的SNR分析是经典先例,vOPD是该思路在OPD中的近期延伸。
IER本质上就是token级梯度估计的SNR。作者发现IER分布极端重尾——通常不到0.1%的token分数大于1——这正是标题'1%的token就够了'的理论根源。
Bayes@32
数学推理评测指标:对每道题采样32个回答,将答案按等价类聚类后,以各聚类的经验频率为权重计算加权正确率。它同时考察准确性与生成一致性,比pass@k更平滑、方差更小。论文数学实验每题32样本,报告均值与标准误。
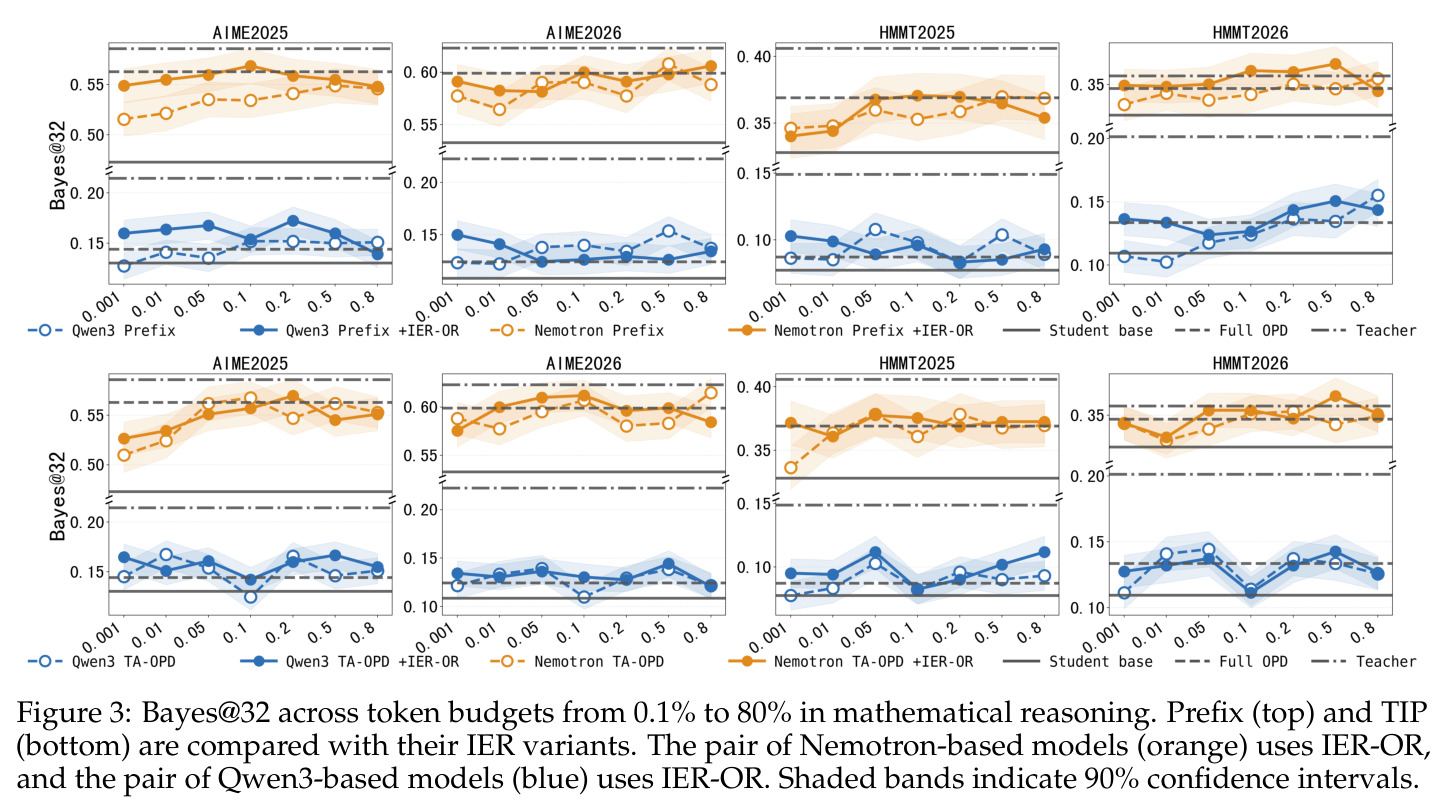
Table 2与Figure 3中AIME 2025/2026、HMMT-Feb 2025/2026的所有数字(如全量OPD的56.3/59.9/36.9/34.7)都以Bayes@32报告,不了解该指标会误读表中零点几分差距的含义。
研究动机
在线策略蒸馏(OPD)让学生在自己生成的轨迹上接受教师模型的逐token监督,传统做法用反向KL散度在每个token位置对齐学生与教师分布,监督密度远高于序列级损失。但并非所有token都值得学:近年工作用token重要度(TIP、TA-OPD)、学生不确定性(熵)、可教性、前缀位置等'有用性'指标筛选监督位置,其中prefix-based方法只蒸馏轨迹前几个token。本文指出一个被集体忽视的维度:固定前缀处的反向KL梯度是关于整个词表下一token分布的期望,而实践中sampled-token OPD只用一个采样token去估计这个期望,因此即使教师纠正本身有价值,单样本梯度估计也可能充满采样噪声、误导学生更新。该问题在稀疏预算下尤其致命:只允许0.1%的token参与更新时,有用性选择器可能恰好保留梯度噪声极大的位置。数据佐证:医疗推理中Prefix选择器在0.1%预算下HealthBench仅38.30/8.68,远低于全量OPD的45.77/19.77,说明'选了很多不该选的位置'。
本文的目标是本文要回答的问题是:给定学生生成的一个前缀,教师在该处的纠正信号能否被有限样本可靠地估计?为此作者提出信息效率比(IER)这一token级梯度估计可靠性指标,在信息几何框架下对单样本反向KL梯度做信号-噪声分解,并将IER与现有有用性分数结合,验证'既有用又可靠'的稀疏监督能否在极小token预算下匹配甚至超过全量OPD。具体目标有三层:其一,建立理论框架,在Fisher几何中推导最优标量基线下的闭式信号-噪声分解(定理1);其二,给出工程可行的top-K候选集近似,使IER在每个前缀只需师生各一次前向即可计算;其三,设计IER-OR与IER-AND两个软逻辑组合算子,让IER与任意有用性选择器即插即用,最终在数学与医疗推理、强到弱(同规模后训练教师)与大到小(更大学生更强教师)、thinking-on与thinking-off等多维设置中系统验证。
与已有工作不同的是,现有token选择方法的共同盲区是只回答'这个token值不值得学'(usefulness),从不回答'这个token的梯度能否被单样本可靠估计'(reliability)。与最相关工作的差异清晰可辨:vOPD用控制变量基线在参数欧氏梯度范数下降低单样本估计方差,但不产出逐token选择准则;OPRD用SNR支持隐空间蒸馏;SA-OPD的梯度SNR区分的是输入驱动与先验驱动的更新,而非采样误差本身;TrOPD用教师接受概率作可靠性代理,缺乏理论推导。本文的独特切入是用反向KL诱导的Fisher局部几何度量自然梯度估计误差,直接推导出闭式的信号-噪声比,无需对同一前缀重复采样即可打分。更关键的是作者明确论证有用性与可靠性是两个正交维度——有用的token可能梯度噪声大、可靠的token可能价值低——Figure 1中不同选择器Spearman排名相关高但top-10%选取的Jaccard相似度低,为这种互补性提供了直接证据,这是区别于所有先前方法的核心视角。
核心方法
直觉上,一个token即使教师的纠正很有价值,若其梯度用单个采样token估计时方差极大,更新方向就不可靠。技术上,OPD在固定学生生成前缀处优化反向KL散度 $D_{KL}(p\|q) = E_p[\log(p_a/q_a)]$,期望梯度为 $g = E_p[\rho(a)\phi_a]$,其中 $\rho(a) = \log(p_a/q_a)$ 是师生对数似然比、$\phi_a = e_a - p_a$;实践中用单样本估计器 $\hat{g}_b(a) = (\rho(a)-b)\phi_a$,$b$为保持无偏的标量基线。作者在Fisher信息几何中度量估计误差:以Fisher伪逆$F^+$加权的误差长度 $\|\delta_b\|^2_{F^+}$ 取代欧氏距离,使噪声度量与分布匹配目标几何自洽。定理1给出闭式分解:信号平方 $\|g\|^2_{F^+} = Var_p[\rho(a)]$,噪声为 $E_p[(\rho(a)-b)^2L(a)] - Var_p[\rho(a)]$(杠杆因子 $L(a) = (1-p_a)/p_a$),最优基线 $b^\star = E_p[\rho L]/E_p[L]$。IER即最优基线下信号与噪声之比,值越高说明该前缀的期望梯度越能被有限样本可靠估计。
核心创新是把token选择从'有用性'扩展到'估计可靠性'这一正交维度并给出闭式解。与vOPD只在参数欧氏空间做方差缩减不同,定理1在Fisher几何下得到三个解析结果:信号恰为对数似然比的方差 $Var_p[\rho(a)]$;最优基线下噪声有闭式表达;最优基线 $b^\star = E_p[\rho L]/E_p[L]$ 有解析形式。这意味着每个前缀只需师生各一次前向即可算出期望梯度信噪比,不必重复采样。工程上用top-K候选集近似全词表统计:候选集$C$取师生各自top-K并集加采样token,缺失logit填小值$\epsilon$,对数似然比clip到$[-30,30]$。IER归一化排名$r_j$与有用性分数$u_j$通过软逻辑算子结合:$s_j^{OR} = 1-(1-u_j)(1-r_j)$(任一高即可入选)、$s_j^{AND} = u_j r_j$(两者皆高才入选),训练目标保持采样的反向KL不变。作者还发现IER分布极端重尾——通常不到0.1%的token分数大于1——说明全量监督中绝大多数token的噪声超过信号,这是'更少但更准'的监督反而有效的根本原因。
方法步骤详情
①候选集构造:每个前缀处取 $C = TopK(z_\theta) \cup TopK(z_T) \cup \{a\}$(师生各自top-K并集加采样token),缺失logit填$\epsilon$,在$C$上归一化得$\hat{p}, \hat{q}$,算 $\hat{\rho}(a) = \text{clip}(\log(\hat{p}(a)/\hat{q}(a)), -30, 30)$。②近似IER:$\widehat{IER} = \widehat{Signal}/\widehat{Noise}$,$\widehat{Signal} = Var_{\hat{p}}[\hat{\rho}]$,$\widehat{Noise} = E_{\hat{p}}[(\hat{\rho}-\hat{b}^\star)^2\hat{L}] - Var_{\hat{p}}[\hat{\rho}]$,$\hat{b}^\star = E_{\hat{p}}[\hat{\rho}\hat{L}]/E_{\hat{p}}[\hat{L}]$,$\hat{L}(a) = (1-\hat{p}(a))/\hat{p}(a)$。③组合打分:batch内IER排名归一化为 $r_j \in [0,1]$,有用性信号归一化为$u_j$,按 $s_j^{OR} = 1-(1-u_j)(1-r_j)$ 或 $s_j^{AND} = u_j r_j$ 合成。④选择与训练:全batch统一竞争token预算(0.1%/1%/10%等,每响应至少留1个token),中选位置按采样反向KL目标更新,其余不做监督;数学用DAPO-Math-17k跑50轮rollout,医疗用RaR-Medicine跑100轮。
技术新颖性
技术新颖性体现在四个层面。理论层面:首次在OPD的token选择问题中引入信息几何视角,把单样本反向KL梯度的估计误差放进Fisher度量下分析,定理1给出信号-噪声闭式分解与最优基线解析解,推导不需任何采样,区别于vOPD(欧氏空间控制变量、不产出选择准则)与TrOPD(用教师接受概率做无理论支撑的代理)。工程层面:top-K候选集近似把全词表统计降为$O(K)$规模,候选集融合师生双方top-K加采样token,用$\epsilon$填充与clip处理分布不重叠及数值稳定,使每前缀仅一次双模型前向即可打分;附录B.3还证明IER的倒数是最优基线下的相对均方误差,赋予其明确的统计解释。方法组合层面:IER-OR/IER-AND是模型无关、选择器无关的软逻辑算子,可与Prefix、Entropy、TIP、TA-OPD、CA-SoftOR任意有用性信号即插即用,且保留原反向KL训练目标不变,只改监督位置的分配。实证层面:发现IER分布重尾(不到0.1%的token超过1)以及不同选择器排名高相关但top-10%选取Jaccard低的互补现象,为可靠性维度独立于有用性提供经验证据。
实验结果
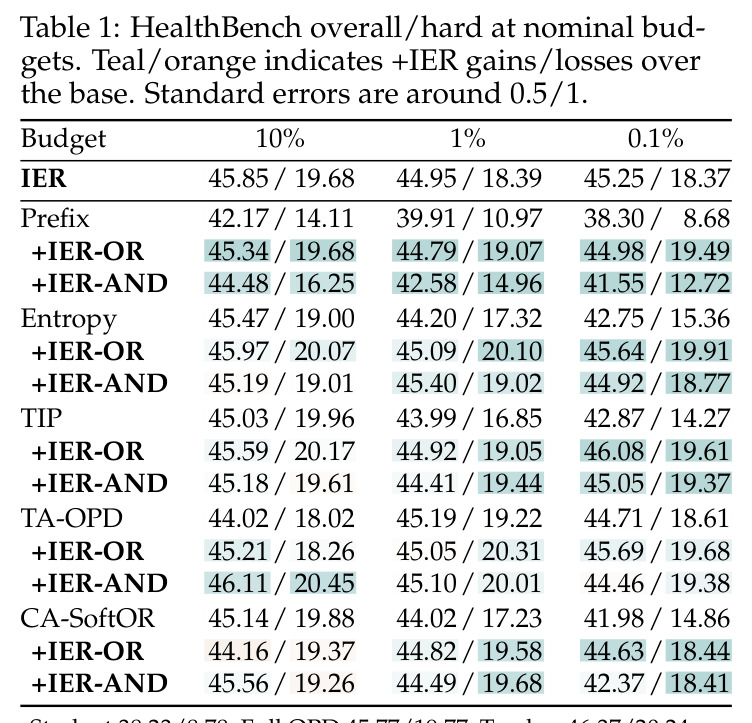
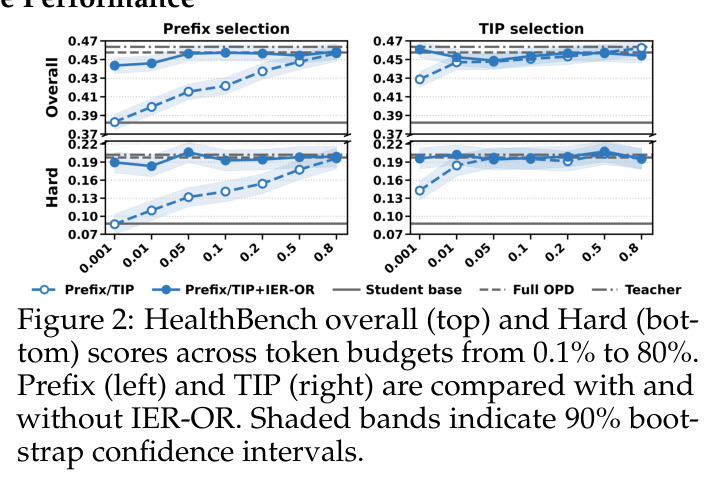
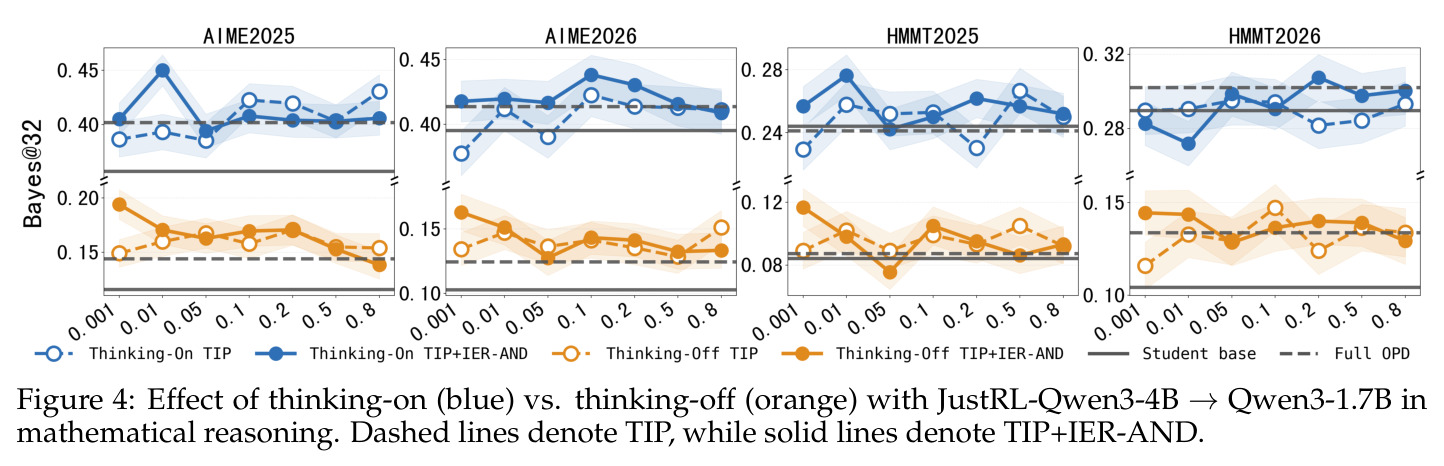
IER分布极端重尾:通常不到0.1%的token分数大于1,即绝大多数位置噪声超过信号。数学上,Nemotron对(JustRL-Nemotron-1.5B→OpenMath-Nemotron-1.5B)全量OPD得56.3/59.9/36.9/34.7(AIME25/26、HMMT25/26,Bayes@32),IER单选器0.1%预算达53.5/58.9/34.8/34.1,接近全量OPD。Qwen3对(JustRL-Qwen3-4B→Qwen3-1.7B,学生仅11.6/10.3/8.4/10.4,全量OPD 14.4/12.5/8.7/13.4)上TIP+IER-AND@0.1%达19.4/16.3/11.7/14.4,四基准全面超过全量OPD(最高+5.0分)。医疗上(学生38.23/8.78,全量OPD 45.77/19.77,教师46.37/20.24),0.1%预算约每条轨迹选1个token,IER达45.25/18.37接近全量OPD,Prefix同预算仅38.30/8.68;TIP+IER-OR@0.1%达46.08/19.61;Prefix+IER-OR升至44.98/19.49(+6.68/+10.81);TA-OPD+IER-AND@10%达46.11/20.45几乎追平教师。Figure 1显示各选择器排名Spearman相关高但top-10% Jaccard低,IER选出的是不同token集合。预算扫描0.1%-80%显示收益非单调,1%-5%往往足够;thinking-on下TIP单独可能劣于学生,TIP+IER-AND两模式均稳定提升;Entropy+IER组合在数学上多次负增益。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 数学推理:JustRL-Nemotron-1.5B→OpenMath-Nemotron-1.5B(强到弱) | Bayes@32(AIME25/AIME26/HMMT25/HMMT26,%) | IER单选器@0.1%预算:53.5/58.9/34.8/34.1;IER@10%:55.5/58.8/36.3/36.9 | 全量OPD(无token选择):56.3/59.9/36.9/34.7;随机选择@0.1%:49.6/55.4/33.5/32.9 | 0.1%预算(千分之一token)即接近全量OPD,10%预算HMMT26反超+2.2分 |
| 数学推理:JustRL-Qwen3-4B→Qwen3-1.7B(大到小) | Bayes@32(AIME25/AIME26/HMMT25/HMMT26,%) | TIP+IER-AND@0.1%预算:19.4/16.3/11.7/14.4 | 全量OPD:14.4/12.5/8.7/13.4;TIP单独@0.1%:14.9/13.4/8.9/11.6 | 较全量OPD提升+5.0/+3.8/+3.0/+1.0,四基准全面超越 |
| 医疗推理:ClinAlign-4B→Qwen3-4B | HealthBench overall/hard | TIP+IER-OR@0.1%:46.08/19.61;IER单选器@0.1%:45.25/18.37;TA-OPD+IER-AND@10%:46.11/20.45 | 全量OPD:45.77/19.77;教师:46.37/20.24;学生:38.23/8.78 | 0.1%预算(约每条轨迹1个token)逼近全量OPD,10%预算追平教师 |
| 医疗推理:弱基线Prefix增强 | HealthBench overall/hard | Prefix+IER-OR@0.1%:44.98/19.49 | Prefix单独@0.1%:38.30/8.68 | +6.68/+10.81,IER把几乎失效的位置选择器拉回接近全量OPD水平 |
局限与改进
作者坦承的局限:IER与有用性分数都是近似,组合并不保证更好——基于Entropy的组合在数学推理上多次性能下降,IER-OR与IER-AND都没有一致改进;增益随选择器与设置波动,'如何最优选择与加权token仍是开放问题'。我自己的观察有五点:其一,top-K候选集近似在高熵或长尾分布前缀上可能失真,缺失logit用$\epsilon$填充的系统偏差未被量化,而杠杆因子 $L(a) = (1-p_a)/p_a$ 恰在低概率token上取值极大,噪声项可能带系统性偏差;其二,理论假设所有token $p_a, q_a > 0$ 并依赖clip到$[-30,30]$,边界行为缺乏分析;其三,batch内归一化排名使IER选择依赖batch构成,小batch下方差可能放大;其四,标准误在0.4-1之间,部分'匹配全量OPD'的结论(如AIME26的58.9对59.9)在统计上难以与噪声区分;其五,医疗评测依赖gpt-oss-120B判分(meta-eval macro F1仅0.6614),评分噪声可能掩盖稀疏与全量监督间的真实差距;此外正文未与vOPD等方差缩减方法直接对比。
独立分析的弱点
独立分析有四个弱点。第一,候选集近似是有偏估计:top-K并集只覆盖两模型概率质量的高密度区,对$1-p$尾部质量贡献大的中长尾token被$\epsilon$截断,而杠杆因子 $L(a) = (1-p_a)/p_a$ 恰在低概率token上取值极大,噪声项可能被系统性低估或高估,论文未给近似误差界;改进方向是用重要性采样或分层求和估计全词表矩,或证明近似IER与精确IER的排序一致性。第二,组合策略粗糙:软OR/AND只是分数层面的融合,未考虑token间冗余(同一短语相邻多个位置同时中选会浪费预算)与预算在轨迹间的分配;可引入次模最大化或按轨迹IER分布自适应分配预算。第三,可靠性定义绑定在单token采样RKL估计器上:若改用top-K蒸馏、多样本估计或其他散度(前向KL、TVD),IER需重新推导,泛化性未知;可建立对估计器族的统一可靠性框架。第四,超参数敏感性缺失:候选集大小K、clip范围$[-30,30]$、$\epsilon$取值的影响均未报告,且实验要求师生共享tokenizer,限制了跨词表大到小蒸馏;应补充消融并探索tokenizer映射下的IER计算。
未来方向
作者明确留下两个方向:更深入理解token重要性,以及更好的训练目标设计。沿本文成果可延伸出多条路径:其一,把静态打分升级为动态预算分配——按轨迹难度或batch内IER分布自适应决定每条rollout的token预算,而非固定0.1%/1%;其二,IER与数据选择结合,在课程层面优先蒸馏IER高发的任务域,形成'选数据+选token'的二维稀疏化;其三,把信息几何可靠性分析推广到前向KL、TVD等其他蒸馏目标与多样本估计器,建立统一的监督-估计权衡理论;其四,在线更新IER统计量,随训练中学生分布$p$的漂移自适应调整最优基线$b^\star$,研究可靠性分布在训练动力学中的演化;其五,与vOPD等方差缩减技术正交叠加,验证'选对token'与'估准梯度'的收益是否可加;其六,探索IER与prefix-based方法的理论联系——为何早期位置更可靠,可能存在位置相关的SNR衰减规律可以形式化;其七,在70B级教师与多模态推理上检验重尾结论的普适性。
复现评估
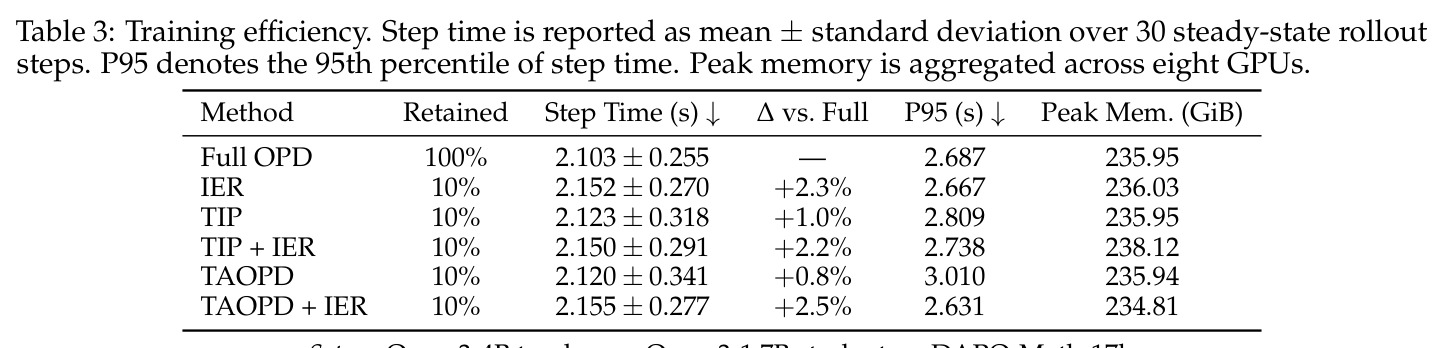
复现条件较好。代码已开源(https://github.com/BruceSheng1202/IER-OPD);训练数据全部公开:数学用DAPO-Math-17k(50轮rollout),医疗用RaR-Medicine(100轮rollout);六个模型均公开可得(Nemotron 1.5B对、Qwen3 4B/1.7B对、ClinAlign-4B/Qwen3-4B)且师生共享tokenizer。评测协议清晰:数学在AIME 2025/2026与HMMT-Feb 2025/2026上每题32样本报Bayes@32均值与标准误;医疗用HealthBench overall/hard,由gpt-oss-120B判分(meta-eval macro F1为0.6614)。实验细节在附录C.2,训练开销在附录C.3,与并发工作对比在附录C.4。门槛在于需师生两模型在每个前缀同时前向并维护top-K logits,成本约为双模型在线推理;完整复现7个预算点×多选择器×多模型对算力不小,但验证核心结论用1.5B-4B模型单机多卡即可完成,整体难度中等。
论文图表
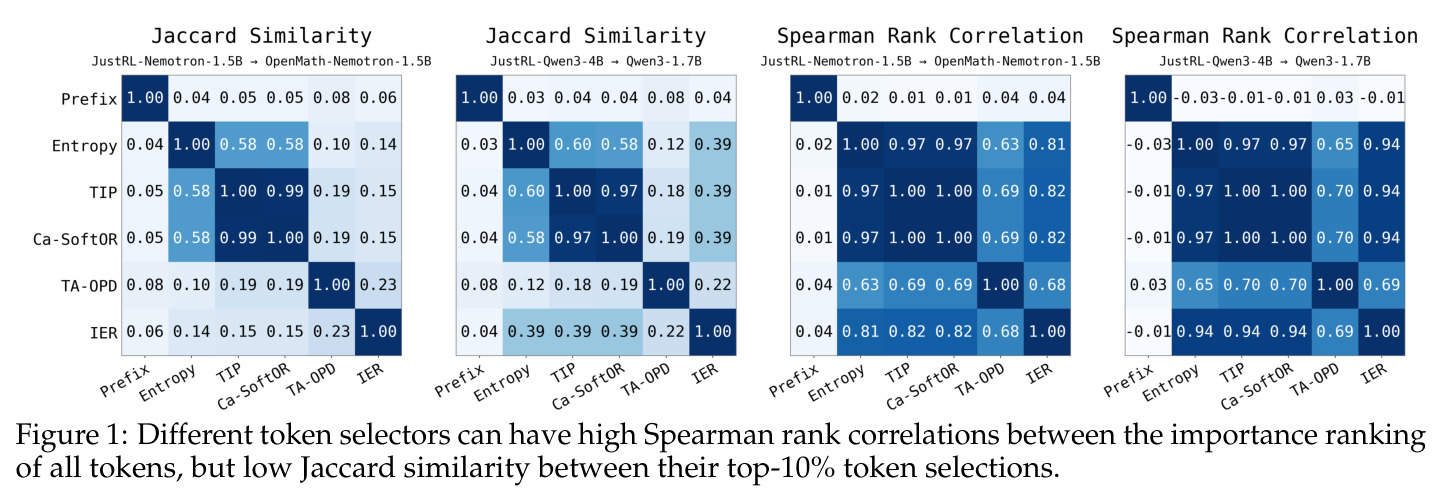
对比IER与各有用性选择器(Prefix、Entropy、TIP、TA-OPD、CA-SoftOR)在同一rollout batch全部token上的重要性排名Spearman相关系数,以及各自top-10%选中集合之间的Jaccard相似度。结果显示:除Prefix外各选择器之间排名相关性很高,但IER与有用性选择器的top-10%集合重叠度很低,且token预算越低Jaccard相似度越低。
这张图是论文核心论点——可靠性与有用性互补而非冗余——最直接的证据。它解释了为什么IER与有用性分数组合能带来增益:两者虽在整体排序上相关,但在真正被监督的头部token上选出的是几乎不同的集合。