神经图像水印中的残差可迁移性 Residual Transferability in Neural Image Watermarking
形式化水印残差跨图可迁移性(RT),定位架构为根因,并提出免重训的内容绑定防御CoverLock。
前置知识
神经图像水印
用神经网络实现的隐形水印:编码器 $E$ 把 $L$ 比特消息 $m$ 以不可感知扰动嵌入图像得到 $x_w = E(x, m)$,解码器 $D$ 从(可能经受失真 $\tau$ 的)图像中恢复消息。训练时联合优化消息恢复损失 $\ell_{wm}$ 与图像保真损失 $\ell_{img}$,并通过模拟噪声层获得鲁棒性。Google SynthID、Meta Content Seal 等工业方案均属此类。
本文研究的残差可迁移性正是这类系统的固有属性,只有理解编解码器如何协同编码消息,才能读懂 RT 差异的行为签名与架构根源。
残差伪造攻击
一种不需要知道水印算法内部细节的攻击:攻击者拿到若干张带同一消息 $m$ 的水印图,估计其干净版本后取差值平均得到水印残差 $\bar{r}_s = \frac{1}{s}\sum_i (x^w_{r,i} - \hat{x}_{r,i})$,再把残差叠加到任意目标图上。若解码器把伪造图判为携带 $m$,即实现虚假署名或溯源。已有工作表明仅需 1 张参考图即可攻击成功。
RT 指标度量的正是这种攻击在理想化(真值残差)条件下的成功率,是全文的核心威胁模型和一切分析的出发点。
BitAcc / BER / TPR / ASR 指标体系
水印安全评估的常用指标:比特准确率 BitAcc 是解码比特与真值一致的比例,比特错误率 BER 为其补;真阳性率 TPR 衡量合法水印图被正常通过的比例,攻击成功率 ASR 衡量伪造图被误判为携带目标水印的比例(本质是误报率)。验证阈值通常按二项零假设校准到极低误报(如 $10^{-6}$)。
论文的 RT 定义、CoverLock 防御对比(Table 2)与鲁棒性分析(Table 3、Figure 4)全部建立在这四个指标之上,不熟悉它们就无法读懂实验部分。
全局平均池化(GAP)与空间结构
GAP 把卷积特征图在空间维度上平均成一个向量,是 CNN 分类头的标准操作。它迫使前面的层把信息空间化分布(证据可出现在任意位置),但也会在最终表示中抹掉位置细节。水印解码器是否保留空间表示直到晚期再池化,直接决定解码是否依赖图像的空间内容。
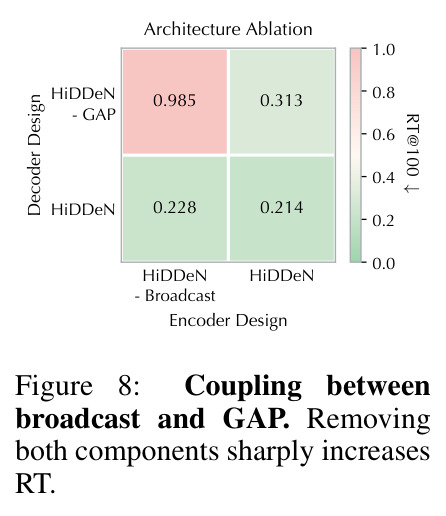
论文识别出的第一个低 RT 机制 Broadcast–GAP 正是『编码器消息空间广播 + 解码器晚期 GAP』的耦合设计,2×2 消融完全围绕它展开。
对比学习与 InfoNCE
自监督表征学习范式:同一样本的两个增广视图(正例对)在嵌入空间拉近、不同样本推远,常用带温度 $\tau_c$ 的 InfoNCE 损失 $\mathcal{L}_{con} = -\frac{1}{2N}\sum_j \log \frac{\exp(e_j^\top e_{\pi(j)}/\tau_c)}{\sum_{k\neq j}\exp(e_j^\top e_k/\tau_c)}$。它能在没有标签的情况下学到对增广不变、对样本可分的表示。
CoverLock 的图像哈希正是用对比学习在冻结 DINOv2 特征上训练的,目标是同一图像不同失真视图的码稳定、不同图像的码互异,这是整个防御的基石。
DINOv2 自监督骨干
Meta 提出的自监督 ViT 基础模型,无需标签即可产出语义强、对常见图像失真稳定的通用视觉特征,常被冻结用作特征提取器。取最后层 16×16=256 个 patch token 并做通道维 mean/std 池化,可同时刻画全局特征响应及其空间变化。
CoverLock 借助冻结 DINOv2 特征的失真稳定性生成每图二进制码,是实现即插即用、完全不修改水印模型的关键组件。
研究动机
AI 生成图像爆发式增长使隐形水印成为内容溯源与署名的基石,Google(SynthID)、Meta(Content Seal)、OpenAI 与 Amazon 都已把水印集成进自己的生成生态。但近年研究揭示出一类成本极低的伪造攻击:攻击者从公开 released 的水印图像中估计水印残差,把它叠加到无关内容上,就能让解码器误判目标图携带同一水印,从而实现虚假归属。Yang et al. (2024a) 用 100 张参考图做残差平均即可攻击,Souček et al. (2026) 的 WmForger 只需单张参考图加一个辅助偏好模型,在 MBRS+COCO 上攻击成功率高达 96.28%,CIN 上达 86.09%。这意味着攻击者可以把别人作品的水印『拷贝』到任何图上伪造出处,直接动摇水印溯源的可信度。更棘手的是,此前工作都在竞相构造更强的攻击,而对『为什么这些残差能跨图迁移』这一根本问题几乎没有解释,防御者只能针对已知攻击被动训练检测器,缺乏体系结构与训练层面的设计指导。
本文的目标是本文的目标分三层。第一,把『残差可迁移性』形式化为水印系统本身的内蕴属性:提出 RT 指标,用真值(oracle)残差而非任何具体攻击的估计残差来度量水印证据跨无关图像保持可解码的程度,从而剥离攻击实现方式的干扰,使不同系统可以公平比较。第二,回答『是什么让残差可迁移』:在五个代表性水印系统上系统比较训练配置与架构设计,先排除训练侧因素,再通过受控架构干预定位造成 RT 巨大差异的因果性设计因素,总结出可指导未来水印架构的两条设计原则。第三,为无法重构架构的已部署系统提供补救:设计一个即插即用、不修改水印模型任何参数的轻量包装器 CoverLock,把水印证据重新绑定到封面图像内容上,目标是在多种攻击下把平均伪造成功率压到 0.25% 以下,同时保持比现有防御更好的鲁棒性。
与已有工作不同的是,已有攻击研究的切入点是『如何更好地估计残差』(多次平均、辅助参考模型等),属于攻击工艺的迭代;已有防御则分两类——分类器检测依赖已知攻击产生的伪造痕迹,换一种残差估计方法就失效,容易陷入攻防军备竞赛;MHDW(2006)式媒体哈希虽然也想把水印验证绑定到内容,但哈希靠手工设计、在失真下鲁棒性差。本文的独特之处有三:一是视角转换,把脆弱性当作系统级内蕴属性,用 oracle 真值残差协议做与攻击无关的度量,从根上避免『防御追着攻击跑』;二是方法论上用受控干预(把 Broadcast–GAP 从 HiDDeN 拆掉、移植进 MBRS/CIN、把 RivaGAN 的自适应注意力换成固定模式)建立架构与 RT 的因果关系,而不只是停留在相关性观察;三是引入捷径学习视角解读训练动态,把水印安全分析与表示学习理论连接起来。
核心方法
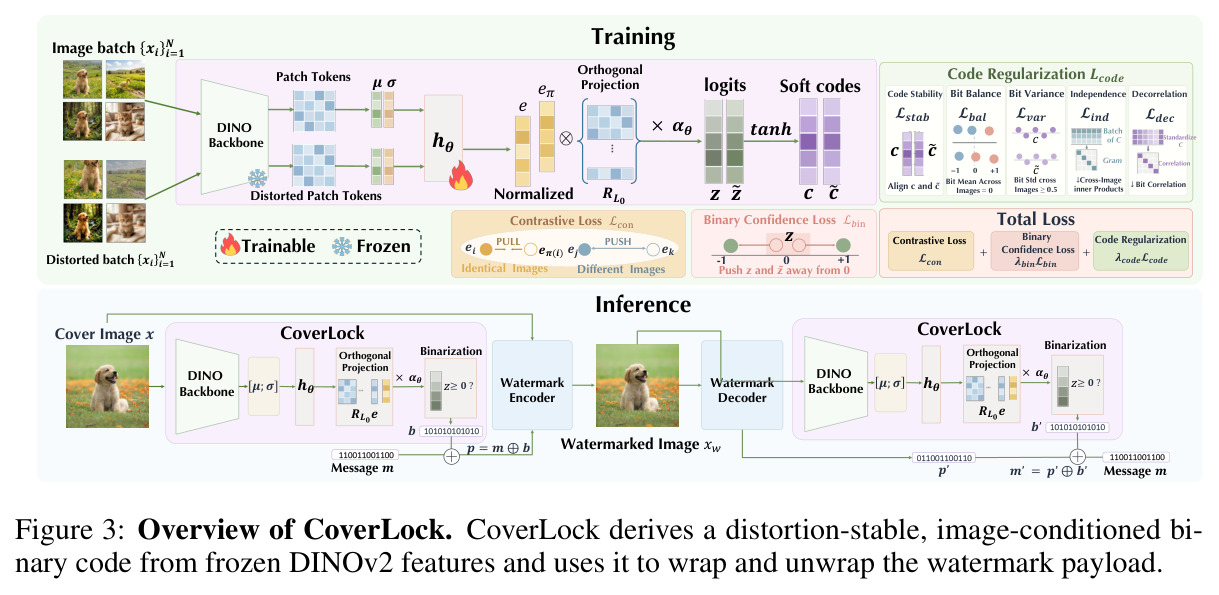
全文按『度量—归因—补救』三步展开。度量:对每个消息 $m_k$,用 $s$ 张源图构造真值残差 $\bar{r}^{(k)}_s = \frac{1}{s}\sum_i (x^{w,(k)}_{r,i} - x^{(k)}_{r,i})$,加到 $T$ 张互不相交的目标图上,计算平均转移比特准确率 $\bar{a}_s = \frac{1}{MT}\sum_{k}\sum_{j} \mathrm{BitAcc}\big(D(\mathrm{clip}_{[0,1]}(x_{t,j} + \bar{r}^{(k)}_s)),\, m_k\big)$,并定义 $\mathrm{RT}@s = \max(2\bar{a}_s - 1, 0) \in [0,1]$(默认 $s=T=100$,$M=5$)。归因:先做行为分析——高 RT 系统在不同封面上平均出的残差图案高度一致,且解码器末层特征方差中封面诱导成分极小(MBRS 仅 1.0%),说明存在与封面无关的捷径通路;再对训练侧因素(数据集、消息长度、损失权重、噪声模拟)做消融,排除其充分解释性;最后对低 RT 系统做架构干预,确认 Broadcast–GAP 耦合设计与内容自适应注意力是压制 RT 的两个机制。补救:CoverLock 用冻结 DINOv2 提取失真稳定的图像特征,经投影头与固定正交投影生成每图 $L$ 位二进制码 $b_\theta(x)$,嵌入前做 $p = m \oplus b_\theta(x)$ 包装,验证时用 $\hat{m} = \hat{p} \oplus b_\theta(\tau(x_w))$ 解包,整个模块只在自然图像上独立训练,不触碰原水印系统的架构与参数。
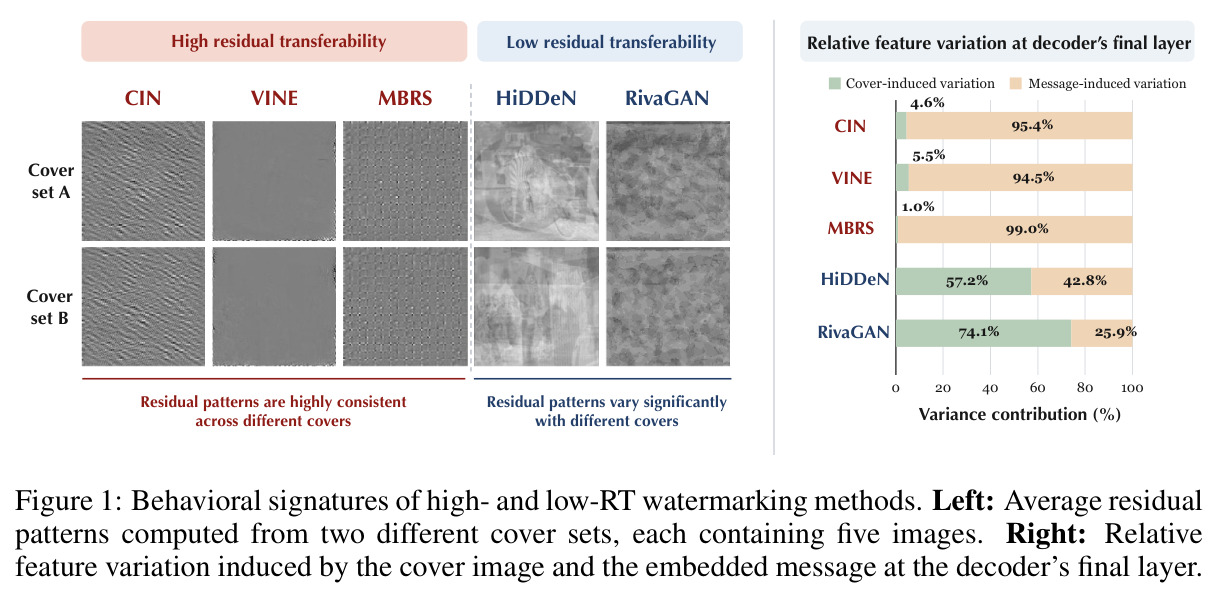
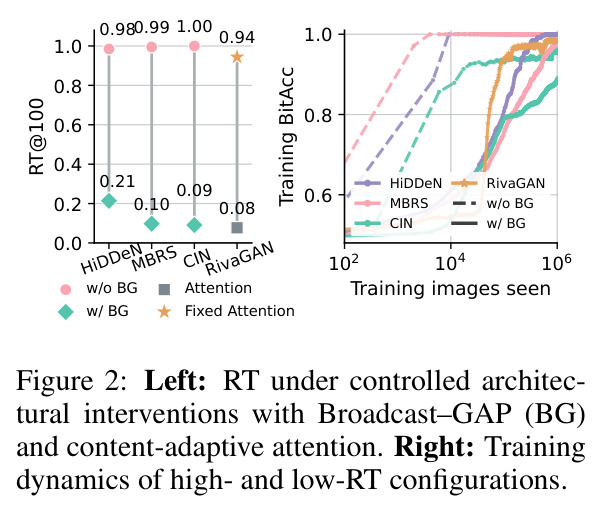
核心创新是『让水印证据依赖封面』这一设计原则的因果确认与工程化。行为层面,论文发现高 RT 系统(CIN/VINE/MBRS)的解码器几乎是『纯消息探测器』:固定消息换封面时末层特征几乎不变(封面诱导方差 CIN 4.6%、VINE 5.5%、MBRS 1.0%),解码不依赖图像内容,残差自然可以跨图搬运;低 RT 系统(HiDDeN 57.3%、RivaGAN 74.1%)则把消息与内容深度耦合。架构层面找到两个负责耦合的机制:其一是 HiDDeN 的 Broadcast–GAP——编码器把消息空间广播并与局部图像特征融合,解码器保留空间表示直到晚期全局平均池化,2×2 消融证明两者必须成对起效(只去广播 RT@100 为 0.228、只去 GAP 为 0.313、都去掉才飙到 0.985);其二是 RivaGAN 的内容自适应注意力,换成固定嵌入模式后 RT@100 从 0.077 涨到 0.944。CoverLock 与已有方法的本质区别在于:不重构水印模型,而是用失真稳定的图像哈希让同一用户消息在不同封面上映射为不同载荷,从验证逻辑上使跨图残差天然失效,且不依赖对任何攻击特征的建模。
方法步骤详情
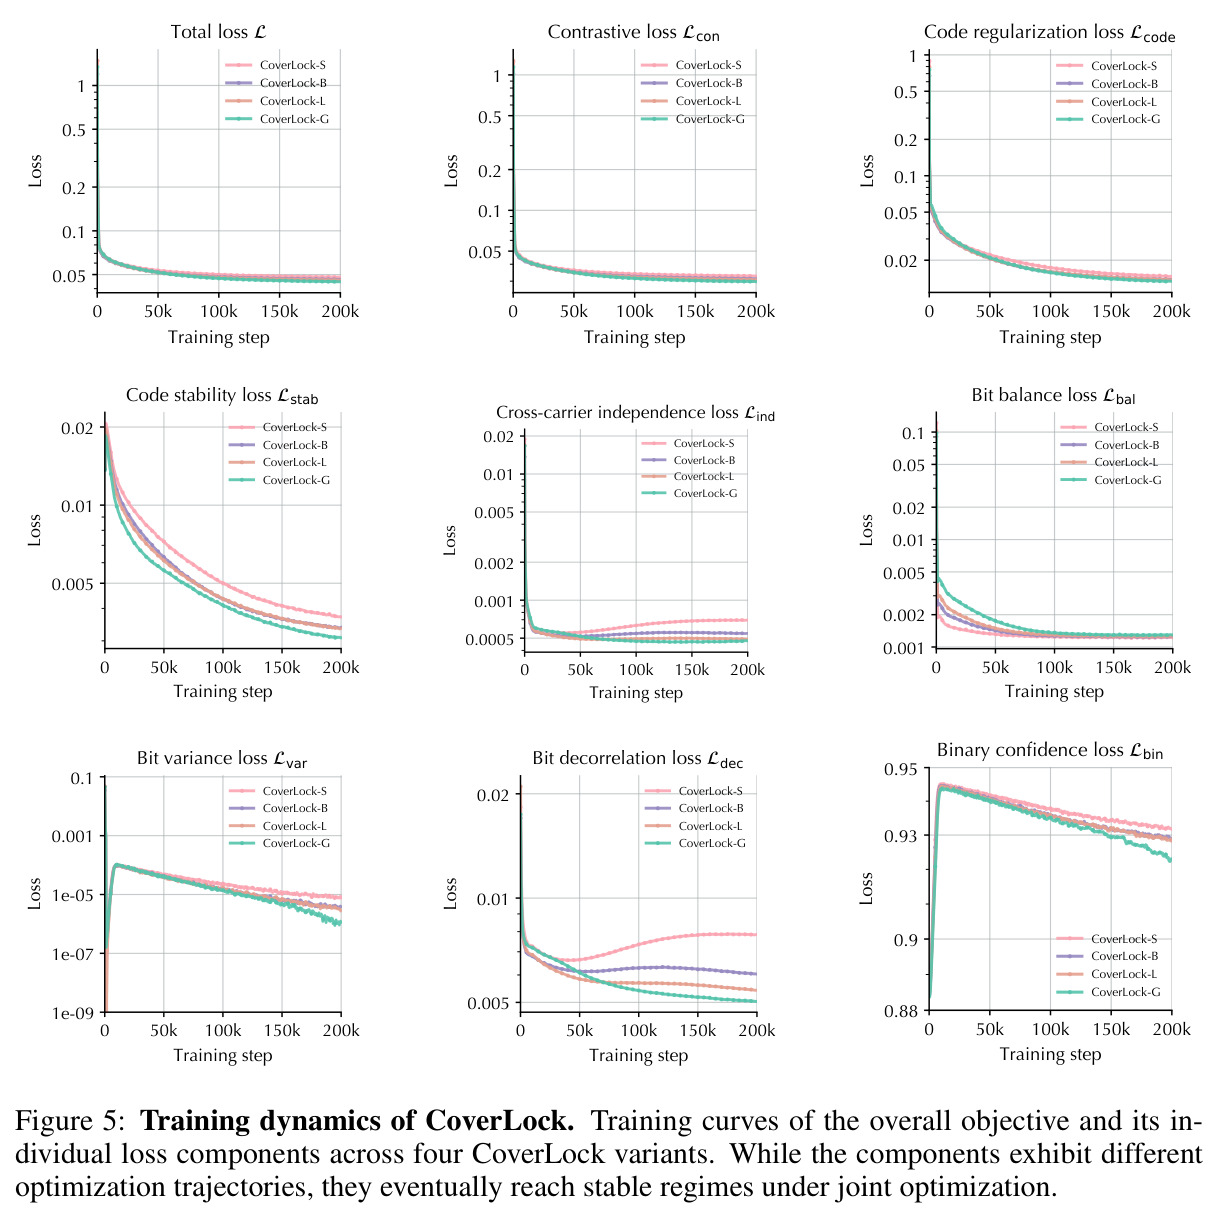
RT 度量步骤:输入 $M{=}5$ 个消息、每消息 $s$ 张源图与 $T{=}100$ 张目标图;(1) 用原编码器生成水印图并求真值残差均值;(2) 逐目标图叠加残差并裁剪到 $[0,1]$;(3) 解码后与 $m_k$ 比较,按上式聚合得 RT@s。CoverLock 步骤:(1) 图像缩放到 224×224,过冻结 DINOv2 ViT-g/14,取最后层 16×16=256 个 patch token $q_p$;(2) 通道维 mean/std 池化拼接成 $s(x) = [\mathrm{Mean}_p(q_p); \mathrm{Std}_p(q_p)] \in \mathbb{R}^{2d}$;(3) 两层 MLP 投影头(LayerNorm+GELU,隐层 512、输出 512)加 $\ell_2$ 归一化得 $e_\theta(x)$;(4) 固定种子的高斯矩阵经 QR 正交化得 $R_{L_0} \in \mathbb{R}^{512\times 256}$(非训练参数,$L_0=256$),按载荷长度 $L \le 256$ 选 $L$ 列,计算 logits $z_\theta(x) = \alpha_\theta R_L^\top e_\theta(x)$,$\alpha_\theta$ 为可学习标度;(5) 二值化 $b_\theta(x) = \mathbf{1}[z_\theta(x) \ge 0]$;(6) 嵌入端计算 $p = m \oplus b_\theta(x)$ 后交给原编码器,验证端 $\hat{m} = D(\tau(x_w)) \oplus b_\theta(\tau(x_w))$;(7) 训练只用 COCO train2017 的 94,629 张图:同图失真对(JPEG Q45–90、模糊 $\sigma$0.3–2.0、噪声 $\sigma$0.005–0.02、裁剪 70–95%、亮度/对比 0.7–1.3)做温度 0.1 的 InfoNCE 对比损失,加 softplus$(\rho - |z|)$($\rho=1$)的二值置信损失与五项码正则(稳定性 $\lambda{=}2$、位平衡 $\lambda{=}5$、位方差 $\nu{=}0.5,\lambda{=}5$、跨图独立 $\lambda{=}1$、位去相关 $\lambda{=}0.05$),AdamW 学习率 $3\times10^{-5}$、batch 256、20 万步。
技术新颖性
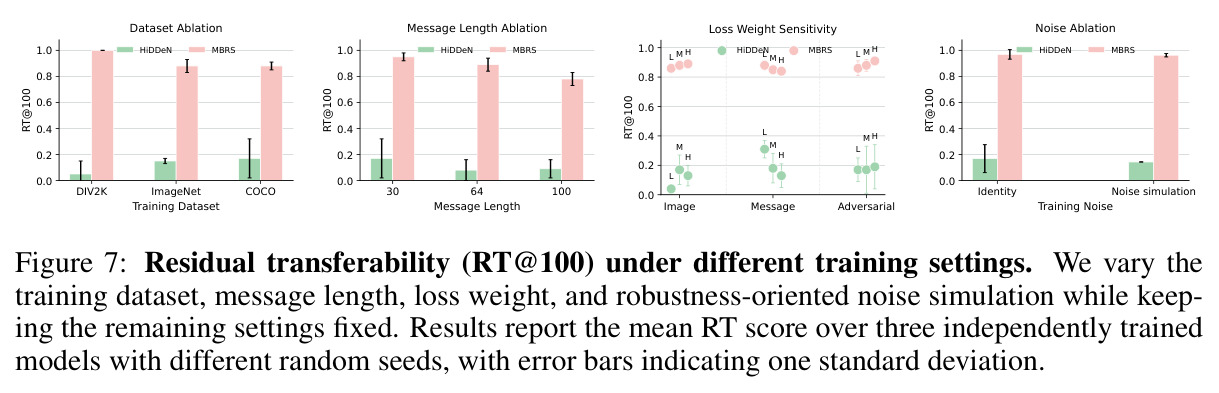
技术新颖性体现在四点。第一,RT 是首个把水印伪造脆弱性从具体攻击中解耦出来的系统级度量:真值残差协议给出攻击成功率的可达上限,使不同系统的可比性不依赖攻击者的实现技巧,也避免防御指标随攻击迭代而失效。第二,归因方法论严格:先排除训练侧因素——换训练集(DIV2K/ImageNet/COCO)、消息长度(30/64/100)、损失权重(高/中/低)、噪声模拟开关都不改变 HiDDeN 低 RT、MBRS 高 RT 的定性格局——再用移植式干预确立因果,且 2×2 消融揭示 broadcast 与 GAP 是耦合而非两个独立开关。第三,把捷径学习引入水印安全分析:高 RT 配置见 $10^2$–$10^4$ 张训练图即达高解码准确率,含低 RT 机制的配置需 $10^4$–$10^6$ 张,说明封面无关通路是更容易学但更危险的解,这为『为什么训练目标相同却学到不同机制』提供了动力学解释。第四,CoverLock 只用自然图像与失真视图训练,不需要水印模型、伪造样本或攻击知识,且通过位平衡、位方差等统计约束保持码近似均匀,使原 Bernoulli 零假设校准继续有效(5 万张 ImageNet 图零误收),这是分类器防御无法提供的攻击无关性保证。
实验结果
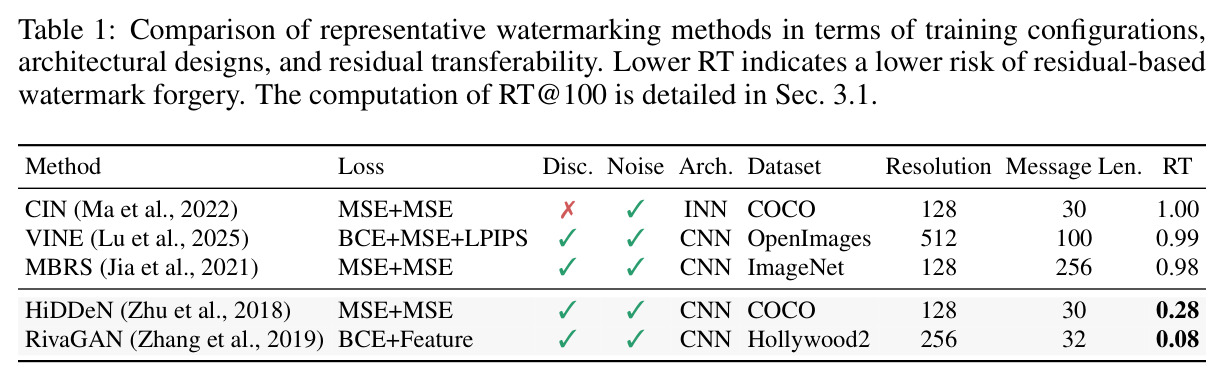
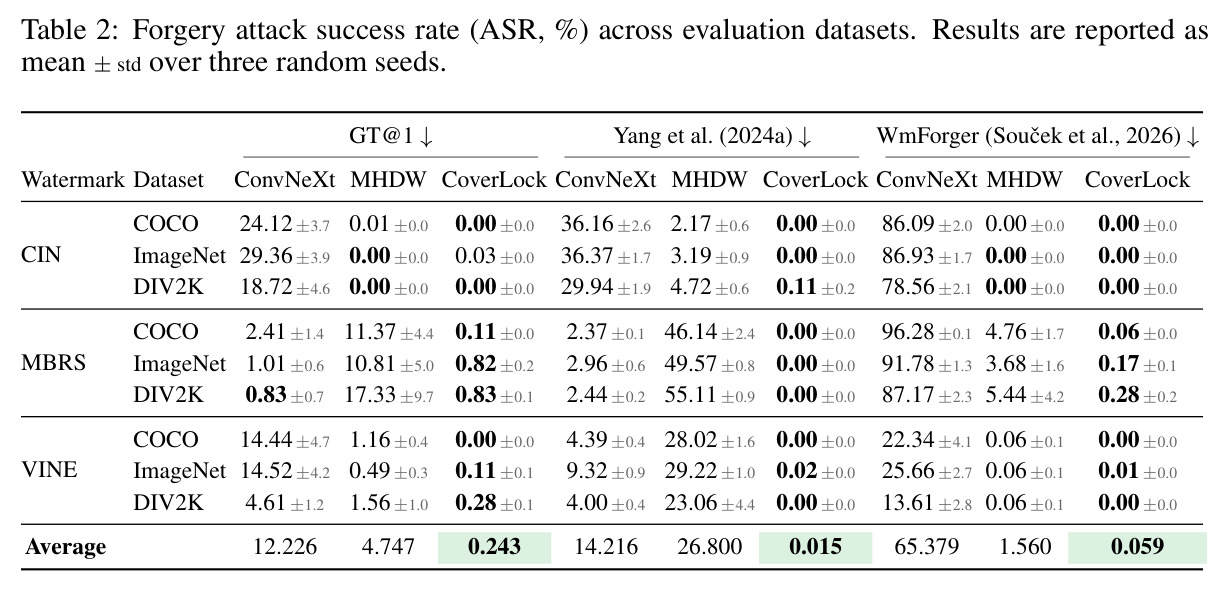
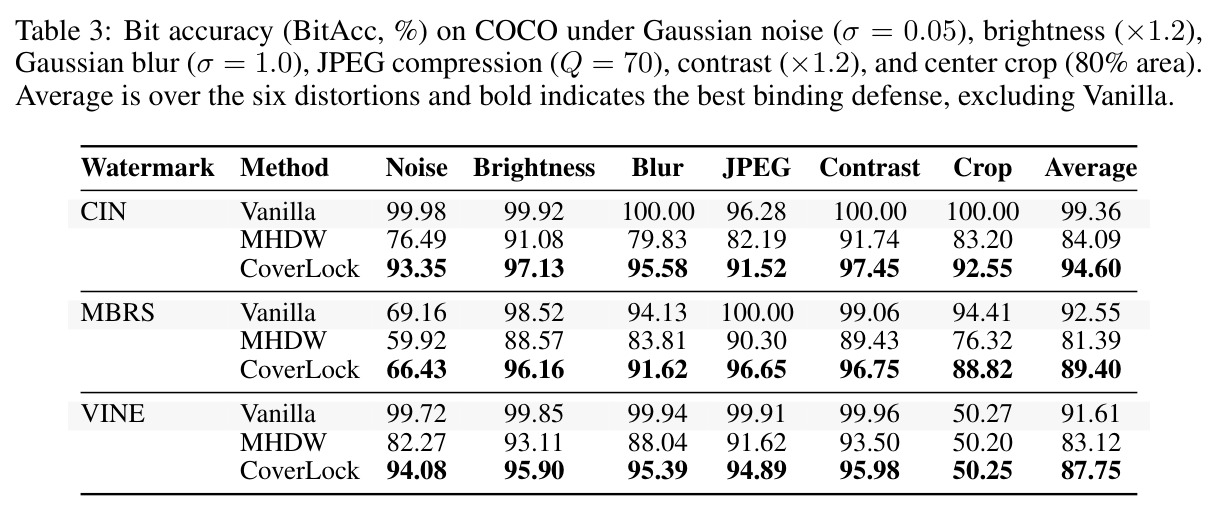
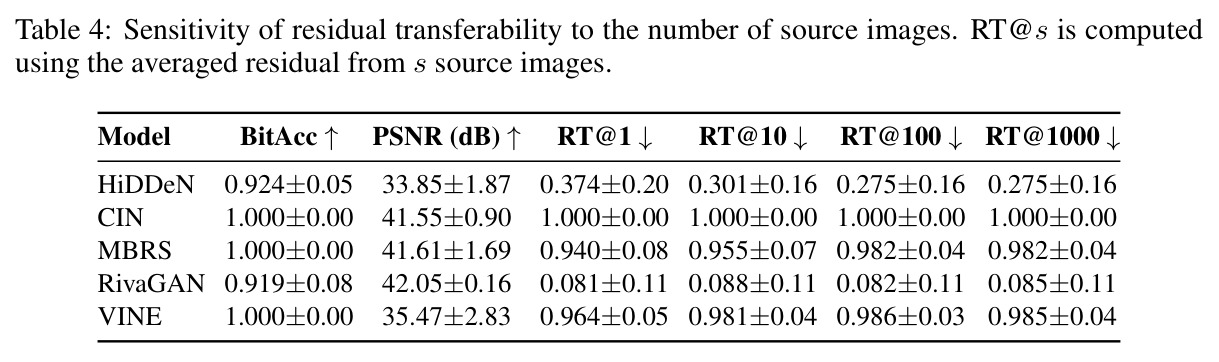
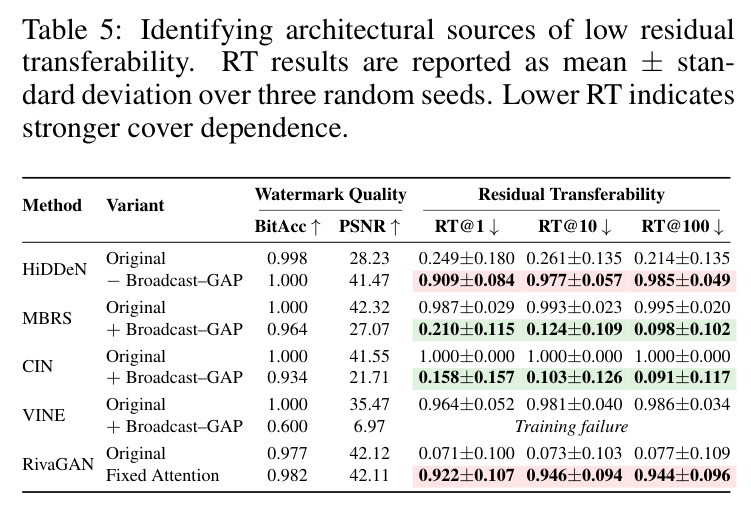
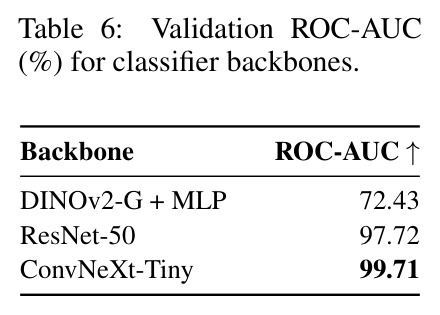
实验分四块。(1) RT 度量(Table 1、Table 4):RT@100 为 CIN 1.00、VINE 0.99、MBRS 0.98、HiDDeN 0.28、RivaGAN 0.08,且源图数从 1 到 1000 时排序稳定(CIN 恒 1.000,RivaGAN 约 0.08);损失、判别器、噪声层、数据集、分辨率、消息长度等训练配置与 RT 无对应关系。(2) 行为签名(Figure 1):高 RT 系统 5 图平均残差图案跨封面几乎一致,低 RT 系统随封面剧变;解码器末层封面诱导方差 MBRS 仅 1.0%、CIN 4.6%、VINE 5.5%,而 HiDDeN 57.3%、RivaGAN 74.1%,与 RT 排序完全吻合。(3) 干预实验(Figure 2/8、Table 5):HiDDeN 去掉 BG 后 RT@100 从 0.214 升至 0.985;MBRS 加 BG 从 0.995 降到 0.098(BitAcc 0.964,PSNR 42.32→27.07dB);CIN 加 BG 从 1.000 降到 0.091(PSNR 21.71dB);VINE 加 BG 训练失败(BitAcc 0.600);RivaGAN 换固定注意力 RT@100 0.944。(4) CoverLock(Table 2/3、Figure 4):三种攻击平均 ASR 为 0.243%(GT@1)/0.015%(Yang)/0.059%(WmForger),全面优于 ConvNeXt 分类器(12.23/14.22/65.38)与 MHDW(4.75/26.80/1.56);无防御时 WmForger 在 MBRS 上 ASR 高达 96.28%。鲁棒性上,六失真平均 BitAcc:CIN 系 CoverLock 94.60 vs MHDW 84.09(Vanilla 99.36),MBRS 系 89.40 vs 81.39,VINE 系 87.75 vs 83.12。安全-鲁棒权衡(MBRS/COCO)上 CoverLock-G 以 TPR 92.50% 达 ASR 0.111%,MHDW 为 ASR 11.367%@TPR 86.38%,分类器要压到低 ASR 时 TPR 跌至约 60%。BER 分解显示优势来自哈希更稳(14.6%→4.2%)而非载荷解码改善(两者载荷 BER 均为 7.4%)。
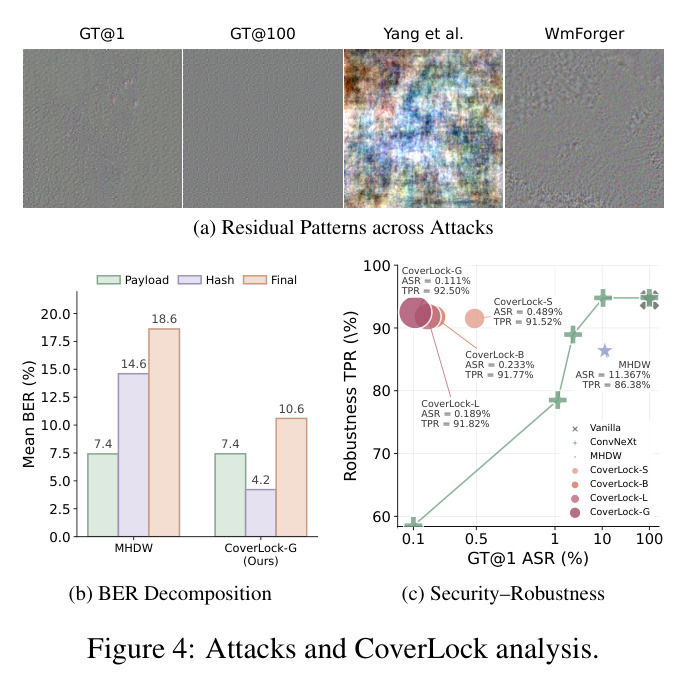
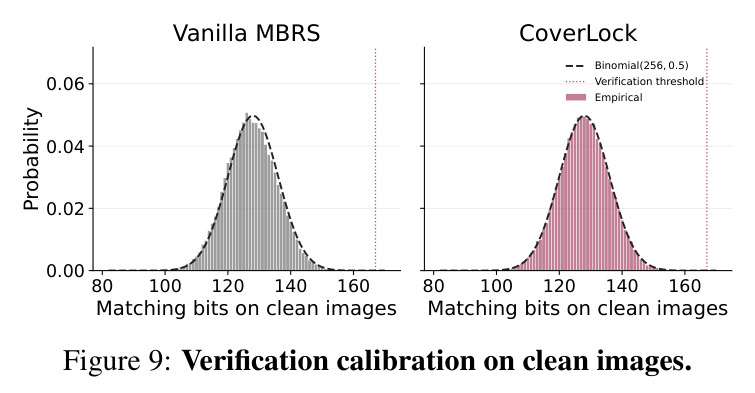
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 残差伪造防御(GT@1 攻击,3 系统×3 数据集平均) | ASR (%) | 0.243 | ConvNeXt 分类器 12.226;MHDW 4.747 | 约为最强基线 MHDW 的 1/20 |
| 残差伪造防御(Yang et al. 100 张参考图) | ASR (%) | 0.015 | ConvNeXt 14.216;MHDW 26.800 | 较 MHDW 降低约 99.94% |
| 残差伪造防御(WmForger 单参考图) | ASR (%) | 0.059 | ConvNeXt 65.379;MHDW 1.560 | 较 MHDW 降低约 96% |
| 六种失真鲁棒性(COCO,CIN) | 平均 BitAcc (%) | 94.60 | MHDW 84.09(无绑定 Vanilla 99.36) | +10.51 个百分点 |
| 六种失真鲁棒性(COCO,MBRS) | 平均 BitAcc (%) | 89.40 | MHDW 81.39(无绑定 Vanilla 92.55) | +8.01 个百分点 |
| 安全-鲁棒权衡(MBRS/COCO) | TPR @ GT@1 ASR | CoverLock-G:TPR 92.50% @ ASR 0.111% | MHDW:TPR 86.38% @ ASR 11.367%;ConvNeXt 低 ASR 时 TPR 约 60% | ASR 降低两个数量级且 TPR 更高,位于帕累托前沿 |
| 架构干预:MBRS 移入 Broadcast–GAP | RT@100 | 0.098 | 原始 MBRS 0.995 | 降低约 90%(代价:PSNR 42.32→27.07dB) |
| 架构干预:HiDDeN 移除 Broadcast–GAP | RT@100 | 0.985(移除后) | 原始 HiDDeN 0.214 | 反向验证:去掉保护设计后 RT 升至接近 1 |
局限与改进
作者在附录 A 承认:安全-鲁棒平衡只在评测的失真范围内成立,更严重或未见的图像变换下可能改变;专门针对图像绑定机制的自适应攻击尚未研究;CoverLock 增加了一个需额外训练与部署的模块;且只识别了两种低 RT 机制,其他架构可能通过不同原理达成内容依赖。我补充几点观察:其一,架构干预的保真度代价非常高——给 MBRS/CIN 加 BG 后 PSNR 从 42.3/41.6dB 掉到 27.1/21.7dB,VINE 干脆训不动,说明『往高 RT 系统里装低 RT 机制』离实用尚有距离,论文未讨论如何弥补画质损失;其二,CoverLock 哈希基于 224×224 的 DINOv2 特征,VINE 下中心裁剪 80% 时绑定方法 BitAcc 只剩约 50.2%(与 Vanilla 相当,因为 VINE 水印本身也在裁剪下崩溃),旋转、透视等更强几何攻击完全未测;其三,载荷长度受 $L \le L_0 = 256$ 限制,长消息系统需要修改投影矩阵;其四,评测只覆盖后处理水印,Tree-Ring、Gaussian Shading 等生成式水印不在范围内;其五,RT 用真值残差度量的是可达上限,真实攻击者的估计质量参差不齐,指标数值与实际风险之间的映射还需更多研究。
独立分析的弱点
独立分析出四点弱点。第一,自适应攻击面:CoverLock 的安全性依赖 $b_\theta(x_t) \ne b_\theta(x_{src})$,若攻击者拿到或逆向出投影头 $\theta$,可以在哈希空间做第二原像搜索——反复微调一张图直到其码与源图一致——论文未评估这类攻击;改进方向是引入密钥化秘密投影、定期换钥,并对哈希做抗碰撞分析。第二,几何脆弱性:DINOv2 特征对裁剪敏感,训练失真分布只含 70–95% 面积裁剪,旋转/透视缺失;改进方向是把旋转不变性或多尺度特征纳入哈希,或扩大训练失真族。第三,架构干预的画质代价:BG 移植使 PSNR 掉 14–20dB,说明封面依赖机制的优化景观本身更难,需要新损失(如感知加权)或渐进训练策略同时保住 PSNR 与低 RT,否则『架构设计指南』难以落地到对画质敏感的生产系统。第四,防御对比范围有限:只与分类器检测和 2006 年的手工哈希 MHDW 比较,未与近年语义绑定方法(如 SemBind)或扩散内生防御对齐评测,CoverLock 在生成式水印上的适用性未知。另外每次验证都要过一遍 ViT-g/14,Giant 骨干的推理开销对高吞吐场景不友好,可蒸馏到小型骨干(不过实验显示小骨干 ASR 会升到 0.489%,需权衡)。
未来方向
作者提出的方向包括:在更严重和未见的失真及分布偏移下检验安全-鲁棒平衡;研究针对图像绑定机制的自适应攻击并发展相应防御;探索 Broadcast–GAP 与内容自适应注意力之外、能达成封面依赖的其他架构原理。基于本文成果还可以延伸:一是把『耦合空间交互』原则嵌入新一代水印训练配方,配合感知损失与渐进训练解决保真度下降,做出低 RT 且高 PSNR 的原生架构;二是把 RT 协议推广为水印安全基准,覆盖视频、音频与模型水印,并定量刻画攻击者残差估计质量与 RT 上限的关系;三是哈希侧改进——密钥化投影、抗碰撞与抗对抗操纵分析、几何鲁棒码本;四是与生成式水印结合,例如把内容绑定码注入扩散去噪轨迹,与 SemBind 等语义绑定方法统一评测;五是从捷径学习视角出发,把『收敛所需图像量』作为安全风险的预警信号,推广到其他安全敏感任务中『容易学的解』与『安全的解』发生偏离的场景。
复现评估
复现条件相当友好。数据与模型全部公开:COCO train2017(118,287 张,按 80/20 划分训练/验证)、DIV2K、ImageNet;五个水印系统(HiDDeN、MBRS、CIN、VINE、RivaGAN)均有开源实现与预训练权重;DINOv2 为公开基础模型。CoverLock 本身只训练轻量投影头与标度 $\alpha_\theta$(两层 MLP,512 维),AdamW 学习率 $3\times10^{-5}$、batch 256、20 万步,单张消费级 GPU 即可完成;附录 B 给出全部超参(五项正则系数、$\rho=1$、对比温度 0.1、失真分布区间)。较重的部分是架构干预实验:需要用统一设置重训 HiDDeN/MBRS/CIN 的原版与改造版(各三个随机种子)以及为基线训练 ConvNeXt 分类器,但都是单模型规模的训练任务。论文承诺开源 CoverLock 实现(撰写时未发布);RT 协议使用真值残差,无需任何攻击代码即可复现核心结论。综合评估:复现 CoverLock 与主表结果难度中等偏低,完整复现干预研究需数倍算力与工程耐心。
论文图表
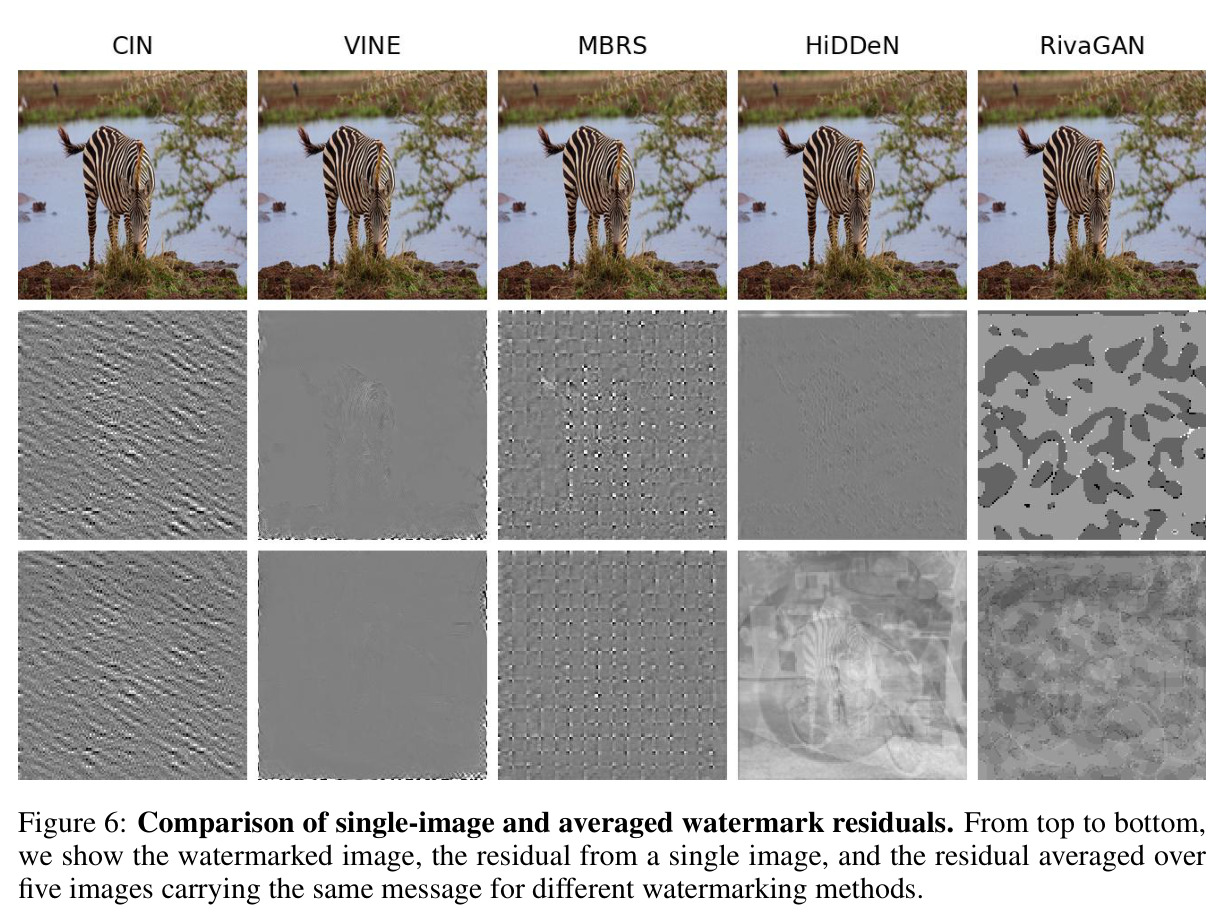
各方法的水印图、单图残差与 5 图平均残差对比:单图残差残留封面结构(编码器重建误差造成『伪内容依赖』的假象),平均 5 张后内容消失、高 RT 系统的公共水印结构清晰显现。
警告『残差看起来依赖图像』可能是误导,为 RT 度量采用残差平均提供方法论依据。