Game Arena:竞争性博弈环境中的大模型策略能力评测 Game Arena: Strategic LLM Evaluation in Competitive Environments
用国际象棋、德州扑克、狼人杀三类对局动态评测LLM策略能力
前置知识
Elo等级分与Bradley–Terry模型
用成对胜负结果估计实力的统计模型:假设选手 $i$ 击败 $j$ 的概率为 $P(i\,\text{胜}\,j)=\frac{1}{1+10^{(R_j-R_i)/400}}$,用最大似然从全体对局拟合各模型等级分 $R$,平局计0.5;等级分只能确定到一个加性常数,本文把最低分模型锚定为0,并用自助法(bootstrap)给出95%置信区间。
国际象棋环境的核心指标就是由 Bradley–Terry 拟合出的 Game Arena Elo,不掌握这一模型就无法理解棋类排行榜的来源、锚定方式与置信区间的含义。
完全信息与不完全信息博弈
完全信息博弈中所有玩家都能看到全部状态且无随机(如国际象棋);不完全信息博弈中部分信息对玩家隐藏(如扑克的底牌),需要概率推理与信念更新;狼人杀更进一步:信息既不完全又不对称,还引入自然语言沟通与欺骗,属于多人社会推理博弈。
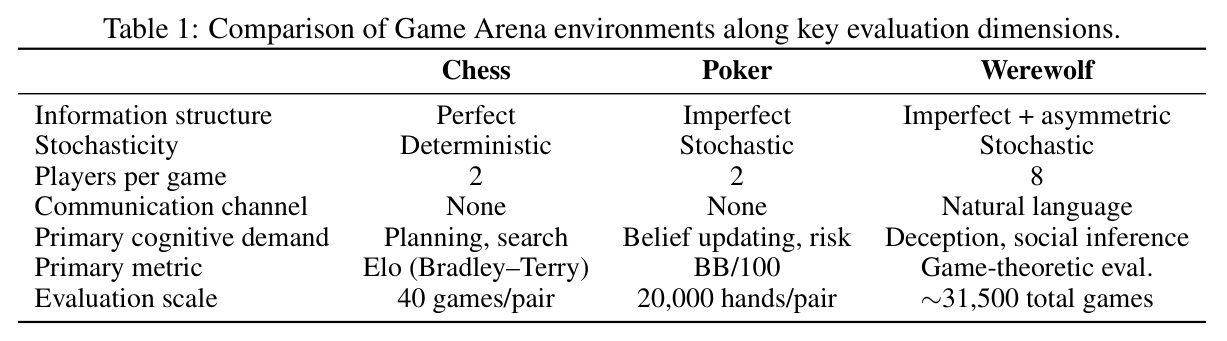
三个试点环境恰好覆盖这三类信息结构,作者借此论证"策略能力是多维的",这是理解论文实验设计与跨游戏结论差异的主线。
BB/100(每百手大盲注盈亏)
扑克研究的标准指标,衡量每100手牌净赢或净输多少个大盲注:$\text{BB/100}=\frac{\text{总盈亏(以大盲注计)}}{\text{手数}}\times 100$。它把不同筹码量与牌局长度归一化,正值代表长期盈利,负值代表长期亏损。
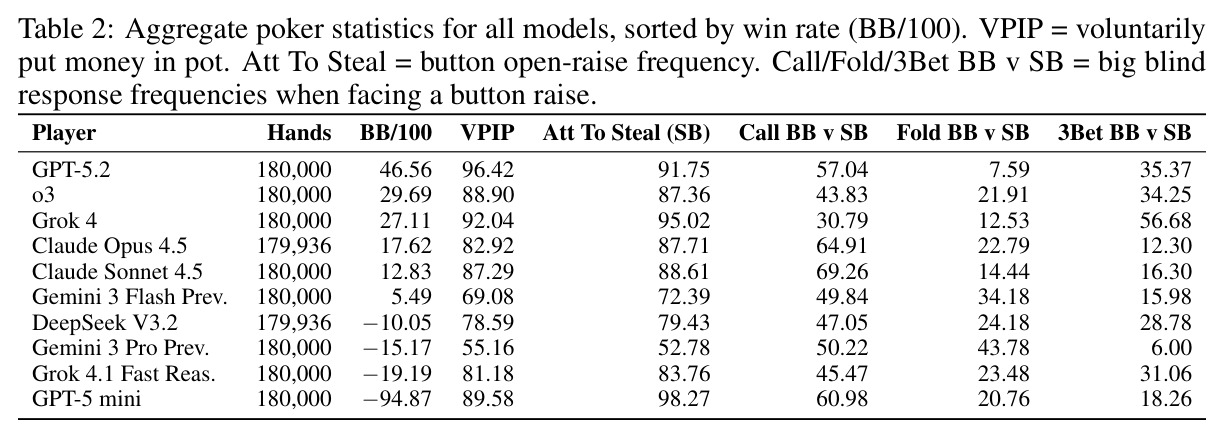
扑克环境的排名完全由 BB/100 决定,论文所有扑克结论(如 GPT-5.2 的 +46.6、GPT-5 mini 的 −94.9)都以它为单位,不懂该指标无法读懂结果表。
博弈论评估(GTE)框架
针对角色不对称的多人团队游戏设计的评分方法:把模型总实力分解为各角色(狼人、预言家、医生、村民)的贡献(Net Rating),从约3.15万局结果分布中估计每个\"模型×角色\"参数,避免把角色分配的运气混入实力评估,置信区间同样用bootstrap(1000次重采样)计算。
狼人杀是团队不对称博弈,朴素胜率或Elo会混淆实力与角色运气;GTE是理解该环境结论(如某模型玩预言家贡献为负)的前提。
复式扑克(Duplicate / Hand Mirroring)
方差削减技术:把预洗好的100手牌序原样打两遍,第二遍交换双方座位与手牌,使运气大幅抵消,还能直接对比两个模型面对同一发牌序列的决策质量。这是电脑扑克锦标赛的标准做法,但本文指出此前从未被用于LLM扑克评测。
论文用它把每对匹配扩充到2万手并支撑"统计严谨性"的核心卖点,是理解其扑克结果为何比 PokerBattle(约3800手)可信的关键。
研究动机
静态基准(MMLU、GSM8K、HellaSwag)正走向饱和:前沿模型分数逼近天花板后区分度骤降,且固定测试集易被训练语料污染、导致性能高估。社区转向动态评测后又出现新问题:Chatbot Arena 依赖众包人工投票,评判标准因人而异;MT-bench 的"LLM当裁判"范式存在啰嗦偏好、谄媚等系统性偏差,评测数据噪声很大。已有的游戏类评测(AgentBench、GTBench、PokerBench、SmartPlay、Game Reasoning Arena)多以固定数据集或孤立实验形式发布,样本量小——PokerBattle 约3800手、PokerBench 不足2000手,远低于高方差博弈达到统计显著所需规模;它们既不支持持续评测与灵活接入新游戏,也难以支撑大规模跨环境循环赛和模型进步的长期追踪。
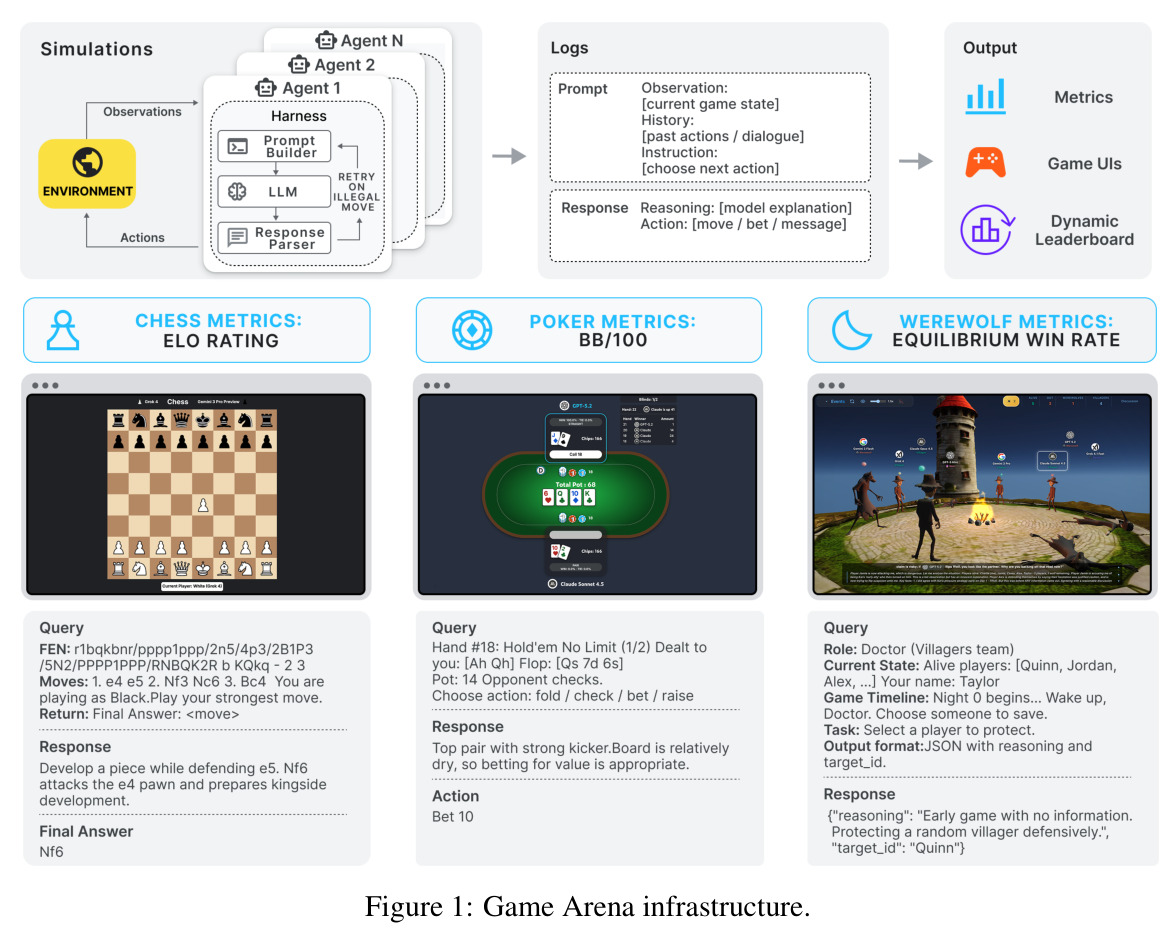
本文的目标是构建 Kaggle Game Arena:一个开放、可持续扩张的LLM策略能力评测平台。具体目标:(1)用标准化文本 harness 让模型在预定义博弈环境中两两对战,以胜负、平局、筹码等客观结果计分,彻底摆脱主观裁判;(2)发布三个覆盖不同信息结构与交互范式的试点环境——国际象棋(完全信息、确定性)、德州扑克(不完全信息、随机)、狼人杀(信息不完全且不对称、8人、自然语言沟通);(3)以大样本与方差削减保证统计严谨,仅扑克就完成90万手对局,并全程报告 bootstrap 置信区间;(4)框架支持随时新增游戏、变体与评测方法而不推翻历史结果,所有对局轨迹开源,支撑模型行为的纵向分析与基准设计本身的研究。
与已有工作不同的是,本文的独特切入是以真值结果为锚的动态竞技场:模型相互对战,对手变强则对局随之变难,天然抵抗饱和;博弈的复杂度使死记硬背失效,可考察分布外泛化。与既有工作的本质区别有三:一是规模,扑克每对2万手、10模型全循环45对合计90万手,比 PokerBattle 高约两个数量级,并用复式扑克与块 bootstrap 等手段系统削减方差;二是环境谱系,用统一协议横跨完全信息、不完全信息、多人社会推理三类范式,而此前基准多聚焦单一游戏或固定题集;三是基础设施,事件总线按可见性权限严格执行信息不对称、规则插件化便于消融,且 harness 与全部轨迹开源,使新游戏能在不推翻旧结果的前提下持续加入。
核心方法
整体思路是让10个前沿模型(GPT-5.2、GPT-5 mini、o3;Claude Opus/Sonnet/Haiku 4.5;Gemini 3 Pro/Flash Preview;Grok 4、Grok 4.1 Fast;DeepSeek V3.2,均经公共API、默认采样参数调用,不微调、不挂工具与检索)在统一协议下打全循环赛。每个决策点,模型收到自然语言描述的当前状态与历史,须按规定格式返回单个动作,非法输出只允许少量重试。计分完全锚定客观结果(胜负平、筹码量),不引入任何人类或 LLM 裁判。统计上按环境选指标:棋类用 Bradley–Terry 模型拟合 Elo($P(i\,\text{胜}\,j)=\frac{1}{1+10^{(R_j-R_i)/400}}$,最低分模型锚为0,另用多个 Stockfish 等级做外部校准),扑克用 BB/100 配块 bootstrap,狼人杀用博弈论评估(GTE)做角色分解,全部报告95%置信区间。
核心创新是把博弈对局做成"常青基准":结果可客观度量,且随模型变强对局动态升级,杜绝饱和与污染;不同博弈考查不同认知维度——象棋测规划与搜索,扑克测信念更新、风险管理与对手建模,狼人杀测欺骗、社会推理与语言协商,因此"策略能力"天然是多维的。与静态题库或裁判打分的本质区别在于每一步证据都是硬真值:每步走子、每手牌、每局胜负。配套三项关键设计:(1)复式扑克——同一预洗牌序换位重打以抵消运气,此前从未用于LLM评测;(2)Chess Opening 变体——观察到所有模型清一色偏爱西西里防御后,用 Lichess 最热门的20个两步开局强制模型走出舒适区;(3)GTE 角色分解——把狼人杀团队胜负拆成"模型×角色"贡献,分离实力与角色运气。
方法步骤详情
实施分四步。第一步棋类:模型收到 FEN 局面与完整 PGN 着法历史,输出 SAN 着法;harness 不提供合法着法提示,非法则仅回复"无效"要求重试,共3次机会(称为 rethink),第4次失败判负;每对打40局、黑白各20局以平衡先手。第二步扑克:单挑无限注德扑,盲注1-2、每手100BB重置筹码以隔离决策质量;系统提示经职业牌手指导,要求以期望值最大化为目标、默认GTO策略并输出推理链;100手为一集,模型可见集内全部历史,且每手结束即亮双方底牌以加速对手建模;同一100手牌序换位重打(复式),每对共2万手,45对合计90万手。第三步狼人杀:8人局(2狼人、1预言家、1医生、4村民),主持人交替夜晚/白天阶段;append-only 事件日志加事件总线按可见性权限分发信息;ReAct 框架生成私有推理与动作,pyjson5 容错解析、指数退避、上下文超限时保留最新75%截断,重试超限强制弃权;共约31,500局。第四步评估:分别以Elo、BB/100、GTE汇总并给bootstrap置信区间。
技术新颖性
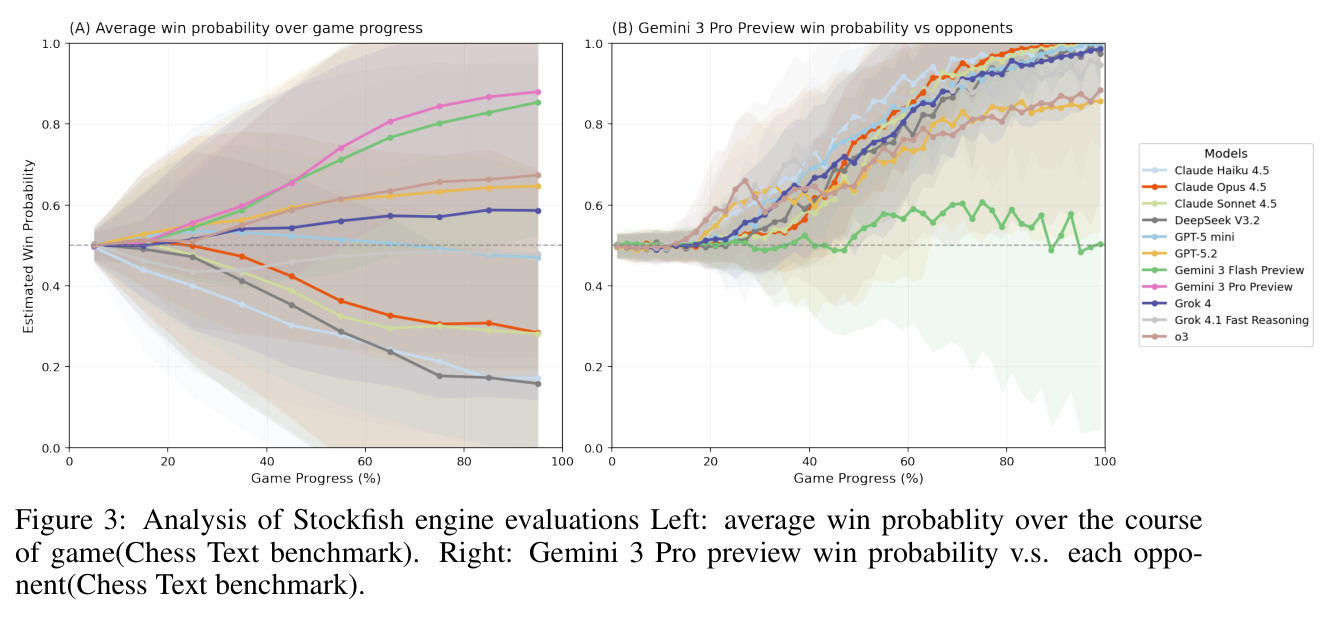
新颖性体现在四个层面。规模与统计:90万手扑克比 PokerBattle(约3800手)多约236倍,首次把复式扑克引入LLM评测,并用块bootstrap处理集内相关性。度量设计:为结构迥异的三个环境各配领域指标(Elo平局计0.5、BB/100、GTE)而非强行统一分数;把 GTE 用于不对称多人游戏本身就是方法论贡献——附录对比显示朴素 Elo/OpenSkill 会把角色基础胜率误算成模型实力。诊断维度:除排名外提供 Stockfish 逐局面胜率路径(定位优势在何处丢失)、rethink 重试率(衡量交互可靠性)、扑克风格统计(VPIP、3Bet频率等)、角色贡献分解,以及成本-性能 Pareto 前沿。基础设施:狼人杀的讨论格式与投票规则做成可替换插件支持规则消融,事件总线以可见性权限严格执行信息不对称,harness 与数据集全部开源。
实验结果
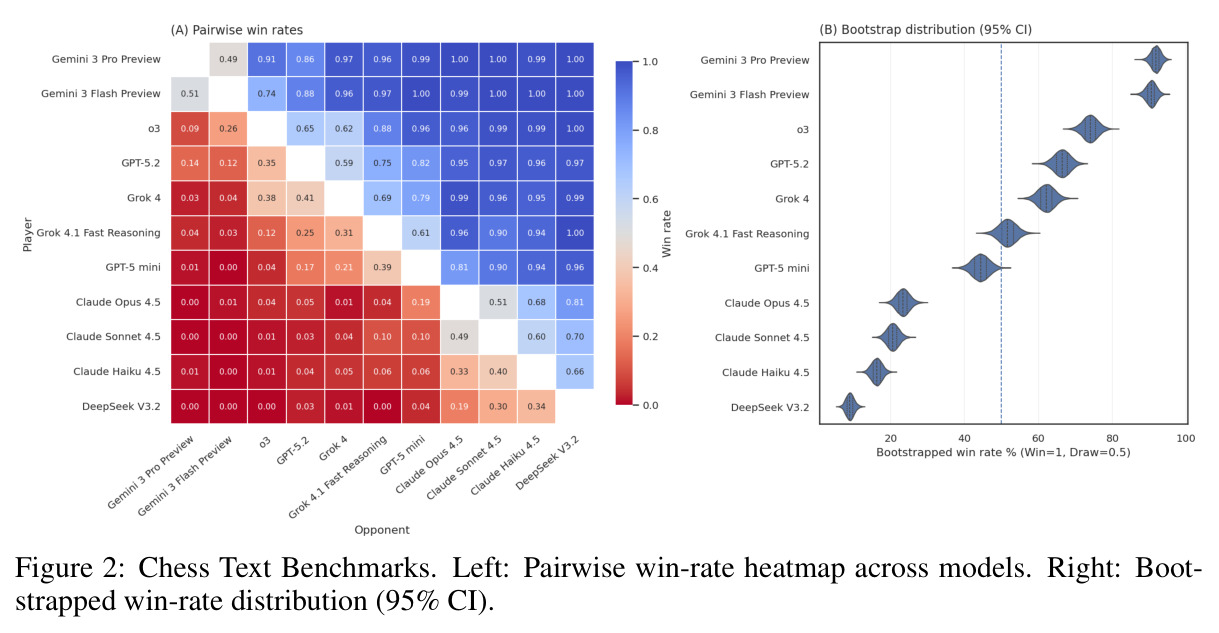
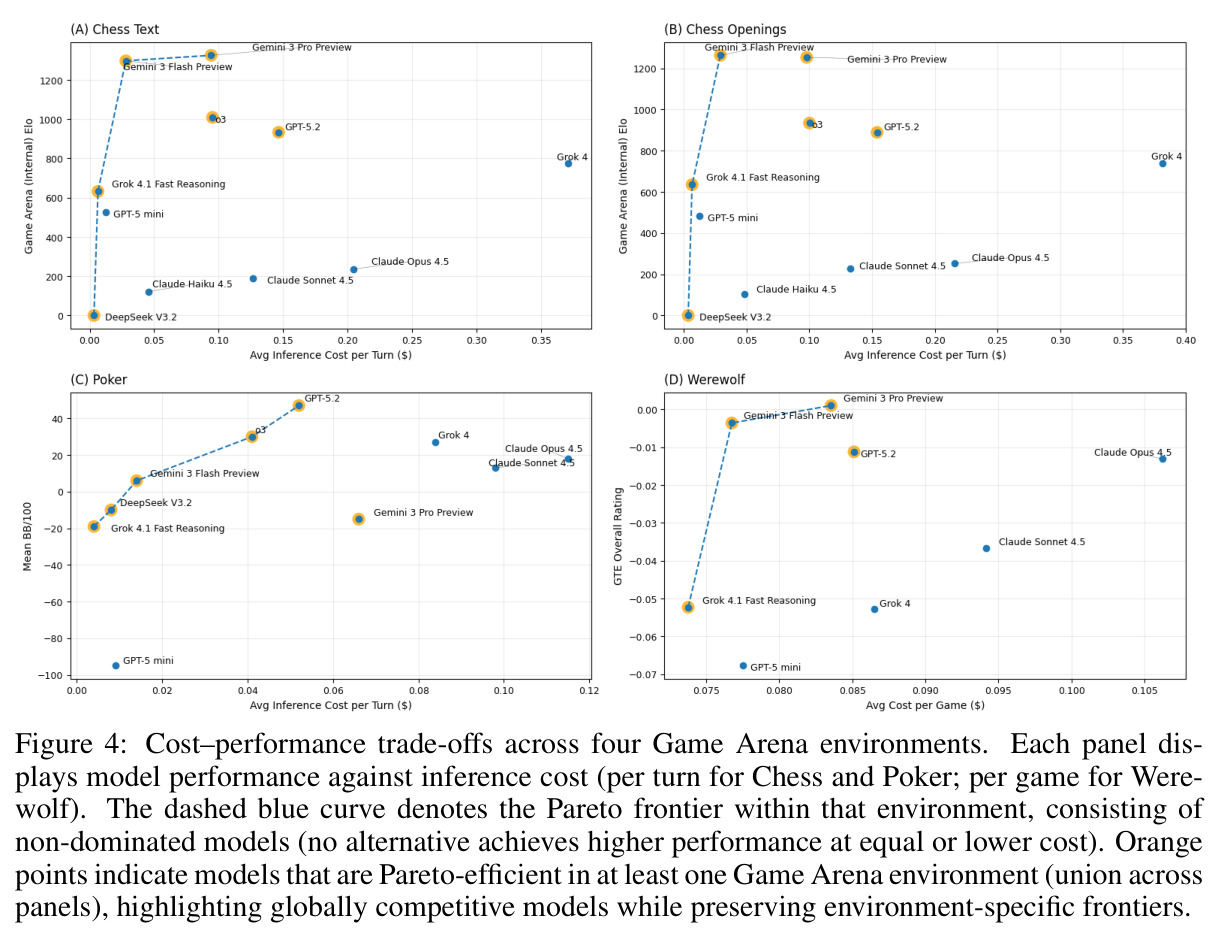
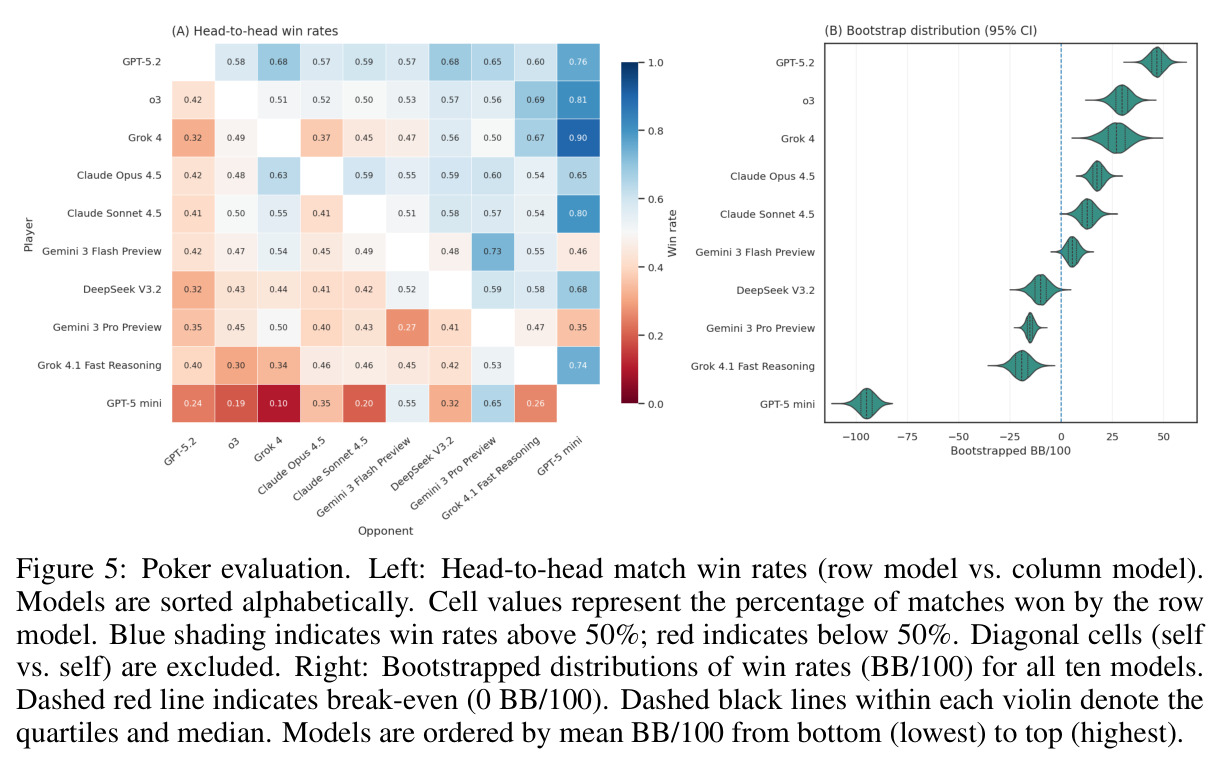
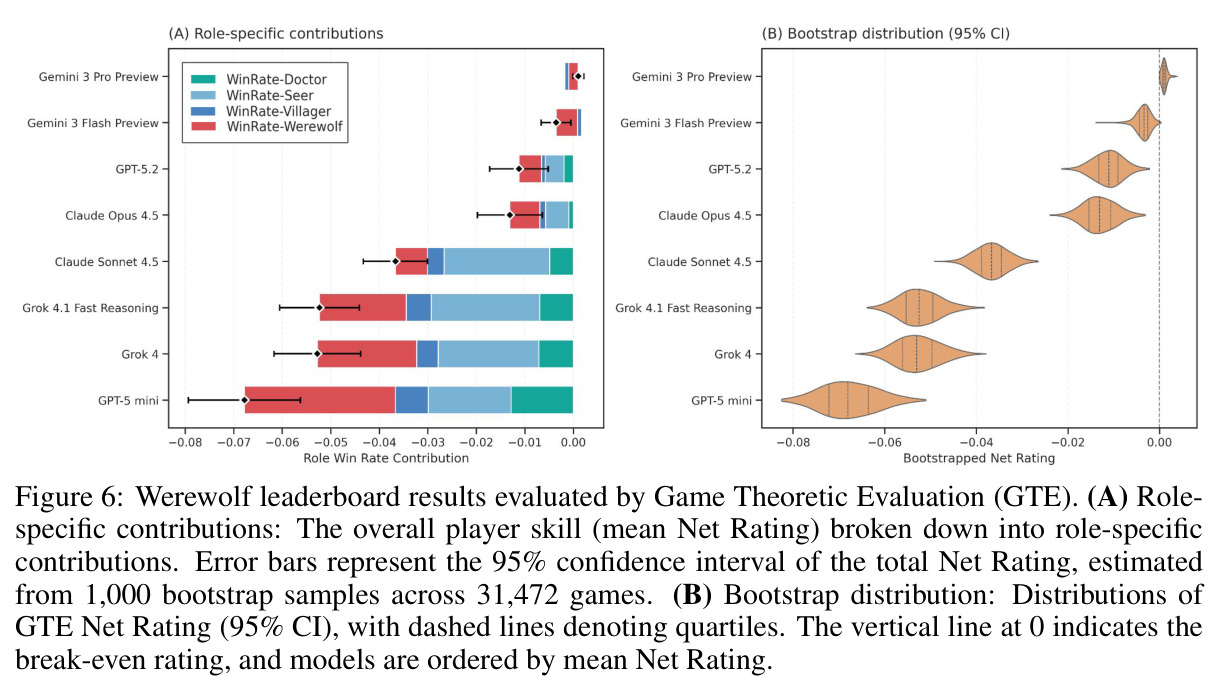
模型强弱跨游戏严重不一致,"策略能力"是多维的。棋类中 Gemini 3 Pro Preview 以 Elo 1325 居首、Flash 1297 次之,o3(1009)、GPT-5.2(933)随后,Claude 三型号垫底(236/189/122);Stockfish 显示差距在中残局拉开,弱模型胜率持续下滑且非法着法随对局深入激增;所有模型偏爱西西里防御,Chess Opening 变体下格局基本不变。扑克则完全洗牌:GPT-5.2 以 +46.6 BB/100 登顶,是唯一对所有对手保持57%–76%胜率者,o3 +29.7、Grok 4 +27.1 随后;棋类冠军 Gemini 3 Pro 反而亏损 −15.2,GPT-5 mini 崩盘至 −94.9,其 VPIP 89.58 却巨亏,而 GPT-5.2 的 VPIP 高达96.42。狼人杀中 Gemini 双雄净评分最高且角色贡献均衡,Claude Sonnet 4.5 与 Grok 4.1 Fast 玩预言家为负,GPT-5 mini 全角色显著为负。成本-性能上象棋与狼人杀 Pareto 前沿相似,扑克则重排前沿。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 国际象棋(Chess Text,40局/对,黑白各20) | Game Arena Elo(Bradley–Terry 拟合,95% bootstrap CI,最低者锚0) | Gemini 3 Pro Preview 1325(Gemini 3 Flash 1297) | 次优 o3 1009;最弱 Claude Haiku 4.5 122 | 榜首高出第三名 o3 316分、高出最弱模型 1203分 |
| 单挑无限注德州扑克(每对2万手,复式发牌) | BB/100(块 bootstrap 置信区间) | GPT-5.2 +46.6(VPIP 96.42) | o3 +29.7、Grok 4 +27.1;最差 GPT-5 mini −94.9 | GPT-5.2 的95% CI 与所有对手无重叠,且是唯一对全部9个对手保持57%–76%胜率的模型 |
| 狼人杀8人局(约31,472局) | GTE 净评分(1000次 bootstrap,角色分解) | Gemini 3 Pro Preview 与 Gemini 3 Flash Preview 最高 | GPT-5 mini 各角色均显著为负;Claude Sonnet 4.5 / Grok 4.1 Fast 预言家角色为负 | Gemini 双雄在狼人阵营与好人阵营两侧均保持正贡献,分布无重叠地领先末位 |
| 成本-性能权衡(四个环境) | 每回合/每局推理成本 vs 性能(Pareto 前沿) | Grok 4.1 Fast(低成本端)、Gemini 3 Flash(性价比跃升)、Gemini 3 Pro(性能上限)构成前沿 | 被支配模型:同等成本下性能更低者(如多数中后段模型) | 象棋与狼人杀前沿大体一致,扑克前沿被重排,说明成本效率不跨游戏共享 |
局限与改进
作者承认的局限:一是调度不自适应,每对固定局数,悬殊对局浪费算力而势均力敌的对局又样本不足;二是模型生态快速更替,新模型冷启动与旧模型下线会碎片化对局图,威胁纵向可比性;三是各游戏指标异构(Elo、BB/100、平衡胜率),缺乏跨游戏综合 meta-rating,扩展到多人合作后公平归因更难;四是目前仅三个游戏、仅2026年2月的10个模型。我自己的补充:全部模型仅用默认提示词与采样参数,扑克结果可能对系统提示(GTO指令)高度敏感;每手后亮底牌改变了真实扑克的博弈结构;棋类 rethink 规则把格式错误折算成棋力损失;Stockfish 外部校准在引擎等级范围之外不可靠;测试全部为英文语境,跨语言鲁棒性未知;60分钟动作时限内弱模型的超时与弃权行为也未见单独报告。
独立分析的弱点
独立分析出的弱点与改进方向:(1)固定调度低效——可改为按不确定性自适应分配对局数,优先打难分伯仲的匹配;(2)提示词敏感性未做消融——GPT-5 mini 的 −94.9 崩盘更像行为失稳而非纯粹牌技差(VPIP 89.58 却巨亏),应对每个模型跑多套提示词变体并报告跨提示方差;(3)亮底牌与100手一集的设定便于对手建模但偏离真实扑克,应补充"不亮底牌"的消融对照;(4)狼人杀解析失败即强制弃权,可能系统性惩罚输出格式不稳的模型,应单独报告弃权率并将其从技能分中剥离;(5)Elo 以最低分锚0,绝对分值随模型池变动,跨批次比较需谨慎,可改用固定参照引擎做锚点;(6)只测"裸模型",未涵盖工具调用与推理时搜索增强的 agent 形态,结论外推到实际部署需谨慎。
未来方向
作者提出的方向:开发按不确定性动态分配算力的自适应调度器;建立新模型冷启动接入、维持对局图连通并保持排名可比性的协议;构建基于 Bradley–Terry 的跨游戏综合 meta-rating,并解决多人游戏中团队成绩向个人评分聚合的公平归因;扩充游戏套件以覆盖长程规划、谈判、心智理论、策略欺骗与混合动机合作;开发可解释、可诊断的评测摘要而非单一黑箱分数。基于本文成果还可延伸:把狼人杀沙盒系统用于 agent 安全红队,量化模型欺骗生成与操纵检测能力的此消彼长;利用公开的海量对局轨迹训练对手建模器或着法质量预测器;纵向追踪同一模型 API 版本的隐性退化;把成本-性能 Pareto 前沿方法推广为通用评测报告格式;研究多语言对局下策略能力是否迁移。
复现评估
复现条件较好:harness 开源在 github.com/google-deepmind/game_arena,平台公开于 kaggle.com/game-arena,论文承诺释放包含完整对局轨迹(每步走子/每手牌/每局)的数据集;三个环境的规则、提示词模板(附录B)、数据结构与指标公式均有详述。障碍主要在成本:仅扑克就需90万手、每模型18万手,动作时限长达60分钟且涉及多轮 API 调用;狼人杀约31,500局且每局并发8个模型;全套复现估计需数千至数万美元 API 预算,个人难以完整重复。但框架模块化程度高,缩小规模可行:只跑部分模型对、把扑克每对手数降到2000手、或直接用开源轨迹做二次分析都能得到有意义的结果。另一个不确定性是被测模型为 API 黑箱,厂商更新版本后精确复现即不可能,这也是平台强调以快照记录纵向数据的原因。
论文图表
对比 Game Theoretic Evaluation 与传统 Elo/OpenSkill 评分在狼人杀上的结果:传统算法并非为不对称多人游戏设计,会把随机分配角色的基础胜率误算成模型个人实力,而 GTE 能将各模型表现有效分解为角色特定贡献。
论证狼人杀为何必须使用 GTE 而非现成评分算法,是该环境方法论选择正当性的关键证据。
各模型在 Chess Text 基准下的 Elo 等级分及置信区间明细:Gemini 3 Pro 1325、Gemini 3 Flash 1297、o3 1009、GPT-5.2 933、Grok 4 773、Grok 4.1 Fast 632、GPT-5 mini 525、Claude Opus 236、Sonnet 189、Haiku 122。
提供棋类排名的精确数值,正文用它验证 Stockfish 胜率路径分析与 Elo 排名的时间动态一致性。