检索式开放式评估为何失效:从长篇医学答案事实性验证自动归纳错误分类体系 Where Does Retrieval-Based Open-Ended Evaluation Fail? Automatic Taxonomy Induction from Long-Form Medical Answer Factuality Verification
提出可自动归纳的错误分类体系,揭示检索-验证流水线在开放式医学事实核查中的结构性失效
前置知识
RAG 与检索-验证(retrieve-then-verify)流水线
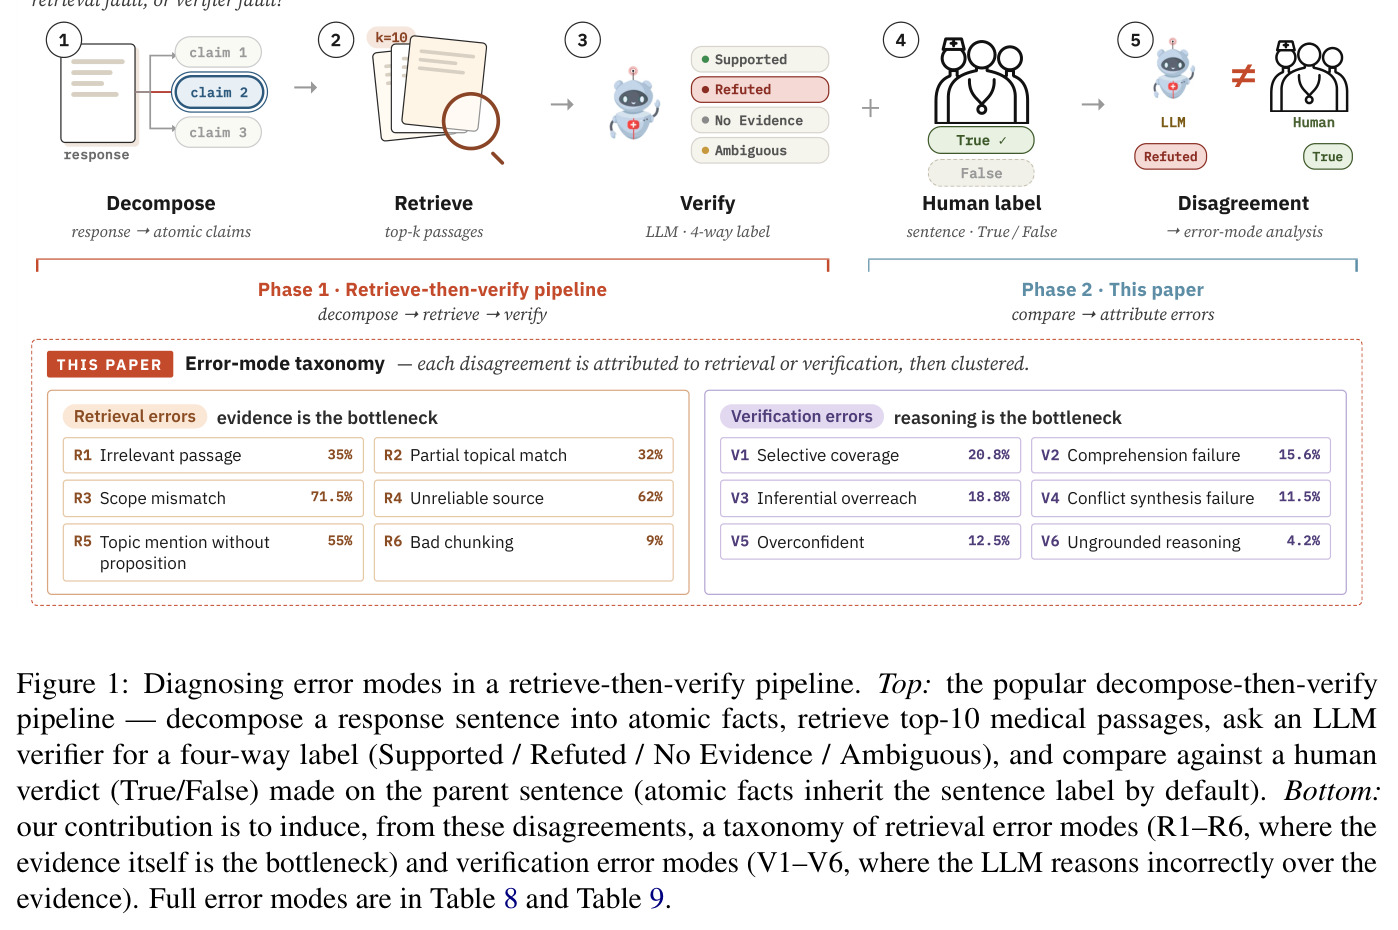
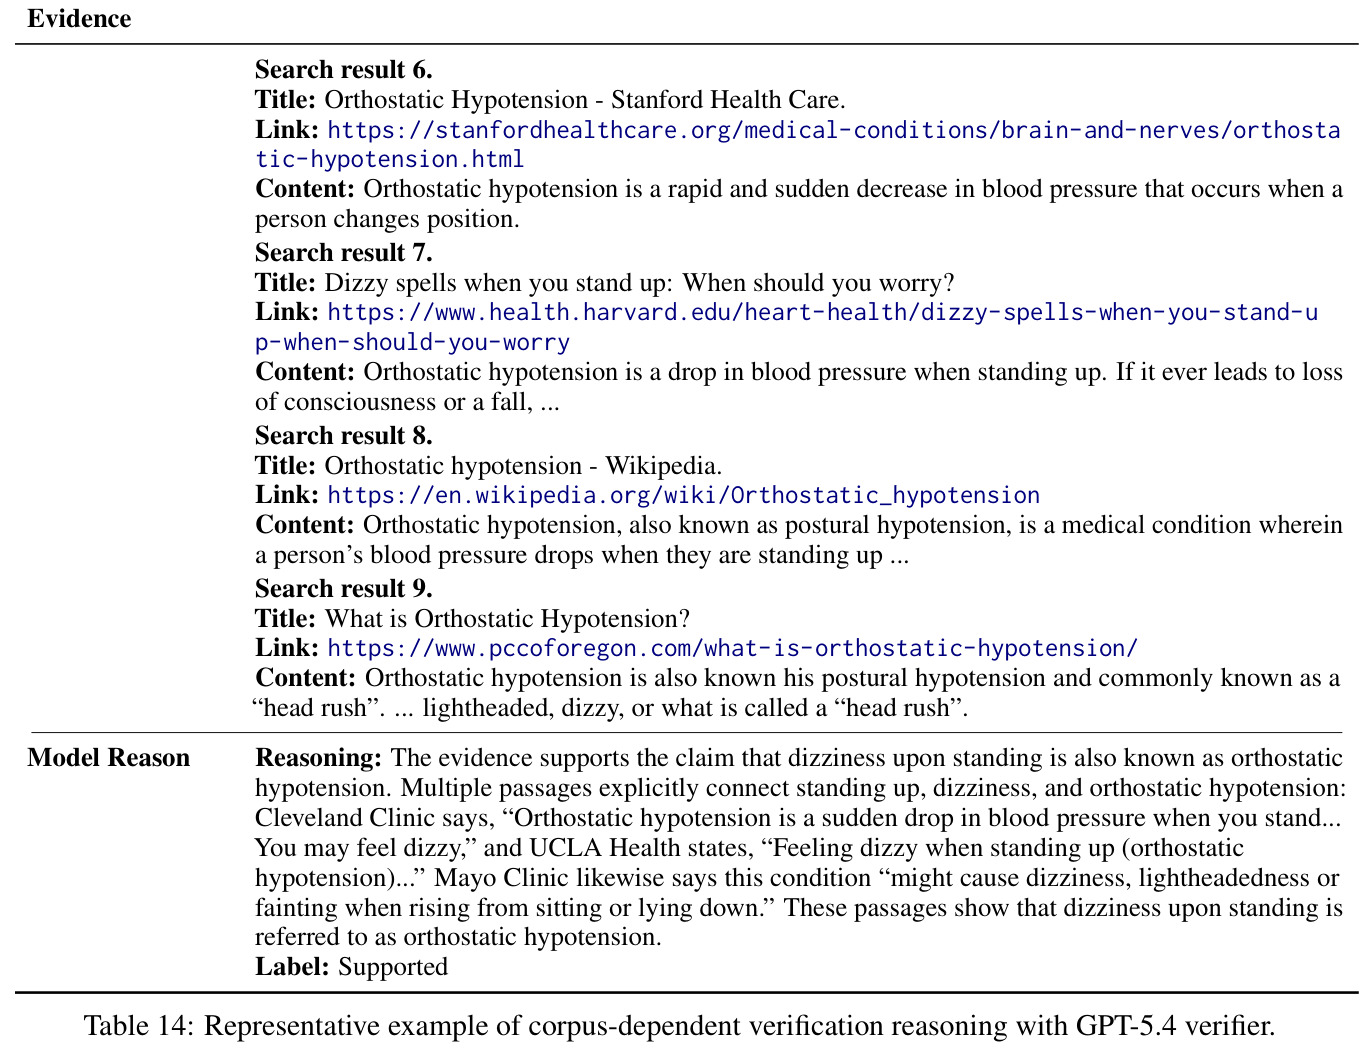
检索增强生成(RAG)先从外部语料检索相关文本再生成答案;事实性评估中的检索-验证流水线则把 LLM 的长答案拆成原子声明(atomic claims),以每条声明为查询检索 top-$k$ 个证据段落,再由验证 LLM 逐条给出 Supported/Refuted 等判决。FActScore 与 MedScore 都是这一“分解-检索-验证”范式的代表。
本文的全部工作就是诊断这条流水线在开放式医学场景下每一环如何失效,不理解该范式就无法理解错误分类的对象与归因逻辑。
开放式 vs 封闭式事实核查
封闭式基准(如 FEVER、SciFact)先有人工策划的声明和金标证据语料,可以直接用 precision@$k$、recall@$k$ 评估检索器,并把检索错误与验证错误干净分离。开放式设定中声明来自模型自由生成的长答案,没有金标答案也没有金标证据——声明甚至可能是语料中毫无支撑的参数化编造,使证据 recall 在原理上无法定义。
论文的核心命题正是:现有封闭式 RAG 诊断工具(RAGChecker、MedRAGChecker 等)在开放式 regime 全部失效,必须发明无需金标的诊断方法。
四分类判决与标签映射
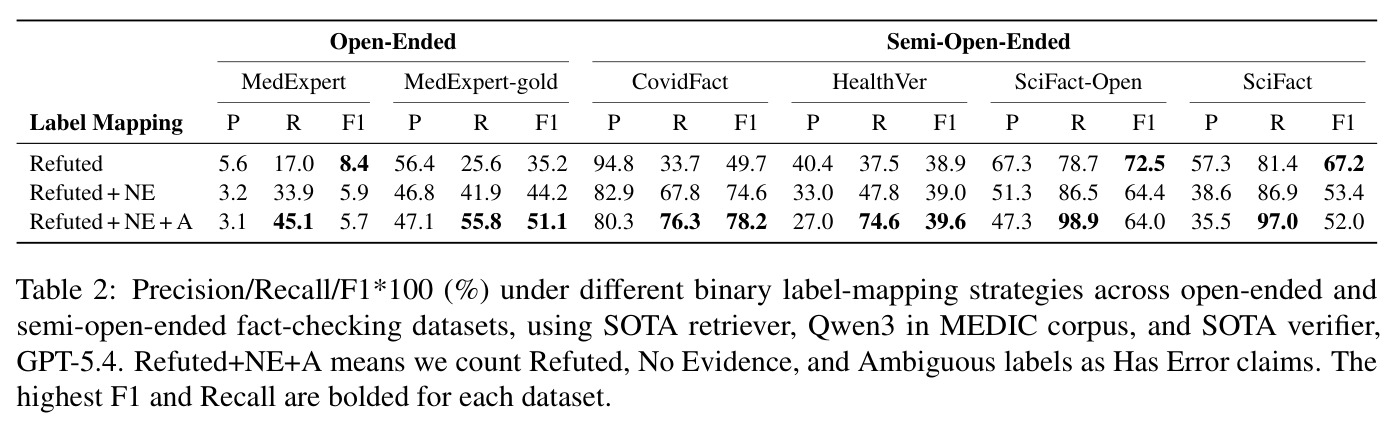
论文把常见的二分类验证扩展为四类:Supported(证据支持)、Refuted(证据反驳)、No Evidence(证据无关或不足)、Ambiguous(证据相互冲突)。汇报 P/R/F1 时需把四类折叠成二分类,文中比较了三种映射策略:仅 Refuted 记为“有错”、Refuted+NE、Refuted+NE+A 记为“有错”。
所有主表(Table 2 等)的召回率与 F1 都依赖映射策略,理解映射才能正确解读开放式与封闭式数据集之间的巨大性能落差。
LLM-as-Judge 与错误模式自动归纳
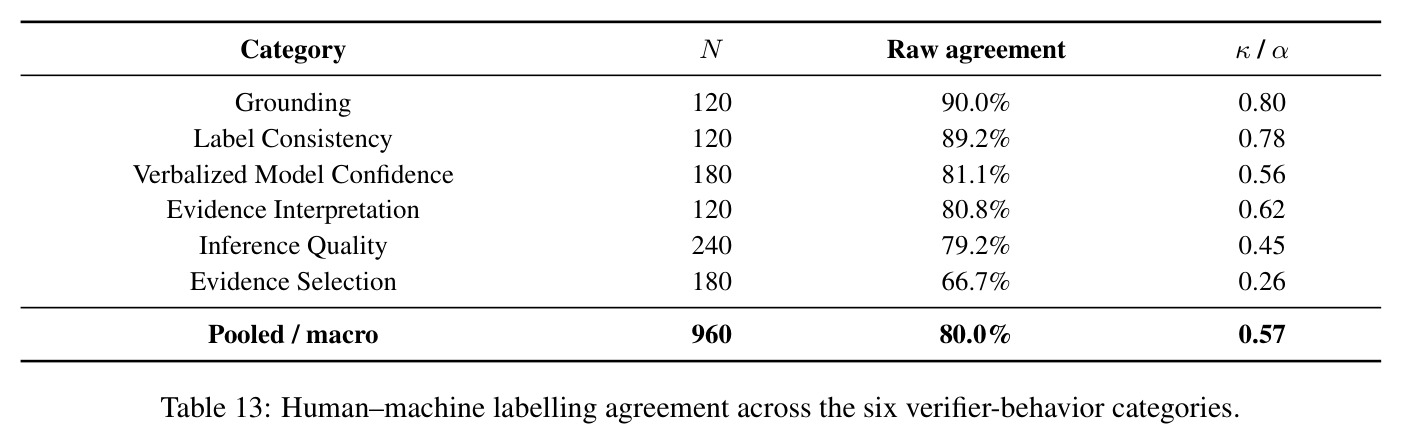
用强 LLM(本文用 Claude Opus 4.7)按代码本(codebook)给检索证据的五个质量维度、验证器思维链的六个连续步骤打子标签;从种子代码本出发,迭代地让 LLM 在新数据上发现未覆盖的错误模式,直到饱和(本文共 6 轮迭代),人工只标注小样本(50 对声明-证据、60 条推理轨迹)并计算 Cohen's $\kappa$、Krippendorff's $\alpha$ 校验一致性。
这是本文在无金标条件下规模化诊断的核心方法论,也是标题中 “Automatic Taxonomy Induction” 的含义。
稠密/稀疏检索与 RRF 融合
BM25 是基于词频的稀疏检索;MedCPT 是医学微调的稠密检索器(月下载 38 万+),Qwen3-Embedding-8B 是 2025 年 MTEB 榜首的通用稠密检索器,SPECTER 面向科学文献;Reciprocal Rank Fusion(RRF)按排名倒数($\sum_i 1/(k+r_i)$)融合多路检索结果。本文比较 MedCPT、RRF-2、RRF-4、Qwen3 四种检索器。
论文用 4 种检索器 × 3 类语料做消融,不熟悉这些检索术语就看不懂 R1–R6 检索错误模式和 Table 4/5/8 的结论。
Precision/Recall/F1 与统计显著性检验
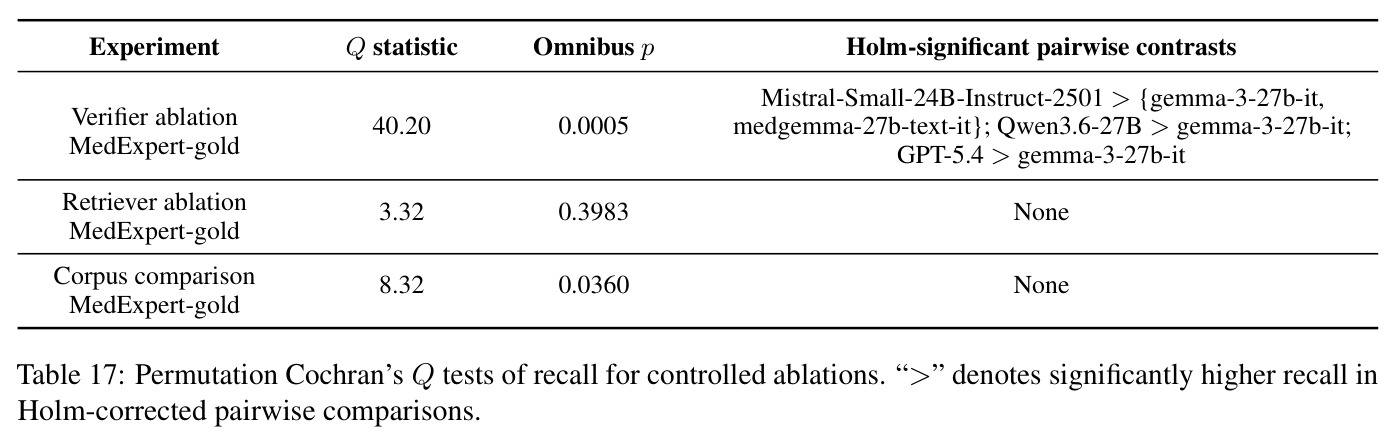
召回率衡量系统找出临床医生所标注错误的比例,是本文最关心的指标(医学场景漏检代价最高);F1 是精确率与召回率的调和平均。由于金标子集小、类别严重不平衡,作者用 Wilson 置信区间、置换 Cochran's Q 检验和分层配对 bootstrap(Holm 校正)来判断消融差异是否统计显著。
论文“没有任何干预能显著改善”的结论完全建立在显著性检验之上,不懂这些工具会误读表格中的排名差异。
研究动机
在医疗这类高风险场景中,LLM 生成的长篇答案可能包含看似合理实则错误的信息,主流做法是 FActScore/MedScore 式的分解-检索-验证流水线,但它只输出一个端到端聚合分数(如 F1),完全无法说明流水线在哪一环、因何种原因失效。本文的实验显示性能崩塌是数量级的:同一套 SOTA 组合(Qwen3 检索 + GPT-5.4 验证)在封闭式生物医学基准上 F1 可达 0.7–0.8(如 CovidFact 78.2),而在由执业临床医生逐句标注的开放式 MedExpert 数据集上 F1 只有 0.08(严格映射下全量仅 8.4,P=5.6),且这种崩塌跨模型规模、推理强度、医学微调与语料扩展持续存在。更麻烦的是诊断工具本身缺位:现有 RAG 诊断框架(RAGChecker、MedRAGChecker、RAG-X 等)都要求金标答案或金标证据标注,而开放式场景中两者都不存在——LLM 生成的原子声明过于多样、无法预先枚举证据,声明本身还可能是语料中无支撑的编造,使检索器的 recall@$k$ 在原理上无法定义。于是检索阶段在开放式评估中一直被当作黑盒子,从未被系统性错误分析。
本文的目标是本文的目标不是再造一个更准的事实核查器,而是打开检索-验证流水线的黑箱:为开放式(无金标答案、无金标证据)医学事实性评估建立一套模型无关的错误分类体系(taxonomy),把失败分解为检索阶段的证据质量错误与验证阶段的推理行为错误,并给出可规模化的自动归纳方法——不需要金标标注,仅用 LLM-as-Judge 加少量人工校验即可把诊断扩展到人工无法穷举的规模。在此基础上,作者要回答一个更根本的问题:这些失败究竟是过时系统的产物,还是范式级限制?为此他们在 6 个前沿验证器、4 种检索器、3 类知识语料上做大规模消融,用统计检验逐一检验“换更强检索器/更大验证模型/开推理/换 Google 权威语料/医学微调”能否解决问题,最终给出面向研究者的可操作建议:用面向任务的多维检索评估,配合验证器中间推理步骤的行为评估,替代单一的端到端聚合指标。
与已有工作不同的是,本文的独特切入角度有三点。第一,诊断而非修补:与需要金标答案的 RAGChecker/MedRAGChecker、以及锚定医生手写答案必含要点的 Kim et al. 检索评估不同,本文第一次在完全没有参考答案的条件下系统分析检索阶段的失效——而这正是开放式生成真实部署时的场景。第二,把错误分类体系本身当作核心贡献:作者不满足于回答“哪里错了”,而是归纳出回答“为什么错”的可复用代码本——检索侧 5 个质量维度(实体匹配、临床范围、可信度、证据极性、切块质量)与验证侧 6 个连续推理步骤(证据选择、证据解读、推断、置信度、标签一致性、接地),并通过 human-in-the-loop 的 LLM 归纳流程自动产出,可迁移到其他高风险领域。第三,把社区默认的“规模崇拜”作为被检验对象:模型变大、推理 token 变多、语料换成 Google 实时权威源、模型做医学微调——这些直觉改进方向被逐一证伪,从而把结论从“系统还不够好”提升为“检索-验证范式在开放式设定下存在结构性限制”。
核心方法
直觉上,作者把诊断拆成两阶段:先用现有最佳流水线跑出大量“系统判决 vs 医生标注”的分歧案例,再从分歧中归纳错误模式。Phase 1 复用 MedScore 的分解-验证流水线:把 MedExpert 中被医生标错的回答句子分解为上下文感知的原子声明,以声明为查询从 30.3M 段落的 MEDIC 语料(或 Google 实时搜索)检索 top-10 段落,由验证 LLM 按 JSON schema 输出四类判决(Supported/Refuted/No Evidence/Ambiguous)及推理文本;句子级真值沿用医生标注,有错句的原子声明默认继承“有错”,聚合规则为“任一声明有错即句子有错”。Phase 2 是本文核心:当系统与医生不一致时,先判断证据是否缺失或低质(归为检索错,证据是瓶颈),再看模型是否误用了在手证据(归为验证错,推理是瓶颈);随后以种子代码本为起点,用 Claude Opus 4.7 迭代归纳出检索侧 5 维 13 子码、验证侧 6 步 16 子码的饱和代码本,对每个检索器标注 800 对(声明, 证据)、对每个验证器标注 576 条(声明, 推理)轨迹,量化各错误模式占比,形成 R1–R6 与 V1–V6 两条分类轴。
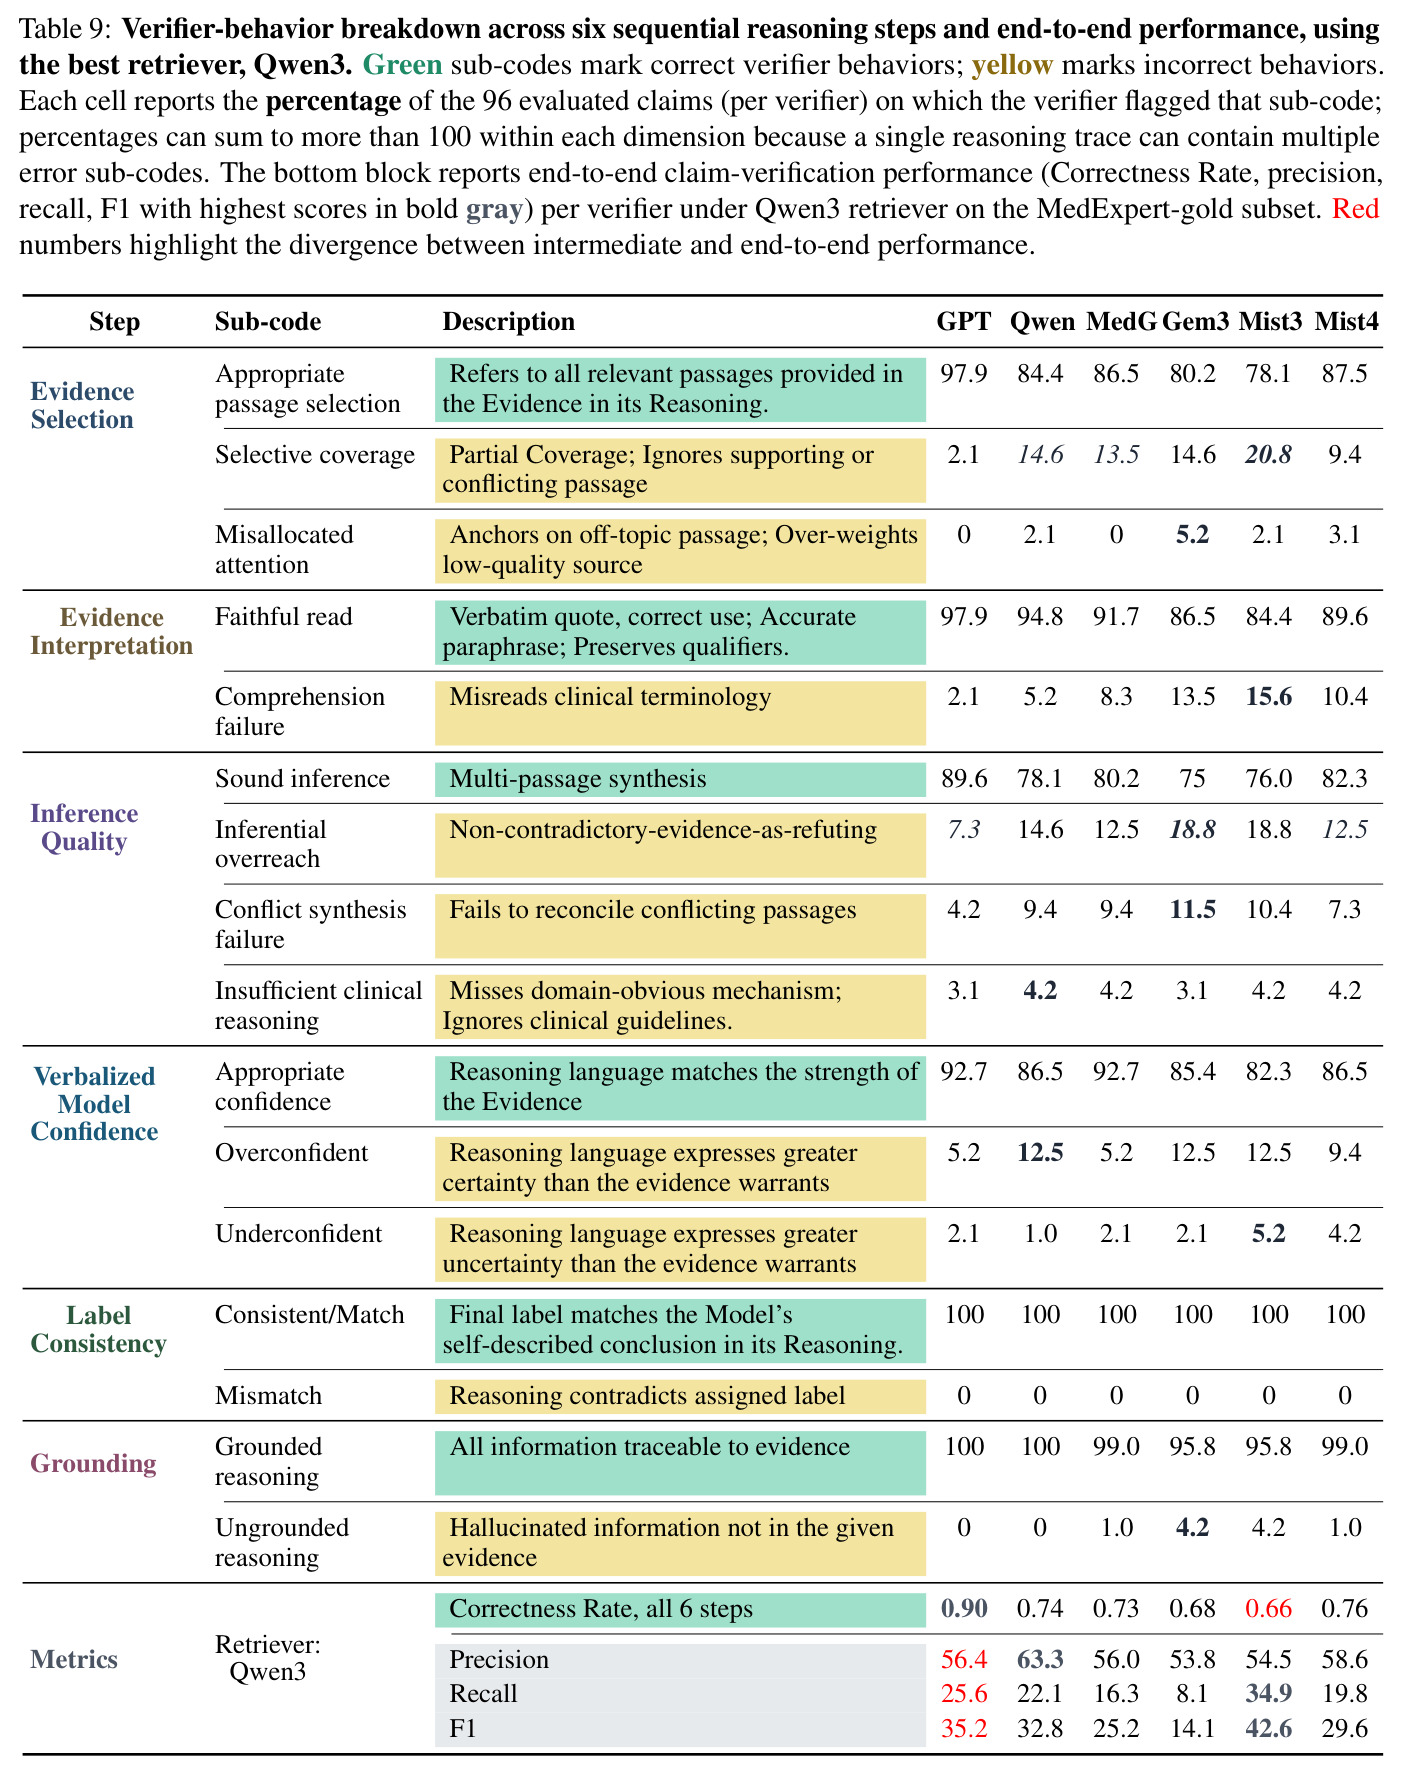
核心创新是“无金标条件下的可归因性”。封闭式诊断依赖金标证据把检索错误与验证错误干净分离;本文证明即使没有任何金标证据,也能做到近似归因:以医生句子级 True/False 标注为锚点(作者用 5 名持证临床医生复判 225 个被标错句子构造 MedExpert-gold,保留全部 86 个有错句,保证召回率指标的可靠性),凡系统漏检或误报,就检查 top-10 证据里“有没有、够不够格”,进而把每段证据按 5 个维度评级、把验证器推理按 6 步流水账逐段审计。第二个关键想法是把“中间过程”当作评估对象而非副产品:一个验证器可能召回率高但六步推理全对率只有 66%(Mistral Small 3,靠错误推理碰对),另一个推理正确率 90%(GPT-5.4)却因证据太差而召回率仅 25.6——端到端 F1 会把这两种失败混为一谈,而本文的中间指标能把它们干净分开。与已有工作的本质区别在于:错误模式不是人工事后总结的定性案例集,而是经 LLM 归纳、人工校验一致性的可量化代码本,可以在无金标的新领域重复使用。
方法步骤详情
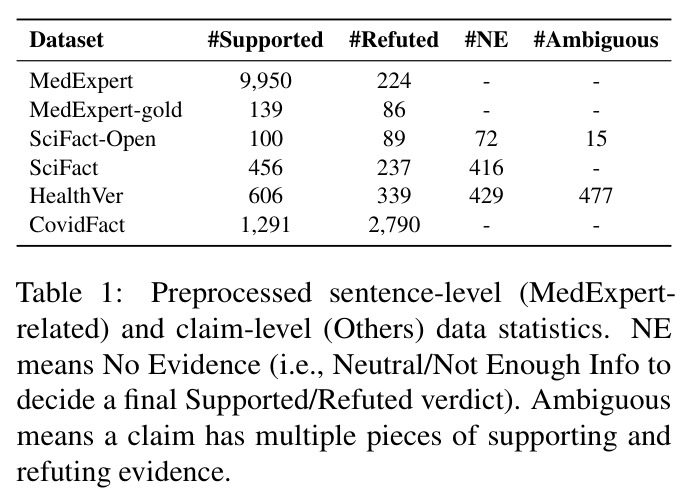
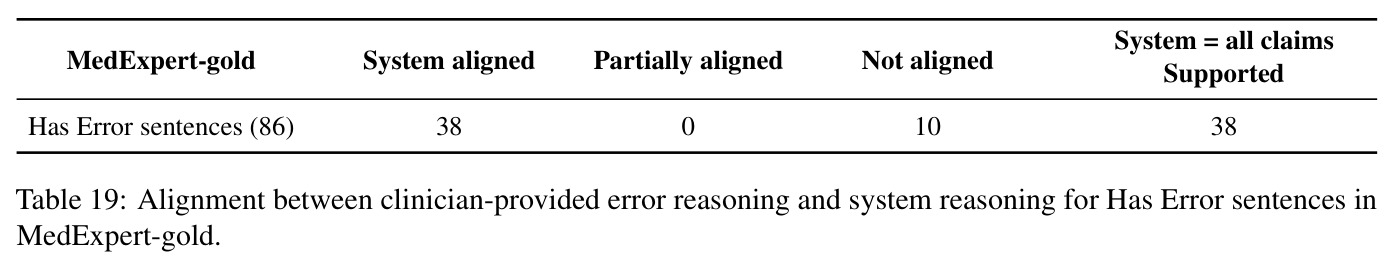
第一步,数据构建:MedExpert 含 4,540 个开放式问答对(医生标注错误句及理由),取全部 225 个被标错句由 5 名临床医生复判,86 句确认有错、139 句改判无错,构成 MedExpert-gold;另将四个封闭式数据集(SciFact 等)改为开放式设定。第二步,流水线运行:4 种检索器(MedCPT、RRF-2、RRF-4、Qwen3-Embedding-8B)× 3 类语料(MEDIC 与 Google 实时搜索)检索 top-10,6 个验证器(GPT-5.4、Gemma/MedGemma-27B、Qwen3.6-27B、Mistral Small 3/4)输出四类判决(含 Ambiguous)。第三步,错误归因:对漏检或误报案例,先查证据是否缺失或低质(检索错 R1–R6),再查推理是否误用证据(验证错 V1–V6)。第四步,代码本归纳:Claude Opus 4.7 寻找代码本未覆盖的新模式,6 轮迭代至饱和;人工标注 50 对声明-证据与 60 条推理轨迹校验,证据侧一致性 $\kappa=0.90$,推理侧仅 0.57。第五步,统计检验:Wilson 区间、Cochran's Q、Holm 校正配对 bootstrap。
技术新颖性
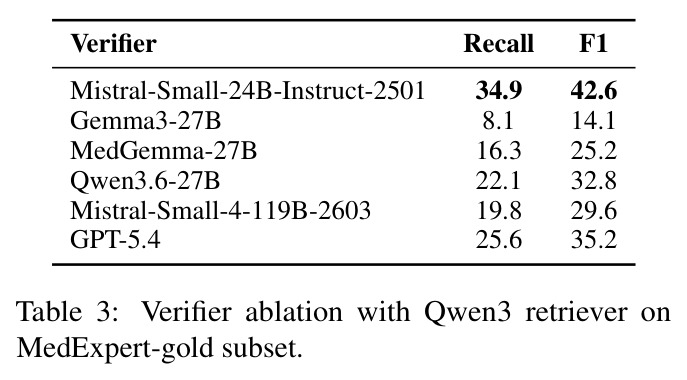
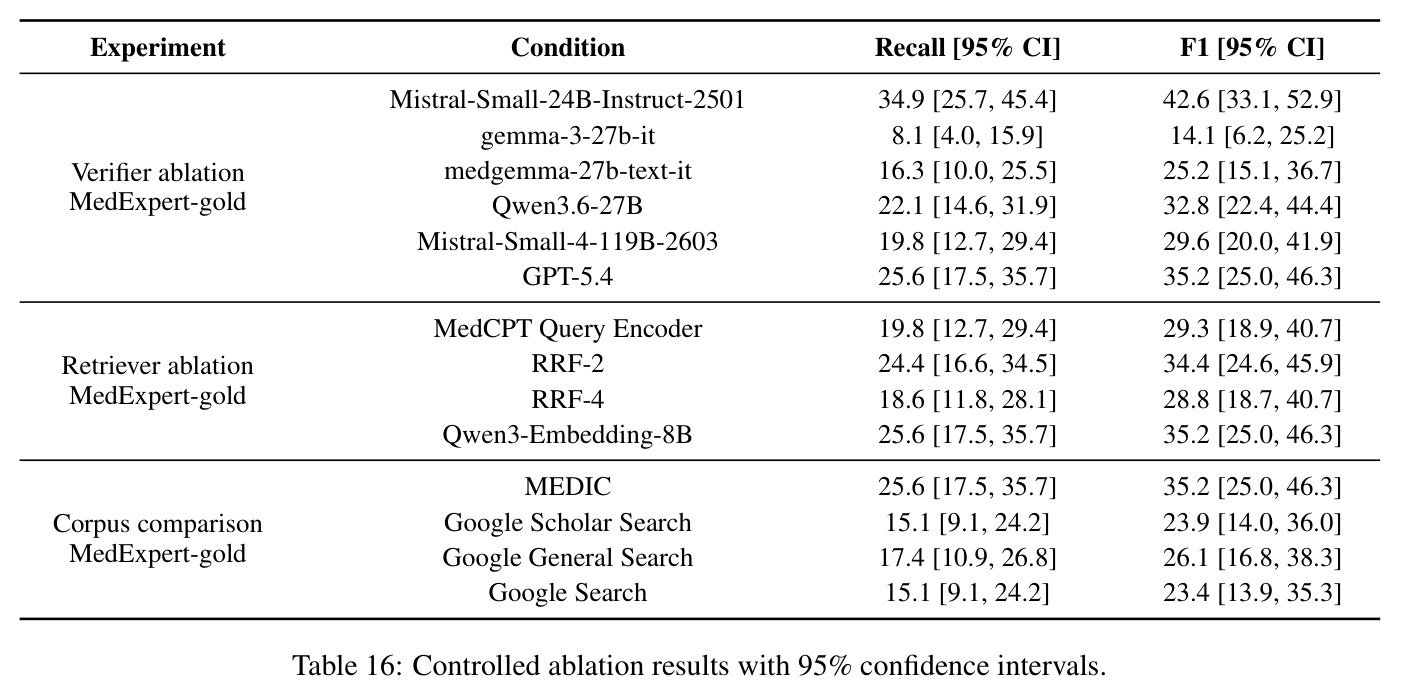
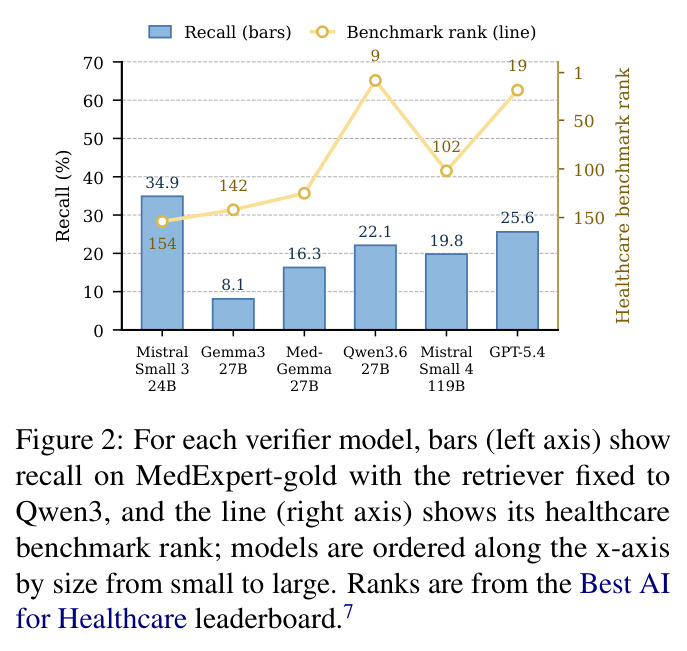
技术新颖性有四点。其一,任务定位新:这是首个针对“无参考答案的开放式检索”的系统性错误分析——MedRAGChecker 需要金标答案的声明、RAGChecker 需要金标答案、Kim et al. 需要医生手写答案的必含要点,全部依赖参考文本,而开放式生成恰恰没有。其二,方法论新:把 LLM-as-qualitative-judge(Chirkova et al., 2025)的错误归纳流程(改造自 Gao et al. 2026 的 Act-onomy 管线)引入医学事实核查,形成“种子代码本 → LLM 找新模式 → 聚类叶节点 → 人工校验一致性 → 迭代至饱和”的闭环,比纯人工案例研究可扩展几个数量级。其三,评估哲学新:主张多维中间评估(检索证据 5 维 × 验证推理 6 步)优于聚合 P/R/F1,并给出反例实证——医疗基准排名与真实验证召回率严重错位(GPT-5.4 排名高但召回 25.6,参数量最小的 Mistral Small 3 召回 34.9 却推理正确率垫底)。其四,统计严谨性在这类定性分析中少见:所有消融配 95% 置信区间与 Holm 校正检验,因此敢于下“没有干预显著有效”的强结论。
实验结果
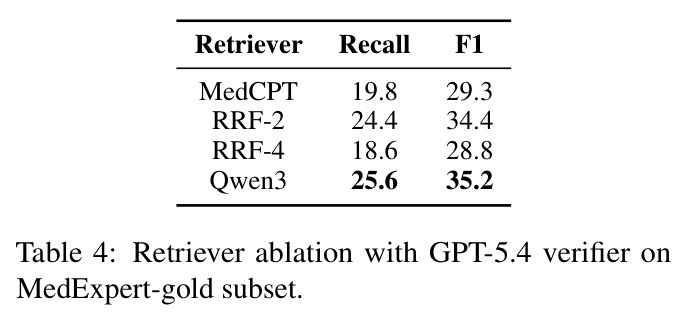
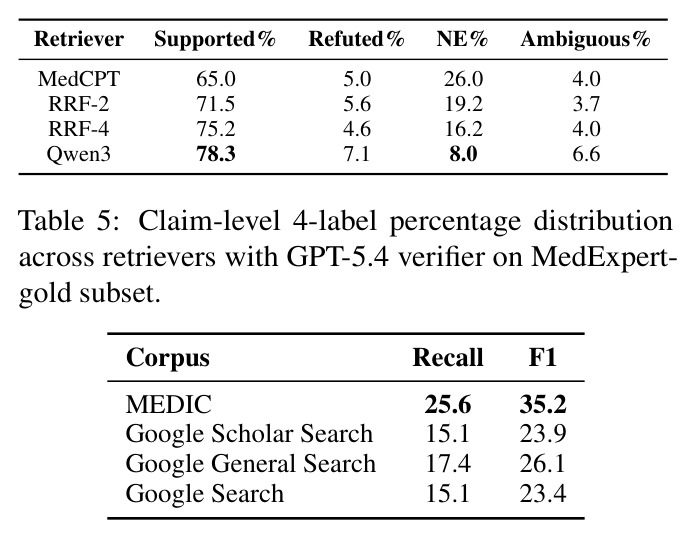
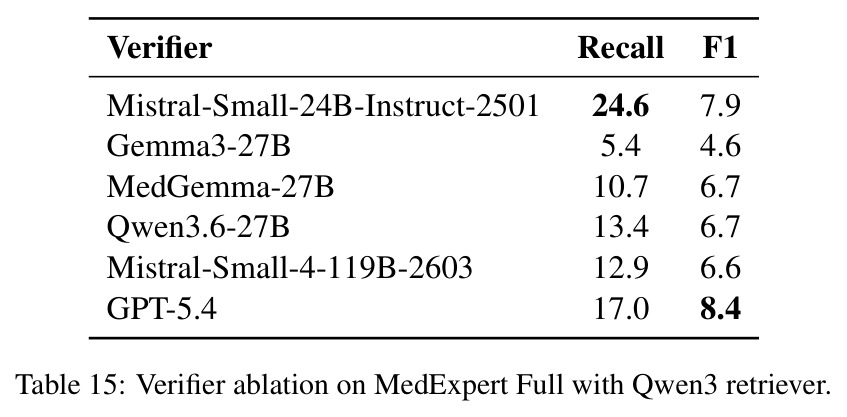
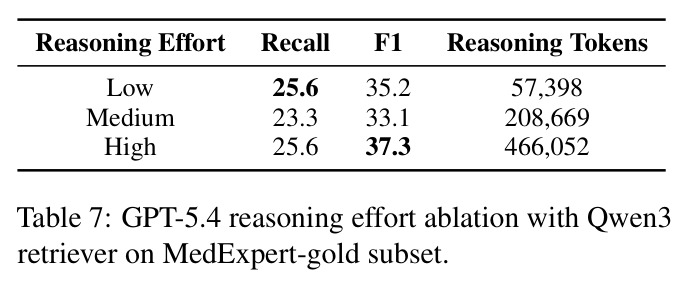
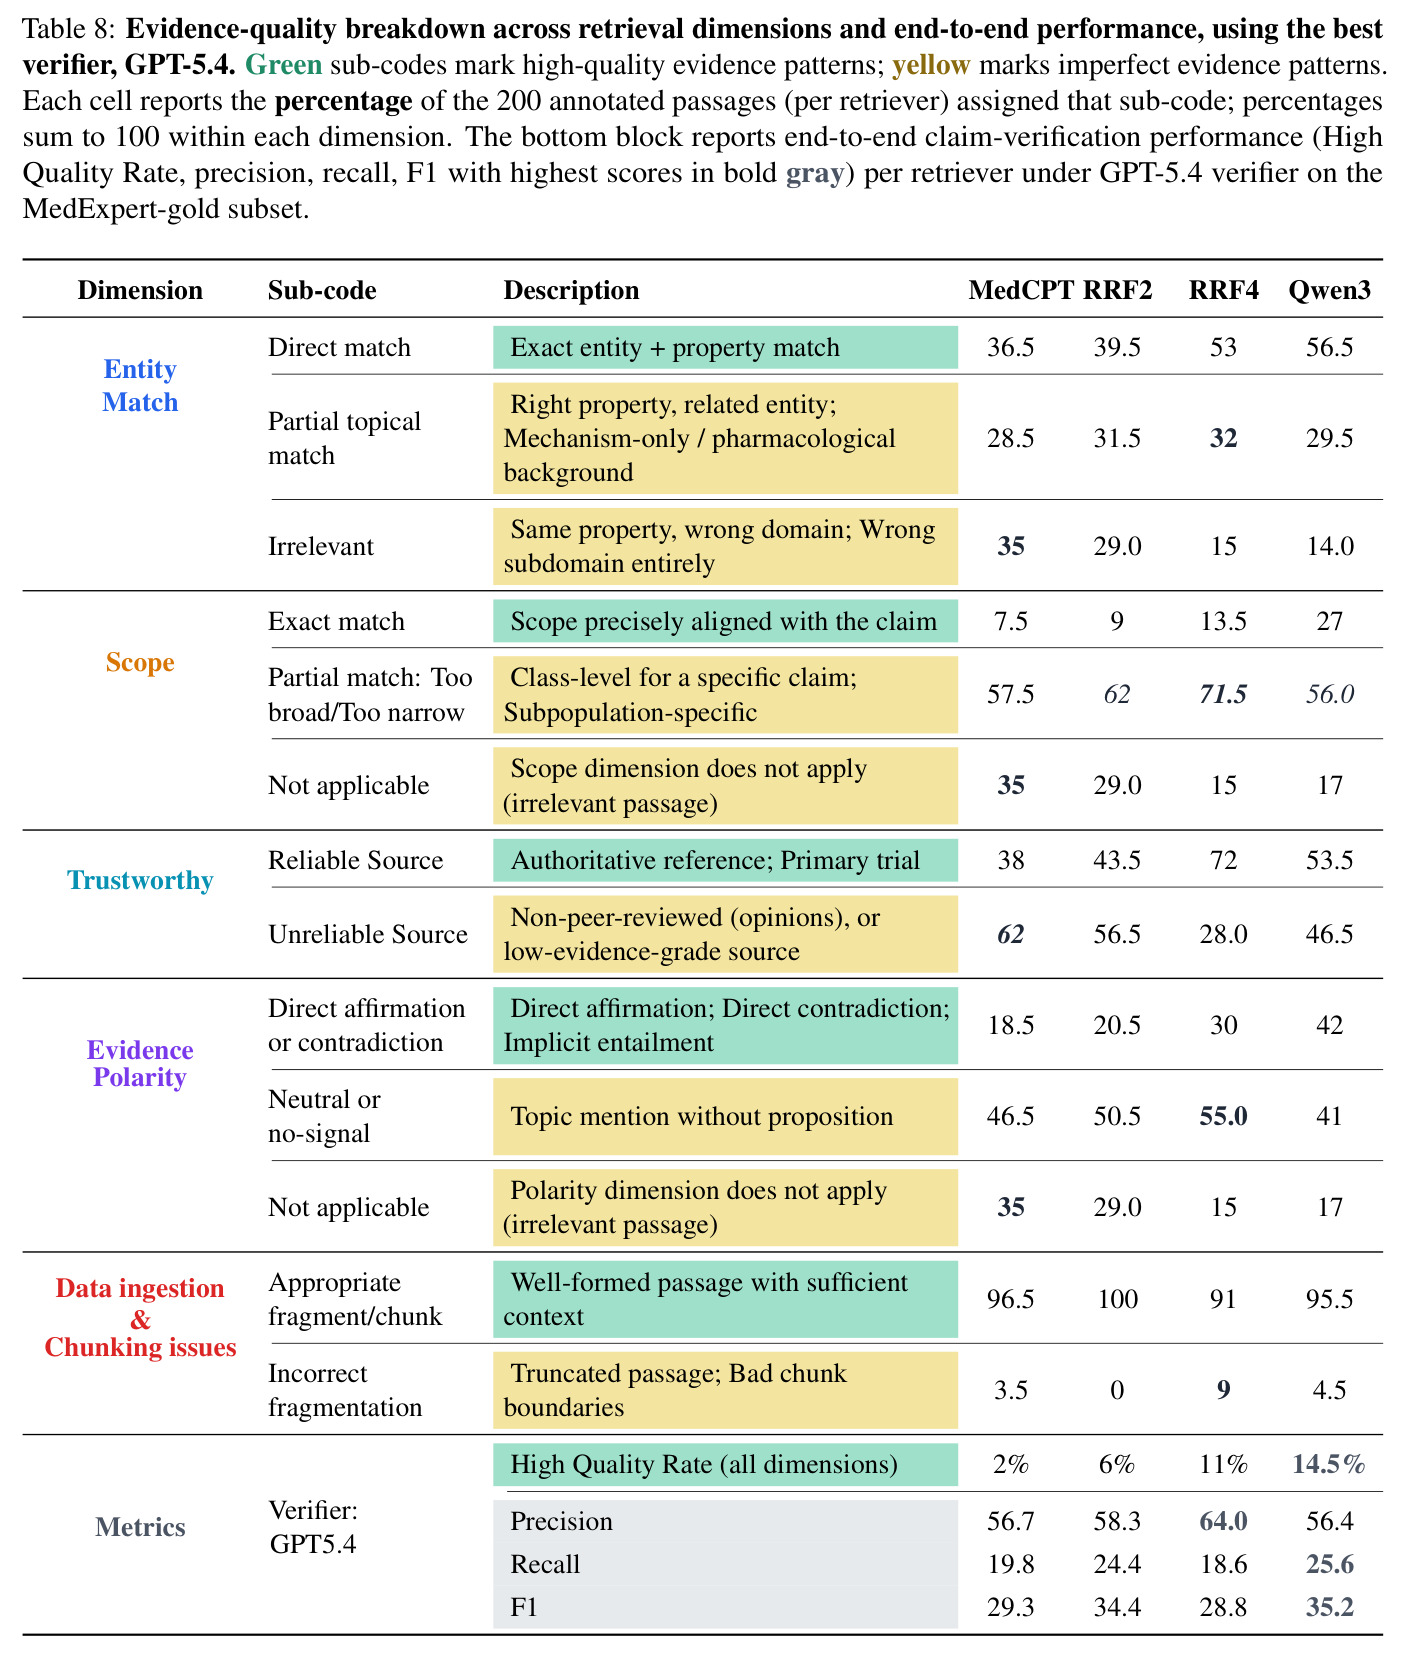
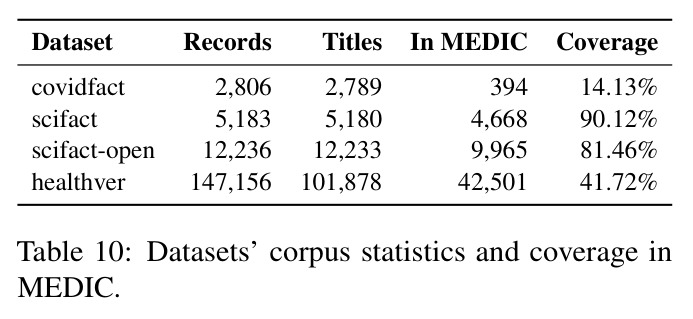
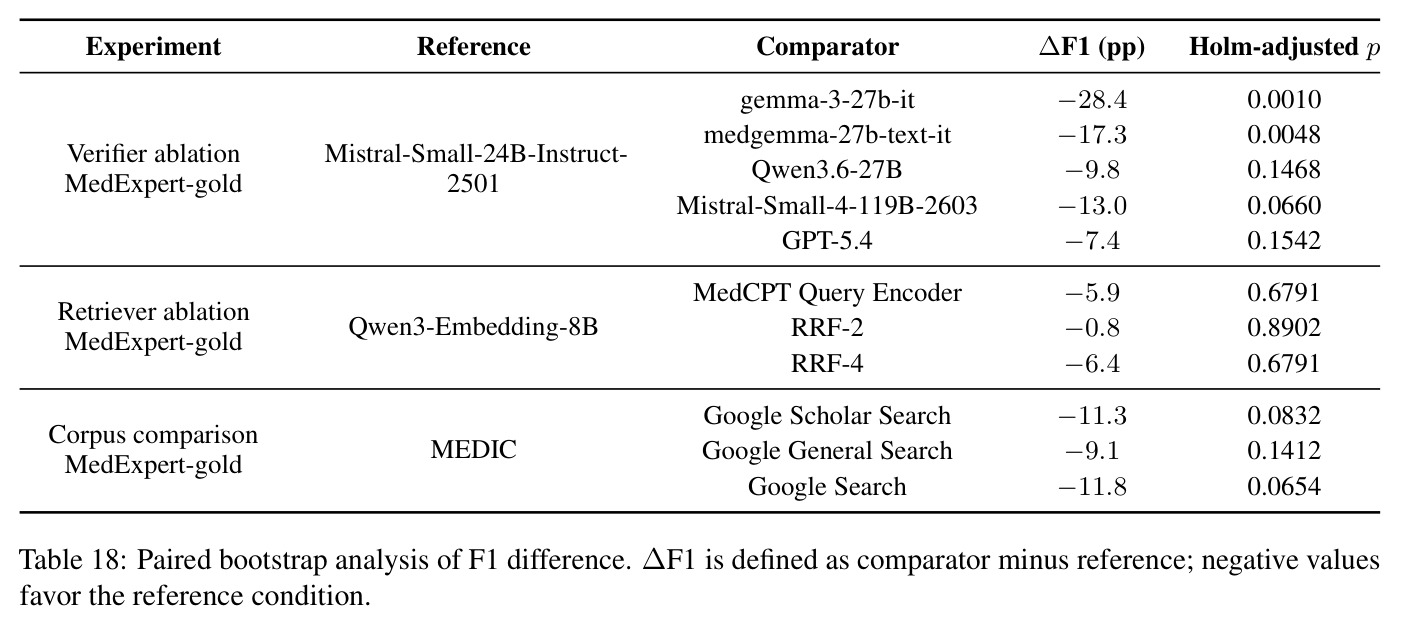
核心发现分三层。崩塌层:SOTA 流水线(Qwen3 检索 + GPT-5.4)在开放式 MedExpert 全量上 F1 仅 8.4,平衡子集 MedExpert-gold F1=35.2;而封闭式 CovidFact F1 达 78.2、SciFact-Open 召回 98.9。不可解层:四条常规改进全部失败——检索器上 Qwen3 最佳(R=25.6,F1=35.2)仅比 MedCPT 高 5.9pp;换 Google 搜索反而拉低 F1 9–12pp($p=0.036$);验证器上基准排名与召回错位,最小的 Mistral Small 3 召回最高(34.9/42.6),GPT-5.4 仅 25.6/35.2,显著效应均偏向基线;推理 low→high 耗 8 倍 tokens 无提升;医学微调的 MedGemma 召回仅翻倍(16.3 vs 8.1)。解释层:金标证据在 MEDIC 的覆盖率决定难度——SciFact 90.12% 对 CovidFact 仅 14.13%,与 F1 排序一致;检索侧瓶颈是范围错配与不可靠来源(exact scope 仅 27%、MedCPT 62% 不可靠);验证侧 GPT-5.4 六步全对率 90% 最高、Mistral3 仅 66%,其高召回多靠错误推理碰对。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 开放式医学事实核查(MedExpert-gold,GPT-5.4 + Qwen3,严格映射) | Recall / F1 | 25.6 / 35.2 | 同一流水线在封闭式 SciFact 上:81.4 / 67.2 | 召回下降 55.8pp、F1 下降 32.0pp——开放式场景下的数量级崩塌(负向) |
| 开放式 MedExpert 全量(类别失衡:9,950 支持句 vs 224 错误句) | F1 | 8.4(GPT-5.4 最佳) | 封闭式 CovidFact 78.2 | 落后 69.8pp,真实部署场景近乎失效 |
| 检索器消融(GPT-5.4 验证,MedExpert-gold) | F1 | Qwen3-Embedding-8B:35.2 | 最常用医学检索器 MedCPT:29.3(RRF-4 最差 28.8) | +5.9pp,但绝对值仍然很低,换检索器无法解决问题 |
| 验证器消融(Qwen3 检索,MedExpert-gold) | Recall / F1 | Mistral Small 3(24B):34.9 / 42.6 | GPT-5.4:25.6 / 35.2;MedGemma-27B:16.3 / 25.2;Gemma3-27B:8.1 / 14.1 | 最小模型反超闭源 SOTA 9.3pp F1——基准排名无法预测开放式验证能力 |
| 知识语料消融(GPT-5.4 + Qwen3,MedExpert-gold) | Recall / F1 | 静态 MEDIC:25.6 / 35.2 | Google 合并实时搜索:15.1 / 23.4 | 实时权威搜索反而 −11.8pp F1(MEDIC 召回显著更优,$p=0.036$) |
| 推理强度消融(GPT-5.4 high vs low,Qwen3 检索) | Recall / F1 / reasoning tokens | high:25.6 / 37.3 / 466,052 | low:25.6 / 35.2 / 57,398 | F1 +2.1pp 且不显著,token 消耗 ×8.1——测试时扩展无效 |
局限与改进
作者承认的局限:MedExpert 是唯一公开的带医生 True/False 标注及理由的开放式医学评估集,MedRAG 是唯一公开的大规模权威医学语料,结论锚定于两者(仅覆盖精神健康与产前护理两专科),外推需谨慎;MedRAG 无段落元数据,时间维度缺失;开放式任务无金标段落,无法计算检索器的 precision@$k$/recall@$k$;受 API 预算限制,错误模式占比只在 MedExpert-gold 子集打标。我自己的观察:gold 子集很小(225 句、86 个有错句),召回率 95% CI 宽达 ±8–10pp(如 Mistral3 34.9 [25.7, 45.4]),许多排名差异统计上不显著;句子级标签默认继承给原子声明、加上“任一声明有错即句子有错”的聚合规则,可能把句子级错误归因到错误声明上,检索/验证的错误归属边界不如论文暗示的干净;推理轨迹标注一致性仅中等($\kappa=0.57$,Evidence Selection 仅 0.26),验证侧占比数字带可观测量噪声;诊断止步于“模式”粒度,未提出或验证任何修复方案;验证提示词只用单一 zero-shot 模板,提示敏感性未考察。
独立分析的弱点
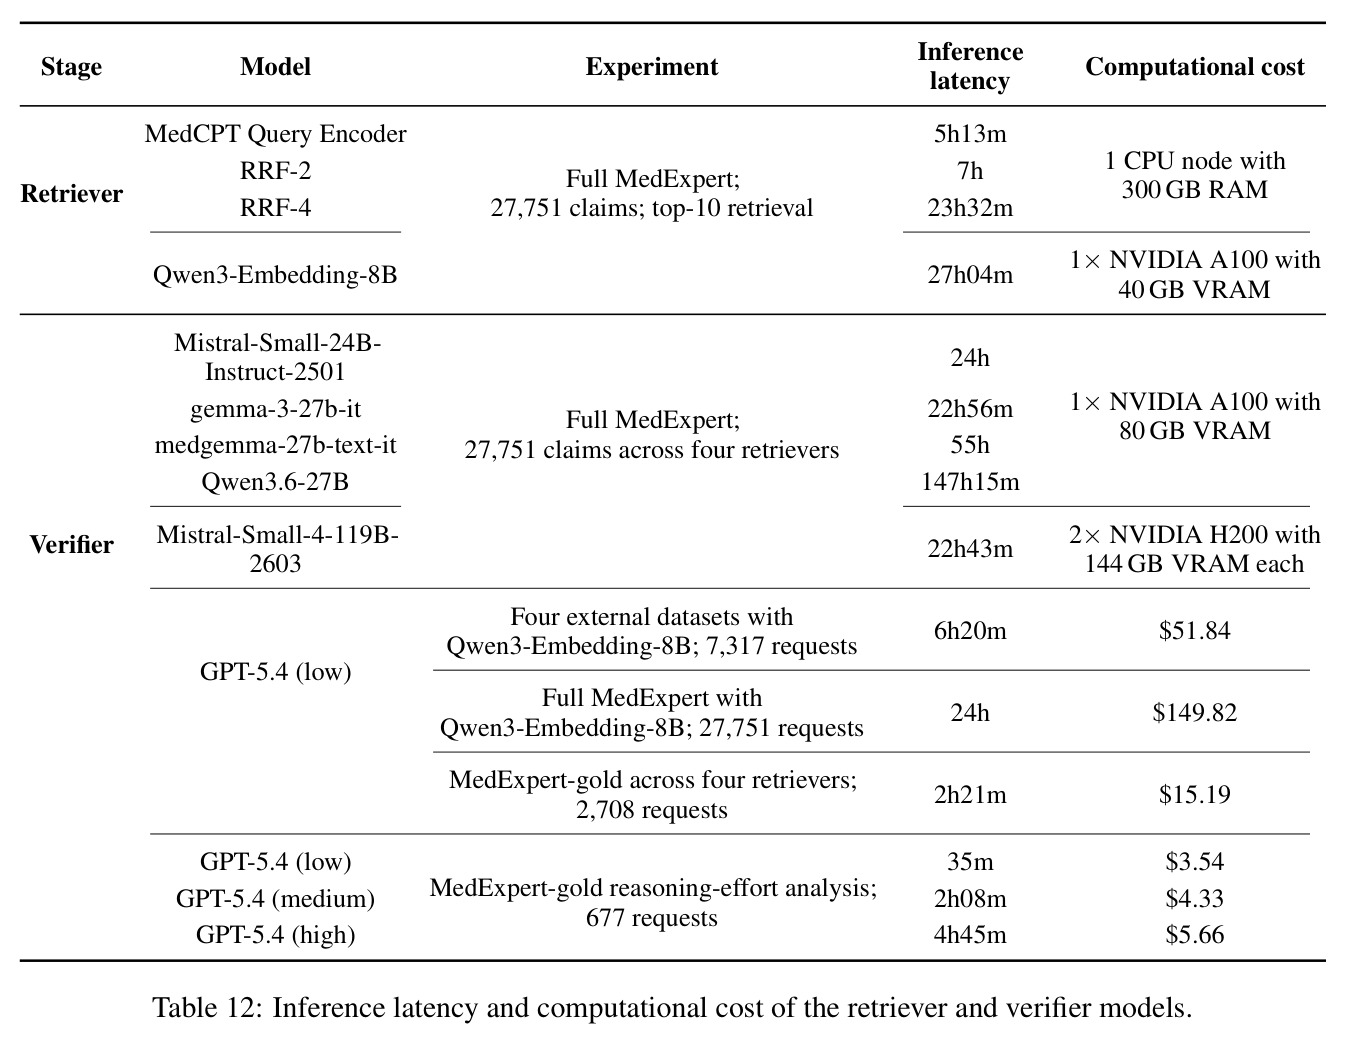
独立分析可见的弱点:第一,归因逻辑的潜在循环性——“这是检索错还是验证错”的判断本身由 LLM 代码本完成,而验证器审计恰恰发现 LLM 存在选择性覆盖与过度推断,用同类模型审计同类模型可能系统性低估验证错误、高估检索错误;改进方向是引入异构裁判或人机混合仲裁抽样。第二,证据“高质量率”作为检索评估的代理指标标准极严——要求 5 个维度同时达标才计为高质量,任一维失败即整段计低质,这使 14.5% 的天花板数字难以与检索文献直接对话,改进方向是同时报告维度级边际分布与加权版本。第三,实验只覆盖英语的两个专科(MH/PC),药物剂量、药物相互作用等推理密集场景可能更糟,需要在更广科室与语言上复验。第四,top-10 检索窗口固定,未探索更大 $k$、查询改写或迭代式 agentic 检索——而这恰是应对“需串联两段证据”(如先查年龄→肝功能减退,再查肝功能→剂量调整)的直觉方案,论文的失败结论可能低估了这类方法的空间。第五,成本结构不利于规模化复现:单个开源验证器跑全量需 147 小时 A100(Qwen3.6-27B),诊断框架自身的推广受算力与 API 预算约束,跨领域复制代码本归纳还需临床专家。
未来方向
作者提出的方向:为检索环节开发面向任务的定制化多维评估与重排(re-ranking),替代词面/余弦相似度加 RRF 的公式化做法;对验证器做中间行为评估,确保推理过程真正正确,而不是只在聚合指标上竞争;待数据资源公开后补齐时间维度(段落发布日期)与金标段落指标。基于本文成果可自然延伸的方向:其一,把 5 维证据质量标签用作重排器的训练信号或强化学习的奖励模型,直接优化“范围匹配+极性+可信度”而非单纯相关性;其二,多跳检索与证据链推理——论文指出老年剂量调整这类声明需要串联两段证据,agentic 检索与迭代查询是顺理成章的下一步;其三,把验证侧 6 步代码本转化为过程监督(process supervision)数据,针对性治理选择性覆盖与置信度失准;其四,构建带时间戳与证据层级(指南>系统综述>RCT>病例报告)的动态医学语料,解决 Google 案例中权威站点本身含错的信任问题;其五,把该分类体系迁移到法律、金融等其他高风险开放域,检验其领域无关性;其六,在无金标条件下定义并估计“证据充分性”这一新检索指标,可能催生开放式检索评估的新基准。
复现评估
复现总体友好但工程量大。开源情况:代码与数据在匿名仓库(4open.science)发布,含基于开源 Act-onomy 改造的双版本归纳管线;数据集全部公开(MedExpert、SciFact/Open、HealthVer、CovidFact),MEDIC 即公开 MedRAG(30.3M 段落),完整 prompt 见 Table 11。算力:稀疏/混合检索 CPU 即可(MedCPT 5h13m、RRF-4 23h32m 跑全量 27,751 声明),稠密检索需 1×A100-40G(27h);开源验证器需 A100-80G 起步(Gemma3 约 23h 至 Qwen3.6-27B 147h),Mistral Small 4 需 2×H200;GPT-5.4 API 合计约 $230(全量 $149.82 + 闭式集 $51.84 + 消融约 $29)。难度评估:Phase 1 复现难度中等偏低,参数齐全(temperature 0、seed 42、top-10、结构化输出);Phase 2 最难复制——需 5 名临床医生参与种子代码本与一致性校验(维度级 $\kappa=0.90$ 依赖专业标注者),代码本饱和需 6 轮迭代与 Claude Opus 4.7,人力与预算需预留。
论文图表