ExplorationBench:用可验证的异星世界度量AI系统的探索能力 ExplorationBench: Measuring AI Systems' Exploration in Verifiable Alien Worlds
在规则可执行且违背先验的异星环境中,精确评测AI自主探索、发现并运用新知识的能力
前置知识
探针与交互式探索
在本文语境中,探针(probe)指系统主动提交给环境的一次可执行实验:在 AlienCode 中是一段候选程序,环境返回其精确输出;在 AlienLogic 中是一个候选证明,验证器返回紧凑结果。探索就是“选探针→读反馈→修正假设”的循环,全部发生在固定上下文窗口内,不更新模型权重、无外部记忆、无标量奖励。
基准的全部协议与六种实验条件都围绕“谁来选探针、反馈是否到来”展开,不理解探针就无法区分 autonomous/hindsight/fixed-probe 三种条件的本质差别。
数据污染与记忆回溯(recall)
LLM 评测中若测试题与预训练语料重合,模型可能靠记忆而非能力得高分,即数据污染;recall 指直接复用训练时见过的知识作答。对黑盒 API 来说污染几乎无法排除,这是静态基准分数虚高的经典原因。
本文的反污染设计是核心:隐藏规则与手册和常识先验都冲突,recall 不仅无用还会主动误导——探索前没有任何 AlienCode 轨迹超过 15.7%。
Best@n 与 Mean@n
对同一系统跑 $n$ 条独立轨迹,Best@$n=\max_r M_{r,4}$ 取完整轨迹的最好终点,Mean@$n$ 取平均;$r^\star=\min\arg\max_r M_{r,4}$ 用最低索引破平局。论文强调 Best@n 不是 pass@n——后者按题取并集,可能超过任何一条真实轨迹。
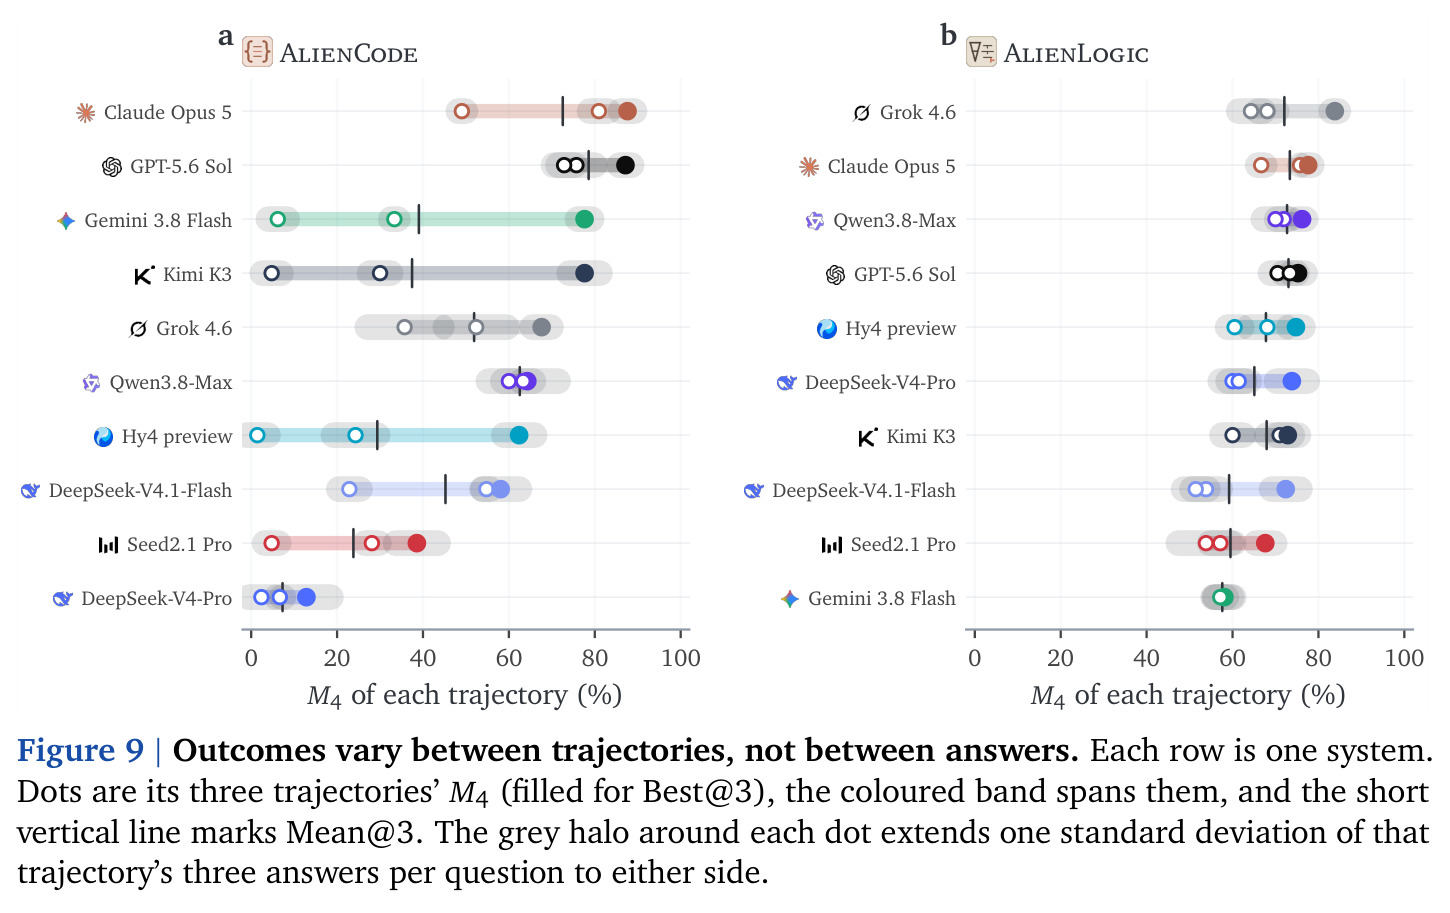
主排名基于 Best@3,而论文发现同系统轨迹方差高达 72.8 分,聚合方式会直接改变排名(如 Qwen3.8-Max 按 Best@3 第六、按 Mean@3 第三),读结果表必须先懂这个指标。
自然演绎与 Fitch 风格证明
自然演绎是形式逻辑证明系统,通过引入/消去规则(如 $\land I$、$\Rightarrow E$、reit 重述)从前提出发构造证明;Fitch 风格用缩进“盒子”管理假设的引入与解除。AlienLogic 对 24 条推理规则打补丁,例如禁止一条前提被重复引用、$⊥$ 消去规则被改写。
AlienLogic 沙盒的所有任务、证明检查器,以及“不可证目标只有在正确拒绝时才得分”的评分方式,都建立在这套形式系统之上,不懂它就看不懂该沙盒的设计。
工具调用智能体(tool-use agent)
模型以结构化 tool call 与环境交替:生成调用参数→环境执行→结果回填上下文→继续决策,代表范式如 ReAct。本文协议保留 tool-call ID 与推理状态字段,不把历史拍平成纯文本,使后续探针能以完整交互史为条件。
整个探索通过结构化工具调用实现;hindsight 重放也保持同一接口、只换“谁选探针”,这是各条件之间可比性的技术前提。
研究动机
评测 AI 的科学探索能力面临一个根本两难:任务必须对被测系统是全新的,否则高分可能只是预训练语料的记忆回溯,而黑盒 API 的数据污染几乎无法排除;答案又必须对评测者完全已知,否则无法精确判分。现成领域只能满足一端:数学、代码、事实问答可以自动验证,但内容不新,模型可能背过答案;真正新颖的产出(一个新定理、一条科学假说)确实是新的,但验证代价高昂,可能需要专家证明检查、专门实验甚至多年观测。与此同时,GPT-5.6 Sol、Claude Opus 5 等前沿系统在静态知识、数学与职业任务评测上已表现很强,但那测的主要是检索与运用既有知识;而探索要求的是另一些事:自行决定采集什么证据、在交互历史中积累证据、从结果中蒸馏新知识、再把新知识应用到没见过的问题上。这条能力链路此前没有被单独、可靠地量化过。
本文的目标是本文要建造一个把“探索”当作独立能力来度量的基准,并回答三个递进的研究问题:RQ1——系统能否仅凭与环境交互习得一个陌生世界的规则;RQ2——“发现一条规则”与“会用这条规则”是什么关系;RQ3——探索的成功有多可靠。为此作者提出“可验证异星世界”框架:环境规则完全可执行,每个答案都能被解释器或证明检查器精确判定,无需 LLM 评审;规则同时刻意与手册和常识先验冲突,使记忆回溯不仅无效而且有害。基准还需满足过程可观测(记录每次探针、每个里程碑的规则报告与闭卷成绩)与条件可控(能用对照实验分离“谁设计实验”与“证据是否到来”),最终对十个前沿系统给出可比较的排名。
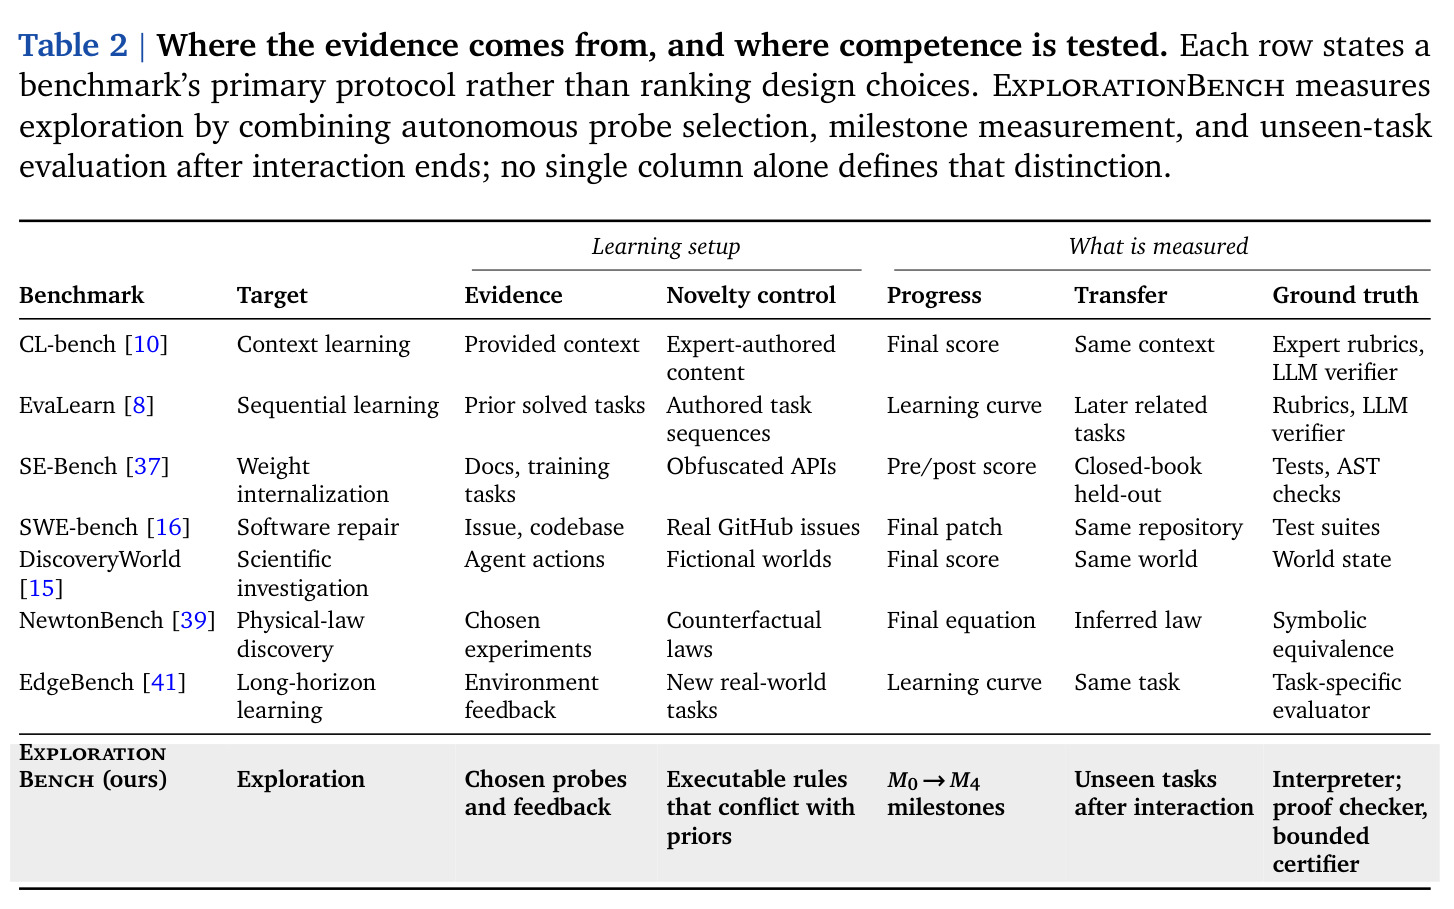
与已有工作不同的是,现有评测各占一角却无人覆盖全程。上下文学习类基准(CL-bench、EvaLearn 等)把新知识直接放进 prompt,模型只读证据而不采集;交互式发现类基准(MARS、DiscoveryWorld、NewtonBench)让智能体自选实验,但评分对象是世界状态或推断出的规律本身;可验证智能体评测(SWE-bench、WebArena、$\tau$-bench)验证结果却不涉及新知识。没有一个工作要求系统在交互结束后、禁用工具的闭卷条件下解决 held-out 任务,并沿 $M_0\to M_4$ 里程碑把“探针选择、规律报告、规律使用”拆开记录。本文另一独特设计是 hindsight 探索:把系统自己最佳轨迹的探针原样重放、反馈实时重算,使证据内容完全相同而决策者不同,从而把“设计实验的能力”从“获得证据”中干净地剥离出来。
核心方法
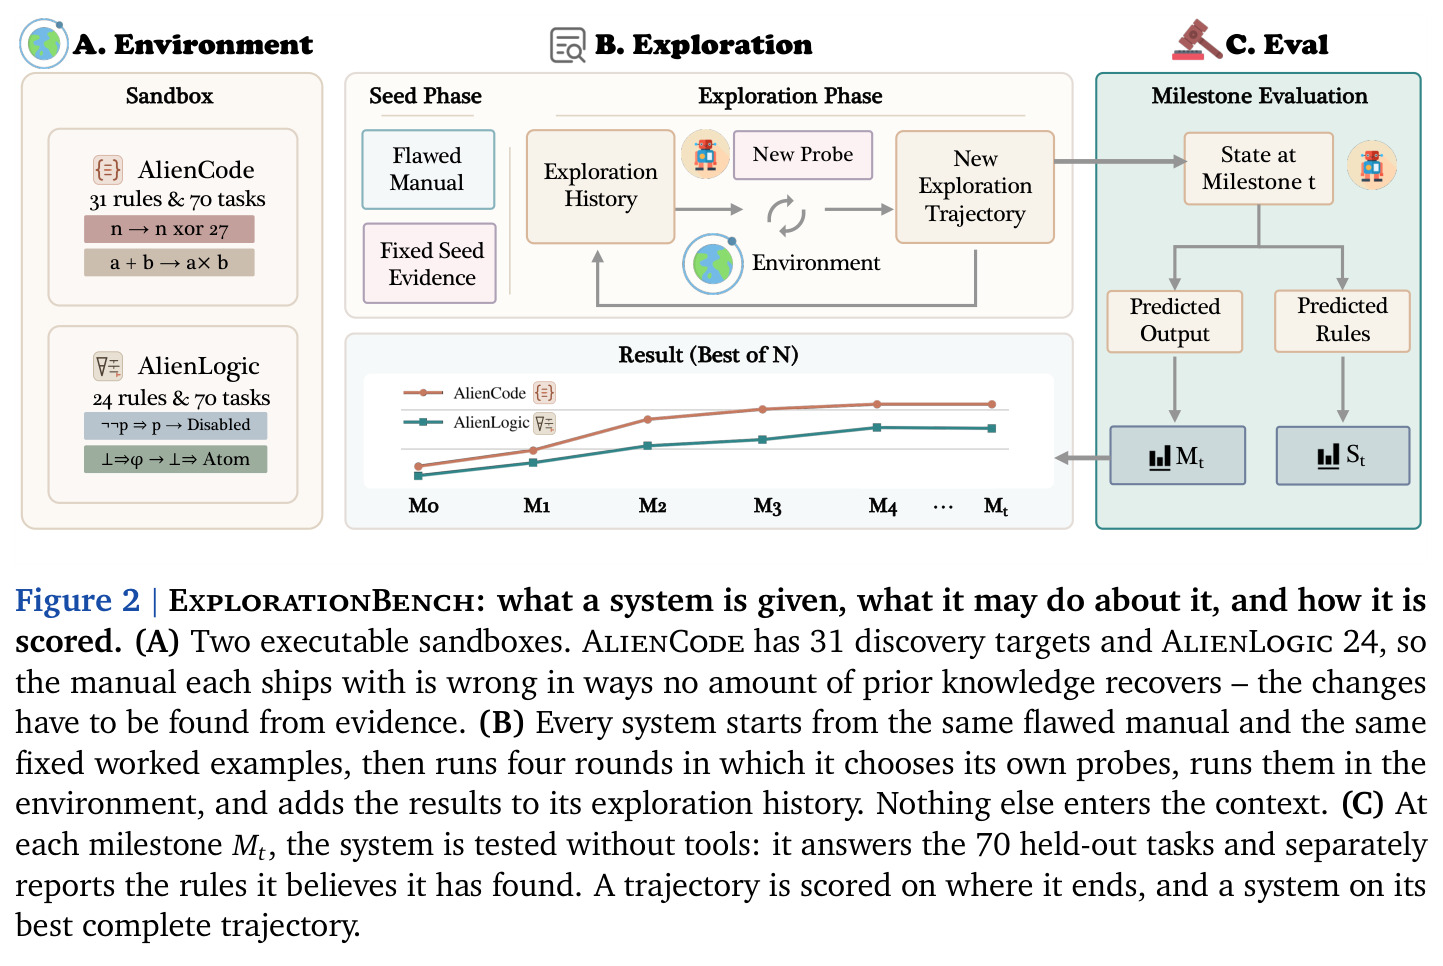
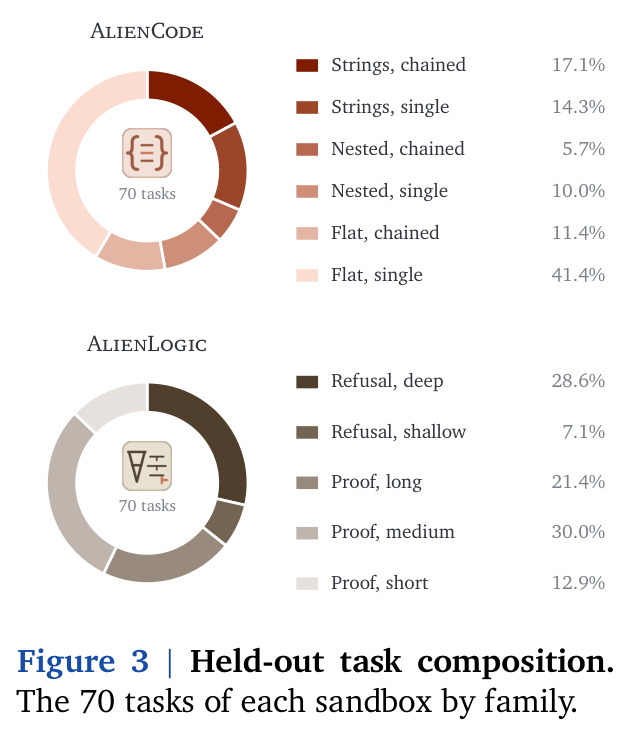
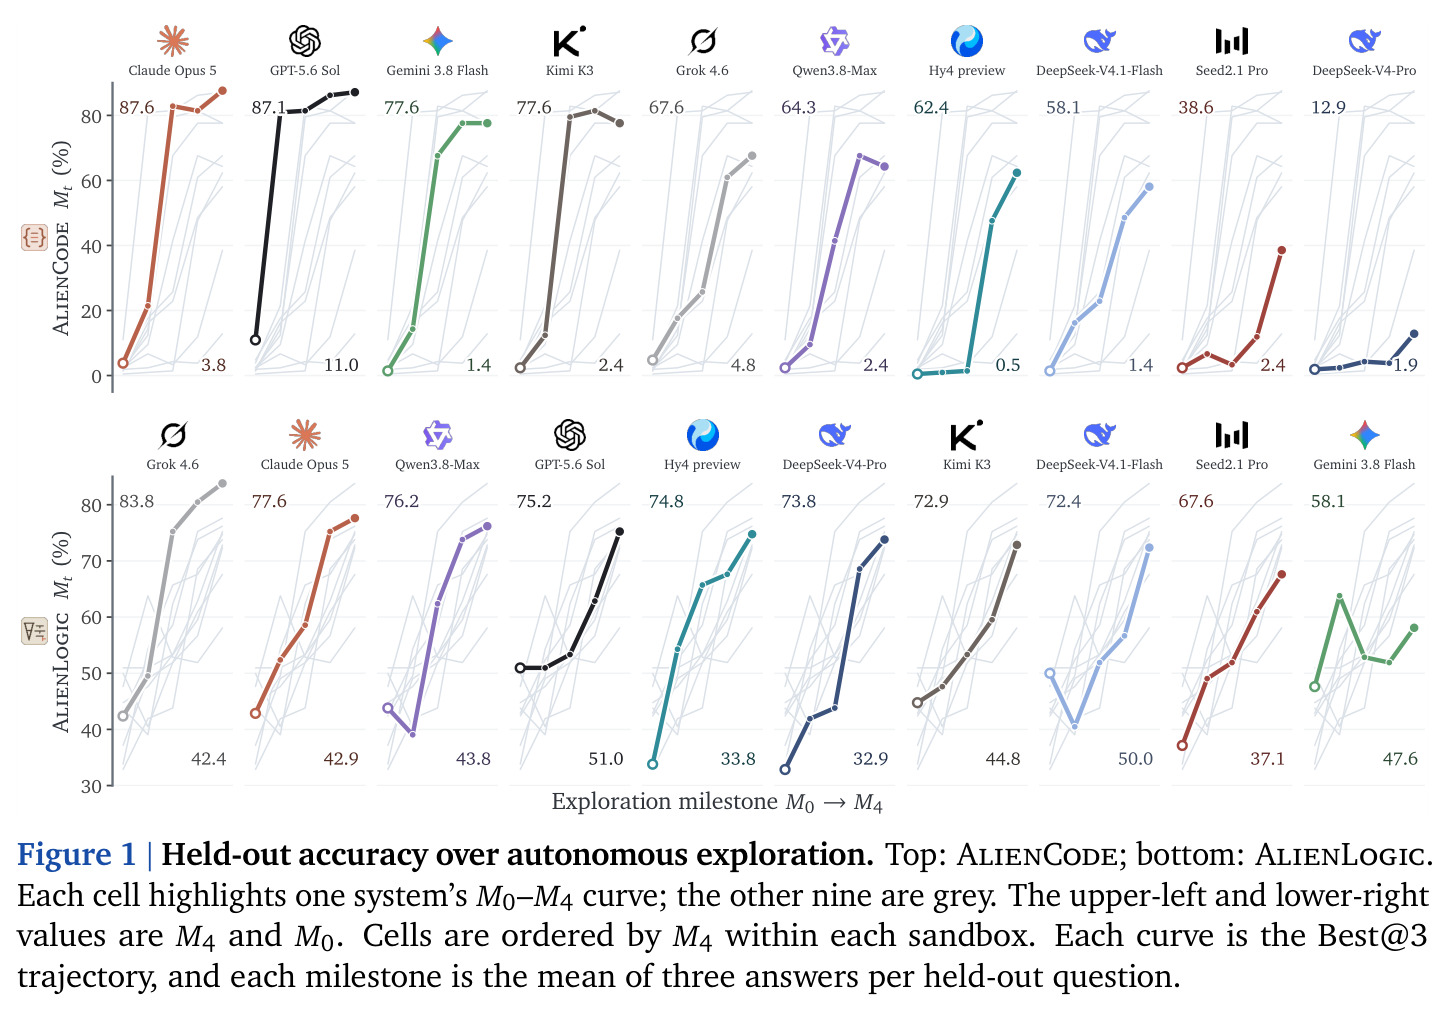
直觉上,ExplorationBench 把探索类比成“拿到一本有错说明书的新仪器,必须自己做实验搞懂它”。具体由两个沙盒实现:AlienCode 是一门小型计算语言,含 31 个发现目标——整数字面量被静默 XOR 27(EMIT(100) 打印 127)、PLUCK 实际从 1 开始计数而手册声称从 0 开始、看似“粉碎”的 SHATTER 实为乘法,且没有任何原语执行加法;AlienLogic 是一阶自然演绎系统,24 条推理规则被打过补丁(如禁止重复引用前提,$\neg\neg p\Rightarrow p$ 被禁用)。形式化上,一集 episode 是五元组 $(E,R,M,D,T)$:隐藏规则集 $R$、有缺陷手册 $M$、固定示例 $D$、held-out 任务集 $T$。系统只见 $M,D$,可对 $E$ 提交探针并读确定性反馈:以交互史 $h_t=(M,D,f_{<t})$ 为条件按策略 $\pi$ 选 $x_t\sim\pi(\cdot\mid h_t)$,四回合内修正假设状态 $H_t$。每个里程碑在禁工具副本中报告规则集 $S_t$ 并闭卷作答 70 题(每题 3 次取均值),得到 $(M_0,\dots,M_4)$ 曲线,主排名指标为 Best@3。
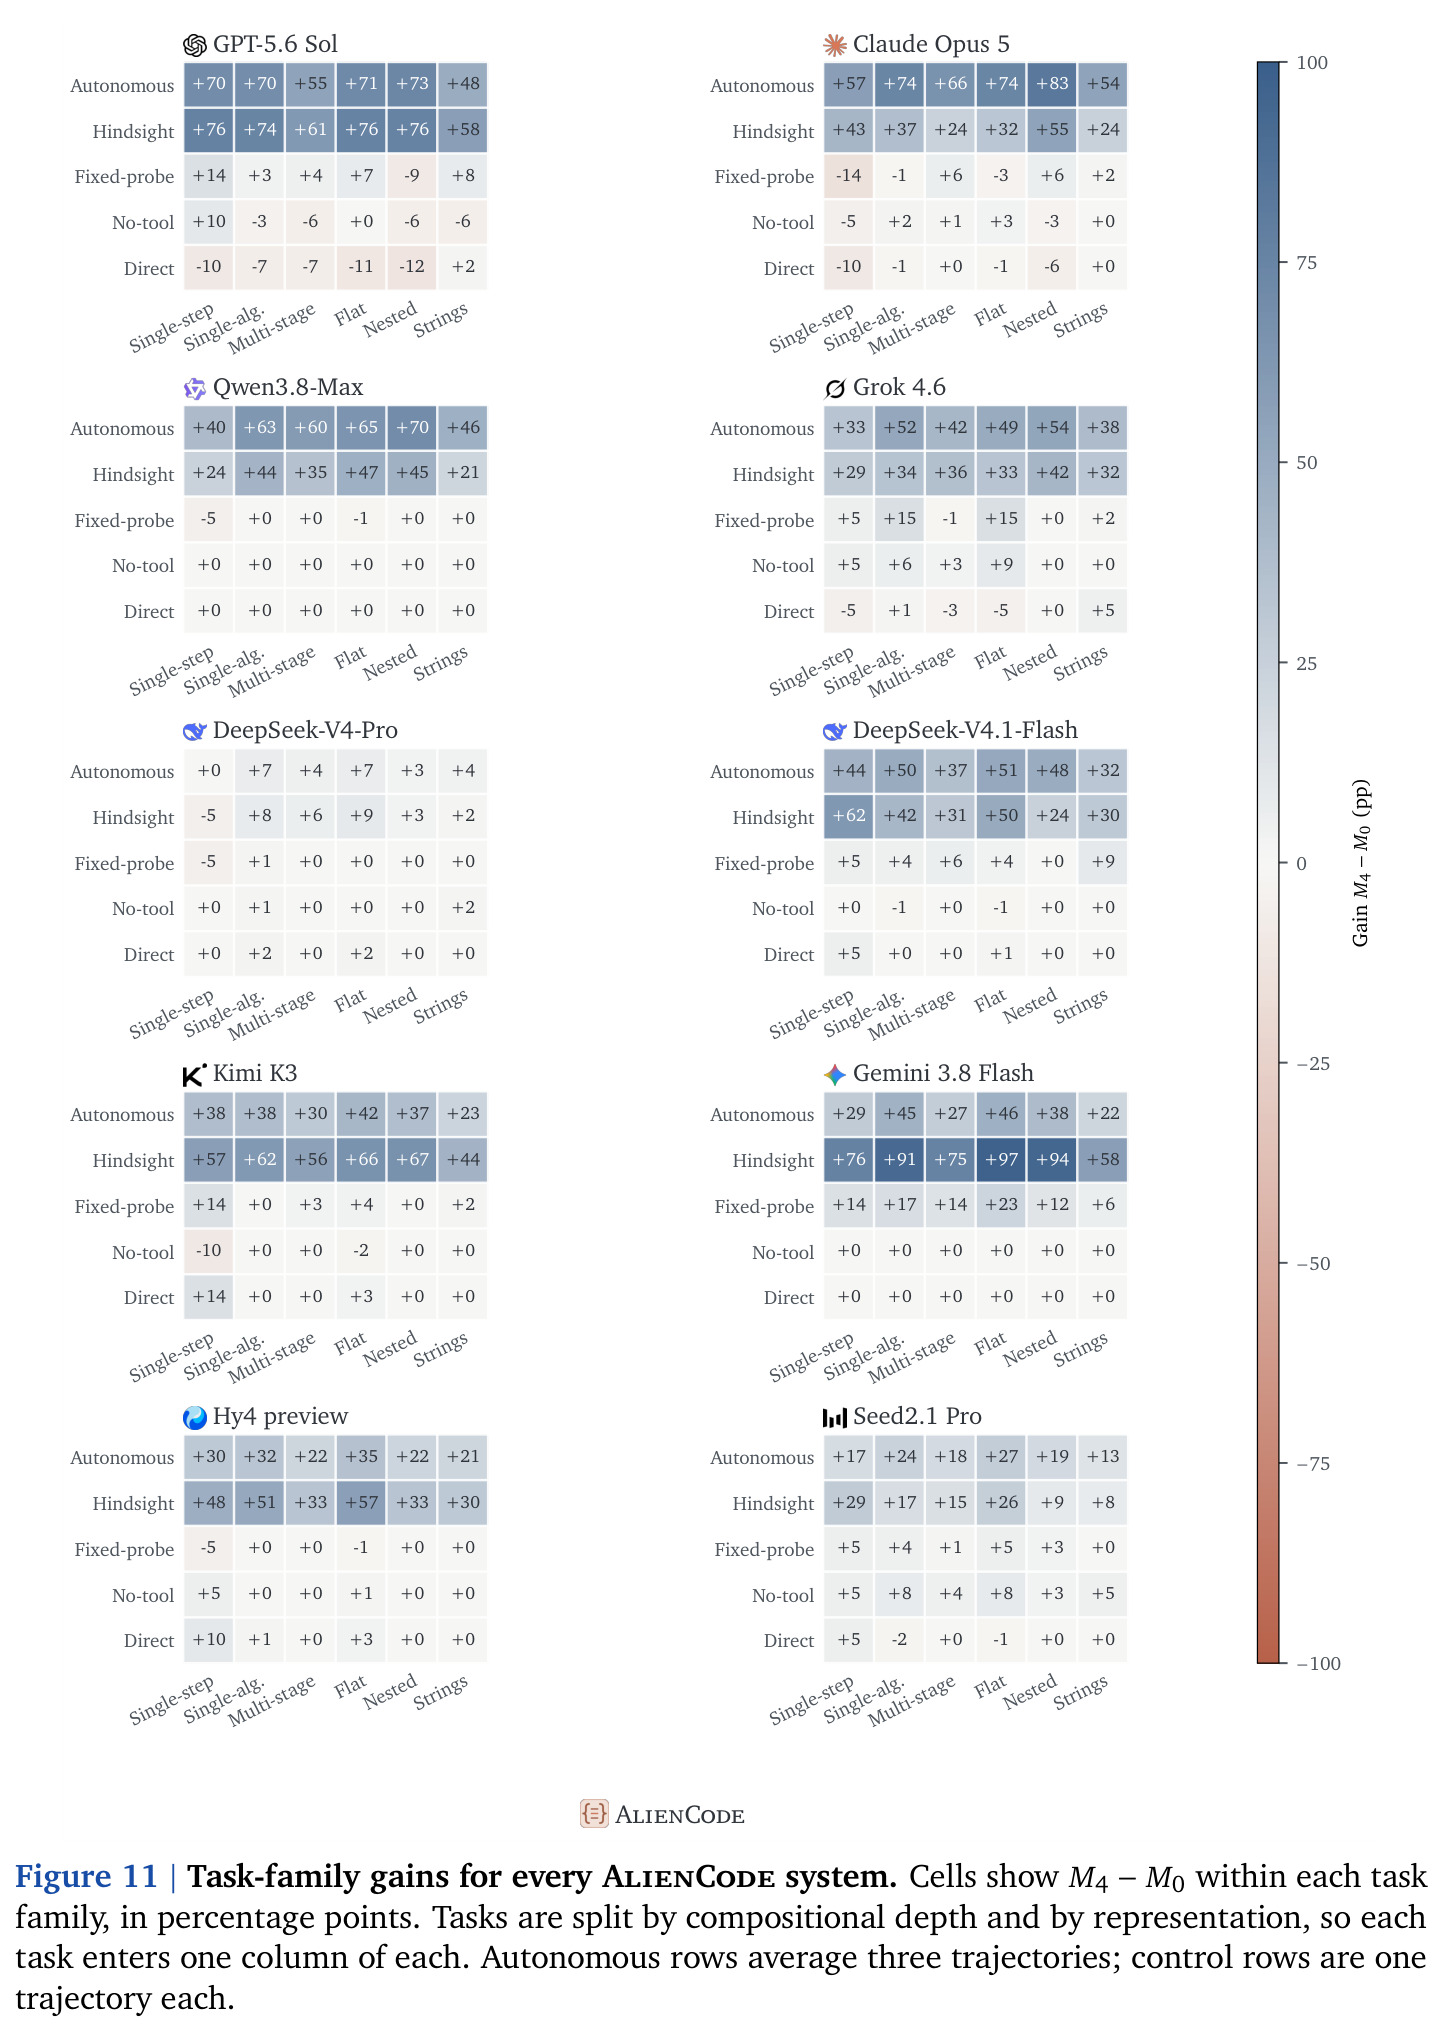
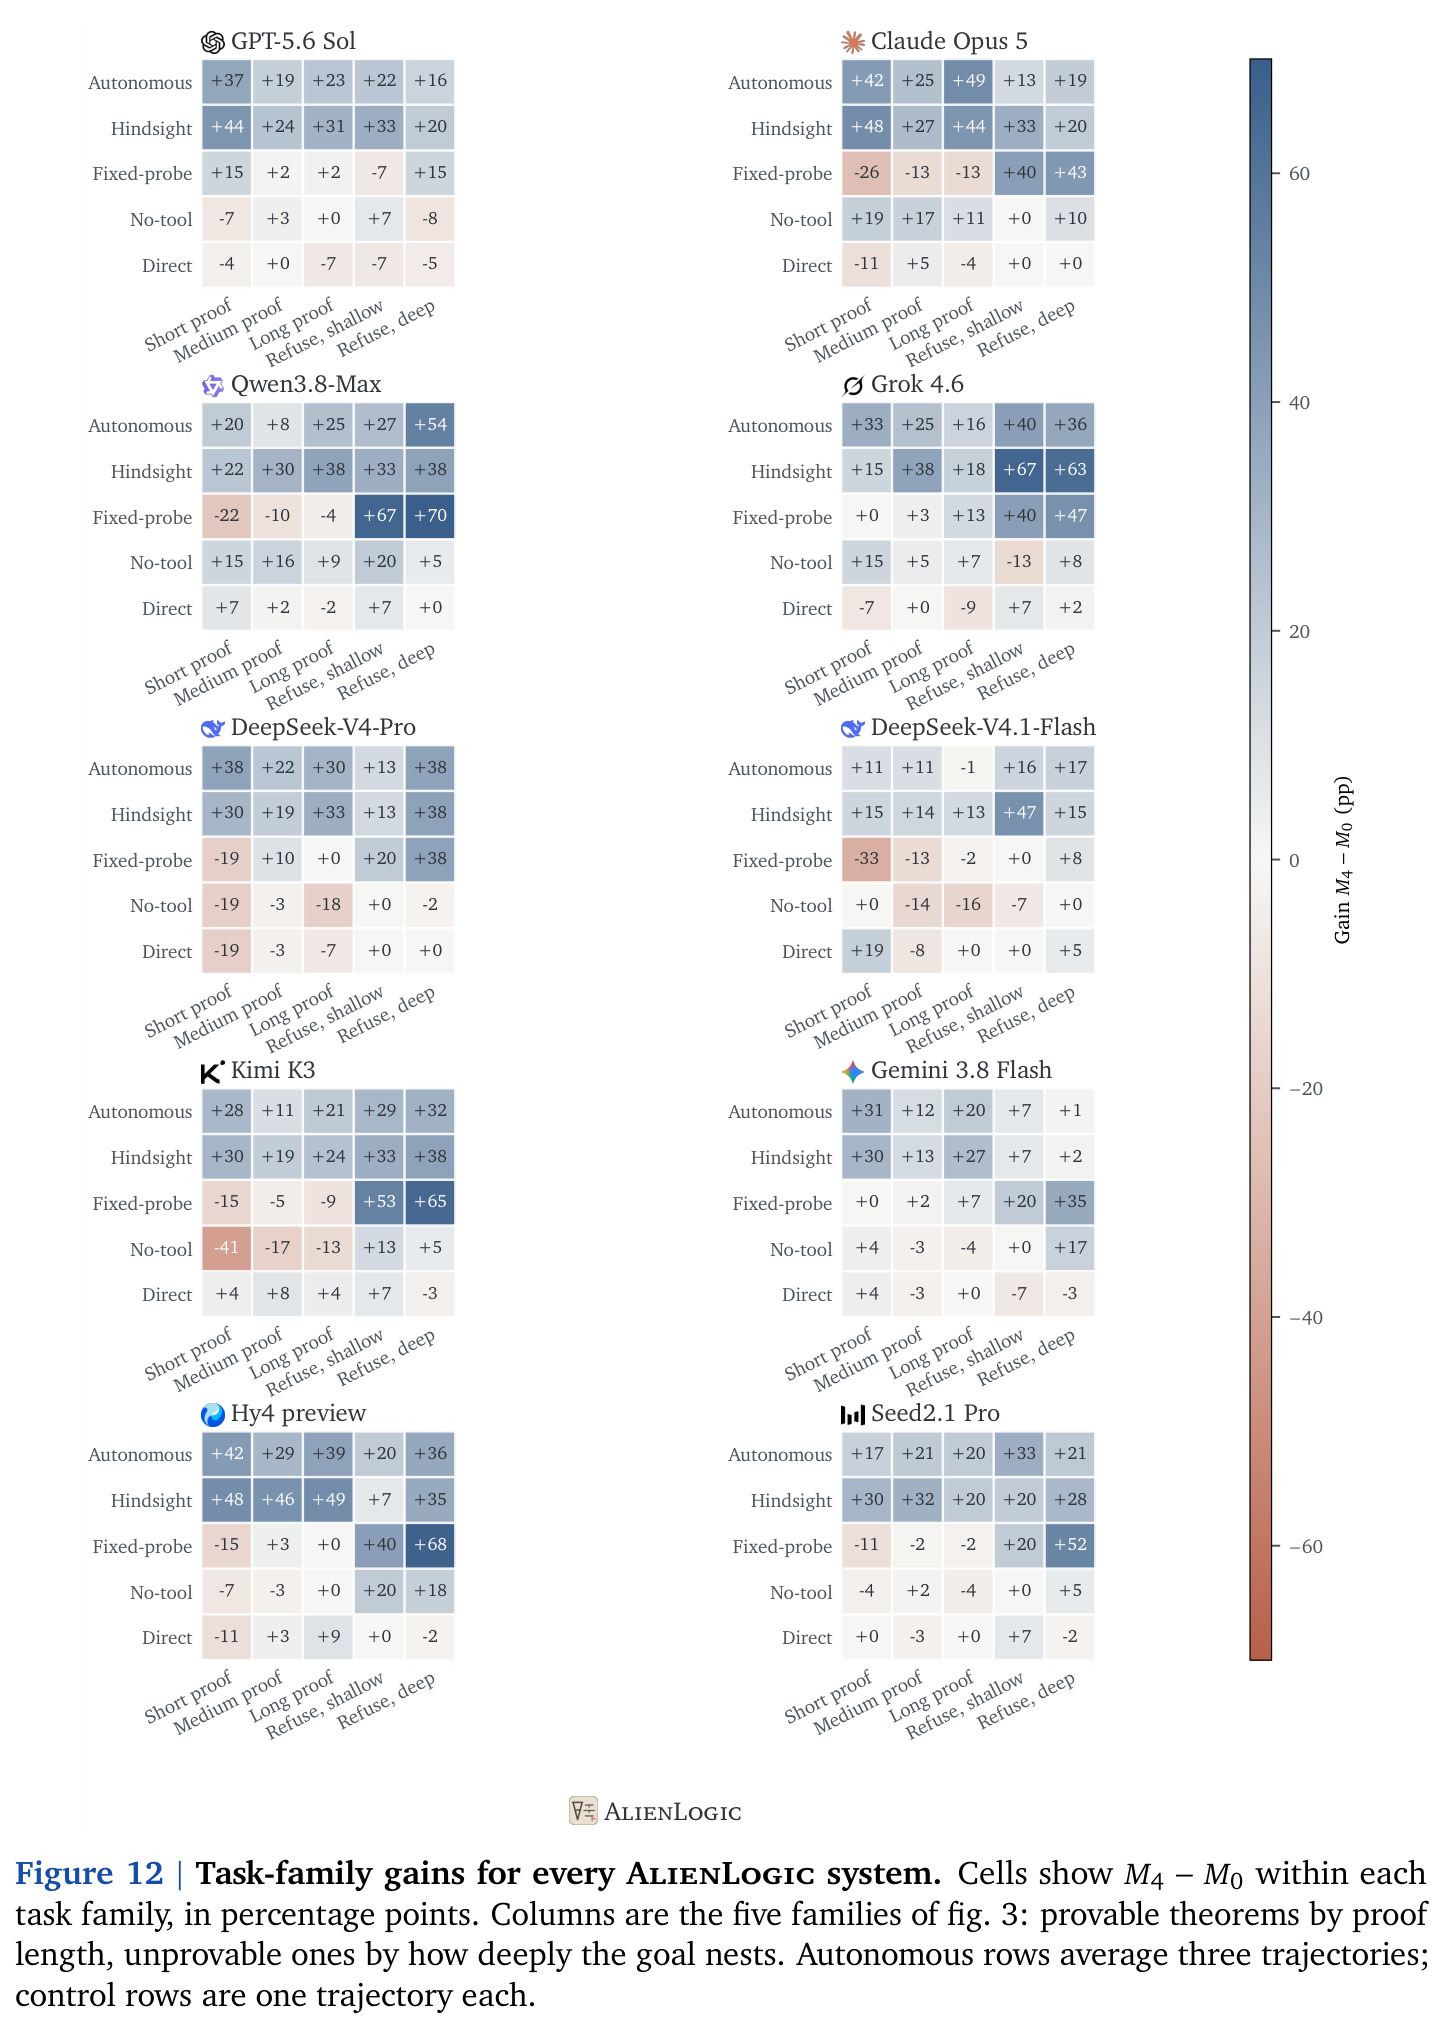
核心创新是把“评估探索”这个不良结构问题转化为两个可操作性质的正交组合。其一是可验证的异星性:规则可执行保证评分精确且确定(解释器在私有输入集上全对才算通过,证明检查器加有界证书判定“不可证”),规则反先验保证 recall 失效——探索前没有任何 AlienCode 轨迹超过 15.7%。其二是过程三分:把探索拆成探针选择(记录预算内的每个探针)、规律发现(每个里程碑让系统自述规则集 $S_t$,对 31 条评测规则逐条判对错)、规律使用(闭卷 held-out 准确率),三者分开报告而非合成单一分数。实验再用六种条件做控制:自主探索(自选探针)、hindsight(重放自己最佳轨迹的探针)、固定探针(全体共用同一模型无关序列)、无工具思考(同轮次模型轮但无环境反馈)、直接作答,以及开卷(O@$M_0$ 提前给全部规则,或 A4+O 探索后给),从而把“谁设计实验”与“证据是否到来”、“发现”与“使用”彻底解耦。
方法步骤详情
协议按五步执行。第一步种子阶段:所有系统收到相同的固定示例——AlienCode 给 10 个覆盖字面量、运算、序列、嵌套、函数体五种形态的示例(各附参考程序与解释器真实输出),AlienLogic 给 8 个合法证明示范;此阶段禁止工具调用,故每条轨迹的 $M_0$ 基于完全相同的证据。第二步探索阶段:四个回合,每回合最多 12 次工具调用(全程上限 48 次),AlienCode 按顶层 EMIT 参数计探针单元(每个 1 单位、循环体内每个 3 单位、单次上限 5),反馈限 15 行/600 字符;预算 $B=(C,P,T)$(调用数、探针单元、token)只记录不计分。第三步里程碑评测:在丢弃式、禁工具的对话副本中让系统报告 $S_t$ 并三答 70 题,副本随后销毁,测试永不变成后续回合的证据。第四步验证:69 道程序合成题需在 5 个私有输入上全部正确,1 道预测题需与解释器实际输出精确匹配,证明需通过检查器,“不可证”目标仅在正确拒绝时得分。第五步计分:$M_{r,t}=\frac{100}{3|T|}\sum_k\sum_\tau y^{(k)}_{r,\tau,t}$ 为三答均值,回答噪声 $\sigma_{r,t}$ 为三次单答分的标准差,Best@$n=\max_r M_{r,4}$,配合 Mean@$n$、最差值与全部轨迹一起报告。
技术新颖性
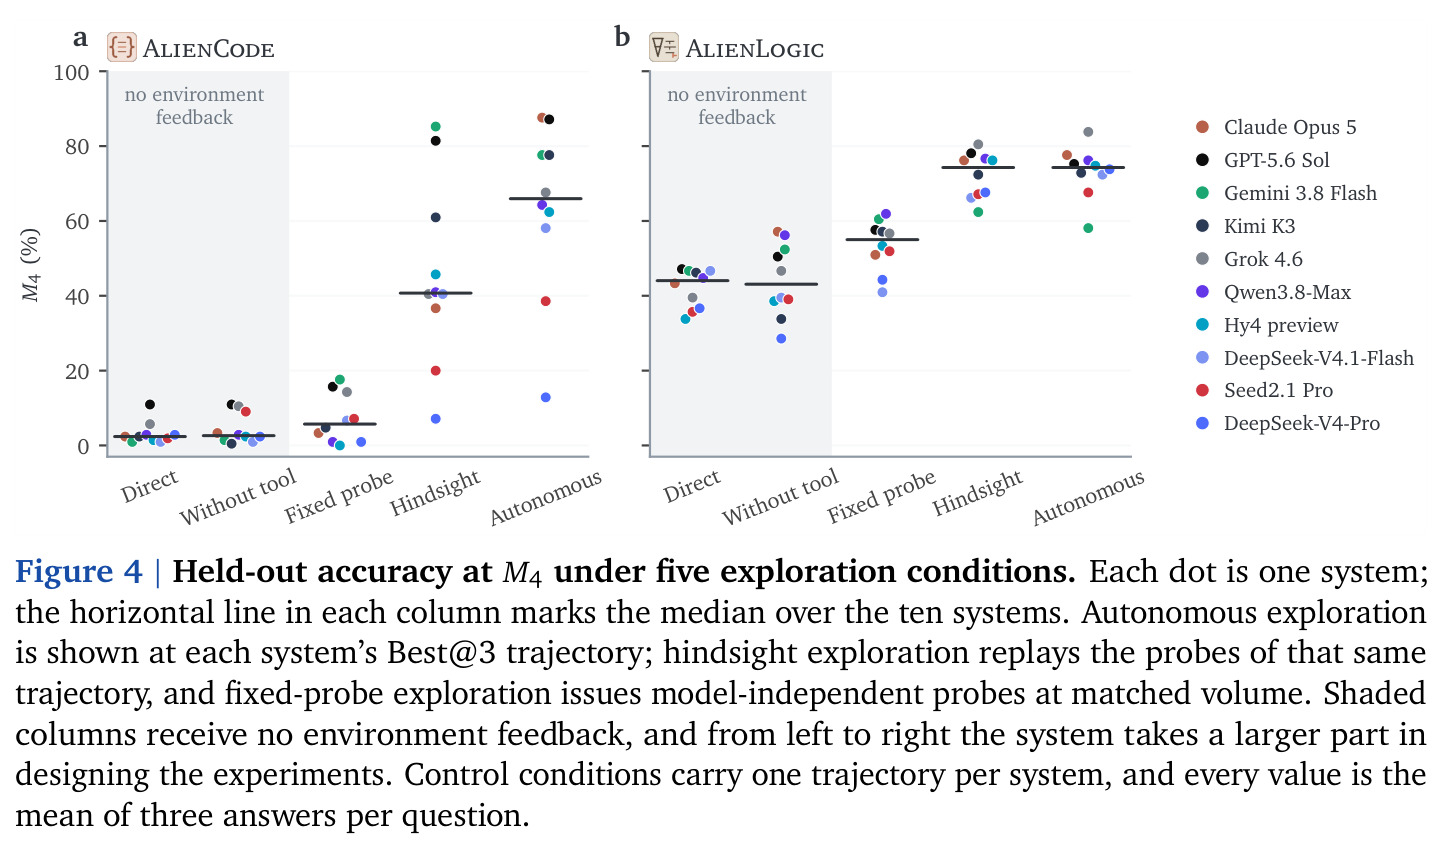
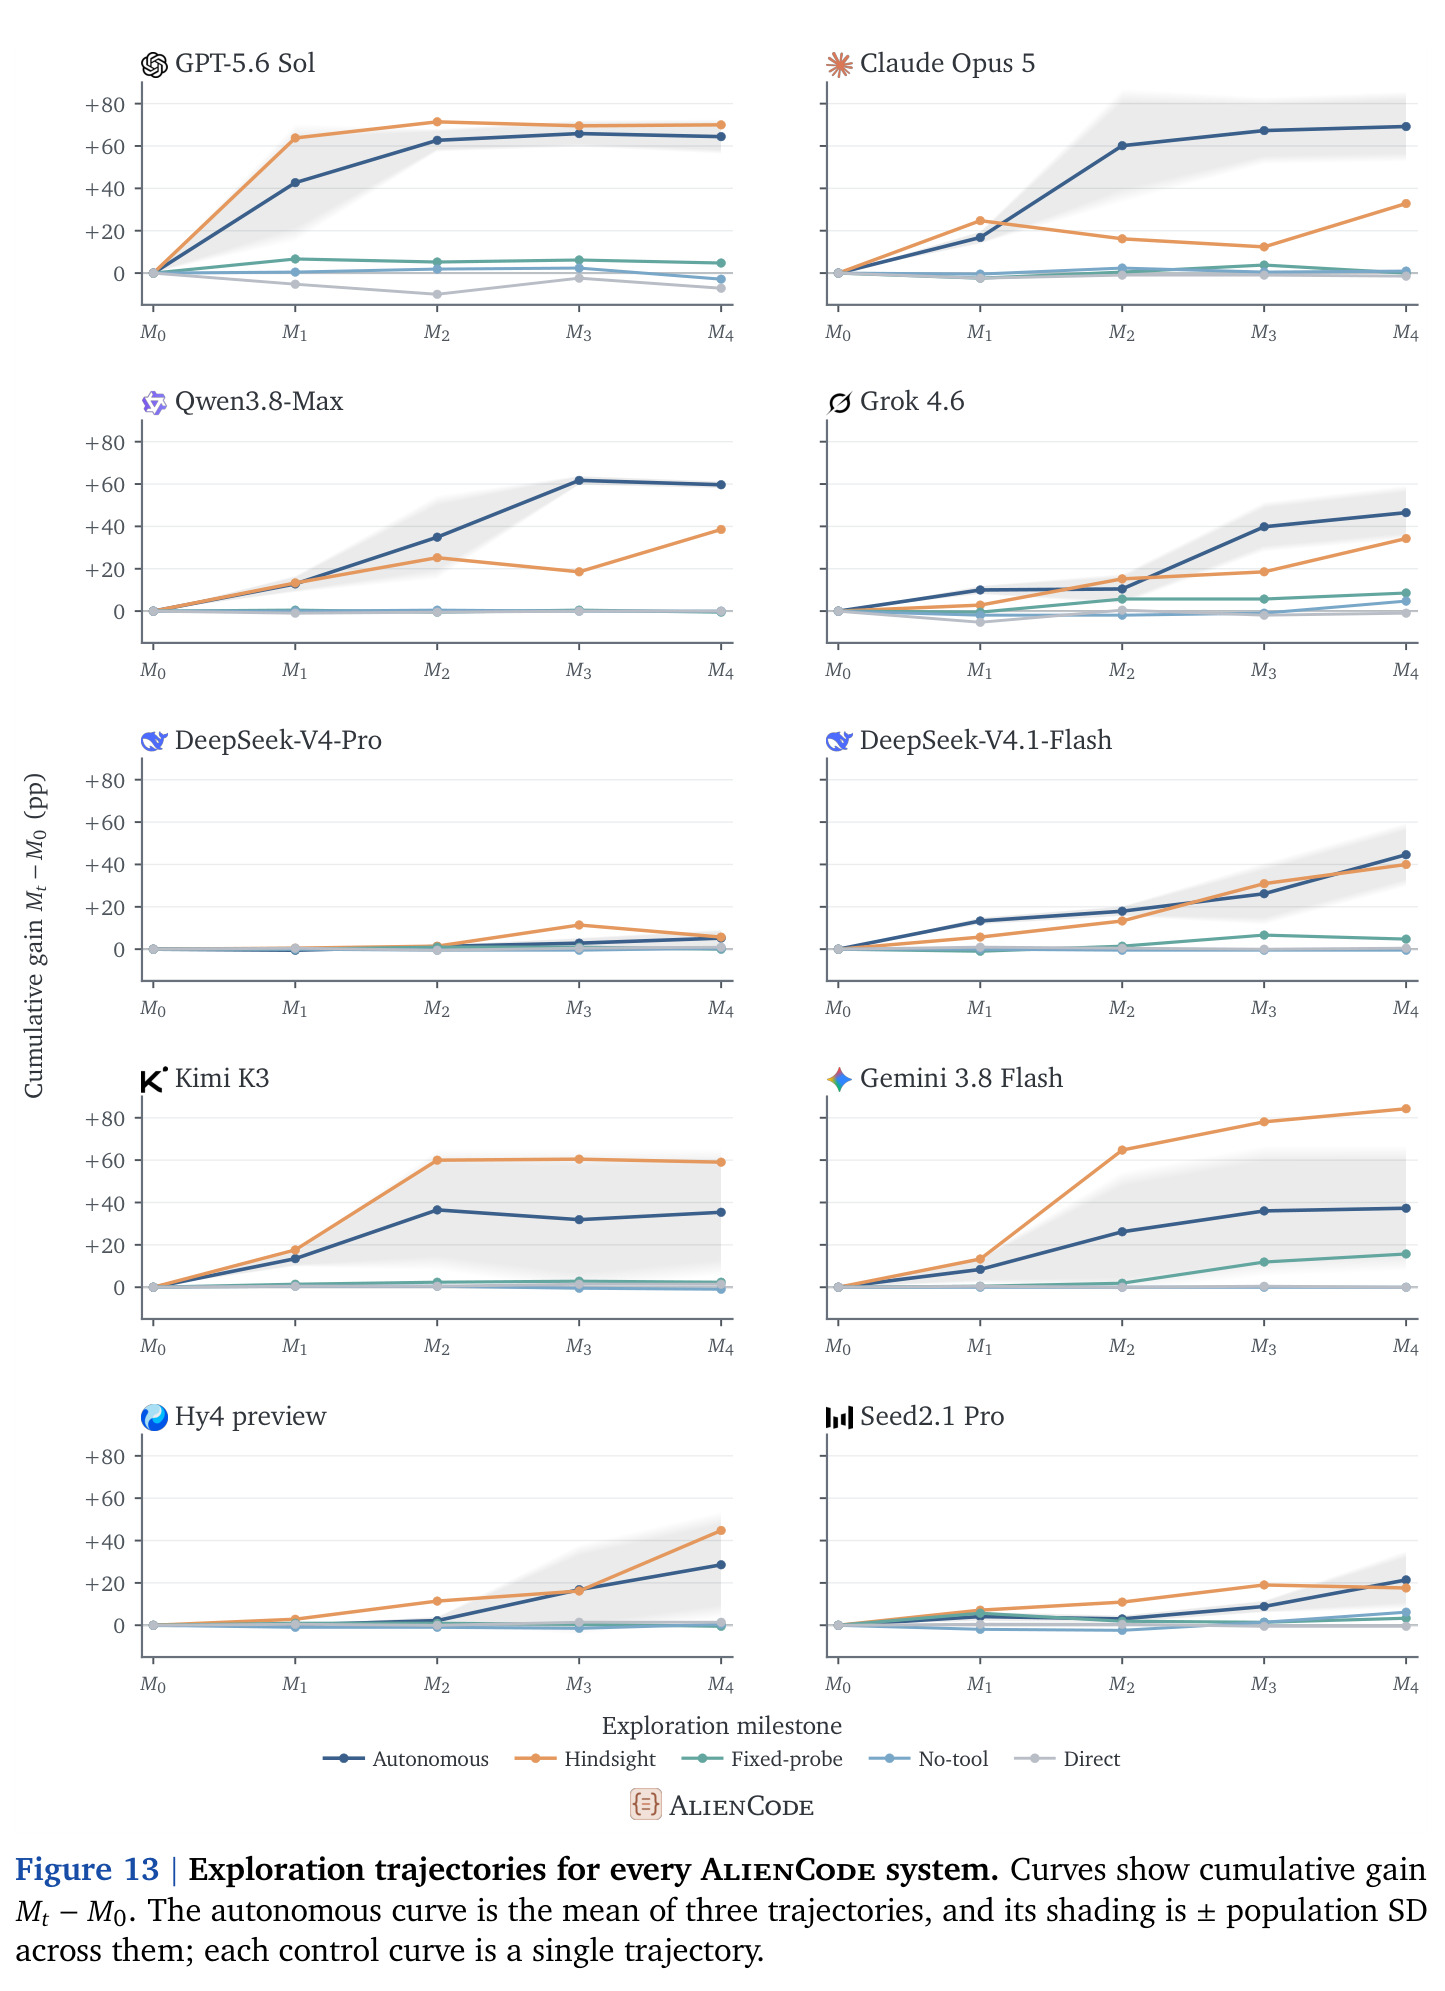
技术新颖性体现在四点。第一,反污染的构造方式:不是换数据集或混淆文本,而是改变世界本身的语义,使预训练知识系统性地指向错误答案,比去重清洗更彻底。第二,评分对象从“产出物”转向“迁移能力”:DiscoveryWorld/NewtonBench 评世界状态或方程本身,本文评交互结束后在未见任务上的闭卷表现,且验证完全可执行、无 LLM judge。第三,hindsight 对照在方法论上干净利落:环境确定性使重放的证据与原轨迹完全相同,唯一差异是谁决定测什么,因此 9/10 系统在 AlienCode 上的下降(中位 17.1 分)可直接归因于实验设计权的丧失。第四,Best@3 的定义坚持“完整轨迹”而非按题取并集(明确区别于 pass@$n$),杜绝拼接出任何智能体都未产出的合成结果;同时报告 Mean@3、最差值与全部轨迹以暴露方差。规则报告作为诊断量永不进入 $M_t$,避免了“自评即分数”的循环论证。
实验结果
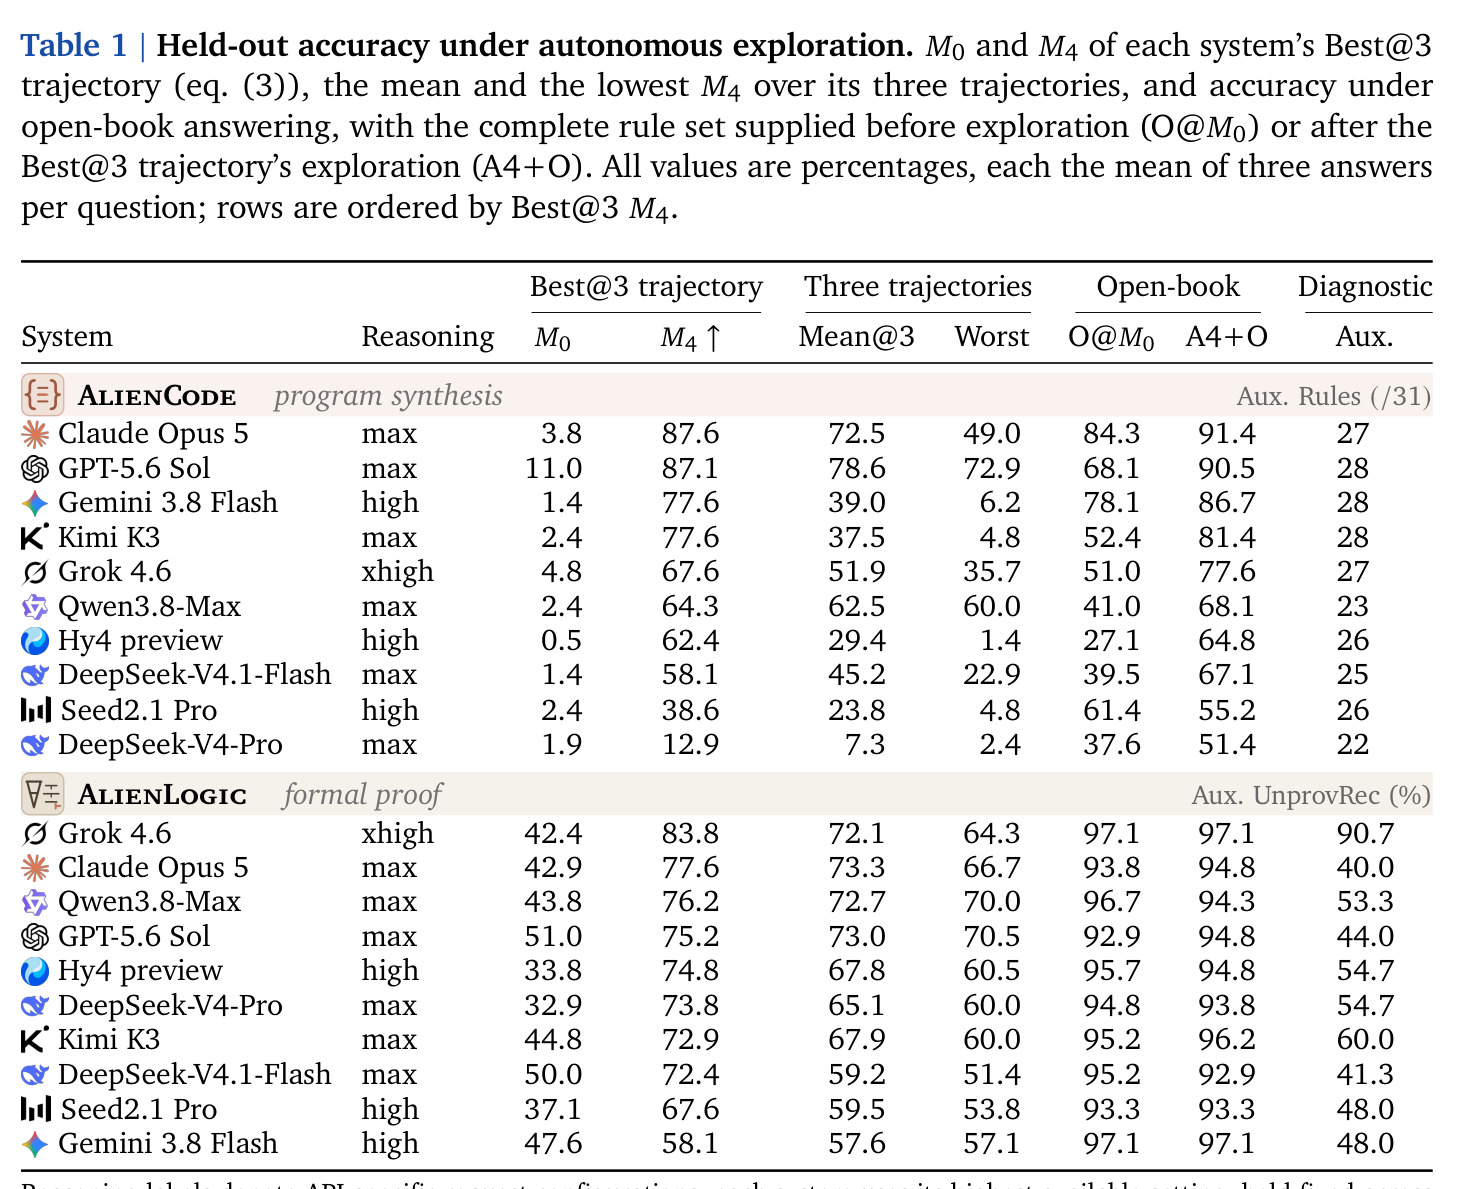
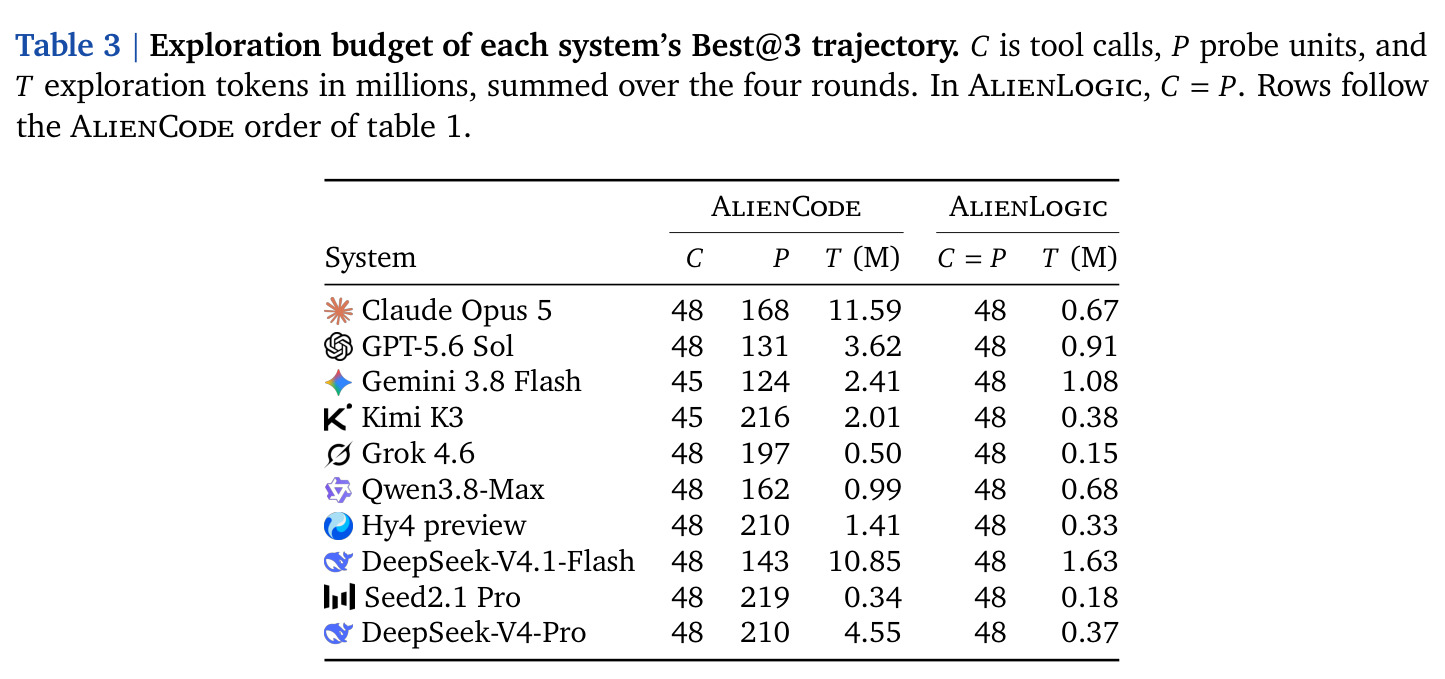
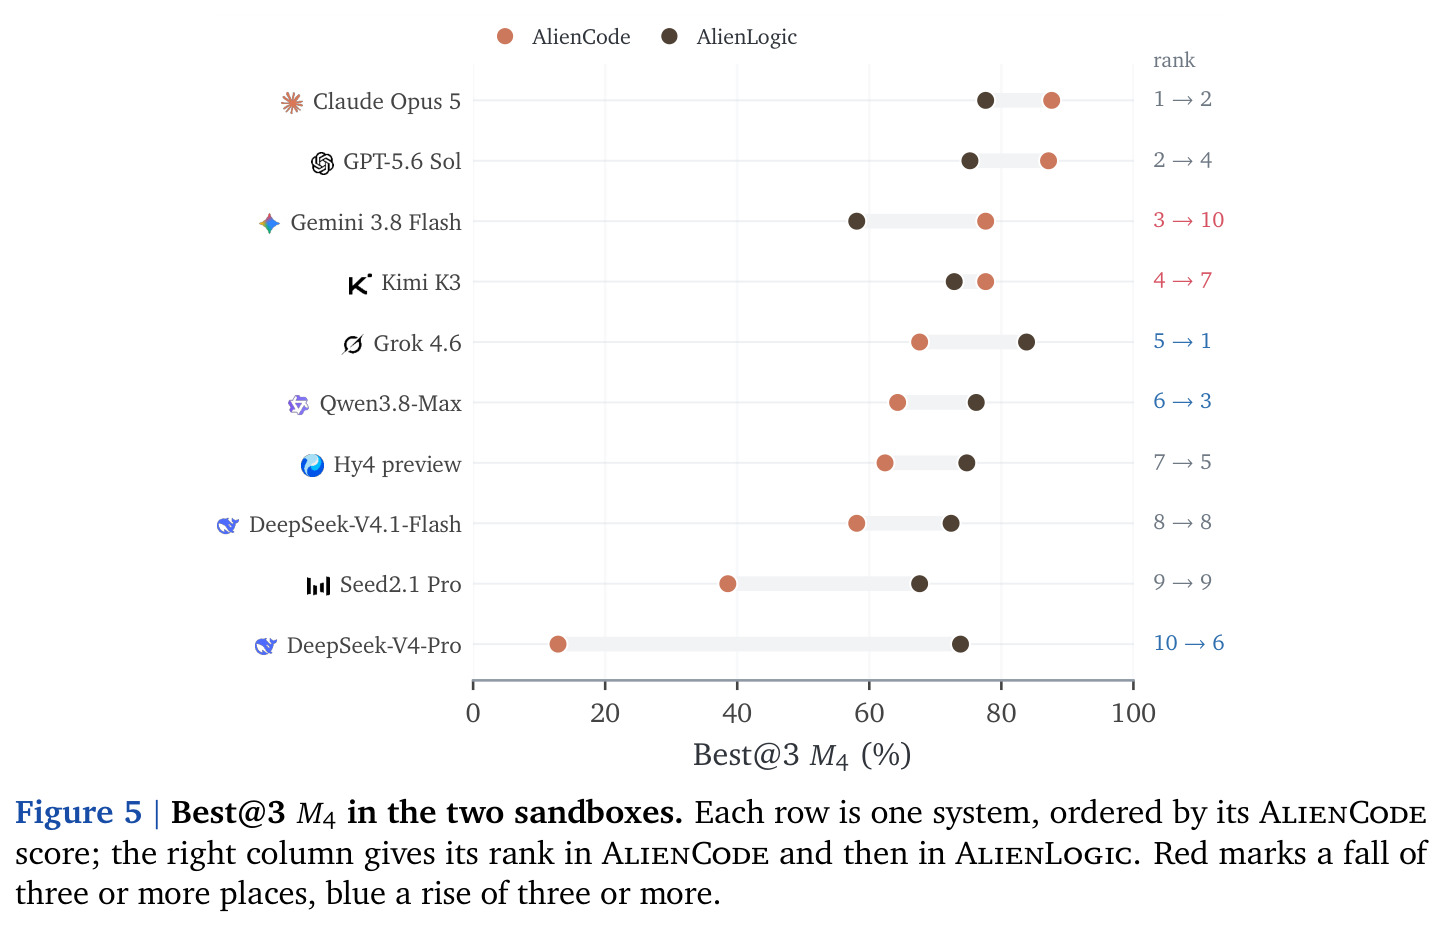
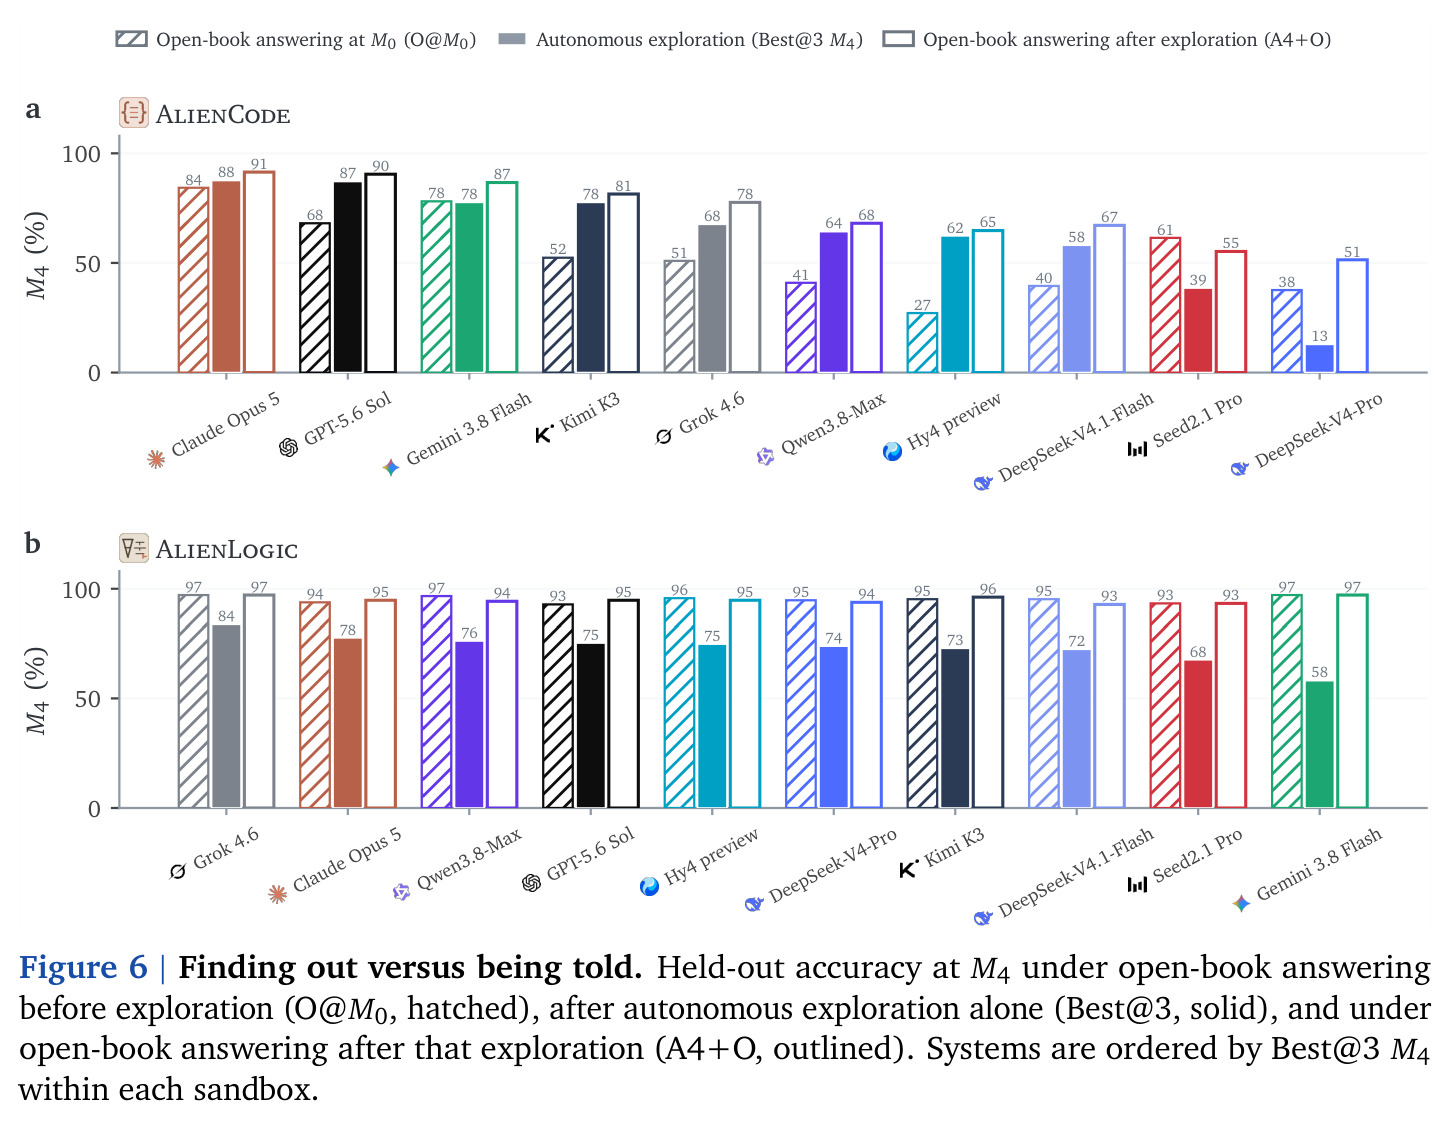
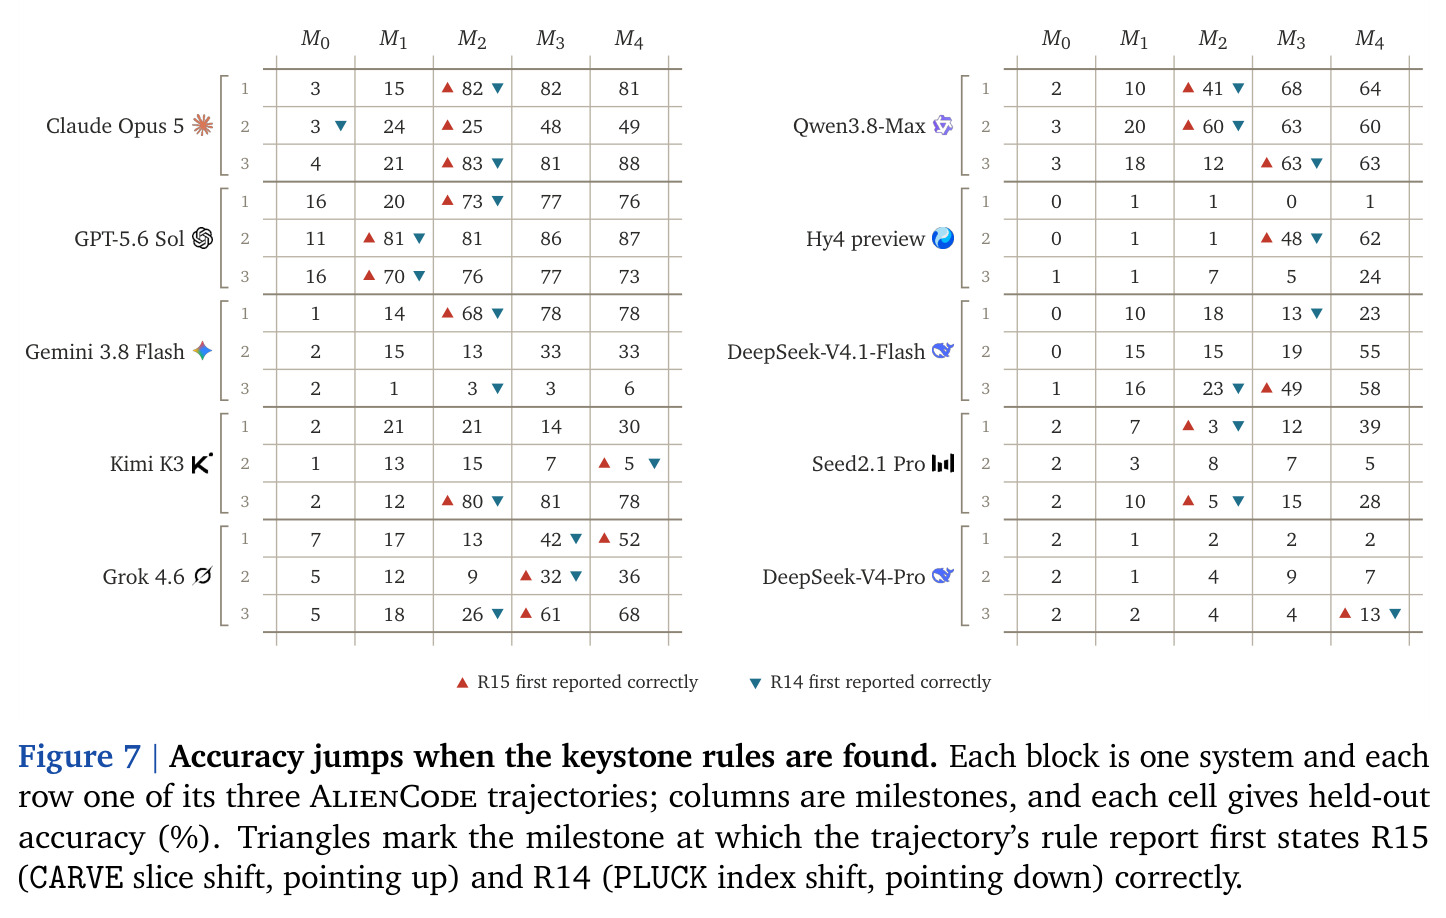
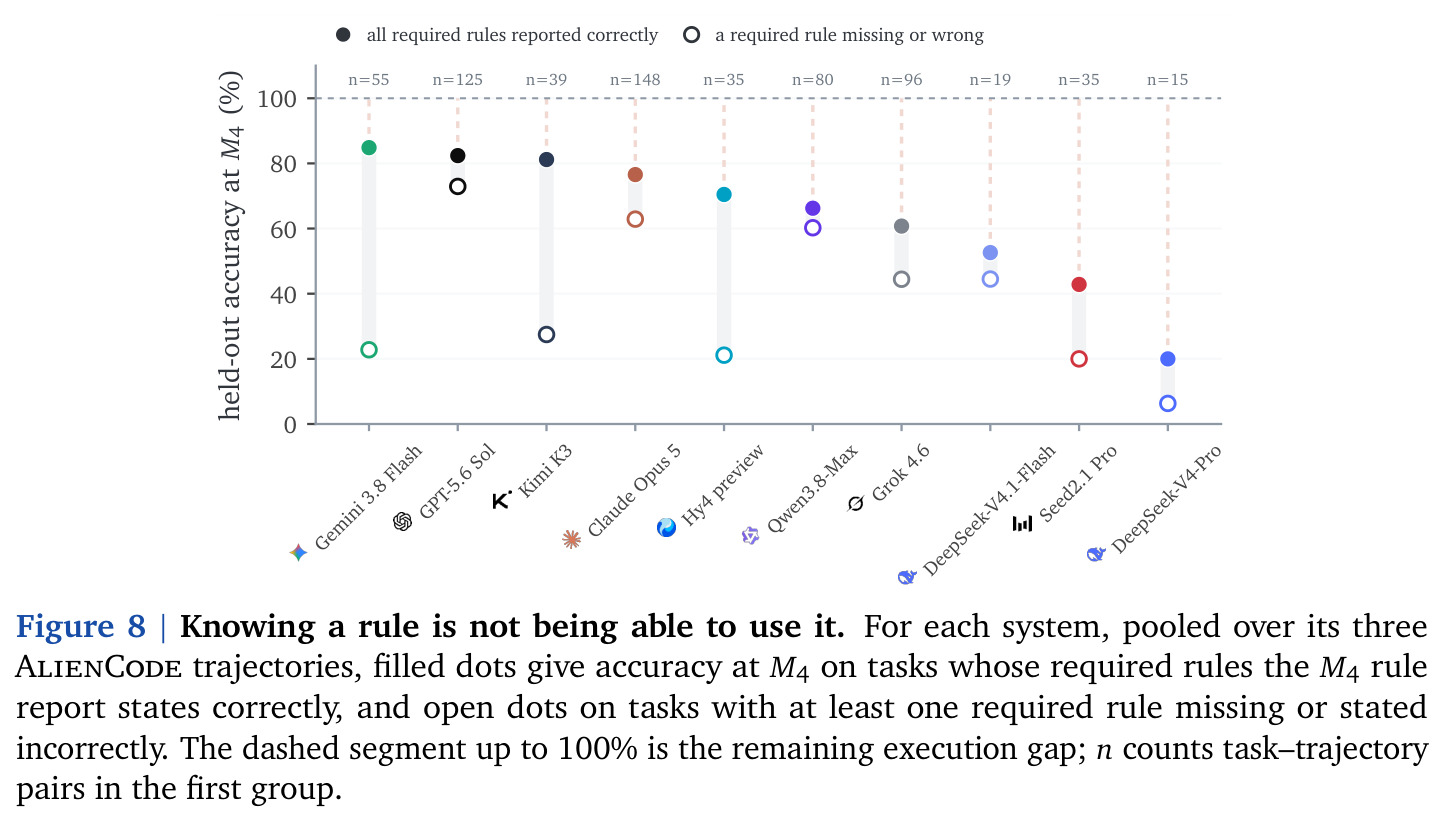
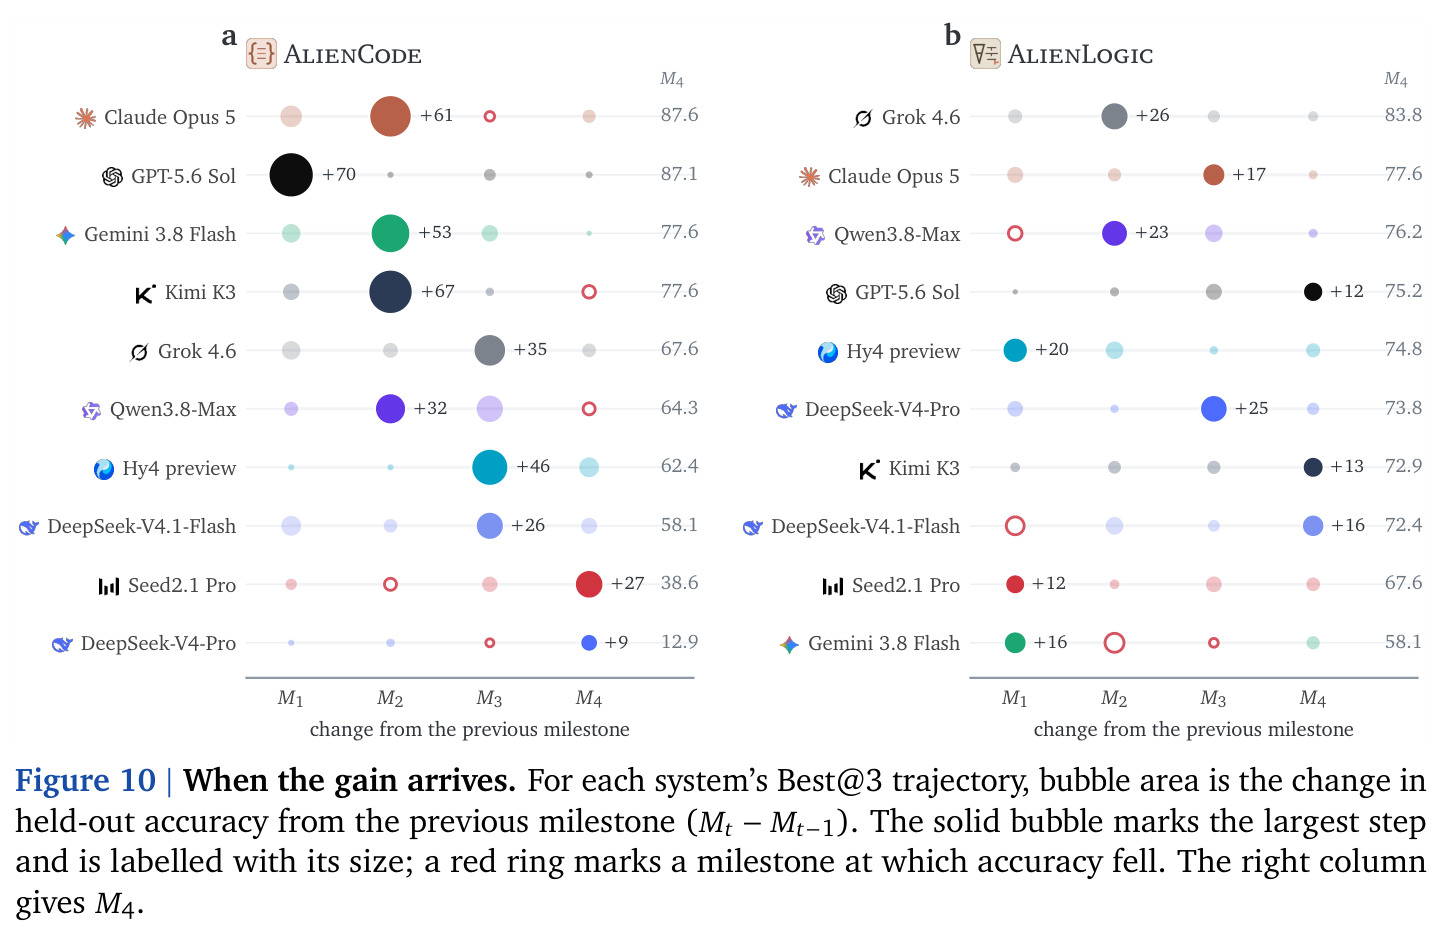
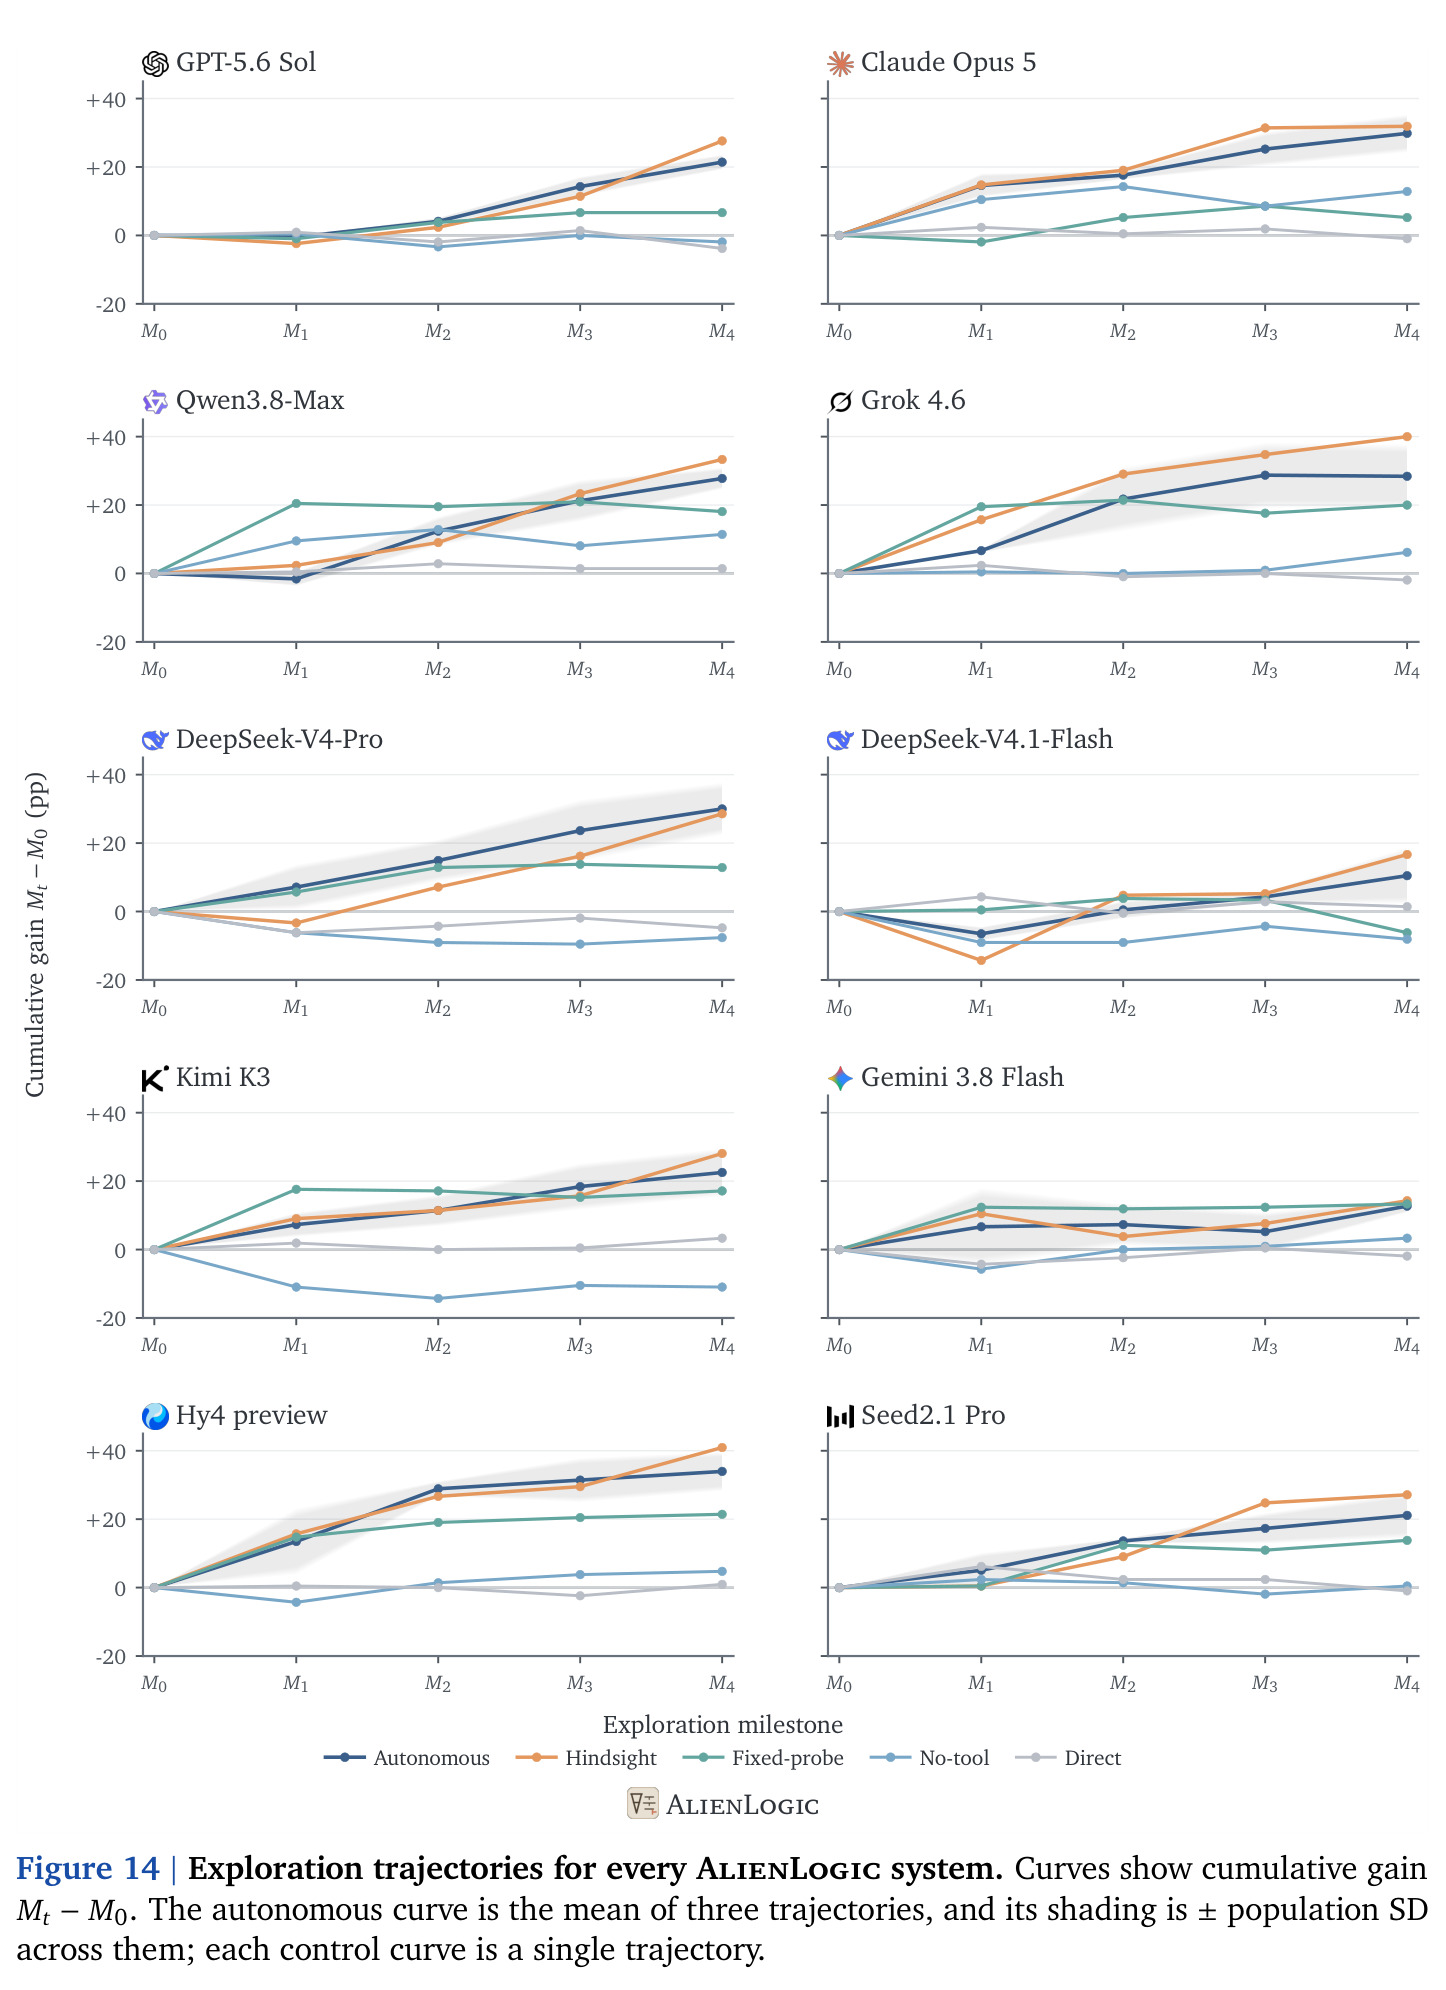
八条发现围绕三个问题。RQ1:探索而非记忆或纯思考产生所需知识——AlienCode 探索前所有轨迹 $\le 15.7\%$,四轮后 Best@3 达 87.6%(Claude Opus 5),7/10 系统超过 60%;同轮次无环境反馈的思考只停在 0.5–11.0%。AlienLogic 因补丁只改动部分推理规则,$M_0$ 即有 32.9–51.9%,最终升至 58.1–83.8%(Grok 4.6 最佳)。RQ2:发现与使用分离——AlienCode 中 7/10 系统的自主探索超过开卷(GPT-5.6 Sol 87.1% 对 68.1%,Hy4 preview 62.4% 对 27.1%),探索后再给规则(A4+O)在 26/30 轨迹上再提中位数 14.5 分;AlienLogic 相反,开卷 93–97% 无任何轨迹能及,瓶颈在发现而非使用。两块基石规则 R14(PLUCK 索引移位)与 R15(CARVE 切片移位)覆盖 51/70 题,13 次 $\ge 30$ 分的跳变中 12 次与 R15 首次报告正确同轮、11 次与 R14 同轮;规则报告正确条数与 $M_4$ 相关 $r=0.85$,但报告全对的任务仍只有 70.9% 解出(647 个任务-轨迹对),知行脱节明显。RQ3:探索不可靠——同系统同预算轨迹相差最多 72.8 分(Kimi K3 终点 4.8–77.6%,Gemini 3.8 Flash 6.2–77.6%),而三答噪声 $\sigma\le 4.7$ 分(AlienLogic $\le 2.9$);每条轨迹都花满 45–48 次调用,差距不在努力程度;最大单步占保留增益 45–92%,且 6/30 条 AlienCode 轨迹终点低于此前里程碑至少 3 分(AlienLogic 3/30)。跨任务泛化差:两沙盒 Best@3 排名 Spearman 仅 0.35,Grok 4.6 从第五跳到第一,Gemini 3.8 Flash 从并列第三跌到最后。实验设计权在 AlienCode 至关重要:自主 66.0% 对 hindsight 40.7% 对固定探针 5.7%(十系统中位数),但在 AlienLogic 中自主与 hindsight 打平(0.5 分)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| AlienCode 自主探索(4 轮后闭卷解题) | held-out 准确率(Best@3 $M_4$) | 87.6%(Claude Opus 5),7/10 系统超过 60% | 同轮次无环境反馈(without-tool)0.5–11.0%;探索前 $M_0$ 全部 ≤15.7% | 比无反馈对照最高约 +77 个百分点,证明增益来自环境证据而非额外思考轮次 |
| AlienLogic 自主探索 | held-out 准确率(Best@3 $M_4$) | 83.8%(Grok 4.6),十系统区间 58.1–83.8% | 开卷 O@$M_0$(直接给全部规则)93–97% | 自主探索仍落后开卷约 9–39 个百分点:AlienLogic 的瓶颈在“发现”而非“使用” |
| 探针设计权对照(AlienCode) | 十系统 $M_4$ 中位数 | 自主探索 66.0% | hindsight 重放 40.7%;固定探针 5.7% | 自主比重放中位高 17.1 分(9/10 系统胜出)、比固定探针高 60.3 分——自己设计实验至关重要 |
| 发现 vs 被告知(AlienCode) | Best@3 $M_4$ 对比 O@$M_0$ | GPT-5.6 Sol 87.1% vs 68.1%;Hy4 preview 62.4% vs 27.1%;7/10 系统自主探索胜出 | 开卷提供完整规则集(O@$M_0$) | A4+O 在 26/30 轨迹上高于 O@$M_0$,中位 +14.5 分:探索不仅给规则还给使用规则的练习 |
局限与改进
作者坦承的局限:基准刻意把探索化简为两个确定性、可执行的世界,因此每个实验与答案都有精确结果,但真实科学探索包含噪声与不完全观测、昂贵或不可逆的实验、开放假设空间以及远超四回合的时间尺度,本文结果只说明系统能否在可验证合成环境中习得陌生规则,不等于能做真科学发现;每系统 3 条轨迹、每题 3 次回答虽暴露了方差,仍不足以精确估计分布。我的补充观察:其一,闭源 API 快照(如 GPT-5.6 Sol、Claude Opus 5)会随版本迭代失效,排名难以跨时间复现;其二,AlienLogic 补丁只覆盖部分规则,$M_0$ 已达 32.9–51.9%,且 8/10 系统挤在 72.4–83.8% 的窄带内,区分度不足;其三,扰动模式(XOR 常数、off-by-one、作用域切换)种类有限,模型可能靠枚举常见扰动族部分猜中;其四,全程限制在单一上下文窗口内,无法考察跨会话知识积累与外部记忆;其五,Best@3 天然奖励高方差系统,作为唯一主指标可能误导选型。
独立分析的弱点
独立分析四点弱点。第一,预算短且实验免费:四回合 48 次调用、反馈限 15 行,且环境无任何成本,现实科学实验昂贵且不可逆,系统从未学过“值不值得做这个实验”——改进方向是引入实验代价与不可逆性机制、拉长时间尺度。第二,探索增益呈单步跳跃(最大单步占保留增益 45–92%)说明系统缺乏系统化的实验设计策略,成功更像碰上一个关键探针(如 GPT-5.6 Sol 一条 12 次调用内的探针同时暴露 R14/R15,精度 11.0%→81.0%),可引入信息增益最大化、最优实验设计等主动学习方法作为显式解码或训练目标。第三,发现会退化:Gemini 3.8 Flash 在 AlienLogic 的 $M_1$ 曾正确拒绝不可证目标 H13,后来却“学到”被检查器拒绝的 reit 绕过套路并写进规则报告,精度 63.8%→52.9%——需要信念修正与反事实检验机制,防止后见推翻前知。第四,知用脱节:规则报告全对的任务仅 70.9% 解出,两条轨迹双基石规则全对却终局 4.8% 与 12.9%(Kimi K3 在函数体内把字面量按顶层规则 XOR 27 而非 53 编码,索引越界报 IndexError),说明陈述性知识没有编译成可执行技能,需要规则→行为的落地训练方案。
未来方向
作者展望:同样的设计可推广到任何“陌生规则可执行、后果可精确验证”的领域,为面向科学发现的 AI 系统提供测试台。可延伸的方向包括:其一,把沙盒从确定性扩展到随机与部分可观测环境,加入实验成本、安全约束与不可逆动作,逼近真实实验科学;其二,用 $M_0\to M_4$ 曲线与轨迹方差作为奖励或早停信号训练专门的探索策略(探针选择器),或把自主与 hindsight 的差距(中位 17.1 分)作为“实验设计能力”的直接优化目标;其三,研究跨世界的元探索能力——两沙盒 Spearman 仅 0.35,若构造规则扰动族库,可测量“探索技能”本身能否迁移;其四,把规则报告与行为的一致性(70.9% 的知行差距、报告退化但精度反升 11.4%→16.8% 的现象)用作可解释性诊断工具;其五,延长回合数并允许外部记忆,考察增益可逆性(6/30 轨迹倒退)能否被记忆固化机制消除;其六,固定探针几乎无效(中位 5.7%)说明被动数据无益,可进一步量化“多大信息量的被动数据”与主动探针的等价交换率。
复现评估
复现评估:论文给出项目网站 www.explorationbench.com,正文未明确声明代码开源,但评分完全自动化(解释器 + 证明检查器 + 有界证书),无需人工或 LLM 评审,沙盒构造与预算记账在附录描述较充分。主要成本是闭源 API 调用:按表 3,单条 Best@3 轨迹的探索 token 从 0.34M(Seed2.1 Pro)到 11.59M(Claude Opus 5,AlienCode)不等,AlienLogic 较低(0.15–1.63M);加上每个里程碑 70 题 × 3 次禁工具作答(完整历史随行进入上下文),10 系统 × 3 轨迹 × 2 沙盒 × 6 条件的完整矩阵估计需数千美元 API 费用。复现难点有三:模型版本快照(如 Qwen3.8-Max 0902、Seed2.1 Pro 0915)会下线导致排名不可比;固定探针与 hindsight 条件需要严格实现工具调用协议与探针单元计费规则;沙盒的 31+24 条隐藏规则集若不开源则只能依赖作者发布。总体难度中高,但单系统单沙盒的最小复现(3 条轨迹)成本可控。
论文图表