训练世界模型中的客体永久性 Training Object Permanence in World Models
用150个认知科学任务与150万样本微调视频世界模型,使其习得客体永久性与坚实性
前置知识
客体永久性 (Object Permanence, OP)
发展心理学的核心概念,指物体在被遮挡、移出视野后依然持续存在的表征能力。经典证据来自Baillargeon的违反期望实验:3.5个月大的婴儿看到小车应被遮挡屏挡住却“穿过”时,会注视更久,说明他们已在脑中维持被遮挡物体的存在与位置。对视频生成模型而言,OP意味着物体进入遮挡区后,必须以相同的身份、数量、尺寸从正确位置重新出现。
本文全部任务设计与评测都围绕模型是否具备“看不见时仍保持什么在哪里”的能力展开,不理解OP就无法理解六个任务族中三个族的设计意图。
物体坚实性 (Object Solidity, OS)
核心知识系统中最原始的物理约束之一:两个刚体不能互相穿透,支撑物移除则物体应立即下落,碰撞传递动量而非融合或消失。婴儿在半岁内就能区分遵守与违反坚实性的事件,成人视觉系统中该约束也是自动、非推理式的(Falck et al., 2020)。对视频模型而言,OS意味着要根据孔径与物体的尺寸关系判断能否通过、支撑移除要触发下落、碰撞后物体数量守恒且轨迹发散。
WROP六个任务族中的阻碍、坠落、碰撞三族专门测这一能力,也是被评测模型最普遍、最顽固的失败点。
违反期望范式 (Violation-of-Expectation, VoE)
发展心理学测前言语婴儿的经典方法:同时呈现“可能事件”与“不可能事件”,若婴儿对不可能事件注视时间显著更长,说明其内在预期被违反,即具备了相应物理先验。本文把这一范式倒转:不给模型做二选一判断,而是要求它直接生成物理上合理的视频续写,把“测量惊讶”变成“生成考试”。
WROP的OP-1和OS-1任务直接以Baillargeon的实验装置为蓝本,理解VoE才能理解任务设计的认知科学依据,以及它与婴儿实验的本质区别。
视频到视频的三种接口类型
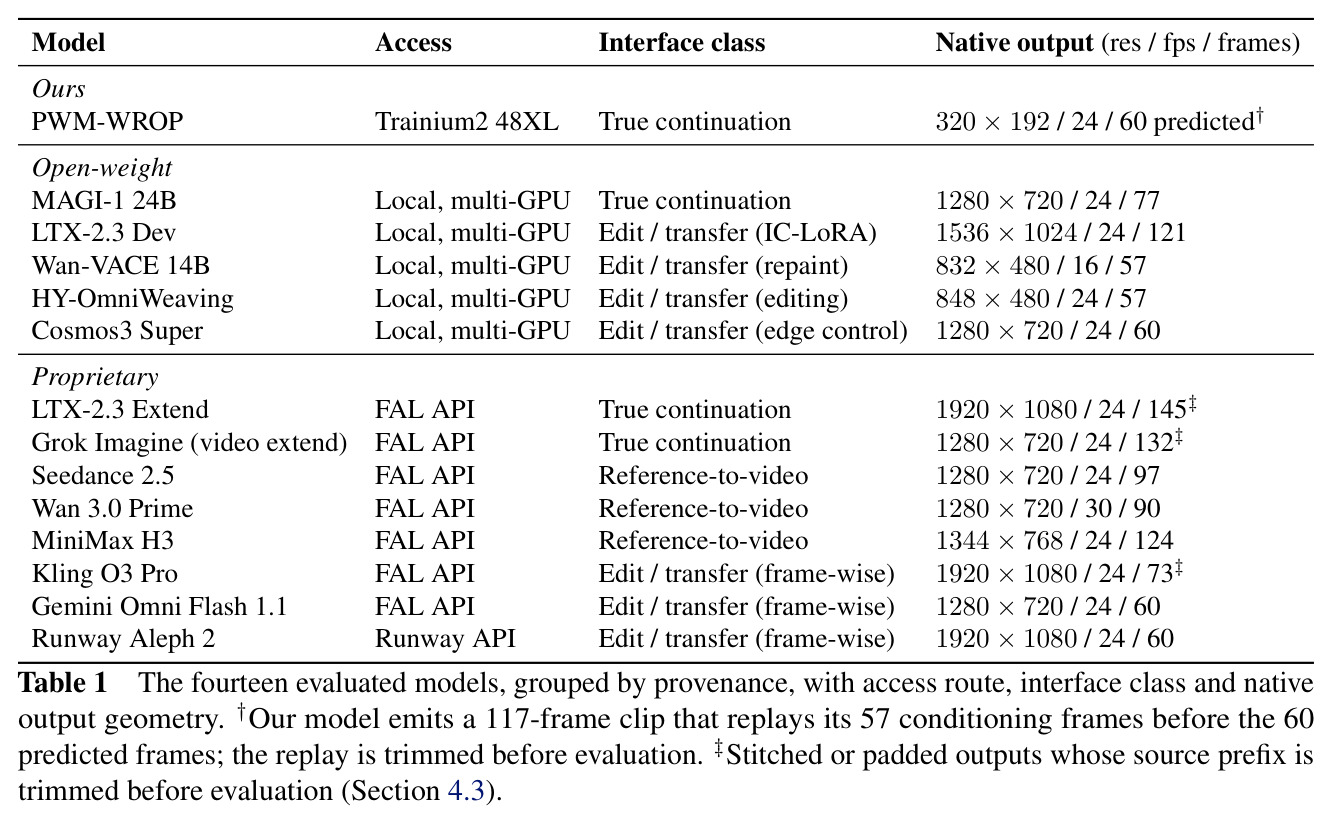
本文把14个被测模型分为三类:真续写(true continuation)模型把输入片段当帧前缀、接着合成后续帧;参考到视频(reference-to-video)模型把输入当视觉参考、按自己的时间线重新生成整个事件;编辑/迁移(edit/transfer)模型逐帧重绘输入区间,输出与输入时间重合、结构上无法表现输入结束之后才发生的事件。三类模型与考试的“契约”根本不同。
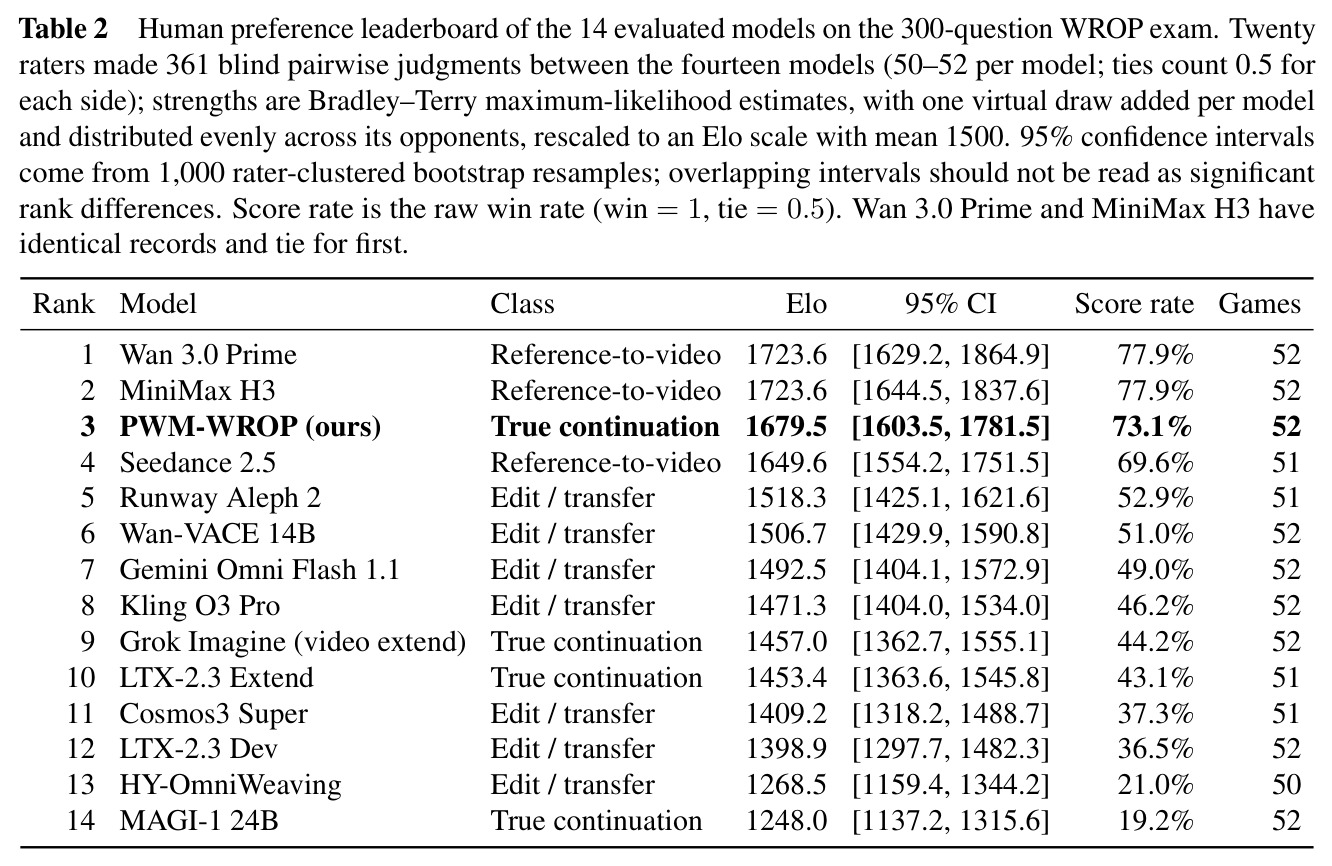
这是理解结果榜单分层的关键——榜单前几名与中间段的分布几乎完全由接口类型解释,而不是模型规模或参数量。
Bradley–Terry 模型与 Elo 评分
从成对比较结果估计各对象强度的统计模型:模型 $i$ 胜过模型 $j$ 的概率为 $p_{ij} = \frac{e^{s_i}}{e^{s_i}+e^{s_j}}$,通过极大似然估计强度 $s_i$,再线性映射到均值为1500的Elo刻度;平局计作半胜。不确定性通过对标注者做聚类bootstrap重采样(本文1000次)得到置信区间。
本文的主要指标是人类盲评Elo,所有排名结论(包括“领先224 Elo”)都建立在这个模型及其置信区间之上。
研究动机
Sora、Veo 3.1、Kling 等新一代视频生成模型画面逼真、时序连贯,正被越来越多地当作“世界模型”。但它们有一个顽固的失败模式:物体进入遮挡区后从错误位置冒出来,或者穿过固体障碍毫不减速。这些失败恰恰对应人类认知最底层的两个先验——客体永久性(OP)与物体坚实性(OS):婴儿3.5个月就能表征被遮挡的物体(Baillargeon, 1986),半岁内就能感知坚实性违反(Baillargeon et al., 1985)。作者认为这类错误是“结构性上游”的:一个允许穿帮穿透的模型不可能生成物理有效的碰撞或支撑移除事件,更高层的场景构建与因果推理都会继承这些错误。而现有评测存在三个缺口:(1) 任务覆盖以二维环境为主;(2) 只测图像到视频(I2V),不覆盖视频到视频(V2V)这一重要且实用的推理场景;(3) 普遍依赖VLM打分,但已有研究表明多模态语言模型本身存在系统性的核心知识缺陷、无法可靠推理物理变换、缺乏感知恒常性——让VLM当物理能力的裁判正是“外行判内行”。此外现有直觉物理基准每任务样本量小、基本没有训练集,物理推理只能测、不能练。
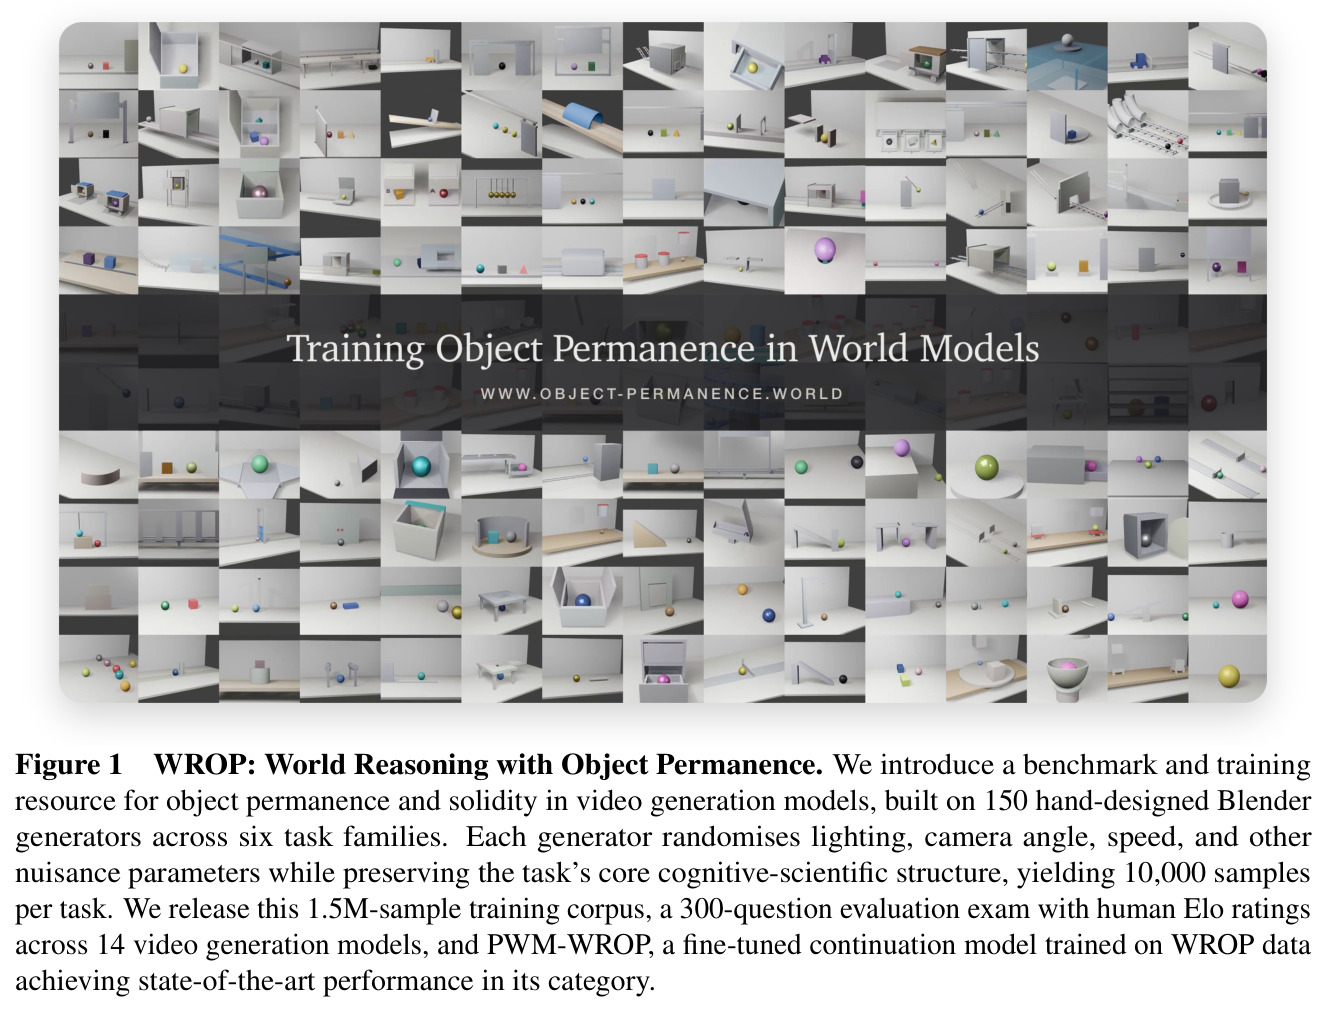
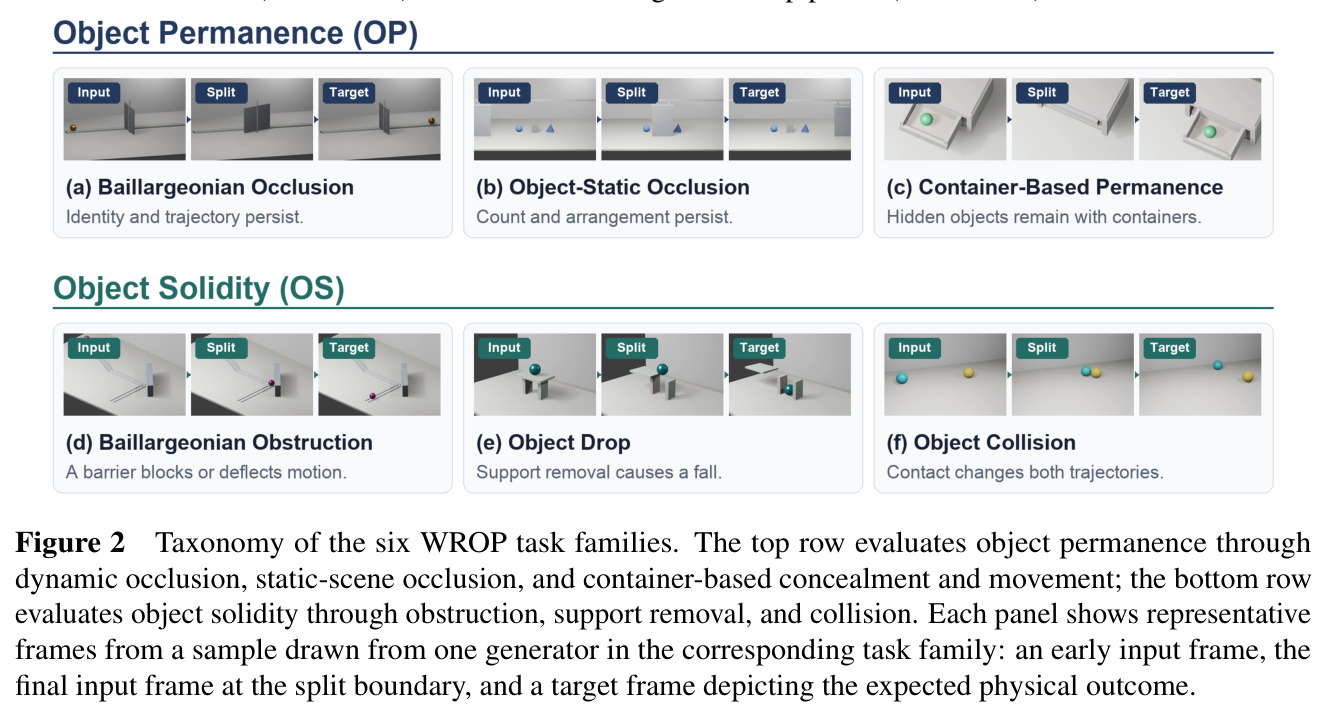
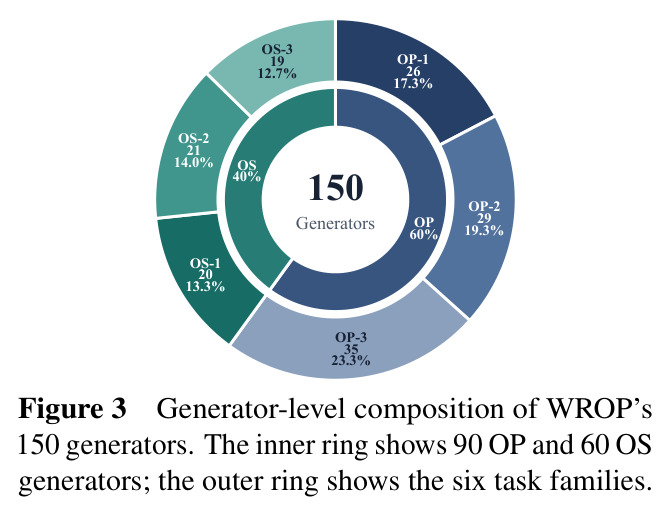
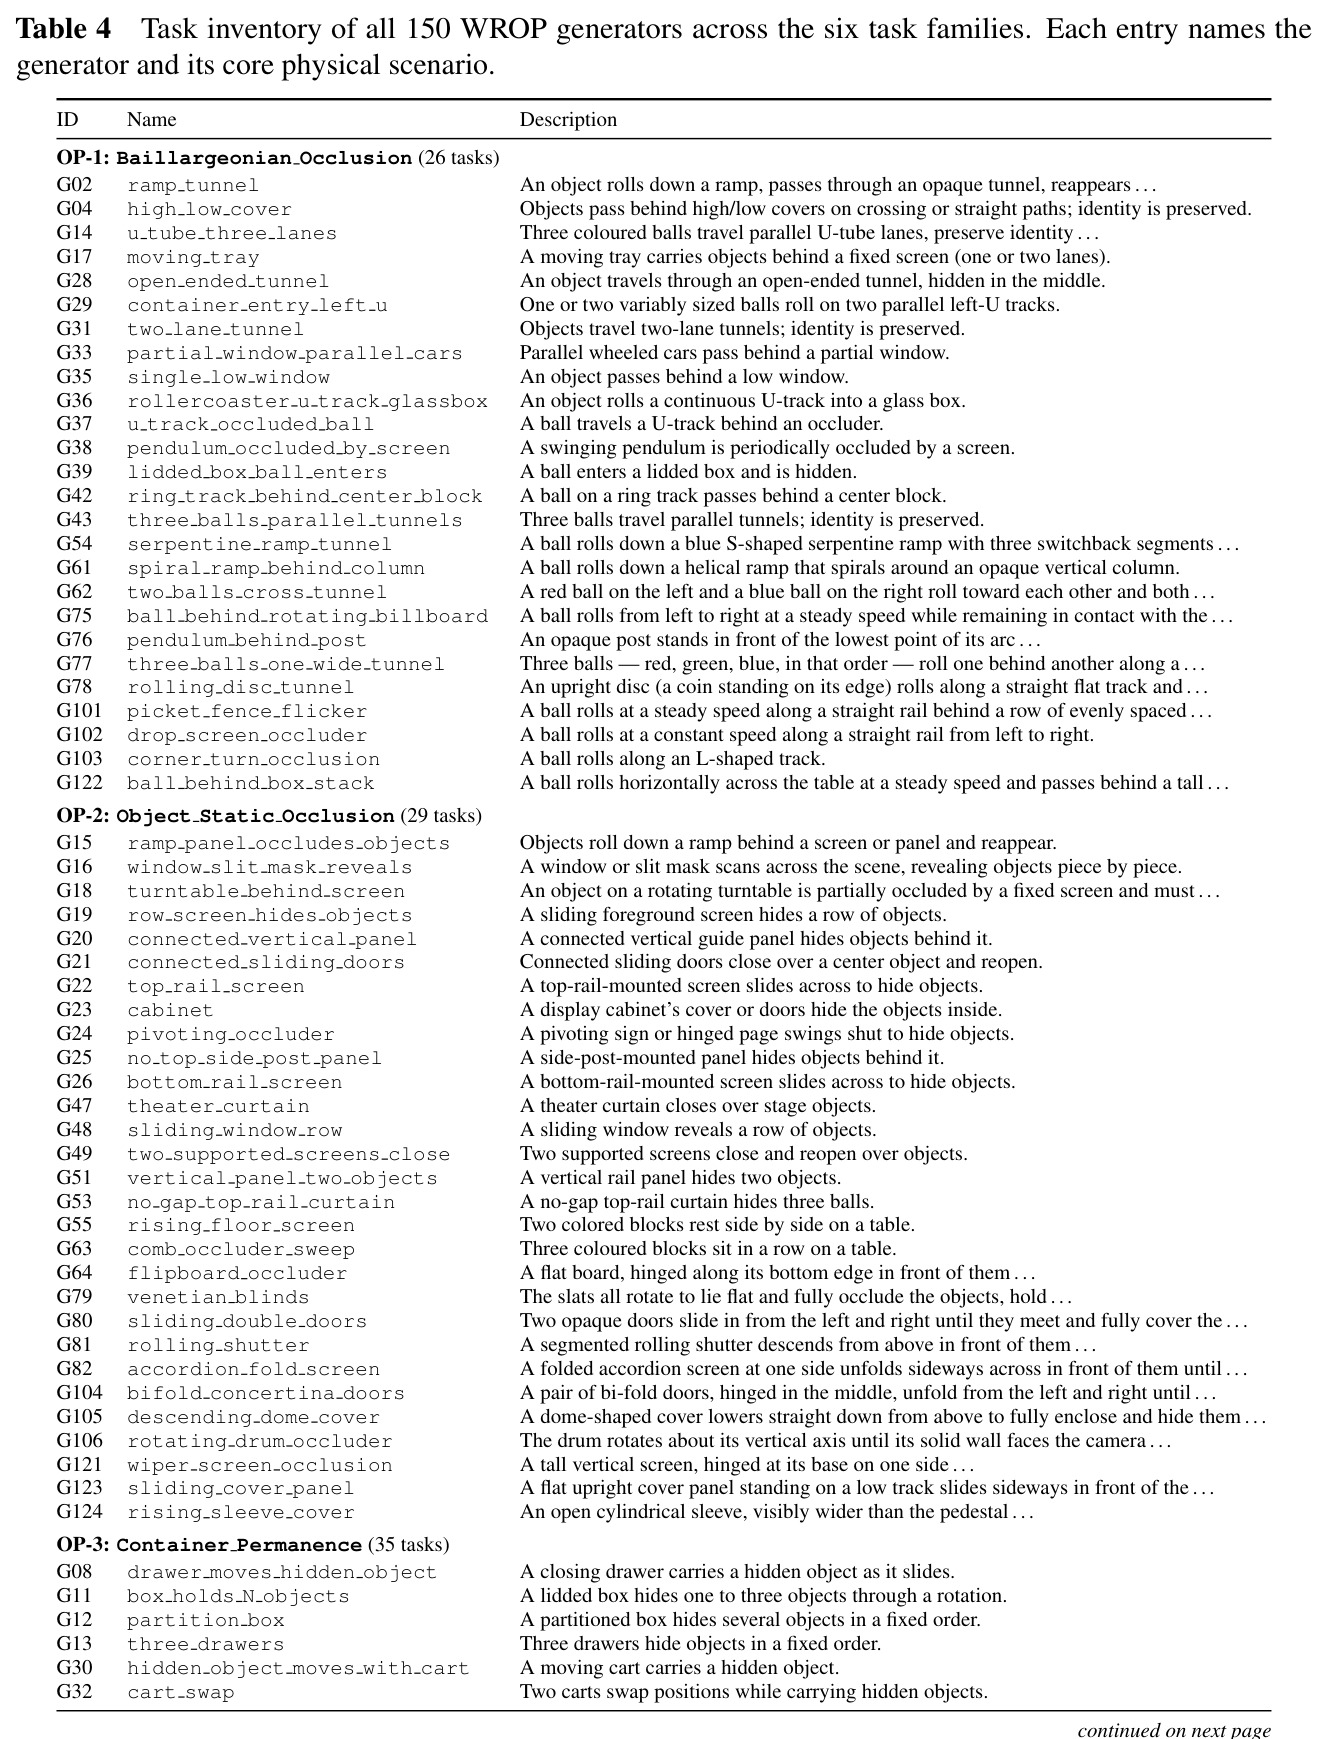
本文的目标是本文的目标有三层。第一,构建一个认知科学上严格操作化的3D合成基准兼训练资源:150个手工设计的Blender任务生成器,覆盖3个OP任务族和3个OS任务族,每个生成器通过随机化结构参数与表面参数产出10,000个样本,合计150万训练语料;另设固定300题考试(每生成器2题),每个样本带有逐帧轨迹与场景状态元数据。第二,在该考试上系统评测14个模型(4个真续写、3个参考到视频、7个编辑/迁移),用20名标注者的盲评成对比较加Bradley–Terry拟合给出带置信区间的可复现排名,辅以对目标视频的全参考自动指标。第三,回答“OP/OS到底能不能训练出来”:把16B开源权重世界模型Cosmos3-Nano在WROP语料上微调为PWM-WROP,验证仅更换训练信号(不改架构、不加任务标签)能否让它在人类盲评中成为真续写类第一、并与前沿商用系统正面竞争。量化锚点非常明确:续写类第一、总榜前三。
与已有工作不同的是,本文的独特切入是“核心认知(core knowledge)路线”。已有的直觉物理评测大多由计算机视觉社区自造任务,与人类物理认知的实证结构对不上;WROP的150个生成器中,OP-1/OS-1直接以Renée Baillargeon等人的经典婴儿实验装置为蓝本(Baillargeonian Occlusion/Obstruction 的命名就是致敬),OP-2/OP-3/OS-2分别对应Wynn、Hespos等人的实验范式,使“模型是否具备物理先验”这一问题第一次有了与发展心理学同构的操作化定义。另一个被普遍忽视的点是评测者问题:当被测能力恰好是VLM的短板时,用VLM打分会系统性失真,WROP改用人类盲评加统计模型聚合,把主观偏好变成带置信区间的排名。第三点是训练集与考试同协议:每个任务的关键物理事件被安排在时间中点开始,输入一半只建立事前场景,事件及其后果永远落在模型必须生成的目标一半——这在结构上堵死了“逐帧重绘输入帧”的作弊路径,也让OP/OS第一次成为可以大规模后训练的能力,而不只是能测的属性。
核心方法
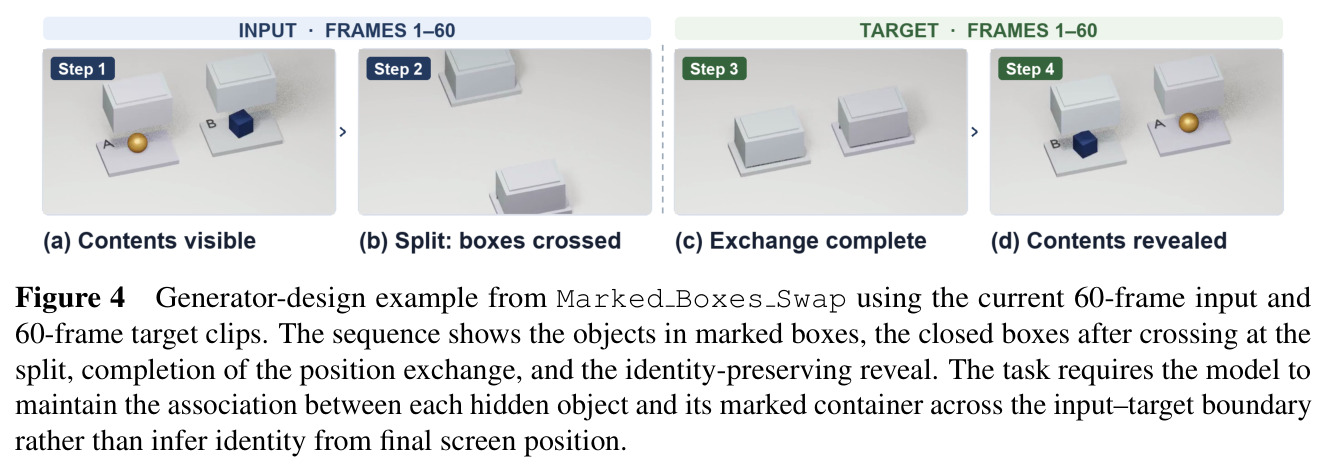
直觉上,这篇论文给视频模型上了一门“婴儿物理课”:把发展心理学家用来测婴儿的150个物理情境做成可批量渲染的Blender生成器,让模型反复练习“看到前半段、补全后半段”。技术路线分三块。数据侧:每个生成器是一个自包含的参数化3D场景,不使用物理引擎,所有轨迹用关键帧解析编写,保证遮挡、接触、重现发生在受控帧上,物理合理性由场景作者负责;每个样本渲染120帧、1280×720、24fps,在第60帧(关键事件开始处)切成60帧输入加60帧目标,附自然语言prompt、逐帧物体轨迹和元数据;结构参数(物体数量、轨迹、遮挡配置、孔径尺寸、接触时机)与表面参数(颜色、材质、光照、机位)分别随机化,前者控制难度梯度,后者防止模型靠感知线索走捷径。评测侧:统一推理harness把输入视频与prompt原样传给14个模型,目标视频全程扣留;20名标注者对120对模型组合做盲评,Bradley–Terry拟合Elo(均值1500),1000次按标注者聚类的bootstrap给出置信区间;另算LPIPS、MS-SSIM、PSNR、MSE等全参考指标作辅助。训练侧:从Cosmos3-Nano微调出16B的PWM-WROP,训练几何为117帧packed clip、320×192(57帧条件加60帧预测),一个epoch扫完150万样本,架构与tokenizer与基座完全一致。
核心创新是“数据即课程”:证明认知科学操作化的合成数据本身,就足以把物理推理灌进一个现成的视频世界模型。它与已有工作有三点本质区别。其一,任务形态从“判断/问答”改为“V2V续写”:关键事件及其后果永远落在模型必须生成的目标半段,模型不能像编辑类模型那样逐帧重绘输入区间蒙混过关——这不仅是评测设计,也是训练信号设计,训练与考试共享同一契约,且除视频片段和prompt外不使用任何任务标签或族名。其二,评测端拒绝VLM裁判:因为VLM自身存在核心知识缺陷(这正是Li et al. 2025等工作的结论),用它评判OP/OS等于让短板当考官;WROP改用人类盲评加Bradley–Terry统计,配合标注者聚类bootstrap的置信区间,把主观偏好变成可复现、可检验的排名。其三,训练干预最小化:PWM-WROP与基座Cosmos3-Nano的架构、tokenizer完全一致,唯一变化是训练数据与目标,因此真续写类内部224 Elo的领先可以较强地归因于数据本身——作者也诚实指出跨接口类的比较无法完全排除架构差异的贡献。
方法步骤详情
完整流程分五步。第一步,生成器实现:150个任务各自写成自包含、参数化的Blender生成器,显式规定物体及其语义角色、场景几何、初始条件、构成任务的关键帧运动与接触事件、相机配置、自然语言prompt与期望物理结果;不使用刚体求解器,遮挡、接触与重现发生在受控帧上。第二步,样本生成:共享driver经统一渲染后端(Blender 4.4.3,EEVEE Next)执行生成器,随机种子控制颜色、材质、光照等表面变化;输出120帧动画,在第60帧切为60帧输入加60帧目标,打包成五元组(输入视频、目标视频、prompt、轨迹、元数据),元数据记录生成器ID、样本索引、种子与渲染配置。第三步,大规模生成与校验:并行worker各贡献10,000个样本,失败渲染自动重试并记录;自动审计验证五组件齐全可读、两段剪辑帧率一致且在帧60无缝衔接、元数据字段完整;发布前对每个生成器人工抽检。第四步,训练:PWM-WROP从Cosmos3-Nano微调,训练集是同一批150个生成器的早期渲染版本(150万样本),每条prompt作文本条件;训练几何为117帧packed clip、320×192(57条件帧加60预测帧),与评测几何完全一致;训练栈PWM是Trainium2原生PyTorch实现,36层模型经tensor-parallel 4乘FSDP2 16分片到64个NeuronCore,静态shape编译,5.7秒每步(batch 16)。第五步,评测:统一harness传递输入与prompt(禁用服务端prompt扩写),专有模型经FAL/Runway API调用并按规则裁剪拼接或前置填充;人类评测中20名通过资格筛选的标注者(注意力检查正确率90.0%,自一致率93.5%,$\kappa=0.891$,无位置偏倚:左位偏好51.4%,$p=0.615$)对120对模型组合各评4题,共完成476/480次判断,其中361次跨模型(每模型50–52次),平局计半胜,按 $p_{ij}=e^{s_i}/(e^{s_i}+e^{s_j})$ 极大似然拟合并重标到均值1500的Elo刻度。
技术新颖性
与已有技术的区别体现在四个层面。相对直觉物理基准(IntPhys、CLEVRER一类):WROP是3D、V2V、带150万训练集的,且任务直接来自发展心理学实证范式而非自造谜题;相对“视频模型即世界模型”的推理评测(迷宫求解、时间归纳、抽象规则跟随),它首次聚焦最底层的OP/OS核心知识并给出可训练路径。相对认知科学本身:把VoE范式从“测量注视时间”倒转为“要求直接生成物理合理续写”,并证明这种倒转在模型训练上可行——原文明确指出与婴儿实验不同,模型被要求直接产出物理上合理的续段。相对模型训练工作:作者刻意不设计新模型,PWM-WROP只是Cosmos3-Nano更换训练信号,把全部贡献压在数据与评测基础设施上,这让“数据侧干预有效”的结论更干净。工程上也有独立价值:PWM是公开的Trainium2原生PyTorch训练栈,附录B完整记录了从15.1秒/步优化到5.7秒/步的过程(重写FSDP2 reduce-scatter的copy-in带来2.25倍加速、multi-tensor AdamW把优化器步骤从1324毫秒降到126毫秒、修复张量并行下复制参数梯度 $5.9\times10^{-5}$ 的相对漂移),并给出bit级正确性验证门,这种透明度在同类工作中少见。
实验结果
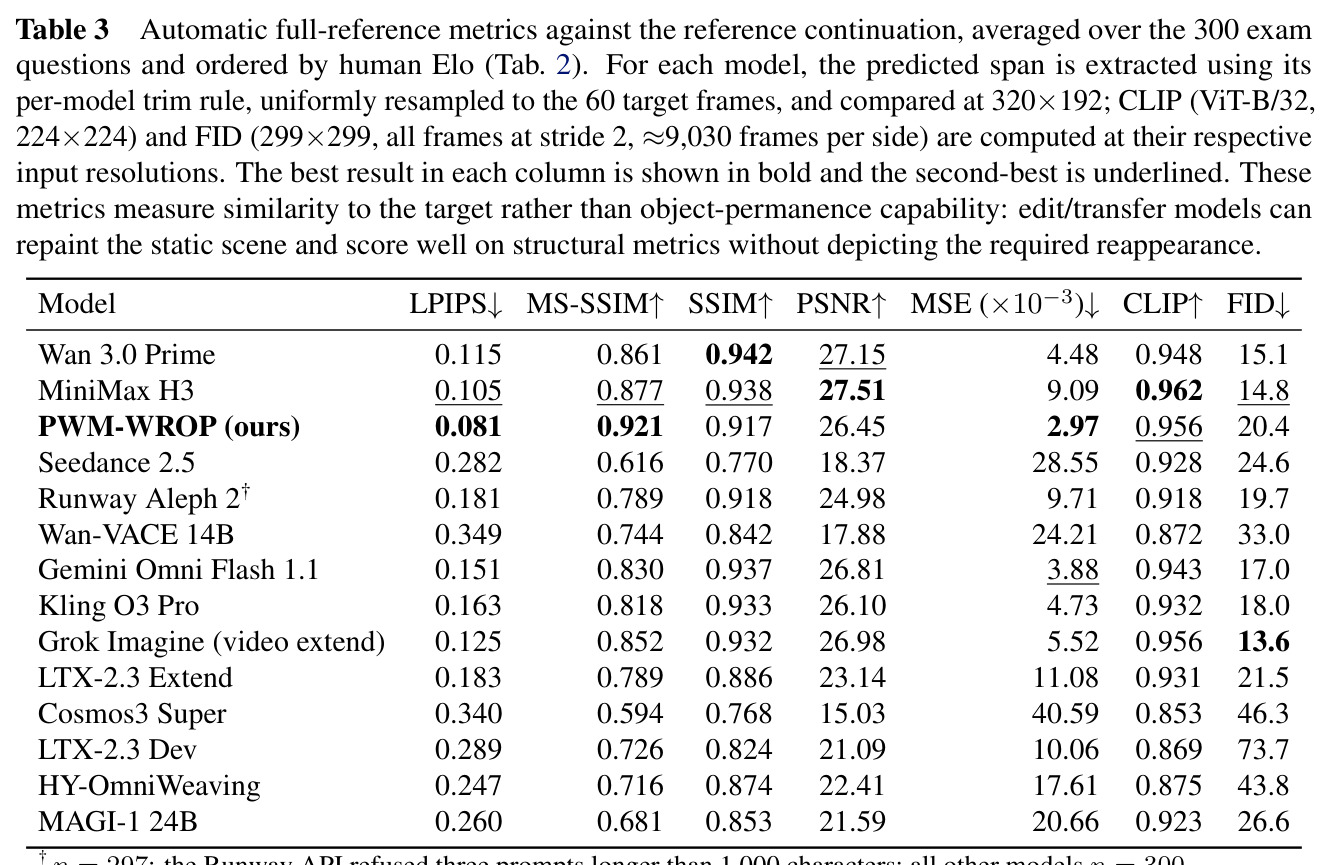
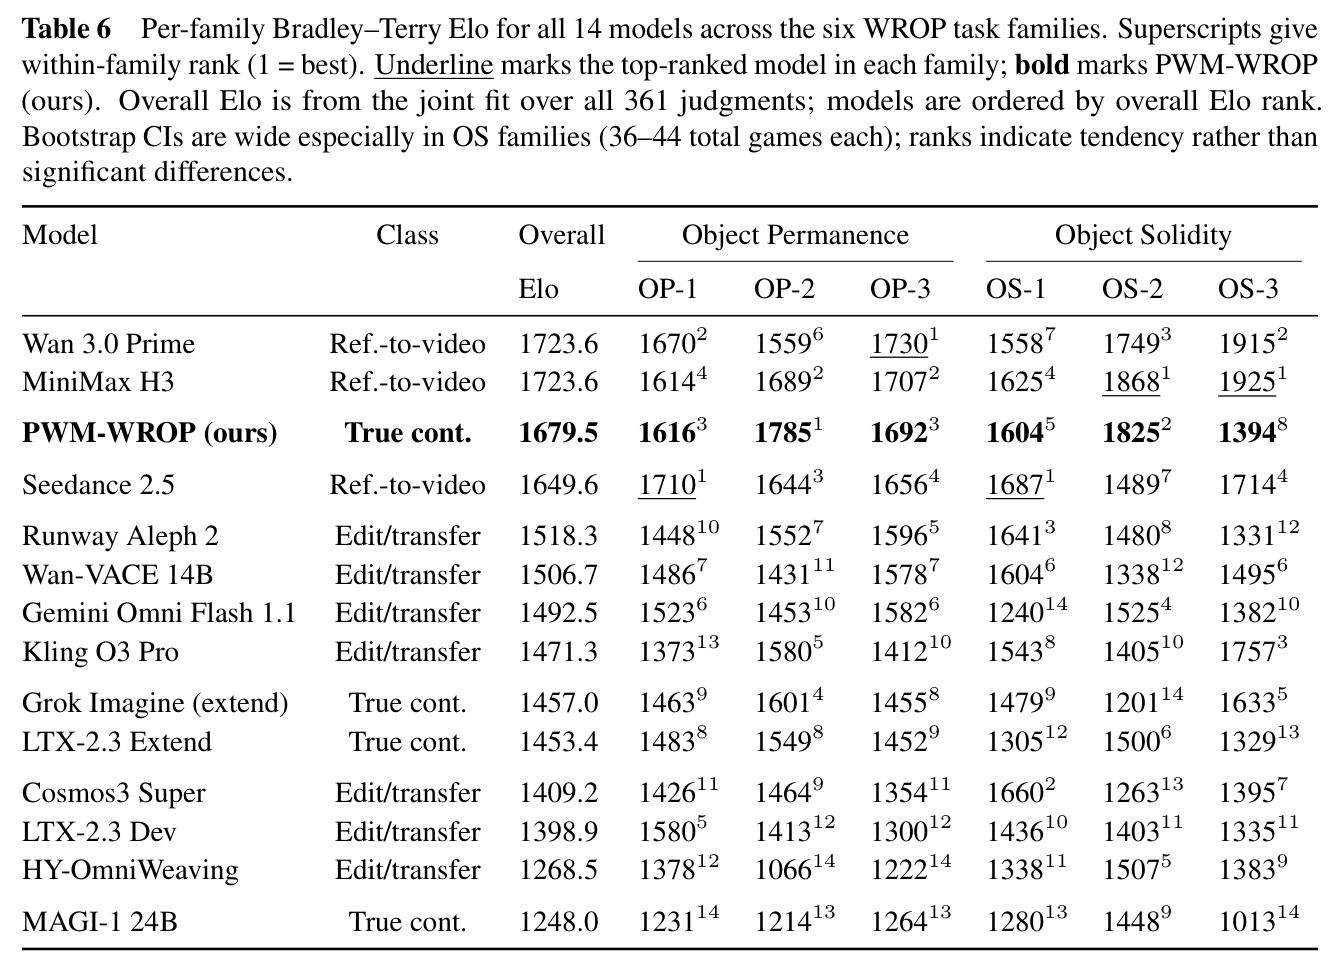
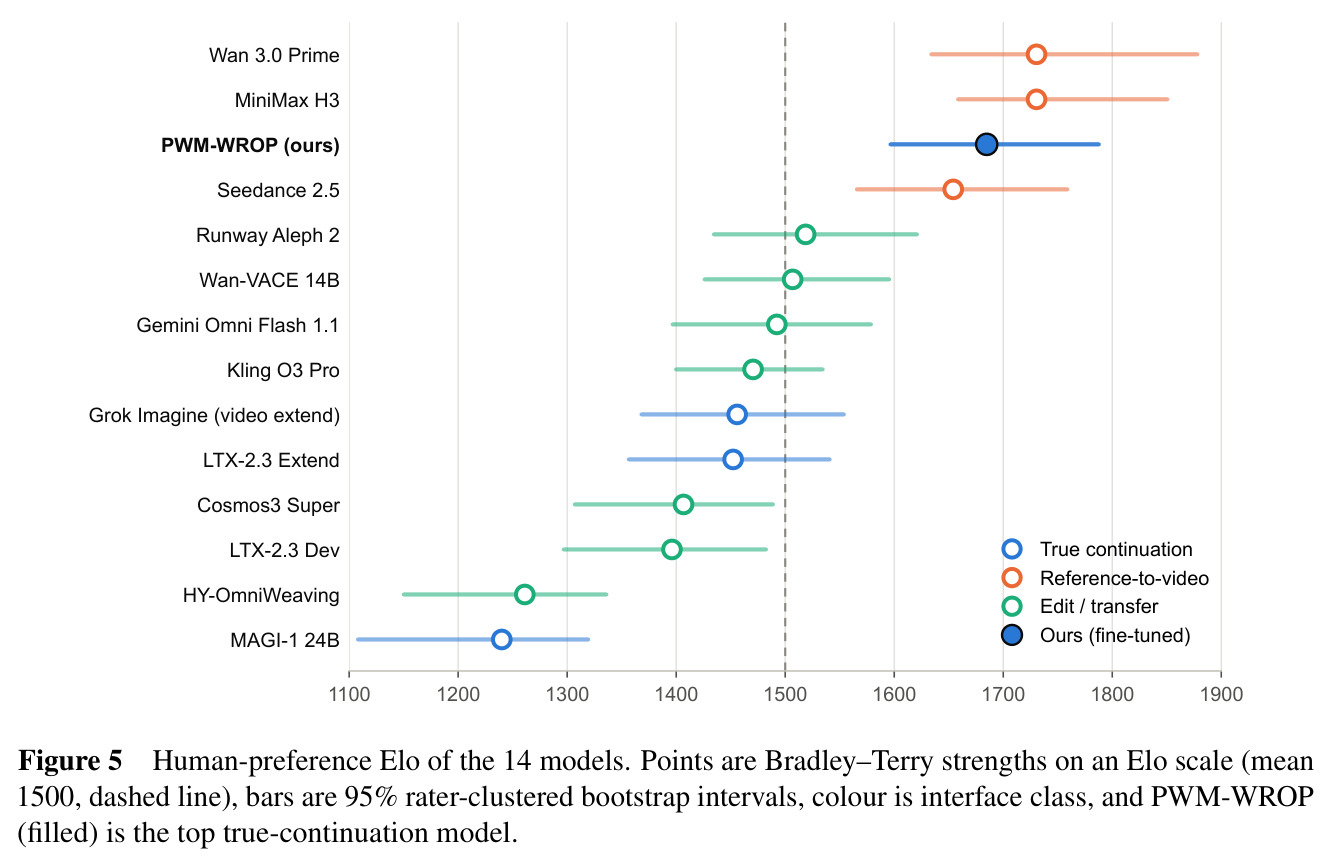
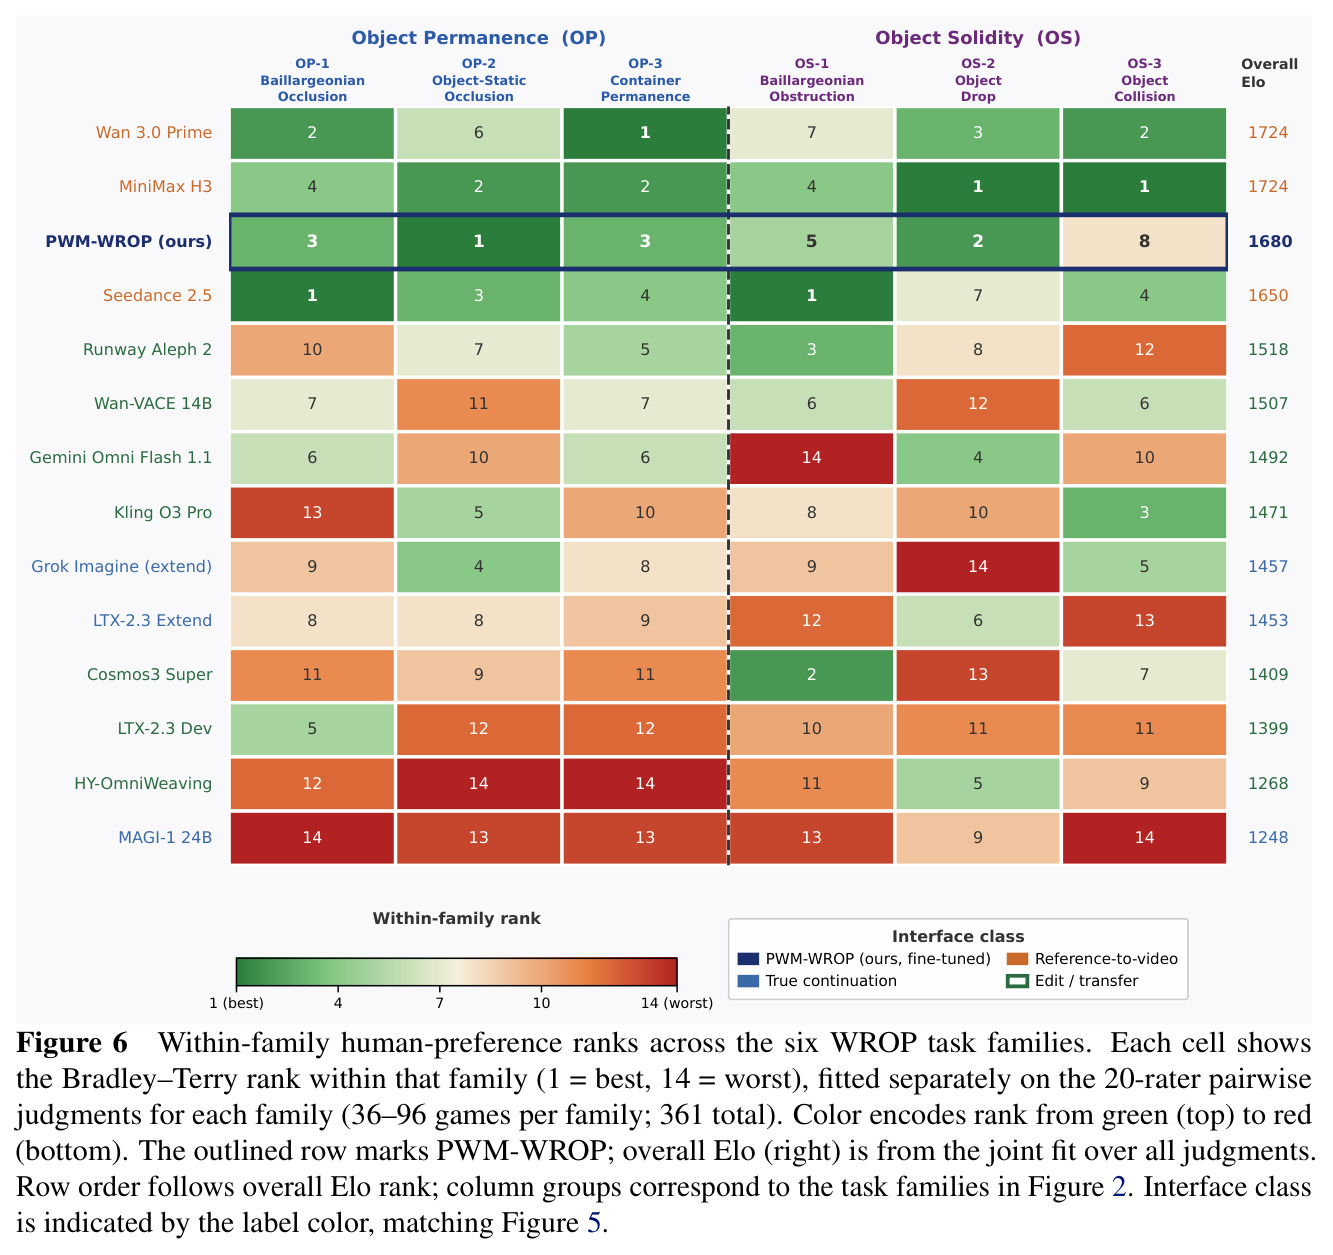
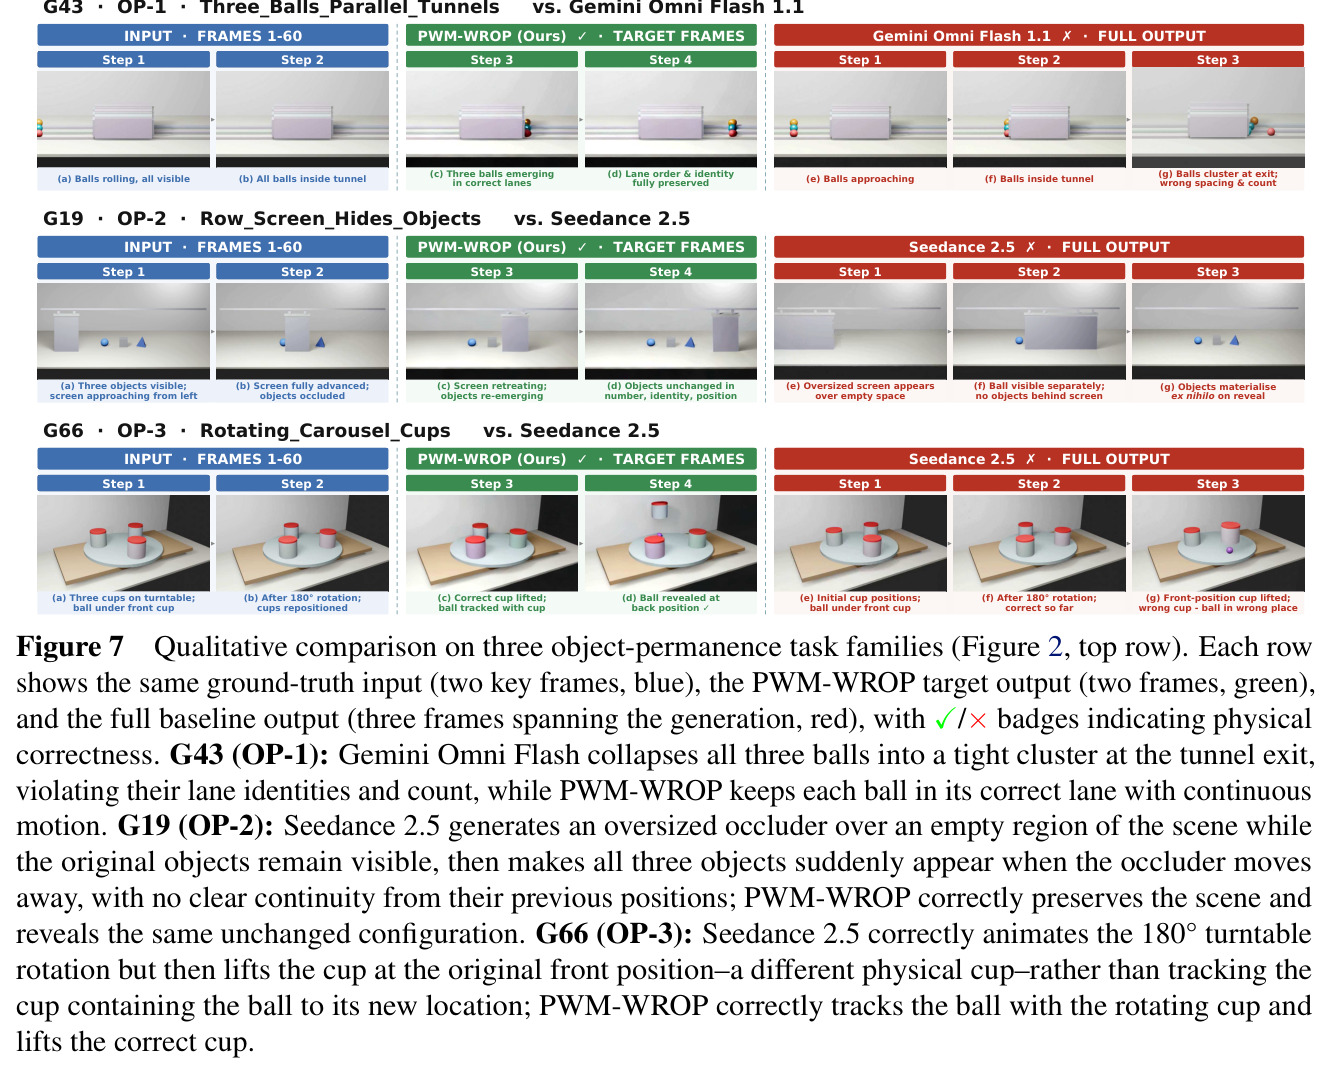
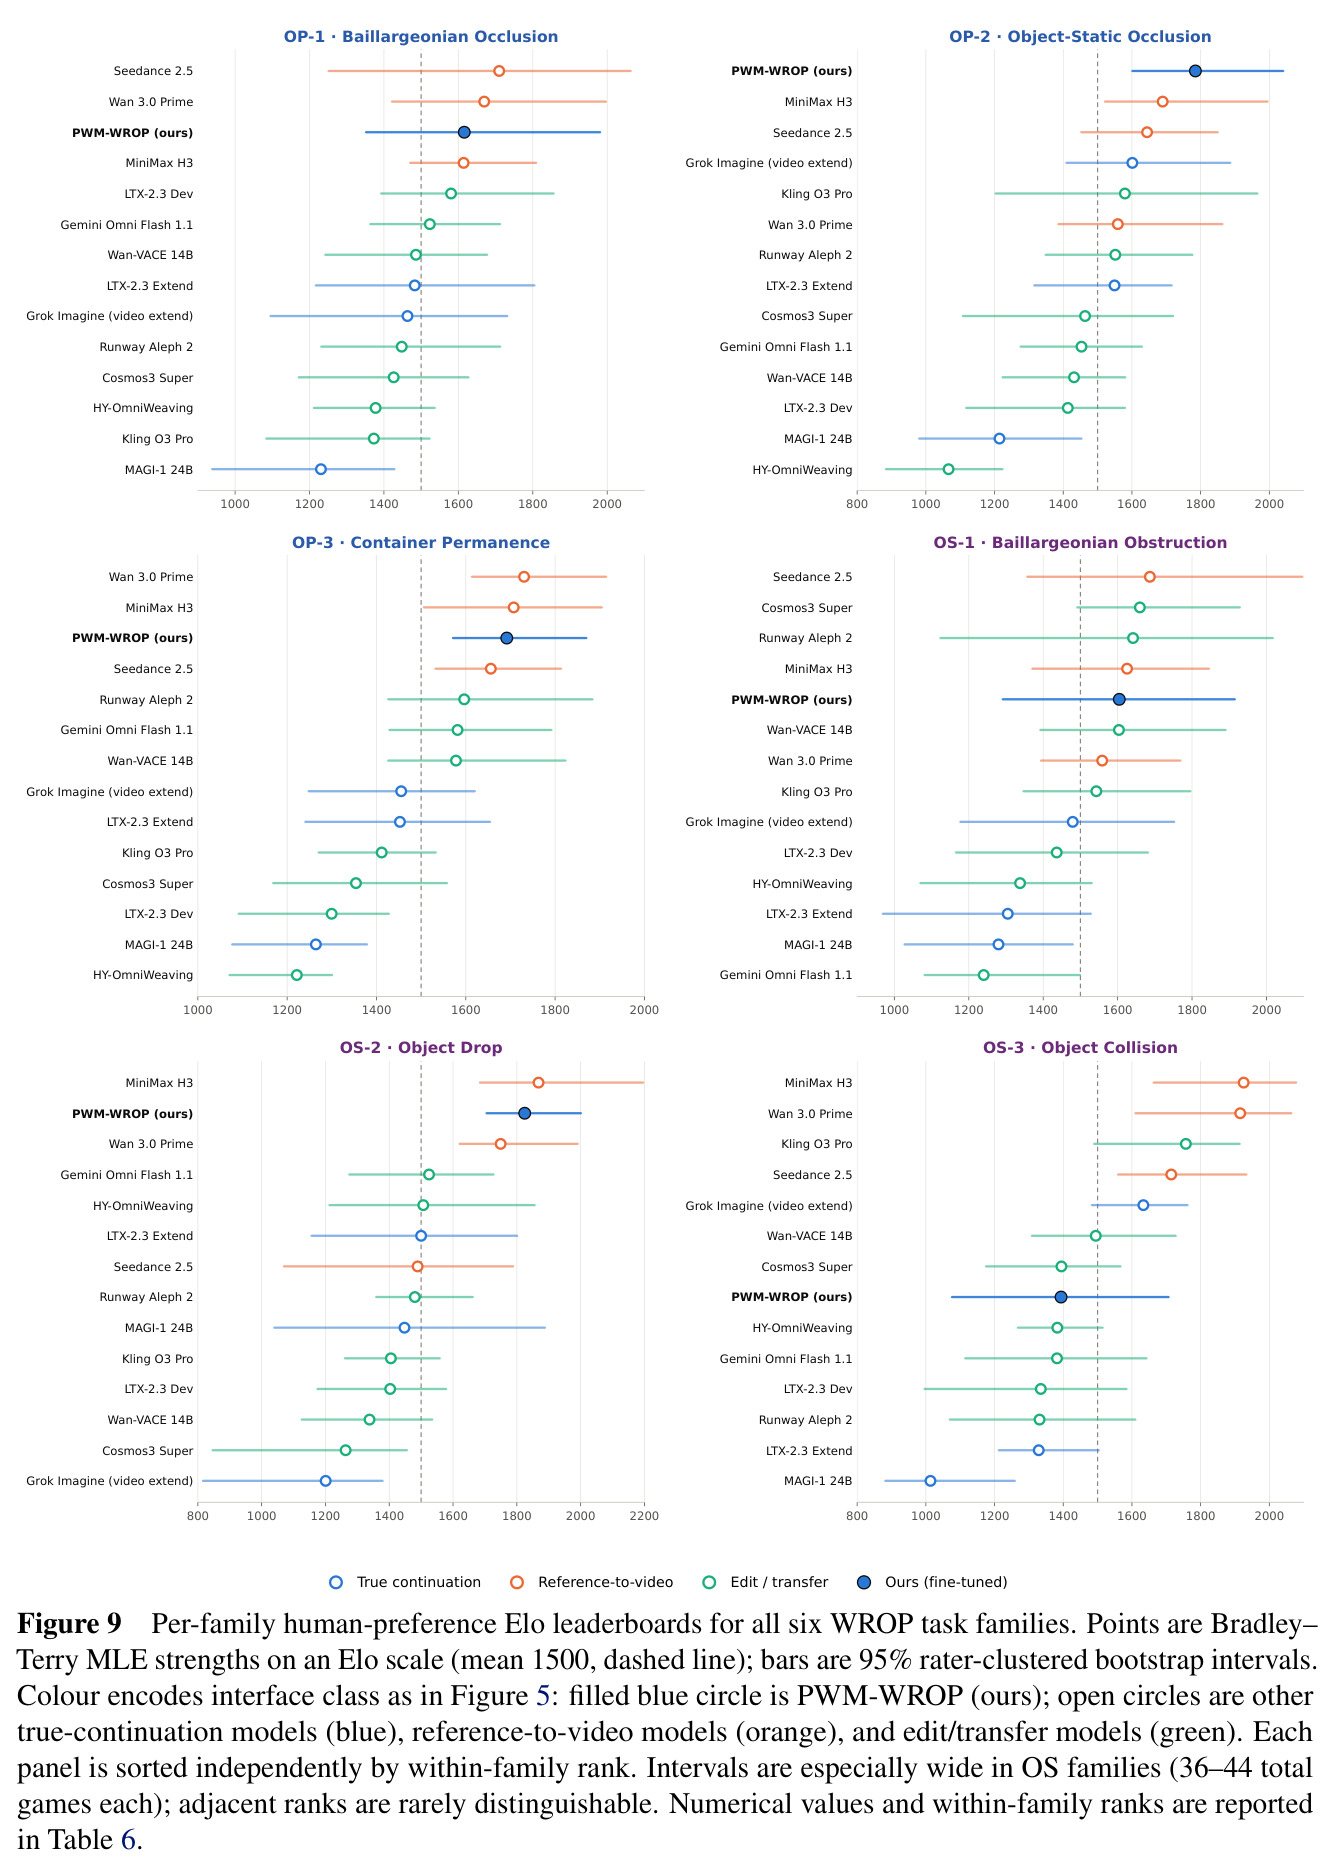
人类盲评总榜(Table 2):Wan 3.0 Prime与MiniMax H3以1723.6并列第一(均为参考到视频类),PWM-WROP以1679.5[置信区间1604–1782]排第三,是真续写类第一,领先次优续写模型Grok Imagine(1457.0)达224 Elo;Seedance 2.5第四(1649.6),MAGI-1 24B垫底(1248.0)。Bootstrap top-1概率:Wan 3.0 Prime 46.8%、MiniMax H3 36.4%、PWM-WROP 12.3%、Seedance 2.5 4.5%,其余十个模型均为0。一个关键观察是接口类型比模型规模更能解释排名:前四名全是参考到视频或被微调模型,第五到第十一名在109 Elo区间内挤满编辑/迁移模型——逐帧重绘机制使其难以表现输入结束后的事件, proprietary与开源模型在此区间混排。分任务族(Table 6/Figure 6):PWM-WROP在OP-2排第一(族内Elo 1785)、OP-1第三(1616)、OP-3第三(1692)、OS-2第二(1825)、OS-1第五(1604)、OS-3第八(1394);OP强、OS弱的剖面提示遮挡跟踪与接触动力学可能依赖不同的内部表征。两个商业领先者的优势主要来自OS族:MiniMax H3在OS-2和OS-3均排第一且胜率100%,Wan 3.0 Prime在OP-3第一、OS-3第二。自动指标(Table 3,320×192对齐):PWM-WROP的LPIPS 0.081(次优0.105)、MS-SSIM 0.921(次优0.877)、MSE $2.97\times10^{-3}$ 和final-frame MSE均为14个模型最优,CLIP相似度0.956排第二;PSNR 26.45略低于MiniMax H3的27.51;在720p上计算的final-frame LPIPS 0.166与FID 20.44受320×192上采样4倍的拖累。定性分析(Figures 7-8,六个生成器逐案例)揭示了代表性失败:Gemini Omni Flash在G43三球平行隧道里多生成第四个球且车道错乱,在G137台球开球前凭空把7球加到12个以上、碰撞后又让紫球消失;Seedance 2.5在G10让球直接穿过孔径只有其直径一半的阻挡板(这是包括MiniMax H3和Wan 3.0 Prime在内最普遍的失败模式)、在G27把整个支架连同板子一起拆掉且球悬浮数帧不落、在G66转盘杯游戏中追踪位置而非追踪杯子导致开错杯;PWM-WROP在六个案例中全部正确。作者把跨任务失败归纳为两类机制:表征丢失(representation dropout,物体在隐藏或碰撞后未被持续跟踪)与因果解耦(causal decoupling,单个事件看起来合理但事件间物理联系断裂)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| WROP 300题考试:视频续写物理合理性盲评(14模型总榜) | Bradley–Terry Elo(20人盲评,361次成对判断) | PWM-WROP 1679.5(真续写类第一,总榜第三) | Wan 3.0 Prime / MiniMax H3 并列第一 1723.6;次优真续写模型 Grok Imagine 1457.0 | 领先同类真续写模型 224 Elo;top-1 概率 12.3%(前两名之外最高) |
| OP-2 物体静态遮挡(29个生成器族) | 族内 Bradley–Terry Elo 排名 | 第1名(族内 Elo 1785) | MiniMax H3 第2名(1689) | 14个模型中排名第一 |
| OS-2 物体坠落(21个生成器族) | 族内 Bradley–Terry Elo 排名 | 第2名(族内 Elo 1825) | MiniMax H3 第1名(1868,族内胜率100%) | 仅次于 MiniMax H3,超过所有其他模型 |
| 感知相似度(对齐到 320×192,300题平均) | LPIPS(越低越好) | 0.081 | 次优 MiniMax H3 0.105;Wan 3.0 Prime 0.115 | 相对次优降低约 23% |
| 结构相似度(对齐到 320×192,300题平均) | MS-SSIM(越高越好) | 0.921 | 次优 MiniMax H3 0.877 | +0.044,14个模型中第一 |
| 像素误差(对齐到 320×192,300题平均) | MSE(×10⁻³,越低越好) | 2.97 | 次优 Wan 3.0 Prime 4.48 | 降低约 34%,14个模型中最优 |
| OS-3 物体碰撞(19个生成器族) | 族内 Bradley–Terry Elo 排名 | 第8名(族内 Elo 1394) | MiniMax H3 第1名(1925) | 负向:接触动力学是微调后模型的明显短板 |
局限与改进
作者承认的局限:三类接口与考试的契约不同,跨类排名不完全公平(参考到视频模型可以脱离输入帧自由重建场景,这解释了它们的领先);自动全参考指标度量的是与目标视频的相似度而非物理正确性,编辑模型只重绘静态场景也能刷高SSIM;OS族每族只有36–44局比较,bootstrap区间很宽,相邻名次大多不构成统计显著;被评模型架构各异,真续写类内部的领先不能百分之百归因于训练数据。我的补充观察:其一,PWM-WROP原生输出320×192,而对手输出720p甚至1080p,虽然在320×192统一对齐评测,但720p层面的final-frame LPIPS 0.166与FID 20.44仍系统性吃亏,且低分辨率是否影响人类偏好未做消融。其二,300题考试全部来自训练所用同批150个生成器(只是不同样本与种子),测的是“生成器内泛化”,对未见过的生成器设计和真实视频的泛化完全没有评估——模型可能记住的是这150套装置的物理脚本。其三,人类评分把文本对齐、运动自然度、客体永久性三个标准合并为一个判断,Elo领先中有多少来自“好看”而非“物理正确”无法分离。其四,ground truth是手写关键帧动画而非物理引擎仿真,减速曲线、碰撞弹性等动力学细节带有人工风格,模型学到的可能是“动画师风格”而非通用物理规律。其五,工作只覆盖OP/OS这两个最底层先验,重力、惯性、流体等更高层直觉物理完全未触及。
独立分析的弱点
独立分析的弱点与改进方向。(1) 考试与训练同生成器导致的泛化盲区:PWM-WROP的领先建立在它见过的同批150个装置上,若换成新设计的任务族或真实拍摄视频,优势可能大幅缩水——这是“概念特异性数据训练”路线最需要警惕的自我验证风险。改进:留出20–30个生成器做held-out考试,并增加真实视频子集(哪怕只覆盖遮挡场景)。(2) 评价维度混杂:三个标准合并成单个Elo,无法回答“模型是物理对了但难看,还是好看但物理错了”。改进:按维度分别收集判断,或训练一个经人类标签校准的OP/OS专用判别器,分维度报告胜率。(3) 统计功效不足:每对模型仅约4题、OS族36–44局,宽置信区间使多数族级结论只是“倾向”。改进:扩大标注者与题目规模,把每族局数拉到数百,或采用自动代理指标做初筛加人工复核。(4) 分辨率混杂:评测在320×192对齐,但尺寸—孔径关系的精细感知在低分辨率下更易失真,这对恰好以尺寸判断为核心的OS-1任务不公平。改进:统一上采样到相同分辨率再盲评,并报告分辨率消融。(5) 关键帧动画的分布偏移:解析编写的运动缺乏物理引擎的次级动态(弹跳、形变、摩擦噪声),与真实视频分布有差距,在合成域上整模型微调可能加剧过拟合。改进:混合少量物理引擎渲染与真实视频做正则,或只用LoRA等参数高效方式微调以保留基座的通用先验。
未来方向
作者明确提出的方向:把WROP作为社区基础设施——数据、考试、模型答案、评分、权重和PWM训练栈全部开源,供社区测量、理解并改进视频模型的物理推理;工程开放项包括词表嵌入在张量并行组内的sharding方案、flash-attention后向的8192 token序列长度限制。基于本文成果可以延伸的研究:其一,能力课程化——从OP/OS扩展到重力、惯性、支撑、流体等更高层核心知识,检验“数据即课程”能否逐级爬升物理认知阶梯;其二,把VoE范式反向用于模型内部——用模型对“可能/不可能续写”的损失或不确定度做免人工的物理先验探针,把300题考试放大为任意规模的自动评估;其三,表征层面的干预——OP强OS弱的分化暗示遮挡跟踪与接触动力学机制不同,可尝试对象槽位表征、持久化世界状态跟踪或按任务族加权的课程与损失设计来补齐OS短板;其四,将WROP式后训练与真实视频数据混合,推广到具身智能和机器人策略的世界模型;其五,扩展时域依赖——当前预测窗口只有60帧,跨更长遮挡、多物体交错遮挡的持久性尚未检验。
复现评估
开源情况非常好:150万样本训练语料、300题固定考试、14个模型的全部生成答案与评分、PWM-WROP权重、PWM训练栈全部公开(object-permanence.world 提供 Website/Data/Code/Benchmark/Model/Leaderboard 入口)。复现训练需要AWS Trainium2:单台trn2.48xlarge(16芯片、64个逻辑NeuronCore,NeuronLink互联),tp4×fsdp16布局,batch 16时5.7秒/步,36层模型完整checkpoint占162 GiB;附录B给出全部优化路径(15.1→6.74→5.71秒/步)与正确性验证门:CPU逐位前向对齐、两层真权重 $7\times10^{-7}$ parity、64秩bit-exact断点恢复、六段示例clip过拟合(sample-to-source cosine 0.979)、64段物理渲染过拟合(续写半段cosine 0.993–0.999,基座仅0.85–0.995)。有Trainium配额的话复现训练难度中低;纯GPU环境需自行移植(作者未提供GPU训练脚本,但模型是diffusers布局的原生PyTorch实现)。数据侧只需Blender 4.4.3(EEVEE Next),重跑150万样本的渲染是主要成本,但抽样子集即可验证流程。人类评测需重新招募约20名标注者完成约476次成对比较,成本可控。总体而言,这是同类工作中复现文档与工程记录质量最高的一档。
论文图表
版式同Figure 7。G10尺寸门:Seedance 2.5让球穿过孔径只有其直径一半的阻挡板,PWM-WROP正确减速停靠;G27支撑移除:Seedance 2.5拆掉整个支架且球悬浮数帧才缓慢下落,PWM-WROP生成时机正确的落地;G137台球开球:Gemini Omni Flash碰撞前凭空多出球(7变12+)、碰撞后紫球消失,PWM-WROP保持7球守恒且轨迹发散合理。
展示了OS任务中“因果解耦”失败的典型形态——事件各自合理但物理联系断裂,支撑论文对失败机制的归纳。
36层Cosmos3-Nano、tp4×fsdp16、batch 16、288×512×30隐帧几何下的吞吐:初始可用配置15.1秒/步(4,705 tokens/s),重写reduce-scatter copy-in后6.74秒/步(10,564 tokens/s),再叠加multi-tensor AdamW与FSDP2预取深度2后5.71秒/步(12,454 tokens/s),各步的损失轨迹逐步完全一致。
训练栈工程的量化证据:证明5.7秒/步的性能没有牺牲数值正确性,对需要在Trainium上训练大模型的人有直接参考价值。