评估 nnU-Net 在 BraTS-GoAT 2026 跨脑肿瘤人群中的泛化能力 Assessing nnU-Net Generalization across Brain Tumor Populations in BraTS-GoAT 2026
常规nnU-Net跨人群验证:集成与镜像增益甚微,小而碎的增强肿瘤是主要失败来源
前置知识
nnU-Net
一个自配置的医学图像分割框架:根据数据集"指纹"(体素间距、图像尺寸、前景占比、类别数等)自动决定预处理方案、网络结构(如 PlainConvUNet 或 ResidualEncoderUNet)、patch 与 batch 大小、损失函数和优化日程,几乎不需人工调参就能成为医学分割的最强默认基线。v2.x 提供 2d/3d_fullres/3d_lowres 等配置。
本文的研究对象正是"完全按默认计划训练的 nnU-Net",只有理解其数据驱动配置机制,才能理解为什么人群漂移可能与配置发生交互(文中引用了成人计划在儿童解剖上欠佳的先例)。
Dice 相似系数 (DSC)
衡量分割预测 $X$ 与参考掩码 $Y$ 重叠度的指标:$\text{DSC} = \frac{2|X \cap Y|}{|X| + |Y|}$,取值 0 到 1。它对小目标极其敏感:当目标体积只有几毫升时,分母很小,几十个体素的误差就会让分数大幅波动,这也是本文失败分析与"小 ET 体积"强相关的度量层面原因。
DSC 是官方排名指标之一,全文所有成绩、差距消融、失败分析都围绕它展开,不理解其小目标敏感性就无法正确解读结果。
ET / TC / WT 区域定义
BraTS 体系把脑肿瘤 MRI 标注拆为三个嵌套区域:坏死与非增强核心 NCR/NET(类别1)、水肿/浸润组织(类别2)、增强肿瘤 ET(类别3)。评估区域为 $\text{ET}=\{3\}$、$\text{TC}=\{1,3\}$、$\text{WT}=\{1,2,3\}$,ET 通常最小最难、临床意义最大(对应活跃肿瘤)。
所有指标按区域分别报告,且论文最重要的发现(失败案例 ET 体积中位数仅 1.04 mL)就发生在 ET 上,不熟悉区域定义就看不懂表格与分析。
五折交叉验证集成与 OOF 预测
把训练集确定性分成 5 折,每折轮流做验证集、其余 80% 做训练集,得到 5 个模型。每个训练案例由"没见过它"的那个折模型预测,称为 out-of-fold (OOF) 预测,可用于诚实的内部验证;推理时也可把 5 个模型的概率图平均成集成。注意这与"同一数据重复训练多次的 deep ensemble"构造不同。
本文所有源域内分析都基于 OOF 预测,最终提交的集成也是 CV 集成;作者专门强调并引用证据说明 CV 集成与 deep ensemble 在分布外没有稳定胜负,这是理解其方法学立场的前提。
测试时增强 (TTA / 镜像翻转)
推理时把输入沿若干空间轴翻转(本文沿三个轴镜像),分别前向推理后在概率图层面平均再解码。相当于利用解剖对称性做零训练成本的"投票",nnU-Net 默认支持。代价是推理时间成倍增加(本文约翻倍至 15.3 s/例)。
论文用配对 bootstrap 精确量化了镜像 TTA 的真实增益——单折下 ET DSC 仅 +0.0021,集成后增益完全消失,这是其"常见加料是否值得"审计结论的一部分。
bootstrap 区间与效应估计
不放回假设下对样本重采样(本文 10,000 次)计算统计量分布以获得置信区间;配对比较时联合重采样两批案例。文中用 rank-biserial 效应衡量两组秩差异、用基于秩残差的 partial Spearman $\rho$ 做协变量调整后的关联强度,并用 Benjamini–Hochberg 方法控制多重比较的假发现率。
作者刻意"报告效应估计而非假设检验",所有结论(如差距 −0.0747、$\rho=0.483$)都附带区间,读懂这些统计工具才能判断哪些差异是真实的。
研究动机
自动脑肿瘤分割在标准 BraTS 成人胶质瘤数据上已经非常成熟,但模型的稳健性建立在"训练分布 ≈ 测试分布"的假设上。现实中 MRI 采集协议、人群年龄结构、肿瘤生物学差异巨大:BraTS-GoAT 2026(Generalizability Across Tumors)任务汇集了成人胶质瘤 (GLI)、脑膜瘤 (MEN)、脑转移瘤 (MET)、撒哈拉以南非洲胶质瘤 (SSA) 和儿童脑肿瘤 (PED) 五类人群,而验证集的参考标签和逐例人群映射全部隐藏。已有先例表明人群漂移会与 nnU-Net 的数据驱动配置发生交互:在儿童 CT 器官分割上,由成人数据指纹导出的配置计划对儿童解剖(尤其小结构)表现欠佳。更实际的问题是,绝大多数挑战赛参赛工作都在堆砌架构改进刷榜,却很少量化"标准操作"——五折集成、镜像 TTA、换残差编码器——到底带来多少真实边际收益,也很少回答"模型在什么情况下失败"。
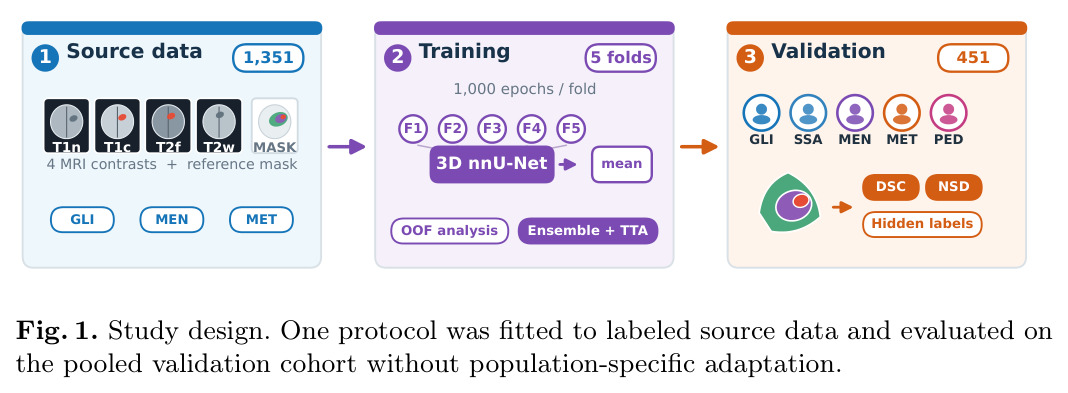
本文的目标是本文设定了三个层层递进的目标。第一,完全不做超参搜索、严格按 nnU-Net 默认计划(3d_fullres、stock trainer、1000 epochs)训练一个常规 3D PlainConvUNet,在 1,351 例有标签混合源数据上做五折交叉验证,形成一个完全透明的基线,并在 451 例混合验证集上提交可评估的成绩(最终官方验证 ET/TC/WT 全局 DSC 为 0.7805/0.8288/0.8854)。第二,用模型匹配的方式量化源域到混合验证集的泛化差距——同一个 fold-0 checkpoint 分别推理源域 OOF 案例和官方验证案例,给出差值及其 bootstrap 区间。第三,在有标签的源域上做系统的 OOF 失败分析,刻画失败案例的形态学特征(ET 体积、连通分量数、最大分量占比),为将来的域自适应策略提供可检验的线索。
与已有工作不同的是,本文的独特切入是把"常规 nnU-Net"本身当作研究对象而非刷分工具,走了一条审计式的路线。与之前 GoAT 工作(多架构组合加自适应后处理)不同:其一,它明确声明所用集成是 CV 集成(成员在不同 80% 子集上训练)而非 deep ensemble,并引用近期受控证据说明二者在分布外没有稳定赢家、建议社区明确报告构造方式——这是多数论文回避的细节;其二,所有配置对比都给出 10,000 次重采样的配对 bootstrap 区间的效应估计而非 p 值假设检验,并坦承五折+TTA 的最终配置是按验证成绩事后选择的;其三,验证服务器未公开 NSD 容差单位,作者就只照录数值不做过度解读;其四,失败分析做了体积协变量调整(基于秩残差的 partial Spearman)、BH 校正和 2,000 次折分层 bootstrap。这种"负结果完整报告+统计严谨"的写法在挑战赛论文中相当少见。
核心方法
直觉上,想知道"标准配方"在陌生人群上的成色,最干净的做法是完全不加料地训练它,再把每种常见"加料"逐一做配对消融。技术路线:数据为 1,351 例有标签混合训练集(GLI/MEN/MET 三个源人群,无逐例人群标签),每例 4 个 MRI 对比度(T1n、T1c、T2-FLAIR、T2w)加参考掩码。用 nnU-Net v2.6.2 的 3d_fullres 配置:重采样到 1mm 各向同性间距、非零掩码内 z-score 归一化;六阶段 3D PlainConvUNet,patch 128×160×112、batch size 2、编码器宽度 32→320;训练用区域式 Dice 与 BCE 联合损失、深监督、SGD(Nesterov 动量 0.99,初始学习率 $\eta=10^{-2}$,权重衰减 $3\times10^{-5}$,多项式衰减),每折 1000 epochs。5 个确定性折各训一个模型(单折 12.1–12.5 小时,A100 40GB),推理时平均五折概率图并叠加三轴镜像 TTA,全程无后处理、无阈值调优。
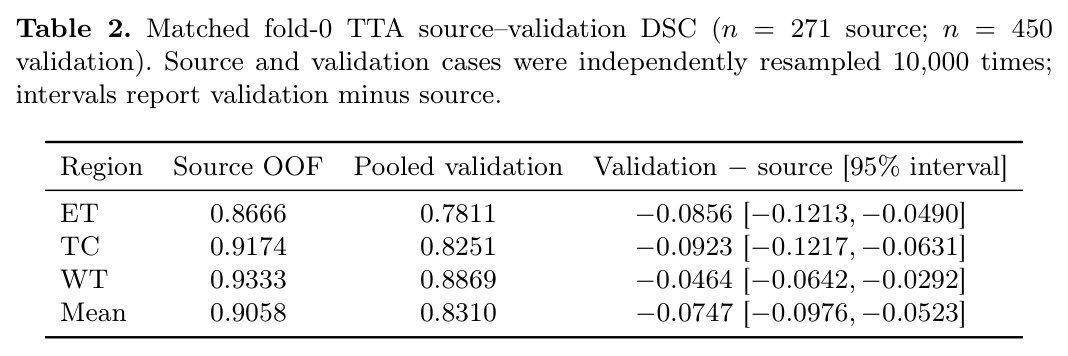
核心创新不是新模型,而是"配对测量 + 诚实的效应估计"这一方法学设计。关键设计一是源-验证泛化差距的测量:用同一个 fold-0+TTA checkpoint 分别推理 271 例源域 OOF 案例与 450 例官方验证案例,两批案例各自独立 bootstrap 重采样 10,000 次后计算均差,得到区域均 Dice 差 −0.0747(95% CI −0.0976 至 −0.0523);作者明确声明这个差混合了评估器实现、病例构成和潜在分布效应,不是纯粹的人群漂移估计——这种克制在刷分文化里是稀缺的。关键设计二是 OOF 失败分析:在 1,343 例三区域 Dice 均有限的案例中,取严格均值 Dice 最低的 10%(阈值 0.7877,共 135 例)作为失败组,对比参考掩码的形态学特征(体积、≥10 体素的 26-连通分量数、最大分量占比、ET/WT 比),并用秩残差 partial Spearman 控制体积协变量。这与"换个花哨架构涨 0.001"的路线本质不同:它回答的是"模型为什么失败、失败能不能被预测"。
方法步骤详情
第一步,预处理:输入 4 对比度 MRI 与掩码(类别 1=NCR/NET、2=水肿、3=ET),评估区域 $\text{ET}=\{3\}$、$\text{TC}=\{1,3\}$、$\text{WT}=\{1,2,3\}$;自动重采样到 1mm 各向同性并 z-score 归一化。第二步,训练:5 个确定性折各训 1000 epochs(每 epoch 250 训练 + 50 验证迭代),前景过采样 0.33,标准几何/噪声/模糊/强度/伽马/镜像增强,保留第 1000 epoch 最终 checkpoint,绝不用挑战成绩选模型,单折 12.3 小时(A100 40GB)。第三步,推理:概率图在转原子标签前做五折平均,叠加三轴镜像 TTA,输出 NIfTI 标签图。第四步,消融:5 个提交配置——fold0、fold0+TTA、folds0–4、folds0–4+TTA、ResidualEncoderUNet-L 五折+TTA(patch 160×192×160、batch 3,同训练器同日程),挑战成绩只用于事后对比。第五步,统计:配对比较联合剔除非有限值案例并做 10,000 次百分位 bootstrap;失败分析取 bottom 10%(阈值 0.7877),用 rank-biserial、秩残差 partial Spearman、BH 校正、2,000 次折分层 bootstrap。容器锁定 nnU-Net 2.6.2 / PyTorch 2.6.0 / CUDA 12.4 / cuDNN 9。
技术新颖性
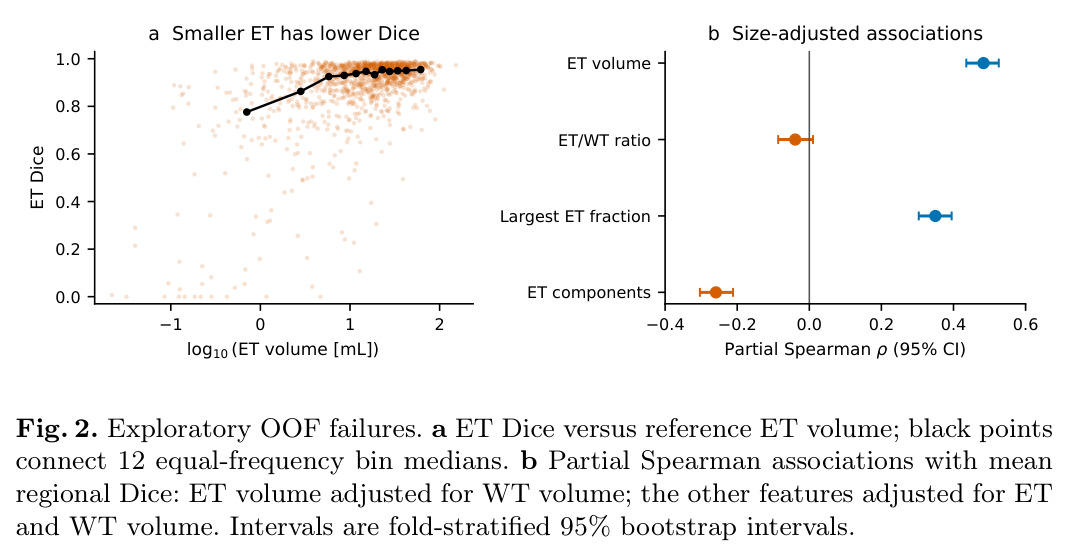
新颖性体现在方法学审计而非算法本身,具体有三点。第一,据其所知首次在 BraTS-GoAT 2026 上系统量化"默认 nnU-Net + 常见加料"的真实边际效应,并给出多数为零的结论——五折集成对 DSC 无配对改善(变化均在 ±0.0008 内)、镜像 TTA 在集成下增益消失、残差编码器各区域点估计反而略低(−0.0033 至 −0.0047 且区间含零)——负结果的完整报告本身就有社区价值。第二,明确区分 CV 集成与 deep ensemble 并引用受控研究(此前文献中两种构造在 OOD 上无稳定胜负),建议明确报告构造方式,这是对集成方法学的一个小而重要的澄清。第三,失败分析将"小而碎的 ET"与低 Dice 建立了经过体积调整仍然稳健的关联(ET 体积 $\rho=0.483$、最大分量占比 $\rho=0.350$、分量数 $\rho=-0.259$,均 $q<10^{-20}$),给出了可操作的失败画像。作者也诚实地标注这些分析是探索性的:假设与估计用同一批案例,且各折训练集有重叠。
实验结果
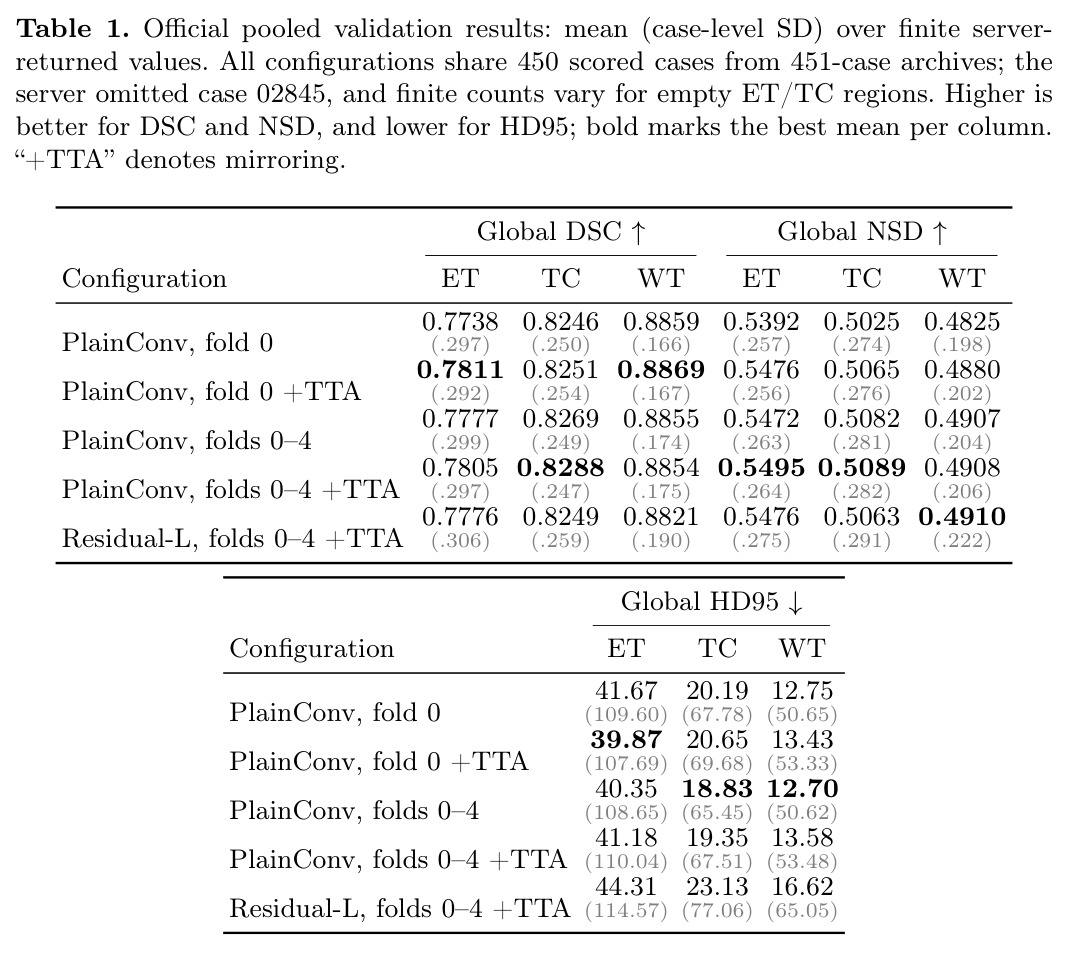
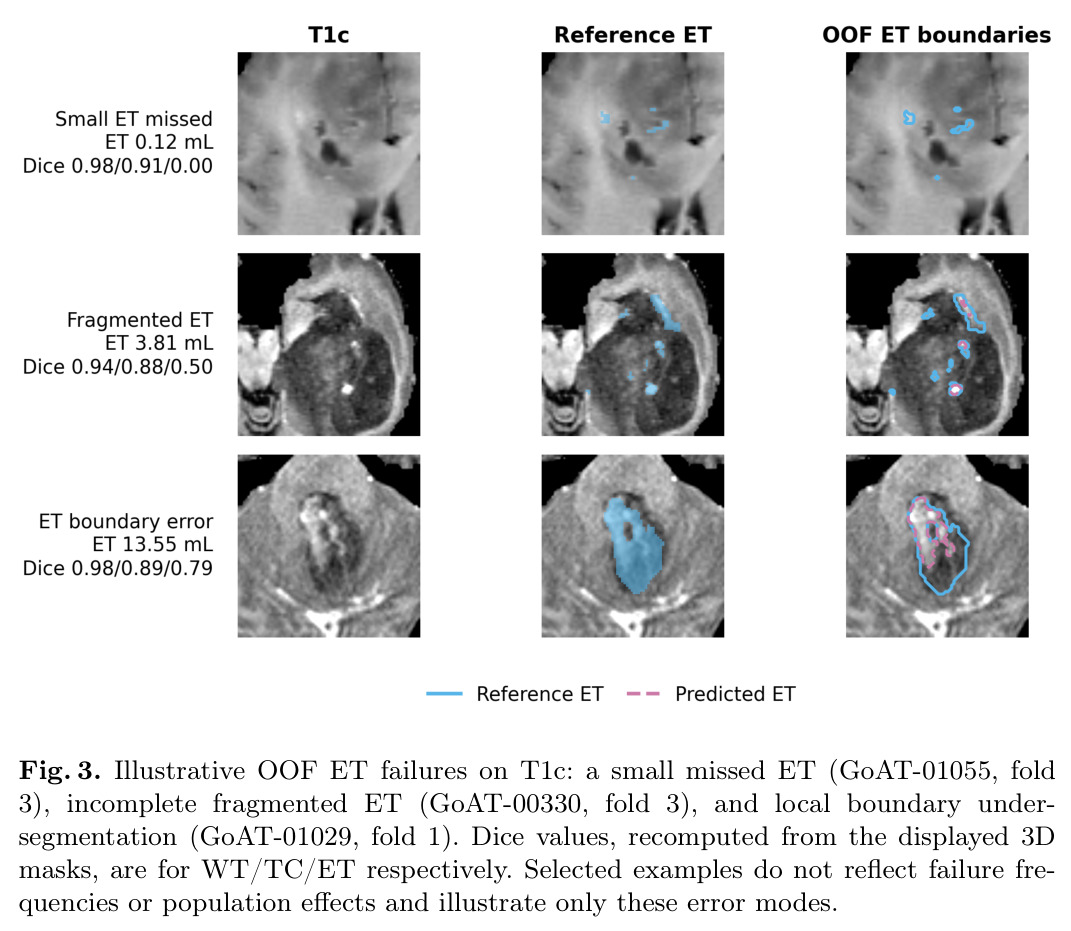
逐一看五组结果。(1) 内部五折 CV:折均前景 Dice 0.9022;逐案例 OOF 区域 Dice:ET 0.8674(n=1343)、TC 0.9125、WT 0.9267,严格均值 0.9034。(2) 官方混合验证(451 例提交、450 例计分):五折+TTA 均值 DSC 最高 0.8315、NSD 0.5164,分区域 ET/TC/WT DSC = 0.7805/0.8288/0.8854;fold0+TTA 为 0.8310/0.5140;残差编码器全面略低(均值 0.8282)但区间含零。(3) 消融:fold0 上镜像 TTA 使 ET/WT DSC 各 +0.0021/+0.0011、NSD +0.0040~0.0055;叠加五折集成后所有变化在 ±0.0008 内且区间含零——TTA 增益在集成下蒸发。(4) 泛化差距:配对 fold-0+TTA 下区域均 Dice 从源 OOF 0.9058 降至 0.8310(−0.0747,CI −0.0976~−0.0523),分区域 ET −0.0856、TC −0.0923、WT −0.0464,ET/TC 掉得最多。(5) 失败分析:bottom 10%(135/1343,阈值 0.7877)失败案例参考 ET 体积中位数仅 1.04 mL vs 非失败组 18.66 mL(rank-biserial −0.808,$q=2.34\times10^{-52}$),在 5%/10%/20% 定义下为 −0.938/−0.808/−0.702;控制体积后 ET 体积 $\rho=0.483$、最大分量占比 $\rho=0.350$ 有利、分量数 $\rho=-0.259$ 不利、ET/WT 比 $\rho=-0.039$ 无关联。事后 ET 阈值/分量尺寸扫描反而 −0.00072,未进最终流程。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| BraTS-GoAT 2026 官方混合验证(450 例计分) | 全局 DSC(ET / TC / WT) | PlainConv 五折 + 镜像 TTA:0.7805 / 0.8288 / 0.8854 | PlainConv fold-0(无 TTA):0.7738 / 0.8246 / 0.8859 | ET +0.0067、TC +0.0042、WT −0.0005(集成+TTA 的联合效果,非各自显著) |
| BraTS-GoAT 2026 官方混合验证 | 三区域平均 DSC | 0.8315(五折+TTA,均值 NSD 0.5164) | 残差编码器 ResidualEncoderUNet-L 五折+TTA:0.8282 | +0.0033(配对区间含零,不构成显著优势) |
| 官方验证 NSD(ET / TC / WT) | 全局 NSD | 0.5495 / 0.5089 / 0.4908(五折+TTA) | fold-0 无 TTA:0.5392 / 0.5025 / 0.4825 | +0.0063 ~ +0.0083 |
| 源域 OOF → 混合验证泛化差距(配对 fold-0+TTA) | 区域均 DSC 之差 | −0.0747(0.9058 → 0.8310);ET −0.0856、TC −0.0923、WT −0.0464 | 源域 OOF 同模型表现 0.9058 | 负向差距,95% CI −0.0976 至 −0.0523,混合了评估器与病例构成因素 |
| 源域 OOF 失败分析(1343 例) | 失败/非失败组参考 ET 体积中位数 | 1.04 mL vs 18.66 mL(rank-biserial −0.808) | 非失败组(其余 1208 例)18.66 mL | $q=2.34\times10^{-52}$,效应在三种失败定义下方向一致 |
局限与改进
作者承认的局限:验证集参考标签和逐例人群映射隐藏,所有目标域分析只能做混合汇总,无法按人群归因;最终提交配置(五折+TTA)是按验证成绩事后选择的,不证明其普适优越;验证服务器未公开 NSD 容差(只知 $\tau=1$ 但不知单位),NSD 数值只能照录;bootstrap 区间只量化案例抽样不确定性,未包含重训练不确定性;失败分析是探索性的,假设与估计使用同一批案例且各折训练集互相重叠。我补充的观察:其一,−0.0747 的泛化差距混合了评估器实现差异与病例构成差异,作者自己也声明这不是纯分布漂移估计,读者不应直接把它当作"跨人群性能下降";其二,失败分析只在有标签源人群(GLI/MEN/MET)上做,"小而碎的 ET 导致失败"未必外推到 SSA 或儿童人群,后者的协议差异和肿瘤生物学可能带来完全不同的失败模式;其三,DSC 对小目标天然苛刻,"ET 小 → Dice 低"有一部分是度量性质而非纯粹的模型能力缺陷,虽然调整体积后的分量碎片化关联仍提供了增量信息;其四,每折仅训练 1000 epochs(12.3h),未探索更长训练、更强增强或针对小病灶的采样策略能否缩小差距。
独立分析的弱点
弱点一:没有逐例人群标签,无法诊断哪个人群拖累分数,也无法验证"儿童/SSA 是否更差"。改进:主办方发布人群映射后立即做分层评估与按人群的错误分解。弱点二:失败分析仅基于源人群 OOF,SSA/PED 的协议差异和肿瘤生物学可能带来完全不同的失败模式,"小而碎 ET"画像未必外推。改进:在验证集上用无监督域距离或预测不确定性做盲态分层检验可迁移性。弱点三:TTA 与集成增益(≤0.002)远小于源-验证差距(0.075),说明工程加料替代不了泛化问题,但论文未测任何域自适应手段(测试时适应、直方图归一化、风格增广)。改进:下一届把这些手段纳入同等严格的配对消融。弱点四:五个提交配置按验证成绩事后挑选,官方成绩带轻微选择偏差(作者已承认)。改进:预先注册提交计划或用内部留出折做模型选择。弱点五:ET 阈值扫描的校准折模型见过部分被评估案例(未完全嵌套),该负结果可信度有限。改进:用完全嵌套的内循环重做。
未来方向
作者提出的方向:获取人群映射后做人群特异分析;把失败画像(小、碎的 ET)转化为针对性训练策略,例如小病灶过采样或分量感知的损失/后处理——但需注意论文自己的阈值扫描失败,说明需要更原则性的方法而非简单调参;推动社区统一公开 NSD 容差标准。基于其成果可延伸的方向:第一,做 CV 集成与 deep ensemble 在本任务上的受控 OOD 对比,检验文献结论是否适用于脑肿瘤分割;第二,用测试时适应或协议层面的归一化(直方图匹配、spacing 对齐)处理 SSA/PED 的采集差异,并把效果放到与本文相同的配对 bootstrap 框架下评估;第三,利用深度集成的预测不确定性做"失败前置检测"——高不确定性加上小 ET 预测时提示人工复核,把失败画像变成部署工具;第四,虽然全局阈值扫描无益,但按肿瘤体积或分量数条件化选择后处理策略(如仅对大 WT 删除小 ET 分量)仍值得系统化探索;第五,参考儿童 CT 的教训,为隐藏目标人群定制 nnU-Net 配置计划(patch 大小、目标 spacing)可能是低成本的泛化手段,可与固定计划做对照。
复现评估
复现条件非常好。代码、nnU-Net plans、容器文件、推理配置、验证检查和分析脚本全部公开在 github.com/Kirscher/BraTS2026,五个 epoch-1000 checkpoint 以版本化包提供链接。数据为 BraTS-GoAT 2026 挑战赛数据(Synapse ID syn74274097),需向主办方申请且不可再分发;挑战预测与官方成绩不公开,依赖验证集的分析只能核查、不能从干净克隆完整重跑(作者明确说明)。算力:训练约 5×12.3h ≈ 2.5 个 A100 40GB 日;推理门槛低,451 例五折+镜像 TTA 用单张 Quadro RTX 6000 24GB 仅需 1h55min(15.3 s/例),中端 GPU 一天内可复现推理级结果。环境锁定 nnU-Net 2.6.2、PyTorch 2.6.0、CUDA 12.4、cuDNN 9,离线容器读 /input 写 /output。总体难度低:有数据权限者按仓库脚本即可端到端重跑;无权限者仍可用公开 checkpoint 与分析脚本核查方法论。
论文图表